首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10000篇文章
优秀的个人博客,低调大师

数仓现网案例丨超大结果集接收异常

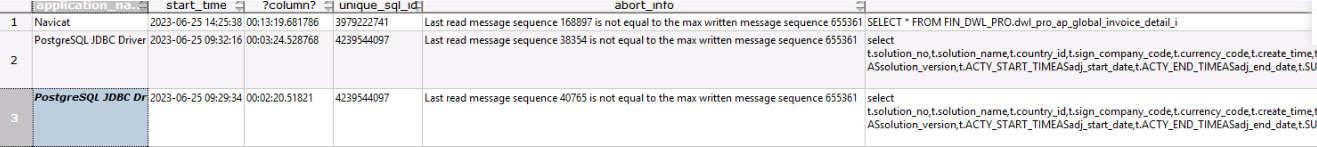
本文分享自华为云社区《GaussDB(DWS)现网案例之超大结果集接收异常》,作者:你是猴子请来的救兵吗 。 问题背景 内核版本GaussDB 8.1.3 问题描述用户使用数据库客户端工具如navicat、dbeaver等执行查询语句异常中断,中断信息"Last read message sequence %d is not equal to the max written message sequence %d" 问题定位 客户端异常中断后有些错误信息时不感知的,此时topsql就派上了用场。历史topsql记录了查询作业运行结束时的资源使用情况(包括内存、下盘、CPU时间等)和运行状态信息(包括报错、终止、异常等)以及性能告警信息。而对于由于FATAL、PANIC错误导致查询异常结束时,状态信息列只显示aborted,无法记录详细异常信息。 1,此时我们通过历史topsql查询视图查询语句执行情况 --当前CN select * from GS_WLM_SESSION_HISTORY; --所有CN select * from PGXC_WLM_SESSION_HISTORY; 根据topsql记录结果发现语句存在abort_info为 Last read message sequence %d is not equal to the max written message sequence %d 可知,查询执行遇到FATAL、PANIC错误导致查询异常结束 2,接着确认日志信息,通过线程ID查看当时语句执行情况,发现客户端存在异常中断 根因分析 前提: cn_retry开启+查询语句+max_cn_temp_file_size临时文件开启 发送逻辑: 服务端执行查询之后,会通过发送缓冲区往客户端发送数据;当查询结果集过大,则发送缓冲区满了之后,会往临时文件写数据;当临时文件超出max_cn_temp_file_size指定的最大值时(此时会禁用cn_retry),需要分批发送,此时会先将已写入临时文件的数据发送至客户端;然后继续将剩余数据写入新的临时文件发送,以此循环,直到所有数据发送完成。 问题场景: 当临时文件超出最大值时,先将其发送至客户端,此时客户端断连(如产生oom),数据发送中断,此时已发送数据量与已写入临时文件的数据量不一致,因此产生报错 Last read message sequence %d is not equal to the max written message sequence %d 此报错代表已写入临时文件的数据与已发送到客户端的数据量不一致,实际场景为客户端异常导致的发送数据中断,因此报错内容符合预期。 相关知识 相关guc参数: 1,cn_send_buffer_size:指定CN端数据发送数据缓存区的大小。整型,8~128, 单位为KB。默认8KB 2,max_cn_temp_file_size:指定SQL语句出错自动重试功能中CN端使用临时文件的最大值,设定为0表示不使用临时文件。默认5G 相关日志记录: 1,临时文件超出max_cn_temp_file_size,记录" %s temp file exceeded, max temp file size : %d KB, current result size : %ld KB" 2,客户端异常导致数据发送失败,记录"could not send data to client [ Remote IP: %s PORT: %s]. detail:%s" 3,数据发送中断或结束,当已发送数据和已写入临时文件的数据量不一致时,记录"Last read message sequence %d is not equal to the max written message sequence %d" 场景复现 创建普通表即可,导入一定量的数据,执行简单查询使其返回较大的结果集,如 select * from store_sales; 为了方便场景复现,临时将允许的临时文件最大值调整为500M,便于触发分批发送。 1,正常接收场景 此时客户端环境内存足够,可正常接收数据,超大结果集将通过临时文件下盘的方法分批发送,直到所有数据发送完成。 2,异常中断场景 此时客户端环境允许的数据量优先,超大结果集将分批发送的过程中,客户端触发OOM异常中断,服务端会记录客户端异常发送失败信息以及已发送数据不一致的错误信息。 改善办法 1,避免超大结果集的查询,如果无法避免,则通过分页或游标多次查询 2,增大客户端支持的运行内存,防止内存不足 知识小结 1,报错Last read message sequence %d is not equal to the max written message sequence %d为超大结果集返回异常中断时的报错,符合预期,需通过业务语句的改写或客户端环境的改善来解决。 2,TopSQL查询监控的原理和适用方法可参考:GaussDB for DWS 资源监控核心技术解密: TopSQL查询监控解密 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓实践丨主动预防-DWS关键工具安装确认

摘要:gdb确认是否安装,所带来的该工具用户数据库实例触发core问题后集群状态反复异常,对此问题及时分析根因并及时进行规避。 本文分享自华为云社区《主动预防-DWS关键工具安装确认》,作者:上官寒雨。 【关键工具确认】 1、gdb确认是否安装(该工具用户数据库实例触发core问题后集群状态反复异常,对此问题及时分析根因并及时进行规避) 登录任意集群节点执行以下命令(HC/HCS/HCSO环境登录沙箱外执行): gdb --help 提示以下信息则已安装 2、gstack是否安装(与gdb关联工具,gdb安装后此工具会默认安装,作用与gdb相同) 登录任意集群节点执行以下命令(HC/HCS/HCSO环境登录沙箱外执行): gstack 提示以下信息则已安装 gdb与gstack安装请参考以下链接: https://bbs.huaweicloud.com/forumreview/thread-182292-1-1.html 3、core是否配置(该配置可以确保数据库实例触发core问题后能够抓取异常堆栈信息,以便使用gdb工具从所抓取信息中获取触发实例异常sql及时规避与根因定位) 集群状态为Normal时执行以下命令确认(集群normal情况下该操作不影响业务) kill -11 备dn进程号,检查对应的数据目录下是否生成core文件,若产生core文件则已配置。 若未配置请按照以下链接进行配置: HC/HCS/HCSO core配置:https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=181948 纯软core配置:https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=182036 4、pg_xlogdump是否存在(异常业务产生大量xlog后造成业务慢,磁盘使用率快速上涨等问题,使用此工具解析异常业务) pg_xlogdump提示以下信息则已安装(纯软环境加载环境变量后执行,HC/HCS/HCSO登录至沙箱内执行) 5、pagehack是否存在(数据文件出现静默损坏使用该工具解析异常数据文件) pagehack提示以下信息则已安装(纯软环境加载环境变量后执行,HC/HCS/HCSO登录至沙箱内执行) pg_xlogdump与pagehack工具获取如下链接: https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=142380 上传步骤如下: 步骤1:登录至第一个CN节点,使用omm(云上使用Ruby用户)将pagehack、pg_xlogdump工具上传至该节点$GAUSSHOME/bin/下步骤2:将工具分发至其他节点 gs_ssh -c "scp$hostname:$GAUSSHOME/bin/pagehack $GAUSSHOME/bin/" gs_ssh -c "scp$hostname:$GAUSSHOME/bin/pg_xlogdump $GAUSSHOME/bin/" $hostname为第一个cn节点的hostname。 6、 gs_detect工具上传步骤(此工具包未运维团队开发,其中包括集群状态异常诊断工具、IO高工具、数据文件损坏扫描等工具,方便出现问题后及时定位及恢复) 步骤1:omm用户登录第一个cn节点(云上使用Ruby),在附件获取gs_detect工具并重命名为gs_detect.tar.gz上传至第一个cn节点/home/omm路径下(HC/HCS/HCSO形态放在第一个cn节点/home/Ruby路径下) 步骤2:使用以下命令解压 cd /home/omm tar -zxvf gs_detect.tar.gz 步骤3:将gs_detect工具分发至其他节点 gs_ssh -c "scp -rhostname:/home/omm/gs_detect /home/omm" $hostname为第一个cn节点的hostname。 注:云上的分发命令需要在沙箱内执行 【系统加固】 1、arm加固项确认(x86机器不涉及) https://support.huawei.com/enterprise/zh/bulletins-product/ENEWS2000007743 2、Centos7.6impi模块导致服务器反复重启,修复方案见附件 《CentOS7.6 ipmi模块补丁合入指导.docx》 附件:gs_detect.tar.txt67.72KB 附件:ipmi模块补丁合入指导.docx2.33MB 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一文掌握数仓中auto analyze的使用

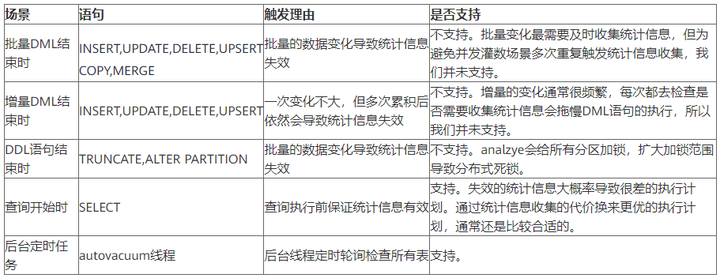
摘要:analyze执行的是否及时,在一定程度上直接决定了SQL执行的快慢。 本文分享自华为云社区《一文读懂autoanalyze使用【这次高斯不是数学家】》,作者: leapdb。 analyze执行的是否及时,在一定程度上直接决定了SQL执行的快慢。因此,GaussDB(DWS)引入了自动统计信息收集,可以做到让用户不再担心统计信息是否过期。 1. 自动收集场景 需要进行自动统计信息收集的场景通常有五个:批量DML结束时,增量DML结束时,DDL结束时,查询开始时和后台定时任务。 所以,为了避免对DML,DDL带来不必要的性能开销和死锁风险,我们选择了在查询开始前触发analzye。 2. 自动收集原理 GaussDB(DWS)在SQL执行过程中,会记录表增删改查相关的运行时统计信息,并在事务提交或回滚后记录到共享的内存种。 这些信息可以通过 “pg_stat_all_tables视图” 查询,也可以通过下面函数进行查询。 pg_stat_get_tuples_inserted --表累积insert条数 pg_stat_get_tuples_updated --表累积update条数 pg_stat_get_tuples_deleted --表累积delete条数 pg_stat_get_tuples_changed --表自上次analyze以来,修改的条数 pg_stat_get_last_analyze_time --查询最近一次analyze时间 因此,根据共享内存中 "表自上次analyze以来修改过的条数" 是否超过一定阈值,就可以判定是否需要做analyze了。 3. 自动收集阈值 3.1 全局阈值 autovacuum_analyze_threshold #表触发analyze的最小修改量 autovacuum_analyze_scale_factor #表触发analyze时的修改百分比 当"表自上次analyze以来修改的条数" >= autovacuum_analyze_threshold + 表估算大小 * autovacuum_analyze_scale_factor时,需要自动触发analyze。 3.2 表级阈值 --设置表级阈值 ALTER TABLE item SET (autovacuum_analyze_threshold=50); ALTER TABLE item SET (autovacuum_analyze_scale_factor=0.1); --查询阈值 postgres=# select pg_options_to_table(reloptions) from pg_class where relname='item'; pg_options_to_table --------------------------------------- (autovacuum_analyze_threshold,50) (autovacuum_analyze_scale_factor,0.1) (2 rows) --重置阈值 ALTER TABLE item RESET (autovacuum_analyze_threshold); ALTER TABLE item RESET (autovacuum_analyze_scale_factor); 不同表的数据特征不一样,需要触发analyze的阈值可能有不同的需求。表级阈值优先级高于全局阈值。 3.3 查看表的修改量是否超过了阈值(仅当前CN) postgres=# select pg_stat_get_local_analyze_status('t_analyze'::regclass); pg_stat_get_local_analyze_status ---------------------------------- Analyze not needed (1 row) 4. 自动收集方式 GaussDB(DWS)提供了三种场景下表的自动分析。 当查询中存在“统计信息完全缺失”或“修改量达到analyze阈值”的表,且执行计划不采取FQS (Fast Query Shipping)执行时,则通过autoanalyze控制此场景下表统计信息的自动收集。此时,查询语句会等待统计信息收集成功后,生成更优的执行计划,再执行原查询语句。 当autovacuum设置为on时,系统会定时启动autovacuum线程,对“修改量达到analyze阈值”的表在后台自动进行统计信息收集。 5.冻结统计信息 5.1 冻结表的distinct值 当一个表的distinct总是估算不准,例如:数据扎堆儿重复场景。如果表的distinct值固定,可以通过以下方式冻结表的distinct值。 postgres=# alter table lineitem alter l_orderkey set (n_distinct=0.9); ALTER TABLE postgres=# select relname,attname,attoptions from pg_attribute a,pg_class c where c.oid=a.attrelid and attname='l_orderkey'; relname | attname | attoptions ----------+------------+------------------ lineitem | l_orderkey | {n_distinct=0.9} (1 row) postgres=# alter table lineitem alter l_orderkey reset (n_distinct); ALTER TABLE postgres=# select relname,attname,attoptions from pg_attribute a,pg_class c where c.oid=a.attrelid and attname='l_orderkey'; relname | attname | attoptions ----------+------------+------------ lineitem | l_orderkey | (1 row) 5.2. 冻结表的全部统计信息 如果表的数据特征基本不变,还可以冻结表的统计信息,来避免重复进行analyze。 alter table table_name set frozen_stats=true; 6. 手动查看表是否需要做analyze a. 不想在业务高峰期时触发数据库后台任务,所以不愿意打开autovacuum来触发analyze,怎么办? b. 业务修改了一批表,想立即对这些表马上做一次analyze,又不知道都有哪些表,怎么办? c. 业务高峰来临前想对临近阈值的表都做一次analyze,怎么办? 我们将autovacuum检查阈值判断是否需要analyze逻辑,抽取成了函数,帮助用户灵活主动的检查哪些表需要做analyze。 6.1 判断表是否需要analyze(串行版,适用于所有历史版本) -- the function for get all pg_stat_activity information in all CN of current cluster. CREATE OR REPLACE FUNCTION pg_catalog.pgxc_stat_table_need_analyze(in table_name text) RETURNS BOOl AS $$ DECLARE row_data record; coor_name record; fet_active text; fetch_coor text; relTuples int4; changedTuples int4:= 0; rel_anl_threshold int4; rel_anl_scale_factor float4; sys_anl_threshold int4; sys_anl_scale_factor float4; anl_threshold int4; anl_scale_factor float4; need_analyze bool := false; BEGIN --Get all the node names fetch_coor := 'SELECT node_name FROM pgxc_node WHERE node_type=''C'''; FOR coor_name IN EXECUTE(fetch_coor) LOOP fet_active := 'EXECUTE DIRECT ON (' || coor_name.node_name || ') ''SELECT pg_stat_get_tuples_changed(oid) from pg_class where relname = ''''|| table_name ||'''';'''; FOR row_data IN EXECUTE(fet_active) LOOP changedTuples = changedTuples + row_data.pg_stat_get_tuples_changed; END LOOP; END LOOP; EXECUTE 'select pg_stat_get_live_tuples(oid) from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into relTuples; EXECUTE 'show autovacuum_analyze_threshold;' into sys_anl_threshold; EXECUTE 'show autovacuum_analyze_scale_factor;' into sys_anl_scale_factor; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_threshold'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_threshold; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_scale_factor'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_scale_factor; --dbms_output.put_line('relTuples='||relTuples||'; sys_anl_threshold='||sys_anl_threshold||'; sys_anl_scale_factor='||sys_anl_scale_factor||'; rel_anl_threshold='||rel_anl_threshold||'; rel_anl_scale_factor='||rel_anl_scale_factor||';'); if rel_anl_threshold IS NOT NULL then anl_threshold = rel_anl_threshold; else anl_threshold = sys_anl_threshold; end if; if rel_anl_scale_factor IS NOT NULL then anl_scale_factor = rel_anl_scale_factor; else anl_scale_factor = sys_anl_scale_factor; end if; if changedTuples > anl_threshold + anl_scale_factor * relTuples then need_analyze := true; end if; return need_analyze; END; $$ LANGUAGE 'plpgsql'; 6.2 判断表是否需要analyze(并行版,适用于支持并行执行框架的版本) -- the function for get all pg_stat_activity information in all CN of current cluster. --SELECT sum(a) FROM pg_catalog.pgxc_parallel_query('cn', 'SELECT 1::int FROM pg_class LIMIT 10') AS (a int); 利用并发执行框架 CREATE OR REPLACE FUNCTION pg_catalog.pgxc_stat_table_need_analyze(in table_name text) RETURNS BOOl AS $$ DECLARE relTuples int4; changedTuples int4:= 0; rel_anl_threshold int4; rel_anl_scale_factor float4; sys_anl_threshold int4; sys_anl_scale_factor float4; anl_threshold int4; anl_scale_factor float4; need_analyze bool := false; BEGIN --Get all the node names EXECUTE 'SELECT sum(a) FROM pg_catalog.pgxc_parallel_query(''cn'', ''SELECT pg_stat_get_tuples_changed(oid)::int4 from pg_class where relname = ''''|| table_name ||'''';'') AS (a int4);' into changedTuples; EXECUTE 'select pg_stat_get_live_tuples(oid) from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into relTuples; EXECUTE 'show autovacuum_analyze_threshold;' into sys_anl_threshold; EXECUTE 'show autovacuum_analyze_scale_factor;' into sys_anl_scale_factor; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_threshold'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_threshold; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_scale_factor'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_scale_factor; dbms_output.put_line('relTuples='||relTuples||'; sys_anl_threshold='||sys_anl_threshold||'; sys_anl_scale_factor='||sys_anl_scale_factor||'; rel_anl_threshold='||rel_anl_threshold||'; rel_anl_scale_factor='||rel_anl_scale_factor||';'); if rel_anl_threshold IS NOT NULL then anl_threshold = rel_anl_threshold; else anl_threshold = sys_anl_threshold; end if; if rel_anl_scale_factor IS NOT NULL then anl_scale_factor = rel_anl_scale_factor; else anl_scale_factor = sys_anl_scale_factor; end if; if changedTuples > anl_threshold + anl_scale_factor * relTuples then need_analyze := true; end if; return need_analyze; END; $$ LANGUAGE 'plpgsql'; 6.3 判断表是否需要analyze(自定义阈值) -- the function for get all pg_stat_activity information in all CN of current cluster. CREATE OR REPLACE FUNCTION pg_catalog.pgxc_stat_table_need_analyze(in table_name text, int anl_threshold, float anl_scale_factor) RETURNS BOOl AS $$ DECLARE relTuples int4; changedTuples int4:= 0; need_analyze bool := false; BEGIN --Get all the node names EXECUTE 'SELECT sum(a) FROM pg_catalog.pgxc_parallel_query(''cn'', ''SELECT pg_stat_get_tuples_changed(oid)::int4 from pg_class where relname = ''''|| table_name ||'''';'') AS (a int4);' into changedTuples; EXECUTE 'select pg_stat_get_live_tuples(oid) from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into relTuples; if changedTuples > anl_threshold + anl_scale_factor * relTuples then need_analyze := true; end if; return need_analyze; END; $$ LANGUAGE 'plpgsql'; 通“优化器触发的实时analyze”和“后台autovacuum触发的轮询analyze”,GaussDB(DWS)已经可以做到让用户不再关心表是否需要analyze。建议在最新版本中试用。 点击关注,第一时间了解华为云新鲜技术~
优秀的个人博客,低调大师

一文讲透数仓临时表的用法

摘要:临时表作为一个SQL标准中的表类型,各个厂商在实现时,往往却不相同,甚至行为上也存在差异,本文小结下GaussDB(DWS)的临时表使用场景。 本文分享自华为云社区《GaussDB(DWS)临时表小结》,作者: sincatter 。 语法介绍 如下为创建表的基本语法(详见手册): CREATE [ [ GLOBAL | LOCAL ] { TEMPORARY | TEMP } | UNLOGGED ] TABLE [ IF NOT EXISTS ] table_name ({ column_name data_type [ compress_mode ] [ COLLATE collation ] [ column_constraint [ ... ] ] | table_constraint | LIKE source_table [ like_option [...] ] } [, ... ]) [ WITH ( {storage_parameter = value} [, ... ] ) ] [ ON COMMIT { PRESERVE ROWS | DELETE ROWS | DROP } ] [ COMPRESS | NOCOMPRESS ] [ TABLESPACE tablespace_name ] [ DISTRIBUTE BY { REPLICATION | { HASH ( column_name [,...] ) } } ] [ TO { GROUP groupname | NODE ( nodename [, ... ] ) } ]; 其中临时表相关的关键字有: [ GLOBAL | LOCAL ] 创建临时表时可以在TEMP或TEMPORARY前指定GLOBAL或LOCAL关键字。目前GaussDB(DWS)设立这两个关键字,仅仅是为了兼容SQL标准,实际行为上无论指定的是GLOBAL还是LOCAL,GaussDB(DWS)都只会创建为本地临时表,即只有LOCAL关键字是有效的。 { TEMPORARY | TEMP } TEMP和TEMPORARY等价。如果指定TEMP或TEMPORARY关键字,则创建的表为临时表。临时表行为上的主要特征为只在当前会话可见,本会话结束后会自动删除。由于临时表只在当前会话创建,对于涉及对临时表操作的DDL语句,很容易产生DDL失败的报错。因此,建议DDL语句中不要对临时表进行操作。 ON COMMIT { PRESERVE ROWS | DELETE ROWS | DROP } ON COMMIT选项决定在事务中执行创建临时表操作,当事务提交时,此临时表的后续操作。有以下三个选项: PRESERVE ROWS(缺省值):提交时不对临时表做任何操作,临时表及其表数据保持不变。 DELETE ROWS:提交时删除临时表中数据。 DROP:提交时删除此临时表。 原理介绍 GaussDB(DWS)的临时表机制继承自PostgreSQL,临时表在元数据和数据存储上与普通表基本无差异,具体来说,临时表是通过建表时将其Schema指定为与session id相关的一个schema,其他session实际上也是可以在系统表中查看到当前临时表的元数据。GaussDB(DWS)会利用schema进行临时表的不同session间隔离。这里通过两个现象去说明这个机制: 现象一: 一个session_1创建一个临时表: postgres=# create temp table tt1(a int); CREATE TABLE postgres=# \d List of relations Schema | Name | Type | Owner | Storage ------------------------------------------+------+-------+-------+---------------------------------- pg_temp_coordinator1_2_4_139820525504256 | tt1 | table | xucw | {orientation=row,compression=no} (1 row) postgres=# select relname,relnamespace from pg_class where relname like 'tt%'; relname | relnamespace ---------+-------------- tt1 | 24600 (1 row) 另外一个session_2,可以一样可以通过pg_class查看临时表的表结构: postgres=# select relname,relnamespace from pg_class where relname like 'tt%'; relname | relnamespace ---------+-------------- tt1 | 24600 (1 row) 但session_2中是无法查看当前临时表中的数据: postgres=# select * from pg_temp_coordinator1_2_4_139820525504256.tt1; ERROR: Can only access temp objects of the current session. LINE 1: select * from pg_temp_coordinator1_2_4_139820525504256.tt1; 现象二: 创建一个临时表后,再根据这个临时表的schema,去创建一个相同schema的普通表: postgres=# create temp table tt1(a int); CREATE TABLE postgres=# \d List of relations Schema | Name | Type | Owner | Storage ------------------------------------------+------+-------+-------+---------------------------------- pg_temp_coordinator1_2_3_139820525504256 | tt1 | table | xucw | {orientation=row,compression=no} (1 row) postgres=# create table pg_temp_coordinator1_2_3_139820525504256.tt2(a int); CREATE TABLE postgres=# select relname,relnamespace from pg_class where relname like 'tt%'; relname | relnamespace ---------+-------------- tt1 | 24592 tt2 | 24592 (2 rows) 随后,退出当前session,重新连接查看表状态,我们会神奇发现之前创建的临时表tt1消失的同时,创建的普通表tt2也一样消失了。 postgres=# select relname,relnamespace from pg_class where relname like 'tt%'; relname | relnamespace ---------+-------------- (0 rows) 使用注意 与使用永久表相比,使用临时表可以提高性能,但存在丢失数据的风险。临时表只在当前会话可见,本会话结束后将自动删除。如果数据丢失是不可接受的,请使用永久表。 临时表对应的sechema在搜索路径中的优先级是高于其他sechma的,即临时表对应schema具有第一搜索优先级。 \parallel模式不支持创建临时表!如需使用临时表,需要在开启parallel之前就创建好,并在parallel内部使用。parallel内部创建的临时表不会生效。 PG_TOTAL_USER_RESOURCE_INFO视图中的used_temp_space和total_temp_space可以查看当前临时表的相关空间使用情况 创建临时表时,会同步创建临时Schema,这些临时Schema的名称类似于pg_temp_*和pg_toast_temp_* CN Retry功能开启时会为临时表数据记录日志,为保证数据一致性,在使用临时表时不能切换CN Retry开关状态,保持使用临时表的会话中CN Retry开关始终处于打开状态或者关闭状态。 临时表和非日志表的存储方式建议和基表相同。当基表为行存(列存)表时,临时表和非日志表也推荐创建为行存(列存)表,可以避免行列混合关联带来的高计算代价 如果上层应用,使用了连接池机制连接GaussDB(DWS),在使用临时表时,强烈建议将连接归还连接池之前,将临时表主动删除,避免造成连接未断开导致的数据异常 在每个会话第一次使用临时表之前可以改变temp_buffers的值,之后的设置将是无效的 autoanalyze不支持对带有ON COMMIT [DELETE ROWS|DROP]选项的临时表触发autoanalyze,如需收集,需用户手动执行analyze操作 如果创建视图时包含临时表,则该视图会自动转为临时视图 典型场景 临时存储 临时表可以减少冗余中间表的存在,在一些复杂操作时,往往需要借助一些中间表去完成功能,但一般来说普通表的创建是需要数据库管理员来统计创建维护的。临时表的存在就允许中间表用完即清,减少数据库系统中冗余表的存在。另外,临时表在使用时数据是session间隔离的,其他session不能看到当前session的数据,数据安全性在一定程度上也更好。 提升性能 对于过于复杂并且不易通过普通优化方法调整性能的SQL可以考虑拆分的方法,把SQL中某一部分拆分成独立的SQL并把执行结果存入临时表,拆分常见的场景包括但不限于: 作业中多个SQL有同样的子查询,并且子查询数据量较大。 Plan cost计算不准,导致子查询hash bucket太小,比如实际数据1000W行,hash bucket只有1000。 函数(如substr,to_number)导致大数据量子查询选择度计算不准。 多DN环境下对大表做broadcast的子查询。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓是如何与“夏令时”愉快的玩耍?

摘要:主要讲述夏令时的起源,发展,标准化以及如何在GaussDB中查询任一时区的夏令时规则。 本文分享自华为云社区《DWS如何与“夏令时”愉快的玩耍!》,原文作者:leapdb 。 1. 背景介绍 为了更深刻理解夏令时,我们先看一则纠结不休的新闻: 新华网莫斯科7月9日电(记者曹妍)俄罗斯联邦委员会(议会上院)9日通过法案,确定从今年10月26日开始,俄罗斯全国时区将在目前基础上向后推迟一个小时。以首都莫斯科为例,目前时间比格林尼治时间早4个小时,10月26日之后,莫斯科时间将比格林尼治时间早3个小时。 该法案此前已经经过国家杜马(议会下院)通过,预计俄总统将很快签署法案。这是俄罗斯2011年永久使用夏令时后再一次变更时制。俄罗斯幅员辽阔,横跨众多时区,社会一直就如何使用“合理时间”争论不休。而这次时制调整,也不是让所有人都很满意。 出于节能考虑,原苏联及俄罗斯曾经使用过三十年的夏令时。夏令时也称夏时制,指的是在天亮早的春夏季将时间向前调一个小时,其初衷是为了更充分地利用阳光。在很多高纬度地区,春夏季太阳升起时间明显比冬季早,夏时制使人早起早睡,减少因照明消耗的能源。 俄罗斯自1981年至2011年规定使用夏令时。每年3月最后一个星期日,时钟被拨快一个小时;每年10月最后一个星期日,时钟被拨慢一个小时。以首都莫斯科为例,夏令时间比格林尼治时间早4个小时,非夏令时间比格林尼治时间早3个小时。 不过,人们对于夏令时的利弊问题一直存在争议。对于现代社会来说,夏时制是否能节省能源消耗的总量尚无定论。另外,医学专家对于每年两次改变时间对人体生物钟影响有多大也各持意见。 从2011年开始,俄罗斯停止使用冬夏时制转换。时任总统2011年下令,当年夏令时结束后不再将钟表调慢一个小时,并永久使用夏令时间,这意味着俄罗斯全国时区提前一个小时,莫斯科时间全年都比格林尼治时间早4个小时。时任总统解释说,频繁调整时间打乱了人体生物周期,让人感到压力,容易生病。 对于幅员辽阔的俄罗斯来说,永久使用夏令时可以使不同地区的居民多获得部分阳光。但是俄罗斯大部分地区纬度高,冬季时天亮得比较晚,仍然使用夏令时迫使人们需要在黑暗中起床上班,给生活造成一定困难。 永久使用夏令时两年多以来,赞成者越来越少。在停止使用夏时制的2011年当年,俄罗斯独立民调机构列瓦达中心的民调显示,63%的受访者支持永久使用夏令时。不过该调查机构去年10月所做民调显示,赞成此举的受访者比例降低到41%。 2012年至今,曾先后有多名议员提交变更时制的议案。在因各种原因多次推迟讨论后,国家杜马6月终于开始正式讨论变更时制的法案,并确定从永久使用夏令时变为永久使用“冬季时间”。不过这也没有让所有人都满意。稍早前一项民调显示,支持使用夏令时和支持使用“冬季时间”的受访者各占约1/3,另外有1/3的受访者表示无所谓。 可见,夏令时一直是一个争论不休的事情,究竟要不要采用夏令时,我们还需要从它的起因及社会发展程度来细看。 2. 什么是夏令时,夏令时的创建、起因及利弊 夏令时,也叫夏时制,夏时令(Daylight Saving Time:DST)又称为“日光节约时制”,在这一制度实行期间所采用的统一时间称为“夏令时间”。一般在天亮早的夏季人为将时间调快一小时,可以使人早起早睡,减少照明量,以充分利用光照资源,从而节约照明用电。各个采纳夏时制的国家具体规定不同。全世界有近110个国家每年要实行夏令时。 夏令时产生及逐步被多个国家所采用的过程: 1. 美国杰出的政治家、外交家——富兰克林(被印在100美元钞票上的人物),在法国任美国驻法国大使期间,由于习惯于当时美国农村贵族的早睡早起生活,早上散步时看到法国人10点才起床,夜生活过到深夜。 这样与法国人交流、工作的时间就会很少,在他看来这是很浪费时间的。于是他在1784年给《巴黎杂志》的编辑写了一封信,信上说法国人的生活习惯浪费了大好的阳光,建议他们早睡早起,说每年可以节约6千4百万磅蜡烛。 2. 1907年,英国建筑师威廉·维莱特(William Willett)才正式向英国议会提出夏令时的构思,主要是为了节省能源和提供更多的时间用来训练士兵,但议会经过辩论没有采纳。 3. 1916年,德国这个崇尚节约、讲究环保的国家,率先站出来尝试,在全国这项计划,结果每天果真能节约下15%的煤、电等资源。 4. 英国因为怕德国会从中得到更大的效益,因此紧跟着也采取了夏令时,夏令时节约了约15%的煤气和电力。 5. 在英德都采纳夏令时后,法国不久也效仿实行。 6 1917年,俄罗斯第一次实行了夏令时。 7. 1918年,参加了第一次世界大战的美国也实行了夏令时,但战后立即取消了。 8. 1942年,第二次世界大战期间,美国又实行了夏令时。1945-1966年由各州自己确定使用夏令时的起始与结束时间(日期)。1966年,美国联邦政府重新统一了夏令时的起始与结束时间(日期)。 9. 欧洲大部分国家从1976年,即第四次中东战争导致首次石油危机(1973年)3年后开始实行夏令时。 10. 看到了夏令时的益处,接下来,全世界的110个国家先后实行,包括中国。 可见,省钱是个人人都喜欢的好事情。 夏令时的优点 为什么说,夏令时更够节省能源?众所周知,夏天是一年四季中,天亮得较早、天黑得较慢的一个季节,夜晚比较短,白昼比较长。那么,如果大家能够在夏天早起、并晚睡一个小时,将能充分利用好自然光照资源,那么,就能把照明用电给节省下来。而整个夏天,每人将能节省下巨额能源。 夏令时的缺点 当夏令时开始和结束时,人们必须将所有计时仪器调快或调慢,这在以前大家都还使用机械手表或功能手机的年代事件很麻烦的事情。 当夏令时结束时,某些时间会在当天出现两次,这些都容易构成混乱。并且影响航班的时间。 夏令时比较适合高纬度地区,因高纬度地区太阳在夏季升起的时间,明显比冬季要早,因此夏令时的实行效果会很好。可是在低纬度地区就不一样了,不仅实行夏令时的效果不大,还会带来许多负面影响。 比如,低纬度地区夏天的夜晚是湿热、闷热的,让人难以入眠。而到了清晨则比较凉爽舒适,正是安稳睡眠的好时间,这时候如果要早起,就会降低人们的睡眠质量,导致人的精神萎靡,从而影响工作质量,且有损身体的健康,并让人的情绪变得较为烦躁,出现一系列不良的反应。而中国,正是一个低纬度国家,所以不适合实行夏令时。 另外,中国还是一个地域辽阔的国家,因此跨越5个时区,从东向西看,就相差了5个小时。如果再被统一要求提前1个小时起床,像东部地区还好些,可像西部地区,相当于天没亮就起床了……如此,睡眠质量受到影响不说,由于起床时天还没亮,也不可能抹黑洗刷吃早点,那么该使用的照明用电,照样会消耗。 而中国的很多城市在夏天热得像个大火炉,说明在中国夏季,最耗电的不是用于照明,而是用于制冷!那么,如果中国实行夏令时,尤其是大量风扇、空调出现并普及后,要是为节省照明用电而消耗制冷用电,反而得不偿失。 夏令时的本意是早睡早起,充分利用阳光,而调快或调慢所有计时仪器,达到这一目的,无疑是最不恰当的,好比掩耳盗铃。我们应该做的是调整适合的作息时间,养成随手关灯等日常节能环保方式。 3. 我国使用夏令时的历史 看到了夏令时的益处,全世界的110个国家先后实行夏令时,包括中国,为加速经济发展、节约能源,便在1986年4月,发布了在全国实行夏令时的通知,所参照的是国外成熟的相关方案。不过在实行6年之后,也就是1991年时,我国便对夏令时喊停了。 下表是我国以前执行夏令时的时间表: 1935年至1951年,每年5月1日至9月30日。 1952年3月1日至10月31日。 1953年至1954年,每年4月1日至10月31日。 1955年至1956年,每年5月1日至9月30日。 1957年至1959年,每年4月1日至9月30日。 1960年至1961年,每年6月1日至9月30日。 1974年至1975年,每年4月1日至10月31日。 1979年7月1日至9月30日。 1986年4月13日至9月14日, 1987年4月12日至9月13日, 1988年4月10日至9月11日, 1989年4月16日至9月17日, 1990年4月15日至9月16日, 1991年4月14日至9月15日。 4. GaussDB(DWS)中如何查询某个国家的夏令时 4.1. GaussDB(DWS)中时区相关系统表 pg_timezone_names - GaussDB(DWS)中存储时区信息的系统表 pg_timezone_abbrevs - GaussDB(DWS)中存储时区简称信息的系统表 4.2. 查询当前(2021/03/05)已经开始使用夏令时间的时区信息 从 pg_timezone_names 查询当前(2021/03/05)已经开始使用夏令时间的时区信息: postgres=# select * from pg_timezone_names where is_dst='t'; name | abbrev | utc_offset | is_dst -----------------------+--------+------------+-------- Australia/NSW | AEDT | 11:00:00 | t Australia/South | ACDT | 10:30:00 | t Australia/Yancowinna | ACDT | 10:30:00 | t Australia/Broken_Hill | ACDT | 10:30:00 | t Australia/Lord_Howe | +11 | 11:00:00 | t Australia/ACT | AEDT | 11:00:00 | t Australia/Melbourne | AEDT | 11:00:00 | t Australia/Adelaide | ACDT | 10:30:00 | t Australia/LHI | +11 | 11:00:00 | t Australia/Currie | AEDT | 11:00:00 | t Australia/Hobart | AEDT | 11:00:00 | t Australia/Tasmania | AEDT | 11:00:00 | t Australia/Sydney | AEDT | 11:00:00 | t Australia/Canberra | AEDT | 11:00:00 | t Australia/Victoria | AEDT | 11:00:00 | t NZ | NZDT | 13:00:00 | t NZ-CHAT | +1345 | 13:45:00 | t Europe/Dublin | GMT | 00:00:00 | t Eire | GMT | 00:00:00 | t Chile/Continental | -03 | -03:00:00 | t Chile/EasterIsland | -05 | -05:00:00 | t Antarctica/McMurdo | NZDT | 13:00:00 | t Antarctica/South_Pole | NZDT | 13:00:00 | t America/Asuncion | -03 | -03:00:00 | t America/Santiago | -03 | -03:00:00 | t Pacific/Apia | +14 | 14:00:00 | t Pacific/Chatham | +1345 | 13:45:00 | t Pacific/Easter | -05 | -05:00:00 | t Pacific/Auckland | NZDT | 13:00:00 | t Pacific/Norfolk | +12 | 12:00:00 | t (30 rows) 从 pg_timezone_abbrevs 查询当前(2021/03/05)已经开始使用夏令时间的时区信息: postgres=# select * from pg_timezone_abbrevs where is_dst='t'; abbrev | utc_offset | is_dst --------+------------+-------- ACDT | 10:30:00 | t ACSST | 10:30:00 | t ADT | -03:00:00 | t AEDT | 11:00:00 | t AESST | 11:00:00 | t AKDT | -08:00:00 | t ALMST | 07:00:00 | t AWSST | 09:00:00 | t AZOST | 00:00:00 | t BDST | 02:00:00 | t BRST | -02:00:00 | t BST | 01:00:00 | t CADT | 10:30:00 | t CDT | -05:00:00 | t CEST | 02:00:00 | t CETDST | 02:00:00 | t CHADT | 13:45:00 | t CLST | -03:00:00 | t CLT | -03:00:00 | t EASST | -05:00:00 | t EAST | -05:00:00 | t EDT | -04:00:00 | t EEST | 03:00:00 | t EETDST | 03:00:00 | t EGST | 00:00:00 | t FJST | 13:00:00 | t FNST | -01:00:00 | t IDT | 03:00:00 | t KDT | 10:00:00 | t KGST | 06:00:00 | t LHDT | 11:00:00 | t MDT | -06:00:00 | t MEST | 02:00:00 | t MESZ | 02:00:00 | t METDST | 02:00:00 | t MSD | 04:00:00 | t MUST | 05:00:00 | t NDT | -02:30:00 | t NZDT | 13:00:00 | t PDT | -07:00:00 | t PKST | 06:00:00 | t PMDT | -02:00:00 | t PYST | -03:00:00 | t PYT | -03:00:00 | t SADT | 10:30:00 | t ULAST | 09:00:00 | t UYST | -02:00:00 | t UZST | 06:00:00 | t WADT | 08:00:00 | t WDT | 09:00:00 | t WETDST | 01:00:00 | t WGST | -02:00:00 | t YEKST | 06:00:00 | t (53 rows) 4.3. GaussDB(DWS)中查询某个时区采用夏令时的历史记录 在GaussDB(DWS)中我们可以通过SQL查询当前某个时区是否已经采用夏令时间的信息,但是我们如果想知道某个时区在历史上都哪些时间使用过夏令时,我们可以借助外部工具来实现。 zdump 是一个linux操作系统自带的二进制时间文件解析工具。通过它我们可以解析一个二进制时区文件,查看某个时区相对于UTC的时间差以及夏令时规则。 GaussDB(DWS)中采用与GNU一致的标准时区数据信息库,因此GaussDB(DWS)中的二进制时区文件也可以使用该工具来解析。从上图中我们可以看出我国采用夏令时的历史。 5. 总结 综上,GaussDB(DWS)作为一款面向全球用户的高性能分析型数据库产品,对夏令时的支持也是符合工业界标准规范的。GaussDB(DWS)中自带时区信息库,可以简易方便的查询夏令时信息。 想了解GuassDB(DWS)更多信息,欢迎微信搜索“GaussDB DWS”关注微信公众号,和您分享最新最全的PB级数仓黑科技~ 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册