Redisson官方文档 - 9. 分布式服务
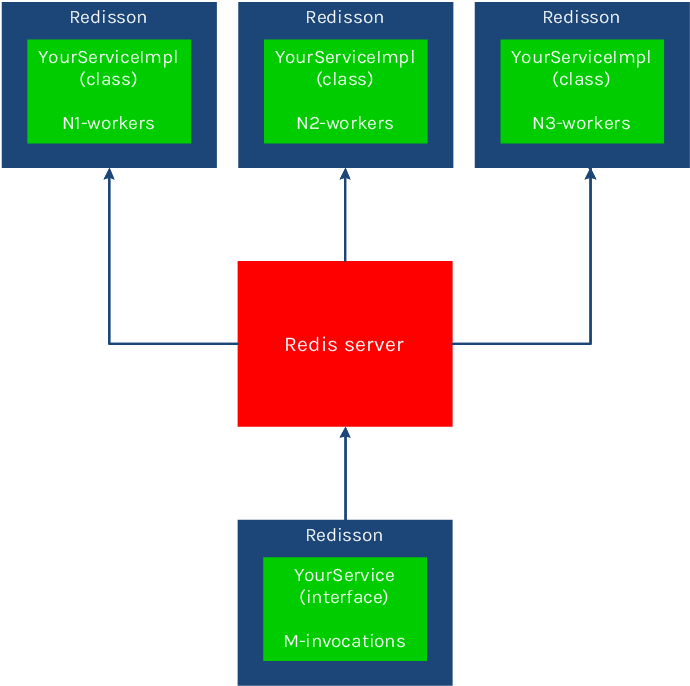
9.1. 分布式远程服务(Remote Service) 基于Redis的Java分布式远程服务,可以用来通过共享接口执行存在于另一个Redisson实例里的对象方法。换句话说就是通过Redis实现了Java的远程过程调用(RPC)。分布式远程服务基于可以用POJO对象,方法的参数和返回类不受限制,可以是任何类型。 分布式远程服务(Remote Service)提供了两种类型的RRemoteService实例: 服务端(远端)实例 - 用来执行远程方法(工作者实例即worker instance).例如: RRemoteService remoteService = redisson.getRemoteService(); SomeServiceImpl someServiceImpl = new SomeServiceImpl(); // 在调用远程方法以前,应该首先注册远程服务 // 只注册了一个服务端工作者实例,只能同时执行一个并发调用 remoteService.register(SomeServiceInterface.class, someServiceImpl); // 注册了12个服务端工作者实例,可以同时执行12个并发调用 remoteService.register(SomeServiceInterface.class, someServiceImpl, 12); 客户端(本地)实例 - 用来请求远程方法.例如: RRemoteService remoteService = redisson.getRemoteService(); SomeServiceInterface service = remoteService.get(SomeServiceInterface.class); String result = service.doSomeStuff(1L, "secondParam", new AnyParam()); 客户端和服务端必须使用一样的共享接口,生成两者的Redisson实例必须采用相同的连接配置。客户端和服务端实例可以运行在同一个JVM里,也可以是不同的。客户端和服务端的数量不收限制。(注意:尽管Redisson不做任何限制,但是Redis的限制仍然有效。) 在服务端工作者可用实例数量 大于1 的时候,将并行执行并发调用的远程方法。 并行执行工作者数量计算方法如下:T = R * N T - 并行执行工作者总数R - Redisson服务端数量N - 注册服务端时指定的执行工作者数量 超过该数量的并发请求将在列队中等候执行。 在服务端工作者实例可用数量为 1 时,远程过程调用将会按 __顺序执行__。这种情况下,每次只有一个请求将会被执行,其他请求将在列队中等候执行。 9.1.1. 分布式远程服务工作流程 分布式远程服务为每个注册接口建立了两个列队。一个列队用于请求,由服务端监听,另一个列队用于应答回执和结果回复,由客户端监听。应答回执用于判定该请求是否已经被接受。如果在指定的超时时间内没有被执行工作者执行将会抛出RemoteServiceAckTimeoutException错误。 下图描述了每次发起远程过程调用请求的工作流程。 9.1.2. 发送即不管(Fire-and-Forget)模式和应答回执(Ack-Response)模式 分布式远程服务通过org.redisson.core.RemoteInvocationOptions类,为每个远程过程调用提供了一些可配置选项。这些选项可以用来指定和修改请求超时和选择跳过应答回执或结果的发送模式。例如: // 应答回执超时1秒钟,远程执行超时30秒钟 RemoteInvocationOptions options = RemoteInvocationOptions.defaults(); // 无需应答回执,远程执行超时30秒钟 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().noAck(); // 应答回执超时1秒钟,不等待执行结果 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().noResult(); // 应答回执超时1分钟,不等待执行结果 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().expectAckWithin(1, TimeUnit.MINUTES).noResult(); // 发送即不管(Fire-and-Forget)模式,无需应答回执,不等待结果 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().noAck().noResult(); RRemoteService remoteService = redisson.getRemoteService(); YourService service = remoteService.get(YourService.class, options); 9.1.3. 异步调用 远程过程调用也可以采用异步的方式执行。异步调用需要单独提交一个带有@RRemoteAsync注释(annotation)的异步接口类。异步接口方法签名必须与远程接口的方法签名相符。异步接口的返回类必须是org.redisson.api.RFuture对象或其子对象。在调用RRemoteService.get方法时将对异步接口的方法进行验证。异步接口无须包含所有的远程接口里的方法,只需要包含要求异步执行的方法即可。 // 远程接口 public interface RemoteInterface { Long someMethod1(Long param1, String param2); void someMethod2(MyObject param); MyObject someMethod3(); } // 匹配远程接口的异步接口 @RRemoteAsync(RemoteInterface.class) public interface RemoteInterfaceAsync { RFuture<Long> someMethod1(Long param1, String param2); RFuture<Void> someMethod2(MyObject param); } RRemoteService remoteService = redisson.getRemoteService(); RemoteInterfaceAsync asyncService = remoteService.get(RemoteInterfaceAsync.class); 9.1.4. 取消异步调用 通过调用Future.cancel()方法可以非常方便的取消一个异步调用。分布式远程服务允许在三个阶段中任何一个阶段取消异步调用: 远程调用请求在列队中排队阶段 远程调用请求已经被分布式远程服务接受,还未发送应答回执,执行尚未开始。 远程调用请求已经在执行阶段 想要正确的处理第三个阶段,在服务端代码里应该检查Thread.currentThread().isInterrupted()的返回状态。范例如下: // 远程接口 public interface MyRemoteInterface { Long myBusyMethod(Long param1, String param2); } // 匹配远程接口的异步接口 @RRemoteAsync(MyRemoteInterface.class) public interface MyRemoteInterfaceAsync { RFuture<Long> myBusyMethod(Long param1, String param2); } // 远程接口的实现 public class MyRemoteServiceImpl implements MyRemoteInterface { public Long myBusyMethod(Long param1, String param2) { for (long i = 0; i < Long.MAX_VALUE; i++) { iterations.incrementAndGet(); if (Thread.currentThread().isInterrupted()) { System.out.println("interrupted! " + i); return; } } } } RRemoteService remoteService = redisson.getRemoteService(); ExecutorService executor = Executors.newFixedThreadPool(5); // 注册远程服务的服务端的同时,通过单独指定的ExecutorService来配置执行线程池 MyRemoteInterface serviceImpl = new MyRemoteServiceImpl(); remoteService.register(MyRemoteInterface.class, serviceImpl, 5, executor); // 异步调用方法 MyRemoteInterfaceAsync asyncService = remoteService.get(MyRemoteInterfaceAsync.class); RFuture<Long> future = asyncService.myBusyMethod(1L, "someparam"); // 取消异步调用 future.cancel(true); 9.2. 分布式实时对象(Live Object)服务 9.2.1. 介绍 一个 分布式实时对象(Live Object) 可以被理解为一个功能强化后的Java对象。该对象不仅可以被一个JVM里的各个线程相引用,还可以被多个位于不同JVM里的线程同时引用。Wikipedia对这种特殊对象的概述是: Live distributed object (also abbreviated as live object) refers to a running instance of a distributed multi-party (or peer-to-peer) protocol, viewed from the object-oriented perspective, as an entity that has a distinct identity, may encapsulate internal state and threads of execution, and that exhibits a well-defined externally visible behavior. Redisson分布式实时对象(Redisson Live Object,简称RLO)运用即时生成的代理类(Proxy),将一个指定的普通Java类里的所有字段,以及针对这些字段的操作全部映射到一个Redis Hash的数据结构,实现这种理念。每个字段的get和set方法最终被转译为针对同一个Redis Hash的hget和hset命令,从而使所有连接到同一个Redis节点的所有可以客户端同时对一个指定的对象进行操作。众所周知,一个对象的状态是由其内部的字段所赋的值来体现的,通过将这些值保存在一个像Redis这样的远程共享的空间的过程,把这个对象强化成了一个分布式对象。这个分布式对象就叫做Redisson分布式实时对象(Redisson Live Object,简称RLO)。 通过使用RLO,运行在不同服务器里的多个程序之间,共享一个对象实例变得和在单机程序里共享一个对象实例一样了。同时还避免了针对任何一个字段操作都需要将整个对象序列化和反序列化的繁琐,进而降低了程序开发的复杂性和其数据模型的复杂性:从任何一个客户端修改一个字段的值,处在其他服务器上的客户端(几乎^)即刻便能查看到。而且实现代码与单机程序代码无异。(^连接到从节点的客户端仍然受Redis的最终一致性的特性限制) 鉴于Redis是一个单线程的程序,针对实时对象的所有的字段操作可以理解为全部是原子性操作,也就是说在读取一个字段的过程不会担心被其他线程所修改。 通过使用RLO,可以把Redis当作一个允许被多个JVM同时操作且不受GC影响的共享堆(Heap Space)。 9.2.2. 使用方法 要想获得RLO带来的所有便利,只需要为一个类添加一个@REntity注释,然后再为其中的一个字段添加一个@RId注释即可。 @REntity public class MyLiveObject { @RId private String name; //其他字段 ... ... //get和set方法 ... ... } 就这样简单两步,即可将一个普通的Java对象“升级”成了一个Redisson分布式实时对象。通过Redisson对象实例提供的RedissonLiveObjectService服务对象可以很方便的获取RLO实例: ... RLiveObjectService service = redisson.getLiveObjectService(); MyLiveObject myObject1 = new MyLiveObject(); myObject1.setName("myName"); MyLiveObject myObject1 = service.<MyLiveObject, String>persist(myObject1); //或者取得一个已经存在的RLO实例 MyLiveObject myObject1 = service.<MyLiveObject, String>get(MyLiveObject.class, "myName"); ... RLO的用法和普通Java对象的用法一样,以以下对象为例: @REntity public class MyObject { @RId private String name; private String value; public MyObject(String name) { this.name = name; } public MyObject() { } public String getName() { return name; } public String getValue() { return value; } public void setName(String name) { this.name = name; } public void setValue(String value) { this.value = value; } } 在作为普通对象操作时: //普通Java对象实例 MyObject standardObject1 = new MyObject(); standardObject1.setName("standard1"); //当然也可以使用非默认构造函数 MyObject standardObject2 = new MyObject("standard2"); 也可以作为RLO实例使用: //首先获取服务实例 RLiveObjectService service = redisson.getLiveObjectService(); //通过服务实例构造RLO实例 MyObject standardObject1 = new MyObject(); standardObject1.setName("liveObjectId"); MyObject liveObject1 = service.<MyObject, String>persist(standardObject1); //服务实例会首先通过单一参数为条件查找构造函数,如果能找到就尝试采用"liveObjectId"作为参数 //来构造实例,如果没有找到就采用默认构造函数,然后调用setName("liveObjectId")赋值,最后再 //返回对象。 在使用上,二者完全没有分别。 //为"value"字段赋值的方法也是一样: standardObject1.setValue("abc");//“abc”作为字段值,储存在JVM内存的堆里(Heap space) standardObject2.setValue("abc");//同上 liveObject1.setValue("abc"); //“abc”作为字段值,储存在Redis里,而不是在JVM内存堆里。(虽然它会在字符串池里出现,但是没有被 //对象引用,因此不会影响垃圾回收。) //提取"value"字段的值也是一样的 System.out.println(standardObject1.getValue()); //在控制台里输出"abc",这个值是从JVM的内存堆里获取出来的。 System.out.println(standardObject2.getValue());//同上 System.out.println(liveObject1.getValue()); //控制台输出内容和上面一样,但值是从Redis里获取出来的。 单从上面两段代码看,结果一模一样,但这其中还有一些细微的不同。这里将通过以下例子详细介绍: @REntity public class MyLiveObject { @RId private String name; private MyOtherObject value; public MyLiveObject(String name) { this.name = name; } public MyObject() { } public String getName() { return name; } public MyOtherObject getValue() { return value; } public void setName(String name) { this.name = name; } public void setValue(MyOtherObject value) { this.value = value; } } 和上面的例子不同的是,我们将“value”字段从一个不可变类String换成了一个可变类MyOtherObject,在一个普通的Java对象里,当你调用getValue()方法时,你得到的会是原MyOtherObject实例的一个引用。在RLO对象里,调用同样的方法,返回的将会是一个全新对象的引用。这就会产生以下的现象: //RLO对象: MyLiveObject myLiveObject = service.get(MyLiveObject.class, "1"); myLiveObject.setValue(new MyOtherObject()); System.out.println(myLiveObject.getValue() == myLiveObject.getValue()); //输出值为假(False) (除非在对象编码器里采用了对象池) //普通Java对象: MyLiveObject notLiveObject = new MyLiveObject(); notLiveObject.setValue(new MyOtherObject()); System.out.println(notLiveObject.getValue() == notLiveObject.getValue()); //输出值为真(True) 再比如: //RLO对象: MyLiveObject myLiveObject = service.get(MyLiveObject.class, "1"); MyOtherObject other = new MyOtherObject(); other.setOtherName("ABC"); myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出是ABC other.setOtherName("BCD"); System.out.println(myLiveObject.getValue().getOtherName()); //还是输出ABC myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //现在输出是BCD //普通Java对象: MyLiveObject myLiveObject = new MyLiveObject("1"); MyOtherObject other = new MyOtherObject(); other.setOtherName("ABC"); myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出是ABC other.setOtherName("BCD"); System.out.println(myLiveObject.getValue().getOtherName()); //输出已经是BCD了 myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出还是BCD 产生这个现象的原因是因为Redisson没有在JVM里保存MyOtherObject对象的状态,而是在每次调用set和get的时候,先将一个实例从Redis里序列化和反序列化出来,再赋值取值。这是和JPA里的修改脱管(detach)对象状态类似。这种现象通常情况下对不可变类来说不会有任何影响,比如说String,Double,Long等等。而在操作可变类是你反而可以利用它这种特性,正因为这个实例处于修改脱管状态,取得的实例与其本身脱离了联系,此时对脱管对象的读写操作可以理解为是处于一个具有一些ACID特性的事务状态。正确利用这样的特性将会获益匪浅。当然如果你仍然希望RLO的用法与普通Java对象完全一致,只需将MyOtherObject也转换成一个RLO对象即可。 //RLO套嵌RLO的情形 MyLiveObject myLiveObject = service.get(MyLiveObject.class, "1"); MyOtherObject other = service.get(MyOtherObject.class, "2"); other.setOtherName("ABC"); myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出ABC other.setOtherName("BCD"); System.out.println(myLiveObject.getValue().getOtherName()); //现在输出已经是BCD了,和普通Java对象一样 myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //还是输出BCD RLO的字段类型基本上无限制,可以是任何类型。比如Java util包里的集合类,Map类等,也可以是自定义的对象。只要指定的编码解码器能够对其进行编码和解码操作便可。关于编码解码器的详细信息请查阅高级使用方法章节。 尽管RLO的字段类型基本上无限制,个别类型还是受限。注释了RId的字段类型不能是数组类(Array),比如int[],long[],double[],byte[]等等。更多关于限制有关的介绍和原理解释请查阅使用限制 章节。 为了保证RLO的用法和普通Java对象的用法尽可能一直,Redisson分布式实时对象服务自动将以下普通Java对象转换成与之匹配的Redisson分布式对象RObject。 普通Java类 转换后的Redisson类 SortedSet.class RedissonSortedSet.class Set.class RedissonSet.class ConcurrentMap.class RedissonMap.class Map.class RedissonMap.class BlockingDeque.class RedissonBlockingDeque.class Deque.class RedissonDeque.class BlockingQueue.class RedissonBlockingQueue.class Queue.class RedissonQueue.class List.class RedissonList.class 类型转换将按照从上至下的顺序匹配类型,例如LinkedList类同时实现了Deque,List和Queue,由于Deque排在靠上的位置,因此它将会被转换成一个RedissonDeque类型。 Redisson的分布式对象也采用类似的方式,将自身的状态储存于Redis当中,(几乎^)所有的状态改变都直接映射到Redis里,不在本地JVM中保留任何赋值。(^本地缓存对象除外,比如RLocalCachedMap) 9.2.3. 高级使用方法 正如上述介绍,RLO类其实都是按需实时生成的代理(Proxy)类。生成的代理类和原类都一同缓存Redisson实例里。这个过程会消耗一些时间,在对耗时比较敏感的情况下,建议通过RedissonLiveObjectService提前注册所有的RLO类。这个服务也可以用来注销不再需要的RLO类,也可以用来查询一个类是否已经注册了。 RLiveObjectService service = redisson.getLiveObjectService(); service.registerClass(MyClass.class); service.unregisterClass(MyClass.class); Boolean registered = service.isClassRegistered(MyClass.class); 9.2.4. 注解(Annotation)使用方法 @REntity 通过指定@REntity的各个参数,可以详细的对每个RLO类实现特殊定制,以达到改变RLO对象的行为。 namingScheme - 命名方案。命名方案规定了每个实例在Redis中对应key的名称。它不仅被用来与已存在的RLO建立关联,还被用来储存新建的RLO实例。默认采用Redisson自带的DefaultNamingScheme对象。 codec - 编码解码器。在运行当中,Redisson用编码解码器来对RLO中的每个字段进行编码解码。Redisson内部采用了实例池管理不同类型的编码解码器实例。Redisson提供了多种不同的编码解码器,默认使用JsonJacksonCodec。 fieldTransformation - 字段转换模式。如上所述,为了尽可能的保证RLO的用法和普通Java对象一致,Redisson会自动将常用的普通Java对象转换成与其匹配的Redisson分布式对象。这是由于字段转换模式的默认值是ANNOTATION_BASED,修改为IMPLEMENTATION_BASED就可以不转换。 @RId @RId注释只能用在具备区分实例的字段上,这类字段可以理解为一个类的id字段或主键字段。这个字段的值将被命名方案namingScheme用来与事先存在的RLO建立引用。加了该注释的字段是唯一在本地JVM里同时保存赋值的字段。一个类只能有一个字段包含@RId注释。 可以通过指定一个生成器generator策略来实现自动生成这个字段的值。默认不提供生成器。 @RObjectField 当@REntity注释里字段转换模式transformationMode是默认值ANNOTATION_BASED时,可以为一个未包含@RId注释的字段添加该注释。这个注释可以用来特别指定该字段的命名方案namingScheme和编码解码器codec。二者可以与@REntity注释里的值不同。 您可能已经看出来了,命名方案namingScheme和编码解码器codec在Redisson分布式实时对象服务里的使用频率是很高的。为了避免重复构造冗余的实例,Redisson在默认情况下通过内置实例池管理重复使用这些实例。有需要可以在构造Redisson实例的同时,通过Config来指定您自己定制的提供者(Provider)对象。 9.2.5. 使用限制 如上所述,带有RId注释字段的类型不能使数组类,这是因为目前默认的命名方案类DefaultNamingScheme还不能正确地将数组类序列化和反序列化。在改善了DefaultNamingScheme类的不足以后会考虑取消这个限制。另外由于带有RId注释的字段是用来指定Redis中映射的key的名称,因此组建一个只含有唯一一个字段的RLO类是毫无意义的。选用RBucket会更适合这样的场景。 9.3. 分布式执行服务(Executor Service) 9.3.1. 分布式执行服务概述 Redisson的分布式执行服务实现了java.util.concurrent.ExecutorService接口,支持在不同的独立节点里执行基于java.util.concurrent.Callable接口或java.lang.Runnable接口的任务。这样的任务也可以通过使用Redisson实例,实现对储存在Redis里的数据进行操作。Redisson分布式执行服务是最快速和有效执行分布式运算的方法。 9.3.2. 任务 Redisson独立节点不要求任务的类在类路径里。他们会自动被Redisson独立节点的ClassLoader加载。因此每次执行一个新任务时,不需要重启Redisson独立节点。 采用Callable任务的范例: public class CallableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; for (Integer value : map.values()) { result += value; } return result; } } RExecutorService executorService = redisson.getExecutorService("myExecutor"); Future<Long> future = executorService.submit(new CallableTask()); Long result = future.get(); 采用Runnable任务的范例: public class RunnableTask implements Runnable { @RInject private RedissonClient redissonClient; private long param; public RunnableTask() { } public RunnableTask(long param) { this.param = param; } @Override public void run() { RAtomicLong atomic = redissonClient.getAtomicLong("myAtomic"); atomic.addAndGet(param); } } RExecutorService executorService = redisson.getExecutorService("myExecutor"); executorService.submit(new RunnableTask(123)); 可以通过@RInject注释来为任务实时注入Redisson实例依赖。 9.3.3. 取消任务 通过Future.cancel()方法可以很方便的取消所有已提交的任务。通过对Thread.currentThread().isInterrupted()方法的调用可以在已经处于运行状态的任务里实现任务中断: public class CallableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; // map里包含了许多的元素 for (Integer value : map.values()) { if (Thread.currentThread().isInterrupted()) { // 任务被取消了 return null; } result += value; } return result; } } RExecutorService executorService = redisson.getExecutorService("myExecutor"); Future<Long> future = executorService.submit(new CallableTask()); // 或 RFuture<Long> future = executorService.submitAsync(new CallableTask()); // ... future.cancel(true); 9.4. 分布式调度任务服务(Scheduler Service) 9.4.1. 分布式调度任务服务概述 Redisson的分布式调度任务服务实现了java.util.concurrent.ScheduledExecutorService接口,支持在不同的独立节点里执行基于java.util.concurrent.Callable接口或java.lang.Runnable接口的任务。Redisson独立节点按顺序运行Redis列队里的任务。调度任务是一种需要在未来某个指定时间运行一次或多次的特殊任务。 9.4.2. 设定任务计划 Redisson独立节点不要求任务的类在类路径里。他们会自动被Redisson独立节点的ClassLoader加载。因此每次执行一个新任务时,不需要重启Redisson独立节点。 采用Callable任务的范例: public class CallableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; for (Integer value : map.values()) { result += value; } return result; } } RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); ScheduledFuture<Long> future = executorService.schedule(new CallableTask(), 10, TimeUnit.MINUTES); Long result = future.get(); 采用Runnable任务的范例: public class RunnableTask implements Runnable { @RInject private RedissonClient redissonClient; private long param; public RunnableTask() { } public RunnableTask(long param) { this.param= param; } @Override public void run() { RAtomicLong atomic = redissonClient.getAtomicLong("myAtomic"); atomic.addAndGet(param); } } RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); ScheduledFuture<?> future1 = executorService.schedule(new RunnableTask(123), 10, TimeUnit.HOURS); // ... ScheduledFuture<?> future2 = executorService.scheduleAtFixedRate(new RunnableTask(123), 10, 25, TimeUnit.HOURS); // ... ScheduledFuture<?> future3 = executorService.scheduleWithFixedDelay(new RunnableTask(123), 5, 10, TimeUnit.HOURS); 9.4.3. 通过CRON表达式设定任务计划 在分布式调度任务中,可以通过CRON表达式来为任务设定一个更复杂的计划。表达式与Quartz的CRON格式完全兼容。 例如: RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); executorService.schedule(new RunnableTask(), CronSchedule.of("10 0/5 * * * ?")); // ... executorService.schedule(new RunnableTask(), CronSchedule.dailyAtHourAndMinute(10, 5)); // ... executorService.schedule(new RunnableTask(), CronSchedule.weeklyOnDayAndHourAndMinute(12, 4, Calendar.MONDAY, Calendar.FRIDAY)); 9.4.4. 取消计划任务 分布式调度任务服务提供了两张取消任务的方式:通过调用ScheduledFuture.cancel()方法或调用RScheduledExecutorService.cancelScheduledTask方法。通过对Thread.currentThread().isInterrupted()方法的调用可以在已经处于运行状态的任务里实现任务中断: public class RunnableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; // map里包含了许多的元素 for (Integer value : map.values()) { if (Thread.currentThread().isInterrupted()) { // 任务被取消了 return null; } result += value; } return result; } } RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); RScheduledFuture<Long> future = executorService.scheduleAsync(new RunnableTask(), CronSchedule.dailyAtHourAndMinute(10, 5)); // ... future.cancel(true); // 或 String taskId = future.getTaskId(); // ... executorService.cancelScheduledTask(taskId); 9.5. 分布式映射归纳服务(MapReduce) 9.5.1 介绍 Redisson提供了通过映射归纳(MapReduce)编程模式来处理储存在Redis环境里的大量数据的服务。这个想法来至于其他的类似实现方式和谷歌发表的研究。所有 映射(Map) 和 归纳(Reduce) 阶段中的任务都是被分配到各个独立节点(Redisson Node)里并行执行的。以下所有接口均支持映射归纳(MapReduce)功能: RMap、 RMapCache、 RLocalCachedMap、 RSet、 RSetCache、 RList、 RSortedSet、 RScoredSortedSet、 RQueue、 RBlockingQueue、 RDeque、 RBlockingDeque、 RPriorityQueue 和 RPriorityDeque 映射归纳(MapReduce)的功能是通过RMapper、 RCollectionMapper、 RReducer 和 RCollator 这几个接口实现的。 1. RMapper 映射器接口适用于映射(Map)类,它用来把映射(Map)中的每个元素转换为另一个作为归纳(Reduce)处理用的键值对。 public interface RMapper<KIn, VIn, KOut, VOut> extends Serializable { void map(KIn key, VIn value, RCollector<KOut, VOut> collector); } 2. RCollectionMapper 映射器接口仅适用于集合(Collection)类型的对象,它用来把集合(Collection)中的元素转换成一组作为归纳(Reduce)处理用的键值对。 public interface RCollectionMapper<VIn, KOut, VOut> extends Serializable { void map(VIn value, RCollector<KOut, VOut> collector); } 3. RReducer 归纳器接口用来将上面这些,由映射器生成的键值对列表进行归纳整理。 public interface RReducer<K, V> extends Serializable { V reduce(K reducedKey, Iterator<V> values); } 4. RCollator 收集器接口用来把归纳整理以后的结果化简为单一一个对象。 public interface RCollator<K, V, R> extends Serializable { R collate(Map<K, V> resultMap); } 以上每个阶段的任务都可以用@RInject注解的方式来获取RedissonClient实例: public class WordMapper implements RMapper<String, String, String, Integer> { @RInject private RedissonClient redissonClient; @Override public void map(String key, String value, RCollector<String, Integer> collector) { // ... redissonClient.getAtomicLong("mapInvocations").incrementAndGet(); } } 9.5.2 映射(Map)类型的使用范例 Redisson提供的RMap、 RMapCache和RLocalCachedMap这三种映射(Map)类型的对象均可以使用这种分布式映射归纳(MapReduce)服务。 以下是在映射(Map)类型的基础上采用映射归纳(MapReduce)来实现字数统计的范例: public class WordMapper implements RMapper<String, String, String, Integer> { @Override public void map(String key, String value, RCollector<String, Integer> collector) { String[] words = value.split("[^a-zA-Z]"); for (String word : words) { collector.emit(word, 1); } } } public class WordReducer implements RReducer<String, Integer> { @Override public Integer reduce(String reducedKey, Iterator<Integer> iter) { int sum = 0; while (iter.hasNext()) { Integer i = (Integer) iter.next(); sum += i; } return sum; } } public class WordCollator implements RCollator<String, Integer, Integer> { @Override public Integer collate(Map<String, Integer> resultMap) { int result = 0; for (Integer count : resultMap.values()) { result += count; } return result; } } RMap<String, String> map = redisson.getMap("wordsMap"); map.put("line1", "Alice was beginning to get very tired"); map.put("line2", "of sitting by her sister on the bank and"); map.put("line3", "of having nothing to do once or twice she"); map.put("line4", "had peeped into the book her sister was reading"); map.put("line5", "but it had no pictures or conversations in it"); map.put("line6", "and what is the use of a book"); map.put("line7", "thought Alice without pictures or conversation"); RMapReduce<String, String, String, Integer> mapReduce = map.<String, Integer>mapReduce() .mapper(new WordMapper()) .reducer(new WordReducer()); // 统计词频 Map<String, Integer> mapToNumber = mapReduce.execute(); // 统计字数 Integer totalWordsAmount = mapReduce.execute(new WordCollator()); 9.5.3 集合(Collection)类型的使用范例 Redisson提供的RSet、 RSetCache、 RList、 RSortedSet、 RScoredSortedSet、 RQueue、 RBlockingQueue、 RDeque、 RBlockingDeque、 RPriorityQueue和RPriorityDeque这几种集合(Collection)类型的对象均可以使用这种分布式映射归纳(MapReduce)服务。 以下是在集合(Collection)类型的基础上采用映射归纳(MapReduce)来实现字数统计的范例: public class WordMapper implements RCollectionMapper<String, String, Integer> { @Override public void map(String value, RCollector<String, Integer> collector) { String[] words = value.split("[^a-zA-Z]"); for (String word : words) { collector.emit(word, 1); } } } public class WordReducer implements RReducer<String, Integer> { @Override public Integer reduce(String reducedKey, Iterator<Integer> iter) { int sum = 0; while (iter.hasNext()) { Integer i = (Integer) iter.next(); sum += i; } return sum; } } public class WordCollator implements RCollator<String, Integer, Integer> { @Override public Integer collate(Map<String, Integer> resultMap) { int result = 0; for (Integer count : resultMap.values()) { result += count; } return result; } } RList<String> list = redisson.getList("myList"); list.add("Alice was beginning to get very tired"); list.add("of sitting by her sister on the bank and"); list.add("of having nothing to do once or twice she"); list.add("had peeped into the book her sister was reading"); list.add("but it had no pictures or conversations in it"); list.add("and what is the use of a book"); list.add("thought Alice without pictures or conversation"); RCollectionMapReduce<String, String, Integer> mapReduce = list.<String, Integer>mapReduce() .mapper(new WordMapper()) .reducer(new WordReducer()); // 统计词频 Map<String, Integer> mapToNumber = mapReduce.execute(); // 统计字数 Integer totalWordsAmount = mapReduce.execute(new WordCollator());