首页 文章 精选 留言 我的

精选列表

搜索[单体架构],共10000篇文章
优秀的个人博客,低调大师

Scala微服务架构 二

三. Scala的Macro(宏) Scala Macros对scala函数库编程人员来说是一项不可或缺的编程工具,可以通过它来解决一些用普通编程或者类层次编程(type level programming)都无法解决的问题,这是因为Scala Macros可以直接对程序进行修改。 说到对程序进行修改,几个概念一定要先理解,"编译期"和"运行期",Java也有一个可以修改程序的功能,大家一定用过,就是反射.不是在运行期,编译器也不知道接下来会发生什么,会执行哪些代码(这就是==动态性==). 而scala是java的衍生语言,自然也有反射,而且它还有一种更高级的反射,就是编译时反射,它就是宏. 3.1 什么是宏? 一般说来,宏是一种规则或模式,或称语法替换 ,用于说明某一特定输入(通常是字符串)如何根据预定义的规则转换成对应的输出(通常是字符串,或者是类,方法等)。这种替换在预编译时进行,称作宏展开。 通过上面的定义,感觉和C的宏概念差不多.但C的宏只不过是一段语法的替换,然而Scala的宏却可以通过表达式树控制一节代码(类,或者方法)的生成。获得了控制代码的执行顺序(见惰性计算和非限制函数)的能力,使得新创建的语法结构与语言内建的语法结构不可区分。 宏,从程序抽象的角度来看,可能不太容易调试和维护,但是能够很强大的固定我们的设计. 同时使用宏能够==大量==的减少样板代码.比如Scala的assert和require就是使用宏实现的. 3.2 宏出现的意义? 编译期元编程 更完善的错误检查 3.2.1 编译期元编程 什么是元编程? 百度词条的一句话: 元编程(Metaprogramming)是指某类计算机程序的编写,这类计算机程序编写或者操纵其他程序(或者自身)作为它们的数据,==或者在运行时完成部分本应在编译时完成的工作==。很多情况下与手工编写全部代码相比工作效率更高。编写元程序的语言称之为元语言,被操作的语言称之为目标语言。==一门语言同时也是自身的元语言的能力称之为反射==。 元编程是用来产生代码的程序,操纵代码的程序,在运行时创建和修改代码而非编程时,这种程序叫做元程序。而编写这种程序就叫做元编程。 所以,元编程技术在多种编程语言中都可以使用,但更多的还是被应用于动态语言中,因为动态语言提供了更多的在运行时将代码视为数据进行操纵的能力。 虽然静态语言也支持元编程(反射机制),但是仍然没有诸如Ruby这样的更趋动态性的语言那么透明,这是因为静态语言在运行时其代码和数据是分布在两个层次上的。 最后可以理解为,元编程就是程序可以操作更小的粒度和动作. 3.2.2 更完善的错误检查 引自知乎https://www.zhihu.com/question/27685977/answer/38014170 首先思考一个问题:如果你的应用程序有bug,那么你希望在什么情况下发现呢? 编译时:这是最理想的状态,如果一个bug可以通过编译器检查出来,那么程序员可以在第一时间发现问题,基本上就是一边写一边fix。这也正是静态编译型语言的强大优势。 单元测试:没有那么理想但是也不差。每写完一段code跑一下测试,看看有没有新的bug出来。对于scala来说,现在的工具链已经不错了,左屏sbt > ~test,右屏写代码惬意得很。 运行时:这个就比较糟糕了。运行时才报错意味着你得首先打包部署,这个时间开销通常就比较大,而且在许多公司,你还要时不时的解决环境问题,很是让人抓狂。 而Scala的宏,就是可以将一些运行期才会出现的错误,在编译器暴露出来. 3.3 宏的编译过程? Scala是如何编译宏的呢? 引用自https://www.cnblogs.com/tiger-xc/p/6112143.html 明白了上面的流程之后,我们出个栗子: object modules { greeting("john") } object mmacros { def greeting(person: String): Unit = macro greetingMacro def greetingMacro(c: Context)(person: c.Expr[String]): c.Expr[Unit] = { import c.universe._ println("compiling greeting ...") val now = reify {new Date().toString} reify { println("Hello " + person.splice + ", the time is: " + new Date().toString) } } } 以上代码的执行逻辑如下: 注意编译器在运算greetingMacro时会以AST方式将参数person传入。由于在编译modules对象时需要运算greetingMacro函数,所以greetingMacro函数乃至整个mmacros对象必须是已编译状态,这就意味着modules和mmacros必须分别在不同的源代码文件里,而且还要确保在编译modules前先完成对mmacros的编译. 3.4 编写宏实现 其实宏的使编写并不难,api已经帮我们做好了一切,我们只要关注如何使用获取宏参数和宏的返回值即可. 上面栗子中的代码,greetingMacro方法就是一个最简单的宏实现,代码如下: def greetingMacro(c: Context)(person: c.Expr[String]): c.Expr[Unit] = { import c.universe._ println("compiling greeting ...") val now = reify {new Date().toString} reify { println("Hello " + person.splice + ", the time is: " + new Date().toString) } } 但是想要实现更多的功能,还需要更加深入的学习Scala的宏和表达式树. ※. 本期语法糖 ※.1 implicit macor (隐式宏) 官方文档 开局出个栗子 trait Showable[T] { def show(x: T): String } def show[T](x: T)(implicit s: Showable[T]) = s.show(x) implicit object IntShowable extends Showable[Int] { def show(x: Int) = x.toString } show(42) // return "42" show("42") // compilation error 可以调用成功show(),主要因为名称空间存在Showable的子类IntShowable,并且是implicit object,这个implicit object的作用上一篇已经讲过了,就不说了. 上面代码,乍一看还可以,但是如果扩展起来就不是很舒服了,如果要让show("42")也可用,我们就需要添加如下代码: implicit object StringShowable extends Showable[String] { def show(x: String) = x } ※.2 宏注解 Macro Annotations ==> @compileTimeOnly("") 官方文档 开局处个栗子,可以自动为case class或class在编译时生成一个名为TempLog的方法. import scala.reflect.macros.Context import scala.language.experimental.macros import scala.annotation.StaticAnnotation import scala.annotation.compileTimeOnly @compileTimeOnly("temp log print") class AnPrint(msg: Any*) extends StaticAnnotation { def macroTransform(annottees : Any*) : Any = macro AnPrintMacroImpl.impl } 官网栗子,我们的代码也比较常见,继承了StaticAnnotation,表示这是一个注解类,有兴趣的朋友可以看看上一期文章. 主要说的是上面 @compileTimeOnly("temp log print") 官网解释 First of all, note the @compileTimeOnly annotation. It is not mandatory, but is recommended to avoid confusion 首先,这不是强制性的,即便不写,也会被编译器自动扩展上.但还是建议加上避免混乱. 然后是宏的具体实现,如下: object AnPrintMacroImpl { def impl(c : whitebox.Context)(annottees: c.Expr[Any]*): c.Expr[Any] = { import c.universe._ val tree = annottees.map(_.tree).toList.head val (className, fields, parents, body) = tree match{ case q"case class $className(..$fields) extends ..$parents { ..$body }" => (className, fields, parents, body) case q"class $className(..$fields) extends ..$parents { ..$body }" => (className, fields, parents, body) } //TempLog val LogDefName = TermName("TempLog") val LogDefImpl = q"""def $LogDefName(sss: Any):Unit=println(" ===> " + sss)""" val out = q""" case class $className(..$fields) extends ..$parents { ..$LogDefImpl ..$body } """ println(showRaw(tree)) c.Expr(out) } } 里面的具体细节,主要是宏将类变成AST,然后利用模式匹配,来解析类信息,之后可以加入自己定义的任何操作,最后用Block封装起来,这样子,一个简单的宏就实现了. 我们测试一下: package myTest @AnPrint("clock") class ccc(val a: String = "aaa", val b: String = "bbb"){ TempLog("init b") } object annotationPrintTest extends App { println("start") val a = new b("aiyou", "wolegequ") a.TempLog("打印我了") println("end") } 注意,这里需要先编译AnPrintMacroImpl和AnPrint文件,才可以测试通过 打印结果如下: start ===> init b ===> 打印我了 end

优秀的个人博客,低调大师

mongodb分片扩展架构

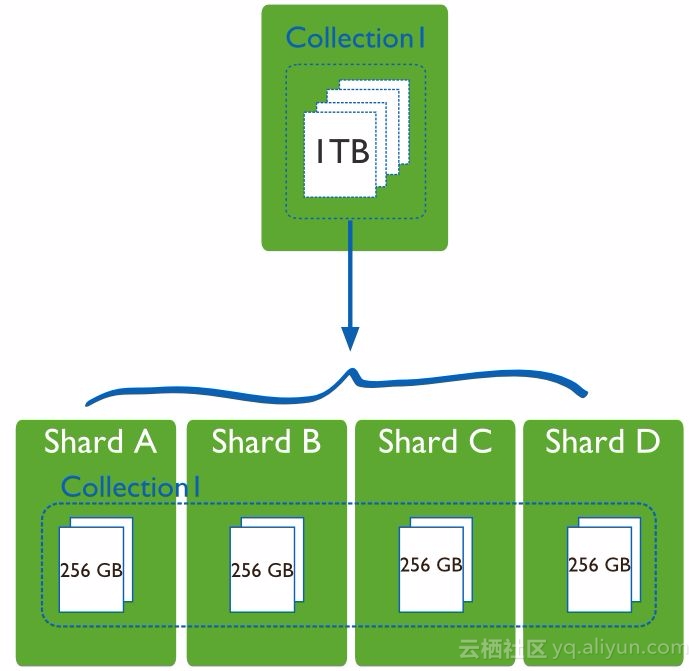
[TOC] 一、简介 MongoDB目前3大核心优势:『灵活模式』+ 『高可用性』 + 『可扩展性』,通过json文档来实现灵活模式,通过复制集来保证高可用,通过Sharded cluster来保证可扩展性。 MongoDB 分片集群Sharded Cluster通过将数据分散存储到多个分片(Shard)上来实现高可扩展性。 当MongoDB复制集遇到下面的业务场景时,你就需要考虑使用Sharded cluster 存储容量需求超出单机磁盘容量 活跃的数据集超出单机内存容量,导致很多请求都要从磁盘读取数据,影响性能 写IOPS超出单个MongoDB节点的写服务能力 如上图所示,Sharding Cluster使得集合的数据可以分散到多个Shard(复制集或者单个Mongod节点)存储,使得MongoDB具备了横向扩展(Scale out)的能力,丰富了MongoDB的应用场景。 二、分片集群 实现分片集群时,MongoDB 引入 Config Server 来存储集群的元数据,引入 mongos 作为应用访问的入口,mongos 从 Config Server 读取路由信息,并将请求路由到后端对应的 Shard 上。 Diagram of a sample sharded cluster for production purposes. Contains exactly 3 config servers, 2 or more mongos query routers, and at least 2 shards. The shards are replica sets. 角色说明 A.数据分片(Shards) 用来保存数据,保证数据的高可用性和一致性。可以是一个单独的mongod实例,也可以是一个副本集。 在生产环境下Shard一般是一个Replica Set,以防止该数据片的单点故障。所有Shard中有一个PrimaryShard,里面包含未进行划分的数据集合: B.配置服务器(Config servers) 保存集群的元数据(metadata),包含各个Shard的路由规则。 C.查询路由(Query Routers) Mongos是Sharded cluster的访问入口,其本身并不持久化数据(Sharded cluster所有的元数据都会存储到Config Server,而用户的数据则会分散存储到各个shard) Mongos启动后,会从config server加载元数据,开始提供服务,将用户的请求正确路由到对应的Shard Sharding集群可以有一个mongos,也可以有多mongos以减轻客户端请求的压力。 三、数据分布策略 Sharded cluster支持将单个集合的数据分散存储在多个shard上,用户可以指定根据集合内文档的某个字段即shard key来分布数据, 目前主要支持2种数据分布的策略,范围分片(Range based sharding)或hash分片(Hash based sharding)。 范围分片 Diagram of the shard key value space segmented into smaller ranges or chunks. 如上图所示,集合根据x字段来分片,x的取值范围为[minKey, maxKey](x为整型,这里的minKey、maxKey为整型的最小值和最大值),将整个取值范围划分为多个chunk,每个chunk(通常配置为64MB)包含其中一小段的数据。 Chunk1包含x的取值在[minKey, -75)的所有文档,而Chunk2包含x取值在[-75, 25)之间的所有文档... 每个chunk的数据都存储在同一个Shard上,每个Shard可以存储很多个chunk,chunk存储在哪个shard的信息会存储在Config server种,mongos也会根据各个shard上的chunk的数量来自动做负载均衡。 范围分片能很好的满足『范围查询』的需求,比如想查询x的值在[-30, 10]之间的所有文档,这时mongos直接能将请求路由到Chunk2,就能查询出所有符合条件的文档。 范围分片的缺点在于,如果shardkey有明显递增(或者递减)趋势,则新插入的文档多会分布到同一个chunk,无法扩展写的能力,比如使用_id作为shard key,而MongoDB自动生成的id高位是时间戳,是持续递增的。 HASH分片 Hash分片是根据用户的shard key计算hash值(64bit整型),根据hash值按照『范围分片』的策略将文档分布到不同的chunk。 Diagram of the hashed based segmentation. Hash分片与范围分片互补,能将文档随机的分散到各个chunk,充分的扩展写能力,弥补了范围分片的不足,但不能高效的服务范围查询,所有的范围查询要分发到后端所有的Shard才能找出满足条件的文档。 合理的选择shard key 选择shard key时,要根据业务的需求及『范围分片』和『Hash分片』2种方式的优缺点合理选择,同时还要注意shard key的取值一定要足够多,否则会出现单个jumbo chunk,即单个chunk非常大并且无法分裂(split);比如某集合存储用户的信息,按照age字段分片,而age的取值非常有限,必定会导致单个chunk非常大。 四、Mongos访问模式 所有的请求都由mongos来路由、分发、合并,这些动作对客户端driver透明,用户连接mongos就像连接mongod一样使用。 Mongos会根据请求类型及shard key将请求路由到对应的Shard,因此不同的操作请求存在不同限制。 查询请求 查询请求不包含shard key,则必须将查询分发到所有的shard,然后合并查询结果返回给客户端 查询请求包含shard key,则直接根据shard key计算出需要查询的chunk,向对应的shard发送查询请求 插入请求 写操作必须包含shard key,mongos根据shard key算出文档应该存储到哪个chunk,然后将写请求发送到chunk所在的shard。 更新/删除请求 更新、删除请求的查询条件必须包含shard key或者_id,如果是包含shard key,则直接路由到指定的chunk,如果只包含_id,则需将请求发送至所有的shard。 其他命令请求 除增删改查外的其他命令请求处理方式都不尽相同,有各自的处理逻辑,比如listDatabases命令,会向每个Shard及Config Server转发listDatabases请求,然后将结果进行合并。 如何连接 一个典型的ConnectURI 结构如下: mongodb://[username:password@]host1[:port1][,host2[:port2],...[,hostN[:portN]]][/[database][?options]] //说明 - mongodb:// 前缀,代表这是一个Connection String; - username:password@ 如果启用了鉴权,需要指定用户密码; - hostX:portX多个 mongos 的地址列表; - /database鉴权时,用户帐号所属的数据库; - ?options 指定额外的连接选项,比如指定readPreference=secondaryPreferred实现读写分离 分片集群可以提供多个 mongos 实现现负载均衡;而当某个 mongos 故障时,客户端也能自动进行 failover,将请求都分散到状态正常的 mongos 上。 当 mongos 数量很多时,还可以按应用来将 mongos 进行分组,比如有2个应用 A、B、有4个 mongos,可以让应用 A 访问 mongos 1-2(URI 里只指定 mongos 1-2 的地址), 应用 B 来访问 mongos 3-4(URI 里只指定 mongos 3-4 的地址),根据这种方法来实现应用间的访问隔离(应用访问的 mongos 彼此隔离,但后端 Shard 仍然是共享的),如下图 五、Config元数据 Config server存储Sharded cluster的所有元数据,所有的元数据都存储在config数据库, 3.2版本后,Config Server可部署为一个独立的复制集,极大的方便了Sharded cluster的运维管理。 config数据集合如下表所示: 集合名称 说明 config.shards 存储各个Shard的信息,可通过addShard、removeShard命令来动态的从Sharded cluster里增加或移除shard config.databases 存储所有数据库的信息,包括DB是否开启分片,primary shard信息,对于数据库内没有开启分片的集合,所有的数据都会存储在数据库的primary shard上 config.colletions 数据分片是针对集合维度的,某个数据库开启分片功能后,如果需要让其中的集合分片存储,则需调用shardCollection命令来针对集合开启分片。 config.chunks 集合分片开启后,默认会创建一个新的chunk,shard key取值[minKey, maxKey]内的文档(即所有的文档)都会存储到这个chunk。当使用Hash分片策略时,可以预先创建多个chunk,以减少chunk的迁移 config.settings 存储sharded cluster的配置信息,比如chunk size,是否开启balancer等 config.tags 主要存储sharding cluster标签(tag)相关的你洗,以实现根据tag来分布chunk的功能 config.changelog 主要存储sharding cluster里的所有变更操作,比如balancer迁移chunk的动作就会记录到changelog里。 config.mongos 存储当前集群所有mongos的信息 config.locks 存储锁相关的信息,对某个集合进行操作时,比如moveChunk,需要先获取锁,避免多个mongos同时迁移同一个集合的chunk。 六、分片均衡 Mongodb 实现了自动分片均衡,均衡器是一个在后台对分片chunk进行监控的进程,当某个shard的chunks差异数量到达阈值时,将自动开始在shard中间迁移chunk数据库以达到均衡目的。整个迁移过程对应用层是透明的,从3.4版本开始,均衡器不再由Mongos执行,而是由Config副本集的主节点来处理。 迁移过程中对集群性能存在一定影响,因此一般可以通过设置均衡窗口对齐到业务闲时段。 阈值参考表 |Number of Chunks| Migration Threshold| |-|-| |Fewer than 20| 2|| |20-79| 4| |80 and greater| 8| 迁移过程 均衡器向源shard发送moveChunk命令; 源shard执行内部的moveChunk流程,过程中数据操作仍然指向当前shard 目标shard构建缺失的索引; 目标shard请求并接收chunk副本数据; 在chunk接收到后,目标shard向源shard确认是否存在增量更新数据,若存在则继续同步; 完全同步后,源shard通知config副本集更新元数据库,将chunk的位置更新为目标shard 在更新完元数据库后并确保没有关联cursor的情况下,源shard删除被迁移的chunk副本。 参考文档 mongodb shard cluster原理http://www.mongoing.com/archives/2782 mongo中文社区-高可用mongodb集群https://yq.aliyun.com/articles/61516 官网-mongodb分片集群https://docs.mongodb.com/manual/core/sharding-balancer-administration/ 作者: zale 出处: http://www.cnblogs.com/littleatp/, 如果喜欢我的文章,请关注我的公众号 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出 原文链接 如有问题, 可留言咨询.

优秀的个人博客,低调大师

YARN HA架构部署测试

ResourceManager(RM)负责跟踪集群中的资源,并调度应用程序(例如MapReduce作业)。 在Hadoop 2.4之前,ResourceManager是纱线集群中的单一故障点。 高可用性特性以活动/备用资源管理器对的形式添加冗余,以删除此故障点。 原理图 配置过程 管理命令 ResourceManger Restart NodeManagers和客户端在RM关闭期间将保持对RM的轮询,直到RM启 动。当启动后,RM将通过心跳机制向正在与其会话的NodeManager和 ApplicationMasters发送同步指令。目前NodeManager和ApplicationMaster 处理该指令的方式为:NodeManager将杀死它管理的所有容器然后向RM 重新注册,对于RM来说,这些重新注册的NodeManager与新加入的 NodeManager相似。ApplicationMasters在接收到RM的同步指令后,将会 关闭。在RM重启后,从状态存储中加载应用元数据和认证信息并放入 内存后,RM将为每个还未完成的应用创建新的尝试。正如之前描述的 ,此种方式下之前正在运行的应用程序的工作将会丢失,因为它们已经 被RM在重启后使用同步指令杀死了 ResourceManager重启可以划分为两个阶段。 第一阶段, 增强的ResourceManager(RM)将应用程序的状态和其它认证信息保存到一个插入式的状态存储中。 RM重启时将从状态存储中重新加载这些信息,然后重新开始之前正在运行的应 用程序,用户不需要重新提交应用程序。 第二阶段, 重启时通过从NodeManagers读取容器的状态和从ApplicationMasters读取容器的请求,集中重构RM的运行状态。与第一阶段不同的是,在第二阶段中,之前正在运行的应用 程序将不会在RM重启后被杀死,所以应用程序不会因为RM中断而丢失工作。

优秀的个人博客,低调大师

以太坊架构简析

HTTPClient:支持HTTP协议、实现get、post等HTTP方法。 Whisper协议:DApp间通信的协议,提供低层次API HTTP/JSON RPC/IPC [1]:实现程序/进程间的通信。外部程序可以通过JSON RPC调用API。 Swarm:一个web应用开发框架,其允许程序分布在多台计算机上,并能够动态分配运算以提升运算效率。 容器:包含程序和程序运行所需的完整环境,相当于轻量虚拟机。可以无视环境难题,被快速部署 P2P网络:对等节点组成的网络,每个节点都同时起到客户端和服务端的作用。 挖矿:节点争夺记账权,并在记账成功后获取代币奖励。 LevelDB:高效的kv(key-value)数据库[2]。 Crypto:加密。以太坊使用SHA3、secp256k1加密算法。 rlp:recursive length prefix,即递归长度前缀。在以太坊中对对象进行序列化[3]和反序列化编码。 校验:包含区块、交易合法性校验,Merkle Patricia Tree校验,交易池校验。 区块链管理:涉及区块的下载、连接、断开、校验、保存 交易池管理:节点将通过验证的交易存在交易池中,准备放在一个挖到的区块里。 EVM:Ethereum Virtual Machine,即以太坊虚拟机。智能合约在EVM之上运行。 智能合约:可以理解为:包含价值且只有在满足一定条件时才会打开的加密箱子。其具有图灵完备性。 web3.js:封装了以太坊JSON RPC API的js库,包含与区块链交互的js对象和函数。有查看网络状态、查询本地账户、查询交易和区块、发送交易、编译/部署合约等的API 交易:一个账户向另一个账户发送被签名的数据包的过程 [1] ipc:inter-progress communication,即进程间通信。Ipc包含lpc(local progress call)和rpc(remote procedure call)。可以认为rpc是:把分割的程序通过网络重组。通过网络,像操作本机代码一样调用远程机器上的代码。JSON RPC是以JSON为协议的RPC,传输的内容是JSON本体。 [2] kv数据库中的数据按照kv对进行组织、索引、存储。kv数据库没有固定的数据结构,而SQL数据库的数据一般都具有固定的数据结构。这里的key一般与hash相关,value一般存储rlp编码。 [3] 序列化:把对象转化为字节序列的过程。反序列化是它的逆过程。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册