首页 文章 精选 留言 我的

精选列表

搜索[单体架构],共10000篇文章
优秀的个人博客,低调大师

用户管理架构设计

今天给大家分享的是:用户管理模块 或者说用户管理子系统如何设计,包括如何抽象以及相关的存储。 大部分的应用中都会有用户的概念,除非你的网站全部是匿名访问,不保存用户任何信息。其实这也是不好的,因为你的网站如果没有用户的概念,没有设计用户模块,就很难收集用户信息及用户行为,也就很难有数据来分析用户的喜好,也就少了一条给用户提供更好服务的途径。 现在是web2.0的时代,甚至是web3.0,用户越来越在意网站给自己带来的内容,显示的内容是否合适自己,而且用户很想参与网站的内容构建,想要对自己构建的内容进行聚合、管理。 说了这么多,就是要说明用户管理模块很重要,是个应用就应该考虑,而且还是重中之重。 先来看一下用户信息都包含哪些内容。 常见的内容包括:登录账号,登录密码,电子邮箱,个人网址,手机,QQ,简介,标签等等。 用户还可能包括企业用户,就会有:企业名称,企业注册号,企业工商号,企业营业执照号,法人,联系人,联系人职务等等企业信息。 如果是涉及到金钱往来的应用,例如:电商网站。肯定还会有银行账户信息:开户银行名称,开户名称,开户账号等。 用户会有很多的类型。 有的是个人,有的是企业。 有的有银行账户信息,有的没有银行账户信息,现在没有的,以后可能会有。 在用户认证方面现在可能是username/password,以后可能需要支持第三方认证(例如:微博,twitter,qq),还可能需要SSO。 单用户模型,单表存储模型 最开始想到的是就是一个用户模型,然后把所有的属性都建立在这个模型上,然后加上个用户类型属性区分一下。不同的用户类型,使用不同的属性。 在存储方面就建立一张表,每个属性来一个字段。虽然有很多的字段在一些情况下会有浪费,甚至在用户量巨大的情况下,是非常浪费的。但是好处就是从模型到存储,都是唯一的,来源唯一,省去一些获取啊,类型转换之类的麻烦。 但是也带来另外的一些麻烦,就是在代码中需要做很多的判断。什么类型,使用那些字段。 多用户模型,多表存储模型 上面的存储太浪费了,而且不清晰,所有用户都在一张表中,看起来有点不爽。 好吧,分开吧,根据用户类型分开,每个用户类型一个模型,单独存储一张表。 个人用户:登陆账号,登录密码,电子邮箱。 企业用户:登陆账号,登录密码,企业名称,组织机构代码,企业法人。 这下好像清晰了一点,需要什么类型的用户就用那个用户的模型,就去那张表找。 但是有几个问题: 1.登陆都是用username/password,在两张表,难道写两遍,但是都一样啊。好吧,也有解决办法,那就是写一个数据库视图,在视图中连接两张表,查询视图就可以了。这样也解决了一些需要同时查询所有用户的场景,不错。但是随着用户类型的增加,需要维护数据库视图,否则查询结果就会产生误差。但是查询单个类型用户的时候,是直接用表呢?还是用视图呢?有点纠结了! 2.需要增加银行账户信息,有几类用户需要添加,有的不需要添加。好吧,打开需要添加的表和模型,添加一下,但是有重复的工作量,是不是可以更好一点呢? !!! 其实我有一点感悟,就是你的代码写的和业务越是贴近,它的复用性就会越低,就是和某种业务绑定了,甚至是和某一个业务点耦合了。 当然,有的时候会有这种需要,这段代码就是为这个业务点来服务的。 但是有很多时候不是这样的。 举个例子吧。 一个实体有很多的状态,有几个状态来来决定是否能进行某个操作,你可能会写这样的一个方法。 private boo CanUpdate(Status status) { if(status==Status.Wait||status==Status.Finish) { return true;} return false; } 当上面的wait和finish状态还同时决定其他操作的时候,你可能又会写一个方法CanDo。这两个方法就有一些重复,可能在定义一个中间状态,复用一下会更好也说不定。 这个例子也可能不太合适,也可能是命名的问题。这个地方还需要大家拍砖,最好是使劲儿的拍,拍醒我,拍明白我。 信息模型,按信息类型存储 看到标题,很多人肯定是糊涂了,说着用户怎么就不提用户的事儿了呢? 其实就是抽象一下,用户就是一种信息。 在经历过几次用户信息的扩充之后,思考一下,把所有的信息都罗列出来,看看他们到底如何建立模型,如何设计存储,才能更好的适应应用的发展。 从另外一个角度,跳出应用,跳出业务划分,单纯的从信息的属性看看,是否有解决办法。 我觉得可以这么划分 验证信息:登录账号,登录密码,电子邮箱。 基本信息:姓名,联系电话,手机,所在地。 个人类信息:证件类型,证件号码。 企业类信息:企业名称,法人,组织机构代码,企业登记号。 银行账户信息:开户行名称,开户行所在地,开户行账户名称,开户行账户号码。 应用中的业务用户类型,都可以从这几种信息中组合而来,而且随时可以增加一类信息。用户信息的底层基础模型分为几个,分开独立存储。 业务中中某一类用户,需要哪些信息,就从用户信息的底层模型中挑选那几个,组合成一个业务的用户模型,进行业务的操作。 甚至底层基础模型还可以做到对业务模型屏蔽存储结构,存储方式,存储类型。 这么做有几个好处: 1.你可以把所有用户的验证信息存储在一起,这样在username/password验证,以及增加第三方验证的时候,都会很方便。 2.大量消除空白字段,节约存储空间。 3.大量消除重复字段,防止遗漏。 4.经过几次重构之后,就可以最大化的实现用户业务模型的组合、分离。上层业务模型清晰,底层基础模型清晰,后台存储模型也很清晰。 本文转自 virusswb 51CTO博客,原文链接:http://blog.51cto.com/virusswb/1111442,如需转载请自行联系原作者

优秀的个人博客,低调大师

无懈可击之完美dns架构

一:dns简介:DNS 是计算机域名系统 (Domain Name System 或Domain Name Service) 的缩写,它是由解析器以及域名服务器组成的。域名服务器是指保存有该网络中所有主机的域名和对应IP地址,并具有将域名转换为IP地址功能的服务器。域名与IP地址之间的转换工作称为域名解析,域名解析需要由专门的域名解析服务器来完成,DNS就是进行域名解析的服务器。 二:dns的阶层式管理模式:每一级dns服务器只管理其相邻的下一级dns,如图: 三:dns的查询过程: 第一种是本地解析:就是客户端可以使用缓存信息就地应答,这些缓存信息是通过以前的查询获得的 第二种是递归查询:即设定的DNS服务器代表客户端向其他DNS服务器查询,以便完全解析该名称,并将结果返回至客户端。 第三种是迭代查询:即设定的DNS服务器向客户端返回一个可以解析该域名的其他DNS服务器,客户端再继续向其他DNS服务器查询。 四:dns的服务器类型: 1:主dns服务器:记录可以修改,删除 2:辅助dns服务器:从主dns那里拷贝记录,不能修改,删除。 3.缓存dns服务器: 4:存根dns服务器:为某些特定的用户进行域名解析 五:dns资源记录 SOA(起始授权机构):此记录指定区域的起点。它所包含的信息有区域名、区域管理员电子邮件地址,以及指示辅 DNS 服务器如何更新区域数据文件的设置等 NS(名称服务器):此记录指定负责给定区域的名称服务器 A(主机): 此记录列出特定主机名的 IP 地址。 CNAME (标准名称):此记录指定标准主机名的别名。 MX邮件交换器记录:此记录列出了负责接收发到域中的电子邮件的主机。 PTR(指针) :把IP地址映射到域名。 六:dns区域: 正向区域:将主机名解析为ip地址 反向区域:将ip地址解析为主机名 案例一:北京总公司有一台主dns服务器 ,并且建立了一台辅助dns服务器,实现主dns服务器的内容同步到辅助dns服务器中。主dns服务器用Linux,辅助dns服务器用windowsserver 2003. 拓扑方案: 一:首先配置Linux主机: 1:[root@lyt ~]# mkdir /mnt/cdrom [root@lyt ~]# mount /dev/cdrom /mnt/cdrom/ [root@lyt ~]# cd /mnt/cdrom/Server/ [root@lyt Server]# ll bind* #查询与dns相关的软件包:如图: 2:[root@lyt Server]# rpm -ivh bind-9.3.6-4.P1.el5.i386.rpm #安装dns的主软件包 [root@lyt Server]# rpm -ivh bind-chroot-9.3.6-4.P1.el5.i386.rpm #有助于dns服务器安全的软件包 [root@lyt Server]# rpm -ivh caching-nameserver-9.3.6-4.P1.el5.i386.rpm #dns服务器的缓存 [root@lyt named]# cd /var/named/chroot #切换到dns服务器的根目录 [root@lyt named]# cd /var/named/chroot/etc/ #切换到dns服务器的主配置文档目录 [root@lyt etc]# cp -p named.caching-nameserver.conf named.conf #-p表示将文件的属性也拷贝一下,新文件名字一定是named.conf [root@lyt etc]# vim named.conf #编辑该文件如图所示: [root@lyt etc]# vim named.rfc1912.zones #编辑区域声明文件 3:[root@lyt chroot]# cd /var/named/chroot/var/named/ #切换到dns服务器的区域文件中 [root@lyt named]# cp -p localhost.zone a.com.db #使用模板拷贝成一个数据库文件 [root@lyt named]# vim a.com.db #编辑该区域的数据库文件如图: [root@lyt named]# service named restart [root@lyt named]# rndc reload #将dns的更新重新加载 二:配置windows server 2003主机: 1:选择:开始——〉设置——〉控制面板——〉添加或删除程序——〉添加/删除windows组件 2:开始——〉设置——〉控制面板——〉管理工具——〉dns 三:测试Linux主机和windows server主机的连通性: 四:修改Linux上主区域的数据库文件,查看windows server 主机上的辅助区域变化: [root@lyt named]# vim a.com.db [root@lyt named]# rndc reload #将dns的更新重新加载 五:限制windows主机到Linux主机上复制主区域内容 1:在named.conf文件中做限制: [root@lyt named]# cd ../../etc/ [root@lyt etc]# vim named.conf #再次编辑次文件,如图: [root@lyt etc]# vim ../var/named/a.com.db [root@lyt etc]# rndc reload 2:在区域文件named.rfc1912.zones中做限制,只能限制某个区域: 将上一步骤中的named.conf文件中的allow-transfer { 192.168.101.100; };禁用,然后用named.rfc1912.zones 作测试: [root@lyt etc]# vim named.rfc1912.zones [root@lyt etc]# rndc reload 案例二:主dns服务器用windows server 2003, 辅助dns:linux 。实现主dns服务器内容同步到辅助dns服务器中。 拓扑方案: 一:配置windows server 2003主机 二:配置linux主机: [root@lyt etc]# vim named.rfc1912.zones [root@lyt etc]# rndc reload [root@lyt etc]# cd ../var/named/slaves/ [root@lyt slaves]# more b.com.db #查看b.com.db中的信息,如图: 三:如果windows server主机中有更新:查看linux主机上是否能够同步信息: [root@lyt slaves]# service named restart [root@lyt slaves]# rndc reload [root@lyt slaves]# cat b.com.db 案例三:反向区域: 1:要求:使用linux主机创建反向区域。windows server 2003主机创建反向区域,作为linux主机的备份dns服务器: 首先配置linux主机: [root@lyt ~]# cd /var/named/chroot/etc/ [root@lyt etc]# vim named.rfc1912.zones [root@lyt named]# cp -p named.local 10.10.10.db 配置windows server 2003主机: 用xp主机进行测试: 2:要求:使用windows server 2003创建反向区域。linux主机建立反向区域,作为辅助区域: 配置linux主机: [root@lyt ~]# cd /var/named/chroot/etc/ [root@lyt etc]# vim named.rfc1912.zones [root@lyt etc]# service named restart [root@lyt etc]# cd ../var/named/slaves/ 案例四:区域的委派与转发1: 1:linux主机做父域,windows server 2003主机做子域 委派:将相关区域解析权限下放给某一台DNS服务器在委派服务器上只存储一条委派方与被委派方的记录。 转发:一般是本地的DNS不能为本地的用户进行服务,然后转发到其他指定的DNS。(转发可以通过转发器和根提示来实现) 说明:在北京总公司有一台dns服务器,域名是c.com,北京分公司的域名是bj.c.com。在上海的分公司域名是sh.c.com。在北京总公司的dns服务器上建立父子域,并对上海分公司dns服务器授权。上海分公司通过设置根提示和转发其来解析北京总公司及北京分公司。 拓扑方案: 一:首先配置linux上的dns-server:(在上个案例中已经将有关dns的软件包安装完毕,现在只修改配置文件) [root@lyt etc]# pwd #显示当前目录 /var/named/chroot/etc [root@lyt etc]# vim named.rfc1912.zones [root@lyt etc]# cd ../var/named/ [root@lyt named]# cp -p localhost.zone c.com.db #复制模板文件,-p表示连同属性一起复制 [root@lyt named]# cp -p localhost.zone bj.c.com.db [root@lyt named]# vim c.com.db#编辑c.com域,对上海分公司进行委派: [root@lyt named]# vim bj.c.com.db #编辑bj.c.com子域的数据库文件如图: [root@lyt named]# named-checkconf /var/named/chroot/etc/named.conf #检测主配置文档是否有错 [root@lyt named]# named-checkzone a.com /var/named/chroot/var/named/a.com.db #检测区域文件是否有错 [root@lyt named]# service named restart 二:配置windwos server 2003主机:(在上个案例中,dns已经安装。这里不用安装了) 三:用xp主机进行测试: 1:dns指向linux主机: 查看解析结果: 2:使xp主机的dns指向windows server 2003主机: 查看解析结果: 在windows server 2003主机上设置根提示: 在xp主机上再次测试,xp主机dns指向子域sh.c.com。设置根提示之后解析成功: 将windows server 2003主机上设置的根提示删除,然后设置转发器: 在xp主机上使用ipconfig /flushdns清除缓存,然后再次进行测试: 2:区域的委派与转发2:windows server 2003主机做父域,linux主机做子域: 首先配置winodws server 2003主机: 在linux主机上配置委派的域sh.d.com: [root@lyt etc]# vim named.rfc1912.zones [root@lyt etc]# cd ../var/named/ [root@lyt named]# cp -p localhost.zone sh.d.com.db [root@lyt named]# vim sh.d.com.db 使用xp主机进行测试:dns指向windows server 2003: dns指向linux主机(sh.d.com子域): 在linux主机上设置根提示: [root@lyt named]# vim named.ca #编辑dns的根指向文件 [root@lyt named]# service named restart 再次用xp主机测试: 在linux主机上设置转发器:(将根指向删除) 1:无条件转发: [root@lyt named]# cd ../../etc/ [root@lyt etc]# vim named.conf 2:配置有条件转发: [root@lyt etc]# vim named.rfc1912.zones [root@lyt etc]# rndc reload 用xp主机,再次进行测试: 看完务必赞一个,写博客好辛苦!!! 本文转自 liuyatao666 51CTO博客,原文链接:http://blog.51cto.com/5503845/973781,如需转载请自行联系原作者

优秀的个人博客,低调大师

JPDA 架构研究22 - 总结

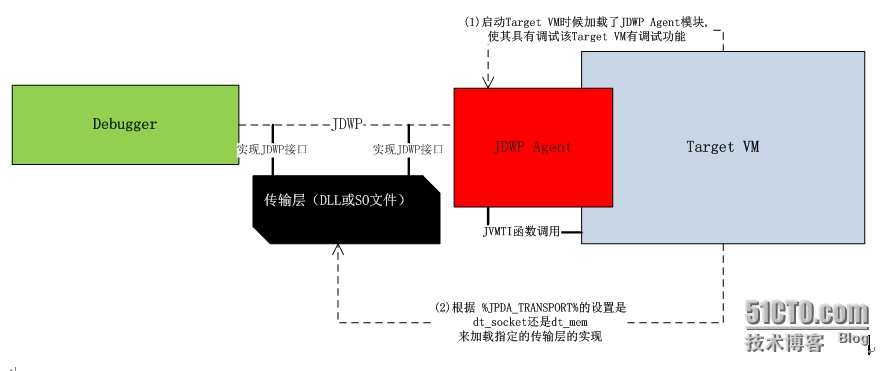
引入: 前面有几十篇文章从JPDA的各个层面深入剖析了这个协议的细节和其中的各个组成部分细节,现在到了我们总结的时候了。因为图比文字更直观,所以这里精心设计一组图来详细阐述这其中的整个奥秘。如果要对某些部分做特别关注,可以参见前面相关文章。 分析(还是分场景): 场景1: JVM加载阶段: 其中dt_mem只适合于windows平台。 场景2:建立连接阶段(分两种情况.): Scenario 1: 如果是 Target VM主动发起对Debugger的连接。 Scenario 2:如果是Target VM被动等Debugger建立的连接。 场景3:调试阶段: 本文转自 charles_wang888 51CTO博客,原文链接:http://blog.51cto.com/supercharles888/1588773,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册