首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

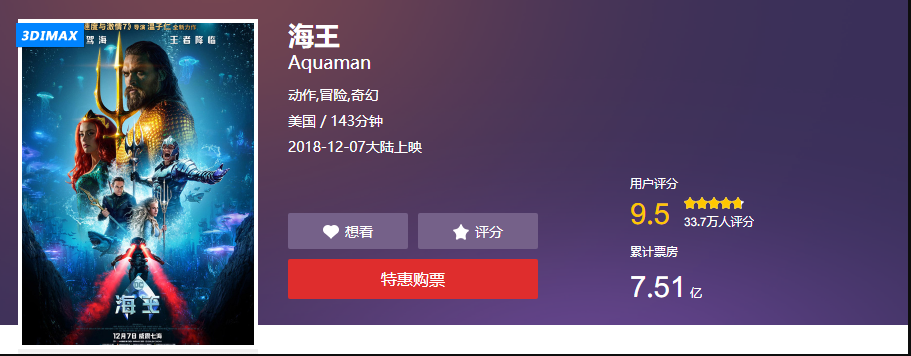
Python爬虫入门教程 33-100 《海王》评论数据抓取 scrapy

1. 海王评论数据爬取前分析 海王上映了,然后口碑炸了,对咱来说,多了一个可爬可分析的电影,美哉~ 摘录一个评论 零点场刚看完,温导的电影一直很不错,无论是速7,电锯惊魂还是招魂都很棒。打斗和音效方面没话说非常棒,特别震撼。总之,DC扳回一分( ̄▽ ̄)。比正义联盟好的不止一点半点(我个人感觉)。还有艾梅伯希尔德是真的漂亮,温导选的人都很棒。真的第一次看到这么牛逼的电影 转场特效都吊炸天 2. 海王案例开始爬取数据 数据爬取的依旧是猫眼的评论,这部分内容咱们用把牛刀,scrapy爬取,一般情况下,用一下requests就好了 抓取地址 http://m.maoyan.com/mmdb/comments/movie/249342.json?_v_=yes&offset=15&startTime=2018-12-11%2009%3A5

优秀的个人博客,低调大师

Python爬虫入门教程 29-100 手机APP数据抓取 pyspider

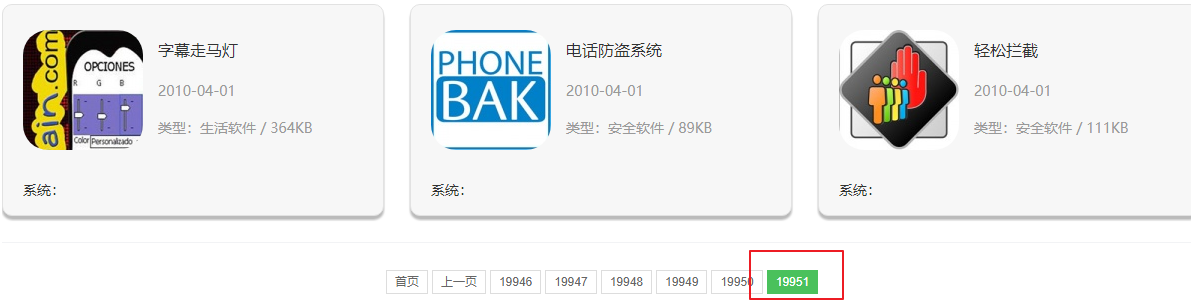
1. 手机APP数据----写在前面 继续练习pyspider的使用,最近搜索了一些这个框架的一些使用技巧,发现文档竟然挺难理解的,不过使用起来暂时没有障碍,估摸着,要在写个5篇左右关于这个框架的教程。今天教程中增加了图片的处理,你可以重点学习一下。 2. 手机APP数据----页面分析 咱要爬取的网站是 http://www.liqucn.com/rj/new/ 这个网站我看了一下,有大概20000页,每页数据是9个,数据量大概在180000左右,可以抓取下来,后面做数据分析使用,也可以练习优化数据库。 网站基本没有反爬措施,上去爬就可以,略微控制一下并发,毕竟不要给别人服务器太大的压力。 页面经过分析之后,可以看到它是基于URL进行的分页,这就简单了,我们先通过首页获取总页码,然后批量生成所有页码即可 http://www.liqucn.

优秀的个人博客,低调大师

Python爬虫入门教程 22-100 CSDN学院课程数据抓取

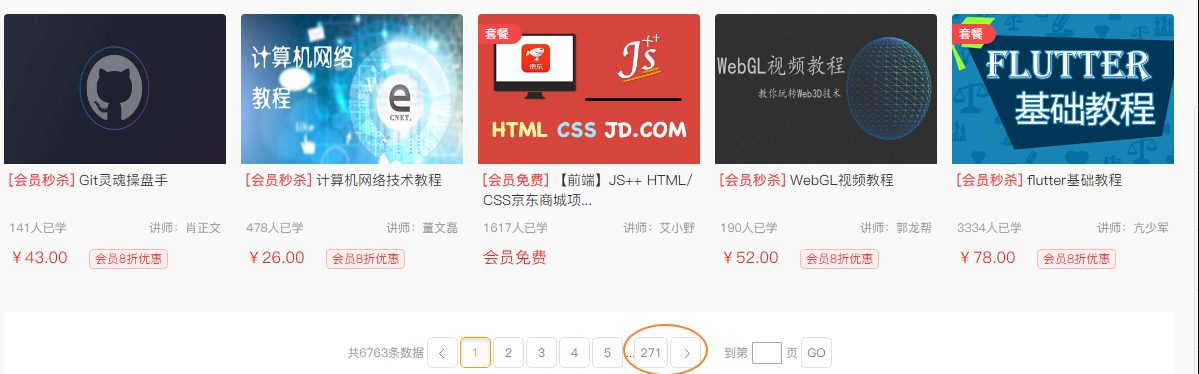
1. CSDN学院课程数据写在前面 今天又要抓取一个网站了,选择恐惧症使得我不知道该拿谁下手,找来找去,算了,还是抓取CSDN学院吧,CSDN学院的网站为 https://edu.csdn.net/courses 我看了一下这个网址,课程数量也不是很多,大概有 6000+ 门课程,数据量不大,用单线程其实就能很快的爬取完毕,不过为了秒爬,我还是选用了一个异步数据操作。 2. CSDN学院课程数据分析页码 还是需要好好的分析一下页码规律 https://edu.csdn.net/courses/p2 https://edu.csdn.net/courses/p3 https://edu.csdn.net/courses/p4 ... ... https://edu.csdn.net/courses/p271 页码还是非常有规律的,直接编写

优秀的个人博客,低调大师

Python爬虫入门教程 18-100 煎蛋网XXOO图片抓取

1.煎蛋网XXOO-写在前面 很高兴我这系列的文章写道第18篇了,今天写一个爬虫爱好者特别喜欢的网站煎蛋网http://jandan.net/ooxx,这个网站其实还是有点意思的,网站很多人写了N多的教程了,各种方式的都有,当然网站本身在爬虫爱好者的不断进攻下,也在不断的完善,反爬措施也很多,今天我用selenium在揍他一波。 整体看上去,煎蛋网的妹子图质量还是可以的,不是很多,但是还蛮有味道的,这可能也是爬虫er,一批一批的奔赴上去的原因。 2. 煎蛋网XXOO-网站分析 这个网站如果用 selenium 爬取,其实也没什么要分析的,模拟访问就行,导入必备的模块。 from selenium import webdriver from selenium.webdriver.common.by import By from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as EC from lxml import etree import requests import time 我使用的是PhantomJS 去加载浏览器,关于这个PhantomJS,去互联网搜索一下吧,资料大把,会看的很爽的,总之呢,它可以模拟一个真实的浏览器做任何事情,得到你想要的数据。 browser = webdriver.PhantomJS() browser.set_window_size(1366, 768) # 这个地方需要设置一下浏览器的尺寸 wait = WebDriverWait(browser,10) browser.get("http://jandan.net/ooxx") 3. 煎蛋网XXOO-分析数据 程序获取到数据之后就可以对数据进行处理了,编写一个get_content函数,用来处理网页源码。 def get_content(): try: wait.until( EC.presence_of_element_located((By.XPATH,'//*[@id="comments"]/ol')) ) # print("正在爬取{}".format(browser.current_url)) page_source = browser.page_source # 获取网页源码 html = etree.HTML(page_source) # 解析源码 imgs = html.xpath("//li[contains(@id,'comment')]//img/@src") # 匹配图片 download(imgs) except Exception as e: print("错误") print(e) finally: browser.close() 图片获取到之后,在上面的代码中,注意有一个地方调用了一个 download函数,这个函数就是用来下载图片的 def download(imgs): path = "./xxoo/{}" # 路径我写死了 for img in imgs: try: res = requests.get(img) content = res.content except Exception as e: print(e) continue file_name = img.split("/")[-1] # 获取文件名 with open(path.format(file_name),"wb") as f: f.write(content) print(file_name,"成功下载文件") time.sleep(0.3) # 循环下载完毕,进行翻页操作 previous-comment-page next = wait.until( EC.presence_of_element_located((By.XPATH, '//*[@id="comments"]//a[@class="previous-comment-page"]')) ) next.click() return get_content() # 继续调用上面的网页源码分析流程 OK,运行一下。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册