首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

Python数据处理小技巧:pivot_table后如何拍平columns

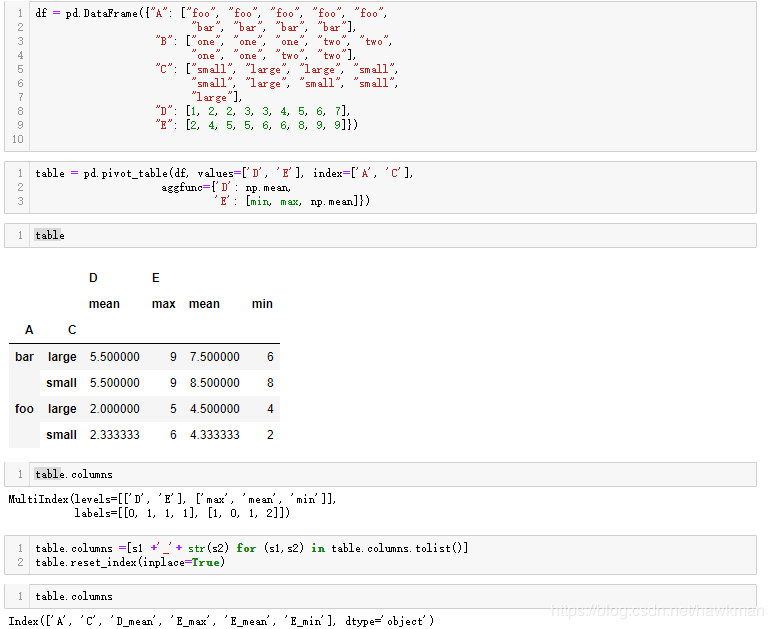
机器学习的过程中很多时候需要用到类似透视表的功能。Pandas提供了pivot和pivot_table实现透视表功能。相对比而言,pivot_table更加强大,在实现透视表的时候可以进行聚类等操作。 pivot_table帮助地址: https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.pivot_table.html 官方给的几个例子: df = pd.DataFrame({"A": ["foo", "foo", "foo", "foo", "foo", ... "bar", "bar", "bar", "bar"], ... "B": ["one", "one", "one", "two", "two", ... "one", "one", "two", "two"], ... "C": ["small", "large", "large", "small", ... "small", "large", "small", "small", ... "large"], ... "D": [1, 2, 2, 3, 3, 4, 5, 6, 7], ... "E": [2, 4, 5, 5, 6, 6, 8, 9, 9]}) df A B C D E 0 foo one small 1 2 1 foo one large 2 4 2 foo one large 2 5 3 foo two small 3 5 4 foo two small 3 6 5 bar one large 4 6 6 bar one small 5 8 7 bar two small 6 9 8 bar two large 7 9 This first example aggregates values by taking the sum. table = pd.pivot_table(df, values='D', index=['A', 'B'], ... columns=['C'], aggfunc=np.sum) table C large small A B bar one 4.0 5.0 two 7.0 6.0 foo one 4.0 1.0 two NaN 6.0 We can also fill missing values using the fill_value parameter. table = pd.pivot_table(df, values='D', index=['A', 'B'], ... columns=['C'], aggfunc=np.sum, fill_value=0) table C large small A B bar one 4 5 two 7 6 foo one 4 1 two 0 6 The next example aggregates by taking the mean across multiple columns. table = pd.pivot_table(df, values=['D', 'E'], index=['A', 'C'], ... aggfunc={'D': np.mean, ... 'E': np.mean}) table D E A C bar large 5.500000 7.500000 small 5.500000 8.500000 foo large 2.000000 4.500000 small 2.333333 4.333333 We can also calculate multiple types of aggregations for any given value column. table = pd.pivot_table(df, values=['D', 'E'], index=['A', 'C'], ... aggfunc={'D': np.mean, ... 'E': [min, max, np.mean]}) table D E mean max mean min A C bar large 5.500000 9.0 7.500000 6.0 small 5.500000 9.0 8.500000 8.0 foo large 2.000000 5.0 4.500000 4.0 small 2.333333 6.0 4.333333 2.0 现在的一个问题是,处理后的dataframe的columns是多层的,例如最后一个例子的columns是这个样子的: table.columns: MultiIndex(levels=[['D', 'E'], ['max', 'mean', 'min']], labels=[[0, 1, 1, 1], [1, 0, 1, 2]]) 为了后续的运算,我们经常希望它能简化,便于处理。也就是说吧columns拍平。大家可以这么处理: table.columns =[s1 +'_'+ str(s2) for (s1,s2) in table.columns.tolist()] table.reset_index(inplace=True) 效果如下: table.columns Index(['A', 'C', 'D_mean', 'E_max', 'E_mean', 'E_min'], dtype='object') 效果如图:​

优秀的个人博客,低调大师

破14亿,Python分析我国存在哪些人口危机!

2020年1月17日,国家统计局发布了2019年国民经济报告,报告中指出我国人口突破14亿。 猪哥的朋友圈被14亿人口刷屏,但是很多人并没有看到我国复杂的人口问题:老龄化、男女比例失衡、生育率下降、人口红利下降等。 今天我们就来分析一下我们国家的人口数据吧! 一、背景 1.人口突破14亿 2020年1月17日,国家统计局发布了 2019年国民经济报告 ,报告中指出:年末中国大陆总人口(包括31个省、自治区、直辖市和中国人民解放军现役军人,不包括香港、澳门特别行政区和台湾省以及海外华侨人数)140005万人。 也就是说2019年底我国人口突破14亿! 报告链接:http://www.stats.gov.cn/tjsj/zxfb/202001/t20200117_1723383.html 2.人口普查年 根据2010年5月12日国务院第111次常务会议通过的《全国人口普查条例》第一章 第八条规定:人口普查每10年进行一次,尾数逢0的年份为普查年度,标准时点为普查年度的11月1日零时。 也就是说2020年11月将进行第七次人口普查,新中国成立后前六次人口普查分别为:1953、1964、1982、1990、2000、2010年。 ps:有些同学可能会有疑问:十年普查一次,那其他年份人口数怎么得来?在非普查年,当年总人口=上年总人口+当年出生人口-当年死亡人口 而计算得出! 3.全面放开二胎 《中华人民共和国人口与计划生育法修正案(草案)》明确规定,“全面两孩”政策2016年元旦开始即可实施。全面实施一对夫妇可生育两个孩子政策,是中国生育政策的一次历史性调整,实行了36年的独生子女政策全面终止。 二、分析目标 新中国成立70,经历了许许多多的风风雨雨,政策、经济、文化也有很多的变化,人口也随之变化。 人口变化对社会经济发展带来巨大而深远的影响,所以今天我们从多角度来分析我国人口变化: 人口总数 男女比 城镇化 增长率 人口结构 三、爬取数据 关于我国人口的数据来源,可以从“国家数据”网站中获取。这是一个由国家统计局提供的网站,里面有很多国家公开的数据信息! 1.请求单页数据 在国家数据网站中,有从新中国成立到2018年的人口相关数据。 在人口数据中,有三项是我们需要的数据:总人口、增长率、人口结构。 我们按F12查看一下请求的链接,然后复制链接使用requests请求数据。 只使用一个简单的get请求,就把数据获取了,而且返回的直接是json数据! 2.分页数据 我们此次的目的是抓取从新中国至今的所有人口数据,而页面中最多可以获取近20年的数据,所以我们需要分析网页请求中关于分页的参数。 分析请求参数猪哥发现主要有两个参数:zb、sj,分别表示指标和时间。 参数:sj=LAST0,表示近10年,于是猪哥猜想:sj=LAST70 是不是就可以获取70年的数据呢? 然后我们再将zb参数更换,获取到所有的数据! 3.保存Excel 获取到数据之后,我们先将数据清洗,提取出我们需要的数据,然后整理保存到Excel中,数据处理方面我们仍然使用 潘大师(pandas)。 我们来看看保存的excel文件数据。 4.2019年数据 目前数据唯一的不完整就是没有2019年的数据,因为2019年刚刚完结所以数据还没有登记到网站上,我们只能自己算出来然后补齐。 猪哥根据2020年1月17日,国家统计局发布了 2019年国民经济报告中关于人口的数据得出了2019年的相关数据。 来看看完整的70年人口数据。 四、数据分析 数据保存完毕后我们就可以开始数据分析步骤了,一般在我们数据分析之前我们需要有个思路:要分析什么?从哪些角度分析?选择何种可视化图形?得出了什么结论?(当然实际工作时的分析报告需要更为严谨,但大体思路类似。) 1.总人口 首先我们提取Excel中的“年末总人口”这一列的数据进行分析。 直接上代码,猪哥先使用潘大师读取Excel,然后再获取总人口的列数据(完整代码请查看源码)。 上面的代码和之前画曲线有点不同的是:添加了自定义曲线背景色和区域色的功能,下次有同学想自定义pyecharts曲线背景就可以参考这里的代码。 在下图中猪哥标注了四个点: 1949年:新中国成立,总人口 5.42亿 1980年:计划生育正式开始,总人口 9.87亿 2016年:全面放开二胎,总人口 13.83亿 2019年:总人口 14亿 通过观察总人口曲线图得知: 人口总体在增加,但增长曲线慢慢放缓,据社科院预测:中国人口将在2029年达到峰值14.42亿,往后逐步下降 新中国成立至今(2020年)唯一出现人口减少的是1960和1961年,这两年是我国的自然灾害年。 根据总人口数,我们再来分析一下 执行计划生育生育前31年与 后31年增长的人口分别是多少? 根据上图我们可以看出:计划生育确实控制了人口的增长! 而放开二胎后并未迎来生育高峰期,联合国相关机构发布的《世界人口展望》2017修订版给出了类似的预期。它倾向于认定中国人口已经开始了倒V型反转,在人口到达高峰后,2050年将会保持13亿多,然后就会加速下滑(低、中、高三种生育率,来自联合国人口基金)。 2.男女人口比例 我们经常会听到别人说:“中国男女比例失衡,将有3000万中国男性娶不到老婆”。 其实这是我国男女比例失衡造成的结果。 下面猪哥就从以下4个角度来分析我国男女比例的关系: 2019年男女比 男性占总人口比例 男女人口数曲线 男女人口数差值 根据上面4图我们可以得出一些结论: 新中国成立以来男性人口一直比女性人口多,可能与我国重男轻女思想有一定关系。 男性占比最高是在新中国成立之初为51.96%,最低是在1996年为50.82%。下图是来自快易数据提供的 中国、印度、日本、英国、美国 五国的男性占比图,从图中可以清晰看出中国与印度的男女比一直处于失衡状态。 2000年我国男女人口差值最大为4131万人,最小差值是在1965年为1718万人。 2006年以来我国男女比例失衡状况逐年缓解 我国到底有多少男性同胞们会打光棍? 由于篇幅有限,我们下期做一个专题分析这个问题! 3.人口城镇化 有很多同学不理解何为“人口城镇化”,下面猪哥引用百度百科的介绍: > 人口城镇化是指农村人口转变为城镇人口、农业人口转变为非农业人口的过程,它是社会生产力发展到一定阶段的产物。 城镇化是一个综合指标,可以用来衡量当地经济发展情况、基础设施和人民生活水平。 同时,城镇化的进程也是房地产市场在需求层面的重要支撑力量,下图是一张人口城镇化与社会发展关系的图。 根据美国地理学家诺瑟姆对世界各国城市化的研究,世界城市化分为三个阶段: 初期(人口城镇化在30%以下):农村人口占优势,工农业生产力水平较低,工业提供就业机会少,农业剩余劳动力得不到释放。 中期(人口城镇化30%~70%):工业基础比较雄厚,经济实力明显增强,农村劳动生产率提高,剩余劳动力转向工业,城市人口比重快速突破50%,而后上升到70%。 后期(人口城镇化70%~90%):农村人口向城镇人口的转化趋于停止,农村人口占比稳定在10%左右,城市人口可以达到90%左右,趋于饱和,这个过程的城市化不再是人口从农村流向城市,而是城市人口在产业之间的结构性转移,主要是从第二产业向第三产业转移。 来看看我国人口城镇化数据分析: 由上图分析可知: 2019年我国人口城镇化达到60.6%,处于人口城镇化的中期。 1995年我国乡村人口达到峰值:8.59亿。 1996年我国城镇化步伐加快,同年城镇化超过30%,进入城镇化的中期。 在2010年我国城市人口与乡村人口持平约为6.7亿,城镇化为50%。 联合国对中国人口城镇化进程进行了预测:我国城镇化初期是1949年~1995年,中期是1996年~2032年,后期是2033年以后。 4.人口增长率 数据可视化的代码猪哥就不放出来了,想看的同学直接取看源码吧,我们直接看图片。 由上图得知: 在自然灾害三年(1959、1960、1961)我国人口死亡率陡增,出生率也下降,人口出现新中国成立以来第一次负增长! 在自然灾害过后的两年(1962、1963)迎来我国最大的一波生育潮,我们通过2010年人口第五次普查的数据也可以验证这个结论。 自然灾害三年过后我国的死亡率一直趋于稳定,维持在6-7‰左右。 我国出生率整体一直在下降,在计划生育之前出生率就在下降。 在2016年我国全面放开二胎之后的三年(2017-2019),出生率并没有出现好转,反而持续走低。 目前的育龄妇女基本都是85-90后,受计划生育(1980年)影响,育龄妇女人数比以前少了,生孩子的数量自然就比以前少了,这一情况会持续下去。 出生率降低,死亡率增加,人口增长就慢慢放缓,社科院预测在2029年左右我国人口达到峰值(14.42亿)之后慢慢减少! 题外话:猪哥在爬取数据之后,发现 国家数据网站 提供的数据也是有误的:1961年人口比1960年人口下降,而增长率却为整数! 5.年龄结构 人口年龄结构是衡量 老龄化 与 人口红利 的指标。 > 老龄化:指老年人口相对增多,在总人口中所占比例不断上升的过程,国际上通常看法是,当一个国家或地区60岁以上老年人口占人口总数的10%,或65岁以上老年人口占人口总数的7%,即意味着这个国家或地区的人口处于老龄化社会。 ——百度百科 老龄化是每个国家每个社会都会经历的阶段,目前来讲发达国家的老龄化问题比发展中国家更严重,据快易数据提供的一份 世界各国老龄化排名来看,中国只排到了65名,第一名是日本,而前几名基本都是欧洲国家。 > 人口红利:经济学术语,是指一个国家的劳动年龄人口占总人口比重较大,抚养率比较低,为经济发展创造了有利的人口条件,整个国家的经济呈高储蓄、高投资和高增长的局面。 人口红利简单来说就是 劳动力人口数 大于 非 劳动力人口,劳动人口比例较高,保证了经济增长中的劳动力需求,劳动力资源丰富和成本优势已经使中国成为世界工厂和世界经济增长的引擎。 从上面三图分析我们可得: 1982年我国 0-14岁少儿占比33.59%,而2019年减至17.9%,比例减至近半。 2019年我国65岁以上人口占比为12.57%,已经进入老龄化社会。世界有92个国家进入老龄化,中国排在65。 2010年我国总抚养比达到最低为:34.2%,意味着每3个劳动力需要养一个老人或小孩。 人口红利在2010年达到顶峰,之后在慢慢降低。 2019年我国老年人口为1.76亿,中国的老龄化即将进入快速老龄化阶段,目前我国多个省的养老金告急,我国养老金体系改革迫在眉睫。 五、总结 由于篇幅过长,很多分析代码并未放出,如果想学习的同学可以查看源码(https://github.com/pig6/china_population)。 我们来总结一下我们今天分析的结果吧: 总人口:我国总人口稳步增长,据社科院预测:中国人口将在2029年达到峰值14.42亿,往后逐步下降 男女比例:我国自新中国成立以来,一直处于男多女少的状态中,2019年男女差为3000万。因为老年人中女性多于男女,所以年轻男女的差值应该会更大,下期我们可以专门分析一下:中国将会有多少光棍? 人口城镇化:2019年我国城镇化超过60%,处于城镇化发展的中期阶段。联合国对中国人口城镇化进程进行了预测:我国城镇化初期是1949年~1995年,中期是1996年~2032年,后期是2033年以后。 人口增长率:我国出生率持续走低,在全面放开二胎之后并未出现生育潮,人口增长慢慢放缓,据社科院预测在2029年人口增长率为0,之后出现负增长,生育率低使得我的老龄化进程加快。 人口年龄结构:人口年龄结构影响着两个重要的指标:人口红利、老龄化。我国人口红利在2010年达到顶峰,之后慢慢减少。老龄化问题是国际普遍存在的问题,尤其是发达国家。据快易数据显示:2018年全世界有92个国家进入老龄化,排在第一的日本老龄化为:27.58%,我国老龄化排在第65位。但随着时间推移我国即将进入快速老化期,养老问题日益凸显! 总结来说我国人口结构存在两个严峻的问题: 养老问题:生育率低、劳动力萎缩、老龄化加速、人口即将见顶、人口红利消失、多省养老金告急,需中央补贴! 剩男问题:计划生育实行后男女人口差拉大,男女失衡,剩男问题严峻,越南买媳妇新闻屡见不鲜! 面对两个严峻的考验,希望有专业人士能为我们国家出谋划策,希望我们的国家早日实现伟大复兴! 数据来源: 1、http://data.stats.gov.cn/easyquery.htm?cn=C01 2、http://www.stats.gov.cn/tjsj/zxfb/202001/t20200117_1723383.html 3、https://www.kylc.com/stats 参考: 1、https://yq.aliyun.com/articles/668824 2、https://mp.weixin.qq.com/s/SmNxflkaYgBewwmjoqOfJw 3、https://www.ssap.com.cn/c/2019-01-03/1074956.shtml 源码地址:https://github.com/pig6/china_population

优秀的个人博客,低调大师

用Python模拟技巧带你实现自动抽屉登录&自动点赞

/1 前言/ 嘿,各位小伙伴们晚上好呀,今天小编又给大家带来干货内容啦,今天带来的是,如何自动登录抽屉,并且点赞! 原计划是不打算使用selenium的,但是因为要涉及点赞,所以免不了登录。但事实证明,我又被啪啪打脸了,抽屉的登录是真的难,各种参数把我干懵了。无赖之下,我还是捡起了selenium,难逃真香定律呐,哈哈哈。 好了,废话不多说,直接进入正题吧! /2 准备工作/ 万年不变的套装... Chromedriver:浏览器驱动,可以理解为一个没有界面的chrome浏览器。 Selenium:用于模拟人对浏览器进行点击、输出、拖拽等操作,就相当于是个人在使用浏览器,也常常用来应付反爬虫措施。 /3 抽屉点赞机制/ 我们都知道,要想点赞,就需要知道是谁点的,登录以后需要等保存状态,一般有cookie,seeeion,token三种形式,那么抽屉的是怎么玩的呢?我们来图解一下,如下图所示。 通过上图,我们一目了然,能看出来,只要我们登录了之后,拿到了cookie,以后就不用selenium啦!所以,我们这里将登录获取cookie和点赞进行分离,分开进行,逻辑也十分的清晰,而且一点儿也不耽误事情。 /4 登录预热/ 抽屉url:https://dig.chouti.com/,直接放这了。 一个热榜资讯社区,大概长这个样子,如下图所示,内容还是挺不错的。 在上图我们可以看到右上方的登录按钮,在左侧可以看到需要点赞的图标以及点赞数,评论数和收藏数等等,接下来我们先进行第一步自动登录。 /5 开始登录/ 点击右上方的登录按钮,页面将会进行跳转,进入到一个登录界面,如下图所示。 弹出登录模态对话框,接下来我们使用selenium来开始盘它了,直接上代码,如下所示。 注意事项1:介于篇幅和排版原因,这里只是给出了一个代码截图,完整代码我在文末留了github链接,回头可以直接去down即可。 因为此登录是模态对话框,所以用selenium是不能点击登录按钮的,需要执行js代码,如下图所示。 Cookie是怎么玩的呢,我他把写在了本地,但是测试发现selenium获取cookie不全,所以我们依然使用js获取。 注意事项2:抽屉如果登录多了,可能会让输入滑块验证码之类的,本文这部分并未有进行处理。 /6 自动登录示例效果图/ 自动登录的效果图如下图所示: /7 开始自动点赞/ 在上面的工作中,我们已经成功的拿到登录返回的cookie了,接下来我们就开始自动点赞,而且有了之前的基础,下面的事情我们就好办多了。 我们首先需要看一下,点赞请求的是哪个接口。我们清空一下浏览器中的NetWork日志,点击第一个文章的赞按钮,如下图所示。 我们可以看到,这个接口发的是post请求,但是发送的是什么数据呢?我们下滑继续一探究竟。 可以看到在Form Data里边,有一个linkid:29213534,是一串长数字,这个是什么呢?马上揭晓! 使用浏览器与网页的交互功能,我们点击对应的文章,那么很快我们就可以锁定这个linkid,如下图所示。 相信大家肯定都看得出来,其实post的那一串数字其实就是文章ID。换句话说,我们只需要把这个ID都获取到,放到post构造数据里边,程序一运行,就可以实现点赞啦! /8 代码实现/ 下面是部分代码截图,完整代码在文末,如下图所示。 注:这里只是测试了前10个文章。 /9 抽屉自动点赞效果图/ 为了方便大家查看,我做了一个简单的小动态图给大家,详情如下。 如果动图看的不是很清晰的话,不用慌,小编已经把原图放到github上了,大家可以去访问看看,很清晰,如下图所示。github链接在文末,欢迎大家来戳! /10 抽屉自动点赞效果图/ 代码详情我已经上传到github这里了:后台回复“抽屉”两字,可以获取代码。如果觉得还不错,记得给个star噢,感想小伙伴们的支持!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册