首页 文章 精选 留言 我的

精选列表

搜索[techo day],共2891篇文章
优秀的个人博客,低调大师

JAVA学习day03

1、引用类型变量格式:类型 变量名=new 类型();举例:Scanner sc=new Sccanner();每个引用类型,都有自己的功能,如何使用功能格式:变量.方法名() 2、util 工具的意思 3、Scanner类,作用,让我们在命令行中,接收键盘的输入 使用Scanner类的步骤: 1、导入包,知名类所在的文件夹 java文件夹的util文件夹 2、公式,创建出Scanner类型变量 3、变量.使用Scanner类中的功能,完成键盘输入 4、随机数java中已经有的引用类型Random类步骤:1、导入包,Random类,在java.util文件夹2、公式:创建Random类型的变量3、变量.调用Random类中的功能,产生随机数 Random类,提供功能,名字,nextInt()产生一个随机数,结果是Int类型出现随机数的范围,在功能netxint()(写一个整数),整数:随机出来的范围随机数的范围0-指定的整数间的随机数nextInt(100)0-99 5、if语句 /***if语句*编写格式:*if(条件){*if语句的执行体*}*条件:结果必须是布尔类型1==1true||false*执行体:当if中的条件为true的时候,执行大括号中的执行体*if条件是false的时候,不执行****/publicclassIfDemo{publicstaticvoidmain(String[]args){inti=5;if(i==5){System.out.println("if中的条件是true");i++;}System.out.println(i); } } 6、if…else语句 7、三元运算符判断条件?表达式1:表达式2如果条件为真,则表达式1;如果为假,则表达式2 8、while循环编写格式:While(条件){ 循环体 }条件:当条件是true,就执行循环体,执行虚幻提后程序再次执行whie中德条件,如果条件还是true,继续执行循环体,直到条件是false的时候,循环就结束。 9、for循环编写格式For(初始化变量;条件;增量){ 循环体 } 10、do…while循环编写格式: Do{ 循环体 }while(条件) 特点:无条件先执行一次 11、嵌套循环循环里面还有虚幻,for形式多For(){ For(){ } }总循环次数=外循环次数*内循环次数 内循环是外循环的循环体 外循环,控制的是行数内循环,控制的是每行的个数 12、跳出break关键字 作用于循环中,终止循环的作用continue关键字 作用:在循环中,终止本次循环,开始下一个循环 13、猜数字游戏 package com.ghy.study; import java.util.Random;import java.util.Scanner; /** 实现猜数字的小游戏 随机数一个数字,让用户猜 结果3种情况* 随机数:Random 键盘输入:Scanner 猜的数字,和随机数进行比较if判断 直到猜中为止,反复去猜,循环while*/ public class GuestNumber { public static void main(String[] args) { System.out.println("猜数字游戏开始啦"); Random r=new Random(); Scanner sc=new Scanner(System.in); int j = r.nextInt(10); System.out.println(j); while (true) { System.out.println("请输入数据:"); int i = sc.nextInt(10); if(i == j){ System.out.println("恭喜你猜对了"); break; }else if(j > i){ System.out.println("猜小了"); }else if (j < i){ System.out.println("猜大了"); } } } }

优秀的个人博客,低调大师

JAVA学习day02

1、基本数据类型四类八种 2、变量定义后,不赋值,不能使用,即必须进行赋值后才能使用; 3、自增和自减++a 和a++相等但是在计算时,有如下差别a=3b=a++b=3,a=4 若a=3c=++ac=4,a=4 4、赋值 5、打印清单实现商品库存清单案例步骤:1、实现表头,是固定数据,直接写输出语句;2、表格中间,商品数据,采用变量形式,定义变量,找对数据类型,输出所有变量3、表格尾巴,一部分数据固定另一部分:商品数据进行数学计算 */ public class Shop { public static void main(String[] args) { //输出表头固定数据 System.out.println("---------商品库存清单-----------"); System.out.println("品牌型号 尺寸 价格 库存数"); //定义表格中的数据变量 //品牌型号String 尺寸,价格double 库存int String macBrand="MacBookAir"; double macSize=13.3; double macPrice=6898.88; int macCount=5; String thinkBrand="ThinkPadT450"; double thinkSize=14; double thinkPrice=5999.88; int thinkCount=10; String asusBrand="ASUS-FL5800"; double asusSize=15.6; double asusPrice=4999.5; int asusCount=18; System.out.println(macBrand+" "+macSize+" "+macPrice+" "+macCount); System.out.println(thinkBrand+" "+thinkSize+" "+thinkPrice+" "+thinkCount); System.out.println(asusBrand+" "+asusSize+" "+asusPrice+" "+asusCount); //计算库存总数,所有商品数量库存求和 int totalCount=macCount+thinkCount+asusCount; //计算所有商品的总金额,每个商品价格*库存数 double totalMoney=macCount*macPrice+thinkCount*thinkPrice+asusCount*asusPrice; System.out.println("总库存数:"+totalCount); System.out.println("所有商品的总金额:"+totalMoney); } }

优秀的个人博客,低调大师

python基础day4

1.列表生成式,迭代器&生成器 列表生成式 将列表[0,1,2,3,4,5,6,7,8]中的每个值加1,如何实现?常用的几种方法 方法一: a=[0,1,2,3,4,5,6,7,8] for i in a: a[i] +=1 b=a print(b) a=[0,1,2,3,4,5,6,7,8]b=[]for i in a:b.append(i+1)print(b) 方法二: a=[0,1,2,3,4,5,6,7,8] for index,i in enumerate(a): a[index] +=1 print(a) 方式三: a=[0,1,2,3,4,5,6,7,8] a = map(lambda x:x+1, a) for i in a:print(i) 其实还有一种写法,如下 a=[i+1 for i in range(9)] print(a) 这就是列表生成式. 生成器 通过列表生成式,我们可以直接创建一个列表。但是,受到内存限制,列表容量肯定是有限的。而且,创建一个包含100万个元素的列表,不仅占用很大的存储空间,如果我们仅仅需要访问前面几个元素,那后面绝大多数元素占用的空间都白白浪费了。 所以,如果列表元素可以按照某种算法推算出来,那我们是否可以在循环的过程中不断推算出后续的元素呢?这样就不必创建完整的list,从而节省大量的空间。在Python中,这种一边循环一边计算的机制,称为生成器:generator。 要创建一个generator,有很多种方法。第一种方法很简单,只要把一个列表生成式的[]改成(),就创建了一个generator: L = [x * x for x in range(9)] print(L)#[0, 1, 4, 9, 16, 25, 36, 49, 64] #generator g = (x * x for x in range(9)) print(g)#<generator object <genexpr> at 0x0000020139A5DEB8> 创建L和g的区别仅在于最外层的[]和(),L是一个list,而g是一个generator。 我们可以直接打印出list的每一个元素,但我们怎么打印出generator的每一个元素呢? 如果要一个一个打印出来,可以通过next()函数获得generator的下一个返回值 >>> g = (x * x for x in range(9)) >>> g <generator object <genexpr> at 0x000001FC6C48CFC0> >>> next(g) 0 >>> next(g) 1 >>> next(g) 4 >>> next(g) 9 >>> next(g) 16 >>> next(g) 25 >>> next(g) 36 >>> next(g) 49 >>> next(g) 64 >>> next(g) Traceback (most recent call last): File "<stdin>", line 1, in <module> StopIteration 我们讲过,generator保存的是算法,每次调用next(g),就计算出g的下一个元素的值,直到计算到最后一个元素,没有更多的元素时,抛出StopIteration的错误。 当然,上面这种不断调用next(g)实在是太恶心了,正确的方法是使用for循环,因为generator也是可迭代对象: >>> g = (x * x for x in range(10)) >>> for n in g: ... print(n) ... 0 1 4 9 16 25 36 49 64 81 所以,我们创建了一个generator后,基本上永远不会调用next(),而是通过for循环来迭代它,并且不需要关心StopIteration的错误。 generator非常强大。如果推算的算法比较复杂,用类似列表生成式的for循环无法实现的时候,还可以用函数来实现。 比如,著名的斐波拉契数列(Fibonacci),除第一个和第二个数外,任意一个数都可由前两个数相加得到: 1, 1, 2, 3, 5, 8, 13, 21, 34, ... 斐波拉契数列用列表生成式写不出来,但是,用函数把它打印出来却很容易: def fib(max): n,a,b = 0,0,1 while n<max: print(b) a,b = b,a+b n=n+1 return '-----done-------' 注意:赋值语句 a,b = b,a+b 相当于: t = (b, a + b) # t是一个tuple a = t[0] b = t[1] 但不必显式写出临时变量t就可以赋值。 上面的函数可以输出斐波那契数列的前N个数: 仔细观察,可以看出,fib函数实际上是定义了斐波拉契数列的推算规则,可以从第一个元素开始,推算出后续任意的元素,这种逻辑其实非常类似generator。 也就是说,上面的函数和generator仅一步之遥。要把fib函数变成generator,只需要把print(b)改为yield b就可以了: def fib(max): n,a,b = 0,0,1 while n<max: #print(b) yield b#保存函数的当前状态 a,b = b,a+b n=n+1 return '-----done-------' 这就是定义generator的另一种方法。如果一个函数定义中包含yield关键字,那么这个函数就不再是一个普通函数,而是一个generator: f=fib(10) print(f)#<generator object fib at 0x000001FCA88DDEB8> 这里,最难理解的就是generator和函数的执行流程不一样。函数是顺序执行,遇到return语句或者最后一行函数语句就返回。而变成generator的函数,在每次调用next()的时候执行,遇到yield语句返回,再次执行时从上次返回的yield语句处继续执行。 f=fib(10) print(f) print(f.__next__()) print(f.__next__()) print("=================") print(f.__next__()) print(f.__next__()) print(f.__next__()) print(f.__next__()) print(f.__next__()) print(f.__next__()) print(f.__next__()) print(f.__next__()) #输出 <generator object fib at 0x00000143D19ADEB8> 1 1 ================= 2 3 5 8 13 21 34 55 View Code 在上面fib的例子,我们在循环过程中不断调用yield,就会不断中断。当然要给循环设置一个条件来退出循环,不然就会产生一个无限数列出来。 同样的,把函数改成generator后,我们基本上从来不会用next()来获取下一个返回值,而是直接使用for循环来迭代: for x in fib(10): print(x) 但是用for循环调用generator时,发现拿不到generator的return语句的返回值。如果想要拿到返回值,必须捕获StopIteration错误,返回值包含在StopIteration的value中: while True: try: x = next(f) print('f',x) except StopIteration as e: print("Generation return value:",e.value) break #输出 f 1 f 1 f 2 f 3 f 5 f 8 f 13 f 21 f 34 f 55 Generation return value: -----done------- View Code 还可通过yield实现在单线程的情况下实现并发运算的效果 # yu import time #单线程下的并行效果 def consumer(name): print('%s 准备吃包子' %name) while True: baozi = yield print('包子[%s]来了,被[%s]吃了' %(baozi,name)) c = consumer("Jon") c.__next__() def producer(name): c=consumer('A') c2=consumer('B') c.__next__() c2.__next__() print('开始做包子') for i in range(10): time.sleep(1) print('做了两个包子,一人一个') c.send(i) c2.send(i) producer('young') 通过生成器实现协程并行运算 迭代器 我们已经知道,可以直接作用于for循环的数据类型有以下几种: 一类是集合数据类型,如list、tuple、dict、set、str等; 一类是generator,包括生成器和带yield的generator function。 这些可以直接作用于for循环的对象统称为可迭代对象:Iterable。 可以使用isinstance()判断一个对象是否是Iterable对象: >>> from collections import Iterable >>> isinstance([], Iterable) True >>> isinstance({}, Iterable) True >>> isinstance('abc', Iterable) True >>> isinstance((x for x in range(10)), Iterable) True >>> isinstance(100, Iterable) False 而生成器不但可以作用于for循环,还可以被next()函数不断调用并返回下一个值,直到最后抛出StopIteration错误表示无法继续返回下一个值了。 *可以被next()函数调用并不断返回下一个值的对象称为迭代器:Iterator。 生成器都是Iterator对象,但list、dict、str虽然是Iterable,却不是Iterator。 把list、dict、str等Iterable变成Iterator可以使用iter()函数: >>> isinstance(iter([]), Iterator) True >>> isinstance(iter('abc'), Iterator) True 你可能会问,为什么list、dict、str等数据类型不是Iterator? 这是因为Python的Iterator对象表示的是一个数据流,Iterator对象可以被next()函数调用并不断返回下一个数据,直到没有数据时抛出StopIteration错误。可以把这个数据流看做是一个有序序列,但我们却不能提前知道序列的长度,只能不断通过next()函数实现按需计算下一个数据,所以Iterator的计算是惰性的,只有在需要返回下一个数据时它才会计算。 Iterator甚至可以表示一个无限大的数据流,例如全体自然数。而使用list是永远不可能存储全体自然数的。 小结 凡是可作用于for循环的对象都是Iterable类型; 凡是可作用于next()函数的对象都是Iterator类型,它们表示一个惰性计算的序列; 集合数据类型如list、dict、str等是Iterable但不是Iterator,不过可以通过iter()函数获得一个Iterator对象。 Python的for循环本质上就是通过不断调用next()函数实现的,例如: for x in [1, 2, 3, 4, 5]: pass 实际上完全等价于: # 首先获得Iterator对象: it = iter([1, 2, 3, 4, 5]) # 循环: while True: try: # 获得下一个值: x = next(it) except StopIteration: # 遇到StopIteration就退出循环 break 2.装饰器 装饰器本质上是一个python函数,他可以让其他函数在不需要做任何代码变动的前提下增加额外功能,装饰器的返回值也是一个函数对象.他经常用于有切面需求的场景,比如,插入日志,性能测试,事务处理,缓存,权限校验等场景.装饰器可以抽离大量与函数功能本身无关的雷同代码并继续重用.概括的说 ,抓个时期的作用就是为已经存在的对象添加额外的功能. 简单例子; def foo(): print('i am foo') 现在在之前的基础,加入日志功能: def foo(): print('i am foo') logging.info('foo is running') bar(),bar1()也有类似的需求,怎么做?在写一个logging在bar函数里?为了减少代码的复写率,所以我们重新定义一个函数,专门处理日志. def use_logging(func): logging.warn('%s is running'%func.__name__) func() def bar(): print('i am bar') use_logging(bar) 逻辑上不难理解,但是这样,我们每次都要讲一个函数作为参数传递个use_logging函数.而且这种方式已经破坏原有的代码逻辑结构,之前执行业务逻辑时,执行运行bar(),但是现在不得不改成user_logging(bar),那么有跟好的方法呢?当然,装饰器 简单装饰器: def t1(func): def warpper(*args,**kwargs): start_time = time.time() func() stop_time = time.time() print("the func run time is %s" %(stop_time-start_time)) return warpper def tes1(): time.sleep(3) print("in the test1") tes1 = t1(tes1) tes1() 函数,t1就是装饰器,他把执行真正业务方法的func包裹在函数里面,看起来像tes1被t1装饰了.在这个例子里,函数进入和退出时,被称为一个横切面,这种编程方式被称为面向切面的编程 @符号是装饰器的语法,在定义函数的时候使用,避免子啊一次赋值操作 import time def t1(func): def warpper(*args,**kwargs): start_time = time.time() func() stop_time = time.time() print("the func run time is %s" %(stop_time-start_time)) return warpper @t1 def tes1(): time.sleep(3) print("in the test1") tes1() 通过上诉对比,可以省去tes1 = t1(tes1) 这一句,直接用tes1()即可得到想要的结果,如果我们有其他类似函数,我们可以继续调用装饰器来修饰函数,而不是重复修改函数或者增加新的封装.这样,我们就提高了程序的重复李永兴,病增加了程序的可读性. 装饰器在python使用如此方便都要归因于python的函数能像普通的对象一样作为参数传递给其他函数,可以被赋值给其他变量,可以作为返回值,可以被定义在另外一个函数内 3.json & pickle 数据序列化 用于序列化的两个模块 json,用于字符串 和 python数据类型间进行转换 pickle,用于python特有的类型 和 python的数据类型间进行转换 Json模块提供了四个功能:dumps、dump、loads、load pickle模块提供了四个功能:dumps、dump、loads、load 序列化1 import json def sayhi(name): print("hello,",name) info = { 'name':'yu', 'age':22, #'func':sayhi } f = open("test.text","w") f.write( json.dumps( info) ) info['age']=21 f.write(json.dumps(info)) f.close() 2. import pickle def sayhi(name): print("hello,",name) info = { 'name':'alex', 'age':22, 'func':sayhi } f = open("test.text","wb") #print(json.dumps(info)) pickle.dump(info,f)#f.write( pickle.dumps( info) ) f.close() 反序列化 import pickle def sayhi(name): print('hello2,',name) f = open('test.text','rb') data = pickle.load(f)#data = pickle.loads(f.read()) print(data['func']('yu')) 4.软件目录结构规范 为什么要设计好目录结构? "设计项目目录结构",就和"代码编码风格"一样,属于个人风格问题。对于这种风格上的规范,一直都存在两种态度: 一类同学认为,这种个人风格问题"无关紧要"。理由是能让程序work就好,风格问题根本不是问题。 另一类同学认为,规范化能更好的控制程序结构,让程序具有更高的可读性。 我是比较偏向于后者的,因为我是前一类同学思想行为下的直接受害者。我曾经维护过一个非常不好读的项目,其实现的逻辑并不复杂,但是却耗费了我非常长的时间去理解它想表达的意思。从此我个人对于提高项目可读性、可维护性的要求就很高了。"项目目录结构"其实也是属于"可读性和可维护性"的范畴,我们设计一个层次清晰的目录结构,就是为了达到以下两点: 可读性高: 不熟悉这个项目的代码的人,一眼就能看懂目录结构,知道程序启动脚本是哪个,测试目录在哪儿,配置文件在哪儿等等。从而非常快速的了解这个项目。 可维护性高: 定义好组织规则后,维护者就能很明确地知道,新增的哪个文件和代码应该放在什么目录之下。这个好处是,随着时间的推移,代码/配置的规模增加,项目结构不会混乱,仍然能够组织良好。 所以,我认为,保持一个层次清晰的目录结构是有必要的。更何况组织一个良好的工程目录,其实是一件很简单的事儿。 目录组织方式 关于如何组织一个较好的Python工程目录结构,已经有一些得到了共识的目录结构。在Stackoverflow的这个问题上,能看到大家对Python目录结构的讨论。 这里面说的已经很好了,我也不打算重新造轮子列举各种不同的方式,这里面我说一下我的理解和体会。 假设你的项目名为foo, 我比较建议的最方便快捷目录结构这样就足够了: Foo/ |-- bin/ | |-- foo | |-- foo/ | |-- tests/ | | |-- __init__.py | | |-- test_main.py | | | |-- __init__.py | |-- main.py | |-- docs/ | |-- conf.py | |-- abc.rst | |-- setup.py |-- requirements.txt |-- README 简要解释一下: bin/: 存放项目的一些可执行文件,当然你可以起名script/之类的也行。 foo/: 存放项目的所有源代码。(1) 源代码中的所有模块、包都应该放在此目录。不要置于顶层目录。(2) 其子目录tests/存放单元测试代码; (3) 程序的入口最好命名为main.py。 docs/: 存放一些文档。 setup.py: 安装、部署、打包的脚本。 requirements.txt: 存放软件依赖的外部Python包列表。 README: 项目说明文件。 除此之外,有一些方案给出了更加多的内容。比如LICENSE.txt,ChangeLog.txt文件等,我没有列在这里,因为这些东西主要是项目开源的时候需要用到。如果你想写一个开源软件,目录该如何组织,可以参考这篇文章。 下面,再简单讲一下我对这些目录的理解和个人要求吧。 关于README的内容 这个我觉得是每个项目都应该有的一个文件,目的是能简要描述该项目的信息,让读者快速了解这个项目。 它需要说明以下几个事项: 软件定位,软件的基本功能。 运行代码的方法: 安装环境、启动命令等。 简要的使用说明。 代码目录结构说明,更详细点可以说明软件的基本原理。 常见问题说明。 我觉得有以上几点是比较好的一个README。在软件开发初期,由于开发过程中以上内容可能不明确或者发生变化,并不是一定要在一开始就将所有信息都补全。但是在项目完结的时候,是需要撰写这样的一个文档的。 可以参考Redis源码中Readme的写法,这里面简洁但是清晰的描述了Redis功能和源码结构。 关于requirements.txt和setup.py setup.py 一般来说,用setup.py来管理代码的打包、安装、部署问题。业界标准的写法是用Python流行的打包工具setuptools来管理这些事情。这种方式普遍应用于开源项目中。不过这里的核心思想不是用标准化的工具来解决这些问题,而是说,一个项目一定要有一个安装部署工具,能快速便捷的在一台新机器上将环境装好、代码部署好和将程序运行起来。 这个我是踩过坑的。 我刚开始接触Python写项目的时候,安装环境、部署代码、运行程序这个过程全是手动完成,遇到过以下问题: 安装环境时经常忘了最近又添加了一个新的Python包,结果一到线上运行,程序就出错了。 Python包的版本依赖问题,有时候我们程序中使用的是一个版本的Python包,但是官方的已经是最新的包了,通过手动安装就可能装错了。 如果依赖的包很多的话,一个一个安装这些依赖是很费时的事情。 新同学开始写项目的时候,将程序跑起来非常麻烦,因为可能经常忘了要怎么安装各种依赖。 setup.py可以将这些事情自动化起来,提高效率、减少出错的概率。"复杂的东西自动化,能自动化的东西一定要自动化。"是一个非常好的习惯。 setuptools的文档比较庞大,刚接触的话,可能不太好找到切入点。学习技术的方式就是看他人是怎么用的,可以参考一下Python的一个Web框架,flask是如何写的:setup.py 当然,简单点自己写个安装脚本(deploy.sh)替代setup.py也未尝不可。 requirements.txt 这个文件存在的目的是: 方便开发者维护软件的包依赖。将开发过程中新增的包添加进这个列表中,避免在setup.py安装依赖时漏掉软件包。 方便读者明确项目使用了哪些Python包。 这个文件的格式是每一行包含一个包依赖的说明,通常是flask>=0.10这种格式,要求是这个格式能被pip识别,这样就可以简单的通过pip install -r requirements.txt来把所有Python包依赖都装好了。具体格式说明:点这里。 关于配置文件的使用方法 注意,在上面的目录结构中,没有将conf.py放在源码目录下,而是放在docs/目录下。 很多项目对配置文件的使用做法是: 配置文件写在一个或多个python文件中,比如此处的conf.py。 项目中哪个模块用到这个配置文件就直接通过import conf这种形式来在代码中使用配置。 这种做法我不太赞同: 这让单元测试变得困难(因为模块内部依赖了外部配置) 另一方面配置文件作为用户控制程序的接口,应当可以由用户自由指定该文件的路径。 程序组件可复用性太差,因为这种贯穿所有模块的代码硬编码方式,使得大部分模块都依赖conf.py这个文件。 所以,我认为配置的使用,更好的方式是, 模块的配置都是可以灵活配置的,不受外部配置文件的影响。 程序的配置也是可以灵活控制的。 能够佐证这个思想的是,用过nginx和mysql的同学都知道,nginx、mysql这些程序都可以自由的指定用户配置。 所以,不应当在代码中直接import conf来使用配置文件。上面目录结构中的conf.py,是给出的一个配置样例,不是在写死在程序中直接引用的配置文件。可以通过给main.py启动参数指定配置路径的方式来让程序读取配置内容。当然,这里的conf.py你可以换个类似的名字,比如settings.py。或者你也可以使用其他格式的内容来编写配置文件,比如settings.yaml之类的。
优秀的个人博客,低调大师

Google Developer Day India 之行

2017.12月1-2号,google开发者大会首次在印度召开,地点是班加罗尔国际展览中心,大会的内容主要以“开发者”为目标用户进行设计的。 大会的安排主要分为3块:主会场、demo展示会场和交流休息区。主会场主要将google对于印度的布局战略进行了介绍,重点关注印度的本地化,和基于此推广众多技术、平台。技术方面,涉及PWA、Android、Firebase、TenseFlow、社区建设等,着重PWA,和机器学习方面的内容。 这次去参加GDDIndia,一方面收到google的邀请,邀请我们在PWA上表示一下支持的态度;另一方面,了解google在印度推什么技术,PWA的在印度的落地情况。下面介绍下主会场的宣讲内容,重点介绍PWA的内容。 Keynote 第一天 Keynote Keynote的演讲者是Pankaj Gupt

优秀的个人博客,低调大师

day4 Activity相关

什么是Activity? 与用户交互的接口,提供用户触摸,点击,滑动的界面。Android中的activity全都归属于task管理 。task 是多个 activity 的集合,这些 activity 按照启动顺序排队存入一个栈(即“back stack”)。android默认会为每个App维持一个task来存放该app的所有activity,task的默认name为该app的packagename。 四种状态? running 活动状态,也是activity处于栈顶的状态,这时用户触摸屏幕,activity会响应事件 paused activity失去焦点或者被比如对话框覆盖时的状态,这时activity只是失去焦点,所有的成员变量和状态都还在 stopped 被其它Activity完全覆盖 killed activity被销毁 Activity生命周期,常见类型概述 Activity生命周期 第一想到的是那副经典的生命周期图,怎么叙述呢。Activity可以理解为一个界面,为了便于界面编程,安卓设计者赋予了Activity生命周期的概念,从产生到消亡,我们开发者可以在生命周期的对应阶段做相应处理,那么怎么做处理呢?就是Activity每到一个生命周期的阶段,就会回调对应的一个方法,比如创建时回调onCreate()。然后我简单介绍下Activity的一个完整的生命周期是怎样的顺序: 首先创建时回调onCreate(),这里可以进行一些初始化操作,比如设置布局资源,然后onStart(),表明Acitivity正在启动,activity已处于可见状态,但是还没有处于前台显示的,就是用户还不能在此Activity进行交互。接着是onResume(),这个调用后会处于前台可见状态,用户可进行交互。 点击Home键回到主界面(Activity不可见),会让activity退居到后台,这时onPause()会被调用,一般情况下,onStop()会在onPause()执行后调用,这时候表明整个Activity被停止或被完全覆盖,因为这个时候activity是不可见得,完全处于后台运行,另外当调用onPause后,如果系统内存吃紧,activity是有可能被回收的。 当我们再次回到原Activity时,onRestart()会调用,表示这个Activity正在重新启动,从桌面回到APP,,onRestart()调用完后会调用onStart(),activity回到可见状态,和前面一样之后调用onResume,activity回到前台可见可交互状态。 退出当前Activity时->onPause() -> onStop() -> onDestroy(),onDestroy会在activity彻底销毁前调用 anroid 进程优先级 前台:处于前台和用户交互的activity或者和前台进程Activity绑定的Service所处的进程 可见:处于可见,但不处于前台,用户不可以交互的进程 服务:后台开启的Service服务 后台:点击了Home,前台进程变为后天进程 空 activity被回收的状态和信息保存和恢复过程 onSaveInstanceState方法在Activity可能被回收之前调用,用来保存自己的状态和信息,以便回收后重建时恢复数据(在onCreate()或onRestoreInstanceState()中恢复),旋转屏幕重建Activity会调用此方法,而且要调用的话就一定发生在onStop方法之前,但并不保证发生在onPause的前面还是后面。onRestoreInstanceState方法这个方法在onStart 和 onPostCreate之间调用,在onCreate中也可以状态恢复,但有时候需要所有布局初始化完成后再恢复状态。 Activity的启动模式,每个启动模式的不同点是什么? 启动模式简单的说就是定义Activity实例与tack的关联方式 为什么定义启动模式: 让某些Activity启动一个新的task 让activity复用,而不是重新创建一个实例 定义方式: 使用manitest文件,通过Activity的 android:launchMode="standard"属性 intent设置:靠Flag FLAG_ACTIVITY_NEW_TASK:指定为singleTask模式 FLAG_ACTIVITY_SINGLE_TOP:指定为singleTop模式 FLAG_ACTIVITY_CLEAR_TOP:标识此Activity,当它启动时,在同一个任务栈中位于它上面的Activity都要出栈 FLAG_ACTIVITY_EXCLUDE_FROM_RECENTS:标识此Activity不会出现在历史Activity的列表中 哪些启动模式: standard 标准模式:总会为activity创建一个新的实例,并将该实例添加到当前task中,这种方式不会启动新的Task,只是将新的 Activity添加到原有的Task中。 singleTop:栈顶复用模式,这种模式下,如果新Activity已经位于任务栈的栈顶,那么此Activity不会被重新创建,同时他的onNewIntent方法会被回调。 singleTask:栈内复用模式 singleInstance:单实例模式,此种模式的Activity只能单独的位于一个任务栈中 如何在非活动Activity内存不足时被系统销毁前保存数据? Activity中提供了一个方法:onSavedInstanceState(Bundle obj).当系统销毁一个Activity时,会将Activity的状态信息已键值对形式存放在bundle对象中. 第一次启动Activity时,这个bundle对象是空的,null.如果Activity被系统销毁了,然后用户要回退回去看的话,系统会调用这个Activity的onCreate方法,并把bundle对象传递过去. 横竖屏切换时,Activity的生命周期会有那些变化? 1、不设置Activity的android:configChanges时,切屏会重新调用各个生命周期,切横屏时会执行一次,切竖屏时会执行两次 2、设置Activity的android:configChanges=”orientation”时,切屏还是会重新调用各个生命周期,切横、竖屏时只会执行一次 3、设置Activity的android:configChanges=”orientation|keyboardHidden”时,切屏不会重新调用各个生命周期,只会执行onConfigurationChanged方法 Activity如何设置为Dialog样式? 在AndroidManifest.xml 中定义Activity的地方一句话android:theme=”@android:style/Theme.Dialog”或android:theme=”@android:style/Theme.Translucent”就变成半透明的,也可以在onCreate代码中设置主题。 Context,Application,Activity的区别与联系? Context:提供应用环境全局信息的接口,并且这个接口是由抽象类实现的,它的执行被android系统所提供,允许我们获取以应用为特征的资源和类型,同时启动应用级的操作,如启动Activity,broadcasting和接收intent。 Application-Context的生命周期与Application的生命周期相关,context随着Application的销毁而销毁,伴随application的一生,与Activity的生面周期无关。 Activity-Context:这个Context的生命周期是和得到它的引用的Activity一样长,如果这个Activity结束了,那么,这个Context也会得到释放 使用context的时候,要小心内存泄漏,防止内存泄漏 不要让生命周期长的对象引用Activity context,即保证引用activity的对象要与activity本身生命周期是一样的 对于生命周期长的对象,可以使用Application-context 避免非静态的内部类,尽量使用静态类,避免生命周期问题,注意内部类对外部类对象引用导致的生命周期的变化。 Activity之间进行数据传递的方式有哪些? intent传递数据 先把数据保存到本地,然后在下一个Activity中从本地获取,存储方式可以是四种持久化存储方式:SharePreferences,SQlite,Content Provider和File 使用EventBus类似的事件总线 使用广播 如何退出Activity?如何安全退出已调用多个Activity的Application? 记录打开的Activity:每打开一个Activity,就记录下来,在需要退出时,关闭每一个Activity,Activity记录可在自定义的Application执行,Application可实现一个接口,该接口会返回相应启动或销毁的Activity实例 在需要结束应用时,发送一个特定的广播,每一个Activity收到广播后关闭 通过intent的flag来实现,根据应用界面的交互场景利用Activity的启动模式来设计。

优秀的个人博客,低调大师

使用workbuddy体验day1

使用workbuddy体验打开第一天,先来报个到,以后持续输出workbuddy体检。 ### **今日完成了新手任务:领取一只 Buddy** #### **任务要求** 新建 1 个任务并发起对话,完成后奖励 300Credits+8 能量,解锁「命中注定」徽章。 #### **操作步骤** 1. 下载安装 WorkBuddy 客户端,使用和网页端一致的微信 / 手机号登录; 1. 客户端左上角点击「+ 新建任务」,任意选择办公 / 代码 / 设计创意模式; 1. 输入任意一句话发送对话,例如:帮我写一段简单 JS 代码; 1. 对话生成完成后,回到网页成长计划页面,任务自动标记完成,领取奖励。#workbuddy

优秀的个人博客,低调大师

day16_ajax学习笔记

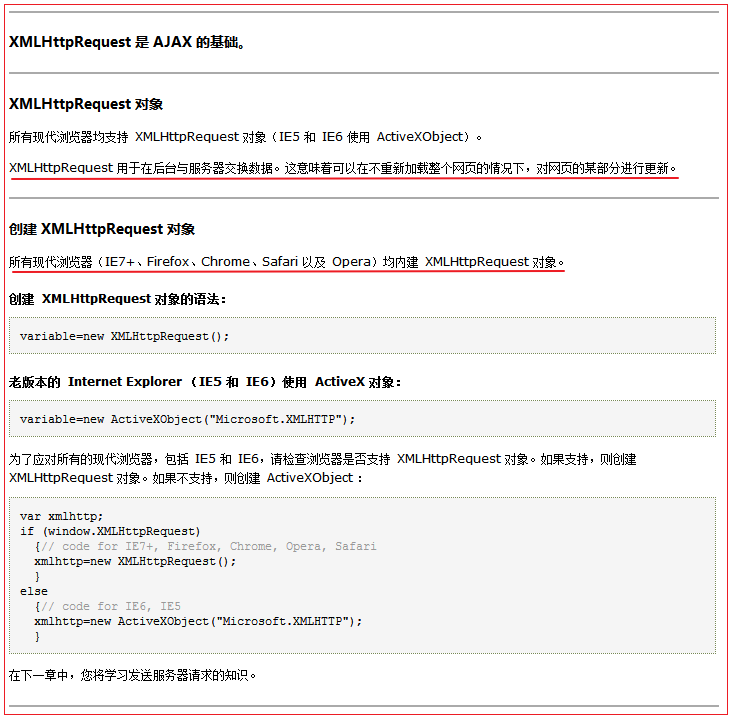
一、什么是Ajax Ajax( Asynchronous JavaScript And XML ):指异步 JavaScript 及 XML。不是一种新的编程语言 ,而是一种用于创建更好更快以及交互性更强的 Web 应用程序的技术,是基于JavaScript、XML、HTML、CSS的新用法。 Ajax:只刷新局部页面的技术。包括以下几种技术: JavaScript:更新局部的网页。 XML:一般用于请求数据和响应数据的封装。 XMLHttpRequest对象:发送请求到服务器并获得返回结果(浏览器内核创建的)。 CSS:美化页面样式。 异步:发送请求后不等待返回结果,由回调函数处理结果。 JavaScript 中 XMLHttpRequest对象是整个Ajax技术的核心,它提供了异步发送请求的能力。 构造方法: 不同浏览器,甚至相同浏览器的不同版本,获取该对象的方式是不同的。 var xmlhttp;if (window.XMLHttpRequest) { // code for IE7+, Firefox, Chrome, Opera, Safari xmlhttp = new XMLHttpRequest();} else { // code for IE6, IE5 xmlhttp = new ActiveXObject("Microsoft.XMLHTTP");} 方法: open() 该方法有3个参数,"get|post","url?name=tom","true|false",默认为true。 send() 发送请求,可以带参数 或 null。 setRequestHeader() 设置请求消息头。 属性: readyState 类型为short,只读 responseText 类型为String,只读 responseXML 类型为Document,只读(一般不用) status 类型为short,只读 事件处理器: onreadystatechange 二、常用方法 open(method, URL, async) 建立与服务器的连接 method参数:指请求的HTTP方法,典型的值是GET或POST URL参数:指请求的地址 async参数:指是否使用异步请求,其值为true或false,默认值是true,一般这个参数不写 send(content) 发送请求 content参数:指请求的参数 setRequestHeader(header, value) 设置请求的头信息 三、常用属性 onreadystatechange: 指定回调函数 readyState: XMLHttpRequest的状态信息(客户端:浏览器) 就绪状态码 说明 0 XMLHttpRequest对象没有完成初始化,即:刚刚创建。 1 XMLHttpRequest对象开始发送请求,即:调用了open方法,但还没有调用send方法。请求还没有发出。 2 XMLHttpRequest对象的请求发送完成,即:send方法已经调用,数据已经提交到服务器,但没有任何响应。 3 XMLHttpRequest对象开始读取响应,还没有结束,即:收到了所有的响应消息头,但正文还没有完全收到。 4 XMLHttpRequest对象读取响应结束,即:一切都收到了。 status: HTTP的状态码(服务器端) 状态码 说明 200 服务器响应正常 400 无法找到请求的资源 403 没有访问权限 500 服务器内部错误 responseText: 获得响应的文本内容 responseXML: 获得响应的XML文档对象 documednt 注:客户端就绪状态码是4,且服务端状态码是200,才可以处理服务器数据。 示例代码如下: <%@ page language="java" contentType="text/html; charset=UTF-8"pageEncoding="UTF-8"%><!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd"><html><head><meta http-equiv="Content-Type" content="text/html; charset=UTF-8"><script type="text/javascript" src="${ pageContext.request.contextPath }/js/myJS.js"></script><title>Insert title here</title></head><script type="text/javascript">// 1、获取XMLHttpRequest对象var req = getXMLHttpRequest();// 4、处理响应结果 req.onreadystatechange = function() {// alert(req.readyState); // 查看客户器端就绪状态码if (req.readyState == 4) {// alert(req.status); // 查看服务器端响应状态码if (req.status == 200) { // 说明服务器响应一切正常 alert(req.responseText); } } }// 2、建立一个连接 req.open("get", "${ pageContext.request.contextPath }/servlet/servletDemo1");// 3、发送请求 req.send(null);</script><body></body></html> 使用Ajax验证用户名是否存在的实现步骤: 使用文本框的onblur事件(失去焦点事件) 使用Ajax技术实现异步交互a) 获取用户名a) 创建 XMLHttpRequest 对象b) 处理响应结果,创建回调函数,根据响应状态动态更新页面c) 建立一个连接d) 发送请求 示例代码如下: <%@ page language="java" contentType="text/html; charset=UTF-8"pageEncoding="UTF-8"%><!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd"><html><head><meta http-equiv="Content-Type" content="text/html; charset=UTF-8"><script type="text/javascript" src="${ pageContext.request.contextPath }/js/myJS.js"></script><title>Insert title here</title><script type="text/javascript">function ckName() {// 获取用户名对象var name = document.getElementsByTagName("input")[0];// 创建XMLHttpRequest对象var xhr = getXMLHttpRequest();// 处理响应结果,创建回调函数,根据响应状态动态更新页面 xhr.onreadystatechange = function() {if (xhr.readyState == 4) { // 说明客户端请求一切正常if (xhr.status == 200) { // 说明服务器响应一切正常// alert(xhr.responseText); // 得到响应结果var msg = document.getElementById("msg");if (xhr.responseText == "true") {// msg.innerText = "用户名已存在"; msg.innerHTML = "<font color='red'>该用户名已存在</font>"; } else { msg.innerHTML = "<font color='green'>该用户名可以使用</font>"; } } } } // 建立一个连接 xhr.open("get", "${ pageContext.request.contextPath }/servlet/ckNameServlet?name=" + name.value + "&time=" + new Date().getTime());// 发送请求 xhr.send(null); }</script></head><body> 用户名:<input type="text" name="userName" onblur="ckName()"/><span id="msg" ></span></br> 密码:<input type="password" name="pwd" /></br></body></html> 验证用户名是否存在改进代码版本(该种方式,使得网页的标签很干净,感觉不到调用事件了): <%@ page language="java" contentType="text/html; charset=UTF-8"pageEncoding="UTF-8"%><!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd"><html><head><meta http-equiv="Content-Type" content="text/html; charset=UTF-8"><script type="text/javascript" src="${ pageContext.request.contextPath }/js/myJS.js"></script><title>Insert title here</title><script type="text/javascript">window.onload = function() {var nameElement = document.getElementsByName("userName")[0]; nameElement.onblur = function() {var name = this.value; // this等价于nameElement// 创建XMLHttpRequest对象var xhr = getXMLHttpRequest();// 处理响应结果,创建回调函数,根据响应状态动态更新页面 xhr.onreadystatechange = function() {if (xhr.readyState == 4) { // 说明客户端请求一切正常if (xhr.status == 200) { // 说明服务器响应一切正常// alert(xhr.responseText); // 得到响应结果var msg = document.getElementById("msg");if (xhr.responseText == "true") {// msg.innerText = "用户名已存在"; msg.innerHTML = "<font color='red'>该用户名已存在</font>"; } else { msg.innerHTML = "<font color='green'>该用户名可以使用</font>"; } } } } // 建立一个连接 xhr.open("get", "${pageContext.request.contextPath }/servlet/ckNameServlet?name=" + name + "&time=" + new Date().getTime());// 发送请求 xhr.send(null); } }</script></head><body> 用户名:<input type="text" name="userName" /><span id="msg" ></span></br> 密码:<input type="password" name="pwd" /></br></body></html> 四、案例1:实现邮箱验证 my.js // 获取XMLHttpRequest对象function getXMLHttpRequest() {var xmlhttp;if (window.XMLHttpRequest) { // code for IE7+, Firefox, Chrome, Opera, Safari xmlhttp = new XMLHttpRequest(); } else { // code for IE6, IE5 xmlhttp = new ActiveXObject("Microsoft.XMLHTTP"); }return xmlhttp;} register.jsp <%@ page language="java" import="java.util.*" pageEncoding="UTF-8"%><!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN"><html><script type="text/javascript" src="${pageContext.request.contextPath }/js/my.js"></script><head><title>bookStore注册页面</title><%--导入css --%><link rel="stylesheet" href="css/main.css" type="text/css" /><script type="text/javascript">function changeImage() {document.getElementById("img").src = "${pageContext.request.contextPath}/imageCode?time=" + new Date().getTime(); }// 验证邮箱是否存在function ckEmail() {// 得到邮箱对象var email = document.getElementByName("email")[0];// 创建XMLHttpRequest对象var xhr = getXMLHttpRequest();// 处理响应结果,创建回调函数,根据响应状态动态更新页面 xhr.onreadystatechange = function() {if (xhr.readyState == 4) {if (xhr.status == 200) { alert(xhr.responseText); // 得到响应结果// 得到邮箱的font标签var font = document.getElementsByTagName("font")[0];if (xhr.responseText == "true") { font.innerHTML = "此邮箱已被使用"; font.style.color = "red"; } else { font.innerHTML = "此邮箱可以使用"; font.style.color = "green"; } } } }// 建立一个连接 xhr.open("get", "${pageContext.request.contextPath}/servlet/ckEmailServlet?email=" + email.value + "&time=" + new Date().getTime());// 发送请求 xhr.send(null); }</script></head><body class="main"><%@include file="head.jsp"%><%--导入头 --%><%@include file="menu_search.jsp"%><%--导入导航条与搜索 --%><div id="divcontent"><form action="${pageContext.request.contextPath}/register.jsp"method="post"><table width="850px" border="0" cellspacing="0"><tr><td style="padding:30px"><h1>新会员注册</h1><table width="70%" border="0" cellspacing="2" class="upline"><tr><td style="text-align:right; width:20%">会员邮箱:</td><td style="width:40%"><input type="text" class="textinput"name="email" onblur="ckEmail()"/></td><td><font color="#999999">请输入有效的邮箱地址</font></td></tr>.......</body></html> CkEmailServlet.java package com.itheima.web.servlet;import java.io.IOException;import java.io.PrintWriter;import javax.servlet.ServletException;import javax.servlet.http.HttpServlet;import javax.servlet.http.HttpServletRequest;import javax.servlet.http.HttpServletResponse;public class CkEmailServlet extends HttpServlet {public void doGet(HttpServletRequest request, HttpServletResponse response)throws ServletException, IOException { PrintWriter out = response.getWriter(); String email = request.getParameter("email");if ("tom@163.com".equals(email)) { out.print(true); } else { out.print(false); } }public void doPost(HttpServletRequest request, HttpServletResponse response)throws ServletException, IOException { doGet(request, response); }} 五、案例2:搜索框显示数据 编写显示数据的容器div 实现ajax响应数据// 创建XMLHttpRequest对象// 通过事件调用回调函数处理响应结果// 创建一个服务器连接// 发送请求 示例代码如下: <%@ page language="java" import="java.util.*" pageEncoding="UTF-8"%><script type="text/javascript"src="${pageContext.request.contextPath}/js/my.js"></script><script type="text/javascript">window.onload = function() {// 得到搜索框对象var searchElement = document.getElementById("name");// 得到父div元素对象var div = document.getElementById("context1");// 给文件框注册按键弹起事件 searchElement.onkeyup = function() { // 先获取文本框的值var name = this.value;// 如果文本框没有数据时,就把父div隐藏,且不向服务器发送请求if (name == "") { div.style.display = "none";return; }// 获得XMLHttpRequest对象var xhr = getXMLHttpRequest();// 处理结果 xhr.onreadystatechange = function() {if (xhr.readyState == 4) { // 客户端请求一 切正常if (xhr.status == 200) { // 服务器响应一切正常var str = xhr.responseText; // 得到服务器返回的数据var ss = str.split(","); // 把字符串 1001,1002,1003 切成数组var childDivs = "";// 循环把数据放入子div中for (var i = 0; i < ss.length; i++) { childDivs += "<div onclick='writeText(this)' onmouseover='changeBackground_over(this)' onmouseout='changeBackground_out(this)'>" + ss[i] + "</div>"; // 把数组中的每个元素放到子div中 } div.innerHTML = childDivs; // 把多个子div(childDivs)放入列表父div中 div.style.display = "block"; // 把列表隐藏 } } } xhr.open("get", "${ pageContext.request.contextPath}/servlet/searchBookAJAXServlet?name=" + name + "&time=" + new Date().getTime()); xhr.send(null); } }// 鼠标悬浮在子div时,改变背景色function changeBackground_over(div) { div.style.backgroundColor = "gray"; // backgroundColor js中属性的写法,background-color css中属性的写法 }// 鼠标离开子div时,恢复背景色function changeBackground_out(div) { div.style.backgroundColor = ""; }// 填充文本到搜索框function writeText(div) {// 先得到搜索框var searchElement = document.getElementById("name");// 把div中的文本添加到搜索框中 searchElement.value = div.innerHTML; // 把父div(context1)隐藏 div.parentNode.style.display = "none"; }</script><div id="divmenu"><a href="${pageContext.request.contextPath}/showProductByPage?category=文学">文学</a><a href="${pageContext.request.contextPath}/showProductByPage?category=生活">生活</a><a href="${pageContext.request.contextPath}/showProductByPage?category=计算机">计算机</a><a href="${pageContext.request.contextPath}/showProductByPage?category=外语">外语</a><a href="${pageContext.request.contextPath}/showProductByPage?category=经营">经管</a><a href="${pageContext.request.contextPath}/showProductByPage?category=励志">励志</a><a href="${pageContext.request.contextPath}/showProductByPage?category=社科">社科</a><a href="${pageContext.request.contextPath}/showProductByPage?category=学术">学术</a><a href="${pageContext.request.contextPath}/showProductByPage?category=少儿">少儿</a><a href="${pageContext.request.contextPath}/showProductByPage?category=艺术">艺术</a><a href="${pageContext.request.contextPath}/showProductByPage?category=原版">原版</a><a href="${pageContext.request.contextPath}/showProductByPage?category=科技">科技</a><a href="${pageContext.request.contextPath}/showProductByPage?category=考试">考试</a><a href="${pageContext.request.contextPath}/showProductByPage?category=生活百科">生活百科</a><a href="${pageContext.request.contextPath}/showProductByPage" style="color:#FFFF00">全部商品目录</a></div><div id="divsearch"><form action="${pageContext.request.contextPath}/findProductBySearch"method="post"><table width="100%" border="0" cellspacing="0" ><tr><td style="text-align:right; padding-right:220px"> Search <input type="text" name="name" class="inputtable" id="name" autocomplete="on"/> <!-- 解决中文提交的问题 --><input type="image" src="images/serchbutton.gif"border="0" style="margin-bottom:-4px"></td></tr></table></form></div><div id="context1" style="display:block; border:1px solid red; background-color:white; width:128px; position:absolute; left:860px; top:135px;"></div> 六、json对象的学习 示例代码如下:json.jsp <%@ page language="java" contentType="text/html; charset=UTF-8"pageEncoding="UTF-8"%><!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd"><html><head><meta http-equiv="Content-Type" content="text/html; charset=UTF-8"><title>Insert title here</title></head><body><script type="text/javascript">/* json对象有些像java的普通类对象,java是纯面向对象,javascript是基于对象和事件的脚本语言。 // java语言创建的类 public class Person() { private String name; private int age; public void show() { } } *//* // js语言创建的类,大小写均可,一般小写,为了更像一个类,这时我们大写 function Person() { var name = "tom"; // 声明一个局部变量 this.age = 10; // 声明一个成员变量 this.show = function() { alert(name); } } var p = new Person(); document.write(p.name); document.write(p.age); p.show(); */var pp = [100, true, 12.34]; // 这是一个数组var pp = { name:"tom", age:18, show:function() { alert("hello json"); } }; // 这是一个json对象document.write(pp.name);document.write(pp.age); pp.show();var ppp = [ { name:"tom", age:18 }, { name:"lune", age:25 } ];document.write(ppp[1].name)</script></body></html> JsonTest.java package com.itheima.json;import java.sql.SQLException;import java.util.ArrayList;import java.util.List;import org.apache.commons.dbutils.QueryRunner;import org.apache.commons.dbutils.handlers.BeanListHandler;import org.junit.Test;import com.itheima.domain.Book;import com.itheima.util.C3P0Util;import net.sf.json.JSONArray;import net.sf.json.JSONObject;import net.sf.json.JsonConfig;public class JsonTest { @Test // 使用 JSONObject对象封装对象数据public void test1() { Book b = new Book(); b.setId("10001"); b.setName("西游记"); b.setPnum(20); String s = JSONObject.fromObject(b).toString(); System.out.println(s); } @Test // 使用 JSONArray对象封装 List<Book>对象数据public void test2() throws SQLException { List<Book> list = new ArrayList<Book>(); Book b1 = new Book(); b1.setId("10001"); b1.setName("西游记"); b1.setPnum(20); Book b2 = new Book(); b2.setId("10002"); b2.setName("三国演义"); b2.setPnum(30); Book b3 = new Book(); b3.setId("10003"); b3.setName("水浒传"); b3.setPnum(40);list.add(b1);list.add(b2);list.add(b3); String s = JSONArray.fromObject(list).toString(); System.out.println(s); } @Test // 使用 JSONArray对象封装 List<Book>对象数据 + 使用 JsonConfig对象过滤掉不想要的数据public void test3() throws SQLException { QueryRunner qr = new QueryRunner(C3P0Util.getDataSource()); List<Book> list = qr.query("select * from book", new BeanListHandler<Book>(Book.class)); JsonConfig jc = new JsonConfig(); jc.setExcludes(new String[]{"pnum", "description", "category", "id"}); String s = JSONArray.fromObject(list, jc).toString(); System.out.println(s); }} 我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

WebRTCon 2018 Day Two精彩回顾

为期两天的WebRTCon 2018落下帷幕,本文带您回顾大会第二天的精彩瞬间。大会第一天的回顾请点这里。本次大会的PPT、视频和演讲实录将会在近期发布,请关注LiveVideoStack微信公众号。LiveVideoStackCon 2018将于10月19-20日在北京举行,这是一次多媒体开发者的盛会,现已开启讲师招募渠道。如果你在某一领域独当一面,欢迎自荐成为大会的讲师,请联系 speaker@livevideostack.com。 由LiveVideoStack音视频技术社区出品的WebRTCon 2018落下帷幕,在第二天的大会中,6个专题20位讲师带来了各自的分享,有近300名的多媒体开发工程师、技术负责人、产品负责人及高端行业用户深度参与。WebRTCon 2018聚焦WebRTC及其周边技术生态,覆盖教育、娱乐、医疗、安防、交通、制造、旅游、电商、金融、社交、游戏、智能设备、IC等行业领域。 VIP晚宴:嘉宾之间参与提问与讨论 “讲师问诊”环节,参会者与嘉宾讨论 参与展台活动的参会者 会场中 展台 此外,主办方与赞助商还提供了许多互动环节,三体云联和网易云信送出了产品代金券,哒哒英语准备了原版刊物礼包,LiveVideoStack针对参会者做了问卷调查和展台探秘与礼品兑换。 20日上午有3个专题同时进行,WebRTC与前端,新技术跨界和解决方案: 《Web前端新兴技术在音视频领域的应用》 TutorABC 大前端负责人 和君 《WebRTC 在线教育场景的实践优化之道》 腾讯 前端工程师 郭锋棉 《触宝电话如何改善通话质量》 触宝科技 音频技术专家 吴威麒 《VR视频技术演进及优酷VR技术实践》 优酷 VR技术专家 盛骁杰 《探索高并发视频会议服务》 华创视讯 研发主管 孙俊伟 《超大规模硬件加速集群助力提升WebRTC用户体验》 Aupera傲睿智存 CTO 周正宁 《实时音视频技术赋能传统行业》 三体云联 产品副总裁 崔文秀 《Animoji动态表情的技术实现》 相芯科技 图形引擎负责人 蔡锐涛 20日下午,共进行了3个专题WebRTC与Codec,WebRTC服务端开发,行业应用专场: 《ABC时代的视频编码优化之“道”》 上海交通大学 图像通信与网络工程研究所副所长 宋利 《AVS2-视频编码标准的新选择》 北京大学 教授 王荣刚 《WebRTC之H.264/265硬件编解码定制与性能优化》 英特尔 实时通信客户端架构师 邱建林 《精析网易NRTC的WebRTC网关服务器技术架构》 网易云信多媒体资深技术架构师 吴桐 《WebRTC网关服务器:开源技术 vs 自行研发》 即构科技 音视频技术资深架构师 黄开宁 《打造自己的WebRTC服务器》 PP云 高级技术经理 王立飞 《低延迟音视频传输技术在直播领域的应用》 陌陌 视频流媒体技术负责人 吴涛 《七牛 WebRTC 连麦服务端架构实践》 七牛 直播云流媒体负责人 谢然 LiveVideoStackCon 2018讲师招募 LiveVideoStackCon 2018是音视频技术领域的综合技术大会,今年是在10月19-20日在北京举行。大会共设立16个专题,预计邀请超过80位技术专家。如果你在某一领域独当一面,欢迎申请成为LiveVideoStackCon 2018的讲师,让你的经验帮到更多人,你可以通过speaker@livevideostack.com 提交演讲信息。了解大会更多详情,请点击『阅读原文』访问LiveVideoStackCon 2018官网,即刻享受6折优惠。

优秀的个人博客,低调大师

WebRTCon 2018 Day One精彩回顾

第一天的WebRTCon 2018有哪些高光时刻?更多精彩瞬间,演讲资料和视频将会逐步整理并在LiveVideoStack公众号发布。 5月20日,由LiveVideoStack音视频技术社区出品的WebRTCon 2018进入第二天。在第一天的大会中,4个专题15位讲师带来了各自的分享,有近300名的多媒体开发工程师、技术负责人、产品负责人及高端行业用户深度参与。WebRTCon 2018聚焦WebRTC及其周边技术生态,覆盖教育、娱乐、医疗、安防、交通、制造、旅游、电商、金融、社交、游戏、智能设备、IC等行业领域。 TutorABC研发总监董海冰作为大会出品人的代表做致辞分享—— 《WebRTC-天涯若比邻》 上午的三场主题演讲都和WebRTC相关,三位讲师都来自Google,他们分别从WebRTC产品与功能演进,下一代Codec——AV1以及VP9与WebRTC结合优化的角度进行了分享。 《WebRTC: Enabling Real-Time Communications on the Web and Mobile》 Google PM of WebRTC Huib Kleinhout 在WebRTC 1.0版定稿后,WebRTC便迎来了真正的快速发展期。 《AV1 - 新一代开放视频编解标准》 Google 软件工程师 Zoe Liu 由于免专利费、开源,并获得了众多巨头公司的支持(包括第一个加入AOM联盟的本土公司爱奇艺),AV1在面对复杂专利授权的HEVC显得胸有成竹。虽然最快到2018年底,AV1就可以在Firefox、Chorme中得到使用,但能支持AV1硬件解码的产品至少要在24个月以后才能面世。 《Optimizations and Features in VP9 for Real-Time Encoding》 Google 软件工程师 姜健 在AV1硬件成熟至少还有24个月的背景下,WebRTC与VP9配合是更加成熟和务实的选择。Google也意识到这一点,必须通过VP9拿出可落地的方案。 同是Google的开源项目,VP9与WebRTC深度结合自然不意外。 VP9在ARM平台上已经有了大幅性能提升。 19日下午同时进行了3个技术专题,WebRTC深度开发,测试监控与服务保障,娱乐多媒体开发应用实践。 《语音通信QoS优化实践》 腾讯音视频实验室高级工程师 张轲 《自动视频检测测试体系实践》 英特尔CS for WebRTC客户端测试架构负责人 张琰彬 《AI赋能的内容安全技术实践》 网易云易盾 CTO 朱浩齐 朱浩齐从策略,技术,产品三个方面,介绍网易在内容安全系统构建方面的实践经验;包括并不限于如何建立对有害信息精细明确的审核体系和应急响应机制;以及如何采用基于自然语言、深度学习技术的智能识别技术改造传统内容识别服务,保证对文字、图片、语音,特别是直播视频内容的全面精准覆盖。 《体育赛事频道化直播关键技术》 PP云 资深架构师 朱明亮 VIP晚宴 一天的学习、交流之后,是时候让大脑放松社交起来了。VIP购票者与大会联席主席、出品人和讲师一起,享受难得的放松时间。 WebRTCon 2018精彩继续。 LiveVideoStackCon 2018讲师招募 LiveVideoStackCon 2018是音视频技术领域的综合技术大会,今年是在10月19-20日在北京举行。大会共设立16个专题,预计邀请超过80位技术专家。如果你在某一领域独当一面,欢迎申请成为LiveVideoStackCon 2018的讲师,让你的经验帮到更多人,你可以通过speaker@livevideostack.com 提交演讲信息。了解大会更多详情,请点击『阅读原文』访问LiveVideoStackCon 2018官网,即刻享受6折优惠。

优秀的个人博客,低调大师

JavaScript学习记录day1

JavaScritps 是什么? JavaScript一种直译式脚本语言,是一种动态类型、弱类型、基于原型的语言,内置支持类型。它的解释器被称为JavaScript引擎,为浏览器的一部分,广泛用于客户端的脚本语言,最早是在HTML(标准通用标记语言下的一个应用)网页上使用,用来给HTML网页增加动态功能。 在Web世界里,只有JavaScript能跨平台、跨浏览器驱动网页,与用户交互。 编写JS的流程 布局:HTML+CSS 属性:确定要修改哪些属性 事件:确定用户做哪些操作(产品设计) 编写JS:在事件中,用JS来修改页面元素的样式 1. 快速入门 JavaScript代码可以直接嵌在网页的任何地方,不过通常我们都把JavaScript代码放到<head>中: <!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8"> <title>我的第一个JS</title> <script> function myFirstScript() { alert("Hello word!"); } myFirstScript(); </script></head><body></body></html> 由<script>...</script>包含的代码就是JavaScript代码,它将直接被浏览器执行。 第二种方法是把JavaScript代码放到一个单独的.js文件,然后在HTML中通过引入这个文件: <html><head> <script src="/static/js/abc.js"></script></head><body> ...</body></html> 这样,/static/js/abc.js就会被浏览器执行。 把JavaScript代码放入一个单独的.js文件中更利于维护代码,并且多个页面可以各自引用同一份.js文件。 可以在同一个页面中引入多个.js文件,还可以在页面中多次编写<script> js代码... </script>,浏览器按照顺序依次执行。 2. 编程工具 我使用的是webstorm,这款工具非常好用,但是是收费软件,可以使用它的开源license。https://www.jetbrains.com/webstorm/ 3. 语法 JavaScript的语法和Java语言类似,每个语句以;结束,语句块用{...}。但是,JavaScript并不强制要求在每个语句的结尾加;,浏览器中负责执行JavaScript代码的引擎会自动在每个语句的结尾补上;。 注意:让JavaScript引擎自动加分号在某些情况下会改变程序的语义,导致运行结果与期望不一致。为了养成良好习惯,我们不要省略;,所有语句都添加;。 if (2 > 1) { x = 1; y = 2; z = 3; } 注意花括号{...}内的语句具有缩进,通常是4个空格。缩进不是JavaScript语法要求必须的,但缩进有助于我们理解代码的层次,所以编写代码时要遵守缩进规则。很多文本编辑器具有“自动缩进”的功能,可以帮助整理代码。 4. 注释 以//开头直到行末的字符被视为行注释,注释是给开发人员看到,JavaScript引擎会自动忽略: // 这是一行注释 alert('hello'); // 这也是注释//另一种块注释是用/*...*/把多行字符包裹起来,把一大“块”视为一个注释:/* 从这里开始是块注释 仍然是注释 仍然是注释 注释结束 */ 5. 大小写 请注意,JavaScript严格区分大小写,如果弄错了大小写,程序将报错或者运行不正常。 本文转自 ygqygq2 51CTO博客,原文链接:http://blog.51cto.com/ygqygq2/1917258,如需转载请自行联系原作者

优秀的个人博客,低调大师

day23-正则|grep介绍

grep工具介绍:grep&egrep工具作为shell必备三剑客之一: grep: (global search regular expression and print out the line),使用正则表达式搜索文本并把行打印出来),是一种强大的文本搜索工具,它可以搜索文本,并把需要的行打印出来: 语法:grep [ options ] "word" filename Options: -c:=count 行数 -i:=ignore-case 不区分大小写 -n:=line-number 显示行号 -v:=revert-match 取反 -r,-R:=recursive(递归的,循环的)读取目录下的所有文件,包括子目录 -A:后面跟数字,过滤出复合要求的行以及下面n行 -B:同上,过滤出符合要求的行以及上面n行 -C:同上,同时过滤出符合要求的行以及上下各n行 -E:‘grep -E’ = egrep eg: 过滤一个字符串 [root@adai003grep]#grep'nologin'passwdbin:x:1:1:bin:/bin:/sbin/nologindaemon:x:2:2:daemon:/sbin:/sbin/nologinadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologin[root@adai003grep]#whichgrepaliasgrep='grep--color=auto' /usr/bin/grep 在Linux中,grep默认带color选项: grep -c [root@adai003grep]#grep-c'nologin'passwd4[root@adai003grep]#cat!$catpasswdroot:x:0:0:root:/root:/bin/bashbin:x:1:1:bin:/bin:/sbin/nologindaemon:x:2:2:daemon:/sbin:/sbin/nologinadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologin grep -n [root@adai003grep]#grep-n'nologin'passwd2:bin:x:1:1:bin:/bin:/sbin/nologin3:daemon:x:2:2:daemon:/sbin:/sbin/nologin4:adm:x:3:4:adm:/var/adm:/sbin/nologin5:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin grep -i [root@adai003grep]#cat!$catpasswdroot:x:0:0:root:/root:/bin/bashbin:x:1:1:bin:/bin:/sbin/Nologindaemon:x:2:2:daemon:/sbin:/sbin/nologinadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologin[root@adai003grep]#grep'nologin'passwddaemon:x:2:2:daemon:/sbin:/sbin/nologinadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologin[root@adai003grep]#grep-i'nologin'passwdbin:x:1:1:bin:/bin:/sbin/Nologindaemon:x:2:2:daemon:/sbin:/sbin/nologinadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologin[root@adai003grep]#grep-c'nologin'passwd3[root@adai003grep]#grep-ic'nologin'passwd4 grep -v [root@adai003grep]#grep-v'nologin'passwdroot:x:0:0:root:/root:/bin/bashbin:x:1:1:bin:/bin:/sbin/Nologin grep -r/R [root@adai003grep]#tree. ├──grep1 │└──passwd1 └──passwd [root@adai003grep]#grep-r'root'../passwd:root:x:0:0:root:/root:/bin/bash./grep1/passwd1:root:x:0:0:root:/root:/bin/bash[root@adai003grep]#grep-R'root'../passwd:root:x:0:0:root:/root:/bin/bash./grep1/passwd1:root:x:0:0:root:/root:/bin/bash grep -A [root@adai003grep]#grep-nA2'daemon'passwd3:daemon:x:2:2:daemon:/sbin:/sbin/nologin4-adm:x:3:4:adm:/var/adm:/sbin/nologin5-lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin grep -B [root@adai003grep]#grep-nB2'daemon'passwd1-root:x:0:0:root:/root:/bin/bash2-bin:x:1:1:bin:/bin:/sbin/Nologin3:daemon:x:2:2:daemon:/sbin:/sbin/nologin grep -C [root@adai003grep]#grep-nC2'daemon'passwd1-root:x:0:0:root:/root:/bin/bash2-bin:x:1:1:bin:/bin:/sbin/Nologin3:daemon:x:2:2:daemon:/sbin:/sbin/nologin4-adm:x:3:4:adm:/var/adm:/sbin/nologin5-lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin 9.2 grep(中) grep应用 eg1:grep -n '[0-9]' [root@adai003grep]#grep-n'[0-9]'passwd1:root:x:0:0:root:/root:/bin/bash2:bin:x:1:1:bin:/bin:/sbin/Nologin3:daemon:x:2:2:daemon:/sbin:/sbin/nologin5:adm:x:3:4:adm:/var/adm:/sbin/nologin6:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin7:pcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin eg2:grep -nv '[0-9]' [root@adai003grep]#cat!$catpasswdroot:x:0:0:root:/root:/bin/bashbin:x:1:1:bin:/bin:/sbin/Nologindaemon:x:2:2:daemon:/sbin:/sbin/nologinCtrl-Alt-Deleteishandledby/usr/lib/systemd/system/cadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologinpcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin Ctrl-Alt-Deleteishandledby/usr/lib/systemd/system/ctrl-alt-del.target [root@adai003grep]#grep-nv'[0-9]'passwd4:Ctrl-Alt-Deleteishandledby/usr/lib/systemd/system/c8:Ctrl-Alt-Deleteishandledby/usr/lib/systemd/system/ctrl-alt-del.target grep -n ' ^# ' 过滤以#开头的行(^在此表示以某字符开头) [root@adai003grep]#catinittab#inittabisnolongerusedwhenusingsystemd. #ADDINGCONFIGURATIONHEREWILLHAVENOEFFECTONYOURSYSTEM. lhugalkdoljweriii #systemduses'targets'insteadofrunlevels.Bydefault,therearetwomaintargets: jlkdghkhladlllsdjfj #multi-user.target:analogoustorunlevel3#graphical.target:analogoustorunlevel5[root@adai003grep]#grep-n'^#'inittab1:#inittabisnolongerusedwhenusingsystemd.2:#ADDINGCONFIGURATIONHEREWILLHAVENOEFFECTONYOURSYSTEM.4:#systemduses'targets'insteadofrunlevels.Bydefault,therearetwomaintargets:6:#multi-user.target:analogoustorunlevel37:#graphical.target:analogoustorunlevel5[root@adai003grep]#grep-nv'^#'inittab过滤不是以#开头的行3:lhugalkdoljweriii5:jlkdghkhladlllsdjfj grep '[^0-9]' 表示非0-9中任意字符所在的行,即任意非数字所在的行(只要包含非数字字符都算在内,中括号内的‘^’表示否定) [root@adai003grep]#catinittab#inittabisnolongerusedwhenusingsystemd. #ADDINGCONFIGURATIONHEREWILLHAVENOEFFECTONYOURSYSTEM. lhugalkdoljweriii235425241245a879869 #systemduses'targets'insteadofrunlevels.Bydefault,therearetwomaintargets:6999%&*0927309#multi-user.target:analogoustorunlevel3^%^%$&%%*&## #graphical.target:analogoustorunlevel5[root@adai003grep]#grep'[^0-9]'inittab #inittabisnolongerusedwhenusingsystemd. #ADDINGCONFIGURATIONHEREWILLHAVENOEFFECTONYOURSYSTEM. lhugalkdoljweriii1245a879869 #systemduses'targets'insteadofrunlevels.Bydefault,therearetwomaintarget:6999%&*0927309#multi-user.target:analogoustorunlevel3^%^%$&%%*&## #graphical.target:analogoustorunlevel5 grep '^[^0-9]' 表示以非数字字符开头的行 [root@adai003grep]#grep'^[^0-9]'inittab#inittabisnolongerusedwhenusingsystemd.#ADDINGCONFIGURATIONHEREWILLHAVENOEFFECTONYOURSYSTEM.lhugalkdoljweriii#systemduses'targets'insteadofrunlevels.Bydefault,therearetwomaintargets:#multi-user.target:analogoustorunlevel3^%^%$&%%*&###graphical.target:analogoustorunlevel5 grep 'r.o' 在此‘.’表示一个任意字符 [root@adai003grep]#grep'r.o'passwdroot:x:0:0:roprot:/root:/bin/bashpcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin grep 'o*o' 在此‘ * ’表示其左边的字符重复n此(n≥0) [root@adai003grep]#grep'o*o'passwdroot:x:0:0:root:/root:/bin/bashbin:x:1:1:bin:/bin:/sbin/Nologindaemon:x:2:2:daemon:/sbin:/sbin/nologinCtrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/cadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologinpcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin grep '.*' 在此' . * '组合表示所有任意字符 [root@adai003grep]#grep'.*'passwdroot:x:0:0:roprot:/root:/bin/bashbin:x:1:1:bin:/bin:/sbin/Nologindaemon:x:2:2:daemon:/sbin:/sbin/nologinCtrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/cadm:x:3:4:adm:/var/adm:/sbin/nologinlp:x:4:7:lp:/var/spool/lpd:/sbin/nologinpcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin Ctrl-Alt-Deleteishandledby/usr/lib/systemd/system/ctrl-alt-del.target grep 'o\ {2\ }' 在此{}表示前面字符或字符串出现的次数(也可以是一个区间,如'o\ {0,3\ }'表示0个到3个o) [root@adai003grep]#grep-n'o\{2\}'passwd1:root:x:0:0:roprot:/root:/bin/bash4:Ctrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/c6:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin[root@adai003grep]#grep-n'o\{3\}'passwd4:Ctrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/c [root@adai003grep]#grep-n'o\{0,3\}'passwd1:root:x:0:0:roprot:/root:/bin/bash2:bin:x:1:1:bin:/bin:/sbin/Nologin3:daemon:x:2:2:daemon:/sbin:/sbin/nologin4:Ctrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/c5:adm:x:3:4:adm:/var/adm:/sbin/nologin6:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin7:pcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin8:Ctrl-Alt-Deleteishandledby/usr/lib/systemd/system/ctrl-alt-del.target 9.3 grep(下) egrep应用 egrep 'o{2}'=grep -E 'o {2}' = grep 'o\ {2\ }' [root@adai003grep]#grep-nE'o{2}'passwd1:root:x:0:0:roprot:/root:/bin/bash4:Ctrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/c6:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin[root@adai003grep]#egrep-n'o{2}'passwd1:root:x:0:0:roprot:/root:/bin/bash4:Ctrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/c6:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin当{}前面是一个字符串时需要使用‘()’ egrep -n 'o+o' 在此‘+’表示其左边的字符重复n此(n≥1,注意和*的区别) [root@adai003grep]#egrep-n'o+o'passwd1:root:x:0:0:roprot:/root:/bin/bash4:Ctrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/c6:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin egrep -n 'o?t' 在此?表示其前面的字符出现0次或1次 [root@adai003grep]#egrep-n'o?t'passwd1:root:x:0:0:roprot:/root:/bin/bash4:Ctrl-Alt-Deoooleoooteioshandledby/usr/lib/systemd/system/c7:pcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin8:Ctrl-Alt-Deleteishandledby/usr/lib/systemd/system/ctrl-alt-del.target egrep -n 'root|nologin' 在此‘|’表示或者 [root@adai003grep]#egrep-n'root|nologin'passwd1:root:x:0:0:roprot:/root:/bin/bash3:daemon:x:2:2:daemon:/sbin:/sbin/nologin5:adm:x:3:4:adm:/var/adm:/sbin/nologin6:lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin7:pcp:x:996:994:PerformanceCo-Pilot:/var/lib/pcp:/sbin/nologin grep -nE '(oo){2}' 在此()内的内容表示一个字符组合,即连续出现两次‘oo’=‘oooo’字符串 [root@adai003grep]#grep-nE'(oo){2}'passwd4:Ctrl-Alt-Deoooleooooteioshandledby/usr/lib/systemd/system/c 扩展 过滤一个目录下所有某类型文档中含有某字符的行: [root@adai003~]#grep-r--include="*.txt"'root'./sed/./sed/test.txt:root:x:0:0:roprot:/root:/bin/bash 说明:过滤./sed/目录下所有.txt文件中含有字符串root的行。 本文转自 芬野 51CTO博客,原文链接:http://blog.51cto.com/yuanhaohao/2061380,如需转载请自行联系原作者

优秀的个人博客,低调大师

Check Point 培训 day1

防水墙:防止内部数据被传出去 防火墙:防止外部入侵 Check Point:Gartner防火墙魔力象限领导者地位,专注安全超过20年,全球范围内的支持 软件防火墙:CPU+内存,x86架构,能做应用层策略 硬件防火墙:极高性能,ASIC芯片,转发流程简单效率高 透明模式/桥模式:有状态监测的交换机 路由模式:有状态监测的路由器 SMS:security management server,用于管理安全策略,维护安全网关的数据库,通过SmartDashboard定义策略,保存在SMS上。 SIC:安全的内部通信,通信必须是加密的,是认证的,必须保证数据完整性,SIC的设置过程必须是用户友善的。SIC在SMS与其他组件之间。 SmartConsole:统一的配置界面 SmartDashborad:主控台 SmartView Tracker:非常详细的日志,适合一线员工排错 SmartEvent:安全大事件,适合首席安全官 SmartLog:中心的追踪日志记录,搜索海量日志,查找关联关系等,速度快,适用安全取证人员 SmartReporter:完全自动产生报告 SmartView Monitor:监控防火墙状态 SmartEndpoint:终端安全解决方案,如加密 SmartUpdate:①升级软件②授权 SmartProvisioning:制作模板统一配置很多防火墙 600系列等适用小企业 2200,4000,12000,13500 21000系列:超低延时转发 41000/61000:虚拟化数据中心 VSX:硬件虚拟化版本 VM版本防火墙 AWS/Azure Checkpoint虚拟防火墙 可以购买单独的网管设备安装SMS 也有软件版本的防火墙,软件刀片架构。 本文转自Grodd51CTO博客,原文链接:http://blog.51cto.com/juispan/2048395,如需转载请自行联系原作者

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码