首页 文章 精选 留言 我的

精选列表

搜索[deep],共1421篇文章
优秀的个人博客,低调大师

Apache Doris 基于 Workload Group 的负载隔离能力|Deep Dive

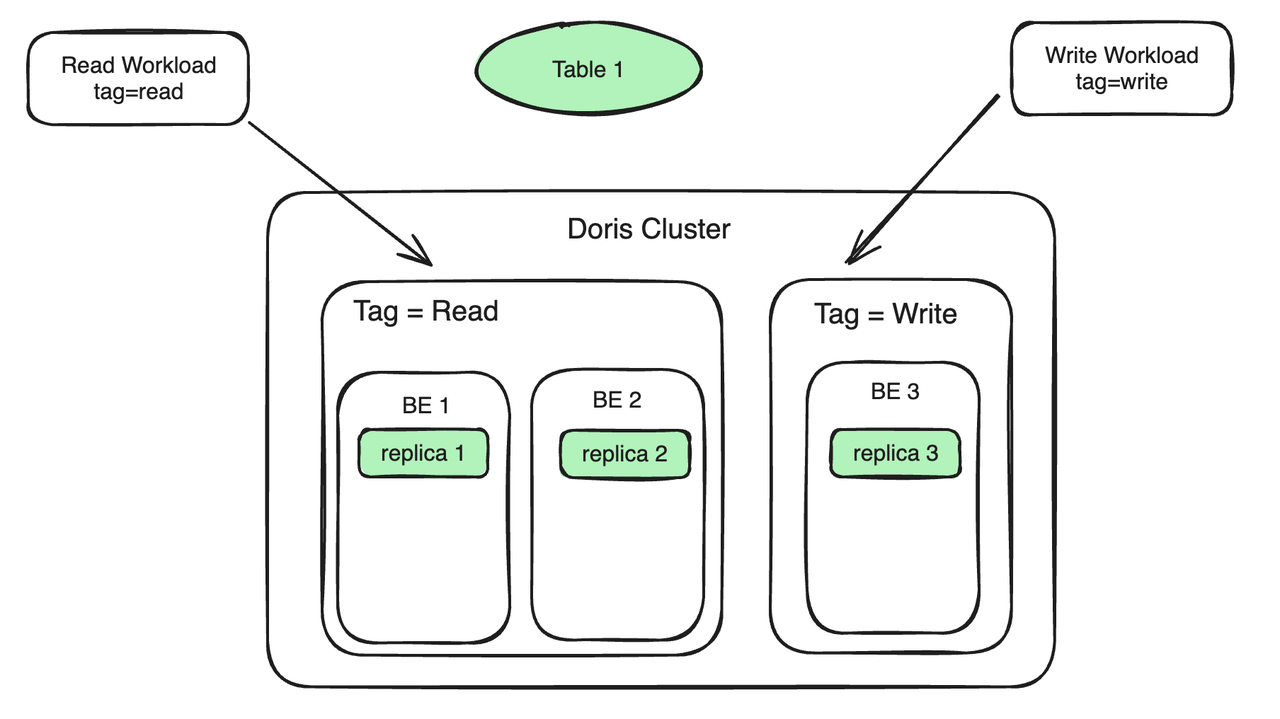
作者:SelectDB 技术团队 现如今企业的数据查询需求在不断增多,在共享同一集群时,往往需要同时面对多个业务线或多种分析负载的并发查询。在有限的资源条件下,查询任务间的资源抢占将导致性能下降甚至集群不稳定,因此负载管理的重要性不言而喻。 从业务场景出发,用户负载管理的需求主要来自以下几方面: 多个业务部门或租户可能共享同一套集群时,为避免不同租户间的负载相互影响,需保证每个租户的资源使用独立性和性能稳定性。 不同业务对查询任务的响应度和优先级有着不同要求,对于关键业务或高优先级任务,如实时数据分析、在线交易等,需要确保这些任务能够获得足够的资源并优先执行,避免因资源竞争对查询性能产生影响。 用户不仅关心资源的分配和管理,还注重成本控制和资源利用率。负载管理方案需在满足隔离要求的同时,实现用户对低使用成本和高资源利用率的诉求。 在早期版本中,Apache Doris 推出了基于资源标签(Resource Tag)的隔离方案,包括集群内节点级别的资源组划分以及针对单个查询的资源限制,实现了不同用户间的资源物理隔离。而为给用户提供更完善的负载管理方案,Apache Doris 自 2.0 版本起,推出了基于 Workload Group 的管理方案,实现了 CPU 资源的软限,为用户提供较高的资源利用率。在新发布的 2.1 版本基于 Linux 内核提供的 CGroup 技术,进一步地实现了对 CPU 资源的硬限,为用户提供更好的查询稳定性。 基于 Resource Tag 的物理隔离方案 在 Apache Doris 中有 FE 和 BE 两类节点,FE 节点负责元数据存储、集群管理、用户请求接入以及查询计划解析等,BE 节点则负责数据的存储和计算。在查询执行过程中涉及资源消耗的主要是 BE 节点,因此 Apache Doris 负载隔离方案都是面向 BE 节点设计。 在 Resource Tag 资源物理隔离方案中,可以对同一个集群内的 BE 节点设置标签,标签相同的 BE 节点会组成一个资源组(Resource Group),可将资源组看作数据存储和计算的一个单元。数据入库时会按照资源组配置将数据的副本写入到不同的资源组中,查询时按照资源组的划分使用对应资源组上的计算资源进行计算。 参考文档:https://doris.apache.org/zh-CN/docs/2.0/admin-manual/resource-admin/multi-tenant 我们以常见的读写分析场景为例,假设集群中有 3 台 BE,具体使用步骤如下: BE 节点绑定 Resource Tag:将两台 BE 绑定到 Tag Read 上,服务于读负载;一台 BE 绑定到 Tag Write 上,服务于写负载。读负载和写负载位于不同的机器上,以实现读写隔离。 数据副本绑定 Resource Tag:Table 1 有三个副本,两个副本绑定到 Tag Read 上,一个副本绑定到 Tag write 上。写入 replica 3 的数据会自动同步到 replica 1 和 replica 2 上,同步过程不会占用过多 BE 1 和 BE 2 的计算资源。 工作负载绑定到 Resource Tag:如果查询 SQL 携带的 Tag 为 Read,查询将被自动路由到 Tag 为 Read 上的机器上(BE 1 、BE 2)上执行;如果将 Stream Load 导入负载指定 Tag 为 Write,那么 Stream Load 就会路由到 Tag 为 Write 的机器上( BE 3)。在此过程除了副本同步时产生的开销,查询和导入之间不再有资源的竞争。 Resource Tag 还可以实现多租户的功能。例如有两个用户 UserA 和 UserB,期望创建各自独立的租户以避免相互影响,那么可以把 UserA 的计算和存储资源绑定到名为 UserA 的 Tag 上,把 UserB 的计算和存储资源绑定到名为 UserB 的 Tag 上,那么两个用户在 BE 侧就实现了租户间的资源隔离。 Resource Tag 本质是通过对 BE 节点的分组实现了资源隔离,这个方案的优点是: 隔离性好,多个租户之间通过物理机隔离,对 CPU、内存、IO 都实现了完全的隔离; 故障隔离,当一个租户出现问题(比如进程崩溃),另外一个租户丝毫不受影响; 基于这个技术,有的用户将不同的资源组放置到不同的物理机房内,实现同城 2 个机房的双活。 但是也存在一定的局限性: 读写隔离场景下,当写入负载停止时,Tag 为 Write 的机器就处于空闲状态,从而降低整个集群的资源利用率,显然无法满足用户对资源充分利用的期望。 多租户场景下,同一个租户内的多个业务方的负载之间也会相互影响。即使可以通过为每个业务方配置单独物理机来满足隔离性,却带来了高成本、低资源利用率等问题。 灵活性差,租户的数量实际是跟副本数绑定的,如果要建立 5 个租户,那么至少需要有 5 个副本才可以,这在一定程度上造成了存储空间的浪费。 基于 Workload Group 的负载管理方案 为解决上述问题,Apache Doris 推出了基于 Workload Group 的管理方案,支持了更细粒度的资源隔离机制——进程内的资源隔离,这意味着同一个 BE 内多个 Query 间也可以实现一定程度上的隔离,有效避免了进程内的资源竞争,提高资源的利用率。 Workload Group 是通过对工作负载进行分组管理,实现对内存和 CPU 资源的精细化管控。通过将用户执行的 Query 与 Workload Group 相关联,限制单个 Query 在单个 BE 节点上的 CPU 和内存资源的百分比。同时可以配置开启内存资源限制,集群资源紧张时自动终止组内高内存占用查询以缓解压力。资源空闲时,多个 Workload Group 共享空闲资源并自动突破限制,确保查询稳定执行。 CPU 资源的限制可细分为软限和硬限,CPU 软限具备资源利用率更高的特点,允许在资源空闲时候灵活分配资源;而 CPU 硬限则更侧重于性能稳定性的保障,确保各 Group 之间不会因负载变化而相互干扰。 (CPU 硬限和软限这两种隔离方式可匹配不同使用场景,但不可同时应用,用户可根据自身需求灵活选择) Workload Group 与 Resource Tag 的方案主要有以下不同: 从计算资源的角度来说,Workload Group 是对 BE 进程内的 CPU 和内存资源进一步划分,多个 Workload Group 需要在同一个 BE 上竞争资源。而 Resource Tag 则是对 BE 节点进行分组,不同业务方的负载发送到不同分组的 BE 上实现资源隔离,不同 BE 分组间的业务负载不会有直接的资源竞争。 从存储资源的角度来说,Workload Group 无需关注存储资源,只关注单 BE 内计算资源的分配。Resource Tag 则需要对数据的副本进行分组,确保需要隔离的业务方数据分布在不同的 BE 上。 01 CPU 软限制 CPU 优先级主要通过参数 cpu_share 体现,可以将它类比为权重的概念。在相同的时间周期内,权重越高的 Group 可以获得更多的 CPU 时间。 以 Group A 和 Group B 为例,若配置 Group A 的 cpu_share 为 1、Group B 的 cpu_share 为 9,给定 10s 的时间周期。当两者负载均饱和时,权重更高的 Group B 可以获得 CPU 的时间为 9s(所有资源的 90%),Group A 可获得 CPU 时间为 1s(所有资源的 10%)。而在实际使用中,并非所有业务都是满负载运行,若 Group B 的负载较低或无负载,那么 Group A 可以独占 10s 的 CPU 时间。这种方式可以提供更高的资源分配灵活性,从而提高集群 CPU 资源的整体利用率。 02 CPU 硬限制 使用 CPU 软限时,如果系统负载较高或 CPU 资源紧张时,可能引起查询性能的波动。为满足更用户对查询性能稳定的高要求, Apache Doris 在最新的 2.1 版本中,实现了 Workload Group 的 CPU 硬限制——无论当前物理机整体 CPU 是否空闲,配置了硬限的 Group 最大 CPU 用量不能超过预先配置的限制值。 以 Group A 和 Group B 为例,若配置 Group A 的 cpu_hard_limit=10%,Group B 的cpu_hard_limit=90%。当两者单机 CPU 资源均达到饱和时, Group A 的 CPU 利用率为 10%, Group B 的 CPU 利用率为 90%,这与 CPU 软限是一样的。但是当 Group B 的负载降低或没有负载时,即便 Group A 增加查询负载,其最大 CPU 利用率仍被严格限制在 10%,无法获得更多的资源。虽然这种方式牺牲了资源分配的弹性,但也确保了查询性能的稳定性。 03 内存资源限制 使用须知,BE 节点内存主要划分为以下几部分: 操作系统保留内存 BE 进程内非查询部分的内存,暂时无法被 Workload Group 统计到。 BE 进程内的查询部分的内存(包括导入操作),可被 Workload Group 统计并管理。 内存资源限制主要通过参数 memory_limit 来限制(设置可以使用 BE 内存的百分比)。不仅可以设置预配置内存用量,还影响内存过度分配(Overcommit)之后的归还优先级。 在初始状态下,高优先级的资源组会被配置更多的内存、低优先级的资源组被分配较少的内存。为了提升内存的利用率,可以通过 enable_memory_overcommit 开启资源组的内存软限制,如果系统有空闲内存资源时可以超限使用。 为了保证系统稳定运行,当系统整体内存资源不足时,系统将会优先取消占用内存较大的任务,以回收超额分配(Overcommit)的内存资源。在此过程中,系统会尽量保留高优先级的资源组内存资源,低优先级资源组超额内存将被更快收回。 04 查询排队 当业务负载超过系统可承载上限时,继续提交新的查询不仅无法有效执行,还会对运行中的查询造成影响。为避免该问题出现,Workload Group 支持查询排队功能。当查询达到预设的最大并发时,新提交计划会进入排队逻辑,当队列已满或等待超时,查询会被拒绝,以此来缓解高负载下系统的压力。 查询排队功能主要有三个属性: max_concurrency:当前 Group 允许同时运行的最大 SQL 数,如果超过最大数值,则进入排队逻辑。 max_queue_size:排队队列中的允许最大查询个数,如果队列满了,那么查询会被拒绝、执行失败。 queue_timeout:队列中排队的时间限制,如果超时会直接失败,单位是毫秒。 参考文档:https://doris.apache.org/zh-CN/docs/admin-manual/workload-group Workload Group 使用测试 接下来,我们对 Workload Group 的 CPU 软限制和硬限制进行详细测试,以便为用户清晰呈现这两种限制在相同硬件条件下的负载管理效果与性能表现。 测试环境:16 核 64G 内存单台物理机 部署方式:1 台 FE、1 台 BE 测试数据集:Clickbench、TPCH 压测工具:JMeter 01 CPU 软限测试 启动两个客户端(1、2),分别在未使用/使用 CPU 软限的前提下,测试 CPU 软限制对负载管理的效果。需要注意的是,在该测试中 Page Cache 会影响测试结果,需要关闭 Page Cache 才会达到理想的测试效果。 通过对比分析两次测试中的客户端的吞吐量数据,我们可以得出以下结论: 未使用 Workload Group 的情况下,两个客户端的吞吐量比例为 1:1,表明它们在相同运行时间内获得的 CPU 资源是相同的。 使用 Workload Group 之后, 分别设置 cpu_share 为 2048 及 1024,结果表明吞吐量比例变为 2:1。这说明在相同的运行时间内,cpu_share参数更大的客户端 1 获得了更高比例的 CPU 资源。 02 CPU 硬限测试 由上文介绍可知,CPU 硬限制在负载较高时,可以保证很好的隔离性。因此我们使用硬限限制 CPU 使用率为 50%(cpu_hard_limit=50%),并使用同一客户端分别在并发数为 1、2、4 时(模拟不同负载)下执行 q23 查询测试,每次测试运行时间为 5 分钟。 从上方测试结果可知,随着查询并发数的增加,CPU 的利用率的始终稳定在 800% 上下(在一个 16 核的机器上,800% 的意味着使用 8 个核,实际的 CPU 利用率 为 50%)。由于 CPU 资源被硬限,因此在并发增加时,tp99 延时增加是符合预期的。 03 模拟生产环境测试 在实际生产环境中,用户往往更关注查询的延迟性能而非单纯的吞吐量。为了更贴近实际应用场景并准确评估性能,我们选取了一系列延迟约为 1 秒的查询 SQL(包括 CKBench 的 q15、q17、q23 和 TPCH 的 q3、q7、q19),构成一个 SQL 集合。这些查询涵盖了单表聚合和 Join 计算等多种特性,使用的 TPCH 数据集大小为 100G。 我们设计了两组测试,分别模拟了未使用 Workload Group 和使用 Workload Group 的场景。在客户端 1 和客户端 2 上进行了四次测试,重点关注 tp90 和 tp99 的延迟情况。 通过观察上表 4 次测试中查询延迟,可得出以下结论: 未使用 Workload Group(测试 1、2):当客户端 2 的并发量从 1 增加到 4 时,客户端 1、2 的查询延迟均显著上升。对比客户端 1 的性能表现,median、tp90 和 tp95 查询响应时间均增加了 2-3 倍。 使用 Workload Group(测试 3、4): 这两次测试中应用了 CPU 硬限制:设置客户端 1 cpu_hard_limit=90%、客户端 2 cpu_hard_limit=90%。从测试结果可知,即使客户端 2 的并发量增加,客户端 1 的查询延迟仅呈现小幅上升,明显优于测试 2 中性能表现。这一结果充分展现了 Workload Group 在负载隔离和性能稳定保障上的有效性。 结束语 目前 Resource Tag 和 Workload Group 功能已经在多个社区用户的生产业务中上线并得到大规模验证,推荐有资源隔离需求的用户使用。 无论是 Resource Tag 或是 Workload Group,其目标都在于在资源隔离的独立性和资源的利用率二者之间进行平衡,前者采取了更彻底的隔离方案,而后者在保证隔离性的同时实现了资源的充分利用,并通过查询队列和任务排队机制进一步保证了在高工作负载场景下的系统稳定性。 在资源隔离的实际使用过程中,我们建议两种方案可以根据业务场景结合起来应用: 如果是跨体系/跨业务部门之间共享同一集群,希望实现资源和数据的物理隔离,可以采取 Resource Tag 方案; 如果是在同一集群内同时面对多种类型的查询负载,可以通过 Workload Group 将不同负载区分开来,通过灵活的资源分配保证多种查询负载均可以获得合适的资源; 在后续的功能完善上,我们还有很多规划: 当前内存限制通过 Cancel Query 来释放内存,未来通过算子落盘可以进一步提升大查询的稳定性、避免资源紧张时的查询任务失败。 目前在 BE 进程的内存模型中,还存在部分非查询的内存未被统计到,这可能导致用户看到的 BE 进程内存和 Workload Group 使用内存之间存在差异,未来版本中将尝试解决这个问题。 查询排队功能只支持根据最大查询并发数排队,未来将通过 BE 的资源用量来约束最大并发数,从而对客户端形成自动的反压,提升 Doris 在客户端持续提交高负载情况下的可用性。 Resource Tag 功能是对 BE 机器资源的划分,Workload Group 则是对单机进程内的资源划分,这两种资源划分的方式都对用户暴露了 BE 节点的概念。而用户在使用资源管理功能时,本质上仅需要关注自己的工作负载在整个集内的可用资源量和资源分配的优先级。未来会探索资源划分新方式,降低用户的理解和使用成本。 致谢 Workload Group 功能是开源社区合作开发的项目,感谢以下同学的贡献:罗甑林(luozenglin),刘立家(liutang123),赵立伟(levy5307)

优秀的个人博客,低调大师

POSTGRESQL REPMGR DEEP DIVE (概念以及注意事项,细节 1)

最近要整理公司使用的POSTGRESQL 的高可用方式,既然是整理和梳理,不如就仔仔细细的来一边. PG 的高可用的方法比较多,REPMGR算是一个靠谱的方案,之前写过6期的REPMGR. 在现在看来浅薄了点, 目前需要对这个高可用的方式进行更深入的理解,从概念到细节. 鉴于大部分的文字都是基于操作的,这里会对于其他的一些文字有所不同,今天我们需要先从概念如说. 1 需要知晓的REPMGR 中的名词 1.1 replication cluster 这里的replication cluster 主要标识的是具有POSTGRESQL 流复制技术使用的服务器叫 replication cluster. 1.2node node 的含义是是指的 POSTGRESQL中的服务器的节点,实际上就是单台POSTGRESQL 的服务器. 1.3 upstream node 这个upstream node 本身的含义有两个,当repmgr 中只包含两个节点的时候,那么upstream node 必然是主节点, 当超过2个节点,并且你使用了级联复制,那么这个upstream node 针对的就是从节点的数据源. 1.4failover 这里的failover不在是一个名词,而是一个动作的表达, 表达当主库失败后,选择出一个新的主库,并进行对外输出的工作的一个过程. 1.5swithover 这里的switchover 也是表达一个功能,通过手动的方式进行主从交换的方式,通过这样的方式,满足一些维护工作,或特殊的需求,例如主库所在的服务器,需要进行下线,并且需要另一个服务器来接替,那么swithover 就是一个非常好的方法来完成这个工作. 1.6fencing 为了防止失败的主库服务器在次上线,导致脑裂的问题,这边对于失败下线的主库所做的事情,让其与应用隔离 1.7witness server 在REPMGR中的服务器超过2台及以上的情况下standby变为主库的情况下,需要进行一个投票的行为,通过投票的方式来决定,实际上个人看法在非极端的情况下,跨网跨域的可以考虑见证服务器,而一般在一个网络中,并且网络稳定的情况下, 两台PG做REPMGR 就可以了,不非要使用见证服务器. REPMGR 到底提供了几种工具 2.1 repmgr repmgr 程序提供的功能主要有 设置standby服务器 手动将一个standby服务器promoting为一个primary 服务器 查看replication cluster 的状态 2.2repmgrd 这个程序作为daemon的状态,来监控服务器提供如下功能 查看和记录复制的性能问题 检测主库的失败并且在适当的时机,将standby promote 为主库 通过内部的事件管理,以及用户自定义的脚本来发送告警邮件 对于REPMGR 来说安装完毕注册完毕后,会产生3个表2个VIEW 其中包含 repmgr.events 另外repmgr.node 表主要提供当前服务器的状态 另外注意如果是编译安装需要补充以下的依赖包 flex libselinux-devel libxml2-devel libxslt-devel openssl-devel pam-devel readline-devel 另外还需要注意如果想使用swithover功能的情况下,需要进行SSH 的配置和操作RSYNC程序的安装. 配置/ETC/hosts 在设置REPMGR 中注册primary server时需要先初始化instance, 另外一些参数的设置也需要注意. max_wal_senders max_replication_slots wal_level archive_mode archive_command 等这些命令的设置(从库也需要有相同的配置) 当然在创建repmgr的同时需要在主库创建repmgr的账号以及repmgr的数据库,并且修改search_path针对repmgr的数据库 ALTER USER repmgr SET search_path TO repmgr, "$user", public; 对于repmgr的用户名密码方面 通过设置.pgpass文件 或者 可以通过pg_hba.conf 文件来控制 .pgpass 主要设置 repmgr 账号,并且replication也是通过repmgr来进行控制 需要在每一台机器包含每一个NODE 的信息 如下面的方式在.pgpass 中进行设置(此为三个节点的信息) node1:5432:repmgr:repmgr:foonode1:5432:replication:repmgr:foonode2:5432:repmgr:repmgr:foonode2:5432:replication:repmgr:foonode3:5432:repmgr:repmgr:foonode3:5432:replication:repmgr:foo 对于pg_hba.conf 来说, 可以有两种配置 1 信任,但需要控制主机,也就是PG 主机之间的固定的数据库 固定的账号 进行信任,这样不会泄漏信息,安全性是可以接受的 2 或者使用./pgpass 与 密码的方式进行登录 本文分享自微信公众号 - AustinDatabases(AustinDatabases)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Deep learning深度学习的十大开源框架

Google开源了TensorFlow( GitHub ),此举在深度学习领域影响巨大,因为Google在人工智能领域的研发成绩斐然,有着雄厚的人才储备,而且Google自己的Gmail和搜索引擎都在使用自行研发的深度学习工具。 对于希望在应用中整合深度学习功能的开发者来说,GitHub上其实还有很多不错的开源项目值得关注,首先我们推荐目前规模人气最高的TOP3: 一、Caffe。源自加州伯克利分校的Caffe被广泛应用,包括Pinterest这样的web大户。与TensorFlow一样,Caffe也是由C++开发,Caffe也是Google今年早些时候发布的DeepDream项目(可以识别喵星人的人工智能神经网络)的基础。 二、Theano。2008年诞生于蒙特利尔理工学院,Theano派生出了大量深度学习Python软件包,最著名的包括Blocks和Keras。 三、Torch。Torch诞生已经有十年之久,但是真正起势得益于去年Facebook开源了大量Torch的深度学习模块和扩展。Torch另外一个特殊之处是采用了不怎么流行的编程语言Lua(该语言曾被用来开发视频游戏)。 除了以上三个比较成熟知名的项目,还有很多有特色的深度学习开源框架也值得关注: 四、Brainstorm。来自瑞士人工智能实验室IDSIA的一个非常发展前景很不错的深度学习软件包,Brainstorm能够处理上百层的超级深度神经网络——所谓的公路网络Highway Networks。 五、Chainer。来自一个日本的深度学习创业公司Preferred Networks,今年6月发布的一个Python框架。Chainer的设计基于define by run原则,也就是说,该网络在运行中动态定义,而不是在启动时定义,这里有Chainer的详细文档。 六、Deeplearning4j。 顾名思义,Deeplearning4j是”for Java”的深度学习框架,也是首个商用级别的深度学习开源库。Deeplearning4j由创业公司Skymind于2014年6月发布,使用 Deeplearning4j的不乏埃森哲、雪弗兰、博斯咨询和IBM等明星企业。 DeepLearning4j是一个面向生产环境和商业应用的高成熟度深度学习开源库,可与Hadoop和Spark集成,即插即用,方便开发者在APP中快速集成深度学习功能,可应用于以下深度学习领域: 人脸/图像识别 语音搜索 语音转文字(Speech to text) 垃圾信息过滤(异常侦测) 电商欺诈侦测 七、Marvin。是普林斯顿大学视觉工作组新推出的C++框架。该团队还提供了一个文件用于将Caffe模型转化成语Marvin兼容的模式。 八、ConvNetJS。这是斯坦福大学博士生Andrej Karpathy开发浏览器插件,基于万能的JavaScript可以在你的游览器中训练神经网络。Karpathy还写了一个ConvNetJS的入门教程,以及一个简洁的浏览器演示项目。 九、MXNet。出自CXXNet、Minerva、Purine等项目的开发者之手,主要用C++编写。MXNet强调提高内存使用的效率,甚至能在智能手机上运行诸如图像识别等任务。 十、Neon。由创业公司Nervana Systems于今年五月开源,在某些基准测试中,由Python和Sass开发的Neon的测试成绩甚至要优于Caffeine、Torch和谷歌的TensorFlow。 Google开源了TensorFlow( GitHub ),此举在深度学习领域影响巨大,因为Google在人工智能领域的研发成绩斐然,有着雄厚的人才储备,而且Google自己的Gmail和搜索引擎都在使用自行研发的深度学习工具。 对于希望在应用中整合深度学习功能的开发者来说,GitHub上其实还有很多不错的开源项目值得关注,首先我们推荐目前规模人气最高的TOP3: 一、Caffe。源自加州伯克利分校的Caffe被广泛应用,包括Pinterest这样的web大户。与TensorFlow一样,Caffe也是由C++开发,Caffe也是Google今年早些时候发布的DeepDream项目(可以识别喵星人的人工智能神经网络)的基础。 二、Theano。2008年诞生于蒙特利尔理工学院,Theano派生出了大量深度学习Python软件包,最著名的包括Blocks和Keras。 三、Torch。Torch诞生已经有十年之久,但是真正起势得益于去年Facebook开源了大量Torch的深度学习模块和扩展。Torch另外一个特殊之处是采用了不怎么流行的编程语言Lua(该语言曾被用来开发视频游戏)。 除了以上三个比较成熟知名的项目,还有很多有特色的深度学习开源框架也值得关注: 四、Brainstorm。来自瑞士人工智能实验室IDSIA的一个非常发展前景很不错的深度学习软件包,Brainstorm能够处理上百层的超级深度神经网络——所谓的公路网络Highway Networks。 五、Chainer。来自一个日本的深度学习创业公司Preferred Networks,今年6月发布的一个Python框架。Chainer的设计基于define by run原则,也就是说,该网络在运行中动态定义,而不是在启动时定义,这里有Chainer的详细文档。 六、Deeplearning4j。 顾名思义,Deeplearning4j是”for Java”的深度学习框架,也是首个商用级别的深度学习开源库。Deeplearning4j由创业公司Skymind于2014年6月发布,使用 Deeplearning4j的不乏埃森哲、雪弗兰、博斯咨询和IBM等明星企业。 DeepLearning4j是一个面向生产环境和商业应用的高成熟度深度学习开源库,可与Hadoop和Spark集成,即插即用,方便开发者在APP中快速集成深度学习功能,可应用于以下深度学习领域: 人脸/图像识别 语音搜索 语音转文字(Speech to text) 垃圾信息过滤(异常侦测) 电商欺诈侦测 七、Marvin。是普林斯顿大学视觉工作组新推出的C++框架。该团队还提供了一个文件用于将Caffe模型转化成语Marvin兼容的模式。 八、ConvNetJS。这是斯坦福大学博士生Andrej Karpathy开发浏览器插件,基于万能的JavaScript可以在你的游览器中训练神经网络。Karpathy还写了一个ConvNetJS的入门教程,以及一个简洁的浏览器演示项目。 九、MXNet。出自CXXNet、Minerva、Purine等项目的开发者之手,主要用C++编写。MXNet强调提高内存使用的效率,甚至能在智能手机上运行诸如图像识别等任务。 十、Neon。由创业公司Nervana Systems于今年五月开源,在某些基准测试中,由Python和Sass开发的Neon的测试成绩甚至要优于Caffeine、Torch和谷歌的TensorFlow。

优秀的个人博客,低调大师

Building a Keras + deep learning REST API(三部曲之一)

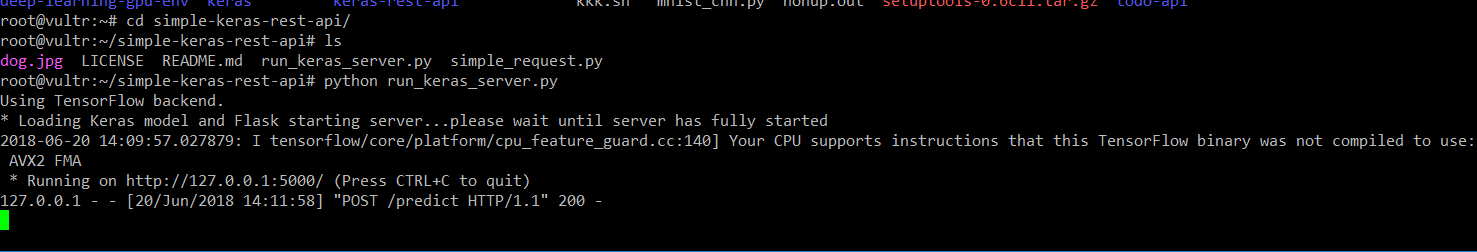
一、基本环境 $ pip install flask gevent requests pillow 其中 flask不需要解释 gevent 是用于自动切换进程的; pillow 是用来进行python下的图像处理的; requests 是用来进行python下request处理的。 二、核心代码解释 # import the necessary packages from keras.applications import ResNet50 from keras.preprocessing.image import img_to_array from keras.applications import imagenet_utils from PIL import Image import numpy as np import flask import io 引入所需的头文件。其中注意keras的几个类库是很有通用性的; # initialize our Flask application and the Keras model app = flask.Flask( __name__) model = None 类库的初始化 def load_model(): # load the pre-trained Keras model (here we are using a model # pre-trained on ImageNet and provided by Keras, but you can # substitute in your own networks just as easily) global model model = ResNet50( weights= "imagenet") 引入model模型,如果想引入自己的模型(CBIR)的话,就在这里引入。 def prepare_image( image, target): # if the image mode is not RGB, convert it if image.mode != "RGB": image = image.convert( "RGB") # resize the input image and preprocess it image = image.resize(target) image = img_to_array(image) image = np.expand_dims(image, axis= 0) image = imagenet_utils.preprocess_input(image) # return the processed image return image image的预处理,这里使用的是keras+PIL,和opencv之间的比较,需要有时间来做。 @app.route( "/predict", methods=[ "POST"]) def predict(): # initialize the data dictionary that will be returned from the # view data = { "success": False} # ensure an image was properly uploaded to our endpoint if flask.request.method == "POST": if flask.request.files.get( "image"): # read the image in PIL format image = flask.request.files[ "image"].read() image = Image.open(io.BytesIO(image)) # preprocess the image and prepare it for classification image = prepare_image(image, target=( 224, 224)) # classify the input image and then initialize the list # of predictions to return to the client preds = model.predict(image) results = imagenet_utils.decode_predictions(preds) data[ "predictions"] = [] # loop over the results and add them to the list of # returned predictions for (imagenetID, label, prob) in results[ 0]: r = { "label": label, "probability": float(prob)} data[ "predictions"].append(r) # indicate that the request was a success data[ "success"] = True # return the data dictionary as a JSON response return flask.jsonify(data) 虽然是核心部分,但是其实非常容易被复用。就是读取数据,然后进行处理的过程。 # if this is the main thread of execution first load the model and # then start the server if __name__ == "__main__": print(( "* Loading Keras model and Flask starting server..." "please wait until server has fully started")) load_model() app.run() 比不可少的main过程。缺少不可运行。 三、运行效果 使用VPS能够更快地得到效果,至少你不需要下载resnet*.h5,一个链路不是太好的大物件。 flask的运行效果,使用curl进行处理的效果 从结果上来看,curch排在了第2,而将这张图片识别为钟楼或者修道院、城堡,宫殿 ,似乎也没有什么不妥。 四、小结反思 真的仅仅是通过了几行代码,就实现了flask部署的核心问题。不过光是跑这个简单的过程,机器就已经发出巨大的热量了;另一方面,整个的结构是什么,也需要进一步去研究清楚才对。 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册