首页 文章 精选 留言 我的

精选列表

搜索[deep],共1760篇文章
优秀的个人博客,低调大师

Technical Deep Dive: 1688.com Product Detail API - Full Guide & Standard JSON Re

# Introduction 1688.com, Alibaba’s flagship B2B wholesale marketplace, serves as the core supply chain hub for millions of global retailers, dropshippers, and enterprise procurement teams. Unlike consumer-facing e-commerce platforms, its open API ecosystem is purpose-built for bulk product sourcing, tiered price negotiation, supplier management, and automated B2B order fulfillment. The official product detail interface (part of the 1688 Open Platform suite) is the foundational technical gateway that enables third-party ERP systems, sourcing tools, and cross-border reselling platforms to access structured, real-time wholesale product data. This guide breaks down the full technical architecture, mandatory request parameters, and provides a production-grade standard JSON response reference to help developers build stable, compliant 1688 data integration pipelines. # 1. Core Interface Basic Information The 1688 Product Detail API is a production-grade RESTful service hosted on Alibaba’s B2B open platform infrastructure, optimized for high-frequency industrial and wholesale business scenarios. |Item|Specification| | --- | --- | |Official API Name|alibaba.product.get (Get Full Wholesale Product Details)| |Communication Protocol|HTTPS POST (Recommended) / GET| |Default Data Format|JSON (XML is supported for legacy enterprise ERP systems)| |Official Gateway Endpoint|https://gw.open.1688.com/openapi| |Authentication Mechanism|AppKey + AppSecret + OAuth 2.0 AccessToken + HMAC-SHA1 Signature| |Typical Use Cases|Wholesale product sourcing, tiered price monitoring, supplier qualification verification, dropshipping inventory synchronization, cross-border e-commerce product listing automation| # 2. Full Request Parameter Breakdown Calling this API strictly follows 1688 Open Platform’s proprietary signature specification. All non-empty parameters must be sorted lexicographically and encrypted with the AppSecret to generate a valid, tamper-proof signature value. # 2.1 Mandatory Public Gateway Parameters These parameters are required for every 1688 API call, used for platform authentication, permission validation and request tracing: |Parameter Name|Type|Required|Description| | --- | --- | --- | --- | |app_key|String|Yes|Unique application identifier, obtained after enterprise developer verification on 1688 Open Platform| |method|String|Yes|Fixed asalibaba.product.getto specify the target product detail interface| |access_token|String|Yes|OAuth 2.0 authorized token, which carries the requester’s permission scope (public data / enterprise exclusive price)| |timestamp|String|Yes|East 8 timezone timestamp formatted asyyyy-MM-dd HH:mm:ss, used to prevent replay attacks| |v|String|Yes|API protocol version, the current stable production version is2.0| |sign_method|String|Yes|Signature algorithm,hmac-sha1is the platform standard for all B2B interfaces| |sign|String|Yes|Final encrypted signature value generated by AppSecret and sorted parameters| # 2.2 Business Core Parameters These parameters control the granularity and scope of the wholesale product data returned: |Parameter Name|Type|Required|Description| | --- | --- | --- | --- | |productId|Long|Yes|1688 unique product ID (Offer ID), extracted directly from the product detail page URL| |fields|String|Yes|Custom return field list, for exampleproductId,title,price,sku,supplier. Explicitly specifying required fields can reduce response latency by over 40%| |needCargoInfo|Boolean|No|Defaultfalse. Set totrueto return real-time warehouse stock distribution and logistics delivery information| |includeExclusivePrice|Boolean|No|Defaultfalse. Only authorized enterprise buyers can set this totrueto view negotiated exclusive contract prices| # 3. Standard Production JSON Response Reference Below is a standard full JSON response that strictly follows 1688’s official B2B interface return specification. This structure includes all unique high-value wholesale business fields, and can be directly used for debugging and enterprise ERP system docking: Use the website: o0b.cn/anzexi ``` { "alibaba_product_get_response": { "code": 0, "msg": "success", "request_id": "1688_req_20260918102233456", "data": { "product_id": 678901234567, "subject": "Factory Direct 1000W Portable Outdoor Power Station 220V Solar Generator for Camping", "supplier_info": { "member_id": "123456789", "company_name": "Shenzhen New Energy Tech Co., Ltd.", "supplier_level": "A+", "gold_supplier_years": 8, "transaction_rate": "98.5%", "main_industry": "Portable Power Station" }, "price_info": { "unit": "piece", "currency": "CNY", "price_tiers": [ {"min_quantity": 1, "max_quantity": 9, "price": "689.00"}, {"min_quantity": 10, "max_quantity": 99, "price": "620.00"}, {"min_quantity": 100, "max_quantity": null, "price": "550.00"} ], "exclusive_contract_price": "520.00", "moq": 1 }, "stock_info": { "total_available_stock": 15600, "stock_status": "instock", "warehouse_distribution": [ {"warehouse_code": "SZ001", "location": "Shenzhen", "stock": 9200, "lead_time_hours": 48}, {"warehouse_code": "GZ002", "location": "Guangzhou", "stock": 6400, "lead_time_hours": 72} ] }, "product_attrs": [ {"attribute_name": "Battery Capacity", "attribute_value": "1024Wh"}, {"attribute_name": "Rated Power", "attribute_value": "1000W"}, {"attribute_name": "Interface Type", "attribute_value": "USB-A / Type-C / AC Outlet"}, {"attribute_name": "Certification", "attribute_value": "CE, FCC, RoHS, PSE"} ], "sku_list": [ { "sku_id": 987654321001, "specification": "Standard Version (No Solar Panel)", "sku_price": "689.00", "sku_stock": 8600 }, { "sku_id": 987654321002, "specification": "Pro Version (With 100W Solar Panel)", "sku_price": "899.00", "sku_stock": 7000 } ], "media_resources": { "main_image": "https://cbu01.alicdn.com/img/ibank/2026/xxx/1.jpg", "image_gallery": [ "https://cbu01.alicdn.com/img/ibank/2026/xxx/1.jpg", "https://cbu01.alicdn.com/img/ibank/2026/xxx/2.jpg", "https://cbu01.alicdn.com/img/ibank/2026/xxx/3.jpg" ], "detail_video": "https://cloud.video.1688.com/play/xxx.mp4" }, "trade_info": { "payment_terms": "T/T, L/C, Alibaba Trade Assurance", "shipping_terms": "FOB Shenzhen", "supply_capability": "50000 pieces / Month", "customization_support": true } } } } ```

优秀的个人博客,低调大师

Apache Doris 实时更新全解:从设计原理到最佳实践|Deep Dive

在数据驱动决策的今天,数据的“新鲜度”已成为企业在激烈市场竞争中脱颖而出的核心竞争力。传统的 T+1 数据处理模式,由于其固有的延迟,已无法满足现代商业对实时性的苛刻要求。无论是为了实现毫秒级的业务库与数据仓库同步、动态调整运营策略,还是为了在秒级内修正错误数据以保障决策的准确性,强大的实时数据更新能力都显得至关重要。 Apache Doris作为一个现代化的实时分析型数据库,其设计的核心目标之一便是提供极致的数据新鲜度。它通过强大的数据模型和灵活的更新机制,将数据分析的延迟从天级、小时级成功压缩至秒级,为用户构建实时、敏捷的商业决策闭环提供了坚实的基础。 本文档将作为一份官方指南,系统性地阐述 Apache Doris 的数据更新能力,内容涵盖其核心原理、多样的更新与删除方式、典型的应用场景,以及在不同部署模式下的性能最佳实践,旨在帮助您全面掌握并高效利用 Doris 的数据更新功能。 1. 核心概念:表模型与更新机制 在 Doris 中,数据表的表模型(Data Model)决定了其数据组织方式和更新行为。为了支持不同的业务场景,Doris 提供了三种表模型:主键模型(Unique Key)、聚合模型(Aggregate Key)和明细模型(Duplicate Key)。其中,主键模型是实现复杂、高频数据更新的核心。 1.1. 表模型概览 1.2. 数据更新方式 Doris 提供了两大类数据更新方法:通过数据导入进行更新和通过 DML 语句进行更新。 1.2.1. 通过导入进行更新 (UPSERT) 这是 Doris 推荐的高性能、高并发的更新方式,主要针对主键模型。所有的导入方式(Stream Load, Broker Load, Routine Load, INSERT INTO)都天然支持 UPSERT 语义。当新数据导入时,如果其主键已存在,Doris 会用新行数据覆盖旧行数据;如果主键不存在,则插入新行。 1.2.2. 通过 UPDATE DML 语句更新 Doris 支持标准的 SQL UPDATE 语句,允许用户根据 WHERE 子句指定的条件对数据进行更新。这种方式非常灵活,支持复杂的更新逻辑,例如跨表关联更新。 -- 简单更新 UPDATE user_profiles SET age = age + 1 WHERE user_id = 1; -- 跨表关联更新 UPDATE sales_records t1 SET t1.user_name = t2.name FROM user_profiles t2 WHERE t1.user_id = t2.user_id; 注意:UPDATE 语句的执行过程是先扫描满足条件的数据,然后将更新后的数据重新写回表中。它适合低频、批量的更新任务。不建议对 UPDATE 语句进行高并发操作,因为并发的 UPDATE 在涉及相同主键时,无法保证数据的隔离性。 1.2.3. 通过 INSERT INTO SELECT DML 语句更新 由于 Doris 默认提供了 UPSERT 的语义,因此使用INSERT INTO SELECT也可以实现类似于UPDATE的更新效果。 1.3. 数据删除方式 与更新类似,Doris 也支持通过导入和 DML 语句两种方式删除数据。 1.3.1. 通过导入进行标记删除 这是一种高效的批量删除方法,主要用于主键模型。用户可以在导入数据时,增加一个特殊的隐藏列 DORIS_DELETE_SIGN。当某行的该列值为 1 或 true 时,Doris 会将该主键对应的数据行标记为删除(关于 delete sign 的原理,后文会有详细的介绍)。 // Stream Load 导入数据,删除 user_id 为 2 的行 // curl --location-trusted -u user:passwd -H "columns:user_id, __DORIS_DELETE_SIGN__" -T delete.json http://fe_host:8030/api/db_name/table_name/_stream_load // delete.json 内容 [ {"user_id": 2, "__DORIS_DELETE_SIGN__": "1"} ] 1.3.2. 通过 DELETE DML 语句删除 Doris 支持标准的 SQL DELETE 语句,可以根据 WHERE 条件删除数据。 主键模型:DELETE 语句会将满足条件的行的主键重新写入,并附带删除标记。因此,其性能与需要删除的数据量成正比。主键模型上的DELETE语句执行原理与UPDATE语句非常相似,先通过查询把要删除的数据读取出来,然后再附加删除标记进行一次写入。相比UPDATE语句,DELETE 语句只需要写入 Key 列和删除标记列,相对轻量一些。 明细/聚合模型:DELETE 语句的实现方式是记录一个删除谓词(Delete Predicate)。在查询时,这个谓词会作为一个运行时过滤器(Runtime Filter)来过滤掉被删除的数据。因此,DELETE 操作本身非常快,几乎与删除的数据量无关。但需要注意,在明细/聚合模型上进行高频的 DELETE 操作会累积大量的运行时过滤器,严重影响后续的查询性能。 DELETE FROM user_profiles WHERE last_login < '2022-01-01'; 下表是对使用 DML 语句进行删除的一个简要总结: 2. 深入主键模型:原理与实现 主键模型是 Doris 实现高性能实时更新的基石。理解其内部工作原理,对于充分发挥其性能至关重要。 2.1. Merge-on-Write (MoW) vs. Merge-on-Read (MoR) 主键模型有两种数据合并策略:写时合并(MoW)和读时合并(MoR)。自 Doris 2.1 版本起,MoW 已成为默认且推荐的实现方式。 MoW 机制通过在写入阶段付出少量代价,换取了查询性能的巨大提升,完美契合了 OLAP 系统“重读轻写”的特点。 下图简要的介绍了 MoW 的核心机制: 2.2. 条件更新 (Sequence Column) 在分布式系统中,数据乱序到达是一个常见问题。例如,一个订单状态先后变更为“已支付”和“已发货”,但由于网络延迟,代表“已发货”的数据可能先于“已支付”的数据到达 Doris。 为了解决这个问题,Doris 引入了 Sequence 列机制。用户可以在建表时指定一个列(通常是时间戳或版本号)作为 Sequence 列。当处理具有相同主键的数据时,Doris 会比较它们的 Sequence 列的值,并始终保留 Sequence 值最大的那一行数据,从而保证了数据的最终一致性,即使数据乱序到达。 CREATE TABLE order_status ( order_id BIGINT, status_name STRING, update_time DATETIME ) UNIQUE KEY(order_id) DISTRIBUTED BY HASH(order_id) PROPERTIES ( "function_column.sequence_col" = "update_time" -- 指定 update_time 为 Sequence 列 ); -- 1. 写入 "已发货" 记录 (update_time 较大) -- {"order_id": 1001, "status_name": "Shipped", "update_time": "2023-10-26 12:00:00"} -- 2. 写入 "已支付" 记录 (update_time 较小,后到达) -- {"order_id": 1001, "status_name": "Paid", "update_time": "2023-10-26 11:00:00"} -- 最终查询结果,保留了 update_time 最大的记录 -- order_id: 1001, status_name: "Shipped", update_time: "2023-10-26 12:00:00" 2.3. 删除机制 DORIS_DELETE_SIGN DORIS_DELETE_SIGN 的工作原理可以概括为“逻辑标记,后台清理”。 执行删除:当用户通过导入或DELETE语句删除数据时,Doris 不会立即从物理文件中移除数据。相反,它会为要删除的主键写入一条新记录,该记录的 DORIS_DELETE_SIGN 列被标记为 1。 查询过滤:当用户查询数据时,Doris 会在查询计划中自动添加一个过滤条件 WHERE DORIS_DELETE_SIGN = 0,从而在查询结果中隐藏所有被标记为删除的数据。 后台 Compaction:Doris 的后台 Compaction 进程会定期扫描数据。当它发现一个主键同时存在正常记录和删除标记记录时,它会在合并过程中将这两条记录都物理地移除,最终释放存储空间。 这种机制确保了删除操作的快速响应,同时通过后台任务异步完成物理清理,避免了对在线业务的性能冲击。 下图展示了DORIS_DELETE_SIGN 的工作原理: 2.4 部分列更新(Partial Column Update) 从 2.0 版本开始,Doris 在主键模型(MoW)上支持了强大的部分列更新能力。用户在导入数据时,只需提供主键和待更新的列,未提供的列将保持其原值不变。这极大地简化了宽表拼接、实时标签更新等场景的 ETL 流程。 要启用此功能,需在创建主键模型表时,开启 Merge-on-Write (MoW) 模式,并设置 enable_unique_key_partial_update 属性为 true。或者在数据导入时配置"partial_columns"参数 CREATE TABLE user_profiles ( user_id BIGINT, name STRING, age INT, last_login DATETIME ) UNIQUE KEY(user_id) DISTRIBUTED BY HASH(user_id) PROPERTIES ( "enable_unique_key_partial_update" = "true" ); -- 初始数据 -- user_id: 1, name: 'Alice', age: 30, last_login: '2023-10-01 10:00:00' -- 通过 Stream Load 导入部分更新数据,只更新 age 和 last_login -- {"user_id": 1, "age": 31, "last_login": "2023-10-26 18:00:00"} -- 更新后数据 -- user_id: 1, name: 'Alice', age: 31, last_login: '2023-10-26 18:00:00' 部分列更新原理概要 不同于传统的 OLTP 数据库,Doris 的部分列更新并非是原地的数据更新,为了让 Doris 有更好的写入吞吐以及查询性能,主键模型的部分列更新采取了“导入时将缺失字段补齐后再整行写入”的实现方案。如下图所示: 因此使用 Doris 的部分列更新存在“读放大”和“写放大”的影响。例如给一个 100 列的宽表更新 10 个字段,Doris 在写入过程中需要补齐缺失的 90 个字段,假设每个字段的大小接近,则 1MB 的 10 字段更新,会在 Doris 系统中产生大约 9MB 的数据读取(补齐缺失的字段),以及 10MB 的数据写入(补齐整行后写入到新的文件),也就是有大约 9 倍的读放大和 10 倍的写放大。 部分列更新性能建议 由于部分列更新存在读放大和写放大,同时 Doris 还是列存系统,在数据读取的过程中可能会产生大量随机 IO,因此对硬盘的随机读 IOPS 有较高的要求。由于传统的机械磁盘在随机 IO 上存在显著瓶颈,因此如果要使用部分列更新功能进行高频的写入,建议使用 SSD 硬盘,最好是 nvme 接口,能够提供最好的随机 IO 支撑。 同时,如果表很宽,也建议开启行存来减少随机 IO。开启行存后,Doris 会在列存之外额外的存储一份行存数据,由于行存数据每一行都是连续存储的,因此可以一次 IO 就读取到整行数据(列存则需要 N 次 IO 才能读取到所有缺失的字段,例如前面的 100 列宽表更新 10 列的例子,每一行需要 90 次 IO 才能读取到所有的字段) 3. 典型应用场景 Doris 强大的数据更新能力使其能够胜任多种要求严苛的实时分析场景。 3.1. CDC 数据实时同步 通过 Flink CDC 等工具捕获上游业务数据库(如 MySQL, PostgreSQL, Oracle)的变更数据(Binlog),并实时写入 Doris 的主键模型表,是构建实时数仓最经典的场景。 整库同步:Flink Doris Connector 内部集成了 Flink CDC,可以实现从上游数据库到 Doris 的自动化、端到端的整库同步,无需手动建表和配置字段映射。 保证一致性:利用主键模型的 UPSERT 能力处理上游的 INSERT 和 UPDATE 操作,利用 DORIS_DELETE_SIGN 处理 DELETE 操作,并结合 Sequence 列(如 Binlog 中的时间戳)处理乱序数据,完美复刻上游数据库的状态,实现毫秒级延迟的数据同步。 3.2. 实时宽表拼接 在很多分析场景中,需要将来自不同业务系统的数据拼接成一张用户宽表或商品宽表。传统的方式是使用离线的 ETL 任务(如 Spark 或 Hive)定期(T+1)进行拼接,实时性差,且维护成本高。或者使用 Flink 进行实时的宽表 join 计算,将拼接后的数据写入数据库,这通常需要消耗大量的计算资源。 利用 Doris 的部分列更新能力,可以极大地简化这一流程: 在 Doris 中创建一张主键模型的宽表。 将来自不同数据源(如用户基础信息、用户行为数据、交易数据等)的数据流通过 Stream Load 或 Routine Load 实时写入这张宽表。 每个数据流只负责更新自己相关的字段。例如,用户行为数据流只更新 page_view_count, last_login_time 等字段;交易数据流只更新 total_orders, total_amount 等字段。 这种方式不仅将宽表的构建从离线 ETL 转变为实时流式处理,大大提升了数据新鲜度,还因为只写入变化的列而减少了 I/O 开销,提升了写入性能。 4. 最佳实践 遵循以下最佳实践,可以帮助您更稳定、更高效地使用 Doris 的数据更新功能。 4.1. 通用性能实践 优先使用导入更新:对于高频、大量的更新操作,应优先选择 Stream Load, Routine Load 等导入方式,而非 UPDATE DML 语句。 攒批写入:避免使用 INSERT INTO 语句进行逐条的高频写入(如 > 100 TPS),因为每条 INSERT 都会产生一次事务开销。如果必须使用,应考虑开启 Group Commit 功能,将多个小批量提交合并成一个大事务。 谨慎使用高频 DELETE:在明细模型和聚合模型上,避免高频的 DELETE 操作,以防查询性能下降。 删除分区数据时使用 TRUNCATE PARTITION:如果需要删除整个分区的数据,应使用 TRUNCATE PARTITION,其效率远高于 DELETE。 串行执行 UPDATE:避免并发执行可能作用于相同数据行的 UPDATE 任务。 4.2. 存算分离架构下的主键模型实践 Doris 3.0 引入了先进的存算分离架构,带来了极致的弹性和更低的成本。在该架构下,由于 BE 无状态,因此在 Merge-on-Write 过程中,需要通过 MetaService 来维护一个全局状态以解决导入/compaction/schema change 之间的写写冲突。主键模型的 MoW 实现依赖于一个基于 Meta Service 的分布式表锁来保证写操作的一致性,如下图所示: 高频的导入和 Compaction 会导致对表锁的频繁竞争,因此需要特别注意以下几点: 控制单表导入频率:建议将单张主键表的导入频率控制在 60 次/秒 以内。可以通过攒批、调整导入并发等方式来降低频率。 合理设计分区分桶: 分区:利用时间分区(如按天或按小时)可以确保单次导入只更新少量分区,减少锁竞争的范围。 分桶:分桶数(Tablet 数量)应根据数据量合理设置,通常在 8-64 之间。过多的 Tablet 会加剧锁竞争。 调整 Compaction 策略:在写入压力非常大的场景下,可以适当调整 Compaction 策略,降低 Compaction 的频率,从而减少其与导入任务之间的锁冲突。 升级到最新稳定版本:Doris 社区正在持续优化存算分离架构下的主键模型性能。例如,即将发布的 3.1 版本对分布式表锁的实现进行了大幅优化。始终建议使用最新的稳定版本以获得最佳性能。 结论 Apache Doris 凭借其以主键模型为核心的强大、灵活且高效的数据更新能力,真正打破了传统 OLAP 系统在数据新鲜度上的瓶颈。无论是通过高性能的导入实现 UPSERT 和部分列更新,还是利用 Sequence 列保证乱序数据的一致性,Doris 都为构建端到端的实时分析应用提供了完整的解决方案。 通过深入理解其核心原理,掌握不同更新方式的适用场景,并遵循本文档提供的最佳实践,您将能够充分释放 Doris 的潜力,让实时数据真正成为驱动业务增长的强大引擎。

优秀的个人博客,低调大师

压缩率提升 48%,详解 Apache Doris 存储压缩优化之道|Deep Dive

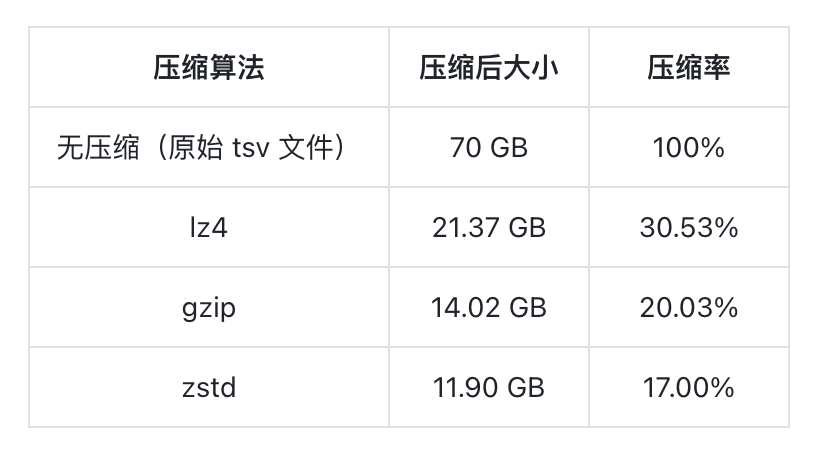
摘要 本文基于 ClickBench 数据集,展示了 Apache Doris 如何通过选择压缩算法、调整数据页大小与分桶数、优化编码策略以及改进数据排序来提升压缩效率。最终,相同数据集的压缩空间从 16.08 GB 降至 8.2 GB,压缩率提升 48.6%。通过合理的调整与优化,Doris 成功在保持查询性能的同时显著降低了存储成本。 在分析型数据库中,列式存储是压缩和查询性能的核心基础。它按列组织数据,同一列值类型一致且分布相似,为编码与压缩算法提供极高空间局部性和可预测性。当存储的值变化较小或重复频繁时,列式布局能够减少冗余存储,并提升向量化扫描的 CPU 效率。 Apache Doris 作为一款典型的列式存储引擎,可独立存储每一列数据。导入时,每列数据写入近似固定大小的数据页,经过编码和压缩处理,以实现更紧凑的存储。在 Doris 中,数据的压缩和解压均以数据页为单位,压缩算法的上下文限制在单个数据页内。因此,数据页大小、编码方式及压缩算法都直接影响最终的压缩效率和查询性能。 在接下来的章节中,我们将结合基于 ClickBench 数据集,较为直观的展示 Apache Doris 在存储压缩方面的优化思考及改进策略。 使读者了解如何通过数据页大小与分桶数调整、编码策略优化、数据排序来提升压缩效率。 一、数据集与基线结果 我们使用 ClickBench 公共数据集来进行本次测试。该数据集包含 10 个 tsv 文件,总大小约 70GB,包括网站访问日志类字段,如 URL、Referer、UserID 等。这类数据通常混合了短字符串与整数列,结构化特征明显。 在导入前先对原始数据进行文件级压缩测试,以作为基线参考: 随后将这批数据直接导入 Doris。使用默认建表参数,建表语句可参考:https://github.com/apache/doris/blob/master/tools/clickbench-tools/sql/create-clickbench-table.sql 数据导入后,整体存储空间约为 16.08 GB。在 Doris 的列式存储下,经过默认 LZ4 压缩,已实现相较于原始文件(21.37 GB)1.33x 倍的压缩效果。但如果从一个以高压缩比著称的列式系统角度来看,这一结果仍存在进一步的优化空间。 接下来从研发角度出发,依次对压缩算法、数据页参数与编码方式、数据排序及特征等层面介绍优化及改进思路。 二、选择合适的压缩算法 Doris 默认使用 LZ4 压缩算法,因其解压速度快且 CPU 占用均衡,适合大多数查询型负载。而在重复性强或结构化明显的数据场景中,LZ4 的压缩比较低。相较之下,ZSTD 提供更高的压缩率,但会增加压缩和解压的 CPU 消耗。在使用时,可根据实际情况灵活选择。 考虑到测试数据集中大量字符串字段存在相似前缀与重复片段的特征,我们将默认的 LZ4 压缩算法调整为 ZSTD,这可以通过在建表语句中设置表属性实现: CREATE TABLE IF NOT EXISTS hits ( .... ) DUPLICATE KEY (CounterID, EventDate, UserID, EventTime, WatchID) DISTRIBUTED BY HASH(UserID) BUCKETS 48 PROPERTIES ( "replication_num"="1", "compression"="ZSTD"); 经过该调整,表空间降至 12.9GB,相比 LZ4 减少了近 20%。虽然在导入阶段 CPU 开销略有上升,但查询性能几乎不受影响,表明 ZSTD 对典型分析型查询的解压成本是可接受的。 三、调整数据页大小与分桶数 在 Doris 的列式存储中,数据压缩的基本单位是数据页。每个数据页在写入之前经过编码与压缩,页内数据的相似程度直接影响通用压缩算法的效果。数据页的大小选择影响压缩效率与查询性能的平衡:过小的页无法形成可识别的模式,而过大的页会增加读取开销和内存负担。 Doris 默认数据页大小为 64KB,适合大部分场景。然而,对于具有明显模式或高重复率的数据集,过小的页会使数据被切得太碎,通用压缩算法的效率会变差。因此,适当增大页的大小可显著提升压缩效果。更大的页可覆盖更多连续数据,聚集相似值于同一压缩上下文内,让压缩算法更充分地挖掘重复模式与统计特征。 对于测试数据集来说,我们选择将页大小从默认的 64KB 调整为 1MB,并同时将分桶数从 48 减少到 4。分桶数越多,每个桶的数据越少,页内数据的相似性降低,压缩率就会下降。通过让数据集中到更少的桶中,可以提高页内数据的相似性,从而带来更好的压缩效果。 CREATE TABLE IF NOT EXISTS hits ( .... ) DUPLICATE KEY (CounterID, EventDate, UserID, EventTime, WatchID) DISTRIBUTED BY HASH(UserID) BUCKETS 4 PROPERTIES ( "replication_num"="1", "compression"="ZSTD", "storage_page_size"="1048576"); 经过测试,存储空间进一步减小到 10.71 GB。页更大、桶更少,使得压缩算法更有效去除冗余。 不过,页大小和分桶数并非越大越好。比如,在高并发查询的场景中,过大的页可能导致额外的 I/O 开销;而在分析型和离线统计类负载中,1MB 的页与较少的分桶数通常能取得最佳效果。因此,最佳取值应根据数据规模、查询模式与导入方式进行综合考虑。 四、优化编码方式 此外,数据在页内的编码方式也与列式存储压缩效果密切相关。Doris 针对不同类型的数据采用了多种编码策略:对整数默认使用 Bitshuffle 编码 + LZ4 压缩,对字符串则使用字典编码或纯二进制编码。这些编码在大多数场景中表现优异,但仍有进一步优化的空间。 01 问题定位 为明确编码方式的改进方向,我们在 Doris 中新增一个系统表:information_schema.column_data_sizes。它精确展示每一列在压缩前后的空间占用情况(压缩前uncompressed_bytes、压缩后compressed_bytes、原始数据raw_data_bytes)以及根据这些数据计算出的压缩比(ratio=compressed_bytes/uncompressed_bytes)。在系统表中执行如下查询: SELECT COLUMN_NAME, COLUMN_TYPE, sum(COMPRESSED_DATA_BYTES) AS compressed_bytes, sum(UNCOMPRESSED_DATA_BYTES) AS uncompressed_bytes, sum(RAW_DATA_BYTES) AS raw_data_bytes, round(sum(COMPRESSED_DATA_BYTES) * 100.0 / sum(UNCOMPRESSED_DATA_BYTES), 2) as ratio FROM information_schema.column_data_sizes WHERE table_id = 1761704935641 GROUP BY COLUMN_NAME, COLUMN_TYPE ORDER BY sum(COMPRESSED_DATA_BYTES) DESC; 查询结果如下(部分节选): +-----------------------+-------------+------------------+--------------------+----------------+--------+ | COLUMN_NAME | COLUMN_TYPE | compressed_bytes | uncompressed_bytes | raw_data_bytes | ratio | +-----------------------+-------------+------------------+--------------------+----------------+--------+ | URL | STRING | 1747139004 | 9404393858 | 9038895826 | 18.58 | | Referer | STRING | 1552943801 | 7023847152 | 6662498316 | 22.11 | | Title | STRING | 1480554020 | 9838412581 | 9488276782 | 15.05 | | OriginalURL | STRING | 810663093 | 5680006400 | 5317485214 | 14.27 | | WatchID | BIGINT | 781560948 | 781560948 | 799979976 | 100.00 | | URLHash | BIGINT | 760852247 | 766458338 | 799979976 | 99.27 | | RefererHash | BIGINT | 743785927 | 747950617 | 799979976 | 99.44 | | FUniqID | BIGINT | 389556325 | 512285220 | 799979976 | 76.04 | | UserID | BIGINT | 379008085 | 495166618 | 799979976 | 76.54 | | HID | INT | 371392630 | 371392630 | 399989988 | 100.00 | +-----------------------+-------------+------------------+--------------------+----------------+--------+ 从结果可知出,字符串列(URL, Referer, Title, OriginalURL)占据了压缩后大部分空间,而部分 BIGINT 列(WatchID,URLHash,RefererHash)的压缩率几乎是 100%。这说明字符串编码方式和整数编码方式还需优化。 02 字符串编码优化 这些存储占用大的字符串列(如 URL 与 Title)的长度大多都很短,平均长度不超过百字节。在 Doris 默认的字符串编码策略中,这类数据的存储方式并不完全高效。 字符串列默认采用 字典编码 与 Plain Binary 编码 的混合策略:系统在 segment 级别范围内优先对一列数据构建字典页,将重复字符串以索引形式存储,以减少空间占用;当字典页超过设定大小上限时(默认 256KB),后续数据自动退化为 Plain Binary 格式,其布局如下: | binary1 | binary2 | ... | offset1 (fixed uint32) | offset2 (fixed uint32) | ... 这种格式在页尾维护了一个定长的 uint32 数组,记录每个字符串在页内的偏移位置。而当短字符串量较多时,固定 4 字节的 offset 数组浪费空间。以 10 万条短字符串为例,仅 offset 数组就需要约 400 KB,这是一笔不小的开销,且压缩算法几乎无法对其有效压缩。 为了解决这一问题,我们重新设计了页内字符串的布局,将存储方式调整为“长度 加 内容”顺序写入: | length1 (varuint32) | binary1 | length2 (varuint32) | binary2 | ... 这种设计省去了独立的 offset 数组,通过变长整数(varuint32)直接记录字符串长度,提高页空间利用率。同时,数据的局部性得到改善,压缩算法(如 ZSTD)可以更有效地捕捉重复模式。经过修改,字符串列的存储空间进一步下降: +-----------------------+-------------+------------------+--------------------+----------------+--------+ | COLUMN_NAME | COLUMN_TYPE | compressed_bytes | uncompressed_bytes | raw_data_bytes | ratio | +-----------------------+-------------+------------------+--------------------+----------------+--------+ | URL | STRING | 1455177520 | 9057197818 | 9038895826 | 16.07 | | Referer | STRING | 1331679271 | 6730874117 | 6662498316 | 19.78 | | Title | STRING | 1122300920 | 9505664009 | 9488276782 | 11.81 | | WatchID | BIGINT | 800004249 | 800004249 | 799979976 | 100.00 | | OriginalURL | STRING | 768372911 | 5402777190 | 5317485214 | 14.22 | +-----------------------+-------------+------------------+--------------------+----------------+--------+ 03 整数编码的优化 在进一步分析 BIGINT 列(如 WatchID、URLHash)时,我们发现其数据分布特征与普通递增或低熵数据截然不同。这些列通常是哈希值或全局唯一 ID,熵值很高,默认使用的 Bitshuffle 编码加 LZ4 压缩效果几乎为零。 基于这一发现,通过设置 integer_type_default_use_plain_encoding=false 禁用了对这些列的 Bitshuffle 编码+ LZ4 压缩,直接写入原始字节序列再通过通用压缩算法压缩。这样省去无效的 Shuffle 操作和 Padding,结合 ZSTD 压缩算法,整体空间还略有下降,写入和读取性能也有所提升。 +-----------------------+-------------+------------------+--------------------+----------------+--------+ | COLUMN_NAME | COLUMN_TYPE | compressed_bytes | uncompressed_bytes | raw_data_bytes | ratio | +-----------------------+-------------+------------------+--------------------+----------------+--------+ | WatchID | BIGINT | 800004249 | 800004249 | 799979976 | 100.00 | | URLHash | BIGINT | 348739226 | 800004249 | 799979976 | 43.59 | | RefererHash | BIGINT | 295833828 | 800004249 | 799979976 | 36.98 | | FUniqID | BIGINT | 169720968 | 800004249 | 799979976 | 21.22 | | UserID | BIGINT | 169536965 | 800004249 | 799979976 | 21.19 | +-----------------------+-------------+------------------+--------------------+----------------+--------+ 04 优化效果 基于字符串和整数编码方式的改进,结合前面压缩算法与页参数的调整,表空间从最初的 16.08 GB 进一步降至 8.27 GB,整体压缩率较初始阶段提升约 48.6%。在此基础上,基于 ClickBench 查询集的测试结果显示,系统在热查询场景下保持了与原有版本相同的性能,而在冷查询场景下的性能提升近一倍,实现了压缩率与查询效率的双重收益。 五、数据本身的排序与特征 数据的排序与特征也是决定压缩效率的关键因素,常被忽视。列式存储的压缩效果依赖于相邻数据的相似性,若表的数据分布或排序与列值变化方向不一致,相似性将被打散,压缩算法难以识别模式。 在实际测试中,这种排序差异的影响非常显著。以刚才测试的 ClickBench 数据为例,通过系统表 information_schema.column_data_sizes,我们发现占用空间最大的列是 URL 列,压缩后约为 1.36 GB。 SELECT COLUMN_NAME,COLUMN_TYPE, sum(COMPRESSED_DATA_BYTES) AS compressed_bytes, sum(UNCOMPRESSED_DATA_BYTES) as uncompressed_bytes, sum(RAW_DATA_BYTES) as raw_data_bytes, round(sum(COMPRESSED_DATA_BYTES) * 100.0 / sum(UNCOMPRESSED_DATA_BYTES), 2) as ratio FROM information_schema.column_data_sizes WHERE table_id=1761728747278 GROUP BY COLUMN_NAME, COLUMN_TYPE ORDER BY sum(COMPRESSED_DATA_BYTES) desc limit 1; +-----------------------+-------------+------------------+--------------------+----------------+--------+ | COLUMN_NAME | COLUMN_TYPE | compressed_bytes | uncompressed_bytes | raw_data_bytes | ratio | +-----------------------+-------------+------------------+--------------------+----------------+--------+ | URL | STRING | 1456833417 | 9144581584 | 9038895826 | 15.93 | +-----------------------+-------------+------------------+--------------------+----------------+--------+ 将该列数据导入到一个仅包含 URL 一列并按照 URL 排序的新表中: create table t1( `URL` varchar(8000) NOT NULL ) DUPLICATE KEY (URL) DISTRIBUTED BY HASH(URL) BUCKETS 1 PROPERTIES ( "replication_num"="1", "storage_page_size"="1048576"); insert into t1 select URL from hits; 查看新表中该列的数据大小,为 0.72 GB: +-------------+-------------+------------------+--------------------+----------------+-------+ | COLUMN_NAME | COLUMN_TYPE | compressed_bytes | uncompressed_bytes | raw_data_bytes | ratio | +-------------+-------------+------------------+--------------------+----------------+-------+ | URL | VARCHAR | 773983002 | 9148474115 | 9038895826 | 8.46 | +-------------+-------------+------------------+--------------------+----------------+-------+ 可以看到,在仅调整了排序与数据聚集方式后,压缩后数据大小从 1.36 GB 减少到了 0.72 GB,压缩比从 15.9% 提升到 8.46%,压缩空间几乎减少了一半。这充分说明了数据的有序性与局部相似性对压缩率的决定性影响。 因此,当用户发现 Doris 的压缩率与其他系统存在差异时,除了压缩算法与参数的区别,更常见的原因在于数据排序和分布模式的不同。压缩算法的效率对数据本身的排序极为敏感,合理设计排序键、分桶列、分桶数与导入方式,往往能带来更大的收益。因此,理解数据的分布特征、控制其在物理层面的布局,是提升 Doris 存储效率的核心手段。 六、结束语 在实际场景中,实现高压缩比的数据存储充满挑战,但列式存储系统 Doris 让这一目标变得可行。经过一系列针对性优化,最终数据的存储空间从最初的 16.08 GB 降至 8.2 GB,整体压缩率提升超过 48%。这一结果并非来自某一个独立的技术点,而是多层次调整叠加的结果:压缩算法的优化、页大小与分桶参数的调整,以及对数据特征的深入理解共同作用,才让压缩效率得到显著提升。

优秀的个人博客,低调大师

Apache Doris 内部数据裁剪与过滤机制的实现原理 | Deep Dive

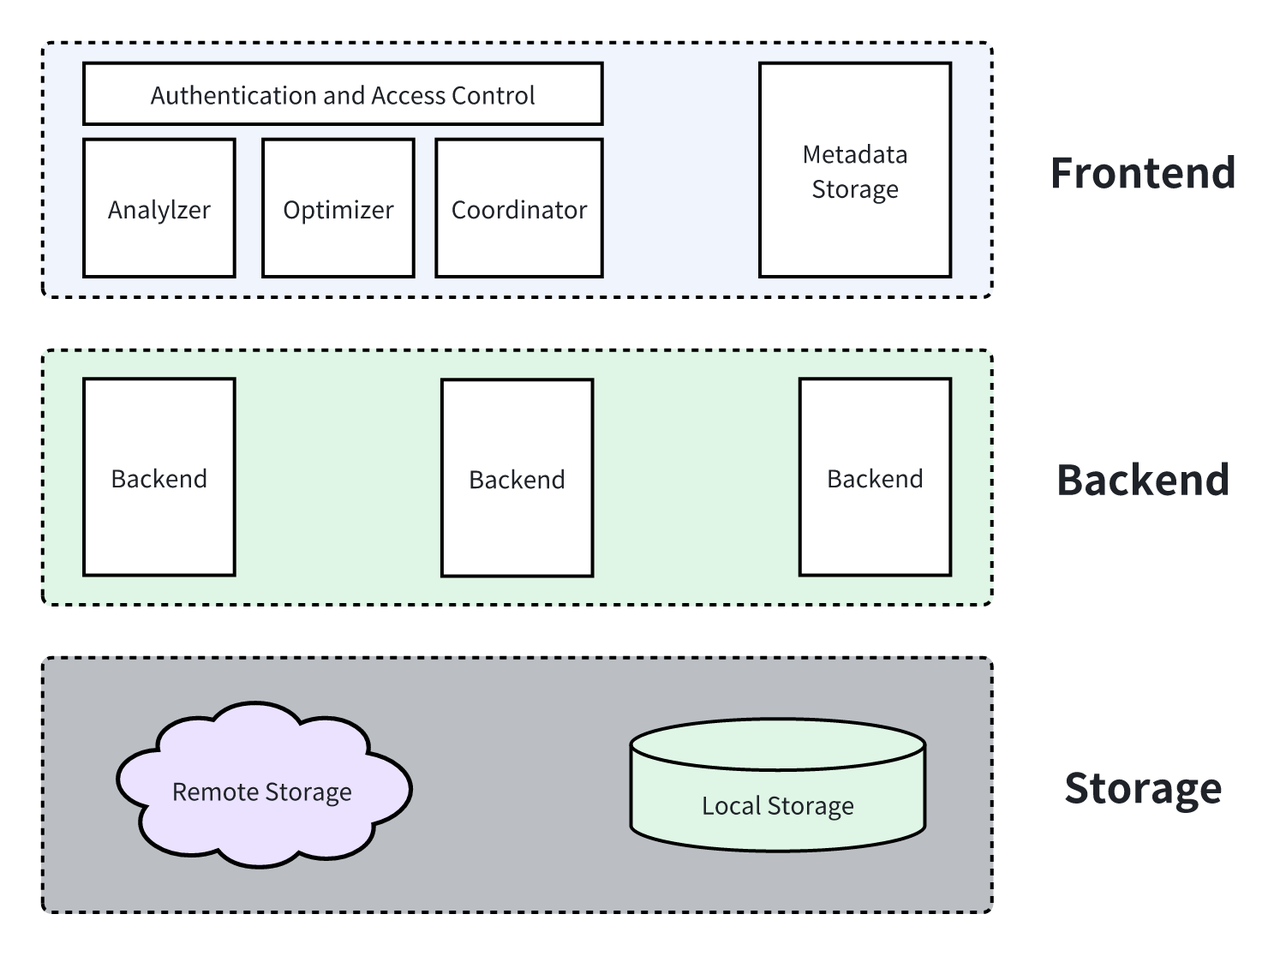
一、概述 对于分析型数据库系统来说,读取数据所需要的磁盘 IO 和网络资源耗费了大量的机器资源,尤其是存算分离模式下,远端存储的数据通过网络传输到本地进行数据处理,所以数据裁剪能力对于分析型数据库系统来说非常重要。近期的研究中也体现出这点,比如在扫描节点上使用过滤操作可以降低 **50%**以上的执行时间[1],PowerDrill 通过应用恰当的策略可以裁剪 **92.41%**的数据读取,而 Snowflake 的测试显示其在自己的消费者数据集上可以裁剪 **99.4%**的数据[2]。 以上的例子是基于不同的数据集的测试结果,并不具有直接的比较价值,但是我们可以得到一个确切的结论,对于现代分析型数据系统,处理数据最快的方式就是尽可能不去处理数据。在 Apache Doris 中,我们探索了多种方式让系统变得更加智能,从而尽可能跳过不需要处理的数据。本文将对 Apache Doris 中所有用到的数据裁剪优化技术进行展开讨论。 二、相关工作 现代分析型数据库系统中,数据通常以水平分区的方式存储在不同的物理空间当中,通过使用分区级别的元数据,数据库执行引擎可以跳过所有不需要处理的数据。例如使用每一列的最大/最小值和查询当中存在的谓词做比较,从而可以跳过所有不符合条件的分区,具体的方法有 zone map[3]和 SMA[4]。还有一种通用的方法是使用二级索引技术,比如使用 Bloom-filter[5],Cuckoo-filters[6] 或者 Xor-filters[7]。另外,许多数据库也实现了一些数据的动态过滤方法,所谓动态过滤,就是在查询执行的过程中生成过滤谓词,并使用运行中生成的谓词对数据进行过滤,相关研究包括[8][9]。 三、Apache Doris 架构介绍 Apache Doris[10]是面向实时分析的现代数据仓库。在这一部分中,我们会简单介绍整体的架构以及现有架构中 Apache Doris 处理数据过滤的概念与能力。 3.1 Apache Doris 整体架构 一个完整的集群包括了 Frontend,Backend 和存储组件三个部分,其中: Frontend 主要是作为服务接口面向用户,完成对 DDL/DML 等任务进行解析,使用优化器对任务进行优化,收集 Backend 执行结果等功能。 Backend 作为系统的执行组件,主要通过一系列控制逻辑以及复杂计算操作对数据进行加工最终返回用户需要的数据。 存储组件作为数据最终存储的位置,需要管理数据分区、数据读写。在 Apache Doris 中,存储组件根据目的位置分为本地存储和云端存储。 3.2 Apache Doris 数据存储概述 在 Apache Doris 的数据模型中,一个数据表通常包含了分区列、Key 列以及数据列。在存储层中,分区的信息在元数据中进行维护,当有用户的查询到达时,Frontend 可以直接根据元数据的信息决定要读取哪些分区的数据。而 Key 列主要是为了能够在存储层完成一些数据聚合的需求,在实际的数据文件中,由 partition 进一步拆分得到的 Segment 按照 Key 列的顺序对数据进行组织,也就是说,Key 列在 segment 内部是有序的。在 Segment 内部,每一列又以单独的列数据文件进行存储,这也是 Doris 中存储的最小单位的数据文件。列数据文件中又进一步维护了该文件的元数据,例如最大最小值等。 3.3 Apache Doris 数据裁剪概述 根据数据裁剪发生的时间,我们将数据裁剪分为两大类,即静态裁剪 和动态裁剪。其中,静态裁剪指查询 SQL 被查询解析器和优化器处理后直接决定的数据裁剪。通常来说,这种方式主要包括 SQL 中已经被写好的过滤谓词,例如当需要查询 a > 1 的数据时,我们可以在优化器中直接决定不再读取 a <= 1 的全部分区。与之相反,动态裁剪是发生在执行过程中决定的裁剪策略。例如,对于一个包含简单等值内连接(inner join)的查询来说,probe 侧只需要读取与 build 侧值相同的行的数据即可,这就需要我们在运行时动态获取这些值并且使用它进行数据裁剪。 更进一步地,为了详细阐述 Apache Doris 中每一种数据裁剪技术的实现细节,我们根据不同的裁剪方式进一步将数据裁剪技术分为 4 种,分别是谓词过滤 ,LIMIT 裁剪 ,TopK 裁剪 和 JOIN 裁剪。其中谓词过滤由用户的 SQL 决定,所以其属于静态数据裁剪。其余 3 种均属于动态裁剪。 Apache Doris 集群的执行层通常包含多个实例,所以动态裁剪的挑战也越大,这是因为在动态裁剪的过程中,我们需要在多个实例中进行交互与协调。后面也将对这里的一些细节进行展开探讨。 四、谓词静态过滤 在 Apache Doris 中,静态谓词在 Frontend 内部经过 Analyzer 和 Optimizer 之后产生。根据这些静态谓词作用的不同列,其生效的时间也不一样。具体而言, 对于分区列的谓词来说,Frontend 能够通过读取到的元数据来确定所需的数据存储在哪些分区中,从而直接对数据分区进行裁剪,这也是最高效的数据裁剪方式。 对于 Key 列的谓词来说,由于 Segment 内部以 Key 列的顺序进行数据的组织,所以我们只需要根据谓词生成 Key 列的上界和下界,再通过二分查找的方式就可以得到我们需要读取的行的范围。 对于普通列的谓词来说,首先单个的列文件中维护了最大最小值等元数据信息,所以我们能够根据谓词条件和元数据进行比较对列文件进行过滤,然后我们读取全部需要读取的列文件再进行谓词计算,就得到了谓词过滤后的数据行号。 接下来我们用一些简单的例子进行解释。首先我们定义表结构, CREATE TABLE IF NOT EXISTS `tbl` ( a int, b int, c int ) ENGINE=OLAP DUPLICATE KEY(a,b) PARTITION BY RANGE(a) ( PARTITION partition1 VALUES LESS THAN (1), PARTITION partition2 VALUES LESS THAN (2), PARTITION partition3 VALUES LESS THAN (3) ) DISTRIBUTED BY HASH(b) BUCKETS 8 PROPERTIES ( "replication_allocation" = "tag.location.default: 1" ); 然后我们插入数据到p1,p2,p3这三个分区中: 4.1 分区列谓词过滤 SELECT * FROM `tbl` WHERE `a` > 0; 如前所述,分区裁剪在 Frontend 层完成,通过与元信息交互就可以查询到所有需要的分区。 4.2 Key 列谓词过滤 使用以下 SQL 对表进行查询,其中b列为 key 列。 SELECT * FROM `tbl` WHERE `b` > 0; 在上述例子中,存储层使用谓词中 Key 列的下界 0(非包含)对 segment 进行二分查找,最终返回符合条件的数据的行号 1(第二行),根据行号再进行其他列的数据读取。 4.3 数据列谓词过滤 使用以下 SQL 对表进行查询,其中c列为数据列。 SELECT * FROM `tbl` WHERE `c` > 2; 在上述例子中,存储层在所有的 Segment 中使用数据谓词中c列的数据文件进行计算,在计算之前首先根据数据文件中维护的最大最小值决定是否跳过当前文件的读取,在本例中,Column File 0 的最大值小于我们需要读取的数据的下界,所以可以直接跳过对应数据的读取,而在计算 Column File 1 后我们得到了匹配数据的行号,根据行号我们就可以再进一步读取其它列对应行的数据。 五、LIMIT 动态数据裁剪 在分析型任务中,LIMIT 查询是非常常见的一类查询[11]。对于普通查询来说,Doris 使用并发读取的方式来加速数据扫描,而对于 LIMIT 查询来说,Doris 使用了不同的策略从而对数据进行提前裁剪。 对于 Scan 上出现的 LIMIT,为了尽可能避免读取不需要的数据,Doris 把扫描并发设置为 1,并在返回数据行数到达 LIMIT 后停止。 对于其它节点上出现的 LIMIT,Doris 执行引擎在数据达到 LIMIT 需要后立刻停止上游所有数据读取。 六、TopK 数据裁剪 TopK 查询在 BI 业务中是一类非常广泛使用的查询。简单来说,TopK 查询是指根据某几列顺序取出的前 K 个结果。和 LIMIT 裁剪类似,如果我们按照最基础的方法,把数据做完整排序再取最靠前的 K 个结果,那么扫描数据带来的开销是非常大的。所以,在数据库系统中,一般我们采用堆排序的方法来执行排序。在堆排序的过程中,我们如果能够应用一些特殊的优化手段,只扫描符合查询条件的数据,将会大大提升查询执行的效率。 标准堆排序方法 处理 TopK 查询最直观的方法是维护一个最小堆(对于降序排序),随着数据不断被扫描出来,也将被插入这个堆中,这也伴随着堆的更新。在这个过程中,不在堆中的数据将被丢弃,即不存在维护其它数据的开销。在所有数据都被扫描结束后,堆中的数据就都是我们需要的数据。 理论最优解法 理论最优解法是指我们能够扫描数据得到正确结果所需要的数据扫描量。在 Doris 中,数据在 Segment 内部按照 Key 列顺序存储(见 3.2),所以当 TopK 查询的结果是按照 Key 列进行排序时,我们只需要读取每个 Segment 的前 K 行,再对其进行汇总排序就可以得到最终结果。而如果排序结果是根据非 Key 列进行排序时,那么理论最优方法应该是读取每个 Segment 的排序数据进行排序,随后再根据排序结果取出对应行的数据,而不需要读取全部数据进行排序。 针对 TopK 类型的查询,Doris 做了针对性的优化。首先我们在数据扫描的线程中,先对数据做一个局部裁剪,随后再利用一个全局的 Coordinator 做数据的完整排序,并根据排序结果对数据进行全局裁剪。所以,TopK 查询在 Doris 执行过程中其实经历了两个阶段,第一个阶段中我们按照上述解法读出排序列,并对其进行局部排序和全局排序,得到满足条件的数据的行号。第二阶段我们根据第一阶段排序得到的行号重新读取我们需要的全部列得到输出结果。 6.1 局部数据裁剪 通常来说,Apache Doris 以集群的形式为用户提供服务。在集群执行查询的过程中,数据首先被多个独立的线程读取出来,然后再经过各自计算,最终到达一个汇总线程得到最终结果。 在 TopK 查询中,扫描数据的独立线程需要首先完成对数据的局部裁剪。具体来说,每个扫描节点都伴随着一个 TopK 节点,这个 TopK 节点需要维护一个大小为 K 的堆,当数据行数小于 K 时,代表数据量没有到达查询结果的行数,所以继续扫描接下来的数据。当数据量到达 K 时,我们就需要丢弃其它不需要的数据,而在下一次扫描数据时,我们把这个堆顶元素作为过滤谓词,即只需要扫描出比它更小的数据。用这种方式,我们不断读出比堆顶元素更小的数据并且不断更新堆,再用新的堆顶元素去过滤数据,这样的方式能够保证我们每次读到的数据都是当前阶段满足 TopK 条件的数据。 6.2 全局数据裁剪 在经过局部数据裁剪后,N 个执行线程会最多返回 NK 行符合条件的结果,所以我们还需要对这些数据再做一次汇总排序,才能得到最终结果。这一步中,我们依旧使用堆排序,把 NK 个数据进行排序,最终得到满足条件的 K 条数据及其行号输出给 Scan,再进一步读出查询结果所需的其他列。 6.3 复杂查询的 TopK 裁剪 上述两部分中,局部数据裁剪不涉及多线程协作,所以比较直观,只要在扫描数据的阶段能够感知到 TopK,就可以完成局部堆的维护和使用。而全局数据裁剪的方法比较复杂,在一个数据库集群中,这个全局协调节点的工作方式直接影响了查询正确性和性能。在 Doris 中,我们设计了一个通用的 Coordinator,这个 Coordinator 对于全部 TopK 查询都同样适用,例如对于包含多表连接的查询来说,我们只需要在第一阶段读出所有需要计算表连接和排序的列进行排序,第二阶段再使用同样的方式,把行号下推到多个表中进行扫描即可。 七、JOIN 数据裁剪 多表连接(join)是数据库系统中最为耗时的操作。从执行的角度来说,数据越少,那么 Join 带来的开销也就越小。如果使用两个表做暴力连接,即计算笛卡尔积,假设两个表的大小分别是 M 和 N,那么笛卡尔积的时间复杂度就是 O(M*N)。所以通常来说我们会选择 Hash Join 作为一种更高效的表连接方法。在 Hash Join 中,我们首先选择数据量少的表作为 Join 的 Build 侧,根据其中的数据构建一个 Hash Table。随后,我们使用另一侧的表作为 Probe 侧,对 Hash Table 进行探测。理想情况下,我们不考虑访存影响,并且假定使用的数据和数据结构都是高效的,那么完成一行数据的 Build 和 Probe 的复杂度都是 O(1),整个 Hash Join 的复杂度是 O(M+N)。由于 Probe 侧数据一般都远大于 Build 侧,所以如何减少 Probe 侧数据的读取和计算是一个非常重要的课题。 在 Apache Doris 中,我们提供了多种方法完成 Probe 侧数据的裁剪。由于 Hash Table 中 Build 侧数据的值是确定的,所以我们可以根据数据量的大小对 JOIN 数据裁剪的方式进行选择。 7.1 JOIN 数据裁剪算法 对于 Join 来说,数据裁剪的预期结果是在不影响正确性的条件下,降低探测阶段的开销。所以我们需要权衡根据 Hash Table 构建谓词的开销以及探测的开销。当 Hash Table 的数据很少时,我们可以直接构造出一个精确谓词,比如一个 In 谓词,In 谓词保证了所有参与探测的数据一定是最终需要输出的结果。 而当 Build 侧数据量大于一定阈值时,构造 In 谓词需要的去重开销就会变得很大。对于这种情况,Doris 舍弃了一部分探测的性能,即降低数据的过滤率,转而选择了构建和计算开销都更低的 Bloom Filter[5]。Bloom Filter 是一种允许一定误判率(the Flase Positive Probability,e.g。 FPP)的高效过滤器。通过使用 Bloom Filter,我们能够在 Build 侧数据量很大的时候同样拥有较低的谓词构建开销,同时,因为数据被过滤后最终还需要经过 Join 的探测过程,所以正确性也能够保证。 在 Apache Doris 中,Join 过滤谓词在运行时动态构建,无法在执行前静态确定,因此我们默认采用了一种自适应的方式,即首先使用 In 谓词进行构建,当去重值的数量到达一定数量后,重新构建 Bloom Filter 作为 JOIN 谓词。 7.2 JOIN 谓词等待策略 由于 Bloom Filter 的构建也需要一定的开销,所以 Doris 中自适应的裁剪算法选择并不能完全避免 Build 侧开销非常大的时候查询等待延迟特别高的问题。所以 Doris 引入了 Join 谓词等待的策略。默认情况下,我们假定这个谓词在 1 秒内构建完成,所以 Probe 侧数据扫描最多等待 1 秒,如果还没有等到 Build 侧传过来的谓词就直接开始执行。 与此同时,如果在数据扫描过程中,Build 侧的谓词构建完成,则在谓词构建完成后立刻发给 Probe 侧对之后的数据进行过滤。 八、总结与展望 本文展示了 Apache Doris 中,谓词过滤、LIMIT 数据裁剪、TopK 数据裁剪、JOIN 数据裁剪四种数据裁剪方式的实现策略。目前,Apache Doris 通过这四类高效的数据裁剪策略极大提升了处理数据的效率。根据 SnowFlake 在 2024 年的客户数据[12],谓词裁剪、TopK 裁剪、Join 裁剪的裁剪率的平均值都超过了 50%,而 LIMIT 裁剪的裁剪率平均值在 10%。可以看出,四类裁剪策略极大影响了客户的查询执行效率。 在未来,Apache Doris 社区将继续探索更通用、更高效的数据裁剪策略。在数据需求越来越大的当下,数据裁剪的效率将很大程度影响数据库系统的处理效率,所以,这将是一个持续的发展方向。 参考文献 [1] Alexander van Renen and Viktor Leis. 2023. Cloud Analytics Benchmark. Proc. VLDB Endow. 16, 6 (2023), 1413--1425. doi:10.14778/3583140.3583156 [2] Alexander Hall, Olaf Bachmann, Robert Büssow, Silviu Ganceanu, and Marc Nunkesser. 2012. Processing a Trillion Cells per Mouse Click. Proc. VLDB Endow. 5, 11 (2012), 1436--1446. doi:10.14778/2350229.2350259 [3] Goetz Graefe. 2009. Fast Loads and Fast Queries. In Data Warehousing and Knowledge Discovery, 11th International Conference, DaWaK 2009, Linz, Austria, August 31 - September 2, 2009, Proceedings (Lecture Notes in Computer Science, Vol. 5691), Torben Bach Pedersen, Mukesh K. Mohania, and A Min Tjoa (Eds.). Springer, 111--124. doi:10.1007/978-3-642-03730-6_10 [4] Guido Moerkotte. 1998. Small Materialized Aggregates: A Light Weight Index Structure for Data Warehousing. In VLDB'98, Proceedings of 24rd International Conference on Very Large Data Bases, August 24-27, 1998, New York City, New York, USA, Ashish Gupta, Oded Shmueli, and Jennifer Widom (Eds.). Morgan Kaufmann, 476--487. http://www.vldb.org/conf/1998/p476.pdf [5] Burton H. Bloom. 1970. Space/Time Trade-offs in Hash Coding with Allowable Errors. Commun. ACM 13, 7 (1970), 422--426. doi:10.1145/362686.362692 [6] Bin Fan, David G. Andersen, Michael Kaminsky, and Michael Mitzenmacher. 2014. Cuckoo Filter: Practically Better Than Bloom. In Proceedings of the 10th ACM International on Conference on emerging Networking Experiments and Technologies, CoNEXT 2014, Sydney, Australia, December 2-5, 2014, Aruna Seneviratne, Christophe Diot, Jim Kurose, Augustin Chaintreau, and Luigi Rizzo (Eds.). ACM, 75--88. doi:10.1145/2674005.2674994 [7] Martin Dietzfelbinger and Rasmus Pagh. 2008. Succinct Data Structures for Retrieval and Approximate Membership (Extended Abstract). In Automata, Languages and Programming, 35th International Colloquium, ICALP 2008, Reykjavik, Iceland, July 7-11, 2008, Proceedings, Part I: Tack A: Algorithms, Automata, Complexity, and Games (Lecture Notes in Computer Science, Vol. 5125), Luca Aceto, Ivan Damgård, Leslie Ann Goldberg, Magnús M. Halldórsson, Anna Ingólfsdóttir, and Igor Walukiewicz (Eds.). Springer, 385--396. doi:10.1007/978-3-540-70575-8_32 [8] Lothar F. Mackert and Guy M. Lohman. 1986. R* Optimizer Validation and Performance Evaluation for Local Queries. In Proceedings of the 1986 ACM SIGMOD International Conference on Management of Data, Washington, DC, USA, May 28-30, 1986, Carlo Zaniolo (Ed.). ACM Press, 84--95. doi:10.1145/16894.16863 [9] James K. Mullin. 1990. Optimal Semijoins for Distributed Database Systems. IEEE Trans. Software Eng. 16, 5 (1990), 558--560. doi:10.1109/32.52778 [10] https://doris.apache.org/ [11] Pat Hanrahan. 2012. Analytic database technologies for a new kind of user: the data enthusiast. In Proceedings of the ACM SIGMOD International Conference on Management of Data, SIGMOD 2012, Scottsdale, AZ, USA, May 20-24, 2012, K. Selçuk Candan, Yi Chen, Richard T. Snodgrass, Luis Gravano, and Ariel Fuxman (Eds.). ACM, 577--578. doi:10.1145/2213836.2213902 [12] Andreas Zimmerer, Damien Dam, Jan Kossmann, Juliane Waack, Ismail Oukid, Andreas Kipf. Pruning in Snowflake: Working Smarter, Not Harder. SIGMOD Conference Companion 2025: 757-770

优秀的个人博客,低调大师

Apache Doris 全新分区策略 Auto Partition 应用场景与功能详解 | Deep Dive系列

编辑:SelectDB 技术团队 在当今数据驱动的时代,如何高效、有序地管理数据库中的海量数据成为挑战。为了处理庞大的数据集,分布式数据库引入了类似分区和分桶策略,通过将数据按特定规则划分成较小的单位并分布到不同节点上,利用并行计算能力以提升处理和分析性能,并加强了数据管理的灵活性。 在 Apache Doris 中,数据划分包含分区和分桶两个层级。分区一般按照时间或其他连续值对数据进行划分,在查询时,通过分区裁剪过滤不必要的范围扫描,提升执行效率,同时极大地方便了对分区数据的增删改等管理操作;分桶则是基于某个或某些列的哈希值将数据分配到不同的桶中,从而有效定位数据、避免数据倾斜。 在 2.1 版本以前,Apache Doris 的分区主要依赖手动分区和动态分区功能(Dynamic Partition)自动创建两种方式: 手动创建分区:需要在建表时指定该表包含的分区,或者在使用过程中通过 DDL 语句修改。 动态分区:主要支持按照时间维度分区,以建表时的现实时间为标准来维护一个范围内的分区。 这两种方式都有其不够灵活之处,因此我们在 2.1 版本引入了 自动分区(Auto Partition)来拓展分区功能。自动分区同时支持按时间维度的 Range 分区,和支持多种数据类型的 List 分区,按照导入数据的实际分布创建分区,提供了更为灵活的分区创建手段,相比于动态分区,保证流程自动化的前提下极大提升了分区使用的自由度。 分区策略演进 面对数据分布的设计维度时,我们往往更关注分区的规划,因为分区列和分区间隔的选择与实际的数据分布模式强相关,合理的分区设计能够大幅提升表的查询和存储效率。 在 Doris 中,数据表(Table)按照分区(Partition)和分桶(Bucket)两种方式依次划分,最终同一个分桶中的数据形成数据分片(Tablet,可视作 Bucket)。Tablet 是 Doris 中多副本高可用、集群间数据调度与均衡的最小物理存储单位。图示如下: 01 手动创建分区 最常见也最基本的创建方式是手动创建,Doris 支持 Range 和 List 两种分区创建方式。对于日志、交易记录等基础业务场景,数据的时间维度较为明确,我们一般按照时间维度创建 Range 分区,建表语句示例如下: -- Range Partition CREATE TABLE IF NOT EXISTS example_range_tbl ( `user_id` LARGEINT NOT NULL COMMENT "用户id", `date` DATE NOT NULL COMMENT "数据灌入日期时间", `timestamp` DATETIME NOT NULL COMMENT "数据灌入的时间戳", `city` VARCHAR(20) COMMENT "用户所在城市", `age` SMALLINT COMMENT "用户年龄", `sex` TINYINT COMMENT "用户性别", `last_visit_date` DATETIME REPLACE DEFAULT "1970-01-01 00:00:00" COMMENT "用户最后一次访问时间", `cost` BIGINT SUM DEFAULT "0" COMMENT "用户总消费", `max_dwell_time` INT MAX DEFAULT "0" COMMENT "用户最大停留时间", `min_dwell_time` INT MIN DEFAULT "99999" COMMENT "用户最小停留时间" ) ENGINE=OLAP AGGREGATE KEY(`user_id`, `date`, `timestamp`, `city`, `age`, `sex`) PARTITION BY RANGE(`date`) ( PARTITION `p201701` VALUES LESS THAN ("2017-02-01"), PARTITION `p201702` VALUES LESS THAN ("2017-03-01"), PARTITION `p201703` VALUES LESS THAN ("2017-04-01"), PARTITION `p2018` VALUES [("2018-01-01"), ("2019-01-01")) ) DISTRIBUTED BY HASH(`user_id`) BUCKETS 16 PROPERTIES ( "replication_num" = "1" ); 该表按照数据导入日期 date 进行分区,并预先创建了 4 个分区。在每个分区下,又根据 user_id 的哈希值划分成 16 个分桶。此时对 2018 年及以后的数据查询时,根据该表的分区设计,实际我们只需要对 p2018 进行扫描,查询语句如下: mysql> desc select count() from example_range_tbl where date >= '20180101'; +--------------------------------------------------------------------------------------+ | Explain String(Nereids Planner) | +--------------------------------------------------------------------------------------+ | PLAN FRAGMENT 0 | | OUTPUT EXPRS: | | count(*)[#11] | | PARTITION: UNPARTITIONED | | | | ...... | | | | 0:VOlapScanNode(193) | | TABLE: test.example_range_tbl(example_range_tbl), PREAGGREGATION: OFF. | | PREDICATES: (date[#1] >= '2018-01-01') | | partitions=1/4 (p2018), tablets=16/16, tabletList=561490,561492,561494 ... | | cardinality=0, avgRowSize=0.0, numNodes=1 | | pushAggOp=NONE | | | +--------------------------------------------------------------------------------------+ 即使入库的数据集中在某几个分区内,分桶的哈希运算机制也能根据 user_id 的值对数据进行二次划分,避免在查询和存储时对部分机器造成不合理的负载倾斜。 在数据量较少的情况下,手动分区尚能应对,而在实际业务场景中,一个集群可能有上万张分区表,此时管理难度将呈指数级上升。例如: CREATE TABLE `DAILY_TRADE_VALUE` ( `TRADE_DATE` datev2 NOT NULL COMMENT '交易日期', `TRADE_ID` varchar(40) NOT NULL COMMENT '交易编号', ...... ) UNIQUE KEY(`TRADE_DATE`, `TRADE_ID`) PARTITION BY RANGE(`TRADE_DATE`) ( PARTITION p_200001 VALUES [('2000-01-01'), ('2000-02-01')), PARTITION p_200002 VALUES [('2000-02-01'), ('2000-03-01')), PARTITION p_200003 VALUES [('2000-03-01'), ('2000-04-01')), PARTITION p_200004 VALUES [('2000-04-01'), ('2000-05-01')), PARTITION p_200005 VALUES [('2000-05-01'), ('2000-06-01')), PARTITION p_200006 VALUES [('2000-06-01'), ('2000-07-01')), PARTITION p_200007 VALUES [('2000-07-01'), ('2000-08-01')), PARTITION p_200008 VALUES [('2000-08-01'), ('2000-09-01')), PARTITION p_200009 VALUES [('2000-09-01'), ('2000-10-01')), PARTITION p_200010 VALUES [('2000-10-01'), ('2000-11-01')), PARTITION p_200011 VALUES [('2000-11-01'), ('2000-12-01')), PARTITION p_200012 VALUES [('2000-12-01'), ('2001-01-01')), PARTITION p_200101 VALUES [('2001-01-01'), ('2001-02-01')), ...... ) DISTRIBUTED BY HASH(`TRADE_DATE`) BUCKETS 10 PROPERTIES ( ...... ); 该表通过手动、逐月的方式创建分区,每个月都需要手动重复增添下一个分区。这不仅需要管理员定期维护表结构变更,在处理实时数据时,可能还需要更频繁地按天、甚至按小时来划分数据分区,给 DBA 带来了沉重负担。 02 动态分区 因此 Doris 引入了动态分区(Dynamic partition)来处理重复性较高的时间分区需求,自动化创建和回收数据分区。通过指定分区单位、历史分区数量和未来分区数量,让 Doris 根据现实时间自动完成分区的创建和回收。 例如按天为单位创建分区,设置 start 为 -7 ,end 为 3:预创建未来 3 天的数据分区,并自动回收距今超过 7 天的历史数据分区。这一功能的实现依赖 FE 端的固定线程,通过不断轮询,检查当前是否需要创建新分区或回收旧分区,从而定期更新数据表的分区结构,建表语句示例如下: CREATE TABLE `DAILY_TRADE_VALUE` ( `TRADE_DATE` datev2 NOT NULL COMMENT '交易日期', `TRADE_ID` varchar(40) NOT NULL COMMENT '交易编号', ...... ) UNIQUE KEY(`TRADE_DATE`, `TRADE_ID`) PARTITION BY RANGE(`TRADE_DATE`) () DISTRIBUTED BY HASH(`TRADE_DATE`) BUCKETS 10 PROPERTIES ( "dynamic_partition.enable" = "true", "dynamic_partition.time_unit" = "DAY", "dynamic_partition.start" = "-7", "dynamic_partition.end" = "3", "dynamic_partition.prefix" = "p", "dynamic_partition.buckets" = "10" ); 随时间推移,该表将始终保持 [当前日期-7, 当前日期+3] 范围内的分区。对于实时数据收集场景,例如 ODS 层直接从外部数据源(如 Kafka)接收数据时,动态分区功能尤为适用。 由于 start 和 end 参数限定了分区的固定范围,用户只能在此范围内管理分区,若需要包含更久远的历史数据,不得不将start 值调大,而这会导致集群中元数据的不必要浪费。因此,在使用动态分区功能时,需要权衡实时管理的便利性与元数据管理的效率。 数据库分区管理的设计思考 对于更复杂的业务场景来说,动态分区有着明显的局限性: 仅支持 Range 分区,而无法支持 List 分区 只能应用于现实世界的时间维度,如果数据与现实时间无关则无法使用 只能包含 1 个连续分区段,无法容纳该范围以外的分区 这导致在某些特定场景下,无法仅依靠动态分区实现分区管理,例如: 当分区的时间维度不再和当前现实时间相关,而是对历史数据进行重放计算。例如处理过往某一年的数据,且需要进行天级别的分区。 在当前数据导入过程中,偶尔发生历史数据变更。例如在天级别的分区表中,偶尔导入若干年前的数据,是否需要将动态分区的 start 调整到非常大的级别以容纳这些数据? 基于上述的功能局限,我们开始思考,能否提出一种新的分区方式,进一步提升分区管理的自动化程度、简化数据表的维护工作?分析发现,理想分区的实现是同时满足 2 个条件: 建表后无需手动调整分区 所有的入库数据都有对应分区 前者是动态分区已经具备的"自动化"能力,后者是希望拥有一种"更加灵活"的分区创建能力。而这种能力的本质,是要求分区创建与实际数据关联。 因此我们开始思考:分区的创建能否从建表时或者日常轮询,延后到数据到达时?从预先构造分区的分布,转为定义"从数据到分区"的映射规则,等数据入库后等待分区容纳时,再根据规则创建对应的分区。这样,相较于手动分区,整个流程都是自动发生的,不再需要人工维护;相较于动态分区,避免了有而无用和用而没有的分区情况。 让分区的创建与实际数据的分布自动关联, 是我们理想分区方式的核心思想。 更灵活便捷的自动分区创建策略 基于以上思考,我们在 Apache Doris 2.1 版本引入了"自动分区"(Auto Partition)功能,不再预先创建分区,而是在数据导入过程中根据设置的规则为创建对应的分区。负责数据处理、分发的 BE 节点会在执行计划的 DataSink 算子中尝试为每行数据找到它所属的 Partition。在以往分区表中,找不到对应分区的新增导入数据将被过滤或直接报错。而在自动分区表中,我们仅需在建表时定义分区创建规则,就可以随数据导入自动生成对应分区。接下来介绍自动分区的具体使用方式。 01 Range 自动分区 Range 自动分区(Auto Range Partition)提供了时间维度上的更优分区方案,弥补了动态分区在调参方面的局限性。它的语法如下: -- AUTO RANGE PARTITION 语法 AUTO PARTITION BY RANGE (FUNC_CALL_EXPR) () FUNC_CALL_EXPR ::= DATE_TRUNC ( <partition_column>, '<interval>' ) 其中 <partition_column> 指分区列名,<interval> 指分区单位,也就是希望生成分区的宽度。例如分区列为 k0,按照月级别分区,那么最终的分区描述语句就是 AUTO PARTITION BY RANGE (DATE_TRUNC(k0, 'month'))。此时对于所有导入数据,我们会调用 (DATE_TRUNC(k0, 'month') 对 k0 计算出分区的左端点,再增加一个 interval 得到分区的右端点。通俗来说就是,此处选定的时间单位是"月",数据导入后自动创建的分区区间是其所属的自然月。 前文动态分区章节中介绍的 DAILY_TRADE_VALUE 表,通过自动分区功能优化如下: CREATE TABLE DAILY_TRADE_VALUE ( `TRADE_DATE` DATEV2 NOT NULL COMMENT '交易日期', `TRADE_ID` VARCHAR(40) NOT NULL COMMENT '交易编号', ...... ) AUTO PARTITION BY RANGE (DATE_TRUNC(`TRADE_DATE`, 'month')) () DISTRIBUTED BY HASH(`TRADE_DATE`) BUCKETS 10 PROPERTIES ( ...... ); 导入数据后,分区创建结果如下: mysql> show partitions from DAILY_TRADE_VALUE; Empty set (0.10 sec) mysql> insert into DAILY_TRADE_VALUE values ('2015-01-01', 1), ('2020-01-01', 2), ('2024-03-05', 10000), ('2024-03-06', 10001); Query OK, 4 rows affected (0.24 sec) {'label':'label_2a7353a3f991400e_ae731988fa2bc568', 'status':'VISIBLE', 'txnId':'85097'} mysql> show partitions from DAILY_TRADE_VALUE; +-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | PartitionId | PartitionName | VisibleVersion | VisibleVersionTime | State | PartitionKey | Range | DistributionKey | Buckets | ReplicationNum | StorageMedium | CooldownTime | RemoteStoragePolicy | LastConsistencyCheckTime | DataSize | IsInMemory | ReplicaAllocation | IsMutable | SyncWithBaseTables | UnsyncTables | +-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | 588395 | p20150101000000 | 2 | 2024-06-01 19:02:40 | NORMAL | TRADE_DATE | [types: [DATEV2]; keys: [2015-01-01]; ..types: [DATEV2]; keys: [2015-02-01]; ) | TRADE_DATE | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 588437 | p20200101000000 | 2 | 2024-06-01 19:02:40 | NORMAL | TRADE_DATE | [types: [DATEV2]; keys: [2020-01-01]; ..types: [DATEV2]; keys: [2020-02-01]; ) | TRADE_DATE | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 588416 | p20240301000000 | 2 | 2024-06-01 19:02:40 | NORMAL | TRADE_DATE | [types: [DATEV2]; keys: [2024-03-01]; ..types: [DATEV2]; keys: [2024-04-01]; ) | TRADE_DATE | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | +-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ 3 rows in set (0.09 sec) 可以看到,该表在导入数据之后自动创建了数据所属的对应分区,而没有数据的分区则不会自动创建。 02 List 自动分区 List 自动分区(Auto List Partition)用来应对实际业务场景中,非时间维度的数据划分需求,例如事件所属的地域、部门等维度。在 Doris 以往的功能中,List 分区不存在一个近似"动态分区"的自动管理机制,自动分区同时补齐了这一短板。它的语法如下: -- AUTO LIST PARTITION 语法 AUTO PARTITION BY LIST (`partition_col`) () 例如,使用一张表的 VARCHAR 列作为分区列,实际含义为条目所属的城市: mysql> CREATE TABLE `str_table` ( -> `city` VARCHAR NOT NULL, -> ...... -> ) -> DUPLICATE KEY(`city`) -> AUTO PARTITION BY LIST (`city`) -> () -> DISTRIBUTED BY HASH(`city`) BUCKETS 10 -> PROPERTIES ( -> ...... -> ); Query OK, 0 rows affected (0.09 sec) mysql> insert into str_table values ("Beijing"), ("Shanghai"), ("Los_Angeles"); Query OK, 3 rows affected (0.25 sec) mysql> show partitions from str_table; +-------------+-----------------+----------------+---------------------+--------+--------------+-------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | PartitionId | PartitionName | VisibleVersion | VisibleVersionTime | State | PartitionKey | Range | DistributionKey | Buckets | ReplicationNum | StorageMedium | CooldownTime | RemoteStoragePolicy | LastConsistencyCheckTime | DataSize | IsInMemory | ReplicaAllocation | IsMutable | SyncWithBaseTables | UnsyncTables | +-------------+-----------------+----------------+---------------------+--------+--------------+-------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | 589685 | pBeijing7 | 2 | 2024-06-01 20:12:37 | NORMAL | city | [types: [VARCHAR]; keys: [Beijing]; ] | city | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 589643 | pLos5fAngeles11 | 2 | 2024-06-01 20:12:37 | NORMAL | city | [types: [VARCHAR]; keys: [Los_Angeles]; ] | city | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 589664 | pShanghai8 | 2 | 2024-06-01 20:12:37 | NORMAL | city | [types: [VARCHAR]; keys: [Shanghai]; ] | city | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | +-------------+-----------------+----------------+---------------------+--------+--------------+-------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ 3 rows in set (0.10 sec) 可以看到,插入"北京"、"上海"、"洛杉矶"三个城市名后,结果根据城市名划分了对应分区,而以往只能通过手动的 DDL 语句实现。Auto List Partition 功能的引入在很大程度上降低了自定义分区的维护成本,拓宽了 Doris 的使用自由度。 03 使用技巧与注意事项 手动调整历史分区 对于写入最新实时数据和零散历史变更数据的表,由于 Auto Partition 不会自动回收历史分区,我们推荐两种可能的处理方式: 正常使用自动分区功能,为零散数据自动创建分区。相较于动态分区,避免创建冗余的空置分区,极大地节省了元数据使用量。 自动分区与手动创建分区相结合,按时间维度创建一个 LESS THAN 分区,容纳历史变更数据,这样可以更清晰地划分历史与实时数据,也为后续的数据管理带来效率上的提升。 mysql> CREATE TABLE DAILY_TRADE_VALUE -> ( -> `TRADE_DATE` DATEV2 NOT NULL COMMENT '交易日期', -> `TRADE_ID` VARCHAR(40) NOT NULL COMMENT '交易编号' -> ) -> AUTO PARTITION BY RANGE (DATE_TRUNC(`TRADE_DATE`, 'DAY')) -> ( -> PARTITION `pHistory` VALUES LESS THAN ("2024-01-01") -> ) -> DISTRIBUTED BY HASH(`TRADE_DATE`) BUCKETS 10 -> PROPERTIES -> ( -> "replication_num" = "1" -> ); Query OK, 0 rows affected (0.11 sec) mysql> insert into DAILY_TRADE_VALUE values ('2015-01-01', 1), ('2020-01-01', 2), ('2024-03-05', 10000), ('2024-03-06', 10001); Query OK, 4 rows affected (0.25 sec) {'label':'label_96dc3d20c6974f4a_946bc1a674d24733', 'status':'VISIBLE', 'txnId':'85092'} mysql> show partitions from DAILY_TRADE_VALUE; +-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | PartitionId | PartitionName | VisibleVersion | VisibleVersionTime | State | PartitionKey | Range | DistributionKey | Buckets | ReplicationNum | StorageMedium | CooldownTime | RemoteStoragePolicy | LastConsistencyCheckTime | DataSize | IsInMemory | ReplicaAllocation | IsMutable | SyncWithBaseTables | UnsyncTables | +-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | 577871 | pHistory | 2 | 2024-06-01 08:53:49 | NORMAL | TRADE_DATE | [types: [DATEV2]; keys: [0000-01-01]; ..types: [DATEV2]; keys: [2024-01-01]; ) | TRADE_DATE | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 577940 | p20240305000000 | 2 | 2024-06-01 08:53:49 | NORMAL | TRADE_DATE | [types: [DATEV2]; keys: [2024-03-05]; ..types: [DATEV2]; keys: [2024-03-06]; ) | TRADE_DATE | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 577919 | p20240306000000 | 2 | 2024-06-01 08:53:49 | NORMAL | TRADE_DATE | [types: [DATEV2]; keys: [2024-03-06]; ..types: [DATEV2]; keys: [2024-03-07]; ) | TRADE_DATE | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | +-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ 3 rows in set (0.10 sec) NULL 值分区 Doris 支持分区表中存储 NULL 值。对于自动分区功能而言,List 分区表的 NULL 值将会存储在真正的 NULL 分区中,例如: mysql> CREATE TABLE list_nullable -> ( -> `str` varchar NULL -> ) -> AUTO PARTITION BY LIST (`str`) -> () -> DISTRIBUTED BY HASH(`str`) BUCKETS auto -> PROPERTIES -> ( -> "replication_num" = "1" -> ); Query OK, 0 rows affected (0.10 sec) mysql> insert into list_nullable values ('123'), (''), (NULL); Query OK, 3 rows affected (0.24 sec) {'label':'label_f5489769c2f04f0d_bfb65510f9737fff', 'status':'VISIBLE', 'txnId':'85089'} mysql> show partitions from list_nullable; +-------------+---------------+----------------+---------------------+--------+--------------+------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | PartitionId | PartitionName | VisibleVersion | VisibleVersionTime | State | PartitionKey | Range | DistributionKey | Buckets | ReplicationNum | StorageMedium | CooldownTime | RemoteStoragePolicy | LastConsistencyCheckTime | DataSize | IsInMemory | ReplicaAllocation | IsMutable | SyncWithBaseTables | UnsyncTables | +-------------+---------------+----------------+---------------------+--------+--------------+------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ | 577297 | pX | 2 | 2024-06-01 08:19:21 | NORMAL | str | [types: [VARCHAR]; keys: [NULL]; ] | str | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 577276 | p0 | 2 | 2024-06-01 08:19:21 | NORMAL | str | [types: [VARCHAR]; keys: []; ] | str | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | | 577255 | p1233 | 2 | 2024-06-01 08:19:21 | NORMAL | str | [types: [VARCHAR]; keys: [123]; ] | str | 10 | 1 | HDD | 9999-12-31 23:59:59 | | NULL | 0.000 | false | tag.location.default: 1 | true | true | NULL | +-------------+---------------+----------------+---------------------+--------+--------------+------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+--------------------+--------------+ 3 rows in set (0.11 sec) 而 Range 自动分区目前并不支持 NULL 值分区。这是因为在 Doris 中,Range 分区的 NULL 值将会存入最小的 LESS THAN 分区 ,Auto Partition 难以确定该分区应有的范围。如果按照(-INFINITY, MIN_VALUE)范围创建,则分区有在业务中被误删除的风险。 04 功能总结 自动分区在功能上基本覆盖了动态分区的使用场景,并带来分区规则前置的拓展,大大减轻了DBA 在管理数据时的工作负担。完成分区规则的定义后,大量的分区创建工作将全部由 Doris 自动完成。在使用自动分区前,我们需要先明确相关限制条件,包括: LIST 自动分区支持多列分区,每个自动创建的分区仅包含一个分区值,分区名长度不能超过 50。Auto List Partition 中,分区名的创建依赖某种特定的规则,对元数据维护具有特定的含义,长度 50 的分区名,所能包含的数据实际长度可能更短。 RANGE 自动分区支持单个分区列 ,分区列类型必须为 DATE 或 DATETIME LIST 自动分区支持 NULLABLE 分区列和实际插入 NULL 值;RANGE 自动分区不支持 NULLABLE 分区列 自从 Doris 2.1.3 版本开始,自动分区不再支持与动态分区共同使用。动态分区在进行分区回收时,不会考虑分区的创建来源。导致即使是 Auto Partition 自动创建的分区,也有可能被立即回收,导致不易察觉的数据丢失。 性能对比 自动分区和动态分区的功能区别主要体现在创建与删除、支持类型以及性能影响这三个方面。 动态分区通过固定线程创建并定期检查和回收分区,只支持按 RANGE 分区。而自动分区根据特定的分区规则在导入数据时按需创建,在 Range 分区的基础上提供了 LIST 分区支持。总体而言,自动分区在灵活性和节约人力方面都具有显著优势。 在导入数据时,动态分区在导入过程中基本不会影响性能,而自动分区会先检索已有分区,按需自动创建,这中间会存在一定的时间开销。因此我们将在后文展示对于自动分区具体的性能测试结果。 自动分区导入流程详解 接下来,详细介绍 Doris 自动分区导入的技术实现。以 Stream Load 为例,Doris 发起导入时,其中一个 BE 会完成前期的数据处理工作,并将数据发送给对应的 BE。用来处理数据的 BE 被称为 Coordinator,其他 BE 则统称为 Executor。 在 Coordinator 执行流程中,最后一个算子是 Datasink Node。在该算子中,数据需要先确定其对应的分区、分桶以及所在 BE 的位置,才能被成功发送到正确的 BE 节点并存储。为了实现数据传输,Coordinator 与 Executor 之间通过特定的 Channel 建立通信桥梁,发送端称为 Node Channel,与之对应的接收端称为 Tablets Channel。 自动分区主要在寻找数据对应分区这一环节发挥作用,具体工作机制如下: 以往找不到分区时,BE 会累计错误直至报错 DATA_QUALITY_ERROR,而开启了 Auto Partition 的表,则会在此阶段发起一个新建分区的请求给 FE 并创建对应的分区。Coordinator 等待 FE 完成分区创建的回传结果后,打开分区导入的对应通道,即对应的 Node Channel 和 Tablets Channel,继续完成数据的导入。 经过上述步骤,自动分区即可实现用户侧无感知的分区创建,使导入顺利完成。 在实际集群运行环境中,Coordinator 等待 FE 完成创建分区事务往往面临巨大的时间开销成本。原因是 Thrift RPC 过程产生的固有开销,以及高负载情况下 FE 的锁开销。为了提高数据导入的效率,我们在 Auto Partition 场景中进行了攒批操作,从而大幅减少 RPC 调用次数,这一改进显著提升了数据写入性能 需要注意的是,目前 FE Master 在"创建对应分区"环节完成对应分区的创建事务后,分区即刻可见,但如果导入流程最终失败或被取消,所创建的分区不会被自动回收。 自动分区性能表现 我们基于不同场景对自动分区进行了性能和稳定性测试,具体如下: 场景1: 1FE + 3BE 环境,随机生成数据集,每个数据集 1 亿行数据、涉及 2000 个分区,6 个数据集并行导入 6 张对应表。 结果:对比开启自动分区前后,所有导入事务的耗时都较为平稳,平均性能损耗不足 5%。 场景 2:1FE + 3BE 环境,使用 Flink 数据源每秒采集 100 条数据,通过 Routine Load 进行导入,分别测试在 1、10、20 个事务(表)并发下的导入反压情况。 结果:在以上并发下,开启自动分区前后均能顺利完成数据导入、未出现反压情况,20 个事务并发时 CPU 利用率接近 100%,整体表现极为平稳。 上述测试方法分别对应两个典型场景: 在贴近生产环境的高负载场景下,检验 Auto Partition 功能面向集群高压力的情况,是否会发生性能劣化; 在 Routine Load 不同并发压力下,检验 Auto Partition 功能是否存在导入瓶颈、数据积压问题; 通过以上真实场景的模拟测试我们发现,开启 Auto Partition 前后对导入性能影响甚微。不论是简单的数据插入、或是生产环境中常见的 Routine Load 消费 Flink 数据源,Auto Partition 都表现出了优异的导入性能和稳定的系统表现。即使面对高负载、集群压力较大的情况,开启 Auto Partition 的导入性能损失仅有 5% 左右,性能表现依旧出色,足以满足实际生产环境的使用需求。 基于 Doris 的自动分区在性能和稳定性方面的出色表现,用户可以放心使用该功能,替代旧有分区方式,简化数据操作流程。 总结与展望 自 Apache Doris 2.1 版本起,自动分区的出现进一步简化了复杂场景下的 DDL 和分区表的维护工作,在我们已发布的版本中,许多用户已经使用该功能简化了工作流程,并且极大的便利了从其他数据库系统迁移到 Doris 的工作,自动分区已成为处理大规模数据和应对高并发场景的理想选择。 不仅如此,我们还将对自动分区功能展开更深入的拓展,以应对更加复杂的数据模型。 对于 Auto Range Partition: 当前仅支持时间类型上的划分,未来期望支持更丰富的类型,如数值类型等, 通过指定上下界的计算方式,创建对应分区 对于 Auto List Partition: 将多个值按特定规则合并到同一分区 这些都是我们未来会考虑的改进方向,欢迎在分区创建方面有需求的同学积极使用并前往 Doris 问答论坛反馈建议,期待与你共建更好的 Apache Doris 社区。 参考文献 Doris Stream Load 原理解析 一文教你玩转 Apache Doris 分区分桶新功能|新版本揭秘
优秀的个人博客,低调大师

Apache Doris 自动分区:如何应对分布式环境下的复杂并发挑战|Deep Dive

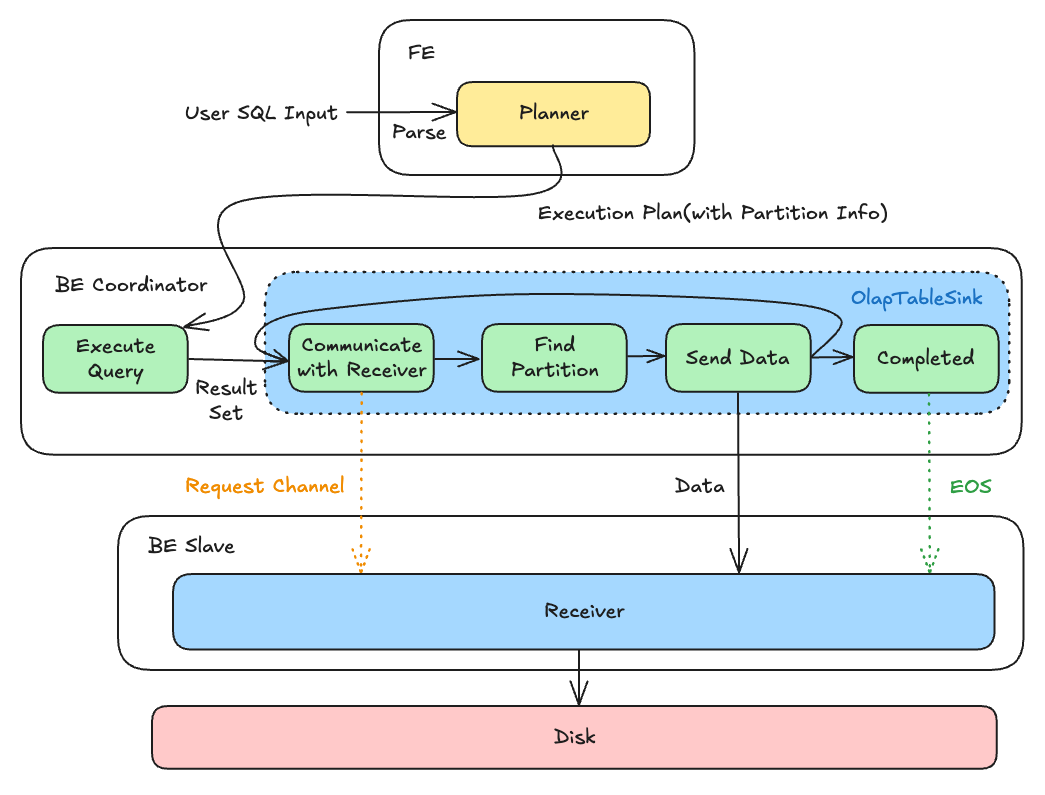
在分布式环境下,分区对性能的影响不可小觑。本文深度、详尽的讲解 Apache Doris 自动分区设计思考,并就多线程复杂并发场景下所面临的挑战,一一剖析 Doris 自动分区设计时的应对策略。 在分布式系统中,复杂并发场景下的数据一致性与流程正确性始终是设计与实现中的核心挑战。Apache Doris 的自动分区功能正是在这一背景下应运而生。然此项技术的实现并非一蹴而就,我们面临多个层面的并发问题,包括 BE 与 FE 之间的元数据竞争、OlapTableSink 与数据发送线程的状态同步等。通过拆解与简化问题,我们设计了串行化分区创建、双重检查线程退出及基于"锚点分区"的引用计数机制等解决方案,逐步构建出一个在分布式、多线程和非对称角色环境下依然能保持正确性与高性能的并发模型。 自动分区的实现 在 Apache Doris 这样的大规模数据仓库中,分区对性能影响较大。Apache Doris 早已支持自动分区 (Auto Partition) 功能,可在数据导入时自动创建数据所对应的分区,节省了人工操作及维护成本。那么,自动分区功能如何实现的呢?在这之前,需要先了解 Doris 及数据导入的过程。 数据导入流程 FE(负责元数据管理和查询规划) 对 SQL 生成对应的查询计划并发送给 BE 执行,第二步:BE(负责数据存储和计算执行)在执行完查询部分并得到结果以后正式进入导入阶段: 根据 FE 下发的分区信息及对应位置,建立和下游 BE 的通道 对于每个到达的 Block,给每一行数据找到对应的分区与分桶 下发数据 重复步骤 2、3 直到处理完最后一个 Block 确认数据发送完成,发送结束标记,接收端落盘形成 rowset 自动分区设计 Doris 作为分布式的数据库,在自动分区中面临的核心矛盾为:作为"大脑"的 FE 负责规划并创建分区,但具体导入哪些数据,却要等到"手脚"的 BE 执行时(OlapTableSink)才能确定。这种信息差导致无法在规划阶段提前创建正确分区。 因此在自动分区设计中,在 OlapTableSink 时插入一个新步骤------实时向 FE 申请所需分区,并重新与下游 BE 协商,以建立新的数据写入通道。因此,导入流程变为以下: FE 下发的初始分区信息会触发 OlapTableSink 与下游建立首次连接(Init Open)。 每个数据块(Block)的到达都可能因创建新分区而触发增量连接(Incremental Open),以打通新的数据通道。 最终,在所有数据块发送完毕后,发出关闭请求。 由于发送数据是重 IO 操作,必须使用单独的线程进行处理,并不在 OlapTableSink 的当前线程当中。由此带来的复杂性我们将在后文分析。 如何应对多线程复杂并发 在实际的使用场景中,Doris 常常要对大规模数据并行处理,流程要比上述复杂百倍。在并发处理中,一个查询计划由多个 Fragment(查询计划的部分切片)构成,而每个 Fragment 会克隆出多个 Instance(执行实例),因此,系统中可能同时存在大量互不感知的 OlapTableSink 实例。 其中每条线都代表一对线程之间的 RPC 交互: BE 需要发送无对应分区的数据给 FE 以获取新创建的分区,FE 会返回新创建的分区信息 对于新创建的分区,Coordinator 需要告知接收端(incremental open),以正确准备数据写入通道 在 incremental open 的同时,可能有数据从 Coordinator 发送到 Slave 进行写入 问题拆解 面对复杂并发的首要原则是拆解:将无直接关联的交互逻辑分离,若各自能独立正确运行,且彼此间的影响可控,则整体流程的正确性便得以保障。 例如,FE 创建分区后向 BE 广播元数据的过程便可被忽略。这是因为分区创建的 RPC 是同步的,它保证了当 Instance 通过 Incremental Open 打开下游通道时,对应的元数据早已在接收端准备就绪。 那么需要关注的交互仅有以下几个: BE 与 FE 之间的通信 BE OlapTableSink 与数据发送线程之间的冲突 数据发送端(BE Coordinator)与接收端(BE Slave)之间的通信 应对策略 BE 与 FE 首先看 BE 与 FE 之间。这里的并发来源是,不同的 BE Instance 都可能向 FE Master 请求分区创建。那么: 不同 Instance 之间有相同的数据怎么办? 如果同时/先后请求了相同的分区创建怎么办? 由于 BE 的 Instance 之间不互相通信,所以必然存在以下情况:不同 Instance 之间因为相同的数据,重复向 FE 请求创建相同的分区。我们要让这些 Instance 之间广播新分区信息来避免重复请求吗?答案是否定的。原因是这样打破了 Doris 用以保持极高稳定性的一贯原则:BE 线程之间的交互只在极特定的统一渠道发生,例如通过 Data Queue 传递数据 Block。如果执行线程之间经常互相交互,锁的开销将会极大拉低性能,并且引入极难排查的隐藏问题。 在 FE 端,我们可以简单加锁将不同的分区创建请求串行化 。其原因是,相比于 BE 需要实际处理海量数据,分区元数据的个数是相对较少的,这些请求的处理也相对较轻,直接加锁串行化不会带来很大的性能问题,好处却是显而易见的:对元数据的操作不产生竞态,对于之前的重复请求,我们直接返回已经创建过的分区信息即可。这样不同 Instance 之间重复请求的问题也迎刃而解。 OlapTableSink 与数据发送线程 这里的核心问题在于------数据发送线程什么时候停止? 对于普通表的导入来说,它会检查所有 NodeChannel 都已停止(由 close 操作标记),这是很清晰的过程。但在自动分区场景下,事情有了很大不同:我们有可能压根不会打开任何 NodeChannel,此时像是普通导入中可以关闭的时刻,但它之后仍有可能通过 incremental open 打开新的,所以不能草率地决定关闭。 因此我们需要把两种情况分开讨论: 如果发现有 NodeChannel,那么是否为自动分区导入没有区别:我们等候所有 Channel 停止 即可。由于导致 Channel 停止的 eos 标记是所有 Block 写入之后的 close 阶段才会产生的,因此即使为自动分区导入,之后也一定不会再有新的 incremental open; 如果当前没有 NodeChannel,那么我们等待 close 操作被触发以后(不会再 Incremental open 了),即可停止数据发送线程。 如何确保没有运行中的 Channel 呢?你不能在 close 之后再去确认这一点,原因是存在如下的并发可能: 当我们先计算过现存 Channel 数,然后根据 close 标记误以为可以停止发送数据时,殊不知此时已经有了新的 Block 正在等待发送。这个后果是极其严重的------**导入会顺利完成,但数据悄悄丢失了。**因此判定导入可以停止的 Channel 记数,必须在检查 Closed 标记之后。------这就是我们所说的,"当一个数据处理逻辑由串行变为并发,由于参与者之间的不同状态交联,简单的情况会陡然变得复杂"。处理并发时必须想清楚所有可能的相互顺序。 简化以后的代码如下,具体细节可见于注释: while (true) { // During incremental_open, the data of the channel may be temporarily // inaccurate, no check should be performed at this time. std::unique_lock<std::mutex> l(_stop_check_channel); int running_channels_num = 0; int opened_nodes = 0; bool is_closed = _try_close; // MUST BEFORE counting of opened_nodes for (const auto& index_channel : _channels) { index_channel->for_each_node_channel([&running_channels_num, this](const std::shared_ptr<VNodeChannel>& ch) { running_channels_num += ch->try_send_and_fetch_status(_state, this->_send_batch_thread_pool_token); }); opened_nodes += index_channel->num_node_channels(); } if (opened_nodes != 0 && running_channels_num == 0 || opened_nodes == 0 && is_closed) { return; } bthread_usleep(sleep_time); } 发送端与接收端 这里的核心问题是,我们怎样知道导入结束了? 在以往的模型中,由于 OlapTableSink 的所有 Instance 都直接由 FE 规划产生且不带修改,因此他们掌握的下游分区分布都是一致的。对于每个下游接收端来说,它的上游也一定是 OlapTableSink 所在 Fragment 的全体 Instance 。那么可以通过一个引用计数 来解决这个问题:上游会在 open 时顺便告知 Instance 数,导入结束时必然是每个 Instance 都完成了 close 操作。那么接收端只需要以此作为计数,等待 Instance 个 close 消息即可结束导入并落盘。 但到了 Auto Partition 的导入场景,事情则大不相同:由于各个 Instance 的数据不同,新增分区的过程使得他们与下游的连接数量也可能不同,且这个数字是无法提前获知的。例如: 假设上图中的分区全部为导入过程中创建的,则下游引用计数并不相同,且当引用计数归零时,下游并不能确保数据接收完毕。例如图中 BE Slave 1,假设 Instance 1、2 的导入均已完成,则某一时刻引用计数会减小至 0。但此时若上游有一 Instance 3,它有可能在 1 和 2 导入完成后再行 incremental open 并导入数据。因此即使计数归 0,我们仍无法关闭下游通道。 这里我们分为两个具体场景来看: 导入前已有部分分区,此时下游 BE 有两种可能 有已知分区位于当前 Slave BE 没有任何分区位于当前 Slave BE 空表导入,无任何分区 对于接收端 1.a。 的情况,同普通表导入一样,导入前已知的分区一定是所有上游 Instance 共同知晓的,所以接收端可以采用以前相同的引用计数方式 。即使接收到了 incremental open 请求,也只是打开一些新的分区 DeltaWriter,不会改变它们的预期的发送端数量------等于 OlapTableSink Instance 总数。 对于接收端 1.b。 的情况,也就是上文提到的,我们通过当前 Slave BE 的信息,是无法判断什么时候该完成导入的。只能从其他角度想办法。 现在让我们看看发送端的操作:如果我们一次性关闭所有 Channel,对于上图中的 BE Slave 2 (也就是情况 1.b。),由于引用计数归 0 时无法判断是否会有其他 Instance 的 incremental open 可能发生。无法结束导入。 但注意到一点:无论有多少 Instance,他们都必然感知 Partition 1 和 2 (称之为 Init Partition)。相应地,Slave 1 和 3 的引用计数必然与 Instance 总数相匹配。如果 Slave 1 和 3 close 完成了,那么所有上游必然已经触发了 close。此时再去 close 那些只有 New Partition 的下游 BE,就不必再担心之后可能有 incremental open 的问题了。 下游 BE 在此时接收到 close 信号,就清楚的知道上游数据均已分发完成,引用计数归 0 时可以直接结束导入。 换句话说,这些 Init Partition 带来的接收端 TabletsChannel 被当做锚点,用以确保上游 Instance 已完成 close 操作。 再来看场景 2,它看起来是最为特殊的情况------这里没有任何 Init Partition 可以作为锚点使用,似乎之前的设计完全失效了。但在软件设计当中,如果相似的问题已经有了良好的解决方案,通过一点小的变换产生一样的场景,应用那些已有的方案往往是不错的选择。我们只需要在 FE 规划发现这种情况时,下发一个不会有任何数据命中的占位分区 (Dummy Partition) ,即可把问题转换到与场景 1 完全一致。而场景 1 刚刚已经被我们完美解决过了。 写在最后 在解决了自动分区各个维度的并发挑战后,我们有必要跳出具体实现,审视其中蕴含的更具普适性的设计哲学与并发范式。这些范式不仅适用于 Doris,也对其他分布式系统的并发设计具有参考价值。 锚点 在并发,尤其是分布式并发当中,如何在线程之间构建同步往往比较困难。当系统里的一切都是动态的时候,协调就无从谈起。这时,最有效的办法就是通过所有参与者的共同信息设定一个不变的参照物。 实践案例 :在"发送端与接收端"的结束设计中,由于连接数量同时存在增、减的情况,我们无法判定关闭的时机。通过"Init Partition 关闭必然意味着上游全部结束导入"的规律,成功使用 Init Partition 所在的下游 BE 当做"锚点"来协调整个关闭过程。空表导入的问题看似复杂,也通过引入 Dummy Partition 归约到已知情形一并解决。 一般规律 :当系统缺乏同步时,找到一个稳定的、所有参与者都认可的状态锚点,可以将复杂的动态协调问题简化为成熟的静态处理逻辑。这体现了通过引入确定性来约束不确定性的核心思想。 状态机 对于存在复杂状态流转的核心组件,将其生命周期管理建模为一个状态机,并通过一个不可逆的临界状态作为"关门信号",可以有效解决"何时停止"的难题。 实践案例 :数据发送线程的生命周期管理。_try_close就是一个关键的临界状态。一旦进入此状态,系统便承诺"不再产生新的任务",这使得线程可以在动态环境中安全地判断完成条件。 一般规律:在消费者-生产者或管理者-工作者的模型中,一个明确的、不可逆的终止信号,配合信号发出后对任务队列的最终原子快照,是解决动态任务集合下优雅退出的通用解法。 并发隔离 将并发控制约束在系统架构的特定层级,避免将其扩散到所有组件之间,是保证系统整体可维护性与性能的基石。 实践案例:拒绝让 BE 的各个 Instance 直接交流新分区信息,而是将分区创建的交汇集中到 FE 进行串行化处理。这确保了 BE 层高吞吐数据处理的纯粹性,将元数据的一致性这个"低频但关键"的问题隔离在 FE 层解决。 在系统的不同层级采用不同的并发策略。数据平面追求吞吐,采用无锁或分片等高并发设计;控制平面追求强一致与正确性,可采用更保守的同步原语。避免让高频执行路径承担复杂的协调任务。 冗余与幂等 在分布式系统中,与其试图消除所有冗余操作,不如承认并接受冗余的必然性,转而将重点放在如何让这些操作具备幂等性,使整个系统对重复请求保持稳定。 实践案例:不同 BE Instance 重复请求创建同一分区。我们并未试图阻止重复请求,而是在 FE 端通过加锁串行化并结合幂等处理------直接返回已创建的分区信息------来优雅地解决。 面向冗余设计,而非面向完美设计。 在消息传递不可靠、组件视角不一致的分布式环境下,幂等性是将系统从"可能重复"的困境中解放出来的关键设计。 Apache Doris 自动分区的并发实践揭示了一个核心启示:应对复杂并发,并非要设计一个包罗万象的复杂模型,而恰恰在于通过精妙的分解与转化,将未知问题映射到已知领域。 未来,我们将继续在自动分区的智能化等方面进行更进一步的提升,例如通过引入表达式分区、合并动态分区等新设计,进一步把 Doris 用户从复杂的 DDL 运维当中解放出来。我们也相信,本文中所阐述的设计思路与实现方法,能够为其他分布式系统在面对类似并发问题时提供有益的参考与启发。

优秀的个人博客,低调大师

|Deep Dive

摘要:在如 Snowflake、ElasticSearch、ClickHouse.... 等传统系统中,对于 JSON 的处理往往面临灵活性及性能无法兼得的困境,而 Apache Doris 的 VARIANT 类型,通过动态子列、稀疏列存储、延迟物化和路径索引等能力,实现了灵活结构 + 列存性能的平衡。本文将对该能力的实现一一讲解,全面展示其优势。 在大数据时代,JSON 已成为数据交换的事实标准。从日志、埋点到 IoT 设备数据,从用户画像到实时监控,JSON 凭借其灵活、可扩展、无需预定义 Schema 的特性,完美契合了快速迭代的现代业务需求。然而,JSON 的动态灵活性与传统数据库的静态处理模型存在根本矛盾,这直接导致了查询性能低下、Schema 管理复杂以及在超宽表场景下的扩展性危机。 因此,对于 JSON 数据的处理,用户常常陷入两难抉择: 牺牲 性能 换取 灵活性(用 JSON 存储,承担高昂查询开销) 牺牲 灵活性 换取 性能(提前建立 Schema,丧失动态响应业务变化能力) 那么,是否存在两全之策,能让性能与灵活性兼得?答案是肯定的。 Doris VARIANT通过底层的存算创新,将半结构化数据的灵活性与结构化数据的分析性能完美结合,全面超越了 Snowflake、ClickHouse 等传统方案。 具体而言,Doris Variant 充分发挥列存与索引优势,避免频繁解析和全量扫描导致 CPU 与 I/O 过高引发性能问题。此外,它能从容应对字段动态变化及类型不一致场景,简化 Schema 维护难度,消除了灵活性与性能间冲突。同时,Doris 优化了超宽表中键值繁多、稀疏分布带来的存储与索引复杂性,解决超宽表场景下扩展性问题。 Doris VARIANT 的卓越性能也在业界公开的 JSONBench 半结构化数据测试中得到了充分验证:冷查询性能排名第一、热查询性能位居第二,全面领先 ClickHouse、Elasticsearch 等一众知名产品。 其查询速度约是 MongoDB 的 164 倍、PostgreSQL 的 1074 倍。此外,对 Doris、 Snowflake 进一步对比, 不管是在冷查询还是热查询中,Doris 相较 Snowflake 有约 2-5 倍的性能优势。具体可见下图: 登顶 JSONBench 榜单 Doris vs. Snowflake Doris Variant 能够具备上述优势,主要得益于以下设计巧思及技术创新。 一、如何让 JSON 获得列存性能? 实现半结构化数据高性能分析的前提是,使其能够像处理结构化数据一样,为其构建高效的列式存储结构,这是后续高性能分析的基础。因此,在 Doris 中,通过动态子列、压缩算法、列裁剪等设计,将半结构数据规范化,从而获获得列存的高性能。 1.1 动态子列 在如 Snowflake 这样的系统中,JSON 数据的底层存储对用户而言是一个黑盒,难以进行查询优化、无法保证性能。而在 Doris 中,当 JSON 对象写入 VARIANT 列时,系统会执行以下操作: 子列与类型推断:解析 JSON 的层级结构,提取出所有的 Key Path(如 user.id, event.properties.timestamp),并自动推断每个子列的值类型(如 BIGINT, DOUBLE, STRING 等)。 动态列化(Subcolumnization): 对于频繁出现的子列,将其物化为独立的内部子列。例如,嵌套在 JSON 中的 user.id 字段在物理存储上会拥有独立的 BIGINT 列式存储结构。 透明访问 :该过程对用户完全透明。无需预先定义 Schema,数据写入时自动完成列式转换。用户仍可使用 v['user']['id']查询 ,但查询引擎可以直接访问到已物化的 user.id 子列,充分利用列存和向量化执行的性能优势。 稀疏列 :对于出现频率极低或结构复杂的稀疏子列,不为其创建独立子列以避免列爆炸。相反,这些数据会被高效组织在一个类 JSONB 的二进制“稀疏”列中,保留完整数据而不为罕见字段额外建列。 通过这一机制,Doris 在数据写入阶段就完成了从半结构化到准结构化的转换,为高性能分析奠定了基础。 1.2 列式存储 在动态子列的基础上,Doris 进一步运用成熟的列式存储技术,实现存储与 I/O 效率的倍增。 压缩: Doris 会根据子列的数据分布自动挑选压缩算法,例如枚举型字段使用字典编码、连续数值用 RLE,从而实现更紧凑的存储并降低读取成本。 子列级 I/O (列裁剪):查询只读取实际需要的字段,消除了过去整块 JSON 拉入再解析的方式。通过 Path 级别列裁剪和延迟物化机制,仅加载必需的 JSON 子列数据,有效减少了数据读取的放大问题。 通过以上策略,Doris 解决传统系统中 JSON 查询的慢和重问题,成功地将 JSON 数据的灵活性与列式存储的高性能相结合,实现了半结构化数据的高效分析。 这种方法不仅提高了查询性能,还简化了 Schema 管理,为用户带来显著的使用优势。 1.3 千列级存储的性能跃升 然后,当数据模型从宽进一步演化为超宽时,新的挑战也随之而来。因此 Doris Variant 持续优化,使其能够从容面对元数据膨胀与合并(Compaction)开销巨大的问题。 1.3.1 元数据存储优化 在日志分析、用户画像等超宽表场景中,单表常涉及上千个列(列存)。即便查询仅需访问其中几列,也需将包含所有列元数据的庞大 Footer 完整加载至内存并解析,内存和反序列化成本急剧膨胀,导致严重的 I/O 与内存开销。 为此,Doris 在 Segment 文件格式层进行了关键优化:将列元数据从 Footer 中剥离,独立存储于专用的数据页(可理解为元数据索引页)中,Footer 仅保留指向该页的轻量指针。读取时先加载精简 Footer,再按需定位并加载所需列元数据。这种 Externalize Meta 的设计,从根本上避免了宽表场景下的元数据膨胀问题,使列裁剪始终保持高效。 以下是关于 VARIANT 元数据打开效率的测试对比(环境设置包含 10,000 个 Segment,每个 Segment 拥有 7,000 个 JSON Path,且均已物化为子列): 优化前:需要解析巨大 Footer(包含所有列的 ColumnMeta),导致大量无效的 I/O 操作、反序列化和内存膨胀,I/O 成为性能瓶颈。 优化后:首先读取小型 Footer(仅包含 PagePointer),然后按需加载被访问列的元数据,避免全量解析。打开速度从 65s 缩减至 4s,效率提升约 16 倍;内存从 60GB 缩减至小于 1GB。 1.3.2 Vertical Compaction 在超宽表场景中,数据合并(Compaction)一直是最棘手的环节。随着表中列数达到上千甚至上万,传统合并策略会暴露出两个主要问题:首先,每次合并都需扫描并重写所有列,即使绝大多数字段并未更新;其次,列元数据和 Segment 文件体积庞大,导致合并的 I/O 成本和内存消耗大幅增加。 为此,Doris Variant 引入子列级 Vertical Compaction,将单次 Compaction 拆分为按列分组的多轮合并。每轮仅加载部分列组(如 10 列),逐步完成全量合并。此举带来两大核心改进: 内存峰值显著降低:每轮只需持有部分列的中间数据,避免了全列并发合并带来的内存瞬时激增; I/O 访问更加可控:更细粒度的列组处理,可以更好与磁盘调度、后台刷写并行化配合。 实测结果显示,在表结构中列数超过 1,000 时,开启 Vertical Compaction 后,单次合并的内存占用从约 50 GB 降至 2 GB 左右,降低近 25 倍;同时,整体吞吐量几乎未受影响。更重要的是,Vertical Compaction 使 VARIANT 不再只是能存 JSON,还能在动态 Schema 的超宽表模型中实现长期稳定的运行——这是大多数列式引擎的薄弱环节。 二、 兼备结构化查询与全文检索 动态子列解决了 JSON 在大规模扫描与聚合场景下的性能瓶颈,而 Doris 进一步为其构建了高度可定制的索引机制,使其在点查询与文本检索场景下也具备极速响应的能力。设计借鉴了 Elasticsearch dynamic mapping 的思想,可提供开箱即用的高性能索引能力。 Doris Variant 的索引体系,目标是在 结构化过滤 与 全文检索 之间取得平衡。它既能像列存一样高效命中结构化字段,又能像搜索引擎一样支持关键词匹配与短语检索。为实现这一目标,Doris 在存储层集成倒排索引,并与 ZoneMap、BloomFilter、延迟物化 等原生索引协同工作,实现从文件级到行级的多层剪枝与快速定位。下面从几个关键机制来看它的实现方式: 2.1 倒排索引的无缝集成 原理: VARIANT 允许用户为任意子列创建倒排索引。例如,CREATE INDEX idx ON tbl(v) USING INVERTED PROPERTIES("parser" = "english")。Doris 在数据写入时,自动提取 v 子列的值,并分词(如果需要)或按原始值建立一个从“词(Term)”到“行号(RowID)”的映射表。 查询: 当查询条件为 WHERE v['message'] MATCH_ANY 'error' 或 v['level'] = 'FATAL' 时,查询引擎不需扫描全表数据。可直接利用倒排索引,快速定位包含关键词 error 或 FATAL 的所有行,查询复杂度从 O(N) 降至 O(logN) 甚至 O(1)。 2.2 内置索引的协同 由于高频子列已被物化为内部子列,它们自然享受到 Doris 的其他索引类型的加成: ZoneMap 索引: 默认开启,记录每个数据块(Page)内子列最大/最小值。对于 WHERE v['properties']['price'] > 1000 这样的范围查询,可快速跳过不满足条件的数据块,甚至跳过文件。 BloomFilter 索引: 对于高基数的子列(如 user_id),可创建布隆过滤器索引,快速判断某个值是否存在,过滤掉大量无关读取请求。 延迟物化配合索引: 先用 ZoneMap/BBloomFilter 倒排在文件/页/行级完成剪枝与定位,再对查询命中的行按需解码非谓词投影的子列,避免对未投影或被过滤掉的子列做无谓解码,可有效降低 CPU 与 I/O 成本。 2.3 Schema Template 与 Path 级索引 Schema Template 和 Path 级索引 是实现精确索引下推的关键机制。前者定义「哪些 JSON 子列需被单独识别与优化」,后者定义「这些子列如何被索引与命中」。 通过 Schema Template,可以为关键子列预声明类型及索引属性,让系统在读写阶段就能识别这些高价值路径。 Path 级索引则在此基础上绑定倒排、Bloom 或 ZoneMap 等多层索引策略,实现结构感知的查询优化。 典型配置: CREATE TABLE IF NOT EXISTS tbl ( k BIGINT, v VARIANT<'content' : STRING>, INDEX idx_tokenized(v) USING INVERTED PROPERTIES( "parser" = "english", "field_pattern" = "content", "support_phrase" = "true" ), INDEX idx_keyword(v) USING INVERTED PROPERTIES( "field_pattern" = "content" ) ); -- tokenized for MATCH; keyword for exact equality SELECT * FROM tbl WHERE v['content'] MATCH 'Doris'; SELECT * FROM tbl WHERE v['content'] = 'Doris'; tokenized 用于 MATCH 搜索;keyword 用于精确匹配。 通配符示例: INDEX idx_logs(v) USING INVERTED PROPERTIES( "field_pattern" = "logs.*" ); 更多使用方式请参考:Variant 文档 三、典型场景实战指南 3.1 日志分析场景 基于 Elasticsearch 或 ClickHouse 的日志分析平台是较为常见的方案,但其问题也比较明显:写入成本高、字段变化难以管理以及查询吞吐不稳定等。 而如果使用 Doris ,Variant 类型可直接写入原始 JSON 日志,不再需要复杂的 ETL 或 Schema Flatten,无需复杂的预处理和 Schema 定义,即可对任意日志字段进行高性能的过滤和全文检索。 示例建表: CREATE TABLE access_log ( dt DATE, log JSON ) DUPLICATE KEY(dt) DISTRIBUTED BY HASH(dt) PROPERTIES ("replication_num" = "1"); CREATE INDEX idx_log ON access_log(log) USING INVERTED; 日志通过 Stream Load 实时写入: curl -u user:password \ -T access.json \ -H "format: json" \ http://fe_host:8030/api/db/access_log/_stream_load 随后就可以像操作结构化数据一样执行查询: SELECT log['status'] AS status,COUNT(*) AS cnt FROM access_log WHERE log['region'] = 'US' GROUP BY status; 在这个场景中,Doris 会自动将 key 列化存储,例如 region 和 status,从而实现亚秒级聚合性能。同时日志结构若有新增字段(例如 latency 或 trace_id),系统会自动创建列存并写入索引,无需手动 ALTER TABLE 或重新导入。 实测表明,在同等硬件条件下,Doris 的日志聚合查询性能相比 Elasticsearch 快 2–3 倍,写入延迟降低 80% 以上,减少约 70–80% 存储空间。 3.2 动态用户画像 在用户画像系统中,每个用户通常拥有成百上千个标签,如地域、兴趣、偏好、活跃度和渠道来源等。这些标签往往需要频繁新增或变更。传统的列式建模方案意味着需要不断修改表结构或维护上百个宽表,这种做法效率极低。而 Doris 的 VARIANT 只需一个 Profile 列即可容纳所有标签信息。 示例建表: CREATE TABLE user_profile ( user_id BIGINT, profile VARIANT ) DUPLICATE KEY(user_id) DISTRIBUTED BY HASH(user_id); 写入时直接插入 JSON 结构: INSERT INTO user_profile VALUES (1001, '{"region": "US", "age": 28, "interest": ["movie","sports"]}'), (1002, '{"region": "CA", "vip": true, "device": "ios"}'); 查询时无需展开,也能高效聚合: SELECT CAST(profile['region'] AS String) AS region,COUNT(*) AS cnt FROM user_profile WHERE profile['vip'] = true GROUP BY region; 在后台,Doris 会自动识别出现的 key (如 region 、vip ),并将其物化为独立列(支持成千上万的独立列)。极其低频字段仍保留在兜底 Sparse 列中。 因此即便标签数量增长到上千个,查询性能依然接近普通结构化表。 实际用户测试中,拥有 7000 个动态标签的用户画像表,查询 Top10 标签分布的平均响应时间保持在 1 秒以内。 3.3 客户使用反馈 度小满实现从 Greenplum 到 Apache Doris 的平滑迁移,构建了超大规模数据分析平台。借助内置的 Variant 类型,实现了对 2–3 万 JSON Key 的高效查询与存储(PB 级别)。系统整体性能提升 20–30 倍,JSON 查询速度提升 10 倍,存储占用为传统 JSON 类型的 1/10。在高并发实时查询与复杂分析任务下,成功支撑 金融级指标分析与实时数据服务,让度小满的数据平台实现从 离线分析 → 实时洞察的跨越。 ——度小满 某大型互联网公司将原有 HBase + Elasticsearch + Snowflake 三套系统迁移至 Doris 这一套系统中来,实现了搜索与分析统一。Doris Variant 列式数据类型支持高维、动态 JSON 的高效存储与查询,让数十亿对象的非结构化属性也能以列式方式处理。并基于子列索引与裁剪机制,查询延迟从秒级降至百毫秒级,并发写入与复杂 Join 性能也显著提升。系统整体成本降低,架构得到简化,稳定性与一致性全面增强。 ——某大型互联网公司 在原系统中(Elasticsearch),Dynamic Mapping 导致字段冲突频发、资源占用高、聚合性能受限。观测云携手飞轮科技,基于 Doris 引入 Variant 数据类型与倒排索引,并通过 S3 对象存储 构建弹性冷热分离架构,大幅提升日志与行为数据的查询效率。升级后,机器成本降低 70%,整体查询性能提升 2 倍,简单查询提速超 4 倍,以不到 1/3 的成本获得数倍性能提升,显著增强了可观测性平台的可扩展性与经济性。 ——观测云 某全球领先的新能源与智能制造企业将原有 Hive/Kudu + Impala/Presto 体系迁移到 Apache Doris,构建了面向车联网与装备全生命周期的实时分析平台。依托 Doris 内置的 Variant 类型,高效处理 PB 级规模的 JSON 半结构化数据,实现秒级实时摄取和毫秒级查询性能。 在核心业务如实时看板、全链路追踪、设备运行与健康分析等场景中,复杂 JSON 查询提速 3–10 倍、高并发查询能力显著提升、且存储占用仅为传统方案的 1/3。借助统一的 Doris 引擎,实现从离线批处理到实时洞察的跨越,大幅降低整体架构复杂度与运维成本。 ——某全球领先的新能源与智能制造企业 面对上百万辆车日均数十 TB 信号数据的挑战,零跑采用 Variant 动态列存 与 S3 对象存储 构建统一数据底座,支持了智能座舱、远程诊断和用户行为分析等多场景。结合物化视图与弹性计算,实现毫秒级查询与自动伸缩、存储成本下降 60% 的显著成效。团队正进一步验证 Serverless 形态,希望利用 S3 的高弹性与 Doris 的高性能,实现“按需使用、零运维伸缩”的数据云脑。 —— 零跑汽车 四、结束语 Apache Doris 的 VARIANT 类型,让半结构化数据能在列式引擎中被自然地处理。它通过动态子列、稀疏列存储、延迟物化和路径索引,将 JSON 解析、列裁剪与索引下推整合为统一体系,实现了灵活结构 与 列存性能的平衡。 未来,Apache Doris 将进一步增强 Variant 自动 Schema 推导能力,支持更丰富的类型、更强大的子列索引系统,并优化稀疏列的数据查询。

优秀的个人博客,低调大师

梁文锋被扒出早年微博小号,孤身前往无人区来一场相当 deep 的 seek 旅行

梁文锋的早期微博账号被挖出来了。 账号叫「程序小王子」,简介写的是「流年似水,秋叶相随」。从发布记录来看,这个账号发布的内容以户外风景为主,尤其记录了大量藏区风光。其中一条2011年11月7日发布的微博格外引人关注: 被困无人区一个星期。所幸我出来了。但我的菲亚特没有出来。它永远地留在了那片漫无边际的高山草原。That's the END。 值得注意的是,这条记录被困经历的微博,似乎也成了他户外冒险的终点。该内容发布后,账号就再也没有更新过新的藏区风景照。 细心网友从评论区发现了能佐证该帐号确实系梁文锋本人的线索——下图ID为「桑书田」的用户正是幻方联合创始人徐进的前妻,她喊的是“梁总”——因此可以百分百确定这就是梁文锋的号了。 甚至还有熟人认出来了——直呼“梁文仔”(这是广东人表达亲切的一种常见称谓,用“仔”替换对方的名字)。 好了,一则小插曲到此为止吧。 有人感慨「从无人区到 AI 无人区,这哥们一直在走别人没走过的路」。有人觉得这正好说明坚持的人最后能成事——「8 万本金起步,到掌控百亿量化基金,再到做出 DeepSeek,这剧本编剧都不敢写」。也有人觉得这种「低谷叙事」有点过了——「人家那时候已经是量化大佬了,开车进西藏是度假,不是流浪」。 但不管怎么解读,这些十几年前的微博碎片拼出了一个画面:一个在浙大读书、写代码、研究量化策略的年轻人,一个人开着菲亚特进西藏,困在无人区,然后走出来,继续往前走。—— 从 Quant 量化到通用人工智能,他一直在走一条少有人走的路。 围观指路:https://weibo.com/u/1656971525

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册