首页 文章 精选 留言 我的

精选列表

搜索[数据一致性],共2385篇文章
优秀的个人博客,低调大师

每日一博 | 并发情况如何实现加锁来保证数据一致性?

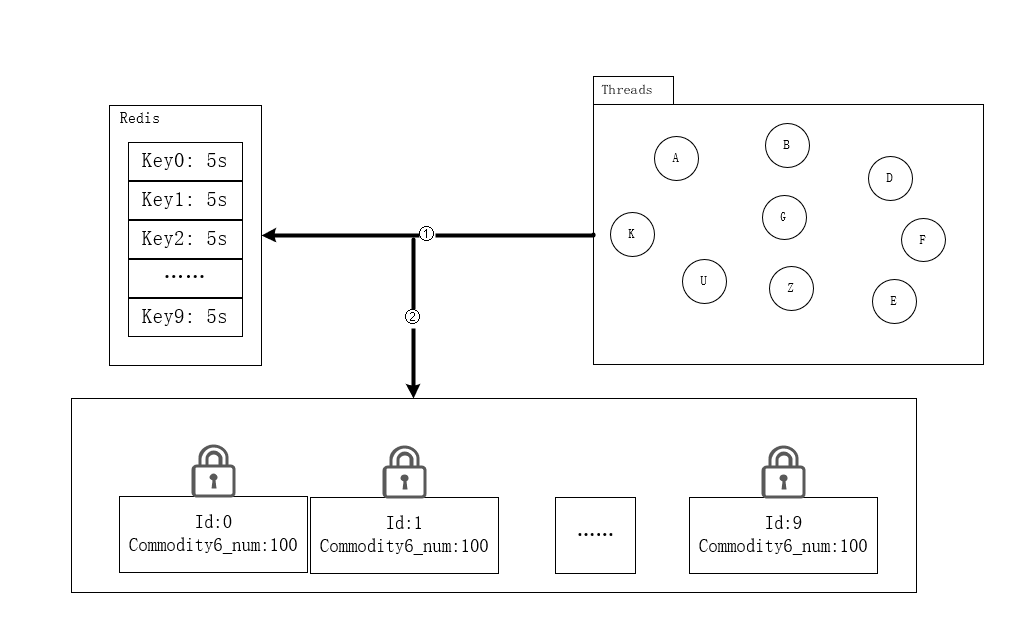
单体架构下锁的实现方案 1. ReentrantLock全局锁 ReentrantLock(可重入锁),指的是一个线程再次对已持有的锁保护的临界资源时,重入请求将会成功。 简单的与我们常用的Synchronized进行比较: ReentrantLock Synchronized 锁实现机制 依赖AQS 监视器模式 灵活性 支持响应超时、中断、尝试获取锁 不灵活 释放形式 必须显示调用unlock()释放锁 自动释放监视器 锁类型 公平锁 & 非公平锁 非公平锁 条件队列 可关联多个条件队列 关联一个条件队列 可重入性 可重入 可重入 AQS机制:如果被请求的共享资源空闲,那么就当前请求资源的线程设置为有效的工作线程,将共享资源通过CAScompareAndSetState设置为锁定状态;如果共享资源被占用,就采用一定的阻塞等待唤醒机制(CLH变体的FIFO双端队列)来保证锁分配。 可重入性:无论是公平锁还是非公平锁的情况,加锁过程会利用一个state值 private volatile int state state值初始化的时候为0,表示没有任何线程持有锁 当有线程来请求该锁时,state值会自增1,同一个线程多次获取锁,就会多次+1,这就是可重入的概念 解锁也是对state值自减1,一直到0,此线程对锁释放。 public class LockExample { static int count = 0; static ReentrantLock lock = new ReentrantLock(); public static void main(String[] args) throws InterruptedException { Runnable runnable = new Runnable() { @Override public void run() { try { // 加锁 lock.lock(); for (int i = 0; i < 10000; i++) { count++; } } catch (Exception e) { e.printStackTrace(); } finally { // 解锁,放在finally子句中,保证锁的释放 lock.unlock(); } } }; Thread thread1 = new Thread(runnable); Thread thread2 = new Thread(runnable); thread1.start(); thread2.start(); thread1.join(); thread2.join(); System.out.println("count: " + count); } } /** * 输出 * count: 20000 */ 2. Mysql行锁、乐观锁 乐观锁即是无锁思想,一般都是基于CAS思想实现的,而在MySQL中通过version版本号 + CAS无锁形式实现乐观锁;例如T1,T2两个事务一起并发执行时,当T2事务执行成功提交后,会对version+1,所以T1事务执行的version条件就无法成立了。 对sql语句进行加锁以及状态机的操作,也可以避免不同线程同时对count值访问导致的数据不一致问题。 // 乐观锁 + 状态机 update table_name set version = version + 1, count = count + 1 where id = id AND version = version AND count = [修改前的count值]; // 行锁 + 状态机 update table_name set count = count + 1 where id = id AND count = [修改前的count值] for update; 3. 细粒度的ReetrantLock锁 如果我们直接采用ReentrantLock全局加锁,那么这种情况是一条线程获取到锁,整个程序全部的线程来到这里都会阻塞;但是我们在项目里面想要针对每个用户在操作的时候实现互斥逻辑,所以我们需要更加细粒度的锁。 public class LockExample { private static Map<String, Lock> lockMap = new ConcurrentHashMap<>(); public static void lock(String userId) { // Map中添加细粒度的锁资源 lockMap.putIfAbsent(userId, new ReentrantLock()); // 从容器中拿锁并实现加锁 lockMap.get(userId).lock(); } public static void unlock(String userId) { // 先从容器中拿锁,确保锁的存在 Lock locak = lockMap.get(userId); // 释放锁 lock.unlock(); } } 弊端:如果每一个用户请求共享资源,就会加锁一次,后续该用户就没有在登录过平台,但是锁对象会一直存在于内存中,这等价于发生了内存泄漏,所以锁的超时和淘汰机制机制需要实现。 4. 细粒度的Synchronized全局锁 上面的加锁机制使用到了锁容器ConcurrentHashMap,该容易为了线程安全的情况,多以底层还是会用到Synchronized机制,所以有些情况,使用lockMap需要加上两层锁。 那么我们是不是可以直接使用Synchronized来实现细粒度的锁机制 public class LockExample { public static void syncFunc1(Long accountId) { String lock = new String(accountId + "").intern(); synchronized (lock) { System.out.println(Thread.currentThread().getName() + "拿到锁了"); // 模拟业务耗时 try { Thread.sleep(1000); } catch (InterruptedException e) { throw new RuntimeException(e); } System.out.println(Thread.currentThread().getName() + "释放锁了"); } } public static void syncFunc2(Long accountId) { String lock = new String(accountId + "").intern(); synchronized (lock) { System.out.println(Thread.currentThread().getName() + "拿到锁了"); // 模拟业务耗时 try { Thread.sleep(1000); } catch (InterruptedException e) { throw new RuntimeException(e); } System.out.println(Thread.currentThread().getName() + "释放锁了"); } } // 使用 Synchronized 来实现更加细粒度的锁 public static void main(String[] args) { new Thread(()-> syncFunc1(123456L), "Thread-1").start(); new Thread(()-> syncFunc2(123456L), "Thread-2").start(); } } /** * 打印 * Thread-1拿到锁了 * Thread-1释放锁了 * Thread-2拿到锁了 * Thread-2释放锁了 */ 从代码中我们发现实现加锁的对象其实就是一个与用户ID相关的一个字符串对象,这里可能会有疑问,我每一个新的线程进来,new的都是一个新的字符串对象,只不过字符串内容一样,怎么能够保证可以安全的锁住共享资源呢; 这其实需要归功于后面的intern()函数的功能; intern()函数用于在运行时将字符串添加到堆空间中的字符串常量池中,如果字符串已经存在,返回字符串常量池中的引用。 分布式架构下锁的实现方案 核心问题:我们需要找到一个多个进程之间所有线程可见的区域来定义这个互斥量。 一个优秀的分布式锁的实现方案应该满足如下几个特性: 分布式环境下,可以保证不同进程之间的线程互斥 同一时刻,同时只允许一条线程成功获取到锁资源 保证互斥量的地方需要保证高可用性 要保证可以高性能的获取锁和释放锁 可以支持同一线程的锁重入性 具备合理的阻塞机制,竞争锁失败的线程要有相应的处理方案 支持非阻塞式的获取锁。获取锁失败的线程可以直接返回 具备合理的锁失效机制,如超时失效等,可以确保避免死锁情况出现 Redis实现分布式锁 redis属于中间件,可独立部署; 对于不同的Java进程来说都是可见的,同时性能也非常可观 依赖与redis本身提供的指令setnx key value来实现分布式锁;区别于普通set指令的是只有当key不存在时才会设置成功,key存在时会返回设置失败 代码实例: // 扣库存接口 @RequestMapping("/minusInventory") public String minusInventory(Inventory inventory) { // 获取锁 String lockKey = "lock-" + inventory.getInventoryId(); int timeOut = 100; Boolean flag = stringRedisTemplate.opsForValue() .setIfAbsent(lockKey, "竹子-熊猫",timeOut,TimeUnit.SECONDS); // 加上过期时间,可以保证死锁也会在一定时间内释放锁 stringRedisTemplate.expire(lockKey,timeOut,TimeUnit.SECONDS); if(!flag){ // 非阻塞式实现 return "服务器繁忙...请稍后重试!!!"; } // ----只有获取锁成功才能执行下述的减库存业务---- try{ // 查询库存信息 Inventory inventoryResult = inventoryService.selectByPrimaryKey(inventory.getInventoryId()); if (inventoryResult.getShopCount() <= 0) { return "库存不足,请联系卖家...."; } // 扣减库存 inventoryResult.setShopCount(inventoryResult.getShopCount() - 1); int n = inventoryService.updateByPrimaryKeySelective(inventoryResult); } catch (Exception e) { // 确保业务出现异常也可以释放锁,避免死锁 // 释放锁 stringRedisTemplate.delete(lockKey); } if (n > 0) return "端口-" + port + ",库存扣减成功!!!"; return "端口-" + port + ",库存扣减失败!!!"; } 作者:竹子爱熊猫 链接:https://juejin.cn/post/7038473714970656775 过期时间的合理性分析: 因为对于不同的业务,我们设置的过期时间的长短都会不一样,太长了不合适,太短了也不合适; 所以我们想到的解决方案是设置一条子线程,给当前锁资源续命。具体实现是,子线程间隔2-3s去查询一次key是否过期,如果还没有过期则代表业务线程还在执行业务,那么则为该key的过期时间加上5s。 但是为了避免主线程意外死亡后,子线程会一直为其续命,造成“长生锁”的现象,所以将子线程变为主(业务)线程的守护线程,这样子线程就会跟着主线程一起死亡。 // 续命子线程 public class GuardThread extends Thread { private static boolean flag = true; public GuardThread(String lockKey, int timeOut, StringRedisTemplate stringRedisTemplate){ …… } @Override public void run() { // 开启循环续命 while (flag){ try { // 先休眠一半的时间 Thread.sleep(timeOut / 2 * 1000); }catch (Exception e){ e.printStackTrace(); } // 时间过了一半之后再去续命 // 先查看key是否过期 Long expire = stringRedisTemplate.getExpire( lockKey, TimeUnit.SECONDS); // 如果过期了,代表主线程释放了锁 if (expire <= 0){ // 停止循环 flag = false; } // 如果还未过期 // 再为则续命一半的时间 stringRedisTemplate.expire(lockKey,expire + timeOut/2,TimeUnit.SECONDS); } } } // 创建子线程为锁续命 GuardThread guardThread = new GuardThread(lockKey,timeOut,stringRedisTemplate); // 设置为当前 业务线程 的守护线程 guardThread.setDaemon(true); guardThread.start(); 作者:竹子爱熊猫 链接:https://juejin.cn/post/7038473714970656775 Redis主从架构下锁失效的问题 为了在开发过程保证Redis的高可用,会采用主从复制架构做读写分离,从而提升Redis的吞吐量以及可用性。但是如果一条线程在redis主节点上获取锁成功之后,主节点还没有来得及复制给从节点就宕机了,此时另一条线程访问redis就会在从节点上面访问,同时也获取锁成功,这时候临界资源的访问就会出现安全性问题了。 解决办法: 红锁算法(官方提出的解决方案):多台独立的Redis同时写入数据,在锁失效时间之内,一半以上的机器写成功则返回获取锁成功,失败的时候释放掉那些成功的机器上的锁。但这种做法缺点是成本高需要独立部署多台Redis节点。 额外记录锁状态:再额外通过其他独立部署的中间件(比如DB)来记录锁状态,在新线程获取锁之前需要先查询DB中的锁持有记录,只要当锁状态为未持有时再尝试获取分布式锁。但是这种情况缺点显而易见,获取锁的过程实现难度复杂,性能开销也非常大;另外还需要配合定时器功能更新DB中的锁状态,保证锁的合理失效机制。 使用Zookepper实现 Zookeeper实现分布式锁 Zookeeper数据区别于redis的数据,数据是实时同步的,主节点写入后需要一半以上的节点都写入才会返回成功。所以如果像电商、教育等类型的项目追求高性能,可以放弃一定的稳定性,推荐使用redis实现;例如像金融、银行、政府等类型的项目,追求高稳定性,可以牺牲一部分性能,推荐使用Zookeeper实现。 分布式锁性能优化 上面加锁确实解决了并发情况下线程安全的问题,但是我们面对100w个用户同时去抢购1000个商品的场景该如何解决呢? 可与将共享资源做一下提前预热,分段分散存储一份。抢购时间为下午15:00,提前再14:30左右将商品数量分成10份,并将每一块数据进行分别加锁,来防止并发异常。 另外也需要在redis中写入10个key,每一个新的线程进来先随机的分配一把锁,然后进行后面的减库存逻辑,完成之后释放锁,以便之后的线程使用。 这种分布式锁的思想就是,将原先一把锁就可以实现的多线程同步访问共享资源的功能,为了提高瞬时情况下多线程的访问速度,还需要保证并发安全的情况下一种实现方式。 参考文章: https://juejin.cn/post/7236213437800890423 https://juejin.cn/post/7038473714970656775 https://tech.meituan.com/2019/12/05/aqs-theory-and-apply.html 作者:京东科技 焦泽斌 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

别把数据一致性只交给业务代码:MySQL 约束的设计、上线与排错实践

不少系统只在业务代码中校验数据:创建用户前查询邮箱是否存在,提交订单前判断金额是否为正数,删除部门前检查是否仍有关联员工。单个请求下,这些逻辑看起来足够可靠,但只要出现并发写入、脚本导入、后台补数或多个服务共用数据库,应用层校验就可能被绕过。 以“邮箱不能重复”为例,两个请求可能同时执行查询,都得到“不存在”,随后各自插入一行。如果表上没有唯一约束,两次写入都能成功。问题不在于查询写错了,而在于“先检查、再写入”不是一个不可分割的动作。 数据库约束的价值,是把不可违反的数据规则放到最终写入边界。应用层仍应提供友好的参数校验和错误提示,但数据库必须能够拒绝破坏一致性的结果。二者并非互相替代:应用校验负责体验和提前失败,数据库约束负责并发条件下的最终正确性。 ## 约束分别解决什么问题 MySQL 表设计中常用的约束包括: - `NOT NULL`:字段必须有值,适合表达“缺失即非法”。 - `DEFAULT`:调用方未提供字段时使用默认值。它是补全规则,不等于合法性校验。 - `UNIQUE`:一列或多列的组合不能重复,适合用户名、业务编号以及租户内唯一键。 - `PRIMARY KEY`:唯一标识一行,同时隐含非空和唯一性。一张表只能有一个主键,但主键可以包含多列。 - `CHECK`:要求行内表达式成立,例如金额非负、结束时间不早于开始时间。 - `FOREIGN KEY`:限制子表引用的值必须存在于父表,用于维护引用完整性。 约束应表达稳定、局部且能够由数据库判断的事实。诸如“会员在活动期间最多购买三件商品”这类涉及统计、时间窗口或外部状态的规则,通常不能只靠简单约束实现,需要事务、锁、条件更新或专门的库存模型。 ## 建立一组可执行的示例表 下面以用户和订单为例。示例使用 InnoDB,并显式命名约束,便于后续定位错误和执行迁移。 ```sql CREATE DATABASE IF NOT EXISTS constraint_lab CHARACTER SET utf8mb4; USE constraint_lab; CREATE TABLE users ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT, tenant_id BIGINT UNSIGNED NOT NULL, email VARCHAR(254) NOT NULL, display_name VARCHAR(100) NOT NULL, status VARCHAR(16) NOT NULL DEFAULT 'active', created_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (id), CONSTRAINT uq_users_tenant_email UNIQUE (tenant_id, email), CONSTRAINT chk_users_status CHECK (status IN ('active', 'disabled')) ) ENGINE=InnoDB; CREATE TABLE orders ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT, user_id BIGINT UNSIGNED NOT NULL, order_no VARCHAR(32) NOT NULL, amount_cent BIGINT UNSIGNED NOT NULL, status VARCHAR(16) NOT NULL DEFAULT 'pending', created_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (id), CONSTRAINT uq_orders_order_no UNIQUE (order_no), CONSTRAINT chk_orders_status CHECK (status IN ('pending', 'paid', 'cancelled')), CONSTRAINT fk_orders_user FOREIGN KEY (user_id) REFERENCES users(id) ON UPDATE RESTRICT ON DELETE RESTRICT ) ENGINE=InnoDB; ``` 这里用整数分保存金额,避免浮点数表示误差。`BIGINT UNSIGNED` 已经排除了负数,因此不必再添加“金额大于等于零”的重复检查;如果业务要求订单金额必须大于零,则可增加 `CHECK (amount_cent > 0)`。 用户邮箱采用 `(tenant_id, email)` 组合唯一约束,表达“同一租户内唯一”,而不是错误地把邮箱设计成全局唯一。约束设计必须忠实反映业务作用域。 ## 理解几个容易误判的细节 ### UNIQUE 与 NULL 唯一约束并不等同于“必填且唯一”。在 MySQL 中,可空唯一列通常允许出现多个 `NULL`,因为 `NULL` 表示未知,彼此不按普通值判等。如果字段必须存在,应同时声明 `NOT NULL`: ```sql ALTER TABLE users MODIFY email VARCHAR(254) NOT NULL; ``` 不要用空字符串代替未知值。空字符串是一个确定的值,会参与唯一性比较,而且容易把“未填写”和“确实为空”混为一谈。 ### DEFAULT 不会修正显式输入 默认值只在插入语句省略该列时生效。调用方显式传入非法值时,`DEFAULT` 不会替它纠正: ```sql -- 使用默认状态 INSERT INTO users (tenant_id, email, display_name) VALUES (1, 'alice@example.test', 'Alice'); -- 仍会被 CHECK 拒绝,而不是自动改成 active INSERT INTO users (tenant_id, email, display_name, status) VALUES (1, 'bob@example.test', 'Bob', 'unknown'); ``` ### CHECK 适合行内规则 `CHECK` 适合只依赖当前行字段的确定性关系。例如优惠后价格不能高于原价: ```sql CREATE TABLE products ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT, price_cent BIGINT UNSIGNED NOT NULL, sale_price_cent BIGINT UNSIGNED NULL, PRIMARY KEY (id), CONSTRAINT chk_sale_price CHECK (sale_price_cent IS NULL OR sale_price_cent 1; ``` 重复数据如何合并不能由通用 SQL 擅自决定。需要明确保留哪一行、其他表引用哪一个用户,以及被合并记录是否需要审计留痕。 ### 2. 查找空值和非法枚举 ```sql SELECT id, tenant_id, email, status FROM users WHERE email IS NULL OR email = '' OR status NOT IN ('active', 'disabled') OR status IS NULL; ``` 修改为 `NOT NULL` 前,必须为现存空值确定真实业务含义。批量填充一个虚假的统一邮箱只会把数据问题隐藏起来,还会与唯一约束冲突。 ### 3. 查找孤儿引用 ```sql SELECT o.id, o.user_id FROM orders AS o LEFT JOIN users AS u ON u.id = o.user_id WHERE u.id IS NULL; ``` 孤儿订单可能需要关联到恢复后的用户、转入异常数据表或阻止迁移。处理方式应由业务规则决定,不能简单删除。 ### 4. 添加约束 完成清理并在预发布环境验证后,再执行变更: ```sql ALTER TABLE users MODIFY email VARCHAR(254) NOT NULL, ADD CONSTRAINT uq_users_tenant_email UNIQUE (tenant_id, email); ``` 如果唯一索引已经存在,就不要重复添加约束。上线前可通过元数据确认当前定义: ```sql SHOW CREATE TABLE users; SELECT CONSTRAINT_NAME, CONSTRAINT_TYPE FROM information_schema.TABLE_CONSTRAINTS WHERE TABLE_SCHEMA = DATABASE() AND TABLE_NAME = 'users'; ``` 对数据量较大的表,应先在接近生产规模的环境评估耗时、临时空间、锁等待和复制延迟。是否能够在线执行取决于 MySQL 版本、存储引擎以及具体变更类型,不能仅凭 `ALTER TABLE` 语法作保证。 ## 应用程序如何处理约束冲突 约束失败是可预期的业务分支,不应全部转换成含糊的“数据库异常”。以创建用户为例,正确流程是直接尝试插入,并把唯一冲突映射为“邮箱已存在”。可以提前查询改善交互,但最终仍以插入结果为准。 下面是使用 Python DB-API 风格驱动的示意代码。不同驱动的异常类型和属性可能不同,应以实际依赖为准: ```python import os import mysql.connector from mysql.connector import errorcode conn = mysql.connector.connect( host=os.environ['DB_HOST'], user=os.environ['DB_USER'], password=os.environ['DB_PASSWORD'], database=os.environ['DB_NAME'], ) try: with conn.cursor() as cursor: cursor.execute( ''' INSERT INTO users (tenant_id, email, display_name) VALUES (%s, %s, %s) ''', (42, 'alice@example.test', 'Alice'), ) conn.commit() except mysql.connector.IntegrityError as exc: conn.rollback() if exc.errno == errorcode.ER_DUP_ENTRY: raise ValueError('该租户中邮箱已存在') from exc raise finally: conn.close() ``` 参数必须通过驱动占位符传入,不要拼接 SQL。日志中可以记录错误码、约束名、请求标识和表名,但不应直接记录密码、完整个人信息或未经筛选的 SQL 参数。 ## 常见问题 ### 有了数据库约束,还需要应用校验吗? 需要。应用校验可以更早发现格式错误并返回可理解的提示;数据库约束负责阻止竞态条件、遗漏路径和外部脚本写入非法数据。关键规则应形成两层防线。 ### 所有表都应该使用外键吗? 不一定。单体系统或边界清晰的关系型数据通常能从外键中受益;高吞吐写入、跨库分片、异步清理等架构可能选择在服务层维护引用关系。但取消外键意味着团队必须补上孤儿检测、删除保护、修复流程和持续审计,而不是取消一致性要求。 ### 唯一约束能否代替幂等设计? 只能完成其中一部分。唯一约束可以保证同一幂等键不会写入两次,但应用还需要在冲突后读取已有结果,并判断请求参数是否与第一次一致。否则,相同幂等键携带不同内容时可能被错误地当成成功重试。 ### 为什么添加约束后写入报错了? 这通常说明新约束揭示了原本被默许的数据问题,也可能是约束作用域设计错误。先根据错误码和约束名定位失败规则,再检查真实输入。不要在应用中捕获所有完整性错误后统一忽略,否则外键失败、非空失败和重复键会被混为一谈。 ### 约束名称重要吗? 重要。显式名称能够让迁移脚本、监控日志和异常映射稳定地指向具体规则。名称可采用 `pk_表名`、`uq_表名_字段`、`fk_子表_父表`、`chk_表名_规则` 等一致格式。 ## 总结 可靠的数据模型不是“表能建出来”就结束,而是要把稳定的不变量写成数据库能够执行的规则。`NOT NULL` 管缺失,`UNIQUE` 管重复,`CHECK` 管行内合法性,`FOREIGN KEY` 管引用关系;应用层则负责输入体验、复杂业务规则和清晰的错误映射。 给旧系统补约束时,应遵循“盘点规则、扫描脏数据、确定修复策略、预演 DDL、分批上线、持续审计”的顺序。约束不是对业务代码的不信任,而是让所有写入入口在并发和故障条件下仍遵守同一套底线。


优秀的个人博客,低调大师

并发情况如何实现加锁来保证数据一致性? | 京东云技术团队

单体架构下锁的实现方案 1. ReentrantLock全局锁 ReentrantLock(可重入锁),指的是一个线程再次对已持有的锁保护的临界资源时,重入请求将会成功。 简单的与我们常用的Synchronized进行比较: ReentrantLock Synchronized 锁实现机制 依赖AQS 监视器模式 灵活性 支持响应超时、中断、尝试获取锁 不灵活 释放形式 必须显示调用unlock()释放锁 自动释放监视器 锁类型 公平锁 & 非公平锁 非公平锁 条件队列 可关联多个条件队列 关联一个条件队列 可重入性 可重入 可重入 AQS机制:如果被请求的共享资源空闲,那么就当前请求资源的线程设置为有效的工作线程,将共享资源通过CAScompareAndSetState设置为锁定状态;如果共享资源被占用,就采用一定的阻塞等待唤醒机制(CLH变体的FIFO双端队列)来保证锁分配。 可重入性:无论是公平锁还是非公平锁的情况,加锁过程会利用一个state值 private volatile int state state值初始化的时候为0,表示没有任何线程持有锁 当有线程来请求该锁时,state值会自增1,同一个线程多次获取锁,就会多次+1,这就是可重入的概念 解锁也是对state值自减1,一直到0,此线程对锁释放。 public class LockExample { static int count = 0; static ReentrantLock lock = new ReentrantLock(); public static void main(String[] args) throws InterruptedException { Runnable runnable = new Runnable() { @Override public void run() { try { // 加锁 lock.lock(); for (int i = 0; i < 10000; i++) { count++; } } catch (Exception e) { e.printStackTrace(); } finally { // 解锁,放在finally子句中,保证锁的释放 lock.unlock(); } } }; Thread thread1 = new Thread(runnable); Thread thread2 = new Thread(runnable); thread1.start(); thread2.start(); thread1.join(); thread2.join(); System.out.println("count: " + count); } } /** * 输出 * count: 20000 */ 2. Mysql行锁、乐观锁 乐观锁即是无锁思想,一般都是基于CAS思想实现的,而在MySQL中通过version版本号 + CAS无锁形式实现乐观锁;例如T1,T2两个事务一起并发执行时,当T2事务执行成功提交后,会对version+1,所以T1事务执行的version条件就无法成立了。 对sql语句进行加锁以及状态机的操作,也可以避免不同线程同时对count值访问导致的数据不一致问题。 // 乐观锁 + 状态机 update table_name set version = version + 1, count = count + 1 where id = id AND version = version AND count = [修改前的count值]; // 行锁 + 状态机 update table_name set count = count + 1 where id = id AND count = [修改前的count值] for update; 3. 细粒度的ReetrantLock锁 如果我们直接采用ReentrantLock全局加锁,那么这种情况是一条线程获取到锁,整个程序全部的线程来到这里都会阻塞;但是我们在项目里面想要针对每个用户在操作的时候实现互斥逻辑,所以我们需要更加细粒度的锁。 public class LockExample { private static Map<String, Lock> lockMap = new ConcurrentHashMap<>(); public static void lock(String userId) { // Map中添加细粒度的锁资源 lockMap.putIfAbsent(userId, new ReentrantLock()); // 从容器中拿锁并实现加锁 lockMap.get(userId).lock(); } public static void unlock(String userId) { // 先从容器中拿锁,确保锁的存在 Lock locak = lockMap.get(userId); // 释放锁 lock.unlock(); } } 弊端:如果每一个用户请求共享资源,就会加锁一次,后续该用户就没有在登录过平台,但是锁对象会一直存在于内存中,这等价于发生了内存泄漏,所以锁的超时和淘汰机制机制需要实现。 4. 细粒度的Synchronized全局锁 上面的加锁机制使用到了锁容器ConcurrentHashMap,该容易为了线程安全的情况,多以底层还是会用到Synchronized机制,所以有些情况,使用lockMap需要加上两层锁。 那么我们是不是可以直接使用Synchronized来实现细粒度的锁机制 public class LockExample { public static void syncFunc1(Long accountId) { String lock = new String(accountId + "").intern(); synchronized (lock) { System.out.println(Thread.currentThread().getName() + "拿到锁了"); // 模拟业务耗时 try { Thread.sleep(1000); } catch (InterruptedException e) { throw new RuntimeException(e); } System.out.println(Thread.currentThread().getName() + "释放锁了"); } } public static void syncFunc2(Long accountId) { String lock = new String(accountId + "").intern(); synchronized (lock) { System.out.println(Thread.currentThread().getName() + "拿到锁了"); // 模拟业务耗时 try { Thread.sleep(1000); } catch (InterruptedException e) { throw new RuntimeException(e); } System.out.println(Thread.currentThread().getName() + "释放锁了"); } } // 使用 Synchronized 来实现更加细粒度的锁 public static void main(String[] args) { new Thread(()-> syncFunc1(123456L), "Thread-1").start(); new Thread(()-> syncFunc2(123456L), "Thread-2").start(); } } /** * 打印 * Thread-1拿到锁了 * Thread-1释放锁了 * Thread-2拿到锁了 * Thread-2释放锁了 */ 从代码中我们发现实现加锁的对象其实就是一个与用户ID相关的一个字符串对象,这里可能会有疑问,我每一个新的线程进来,new的都是一个新的字符串对象,只不过字符串内容一样,怎么能够保证可以安全的锁住共享资源呢; 这其实需要归功于后面的intern()函数的功能; intern()函数用于在运行时将字符串添加到堆空间中的字符串常量池中,如果字符串已经存在,返回字符串常量池中的引用。 分布式架构下锁的实现方案 核心问题:我们需要找到一个多个进程之间所有线程可见的区域来定义这个互斥量。 一个优秀的分布式锁的实现方案应该满足如下几个特性: 分布式环境下,可以保证不同进程之间的线程互斥 同一时刻,同时只允许一条线程成功获取到锁资源 保证互斥量的地方需要保证高可用性 要保证可以高性能的获取锁和释放锁 可以支持同一线程的锁重入性 具备合理的阻塞机制,竞争锁失败的线程要有相应的处理方案 支持非阻塞式的获取锁。获取锁失败的线程可以直接返回 具备合理的锁失效机制,如超时失效等,可以确保避免死锁情况出现 Redis实现分布式锁 redis属于中间件,可独立部署; 对于不同的Java进程来说都是可见的,同时性能也非常可观 依赖与redis本身提供的指令setnx key value来实现分布式锁;区别于普通set指令的是只有当key不存在时才会设置成功,key存在时会返回设置失败 代码实例: // 扣库存接口 @RequestMapping("/minusInventory") public String minusInventory(Inventory inventory) { // 获取锁 String lockKey = "lock-" + inventory.getInventoryId(); int timeOut = 100; Boolean flag = stringRedisTemplate.opsForValue() .setIfAbsent(lockKey, "竹子-熊猫",timeOut,TimeUnit.SECONDS); // 加上过期时间,可以保证死锁也会在一定时间内释放锁 stringRedisTemplate.expire(lockKey,timeOut,TimeUnit.SECONDS); if(!flag){ // 非阻塞式实现 return "服务器繁忙...请稍后重试!!!"; } // ----只有获取锁成功才能执行下述的减库存业务---- try{ // 查询库存信息 Inventory inventoryResult = inventoryService.selectByPrimaryKey(inventory.getInventoryId()); if (inventoryResult.getShopCount() <= 0) { return "库存不足,请联系卖家...."; } // 扣减库存 inventoryResult.setShopCount(inventoryResult.getShopCount() - 1); int n = inventoryService.updateByPrimaryKeySelective(inventoryResult); } catch (Exception e) { // 确保业务出现异常也可以释放锁,避免死锁 // 释放锁 stringRedisTemplate.delete(lockKey); } if (n > 0) return "端口-" + port + ",库存扣减成功!!!"; return "端口-" + port + ",库存扣减失败!!!"; } 作者:竹子爱熊猫 链接:https://juejin.cn/post/7038473714970656775 过期时间的合理性分析: 因为对于不同的业务,我们设置的过期时间的长短都会不一样,太长了不合适,太短了也不合适; 所以我们想到的解决方案是设置一条子线程,给当前锁资源续命。具体实现是,子线程间隔2-3s去查询一次key是否过期,如果还没有过期则代表业务线程还在执行业务,那么则为该key的过期时间加上5s。 但是为了避免主线程意外死亡后,子线程会一直为其续命,造成“长生锁”的现象,所以将子线程变为主(业务)线程的守护线程,这样子线程就会跟着主线程一起死亡。 // 续命子线程 public class GuardThread extends Thread { private static boolean flag = true; public GuardThread(String lockKey, int timeOut, StringRedisTemplate stringRedisTemplate){ …… } @Override public void run() { // 开启循环续命 while (flag){ try { // 先休眠一半的时间 Thread.sleep(timeOut / 2 * 1000); }catch (Exception e){ e.printStackTrace(); } // 时间过了一半之后再去续命 // 先查看key是否过期 Long expire = stringRedisTemplate.getExpire( lockKey, TimeUnit.SECONDS); // 如果过期了,代表主线程释放了锁 if (expire <= 0){ // 停止循环 flag = false; } // 如果还未过期 // 再为则续命一半的时间 stringRedisTemplate.expire(lockKey,expire + timeOut/2,TimeUnit.SECONDS); } } } // 创建子线程为锁续命 GuardThread guardThread = new GuardThread(lockKey,timeOut,stringRedisTemplate); // 设置为当前 业务线程 的守护线程 guardThread.setDaemon(true); guardThread.start(); 作者:竹子爱熊猫 链接:https://juejin.cn/post/7038473714970656775 Redis主从架构下锁失效的问题 为了在开发过程保证Redis的高可用,会采用主从复制架构做读写分离,从而提升Redis的吞吐量以及可用性。但是如果一条线程在redis主节点上获取锁成功之后,主节点还没有来得及复制给从节点就宕机了,此时另一条线程访问redis就会在从节点上面访问,同时也获取锁成功,这时候临界资源的访问就会出现安全性问题了。 解决办法: 红锁算法(官方提出的解决方案):多台独立的Redis同时写入数据,在锁失效时间之内,一半以上的机器写成功则返回获取锁成功,失败的时候释放掉那些成功的机器上的锁。但这种做法缺点是成本高需要独立部署多台Redis节点。 额外记录锁状态:再额外通过其他独立部署的中间件(比如DB)来记录锁状态,在新线程获取锁之前需要先查询DB中的锁持有记录,只要当锁状态为未持有时再尝试获取分布式锁。但是这种情况缺点显而易见,获取锁的过程实现难度复杂,性能开销也非常大;另外还需要配合定时器功能更新DB中的锁状态,保证锁的合理失效机制。 使用Zookepper实现 Zookeeper实现分布式锁 Zookeeper数据区别于redis的数据,数据是实时同步的,主节点写入后需要一半以上的节点都写入才会返回成功。所以如果像电商、教育等类型的项目追求高性能,可以放弃一定的稳定性,推荐使用redis实现;例如像金融、银行、政府等类型的项目,追求高稳定性,可以牺牲一部分性能,推荐使用Zookeeper实现。 分布式锁性能优化 上面加锁确实解决了并发情况下线程安全的问题,但是我们面对100w个用户同时去抢购1000个商品的场景该如何解决呢? 可与将共享资源做一下提前预热,分段分散存储一份。抢购时间为下午15:00,提前再14:30左右将商品数量分成10份,并将每一块数据进行分别加锁,来防止并发异常。 另外也需要在redis中写入10个key,每一个新的线程进来先随机的分配一把锁,然后进行后面的减库存逻辑,完成之后释放锁,以便之后的线程使用。 这种分布式锁的思想就是,将原先一把锁就可以实现的多线程同步访问共享资源的功能,为了提高瞬时情况下多线程的访问速度,还需要保证并发安全的情况下一种实现方式。 参考文章: https://juejin.cn/post/7236213437800890423 https://juejin.cn/post/7038473714970656775 https://tech.meituan.com/2019/12/05/aqs-theory-and-apply.html 作者:京东科技 焦泽斌 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

当MySQL执行XA事务时遭遇崩溃,且看华为云如何保障数据一致性

摘要:当前MySQL所有版本不支持分布式事务的崩溃恢复安全,这严重影响了分布式事务的高可用保障。 华为云数据库内核高级技术专家,拥有十多年MySQL内核研发经验,目前在华为云数据库团队研发华为云数据库(RDS for MySQL和GaussDB(for MySQL))内核特性和服务化特性,修复华为云数据库现网问题;曾在官方MySQL团队研发MySQL内核特性和修复MySQL内核问题九年多,尤其擅长MySQL Replication。 注:本文如没有特殊说明,MySQL指社区版MySQL;binlog指MySQL server日志;redo Log指MySQL InnoDB日志 MySQL replication实时同步主库上执行的事务到备库,并且支持一般事务的崩溃恢复安全,这为一般事务的高可用提供了坚实的保障。如果没有此高可用保障,主库崩溃(不能正常恢复场景)后,数据库服务轻则中断几十分钟甚至几小时,重则丢失用户数据。 但是当前MySQL所有版本不支持分布式事务的崩溃恢复安全,这严重影响了分布式事务的高可用保障。华为云数据库(包括RDS (for MySQL) 和GaussDB (for MySQL))解决了这一痛点,支持分布式事务的崩溃恢复安全,极大地提升华为云数据库的可靠性和可用性。 接下来我们将逐个讨论MySQL在分布式事务崩溃恢复安全方面的几个常见问题,以及华为云数据库采取了什么解决方案来保证数据的一致性。 (如需了解分布式事务,请参考这里:https://dev.mysql.com/doc/refman/8.0/en/xa.html) 问题一: 如上图所示:如果崩溃发生在危险区间段内的任意一点,主库重启后,binlog中保存有准备阶段执行的事务,但是InnoDB回滚了准备阶段执行的事务。从而导致MySQL server和InnoDB数据不一致。准备阶段执行的事务会被回放到备库,它获得的所有事务处理过程中使用的锁永远不能被释放。最终导致备库回放需要获得相关锁的其它事务时锁超时失败,复制中断。 华为云数据库解决方案 如上图流程所示: 如果崩溃发生在阶段一,主库重启后,这个分布式事务准备阶段既不在MySQL server中,也不在InnoDB中; 如果崩溃发生在阶段二,主库重启恢复过程中这个分布式事务准备阶段会被InnoDB回滚掉,最终这个分布式事务准备阶段既不在MySQL server中,也不在 InnoDB; 如果崩溃发生在阶段三,主库重启后,这个分布式事务准备阶段既存在MySQL server中,也存在InnoDB中; 所以,无论崩溃发生在上图中的哪一点,主库重启后,华为云数据库都能保证MySQL server和InnoDB数据的一致性。 问题二: 如上图所示:如果崩溃发生在危险区间段内的任意一点,主库重启后,binlog保存有XA COMMIT xid, 但是MySQL InnoDB没有提交这个分布式事务。 如果不重新提交,那么在准备阶段获得的所有事务处理过程中使用的锁永远不能被释放,最终导致主库执行需要获得相关锁的其它事务时锁超时失败; 如果重新提交,XA COMMIT xid再次被持久化到binlog,备库在回放第二个XA COMMIT xid时抛出“Unknown XID”错误,导致复制中断。 华为云数据库解决方案 主库在重启的过程中以binlog作为仲裁提交了这个分布式事务准备阶段执行的事务,保证了华为云数据库MySQL server和MySQL InnoDB数据的一致性。 问题三: 如上图所示:如果崩溃发生在危险区间段内的任意一点,主库重启后, binlog保存有XA ROLLBACK xid,但是MySQL InnoDB没有回滚这个分布式事务。 如果不重新回滚,这个分布式事务准备阶段获得的所有事务处理过程中使用的锁永远不能被释放,最终导致主库执行需要获得相关锁的其它事务时锁超时失败; 如果重新回滚,XA ROLLBACK xid再次被持久化到binlog,备库在回放第二个XA ROLLBACK xid时抛出“Unknown XID”错误,导致复制中断。 华为云数据库解决方案 主库在重启的过程中以binlog作为仲裁回滚了这个分布式事务准备阶段执行的事务,保证了华为云数据库MySQL server和MySQL InnoDB数据的一致性。 问题四: 如上图所示:如果崩溃发生在危险区间段内的任意一点,主库重启后,binlog中保存有一阶段提交分布式事务,但是MySQL InnoDB回滚了这个一阶段提交分布式事务。从而导致MySQL server和MySQL InnoDB数据不一致。一阶段提交的分布式事务会被回放到备库,最终导致备库数据和主库数据的不一致。 华为云数据库解决方案 如上图所示: 如果崩溃发生在阶段一,主库重启后,这个一阶段提交分布式事务既不在MySQL server中,也不在MySQL InnoDB中; 如果崩溃发生在阶段二,主库重启恢复过程中这个一阶段提交分布式事务会被MySQL InnoDB回滚掉,最终这个分布式事务既不在MySQL server中,也不在MySQL InnoDB中; 如果崩溃发生在阶段三,主库重启后,这个一阶段提交分布式事务既存在MySQL server中,也存在MySQL InnoDB中; 无论崩溃发生在上图中的哪一点,主库重启后,华为云数据库都能保证MySQL server和MySQL InnoDB数据的一致性。 华为云数据库很好地解决了分布式事务崩溃恢复安全的相关问题,极大地提升数据库的可靠性和可用性,提升了用户使用华为云数据库的体验。后续我们会持续在分布式事务方面做更多的优化和解决MySQL可能遇到的问题,也欢迎大家使用华为云数据库分布式事务,体验华为云数据库卓越的可靠性和可用性,期待您的反馈!https://www.huaweicloud.com/product/gaussdb_mysql.html 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册