数据库同步工具选型与实战:CDC方案、国产适配与数据一致性保障
大家好,我是数据库小学妹👋我踩过的坑,你别再踩。 数据库同步工具,就是把一个数据库的数据按规则复制到另一个库,保持两边一致。这东西选对了省事,选错了半夜得爬起来救火。我就经历过。 凌晨两点,客户打电话说报表数据对不上。我查了半小时,发现昨晚的数据库同步任务跑了一半断了。三万多条增量数据丢了一半。目标库的财务表和源库差了十几万,第二天老板要看的报表直接废了。 同步任务出问题,我不是第一次遇到了。之前用DataX做离线同步,任务跑得稳,延迟扛不住。换Canal做实时同步,源库只支持MySQL,Oracle那边直接卡住。后来又试了SeaTunnel,分布式能力还行,DDL同步那段折腾了我好几天。 后来我花了一个月,把市面上主流的数据库同步工具都跑了一遍。离线到实时,开源到商业,国外到国产都有。实测结果和踩坑教训都在这,选型时拿来对照就行。 --- ## 数据库同步工具是什么,离线实时混合三种模式 数据库同步工具,功能就是把一个数据库的数据按规则复制到另一个库,保持两边一致。按同步方式分三类。 **离线同步**,定期把源库数据全量或增量拉到目标库。T+1报表、数据仓库入仓用这个。代表工具是DataX、Kettle。延迟在小时到天级别,吞吐量大。 **实时同步(CDC)**,基于数据库的变更日志(binlog、WAL、Redo Log)实时捕获数据变化,毫秒级推到目标库。实时报表、缓存更、异地灾备都用这个。代表工具是Canal、Debezium、Oracle GoldenGate。 **混合模式**,全量初始化加增量实时追平,跑完自动从全量切到增量。迁移和持续同步一套搞定。代表工具是Apache SeaTunnel、TapData,还有金仓数据库配套的Kingbase FlySync(金仓异构数据同步软件)。 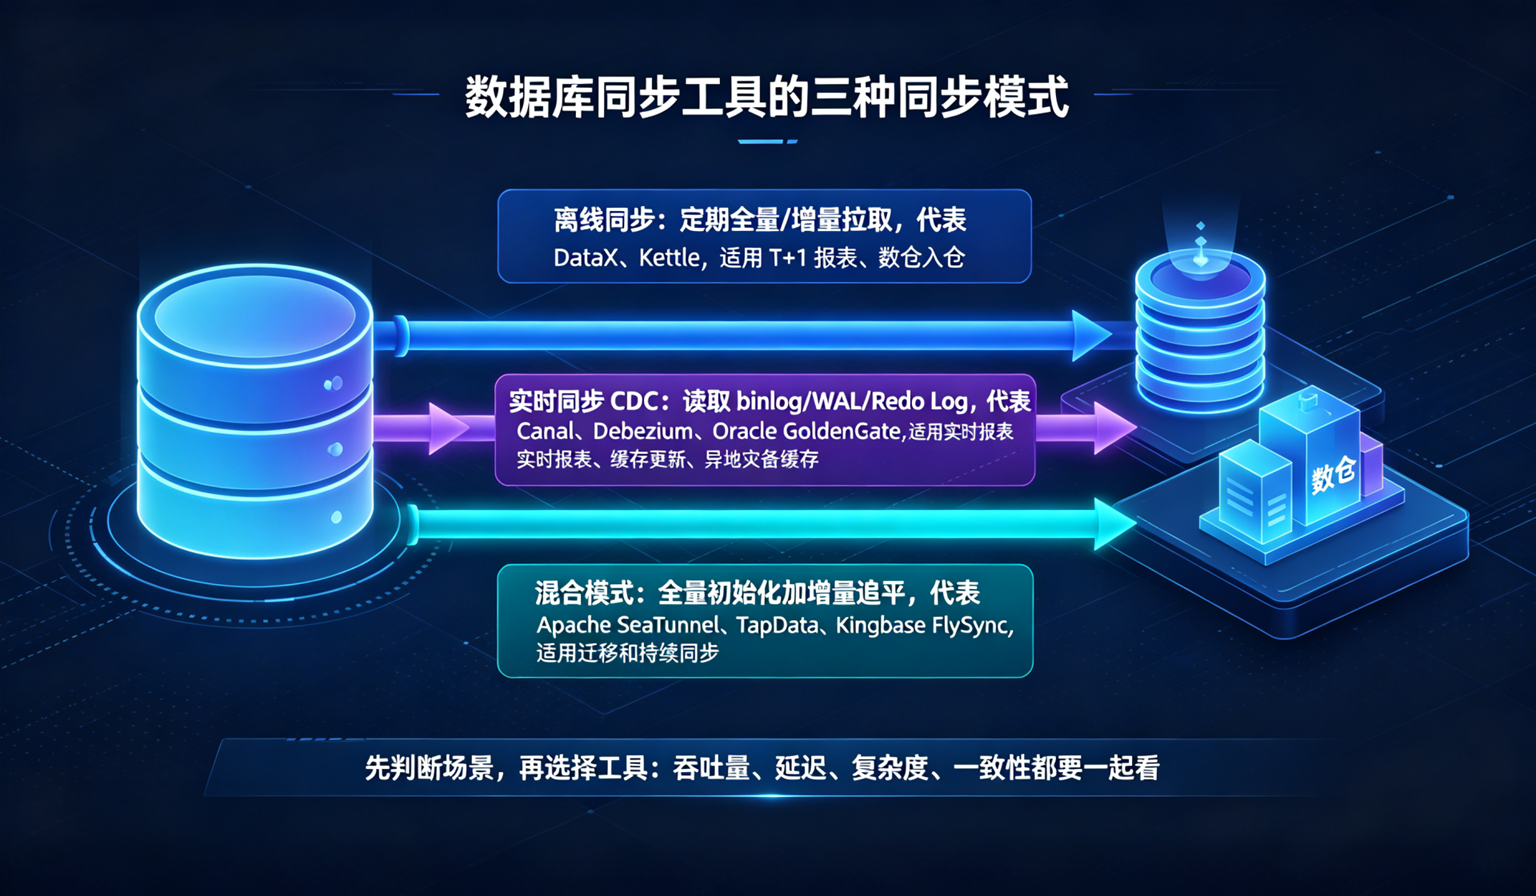 选型时先看自己的场景属于哪一类。离线任务上实时工具是浪费资源,实时需求用离线工具会出问题。 --- ## 主流数据库同步工具对比,一张表看清各家长短 我把测试过的主流数据库同步工具整理成了一张对比表。数据来源是我自己的测试环境和各工具官方文档。测试环境是两台8核16G的服务器,源库MySQL 8.0,目标库PostgreSQL 14,数据量约五百万行。 | 工具 | 同步方式 | 支持数据源 | 实时性 | 易用性 | 开源/商业 | 适用场景 | 核心局限 | | ----------------- | --------- | --------------------------------- | ------ | --- | ----- | ------------------- | -------------------- | | DataX | 离线 | MySQL/Oracle/PG/Hive/HBase等 | 低(T+1) | 中 | 开源 | 数据仓库入仓、定时报表 | 单机瓶颈、无实时能力 | | Canal | 实时CDC | MySQL | 高(毫秒级) | 中 | 开源 | MySQL实时同步、缓存更新 | 仅支持MySQL | | Debezium | 实时CDC | MySQL/PG/Oracle/SQLServer/MongoDB | 极高 | 低 | 开源 | 事件流架构、多源CDC采集 | 强依赖Kafka | | Kettle | 离线 | 几乎所有主流数据库 | 低 | 低 | 开源 | 复杂ETL、数据清洗 | 学习成本高 | | SeaTunnel | 全量+增量+CDC | MySQL/PG/Oracle/Hive/Iceberg等 | 高 | 中 | 开源 | 大数据量同步、湖仓一体 | 需理解分布式模型 | | TapData | 全量+增量+CDC | MySQL/Oracle/PG/MongoDB/达梦/金仓等 | 高 | 高 | 商业+开源 | 多源异构实时同步、国产替代 | 商业版付费 | | Oracle GoldenGate | 实时CDC | Oracle/MySQL/SQLServer/DB2等 | 极高 | 低 | 商业 | 金融级Oracle实时复制 | 授权费用高 | | Kingbase FlySync | 全量+增量+CDC | Oracle/MySQL/PG/SQLServer/KES等 | 高 | 高 | 商业 | Oracle到KES迁移、异构数据同步 | 聚焦Oracle/MySQL到KES场景 | 选型时最容易犯的错误,是把数据源支持范围想当然。选数据库同步工具时,Canal只能吃MySQL的binlog,设计原理就是这样。源库是Oracle的话,Canal直接排除。Debezium支持多源CDC,但架构依赖Kafka,部署复杂度直接上一个台阶。 实测性能数据也值得参考。同样的五百万行MySQL到PostgreSQL同步,DataX单通道约每分钟12万行,开到五个通道能到每分钟45万行,但源库CPU也跟着上去了。Canal做实时CDC,稳定状态下延迟在200毫秒以内,峰值不超过1秒。SeaTunnel分布式模式下,三节点集群吞吐能到每分钟80万行,但单节点和DataX差距不大。KFS做Oracle到KES的全量同步,2000万行大约4小时,增量CDC延迟在秒级以内。这些数据是我测试环境的结果,实际表现要看网络、磁盘IO和数据特征。 --- ## 数据库同步工具CDC方案,为什么多数团队卡在DDL同步上 CDC是实时数据库同步工具的核心技术。原理不复杂:伪装成数据库的从节点,订阅变更日志,解析后推到目标端。DDL(表结构变更)同步才是所有CDC工具的公共难题。 源库加了一列,或者改了字段类型。CDC工具如果只管DML(增删改),目标库的表结构就和源库对不上了。后续数据推过来,字段对不上,直接报错。 DDL之外,还有两个容易被忽略的难题。 **长事务处理**。源库批量任务跑两小时,Canal会把中间状态实时推出,目标库可能先收到部分更新。Debezium等事务提交后再发,但内存持续上涨。KFS默认提交后记位点,但Checkpoint间隔需要合理设置,太短会增加I/O开销,太长网络抖动时可能丢失进度。 **大字段同步**。BLOB或CLOB字段,Canal解析时内存暴涨。Debezium默认转Base64,消息体积膨胀三倍。KFS做了分片处理,配置里开启后同步更稳定。 我之前用Canal,DDL同步得自己写消费者处理。Canal只负责解析binlog,DDL事件推过来后,你要自己写逻辑去目标库执行ALTER TABLE。写漏了,后面数据全丢。 SeaTunnel在这块做得相对完整。它支持全量加增量自动切换,DDL变更能通过内置的转换插件自动映射到目标端。但配置不简单,需要理解它的分布式执行模型。我第一次配的时候,Checkpoint间隔设大了,网络抖动时丢了十几万条数据。后来把间隔从五分钟调到三十秒,加上Exactly-Once语义保障,才算稳下来。 Debezium把DDL事件发到Kafka Topic里,下游消费者自己决定怎么处理。灵活,但你要多写一套消费逻辑。团队没有专职流处理工程师的话,这块会拖很久。 实时同步项目,DDL同步方案在选型阶段就得定下来。上线了才发现DDL没处理好,返工成本比选型时多花几天时间高得多。 --- ## 数据库同步工具信创适配,国产数据库同步怎么选 信创项目的数据库同步需求,和普通项目有个本质区别:源库或目标库里至少有一个是国产数据库。达梦、金仓、OceanBase、GaussDB,这些库的日志格式、复制协议、驱动接口,和MySQL/Oracle不完全一样。 通用开源同步工具,大部分没针对国产数据库做深度适配。DataX的OracleReader写得很成熟,但国产数据库的Reader插件是社区后来补的,适配深度和稳定性还在追赶。Canal的binlog解析专门针对MySQL做,换成国产库的日志格式直接不认。 去年我参与了一个项目,客户从Oracle迁移到KingbaseES。Oracle那边三百多个存储过程,迁移后按标准流程跑了三个月双写验证,保持Oracle和KES之间的数据实时同步。 同步方案对比了三个选项。OGG是Oracle官方方案,对KES的支持有限。TapData支持Oracle到KES的CDC同步,可视化配置上手快。KES自有的Kingbase FlySync专为Oracle到KES的迁移场景设计,结构迁移、全量迁移、增量同步和数据校验订正都支持,全链路在信创环境下跑得很顺。 选型主要看三个指标。DDL同步完整度,源库改了表结构目标库能不能自动跟上。断点续传可靠性,网络断了重连后数据会不会丢或重复。数据校验能力,同步跑了一段时间后两边数据能不能一键对账。Kingbase FlySync这三项表现都不错,异构数据库之间的结构映射不用手写转换脚本。 Oracle到国产数据库的迁移同步,专用工具比通用工具风险小。还有个容易被忽略的点:信创环境下部署任何同步工具,都要注意JDBC驱动和CPU架构的匹配。x86版驱动在鲲鹏加统信UOS的服务器上可能连源库报超时,换成ARM适配版就正常。POC阶段要把CPU架构、操作系统、驱动版本都验证一遍。 --- ## Kingbase FlySync实战,Oracle到KES迁移全链路 此前参与的省级财务平台迁移,源库Oracle 11g,目标库KingbaseES V8。三百多张表,核心交易表两千多万行。分四步走。 结构迁移用KFS内置工具,Oracle的表结构、索引、约束自动映射到KES。NUMBER转NUMERIC,VARCHAR2转VARCHAR,十几个自定义精度的表手动调了映射规则。 全量初始化2000万行跑了将近4小时,源库CPU峰值65%。跑完自动切增量CDC,延迟秒级以内。校验跑了全表行比对加500条随机抽样,数据一致。最后三个月双写验证,每周对账,没出过差异。 过程中踩了两个坑。Oracle的DECODE函数是Oracle独有的语法,目标库不是Oracle的话,这种函数都得手动处理。KFS控制台有自定义转换规则,在同步层加了一层映射,把DECODE逻辑转成标准SQL,问题解决了。长事务导致位点回退,报表任务跑两小时,Checkpoint设三十秒把中间状态记下来了,网络抖动后重复写入二十万条。这是所有CDC工具的共性风险,把间隔调到六十秒,开了事务完整性校验,问题解决。 KFS全量加增量自动切换省心,数据校验也实用。它聚焦Oracle和MySQL到KES场景,在这个方向做得比较深。如果是跨国产库同步或多目标分发,TapData更合适。 --- ## 数据库同步工具5个踩坑教训,选型前看完省一半时间 **第一个坑,全量同步期间源库被打挂。** 用DataX跑全量同步,五百万行的表一次性拉。源库MySQL的CPU飙到95%,业务查询卡了十几秒。客户打电话投诉,说系统跟死了一样。 后来改了策略。分片拉取,每次十万行,中间间隔两秒。对源库的影响降到百分之十以内。DataX本身支持分片键配置,但默认是全表扫描,上线前一定要检查分片设置。 **第二个坑,网络抖动后数据重复写入。** 目标库是PostgreSQL,同步任务跑着网络闪断了十秒。重连后,断点前那批数据又推了一遍。目标库里出现一批重复记录,财务对账直接乱了。 解决办法是开幂等写入。SeaTunnel的Checkpoint加两阶段提交,能做到Exactly-Once。TapData也内置了幂等机制。很多开源工具默认配置不开这个功能,上线前要手动配。 **第三个坑,DDL同步没跟上,目标库表结构对不上。** 前面CDC那节说过这个坑。补充一个细节:有些工具只同步表结构变更,不同步索引变更。源库加了个联合索引,目标库没有。结果目标库慢查询突然多了起来,查了半天才发现是索引没同步过来。 **第四个坑,异构数据库类型映射出错。** MySQL的DATETIME类型同步到PostgreSQL变成TIMESTAMP WITH TIME ZONE。时区一转换,时间差八个小时。业务逻辑全乱。 Oracle的NUMBER类型同步到KES,默认映射成DECIMAL。大部分场景没问题,NUMBER不带精度的写法在KES里需要显式声明。迁移前先用评估工具跑一遍,把类型映射关系理清楚。 **第五个坑,同步任务没有监控告警。** 任务跑着停了,没人知道。三天后客户发现报表数据停留在三天前。排查才发现同步进程早就挂了,没有任何告警。 数据库同步工具一定要配监控。任务状态、延迟时间、数据量、错误日志,四项至少要有。TapData和Kingbase FlySync自带可视化监控面板。开源工具像DataX和SeaTunnel,自己接Prometheus加Grafana。 --- ## 数据库同步工具配置示例 先看DataX的全量同步配置。从MySQL到PostgreSQL的标准写法。 ```json { "job": { "content": [{ "reader": { "name": "mysqlreader", "parameter": { "username": "sync_user", "column": ["id", "name", "amount", "create_time"], "connection": [{"table": ["orders"], "jdbcUrl": ["jdbc:mysql://192.168.1.100:3306/prod_db"]}], "where": "create_time >= '2026-01-01'" } }, "writer": { "name": "postgresqlwriter", "parameter": { "username": "target_user", "column": ["id", "name", "amount", "create_time"], "connection": [{"jdbcUrl": "jdbc:postgresql://192.168.1.200:5432/dw_db", "table": ["orders"]}] } } }], "setting": { "speed": { "channel": 3, "record": 10000 } } } } ``` channel设3,三个并发通道。record设一万,每次拉一万条。根据源库承受能力调。我那个把源库打挂的例子,channel设成了10,太高了。 Oracle到KES的同步,Kingbase FlySync通过控制台配置。添加源端和目标端数据源,选全量加增量模式,勾选表,启动任务。类型映射是关键,Oracle的NUMBER、VARCHAR2、DATE对应KES的NUMERIC、VARCHAR、TIMESTAMP。内置自动映射,但建议先用结构迁移功能跑一遍,确认字段类型没问题再跑数据。 --- ## 数据库同步工具选型决策矩阵,按场景对号入座 选工具别凭感觉。按数据量级、实时性要求和预算三个维度来筛。 ``` 你的数据量有多大? | +-- 百万行以下,每天同步一次 | +-- DataX(稳定、配置简单、开源免费) | +-- Kettle(可视化操作,但学习成本高) | +-- 千万到亿级,需要近实时(分钟级延迟) | +-- SeaTunnel(分布式扩展,批流一体) | +-- TapData(可视化配置,商业版省心) | +-- 持续实时同步(秒级/毫秒级延迟) | +-- MySQL源 → Canal(轻量、毫秒级) | +-- 多源异构 → Debezium + Kafka(灵活但架构重) | +-- Oracle源 → GoldenGate(企业级,贵) | +-- Oracle迁移到国产数据库 | +-- 金仓KES目标 → Kingbase FlySync(专为异构迁移设计) | +-- 多国产库目标 → TapData(支持达梦/金仓/OceanBase) | +-- 信创项目,要求私有化部署 | +-- Kingbase FlySync(信创环境全兼容) | +-- SeaTunnel(开源、可私有部署) | +-- TapData(支持本地部署版本) ``` 选型时还有个隐形成本很多人忽略:运维人力。DataX开箱即用,出了问题自己查日志。GoldenGate功能强,配置复杂,没经验的DBA配一天都配不完。TapData和Kingbase FlySync有可视化界面,非DBA也能上手。团队没有专职DBA的话,易用性维度要加权重。 --- ## 数据库同步工具不同角色选型建议 DBA这边。Oracle存量系统迁移到国产库,DDL完整度和数据校验是硬指标。表结构能不能自动同步,两边数据能不能一键对账,POC阶段就测。 开发这边。看同步工具跟现有技术栈的兼容性。驱动认不认,方言包有没有,这些提前验证。我之前帮项目评估KES迁移,20个主流开源组件都做了适配验证。 运维这边。监控告警是底线。选工具时先把监控面板打开看看。延迟多少、每秒处理多少条、有没有错误日志,这些一目了然。算账时把运维人力成本加进去。 --- ## 数据库同步工具选型总结,按场景选别按名气选 数据库同步工具没有万能解。离线选DataX,MySQL实时选Canal,多源异构选SeaTunnel或TapData,Oracle到KES迁移选Kingbase FlySync。按场景选,别按名气选。 我踩过的坑,总结起来就三条:分片参数要调,幂等写入要开,监控告警要配。选型阶段花两天把这三件事搞清楚,上线后能省两周排查时间。 开头那个凌晨丢数据的客户,后来切了混合模式同步,开了幂等和监控,跑了两个月再没丢过一条。 你目前在什么场景下需要同步?源库和目标库分别是什么?数据量多大?评论区说一下,我帮你看看哪个方案合适。 我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋 --- *本文数据来源:作者实测环境(MySQL 8.0到PostgreSQL 14,8核16G服务器,五百万行测试数据)及各工具官方技术文档。测试数据仅供参考,实际表现因部署环境和数据特征而异。文中提及的产品仅为技术示例,实际选型应结合具体业务需求综合评估。*