首页 文章 精选 留言 我的

精选列表

搜索[手脑一体],共10002篇文章
优秀的个人博客,低调大师

RxJS 实现摩斯密码(Morse) 【内附脑图】

参加 2018 ngChina 开发者大会,特别喜欢 Michael Hladky 奥地利帅哥的 RxJS 分享,现在拿出来好好学习工作坊的内容(工作坊Demo地址),结合这个示例,做了一个改进版本,实现更简洁,逻辑更直观。 一、摩斯密码是什么? 了解者可跳过次章节 摩斯密码(Morse),是一种时通时断的信号代码,这种信号代码通过不同的排列组合来表达不同的英文字母、数字和标点符号等。 地球人都知道的 SOS 求救信号,就是 Morse,三短(S) 三长(O) 三短(S)。 信号对应表如下: 二、业务逻辑分析 分析关键步骤,很巧,和把大象装进冰箱里同样都只需要三步耶: 第一步,识别点信号,短为 “滴” 长为“嗒”。 第二步,根据 “长间隔” 来切片分组。 第三步,分组数据根据对应表转化出最终结果。 三、撸代码,优化后版本(完整在线示例) 开始前要做好热身活动: Morse 的最小单元,"." 代表嘀,"-" 代表嗒,点击事件用 Down 代表 mousedown,Up 代表 mouseup。 200ms 间隔用来区别嘀嗒,1s 间隔用来区分一个 Morse 单元组的结束。 // 点信号 = Down - Up = 间隔 < 200ms ?"." : "-"; // Down <200ms Up >1s = "." = E // Down <200ms Up <1s Down >200ms Up >1s = ".", "-" = A // 直接使用 fromEvent 操作符,来生成点击操作的流,然后用 map 操作符转化成时间戳, // takeUntil 用来控制流的结束,避免重复订阅。 const clickBegin$ = fromEvent(this.sendButtonElementRef.nativeElement, 'mousedown') .pipe( takeUntil(this.onDestroy$), map(n => Date.now()) ) const clickEnd$ = fromEvent(this.sendButtonElementRef.nativeElement, 'mouseup') .pipe( takeUntil(this.onDestroy$), map(n => Date.now()) ) 第一步,识别点信号为 “滴” “嗒” 前面代码已经拿到点击事件的流,并且用 "map" 操作符,把数据转化为当前的时间戳。 下面开始计算 Down & Up 之间的间隔时间,思考,合并两个流的的操作符有哪些呢? forkJoin、concat ? 需要两个流 complate 状态后才返回数据,不适应数据持续输出的场景。 merge ? Down & Up 的时间戳不会同时获得,还需要处理存储的问题,不完全适应场景。 combineLatest ? 满足数据持续输出,满足同时获得,哎哟,还不错。 但是这个操作符的特点是,会缓存上一次的值,所以第二次 Down 也会获得到数据,Up - Down 也就会为负值,取绝对值后可以用来判断是否 >1s,来区分一个 Morse 单元组的结束。 zip ? 哎呀哈,这个更合适呢,盘它! 单词选的很到位,这个操作符功能可以理解为像拉链一样,确保获得数据每一次都是一个纯净的 Down & Up。 但是需要注意 zip 会自动缓存数据,例如 zip(A$, B$),A$收到的数据一直比B$多太多,有内存溢出风险,就像拉错位的拉链,很蓝瘦。 // zip的实现 zip(clickBegin$, clickEnd$) .pipe( // 计算 Down - Up 间隔时间 map(this.toTimeDiff), // 根据间隔时间,转化为嘀嗒替代字符 "." "-" map(this.msToMorseCharacter) ) .subscribe(result => { // 发送到主信号流 morseSignal$.next(result); }); 第二步,根据 “长间隔” 来切片分组 分组的操作符有哪些? partition? 根据函数拆成两个流。 groupBy? 根据函数拆成 n 个流。 window? 根据流拆成 n 个流。以上各位都打扰了,我还要自己处理数据缓存,再见。 buffer? 哇,初恋般的感觉,用流控制来做切片数据成数组,拿到数组只需要 join 一下就好,就可以去去匹配对应表了,好棒! “长间隔”的切片流,怎么获得呢?拿出法宝 debounceTime(1000) ,当点击的 Down Up 周期完成后,间隔 1s 就认为是一个Morse 单元组的结束。 然后又遇到了问题,怎么判断一个点击周期呢?不用单纯用 Up ,因为下一个 Down Up 周期可能会超出 1s,就会导致切片时机错误。所以模拟了点击持续的流 clickKeeping$,用 switchMap 替换为新的流且不影响原来的流,timer 产生一个小于 1s 间隔的持续流信号,用 takeUntil 在 Up 事件流 clickEnd$ 后把整个流结束。 // 点击持续状态流 const clickKeeping$ = clickBegin$ .pipe( // 替换为新的流,不影响原来的流 switchMap(() => { // 定时在持续发送数据,维持点击中状态 return timer(0, morseTimeRanges.lessThenlongBreak).pipe( // 直到 Up 后结束点击状态 takeUntil(clickEnd$) ); }) ) // “长间隔”的切片流 const morseBreak$ = clickKeeping$.pipe( debounceTime(morseTimeRanges.longBreak) ); // 获得 Morse 单元组 morseSignal$ .pipe( // 切片分组主信号流 buffer(morseBreak$) // 转化为,例如 ['.', '.', '.'] ) 第三步,分组数据根据对应表转化出最终结果 join('') Morse 单元组去匹配对应表,很简单不用说。 错误发生在 switchMap 中,分支流报错,但是主流不会收到影响,然后用 catchError 捕捉错误。 // Morse 单元组去匹配对应表 private translateSymbolToLetter = morseArray => { const morseCharacters = morseArray.join(''); const find = morseTranslations.find(n => n.symbol === morseCharacters) // 这里 find 可能为 undefined 导致报错,但是错误会被 catchError 捕捉 return find.char; } // 转化+错误处理,最终完成 morseSignal$ .pipe( buffer(morseBreak$), switchMap(n => { return of(n).pipe( // 只为了 Demo 演示中的展示用 tap(n => this.lastMorseGroupCharacters = n.join(' ')), // 转化成对应表中字符 map(this.translateSymbolToLetter), // 捕捉错误 catchError(n => { return of(morseCharacters.errorString); }) ) }) ) .subscribe(result => { // 输出最终转化结果 this.morseLog.push(result); console.log('结果:', result) }); 四、解读 Michael Hladky 大神的示例 整体上,把 “嘀嗒” “短间隔” “长间隔” 都转化成替代符,过滤无用的替代符,然后 filter “长间隔” 替代符的流,来做 buffer 切片数据。其他还有因为使用 combineLatest 操作符导致的不同。 // 识别 “嘀” “嗒” const morseCharFromEvents$ = observableCombineLatest(this.startEvents$, this.stopEvents$) .pipe( // 计算 mousedown mouseup 时间间隔 map(this.toTimeDiff), // 转化成标识符 map(this.msToMorseChar), // 过滤 Morse 单元组中的 “短间隔“ 标识符 filter(this.isCharNoShortBreak as any) ); // 主信号流 this.morseChar$ = observableMerge(morseCharFromEvents$, this.injectMorseChar$) // 识别 “长间隔“ 标识符,来作为切片流 const longBreaks$ = this.morseChar$ .pipe(filter(this.isCharLongBreak as any)); // 切片成 Morse 单元组 this.morseSymbol$ = this.morseChar$ .pipe( buffer(longBreaks$), map(this.charArrayToSymbol), filter(n => (n !== '') as any) ) // 错误处理 + 标识符对应表转化 this.morseLetter$ = this.morseSymbol$ .pipe( switchMap(n => observableOf(n).pipe(this.saveTranslate('ERROR'))) ); // Up 后补4个 “长间隔“ 标识符,用来做 Morse 单元组的结束 const breakEmitter$ = observableTimer(this.msLongBreak, this.msLongBreak) .pipe( mapTo(this.mC.longBreak), take(4) ); this.stopEventsSubject .pipe( switchMapTo( breakEmitter$.pipe(takeUntil(this.startEventsSubject)) ) ) .subscribe(n => this.injectMorseChar(n)); 总结 下图是读完《深入浅出RxJS》后的学习笔记,标注了一些操作符的快速记忆特点,方便使用的适合查阅。 本文作者:甄帅 文章来源:Worktile技术博客 欢迎访问交流更多关于技术及协作的问题。 文章转载请注明出处。


优秀的个人博客,低调大师

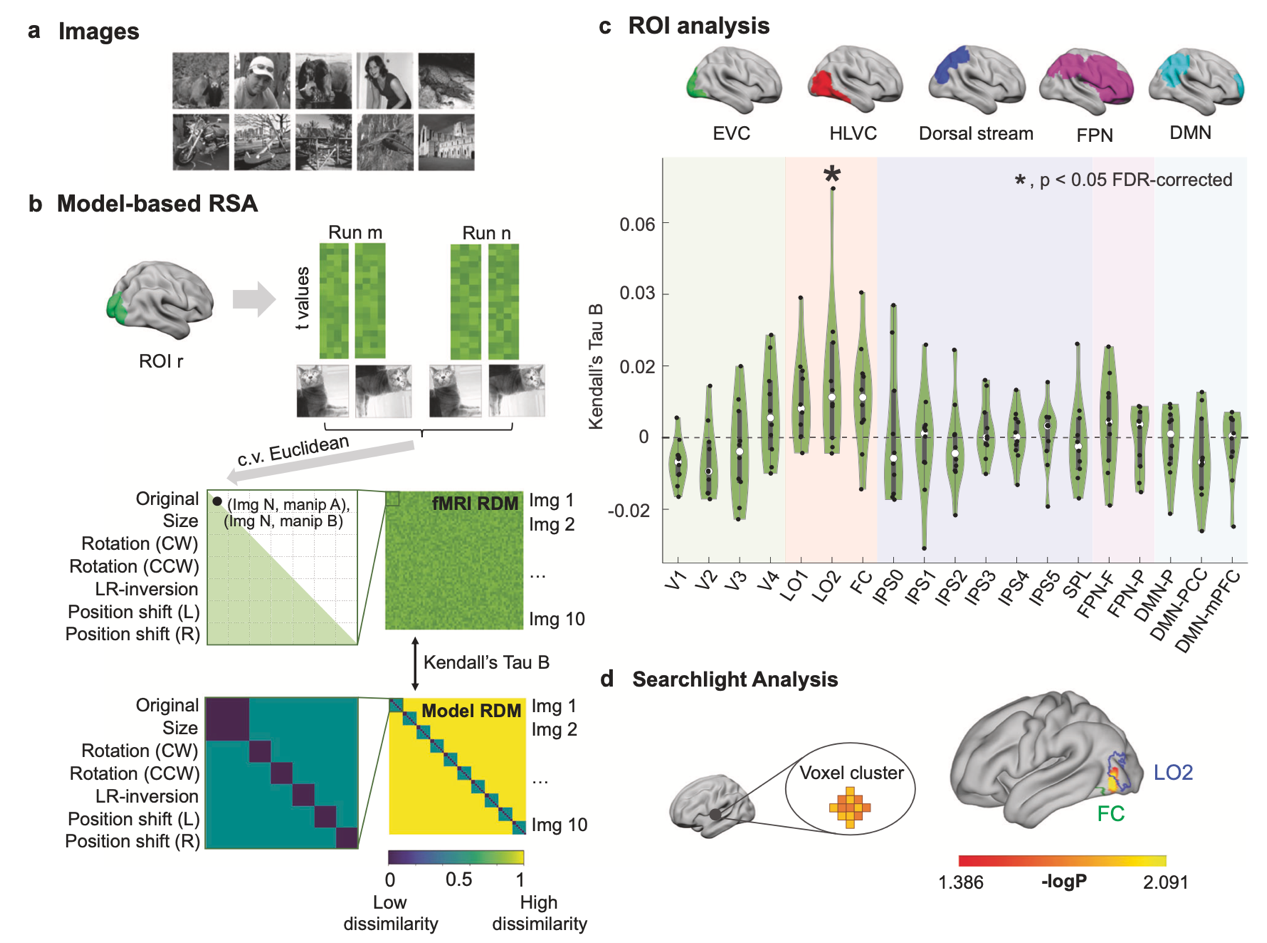
Nature子刊:脑成像揭示“顿悟”的神经机制

大脑成像研究的最新成果揭示,洞察力的闪现并非仅令人愉悦,它们实际上会重塑大脑对信息的表征方式,并助力将这些信息深深刻入记忆。这项研究由美国杜克大学以及德国洪堡大学和汉堡大学的研究人员联合开展,其发现对教育领域具有深远意义,表明培养“尤里卡时刻”或许能够使学习效果超越课堂,实现长期记忆与知识的深度内化。

优秀的个人博客,低调大师

网友脑洞大开 用 Emoji 开发“俏皮”编程语言

Emoji表情真是无所不能了。你知道它能当密码,但你想过它能用来编程吗?国外论坛4Chan的一位网友就把Emoji变成了编程语言。这门语言名为FourMan,它当然有一个表情名称,但抱歉,我正在用的编辑框打不出来啊!看看题图中的例子,你能猜出写的什么吗?大概是编程累成狗吧。不知道程序猿看到这种语言作何感想? https://yqfile.alicdn.com/d42fa81eefda6c01f7c77fc6f143821f73ff1fce.png " > FourMan还处于早期阶段,制作者只是开发了一些示例代码,制定了语言规范,但它的最终目标是开发出编译器,Android,iOS和Windows Phone版的IDEs,以及能使用表情的键盘。不过要成为一种完全可用的语言,它还早得很呢。 https://yqfile.alicdn.com/3c4bd1f139b3739106574d3b5ce09d135831ec6f.png " > 当然,这并不是第一次有人干这种事,之前还有一个被称为Emoticon的表情语言,而且苹果的Swift语言还支持表情变量哦。 文章转载自 开源中国社区 [http://www.oschina.net]

优秀的个人博客,低调大师

灵魂画手:漫画图解 SSH

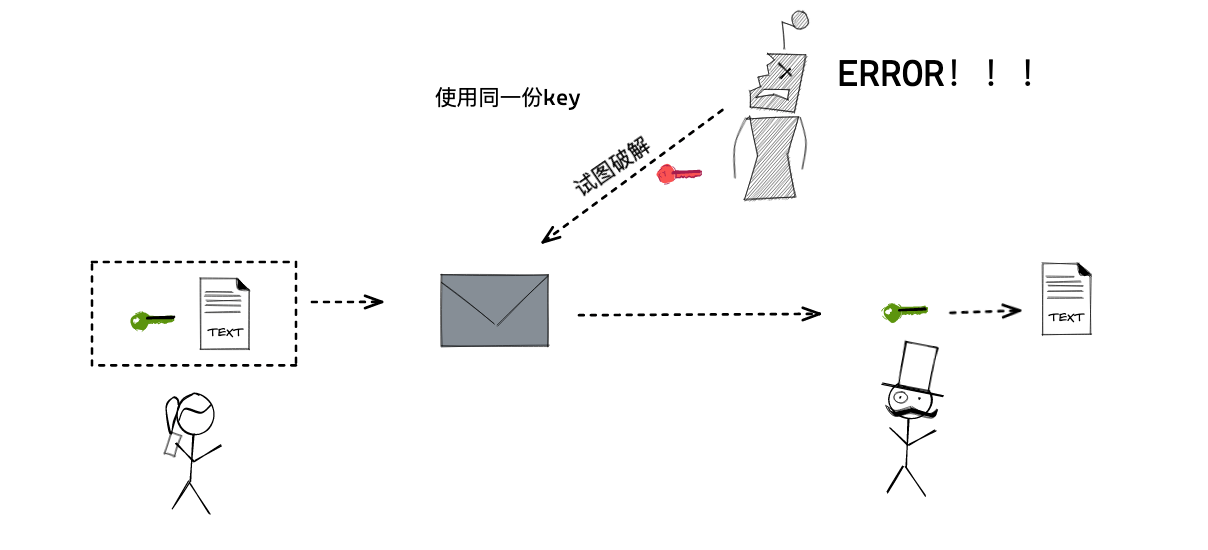
OpenSSL 本身是一个软件库,这个软件被广泛的应用在系统服务器当中,他的主要功能是在网络通信的过程中,保证数据的一致性以及数据传输过程中的安全性。软件本身是由C语言编写,这使得他具备了跨平台的特性,OpenSSL 主要包括如下三大功能: 加解密: OpenSSL 具有丰富的加解密算法库,支持不同的加解密方式以及存储秘钥的方式,如对称加密,非对称加密,信息摘要等内容 SSL 协议: OpenSSL 实现了 SSL 协议的的 SSLv2 和 SSLv3,支持了其中绝大部分算法协议 证书操作: OpenSSL 自身提供了一种文本数据库,支持证书的管理功能,包括证书秘钥的产生、请求产生、证书签发、吊销和验证等功能。 加解密的几种形式 加解密的形式通常分为以下几种: 对称加密算法 非对称加密算法 不可逆加密算法 下面我们挨个来看这些加密算法。 对称算法 对称算法是指信息的发送方和接收方使用同一份秘钥去加解密数据。AES、DES 等都是常用的对称加密算法。 对称算法的优点是加解密的速度快,适合对于大数据量加密。缺点是因为只有一个秘钥,所以秘钥管理困难,只要暴露了,就很容易破解加密后的信息。 非对称算法 非对称算法是指信息的发送方和接收方分别持有一份秘钥。一份公开发布,称公钥;一份私有,称秘钥。秘钥可以导出对应的公钥。RSA、DSA 等是常用的非对称加密算法。 一般情况下,信息发送者用公开密钥去加密,而信息接收者则用私用密钥去解密。公钥机制灵活,但加密和解密速度却比对称密钥加密慢得多。不同的使用场景下,也会衍生出其他的使用方法,比如私钥加密,公钥解密。 RSA 加解密算法 RSA 是一个流行的非对称加密算法, 生成公私钥内容如下: # 生成秘钥 OpenSSL genrsa -out test.key 1024 # 从秘钥中导出公钥 OpenSSL rsa -in test.key -pubout -out test_pub.key # 公钥加密文件 echo "test" > hello OpenSSL rsautl -encrypt -in hello -inkey test_pub.key -pubin -out hello.en # 私钥解密文件 OpenSSL rsautl -decrypt -in hello.en -inkey test.key -out hello.de 不可逆加密算法 不可逆加密算法主要用于校验文件的一致性,摘要算法就是其中一种。常用的摘要算法有 MD5。 摘要算法 摘要算法用来把任何长度的明文以一定规则变成固定长度的一串字符。在做文件一致性校验的时候,我们通常都是先使用摘要算法,获得固定长度的一串字符,然后对这串字符进行签名。接收者接收到文件后,也会执行一遍摘要算法后再签名。前后数据一致,则表示文件在传输过程没有被窜改。 base64 特别需要注意的是,base64 不是加密算法,它是编码方式。 它可以方便传输过程 ASCII 码和二进制码之间的转换。类似于图片或者一些文本协议,在传输过程中通常可以使用 base64 转换成二进制码进程传输。 SSH 加密流程 客户端发送自己的密钥 ID 给服务器端 服务器在自己的 authorized_keys 文件中查找是否存在此 ID 的公钥 如果有,则服务器生成一个随机数,用当前 ID 的公钥加密 服务器将加密后的随机数发给客户端 客户端用私钥解密该随机数,然后在本地为随机数做 MD5 加密 客户端将该 MD5 哈希发给服务器端 服务器端为一开始自己生成的随机数也做一个 MD5 哈希,然后用通讯通道“公共的密钥”将该哈希加密,再跟客户端发来的内容进行对比。如果双方内容一致,则通过验证,开放访问权限给客户端 深入了解 OpenSSL 后,其对密码学技术的功能支持会让你激动不已,如果有兴趣可以更加深入地了解其中的内容以及试验不同加密方式在不同场景中的使用。放个小预告: 后续还会推出一篇用 pyo3 来给 python 编写 rsa 正反向加解密模块的文章。 推荐阅读 webpack 从 0 到 1 构建 vue MySQL 那些常见的错误设计规范

优秀的个人博客,低调大师

来,教你写一手好SQL!

点击关注上方“SQL数据库开发”, 设为“置顶或星标”,第一时间送达干货 本人负责的项目主要采用阿里云数据库 MySQL,最近频繁出现慢 SQL 告警,执行时间最长的竟然高达 5 分钟。 导出日志后分析,主要原因竟然是没有命中索引和没有分页处理。其实这是非常低级的错误,我不禁后背一凉,团队成员的技术水平亟待提高啊。 改造这些 SQL 的过程中,总结了一些经验分享给大家,如果有错误欢迎批评指正。 MySQL 性能 ①最大数据量 抛开数据量和并发数,谈性能都是耍流氓。MySQL 没有限制单表最大记录数,它取决于操作系统对文件大小的限制。 《阿里巴巴 Java 开发手册》提出单表行数超过 500 万行或者单表容量超过 2GB,才推荐分库分表。 性能由综合因素决定,抛开业务复杂度,影响程度依次是硬件配置、MySQL 配置、数据表设计、索引优化。500 万这个值仅供参考,并非铁律。 我曾经操作过超过 4 亿行数据的单表,分页查询最新的 20 条记录耗时 0.6 秒,SQL 语句大致是: selectfield_1,field_2fromtablewhereid<#{prePageMinId}orderbyiddesclimit20 prePageMinId 是上一页数据记录的最小 ID。 虽然当时查询速度还凑合,随着数据不断增长,有朝一日必定不堪重负。 分库分表是个周期长而风险高的大活儿,应该尽可能在当前结构上优化,比如升级硬件、迁移历史数据等等,实在没辙了再分。对分库分表感兴趣的同学可以阅读分库分表的基本思想。 ②最大并发数 并发数是指同一时刻数据库能处理多少个请求,由 max_connections 和 max_user_connections 决定。 max_connections 是指 MySQL 实例的最大连接数,上限值是 16384,max_user_connections 是指每个数据库用户的最大连接数。 MySQL 会为每个连接提供缓冲区,意味着消耗更多的内存。如果连接数设置太高硬件吃不消,太低又不能充分利用硬件。 一般要求两者比值超过 10%,计算方法如下: max_used_connections/max_connections*100%=3/100*100%≈3% 查看最大连接数与响应最大连接数: showvariableslike'%max_connections%';showvariableslike'%max_user_connections%'; 在配置文件 my.cnf 中修改最大连接数: [mysqld]max_connections=100max_used_connections=20 ③查询耗时 0.5 秒 建议将单次查询耗时控制在 0.5 秒以内,0.5 秒是个经验值,源于用户体验的 3 秒原则。如果用户的操作 3 秒内没有响应,将会厌烦甚至退出。 响应时间=客户端 UI 渲染耗时+网络请求耗时+应用程序处理耗时+查询数据库耗时,0.5 秒就是留给数据库 1/6 的处理时间。 ④实施原则 相比 NoSQL 数据库,MySQL 是个娇气脆弱的家伙。它就像体育课上的女同学,一点纠纷就和同学闹别扭(扩容难),跑两步就气喘吁吁(容量小并发低),常常身体不适要请假(SQL 约束太多)。 如今大家都会搞点分布式,应用程序扩容比数据库要容易得多,所以实施原则是数据库少干活,应用程序多干活: 充分利用但不滥用索引,须知索引也消耗磁盘和 CPU。 不推荐使用数据库函数格式化数据,交给应用程序处理。 不推荐使用外键约束,用应用程序保证数据准确性。 写多读少的场景,不推荐使用唯一索引,用应用程序保证唯一性。 适当冗余字段,尝试创建中间表,用应用程序计算中间结果,用空间换时间。 不允许执行极度耗时的事务,配合应用程序拆分成更小的事务。 预估重要数据表(比如订单表)的负载和数据增长态势,提前优化。 数据表设计 ①数据类型 数据类型的选择原则,更简单或者占用空间更小: 如果长度能够满足,整型尽量使用 tinyint、smallint、medium_int 而非 int。 如果字符串长度确定,采用 char 类型。 如果 varchar 能够满足,不采用 text 类型。 精度要求较高的使用 decimal 类型,也可以使用 BIGINT,比如精确两位小数就乘以 100 后保存。 尽量采用 timestamp 而非 datetime。 相比 datetime,timestamp 占用更少的空间,以 UTC 的格式储存自动转换时区。 ②避免空值 MySQL 中字段为 NULL 时依然占用空间,会使索引、索引统计更加复杂。从 NULL 值更新到非 NULL 无法做到原地更新,容易发生索引分裂影响性能。 因此尽可能将 NULL 值用有意义的值代替,也能避免 SQL 语句里面包含 is not null 的判断。 ③Text 类型优化 由于 Text 字段储存大量数据,表容量会很早涨上去,影响其他字段的查询性能。建议抽取出来放在子表里,用业务主键关联。 索引优化 索引分类如下: 普通索引:最基本的索引。 组合索引:多个字段上建立的索引,能够加速复合查询条件的检索。 唯一索引:与普通索引类似,但索引列的值必须唯一,允许有空值。 组合唯一索引:列值的组合必须唯一。 主键索引:特殊的唯一索引,用于唯一标识数据表中的某一条记录,不允许有空值,一般用 primary key 约束。 全文索引:用于海量文本的查询,MySQL 5.6 之后的 InnoDB 和 MyISAM 均支持全文索引。由于查询精度以及扩展性不佳,更多的企业选择 Elasticsearch。 索引优化原则: 分页查询很重要,如果查询数据量超过 30%,MySQL 不会使用索引。 单表索引数不超过 5 个、单个索引字段数不超过 5 个。 字符串可使用前缀索引,前缀长度控制在 5-8 个字符。 字段唯一性太低,增加索引没有意义,如:是否删除、性别。 合理使用覆盖索引,如下所示: selectlogin_name,nick_namefrommemberwherelogin_name=? login_name, nick_name 两个字段建立组合索引,比 login_name 简单索引要更快。 SQL 优化 ①分批处理 博主小时候看到鱼塘挖开小口子放水,水面有各种漂浮物。浮萍和树叶总能顺利通过出水口,而树枝会挡住其他物体通过,有时还会卡住,需要人工清理。 MySQL 就是鱼塘,最大并发数和网络带宽就是出水口,用户 SQL 就是漂浮物。 不带分页参数的查询或者影响大量数据的 update 和 delete 操作,都是树枝,我们要把它打散分批处理,下面举例说明。 业务描述: 更新用户所有已过期的优惠券为不可用状态。 SQL 语句: updatestatus=0FROM`coupon`WHEREexpire_date<=#{currentDate}andstatus=1; 如果大量优惠券需要更新为不可用状态,执行这条 SQL 可能会堵死其他 SQL,分批处理伪代码如下: intpageNo=1;intPAGE_SIZE=100;while(true){List<Integer>batchIdList=queryList('selectidFROM`coupon`WHEREexpire_date<=#{currentDate}andstatus=1limit#{(pageNo-1)*PAGE_SIZE},#{PAGE_SIZE}');if(CollectionUtils.isEmpty(batchIdList)){return;}update('updatestatus=0FROM`coupon`wherestatus=1andidin#{batchIdList}')pageNo++;} ②操作符 <> 优化 通常 <> 操作符无法使用索引,举例如下,查询金额不为 100 元的订单: selectidfromorderswhereamount!=100; 如果金额为 100 的订单极少,这种数据分布严重不均的情况下,有可能使用索引。 鉴于这种不确定性,采用 union 聚合搜索结果,改写方法如下: (selectidfromorderswhereamount>100)unionall(selectidfromorderswhereamount<100andamount>0) ③OR 优化 在 Innodb 引擎下 OR 无法使用组合索引,比如: selectid,product_namefromorderswheremobile_no='13421800407'oruser_id=100; OR 无法命中 mobile_no + user_id 的组合索引,可采用 union,如下所示: (selectid,product_namefromorderswheremobile_no='13421800407')union(selectid,product_namefromorderswhereuser_id=100); 此时 id 和 product_name 字段都有索引,查询才最高效。 ④IN 优化 IN 适合主表大子表小,EXIST 适合主表小子表大。由于查询优化器的不断升级,很多场景这两者性能差不多一样了。 尝试改为 Join 查询,举例如下: selectidfromorderswhereuser_idin(selectidfromuserwherelevel='VIP'); 采用 Join 如下所示: selecto.idfromordersoleftjoinuseruono.user_id=u.idwhereu.level='VIP'; ⑤不做列运算 通常在查询条件列运算会导致索引失效,如下所示,查询当日订单: selectidfromorderwheredate_format(create_time,'%Y-%m-%d')='2019-07-01'; date_format 函数会导致这个查询无法使用索引,改写后: selectidfromorderwherecreate_timebetween'2019-07-0100:00:00'and'2019-07-0123:59:59'; ⑥避免Select All 如果不查询表中所有的列,避免使用 SELECT *,它会进行全表扫描,不能有效利用索引。 ⑦Like 优化 Like 用于模糊查询,举个例子(field 已建立索引): SELECTcolumnFROMtableWHEREfieldlike'%keyword%'; 这个查询未命中索引,换成下面的写法: SELECTcolumnFROMtableWHEREfieldlike'keyword%'; 去除了前面的 % 查询将会命中索引,但是产品经理一定要前后模糊匹配呢?全文索引 fulltext 可以尝试一下,但 Elasticsearch 才是终极武器。 ⑧Join 优化 Join 的实现是采用 Nested Loop Join 算法,就是通过驱动表的结果集作为基础数据,通过该结数据作为过滤条件到下一个表中循环查询数据,然后合并结果。 如果有多个 Join,则将前面的结果集作为循环数据,再次到后一个表中查询数据。 驱动表和被驱动表尽可能增加查询条件,满足 ON 的条件而少用 Where,用小结果集驱动大结果集。 被驱动表的 Join 字段上加上索引,无法建立索引的时候,设置足够的 Join Buffer Size。 禁止 Join 连接三个以上的表,尝试增加冗余字段。 ⑨Limit 优化 Limit 用于分页查询时越往后翻性能越差,解决的原则:缩小扫描范围,如下所示: select*fromordersorderbyiddesclimit100000,10耗时0.4秒select*fromordersorderbyiddesclimit1000000,10耗时5.2秒 先筛选出 ID 缩小查询范围,写法如下: select*fromorderswhereid>(selectidfromordersorderbyiddesclimit1000000,1)orderbyiddesclimit0,10耗时0.5秒 如果查询条件仅有主键 ID,写法如下: selectidfromorderswhereidbetween1000000and1000010orderbyiddesc耗时0.3秒 如果以上方案依然很慢呢?只好用游标了,感兴趣的朋友阅读 JDBC 使用游标实现分页查询的方法。 其他数据库 作为一名后端开发人员,务必精通作为存储核心的 MySQL 或 SQL Server,也要积极关注 NoSQL 数据库,他们已经足够成熟并被广泛采用,能解决特定场景下的性能瓶颈。 编辑:陶家龙 出处:www.cnblogs.com/xiaoyangjia/p/11267191.html ——End—— 后台回复关键字:1024,获取一份精心整理的技术干货 后台回复关键字:进群,带你进入高手如云的交流群。 推荐阅读 不懂就问:为什么SELECT * 会导致查询效率低? SQL 语法速成手册 精心整理了一套SQL高级函数,建议收藏 一款SQL自动检查神器,再也不用担心SQL出错了! SQL 语句中 where 条件后 写上1=1 是什么意思 这是一个能学到技术的公众号,欢迎关注 点击「阅读原文」了解SQL训练营 本文分享自微信公众号 - SQL数据库开发(sql_road)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册