首页 文章 精选 留言 我的

精选列表

搜索[手脑一体],共10002篇文章
优秀的个人博客,低调大师

苹果奇葩修漏洞,Siri被“剁手”

前两天 iPhone 6s、iPhone 6s Plus 上的Siri 被爆出严重的漏洞,让用户可以通过一连串“调戏”手段把Siri搞懵X。具体手法如下: 呼出 Siri,命令它进行Twitter搜索。如果搜索结果包含可执行的联系人数据,比如电子邮箱地址,接下来利用3D Touch手势呼出相关菜单,就可以绕过安全验证发送电子邮件、添加或修改联系人信息。 【使用 Siri 和 3D Touch 绕过安全验证演示】 平胸而论,Siri给出这些丰富的搜索结果也是出于“好心”。而且,Siri 的热情并不是造成漏洞的主要原因,绕过安全验证的关键步骤是使用3D Touch 呼出的菜单(3D Touch Quick Action)。 不过,反应迅速的苹果在今天就宣布修复了这个漏洞。正当童鞋们好奇自己为什么没有收到 iOS 升级推送的时候,苹

优秀的个人博客,低调大师

脑洞炸开:阿里巴巴能源云计划PPT外泄

3月26日消息,亿邦动力网独家获得一张阿里内部传出的PPT,内容披露了阿里正在推进的“能源云计划”。这项计划的推进,似乎也从侧面为马云一直念念不忘的“百年企业”梦想给出了一个答案——深入经济腹地。 亿邦动力网了解到,这项主题为“共建美好地球”的阿里能源云计划分为两个方面:发展清洁能源、促进节能增效,可细分为10个大项目: 1. 分布式发电:充分开发利用各种可用的分散可再生能源,以满足特定用户的需要,支持现有配电网的经济运行; 2. 微电网:多个分布式电源按照一定的拓扑结构组成的网络,促进分布式电源与可再生能源的大规模接入; 3. 储能:有效调节新能源发电引起的电网波动,使大规模风电及光伏发电方面可靠地并入常规电网; 4. 电动汽车:促进电能替代,减少排放,可用于电网调峰; 5. 绿色能源交易:通过市场机制促进绿色能源发展; 6. 智能电网:通过广泛应用先进的设备和数字技术,实现电网的可靠、安全、经济、高效; 7. 特高压:通过特高压的建设,实现输送容量大、送电距离长、线路耗损低、占用土地少的目标; 8. 虚拟电厂:通过减少终端用电设备和装置的用电需求的方式来产生“富余”的电能,达到建设实际电厂的效果; 9. 家庭能源管理:在为用户降低能耗,培养良好用能习惯的同时,为企业挖掘新的商机; 10. 冷热电三联供:充分利用天然气的热能,综合用能效率可达90%以上。同时可降低以天然气为染料的供热成本。 图片信息显示,实现这些目标的技术手段则包含大数据、3D打印、物联网、共享服务、移动互联网、高速通信、量子计算、电子商务等。 改变世界,马云与拉里佩奇“英雄所见略同”? 亿邦动力网了解到,早在2014年11月,马云就曾公开表示:“我觉得我们需要的是最本质的东西,水是清的可以喝的,天是蓝的是可以呼吸的,我们所有的生活是舒适的,技术应该保证这些东西,而不是我们不断地思考我们如何追。” Google(谷歌)创始人拉里·佩奇也一直认为,人们是否在使用清洁能源、交通运输是否在优化、互联网是否在变得更好等等,这些工作都很重要。即使是少数人也可以影响这个世界。 从阿里内部流出的图片可以看出,马云与拉里·佩奇所关注的核心项目也有所相同:清洁能源、智能硬件和数据。 公开资料显示,Google方面一直在研发和推进新能源、汽车等项目,与本次曝光的阿里能源云计划相似:一方面,Google X部门一直在研发自动驾驶汽车,其认为自动驾驶汽车的行驶模式可以更加节能高效,因此交通拥堵及对空气的污染将得以减弱;另一方面,Google X部门收购了一家专门开发自动机载风力涡轮机的公司Makani Power。 谷歌对新能源领域具有长远规划和布局,早在2011年6月,谷歌就曾发布过一份报告:《清洁技术创新对美国能源系统和经济的影响》。自2010年至2015年,Google共投资了近20个新能源项目,总装机容量为20亿瓦,可满足50万户家庭的一年的用电需求。 而在数据建立上,谷歌的数据中心包含大量支持Gmail、搜索、地图等谷歌产品及谷歌其它云平台服务所需的服务器。仅2015年,谷歌就已经斥资近100亿美元加强云业务。 虽然,谷歌与阿里对改变世界的理想非常相近,推行领域雷同(均集中于新能源、数据、智能汽车、智能硬件等领域)。但阿里似乎更追求由新能源生产、新能源传输到消费的完整商业链条。 背靠阿里云,整合能源上游 亿邦动力网盘点阿里近一年来,其新能源计划举动,整理如下: 一、 在新能源领域,阿里方面已经先后与太阳能光伏公司阳光电源、联合光伏等达成战略合作协议。内容涉及智慧光伏电站、能源互联网、互联网金融、云计算、大数据、信息安全等领域合作。 阳光电源副总裁赵为介绍称,“我们联合阿里云新近推出了智慧光伏云iSolar Cloud(以下简称iSolar Cloud),这是我们的第四代电站运维管理系统,也是集团级光伏电站运维平台。” 二、 在能源基础设施层面,阿里一方面先后与浙江省电力公司、深圳供电局达成战略合作,涉及能源互联网、互联网+城市供电系统等领域,主推以阿里云为基础的数字化、网络化、智能化;另一方面,阿里云也先后与中石化、中石油达成合作,以实现信息技术与制造技术深度融合的数字化、网络化、智能化。 业内人士分析称,目前,太阳能发电站多建在偏远地区或气候恶劣的山区,由数万片太阳能电池板和光伏逆变器组成,人力维护成本高,接入云端服务后,可实现远程自动维护,了解各设备的运行状况,合理安排维护人力配置。以太阳能光伏公司阳光电源与阿里合作为例,智慧光伏云预期可每年将发电站的收益提高3%-7%,相当于1GW的太阳能发电站,每年可增加收入约5000万元。 若是普通用户在自家屋顶建了小型太阳能发电站,可使用智能手机远程监控,管理发电站的能源使用,多余的能源可计入国家电网出售。长期来看太阳能光伏产业与云端服务结合所带来的收益远不止于此,云端系统可分析给出太阳能发电站所处位置的精确天气预报,进行跨区域的能源供给和消费调整,降低电力传输的损耗。 亿邦动力网了解到,目前,安徽省、甘肃省、华北电力大学等有关部门均提出电网建设、配套设施、清洁能源改进问题、计划。安徽省有关领导人也曾在公开场合提出,构建以“特高压电网+智能电网+清洁能源”为核心的全球能源互联网,是未来电网发展的大方向,在其建设进程中,安徽也将积极转变能源发展方式,融入“电网互联”。阿里能源云计划所提出的清洁能源、特高压、新能源交易、智能电网等恰与其深度契合。 能源云计划,会不会落在YunOS上? 据亿邦动力网了解,在阿里内部流出的能源云计划图表中,电动汽车、家庭能源管理成为其最主要的消费途径。 上汽、力帆均与阿里达成战略合作。其中,上汽互联网汽车将集成阿里的YunOS操作系统、大数据、阿里通信、高德导航、阿里云计算、虾米音乐等资源。 公开资料显示,阿里旗下的YunOS操作系统,于2011年7月正式上线。融合阿里在云数据存储、云计算服务以及智能设备操作系统等多领域的技术,可搭载于智能手机、智能机顶盒、互联网电视等多种智能终端设备。 亿邦动力网了解到,除去YunOS官方网站宣传的“DT时代的OS”中,适用于任何智能产品(手机、穿戴、电脑、汽车以及物联网)之外,YunOS还与多家机构合作。百度百科显示,2014年,YunOS以唯一的移动操作系统身份入围2014年中央国家机关政府采购协议供货商名单;2015年,与公安部第一研究所合作研发的PMOS专用移动操作系统荣获“CITE创新金奖”,与深圳路畅科技联合研发的畅安云系列智能车载导航也荣获“CITE创新奖”。YunOS在不知不觉中,已经延伸到了众多领域之中。 从已曝光的阿里能源云计划可以看出,由清洁能源(光电、风电等)、电网,最终到达互联网汽车、智能家用电器等恰为一个完整的商业链条。 阿里云以能源云计划为切入点,可将上至能源产生、下至能源输送串联成一个整体,并最终以YunOS整合出行、家庭等智能设备,能源消耗全部聚拢于阿里云的大体系之内。 资深电商系统服务界研究人士向亿邦动力网分析称,阿里通过阿里云将太阳能、风能等清洁能源整合之后,以电网传送至用户手中,通过对接支付宝付款。阿里云整合所有数据之后,可以描述每一个用户的生活。 上述资深研究人士同时表示,从阿里内部流出的图片可以看出,阿里能源云计划中的“家庭能源管理”描述(在为用户降低能耗,培养良好用能习惯的同时,为企业挖掘新的商机)的前景,极为契合。届时,能源利用率与现在相比,或许能够更加高效。 本文转自d1net(转载)

优秀的个人博客,低调大师

烧脑还是性感?“区块链”吸金能力远超云计算

区块链(Blockchain),这一被中关村区块链产业联盟理事长单位、世纪互联创始人兼董事长陈升称作互联网TCP/IP底层协议的升级版、未来网络空间基础设施新高地的新技术,将对未来的信息基础架构产生何种重要的影响? 性感,改变未来世界的商业运作模式 区块链,很多人对这一新技术并不了解,而有些人却不屑一顾,将它与比特币划上了等号。区块链确实是比特币的重要支撑技术,而比特币也是区块链技术的一种应用,但区块链技术的应用远远不止比特币这一种形式,而是在金融、公共服务、智慧城市、物联网等多个领域扮演重要角色。 区块链是一串使用密码学方法相关联产生的数据块,它提供了多中心化的、无需信任积累的信用建立范式。在这种范式中,任何互不了解的人都可以通过加入一个公开透明的数据库,通过点对点的记账、数据传输、认证或合约,而不需要借助任何一个中间方来达成信用共识。如果要给区块链技术画像,那么“全网记账”、“去中心化”、“P2P网络”、“分布式结构”等就是必不可少的几个标签。 区块链技术降低了全球信用的建立成本。这种点对点验证将会产生一种基础协议。区块链是构建未来网络空间的核心关键技术,将在网络经济、共享经济中发挥重要作用,物联网、金融、智能设备、医疗、教学、档案、司法、版权甚至家庭娱乐,都将依赖于区块链技术的发展。如果说互联网TCP/IP协议让人们进入了信息自由传递的时代,那么区块链技术就将把人们带入信息的自由公证时代。 被喻为比特币之父的中本聪在其著作中首次提到了“区块链”这一概念。比特币目前确实存在很大争议,我国的金融机构被明令禁止开展比特币业务。如今,人们对支持比特币的基础支撑技术区块链有了更深入的研究。区块链技术实际上就是一种分布式的账本技术。它的出现让公共记账成为可能,而且可以更好地支持国际支付与清算,并将改变未来世界的商业运作模式。 统计数据显示,目前在国外有900多家银行和各类机构将区块链技术应用于13个业务应用领域;在中国,也有二三十家机构将区块链技术应用于7个业务应用领域。电子钱包、支付、公共服务、资讯类服务等都已经在尝试使用区块链技术。 就像上个世纪90年代互联网技术的兴起给人们带来的震撼和改变一样,区块链这种革命性的技术将再次给人们的生活、工作带来巨变。 Factom公司正在中国努力推动区块链技术的落地。近日,Factom与软通动力联合签署合作备忘录,双方致力于将区块链技术与智慧城市解决方案进行融合。Factom公司副总裁、Factom(中国)联合创始人王立仁用“性感”一词来形容区块链技术,因为从4年前开始应用和推广区块链技术,他就发现区块链不仅将带来技术的变革,更是一个潜力巨大的商机。 区块链这种分布式记账技术通过对信息的确权,将建立起人与人之间的信任,促进信息的流通与交易,更好地实现对风险的管控。美国银行曾因欺骗性的按揭文件事件被处罚170亿美元。区块链技术的出现会让以前这种因为信息不对称而发生的金融期诈得以避免。 联盟 托起“区块链”的明天 在国际上,区块链技术受到了广泛关注,尤其是金融领域。由初创公司R3领导的区块链联盟在短短几个月中就吸收了几十家国际知名的金融机构成员。该联盟的一项核心任务是进行区块链技术的概念验证和相关技术标准的制定。不过可惜的是,R3联盟中还没有一位来自中国的成员。据说,不是中国的银行不积极,而是R3联盟已经宣布不再接纳银行成员,而是转而重点吸纳大型企业会员。 在互联网技术刚刚兴起时,由于种种原因,中国的企业没能参与主要标准的制定,丧失了话语权。那么在以区块链技术为代表的新一波互联网技术浪潮袭来时,中国不能再掉队。这也是中关村区块链产业联盟成立的重要意义所在。 应对区块链的浪潮,有几点需要注意:第一,政府要重视,因为正确运用区块链技术,可以提升公共服务的可信度,有利于共享经济的实现,更好地服务于经济发展和民生;第二,产业界要加强对区块链技术的研究,区块链是多种技术的融合,需要云计算、安全、法律,以及金融、能源、交通、医疗等行业跨技术和应用领域的联合、互动;第三,治理先行,现在已经有人将比特币用于洗黑钱,如果监管不利,有可能导致区块链被用于非法活动;第四,注重联盟,产、学、研、用等各界力量必须联合起来,共同推动区块链技术的发展和应用。 北京市东权律师事务所总经理、北京东方亿思知识产权代理有限责任公司总经理李晓冬博士也赞同以联盟的方式推动区块链产业的发展。他表示:“从技术、资金、市场推广等方面来看,一个单位或组织很难催熟区块链应用,而区块链本身所具有的去中心化、民主、自治的特征也更适合以联盟的方式进行推广。中关村区块链产业联盟是一个开放的平台,它可以让成员单位充分施展自己的才能,共同推动区块链技术标准的制定,促进产业链的发展,让所有成员受益。” 中关村区块链产业联盟虽然是一个非盈利的组织,但是推动区块链产业的发展却可以让相关参与者、推广者受益,而获益的其中一种方式就是知识产权。与国内各种各样的联盟相比,中关村区块链产业联盟的特色是推动区块链产业标准的制定,实现资源共享,通过建立专利池、版权池,反哺联盟,同时也可让联盟成员通过出售专利许可而获得收益。“推动区块链技术的发展,既需要情怀,也要重视经济利益。建立相关技术标准就和知识产权直接相关。”李晓冬表示,“中关村区块链产业联盟将参考现有的国际标准,由旗下的工作组负责具体的中国标准的制定。” 人们现在都在热烈谈论“互联网+”,让互联网与行业应用发生化学反应。其实,区块链也非常需要这个“+”。区块链可以加数字货币、金融、结算、物联网、不动产登记甚至婚姻登记。除了这些具体的应用以外,区块链更重要的是加革新的意识、新的生态系统、相关标准等。 中关村管委会郭洪主任表示:“中关村是中国的互联网发祥地、网络经济引擎和全球的互联网创新中心,也是网络强国建设的关键支撑载体。希望中关村区块链产业联盟放眼全球,抢占制高点,标准先行,创新应用,聚合区块链领域人才和资源,培育一批具有国际竞争力的区块链企业。” 云优先 区块链优先 中关村区块链产业联盟聚焦区块链技术的标准化和产业化,旨在推动未来网络空间基础设施产业快速发展,提高我国在区块链技术领域的研究、开发和应用水平,通过创新促进经济增长,为在万物互联时代下的新一轮国际竞争中抢占标准专利的制高点和话语权提供有力保障。 陈升表示:“区块链技术用共识机制确保信息真实,将推动共享经济的普及,形成与资产联接的全球开放信用体系,助力未来信息基础设施的投资、建设和运营。联盟将整合行业资源,构建核心与关健基础设施,打造面向未来的生态系统。” 区块链技术将给未来的IT基础设施建设带来哪些深远影响呢? 从最早的通信网络发展到信息网络,再到今天的价值网络,底层技术协议的改变至关重要。今天,我们在金融、支付、结算、物联网、公共服务等领域看到的因区块链技术带来的变化只是“冰山一角”。“为了提供中立、安全、公共化、服务化的基础设施,我们需要像区块链这样的新技术。”陈升表示。 作为一家IDC服务商,提供安全、可靠、高效、整体拥有成本最优的数据中心基础设施是世纪互联的主业。世纪互联集团公司创新研究院将致力于区块链技术的研发。在国内,微软与世纪互联在云数据中心的建设和云服务的提供方面有全面而深入的合作。微软在Azure云平台上已经开始提供“区块链即服务”(Blockchain as a Service)。下一步,微软计划将这一服务引入中国,而合作伙伴还是选择世纪互联。这也是“云优先、区块链优先”的具体体现。 “互联网虽然解决了安全、低成本的信息传递问题,但是没有解决价值有效传递这一问题。因此,区块链应运而生,它不是替代现有的互联网,而是在其上增加了‘有价值’的一层。”点亮投资管理(上海)有限公司合伙人郭峰介绍说,“就像网络分不同的层面,区块链也分成三个层面:最底层是基于TCP/IP的P2P网络;中间层包括密码学算法和分布式共识算法,以及平台的路由,这一层也是实现互联网价值传递的基础;最上层是各种应用。” 区块链是多种技术的组合,涉及不同的架构、场景,而且变化非常快,它更需要可靠、廉价、易扩展的基础设施。未来,很多终端和应用都可以由区块链来支撑,比如智能手环、手机等。 华旗银行与日本的野村证券做过一项研究:使用区块链技术的银行可以将运营成本降低到原来的十分之一甚至更低。“区块链技术的应用可以极大地节省社会资源。”郭峰表示,“在国外,针对区块链技术公司的投资热度远远超过了云计算。“ 记者获悉,近日,美国一家金融科技公司Ripple的高管到访中国。这家成立于2012年的公司基于区块链技术提供跨境支付服务,此次来华也是想在中国寻找落地其服务的机会。另外,像IBM这样的IT巨头也表示出对区块链技术的浓厚兴趣。 本文转自d1net(转载)

优秀的个人博客,低调大师

手敲,Ascend算子开发入门笔记分享

本文分享自华为云社区《Ascend算子开发入门笔记》,作者: JeffDing 。 基础概念 什么是Ascend C Ascend C是CANN针对算子开发场景推出的编程语言,原生支持C和C++标准规范,最大化匹配用户开发习惯;通过多层接口抽象、自动并行计算、孪生调试等关键技术,极大提高算子开发效率,助力AI开发者低成本完成算子开发和模型调优部署。 使用Ascend C开发自定义算子的优势 C/C++原语编程,最大化匹配用户的开发习惯 编程模型屏蔽硬件差异,编程范式提高开发效率 多层级API封装,从简单到灵活,兼顾易用与高效 孪生调试,CPU侧模拟NPU侧的行为,可优化在CPU侧调试 昇腾计算架构CANN CANN 介绍网站:https://www.hiascend.com/software/cann AI Core是NPU卡的计算核心,NPU内部有多个AI Core。每个AI Core相当于多核CPU中的一个核心 SIMD SIMD,也就是单指令多数据计算,一条指令可以处理多个数据:Ascend C编程API主要是向量计算API和矩阵运算API,计算API都是SIMD样式 并行计算之SPMD数据并行与流线型并行 SPMD数据并行原理 启动一组进程,他们运行的相同程序 把待处理数据切分,把切分后数据分片分发给不同进程处理 每个进程对自己的数据分片进行3个任务T1、T2、T3的处理 流水线并行原理 启动一组进程 对数据进行切分 每个进程都处理所有的数据切片,对输入数据分片只做一个任务的处理 Ascend C编程模型与范式 并行计算架构抽象 使用Ascend C编程语言开发的算子运行在AI Core上,AI Core是昇腾AI处理器中的计算核心 一个AI处理器内部有多个AI Core,AI Core中包含计算单元、存储单元、搬运单元等核心组件 计算单元包括了三种基础计算资源 Scalar计算单元:执行地址计算、循环控制等标量计算工作,并把向量计算、矩阵计算、数据半圆、同步指令发射给对应单元执行 Cube计算单元:负责执行矩阵运算 Vector计算单元:负责执行向量计算 搬运单元负责在Global Memory和Local Memory之间搬运数据,包含搬运单元MTE(Memory Transfer Engine,数据搬入单元),MTE3(数据搬出单元) 存储单元为AI Core的内部存储,统称为Local Memory与此相对应,AI Core的外部存储称之为Global Memory 异步指令流 Scalar计算单元读取指令序列,并把向量计算、矩阵计算、数据搬运指令发射给对应单元的指令队列,向量计算单元、矩阵计算单元、数据搬运单元异步的并行执行接收到的指令 同步信号流 指令间可能存在依赖关系,为了保证不同指令队列间的指令按照正确的逻辑关系执行,Scalar计算单元也会给对应单元下发同步指令 计算数据流 DMA搬入单元把数据搬运到Local Memory,Vector/Cube计算单元完成数据计算,并把计算结构写回Local Memory,DMA搬出单元把处理好的数据搬运回Global Memory SPMD编程模型介绍 Ascend C算子编程是SPMD的编程,将需要处理的数据拆分并行分布在多个计算核心上运行多个AI Core共享相同的指令代码,每个核上的运行实例唯一的区别是block_idx不同block的类似于进程,block_idx就是标识进程唯一性的进程ID,编程中使用函数GetBlockIdx()获取ID 核函数编写及调用 核函数(Kernel Function)是Acend C算子设备侧的入口。Ascend C允许用户使用核函数这种C/C++函数的语法扩展来管理设备侧的运行代码,用户在核函数中实现算子逻辑的编写,例如自定义算子类及其成员函数以实现该算子的所有功能。核函数是主机侧和设备侧连接的桥梁 核函数是直接在设备侧执行的代码。在核函数中,需要为在一个核上执行的代码规定要进行的数据访问和计算操作,SPMD编程模型允许核函数调用时,多个核并行地执行同一个计算任务。 使用函数类型限定符 除了需要按照C/C++函数声明的方式定义核函数之外,还要为核函数加上额外的函数类型限定符,包含__global__和__aicore__ 使用__global__函数类型限定符来标识它是一个核函数,可以被<<<…>>>调用;使用__aicore__函数类型限定符来标识该函数在设备侧AI Core上执行 __gloabl__ __aircore__ void kernel_name(argument list); 使用变量类型限定符 为了方便:指针入参变量统一的类型定义为__gm__uint8_t* 用户可统一使用uint8_t类型的指针,并在使用时转化为实际的指针类型;亦可直接传入实际的指针类型 规则或建议 核函数必须具有void返回类型 仅支持入参为指针类型或C/C++内置数据类型(Primitive Data Types),如:half* s0、flat* s1、int32_t c 提供了一个封装的宏GM_ADDR来避免过长的函数入参列表 #define GM_ADDR __gm__ unit8_t* __restrict__ 调用核函数 核函数的调用语句是C/C++函数调用语句的一种扩展 常见的C/C++函数调用方式是如下的形式: function_name(argument list); 核函数使用内部调用符<<<…>>>这种语法形式,来规定核函数的执行配置: kernel_name<<<blockDim, l2ctrl, stream>>>(argument list); 注:内核调用符仅可在NPU模式下编译时调用,CPU模式下编译无法识别该符号 blocakdim,规定了核函数将会在几个核上执行,每个执行该核函数的核会被分配一个逻辑ID,表现为内置变量block_idx,编号从0开始,可为不同的逻辑核定义不同的行为,可以在算子实现中使用GetBlockIDX()函数来获得。 l2ctl,保留函数,展示设置为固定值nullptr。 stream:类型为aclrtStream,stream是一个任务队列,应用程序通过stream来管理任务的并行 使用内核调用符<<<…>>>调用核函数: HelloWorld<<<8, nullptr, stream>>>(fooDevice)); blockDim设置为8,表示在8个核上调用了HelloWorld核函数,每个核都会独立且并行地执行该核函数Stream可以通过aclrtCreateStream来创建,它的作用是在当前进程或线程中显式创建一个aclrtStream argument list设置为cooDevice这1个入参。 核函数的调用是异步的,核函数的调用结束后,控制权立刻返回给主机侧。 强制主机侧程序等待所有核函数执行完毕的API(阻塞应用程序运行,直到指定Stream中的所有任务都完成,同步接口)为aclrtSynchronizeStream aclError aclrtSynchronizeStream(aclrtStream stream); 编程API介绍 Ascend C算子采用标准C++语法和一组类库API进行编程 计算类API:标量计算API、向量计算API、矩阵计算API、分别实现调用Scalar计算单元、Vector计算单元、Cube计算单元 数据搬运API:基于Local Memory数据进行计算、数据需要先从Gloabl Memory搬运至Local Memory,再使用计算接口完成计算,最后从Local Memory搬出至Gloabl Memory。比如DataCopy接口 内存管理API:用于分配管理内存,比如AllocTensor、FreeTensor接口 任务同步API:完成任务间的通信和同步,比如EnQue、DeQue接口。不同的指令异步并行执行,为了保证不同指令队列间的指令按照正确的逻辑关系执行,需要向不同的组件发送同步指令 Ascend C API用于计算的基本数据类型都是Tensor:GlobalTensor和LocalTensor 4级API定义 4级API定义:API根据用户使用的场景分为4级 3级API,运算符重载,支持+, - ,* ,/ ,= ,| ,& ,^ ,> ,< ,>- ,<= 实现计算的简单表述,类似dst=src1+src2 2级连续计算API,类似Add(dst,src1,src2,count),针对源操作数的连续COUNT个数据进行计算连续写入目的操作数,解决一维tensor的连续count个数据的计算问题 1级slice计算API,解决多维数据中的切片计算问题(开发中) 0级丰富功能计算API,可以完整发挥硬件优势的计算API,该功能可以充分发挥CANN系列芯片的强大指令,支持对每个操作数的repeattimes,repetstride,MASK的操作。调用类似:Add(dst,src1,src2,repeatTimes,repeatParams); 流水编程范式介绍 Ascend C编程范式把算子内部的处理程序,分成多个流水任务(Stage),以张量(Tensor)为数据载体,以队列(Queue)进行任务之间的通信与同步,以内存管理模块(Pipe)管理任务间的通信内存。 快速开发编程的固定步骤 统一代码框架的开发捷径 使用者总结出的开发经验 面向特定场景的编程思想 定制化的方法论开发体验 抽象编程模型“TPIPE并行计算" 针对各代Davinci芯片的复杂数据流,根据实际计算需求,抽象出并行编程范式,简化流水并行 Ascend C的并行编程式范式核心要素 一组并行计算任务 通过队列实现任务之间的通信和同步 程序员自主表达对并行计算任务和资源的调度 典型的计算范式 基本的矢量编程范式:计算任务分为CopyIn,Compute,CopyOut 基本的矩阵编程范式:计算任务分为CopyIn,Compute,Aggregate,CopyOut 复杂的矢量/矩阵编程范式,通过将矢量/矩阵的Out/ln组合在一起的方式来实现复杂计算数据流 流水任务 流水任务(Stage)指的是单核处理程序中主程序调度的并行任务。 在核函数内部,可以通过流水任务实现数据的并行处理来提升性能 举例来说,单核处理程序的功能可以拆分为3个流水任务:Stage1、Stage2、Stage3,每个任务专注数据切片的处理。Stage间的剪头表达数据间的依赖,比如Stage1处理完Progress1之后,Stage2才能对Proress1进行处理。 若Progres的n=3,待处理的数据被切分成3片,对于同一片数据,Stage1、Stage2、Stage3之间的处理具有依赖关系,需要串行处理;不同的数据切片,同一时间点,可以有多个流水任务Stage在并行处理,由此达到任务并行、提升性能的目的 任务间通信和同步 数据通信与同步的管理者 Ascend C中使用Queue队列完成任务之间的数据通信和同步,Queue提供了EnQue、DeQue等基础API。 Queue队列管理NPU上不同层级的物理内存时,用一种抽象的逻辑位置(QuePosition)来表达各个级别的存储(Storage Scope),代替了片上物理存储的概念,开发者无需感知硬件架构。 矢量编程中Queue类型(逻辑位置)包括:VECIN、VECOUT 数据的载体 Ascend C使用GlobalTensor和LocalTensor作为数据的基本操作单元,它是各种指令API直接调用的对象,也是数据的载体 矢量编程任务间通信和任务 矢量编程中的逻辑位置(QuePosition):搬入数据的存放位置:VECIN、搬出数据的存放位置:VECOUT。 矢量编程主要分为CopyIn、Compute、CopyOut三个任务 CopyIn任务中将输入数据从GlobalTensor搬运至LocalTensor后,需要使用EnQue将LocalTensor放入VECIN的Queue中 Compute任务等待VECIN的Queue中LocalTensor出队之后才可以进行矢量计算,计算完成后使用EnQue将计算结果LocalTensor放入VECOUT的Queue中 CopyOut任务等待VECOUT的Queue中Localtensor出队,再将其拷贝至GlobalTensor Stage1:CopyIn任务 使用DataCopy接口将GlobalTensor拷贝纸LocalTensor 使用EnQue将LocalTensor放入VECIN的Queue中 Stage2:Compute任务 使用DeQue从VECIN中取出LocalTensor 使用Ascend C指令API完成矢量计算:Add 使用EnQue将结果LocalTensor放入VECOUT的Queue中 Stage3:CopyOut任务 使用DeQue接口从VECOUT的Queue中取出LocalTensor 使用DataCopy接口将LocalTensor拷贝至GlobalTensor 内存管理 任务见数据传递使用到的内存统一由内存管理模块Pipe进行管理。 Pipe作为片上内存管理者,通过InitBuffer接口对外提供Queue内存初始化功能,开发者可以通过该接口为指定的Queue分配内存。 Queue队列内存初始化完成后,需要使用内存时,通过调用AllocTensor来为LocalTensor分配内存给Tensor,当创建的LocalTensor完成相关计算无需再使用时,再调用FreeTensor来回收LocalTensor的内存 临时变量内存管理 编程过程中使用到的临时变量内存同样通过Pipe进行管理。临时变量可以使用TBuf数据结构来申请指定QuePosition上的存储空间,并使用Get()来将分配到的存储空间分配给新的LocalTensor从TBuf上获取全部长度,或者获取指定长度的LocalTensor LocalTensor<T> Get<T>(); LocalTensor<T> Get<T>(uint32_t len); Tbuf及Get接口的示例 //为TBuf初始化分配内存,分配内存长度为1024字节 TPipe pipe; TBuf<TPosition::VECIN> calcBuf; //模板参数为QuePosition中的VECIN类型 uint32_t byteLen = 1024; pipe.InitBuffer(calcBuf,byteLen); //从calcBuf获取Tensor,Tensor为pipe分配的所有内存大小,为1024字节 LocalTensor<int32_t> tempTensor1 = calcBuf.Get<int32_t>(); //从calcBuf获取Tensor,Tensor为128个int32_t类型元素的内存大小,为512字节 LocalTensro<int32_t> tempTensor1 = calcBuf.Get<int32_t>(128); 使用TBuf申请的内存空间只能参与计算,无法执行Queue队列的入队出队操作 Ascend C矢量编程 算子分析 开发流程 算子分析:分析算子的数学表达式、输入、输出以及计算逻辑的实现,明确需要调用的Ascend接口 核函数定义:定义Ascend算子入口函数 根据矢量编程范式实现算子类:完成核函数的内部实现 以ElemWise(ADD)算子为,数学公式 为简单起见,设定张量x,y,z为固定shape(8,2048),数据类型dtype为half类型,数据排布类型format为ND,核函数名称为add_custom 算子分析 明确算子的数学表达式及计算逻辑 Add算子的数学表达式为 计算逻辑:输入数据需要先搬入到片上存储,然后使用计算接口完成两个加法运算,得到最终结果,再搬出到外部存储 明确输入输出 Add算子有两个: 输入数据类型为half,输出数据类型与输入数据类型相同。输入支持固定shape(8,2048),输出shape与输入shape相同,输入数据排布类型为ND 确定核函数名称和参数 自定义核函数明,如add_custom,根据输入输出,确定核函数有3个入参x,y,z x,y为输入在GlobalMemory上的内存地址,z为输出在globalMemory上的内存地址 确定算子实现所需接口 涉及内外部存储间的数据搬运,使用数据搬移接口:DataCopy实现 涉及矢量计算的加法操作,使用矢量双目指令:Add实现 使用到LocalTensor,使用Queue队列管理,会使用到Enque,Deque等接口。 算子实现 核函数定义 在add_custom核函数的实现中示例化KernelAdd算子类,调用Init()函数完成内存初始化,调用Process()函数完成核心逻辑。 注:算子类和成员函数名无特殊要求,开发者可根据自身的C/C++编码习惯,决定核函数中的具体实现。 // implementation of kenel function extern "C" __global__ __aicore__ void add_custom(__gm__ uint8_t* x, __gm__ uint8_t* y, __gm__ uint8_t* z) { kernelAdd op; op.Init(x,y,z); op.Process(); } 对于核函数的调用,使用内置宏__CCE_KT_TEST__来标识<<<…>>>仅在NPU模式下才会编译到(CPU模式g++没有<<<…>>>的表达),对核函数的调用进行封装,可以在封装函数中补充其他逻辑,这里仅展示对于核函数的调用。 #ifndef __CCE_KT_TEST__ // call of kernel function void add_custom_do(uint32_t blockDim, void* l2ctrl, void* stream, uint8_t* x, uint8_t* y, uint8_t* z) { add_custom<<<blockDim, l2ctrl, stream>>>(x,y,z); } 算子类实现 CopyIn任务:将Global Memory上的输入Tensor xGm和yGm搬运至Local Memory,分别存储在xlocal,ylocal。 Compute任务:对xLocal,yLocal执行加法操作,计算结果存储在zlocal中。 CopyOut任务:将输出数据从zlocal搬运至Global Memory上的输出tensor zGm中。 CopyIn.Compute任务间通过VECIN队列和inQueueX,inQueueY进行通信和同步。 Compute,CopyOut任务间通过VECOUT和outQueueZ进行通信和同步。 pipe内存管理对象对任务间交互使用到的内存、临时变量是用到的内存进行统一管理。 向量加法z=x+y 代码样例 TPIPE流水式编程范式 算子类实现 算子类类名: KernelAdd 初始化函数Init()和核心处理函数Process() 三个流水任务:CopyIn(),Compute(),CopyOut() Process的含义 TQue模板的BUFFER)NUM的含义: 该Queue的深度,double buffer优化技巧 class KernelAdd{ public: __aicore__ inline KernelAdd() //初始化函数,完成内存初始化相关操作 __aicore__ inline voide Init(__gm__ uint8_t* x, __gm__ uint8_t* y, __gm__ uint8_t* z){} // 核心处理函数,实现算子逻辑,调用私有成员函数CopyIn,Compute,CopyOut完成算子逻辑 __aicore__ inline void Process(){} private: // 搬入函数,完成CopyIn阶段的处理,被Process函数调用 __aicore__ inline void CopyIn(int32_t process){} // 计算函数,完成Compute阶段的处理,被Process函数调用 __aicore__ inline void Compute(int32_t process){} // 搬出函数,完成CopyOut阶段的处理,被Process函数调用 __aicore__ inline void CopyOut(int32_t process){} private: // pipe内存管理对象 TPipe pipe; // 输入数据Queue队列管理对象,QuePosition为VECIN TQue<QuePosition::VECIN, BUFFER_NUM> inQueueX, inQueueY; // 输出数据Queue队列管理对象,QuePosition为VECOUT TQue<QuePosition::VECOUT, BUFFER_NUM> outQueueZ; // 管理输入输出的Global Memory内存地址的对象,其中xGm,yGm为输入,zGm为输出 GlobalTensor<half> xGm, yGm ,zGm; }; Init()函数实现 使用多核并行计算,需要将数据切片,获取到每个核实际需要处理的在Global Memory上的内存偏移地址。 数据整体长度TOTAL_LENGTH为8 * 2048,平均分配到8个核上运行,每个核上处理的数据大小BLOCK_LENGTH为2048,block_idx为核的逻辑ID,(gmhalf*)x + GetBlockIdx() * BLOCK_LENGTH即索引为block_idx的核的输入数据在Global Memory上的内存偏移地址 对于单核处理数据,可以进行数据切块(Tiling),将数据切分成8快,切分后的每个数据块再次切分成BUFFER_NUM=2块,可开启double buffer,实现流水线之间的并行。 单核需要处理的2048个数据切分成16块,每块TILE_LENGTH=128个数据,Pipe为inQueueX分配了BUFFER_NUM块大小为TITLE_LENGTH * sizeof(half)个字节的内存块,每个内存块能容纳TILE_LENGTH=128个half类型数据 代码示例 constexpr int32_t TOTAL_LENGTH = 8 * 2048; //total length of data constexpr int32_t USE_CORE_NUM = 8; //num of core used constexpr int32_t BLOCK_LENGTH = TOTAL_LENGTH / USE_CORE_NUM; //length computed of each ccore constexpr int32_t TILE_NUM = 8; //split data into 8 tiles constexpr int32_t BUFFER_NUM = 2; //tensor num for each queue constexpr int32_t TILE_LENGTH = BLOCK_LENGTH / TILE_NUM / BUFFER_NUM; //seperate to 2 parts, due to double buffer __aicore__ inline void Init(GM_ADDR x, GM_ADDR y, GM_ADDR z) { //get start index for current core,core parallel xGm,SetGlobalBuffer((__gm__ half*)x * BLOCK_LENGTH * GetBlockIdx(), BLOCK_LENGTH); yGm,SetGlobalBuffer((__gm__ half*)y * BLOCK_LENGTH * GetBlockIdx(), BLOCK_LENGTH); zGm,SetGlobalBuffer((__gm__ half*)z * BLOCK_LENGTH * GetBlockIdx(), BLOCK_LENGTH); //pipe alloc memory to queue,the unit is Bytes pipe.InitBuffer(inQueueX, BUFFER_NUM, TILE_LENGTH * sizeof(half)); pipe.InitBuffer(inQueueY, BUFFER_NUM, TILE_LENGTH * sizeof(half)); pipe.InitBuffer(outQueueZ, BUFFER_NUM, TILE_LENGTH * sizeof(half)); } Process()函数实现 代码示例 __aicore__ inline void Process() { // loop count need to be doubled, due to double buffer constexpr int32_t loopCount = TILE_NUM * BUFFER_BUM; // tiling strategy, pipeline prallel for (int32_t i = 0; i < loopCount; i++) { CopyIn(i); Compute(i); CopyOut(i); } } __aicore__ inline void CopyIn(int32_t progress) { // alloc tensor from queue memory LocalTensor<half> xLocal = inQueueX.AllocTensor<half>(); LocalTensor<half> yLocal = inQueueY.AllocTensor<half>(); // copy progress_th tile from global tensor to local tensor DataCopy(xLocal,xGm[progress * TILE_LENGTH], TILE_LENGTH); DataCopy(xLocal,yGm[progress * TILE_LENGTH], TILE_LENGTH); // enque input tensors to VECIN queue inQueueX.EnQue(xLocal); inQueueY.EnQue(yLocal); } __aicore__ inline void Compute(int32_t progress) { //dque input tensors from VECIN queue LocalTensor<half> xLocal = inQueueX.DeQue<half>(); LocalTensor<half> yLocal = inQueueY.DeQue<half>(); LocalTensor<half> zLocal = outQueueZ.AllocTensor<half>(); // call Add instr for computation Add(zLocal, xLocal, yLocal, TILE_LENGTH); // enque the output tensor to VECOUT queue outQueueZ.EnQue<half>(zLocal)l // free input tensors for reuse inQueueX.FreeTensor(xLocal); inQueueY.FreeTensor(yLocal); } __aicore__ inline void CopyOut(int32_t progress) { //deque output tensor form VECOUT queue LocalTensor<half> zLocal = outQueueZ.Deque<half>(); // copy progress_th tile form local tensor to global tensor DataCopy(zGm[progress * TILE_LENGTH), zlocal, TILE_LENGTH); // free outpupt tensor for reuse outQueueZ.freeTensor(zLocal); } double buffer机制 double buffer通过将数据搬运与矢量计算并执行以隐藏数据搬运时间并降低矢量指令的等待时间,最终提高矢量计算单元的利用效率1个Tensor同一时间只能进行搬入、计算和搬出三个流水任务中的一个,其他两个流水任务涉及的硬件但愿则处于Idle状态。 如果将待处理的数据一分为而,比如Tensor1、Tensor2。 当矢量计算单元对于Tensor1进行Compute时,Tensor2可以进行CopyIn的任务 当矢量计算单元对于Tensor2进行Compute时,Tensor1可以进行CopyOut的任务 当矢量计算单元对于Tensor2进行CopyOut时,Tensor2可以进行CopyIn的任务 由此,数据的进出搬运和矢量计算之间实现你并行,硬件单元闲置问题得以有效缓解 Ascend C 算子调用 HelloWorld样例 运行CPU模式包含的头文件 运行NPU模式包含的头文件 核函数的定义 内置宏__CE_KT_TEST__:区分运行CPU模式或NPU模式逻辑的标志 主机侧执行逻辑:负责数据在主机侧内存的申请,主机到设备的拷贝,核函数执行同步和回收资源的工作 设备侧执行逻辑 主机侧执行CPU模式逻辑:使用封装的执行宏ICPU_RUN_KF 主要包括: gMAlloc(…):申请CPU模式下的内存空间 ICPU_RUN_KF:使用封装的执行宏 GmFree:释放CPU模式下的内存空间 流程 AscendCL初始化—>运行管理资源申请—>Host数据传输至Device—>执行任务并等待—>Device数据传输至Host—>运行资源释放—>AscendCL去初始化 主机侧执行NPU模式逻辑:使用内核调用符<<<…>>>重要接口 aclInit aclCreateStream aclMallocHost aclMalloc aclMemcpy <<<…>>> aclrtSynchronizeStream aclrtFree aclrtfreeHost aclrtDestoryStream aclFinalize AddCustom样例 Ascend C矢量算子样例代码 核函数源文件:add_custom.app 真值数据生成脚本:add_custom.py CmakeLists.txt:方便对多个源文件进行编译 读写数据文件辅助函数:data_utils.h 主机侧源文件:main.cpp 一键执行脚本:run.sh 组织CPU模式和NPU模式下编译的cmake脚本 点击关注,第一时间了解华为云新鲜技术~


优秀的个人博客,低调大师

手撕源码!线程池核心组件源码剖析

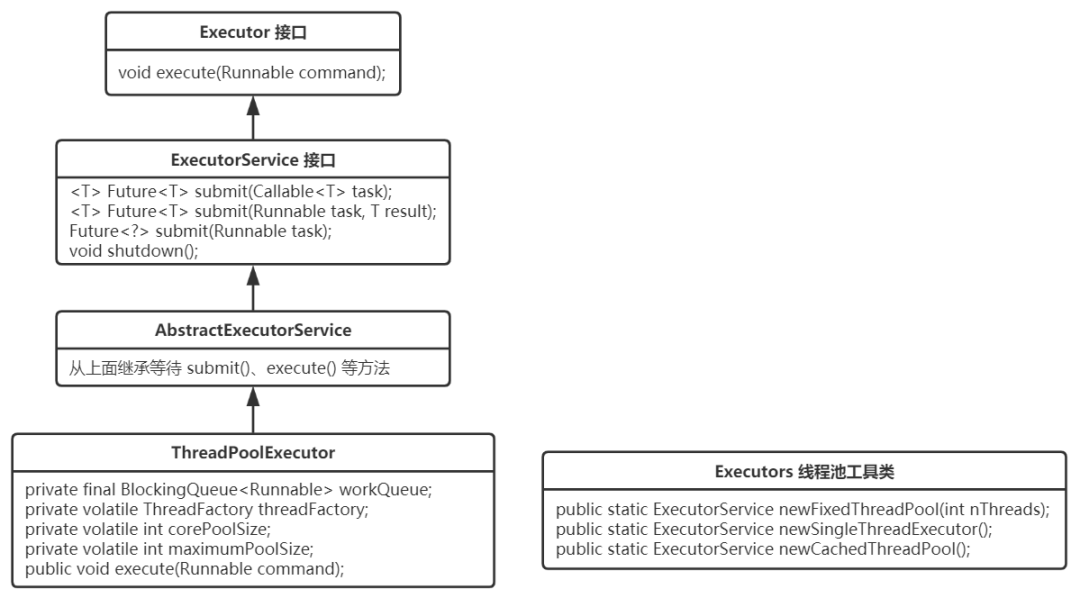
本文选自 Doocs 开源社区旗下“源码猎人”项目,作者 AmyliaY。项目将会持续更新,欢迎 Star 关注。项目地址:https://github.com/doocs/source-code-hunter 线程池核心组件图解 看源码之前,先了解一下该组件 最主要的几个 接口、抽象类和实现类的结构关系。 该组件中,Executor 和 ExecutorService 接口 定义了线程池最核心的几个方法,提交任务 submit ()、关闭线程池 shutdown()。抽象类 AbstractExecutorService 主要对公共行为 submit()系列方法进行了实现,这些 submit()方法 的实现使用了 模板方法模式,其中调用的 execute()方法 是未实现的 来自 Executor 接口 的方法。实现类 ThreadPoolExecutor 则对线程池进行了具体而复杂的实现。 另外还有一个常见的工具类 Executors,里面为开发者封装了一些可以直接拿来用的线程池。 源码赏析 话不多说,直接上源码。(这里只看最主要的代码部分) Executor 和 ExecutorService 接口 public interface Executor { /** * 在将来的某个时间执行给定的 Runnable。该 Runnable 可以在新线程、池线程或调用线程中执行。 */ void execute(Runnable command);}public interface ExecutorService extends Executor { /** * 优雅关闭,该关闭会继续执行完以前提交的任务,但不再接受新任务。 */ void shutdown(); /** * 提交一个有返回值的任务,并返回该任务的 未来执行完成后的结果。 * Future的 get()方法 将在成功完成后返回任务的结果。 */ <T> Future<T> submit(Callable<T> task); <T> Future<T> submit(Runnable task, T result); Future<?> submit(Runnable task);} AbstractExecutorService 抽象类 /** * 该抽象类最主要的内容就是,实现了 ExecutorService 中的 submit()系列方法 */public abstract class AbstractExecutorService implements ExecutorService { /** * 提交任务 进行执行,返回获取未来结果的 Future对象。 * 这里使用了 “模板方法模式”,execute()方法来自 Executor接口,该抽象类中并未进行实现, * 而是交由子类具体实现。 */ public Future<?> submit(Runnable task) { if (task == null) throw new NullPointerException(); RunnableFuture<Void> ftask = newTaskFor(task, null); execute(ftask); return ftask; } public <T> Future<T> submit(Runnable task, T result) { if (task == null) throw new NullPointerException(); RunnableFuture<T> ftask = newTaskFor(task, result); execute(ftask); return ftask; } public <T> Future<T> submit(Callable<T> task) { if (task == null) throw new NullPointerException(); RunnableFuture<T> ftask = newTaskFor(task); execute(ftask); return ftask; }} ThreadPoolExecutor public class ThreadPoolExecutor extends AbstractExecutorService { /** * ************** * ** 主要属性 ** * ************** */ /** 阻塞队列 */ private final BlockingQueue<Runnable> workQueue; /** 用于创建线程的 线程工厂 */ private volatile ThreadFactory threadFactory; /** 核心线程数 */ private volatile int corePoolSize; /** 最大线程数 */ private volatile int maximumPoolSize; /** * ************** * ** 构造方法 ** * ************** */ /** 最后都使用了最后一个构造方法的实现 */ public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, Executors.defaultThreadFactory(), defaultHandler); } public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, threadFactory, defaultHandler); } public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, RejectedExecutionHandler handler) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, Executors.defaultThreadFactory(), handler); } public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) { if (corePoolSize < 0 || maximumPoolSize <= 0 || maximumPoolSize < corePoolSize || keepAliveTime < 0) throw new IllegalArgumentException(); if (workQueue == null || threadFactory == null || handler == null) throw new NullPointerException(); this.corePoolSize = corePoolSize; this.maximumPoolSize = maximumPoolSize; this.workQueue = workQueue; this.keepAliveTime = unit.toNanos(keepAliveTime); this.threadFactory = threadFactory; this.handler = handler; } /** * ************** * ** 主要实现 ** * ************** */ /** 执行 Runnable任务 */ public void execute(Runnable command) { if (command == null) throw new NullPointerException(); /* * 分三步进行: * * 1、如果运行的线程少于 corePoolSize,尝试开启一个新的线程;否则尝试进入工作队列 * * 2. 如果工作队列没满,则进入工作队列;否则 判断是否超出最大线程数 * * 3. 如果未超出最大线程数,则尝试开启一个新的线程;否则 按饱和策略处理无法执行的任务 */ int c = ctl.get(); if (workerCountOf(c) < corePoolSize) { if (addWorker(command, true)) return; c = ctl.get(); } if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); if (! isRunning(recheck) && remove(command)) reject(command); else if (workerCountOf(recheck) == 0) addWorker(null, false); } else if (!addWorker(command, false)) reject(command); } /** * 优雅关闭,在其中执行以前提交的任务,但不接受新任务。如果已关闭,则调用没有其他效果。 */ public void shutdown() { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { checkShutdownAccess(); advanceRunState(SHUTDOWN); interruptIdleWorkers(); onShutdown(); // hook for ScheduledThreadPoolExecutor } finally { mainLock.unlock(); } tryTerminate(); }} ThreadPoolExecutor 中的 execute()方法 执行 Runnable 任务 的流程逻辑可以用下图表示。 工具类 Executors 看类名也知道,它最主要的作用就是提供 static 的工具方法,为开发者提供各种封装好的 具有各自特性的线程池。 public class Executors { /** * 创建一个固定线程数量的线程池 */ public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } /** * 创建一个单线程的线程池 */ public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); } /** * 创建一个缓存的,可动态伸缩的线程池。 * 可以看出来:核心线程数为0,最大线程数为Integer.MAX_VALUE,如果任务数在某一瞬间暴涨, * 这个线程池很可能会把 服务器撑爆。 * 另外需要注意的是,它们底层都是使用了 ThreadPoolExecutor,只不过帮我们配好了参数 */ public static ExecutorService newCachedThreadPool() { return new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS, new SynchronousQueue<Runnable>()); }} 全文完! 希望本文对大家有所帮助。如果感觉本文有帮助,有劳转发或点一下“在看”!让更多人收获知识! 长按识别下图二维码,关注公众号「Doocs 开源社区」,第一时间跟你们分享好玩、实用的技术文章与业内最新资讯。 本文分享自微信公众号 - Doocs开源社区(idoocs)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册