首页 文章 精选 留言 我的

精选列表

搜索[增量式],共10000篇文章
优秀的个人博客,低调大师

分布式缓存-redis集群部署

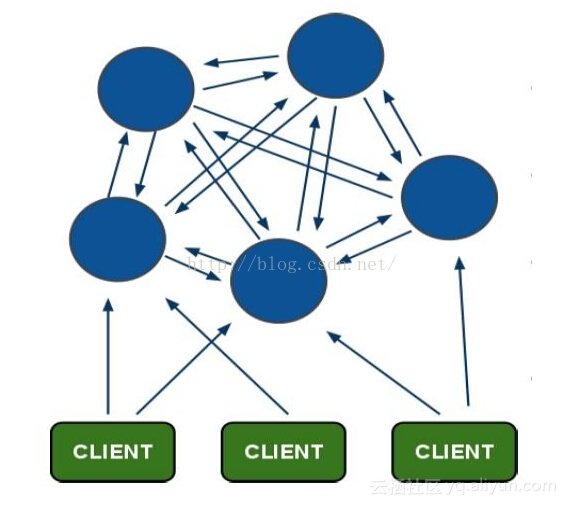
此篇文章只是了解一下redis部署架构方式,至于怎么搭建有兴趣自己研究 redis几个特点:1、redis支持5中数据类型,每种数据类型都有自己的数据结构2、redis提供两种数据持久化机制,RDB和AOF模式,RDB模式是定时用一个线程将数据保存成文件存储在硬盘中,优点是恢复数据块缺点是可能会丢失一整段时间内的数据。AOF机制是通过保存对数据的变更命令日志来实现数据持久化,可选择每次变更保存日志,也可以选择每秒内的日志保存。优点是数据完整性高,缺点是性能低。 redis cluster集群方案: 此种架构特点:1、若干节点组成一个集群,每个节点有主备多个实例,保证高可用性。整个集群将16384个插槽分别存储在不同的节点上,每个集群节点的数据均不一样,每个节点上的主备实例节点数据是一样的。2、Redis Cluster采用无中心架构,每个节点都保存数据和整个集群的节点状态,集群节点不会代理查询,Redis Cluster采用异步复制机制 ,master和slave在先写到master,然后master直接返回ok,然后再把变更异步传播更新到slave里去。3、应该是不支持不同slot的批量操作的,同一个slot的批量操作应该是没问题的。 实际部署架构: 代理层可做批量操作、支持更高的并发、高可用性。 redis集群架构参考redis集群知识

优秀的个人博客,低调大师

python函数式编程之迭代器

什么是迭代器 顾名思义,就是更新换代的意思 python中的迭代器就是根据上一个结果生成下一个结果,一直循环往复不断重复的过程 迭代器有两个特点: 1.不断重复同一个过程 2.根据上一个结果生成下一个结果 迭代器的定义 先来看两个例子 代码一: while True: cmd = input("input your command: ").strip() print(cmd) 代码二: l1 = ["a", "b", "c", "d"] count = 0 while count < len(l1): print(l1[count]) count += 1 在代码一中,让用户不断输入命令,然后打印用户输入的命令,这是一个不断重复的过程,但是后一个结果跟前一个结果没有什么联系,所以代码一不是迭代器 在代码二中,先定义一个列表l1和count,在count的值小于列表l1的长度中,打印列表中count索引的值,然后count的值加1,这几行代码符合迭代器的定义 代码二的执行过程: 首先,打印列表l1中count索引的值,这是一个不断重复的过程 然后,每循环一次,count的值就在以前的基础上增加1,直到count的值等于列表l1的长度时,循环中止 所以代码一不是迭代器,代码二才是符后迭代器的定义标准 迭代器的作用 python中常见的数据类型包括字符串,列表,元组,字典,集合,文件 我们知道,python中的数据类型又分为有序和无序 对于有序数据类型,可以如上面的代码二所示,使用索引遍历有序数据类型中的元素 而对于无序数据类型,就不可以使用索引来遍历其中的元素了,此时可以使用for循环来遍历其中的元素 现在来看看for循环到底做了哪些事,可以取出无序数据类型中的元素 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } for k in dic1: print(k) 执行上面的程序,可以打印出字典dic1中所有的键 实际上,python为了提供一种不依赖于索引的迭代方式,python会为一些对象内置__iter__方法 在python中,如果一个对象有__iter__方法,那么这个对象就是可迭代对象 执行obj.__iter__()方法得到的结果就是迭代器 所以python中的迭代器,都会有__iter__方法和__next__方法 以上面定义的dic1为例 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } i = dic1.__iter__() # dic1.__iter__方法执行结果得到一个迭代器i print(i) # 打印迭代器,得到结果:<dict_keyiterator object at 0x0000000002DBD278> print(i.__next__()) # 执行迭代器i中的__next__方法,得到dic1中的一个元素,然后打印迭代出的元素 print(i.__next__()) # 再次执行迭代器的__next__方法,得到dic1的第二个元素,然后打印出来 print(i.__next__()) # 第三次执行迭代器的__next__方法,得到dic1的第三个元素,然后打印出来 由于python的字典是无序的数据类型,所以每次得到的dic1中的元素可能是不相同的 执行三次__next__方法,得到的结果如下 a b c 上面dic1的长度为4,如果执行5次__next__方法,会出错什么结果 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } i = dic1.__iter__() print(i.__next__()) print(i.__next__()) print(i.__next__()) print(i.__next__()) print(i.__next__()) 程序执行结果 a File "D:\python3\lib\unittest\loader.py", line 153, in loadTestsFromName b module = __import__(module_name) c File "E:\python_learn\py_code\test.py", line 21, in <module> d print(i.__next__()) StopIteration 可以看到,python解释器在执行第五次__next__方法时,抛出了StopIteration的错误,这说明如果执行__next__方法的次数超出迭代器的长度时,python解释会抛出异常 迭代器的优缺点 迭代器的优点 1.提供一种不依赖于索引的取值方式 2.提供惰性计算,每执行一次__next__方法,只会从迭代器中取出一个值,不管这个数据长度有多大,使用迭代器取值时,每取出一个值,占用的内存空间都一个元素的大小,非常节省内存空间 迭代器的缺点 1.取值比较麻烦。如果想用迭代器的方式取出列表中的第三个值,必须调用三次__next__方法,才能取出第三个值,而前两次取出的值实际上是没有作用的 2.一次性的,只能向后迭代,不能回退。如果运行两次__next__方法后,就不可能回退再去了迭代器的第一个值 3.不能获取到迭代器的长度,只能不停执行__next__方法,直到出现StopIteration的提示,此时才能知道迭代器的长度 for循环的执行过程 定义一个列表,使用for循环遍历取出列表中的值 l1 = ['a', 'b', 'c', 'd'] for i in l1: print(i) 在for循环的执行过程中,实际上for循环是把in后面的对象执行__iter__方法,得到一个迭代器对象,然后不停执行迭代器对象中的__next__方法,得到元素,然后把迭代出来的元素赋值给i,再调用print方法打印元素i,直到for循环捕捉到StopIteration异常,结束循环,程序停止 类似于下面的代码 l1 = ['a', 'b', 'c', 'd'] obj = l1.__iter__() while True: try: i = obj.__next__() print(i) except StopIteration: break 判断一个对象是迭代器对象还是可迭代对象 只要一个对象有__iter__方法,这个对象就是可迭代对象 一个可迭代对象有__next__方法,这个对象就是迭代器对象 判断python中的字符串,列表,元组,字典和文件对象是否是可迭代对象和迭代器对象 示例代码 from collections import Iterable, Iterator s1 = "hello" l1 = ['a', 'b', 'c', 'd'] t1 = ('a', 'b', 'c', 'd') set1 = {'a', 'b', 'c', 'd'} dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } f1 = open("db.txt", "w", encoding="utf-8") print(isinstance(s1, Iterable)) print(isinstance(l1, Iterable)) print(isinstance(t1, Iterable)) print(isinstance(set1, Iterable)) print(isinstance(dic1, Iterable)) print(isinstance(f1, Iterable)) print("*" * 30) print(isinstance(s1, Iterator)) print(isinstance(l1, Iterator)) print(isinstance(t1, Iterator)) print(isinstance(set1, Iterator)) print(isinstance(dic1, Iterator)) print(isinstance(f1, Iterator)) 执行结果: True True True True True True ****************************** False False False False False True 从上面的例子,可以看出,字符串,列表,元组,集合,字典和文件都是可迭代对象,其中只有文件是迭代器对象 在上面,我们知道,使用for遍历对象中的值时,是把in后面的对象的变为可迭代对象,然后调用__next__方法取出对象中的元素 既然文件本身就是迭代器对象,那使用for循环获取文件的内容时,又是怎么做的呢 先打开一个文件,打印出这个文件对象,再调用文件对象的__iter__方法得到迭代器对象,判断两个对象是否是同一个对象 f1 = open("db.txt", encoding="utf-8") print(f1) obj = f1.__iter__() print(obj) print(obj is f1) 执行结果 <_io.TextIOWrapper name='db.txt' mode='r' encoding='utf-8'> <_io.TextIOWrapper name='db.txt' mode='r' encoding='utf-8'> True 得到结论: 如果一个对象可以被for循环迭代,则这个对象一定是可迭代对象 文件对象被执行__iter__方法,得到的结果仍然是一个迭代器对象
优秀的个人博客,低调大师

HAS-插件式Kerberos认证框架

HAS解决方案要点 Hadoop服务以及服务之间继续使用原先的Kerberos的认证机制; 在集群部署的时候可以把节点使用的Keytab放到可靠的节点上, 集群运行时,集群内的节点只有通过认证后才能正常使用。企图冒充的节点由于没有事先得到的密钥信息,无法与集群内部的节点通信, 从而防止了恶意的使用或篡改Hadoop集群的问题,确保了Hadoop集群的可靠安全; Hadoop的用户也可以继续使用熟悉的认证方式登录; HAS兼容MIT Kerberos协议,用户还是可以用password或Keytab这种方式进行认证; 在新的认证机制中可以定制实现自己插件与已经存在的认证系统结合; HAS中的新的认证机制采用plugin已有的认证系统,具有高可定制性; 基于新的认证机制安全管理人员不需同步用户账户信息到Kerberos的数据库; 没有用户账户信息的拷

优秀的个人博客,低调大师

zookeeper安装部署--分布式模式

本地模式,和伪分布模式,只适合测试 1:下载zookeeper(zookeeper-3.4.6.tar.gz) http://mirrors.cnnic.cn/apache/zookeeper/zookeeper-3.4.7/ 规划:5个节点(nimbus,slave1,slave2,slave3,slave4)参与选举为前三个节点,后面两个节点作为observer,不参与投票,只负责监控,读取数据 创建目录(xshell 执行一下命令,5个节点同时创建目录) mkdir -p /home/hadoop/app tar -zxvfzookeeper-3.4.6.tar.gz mvzookeeper-3.4.6zookeeper chown -R hadoop:hadoopzookeeper su hadoop cdzookeeper cd conf/ cp zoo_sample.cfg zoo.cfg vi zoo.cfg tickTime=2000(客户端与服务器之间维持心跳的时间间隔单位毫秒)每个多少时间发送一个心跳 initLimit=10(zookeeper接收客户端,zookeeper服务器集中连到leader服务器,不是用户客户端,次数超过多少,无应答,表示失败) syncLimit=5(leader与follower,发送消息,请求和应答时间长度) dataDir=/tmp/zookeeper(数据节点,日志文件)/home/hadoop/data/zookeeper/zkdata dataLogDir=/home/hadoop/data/zookeeper/zkdatalog clientPort=2181(客户端口) server.1=nimbus:2888:3888 server.2=slave1:2888:3888 server.3=slave2:2888:3888 server.4=slave3:2888:3888:observer server.5=slave4:2888:3888:observer (xshell 执行一下命令,5个节点同时创建目录) mkdir -p /home/hadoop/data/zookeeper/zkdata mkdir -p /home/hadoop/data/zookeeper/zkdatalog cd /home/hadoop/data/zookeeper/zkdata vi myid 1 wq slave1 下 cd zkdata vi myid 2 wq 其他节点类似创建myid 将配置好的zookeeper同步到其他节点上 scp -r zookeeper hadoop@slave1:/home/hadoop/app/ scp -r zookeeper hadoop@slave2:/home/hadoop/app/ scp -r zookeeper hadoop@slave3:/home/hadoop/app/ scp -r zookeeper hadoop@slave4:/home/hadoop/app/ slave3上改配置 vi zoo.cfg peerType=observer slave4上改配置 vi zoo.cfg peerType=observer 快捷命令方式 cd /home/hadoop/app/zookeeper 启动下 bin/zkServer.sh start 查看进程 jps bin/zkServer.sh status follower nimbus,slave1 leader slave2 observer slave3,slave4 测试-把slave2停止 bin/zkServer.sh stop slave1变成leader 把slave1停掉 bin/zkServer.sh stop nimbus下 bin/zkServer.sh status 集群不可用 slave3和slave4都不可用 本文转自 skinglzw 51CTO博客,原文链接:http://blog.51cto.com/skinglzw/1833305,如需转载请自行联系原作者

优秀的个人博客,低调大师

嵌入式流程解决方案

一.需求分析由于企业业务的独特性或者企业高层独特的管理思想,很多客户选择了自行开发业务系统的方式来实现独有的竞争力。这类信息系统通常经过了多年的开发,伴随着企业的发展一直在不断优化,与企业的业务非常匹配。然而,近几年流程管理思想和技术的不断兴起,这类系统由于规划时间早,对流程的支持非常弱,因此,很多客户期望通过集成第三方的流程管理产品,在业务系统尽量少调整的前提下,嵌入工作流,实现业务系统的工作流驱动。二.方案实现 以H3 BPM流程引擎为基础,企业自主开发的业务系统通过H3 BPM开放的Webservice接口、 API接口、功能控件等,将流程引擎集成到业务系统,实现业务系统的工作流驱动。 H3 BPM采用微软.net技术架构,如果客户业务系统同样采用.net,可在项目中直接引用H3 BPM的 程序集和控件集,把H3 BPM流 程引擎作为基础构建来使用,如下图: 这样,可以充分的运用H3 BPM进百个控件和所有的API函数,H3 BPM有近 600页的API库,可以完成几乎所有的流程操作,如下图: 旧系统如果不是.net系统,可以采用WebService的方式,H3 BPM给常用 接口封装了WebService接口,包括流程发起、任务提交、任务打回、任务转交、撤销流程等等。如下图: 三.方案价值 本文转自 lwl_BPM 51CTO博客,原文链接:http://blog.51cto.com/12438115/1913512,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop伪分布式2.4.1安装

一、准备: 1、修改主机名: vi /etc/sysconfig/network内容如下: NETWORKING=yes HOSTNAME=myHadoop 2、修改主机名和IP的映射关系,即hosts文件: vi /etc/hosts 192.168.127.150myHadoop 3、关闭防火墙: 3.1、查看防火墙状态 service iptables status 3.2、关闭防火墙 service iptables stop 3.3、查看防火墙开机启动状态 chkconfig iptables --list 3.4、关闭防火墙开机启动 chkconfig iptables off 4、重启Linux: reboot/shutdown -r now 二、安装JDK: 1、解压: tar -zxvf jdk-7u55-linux-i586.tar.gz -C /opt/tool 2、将java添加到环境变量中: sudo vi /etc/profile #在文件最后添加 export JAVA_HOME=/opt/tool/jdk-7u_65-i585 export PATH=$PATH:$JAVA_HOME/bin #刷新配置 source /etc/profile #验证:java -version java version "1.7.0_65" Java(TM) SE Runtime Environment (build 1.7.0_65-b17) Java HotSpot(TM) Client VM (build 24.65-b04, mixed mode) 三、安装hadoop2.4.1: 1、解压: tar -zxvf hadoop-2.4.1.tar.gz -C /opt/tool 2、将hadoop添加到环境变量中 sudovi /etc/profile #在文件最后添加 export HADOOP_HOME=/opt/tool/hadoop-2.4.1 export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin #刷新配置 source /etc/profile #验证:hadoop version Hadoop 2.4.1 Subversion http://svn.apache.org/repos/asf/hadoop/common -r 1604318 Compiled by jenkins on 2014-06-21T05:43Z Compiled with protoc 2.5.0 From source with checksum bb7ac0a3c73dc131f4844b873c74b630 This command was run using /opt/tool/hadoop-2.4.1/share/hadoop/common/hadoop-common-2.4.1.jar 3、配置hadoop: 3.1:hadoop-env.sh vim hadoop-env.sh #第27行 export JAVA_HOME=/opt/tool/jdk-7u_65-i585 3.2:core-site.xml <!-- 指定HADOOP所使用的文件系统URI,HDFS的老大(NameNode)的地址 --> <property> <name>fs.defaultFS</name> <value>hdfs://hadoopnode0:9000</value> </property> <!-- 指定hadoop运行时产生文件的存储目录 --> <property> <name>hadoop.tmp.dir</name> <value>/opt/tool/hadoop-2.4.1/tmp</value> </property> 3.3:hdfs-site.xml hdfs-default.xml (3) <!-- 指定HDFS副本的数量 --> <property> <name>dfs.replication</name> <value>1</value> </property> 3.4:mapred-site.xml (mv mapred-site.xml.template mapred-site.xml) mv mapred-site.xml.template mapred-site.xml vim mapred-site.xml <!-- 指定mr运行在yarn上 --> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> 3.5:yarn-site.xml <!-- 指定YARN的老大(ResourceManager)的地址 --> <property> <name>yarn.resourcemanager.hostname</name> <value>hadoopnode0</value> </property> <!-- reducer获取数据的方式 --> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> 3.6:格式化namenode (是对namenode进行初始化,只有在第一次安装时执行格式化,切记切记,否则数据丢失。) hdfs namenode -format (或者hadoop namenode -format) 3.7:启动hadoop: #先启动HDFS:start-dfs.sh,启动了一下进程: NameNode SecondaryNameNode DataNode #再启动YARN:start-yarn.sh,启动了一下进程: NodeManager ResourceManager 3.8:验证是否启动成功 使用jps命令验证 22303 NameNode 22216 Jps 27643 SecondaryNameNode 25566 NodeManager 25603 ResourceManager 27812 DataNode http://192.168.1.201:50070 (HDFS管理界面) http://192.168.1.201:8088 (MR管理界面) 4、NameNode: 是整个文件系统的管理节点。它维护着整个文件系统的文件目录树, 文件/目录的元数据信息和每个文件对应的数据库列表。接收用户的操作请求。 元数据信息保存在fsimage和edit中,fsimage保存的是合并后的元数据信息,而edit保存的是实时的元数据信息。 5、DataNode: 提供真实文件数据的存储服务。文件存储时,是以block为单位进行存储的。 文件块(block):最基本的存储单位。对于文件内容而言,一个文件的长度大小是size, 那么从文件的0偏移开始,按照固定的大小,顺序对文件进行划分并编号,划分好的每一个块 称为一个block。HDFS默认block大小为128MB,以一个256MB文件为例,可以分割为2个Block。 6、SecondaryNameNode : 用来合并fsimage和edit。 本文转自lzf0530377451CTO博客,原文链接:http://blog.51cto.com/8757576/1827475,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册