首页 文章 精选 留言 我的

精选列表

搜索[增量式],共10000篇文章
优秀的个人博客,低调大师

分布式Redis缓存串讲(一)

互联网应用的基石 现在流量稍微大些的网站,都会采取Redis。基于Redis的内存缓存特性,可以大幅度降低数据库的访问量,大大提升了网站的并发能力,充当数据库的削量先锋。既然Redis这么重要,我们从它的官方介绍来完整的了解下它的能力,知己知彼,才能更运用自如。 Redis官方介绍 Redis是一个开源(BSD协议),内存解构存储,可以用作数据库,缓存和消息代理。它支持诸如字符串(strings),哈希散列(hashs),列表(lists),集合(sets),带有范围查询的排序集(sorted sets with range queries),位图(bitmaps),超级日志(hyperloglogs )和带有半径查询的地理空间索引(geospatial indexes with radius queries),Redis具有内置复制( replication),Lua脚本(Lua scripting),LRU驱逐(LRU eviction),事务(transactions )和不同级别的磁盘持久性(different levels of on-disk persistence),并通过Redis Sentinel提供高可用性和通过Redis Cluster自动分区。 您可以 对这些类型运行原子操作,例如附加到字符串 ; 递增哈希值 ; 将元素推送到列表中 ; 计算集合交集, 并集和差异 ; 或者在排序集中获得排名最高的成员。 你可以对这些类型执行原子操作,像追加字符串;在哈希里递增值;推送一个元素到列表;计算集合交集, 并集和差异 ; 或者在排序集中获得排名最高的成员。为了实现其出色的性能,Redis使用 内存数据集。根据您的使用情况,您可以通过 每隔一段时间将数据集转储到磁盘或通过将每个命令附加到日志来保留它。如果您只需要功能丰富的网络内存缓存,则可以选择禁用持久性。 Redis还支持简单到设置的主从异步复制,具有非常快速的非阻塞第一次同步,自动重新连接以及在网络分割上的部分重新同步。 其他功能包括: 事务 发布/订阅 Lua脚本(例如:eval 调用redis的脚本) 设置Key的过期时间 LRU-Cahce(内存管理的一种页面置换算法,最近最少使用) 自动故障转移(通过Redis Sentinel实现) Redis是用ANSI C编写,官方建议使用Linux进行部署,Windows版本没有官方支持,但Microsoft开发并维护了Redis的Win-64端口。 Redis应用场景 数据表缓存 一般访问量较大的表,读取时可以先获取Redis缓存,获取不到再查询数据库,然后放入Redis。这是最常见的运用场景。 业务状态缓存 例如,多租户的系统,为了减小批量数据压力,可以利用redis实现同一时间内,只能由一个导入。导入完成,清空缓存。也可以限制十分钟内只能导入一次等。 还有例如首页数据放入缓存,两分钟更新一次。 原子性 利用Redis一些原子性命令Inc,decr,可以实现业务参数唯一执行的场景,如订单付款成功通知,为了防止业务线创建多条记录,可以对订单Id执行inc命令,判断是否为1,1代表只有一个执行,如果大于1,则返回结果,并调用decr。类似于信号量。 Redis应用风险 虽然Redis给我们提供了巨大的便利,但也要时刻保持对它的关注。要不然有些时候,会对你造成巨大的伤害。 缓存穿透 意思是指同一个key,数据库没有数据,巨大流量下,会不断的访问数据库。这是浪费的,可以针对一些场景,控制查询次数。如果获取不到值,在指定的时间内不再请求数据库。 缓存雪崩 同一时间内大量key同时失效,造成流量集体访问数据库,临时失去了缓存的作用。 缓存预热 必要的基础数据,可以提前缓存掉。节约第一次加载时间。 风险监控 针对线上机器的不同维度实施监控,如链接数,内存,cpu,稳定性等有异常及时发通知。 flushall风险预知 在极端情况下,为了保证新业务的稳定,可能采取被迫措施flushall,清空所有缓存。这种情况下,你一定不能把缓存当成数据库来使用,要有缓存随时可以丢弃的自觉性。谨记! 虽然有大量要注意的风险点,但比起它的收益来讲,我们肯定会继续使用的。量一大,各种问题都会出来,不要怕,挺住! Redis C#客户端 C#客户端这里列举了 csredis Nhiredis redis-sharp redisboost ServiceStack.Redis Sider StackExchange.Redis TeamDev Redis Client 使用之前,可以先了解下它们的优点和弊端,如ServiceStack.Redis 4.0以上版本属于收费版本。StackExchange.Redis在.netcore下有超时bug。 Redis常用命令知悉 Redis官方提供了在线命令测试redis命令,我们可以通过这个网页快速熟悉命令。 命令种类有很多,我们今天先从strings,lists来熟悉下。 string下的命令 set get getrange 获取字符串区间 append 追加 > set key1 dolll OK > get key1 "dolll" > GETRANGE key1 0 2 "dol" > append key1 as 7 > get key1 "dolllas" incr 递增 decr 递减 > incr hello (integer) 1 > incr hello (integer) 2 > decr hello (integer) 1 list下的命令 lpush lrange > lpush dwe redis (integer) 1 > lpush dwe ds (integer) 2 > lpush dwe sd (integer) 3 > lpush dwe qd (integer) 4 > lRange dwe 0 20 1) "qd" 2) "sd" 3) "ds" 4) "redis" 匆忙的结束 今天主要重温了下Redis,了解Redis应用场景,C#客户端和简单的运行命令。 作者:从此启程/范存威 出处:http://www.cnblogs.com/fancunwei/ 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文链接。如文章对您有用,烦请点个推荐再走,感谢! 本博客新开通打赏,鼠标移到右侧打赏浮动处,即可赏博主点零花钱,感谢您的支持!

优秀的个人博客,低调大师

Docker部署Apollo分布式环境

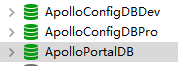
在一个Docker容器中部署Dev和Pro双配置环境。 应用镜像:https://hub.docker.com/r/idoop/docker-apollo/ 里面说明很清晰,不过有些地方需要我们部署后手工调整,很坑啊。 一、创建数据库和表 参考:官方文档 创建三个数据库: 然后分别通过官方的sql建立表结构 二、创建Docker容器 经验证Network可以使用bridge桥接模式。 配置容器的ENV环境变量: # 开启Portal,默认端口: 8070 PORTAL_DB: jdbc:mysql://192.168.1.28:3306/ApolloPortalDB?characterEncoding=utf8 PORTAL_DB_USER: root PORTAL_DB_PWD: toor # 开启dev环境, 默认端口: config 8080, admin 8090 DEV_DB: jdbc:mysql://192.168.1.28:3306/ApolloConfigDBDev?characterEncoding=utf8 DEV_DB_USER: root DEV_DB_PWD: toor # 开启pro环境, 默认端口: config 8083, admin 8093 DEV_DB: jdbc:mysql://192.168.1.28:3306/ApolloConfigDBPro?characterEncoding=utf8 DEV_DB_USER: root DEV_DB_PWD: toor 我们都采用默认端口,注意不要跟其他容器端口冲突。 然后我们就启动容器吧。 三、调整配置 1.修改apollo默认密码 新版本可以在界面中进行修改了,进入用户管理界面: 官方文档中写的很明确,update or create,也就是用户名已存在的会进行更新。我们直接填写apollo,然后修改为新密码即可。 2.配置部门列表 修改ApolloPortalDB数据库,表ServerConfig的organizations字段: 3.调整Pro的Eureka连接地址(很坑的一个地方) 默认的话都会连接到8080的Eureka上,这样会出问题的,配置混乱。 我们修改数据库ApolloConfigDBPro中的ServerConfig表里面的eureka.service.url字段 可以看到默认为8080,我们修改为8083即可。 我们重启容器服务,然后可以验证一下: 访问8080端口和8083端口,看到都是对应的就说明配置正确了。

优秀的个人博客,低调大师

分布式缓存-redis集群部署

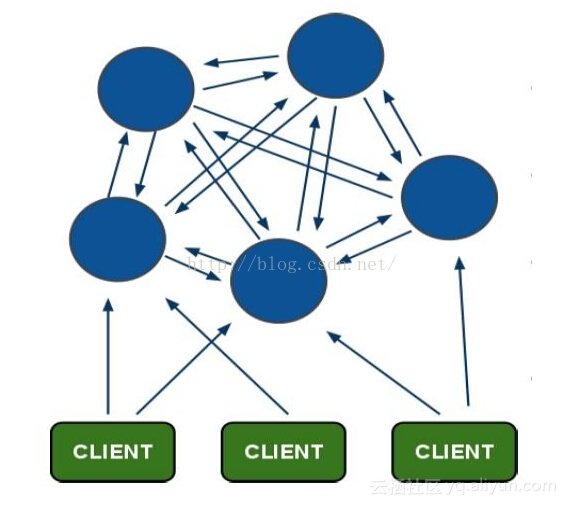
此篇文章只是了解一下redis部署架构方式,至于怎么搭建有兴趣自己研究 redis几个特点:1、redis支持5中数据类型,每种数据类型都有自己的数据结构2、redis提供两种数据持久化机制,RDB和AOF模式,RDB模式是定时用一个线程将数据保存成文件存储在硬盘中,优点是恢复数据块缺点是可能会丢失一整段时间内的数据。AOF机制是通过保存对数据的变更命令日志来实现数据持久化,可选择每次变更保存日志,也可以选择每秒内的日志保存。优点是数据完整性高,缺点是性能低。 redis cluster集群方案: 此种架构特点:1、若干节点组成一个集群,每个节点有主备多个实例,保证高可用性。整个集群将16384个插槽分别存储在不同的节点上,每个集群节点的数据均不一样,每个节点上的主备实例节点数据是一样的。2、Redis Cluster采用无中心架构,每个节点都保存数据和整个集群的节点状态,集群节点不会代理查询,Redis Cluster采用异步复制机制 ,master和slave在先写到master,然后master直接返回ok,然后再把变更异步传播更新到slave里去。3、应该是不支持不同slot的批量操作的,同一个slot的批量操作应该是没问题的。 实际部署架构: 代理层可做批量操作、支持更高的并发、高可用性。 redis集群架构参考redis集群知识

优秀的个人博客,低调大师

python函数式编程之迭代器

什么是迭代器 顾名思义,就是更新换代的意思 python中的迭代器就是根据上一个结果生成下一个结果,一直循环往复不断重复的过程 迭代器有两个特点: 1.不断重复同一个过程 2.根据上一个结果生成下一个结果 迭代器的定义 先来看两个例子 代码一: while True: cmd = input("input your command: ").strip() print(cmd) 代码二: l1 = ["a", "b", "c", "d"] count = 0 while count < len(l1): print(l1[count]) count += 1 在代码一中,让用户不断输入命令,然后打印用户输入的命令,这是一个不断重复的过程,但是后一个结果跟前一个结果没有什么联系,所以代码一不是迭代器 在代码二中,先定义一个列表l1和count,在count的值小于列表l1的长度中,打印列表中count索引的值,然后count的值加1,这几行代码符合迭代器的定义 代码二的执行过程: 首先,打印列表l1中count索引的值,这是一个不断重复的过程 然后,每循环一次,count的值就在以前的基础上增加1,直到count的值等于列表l1的长度时,循环中止 所以代码一不是迭代器,代码二才是符后迭代器的定义标准 迭代器的作用 python中常见的数据类型包括字符串,列表,元组,字典,集合,文件 我们知道,python中的数据类型又分为有序和无序 对于有序数据类型,可以如上面的代码二所示,使用索引遍历有序数据类型中的元素 而对于无序数据类型,就不可以使用索引来遍历其中的元素了,此时可以使用for循环来遍历其中的元素 现在来看看for循环到底做了哪些事,可以取出无序数据类型中的元素 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } for k in dic1: print(k) 执行上面的程序,可以打印出字典dic1中所有的键 实际上,python为了提供一种不依赖于索引的迭代方式,python会为一些对象内置__iter__方法 在python中,如果一个对象有__iter__方法,那么这个对象就是可迭代对象 执行obj.__iter__()方法得到的结果就是迭代器 所以python中的迭代器,都会有__iter__方法和__next__方法 以上面定义的dic1为例 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } i = dic1.__iter__() # dic1.__iter__方法执行结果得到一个迭代器i print(i) # 打印迭代器,得到结果:<dict_keyiterator object at 0x0000000002DBD278> print(i.__next__()) # 执行迭代器i中的__next__方法,得到dic1中的一个元素,然后打印迭代出的元素 print(i.__next__()) # 再次执行迭代器的__next__方法,得到dic1的第二个元素,然后打印出来 print(i.__next__()) # 第三次执行迭代器的__next__方法,得到dic1的第三个元素,然后打印出来 由于python的字典是无序的数据类型,所以每次得到的dic1中的元素可能是不相同的 执行三次__next__方法,得到的结果如下 a b c 上面dic1的长度为4,如果执行5次__next__方法,会出错什么结果 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } i = dic1.__iter__() print(i.__next__()) print(i.__next__()) print(i.__next__()) print(i.__next__()) print(i.__next__()) 程序执行结果 a File "D:\python3\lib\unittest\loader.py", line 153, in loadTestsFromName b module = __import__(module_name) c File "E:\python_learn\py_code\test.py", line 21, in <module> d print(i.__next__()) StopIteration 可以看到,python解释器在执行第五次__next__方法时,抛出了StopIteration的错误,这说明如果执行__next__方法的次数超出迭代器的长度时,python解释会抛出异常 迭代器的优缺点 迭代器的优点 1.提供一种不依赖于索引的取值方式 2.提供惰性计算,每执行一次__next__方法,只会从迭代器中取出一个值,不管这个数据长度有多大,使用迭代器取值时,每取出一个值,占用的内存空间都一个元素的大小,非常节省内存空间 迭代器的缺点 1.取值比较麻烦。如果想用迭代器的方式取出列表中的第三个值,必须调用三次__next__方法,才能取出第三个值,而前两次取出的值实际上是没有作用的 2.一次性的,只能向后迭代,不能回退。如果运行两次__next__方法后,就不可能回退再去了迭代器的第一个值 3.不能获取到迭代器的长度,只能不停执行__next__方法,直到出现StopIteration的提示,此时才能知道迭代器的长度 for循环的执行过程 定义一个列表,使用for循环遍历取出列表中的值 l1 = ['a', 'b', 'c', 'd'] for i in l1: print(i) 在for循环的执行过程中,实际上for循环是把in后面的对象执行__iter__方法,得到一个迭代器对象,然后不停执行迭代器对象中的__next__方法,得到元素,然后把迭代出来的元素赋值给i,再调用print方法打印元素i,直到for循环捕捉到StopIteration异常,结束循环,程序停止 类似于下面的代码 l1 = ['a', 'b', 'c', 'd'] obj = l1.__iter__() while True: try: i = obj.__next__() print(i) except StopIteration: break 判断一个对象是迭代器对象还是可迭代对象 只要一个对象有__iter__方法,这个对象就是可迭代对象 一个可迭代对象有__next__方法,这个对象就是迭代器对象 判断python中的字符串,列表,元组,字典和文件对象是否是可迭代对象和迭代器对象 示例代码 from collections import Iterable, Iterator s1 = "hello" l1 = ['a', 'b', 'c', 'd'] t1 = ('a', 'b', 'c', 'd') set1 = {'a', 'b', 'c', 'd'} dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } f1 = open("db.txt", "w", encoding="utf-8") print(isinstance(s1, Iterable)) print(isinstance(l1, Iterable)) print(isinstance(t1, Iterable)) print(isinstance(set1, Iterable)) print(isinstance(dic1, Iterable)) print(isinstance(f1, Iterable)) print("*" * 30) print(isinstance(s1, Iterator)) print(isinstance(l1, Iterator)) print(isinstance(t1, Iterator)) print(isinstance(set1, Iterator)) print(isinstance(dic1, Iterator)) print(isinstance(f1, Iterator)) 执行结果: True True True True True True ****************************** False False False False False True 从上面的例子,可以看出,字符串,列表,元组,集合,字典和文件都是可迭代对象,其中只有文件是迭代器对象 在上面,我们知道,使用for遍历对象中的值时,是把in后面的对象的变为可迭代对象,然后调用__next__方法取出对象中的元素 既然文件本身就是迭代器对象,那使用for循环获取文件的内容时,又是怎么做的呢 先打开一个文件,打印出这个文件对象,再调用文件对象的__iter__方法得到迭代器对象,判断两个对象是否是同一个对象 f1 = open("db.txt", encoding="utf-8") print(f1) obj = f1.__iter__() print(obj) print(obj is f1) 执行结果 <_io.TextIOWrapper name='db.txt' mode='r' encoding='utf-8'> <_io.TextIOWrapper name='db.txt' mode='r' encoding='utf-8'> True 得到结论: 如果一个对象可以被for循环迭代,则这个对象一定是可迭代对象 文件对象被执行__iter__方法,得到的结果仍然是一个迭代器对象

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册