首页 文章 精选 留言 我的

精选列表

搜索[分发链路],共10000篇文章
优秀的个人博客,低调大师

TKE 重磅推出全链路调度解决方案

引言 在 K8s 集群运营过程中,常常会被节点 CPU 和内存的高使用率所困扰,既影响了节点上 Pod 的稳定运行,也会增加节点故障的几率。为了应对集群节点高负载的问题,平衡各个节点之间的资源使用率,应该基于节点的实际资源利用率监控信息,从以下两个策略入手: 在 Pod 调度阶段,应当优先将 Pod 调度到资源利用率低的节点上运行,不调度到资源利用率已经很高的节点上 在监控到节点资源率较高时,可以自动干预,迁移节点上的一些 Pod 到利用率低的节点上 为此,我们提供 动态调度器 + Descheduler 的方案来实现,目前在公有云 TKE 集群内【组件管理】- 【调度】分类下已经提供这两个插件的安装入口,文末还针对具体的客户案例提供了最佳实践的例子。 动态调度器 原生的 Kubernetes 调度器有一些很好的调度策略用来应对节点资源分配不均的问题,比如 BalancedResourceAllocation,但是存在一个问题是这样的资源分配是静态的,不能代表资源真实使用情况,节点的 CPU/内存利用率 经常处于不均衡的状态。所以,需要有一种策略可以基于节点的实际资源利用率进行调度。动态调度器所做的就是这样的工作。 技术原理 原生 K8s 调度器提供了 scheduler extender 机制来提供调度扩展的能力。相比修改原生 scheduler 代码添加策略,或者实现一个自定义的调度器,使用 scheduler extender 的方式侵入性更少,实现更加灵活。所以我们选择基于 scheduler extender 的方式来添加基于节点的实际资源利用率进行调度的策略。 scheduler extender 可以在原生调度器的预选和优选阶段加入自定义的逻辑,提供和原生调度器内部策略同样的效果。 架构 node-annotator:负责拉取 Prometheus 中的监控数据,定期同步到 Node 的 annotation 里面,同时负责其他逻辑,如动态调度器调度有效性衡量指标,防止调度热点等逻辑。 dynamic-scheduler:负责 scheduler extender 的优选和预选接口逻辑实现,在预选阶段过滤掉资源利用率高于阈值的节点,在优选阶段优先选择资源利用率低的节点进行调度。 实现细节 动态调度器的策略在优选阶段的权重如何配置? 原生调度器的调度策略在优选阶段有一个权重配置,每个策略的评分乘以权重得到该策略的总得分。对权重越高的策略,符合条件的节点越容易调度上。默认所有策略配置权重为 1,为了提升动态调度器策略的效果,我们把动态调度器优选策略的权重设置为 2。 动态调度器如何防止调度热点? 在集群中,如果出现一个新增的节点,为了防止新增的节点调度上过多的节点,我们会通过监听调度器调度成功事件,获取调度结果,标记每个节点过去一段时间的调度 Pod 数,比如 1min、5min、30min 内的调度 Pod 数量,衡量节点的热点值然后补偿到节点的优选评分中。 产品能力 组件依赖 组件依赖较少,仅依赖基础的节点监控组件 node-exporter 和 Prometheus。Prometheus 支持托管和自建两种方式,使用托管方式可以一键安装动态调度器,而使用自建 Prometheus 也提供了监控指标配置方法。 组件配置 调度策略目前可以基于 CPU 和内存两种资源利用率。 预选阶段 配置节点 5分钟内 CPU 利用率、1小时内最大 CPU 利用率,5分钟内平均内存利用率,1小时内最大内存利用率的阈值,超过了就会在预选阶段过滤节点。 优选阶段 动态调度器优选阶段的评分根据截图中 6个指标综合评分得出,6个指标各自的权重表示优选时更侧重于哪个指标的值,使用 1h 和 1d 内最大利用率的意义是要记录节点 1h 和 1d 内的利用率峰值,因为有的业务 Pod 的峰值周期可能是按照小时或者天,避免调度新的 Pod 时导致在峰值时间节点的负载进一步升高。 产品效果 为了衡量动态调度器对增强 Pod 调度到低负载节点的提升效果,结合调度器的实际调度结果,获取所有调度到的节点在调度时刻的的 CPU/内存利用率以后统计以下几个指标: cpu_utilization_total_avg :所有调度到的节点 CPU 利用率平均值。 memory_utilization_total_avg :所有调度到的节点内存利用率平均值。 effective_dynamic_schedule_count :有效调度次数,当调度到节点的 CPU 利用率小于当前所有节点 CPU 利用率的中位数,我们认为这是一次有效调度,effective_dynamic_schedule_count 加 0.5分,对内存也是同理。 total_schedule_count :所有调度次数,每次新的调度累加1。 effective_schedule_ratio :有效调度比率,即 effective_dynamic_schedule_count/total_schedule_count下面是在同一集群中不开启动态调度和开启动态调度各自运行一周的指标变化,可以看到对于集群调度的增强效果。 指标 未开启动态调度 开启动态调度 cpu_utilization_total_avg 0.30 0.17 memory_utilization_total_avg 0.28 0.23 effective_dynamic_schedule_count 2160 3620 total_schedule_count 7860 7470 effective_schedule_ratio 0.273 0.486 Descheduler 现有的集群调度场景都是一次性调度,即一锤子买卖。后续出现节点 CPU 和内存利用率过高,也无法自动调整 Pod 的分布,除非触发节点的 eviction manager 后驱逐,或者人工干预。这样在节点 CPU/内存利用率高时,影响了节点上所有 Pod 的稳定性,而且负载低的节点资源还被浪费。 针对此场景,借鉴 K8s 社区 Descheduler 重调度的设计思想,给出基于各节点 CPU/内存实际利用率进行驱逐的策略。 架构 Descheduler 从 apiserver 中获取 Node 和 Pod 信息,从 Prometheus 中获取 Node 和 Pod 监控信息,然后经过Descheduler 的驱逐策略,驱逐 CPU/内存使用率高的节点上的 Pod ,同时我们加强了 Descheduler 驱逐 Pod 时的排序规则和检查规则,确保驱逐 Pod 时服务不会出现故障。驱逐后的 Pod 经过动态调度器的调度会被调度到低水位的节点上,实现降低高水位节点故障率,提升整体资源利用率的目的。 产品能力 产品依赖 依赖基础的节点监控组件 node-exporter 和Prometheus。Prometheus 支持托管和自建两种方式,使用托管方式可以一键安装 Descheduler,使用自建 Prometheus 也提供了监控指标配置方法。 组件配置 Descheduler 根据用户配置的利用率阈值,超过阈值水位后开始驱逐 Pod ,使节点负载尽量降低到目标利用率水位以下。 产品效果 通过 K8s 事件 通过 K8s 事件可以看到 Pod 被重调度的信息,所以可以开启集群事件持久化功能来查看 Pod 驱逐历史。 节点负载变化 在类似如下节点 CPU 使用率监控视图内,可以看到在开始驱逐之后,节点的 CPU 利用率下降。 最佳实践 集群状态 拿一个客户的集群为例,由于客户的业务大多是内存消耗型的,所以更容易出现内存利用率很高的节点,各个节点的内存利用率也很不平均,未使用动态调度器之前的各个节点监控是这样的: 动态调度器配置 配置预选和优选阶段的参数如下: 在预选阶段过滤掉 5分钟内平均内存利用率超过 60%或者 1h内最大内存利用率超过 70%的节点,即 Pod 不会调度到这些这些节点上。 在优选阶段将 5分钟平均内存利用率权重配置为 0.8,1h 和1d 内最大内存利用率权重配置为 0.2、0.2,而将 CPU 的指标权重都配置为 0.1。这样优选时更优先选择调度到内存利用率低的节点上。 Descheduler配置 配置 Descheduler 的参数如下,当节点内存利用率超过 80%这个阈值的时候,Descheduler 开始对节点上的 Pod 进行驱逐,尽量使节点内存利用率降低到目标值 60% 为止。 集群优化后状态 通过以上的配置,运行一段时间后,集群内各节点的内存利用率数据如下,可以看到集群节点的内存利用率分布已经趋向于均衡:

优秀的个人博客,低调大师

OpenTelemetry 演示与 OpenTelemetry 的 Elastic 分发

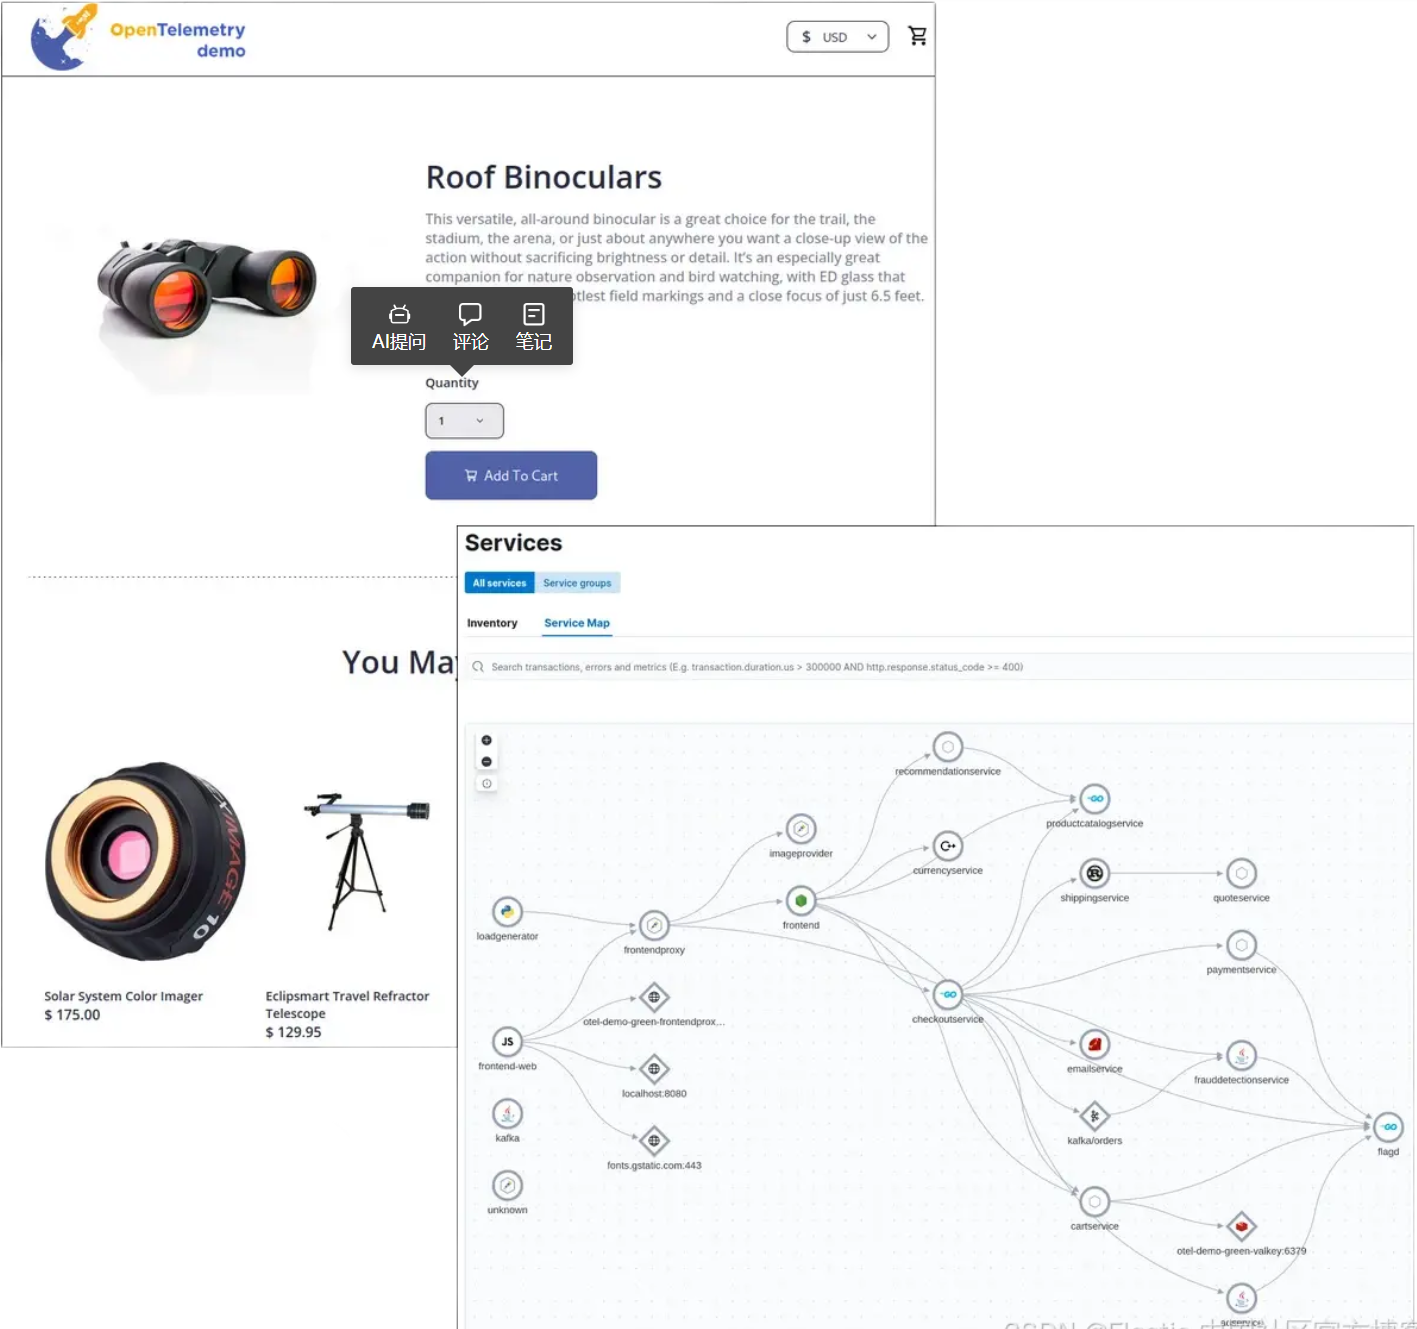
作者:来自 ElasticRoger Coll 了解 Elastic 如何致力于支持用户使用 OpenTelemetry。探索我们对 OpenTelemetry Demo 的公开部署,并了解 Elastic 的解决方案如何增强你的可观察性体验。 最近,Elastic 为各种 OpenTelemetry 组件引入了 Elastic Distributions (EDOT),我们很自豪地宣布,这些 EDOT 组件现已在 Elastic 的 OpenTelemetry Demo 分支中可用。我们还公开了一个 Kibana 端点,让你可以深入了解演示的实时数据并亲自探索其功能。在这篇博文中,我们将详细说明分支背后的原因,并探索它引入的强大新功能。我们还将全面概述如何利用这些增强功能与 OpenTelemetry (EDOT) 的 Elastic Distributions 进行高级错误检测,以及 EDOT Collector(Elastic Agent 的尖端发展)进行无缝数据收集和分析。 什么是 OpenTelemetry 演示? OpenTelemetry 演示是一个基于微服务的应用程序,由 OpenTelemetry 社区创建,旨在展示其在现实的分布式系统环境中的功能。这个演示应用程序称为 OpenTelemetry Astronomy Shop,它模拟了一个由 10 多个互连微服务(以多种语言编写:Go、Java、.NET、Node.js 等)组成的电子商务网站,通过 HTTP 和 gRPC 进行通信。每项服务都完全使用 OpenTelemetry 进行检测,生成全面的跟踪、指标和日志。该演示是了解如何在实际应用程序中实现和使用 OpenTelemetry 的宝贵资源。 其中一项微服务名为 loadgenerator,它会自动开始向演示的各个端点生成请求,模拟多个客户端与系统交互的真实环境。这有助于复制具有并发用户活动的繁忙实时应用程序的行为。 Elastic 的分支 Elastic 认识到了通过分支 OpenTelemetry Demo 并集成高级 Elastic 功能来增强 OpenTelemetry Demo 的机会,以实现更深入的可观察性和更简单的监控。虽然分支是推荐的 OpenTelemetry 方法,但我们的目标是尽可能利用上游版本的强大基础和最新更新。为了实现这一点,Elastic 的 OpenTelemetry Demo 分支每天都会从上游进行拉取,将它们与 Elastic 特定的更改无缝集成。为了避免冲突,我们不断向上游做出贡献,确保 Elastic 的修改始终是附加的或可通过环境变量进行配置的。其中一个贡献是 .env.override 文件,它专为供应商分支而设计,用于覆盖演示中使用的微服务镜像和配置文件。 使用 Elastic 发行版获得更深入的洞察 在 Elastic 的 OpenTelemetry Demo 分支的最新更新中,我们已将用于检测的一些微服务 OTel SDK 替换为 Elastic 的专用发行版。这些更改确保与 Elastic 的可观察性工具进行更深入的集成,提供更丰富的洞察和更强大的监控功能。以下是分支的一些更改: Java 服务:广告、欺诈检测和 Kafka 服务现在使用 OpenTelemetry Java 代理的 Elastic 发行版。发行版中包含的功能之一是堆栈跟踪,它提供有关 span 起源于代码路径中何处的精确信息。在此处了解有关 Elastic Java 代理的更多信息。 Cart 服务已升级为使用 OpenTelemetry .NET 代理的 Elastic 发行版。此替换可让你了解如何使用 OpenTelemetry .NET 的 Elastic 发行版 (EDOT .NET) 开始在 .NET 应用程序中使用 OpenTelemetry,而无需进行任何代码更改。在此博客文章中了解有关 Elastic .NET 代理的更多信息。 在 Payment 服务中,我们配置了 OpenTelemetry Node.js 代理的 Elastic 发行版。该发行版附带 host-metrics 扩展,Kibana 提供了精选的服务指标 UI。在此处阅读有关 Elastic Node.js 代理的更多信息。 Recommendation 服务现在利用 EDOT Python,取代了标准的 OpenTelemetry Python 代理。Python 发行版是零代码(或自动)检测的另一个示例,这意味着发行版将设置 OpenTelemetry SDK 并为你启用所有推荐的检测。在此博客文章中了解有关 Elastic Python Agent 的更多信息。 需要强调的是,OpenTelemetry 的 Elastic 发行版不捆绑专有软件,它们建立在原始 OTel SDK 之上,但它们提供了一些优势,例如安装的单一软件包、使用合理的默认配置轻松自动检测、自动日志遥测发送等等。沿着这些思路,最终目标是将尽可能多的 EDOT 功能贡献给上游 OpenTelemetry 代理;它们的设计方式是,作为扩展实现的附加功能可直接与 OTel SDK 配合使用。 使用 Elastic Collector Distribution 收集数据 OpenTelemetry Demo 应用程序生成信号并将其发送到 OpenTelemetry Collector OTLP 端点。在 Demo 的分支中,EDOT 收集器设置为将所有 OTLP 信号从微服务转发到APM 服务器OTLP 端点。此外,它还将收集器收集的所有其他指标和日志发送到Elasticsearch端点。 如果分支部署在 Kubernetes 环境中,收集器将自动开始收集系统的指标。收集器将配置为使用hostmetrics 接收器来监控所有 K8s 节点的指标,使用kuebeletstats 接收器来检索 Kubelet 的指标,使用 filelog 接收器来收集所有集群的指标。 微服务生成的信号和 EDOT 收集器收集的信号都富含 Kubernetes 元数据,使用户可以无缝关联它们。这样可以轻松跟踪和观察每个服务在哪些 Kubernetes 节点和 pod 上运行,从而深入了解应用程序性能和基础设施健康状况。 了解有关 Elastic 的 OpenTelemetry Collector 发行版的更多信息:https://www.elastic.co/observability-labs/blog/elastic-distribution-opentelemetry-collector 使用 Elastic 进行错误检测 OpenTelemetry Demo 结合了flagd,这是一个用于模拟错误场景的功能标志评估引擎。例如,paymentServiceFailure 标志将强制对 charge 服务收费端点的每个请求都产生错误。由于该服务使用 OpenTelemetry 进行检测,因此错误将被捕获到生成的跟踪中。然后,我们可以使用 Kibana 强大的可视化和搜索工具将错误追溯到其根本原因。 另一个可用标志名为 adServiceHighCpu,它会导致广告服务中的 CPU 负载过高。可以通过服务的指标或其 Kubernetes pod 的相关指标来监控这种增加的 CPU 使用率: 模拟场景的完整列表可在此链接中找到。 开始你自己的探索 准备好探索带有 Elastic 的 OpenTelemetry Demo 及其增强的可观察性功能了吗?点击 Kibana 链接,开始你自己的探索,了解 Elastic 和 OpenTelemetry 如何改变你的可观察性方法。 现场演示:https://ela.st/demo-otel 但这还不是全部 —— 如果你想更进一步,你可以直接使用自己的 Elasticsearch 堆栈部署 OpenTelemetry Demo。按照此处提供的步骤进行设置,并开始从你自己的环境中获得有价值的见解。 原文:OpenTelemetry Demo with the Elastic Distributions of OpenTelemetry — Elastic Observability Labs

优秀的个人博客,低调大师

Gearman——分布式任务分发框架

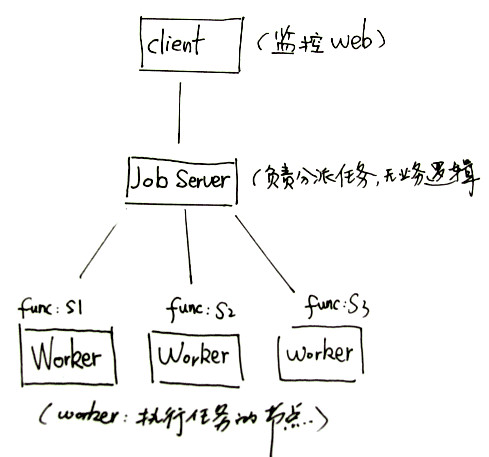
工作中我们有时候会遇到比如需要同时发布数据到多个个服务器上,或者同时处理多个任务。可以使用PHP的curl_multi的方式并发处理请求,但是由于网络和数据以及各个服务器等等的一些情况导致这种并发处理的响应时间很慢,因为在并发请求的过程中还包括记录日志,处理数据等逻辑,等待处理结果并返回,所以也不能友好的满足后台操作的体验。 现在有另外一种方案,利Gearman来实现并发的需求。通过Client将请求发送到Gearman的Jobs,在每个Work中来再来进行curl_multi和数据处理和日志等一些操作,同时用supervisor 来监控Gearman以及Works的进程,这样可以实现一个并行的多进程和负载均衡的方案。 Gearman可以做什么: 异步处理:图片处理,订单处理,批量邮件/通知之类的 要求高CPU或内存的处理:大容量的数据处理,MapReduce运算,日志聚集,视频编码 分布式和并行的处理 定时处理:增量更新,数据复制 限制速率的FIFO处理 分布式的系统监控任务 Gearman工作原理: 使用Gearman的应用通常有三部分组成:一个Client、一个Worker、一个 任务服务器。 Client的作用是提出一个 Job 任务 交给 Job Server 任务服务器。Job Server 会去寻找一个 合适的 Worker 来完成这项任务。Worker 执行由 Client 发送过来的 Job,并且将结果通过 Job Server 返回给 Client。Gearman 提供了 Client 和 Worker 的 API,利用这些API 应用可以同 Gearman Job Server来进行通信。Gearman 内部 Client 和 Worker 之间的通信都是通过 TCP 连接来进行的。 通常,多语言多系统之间的集成是个大问题,一般来说,人们多半会采用WebService的方式来处理此类集成问题,但不管采用何种风格的WebService,如RPC风格,或者REST风格,其本身都有一定的复杂性。相比之下,Gearman也能实现类似的作用,而且更简单易用。 一个Gearman请求的处理过程涉及三个角色:Client -> Job -> Worker。 Client:请求的发起者,可以是C,PHP,Perl,MySQL UDF等等。 Job:请求的调度者,用来负责协调把Client发出的请求转发给合适的Work。 Worker:请求的处理者,可以是C,PHP,Perl等等。 因为Client,Worker并不限制用一样的语言,所以有利于多语言多系统之间的集成。 甚至我们通过增加更多的Worker,可以很方便的实现应用程序的分布式负载均衡架构。 3 Gearman下载 1)官网 http://gearman.org/ 2)官网下载 https://launchpad.net/gearmand 3)官网使用向导 http://gearman.org/getting-started/ 3)本次安装用到的所有软件下载地址(安装环境为CentOS-6.5) http://download.csdn.net/detail/clevercode/8698699 4 Gearman安装 4.1 安装linux必备常用库 Linux中必备常用支持库的安装:http://blog.csdn.net/clevercode/article/details/45438401 4.2 安装gearmand依赖的库 # yum install -y boost-devel gperf libevent-devel libuuid-devel 4.3 安装gearmand服务 1)解压 # cd /usr/local/src/gearman # tar xzf gearmand-1.1.12.tar.gz 2)配置 # cd gearmand-1.1.12 # ./configure 3)编译 # make 4)安装 # make install 5)安装成功图,输入 # gearman 5 安装php扩展 1)安装phpize # yum install -y php-devel 2)解压 # cd /usr/local/src/gearman # tar xzf gearman-1.1.2.tgz 3)配置 # cd gearman-1.1.2 # phpize # ./configure 4)编译 # make 5)安装 # make install 6)安装成功 出现“Installing shared extensions: /usr/lib64/PHP/modules/”表示安装成功,/usr/lib64/php/modules/是gearman.so扩展的目录。如图 7)配置(加入扩展) # vi /usr/local/php5/etc/php.ini extension="gearman.so" 8)查配置是否成功 # vi test.php print gearman_version() . "\n"; ?> 执行php test.php后,出现1.1.12表示安装成功 # php test.php 1.1.12 6 Gearman启动停止 1) 创建日志/data0/logs/gearmand.log # touch /data0/logs/gearmand.log 2)启动 # /usr/local/sbin/gearmand -d -u root -L 192.168.142.130 --log-file=/data0/logs/gearmand.log 3)参数详解 -b,--backlog= 储备的监听连接数量 -d, --daemon 后台运行 -f, --file-descriptors= 文件描述符的数量 -h, --help 帮助 -j, --job-retries= 在ob server移除不可用job之前运行的次数,防止不断运行导致其他可用worker崩溃。默认没有限制 -l, -log-file= 日志文件存放位置(默认记录最简单日志) -L, --listen= 监听的IP,默认全部接受 -p, --port= 指定监听端口 -P, --pid-file= 指定进程ID写入位置 -r, --protocol= 加载协议模块 -q, --queue-type= 指定持久化队列 -t, --threads= 使用的I/9线程数量。默认为0 -u, --user= 启动后,切换到指定用户 -v, --verbose 增加一级详细程度 -V, --version 显示版本信息 4)查是否运行 # ps axu | grep gearmand 5)查看监听端口 # netstat -anp | grep 4730 6)停止,直接kill掉进程。 7 Gearman使用 7.1 创建Worker 创建worker.php,创建一个发送邮件的Worker端。代码如下 [php]view plaincopy $worker=newGearmanWorker(); $worker->addServer('192.168.142.130','4730'); $worker->addFunction("sendMail","my_sendmail_function"); while($worker->work()); functionmy_sendmail_function($job){ //接收数据 $tmp=$job->workload(); $receiveArr=unserialize($tmp); $from=$receiveArr['from']; $to=$receiveArr['to']; $subject=$receiveArr['subject']; $content=$receiveArr['content']; //发送邮件 //.... return$subject.'sendmailOK'; } ?> 7.2 启动Worker端 如果处理的数据量大,可以执行以下脚本多次,即启动多个Worker端。 # nohup php worker.php > tmp.txt & 7.3 创建Client(阻塞模式,需要等待返回结果才结束) 创建一个client.php。do()方法是阻塞模式,必须等待worker端返回结果,程序才能停止。(如图返回:hello Gearman sendmail OK) [php]view plaincopy $client=newGearmanClient(); $client->addServer('192.168.142.130','4730'); $job=array(); $job['from']='Code'; $job['to']='Gearman'; $job['subject']='helloGearman'; $job['content']='helloGearman:thisisfromGearmanClient'; $job=serialize($job); //等到worker端返回结果,才会结束。 $ret=$client->do("sendMail",$job); echo$ret."\r\n"; ?> 7.4 创建Client(非阻塞,不用等结果) 创建一个client2.php。doBackground()不用等待worker端返回结果,程序就结束了。 [php]view plaincopy $client=newGearmanClient(); $client->addServer('192.168.142.130','4730'); $job=array(); $job['from']='Code'; $job['to']='Gearman'; $job['subject']='helloGearman'; $job['content']='helloGearman:thisisfromGearmanClient'; $job=serialize($job); //不等待返回结果,就会结束 $ret=$client->doBackground("sendMail",$job); echo$ret."\r\n"; ?> 8 Gearman管理 输入以下命令,查看4730端口情况。 # (echo "status" ; sleep 2 ) | telnet 192.168.142.130 4730 1)字段说明:"已知注册的任务" "正在运行的任务" "队列中的任务" "可用的 Worker". 2)sendMail 0 0 1,注册的任务名为 sendMail,0 个正常在运行,队列为空,有一个可用的 Worker.

优秀的个人博客,低调大师

从内网私有地址一路走到百度目标节点,逐行拆解这份 Windows tracert 里的 TTL、RTT、超时与新加坡链路

屏幕最终给出了大约 13 跳的路径,中间既出现了 10.x.x.x、172.28.x.x 这样的私有地址,也出现了 203.x.x.x、140.x.x.x、120.x.x.x、180.x.x.x 等公网地址。再往后还能看到 sin4、singapore 一类很有地域意味的设备名。第 11 跳开始出现 *,第 12 跳甚至三个探测包全部超时,可第 13 跳偏偏又成功到达了 45.113.x.x。

优秀的个人博客,低调大师

制造图纸防泄密:基于腾讯云 CLS 异常行为日志构建全链路审计溯源体系

在机械、模具、装备制造行业,CAD 图纸、三维工艺模型属于核心数字资产。图纸在设计、内部流转、外协交付过程中,存在私自解密、批量导出、跨盘拷贝、违规外发等风险。传统本地加密系统仅能实现文件加解密控制,日志分散存储在终端,难以集中检索、长期留存、关联分析,一旦发生泄密事件,追溯取证难度大。通过将终端加密风险行为日志统一接入腾讯云日志服务(CLS),搭建集中化日志存储、检索、告警、审计平台,能够补齐加密体系的溯源短板,形成 “终端管控 + 云端审计” 一体化图纸防泄露方案。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册