首页 文章 精选 留言 我的

精选列表

搜索[快直播],共10000篇文章
优秀的个人博客,低调大师

UKUI 网站全新升级上线,焕新体验一睹为快!

UKUI (Ultimate Kylin User Interface) 是由openKylin社区UKUI SIG组开发维护的一款轻量级 Linux 桌面环境,默认搭载于openKylin开源操作系统、优麒麟开源操作系统和银河麒麟商业发行版中,同时支持 Debian、Ubuntu、ArchLinux、openEuler 等十款主流 Linux 发行版。基于 QT 进行开发,注重易用性和敏捷度,可以不依赖其它套件而独自运行,给用户带来亲切和高效的使用体验。 为进一步提升用户体验,openKylin社区对UKUI网站(https://www.ukui.org )进行了全新改版升级,并已于近期正式上线。各位小伙伴你发现了吗?是否有给大家带来一些惊喜呢?现在就让小K给大家简单介绍一下全新UKUI网站具体都有哪些亮点升级吧。 一、内容全面更新 新版UKUI网站对内容进行了全新规划,菜单导航信息分类更清晰,提炼出设计、开发、参与、文档、公告五个模块,方便用户更快定位到自己想要查看的内容。 二、视觉全新设计 区别于以往的只有夜间模式,新版UKUI网站新增了白天模式,用户可随意切换成自己喜欢的模式。同时对2种模式下的页面布局进行了优化,页面整体更简洁大气,减轻大家浏览网页时的视觉疲劳。 三、中英文双语切换 新版UKUI网站支持中英文实时切换,同时满足国内和国际用户诉求。 四、全面兼容各种设备 新版UKUI网站全面考虑了在PC电脑端、平板端、移动端上等不同设备上的展示效果,保障网站页面信息在不同设备上均能良好展示。 欢迎各位小伙伴点击“https://www.ukui.org/”前往体验,如果在体验过程中发现问题或不足,欢迎大家前往openKylin小程序提交反馈~ openKylin(开放麒麟)社区旨在以“共创”为核心,在开源、自愿、平等、协作的基础上,通过开源、开放的方式与企业构建合作伙伴生态体系,共同打造桌面操作系统顶级社区,推动Linux开源技术及其软硬件生态繁荣发展。 社区首批理事成员单位包括麒麟软件、普华基础软件、中科方德、麒麟信安、凝思软件、一铭软件、中兴新支点、元心科技、中国电科32所、技德系统、北京麟卓、先进操作系统创新中心等13家产业同仁和行业机构。 审核:openKylin

优秀的个人博客,低调大师

端侧压缩部署“小” “快” “灵”!

大家好,今天带来的是有关文心ERNIE 3.0 Tiny新升级内容的文章。 近年来,随着深度学习技术的迅速发展,大规模预训练范式通过一次又一次刷新各种评测基线证明了其卓越的学习与迁移能力。在这个过程中,研究者们发现通过不断地扩大模型参数便能持续提升深度学习模型的威力。然而,参数的指数级增长意味着模型体积增大、所需计算资源增多、计算耗时更长,而这无论出于业务线上响应效率的要求还是机器资源预算问题,都给大模型落地带来了极大的挑战。让我们一起看看文心ERNIE 3.0 Tiny如何来解决这些问题的吧! 图:模型上线时精度、时延、内显存占用等多重需求示意 如何在保证效果的前提下压缩模型?如何适配 CPU、GPU 等多硬件的加速?如何在端侧场景下落地大模型?如何让加速工具触手可及?这是行业内亟待解决的课题。2022年6月,文心大模型中的轻量化技术加持的多个文心ERNIE 3.0 Tiny轻量级模型(下文简称文心ERNIE 3.0 Tiny v1)开源至飞桨自然语言处理模型库PaddleNLP中,该模型刷新了中文小模型的SOTA成绩,配套模型动态裁剪和量化推理方案,被学术与工业界广泛使用。 近期,文心ERNIE 3.0 Tiny升级版–––文心ERNIE 3.0 Tiny v2也开源了!相较于v1,文心ERNIE 3.0 Tiny v2在Out-domain(域外数据)、Low-resource(小样本数据)的下游任务上精度显著提升,并且v2还开源了3L128H结构,5.99M参数量的小模型,更适用于端侧等低资源场景。 同时,PaddleNLP依托PaddleSlim、Paddle Lite、FastDeploy开源了一整套端上语义理解压缩和部署方案。通过模型裁剪、量化感知训练、Embedding量化等压缩方案,在保持模型精度不降的情况下,推理加速2.1倍,内存占用降低62.18%(降低2.6倍),体积缩小92.2%(缩小12.8倍)仅5.4M。再结合高性能NLP处理库FastTokenizer对分词阶段进行加速,使端到端推理性能显著提升,从而将文心ERNIE 3.0 Tiny v2模型成功部署至端侧。由于端侧部署对内存占用的要求比服务端更高,因此该方案也同样适用于服务端部署。 图:端侧设备示意 文心 ERNIE 3.0 Tiny v2开源 百度文心大模型团队在2021年底发布了百亿级别大模型文心ERNIE 3.0和千亿级别的大模型文心ERNIE 3.0 Titan。为了让大模型的能力能够真正在一线业务发挥威力,文心大模型团队推出多个轻量级模型,即文心ERNIE 3.0 Tiny系列,刷新了中文小模型的成绩。除了在GPU上,这些模型也能在CPU上轻松调用,极大拓展了大模型的使用场景。本次开源的文心ERNIE 3.0 Tiny v2,使教师模型预先注入下游知识并参与多任务训练,大大提高了小模型在下游任务上的效果。 多任务学习提升泛化性 文心ERNIE 3.0 Tiny v1直接通过在线蒸馏技术将预训练大模型压缩成预训练小模型。在此基础上,文心ERNIE 3.0 Tiny v2 首先在多个下游任务中微调教师模型,让教师模型学习到下游任务相关知识,并将这些知识通过蒸馏的方式传导给学生模型。尽管学生模型完全没有见过下游数据,也能够蒸馏获取到下游任务的相关知识,进而使下游任务的效果得到提升。由于教师模型是在多任务上进行微调的,多任务学习带来的强泛化性也能传递给学生模型,从而提升小模型的泛化性,最终获得的学生模型相比文心ERNIE 3.0 Tiny v1在Out-domain和Low-resource数据集上获得大幅提升。 图:文心ERNIE 3.0 Tiny v2示意 文心ERNIE 3.0 Tiny v2 包含一系列不同尺寸的中文预训练模型,方便不同性能需求的应用场景使用: 文心ERNIE 3.0 Tiny-Base-v2 (12-layer, 768-hidden, 12-heads) 文心ERNIE 3.0 Tiny-Medium-v2 (6-layer, 768-hidden, 12-heads) 文心ERNIE 3.0 Tiny-Mini-v2 (6-layer, 384-hidden, 12-heads) 文心ERNIE 3.0 Tiny-Micro-v2 (4-layer, 384-hidden, 12-heads) 文心ERNIE 3.0 Tiny-Nano-v2 (4-layer, 312-hidden, 12-heads) 文心ERNIE 3.0 Tiny-Pico-v2 (3-layer, 128-hidden, 2-heads) 除以上中文模型外,本次还发布了英文版文心ERNIE 3.0 Tiny-Mini-v2,适用于各类英文任务。多任务学习的能力加持下,在文本分类、文本推理、实体抽取、问答等各种 NLU 任务上,文心ERNIE 3.0 Tiny v2相比文心ERNIE 3.0 Tiny v1在Out-domain、Low-resource数据上均获得显著的效果提升,在In-domain上也有一定提升。 文心ERNIE 3.0 Tiny v2 多任务学习、在线蒸馏方案效果显著,刷新了中文小模型的SOTA成绩。具体对比数据见如下模型精度-时延图,横坐标表示在 ARM CPU(高通865芯片)上,基于ARMv8 arch测试(batch_size=1, seq_len=32)的推理时延(Latency,单位毫秒),纵坐标是 CLUE 10 个任务上的平均精度(包含文本分类、文本匹配、自然语言推理、代词消歧、阅读理解等任务),其中CMRC2018阅读理解任务的评价指标是Exact Match(EM),其它任务的评价指标均是Accuracy。模型名下方标注了模型的参数量。 图中越靠左上方的模型,精度和性能水平越高。可以看到文心ERNIE 3.0 Tiny v2在同等规模的开源模型中,综合实力领先其他同类型轻量级模型,这波开源厉害了!与UER/RoBERTa-Base相比,12L768H的文心ERNIE 3.0 Base平均精度提升了4.5个点;6L768H的文心ERNIE 3.0 Medium相比12L768H的UER/Chinese-RoBERTa高2.4,并且节省一倍运算时间;另外值得一提的是,这些小模型能够直接部署在CPU上,简直是CPU开发者的希望之光! 在PaddleNLP中,可一键加载以上模型。 frompaddlenlp.transformersimport* tokenizer=AutoTokenizer.from_pretrained("ernie-3.0-tiny-medium-v2-zh") #用于分类任务(本项目中的意图识别任务) seq_cls_model=AutoModelForSequenceClassification.from_pretrained("ernie-3.0-tiny-medium-v2-zh") #用于序列标注任务(本项目中的槽位填充任务) token_cls_model=AutoModelForTokenClassification.from_pretrained("ernie-3.0-tiny-medium-v2-zh") #用于阅读理解任务 qa_model=AutoModelForQuestionAnswering.from_pretrained("ernie-3.0-tiny-medium-v2-zh") 此外,PaddleNLP还提供了CLUE Benchmark的一键评测脚本,并提供了大量中文预训练模型在CLUE上的效果。PaddleNLP接入了Grid Search策略,支持在超参列表范围内自动搜索超参,保留最佳结果和对应的超参数,方便一键复现模型效果,且打通了CLUE各个任务数据处理、训练、预测、结果提交的流程,方便用户快速提交CLUE榜单。 以上模型均已开源,如有帮助,欢迎star支持。 模型地址 https://github.com/PaddlePaddle/PaddleNLP/tree/develop/model_zoo/ernie-tiny 端上语义理解压缩、部署方案 由文心大模型蒸馏得到的文心ERNIE 3.0 Tiny v2可以直接在下游任务上微调应用,如果想要将模型部署在移动端、边缘端,或者想要进一步压缩模型体积,降低推理时延,可使用PaddleNLP开源的端上语义理解压缩方案。以边缘端业务上线场景为例,模型经过压缩后,精度基本无损,端到端推理速度达到原来的2.13倍,内存占用减小了62.18%,体积减小了92.2% ! 结合飞桨模型压缩工具PaddleSlim,PaddleNLP发布了端上语义理解压缩方案,包含裁剪、量化级联压缩,如下图所示: 基于PaddleNLP提供的的模型压缩API,可大幅降低开发成本。压缩API支持对ERNIE、BERT等ransformer类下游任务微调模型进行裁剪和量化。只需要简单地调用compress()即可一键启动裁剪量化流程,并自动保存压缩后的模型。 frompaddlenlp.trainerimportPdArgumentParser,CompressionArguments # Step1:使用 PdArgumentParser 解析从命令行传入的超参数,以获取压缩参数 compression_args; parser=PdArgumentParser(CompressionArguments) compression_args=parser.parse_args_into_dataclasses() #Step2:实例化Trainer并调用compress() trainer=Trainer( model=model, args=compression_args, data_collator=data_collator, train_dataset=train_dataset, eval_dataset=eval_dataset, criterion=criterion) trainer.compress() PaddleNLP模型裁剪、量化使用示例 下面会对压缩方案中的词表裁剪、模型宽度裁剪、量化感知训练、词表量化进行介绍。 词表裁剪 端侧部署对内存占用的要求较高,而文心ERNIE 3.0 Tiny预训练模型的词表参数量在总参数量中占比很大,因此在下游任务微调之前,可以按照词频对词表进行裁剪,去除出现频次较低的词,这样能够减少分词后[UNK]的出现,使精度得到最大限度保持。例如,某数据集4w大小的词表,高频出现的词不到1w个,此时通过词表裁剪可以节省不少内存。 模型宽度裁剪 基于DynaBERT宽度自适应裁剪策略,通过知识蒸馏的方法,在下游任务中将文心ERNIE 3.0 Tiny的知识迁移到宽度更窄的学生网络中,最后得到效果与教师模型接近的学生模型。一般来说,对于4到6层的NLU模型,宽度裁剪1/4可基本保证精度无损。DynaBERT宽度自适应裁剪策略主要分为以下3个步骤: Step1 根据Attention Head和FFN中神经元的重要性对神经元进行重新排序,将新模型作为待压缩的模型,这样可以保证之后对神经元的裁剪可以更大程度地保留更重要的神经元。 Step2 用教师模型同时蒸馏按不同比例压缩宽度的多个模型。 Step3 在蒸馏后得到的不同宽度的学生模型中,选择大小和精度符合要求的模型并导出。 量化感知训练 模型量化是一种通过将训练好的模型参数、激活值从FP32浮点数转换成INT8整数来减小存储、加快计算速度、降低功耗的模型压缩方法。目前主要有两种量化方法: 静态离线量化:使用少量校准数据计算量化信息,可快速得到量化模型; 量化感知训练:在模型中插入量化、反量化算子并进行训练,使模型在训练中学习到量化信息 。 图:量化感知训练 vs 离线量化 在对文心ERNIE 3.0 Tiny的压缩中,更推荐使用量化感知训练的方式。通常情况下,使用量化感知训练的方法能够比使用静态离线量化取得更高的精度。这是因为在量化感知训练之前,压缩API在模型的矩阵乘算子前插入量化、反量化算子,使量化带来的误差可以在训练过程中被建模和优化,能够使模型被量化后精度基本无损。 Embedding 量化 端侧部署对显存的要求比较高,为了能进一步节省内存占用,可对模型的 Embedding 权重进行INT8量化,并将精度的损失保持在0.5%之内。Embedding 量化主要分两步: Step1 离线统计权重在log域上的分布并进行分桶,根据分桶结果将FP32权重量化成INT8权重。如图所示,量化算子会统计权重在log域上量化后的数值分布,取出现次数top k的FP32数值,记录在对应的x轴上,作为buckets的value,其中key为 [-128,127] 范围内的整数。 Step2 构造INT8推理模型:将权重设置为量化后的INT8权重,并在Embedding对应的算子后,插入反量化算子,反量化算子根据buckets将INT8数值类型的输入 [5, 3, 6] 反量化为 [1.51, 0.75, 2.50],实现方式为查表。 部署 模型压缩后,精度基本无损,体积减小了92.2%,仅有5.4MB。到此,算法侧的工作基本完成。为了进一步降低部署难度,可以使用飞桨FastDeploy对模型进行部署。FastDeploy是一款全场景、易用灵活、极致高效的AI推理部署工具,提供开箱即用的部署体验。 FastDeploy为NLP任务提供了一整套完整的部署Pipeline,提供文心ERNIE 3.0 Tiny模型从文本预处理、推理引擎Runtime以及后处理三个阶段所需要的接口模块,开发者可以基于这些接口模块在云、边、端上部署各类常见的NLP任务,如文本分类、序列标注、信息抽取等。 FastDeploy中的Paddle Lite后端基于算子融合和常量折叠对深度模型进行优化,无缝衔接了Paddle Lite的FP16和INT8的推理能力,可使模型推理速度大幅提升。其集成的高性能NLP处理库FastTokenizer(视觉领域集成了高性能AI处理库FlyCV),能够对分词阶段进行加速,适配GPU、CPU等多硬件。例如在麒麟985芯片上测试,单条文本的分词时延低于0.1毫秒。 在端到端部署方面,FastDeploy在Android端目前支持CV和NLP中的7+场景,35+模型的开箱即用,以及简单一致的API,让Android开发者快速完成AI落地,并且获得考虑前后处理在内端到端高性能的部署体验。 综上,基于FastDeploy部署工具,可完成文心ERNIE 3.0 Tiny端侧和服务端的高效部署。以下动图展示了基于文心ERNIE 3.0 Tiny v2的意图识别、槽位填充联合模型,使用FastDeploy部署在Android APP上进行推理的效果展示: GitHub地址 https://github.com/PaddlePaddle/FastDeploy 总结来说,以上各类压缩策略以及对应的推理功能如果从零实现非常复杂,飞桨模型压缩工具库PaddleSlim和飞桨高性能深度学习端侧推理引擎Paddle Lite提供了一系列压缩、推理工具链。飞桨AI推理部署工具FastDeploy对其进一步封装,使开发者可以通过更简单的API去实现模型压缩、推理部署流程,适配多领域模型,并兼容多硬件。PaddleNLP依托以上工具,提供NLP模型数据处理、训练、压缩、部署全流程的最佳实践。 文心大模型 随着数据井喷、算法进步和算力突破,效果好、泛化能力强、通用性强的预训练大模型(以下简称“大模型”),成为人工智能发展的关键方向与人工智能产业应用的基础底座。 文心大模型源于产业、服务于产业,是产业级知识增强大模型,涵盖基础大模型、任务大模型、行业大模型,大模型总量达36个,并构建了业界规模最大的产业大模型体系。文心大模型配套了丰富的工具与平台层,包括大模型开发套件、API以及内置文心大模型能力的EasyDL和BML开发平台。 百度通过大模型与国产深度学习框架融合发展,打造了自主创新的AI底座,大幅降低了AI开发和应用的门槛,满足真实场景中的应用需求,真正发挥大模型驱动AI规模化应用的产业价值。 文心大模型官网地址 https://wenxin.baidu.com/ 相关项目地址 官网地址 https://www.paddlepaddle.org.cn PaddleNLP https://github.com/PaddlePaddle/PaddleNLP FastDeploy https://github.com/PaddlePaddle/FastDeploy PaddleSlim https://github.com/PaddlePaddle/PaddleSlim Paddle Lite https://github.com/PaddlePaddle/Paddle-Lite 参考文献 [1] Liu W, Chen X, Liu J, et al. ERNIE 3.0 Tiny: Frustratingly Simple Method to Improve Task-Agnostic Distillation Generalization[J]. arXiv preprint arXiv:2301.03416, 2023. [2] Su W, Chen X, Feng S, et al. ERNIE-Tiny: A Progressive Distillation Framework for Pretrained Transformer Compression[J]. arXiv preprint arXiv:2106.02241, 2021. [3] Wang S, Sun Y, Xiang Y, et al. ERNIE 3.0 Titan: Exploring Larger-scale Knowledge Enhanced Pre-training for Language Understanding and Generation[J]. arXiv preprint arXiv:2112.12731, 2021. [4] Sun Y, Wang S, Feng S, et al. ERNIE 3.0: Large-scale Knowledge Enhanced Pre-training for Language Understanding and Generation[J]. arXiv preprint arXiv:2107.02137, 2021. [5] Hou L, Huang Z, Shang L, Jiang X, Chen X and Liu Q. DynaBERT: Dynamic BERT with Adaptive Width and Depth[J]. arXiv preprint arXiv:2004.04037, 2020.[6] Wu H, Judd P, Zhang X, Isaev M and Micikevicius P. Integer Quantization for Deep Learning Inference: Principles and Empirical Evaluation[J]. arXiv preprint arXiv:2004.09602v1, 2020.

优秀的个人博客,低调大师

Perl 指导委员会谈发展战略: Perl 7 没那么快发布

随着 Perl 5.36 即将发布,Perl 指导委员会在一篇博客中谈论了 Perl 语言当前的发展策略以及未来的发展计划,同时也解答了一些常见的问题。 谁在决定 Perl 的方向? 2020 年 6 月,Perl 官方宣布 Perl 7 计划。Perl 7 的一个关键想法是通过启用许多广泛使用的模块/编译指示,来减少代码顶部所需的样板,但这将以破坏一些向后兼容性为代价。 该想法引发了很多激烈的讨论,有些人认为抛弃 Perl 的关键优势“向后兼容性”是非常糟糕的想法,另一些人则认为墨守成规得不到更好的发展。 这些讨论引发了另一个新问题:谁有权利决定 Perl 的发展方向和具体计划?原作者 Larry Wall ?但他已经有近 20 年没有参与 Perl 的开发了。最终,社区在讨论之后创建了一个新的治理结构 :为 Perl 5 作出最多贡献的核心团队通过选举推出三个人,这三个人组成的 Perl 指导委员会(PSC) 拥有 Perl 未来的最终决策权。 Perl 当前发展战略 第一届 PSC 在 2020 年底当选,随后为 Perl 制定了如下的战略: 现有的合理编写的 Perl 5 代码应该能在未来的 Perl 版本下继续运行(继续保持向后兼容性)。但有时这是不可能的,比如某些安全漏洞可能需要破坏向后兼容性的更改才能修复。 推动语言向前发展,提高引入新功能的速度。所以引入了 RFC 流程,任何人都可以使用该流程来对 Perl 语言提出修改。 让人们更容易使用这些新功能。 该策略的核心是功能保护和版本包捆绑。 特性保护 如果一个新的语言特性不能向后兼容,那么它就会受到“特性保护”的保护。比如 ,Perl 5.010 引入了 say 关键字。但默认情况下无法启用它,因为有人可能在代码中有一个 say 函数,那么新的关键字就会与之冲突。因此需要用到 feature pragma (编译指示功能): use feature 'say'; say "hello, world"; 但并不是所有的新语言特性都有保护。如果新的语法,在所有旧版本的 Perl 中都会导致语法错误,那么就不需要保护了。例如,Perl 5.36.0 引入了新的语法,允许一次从一个列表中处理 N 项: foreach my ($key, $value) (%hash) { … } 这个新语法没有特性保护,所以可以在第 0 行使用 (即在use v5.36 之前)。 版本包捆绑 Perl 5.36.0 引入了版本包捆绑(Version bundles)功能,解决了 Perl 被诟病已久的“样板文件” 问题。该功能只需将这一行放在代码顶部: use v5.36; 这一行相当于以前的: require v5.36; use strict; use warnings; use feature 'say'; use feature 'state'; use feature 'current_sub'; use feature 'fc'; use feature 'lexical_subs'; use feature 'signatures'; use feature 'isa'; use feature 'bareword_filehandles'; use feature 'bitwise'; use feature 'evalbytes'; use feature 'postderef_qq'; use feature 'unicode_eval'; use feature 'unicode_strings'; no feature 'indirect'; no feature 'multidimensional'; 也就是说,版本包捆绑功能,让开发者使用简单的use v...; 语句即可达成这些效果: 告诉 perl 解释器和人类读者,当前代码需要 perl 5.36.0 或更高版本才能运行; 支持当前版本 Perl 提供的所有非实验性功能; 使用了许多已被广泛实践过的附加编译指示。 该功能极大地减少了在代码顶部编写的样板文件,解决了 Perl 这个诟病已久的问题。 Perl 7 咋样了? 目前,Perl 的计划是继续引入新功能,并解决所有现有的实验性功能,实验性功能要么被删除,要么成为非实验性功能(包含在版本包捆绑中)。 在未来的某个时候,Perl 指导委员会可能会认为:这些新的功能加在一起,代表了一个足够大的进步,足以证明 Perl 的新方向是正确的。如果发生这种情况,那么 Perl 版本将被提升到 7.0。 我们有很多好的想法在工作中,如果我们能够保持去年的势头,那么事情看起来很有希望。与此同时,我们将继续发布 5.XX 版本。(画饼大师?) 即使 Perl 版本将被提升到 7.0,默认情况下 Perl 7 仍将向后兼容 Perl 5 —— 必须将 use v7; 放在代码顶部,才能使用 V7 所有新功能。 感兴趣的朋友可以移步Perl 指导委员会的博客作进一步阅读。

优秀的个人博客,低调大师

海量数据分析快准稳!GaussDB(for MySQL) HTAP只读分析特性详解

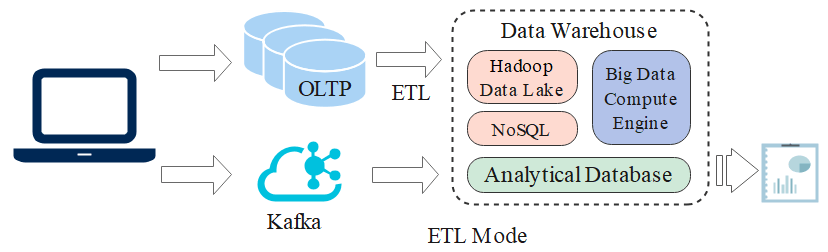
摘要:除了拥有 ClickHouse 本身的极致性能外,GaussDB(for MySQL)的HTAP只读分析在 MaterilizeMySQL引擎的性能和稳定性等方面具有更优秀的表现,为提供更快更准的数据分析保驾护航。 引言 HTAP(Hybrid Transactional/Analytical Processing)这个词相信大家最近经常会听到,它能够同时支撑在线事务处理(On-Line Transactional Processing, 简称OLTP) 和在线数据分析 (On-Line Analytical Processing, 简称 OLAP)。令人惊喜的是,ClickHouse 作为近年来炙手可热的大数据分析系统可以通过 MaterializeMySQL 引擎挂载为 MySQL 的从库,作为 MySQL 的 "协处理器" 面向 OLAP 场景提供高效数据分析能力,这对解决异构数据库之间数据共享问题提供了新的途径。我们可以充分发挥 ClickHouse 的分析性能,结合 TP 类引擎如 MySQL 等提供 HTAP 能力。然而实际应用场景中 ClickHouse 仍然面临一些挑战,因此 GaussDB(for MySQL)的HTAP只读分析应运而生,除了拥有 ClickHouse 本身的极致性能外,GaussDB(for MySQL)的HTAP只读分析在 MaterilizeMySQL引擎的性能和稳定性等方面具有更优秀的表现,为提供更快更准的数据分析保驾护航。 背景 大数据时代的到来,数据量急剧增长的同时用户结构也越来越多样化,这些用户处理数据时发现,仅仅是创建一个可视化报表需要经过数据的抽取 (Extract), 转换 (Transform) 和装载 (Load), 整个周期可能长达数日甚至数周。事实上,ETL 模式的优点在于能够结合数据湖等处理多源数据,低成本处理海量数据且生态较完善,当然缺点也十分明显,传统的数据仓库和数据湖等无法支持大量实时并发的更新,数据分析时效性较低。除此之外,ETL 模式应对变化的能力也相对较弱,如上游数据源发生变化(例如表结构的变化等),整个数据链的处理过程都需要做相应的修改,增加了数据维护的难度。 如何追求实时分析呢?答案是 HTAP。HTAP 可以支持大量并发的更新且数据同步时延通常在在秒级或毫秒级,有效避免传统解决方案中数据抽取,转换和装载等繁琐步骤,极大提升数据处理的时效性。 极致性能-ClickHouse ClickHouse ClickHouse 是 Yandex 公司开源的面向 OLAP 的分布式列式数据库,具有实时查询、完备的DBMS、高效数据压缩压缩,支持批量更新及高可用等特性。此外,ClickHouse 拥有非常完善的SQL支持以及开箱即用等许多特点。在官方公布的基准测试对比中,ClickHouse 遥遥领先对手。 Row Store & Column Store MySQL 存储采用的 Row Store,表中数据按照 Row 为逻辑存储单元在存储介质中连续存储。这种存储方式适合随机的增删改查操作,对于按行查询较为友好。但如果选择查询的目标只涉及一行中少数几个属性,Row 存储方式也不得不将所有行全部遍历再筛选出目标属性,当数据表很宽(表的属性很多)时,查询效率通常较低。尽管索引等优化方案在 OLTP 应用场景中能够提升一定效率,但是在面对海量数据背景的 OLAP 场景仍然显得有些力不从心。 ClickHouse 则采用的是 Column Store,表中数据按照 Column 为逻辑存储单元在存储介质中连续存储。这种存储方式适合采用 SIMD (Single Instruction Multiple Data) 并发处理数据,恰恰弥补了 Row Store 存储方式的缺陷,尤其在大宽表(属性很多)的时候,查询效率明显提升。此外,列存方式相邻数据类型相同,因此天然适合数据压缩,从而达到极致的数据压缩比。 Performance 下表是 Yandex 公司官方公布的性能测试数据,数据集 100 million,从上至下的三条数据分别表示:Cold Cache,Second Round,Third Round 的查询响应时间,可以看出 ClickHouse 的性能遥遥领先各大数据库引擎,相比于MySQL而言,性能甚至高达600多倍。 注:以下实验数据均为单节点:2 * Intel (R) Xeon (R) CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 on 8 6TB SATA HDD; ext4. 巨人肩膀上的 GaussDB(for MySQL) HTAP只读分析 尽管 ClickHouse 拥有如此极致的性能,但实践生产过程中仍然面临一些困境。比如存在数据类型不支持,全量复制性能问题等方面的挑战。此外也有一些与引擎本身设计有关的性能问题:比如 FINAL 去重导致的查询性能问题等,给用户使用过程带来一些不好的体验。 全量并行复制 MaterializeMySQL 引擎通过消费 BinLog 的方式来订阅 MySQL 数据。数据同步过程分为三个步骤,首先是检验源端 MySQL 参数是否符合规范,然后是全量和增量复制阶段。ClickHouse 数据同步的全量复制过程是单线程的,在数据量较大时复制时延较高。GaussDB(for MySQL) HTAP只读分析对全量复制进行了并行化处理,优化后的复制性能平均提升 8-10 倍,对实际生产实践是十分有意义的。 MVCC & Snapshot MaterializeMySQL 引擎在 DDL 转化过程中默认增加了2个隐藏字段:_sign (-1删除, 1插入/更新) 和 _version (数据版本)。下方是同一张表在 MySQL 和 ClickHouse 里的 DDL: MaterializeMySQL 引擎当前不提供 MySQL 数据的事务一致性视图,数据行以批量插入的方式同步到 ClickHouse 中,引擎底层使用的是 ReplacingMergeTree。如果数据发生了修改,获取最新的数据时需要指定 FINAL(类似于 GROUP BY)去重,并使用过滤器隐藏已删除的行。然而当数据规模很大时,FINAL 操作的性能往往不太理想。 为了感知事务,GaussDB(for MySQL) HTAP只读分析实现了事务一致性并提供四种隔离级别,用户可以根据具体使用场景选择不同的隔离级别。此外,GaussDB(for MySQL) HTAP只读分析还提供了快照功能,优化 FINAL 带来的查询性能问题。 FINAL 性能优化 前面提到 MaterializeMySQL 底层使用的是 ReplacingMergeTree,该引擎后台会按照一定规则执行 Merge 操作,用户想要获得最新数据则必须通过 FINAL 操作去重。除了采用 MVCC + Snapshot 机制保障查询性能外,GaussDB(for MySQL) HTAP只读分析从索引以及过滤策略等方面对 ReplacingMergeTree 引擎本身的 FINAL 操作进行了优化,即使不依赖 MVCC + Snapshot 也能提供不错的查询性能。 GaussDB(for MySQL) HTAP只读分析兼容性及稳定性 类型支持增强 MySQL 和 ClickHouse 的基本数据类型之间都有对应的映射关系(见下表),值得一提的是 ClickHouse 将不支持的 MySQL 数据类型都转换为 String 类型存储。MySQL 不支持的 ClickHouse 类型也都被转换为 MYSQL_TYPE_STRING 类型。从下表中不难看出,ClickHouse 仍有一部分数据类型还未支持,而这部分数据类型在实际应用场景中是有可能出现的,因此 GaussDB(for MySQL) HTAP只读分析针对常用的数据类型例如 BIT 和 TIME 以及 YEAR 等做了适配,解决部分用户的刚要需求。 Unique Key 同步支持 MaterializeMySQL 引擎当前仅支持含有 Primary Key 的表同步,现实生产过程中是可能存在一些表格没有主键,但却含有 Unique Key 的,因此有必要支持这种表的数据同步。GaussDB(for MySQL) HTAP只读分析对仅含有 Unique Key (NOT NULL) 的表单独处理,使用 Unique Key 进行分区。 优雅的复制中断重连 实际应用过程中,全量数据复制的数据规模通常较大,同步时间较长,复制中断(网络,MySQL服务端宕机等)的情况是有可能发生的,ClickHouse 遇到上述情况时选择终止当前库的同步并返回错误。为了提升数据同步的稳定性,GaussDB(for MySQL) HTAP只读分析针对 MaterializeMySQL 引擎设计了重连,当中断发生时清理现场并在一定时间间隔内进行重连。与全量复制中断重连不同的是,增量复制中断后不需要清理现场,这与增量复制的方式有关,增量复制基于 BinLog Event,已经增量同步成功的数据不需要重新再来一次,重新建立连接后会根据全局 GTID 找到最新的同步点开始同步。 更完备的异常处理机制 GaussDB(for MySQL) HTAP只读分析不仅引入了 MVCC + Snapshot 以及并行复制等新特性,也为内核嵌入了更完备的异常处理机制。以全量并行复制为例,GaussDB(for MySQL) HTAP只读分析为所有并行线程维护独立的异常处理信息和堆栈。在新的异常处理机制下 GaussDB(for MySQL) HTAP只读分析更加稳定,更容易帮助用户发觉潜在问题的根源。 GaussDB(for MySQL) HTAP只读分析个性化定制 Show Slave Status 支持 GaussDB(for MySQL) HTAP只读分析为用户提供了类似 MySQL 主备间的 SHOW SLAVE STATUS 指令,通过该指令可以直观地获取 MaterializeMySQL 引擎同步的数据库状态。这些状态信息除了反应同步线程是否异常之外,还涵盖了当前复制的 BinLog 位点,GITD 以及 Second Behind Master 等有价值的信息,为用户运维提供极大方便。 ALTER Database 支持 Alter Database 为 MaterializeMySQL 引擎用户提供了如下操作: 表定义重写 Override 为了提供个性化的建库同步操作,GaussDB(for MySQL) HTAP只读分析为 MaterializeMySQL 引擎增加了 Over Write 功能,用户可以覆盖指定表的列并添加新列,添加索引并覆盖 PARTITION BY 或 SAMPLE BY 字段,使用示例如下: 适配 MySQL Partition 数据分区是提升数据库使用性能的重要途径之一,ClickHouse 的分区策略是优先考虑日期,否则会选择类型长度较小的字段做哈希处理并进行分区。可以看到,ClickHouse 的分区策略和 MySQL 有一定区别,为了尽可能的支持 MySQL 的分区策略, GaussDB(for MySQL) HTAP只读分析目前支持 Range 分区,如果建表语句里没有 Range 分区,则使用 ClickHouse 默认的分区策略。 黑/白名单过滤 MaterializeMySQL 引擎建立的数据同步是库级的,意味着默认情况下会尝试将该库所有表全部复制,在某些实际应用场景中往往不需要复制全部的表,或者说有些表本身不适合复制(例如没有 Primary Key 或者 NOT NULL 的 Unique Key),GaussDB(for MySQL) HTAP只读分析不希望因为部分表无法复制导致整个库的复制失败,而是能够有选择的进行复制。GaussDB(for MySQL) HTAP只读分析针对这个问题设计了黑/白名单的过滤,允许用户自定义需要复制的表,这在生产应用是十分有意义的,用法参考如下: 场景示例 前文分析了许多 GaussDB(for MySQL) HTAP只读分析的优点,那 GaussDB(for MySQL) HTAP只读分析到底能提供什么样的解决方案,为用户解决数据难题呢? 上图以 MySQL + GaussDB(for MySQL) HTAP只读分析为例,用户既能得到 MySQL 完备的事务保障,又能享受到 GaussDB(for MySQL) HTAP只读分析的极致分析性能。用户从不同渠道获取数据并加载到 MySQL 引擎,GaussDB(for MySQL) HTAP只读分析作为 MySQL 的 “从库” 实时同步用户数据并提供高效的数据分析能力。 高实效性 与传统 ETL(T + 1)方案不同,GaussDB(for MySQL) HTAP只读分析搭配 MySQL 的 HTAP 解决方案能够提供秒级数据同步。 数据压缩 GaussDB(for MySQL) HTAP只读分析底层存储采取 Column Store,这种存储形式天然适合数据压缩,因此 GaussDB(for MySQL) HTAP只读分析拥有极致的数据压缩比,同等条件下能够为用户节约大量存储成本。 历史备份 相比在 MySQL 中备份,GaussDB(for MySQL) HTAP只读分析的存储成本更低,某些场景下更适合用于历史数据备份。 存储分层 为了进一步降低用户存储成本,GaussDB(for MySQL) HTAP只读分析提供 ESSD + EVS + OBS 分层存储方案,将热数据温数据和冷数据分别存在不同的存储介质中,进一步降低存储成本。 小结 HTAP 虽然不是一个非常新的概念,但随着现阶段数据业务越来越模糊(AP业务TP化 ,TP业务AP化),这个概念又重新回到了人们的视线。用户对数据处理和消费需求的不断迭代和升级,也为 HTAP 的发展创造了更多机会。GaussDB(for MySQL) HTAP只读分析站在 ClickHouse 极致性能的肩膀上针对实际生产遇到的问题做了一系列优化,获得更快更好的使用体验。相信未来 HTAP 的竞争会愈演愈烈,这对 GaussDB(for MySQL) HTAP只读分析来说既是挑战也是机会, GaussDB(for MySQL) HTAP只读分析会继续为用户提供海量数据的高效解决方案,助力企业数字化转型。更多产品了解,请戳https://www.huaweicloud.com/product/gaussdb_mysql.html 注:该功能目前在邀请测试阶段,想体验的小伙伴们欢迎评论区留言! 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

esbuild 0.9.0 发布,比 Webpack 快 100 倍的打包和压缩工具

esbuild0.9.0 已发布,此版本包含不向后兼容的变更。主要变化如下: 支持package.json文件中节点的exports字段(#187) 删除esbuild.startService()API 从outputFiles中删除metafile(#633) 扩展名.mjs和.cjs不再是隐式状态 删除--summaryflag(#704) 将--error-limit=重命名为--log-limit= 删除被弃用的--avoid-tdz选项 从 Go API 删除SpinnerBusy和SpinnerIdle …… 详情查看 release notes。 esbuild 是 Go 编写的 JavaScript 打包和压缩工具,支持 TypeScript。 根据项目介绍中的 Benchmark测试结果,在使用同一份代码 (three.js) 的情况下,esbuild 比其他打包工具(rollup / webpack / parcel 等)快了至少 100 倍。Vue.js 作者尤雨溪的新工具Vite也是基于 esbuild 转换库来添加对 TypeScript 的支持。 主要特性 速度极快,无需缓存 支持 ES6 和 CommonJS 模块 支持Tree shaking 适用于 Go 和 JavaScript 的API 支持TypeScript和JSX语法 生成Source map 插件 加载器 压缩&打包 …… 延伸阅读 Vite 2.0 发布

优秀的个人博客,低调大师

sureness GA 啦,比 Shiro、Spring Security 快几倍,面向 rest 的安全框架

大家周一好,经过22个版本的迭代到v1.0.0,很高兴激动宣布面向rest api的安全框架-sureness,正式GA啦。 📫 背景 在主流的前后端分离架构中,如何通过有效快速的认证鉴权来保护后端提供的restful api变得尤为重要。对现存框架,不原生支持rest的apache shiro, 还是深度绑定spring,较慢性能,学习曲线陡峭的spring security,或多或少都不是我们的理想型。 于是乎sureness诞生了,我们希望能解决这些,提供一个面向restful api,无框架依赖,可以动态修改权限,多认证策略,更快速度,易用易扩展的认证鉴权框架。 🎡 介绍 sureness 是我们在深度使用权限框架 apache shiro 之后,吸取其一些优点全新设计开发的一个认证鉴权框架 1. 面向 restful api 的认证鉴权,基于 rbac (用户-角色-资源)主要关注于对 restful api 的安全保护 2. 无特定框架依赖(本质就是过滤器处拦截判断,已有springboot,quarkus,javalin,ktor等集成样例) 3. 支持动态修改权限配置(动态修改配置每个rest api谁有权访问) 4. 支持 websocket ,主流http容器 servlet 和 jax-rs 5. 支持多种认证策略, jwt, basic auth, digest auth ... 可扩展自定义支持的认证方式 6. 基于改进的字典匹配树拥有的高性能 7. 良好的扩展接口, 样例和文档 sureness的低配置,易扩展,不耦合其他框架,希望能帮助开发者对自己的项目多场景快速安全的进行保护 🔍 框架对比 ~ sureness shiro spring security 多框架支持 支持 需改动支持 不支持 restful api 支持 需改动支持 支持 websocket 支持 不支持 不支持 过滤链匹配 优化的字典匹配树 ant匹配 ant匹配 注解支持 支持 支持 支持 servlet 支持 支持 支持 jax-rs 支持 不支持 不支持 权限动态修改 支持 需改动支持 需改动支持 性能速度 较快 较慢 较慢 学习曲线 简单 简单 陡峭 📈 基准性能测试 基准测试显示sureness对比无权限框架应用损耗0.026ms性能,shiro损耗0.088ms,spring security损耗0.116ms, 相比之下sureness基本不消耗性能,且性能(参考TPS损耗)是shiro的3倍,spring security的4倍 性能差距会随着api匹配链的增加而进一步拉大 详见基准测试 ✌ 框架支持样例 [√] sureness集成springboot样例(配置文件方案) sample-bootstrap [√] sureness集成springboot样例(数据库方案) sample-tom [√] sureness集成quarkus样例 sample-quarkus [√] sureness集成javalin样例 sample-javalin [√] sureness集成ktor样例 sample-ktor [√] sureness集成spring webflux样例 sample-spring-webflux [√] more samples todo 项目仓库地址,欢迎使用,开源不易,觉得不错请大佬们star下给予鼓励,弯腰感谢。 GITEE仓库地址 GITHUB仓库地址

优秀的个人博客,低调大师

因在Java中不会优雅地判空,被CTO屌的快哭了。。。

判空灾难 作为搬砖党的一族们,我们对判空一定再熟悉不过了,不要跟我说你很少进行判空,除非你喜欢NullPointerException。 不过NullPointerException对于很多猿们来说,也是Exception家族中最亲近的一员了。 为了避免NullPointerException来找我们,我们经常会进行如下操作。 if (data != null) { do sth. } 如果一个类中多次使用某个对象,那你可能要一顿操作,so: “世界第九大奇迹”就这样诞生了。Maybe你会想,项目中肯定不止你一个人会这样一顿操作,然后按下Command+Shift+F,真相就在眼前: What,我们有接近一万行的代码都是在判空? 好了,接下来,要进入正题了。 NullObject模式 对于项目中无数次的判空,对代码质量整洁度产生了十分之恶劣的影响,对于这种现象,我们称之为“判空灾难”。 那么,这种现象如何治理呢,你可能听说过NullObject模式,不过这不是我们今天的武器,但是还是需要介绍一下NullObject模式。 什么是NullObject模式呢? In object-oriented computer programming, a null object is an object with no referenced value or with defined neutral ("null") behavior. The null object design pattern describes the uses of such objects and their behavior (or lack thereof). 以上解析来自Wikipedia。 NullObject模式首次发表在“ 程序设计模式语言 ”系列丛书中。一般的,在面向对象语言中,对对象的调用前需要使用判空检查,来判断这些对象是否为空,因为在空引用上无法调用所需方法。 空对象模式的一种典型实现方式如下图所示(图片来自网络): 示例代码如下(命名来自网络,哈哈到底是有多懒): Nullable是空对象的相关操作接口,用于确定对象是否为空,因为在空对象模式中,对象为空会被包装成一个Object,成为Null Object,该对象会对原有对象的所有方法进行空实现… public interface Nullable { boolean isNull(); } 这个接口定义了业务对象的行为。 public interface DependencyBase extends Nullable { void Operation(); } 这是该对象的真实类,实现了业务行为接口DependencyBase与空对象操作接口Nullable。 public class Dependency implements DependencyBase, Nullable { @Override public void Operation() { System.out.print("Test!"); } @Override public boolean isNull() { return false; } } 这是空对象,对原有对象的行为进行了空实现。 public class NullObject implements DependencyBase{ @Override public void Operation() { // do nothing } @Override public boolean isNull() { return true; } } 在使用时,可以通过工厂调用方式来进行空对象的调用,也可以通过其他如反射的方式对对象进行调用(一般多耗时几毫秒)在此不进行详细叙述。 public class Factory { public static DependencyBase get(Nullable dependencyBase){ if (dependencyBase == null){ return new NullObject(); } return new Dependency(); } } 这是一个使用范例,通过这种模式,我们不再需要进行对象的判空操作,而是可以直接使用对象,也不必担心NPE(NullPointerException)的问题。 public class Client { public void test(DependencyBase dependencyBase){ Factory.get(dependencyBase).Operation(); } } 关于空对象模式,更具体的内容大家也可以多找一找资料,上述只是对NullObject的简单介绍,但是,今天我要推荐的是一款协助判空的插件NR Null Object,让我们来优雅地进行判空,不再进行一顿操作来定义繁琐的空对象接口与空独享实现类。 .NR Null Object NR Null Object是一款适用于Android Studio、IntelliJ IDEA、PhpStorm、WebStorm、PyCharm、RubyMine、AppCode、CLion、GoLand、DataGrip等IDEA的Intellij插件。其可以根据现有对象,便捷快速生成其空对象模式需要的组成成分,其包含功能如下: 1、分析所选类可声明为接口的方法; 2、抽象出公有接口; 3、创建空对象,自动实现公有接口; 4、对部分函数进行可为空声明; 5、可追加函数进行再次生成; 6、自动的函数命名规范 让我们来看一个使用范例: 怎么样,看起来是不是非常快速便捷,只需要在原有需要进行多次判空的对象中,邮件弹出菜单,选择Generate,并选择NR Null Object即可自动生成相应的空对象组件。 那么如何来获得这款插件呢? 安装方式 可以直接通过IDEA的Preferences中的Plugins仓库进行安装。 选择 Preferences → Plugins → Browse repositories 搜索“NR Null Oject”或者“Null Oject”进行模糊查询,点击右侧的Install,restart IDEA即可。 Optional 还有一种方式是使用Java8特性中的Optional来进行优雅地判空,Optional来自官方的介绍如下: A container object which may or may not contain a non-null value. If a value is present, isPresent() will return true and get() will return the value. 一个可能包含也可能不包含非null值的容器对象。如果存在值,isPresent()将返回true,get()将返回该值。 话不多说,举个例子。 有如下代码,需要获得Test2中的Info信息,但是参数为Test4,我们要一层层的申请,每一层都获得的对象都可能是空,最后的代码看起来就像这样。 public String testSimple(Test4 test) { if (test == null) { return ""; } if (test.getTest3() == null) { return ""; } if (test.getTest3().getTest2() == null) { return ""; } if (test.getTest3().getTest2().getInfo() == null) { return ""; } return test.getTest3().getTest2().getInfo(); } 但是使用Optional后,整个就都不一样了。 public String testOptional(Test test) { return Optional.ofNullable(test).flatMap(Test::getTest3) .flatMap(Test3::getTest2) .map(Test2::getInfo) .orElse(""); } 1、Optional.ofNullable(test),如果test为空,则返回一个单例空Optional对象,如果非空则返回一个Optional包装对象,Optional将test包装; public static <T> Optional<T> ofNullable(T value) { return value == null ? empty() : of(value); } 2、flatMap(Test::getTest3)判断test是否为空,如果为空,继续返回第一步中的单例Optional对象,否则调用Test的getTest3方法; public<U> Optional<U> flatMap(Function<? super T, Optional<U>> mapper) { Objects.requireNonNull(mapper); if (!isPresent()) return empty(); else { return Objects.requireNonNull(mapper.apply(value)); } } 3、flatMap(Test3::getTest2)同上调用Test3的getTest2方法; 4、map(Test2::getInfo)同flatMap类似,但是flatMap要求Test3::getTest2返回值为Optional类型,而map不需要,flatMap不会多层包装,map返回会再次包装Optional; public<U> Optional<U> map(Function<? super T, ? extends U> mapper) { Objects.requireNonNull(mapper); if (!isPresent()) return empty(); else { return Optional.ofNullable(mapper.apply(value)); } } 5、orElse("");获得map中的value,不为空则直接返回value,为空则返回传入的参数作为默认值。 public T orElse(T other) { return value != null ? value : other; } 怎么样,使用Optional后我们的代码是不是瞬间变得非常整洁,或许看到这段代码你会有很多疑问,针对复杂的一长串判空,Optional有它的优势,但是对于简单的判空使用Optional也会增加代码的阅读成本、编码量以及团队新成员的学习成本。毕竟Optional在现在还并没有像RxJava那样流行,它还拥有一定的局限性。 如果直接使用Java8中的Optional,需要保证安卓API级别在24及以上。 你也可以直接引入Google的Guava。(啥是Guava?来自官方的提示) Guava is a set of core libraries that includes new collection types (such as multimap and multiset), immutable collections, a graph library, functional types, an in-memory cache, and APIs/utilities for concurrency, I/O, hashing, primitives, reflection, string processing, and much more! 引用方式,就像这样: dependencies { compile 'com.google.guava:guava:27.0-jre' // or, for Android: api 'com.google.guava:guava:27.0-android' } 不过IDEA默认会显示黄色,提示让你将Guava表达式迁移到Java Api上。 当然,你也可以通过在Preferences搜索"Guava"来Kill掉这个Yellow的提示。 关于Optional使用还有很多技巧,感兴趣可以查阅Guava和Java8相关书籍和文档。 使用Optional具有如下优点: 将防御式编程代码完美包装 链式调用 有效避免程序代码中的空指针 但是也同样具有一些缺点: 流行性不是非常理想,团队新成员需要学习成本 安卓中需要引入Guava,需要团队每个人处理IDEA默认提示,或者忍受黄色提示 有时候代码阅读看起来可能会如下图所示: Kotlin 当然,Kotlin以具有优秀的空安全性为一大特色,并可以与Java很好的混合使用,like this: test1?.test2?.test3?.test4 如果你已经开始使用了Kotlin,可以不用再写缭乱的防御判空语句。如果你还没有使用Kotlin,并不推荐为了判空优雅而直接转向Kotlin。

优秀的个人博客,低调大师

快60倍!分析型数据库 AnalyticDB for PostgreSQL 版 6.0 启动商用。

信息摘要: 分析型数据库 PostgreSQL6.0 商业化,新一代在线数据仓库服务,事务处理速度提升60倍适用客户: 金融/新零售/数字政务/互联网金融/电子商务/版本/规格功能: AnalyticDB PostgreSQL 6.0 产品性能和功能大幅提升。 首先 6.0 版本提升了在混合事务分析( HTAP)场景的服务性能,在线事务事务处理能力大幅提升,短查询性能相比较线上4.3版提高 70倍;同时 6.0 加强了对于半结构化数据类型的支持能力,支持存储,搜索、分析和查询半结构化文件,支持 JSONb和HSTORE Data Types 类型,大大拓展了大数据分析的业务应用领域和场景;另外 6.0 版本针对关联查询场景也提供了复制表功能,实现维度小表与本地数据表实时关联查询,避免数据在集群内迁移,分析性能达到进一步优化提升,是企业构建企业实时数仓的最佳解决方案! 架构案例:https://promotion.aliyun.com/ntms/act/adbrdsdatawarnhouseshangyehua.html?wh_ttid=pc技术深度解析:https://yq.aliyun.com/articles/741094产品文档: https://help.aliyun.com/document_detail/146972.html?spm=a2c4g.11174283.6.542.1b667dafrvoXQf

优秀的个人博客,低调大师

Dapps 上架 AriaNg 应用,比迅雷快两倍的下载速度

介绍 是一个应用程序商店,包含丰富的软件,一键安装程序;多版本共存。 官网文档:dapps应用商店 新增内容: AriaNg下载工具,使用效果比迅雷好太多,建议代替迅雷 速度优化及修改 目前包含的软件 AriaNg 高速下载器 ------查看效果 BaiduPCS-Go百度网盘客户端------查看效果 wordpress ------查看效果 py12306抢票 ------查看效果 magnetw: 种子搜索神器 ------查看效果 PhpMyAdmin:mysql管理工具 ------查看效果 adminmongo: mongo管理工具 ------查看效果 PHP: 世界上最好的语言(版本:5.6,7.1,7.2,7.3)------查看效果 Mysql:数据库(版本:5.6,5.7,,8.0)------查看效果 Nginx:服务器(版本:1.16)------查看效果 redis:nosql数据库(版本:5.0)------查看效果 mongo:是一个基于分布式文件存储的数据库(版本:3.4,4.0)------查看效果 gogs版本控制 ------查看效果 rabbitmq3.7队列服务 ------查看效果 2048游戏 ------查看效果 等...... dapps应用商店中直接安装 使用文档:查看 效果:

优秀的个人博客,低调大师

《快学 Go 语言》第 2 课 —— 变量什么的最讨厌了

任何一门语言里面最基础的莫过于变量了。如果把内存比喻成一格一格整齐排列的储物箱,那么变量就是每个储物箱的标识,我们通过变量来访问计算机内存。没有变量的程序对于人类来说是可怕的,需要我们用数字位置来定位内存的格子,人类极不擅长这样的事。这就好比一岁半左右的幼儿还没有学会很多名词,只能用手来对物体指指点点来表达自己的喜好。变量让程序逻辑有了丰富的表达形式。 定义变量的三种方式 Go 语言的变量定义有多种形式,我们先看最繁琐的形式 package mainimport "fmt"func main() {var s int = 42 fmt.Println(s) } -------------42 注意到我们使用了 var 关键字,它就是用来显式定义变量的。还注意到在变量名称 s 后面声明了变量的类型为整形 int,然后再给它赋上了一个初值 42。上面的变量定义可以简化,将类型去掉,因为编译器会自动推导变量类型,效果也是一样的,如下 package mainimport "fmt"func main() {var s = 42 fmt.Println(s) } ---------------42 更进一步,上面的变量定义还可以再一次简化,去掉 var 关键字。 package mainimport "fmt"func main() {s := 42 fmt.Println(s) }--------------- 42 注意到赋值的等号变成了 :=,它表示变量的「自动类型推导 + 赋值」。 这三种变量定义方式都是可行的,各有其优缺点。可读性最强的是第一种,写起来最方便的是第三种,第二种是介于两者之间的形式。 类型是变量身份的象征,如果一个变量不那么在乎自己的身份,那在形式上就可以随意一些。var 的意思就是告诉读者「我很重要,你要注意」,:= 的意思是告诉读者「我很随意,别把我当回事」。var 再带上显式的类型信息是为了方便读者快速识别变量的身份。 如果一个变量很重要,建议使用第一种显式声明类型的方式来定义,比如全局变量的定义就比较偏好第一种定义方式。如果要使用一个不那么重要的局部变量,就可以使用第三种。比如循环下标变量 for i:=0; i<10; i++ { doSomething() } 那第二种方式能不能用在上面的循环下标中呢,答案是不可以,你无法将 var 关键字直接写进循环条件中的初始化语句中,而必须提前声明变量,像下面这样,这时就很明显不如简写的形式了 var i = 0for ; i<10; i++ { doSomething() } 如果在第一种声明变量的时候不赋初值,编译器就会自动赋予相应类型的「零值」,不同类型的零值不尽相同,比如字符串的零值不是 nil,而是空串,整形的零值就是 0 ,布尔类型的零值是 false。 package mainimport "fmt"func main() {var i int fmt.Println(i) } -----------0 全局变量和局部变量 上面我们在代码例子中编写的变量都是局部变量,它定义在函数内部,函数调用结束它就消亡了。与之对应的是全局变量,在程序运行期间,它一直存在,它定义在函数外面。 package mainimport "fmt"var globali int = 24func main() {var locali int = 42 fmt.Println(globali, locali) } ---------------24 42 如果全局变量的首字母大写,那么它就是公开的全局变量。如果全局变量的首字母小写,那么它就是内部的全局变量。内部的全局变量只有当前包内的代码可以访问,外面包的代码是不能看见的。 学过 C 语言的同学可能会问,Go 语言里有没有静态变量呢?答案是没有。 变量与常量 Go 语言还提供了常量关键字 const,用于定义常量。常量可以是全局常量也可以是局部常量。你不可以修改常量,否则编译器会抱怨。常量必须初始化,因为它无法二次赋值。全局常量的大小写规则和变量是一致的。 package mainimport "fmt"const globali int = 24func main() {const locali int = 42 fmt.Println(globali, locali) } Go 语言被称为互联网时代的 C 语言,它延续使用了 C 语言的指针类型。 package mainimport "fmt"func main() {var value int = 42var pointer *int = &value fmt.Println(pointer, *pointer) } --------------0xc4200160a0 42 我们又看到了久违的指针符号 * 和取地址符 &,在功能和使用上同 C 语言几乎一摸一样。同 C 语言一样,指针还支持二级指针,三级指针,只不过在日常应用中,很少遇到。 package mainimport "fmt"func main() {var value int = 42var p1 *int = &valuevar p2 **int = &p1var p3 ***int = &p2 fmt.Println(p1, p2, p3) fmt.Println(*p1, **p2, ***p3) } ----------0xc4200160a0 0xc42000c028 0xc42000c03042 42 42 指针变量本质上就是一个整型变量,里面存储的值是另一个变量内存的地址。* 和 & 符号都只是它的语法糖,是用来在形式上方便使用和理解指针的。* 操作符存在两次内存读写,第一次获取指针变量的值,也就是内存地址,然后再去拿这个内存地址所在的变量内容。 图片 如果普通的变量是一个储物箱,那么指针变量就是另一个储物箱,这个储物箱里存放了普通变量所在储物箱的钥匙。通过多级指针来读取变量值就好比在玩一个解密游戏。 Go 语言基础类型大全 Go 语言定义了非常丰富的基础类型,下面我列举了所有的基础数据类型。 package mainimport "fmt"func main() {// 有符号整数,可以表示正负var a int8 = 1 // 1 字节var b int16 = 2 // 2 字节var c int32 = 3 // 4 字节var d int64 = 4 // 8 字节 fmt.Println(a, b, c, d)// 无符号整数,只能表示非负数var ua uint8 = 1var ub uint16 = 2var uc uint32 = 3var ud uint64 = 4 fmt.Println(ua, ub, uc, ud)// int 类型,在32位机器上占4个字节,在64位机器上占8个字节var e int = 5var ue uint = 5 fmt.Println(e, ue)// bool 类型var f bool = true fmt.Println(f)// 字节类型var j byte = 'a' fmt.Println(j)// 字符串类型var g string = "abcdefg" fmt.Println(g)// 浮点数var h float32 = 3.14var i float64 = 3.141592653 fmt.Println(h, i) } -------------1 2 3 41 2 3 45 5true abcdefg3.14 3.14159265397 还有另外几个不常用的数据类型,读者可以暂不理会。 复数类型 complex64 和 complex128 unicode字符类型 rune uintptr 指针类型 复数类型用于科学计算,平时基本上用不上。rune 和 uintptr 的用法在后续文章中会详细讲解。简单一点说 rune 和 byte 的关系就好比 Python 里面的 unicode 和 byte 、Java 语言里面的 char 和 byte 。uintptr 相当于 C 语言里面的 void* 指针类型。 下一节我们开讲 Go 语言的条件判断与循环语句 原文发布时间为: 2018-11-13 本文作者:码洞 本文来自云栖社区合作伙伴“码洞”,了解相关信息可以关注“码洞”。

优秀的个人博客,低调大师

快学 Go 语言第 2 课 —— 变量什么的最讨厌了

任何一门语言里面最基础的莫过于变量了。如果把内存比喻成一格一格整齐排列的储物箱,那么变量就是每个储物箱的标识,我们通过变量来访问计算机内存。没有变量的程序对于人类来说是可怕的,需要我们用数字位置来定位内存的格子,人类极不擅长这样的事。这就好比一岁半左右的幼儿还没有学会很多名词,只能用手来对物体指指点点来表达自己的喜好。变量让程序逻辑有了丰富的表达形式。 定义变量的三种方式 Go 语言的变量定义有多种形式,我们先看最繁琐的形式 package mainimport "fmt"func main() {var s int = 42 fmt.Println(s) } -------------42 注意到我们使用了 var 关键字,它就是用来显式定义变量的。还注意到在变量名称 s 后面声明了变量的类型为整形 int,然后再给它赋上了一个初值 42。上面的变量定义可以简化,将类型去掉,因为编译器会自动推导变量类型,效果也是一样的,如下 package mainimport "fmt"func main() {var s = 42 fmt.Println(s) } ---------------42 更进一步,上面的变量定义还可以再一次简化,去掉 var 关键字。 package mainimport "fmt"func main() {s := 42 fmt.Println(s) }--------------- 42 注意到赋值的等号变成了 :=,它表示变量的「自动类型推导 + 赋值」。 这三种变量定义方式都是可行的,各有其优缺点。可读性最强的是第一种,写起来最方便的是第三种,第二种是介于两者之间的形式。 类型是变量身份的象征,如果一个变量不那么在乎自己的身份,那在形式上就可以随意一些。var 的意思就是告诉读者「我很重要,你要注意」,:= 的意思是告诉读者「我很随意,别把我当回事」。var 再带上显式的类型信息是为了方便读者快速识别变量的身份。 如果一个变量很重要,建议使用第一种显式声明类型的方式来定义,比如全局变量的定义就比较偏好第一种定义方式。如果要使用一个不那么重要的局部变量,就可以使用第三种。比如循环下标变量 for i:=0; i<10; i++ { doSomething() } 那第二种方式能不能用在上面的循环下标中呢,答案是不可以,你无法将 var 关键字直接写进循环条件中的初始化语句中,而必须提前声明变量,像下面这样,这时就很明显不如简写的形式了 var i = 0for ; i<10; i++ { doSomething() } 如果在第一种声明变量的时候不赋初值,编译器就会自动赋予相应类型的「零值」,不同类型的零值不尽相同,比如字符串的零值不是 nil,而是空串,整形的零值就是 0 ,布尔类型的零值是 false。 package mainimport "fmt"func main() {var i int fmt.Println(i) } -----------0 上面我们在代码例子中编写的变量都是局部变量,它定义在函数内部,函数调用结束它就消亡了。与之对应的是全局变量,在程序运行期间,它一直存在,它定义在函数外面。 package mainimport "fmt"var globali int = 24func main() {var locali int = 42 fmt.Println(globali, locali) } ---------------24 42 如果全局变量的首字母大写,那么它就是公开的全局变量。如果全局变量的首字母小写,那么它就是内部的全局变量。内部的全局变量只有当前包内的代码可以访问,外面包的代码是不能看见的。 学过 C 语言的同学可能会问,Go 语言里有没有静态变量呢?答案是没有。 变量与常量 Go 语言还提供了常量关键字 const,用于定义常量。常量可以是全局常量也可以是局部常量。你不可以修改常量,否则编译器会抱怨。常量必须初始化,因为它无法二次赋值。全局常量的大小写规则和变量是一致的。 package mainimport "fmt"const globali int = 24func main() {const locali int = 42 fmt.Println(globali, locali) } Go 语言被称为互联网时代的 C 语言,它延续使用了 C 语言的指针类型。 package mainimport "fmt"func main() {var value int = 42var pointer *int = &value fmt.Println(pointer, *pointer) } --------------0xc4200160a0 42 我们又看到了久违的指针符号 * 和取地址符 &,在功能和使用上同 C 语言几乎一摸一样。同 C 语言一样,指针还支持二级指针,三级指针,只不过在日常应用中,很少遇到。 package mainimport "fmt"func main() {var value int = 42var p1 *int = &valuevar p2 **int = &p1var p3 ***int = &p2 fmt.Println(p1, p2, p3) fmt.Println(*p1, **p2, ***p3) } ----------0xc4200160a0 0xc42000c028 0xc42000c03042 42 42 指针变量本质上就是一个整型变量,里面存储的值是另一个变量内存的地址。* 和 & 符号都只是它的语法糖,是用来在形式上方便使用和理解指针的。* 操作符存在两次内存读写,第一次获取指针变量的值,也就是内存地址,然后再去拿这个内存地址所在的变量内容。 图片 如果普通的变量是一个储物箱,那么指针变量就是另一个储物箱,这个储物箱里存放了普通变量所在储物箱的钥匙。通过多级指针来读取变量值就好比在玩一个解密游戏。 Go 语言基础类型大全 Go 语言定义了非常丰富的基础类型,下面我列举了所有的基础数据类型。 package mainimport "fmt"func main() {// 有符号整数,可以表示正负var a int8 = 1 // 1 字节var b int16 = 2 // 2 字节var c int32 = 3 // 4 字节var d int64 = 4 // 8 字节 fmt.Println(a, b, c, d)// 无符号整数,只能表示非负数var ua uint8 = 1var ub uint16 = 2var uc uint32 = 3var ud uint64 = 4 fmt.Println(ua, ub, uc, ud)// int 类型,在32位机器上占4个字节,在64位机器上占8个字节var e int = 5var ue uint = 5 fmt.Println(e, ue)// bool 类型var f bool = true fmt.Println(f)// 字节类型var j byte = 'a' fmt.Println(j)// 字符串类型var g string = "abcdefg" fmt.Println(g)// 浮点数var h float32 = 3.14var i float64 = 3.141592653 fmt.Println(h, i) } -------------1 2 3 41 2 3 45 5true abcdefg3.14 3.14159265397 还有另外几个不常用的数据类型,读者可以暂不理会。 复数类型 complex64 和 complex128 unicode字符类型 rune 复数类型用于科学计算,平时基本上用不上。rune 和 uintptr 的用法在后续文章中会详细讲解。简单一点说 rune 和 byte 的关系就好比 Python 里面的 unicode 和 byte 、Java 语言里面的 char 和 byte 。uintptr 相当于 C 语言里面的 void* 指针类型。 uintptr 指针类型 原文发布时间为:2018-11-1 本文作者:码洞 本文来自云栖社区合作伙伴“码洞”,了解相关信息可以关注“码洞”。

优秀的个人博客,低调大师

区块链开发公司发展快 未来主要应用方向怎么走

近几年,区块链的概念越来越受到重视,多种行业专业人士也认为区块链技术将成为工业4.0的重要引擎。 简单理解,区块链中的“区块”指的是信息块,这个信息块内含有一个特殊的信息就是时间戳。含有时间戳的信息块彼此互连,形成的信息块链条被称为“区块链”。 1、财务管理行业 区块链应用的核心价值金融部门:促进反洗钱和客户鉴定审查。在块链的创新和应用中,金融是最重要的领域,而区块链应用技术在数字货币、支付清算、智能合同、金融交易和互联网等方面有着广泛的应用前景。由于其篡改时间戳和网络范围的开放性,已被广泛信赖的银行,证券,保险等金融部门,并在近几年已经疯狂的飙升,即使在许多国家,比特币已经成为一种合法的货币。 2、社会管理方面 区块链应用的社会领域核心价值:让用户控制数据,消除隐私泄露。总是会收到一个类似的广告窗口在其他社会平台,因为区块链应用的数据隐私是一个垄断的大型数据平台的可耻的销售。区块链应用技术实现中心向中心的转变,使数据的控制牢牢掌握在用户手中。 3、著作权保护方面 区块链应用中的版权领域的核心价值:重塑知识产权保护。区块链应用技术所有事务都记录在块中,记录的形成不能被篡改,因此可以跟踪和查询所有事务,以保护块链上的事务透明度,以避免网络用户非法使用知识产权保护内容。对于创作者来说,这是一种更方便、更安全、更便宜的版权保护方式。 4、物联网+区块链 IBM曾提出一个概念“运用区块链技术,可以为物联网的世界提供一个引人入胜的可能性,当产品最终完成组装时,可以由制造商注册到通用的区块链 里面标示着它生命周期的开始,一旦该产品售出,经销商可以把它注册到一个区域性的区块链上(社区、城市或国家),通过创建有形资产和匹配供给和需求,物联 网将会创造一个新的市场。” 区块链应用的核心是去中央和信任,服务佳的区块链应用对凭借智能合同技术的使用,可以自动执行操作,以满足一定的条件,还可以使更多的商品“共享”,大大降低了合同建立和执行的成本。区块链应用同适用于今天蓬勃发展的共享自行车行业,它可能会给该行业带来全新的变化。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册