首页 文章 精选 留言 我的

精选列表

搜索[多云部署],共10000篇文章
优秀的个人博客,低调大师

Flask环境github部署(十三)

(1) github项目搭建 1 连接GitHub hostnamectl set-hostname flask-dev # 设置 hostname,一般是主机名可以不更改 ssh-keygen # 生成SSH公钥,一直enter代表不设置密码 cd .ssh/ #存放秘钥文件,id_rsa是私钥文件,id_rsa.pub是公钥文件 vim id_rsa.pub #编辑秘钥,全部复制公钥添加到 账户settings >> SSH-keys >> add SSHkeys 2 配置git git config --global user.email "邮箱" #设置用户名与邮箱,作为标识 git config --global user.name "账户名" vim ~/.gitconfig #添加配置信息 [core] repositoryformatversion = 0 filemode = true bare = false logallrefupdates = true editor = vim 3 配置虚拟环境 pip3 install virtualenv #安装virtualenv virtualenv flaskenv #创建flaskenv虚拟环境 source env/bin/activate #激活虚拟环境 4 安装flask pip3 install flask #安装flask pip freeze > requirements.txt #在requirements.txt生成当前环境下所需要安装的python软件包列表 pip install -r requirements.txt #生成 requirements.txt 文件,更方便我们去安装需要的包 deactivate #退出当前的虚拟环境 5 创建github项目 # 让 Git 忽略对整个 env 目录和所有 *.pyc 文件的处理,让 Git 仅处理自己的代码文件 vim .gitignore env/ *.pyc mkdir gitblog #创建项目名 cd gitblog # 创建 README 文件 echo "# welcome to why blog! " >> README.md # 初始化 git 仓库 git init # 将刚创建的文件都加入 git 缓冲区 git add . # 提交改动文件到 git 仓库 git commit -m "first commit" # 将项目发布到 github git remote add origin https://github.com/用户名/blog.git git push -u origin master (2) 项目简单流程 1 项目配置文件config.py/settings.py #配置所有环境的基类 class Config: SECRET_KEY = 'JAGAFAjjfdsfdasdas' SQLALCHEMY_TRACK_MODIFITIONS = False #测试 class TestingConfig(Config): SQLALCHEMY_DATABASE_URI = 'mysql+pymysql://root:xxx@127.0.0.1:3306/xxxblog' pass #开发 class DevelopmentConfig(Config): SQLALCHEMY_DATABASE_URI = 'mysql+pymysql://root:xxx@127.0.0.1:3306/xxxblog' DEBUG = True #生产 class ProductionConfig(Config): SQLALCHEMY_DATABASE_URI = 'mysql+pymysql://root:xxx@127.0.0.1:3306/xxxblog' pass sqlalchemy通过特殊的URI字符串创建数据库的连接 # database_type+driver://user:password@sql_server_ip:port/database_name 2 创建主启动文件manage.py ​ 该文件是 Flask 应用的核心,也是程序的入口 from flask import Flask from config import DevelopmentConfig from flask_script import Manager app = Flask(__name__) manager = Manager(app) # 使用 config.from_object() 而不使用 app.config['DEBUG'] 是因为这样可以加载 class DevConfig 的配置变量集合,而不需要一项一项的添加和修改。 app.config.from_object(DevConfig) # 指定 URL='/' 的路由规则 @app.route('/') def index(): return '<h1>index</h1>' if __name__ == '__main__': manager.run() #注意 : 通过 manager.py 来执行命令行是十分有必要的,因为一些 Flask 的扩展只有在 Flask app object 被创建之后才会被初始化,所以非常依赖于应用上下 文的环境,在没有 Flask app object 时,直接运行默认的 Python CLI 会导致 这些 Flask 扩展返回错误。 3 运行开发服务器 python manage.py runserver -d -r python3 当前启动文件名.py runserver 可选参数 #可选参数如下: -h 主机名 -p 端口号 --threaded 开启多线程 -d 开启调试模式 -r 代码修改后重新加载 4 Models与SQLAlchemy 在 Web 应用程序开发中引入了 Models 为了 —— 将关系型数据转化为一个对象类型 SQLAlchemy 是一个 Python 包,其最底层包装了对数据库进入操作的统一接口,然后在最上层提供了对象关系映射(ORM)的实现。 SQLAlchemy-ORM 可以把大量的不同类型的数据库中的数据,转换成 Python 对象的集合。即SQLAlchemy-ORM 可以将对这些数据对象的操作转化为对数据库的操作。 Flask 为我们提供了 Flask SQLAlchemy,其实就是在 SQLAlchemy 上提供了一层包装,让 SQLAlchemy 可以结合 Flask 的一些特性来使用。

优秀的个人博客,低调大师

阿里云部署Hbase集群

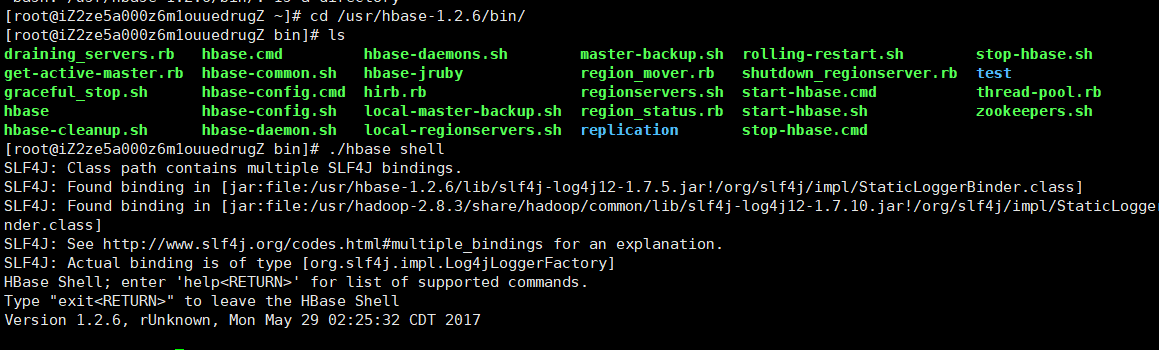
安装环境 主机 ip 操作系统 master 10.30.45.239 centos7.4 slave1 10.31.155.33 centos7.4 slave2 10.81.233.67 centos7.4 阿里云3台ecs搭建一个小型的hbase分布式数据存储(这里的ip都是内网)。一台作为主master两台作为从slave。 安装步骤 安装vim编辑器 安装ssh 配置ssh免密码登陆 安装jdk 安装hadoop 安装zookeeper 安装时间同步服务 NTP 安装hbase 准备工作 版本 centos7.4 内核为3.10 Hadoop 2.8.3 Hbase 1.2.6 Zookeeper 3.4.10 Sqoop 1.4.7 Phoenix 4.13.1 修改hostname # vim /etc/hostname 输入自定义主机名 ,三台都要改 修改hosts文件 分别登陆三台主机,修改hosts vim /etc/hosts --添加以下信息(三台都要改) 10.30.45.239 master 10.31.155.33 slave1 10.81.233.67 slave2 登陆master,下载所有安装包 --下载jdk8u31 wget --no-check-certificate --no-cookies --header "Cookie: oraclelicense=accept-securebackup-cookie" http://download.oracle.com/otn-pub/java/jdk/8u131-b11/d54c1d3a095b4ff2b6607d096fa80163/jdk-8u131-linux-x64.tar.gz -- 下载 hadoop-2.8.3 wget http://mirrors.tuna.tsinghua.edu.cn/apache/hadoop/common/hadoop-2.8.3/hadoop-2.8.3.tar.gz --下载hbase 1.2.6 wget http://mirrors.hust.edu.cn/apache/hbase/1.2.6/hbase-1.2.6-bin.tar.gz --下载zookeeper 3.4.10 wget http://apache.claz.org/zookeeper/zookeeper-3.4.10/zookeeper-3.4.10.tar.gz --下载phoenix4.13.1 wget http://mirror.bit.edu.cn/apache/phoenix/apache-phoenix-4.13.1-HBase-1.2/bin/apache-phoenix-4.13.1-HBase-1.2-bin.tar.gz --下载sqoop1.4.7 wget http://mirror.cogentco.com/pub/apache/sqoop/1.4.7/sqoop-1.4.7.bin__hadoop-2.6.0.tar.gz 写这篇文章的时候是2018年4月。适当选择稳定的版本安装。下载官网如下: jdk : http://www.oracle.com/technetwork/java/javase/downloads/index.html hadoop:http://hadoop.apache.org/releases.html hbase: http://www.apache.org/dyn/closer.lua/hbase/ zookeeper: http://zookeeper.apache.org/releases.html sqoop: http://sqoop.apache.org phoenix: https://phoenix.apache.org/ 设置3台ecs之间免密登陆 方便后期之间文件复制。 # # slave1 # ssh-keygen -t rsa -- 不用输入密码,一路回车就行 # cp ~/.ssh/id_rsa.pub ~/.ssh/slave1_id_rsa.pub # scp ~/.ssh/slave1_id_rsa.pub master:~/.ssh/ # # slave2 # ssh-keygen -t rsa # cp ~/.ssh/id_rsa.pub ~/.ssh/slave2_id_rsa.pub # scp ~/.ssh/slave2_id_rsa.pub master:~/.ssh/ # # master ssh-keygen -t rsa # cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys # cat ~/.ssh/slave1_id_rsa.pub >> ~/.ssh/authorized_keys # cat ~/.ssh/slave2_id_rsa.pub >> ~/.ssh/authorized_kyes -- 拷贝文件至slave1及slave2 # scp ~/.ssh/authorized_keys slave1:~/.ssh # scp ~/.ssh/authorized_keys slave2:~/.ssh 关闭防火墙及SELINUX(master、slave1、slave2均需修改) -- 关闭防火墙 # systemctl stop firewalld.service # systemctl disable firewalld.service -- 关闭SELINUX # vim /etc/selinux/config -- 注释掉 #SELINUX=enforcing #SELINUXTYPE=targeted -- 添加 SELINUX=disabled 设置时间同步 这里省略,第一我懒得配,第二阿里云有自动同步 安装jdk 登陆master -- 解压jdk安装包 # mkdir /usr/java # tar -zxvf jdk-8u131-linux-x64.tar.gz -C /usr/java -- 拷贝jdk至slave1及slave2中 # scp -r /usr/java slave1:/usr # scp -r /usr/java slave2:/usr -- 设置jdk环境变量(master、slave1、slave2均需修改) # vim /etc/environment JAVA_HOME=/usr/java/jdk1.8.0_131 JRE_HOME=/usr/java/jdk1.8.0_131/jre # vim /etc/profile export JAVA_HOME=/usr/java/jdk1.8.0_131 export JRE_HOME=${JAVA_HOME}/jre export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin 搭建Hadoop环境 解压安装 登陆master # tar -zxvf hadoop-2.8.3-x64.tar.gz -C /usr # cd /usr/hadoop-2.8.3 # mkdir tmp logs hdf hdf/data hdf/name 修改Hadoop配置文件 -- 修改 slaves 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/slaves -- 删除 localhost,添加 slave1 slave2 -- 修改 core-site.xml 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/core-site.xml -- 在 configuration 节点中添加以下内容 <property> <name>fs.default.name</name> <value>hdfs://master:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>file:/usr/hadoop-2.8.3/tmp</value> </property> -- 修改 hdfs-site.xml 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/hdfs-site.xml -- 在 configuration 节点添加以下内容 <property> <name>dfs.datanode.data.dir</name> <value>/usr/hadoop-2.8.3/hdf/data</value> <final>true</final> </property> <property> <name>dfs.namenode.name.dir</name> <value>/usr/hadoop-2.8.3/hdf/name</value> <final>true</final> </property> -- 修改 mapred-site.xml 文件 # cp /usr/hadoop-2.8.3/etc/hadoop/mapred-site.xml.template /usr/hadoop-2.8.3/etc/hadoop/mapred-site.xml # vim /usr/hadoop-2.8.3/etc/hadoop/mapred-site.xml -- 在 configuration 节点添加以下内容 <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <property> <name>mapreduce.jobhistory.address</name> <value>master:10020</value> </property> <property> <name>mapreduce.jobhistory.webapp.address</name> <value>master:19888</value> </property> -- 修改 yarn-site.xml 文件 # vim /usr/hadoop-2.8.3/etc/hadoop/yarn-site.xml -- 在 configuration 节点添加以下内容 <property> <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name> <value>org.apache.mapred.ShuffleHandler</value> </property> <property> <name>yarn.resourcemanager.address</name> <value>master:8032</value> </property> <property> <name>yarn.resourcemanager.scheduler.address</name> <value>master:8030</value> </property> <property> <name>yarn.resourcemanager.resource-tracker.address</name> <value>master:8031</value> </property> <property> <name>yarn.resourcemanager.admin.address</name> <value>master:8033</value> </property> <property> <name>yarn.resourcemanager.webapp.address</name> <value>master:8088</value> </property> 复制hadoop到slave节点 # scp -r /usr/hadoop-2.8.3 slave1:/usr # scp -r /usr/hadoop-2.8.3 slave2:/usr 配置 master 和 slave 的 hadoop 环境变量 # vim /etc/profile -- 添加如下内容 export HADOOP_HOME=/usr/hadoop-2.8.3 export PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH export HADOOP_LOG_DIR=/usr/hadoop-2.8.3/logs export YARN_LOG_DIR=$HADOOP_LOG_DIR -- 保存后执行 # source /etc/profile # vim ~/.bashrc -- 添加如下内容 export HADOOP_PREFIX=/usr/hadoop-2.8.3/ -- 保存后执行 # source ~/.bashrc 格式化 namenode # /usr/hadoop-2.8.3/sbin/hdfs namenode -format 启动 hadoop(仅在master节点执行) # ssh master # /usr/hadoop-2.8.3/sbin/start-all.sh 到这一步已经成功完成了hadoop环境的搭建 Zookeeper环境搭建 解压缩 zookeeper 安装包到master,并建立基本目录 # tar -zxvf zookeeper-3.4.10.tar.gz -C /usr # mkdir /usr/zookeeper-3.4.10/data 修改master配置文件 -- 复制配置文件模板 # cp /usr/zookeeper-3.4.10/conf/zoo-sample.cfg /usr/zookeeper-3.4.10/conf/zoo.cfg -- 修改配置文件 # vim /usr/zookeeper-3.4.10/conf/zoo.cfg -- 添加如下内容 dataDir=/usr/zookeeper-3.4.10/data server.1=master:2888:3888 server.2=slave1:2888:3888 server.3=slave2:2888:3888 复制到各个子节点 # scp -r /usr/zookeeper-3.4.10 slave1:/usr # scp -r /usr/zookeeper-3.4.10 slave2:/usr 创建myid文件 -- master节点添加myid文件 # ssh master # touch /usr/zookeeper-3.4.10/data/myid # echo 1 > /usr/zookeeper-3.4.10/data/myid -- slave1节点添加myid文件 # ssh slave1 # touch /usr/zookeeper-3.4.10/data/myid # echo 2 > /usr/zookeeper-3.4.10/data/myid -- slave2节点添加myid文件 # ssh slave2 # touch /usr/zookeeper-3.4.10/data/myid # echo 3 > /usr/zookeeper-3.4.10/data/myid 启动zookeeper(master、slave1、slave2均需执行) -- 启动master # ssh master # cd /usr/zookeeper-3.4.10/bin # ./zkServer.sh start -- 启动slave1 # ssh slave1 # cd /usr/zookeeper-3.4.10/bin # ./zkServer.sh start -- 启动slave2 # ssh slave2 # cd /usr/zookeeper-3.4.10/bin # ./zkServer.sh start 到这一步完成了zookeeper环境的搭建 HBase环境搭建 解压缩hbase安装包 # tar -zxvf hbase-1.2.6-bin.star.gz -C /usr # mkdir /usr/hbase-1.2.6-bin/logs 修改Hbase启动时要使用的环境变量(hbase-env.sh) -- 打开环境变量配置文件 # vim /usr/hbase-1.2.6/conf/hbase-env.sh -- 添加如下内容 -- 1、设置java安装路径 export JAVA_HOME=/usr/java/jdk1.8.0_131 -- 2、设置hbase的日志地址 export HBASE_LOG_DIR=${HBASE_HOME}/logs -- 3、设置是否使用hbase管理zookeeper(因使用zookeeper管理的方式,故此参数设置为false) export HBASE_MANAGES_ZK=false -- 4、设置hbase的pid文件存放路径 export HBASE_PID_DIR=/var/hadoop/pids 添加所有的region服务器到regionservers文件中 – 打开regionservers配置文件 # vim /usr/hbase-1.2.5/conf/regionservers -- 删除localhost,新增如下内容 master slave1 slave2 注:hbase在启动或关闭时会依次迭代访问每一行来启动或关闭所有的region服务器进程 修改Hbase集群的基本配置信息(hbase-site.xml),该配置将会覆盖Hbase的默认配置 -- 打开配置文件 # vim /usr/hbase-1.2.6/conf/hbase-site.xml -- 在configuration节点下添加如下内容 <property> <name>hbase.rootdir</name> <value>hdfs://master:9000/hbase</value> </property> <property> <name>hbase.cluster.distributed</name> <value>true</value> </property> <property> <name>hbase.zookeeper.quorum</name> <value>master,slave1,slave2</value> </property> <property> <name>hbase.zookeeper.property.dataDir</name> <value>/usr/zookeeper-3.4.10/data</value> </property> <property> <name>hbase.master</name> <value>hdfs://master:60000</value> </property> 复制hbase到slave中 # scp -r /usr/hbase-1.2.6 slave1:/usr # scp -r /usr/hbase-1.2.6 slave2:/usr 启动hbase(仅在master节点上执行即可) # ssh master # /usr/hbase-1.2.5/bin/start-hbase.sh 到这一步hbase环境搭建完成 本地测试 使用Habse shell连接Hbase cd /usr/hbase-1.2.6/bin/ ./hbase shell ./hbase shell 创建user1表 create 'user1','personalinfo' create 对user1简单CURD 插入 put 'user1','roow1','personalinfo:name','zhangsan' put 查询 get 'user1','row1','personalinfo:name' get 其他命令 help查询就好 hbase(main):001:0> help HBase Shell, version 1.2.6, rUnknown, Mon May 29 02:25:32 CDT 2017 Type 'help "COMMAND"', (e.g. 'help "get"' -- the quotes are necessary) for help on a specific command. Commands are grouped. Type 'help "COMMAND_GROUP"', (e.g. 'help "general"') for help on a command group. COMMAND GROUPS: Group name: general Commands: status, table_help, version, whoami Group name: ddl Commands: alter, alter_async, alter_status, create, describe, disable, disable_all, drop, drop_all, enable, enable_all, exists, get_table, is_disabled, is_enabled, list, locate_region, show_filters Group name: namespace Commands: alter_namespace, create_namespace, describe_namespace, drop_namespace, list_namespace, list_namespace_tables Group name: dml Commands: append, count, delete, deleteall, get, get_counter, get_splits, incr, put, scan, truncate, truncate_preserve Group name: tools Commands: assign, balance_switch, balancer, balancer_enabled, catalogjanitor_enabled, catalogjanitor_run, catalogjanitor_switch, close_region, compact, compact_rs, flush, major_compact, merge_region, move, normalize, normalizer_enabled, normalizer_switch, split, trace, unassign, wal_roll, zk_dump Group name: replication Commands: add_peer, append_peer_tableCFs, disable_peer, disable_table_replication, enable_peer, enable_table_replication, list_peers, list_replicated_tables, remove_peer, remove_peer_tableCFs, set_peer_tableCFs, show_peer_tableCFs Group name: snapshots Commands: clone_snapshot, delete_all_snapshot, delete_snapshot, list_snapshots, restore_snapshot, snapshot Group name: configuration Commands: update_all_config, update_config Group name: quotas Commands: list_quotas, set_quota Group name: security Commands: grant, list_security_capabilities, revoke, user_permission Group name: procedures Commands: abort_procedure, list_procedures Group name: visibility labels Commands: add_labels, clear_auths, get_auths, list_labels, set_auths, set_visibility SHELL USAGE: Quote all names in HBase Shell such as table and column names. Commas delimit command parameters. Type <RETURN> after entering a command to run it. Dictionaries of configuration used in the creation and alteration of tables are Ruby Hashes. They look like this: {'key1' => 'value1', 'key2' => 'value2', ...} and are opened and closed with curley-braces. Key/values are delimited by the '=>' character combination. Usually keys are predefined constants such as NAME, VERSIONS, COMPRESSION, etc. Constants do not need to be quoted. Type 'Object.constants' to see a (messy) list of all constants in the environment. If you are using binary keys or values and need to enter them in the shell, use double-quote'd hexadecimal representation. For example: hbase> get 't1', "key\x03\x3f\xcd" hbase> get 't1', "key\003\023\011" hbase> put 't1', "test\xef\xff", 'f1:', "\x01\x33\x40" The HBase shell is the (J)Ruby IRB with the above HBase-specific commands added. For more on the HBase Shell, see http://hbase.apache.org/book.html

优秀的个人博客,低调大师

YARN HA架构部署测试

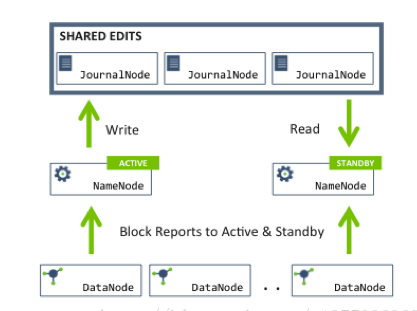
ResourceManager(RM)负责跟踪集群中的资源,并调度应用程序(例如MapReduce作业)。 在Hadoop 2.4之前,ResourceManager是纱线集群中的单一故障点。 高可用性特性以活动/备用资源管理器对的形式添加冗余,以删除此故障点。 原理图 配置过程 管理命令 ResourceManger Restart NodeManagers和客户端在RM关闭期间将保持对RM的轮询,直到RM启 动。当启动后,RM将通过心跳机制向正在与其会话的NodeManager和 ApplicationMasters发送同步指令。目前NodeManager和ApplicationMaster 处理该指令的方式为:NodeManager将杀死它管理的所有容器然后向RM 重新注册,对于RM来说,这些重新注册的NodeManager与新加入的 NodeManager相似。ApplicationMasters在接收到RM的同步指令后,将会 关闭。在RM重启后,从状态存储中加载应用元数据和认证信息并放入 内存后,RM将为每个还未完成的应用创建新的尝试。正如之前描述的 ,此种方式下之前正在运行的应用程序的工作将会丢失,因为它们已经 被RM在重启后使用同步指令杀死了 ResourceManager重启可以划分为两个阶段。 第一阶段, 增强的ResourceManager(RM)将应用程序的状态和其它认证信息保存到一个插入式的状态存储中。 RM重启时将从状态存储中重新加载这些信息,然后重新开始之前正在运行的应 用程序,用户不需要重新提交应用程序。 第二阶段, 重启时通过从NodeManagers读取容器的状态和从ApplicationMasters读取容器的请求,集中重构RM的运行状态。与第一阶段不同的是,在第二阶段中,之前正在运行的应用 程序将不会在RM重启后被杀死,所以应用程序不会因为RM中断而丢失工作。

优秀的个人博客,低调大师

CentOS7 部署docker

1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 1.docker安装 CentOS7 yum install epel-release-y yum install docker-y [root@Docker~] #dockerversion Client: Version:1.12.6 APIversion:1.24 Packageversion:docker-1.12.6-61.git85d7426.el7.centos.x86_64 Goversion:go1.8.3 Gitcommit:85d7426 /1 .12.6 Built:TueOct2415:40:212017 OS /Arch :linux /amd64 Server: Version:1.12.6 APIversion:1.24 Packageversion:docker-1.12.6-61.git85d7426.el7.centos.x86_64 Goversion:go1.8.3 Gitcommit:85d7426 /1 .12.6 Built:TueOct2415:40:212017 OS /Arch :linux /amd64 [root@Docker~] # [root@Docker~] #dockerinfo Containers:0 Running:0 Paused:0 Stopped:0 Images:0 ServerVersion:1.12.6 StorageDriver:devicemapper PoolName:docker-253:0-270443527-pool PoolBlocksize:65.54kB BaseDeviceSize:10.74GB BackingFilesystem:xfs Data file : /dev/loop0 Metadata file : /dev/loop1 DataSpaceUsed:11.8MB DataSpaceTotal:107.4GB DataSpaceAvailable:102.8GB MetadataSpaceUsed:581.6kB MetadataSpaceTotal:2.147GB MetadataSpaceAvailable:2.147GB ThinPoolMinimumFreeSpace:10.74GB UdevSyncSupported: true DeferredRemovalEnabled: true DeferredDeletionEnabled: true DeferredDeletedDeviceCount:0 Dataloop file : /var/lib/docker/devicemapper/devicemapper/data WARNING:Usageofloopbackdevicesisstronglydiscouraged for productionuse.Use`--storage-optdm.thinpooldev`tospecifyacustomblockstoragedevice. Metadataloop file : /var/lib/docker/devicemapper/devicemapper/metadata LibraryVersion:1.02.107-RHEL7(2015-10-14) LoggingDriver:journald CgroupDriver:systemd Plugins: Volume: local Network:hostbridgeoverlaynull Swarm:inactive Runtimes:docker-runcrunc DefaultRuntime:docker-runc SecurityOptions:seccomp KernelVersion:3.10.0-327.el7.x86_64 OperatingSystem:CentOSLinux7(Core) OSType:linux Architecture:x86_64 NumberofDockerHooks:3 CPUs:2 TotalMemory:1.954GiB Name:localhost.localdomain ID:7NNL:RVYC:M6QY:CP2P:5SNV:3N25:U45I:TUWG:Y4NK:7H4R:CN2B:3E67 DockerRootDir: /var/lib/docker DebugMode(client): false DebugMode(server): false Registry:https: //index .docker.io /v1/ WARNING:bridge-nf-call-iptablesisdisabled WARNING:bridge-nf-call-ip6tablesisdisabled InsecureRegistries: 127.0.0.0 /8 Registries:docker.io(secure) CentOS6 yum install epel-release-y yum install lxclibcgroupdevice-map*-y yum install docker-io-y [root@Docker~] #dockerversion Clientversion:1.7.1 ClientAPIversion:1.19 Goversion(client):go1.4.2 Gitcommit(client):786b29d /1 .7.1 OS /Arch (client):linux /amd64 Serverversion:1.7.1 ServerAPIversion:1.19 Goversion(server):go1.4.2 Gitcommit(server):786b29d /1 .7.1 OS /Arch (server):linux /amd64 [root@Docker~] # [root@Docker~] #dockerinfo Containers:0 Images:0 StorageDriver:devicemapper PoolName:docker-253:0-130626-pool PoolBlocksize:65.54kB BackingFilesystem:extfs Data file : /dev/loop0 Metadata file : /dev/loop1 DataSpaceUsed:305.7MB DataSpaceTotal:107.4GB DataSpaceAvailable:11.1GB MetadataSpaceUsed:729.1kB MetadataSpaceTotal:2.147GB MetadataSpaceAvailable:2.147GB UdevSyncSupported: true DeferredRemovalEnabled: false Dataloop file : /var/lib/docker/devicemapper/devicemapper/data Metadataloop file : /var/lib/docker/devicemapper/devicemapper/metadata LibraryVersion:1.02.117-RHEL6(2016-12-13) ExecutionDriver:native-0.2 LoggingDriver:json- file KernelVersion:2.6.32-431.el6.x86_64 OperatingSystem:<unknown> CPUs:1 TotalMemory:1.834GiB Name:localhost.localdomain ID:SKZZ:TYST:LUEG:N66O:364P:7YRG:GQ3W:ODYR:G476:JSHB:I2HF:3A5W 说明:docker默认的存储驱动类型为devicemapper,docker-ce默认的存储驱动类型为overlay2。 2.搜索并下载nginx容器 [root@Docker~] #dockersearchnginx [root@Docker~] #dockerpulldocker.io/nginx 3.将容器的80端映射到本机的8080 [root@Docker~] #dockerrun--name=nginx-itd-p8080:80docker.io/nginxbash 或者 [root@Docker~] #dockerrun--namenginx-itd-p8080:80docker.io/nginx/bin/bash 或者 [root@Docker~] #dockerrun--name=nginx-itd-p8080:80docker.io/nginx 注:--privileged给予管理员权限,--restart=always容器随docker宿主机的启动而启动;CentOS7安装服务器后若使用systemctl工具启动创建容器时需要执行 /usr/sbin/init 或 /sbin/init 命令。 4.查看docker容器进程 [root@Docker~] #dockerps-a CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES 26ae21c8bddddocker.io /nginx "bash" 5secondsagoUp4seconds0.0.0.0:8080->80 /tcp nginx 5.查看docker容器IP地址 [root@Docker~] #dockerinspect0a9db4be695b|grep-iip "HostIp" : "" , "IpcMode" : "" , "LinkLocalIPv6Address" : "" , "LinkLocalIPv6PrefixLen" :0, "HostIp" : "0.0.0.0" , "SecondaryIPAddresses" :null, "SecondaryIPv6Addresses" :null, "GlobalIPv6Address" : "" , "GlobalIPv6PrefixLen" :0, "IPAddress" : "172.17.0.2" , "IPPrefixLen" :16, "IPv6Gateway" : "" , "IPAMConfig" :null, "IPAddress" : "172.17.0.2" , "IPPrefixLen" :16, "IPv6Gateway" : "" , "GlobalIPv6Address" : "" , "GlobalIPv6PrefixLen" :0, [root@Docker~] # 6.浏览器访问测试: http: //IP :8080 1 2 3 4 5 6 7 8 9 10 11 12 7.登录进入容器中,更改默认的测试页面内容 [root@Docker~] #dockerexec-it0a9db4be695b/bin/bash root@0a9db4be695b:/ #cd/usr/share/nginx/html/ root@0a9db4be695b: /usr/share/nginx/html #ls 50x.htmlindex.html root@0a9db4be695b: /usr/share/nginx/html #echo"<h1>www.hello.com</h1>">index.html root@0a9db4be695b: /usr/share/nginx/html #exit exit [root@Docker~] # 8.浏览器访问测试: http: //IP :8080 1 2 9.强制删除所有的虚拟机 [root@Docker~] #dockerrm-f`dockerps-aq` 本文转自 dengaosky 51CTO博客,原文链接:http://blog.51cto.com/dengaosky/2045168,如需转载请自行联系原作者

优秀的个人博客,低调大师

elasticsearch5.6.3插件部署

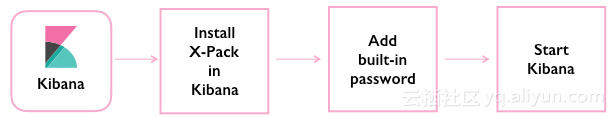
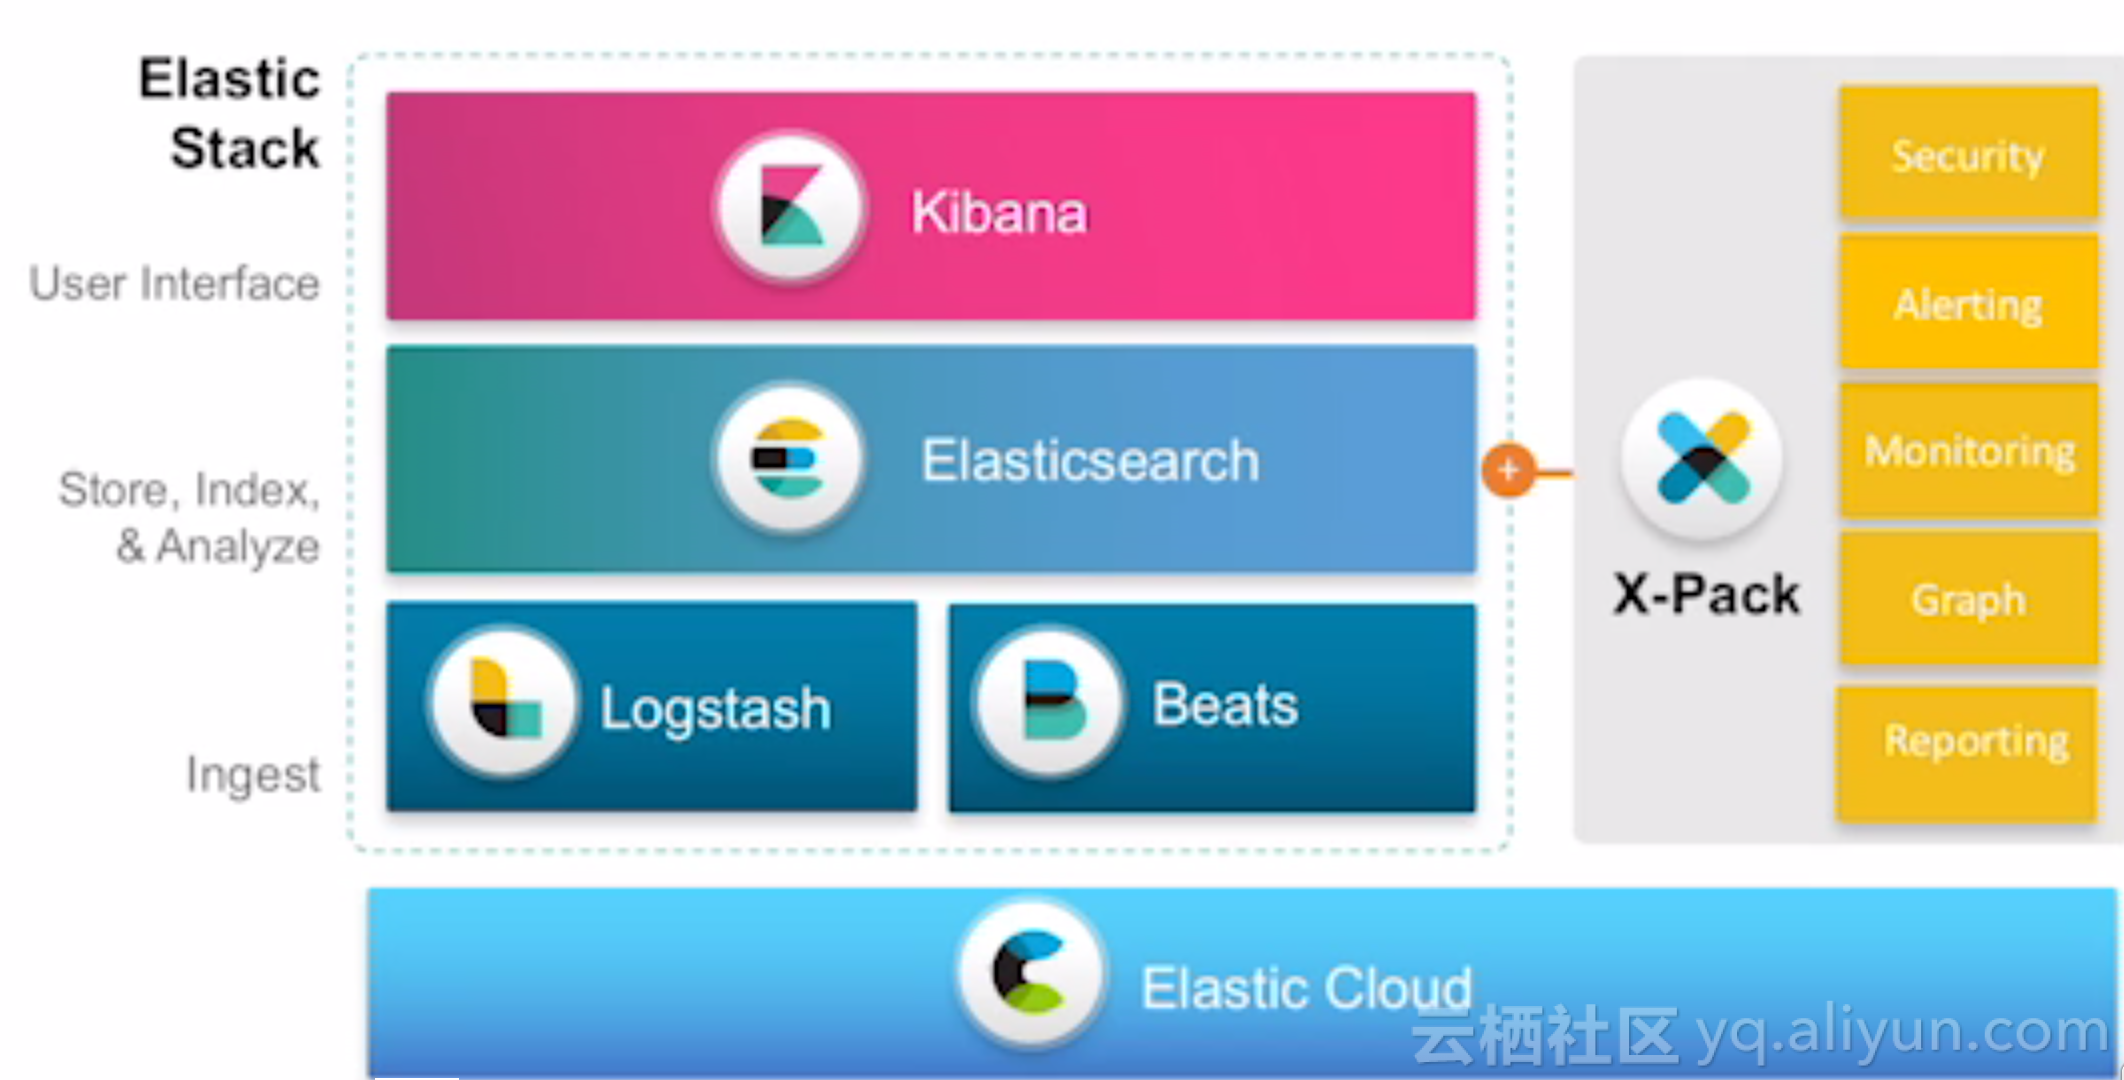
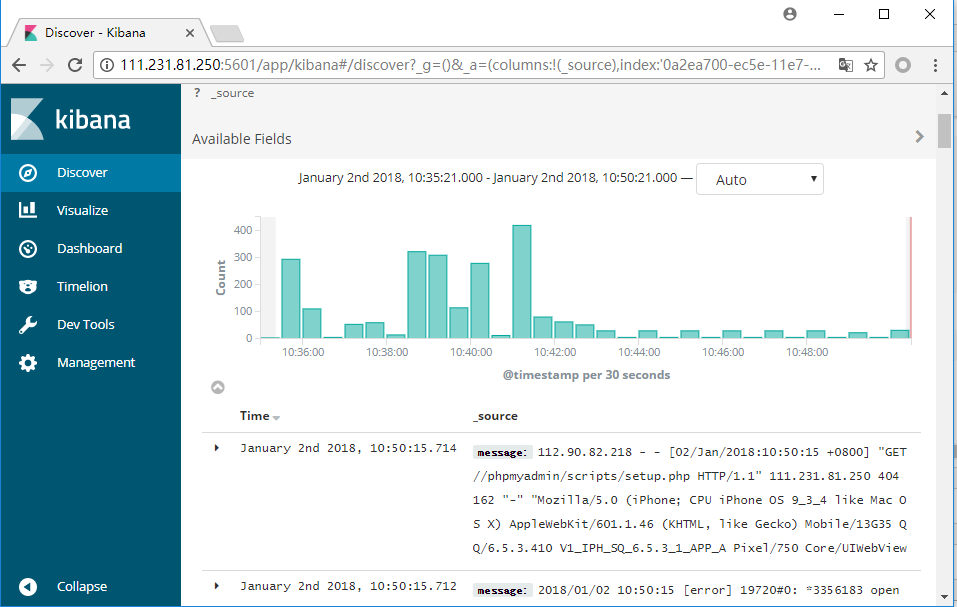
需要注意的是,5.x和2.x插件方面改动很大。参考:https://www.elastic.co/blog/running-site-plugins-with-elasticsearch-5-0。因为安全原因,原先的head、bigdesk、krof等插件不再支持直接在plugin目录下解压使用;新出个安全监控插件X-Pack,涵盖了marvel等功能。后面我会选择性地安装一些插件。 1.elasticsearch 安装和2.x一样,没什么可说的。安装后启动会遇到一系列问题,参考:http://www.cnblogs.com/jiu0821/p/7683322.html 2.kibana5.6.3 安装和2.x一样,只是界面大为改观,且内置了sense插件。 实际安装过程中遇到一个问题,kibana日志正常但不可用其他主机通过浏览器访问,端口是开放的。使用命令:netstat -an | grep LISTEN看到5601端口绑定的地址是127.0.0.1,由于本地hosts配置问题,无法通过本机实际ip访问。两个方案,一个就是配置本地hosts问题,另一个可以修改kibana的配置文件,把里面的host改为“host:0.0.0.0",解决。(0.0.0.0代表使用所有地址) 3.cerebro(krof) realease版本下载地址:https://github.com/lmenezes/cerebro/releases 解压安装包到一个自定义目录(非elasticsearch或kibana的plugin目录),Run bin/cerebro(or bin/cerebro.bat if on Windows)。界面会让你输入es域名,连接即可。 4.analysis-ik 下载地址:https://github.com/medcl/elasticsearch-analysis-ik/releases 解压,复制到插件目录:mv elasticsearch-analysis-ik-5.6.3elasticsearch安装目录/plugins/analysis-ik 这个时候需要重启 elasticsearch 插件才能生效(这个可以等设置好词库再重启也可以) 5.bigdesk 下载地址:https://github.com/hlstudio/bigdesk 修改es配置文件,添加参数: http.cors.enabled: true http.cors.allow-origin: "*" 解压安装包到一个自定义目录(非elasticsearch或kibana的plugin目录)。这个插件需要运行在一个web server上,es没有提供,我们需要自己搭建。 安装node,然后进入bigdesk目录下的_site目录,可以看到有个index.html。这里暂且使用Python提供的一个简易web server,执行: python -m SimpleHTTPServer [port] 注:这里的port可不填,也可以填自己指定的端口号 然后就可以用浏览器访问了,访问http://ip:port。 本文转自 jiu~ 博客园博客,原文链接:http://www.cnblogs.com/jiu0821/p/7695149.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

hadoop的部署以及应用

1.基础环境 1 2 3 4 5 6 7 8 9 10 [hadoop@master~]$ cat /etc/redhat-release CentOSLinuxrelease7.2.1511(Core) [hadoop@master~]$ [hadoop@master~]$getenforce Disabled [hadoop@master~]$systemctlstatusfirewalld ●firewalld.service-firewalld-dynamicfirewalldaemon Loaded:loaded( /usr/lib/systemd/system/firewalld .service;disabled;vendorpreset:enabled) Active:inactive(dead) [hadoop@master~]$ 2.IP以及对应节点 IP 主机名 hadoop node hadoop 进程名称 192.168.56.100 master master namenode,jobtracker 192.168.56.101 slave1 slave datanode,tasktracker 192.168.56.102 slave2 slave datanode,tasktracker 192.168.56.103 slave3 slave datanode,tasktracker 1 2 3 4 5 6 [hadoop@master~] #cat/etc/hosts 192.168.56.100Master 192.168.56.101slave1 192.168.56.102slave2 192.168.56.103slave3 [hadoop@master~] # 3.增加hadoop用户,所有节点 1 2 useradd hadoop echo hadoop| passwd --stdinhadoop 4.jdk 1 2 3 4 5 6 7 8 9 10 11 12 [hadoop@slave1application] #ll total4 lrwxrwxrwx1rootroot24Jul1001:35jdk-> /application/jdk1 .8.0_60 drwxr-xr-x8rootroot4096Aug52015jdk1.8.0_60 [hadoop@slave1application] #pwd /application [hadoop@slave1application] # [hadoop@master~] #java-version javaversion "1.8.0_60" Java(TM)SERuntimeEnvironment(build1.8.0_60-b27) JavaHotSpot(TM)64-BitServerVM(build25.60-b23,mixedmode) [hadoop@master~] # 5.master(192.168.56.100)上的hadoop用户可以ssh所有slave节点的hadoop用户下 6.设置hadoop安装路径 以及环境变量(所有节点) 1 2 3 4 5 6 7 su -hadoop tar xfhadoop-2.7.0tar.gz /home/hadoop/hadoop-2 .7.0 vi /etc/profile 添加hadoop环境变量 export HADOOP_HOME= /home/hadoop/hadoop-2 .7.0 export PATH=$PATH:$HADOOP_HOME /bin source /etc/profile 7.修改hadoop的环境的Java环境变量 1 2 3 4 /home/hadoop/hadoop-2 .7.0 /etc/hadoop vi hadoop- env .sh添加 ###JAVA_HOME export JAVA_HOME= /application/jdk/ 8.修改hadoop的配置文件 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 cd /home/hadoop/hadoop-2 .7.0 /etc/hadoop 1. ############################## [hadoop@masterhadoop]$ cat core-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>fs.default.name< /name > <value>hdfs: //master :9000< /value > < /property > <property> <name>hadoop.tmp. dir < /name > <value> /home/hadoop/tmp < /value > < /property > < /configuration > [hadoop@masterhadoop]$ 2. ###################################(默认不存在拷贝个模板即可) [hadoop@masterhadoop]$ cat mapred-site.xml <?xmlversion= "1.0" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>mapred.job.tracker< /name > <value>master:9001< /value > < /property > <property> <name>mapred. local . dir < /name > <value> /home/hadoop/tmp < /value > < /property > < /configuration > [hadoop@masterhadoop]$ 3. ######################################### [hadoop@masterhadoop]$ cat hdfs-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>dfs.name. dir < /name > <value> /home/hadoop/name1 , /home/hadoop/name2 , /home/hadoop/name3 < /value > <description>< /description > < /property > <property> <name>dfs.data. dir < /name > <value> /home/hadoop/data1 , /home/hadoop/data2 , /home/hadoop/data3 < /value > <description>< /description > < /property > <property> <name>dfs.replication< /name > <value>3< /value > < /property > < /configuration > [hadoop@masterhadoop]$ [hadoop@masterhadoop]$ cat masters master [hadoop@masterhadoop]$ cat slaves slave1 slave2 slave3 [hadoop@masterhadoop]$ 9.分发到slave节点 1 2 3 scp -r /home/hadoop/hadoop-2 .7.0slave1: /home/hadoop/ scp -r /home/hadoop/hadoop-2 .7.0slave2: /home/hadoop/ scp -r /home/hadoop/hadoop-2 .7.0slave3: /home/hadoop/ 10.master 节点测试 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 /home/hadoop/name1 /home/hadoop/name2 /home/hadoop/name3 这三个目录不要创建,如果创建会提示 重新reload cd /home/hadoop/hadoop-2 .7.0 [hadoop@masterhadoop-2.7.0]$. /bin/hadoop namenode- format DEPRECATED:Useofthisscripttoexecutehdfs command isdeprecated. Insteadusethehdfs command for it. 17 /07/10 02:57:34INFOnamenode.NameNode:STARTUP_MSG: /************************************************************ STARTUP_MSG:StartingNameNode STARTUP_MSG:host=Master /192 .168.56.100 STARTUP_MSG:args=[- format ] STARTUP_MSG:version=2.7.0 STARTUP_MSG:classpath= /home/hadoop/hadoop-2 .7.0 /etc/hadoop : /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-lang-2 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/hadoop-auth-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/curator-recipes-2 .7.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-collections-3 .2.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/xmlenc-0 .52.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/htrace-core-3 .1.0-incubating.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jetty-util-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-beanutils-core-1 .8.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-digester-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jsp-api-2 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/httpcore-4 .2.5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/mockito-all-1 .8.5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/hadoop-annotations-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/junit-4 .11.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-logging-1 .1.3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-configuration-1 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/api-util-1 .0.0-M20.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jaxb-impl-2 .2.3-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-compress-1 .4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jersey-json-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jettison-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-jaxrs-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/hamcrest-core-1 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-net-3 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-cli-1 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/api-asn1-api-1 .0.0-M20.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-math3-3 .1.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-xc-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/stax-api-1 .0-2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-codec-1 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/slf4j-log4j12-1 .7.10.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jsr305-3 .0.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/snappy-java-1 .0.4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jetty-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/guava-11 .0.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/avro-1 .7.4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/paranamer-2 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-beanutils-1 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jsch-0 .1.42.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/apacheds-kerberos-codec-2 .0.0-M15.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jets3t-0 .9.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/activation-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/java-xmlbuilder-0 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/servlet-api-2 .5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/xz-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/apacheds-i18n-2 .0.0-M15.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-httpclient-3 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/gson-2 .2.4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jaxb-api-2 .2.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/curator-framework-2 .7.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/httpclient-4 .2.5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/curator-client-2 .7.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/slf4j-api-1 .7.10.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/lib/zookeeper-3 .4.6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/hadoop-nfs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/hadoop-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/common/hadoop-common-2 .7.0-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs : /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-lang-2 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/xmlenc-0 .52.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/htrace-core-3 .1.0-incubating.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jetty-util-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-logging-1 .1.3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/leveldbjni-all-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-cli-1 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-daemon-1 .0.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-codec-1 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jsr305-3 .0.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jetty-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/guava-11 .0.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/servlet-api-2 .5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/xercesImpl-2 .9.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/netty-all-4 .0.23.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/lib/xml-apis-1 .3.04.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/hadoop-hdfs-nfs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/hadoop-hdfs-2 .7.0-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/hdfs/hadoop-hdfs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-lang-2 .6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-collections-3 .2.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/javax .inject-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jetty-util-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/aopalliance-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-logging-1 .1.3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/leveldbjni-all-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jaxb-impl-2 .2.3-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-compress-1 .4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-json-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jettison-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-jaxrs-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-cli-1 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-xc-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/stax-api-1 .0-2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-codec-1 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jsr305-3 .0.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jetty-6 .1.26.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/guava-11 .0.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-guice-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/guice-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/activation-1 .1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/servlet-api-2 .5.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/xz-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jaxb-api-2 .2.2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/zookeeper-3 .4.6-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/guice-servlet-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-client-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/lib/zookeeper-3 .4.6.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-sharedcachemanager-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-applicationhistoryservice-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-applications-distributedshell-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-applications-unmanaged-am-launcher-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-resourcemanager-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-registry-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-tests-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-web-proxy-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-api-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-server-nodemanager-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/yarn/hadoop-yarn-client-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/asm-3 .2.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/javax .inject-1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/aopalliance-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jersey-core-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/hadoop-annotations-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jackson-mapper-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/junit-4 .11.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/leveldbjni-all-1 .8.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/commons-compress-1 .4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/hamcrest-core-1 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/snappy-java-1 .0.4.1.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jersey-guice-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/guice-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/netty-3 .6.2.Final.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/avro-1 .7.4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/paranamer-2 .3.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jackson-core-asl-1 .9.13.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/protobuf-java-2 .5.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/xz-1 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/commons-io-2 .4.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/guice-servlet-3 .0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/jersey-server-1 .9.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/lib/log4j-1 .2.17.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-examples-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-2 .7.0-tests.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-hs-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-core-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-hs-plugins-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-common-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-shuffle-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /share/hadoop/mapreduce/hadoop-mapreduce-client-app-2 .7.0.jar: /home/hadoop/hadoop-2 .7.0 /contrib/capacity-scheduler/ *.jar: /home/hadoop/hadoop-2 .7.0 /contrib/capacity-scheduler/ *.jar STARTUP_MSG:build=Unknown-rUnknown;compiledby 'root' on2015-05-27T13:56Z STARTUP_MSG:java=1.8.0_60 ************************************************************/ 17 /07/10 02:57:34INFOnamenode.NameNode:registeredUNIXsignalhandlers for [TERM,HUP,INT] 17 /07/10 02:57:34INFOnamenode.NameNode:createNameNode[- format ] 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name1 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name2 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name3 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name1 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name2 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. 17 /07/10 02:57:35WARNcommon.Util:Path /home/hadoop/name3 shouldbespecifiedasaURI in configurationfiles.Pleaseupdatehdfsconfiguration. Formattingusingclusterid:CID-77e0896d-bda2-49f1-8127-c5343f1c52c9 17 /07/10 02:57:35INFOnamenode.FSNamesystem:NoKeyProviderfound. 17 /07/10 02:57:35INFOnamenode.FSNamesystem:fsLockisfair: true 17 /07/10 02:57:35INFOblockmanagement.DatanodeManager:dfs.block.invalidate.limit=1000 17 /07/10 02:57:35INFOblockmanagement.DatanodeManager:dfs.namenode.datanode.registration.ip- hostname -check= true 17 /07/10 02:57:35INFOblockmanagement.BlockManager:dfs.namenode.startup.delay.block.deletion.secis set to000:00:00:00.000 17 /07/10 02:57:36INFOblockmanagement.BlockManager:Theblockdeletionwillstartaround2017Jul1002:57:36 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapBlocksMap 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:2.0%maxmemory966.7MB=19.3MB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^21=2097152entries 17 /07/10 02:57:36INFOblockmanagement.BlockManager:dfs.block.access.token. enable = false 17 /07/10 02:57:36INFOblockmanagement.BlockManager:defaultReplication=3 17 /07/10 02:57:36INFOblockmanagement.BlockManager:maxReplication=512 17 /07/10 02:57:36INFOblockmanagement.BlockManager:minReplication=1 17 /07/10 02:57:36INFOblockmanagement.BlockManager:maxReplicationStreams=2 17 /07/10 02:57:36INFOblockmanagement.BlockManager:shouldCheckForEnoughRacks= false 17 /07/10 02:57:36INFOblockmanagement.BlockManager:replicationRecheckInterval=3000 17 /07/10 02:57:36INFOblockmanagement.BlockManager:encryptDataTransfer= false 17 /07/10 02:57:36INFOblockmanagement.BlockManager:maxNumBlocksToLog=1000 17 /07/10 02:57:36INFOnamenode.FSNamesystem:fsOwner=hadoop(auth:SIMPLE) 17 /07/10 02:57:36INFOnamenode.FSNamesystem:supergroup=supergroup 17 /07/10 02:57:36INFOnamenode.FSNamesystem:isPermissionEnabled= true 17 /07/10 02:57:36INFOnamenode.FSNamesystem:HAEnabled: false 17 /07/10 02:57:36INFOnamenode.FSNamesystem:AppendEnabled: true 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapINodeMap 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:1.0%maxmemory966.7MB=9.7MB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^20=1048576entries 17 /07/10 02:57:36INFOnamenode.FSDirectory:ACLsenabled? false 17 /07/10 02:57:36INFOnamenode.FSDirectory:XAttrsenabled? true 17 /07/10 02:57:36INFOnamenode.FSDirectory:Maximumsizeofanxattr:16384 17 /07/10 02:57:36INFOnamenode.NameNode:Caching file namesoccuring more than10 times 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapcachedBlocks 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:0.25%maxmemory966.7MB=2.4MB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^18=262144entries 17 /07/10 02:57:36INFOnamenode.FSNamesystem:dfs.namenode.safemode.threshold-pct=0.9990000128746033 17 /07/10 02:57:36INFOnamenode.FSNamesystem:dfs.namenode.safemode.min.datanodes=0 17 /07/10 02:57:36INFOnamenode.FSNamesystem:dfs.namenode.safemode.extension=30000 17 /07/10 02:57:36INFOmetrics.TopMetrics:NNTopconf:dfs.namenode. top .window.num.buckets=10 17 /07/10 02:57:36INFOmetrics.TopMetrics:NNTopconf:dfs.namenode. top .num. users =10 17 /07/10 02:57:36INFOmetrics.TopMetrics:NNTopconf:dfs.namenode. top .windows.minutes=1,5,25 17 /07/10 02:57:36INFOnamenode.FSNamesystem:Retrycacheonnamenodeisenabled 17 /07/10 02:57:36INFOnamenode.FSNamesystem:Retrycachewilluse0.03oftotalheapandretrycacheentryexpiry time is600000millis 17 /07/10 02:57:36INFOutil.GSet:Computingcapacity for mapNameNodeRetryCache 17 /07/10 02:57:36INFOutil.GSet:VM type =64-bit 17 /07/10 02:57:36INFOutil.GSet:0.029999999329447746%maxmemory966.7MB=297.0KB 17 /07/10 02:57:36INFOutil.GSet:capacity=2^15=32768entries 17 /07/10 02:57:36INFOnamenode.FSImage:AllocatednewBlockPoolId:BP-467031090-192.168.56.100-1499626656612 17 /07/10 02:57:36INFOcommon.Storage:Storagedirectory /home/hadoop/name1 hasbeensuccessfullyformatted. 17 /07/10 02:57:36INFOcommon.Storage:Storagedirectory /home/hadoop/name2 hasbeensuccessfullyformatted. 17 /07/10 02:57:36INFOcommon.Storage:Storagedirectory /home/hadoop/name3 hasbeensuccessfullyformatted. 17 /07/10 02:57:36INFOnamenode.NNStorageRetentionManager:Goingtoretain1imageswithtxid>=0 17 /07/10 02:57:36INFOutil.ExitUtil:Exitingwithstatus0 17 /07/10 02:57:37INFOnamenode.NameNode:SHUTDOWN_MSG: /************************************************************ SHUTDOWN_MSG:ShuttingdownNameNodeatMaster /192 .168.56.100 ************************************************************/ [hadoop@masterhadoop-2.7.0]$ 11.启动服务 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 [hadoop@mastersbin]$ pwd /home/hadoop/hadoop-2 .7.0 /sbin [hadoop@mastersbin]$ [hadoop@mastersbin]$. /start-all .sh ThisscriptisDeprecated.Insteadusestart-dfs.shandstart-yarn.sh Startingnamenodeson[master] master:startingnamenode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-namenode-master .out slave3:startingdatanode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-datanode-slave3 .out slave2:startingdatanode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-datanode-slave2 .out slave1:startingdatanode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-datanode-slave1 .out Startingsecondarynamenodes[0.0.0.0] 0.0.0.0:startingsecondarynamenode,loggingto /home/hadoop/hadoop-2 .7.0 /logs/hadoop-hadoop-secondarynamenode-master .out startingyarndaemons startingresourcemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-resourcemanager-master .out slave3:startingnodemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-nodemanager-slave3 .out slave2:startingnodemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-nodemanager-slave2 .out slave1:startingnodemanager,loggingto /home/hadoop/hadoop-2 .7.0 /logs/yarn-hadoop-nodemanager-slave1 .out 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 [hadoop@mastersbin]$ netstat -lntup (Notallprocessescouldbeidentified,non-ownedprocessinfo willnotbeshown,youwouldhavetoberoottoseeitall.) ActiveInternetconnections(onlyservers) ProtoRecv-QSend-QLocalAddressForeignAddressStatePID /Program name tcp00192.168.56.100:90000.0.0.0:*LISTEN4405 /java tcp000.0.0.0:500900.0.0.0:*LISTEN4606 /java tcp000.0.0.0:500700.0.0.0:*LISTEN4405 /java tcp000.0.0.0:220.0.0.0:*LISTEN- tcp00127.0.0.1:250.0.0.0:*LISTEN- tcp600:::22:::*LISTEN- tcp600:::8088:::*LISTEN4757 /java tcp600::1:25:::*LISTEN- tcp600:::8030:::*LISTEN4757 /java tcp600:::8031:::*LISTEN4757 /java tcp600:::8032:::*LISTEN4757 /java tcp600:::8033:::*LISTEN4757 /java [hadoop@mastersbin]$ http://192.168.56.100:50070/dfshealth.html#tab-overview http://192.168.56.103:8042/node/allApplications http://192.168.56.100:50090/status.html 本文转自 小小三郎1 51CTO博客,原文链接:http://blog.51cto.com/wsxxsl/1945709,如需转载请自行联系原作者

优秀的个人博客,低调大师

CentOS7 部署Kubernetes

一、Installing Docker yuminstall-ydocker systemctlenabledocker&&systemctlstartdocker 二、Installing kubeadm, kubelet and kubectl cat<<EOF>/etc/yum.repos.d/kubernetes.repo [kubernetes] name=Kubernetes baseurl=https://packages.cloud.google.com/yum/repos/kubernetes-el7-x86_64 enabled=1 gpgcheck=1 repo_gpgcheck=1 gpgkey=https://packages.cloud.google.com/yum/doc/yum-key.gpghttps://packages.cloud.google.com/yum/doc/rpm-package-key.gpg EOF setenforce0 yuminstall-ykubeletkubeadmkubectl systemctlenablekubelet&&systemctlstartkubelet 1.关闭selinux 2.Some users on RHEL/CentOS 7 have reported issues with traffic being routed incorrectly due to iptables being bypassed. You should ensurenet.bridge.bridge-nf-call-iptablesis set to 1 in yoursysctlconfig, e.g. cat<<EOF>/etc/sysctl.d/k8s.conf net.bridge.bridge-nf-call-ip6tables=1 net.bridge.bridge-nf-call-iptables=1 EOF sysctl--system 参考https://kubernetes.io/docs/setup/independent/install-kubeadm/ 本文转自不要超过24个字符博客51CTO博客,原文链接http://blog.51cto.com/cstsncv/2060277如需转载请自行联系原作者 cstsncv

优秀的个人博客,低调大师

hbase,zookeeper安装部署(二)

一、Hbase基础 1.概念 Hbase是一个在HDFS上开发的面向列分布式数据库,用于实时地随机访问超大规模数据集,它是一个面向列族的存储器。由于调优和存储都是在列族这个层次上进行,最好所有列族的成员都有相同的“访问模式”和大小特征 2.区域 hbase自动把表水平划分“区域”(region)。 每个区域由表中行的子集构。每个区域由它所属于表,它所包含的第一行及其最后一行(不包括这行)来表示 区域是在hbase集群上分布数据最小单位。用这种方式,一个因为太大而无法放在单台服务器的表会被放到服务器集群上,其中每个节点都负责管理表所有区域的一个子集。 3.实现 Hbase主控制(master):负责启动(bootstrap)一个全新安装,把区域分配给注册的regionserver,恢复regionserver的故障。master的负载很轻。 regionsever:负责零个或多个区域的管理以及响应客户端的读写请。还负责区域划分并通知Hbase master有了新的子区域(daughter region),这样主控机就可以把父区域设为离线,并用子区域替换父区域。 Hbase依赖于ZooKeeper。默认情况下,它管理一个ZooKeeper实例,作为集群的“权威机构”(authority)。Hbase负责根目录表(root catalog table)的位置,当前集群主控机地址等重要信息管理。 ZooKeeper上管理分配事务状诚有助于恢复能够从崩溃服务器遗留的状态开始继续分配。 启动一个客户端到HBase集群连接时,客户端必须至少拿到集群所传递的ZooKeeper集合体(ensemble)的位置。这样,客户端才能访问Zookeeper的层次结构,从而了解集群的属性。如服务器位置 4.多种文件系统接口的实现 HBase通过hadoop的文件系统API来持久久化存储数据。 有多种文件系统接口的实现:一种用于本地化文件系统;一种用于KFS文件系统,Amazon S3以及HDFS。多数人使用HDFS作为存储来运行HBase,目前我公司就这样。 5.运行中的HBase Hbase内部保留名为-ROOT-和.META.的特殊目录表(catalog table)。它们维护着当前集群上所有区域的表,状态和位置。 -ROOT-表:包含.META.表的区域列表。 .META.表:包含所有用户空间区域(user-space region)的列表。 表中的项使用区域名作为键。 区域名由表名,起始行,创建时间戳进行哈希后的结果组成 6.与区域regionsver交互过程 连接到ZooKeeper集群上的客户端首先查找-ROOT-的位置,然后客户端通过-ROOT-获取所请求行所在范围所属.META.区域位置。客户端接着查找.META.区域来获取用户空间区域所在节点及其位置。接着客户端就可直接和管理那个区域的regionserver进行交互了 7.每个行操作可能要访问三次远程节点。节省代价,可利用缓存 客户端会缓存它们遍历-ROOT-时获取的信息和.META位置以有用户空间区域的开始行和结束行。这样,以后不需要访问.META.表也能得知区域存放的位置。当发生错误时--却区域被移动了,客户端会再去查看.META.获取区域新位置。如果.META.区域也被移动了,客户端就去查看-ROOT- 8.regionsever写操作 到达Regionsver的写操作首先被追架到“提交日志”(commit log)中,然后被加入内存的memstore。如果memstore满,它的内容被“涮入”(flush)文件系统 9、regionserver故障恢复 提交日志存放在HDFS,即使一个regionserver崩溃,主控机会根据区域死掉的regionserver的提交日志进行分割。重新分配后,在打开并使用死掉的regionserver上的区域之前,这些区域会找到属于它们的从被分割提交日志中得到文件,其中包含还没有被持久化存储的更新。这些更新会被“重做”(replay)以使区域恢复到服务器失败前状态 10、regionserver读操作 在读时候,首先查区域memstore。如果memstore找到所要征曾版本,查询结束了。否则,按照次序从新到旧松果“涮新文件"(flush file),直到找到满足查询的版本,或所有刷新文件都处理完止。 11、regionsever监控进程 一个后台进程负责在刷新文件个数到达一个阀值时压缩他们 一个独立的进程监控着刷新文件的大小,一旦文件大小超出预先设定的最大值,便对区域进行分割 二、ZooKeeper基础 1、概念 ZooKeeper是hadoop的分布式协调服务 2、ZooKeeper具有特点 是简单的 是富有表现力 zookeeper是的基本操作是一组丰富的”构件“(bulding block),可用于实现多种协调数据结构和协议。如:分布式队列,分布式锁和一组节点的”领导者选举“(lead election) 具有高可用性 运行一组机器上,设计上具有高可用性,应用程序可以完全依赖于它。zookeeper可帮助系统避免出现单点故障,因此可用于构建一个可靠的程序 采用松藕合交互方 支技交互过程,参与者不需要彼此了解。 一个资源库 提供一个通用协调的模式的实现方法开源共享库 对于写操作为主的工作负裁来说,zookeeper的基准吞吐量已经超过了每秒10 000 个操作;对于以读操作来说,吞吐量更是高出好几倍 3.ZooKeeper中组成员关系 看作一个具有高可用性特征的文件系统。这个文件系统没有文件和目录,统一使用”节点“(node)的概念,称为znode,作为保存数据的容器(如同文件),也可作为保存其他znode的容器。一个以组名为节点为的znode作为父节点,然后以组成员(服务器名)为节点名创建的作为子节点的znode. 4.数据模型 ZooKeeper维护着一个树形层次结构,znode可用于存储数据,并且与之关联的ACL。被设计用来实现协调服务(这类服务通常使用小数据文件),而不是用于大容量数据存储。一个znode能存储数据被限制在1MB以内。 ZooKeeper的数据访问具有原子性。 客户端端读取一个znode的数据时,要么读到所有数据,要么读操作失败,不会只读到部分数据。同样一个写操作将替换znode存储的所有数据。ZooKeeper会保证写操作不成就失败,不会出现部分写之类的情况,也就不会出现只保存客户端所写部分数据情部。ZooKeeper不支技添操作。这些特征与HDF所不同的。HDFS被设计用于大容量数据存储,支技流式数据访问和添加操作。 5.znode类型 znode有两种类型:短暂的和持久的。znode的类型在创建时被确定并且之后不能再修改。在创建短暂znode客户端会话结束时,zookeeper会将短暂znode删除。持久znode不依赖于客户端会话,只有当客户端(不一定是创建它的那个客户端)明确要删除该持久znode时才会被删除。短暂znode不可以有子节点,即使短暂子节点 6.顺序号 顺序(sequential)znode是指名称包含zookeeper指定顺序的znode.如果创建znode时设置了顺序标识,那zanode名称之后会附加一个值,这个值是由一个单调递增计数器(由父节点维护)所有添加。如如znode的名字/a/b-3 7.观察 znode以某种方式发生变化时,”观察“(watch)机制可以让客户端得到通知。可以针对zookeeper服务的操作来设置观察,该服务的其他操作可以触发观察 二、基本环境准备(参考上一章) 1.机器准备 1 2 3 4 IP地址主机名扮演的角色 10.1 . 2.208 vm13master 10.1 . 2.215 vm7slave 10.1 . 2.216 vm8slave 2.系统版本 1 CentOSrelease 6.5 3.时间同步 4.防火墙关闭 5.创建hadoop用户和hadoop用户组 6.修改hosts 1 2 3 4 5 6 7 8 127.0 . 0.1 localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 :: 1 localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 10.1 . 2.214 master 10.1 . 2.215 slave-one 10.1 . 2.216 slave-two 10.1 . 2.208 vm13 10.1 . 2.197 vm7 10.1 . 2.198 vm8 7.修改文件句柄 8.JVM环境准备 三、hbase安装配置 1.软件准备 1 2 hbase- 0.94 . 16 .tar.gz jdk1. 7 .0_25.tar.gz 2.解压包 1 2 [hadoop@vm13local]$ls-ld/usr/local/hbase- 0.94 . 16 / drwxr-xr-x. 11 hadoophadoop 4096 Jan 13 13 : 11 /usr/local/hbase- 0.94 . 16 / 3.配置文件修改 3.1hbase-env.sh 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 #指定jdk安装目录 exportJAVA_HOME=/usr/local/jdk1. 7 .0_25 #指定Hadoop配置目录,看需要性 exportHBASE_CLASSPATH=/usr/local/hadoop- 1.0 . 4 /conf #设置堆的使用量 exportHBASE_HEAPSIZE= 2000 exportHBASE_OPTS= "-XX:ThreadStackSize=2048-XX:+UseConcMarkSweepGC" #额外ssh选,默认 22 端口 exportHBASE_SSH_OPTS= "-oConnectTimeout=1-oSendEnv=HBASE_CONF_DIR-p22" #在这里先让hbase管理自带zookeeper工具,默认开启,hbase是启动依赖zookeeper exportHBASE_MANAGES_ZK= true 3.2hbase-site.xml hbase.rootdir:设置Hbase数据存放目录 hbase.cluster.distributed:启用Hbase分布模式 hbase.maste:指定Hbase master节点 hbase.zookeeper.quorum:指定Zookeeper集群几点,据说必须为奇数 hbase.zookeeper.property.dataDir:Zookeeper的data目录 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 ?xmlversion= "1.0" ?> <?xml-stylesheettype= "text/xsl" href= "configuration.xsl" ?> <!-- /** *Copyright2010TheApacheSoftwareFoundation * *LicensedtotheApacheSoftwareFoundation(ASF)underone *ormorecontributorlicenseagreements.SeetheNOTICEfile *distributedwiththisworkforadditionalinformation *regardingcopyrightownership.TheASFlicensesthisfile *toyouundertheApacheLicense,Version2.0(the *"License");youmaynotusethisfileexceptincompliance *withtheLicense.YoumayobtainacopyoftheLicenseat * *http://www.apache.org/licenses/LICENSE-2.0 * *Unlessrequiredbyapplicablelaworagreedtoinwriting,software *distributedundertheLicenseisdistributedonan"ASIS"BASIS, *WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. *SeetheLicenseforthespecificlanguagegoverningpermissionsand *limitationsundertheLicense. */ --> <configuration> <property> <name>hbase.rootdir</name> <value>hdfs: //master:9000/hbase</value> <description>ThedirectorysharedbyRegionServers.</description> </property> <property> <name>hbase.cluster.distributed</name> <value> true </value> <description> Themodetheclusterwillbe in .Possiblevaluesare false :standaloneandpseudo-distributedsetups with managedZookeeper true :fully-distributed with unmanagedZookeeperQuorum(seehbase-env.sh) </description> </property> <property> <name>hbase.zookeeper.quorum</name> <!--<value>dcnamenode1,dchadoop1,dchadoop3,dchbase1,dchbase2</value>--> <value>vm13,vm7,vm8</value> </property> <property> <name>hbase.zookeeper.property.dataDir</name> <value>/data0/zookeeper</value> </property> <property> <name>hbase.regionserver.handler.count</name> <value> 32 </value> <description>Default: 10 . CountofRPCListenerinstancesspunuponRegionServers. Sameproperty is usedbytheMaster for countofmasterhandlers. </description> </property> <!--memStoreflushpolicy:noblockingwrites--> <property> <name>hbase.hregion.memstore.flush.size</name> <value> 134217728 </value> <description>Default: 134217728 (128MB) Memstorewillbeflushedtodisk if sizeofthememstore exceeds this numberofbytes.Value is checkedbyathreadthatruns everyhbase.server.thread.wakefrequency. </description> </property> <property> <name>hbase.regionserver.maxlogs</name> <value> 64 </value> <description>Default: 32 .</description> </property> <!-- <property> <name>hbase.regionserver.hlog.blocksize</name> <value> 67108864 </value> <description>Default is hdfsblocksize,e.g.64MB/128MB</description> </property> --> <property> <name>hbase.regionserver.optionalcacheflushinterval</name> <value> 7200000 </value> <description>Default: 3600000 ( 1 hour). Maximumamountoftimeaneditlives in memorybeforebeingautomaticallyflushed. Default 1 hour.Setitto 0 todisableautomaticflushing. </description> </property> <!--memStoreflushpolicy:blockingwrites--> <property> <name>hbase.hregion.memstore.block.multiplier</name> <value> 3 </value> <description>Default: 2 . Blockupdates if memstorehashbase.hregion.block.memstore timehbase.hregion.flush.sizebytes.Usefulpreventing runawaymemstoreduringspikes in updatetraffic.Withoutan upper-bound,memstorefillssuchthatwhenitflushesthe resultantflushfilestakealongtimetocompactorsplit,or worse,weOOME. </description> </property> <property> <name>hbase.regionserver.global.memstore.lowerLimit</name> <value> 0.35 </value> <description>Default: 0.35 . Whenmemstoresarebeingforcedtoflushtomakeroom in memory,keepflushinguntilwehit this mark.Defaultsto 35 %ofheap. Thisvalueequaltohbase.regionserver.global.memstore.upperLimitcauses theminimumpossibleflushingtooccurwhenupdatesareblockeddueto memstorelimiting. </description> </property> <property> <name>hbase.regionserver.global.memstore.upperLimit</name> <value> 0.4 </value> <description>Default: 0.4 . Maximumsizeofallmemstores in aregionserverbefore new updatesareblockedandflushesareforced.Defaultsto 40 %ofheap </description> </property> <property> <name>hbase.hstore.blockingStoreFiles</name> <value> 256 </value> <description>Default: 7 . Ifmorethan this numberofStoreFiles in anyoneStore (oneStoreFile is writtenperflushofMemStore)thenupdatesare blocked for this HRegionuntilacompaction is completed,or untilhbase.hstore.blockingWaitTimehasbeenexceeded. </description> </property> <!--splitpolicy--> <property> <name>hbase.hregion.max.filesize</name> <value> 4294967296 </value> <description>Default: 10737418240 (10G). MaximumHStoreFilesize.Ifanyoneofacolumnfamilies'HStoreFileshas growntoexceed this value,thehostingHRegion is split in two. </description> </property> <!--compactpolicy--> <property> <name>hbase.hregion.majorcompaction</name> <value> 0 </value> <description>Default: 1 day. Thetime( in miliseconds)between 'major' compactionsofall HStoreFiles in aregion.Default: 1 day. Setto 0 todisableautomatedmajorcompactions. </description> </property> <property> <name>hbase.hstore.compactionThreshold</name> <value> 5 </value> <description>Default: 3 . Ifmorethan this numberofHStoreFiles in anyoneHStore (oneHStoreFile is writtenperflushofmemstore)thenacompaction is runtorewriteallHStoreFilesfiles as one.Largernumbers putoffcompactionbutwhenitruns,ittakeslongertocomplete. </description> </property> </configuration> 3.3 regionservers 1 2 vm7 vm8 3.4将修改的好/usr/local/hbase-0.94.16整个目录复制到vm7,vm8,注意修改好属主属组hadoop权限 3.5事先创建/data0,并属主属组为hadoop 3.6 启动hbase 1 [hadoop@vm13conf]$start-hbase.sh 3.7 验证进程是否成功 1 2 3 [hadoop@vm13conf]$jps 8146 Jps 7988 HMaster 1 2 3 4 [hadoop@vm7conf]$jps 4798 Jps 4571 HQuorumPeer 4656 HRegionServer 1 2 3 4 [hadoop@vm8conf]$jps 4022 HQuorumPeer 4251 Jps 4111 HRegionServer 四、zookeeper 1.软件准备 1 zookeeper- 3.4 . 5 .tar.gz 2.解压包 1 2 3 4 5 [hadoop@vm13local]$pwd /usr/local [hadoop@vm13local]$ls-l drwxr-xr-x. 10 hadoophadoop 4096 Apr 22 2014 zookeeper 3.配置文件 3.1log4j.properties 3.1.1 配置根Logger 其语法为: log4j.rootLogger = [ level ] , appenderName1, appenderName2, … level : 是日志记录的优先级,分为OFF、FATAL、ERROR、WARN、INFO、DEBUG、ALL或者您定义的级别。Log4j建议只使用四个级别,优先级从高到低分别是ERROR、WARN、INFO、DEBUG。通过在这里定义的级别,您可以控制到应用程序中相应级别的日志信息的开关。比如在这里定 义了INFO级别,则应用程序中所有DEBUG级别的日志信息将不被打印出来。appenderName:就是指定日志信息输出到哪个地方。您可以同时指定多个输出目的地。 例如:log4j.rootLogger=info,A1,B2,C3 3.1.2 配置日志信息输出目的地 其语法为: log4j.appender.appenderName = fully.qualified.name.of.appender.class // "fully.qualified.name.of.appender.class" 可以指定下面五个目的地中的一个: 1.org.apache.log4j.ConsoleAppender(控制台) 2.org.apache.log4j.FileAppender(文件) 3.org.apache.log4j.DailyRollingFileAppender(每天产生一个日志文件) 4.org.apache.log4j.RollingFileAppender(文件大小到达指定尺寸的时候产生一个新的文件) 5.org.apache.log4j.WriterAppender(将日志信息以流格式发送到任意指定的地方) 1.ConsoleAppender选项 Threshold=WARN:指定日志消息的输出最低层次。 ImmediateFlush=true:默认值是true,意谓着所有的消息都会被立即输出。 Target=System.err:默认情况下是:System.out,指定输出控制台 2.FileAppender 选项 Threshold=WARN:指定日志消息的输出最低层次。 ImmediateFlush=true:默认值是true,意谓着所有的消息都会被立即输出。 File=mylog.txt:指定消息输出到mylog.txt文件。 Append=false:默认值是true,即将消息增加到指定文件中,false指将消息覆盖指定的文件内容。 3.DailyRollingFileAppender 选项 Threshold=WARN:指定日志消息的输出最低层次。 ImmediateFlush=true:默认值是true,意谓着所有的消息都会被立即输出。 File=mylog.txt:指定消息输出到mylog.txt文件。 Append=false:默认值是true,即将消息增加到指定文件中,false指将消息覆盖指定的文件内容。 DatePattern=''.''yyyy-ww:每周滚动一次文件,即每周产生一个新的文件。当然也可以指定按月、周、天、时和分。即对应的格式如下: 1)''.''yyyy-MM: 每月 2)''.''yyyy-ww: 每周 3)''.''yyyy-MM-dd: 每天 4)''.''yyyy-MM-dd-a: 每天两次 5)''.''yyyy-MM-dd-HH: 每小时 6)''.''yyyy-MM-dd-HH-mm: 每分钟 4.RollingFileAppender 选项 Threshold=WARN:指定日志消息的输出最低层次。 ImmediateFlush=true:默认值是true,意谓着所有的消息都会被立即输出。 File=mylog.txt:指定消息输出到mylog.txt文件。 Append=false:默认值是true,即将消息增加到指定文件中,false指将消息覆盖指定的文件内容。 MaxFileSize=100KB: 后缀可以是KB, MB 或者是 GB. 在日志文件到达该大小时,将会自动滚动,即将原来的内容移到mylog.log.1文件。 MaxBackupIndex=2:指定可以产生的滚动文件的最大数。 3.1.3 配置日志信息的格式 其语法为: 1). log4j.appender.appenderName.layout = fully.qualified.name.of.layout.class "fully.qualified.name.of.layout.class" 可以指定下面4个格式中的一个: 1.org.apache.log4j.HTMLLayout(以HTML表格形式布局), 2.org.apache.log4j.PatternLayout(可以灵活地指定布局模式), 3.org.apache.log4j.SimpleLayout(包含日志信息的级别和信息字符串), 4.org.apache.log4j.TTCCLayout(包含日志产生的时间、线程、类别等等信息) 1.HTMLLayout 选项 LocationInfo=true:默认值是false,输出java文件名称和行号 Title=my app file: 默认值是 Log4J Log Messages. 2.PatternLayout 选项 ConversionPattern=%m%n :指定怎样格式化指定的消息。 3.XMLLayout 选项 LocationInfo=true:默认值是false,输出java文件和行号 2). log4j.appender.A1.layout.ConversionPattern=%-4r %-5p %d{yyyy-MM-dd HH:mm:ssS} %c %m%n 这里需要说明的就是日志信息格式中几个符号所代表的含义: -X号: X信息输出时左对齐; %p: 输出日志信息优先级,即DEBUG,INFO,WARN,ERROR,FATAL, %d: 输出日志时间点的日期或时间,默认格式为ISO8601,也可以在其后指定格式,比如:%d{yyy MMM dd HH:mm:ss,SSS},输出类似:2002年10月18日 22:10:28,921 %r: 输出自应用启动到输出该log信息耗费的毫秒数 %c: 输出日志信息所属的类目,通常就是所在类的全名 %t: 输出产生该日志事件的线程名 %l: 输出日志事件的发生位置,相当于%C.%M(%F:%L)的组合,包括类目名、发生的线程,以及在代码中的行数。举例:Testlog4.main(TestLog4.java:10) %x: 输出和当前线程相关联的NDC(嵌套诊断环境),尤其用到像java servlets这样的多客户多线程的应用中。 %%: 输出一个"%"字符 %F: 输出日志消息产生时所在的文件名称 %L: 输出代码中的行号 %m: 输出代码中指定的消息,产生的日志具体信息 %n: 输出一个回车换行符,Windows平台为"",Unix平台为" "输出日志信息换行 可以在%与模式字符之间加上修饰符来控制其最小宽度、最大宽度、和文本的对齐方式。如: 1)%20c:指定输出category的名称,最小的宽度是20,如果category的名称小于20的话,默认的情况下右对齐。 2)%-20c:指定输出category的名称,最小的宽度是20,如果category的名称小于20的话,"-"号指定左对齐。 3)%.30c:指定输出category的名称,最大的宽度是30,如果category的名称大于30的话,就会将左边多出的字符截掉,但小于30的话也不会有空格。 4)%20.30c:如果category的名称小于20就补空格,并且右对齐,如果其名称长于30字符,就从左边交远销出的字符截掉 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 #Definesome default valuesthatcanbeoverriddenbysystemproperties zookeeper.root.logger=INFO,ROLLINGFILE zookeeper.console.threshold=INFO #zookeeper.log.dir=. zookeeper.log.dir=/data0/zookeeper/logs zookeeper.log.file=zookeeper.log zookeeper.log.threshold=INFO #zookeeper. trace log.dir=. zookeeper. trace log.dir=/data0/zookeeper/logs zookeeper. trace log.file=zookeeper_ trace .log # #ZooKeeperLoggingConfiguration # #Format is "< default threshold>(,<appender>)+ #DEFAULT:consoleappenderonly log4j.rootLogger=${zookeeper.root.logger} #Example with rollinglogfile #log4j.rootLogger=DEBUG,CONSOLE,ROLLINGFILE #Example with rollinglogfileandtracing #log4j.rootLogger=TRACE,CONSOLE,ROLLINGFILE,TRACEFILE # #LogINFOlevelandabovemessagestotheconsole # log4j.appender.CONSOLE=org.apache.log4j.ConsoleAppender log4j.appender.CONSOLE.Threshold=${zookeeper.console.threshold} log4j.appender.CONSOLE.layout=org.apache.log4j.PatternLayout log4j.appender.CONSOLE.layout.ConversionPattern=%d{ISO8601}[myid:%X{myid}]-%-5p[%t:%C{ 1 }@%L]-%m%n # #AddROLLINGFILEtorootLoggerto get logfileoutput #LogDEBUGlevelandabovemessagestoalogfile log4j.appender.ROLLINGFILE=org.apache.log4j.RollingFileAppender log4j.appender.ROLLINGFILE.Threshold=${zookeeper.log.threshold} log4j.appender.ROLLINGFILE.File=${zookeeper.log.dir}/${zookeeper.log.file} #Maxlogfilesizeof10MB log4j.appender.ROLLINGFILE.MaxFileSize=10MB #uncommentthenextlinetolimitnumberofbackupfiles #log4j.appender.ROLLINGFILE.MaxBackupIndex= 10 log4j.appender.ROLLINGFILE.layout=org.apache.log4j.PatternLayout log4j.appender.ROLLINGFILE.layout.ConversionPattern=%d{ISO8601}[myid:%X{myid}]-%-5p[%t:%C{ 1 }@%L]-%m%n # #AddTRACEFILEtorootLoggerto get logfileoutput #LogDEBUGlevelandabovemessagestoalogfile log4j.appender.TRACEFILE=org.apache.log4j.FileAppender log4j.appender.TRACEFILE.Threshold=TRACE log4j.appender.TRACEFILE.File=${zookeeper. trace log.dir}/${zookeeper. trace log.file} log4j.appender.TRACEFILE.layout=org.apache.log4j.PatternLayout ###Noticeweareincludinglog4j'sNDChere(%x) log4j.appender.TRACEFILE.layout.ConversionPattern=%d{ISO8601}[myid:%X{myid}]-%-5p[%t:%C{ 1 }@%L][%x]-%m%n 3.2 zoo.cfg zookeeper服务器集合体中,每个服务器都有一个数值型ID,服务器ID在集合体中是唯一的,并且取值范围在1到255之间。通过一个名为myid的纯文本文件设定服务器ID,这个文件保存在dataDir参数所指定的目录中 每台服务器添格格式如下 server.n=hostname:port:port n是服务器的ID。这里2个端口设置:第一个是跟随者用来连接领导者的端口;第二个端口用来被用于领导者选举。如server.2=10.1.2.198:12888:13888,服务器在3个端口上监听,2181端口用于客户端连接;对于领导者来说,12888被用于跟随者连接;13888端口被用于领导者选举阶段的其他务器连接。当一个zookeeper服务器启动时,读取myid文件用于确定自己的服务器ID,然后通过读取配置文件来确定应当在哪个端口进行听,同时确定集合体中其他服务器的网络地址。 initLimit:设定所有跟随者与领导者进行连接同步的时间范围。如果设定的时间段内,半数以上的跟随者未能完成同步,领导者宣布放弃领导地位,然后进行另外一次领导者选举。如果这情况经常发生,可通过日志中记录发现情况,表明设定的值太小 syncLimit:设定了允许一个跟随者与领导者进行同步的时间。如果在设定时间段内,一个跟随者未能完成同步,会自己重启。所有关联到跟随者客户端将连接另一个跟随者 tickTime:指定了zookeeper中基本时间单元(以毫秒为单位) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 #Thenumberofmillisecondsof each tick tickTime= 2000 #Thenumberofticksthattheinitial #synchronizationphasecantake initLimit= 10 #Thenumberofticksthatcanpassbetween #sendingarequestandgettinganacknowledgement syncLimit= 5 #thedirectorywherethesnapshot is stored. # do not use /tmp for storage,/tmphere is just #examplesakes. dataDir=/data0/zookeeper/data #theportatwhichtheclientswillconnect clientPort= 2181 server. 1 =vm13: 12888 : 13888 server. 2 =vm7: 12888 : 13888 server. 3 =vm8: 12888 : 13888 # #Besuretoreadthemaintenancesectionofthe #administratorguidebeforeturningonautopurge. # #http: //zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance # #Thenumberofsnapshotstoretain in dataDir #autopurge.snapRetainCount= 3 #Purgetaskinterval in hours #Setto "0" todisableautopurgefeature #autopurge.purgeInterval= 1 3.3 zookeeper-env.sh 1 2 ZOO_LOG_DIR=/data0/zookeeper/logs ZOO_LOG4J_PROP=INFO,ROLLINGFILE 五、启动 1.修改hbase-env.sh,不使用hbase自带zookeeper工具 1 exportHBASE_MANAGES_ZK= true 2.启动zookeeper,并查看日志 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 [hadoop@vm13data]$zkServer.shstart JMXenabledby default Usingconfig:/usr/local/zookeeper/bin/../conf/zoo.cfg Startingzookeeper...^[[ASTARTED [hadoop@vm13data]$tail/data0/zookeeper/logs/zookeeper.log-n 30 org.apache.zookeeper.server.quorum.QuorumPeerConfig$ConfigException:Errorprocessing/usr/local/zookeeper/bin/../conf/zoo.cfg atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parse(QuorumPeerConfig.java: 121 ) atorg.apache.zookeeper.server.quorum.QuorumPeerMain.initializeAndRun(QuorumPeerMain.java: 101 ) atorg.apache.zookeeper.server.quorum.QuorumPeerMain.main(QuorumPeerMain.java: 78 ) Causedby:java.lang.IllegalArgumentException:serverid null is notanumber atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parseProperties(QuorumPeerConfig.java: 358 ) atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parse(QuorumPeerConfig.java: 117 ) ... 2 more 2016 - 01 - 14 13 : 19 : 27 , 482 [myid:]-INFO[main:QuorumPeerConfig@ 101 ]-Readingconfigurationfrom:/usr/local/zookeeper/bin/../conf/zoo.cfg 2016 - 01 - 14 13 : 19 : 27 , 488 [myid:]-INFO[main:QuorumPeerConfig@ 334 ]-Defaultingtomajorityquorums 2016 - 01 - 14 13 : 19 : 27 , 489 [myid:]-ERROR[main:QuorumPeerMain@ 85 ]-Invalidconfig,exitingabnormally org.apache.zookeeper.server.quorum.QuorumPeerConfig$ConfigException:Errorprocessing/usr/local/zookeeper/bin/../conf/zoo.cfg atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parse(QuorumPeerConfig.java: 121 ) atorg.apache.zookeeper.server.quorum.QuorumPeerMain.initializeAndRun(QuorumPeerMain.java: 101 ) atorg.apache.zookeeper.server.quorum.QuorumPeerMain.main(QuorumPeerMain.java: 78 ) Causedby:java.lang.IllegalArgumentException:serverid null is notanumber atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parseProperties(QuorumPeerConfig.java: 358 ) atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parse(QuorumPeerConfig.java: 117 ) ... 2 more 2016 - 01 - 14 13 : 19 : 36 , 661 [myid:]-INFO[main:QuorumPeerConfig@ 101 ]-Readingconfigurationfrom:/usr/local/zookeeper/bin/../conf/zoo.cfg 2016 - 01 - 14 13 : 19 : 36 , 666 [myid:]-INFO[main:QuorumPeerConfig@ 334 ]-Defaultingtomajorityquorums 2016 - 01 - 14 13 : 19 : 36 , 668 [myid:]-ERROR[main:QuorumPeerMain@ 85 ]-Invalidconfig,exitingabnormally org.apache.zookeeper.server.quorum.QuorumPeerConfig$ConfigException:Errorprocessing/usr/local/zookeeper/bin/../conf/zoo.cfg atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parse(QuorumPeerConfig.java: 121 ) atorg.apache.zookeeper.server.quorum.QuorumPeerMain.initializeAndRun(QuorumPeerMain.java: 101 ) atorg.apache.zookeeper.server.quorum.QuorumPeerMain.main(QuorumPeerMain.java: 78 ) Causedby:java.lang.IllegalArgumentException:serverid null is notanumber atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parseProperties(QuorumPeerConfig.java: 358 ) atorg.apache.zookeeper.server.quorum.QuorumPeerConfig.parse(QuorumPeerConfig.java: 117 ) ... 2 more 从日志查看可以知道,Zookeeper的启动入口org.apache.zookeeper.server.quorum.QuorumPeerMain。 在这个类的main方法里进入了zookeeper的启动过程,首先我们会解析配置文件,即zoo.cfg和myid。 3.创建服务器ID 1 [hadoop@vm13data]$echo 1 >myid 1 [hadoop@vm7zookeeper]$echo 2 >/data0/zookeeper/data/myid 1 [hadoop@vm8zookeeper]$echo 3 >/data0/zookeeper/data/myid 4.再启动 zookeep服务,需要三台单独各启动起来 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 [hadoop@vm13data]$zkServer.shstart JMXenabledby default Usingconfig:/usr/local/zookeeper/bin/../conf/zoo.cfg Startingzookeeper...STARTED [hadoop@vm13data]$tail/data0/zookeeper/logs/zookeeper.log-n 30 atjava.net.AbstractPlainSocketImpl.connect(AbstractPlainSocketImpl.java: 182 ) atjava.net.SocksSocketImpl.connect(SocksSocketImpl.java: 392 ) atjava.net.Socket.connect(Socket.java: 579 ) atorg.apache.zookeeper.server.quorum.QuorumCnxManager.connectOne(QuorumCnxManager.java: 354 ) atorg.apache.zookeeper.server.quorum.QuorumCnxManager.toSend(QuorumCnxManager.java: 327 ) atorg.apache.zookeeper.server.quorum.FastLeaderElection$Messenger$WorkerSender.process(FastLeaderElection.java: 393 ) atorg.apache.zookeeper.server.quorum.FastLeaderElection$Messenger$WorkerSender.run(FastLeaderElection.java: 365 ) atjava.lang.Thread.run(Thread.java: 724 ) 2016 - 01 - 14 13 : 29 : 27 , 154 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :QuorumPeer@ 738 ]-FOLLOWING 2016 - 01 - 14 13 : 29 : 27 , 177 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Learner@ 85 ]-TCPNoDelay set to: true 2016 - 01 - 14 13 : 29 : 27 , 184 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:zookeeper.version= 3.4 . 5 - 1392090 ,builton 09 / 30 / 2012 17 : 52 GMT 2016 - 01 - 14 13 : 29 : 27 , 184 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:host.name=vm13 2016 - 01 - 14 13 : 29 : 27 , 184 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:java.version= 1.7 .0_25 2016 - 01 - 14 13 : 29 : 27 , 184 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:java.vendor=OracleCorporation 2016 - 01 - 14 13 : 29 : 27 , 185 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:java.home=/usr/local/jdk1. 7 .0_25/jre 2016 - 01 - 14 13 : 29 : 27 , 185 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:java. class .path=/usr/local/zookeeper/bin/../build/classes:/usr/local/zookeeper/bin/../build/lib/*.jar:/usr/local/zookeeper/bin/../lib/slf4j-log4j12- 1.6 . 1 .jar:/usr/local/zookeeper/bin/../lib/slf4j-api- 1.6 . 1 .jar:/usr/local/zookeeper/bin/../lib/netty- 3.2 . 2 .Final.jar:/usr/local/zookeeper/bin/../lib/log4j- 1.2 . 15 .jar:/usr/local/zookeeper/bin/../lib/jline- 0.9 . 94 .jar:/usr/local/zookeeper/bin/../zookeeper- 3.4 . 5 .jar:/usr/local/zookeeper/bin/../src/java/lib/*.jar:/usr/local/zookeeper/bin/../conf: 2016 - 01 - 14 13 : 29 : 27 , 185 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:java.library.path=/usr/java/packages/lib/amd64:/usr/lib64:/lib64:/lib:/usr/lib 2016 - 01 - 14 13 : 29 : 27 , 185 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:java.io.tmpdir=/tmp 2016 - 01 - 14 13 : 29 : 27 , 186 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:java.compiler=<NA> 2016 - 01 - 14 13 : 29 : 27 , 186 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:os.name=Linux 2016 - 01 - 14 13 : 29 : 27 , 186 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:os.arch=amd64 2016 - 01 - 14 13 : 29 : 27 , 189 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:os.version= 2.6 . 32 - 431 .el6.x86_64 2016 - 01 - 14 13 : 29 : 27 , 189 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:user.name=hadoop 2016 - 01 - 14 13 : 29 : 27 , 190 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:user.home=/home/hadoop 2016 - 01 - 14 13 : 29 : 27 , 190 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Environment@ 100 ]-Serverenvironment:user.dir=/data0/zookeeper/data 2016 - 01 - 14 13 : 29 : 27 , 191 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :ZooKeeperServer@ 162 ]-Createdserver with tickTime 2000 minSessionTimeout 4000 maxSessionTimeout 40000 datadir/data0/zookeeper/data/version- 2 snapdir/data0/zookeeper/data/version- 2 2016 - 01 - 14 13 : 29 : 27 , 194 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Follower@ 63 ]-FOLLOWING-LEADERELECTIONTOOK- 283 2016 - 01 - 14 13 : 29 : 27 , 223 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :Learner@ 322 ]-Gettingadifffromtheleader 0x100000002 2016 - 01 - 14 13 : 29 : 27 , 228 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :FileTxnSnapLog@ 240 ]-Snapshotting: 0x100000002 to/data0/zookeeper/data/version- 2 /snapshot. 100000002 2016 - 01 - 14 13 : 29 : 27 , 230 [myid: 0 ]-INFO[QuorumPeer[myid= 0 ]/ 0 : 0 : 0 : 0 : 0 : 0 : 0 : 0 : 12181 :FileTxnSnapLog@ 240 ]-Snapshotting: 0x100000002 to/data0/zookeeper/data/version- 2 /snapshot. 100000002 5、验证 使用nc(telnet也可以)发送ruok命令(Are you OK?)到监听端口,检查zookeeper是否正在运行 1 2 imok[hadoop@vm13hbase]$echo "ruok" |nclocalhost 2181 imok 进程验证 1 2 3 4 5 6 7 8 9 10 11 12 13 14 [hadoop@vm13data]$jps 9134 Jps 9110 QuorumPeerMain [hadoop@vm7zookeeper]$jps 5312 Jps 5287 QuorumPeerMain [hadoop@vm8zookeeper]$jps 4797 Jps 4732 QuorumPeerMain 6.启动hbase,查看日志 1 2 3 4 [hadoop@vm13data]$start-hbase.shstart startingmaster,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-master-vm13.out vm7:startingregionserver,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-regionserver-vm7.out vm8:startingregionserver,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-regionserver-vm8.out 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 [hadoop@vm13hbase- 0.94 . 16 ]$tail/usr/local/hbase- 0.94 . 16 /logs/hbase-hadoop-master-vm13.log-n 30 atorg.apache.hadoop.hbase.master.HMasterCommandLine.startMaster(HMasterCommandLine.java: 152 ) atorg.apache.hadoop.hbase.master.HMasterCommandLine.run(HMasterCommandLine.java: 104 ) atorg.apache.hadoop.util.ToolRunner.run(ToolRunner.java: 65 ) atorg.apache.hadoop.hbase.util.ServerCommandLine.doMain(ServerCommandLine.java: 76 ) atorg.apache.hadoop.hbase.master.HMaster.main(HMaster.java: 2120 ) Causedby:org.apache.zookeeper.KeeperException$ConnectionLossException:KeeperErrorCode=ConnectionLoss for /hbase atorg.apache.zookeeper.KeeperException.create(KeeperException.java: 99 ) atorg.apache.zookeeper.KeeperException.create(KeeperException.java: 51 ) atorg.apache.zookeeper.ZooKeeper.exists(ZooKeeper.java: 1041 ) atorg.apache.zookeeper.ZooKeeper.exists(ZooKeeper.java: 1069 ) atorg.apache.hadoop.hbase.zookeeper.RecoverableZooKeeper.exists(RecoverableZooKeeper.java: 199 ) atorg.apache.hadoop.hbase.zookeeper.ZKUtil.createAndFailSilent(ZKUtil.java: 1109 ) atorg.apache.hadoop.hbase.zookeeper.ZKUtil.createAndFailSilent(ZKUtil.java: 1099 ) atorg.apache.hadoop.hbase.zookeeper.ZKUtil.createAndFailSilent(ZKUtil.java: 1083 ) atorg.apache.hadoop.hbase.zookeeper.ZooKeeperWatcher.createBaseZNodes(ZooKeeperWatcher.java: 162 ) atorg.apache.hadoop.hbase.zookeeper.ZooKeeperWatcher.<init>(ZooKeeperWatcher.java: 155 ) atorg.apache.hadoop.hbase.master.HMaster.<init>(HMaster.java: 347 ) atsun.reflect.NativeConstructorAccessorImpl.newInstance0(NativeMethod) atsun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java: 57 ) atsun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java: 45 ) atjava.lang.reflect.Constructor.newInstance(Constructor.java: 526 ) atorg.apache.hadoop.hbase.master.HMaster.constructMaster(HMaster.java: 2101 ) ... 5 more 2016 - 01 - 14 13 : 32 : 33 , 200 INFOorg.apache.zookeeper.ClientCnxn:Openingsocketconnectiontoservervm8/ 10.1 . 2.198 : 2181 .WillnotattempttoauthenticateusingSASL(unknownerror) 2016 - 01 - 14 13 : 32 : 33 , 201 WARNorg.apache.zookeeper.ClientCnxn:Session 0x0 for server null ,unexpectederror,closingsocketconnectionandattemptingreconnect java.net.ConnectException:Connectionrefused atsun.nio.ch.SocketChannelImpl.checkConnect(NativeMethod) atsun.nio.ch.SocketChannelImpl.finishConnect(SocketChannelImpl.java: 708 ) atorg.apache.zookeeper.ClientCnxnSocketNIO.doTransport(ClientCnxnSocketNIO.java: 350 ) atorg.apache.zookeeper.ClientCnxn$SendThread.run(ClientCnxn.java: 1068 ) 从日志 来看:org.apache.zookeeper.KeeperException$ConnectionLossException: KeeperErrorCode = ConnectionLoss for /hbase。这是由于hbase自带zookeeper管理具,在hadoop上创建/hbase是目录,所以回到hadoop集群下mastser查看 1 2 3 4 [root@masterhadoop1. 0 ]#hadoopfs-ls/ Found 2 items drwxr-xr-x-hadoopsupergroup 0 2016 - 01 - 11 11 : 40 /hadoop drwxr-xr-x-hadoopsupergroup 0 2016 - 01 - 14 10 : 42 /hbase 删除/hbase 1 2 [hadoop@masterhadoop1. 0 ]$hadoopfs-rmr/hbase Movedtotrash:hdfs: //master:9000/hbase 另外如果zookeeper定义不是默认的2181端口,比如是12181端口,那么还要在hbase-site.sh下需要添加 1 2 3 4 5 6 7 8 <property> <name>hbase.zookeeper.property.clientPort</name> <value> 12181 </value> <description> PropertyfromZooKeeper'sconfigzoo.cfg. Theportatwhichtheclientswillconnect. </description> </property> 再启动 1 2 3 4 [hadoop@vm13conf]$start-hbase.sh startingmaster,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-master-vm13.out vm8:startingregionserver,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-regionserver-vm8.out vm7:startingregionserver,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-regionserver-vm7.out 检查 1 2 3 4 hadoop@vm13conf]$start-hbase.sh startingmaster,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-master-vm13.out vm8:startingregionserver,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-regionserver-vm8.out vm7:startingregionserver,loggingto/usr/local/hbase- 0.94 . 16 //logs/hbase-hadoop-regionserver-vm7.out 日志 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 [hadoop@vm13conf]$tail../logs/hbase-hadoop-master-vm13.log-n 50 2016 - 01 - 14 16 : 34 : 19 , 901 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 19 , 904 INFOorg.apache.hadoop.hbase.catalog.CatalogTracker:Failedverificationof.META.,, 1 ataddress=vm7, 60020 , 1452760130913 ;org.apache.hadoop.hbase.NotServingRegionException:org.apache.hadoop.hbase.NotServingRegionException:Region is notonline:.META.,, 1 2016 - 01 - 14 16 : 34 : 19 , 957 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 19 , 958 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 19 , 967 INFOorg.apache.hadoop.hbase.catalog.CatalogTracker:Failedverificationof.META.,, 1 ataddress=vm7, 60020 , 1452760130913 ;org.apache.hadoop.hbase.NotServingRegionException:org.apache.hadoop.hbase.NotServingRegionException:Region is notonline:.META.,, 1 2016 - 01 - 14 16 : 34 : 19 , 973 DEBUGorg.apache.hadoop.hbase.master.AssignmentManager:Handlingtransition=RS_ZK_REGION_OPENING,server=vm8, 60020 , 1452760452737 ,region= 1028785192 /.META. 2016 - 01 - 14 16 : 34 : 20 , 019 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 20 , 021 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 20 , 025 INFOorg.apache.hadoop.hbase.catalog.CatalogTracker:Failedverificationof.META.,, 1 ataddress=vm7, 60020 , 1452760130913 ;org.apache.hadoop.hbase.NotServingRegionException:org.apache.hadoop.hbase.NotServingRegionException:Region is notonline:.META.,, 1 2016 - 01 - 14 16 : 34 : 20 , 030 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 20 , 032 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 20 , 038 INFOorg.apache.hadoop.hbase.catalog.CatalogTracker:Failedverificationof.META.,, 1 ataddress=vm7, 60020 , 1452760130913 ;org.apache.hadoop.hbase.NotServingRegionException:org.apache.hadoop.hbase.NotServingRegionException:Region is notonline:.META.,, 1 2016 - 01 - 14 16 : 34 : 20 , 093 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34 : 20 , 094 DEBUGorg.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation:Lookeduprootregionlocation,connection=org.apache.hadoop.hbase.client.HConnectionManager$HConnectionImplementation@4c627d22;serverName=vm7, 60020 , 1452760452808 2016 - 01 - 14 16 : 34

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册