首页 文章 精选 留言 我的

精选列表

搜索[低空时代],共10000篇文章
优秀的个人博客,低调大师

手机流量“薄利多销”时代已结束

连续四年,政府工作报告中都为“提速降费”制定了年度“小目标”。不过和往年明显不同,今年的政府工作报告中只是提出“宽带和专线平均资费降低15%”,没有再对降低移动网络流量资费设定目标。 而在过去,比如在2018年和2019年的政府工作报告中,先后提出“移动网络流量资费年内至少降低30%”“移动网络流量平均资费再降低20%以上”。 为何不再提及降低移动网络流量资费,这背后的原因是什么? 原因之一在于,从2015年算起,经过连续5年大力推进“提速降费”工作,我国的移动网络流量资费水平下降非常明显,资费贵的矛盾已经大大缓解。 在2017年一季度时,我国的手机流量平均资费超过35元/GB,到2019年第四季度已降至5元/GB,到2020年第一季度,进一步降低至4.4元/GB。现在来看,我国的流量资费已经比美国、日本、韩国等国低了很多,下降的空间比较小。 原因之二在于,流量资费降低后带来的“薄利多销”效应和过去相比已经大大弱化,流量使用量呈现出增长明显放慢的状态,造成收入增长乏力的效应。 目前,流量收入仍是电信运营商的收入支柱,在新兴业务没有真正扛起“大梁”之前,如果一味要求降低流量资费,一旦这根“支柱”倒下或者摇摇欲坠,不仅是对电信运营商行业整体不利,更重要的是对加快5G发展和 “新基建”进度带来不利影响,毕竟,运营商在5G和“新基建”领域承担着极其重要的作用。 过去几年,流量资费降低带来的消费刺激效应非常明显,释放了居民信息消费潜力。这并非虚言,一组组翔实的数据可以证明。 从2015年开始到2018年,每年我国的移动互联网接入流量(其中手机上网流量占据绝大部分)消费水平都保持着100%以上的增长速度,放眼全世界,实属罕见。 尤其是2017年、2018年堪称高峰期,每年移动互联网接入流量同比增幅都超过150%。对于个人用户而言,很明显的感触在于:自己敢用流量了,每个月使用的流量越来越多。2015年时,我国月户均移动互联网接入流量(DOU)达到389.3MB/户/月,也就是说,每位手机用户每月使用的流量不到400MB,而到2019年12月这一数字已经高达8.59GB/户/月,足足提升了23倍。 过去数年时间,虽然流量资费降低了,但是因为降价带来的刺激效应,使得人们的流量消费水平提升非常迅速,这带动了电信运营商数据流量收入在快速增长,逐渐成为电信运营商的支柱型收入来源。 我国移动数据流量平均资费和用户月均移动数据使用量情况 图源/信通院 以2018年为例,这一年,中国移动的手机上网流量同比猛增182%,带动手机上网流量收入增长9.8%,手机上网流量收入达到3694亿元,在其通信服务收入中占比达到55.1%,在经营收入中占比也达到50%,成为不折不扣的最大收入来源。 另外两家运营商,手机上网流量收入在经营收入同样成为各自收入增长的主要驱动力。2018年,中国电信的手机上网流量大幅提升了291%,手机流量收入同比增长22.4%,达到1112亿元,在整体经营收入中的占比接近30%。这一年,中国联通的手机上网流量也激增1.8倍,手机上网收入同比增长13.7%,达到人民币1048亿元,在整体经营收入中的占比提升至36%。 这段时间,虽然流量业务量增长和流量收入增长之间的“量收剪刀差”在不断拉大,达到史无前例的水平。但是,因为“薄利多销”效应,刺激了运营商流量收入的较快增长,为业务收入增长做出了巨大贡献,所以“量收剪刀差”矛盾并没有引起太多关注。 但是,随着时间的推移,“薄利多销”的效应在减弱。 从2019年和今年前四个月的情况来看,用户流量消费水平的增速已经明显放缓,呈现乏力态势。 '根据工信部发布的数据,2019年我国移动互联网接入流量增速已从之前每年超过100%的增长,降低至71.6%,增速较上年收窄116.7个百分点。具体到三家电信运营商,都面临着相同的状况,和上一年相比手机上网流量增幅出现明显下滑,中国移动从2018年的182.1%增速降至2019年的90.3%,中国电信从291%降至73.2%,中国联通从180%降至46%。也就是说,虽然手机上网流量仍在增长,但是已经从过去的“大踏步”变成如今的“小碎步”。 在流量消费水平增长放缓的情况下,如果再要求流量资费水平继续一定幅度的下降,手机流量收入或将进入负增长的通道,这势必拉低运营商整体业务的增长,使得运营商面临更加严峻的局面。 对于国内运营商行业来说,之前已经遭遇流量红利释放过快的局面,现在“提速降费”没有再对流量资费降低做出“硬性规定”,让电信运营商“歇歇脚、喘口气”,从而更好去推进5G和“新基建”。同时,更希望5G应用能尽快成熟,不仅是行业应用,还有个人应用,为运营商的发展打开新天地。

优秀的个人博客,低调大师

谈AI时代如何填补信息安全漏洞

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 最近,中信银行信息泄漏事件持续发酵。继上海银保监局介入后,5月9日,银保监对各大银行进行监管审查。据银保监公布行政处罚信息公开表显示,中国银行、工商银行、中信银行等在内的8家银行,因监管标准化数据(EAST)系统数据质量及报送存在违法违规行为被罚,共计1770万元。 这起关于个人信息泄露的事件引起了社会的热议。在数据爆炸的当下,我们该如何应对永无止境的信息安全攻防战呢? 数据爆炸带来的困扰 近年来,随着移动互联网的高速发展,海量的数据信息在给我们生活带来便利的同时,个人信息泄露的问题也日渐凸显。最典型的例子就是Facebook等社交网络巨头,近年来,随着全球用户的增长,Facebook一直在为用户的隐私问题而烦恼。 就在5月9日,Facebook用户请求法官同意他们就一项集体诉讼达成5.5亿美元的和解。该诉讼指控Facebook通过照片标记工具非法收集生物识别数据。 据报道,Facebook已同意为集体诉讼成员关闭面部识别功能,删除现有的用户生物识别信息,除非在和解生效后的180天之内用户同意开启该面部识别功能。此外,集体诉讼成员将获得150~300美元的赔偿。 而在此前2018年10月,Facebook被爆8700万用户数据被不当泄露给政治咨询公司剑桥分析,随后FTC对此展开调查,并认为Facebook没有保障好用户的数据安全,违反了公司此前有关于保护用户隐私的承诺。经过长达一年半之久的调查后,Facebook与FTC达成和解协议,罚款50亿美元,并内部成立独立隐私委员会。 除了人为的之外,也有因系统漏洞而出现的隐私泄露问题。如2019年12月,Facebook因API安全漏洞,使黑客在访问受限的情况下也能访问用户的ID和电话号码,从而导致2.67亿个用户的隐私数据被非法售卖;2019年2月,深圳一家人工智能公司深网视界(SenseNets)因没有对人脸识别数据库进行密码保护,导致250万用户信息被"裸奔",包括身份证号码、地址、出生日期、识别其身份的位置等。 随着人工智能、大数据等前沿信息科技的深入发展,对金融数据的风险控制、信息安全和数据防护能力以及技术处理手段都提出了更高的要求。然而,对此常见的防护处理手段,仍然任重而道远。 “谁收集、谁负责”? 随着互联网的迅速发展,隐私问题也越来越受到重视。但面对数据市场需求旺盛,不少人利用买卖数据信息进行谋利。例如,2018年9月,华住酒店集团共140G约5亿条个人信息遭泄露、并在境外黑市中以8个比特币标价售卖;顺丰也被传出在“暗网”上以2个比特币售卖3亿条快递数据的消息,后顺丰辟谣称暗网所售数据非顺丰数据。这也间接说明,3亿条快递数据被售卖是实情。 如今,大量APP无论是否必要,都会要求用户同意“隐私条例”来收集用户手机号码、地理位置等,否则不予使用。据中国消费者协会在2018年8月发布的《APP个人信息泄露情况调查报告》显示,遇到过个人信息泄露情况的人数占比为85.2%。 根据调查结果,个人信息泄露的主要途径有四类: 1.经营者未经本人同意收集个人信息,约占调查总样本的62.2%; 2.经营者或不法分子故意泄露、出售或者非法向他人提供个人信息,约占调查总样本的60.6%; 3.网络服务系统存有漏洞造成个人信息泄露57.4% 4.不法分子通过木马病毒、钓鱼网站等手段盗取、骗取个人信息和经营者收集不必要的个人信息分别占34.4%和26.2%。 与之对应的,在这些数据收集的过程中,企业数据库安防力量薄弱、责任意识淡薄等因素为大规模数据泄露埋下伏笔。 据360互联网安全中心2018年发布的《WannaCry一周年勒索软件威胁形势分析报告》显示,2017年勒索病毒爆发前夕,各机构有58天的时间可以进行补丁升级等安全布防工作。但一些机构错误认为自身隔离措施足够安全、打补丁太麻烦而没有升级,致使其最终遭受勒索病毒攻击。 于此同时,大量传统企业依旧缺乏警惕,自认为不会成为被攻击对象,在用户数据保管上没有做好安全措施,最终导致大批量用户数据泄露。 从上述事件来看,这些数据泄露事件的起因大多是由于开发人员安全意识不强、企业对信息安全的重视程度不够,或者是因为公司存在“内鬼”导致。 实际上,早在2017年发布施行的《网络安全法》中就明确提出了“谁收集、谁负责”的原则。也就是说信息收集方要承担起保障数据安全的义务,但国内到现在也没有让广大公司意识到数据安全严峻性的标志性案件。 科技:只是个工具? 从世界范围来看,加强数据保护与利用相关立法已成趋势。例如2018年5月,被称为欧盟那个最严厉的《欧盟一般数据保护条例》(GDPR)生效实施,包含数据保护政策、数据加密等,进一步加强了对个人信息的保护力度。 然而,截至目前,我国依旧没有专门针对数据保护相关的条例,对于信息泄露缺乏强有力的惩罚措施。近年来,涉及数据保护与利用的立法活动,主要围绕个人信息保护并且是基于个人信息安全而展开的,而针对个人信息保护的责任认定及处罚主要集中在刑法、民法、网络安全法等大法当中。 由于这些大法涉及内容较广,针对个人信息保护的责任认定和处罚缺乏可操作的细节,量刑也相对较轻。如此次中信银行信息泄露的问题,最终也只是罚款160万元。而在此前,腾讯微信、新浪微博、百度贴吧等都因涉嫌违反《网络安全法》被立案调查,BOSS直聘网因涉嫌信息泄露被网信办责令整改,但最后大多仅仅只是赔礼道歉而已。 因此,建立健全相关数据保护的法律和法规已经势在必行。同时,当人脸识别、自动驾驶、AI+医疗等应用场景成为构建智慧城市的标配时,构建健全而完善的规章制度是维持智能社会正常运转的必备准绳。 除此之外,目前区块链也已成为保障数据安全的重要技术之一。诸如去中心化、不可篡改等区块链的特性,可应用于保险、物流、选举、公益等各行各业,以改善用户敏感数据保护中存在的安全隐患,保障数据安全。 科技只是工具,其中的善恶都取决于使用技术的人。当前,数据安全已然成为全球性的问题,如何界定科技进步和隐私保护的边界,成为科技界及整合社会共同面临的新挑战和新机遇但毋庸置疑的是,科技向善,要从“人性”出发,以人为本。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-05-12本文作者:csdn本文来自:“AI报道”,了解相关信息可以关注“AI报道”

优秀的个人博客,低调大师

云计算2.0时代即将到来

云计算已经改变了我们对数据管理和分布式工作负载的看法。 向任何一位首席信息官询问他们对多云的看法--数据和应用程序应该如何在所有公共云、私有云和本地云之间无缝地传输,以获得最低成本和最佳性能--你可能都会得到两种截然不同的回答。 其中一个典型的例子是来自那些还没有将计算转移到AWS、Microsoft Azure或Google Cloud等公共云的新手。他们对这个概念完全不感兴趣。因为他们的印象是,无论如何,云就应该是这样工作的。 另一个呢?这是为那些曾经和上面那些人有同样印象的人写的。然后,他们将数据和工作负载转移到了公共平台。现在,他们仍在想,是否真的可以实现多云。 事实上,这是有可能的。我们现在开始看到一个新的稳定的产品出现了,可以解决今天的多云缺点。今年1月,Gartner为这类新兴产品创造了“云数据生态系统”这一术语。分析公司451 research去年年底将其命名为“企业智能平台”,而Cloudera号称是该类别中最全面的平台,并在去年夏天将其命名为了“企业数据云” 我称之为云计算2.0。当一切尘埃落定,它最后将变成云1.0本应成为的一切。 发生了什么… 在看似无限的按需存储和计算能力的诱惑下,许多急于放弃数据中心资本化决策的早期采用者双双投入了云模型。但是很多人很快发现他们的脚卡在了需要着陆的地方。 这里有两个原因。首先,他们已经被锁定在长期合同当中,签订这些合同是为了在不知道实际需要多大能力的情况下也能够获得优惠价格。虽然他们支付的是固定利率,但实际上他们最终还是支付了更多。有些人最终只使用了他们保留的功能的一小部分。而那些低估了存储空间和计算需求的人最终会面临令人瞠目结舌的超额收费。 第二个原因是,他们了解到,在所有相关元数据都完好无损的情况下,从云服务将数据带回会是多么困难。放弃历史记录和其他描述性的上下文关联会极大地降低数据在未来分析中的价值。 在某种程度上,为了摆脱困境,企业开始越来越多地投资于自己的私有云能力,或者外包给第三方数据中心,或者投资于老式的、实地的、现场的资本化方案。他们的目标是最大限度地利用自己的资源,然后在绝对必要的时候才将其释放到云上。 “肯定有很多遣返活动在进行当中,”联想数据中心集团软件定义基础设施业务的技术总监Henry Vail告诉我。“客户真的很喜欢混合云的概念。因此,他们正在构建或外包自己的私有云。” 重要的是要理解那些冒险进入云的企业仍然对云模型充满热情,并继续致力于云计算。甚至一些还没有涉足实际云计算的公司也在投资并受益于虚拟机、容器和微服务的灵活性和效率。 云提供商都在使用他们自己的混合云选项来对此做出响应。事实上,去年年底,三大公共云提供商都发布了或增强了将其服务扩展到私有云部署的计划: AWS宣布了自己的基础设施即服务产品AWS Outposts 微软(Microsoft)于2017年首次引入Azure Stack,将其云服务扩展到了客户的数据中心,并发布了Azure Arc,将Azure Stack的保护伞扩展到更广泛的硬件和服务上面。 谷歌也披露了自己的混合云平台Google Anthos。 拥抱多云 就目前而言,这些服务都是受欢迎的扩展。也就是说,虽然它们都在将自己的平台从自己的公共云扩展到托管的私有云和内部数据中心,但它们都没有帮助客户走出自己的领域,然后进入竞争对手的云基础设施。 无论是在IBM和Redhat、HPE还是Oracle,您都会遇到与其他云提供商几乎相同的情况。像Nutanix和Dell的VMware这样的平台是独一无二的,因为它们支持多个云平台。但首先,你必须从中挑选一个。从一个地方移动到另一个地方仍然具有挑战性。 我们很难指责公共云提供商为何不愿为付费客户铺平道路,尽管有一天他们可能不得不这么做。因为客户确实需要云计算。 事实上,在云平台之间左右移动的能力,以及从公共云向私有或租赁资产的上下移动的能力,都是我们在听云广告时能够听到的。不幸的是,这并不是云提供商真正想说的。至少现在还没有。 “客户真的希望能够用单一的规则来管理一切,”Cloudera负责行业解决方案的副总裁Cindy Maike表示。“出于成本或性能方面的考虑,他们希望能够灵活地访问数据,并将工作负载放在最合理的地方。如今,客户想知道他们能以多快的速度来采取行动。” 当然,答案是它取决于或者主要取决于您将如何开发您的云架构。如果您从一开始就准备好了数据和工作负载,那么就会轻松很多。 而且还会有更多的帮助。 例如,在业务分析和机器学习方面,像Databricks、Looker和Rancher这样的公司可以用来帮助编排跨不同部署的ML项目。像Panoply、Qubole和Snowflake这样的公司则能够在混合云和多云部署中帮助协调数据。Cloudera的独特之处在于,它为数据和ML管理提供了新的Cloudera数据平台,这是与一年多前收购的Hortonworks进行功能合并的结果。 Cloudera平台的一个关键部分是它的治理能力,它可以帮助运营商设置和维护元数据参数,包括安全性、法规遵从性和数据分析--甚至是跨云平台的数据分析。当然,其他独立的数据管理平台也正在追求多云治理。最终,每个人都会需要这样做。因为如果没有轻松的数据和应用程序的可移植性,我们就无法实现真正的多云数据。 这就是云2.0的核心和灵魂,也正是我们想从云1.0中想要得到的。 【责任编辑: 赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

移动互联网时代的“下架故事”

元旦将近,在一年更迭的时候,各行各业的“总结体”又被提上日程。各个品牌的市场团队正在加紧制作H5,告诉用户他们的2019年打了多少次车、点了多少次外卖。就连热爱吵架的微博网友,都开始总结这一年自己骂过XX个人。 但回顾2019这一年,会发现今年可谓是互联网的“下架年”,不仅从年初开始就不断有行业头部、用户量巨大的App遭遇下架,最近更是有国家网络安全通报中心发文通报,下架整改100款违法违规App。其中包括天津银行、光大银行这样银行机构的产品,也包括樊登读书、晋江小说阅读这样的内容产品,还有考拉海淘这样的电商产品。 对于开发者来说,他们一年的总结或许是:近年你参与开发的产品中有X款被下架,累积下架时间达到了XX天,为了处理下架问题你参加了X次紧急会议…… 移动互联网规范史:App们为何下架? 回想2015年左右在App生态野蛮生长的时期,除非涉及法纪问题,“下架”很多时候都是应用商店方面的决定。尤其是特别“虐”的App Store,往往会因为排名等问题和运营者“勾心斗角”,当时如果App遭遇下架,往往是因为开发者在ASO过程中钻了空子或触犯一些规则,被应用商店惩罚式的下架,重新上架后往往会遇到排名、权重甚至评分都被清空的情况。 当然随着时间推移,App Store也对于“适用iOS 11”、“热更新”、“GDPR标准”等等情况提出了相关要求,但一般情况下应用商店造成的下架不会造成太多负面影响。真正造成影响的,还是网信办、工信部等等监管部门主导的App整改。 App下架史,同样也可以被看作移动互联网的“规范史”。 相关部门对于移动互联网的规范是逐步细化的,一开始是对整个类目的高度关注;像在2016年左右,下架规模最大的是涉赌的竞彩品类。随后逐渐提高对于内容合规性的关注;像是从2017年以来对于直播类、资讯分发类产品的高度关注,连今日头条、小红书这样极高国民度的产品,和内涵段子这样现象级的产品都曾“中枪”。 而在最近这次的大规模下架的原因,公安部加大打击整治侵犯公民个人信息违法犯罪力度,组织开展APP违法违规采集个人信息集中整治。下架的产品大部分都是因为缺乏详细的隐私协议或超范围、违规收集用户信息。可见移动互联网的规范行动,已经从品类走向内容,再走向了数据隐私。 发展在前,监管在后,这在商业世界似乎是一个很常见的现象。当移动互联网发展到顶峰,未来又开始与语音识别、人脸识别等等AI技术开始结合时,监管的逐步完善是自然的现象。 对于开发者来说,能够自查自纠减少触犯监管红线的可能当然是最好的,但今天我们要讨论的是,下架究竟会给产品甚至品牌带来哪些影响? 被骂、被抛弃、被山寨:2019年的下架故事 在我们以往的理解中,App下架造成的最多后果也只是一段时间内用户无法继续增长,再严重一些,可能会影响搜索权重、关键词排名等等。但从最近两年的案例来看,“下架”往往成为蝴蝶的翅膀,掀起一系列问题风暴。 其中有外部的公关问题。 今年2月份时,刚刚爆出上市计划不久后,知名“直男聚集地”虎扑就被下架,下架的原因据官方口径是“内部存在问题”。这样的说法显然不能平息猜测,加之虎扑一向与“粉圈”不睦,很快虎扑下架就被刷上了热搜,大量不同艺人粉丝在热搜里进行控评,舆论风向很快从“内部问题下架”变成了“究竟是杨超越粉丝让虎扑下架还是王源粉丝让虎扑下架”。粉丝们集中攻击称虎扑社区氛围过于“直男”极不友好,也再次让虎扑用户调性甚至整款产品的盈利能力被广泛讨论和怀疑。 对于尚未走向资本市场的虎扑来说,公关问题还只是说说而已。对于已经上市的企业来说结果则会直接反映到资本市场表现中,就像陌陌旗下的社交产品探探在被下架后,陌陌的股价直接跌掉了10%。 如果说下架引起的舆论情绪最多影响到股价,但内部的内容生态问题,就已经真正影响到产品的商业价值了。 今年最受关注的下架事件来自于小红书,小红书下架原因同样也错综复杂,有人说是因为大量炫富内容价值观不当,也有人说KOL发布的电子烟广告涉及违规,甚至还有说法称小红书中的网红中藏着很多“暗娼”。 实际上对于小红书这款用户量高达2.5亿的产品来说,即使一时下架,凭借其存量用户数量也能保证内容生态平稳运行。但事实却是,在下架期间,原本红火的KOL广告业务大受打击。广告主不仅降低了预算,以往小红书特有的“素人模式”(向只有几千、几百粉丝量博主广泛投放广告)几乎也消失殆尽。一位曾经从事小红书KOL广告销售告诉我们,原本他负责的就是这种“素人广告”的销售,2018年末到2019年初业务高峰时,常常有广告主一天向千余位素人博主投放广告,但下架事件发生后,广告主不仅会有避险心态,还对流量的真实度产生了怀疑。一些素人博主发现没有收益,慢慢的也减少了内容更新,这条产业链也慢慢萎靡了。 虽然过度商业化是不利于内容社区发展的,但适当的商业化机会一定是内容生态的润滑剂,下架对于商业的影响最终会转化为对于用户活跃度的影响——根据QuestMobile数据显示,截至今年9月底,小红书月活跃用户数为7288万,相比六月份的9300万月活下降了不少。 如果说公关危机和商业价值影响还属于因产品属性产生的个例,那么接下来的问题就是每一款被下架产品都有可能遇到的——山寨产品。 大多数情况下,当产品被下架时,应用商店也就无法再通过专栏推荐、排名等等方式对于产品进行保护。这时山寨App通过相似名字、VI设计来蹭流量的情况,就会频频出现。小红书、天天狼人杀等等产品都曾经遇到类似的情况。 要说最为悲惨的还是被彻底关停的“内涵段子”,由于这款产品似乎永无恢复之日,山寨产品也格外猖獗,不仅利用上类似的名称和icon,甚至还有产品用着内涵段子的icon起名皮皮搞笑,连内涵段子的转生小号也不放过。热心网友们只好去评论区里进行引导,称皮皮虾才是真正的内涵段子2.0。 除了建起缓冲带,我们还能做些什么? 从这些稀奇古怪的“下架故事”里,我们不难发现,看似“一段时间内不能被下载”这样无关紧要的情况,实则牵一发动全身。对于那些正处于上升期、产品内部生态复杂的产品来说,更是如此。 令人扼腕叹息的是,在经过四五年的奔跑之后,很多产品回首来时路,都能看到原罪的踪迹。这其中既包括数据采集规则这样与技术实现有关的情况,也包括内容价值观、用户调性、用户行为等等很难给出非黑即白评定的元素。尤其对于社交类和内容类的产品来说,监管以及下架这一监管带来的最轻微的后果,始终是悬在头顶的达摩克利斯之剑。 当然我们也可以找到一些正面案例,看看一些产品是如何安稳渡过下架风波的:像是传闻在100款App内的电商产品未来集市,就在消息传出后的第一时间澄清App并未下架,在接到通知后已经即使进行整改;又比如网易云音乐,干脆在下架时间进行了大规模的更新,重新上架后让云村、直播等等新功能来支撑起新的流量入口。 像这些产品这样,在下架发生后,及时作出清晰明了的公关回应,并在重新上架时增添新功能或宣布新的政策,可以较好的冲淡下架带来的负面效应。但这一切也只能勉强起到缓冲作用,至于App下架的其他不确定性,我们更是难以解决。 在接下来的一顿时间里,下架故事显然还会继续。最好的解决方式,或许还是让自己不要成为其中的主角。

优秀的个人博客,低调大师

云原生时代, Kubernetes 多集群架构初探

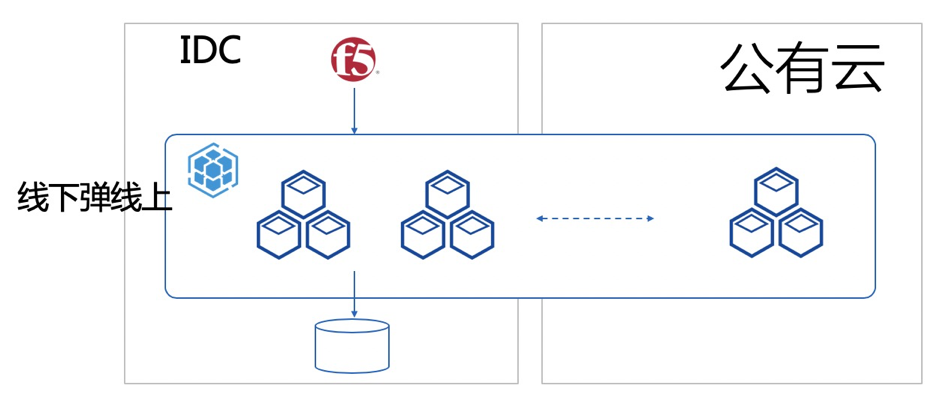
为什么我们需要多集群? 近年来,多集群架构已经成为“老生常谈”。我们喜欢高可用,喜欢异地多可用区,而多集群架构天生就具备了这样的能力。另一方面我们也希望通过多集群混合云来降低成本,利用到不同集群各自的优势和特性,以便使用不同集群的最新技术(如 AI、GPU 集群等)。 就是因为这种种原因,多集群几乎成为了云计算的新潮流,而被谈及最多并且落地的多集群场景主要有这三类: 一类用于应对“云突发”。如下图 1 所示,正常情况下用户使用自己的 IDC 集群提供服务,当应对突发大流量时,迅速将应用扩容到云上集群共同提供服务,将多集群作为备用资源池。该模式一般针对无状态的服务,可以快速弹性扩展,主要针对使用 CPU、内存较为密集的服务,如搜索、查询、计算等类型的服务。 图 1:多集群“云突发”场景 第二类用于“云容灾”。如下图 2 所示,通常主要服务的集

优秀的个人博客,低调大师

高可用方案成为云时代企业重要选择

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 在“上云”已经成为共识之后,如何保障云上企业业务的连续性和可用性,成为业界关注的一个重要话题。 根据明尼苏达大学的研究,在遭遇灾难的同时又没有灾难恢复计划的企业中,将有超过60%的的企业在两到三年后退出市场,而随着企业对数据处理依赖程度的递增,该比例还有逐渐上升的趋势。 IDC在全球范围内,针对多个行业的中小型企业(员工数小于1000名)的调研显示,近80%的公司预计每小时的停机成本至少在2万美元以上,而超过20%的企业估算其每小时的停机成本至少为10万美元。 目前,不管是对于云计算厂商,还是对于上云企业,高可用都已经成为业务架构设计中必须考虑的因素之一,它通常是指通过技术手段,尽可能缩短因日常维护操作(计划)和突发的故障(非计划)所导致的停机时间,以提高业务的可用性。 以国内领先的云计算厂商腾讯云为例,腾讯云目前在高可用性这块做了很多的努力,无论是技术架构还是落地实践都走在国内公有云厂商的前列。架构上,腾讯云高可用包括客户端接入、外网接入、云内网络、云上服务器、中间件、数据层等多个层面。 详细来说,在客户端引入腾讯云全球领先的接入层技术(云解析、httpdns和IP直连), 通过腾讯云智能调度系统,可以保证任意节点发生故障均能无缝切换到其他节点;针对外网接入,高达40+ BGP线路和跨区域容灾能力,能够及时对故障快速调度切换,防止骨干网故障;云内网络通过跨区域数据中心互联互通,形成双环路保护。 最核心的云上服务器,腾讯云目前支持宕机迁移无感知,同时,云硬盘三副本存储策略,可以消除单点故障;腾讯云中间件能够实现跨区域集群,在保障数据正确的同时,减少业务感知;腾讯云数据库支持实时热备,读写分离,实现了同城多可用区、异地灾备和两地三中心,满足跨地域容灾金融级需求。 除了上述六层高可用方案保证之外,在最关键以及最主要的基础设施层,腾讯云也具备高可用方案。比如,依托遍布全球五大洲25个地区的53个可用区,腾讯云为国内外用户提供强有力的技术支持,助力业务飞速拓展。另外,部署全球的超1300+个加速节点,超过100T的带宽储备,能够将服务内容分发到全网加速节点,支持千万用户并发,有效解决跨运营商、跨地域高延迟访问等问题。 对于越来越多的上云企业而言,除了选择有高可用架构的云服务商之外,更要搭建符合自身业务特色的高可用架构,才是业务稳定性的重要保证。 比如,作为目前国民级短视频社区快手。短视频和直播业务是快手最重要的业务,其中访问量,突发,高性能处理等并发要求高,平台服一旦故障,将会对其产生巨大的损失。 为了确保平台服的高可用,腾讯云从接入层、逻辑层、以及数据层帮助快手建设高可用解决方案。在接入层,通过专线链接各大机房,利用腾讯云的安全产品,保障全站的网络攻击;逻辑层和数据层针对核心的业务做异地多活,定期演练,以应对机房灾难性故障的快速恢复。通过多项高可用方案,腾讯云全面护航快手业务连续性和稳定性。 电商平台由于自身的业务特性,需要应对节假日等流量高峰和高并发冲击,其对高可用的需求更为强烈。在移动电商领域,每日优鲜是这个领域最典型的案例。作为致力于重构供应链,连接生鲜生产者和消费者的领导电商,每日优鲜目前在北上广深等10多个城市构筑了“城市分选中心+社区配送中心”的极速达冷链物流体系,为全国数百万客户提供会员1小时送货服务。 每日优鲜之前业务全部部署在单一云服务商之上,一旦出现网络故障,将会导致业务全部中断,没有容灾切换能力。腾讯云通过多云热备部署,DNS应急切换,保障业务连续性,实现业务容灾切换。双云之间通过专线打通,实现双线冗余,系统异常时,流量切入腾讯云,并通过技术手段实现数据一致性。 游戏场景对于高可用方案的需要则更为迫切,一款热门游戏,在极短的时间内需要应对10倍以及百倍的用户量增长。完善的高可用解决方案对于保障游戏的顺利运营,起到极为重要的作用。作为国内知名的游戏平台,乐逗游戏承载数款热门网络游戏,其最重要的业务模块为游戏平台服务系统,为了确保该系统的高可用,腾讯云为乐逗游戏平台提供了一整套异地容灾高可用解决方案。 为了实现游戏平台服的跨城异地容灾,规避机房故障等灾难性故障对业务造成的影响,腾讯云通过负载均衡接入,并将BGP高防包绑定负载均衡做抵御网络攻击;同时,为应对业务用户激增方便扩展,系统接入自动扩容,根据业务流量动态扩缩容;另外,在关键的数据层采用数据库读写分离架构和主备容灾架构做好高可用。 随着越来越多的企业将业务部署在云上,故障已经成为企业不得不重点关注的重点,采用高可用架构和方案也成为企业运维人员必须思考的话题,除此之外,作为企业技术人员,如何保证企业业务和服务的稳定性,值得业界一起探索。

优秀的个人博客,低调大师

大前端时代安全性如何做

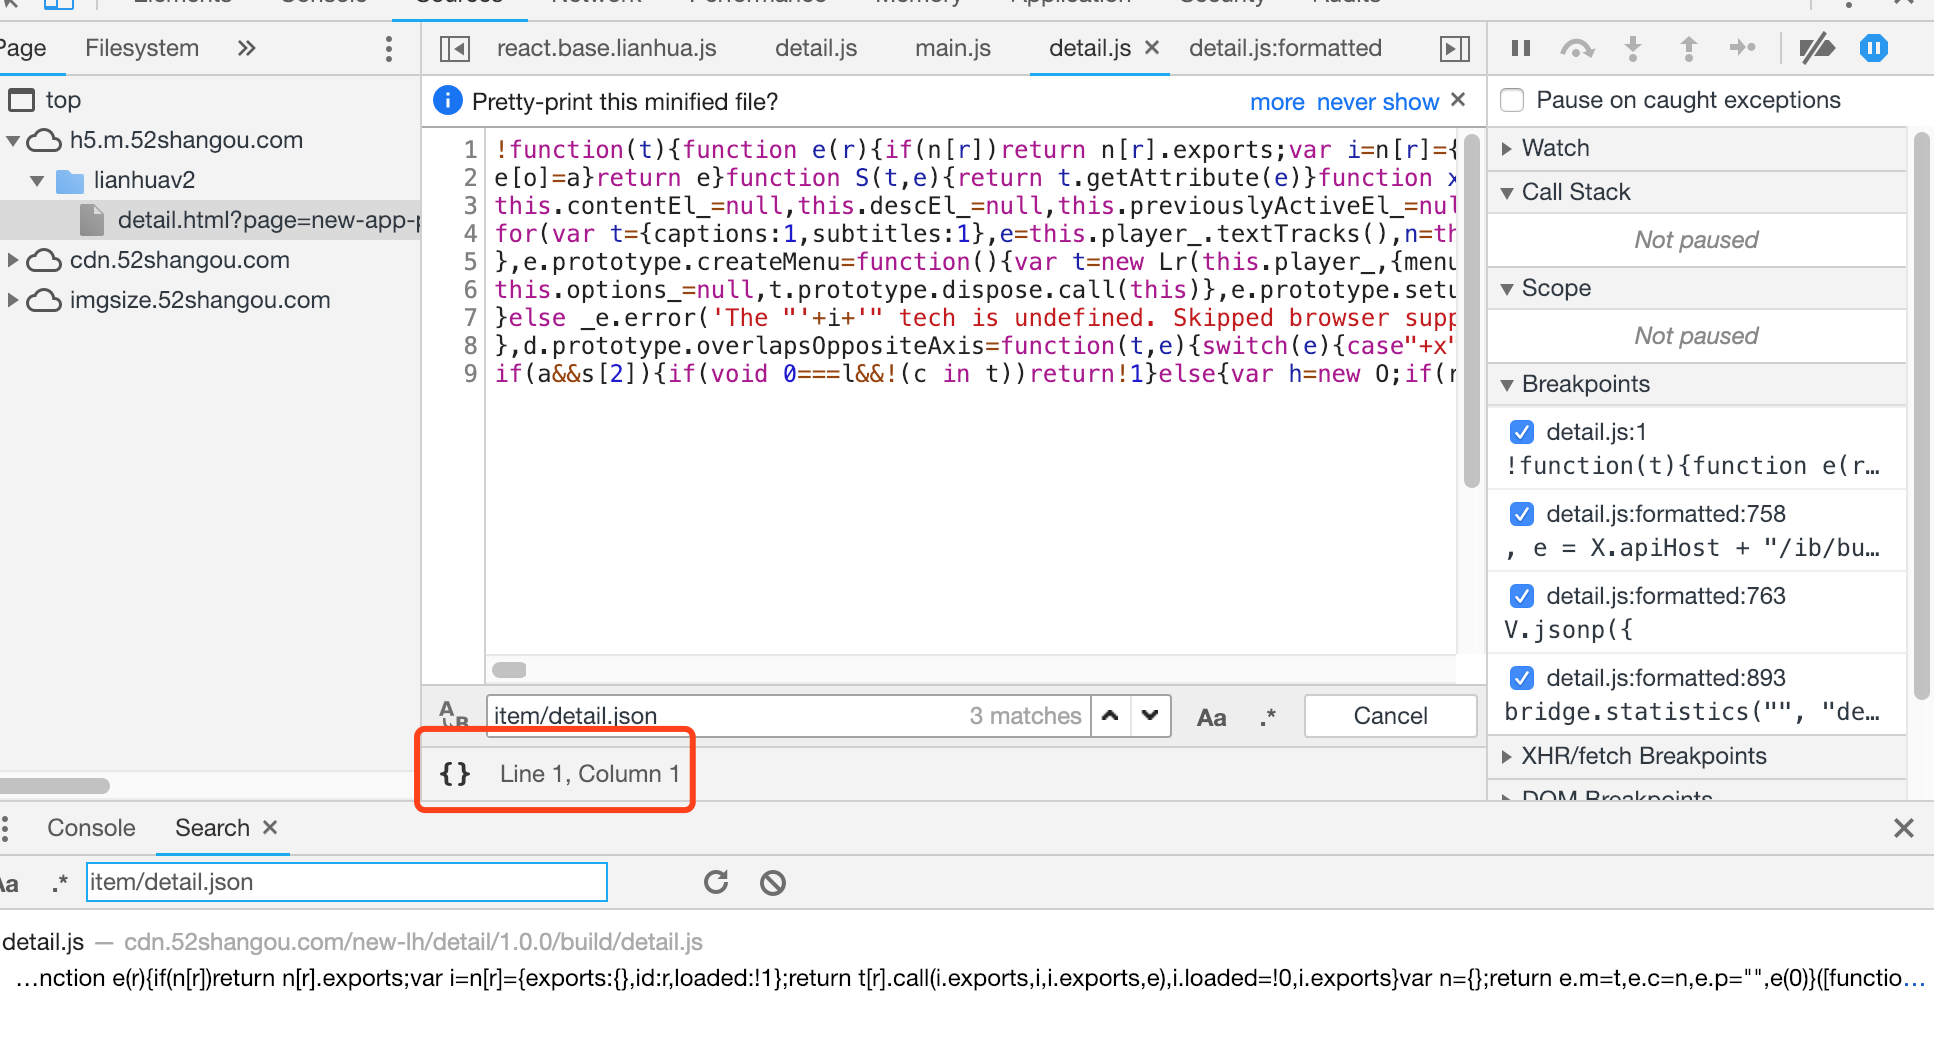
之前在上家公司的时候做过一些爬虫的工作,也帮助爬虫工程师解决过一些问题。然后我写过一些文章发布到网上,之后有一些人就找我做一些爬虫的外包,内容大概是爬取小红书的用户数据和商品数据,但是我没做。我觉得对于国内的大数据公司没几家是有真正的大数据量,而是通过爬虫工程师团队不断的去各地爬取数据,因此不要以为我们的数据没价值,对于内容型的公司来说,数据是可信竞争力。那么我接下来想说的就是网络和数据的安全性问题。 对于内容型的公司,数据的安全性很重要。对于内容公司来说,数据的重要性不言而喻。比如你一个做在线教育的平台,题目的数据很重要吧,但是被别人通过爬虫技术全部爬走了?如果核心竞争力都被拿走了,那就是凉凉。再比说有个独立开发者想抄袭你的产品,通过抓包和爬虫手段将你核心的数据拿走,然后短期内做个网站和 App,短期内成为你的劲敌。 背景 目前通过 App 中的 网页分析后,我们的数据安全性做的较差,有以下几个点存在问题: 网站的数据通过最早期的前后端分离来实现。稍微学过 Web 前端的工程师都可以通过神器 Chrome 分析网站,进而爬取需要的数据。打开 「Network」就可以看到网站的所有网络请求了,哎呀,不小心我看到了什么?没错就是网站的接口信息都可以看到了。比如 “detail.json?itemId=141529859”。或者你的网站接口有些特殊的判断处理,将一些信息存储到 sessionStorage、cookie、localStorage 里面,有点前端经验的爬虫工程师心想”嘿嘿嘿,这不是在裸奔数据么“。或者有些参数是通过 JavaScript 临时通过函数生成的。问题不大,工程师也可以对网页元素进行查找,找到关键的 id、或者 css 类名,然后在 "Search“ 可以进行查找,找到对应的代码 JS 代码,点击查看代码,如果是早期前端开发模式那么代码就是裸奔的,跟开发者在自己的 IDE 里面看到的内容一样,有经验的爬虫就可以拿这个做事情,因此安全性问题亟待解决。 想知道 Chrome 更多的调试使用技巧,看看这篇文章 App 的数据即使采用了 HTTPS,但是对于专业的抓包工具也是可以直接拿到数据的,因此 App 的安全问题也可以做一些提高,具体的策略下文会讲到。 想知道 Charles 的更多使用技巧,可以看看这篇文章 爬虫手段 目前爬虫技术都是从渲染好的 html 页面直接找到感兴趣的节点,然后获取对应的文本 有些网站安全性做的好,比如列表页可能好获取,但是详情页就需要从列表页点击对应的 item,将 itemId 通过 form 表单提交,服务端生成对应的参数,然后重定向到详情页(重定向过来的地址后才带有详情页的参数 detailID),这个步骤就可以拦截掉一部分的爬虫开发者 解决方案 制定出Web 端反爬技术方案 本人从这2个角度(网页所见非所得、查接口请求没用)出发,制定了下面的反爬方案。 使用HTTPS 协议 单位时间内限制掉请求次数过多,则封锁该账号 前端技术限制 (接下来是核心技术) # 比如需要正确显示的数据为“19950220” 1. 先按照自己需求利用相应的规则(数字乱序映射,比如正常的0对应还是0,但是乱序就是 0 <-> 1,1 <-> 9,3 <-> 8,...)制作自定义字体(ttf) 2. 根据上面的乱序映射规律,求得到需要返回的数据 19950220 -> 17730220 3. 对于第一步得到的字符串,依次遍历每个字符,将每个字符根据按照线性变换(y=kx+b)。线性方程的系数和常数项是根据当前的日期计算得到的。比如当前的日期为“2018-07-24”,那么线性变换的 k 为 7,b 为 24。 4. 然后将变换后的每个字符串用“3.1415926”拼接返回给接口调用者。(为什么是3.1415926,因为对数字伪造反爬,所以拼接的文本肯定是数字的话不太会引起研究者的注意,但是数字长度太短会误伤正常的数据,所以用所熟悉的 Π) ​``` 1773 -> “1*7+24” + “3.1415926” + “7*7+24” + “3.1415926” + “7*7+24” + “3.1415926” + “3*7+24” -> 313.1415926733.1415926733.141592645 02 -> "0*7+24" + "3.1415926" + "2*7+24" -> 243.141592638 20 -> "2*7+24" + "3.1415926" + "0*7+24" -> 383.141592624 ​``` # 前端拿到数据后再解密,解密后根据自定义的字体 Render 页面 1. 先将拿到的字符串按照“3.1415926”拆分为数组 2. 对数组的每1个数据,按照“线性变换”(y=kx+b,k和b同样按照当前的日期求解得到),逆向求解到原本的值。 3. 将步骤2的的到的数据依次拼接,再根据 ttf 文件 Render 页面上。 后端需要根据上一步设计的协议将数据进行加密处理 下面以 Node.js 为例讲解后端需要做的事情 首先后端设置接口路由 获取路由后面的参数 根据业务需要根据 SQL 语句生成对应的数据。如果是数字部分,则需要按照上面约定的方法加以转换。 将生成数据转换成 JSON 返回给调用者 // json var JoinOparatorSymbol = "3.1415926"; function encode(rawData, ruleType) { if (!isNotEmptyStr(rawData)) { return ""; } var date = new Date(); var year = date.getFullYear(); var month = date.getMonth() + 1; var day = date.getDate(); var encodeData = ""; for (var index = 0; index < rawData.length; index++) { var datacomponent = rawData[index]; if (!isNaN(datacomponent)) { if (ruleType < 3) { var currentNumber = rawDataMap(String(datacomponent), ruleType); encodeData += (currentNumber * month + day) + JoinOparatorSymbol; } else if (ruleType == 4) { encodeData += rawDataMap(String(datacomponent), ruleType); } else { encodeData += rawDataMap(String(datacomponent), ruleType) + JoinOparatorSymbol; } } else if (ruleType == 4) { encodeData += rawDataMap(String(datacomponent), ruleType); } } if (encodeData.length >= JoinOparatorSymbol.length) { var lastTwoString = encodeData.substring(encodeData.length - JoinOparatorSymbol.length, encodeData.length); if (lastTwoString == JoinOparatorSymbol) { encodeData = encodeData.substring(0, encodeData.length - JoinOparatorSymbol.length); } } //字体映射处理 function rawDataMap(rawData, ruleType) { if (!isNotEmptyStr(rawData) || !isNotEmptyStr(ruleType)) { return; } var mapData; var rawNumber = parseInt(rawData); var ruleTypeNumber = parseInt(ruleType); if (!isNaN(rawData)) { lastNumberCategory = ruleTypeNumber; //字体文件1下的数据加密规则 if (ruleTypeNumber == 1) { if (rawNumber == 1) { mapData = 1; } else if (rawNumber == 2) { mapData = 2; } else if (rawNumber == 3) { mapData = 4; } else if (rawNumber == 4) { mapData = 5; } else if (rawNumber == 5) { mapData = 3; } else if (rawNumber == 6) { mapData = 8; } else if (rawNumber == 7) { mapData = 6; } else if (rawNumber == 8) { mapData = 9; } else if (rawNumber == 9) { mapData = 7; } else if (rawNumber == 0) { mapData = 0; } } //字体文件2下的数据加密规则 else if (ruleTypeNumber == 0) { if (rawNumber == 1) { mapData = 4; } else if (rawNumber == 2) { mapData = 2; } else if (rawNumber == 3) { mapData = 3; } else if (rawNumber == 4) { mapData = 1; } else if (rawNumber == 5) { mapData = 8; } else if (rawNumber == 6) { mapData = 5; } else if (rawNumber == 7) { mapData = 6; } else if (rawNumber == 8) { mapData = 7; } else if (rawNumber == 9) { mapData = 9; } else if (rawNumber == 0) { mapData = 0; } } //字体文件3下的数据加密规则 else if (ruleTypeNumber == 2) { if (rawNumber == 1) { mapData = 6; } else if (rawNumber == 2) { mapData = 2; } else if (rawNumber == 3) { mapData = 1; } else if (rawNumber == 4) { mapData = 3; } else if (rawNumber == 5) { mapData = 4; } else if (rawNumber == 6) { mapData = 8; } else if (rawNumber == 7) { mapData = 3; } else if (rawNumber == 8) { mapData = 7; } else if (rawNumber == 9) { mapData = 9; } else if (rawNumber == 0) { mapData = 0; } } else if (ruleTypeNumber == 3) { if (rawNumber == 1) { mapData = "&#xefab;"; } else if (rawNumber == 2) { mapData = "&#xeba3;"; } else if (rawNumber == 3) { mapData = "&#xecfa;"; } else if (rawNumber == 4) { mapData = "&#xedfd;"; } else if (rawNumber == 5) { mapData = "&#xeffa;"; } else if (rawNumber == 6) { mapData = "&#xef3a;"; } else if (rawNumber == 7) { mapData = "&#xe6f5;"; } else if (rawNumber == 8) { mapData = "&#xecb2;"; } else if (rawNumber == 9) { mapData = "&#xe8ae;"; } else if (rawNumber == 0) { mapData = "&#xe1f2;"; } } else{ mapData = rawNumber; } } else if (ruleTypeNumber == 4) { var sources = ["年", "万", "业", "人", "信", "元", "千", "司", "州", "资", "造", "钱"]; //判断字符串为汉字 if (/^[\u4e00-\u9fa5]*$/.test(rawData)) { if (sources.indexOf(rawData) > -1) { var currentChineseHexcod = rawData.charCodeAt(0).toString(16); var lastCompoent; var mapComponetnt; var numbers = ["0", "1", "2", "3", "4", "5", "6", "7", "8", "9"]; var characters = ["a", "b", "c", "d", "e", "f", "g", "h", "h", "i", "j", "k", "l", "m", "n", "o", "p", "q", "r", "s", "t", "u", "v", "w", "x", "y", "z"]; if (currentChineseHexcod.length == 4) { lastCompoent = currentChineseHexcod.substr(3, 1); var locationInComponents = 0; if (/[0-9]/.test(lastCompoent)) { locationInComponents = numbers.indexOf(lastCompoent); mapComponetnt = numbers[(locationInComponents + 1) % 10]; } else if (/[a-z]/.test(lastCompoent)) { locationInComponents = characters.indexOf(lastCompoent); mapComponetnt = characters[(locationInComponents + 1) % 26]; } mapData = "&#x" + currentChineseHexcod.substr(0, 3) + mapComponetnt + ";"; } } else { mapData = rawData; } } else if (/[0-9]/.test(rawData)) { mapData = rawDataMap(rawData, 2); } else { mapData = rawData; } } return mapData; } //api module.exports = { "GET /api/products": async (ctx, next) => { ctx.response.type = "application/json"; ctx.response.body = { products: products }; }, "GET /api/solution1": async (ctx, next) => { try { var data = fs.readFileSync(pathname, "utf-8"); ruleJson = JSON.parse(data); rule = ruleJson.data.rule; } catch (error) { console.log("fail: " + error); } var data = { code: 200, message: "success", data: { name: "@杭城小刘", year: LBPEncode("1995", rule), month: LBPEncode("02", rule), day: LBPEncode("20", rule), analysis : rule } } ctx.set("Access-Control-Allow-Origin", "*"); ctx.response.type = "application/json"; ctx.response.body = data; }, "GET /api/solution2": async (ctx, next) => { try { var data = fs.readFileSync(pathname, "utf-8"); ruleJson = JSON.parse(data); rule = ruleJson.data.rule; } catch (error) { console.log("fail: " + error); } var data = { code: 200, message: "success", data: { name: LBPEncode("建造师",rule), birthday: LBPEncode("1995年02月20日",rule), company: LBPEncode("中天公司",rule), address: LBPEncode("浙江省杭州市拱墅区石祥路",rule), bidprice: LBPEncode("2万元",rule), negative: LBPEncode("2018年办事效率太高、负面基本没有",rule), title: LBPEncode("建造师",rule), honor: LBPEncode("最佳奖",rule), analysis : rule } } ctx.set("Access-Control-Allow-Origin", "*"); ctx.response.type = "application/json"; ctx.response.body = data; }, "POST /api/products": async (ctx, next) => { var p = { name: ctx.request.body.name, price: ctx.request.body.price }; products.push(p); ctx.response.type = "application/json"; ctx.response.body = p; } }; //路由 const fs = require("fs"); function addMapping(router, mapping){ for(var url in mapping){ if (url.startsWith("GET")) { var path = url.substring(4); router.get(path,mapping[url]); console.log(`Register URL mapping: GET: ${path}`); }else if (url.startsWith('POST ')) { var path = url.substring(5); router.post(path, mapping[url]); console.log(`Register URL mapping: POST ${path}`); } else if (url.startsWith('PUT ')) { var path = url.substring(4); router.put(path, mapping[url]); console.log(`Register URL mapping: PUT ${path}`); } else if (url.startsWith('DELETE ')) { var path = url.substring(7); router.del(path, mapping[url]); console.log(`Register URL mapping: DELETE ${path}`); } else { console.log(`Invalid URL: ${url}`); } } } function addControllers(router, dir){ fs.readdirSync(__dirname + "/" + dir).filter( (f) => { return f.endsWith(".js"); }).forEach( (f) => { console.log(`Process controllers:${f}...`); let mapping = require(__dirname + "/" + dir + "/" + f); addMapping(router,mapping); }); } module.exports = function(dir){ let controllers = dir || "controller"; let router = require("koa-router")(); addControllers(router,controllers); return router.routes(); }; 前端根据服务端返回的数据逆向解密 $("#year").html(getRawData(data.year,log)); // util.js var JoinOparatorSymbol = "3.1415926"; function isNotEmptyStr($str) { if (String($str) == "" || $str == undefined || $str == null || $str == "null") { return false; } return true; } function getRawData($json,analisys) { $json = $json.toString(); if (!isNotEmptyStr($json)) { return; } var date= new Date(); var year = date.getFullYear(); var month = date.getMonth() + 1; var day = date.getDate(); var datacomponents = $json.split(JoinOparatorSymbol); var orginalMessage = ""; for(var index = 0;index < datacomponents.length;index++){ var datacomponent = datacomponents[index]; if (!isNaN(datacomponent) && analisys < 3){ var currentNumber = parseInt(datacomponent); orginalMessage += (currentNumber - day)/month; } else if(analisys == 3){ orginalMessage += datacomponent; } else{ //其他情况待续,本 Demo 根据本人在研究反爬方面的技术并实践后持续更新 } } return orginalMessage; } 比如后端返回的是323.14743.14743.1446,根据我们约定的算法,可以的到结果为1773 根据 ttf 文件 Render 页面 上面计算的到的1773,然后根据ttf文件,页面看到的就是1995 然后为了防止爬虫人员查看 JS 研究问题,所以对 JS 的文件进行了加密处理。如果你的技术栈是 Vue 、React 等,webpack 为你提供了 JS 加密的插件,也很方便处理 JS混淆工具 个人觉得这种方式还不是很安全。于是想到了各种方案的组合拳。比如 反爬升级版 个人觉得如果一个前端经验丰富的爬虫开发者来说,上面的方案可能还是会存在被破解的可能,所以在之前的基础上做了升级版本 组合拳1: 字体文件不要固定,虽然请求的链接是同一个,但是根据当前的时间戳的最后一个数字取模,比如 Demo 中对4取模,有4种值 0、1、2、3。这4种值对应不同的字体文件,所以当爬虫绞尽脑汁爬到1种情况下的字体时,没想到再次请求,字体文件的规则变掉了 😂 组合拳2: 前面的规则是字体问题乱序,但是只是数字匹配打乱掉。比如 1 -> 4, 5 -> 8。接下来的套路就是每个数字对应一个 unicode 码 ,然后制作自己需要的字体,可以是 .ttf、.woff 等等。 这几种组合拳打下来。对于一般的爬虫就放弃了。 反爬手段再升级 上面说的方法主要是针对数字做的反爬手段,如果要对汉字进行反爬怎么办?接下来提供几种方案 方案1: 对于你站点频率最高的词云,做一个汉字映射,也就是自定义字体文件,步骤跟数字一样。先将常用的汉字生成对应的 ttf 文件;根据下面提供的链接,将 ttf 文件转换为 svg 文件,然后在下面的“字体映射”链接点进去的网站上面选择前面生成的 svg 文件,将svg文件里面的每个汉字做个映射,也就是将汉字专为 unicode 码(注意这里的 unicode 码不要去在线直接生成,因为直接生成的东西也就是有规律的。我给的做法是先用网站生成,然后将得到的结果做个简单的变化,比如将“e342”转换为 “e231”);然后接口返回的数据按照我们的这个字体文件的规则反过去映射出来。 方案2: 将网站的重要字体,将 html 部分生成图片,这样子爬虫要识别到需要的内容成本就很高了,需要用到 OCR。效率也很低。所以可以拦截掉一部分的爬虫 方案3: 看到携程的技术分享“反爬的最高境界就是 Canvas 的指纹,原理是不同的机器不同的硬件对于 Canvas 画出的图总是存在像素级别的误差,因此我们判断当对于访问来说大量的 canvas 的指纹一致的话,则认为是爬虫,则可以封掉它”。 本人将方案1实现到 Demo 中了。 关键步骤 先根据你们的产品找到常用的关键词,生成词云 根据词云,将每个字生成对应的 unicode 码 将词云包括的汉字做成一个字体库 将字体库 .ttf 做成 svg 格式,然后上传到 icomoon 制作自定义的字体,但是有规则,比如 “年” 对应的 unicode 码是 “\u5e74” ,但是我们需要做一个 恺撒加密 ,比如我们设置 偏移量 为1,那么经过恺撒加密 “年”对应的 unicode 码是“\u5e75” 。利用这种规则制作我们需要的字体库 在每次调用接口的时候服务端做的事情是:服务端封装某个方法,将数据经过方法判断是不是在词云中,如果是词云中的字符,利用规则(找到汉字对应的 unicode 码,再根据凯撒加密,设置对应的偏移量,Demo 中为1,将每个汉字加密处理)加密处理后返回数据 客户端做的事情: 先引入我们前面制作好的汉字字体库 调用接口拿到数据,显示到对应的 Dom 节点上 如果是汉字文本,我们将对应节点的 css 类设置成汉字类,该类对应的 font-family 是我们上面引入的汉字字体库 //style.css @font-face { font-family: "NumberFont"; src: url('http://127.0.0.1:8080/Util/analysis'); -webkit-font-smoothing: antialiased; -moz-osx-font-smoothing: grayscale; } @font-face { font-family: "CharacterFont"; src: url('http://127.0.0.1:8080/Util/map'); -webkit-font-smoothing: antialiased; -moz-osx-font-smoothing: grayscale; } h2 { font-family: "NumberFont"; } h3,a{ font-family: "CharacterFont"; } 传送门 字体制作的步骤、ttf转svg、字体映射规则 实现的效果 页面上看到的数据跟审查元素看到的结果不一致 去查看接口数据跟审核元素和界面看到的三者不一致 页面每次刷新之前得出的结果更不一致 对于数字和汉字的处理手段都不一致 这几种组合拳打下来。对于一般的爬虫就放弃了。 <hr> 前面的 ttf 转 svg 网站当 ttf 文件太大会限制转换,让你购买,下面贴出个新的链接。 ttf转svg Demo 地址 运行步骤 //客户端。先查看本机 ip 在 Demo/Spider-develop/Solution/Solution1.js 和 Demo/Spider-develop/Solution/Solution2.js 里面将接口地址修改为本机 ip $ cd Demo $ ls REST Spider-release file-Server.js Spider-develop Util rule.json $ node file-Server.js Server is runnig at http://127.0.0.1:8080/ //服务端 先安装依赖 $ cd REST/ $ npm install $ node app.js App 端安全的解决方案 目前 App 的网络通信基本都是用 HTTPS 的服务,但是随便一个抓包工具都是可以看到 HTTPS 接口的详细数据,为了做到防止抓包和无法模拟接口的情况,我们采取以下措施: 中间人盗用数据,我们可以采取 HTTPS 证书的双向认证,这样子实现的效果就是中间人在开启抓包软件分析 App 的网络请求的时候,网络会自动断掉,无法查看分析请求的情况 对于防止用户模仿我们的请求再次发起请求,我们可以采用 「防重放策略」,用户再也无法模仿我们的请求,再次去获取数据了。 对于 App 内的 H5 资源,反爬虫方案可以采用上面的解决方案,H5 内部的网络请求可以通过 Hybrid 层让 Native 的能力去完成网络请求,完成之后将数据回调给 JS。这么做的目的是往往我们的 Native 层有完善的账号体系和网络层以及良好的安全策略、鉴权体系等等。 后期会讨论 App 安全性的更深层次玩法,比如从逆向的角度出发如何保护 App 的安全性。提前给出一篇逆向安全方面的文章 关于 Hybrid 的更多内容,可以看看这篇文章 Awesome Hybrid 比如 JS 需要发起一个网络请求,那么按照上面将网络请求让 Native 去完成,然后回调给 JS JS 端代码 var requestObject = { url: arg.Api + "SearchInfo/getLawsInfo", params: requestparams, Hybrid_Request_Method: 0 }; requestHybrid({ tagname: 'NativeRequest', param: requestObject, encryption: 1, callback: function (data) { renderUI(data); } }) Native 代码(iOS为例) [self.bridge registerHandler:@"NativeRequest" handler:^(id data, WVJBResponseCallback responseCallback) { NSAssert([data isKindOfClass:[NSDictionary class]], @"H5 端不按套路"); if ([data isKindOfClass:[NSDictionary class]]) { NSDictionary *dict = (NSDictionary *)data; RequestModel *requestModel = [RequestModel yy_modelWithJSON:dict]; NSAssert( (requestModel.Hybrid_Request_Method == Hybrid_Request_Method_Post) || (requestModel.Hybrid_Request_Method == Hybrid_Request_Method_Get ), @"H5 端不按套路"); [HybridRequest requestWithNative:requestModel hybridRequestSuccess:^(id responseObject) { NSDictionary *json = [NSJSONSerialization JSONObjectWithData:responseObject options:NSJSONReadingMutableLeaves error:nil]; responseCallback([self convertToJsonData:@{@"success":@"1",@"data":json}]); } hybridRequestfail:^{ LBPLog(@"H5 call Native`s request failed"); responseCallback([self convertToJsonData:@{@"success":@"0",@"data":@""}]); }]; } }]; 以上是第一阶段的安全性总结,后期应该会更新(App逆向、防重放、服务端等)。

优秀的个人博客,低调大师

边缘计算时代,CDN企业的布局与实践

据IDC预测,到2020年将有超过500亿的终端和设备联网,其中超过50%的数据需要在网络边缘侧进行分析、处理与存储,边缘云市场规模可达万亿级别,成为互联网下半场无可争议的“新大陆”,商机无限。近日,Gartner最新预测更是将边缘计算作为“2019年十大战略技术”之一。然而,目前边缘计算产业仍然处于初期的发展阶段,无论是对于运营商、设备商、终端厂商,还是云计算、IDC、CDN企业来说,及早布局才能更好掌握先机。 近日,蓝汛助理总裁陆鑫向通信世界全媒体记者(蓝汛——CDN行业的领军企业)分享了蓝汛如何与阿里云边缘计算相配合,率先实现了将CDN布局到边缘云平台的经验心得。在陆鑫看来,未来,CDN将成为边缘云市场的一大主要应用场景。 缘何情定阿里边缘云边缘计算被视为是实现物理计算、智能城市、普适计算和物联网的重要因素。在我国,边缘计算联盟

优秀的个人博客,低调大师

AI时代的金融级大规模图分析

小蚂蚁说: GeaBase是具备高性能、高可用、高扩展性及可移植性强的实时金融级分布式图数据库,广泛应用于蚂蚁金服风控、社交、推荐等技术场景。“过无人区” 、“Made in China” 、“反哺”是GeaBase的几个耀眼标签。每年的支付宝春节红包、每一笔交易的反洗钱识别等等,背后的技术都少不了它的身影。 背景阅读:《GeaBase,中国首个金融级分布式图数据库诞生记》 2018年云栖ATEC金融科技开放峰会上,蚂蚁金服重点发布了新产品“金融数据+智能套件”,该套件包含金融计算引擎、数据智能中台、智能应用等组件,整合了许多世界级数据处理与智能分析能力,包括国内首个金融级图数据库GeaBase、实时计算引擎,以及领先的视觉识别、数据智能能力,有效解决过去银行数据分析决策困难、迭代周期长等数据智能困局。 今天,我们将重点介绍其中的关键组件

优秀的个人博客,低调大师

拥抱新时代,Google 开源量子算法框架 CIRQ

过去几年,量子计算不仅在量子硬件方面有所发展,在量子算法的开发方面也迎来了改进。随着 Noisy Intermediate Scale Quantum 计算机(NISQ)的推出,开发用于理解这些机器性能的算法越来越重要。然而,在 NISQ 处理器上设计量子算法时的一个常见问题是如何充分利用这些有限的量子器件。此外,一些量子处理器具有复杂的几何约束和其他细微差别,忽略这些因素将导致错误的量子计算,或影响优化和修改的计算结果。 NISQ 即嘈杂中型量子,NISQ 计算机指那些拥有 50-100 量子比特、以及高保真量子门的设备。为解决上述问题,并帮助开发者了解 NISQ 量子计算机是否能够解决具有实际重要意义的计算问题,Google 近日开源了 Cirq 。这是一个专为 NISQ 算法打造的框架,允许开发者为特定的量子处理器编写量子算法。 Cirq 为用户提供了对量子电路 (Quantum Circuits)的精确控制,为编写和编译量子电路,其数据结构经过专门优化,让开发者能更加充分地利用 NISQ 架构。Cirq 支持在模拟器上运行这些算法,旨在通过云轻松与未来的量子硬件或更大的模拟器集成。 同时开源的还有OpenFermion-Cirq,这是基于 Cirq 和最新算法的一个应用示例。OpenFermion是一个专注解决化学问题的量子算法开发平台,OpenFermion-Cirq 则是一个把量子模拟算法编译成 Cirq 的开源库。该新库利用最新研究进度为量子化学问题构建低深度量子算法,允许用户定制为在特定硬件上运行。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册