首页 文章 精选 留言 我的

精选列表

搜索[主数据管理],共10000篇文章
优秀的个人博客,低调大师

阿里云发布分布式数据库PolarDB-X,应对海量数据管理

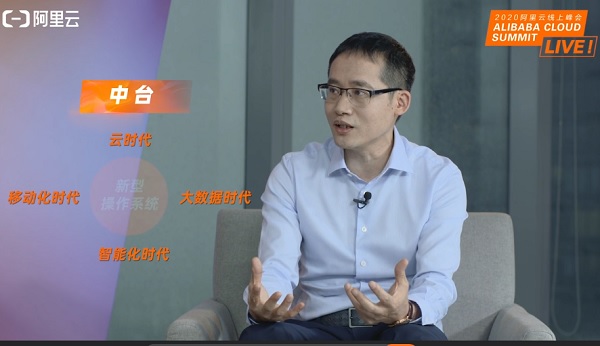
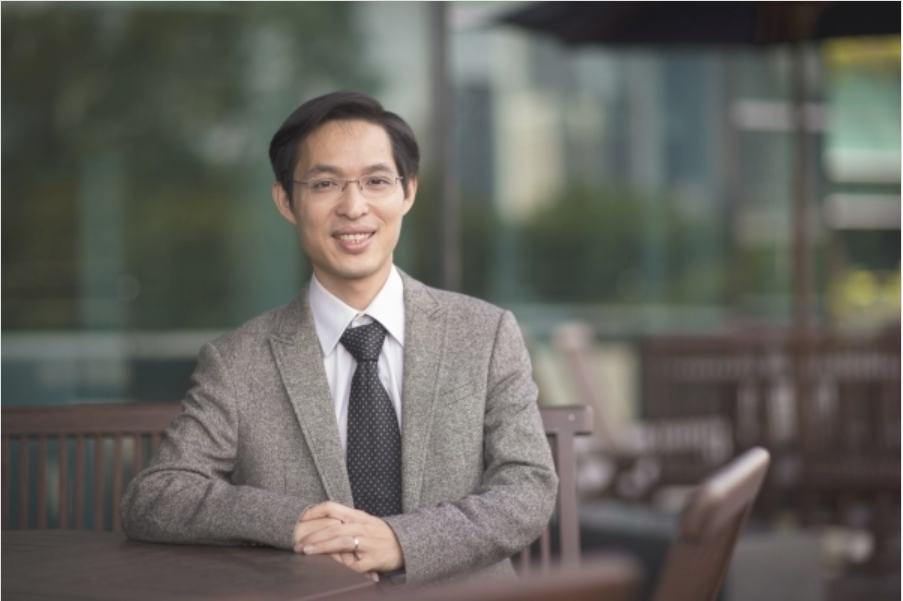
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 一场不期而至的疫情给不少企业的生产经营带来不小的影响,使得很多活动被迫转到了线上,包括很多新闻发布会。日前,阿里云也举办了一场线上的活动——云上的峰会,在会上阿里云发布了包括第七代ECS、POLARDB-X数据库、视觉智能开放平台、新一代阿里云数据中台、阿里云专有云敏捷版和混合云管理平台、云原生数据仓库和数据湖解决方案,以及城市大脑3.0、政务中台、阿里巴巴未来社区等众多行业解决方案。 从全面上云到加速重构 近几年,云计算在中国得到快速普及,不少企业或多或少从云计算技术中受益。阿里云继去年提出要全面上云之后,今年提出要深化云的应用,也就是“加速重构”。 在阿里云智能总裁张建锋看来,全面上云是一个技术性阶段,重点在于从原来的非云基础设施转变为云;而全面重构是一个更强的深化。 阿里云智能总裁张建锋 “上云更多着眼于技术升级,而要重构,就需要关注的面会更广,包括理念要升级,组织要升级,经营模式、运营模式要升级。”张建锋说。基于这一个认识,张建锋表示,阿里云明确提出要“做深基础,做厚中台,做强生态”。所谓“做深基础”是指继续要做芯片、数据库、路由器、交换机等,基于云的特点来构建整套的IT基础体系。 “做厚中台”是在“中台”这个新型的操作系统上提供更多的功能,以方便上层的应用开发,这些功能包括AI能力、大数据的处理、IOT的能力以及对移动。值得一提的是,在阿里的中台中钉钉被赋予了重任,张建锋表示,钉钉已经远不只是一个沟通工具,它更是一个平台,阿里中台的重要组成部分。 “做强生态”是指不是阿里云来做所有事情的。阿里云愿意在一个开放的体系中,让所有软件开发商、其他合作伙伴基于云的结构、基于一个新型的操作系统来帮助各行各业完成应用的开发和交付。 “我们提出做深基础、做厚中台、做强生态,这是我们作为数字经济时代基础的一个主要的出发点,也是一个落脚点。 云原生的分布式数据库PolarDB-X 在阿里云线上峰会上,阿里云一口气发布六款产品和多款解决方案,这也是具体落实张建锋所说的“做深基础、做厚中台、做强生态”战略。阿里云的分布式数据库PolarDB-X也是其中之一。 PolarDB-X采用了基于云原生一体化架构设计,这款阿里云自研的分布式数据库可支撑千万级并发规模,专注解决海量数据存储、超高并发吞吐、大表瓶颈以及复杂计算效率等瓶颈问题。 PolarDB-X很容易让人联想到2018年阿里云推出的云原生数据库PolarDB,这也是阿里云数据库业务中成长最快的业务。PolarDB本质上还是一个集中式数据库,但它其实已经享受到分布式技术的红利了,PolarDB采用了计算、存储分离的架构,其底层采用的就是分布式共享存储,从而可以保证数据库的海量存储能力,而PolarDB-X将这种分布式的能力扩展到了计算层。 “PolarDB的计算是一写多读多个计算节点,最多做到16个节点,现在,PolarDB-X相当于在PolarDB之上又加上了一个分布式拓展层,这样可以根据企业的并发需求、数据量进行水平拓展。”阿里巴巴副总裁、阿里云数据库负责人李飞飞说。 阿里巴巴副总裁、阿里云数据库负责人李飞飞 在李飞飞看来,PolarDB-X的一大亮点是借助PolarDB-X的水平拓展层来支持分布式的事务处理和分布式查询,并最终为客户提供一个完整的从云原生再到分布式架构上的升级路径。另一个特点是,PolarDB-X是一体化透明式分布式数据库,也就是说业务系统不需要去关心,也就是不需要传统的中间件,也不需要分布、分表,因此对业务系统的侵入性会非常非常小。 据悉,PolarDB-X也是阿里巴巴核心系统正在使用的数据库。PolarDB-X连续多年稳定支撑了天猫双11,在1秒钟内系统负载增加了135倍情况下依然保持稳定,峰值TPS达8700万次,但成本仅为传统数据库的 1/6。 云数据库是技术演进的必然趋势 发展至今,数据库已经有超过40年的历史,特别是关系数据库不管是历史还是技术都已经非常成熟,而随着云计算的普及,数据库市场迎来快速变革,这就是以云原生数据库为代表的新一代数据库的出现。Gartner曾就此专门发布研究报告认为,数据库的云化是必然趋势。 李飞飞在接受采访时表示,云原生数据库是技术自然演进的必然结果。不管是在中国市场还是海外市场,都可以看到云原生架构为企业业务带来的实实在在的技术红利。从市场来看,这几年云数据库的崛起也的确非常迅速,开始抢占传统数据库的市场。 李飞飞认为,云实现了资源池化,但要把资源池化的优势发挥出来,还要用分布式的能力实现水平拓展、弹性、高可用。 “把云原生和分布式能力完美良好的结合在一起,同时再利用K8S容器化的这种部署方式,可以使得整个运维管控大大简化、编排大大简化,这是整个数据库技术的第一个趋势。”李飞飞说。 除了数据库的云化之外,李飞飞认为数据库技术还有以下两个明显趋势: 一个是数据仓库和数据库系统一体化,即HTAP数据库。如果数据库和数据仓库一体化,就是实现数据交易处理和数据分析利用同一套系统处理,好处是数据从生产到处理到存储到消费,可以完美的处理好,而不用将数据在各个系统之间来回迁移。 最后是智能化。得益于人工智能技术的快速进步和普及,智能化已经在数据库的各个层面得到应用,并且与数据库系统进行深入整合,帮助实现数据库运维的智能化、自动化,也就是现在经常说的“自动驾驶的数据库”。 李飞飞表示,阿里云要客观认识自己,既要认识到自己的长足,同时也要认识到自己的不足。比如,Oracle领导数据库市场40多年,在数据库内核上积累了自己的优势(比如查询优化),有非常明显的优势。另一方面,正因为它在传统商业数据库领域深耕多年,体量大、整个系统非常复杂,想向云转身没那么容易的,要经过非常大的代码修改和架构改造。相对而言,云计算厂商去做数据库,没有历史包袱,更加有利于在新的赛道上发挥出自己的技术优势。这也是PolarDB等云原生数据迅速崛起的背景。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-06-17本文作者:邹大斌本文来自:“至顶网”,了解相关信息可以关注“至顶网”

优秀的个人博客,低调大师

表格存储TableStore2.0重磅发布,提供更强大数据管理能力

表格存储TableStore是阿里云自研的面向海量结构化和半结构化数据存储的Serverless NoSQL多模型数据库,被广泛用于社交、物联网、人工智能、元数据和大数据等业务场景。表格存储TableStore采用与Google Bigtable类似的宽表模型,天然的分布式架构,能支撑高吞吐的数据写入以及PB级数据存储。 原生的宽表数据模型,存在一些天然的缺陷,例如无法很好的支持属性列的多条件组合查询,或者更高级的全文检索或空间检索。另外在与计算系统的对接上,特别是流计算场景,传统的大数据Lambda架构,需要用户维护多套存储和计算系统,没法很天然的支持数据在存储和计算系统之间的流转。以上这些问题,均在表格存储TableStore在支持阿里巴巴集团内、阿里云公共云以及专有云等业务中逐渐暴露出来。

优秀的个人博客,低调大师

1 weekend110的NN元数据管理机制 + NN工作机制 + DN工作原理

第一天的笔记,是伪分布hadoop集群搭建, 后面是hadoop Ha的分布式集群搭建 第一天,是HDFS的shell操作 NN工作机制 里面是二进制 DN工作原理 上传完了之后,在hdfs的虚拟路径下,有这个文件,其实,是切分成很多block,放到公共的datanode文件夹下。 134217728/1024/1024=128M,所以,分成2个Block。 其实,此刻,blk_1073741856等价于jdk-7u65-linux-i586.tar.gz。 所以,文件被是切分成很多block,放到公共的datanode文件夹下。也可以合并,上述,就是合并,照样,达到复原。。。 这里,有个知识点,blk_1073741856和blk_1073741857,没有显示出来。 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5893338.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

加强大数据管理 将公共资源数据交由第三方保存

国务院《促进大数据发展行动纲要》(以下简称《纲要》)公开发布,开启了国家系统部署大数据发展工作的序幕。《纲要》提出,要从政府大数据、新兴产业大数据、安全保障体系三个方面着手,推进大数据领域十大工程建设;要全面推进大数据发展和应用,加快政府数据开放共享,深化大数据在各行业创新应用;通过建设数据强国,提升政府治理能力,推动经济转型升级。 全国人大代表、中国通信服务青海公司总经理邓晓辉认为,《纲要》是中国大数据领域的顶层设计,标志着大数据战略正式上升为国家战略。当前,不论我们称之为大数据时代、互联网时代,还是物联网时代、智能穿戴时代,它们都有一个共同的特征,就是信息数据化。当人与物都被数据化之后,就意味着巨大的商机蕴藏到了这些数据中。 面对大数据所蕴含的巨大价值,不必担心其商业价值的有效利用,而应担心数据背后的安全隐患。目前,由单一机构保存数据的方式非常普遍,在数据集中有效利用以及数据安全等方面都存在诸多隐患。 一是哪些数据可以通过第三方进行保存。针对数据的重要性和保密等级,需要对数据范围进行界定。公共资源数据涉及生产、生活、安全等诸多方面,如果安全等级较高的数据泄露,危害国家安全和人民生命财产,其后果不堪设想。目前,对于界定在第三方进行保存的数据,还缺乏针对性较强的法律法规。 二是海量数据保护难度大。公共资源数据的爆发式增长是基于大数据时代的发展。而大数据具有数据量大、数据类型繁多、数据生成速度快以及价值密度低等特点,若不对数据进行筛选过滤,对重点数据进行针对性强化保护,那么对公共资源数据的保护必将陷入成本高、效率低、耗时久、质量差的泥潭。 三是监管尚未到位。目前的数据第三方保存主要基于各地的信息中心、数据中心和部分大型互联网企业的服务和设备。而在这些企业或单位获得大量公共资源数据之后,在缺乏监管的情况下可能会隐秘地收集、处理、使用公共资源数据信息,特别是不能排除在利益驱动下对数据的恶意修改。 邓晓辉代表希望国家尽快研究出台第三方数据保存的相应制度规范,提出了以下四条建议: 一是要进一步规范大数据中心建设。国家要统一规划数据中心建设,既要保证数据的有效存储、采集、利用,也要防止过度重复建设,避免资源浪费和数据集中度不足,影响数据的利用、共享。 二是对公共资源数据的安全范围进行明确化界定。对于那些涉及信息安全的数据,一定要尽可能给予保护;对于那些有可能涉及个人隐私的数据,要在进行安全处理之后才能部分开放。法律和行业规范的制定与实施应该和技术保持同步,相互补充,对公共资源数据的存储、使用和发布也必须严格地按照法律和行业规定执行,构建良好的大数据环境,这样才能更好地保障信息安全和个人隐私。 三是可以通过完善相应的法律条款来打击公共资源数据不法泄露行为。遵循已有的法律法规,对涉及信息安全的数据泄露行为进行严厉打击,做到有法必依、执法必严。在此基础上应进一步完善个人隐私保护的法律法规,尽快推进《个人信息保护法》的立法工作。 四是建立各单位企业通用的公共资源数据保存安全条例,加之相应的法律规范来达到公共资源数据的第三方保存安全保护的目的。政府和数据提供方应对数据的安全性进行筛选,以免泄露涉密信息或与数据安全相关的信息。相关单位和企业则要对数据安全保护高度重视,应做到数据保存者、使用者对其保存和使用的行为承担法律责任。 本文转自d1net(转载)

优秀的个人博客,低调大师

Milvus 核心组件再升级,主打就是一个低延迟、高准确度

熟悉我们的朋友都知道,在 Milvus 和 Zilliz Cloud 中,有一个至关重要的组件——Knowhere。 Knowhere 是什么?如果把向量数据库整体看作漫威银河护卫队宇宙,那么 Knowhere 就是名副其实的总部,它的主要功能是对向量精确搜索其最近邻或通过构建索引进行低延迟、近似的最近邻搜索(ANNS)。 Knowhere 2.x 版本自 2022 年 7 月开始重构,经过多次方案讨论、设计、开发和测试的迭代,终于随着 Milvus 2.3 和各位见面了。对于用户而言,相较于 1.x 版本,Knowhere 2.x 版本提供了更规范的接口以及更丰富的功能,例如支持 GPU 索引、Cosine 相似性类型、ScaNN 索引和 ARM 架构等。对于开发者来说,升级后的 Knowhere 可以更方便地增加新的索引算法,利于后期维护。 接下来我将详细为大家介绍 Knowhere 2.x 的新功能、优化及设计理念。 支持 GPU 索引 Zilliz 一直都非常欢迎外部开发者提出想法和贡献代码,此前,英伟达(Nvidia)公司在 Knowhere 2.x 版本贡献了其向量搜索库 RAFT 中的 GPU_FLAT 和 GPU_IVFPQ 索引。GPU 强劲的算力在一些场景下可以显著地加速索引搜索的过程。相较于 CPU 版本,Milvus 端到端性能在 Nvidia A100 上的吞吐量有了显著提升(SIFT1M 近 70 倍)。GPU 索引详细内容请访问 https://milvus.io/docs/install_standalone-gpu-docker.md。 支持 Cosine 相似性类型 在 Knowhere 1.x 版本上,如果想使用 Cosine 相似性类型,用户需要使用 Inner Product 相似性类型并在插入向量前进行归一化操作,使得其在数学上是等价的。这不仅对于用户有更高理论知识的要求,也增加了使用的成本和接入的难度。 Knowhere 2.x 版本原生支持 Cosine 距离并在库内部自动归一化传入向量并适配对应的索引类型,大大减少了理解成本,提升了用户体验。 支持 ScaNN 索引 Faiss 实现的 ScaNN,又名 FastScan,使用更小的 PQ 编码和相应的指令集可以更为友好地访问 CPU 寄存器,从而使其拥有优秀的索引性能。该索引在 Cohere 数据集,Recall 约 95% 的时候,Milvus 使用 Knowhere 2.x 版本端到端的 QPS 是 IVF_FLAT 的 7 倍,HNSW 的 1.2 倍。 支持 ARM 架构 ARM 架构对比 x86 架构,虽然其性能弱于后者,但因为更简单的设计和指令集,ARM 架构的能效和功耗更低,所以价格更为便宜。在 AWS 云平台相同 CPU 规格,如 1 vCPU,16GB 内存的情况下,ARM 实例比 x86 实例的价格低 15% 左右。Knowhere 2.x 版本支持了 ARM 架构,使得用户可以在此架构上运行和搭建上层服务。 支持 Range Search 最近邻问题包括 K 近邻问题 (KNN) 和范围搜索 (Range Search)。前者解决的问题是给定一个向量集合 X,参数 k 和查询向量 q,索引返回在向量集合 X 中由相似性类型定义的离查询向量 q 最“近”的 k 个向量。范围搜索则不给定参数 k,它需要给定一个范围 (radius),索引返回在向量集合 X 中与查询向量 q 的距离在范围内的所有向量。 Knowhere 2.x 为库中的多个索引提供了范围搜索的功能,例如 HNSW,DiskANN 还有 IVF 系列等。不同于 K 近邻问题,范围搜索返回向量的数目是预先不可知的。这对于结果的返回也提出了更高的要求,试考虑查询范围取查询向量 q 与向量集合 X 中最远向量的距离,结果将尝试返回整个向量集合。对此,Milvus 提供了对查询结果分页的功能,具体可参考 https://milvus.io/docs/within_range.md。 优化过滤查询 在向量查询中,可能存在有部分向量已经被删除的情况。或者在标量与向量的混合查询中,有一部分向量已经被标量查询先行过滤,例如数据库中有日期的标量列,并且用户只希望在满足特定日期的向量中进行查询。在大部分向量被过滤的场景下,Knowhere 2.x 针对 HNSW 的过滤向量查询进行了优化,使其相较于之前版本有至多 6 到 80 倍的性能提升。 优化代码结构和编译 Knowhere 2.x 版本简化了 C++ 类之间的继承关系,减少了函数调用;使用代理模式来规范新索引的接入,使得错误使用的风险更低;重构了 Config 模块,使用起来更为方便快捷;使用 conan 作为包管理工具,简化和加速了编译流程;使用 Folly 中的线程池来获得对于线程更为精准的把控。 支持 MMAP MMAP (Memory Mapping) 将文件或设备映射到内存,即进程的地址空间。一些用户可能数据量较大但苦于没有足够的内存空间放置索引。用户之前可以尝试使用磁盘索引 DiskANN,现在也可以尝试使用 MMAP。用户选择开启后,Milvus 和 Knowhere 2.x 会自动将大文件进行内存映射,从而可以在内存不足的情况下使用大索引数据。 支持从索引获得原始向量 用户在搜索完成后,可能需要通过返回的 ID 取得原始向量,进一步进行定制化的计算或筛选。在之前版本的 Milvus 中,需要通过从例如 S3 或其他远程存储中获得。Knowhere 2.x 版本支持从索引中直接获得原始向量。因为索引本身已经被加载到内存(除 DiskANN 以外),该操作的延时会远低于从 S3 获取。值得注意的是并不是所有索引都支持,例如 IVFPQ 对原始向量进行了量化处理,从而丢失了这一信息。具体索引支持的表格详见 https://github.com/zilliztech/knowhere/releases/tag/v2.2.0。 至此,我们罗列了部分 Knowhere 2.x 重要的新功能和优化。希望本文能帮助大家对此有更为清晰的认识,也欢迎大家在 Knowhere 仓库的 issue https://github.com/zilliztech/knowhere/issues 中提出宝贵的意见和建议。同时,Milvus 2.3 系列解读会持续更新,下一篇的主题是 Milvus 最新的消息队列 NATS,敬请期待! 🌟「寻找 AIGC 时代的 CVP 实践之星」 专题活动即将启动! Zilliz 将联合国内头部大模型厂商一同甄选应用场景, 由双方提供向量数据库与大模型顶级技术专家为用户赋能,一同打磨应用,提升落地效果,赋能业务本身。 如果你的应用也适合 CVP 框架,且正为应用落地和实际效果发愁,可直接申请参与活动,获得最专业的帮助和指导!联系邮箱为 business@zilliz.com。 ​ 如果在使用 Milvus 或 Zilliz 产品有任何问题,可添加小助手微信 “zilliz-tech” 加入交流群。 ​ 欢迎关注微信公众号“Zilliz”,了解最新资讯。

优秀的个人博客,低调大师

微软敲定Windows 10一年两更策略:春季上新功能、秋季主优化

即将开播:6月19日,互联网银行架构师魏生谈互联网开放银行实施路径的探索与思考 即将开播:4月29日,民生银行郭庆谈商业银行金融科技赋能的探索与实践--> 对于Windows 10的更新策略,微软已经明确下来,一年两次大的更新,分别是春季和秋季,而更新上的侧重点也不太一样。 在维持一年两个功能更新不变的情况下,春季发布的功能更新将包含重大改进并引入新的功能,而秋季是小规模更新,重点是完善和优化。 微软表示:“Windows 10 20H2将会提供一系列功能,以提高性能和质量。我们将使用服务技术(类似于每月获得的更新)来分发 20H2,为那些选择加入新版本的May 2020更新用户提供更新。简答来说,所有运行 May 2020 功能更新和 Windows 10 20H2的用户由于可以像月度更新一样安装,因此能够更快的获得更新。” 今天微软宣布面向 Beta Channel(也就是之前的 Slow Ring)发布了 20H2 版本更新,最新版本号为Build 19042.330。该版本包含了来自KB4557957的修复,新版默认安装基于 Chromium 的新版 Edge浏览器。 近日,微软宣布启用全新的命名方式,沿用基于Chromium 的Edge方式来命名Windows Insider三大开发分支版本,其中 Fast Ring 更名为Dev Channel,而Slow Ring更名为Beta Channel,Release Preview Ring更名为Release Preview Channel。 对于普通用户来说,如果想要更稳妥的升级,那么等待每年的秋季更新似乎是个不错的办法。

优秀的个人博客,低调大师

Go 公布 2.0 设计草案:主打规模化和扩展性,支持泛型

去年7月,Go 语言官博就曾透露Go2 开发计划,并表示Go2的目标就是解决 Go 1.x 在规模化方面做的还不够好的地方。随着时间的推进,开发团队已着手准备 2.0 版本的开发工作,并公布了设计草案,供社区讨论和反馈,以促进最终的语言设计。 设计草案包含三个方面,错误处理、错误值和泛型,并针对各个方面进行了详细的概述和改进草案。大致总结如下: 一、错误处理(Error handling) 为扩展至大型代码库,Go 程序必须是轻量级的,不会过度重复,且具备稳健性,能够优雅地处理出现的错误。 目前Go 检查错误的代码太多,但处理这些错误的代码却严重不足。对于 Go 2,开发团队希望错误检查更加轻量级,减少用于错误检查的 Go 程序的文本量。此外,还能更加方便地编写错误处理程序,提高开发者处理错误的可能性。 为避免处理重复异常,错误检查和错误处理还必须是显性的,在程序文本中可见。 参考示例: funcmain(){ hex,err:=ioutil.ReadAll(os.Stdin) iferr!=nil{ log.Fatal(err) } data,err:=parseHexdump(string(hex)) iferr!=nil{ log.Fatal(err) } os.Stdout.Write(data) } 简化后: funcmain(){ handleerr{ log.Fatal(err) } hex:=checkioutil.ReadAll(os.Stdin) data:=checkparseHexdump(string(hex)) os.Stdout.Write(data) } 二、错误值(Error values) 大型程序必须能够以编程方式测试和响应错误,并且还能很好地报告它们。 目前的各种流行的助手工具包添加了超出标准错误接口的功能,但它们以不兼容的方式执行。对于 Go 2,开发团队考虑将“可选接口”标准化,以允许这些工具包进行互操作,并慢慢减少对它们的需求。 改进主要包含两个目标:一是让程序的错误检查更容易,更不容易出错,以提高程序的错误处理和稳健性;二是希望能够以标准格式打印包含额外细节的错误。 //Isreportswhethererroranyoftheerrorsinitschainisequaltotarget. funcIs(err,targeterror)bool//AscheckswhethererroranyoftheerrorsinitschainisavalueoftypeE.//Ifso,itreturnsthediscoveredvalueoftypeE,withoksettotrue.//Ifnot,itreturnsthezerovalueoftypeE,withoksettofalse. funcAs(typeE)(errerror)(eE,okbool) 三、泛型(Generics) 想要扩展到大型代码库,代码的可重用性非常重要。 Go 团队在早期其实一直有在调查和讨论“泛型”的可能性设计,但由于种种原因,Go 1 更多的是确保能快速构建包含很多独立软件包的程序。 Go2的目标是通过允许带有类型参数的参数多态来解决编写 Go 库的问题,这些问题抽象出了不必要的类型细节。 此外,除了预期的容器类型之外,开发团队还希望能编写有用的库来操作任意的 map 和 channel 值。理想方案是编写能够同时操作 [ ]byte 和 string 值的多态函数。 typeList(typeT)[]T funcKeys(typeK,V)(mmap[K]V)[]K 更多细节请查阅设计草案页面。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册