首页 文章 精选 留言 我的

精选列表

搜索[Linux Mint],共10000篇文章
优秀的个人博客,低调大师

转载:linux下大数据人工智能自动化脚本定时任务模板

转自: https://mp.weixin.qq.com/s/mXXJmDqtv7PyqglN9ekvNQ 本文针对有初级sql及python人工智能开发基础,需要执行定时任务的初学人员。 假设在工作中,要执行一个任务,大致要求如下: 一、每月执行一次定时任务; 二、用hive处理数据,并下载; 三、用python读取数据,送入机器学习算法训练,预测结果,保存结果; 四、读取预测结果,上传到数据库指定位置,并按月分区 (一)、关于定时任务crontab,命令网上可以搜到很多用法。在这里有一个坑需要注意,就是直接执行shell脚本时用到的python环境路径,可能与定时任务的python路径不同,导致执行脚本时报错,找不到模块。这里有一个小方法,写一个python程序test.py。 import sys print(sys.path) python test.py与crontab -e各执行一次,就可以看到两次路径是否相同了。还有一点,就是关于注册信息的问题, kinit -kt /home/accunt/cluster_keytab/accunt.keytab accunt中的accunt是你自己的账户,没有这句话,程序也会报错。所以建议专门写一个定时任务,每隔几个小时执行一次该命令。 (二)、程序中经常会涉及到变量,比较常见的是时间变量,这样才能做到自动化,train_month_t=$(date +%Y%m -d '-1 month')这句话意思是,获取执行程序时的月份的前一个月,‘$’是定义一个变量,用$train_month_t传入sql语句中。exportHIVE_SKIP_SPARK_ASSEMBLY=true;这句话的作用是在下载数据时,保证数据能够下载齐全。 (三)、为了降低shell脚本的篇幅,可以将python部分以子文件形式执行。这里为了防止在定时任务时,python路径不统一,使用python的环境路径执行程序。通过sys.argv[1]将参数$py_month传进去。这里的月份形式是'201808',传进去是字符串格式。 (四)、在数据库里建表,并将通过人工智能预测好的数据,上传到指定分区。 下面是模板内容: #!/bin/bash kinit -kt /home/accunt/cluster_keytab/accunt.keytab accunt echo"***************************" train_month_t=$(date +%Y%m -d '-1 month') echo$train_month_t echo"*************start*************" sql_train=" create table if not exists test.t_test (a string, b string) row format delimited fields terminated by '\t' lines terminated by '\n' stored as textfile; set hive.exec.dynamic.partition.mode=nonstrict; insert overwrite table test.t_test select a,b from product.t_test where day=concat('$train_month_t','01'); " echo$sql_train>./train.sql kinit -kt /home/accunt/cluster_keytab/accunt.keytab accunt hive -f ./train.sql exportHIVE_SKIP_SPARK_ASSEMBLY=true; hive -e"set hive.cli.print.header=true; select distinct a,b from test.t_test;">./train.csv echo"*************train sql successful************" kinit -kt /home/accunt/cluster_keytab/accunt.keytab accunt ./python ./train_pred.py$py_month echo"*************py successful************" load_sql=" create table if not exists test.result (a string, b string) partitioned by (month string) row format delimited fields terminated by '\t' lines terminated by '\n' stored as textfile tblproperties('skip.header.line.count'='1'); LOAD DATA LOCAL INPATH './preds_$load_month.csv' into table test.result PARTITION (month='$load_month'); " echo$load_sql>./load.sql kinit -kt /home/accunt/cluster_keytab/accunt.keytab accunt hive -f ./load.sql echo"*************load_sql successful************" echo"*************successful************" 至此,一个简单的大数据人工智能预测分析脚本模板完成了,希望能有所帮助,并指出不足之处,共同进步! 转自: https://mp.weixin.qq.com/s/mXXJmDqtv7PyqglN9ekvNQ

优秀的个人博客,低调大师

使用Wisdom RESTClient如何在Linux和Mac上获取测试报告和API文档?

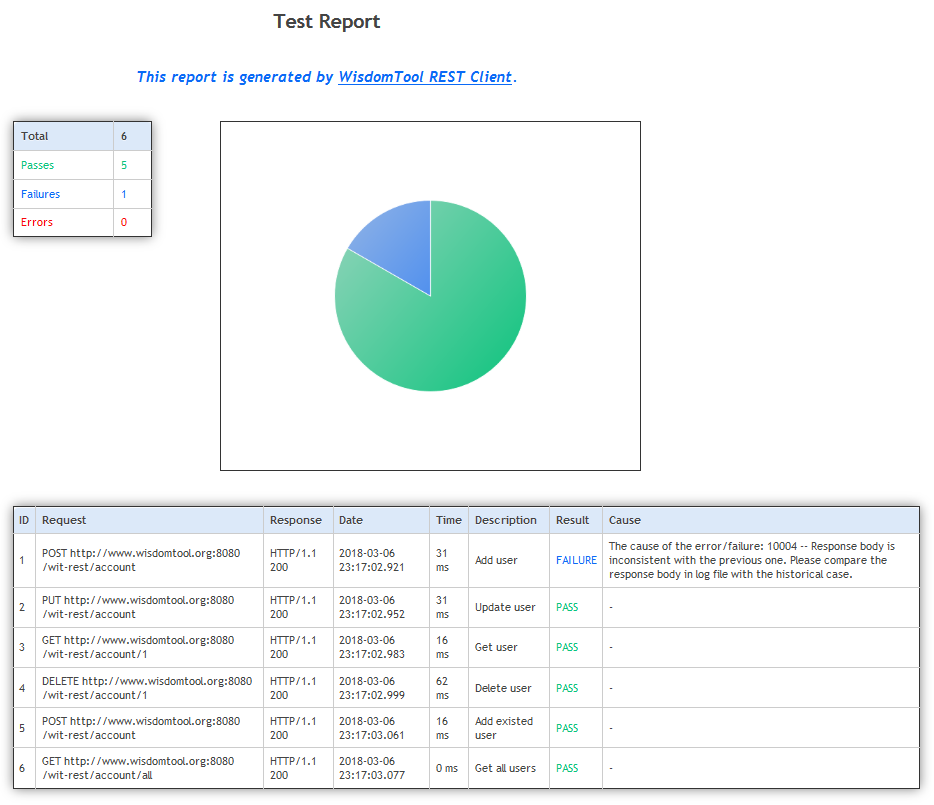
使用Wisdom RESTClient自动化测试REST API,生成REST API文档, 需要先执行命令java -jar restclient-1.2.jar启动Wisdom RESTClient界面。 先使用工具测试REST API,产生历史记录。 选择菜单选项Apidoc --> Create生成API文档:work/apidoc/apidoc.html 选择菜单选项Test --> Start Test生成测试报告:work/report/report.html 用浏览器手动打开这些HTML文件。

优秀的个人博客,低调大师

马哥2016全新Linux+Python高端运维班第四周作业

1、复制/etc/skel目录为/home/tuser1,要求/home/tuser1及其内部文件的属组和其它用户均没有任何访问权限。 2、编辑/etc/group文件,添加组hadoop。 #echo"hadoop:x:1003:">>/etc/group 3、手动编辑/etc/passwd文件新增一行,添加用户hadoop,其基本组ID为hadoop组的id号;其家目录为/home/hadoop。 #echo"hadoop:x:1003:1003:hadoop:/home/hadoop:/bin/bash">>/etc/passwd 4、复制/etc/skel目录为/home/hadoop,要求修改hadoop目录的属组和其它用户没有任何访问权限。 5、修改/home/hadoop目录及其内部所有文件的属主为hadoop,属组为hadoop。 6、显示/proc/meminfo文件中以大写或小写S开头的行;用两种方式; #grep-i‘^s‘/proc/meminfo #grep‘^[Ss]‘/proc/meminfo 7、显示/etc/passw d文件中其默认shell为非/sbin/nologin的用户; 8、显示/etc/passwd文件中其默认shell为/bin/bash的用户; # grep ‘/bin/bash‘ /etc/passwd | cut -d: -f1 9、找出/etc/passwd文件中的一位数或两位数; # grep -o ‘\b[0-9]\{1,2\}\b‘ /etc/passwd 10、显示/boot/grub/grub.conf中以至少一个空白字符开头的行; #egrep‘^[[:space:]]+‘/boot/grub/grub.conf 11、显示/etc/rc.d/rc.sysinit文件中以#开头,后面跟至少一个空白字符,而后又有至少一个非空白字符的行; #egrep‘^#[[:space:]]+[^[:space:]]+‘/etc/rc.d/rc.sysinit 12、打出netstat -tan命令执行结果中以‘LISTEN’,后或跟空白字符结尾的行; #netstat-tan|egrep‘LISTEN[[:space:]]*$‘ 13、添加用户bash, testbash, basher, nologin (此用户的shell为/sbin/nologin),而后找出当前系统上其用户名和默认shell相同的用户的信息; # useradd bash && useradd testbash && useradd basher && useradd -s /sbin/nologin nologin awk -F‘[:/]‘ ‘$1==$NF{print $0}‘ /etc/passwd 本文转自xinrenbaodao 51CTO博客,原文链接http://blog.51cto.com/11832904/1844068:,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux集群和自动化维1.2 IDC机房的选择及CDN的选型

1.2 IDC机房的选择及CDN的选型 如果自己的业务网站中含有大量的图片和视频类文件,为了加快客户端的访问速度,同时为了减缓对真正的核心机房的服务压力,并且提升用户体验,建议在前端最好采用CDN缓存加速方案。 CDN(Content Delivery Network),即内容分发网络。其目的是通过在现有的Internet中增加一层新的网络架构,将网站的内容发布到最接近用户的网络“边缘”,使用户可以就近取得所需的内容,提高用户访问网站的响应速度。CDN缓存加速方案一般有如下几种方式。 租赁CDN:中小型网站直接购买服务就好,现在CDN已经进入按需付费的云计算模式了,性价比是可以准确计算的。 自建CDN:这种方案的成本就有点大了,为了保证良好的缓存效果,必须在全国机房布点,还要自建智能Bind系统,搭建大型网站时推荐采用此种方案,专业的

优秀的个人博客,低调大师

一天一个linux基础命令之时间日期命令date

时间日期命令:date 1、命令格式: date[OPTION]...[+FORMAT] date[-u|--utc|--universal][MMDDhhmm[[CC]YY][.ss]] 2、命令功能 打印不同格式的时间或日期,以及要根据时间和日期执行操作。日期可以以多种格式去打印,也可以使用命令设置固定的格式。在类UNIX系统中,日期被存储为一个整数,其大小为自世界标准时间(UTC)1970年1月1日0时0分0秒起流逝的秒数。 3、常用选项 -d "String" 显示字符串所指的时间。字符串前后必须加上双引号"",也可以用做转换时间显示格式 -s "String" 根据字符串来设置时间,字符串前后必须加上双引号 -u 显示世界时间 日期格式 %Y:显示四位的年份(2016) %y:显示两位的年份(16) %m:月份 %d:天数 %H:小时24小时制 %M:分钟 %S:秒钟 %T:时间,冒号分隔的时间(12:12:01) %X|%r:时间,冒号分隔的时间(10:58:02AM)[%T%p] %D:日期,以斜线隔开的日期(12/27/16) %x:日期,以斜线隔开的日期(12/27/2016) %F:日期:以横杠隔开的日期(2016-12-27) %p:显示出AM或PM unix元年:1970-01-0100:00:00 %s:距离unix元年到现在经历的秒数 %j:一年的第几天(001~366) %w:一个星期的第几天(0代表星期天) %W:一年的第几个星期 %Z显示时区,日期域(CST) %a星期的简称(Sun~Sat) %A星期的全称(Sunday~Saturday) %h,%b月的简称(Jan~Dec) %B月的全称(January~December) 4、使用实例 1、显示当前时间 命令:date [root@server~]#date TueDec2711:06:57CST2016 2、设置指定时间 命令:date [MMDDhhmm[[CC]YY][.ss]] [root@server~]#date122711302016 TueDec2711:30:00CST2016 [root@server~]#date TueDec2711:30:05CST2016 [root@server~]# 提示:MM:月份 DD:天 hh:小时 mm:分钟 [CC[YY]]:两位的年,或者四位的年 .ss:秒钟 如果不指,则按照当前时间设置 3、以指定的格式显示时间 命令:date +FORMAT [root@server~]#date+%T 11:10:59 [root@server~]#date+%H-%M-%S 11-11-23 [root@server~]#date+%F 2016-12-27 [root@server~]#date"+%F%H-%M-%S" 2016-12-2711-11-48 [root@server~]#date"+%F%T" 2016-12-2711:12:00 [root@server~]# 提示:显示指定格式时间时:如果中间有空格,需在显示时间的格式上加入双引号 4、创建以当前时间为名称的目录 命令:mkdir `COMMAND` [root@server~]#mkdir`date+%F-%H-%M-%S` [root@server~]#ls 2016-12-27-11-15-05install.loganaconda-ks.cfginstall.log.syslog [root@server~]# 提示:此时我们用到了命令引用`` 命令引用:引用的是命令的执行结果 date +%F-%H-%M-%S执行结果为2016-12-27-11-15-05,创建时,就直接创建以当前时间为名称的目录 5、输出昨天现在的时间 命令:date -d "1 day ago" [root@server~]#date-d"1dayago" MonDec2611:22:50CST2016 [root@server~]# 提示:也可以使用 date -d "+ 1 day" date-d "+1 day" +%Y%m%d //显示前一天的日期 date-d "-1 day" +%Y%m%d //显示后一天的日期 date-d "-1 month" +%Y%m%d //显示上一月的日期 date-d "+1 month" +%Y%m%d //显示下一月的日期 date-d "-1 year" +%Y%m%d //显示前一年的日期 date-d "+1 year" +%Y%m%d //显示下一年的日期 常用的日期英文格式都可以来进行使用 6、显示30秒后的时间 命令:date -d "30 second" +%T [root@server~]#date+%T 11:24:50 [root@server~]#date-d"30second"+%T 11:25:21 7、将指定的时间转换显示的格式 命令:date -d "TIME" +FORMAT [root@server~]#date-d"2012-12-12""+%Y/%m/%d%H:%M.%S" 2012/12/1200:00.00 [root@server~]#date TueDec2711:26:14CST2016 [root@server~]# 提示:转换时间格式时,不影响当前时间 8、转换apache日志时间格式 命令:date -d "TIME" +FORMAT [root@server~]#date-d"Dec5,201612:12:31AM"+"%Y-%m-%d%H:%M.%S" 2016-12-0500:12.31 [root@server~]# [root@server~]#date-d"Dec5,201612:12:31"+"%Y-%m-%d%H:%M.%S" 2016-12-0512:12.31 [root@server~]# 9、设置时间 命令:date -s "String" [root@server~]#date-s"2016122712:23:00"//设置全时间 TueDec2712:23:00CST2016 [root@server~]#date-s"2016/12/2712:23:00"//设置全时间 TueDec2712:23:00CST2016 [root@server~]#date-s"2016-12-2712:23:00"//设置全时间 TueDec2712:23:00CST2016 [root@server~]#date-s"20161227"//设置成20161227,不过会把具体时间设置成00:00:00 TueDec2700:00:00CST2016 [root@server~]#date-s"12:25:00"//设置具体时间,不会对日期做出修改 TueDec2712:25:00CST2016 [root@server~]# 硬件时钟命令:hwclock [options] 常用选项 -s:以硬件时钟为准,将系统时间修改成硬件时间--hctosys -w:以软件时钟为准,将硬件时间修改成系统时间--systohc [root@server~]#hwclock Tue27Dec201612:02:21PMCST-1.016560seconds [root@server~]#date TueDec2712:04:17CST2016 [root@server~]#hwclock-s [root@server~]#date TueDec2712:02:32CST2016 显示日历 cal cal[-smjy13] [[[day] month] year] 月历 常用选项: -3:显示前三月份 -m:显示时以mon(星期一)打头 -j:显示当前月份在本年的第几天 -y:显示整年

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册
修改密码
忘记密码