首页 文章 精选 留言 我的

精选列表

搜索[MSA技术],共10000篇文章
优秀的个人博客,低调大师

AI+低代码技术揭秘

概述​ VTJ.PRO 是一个 AI 驱动的 Vue3 低代码开发平台,支持 Vue 单文件组件 (SFC) 和领域特定语言 (DSL) 表示之间的双向转换。VTJ 构建在具有同步版本控制的 monorepo 架构之上,为可视化设计、代码生成和多平台部署提供了一个全面的软件包生态系统,同时保持与现有 Vue 3 开发工作流程的兼容性。 目的和范围​ 本文档简要概述了 VTJ 低代码平台,包括其架构、关键组件和设计理念。有关特定组件(如 Engine 和 Provider 系统)的详细信息,请参阅核心架构 ,或者有关工程和块模型的详细信息,请参阅工程和块模型 。 主要特点​ 双向代码流:在视觉设计和 Vue 源代码之间无缝转换 AI 集成:智能代码生成、优化和图像到代码转换功能 Vue 3 基础:建立在最新的 Vue 生态系统之上,支持 TypeScript 和 Vite 多平台支持:面向 Web 应用程序、移动应用程序和 UniApp(跨平台)项目 低学习曲线:专为 Vue 开发人员设计,需要最少的额外知识 非侵入式实施:与现有项目集成,无代码污染 系统架构概述​ VTJ 遵循模块化架构,在多个软件包中明确分离关注点,从基础到平台特定的实现,按层组织。 Monorepo 包架构​ 项目脚手架系统​ AI 增强的设计时到运行时流程​ VTJ 的核心创新是 Vue SFC 和低代码 DSL 之间的双向转换,并通过 AI 功能进行了增强: 双向代码管道​ 数据结构流​ AI 驱动的开发功能​ VTJ 将 AI 功能集成到整个开发管道中,重点是图像到代码的生成和智能辅助: AI 集成架构​ 开始​ VTJ 提供了几种开始使用该平台的方法: 使用 create-vtj 创建项目​ create-vtj脚手架工具使用预配置的构建系统生成特定于平台的项目: shell # Web applications (PC) - uses @vtj/web platform npm create vtj@latest --registry=https://registry.npmmirror.com -- -t app # Mobile H5 applications - uses @vtj/h5 platform npm create vtj@latest --registry=https://registry.npmmirror.com -- -t h5 # Cross-platform apps - uses @vtj/uni-app platform npm create vtj@latest --registry=https://registry.npmmirror.com -- -t uniapp # Component development - uses @vtj/materials npm create vtj@latest --registry=https://registry.npmmirror.com -- -t material 开发环境设置​ 对于 VTJ 本身的本地开发: shell git clone https://gitee.com/newgateway/vtj.git cd vtj npm run setup && npm run build && npm run app:dev 与现有项目集成​ VTJ 通过特定于平台的软件包与现有的 Vue 3 项目无缝集成。有关详细的集成模式,请参阅 集成指南 多平台部署架构​ VTJ 通过专门的平台包支持多个部署目标,每个平台包都针对特定环境进行了优化: 平台 包 目标环境 关键依赖项 Web @vtj/web 桌面 Web 应用程序 element-plus、@vtj/core、@vtj/renderer 设计器 @vtj/pro 使用 Designer 的企业平台 @vtj/renderer、@vtj/local、 @vtj/materials 移动式 H5 @vtj/h5 移动 Web 应用程序 vant、@vtj/core、@vtj/renderer UniApp @vtj/uni-app 跨平台应用(iOS/Android/小程序) @dcloudio/uni-app、@vtj/uni、@vtj/renderer 平台架构​ 当前版本​ VTJ 的当前版本是 0.12.40,在 monorepo 中的所有软件包之间同步。 结论​ VTJ.PRO 是专为 Vue 3 开发人员设计的综合性低代码平台。通过实现视觉设计和 Vue 源代码之间的双向转换,它可以加速开发,同时保持直接代码访问的灵活性和强大功能。该平台的模块化架构、AI 集成和多平台支持使其适用于广泛的应用程序开发场景。

优秀的个人博客,低调大师

浅谈LocalCache | 京东云技术团队

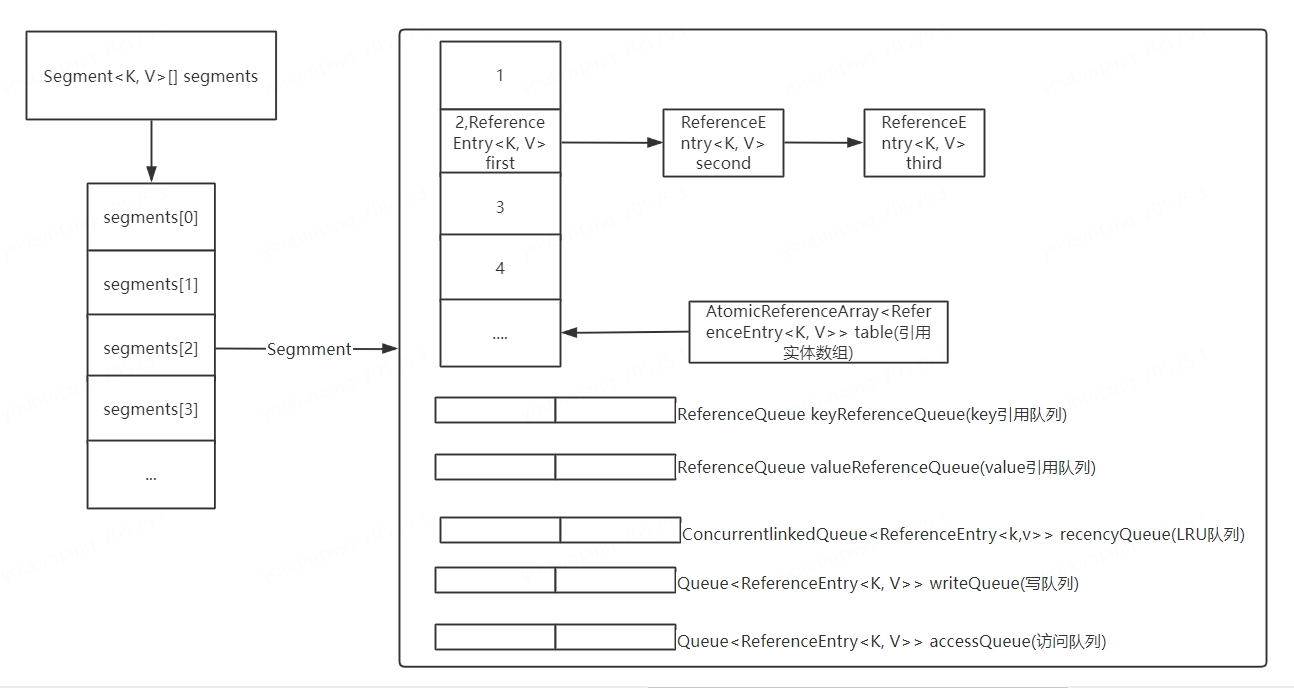
1、什么是LocalCache? 本地缓存是一种将数据存储在应用程序内存中的机制,用于提高数据访问的性能和响应速度。它通过在内存中维护一个键值对的存储结构,允许应用程序快速检索和访问数据,而无需每次都从慢速的数据源(如数据库或网络)获取数据。 2、LocalCache优缺点 1)优点 •快速访问:LocalCache将数据存储在内存中,因此可以快速访问缓存数据,提高应用程序的性能。 •减轻后端负载:通过将经常访问的数据存储在本地缓存中,可以减少对后端数据源的访问次数,降低后端负载,提高系统的整体性能。 •灵活性:LocalCache提供了一些配置选项,如最大容量、过期时间等,可以根据需求进行调整。这使得开发人员能够灵活地控制缓存的行为,以适应不同的业务场景。 2)缺点 •有限的容量:由于LocalCache是基于内存的,因此容量是有限的。如果缓存数据量过大,可能会导致内存消耗过高,影响系统的稳定性。 •单点故障:LocalCache存储在单个应用程序中,如果应用程序崩溃或重启,缓存数据将丢失。这可能会导致缓存冷启动和性能下降。 3、LocalCache应用场景 LocalCache适用于许多不同的使用场景,特别是以下几种情况: 1.**频繁访问的数据:**如果应用程序中有一些频繁被访问的数据,将这些数据存储在LocalCache中可以大大提高访问速度。由于数据存储在内存中,相比于从磁盘或网络中读取数据,从本地缓存中获取数据的速度更快。 2.**减轻后端负载:**通过将经常访问的数据存储在本地缓存中,可以减少对后端数据源(如数据库或API)的访问次数。这样可以降低后端的负载,提高系统的整体性能。 3.**降低网络延迟:**在分布式系统或微服务架构中,不同的服务可能位于不同的节点上,通过网络进行通信。使用本地缓存可以减少对远程服务的调用次数,从而减少网络延迟,提高系统的响应速度。 4.灵活性和可配置性:LocalCache提供了一些配置选项,如最大容量、过期时间等,可以根据需求进行调整。这使得开发人员能够灵活地控制缓存的行为,以适应不同的业务场景。 4、LocalCache实际使用场景 1.**数据库中间件:**数据库中间件是位于应用程序和后端数据库之间的软件层,常见的数据库中间件包括MySQL Proxy、Cobar、MyCat等。这些中间件可以使用LocalCache来缓存查询结果,以减轻后端数据库的负载并提高查询性能。当应用程序发出相同的查询请求时,中间件可以先检查LocalCache中是否有相应的缓存结果,如果有则直接返回缓存结果,否则再向后端数据库发起查询请求。 2.**消息队列:**消息队列是一种用于异步通信的中间件,常见的消息队列系统包括Apache Kafka、RabbitMQ等。在消息队列系统中,LocalCache可以用来缓存消息,以提高消息的处理速度和响应能力。当消费者需要处理消息时,它可以先在LocalCache中查找是否有相应的消息缓存,如果有则直接消费缓存消息,否则再从消息队列中获取消息。 3.**前端应用:**前端应用包括各种Web应用、移动应用和桌面应用,常见的前端框架如React、Angular、Vue.js等。在前端应用中,LocalCache可以用于缓存静态资源(如JavaScript、CSS、图像等)或动态数据,以提高应用的加载速度和用户体验。例如,前端应用可以先检查LocalCache中是否有相应的资源缓存,如果有则直接使用缓存资源,否则再从服务器获取资源并将其缓存到LocalCache中。 4.**服务端应用:**服务端应用包括各种后端服务、微服务和RESTful API等,常见的服务端框架如Spring、Node.js、Ruby on Rails等。LocalCache可以在服务端应用中使用,用于缓存计算结果、数据库查询结果等,以提高性能和减少对外部资源的依赖。例如,当服务端应用需要进行频繁的计算或查询时,它可以先检查LocalCache中是否有相应的缓存结果,如果有则直接返回缓存结果,否则再进行计算或查询,并将结果缓存到LocalCache中。 5.**开源框架:**许多开源框架提供了自己的LocalCache实现,以方便开发人员在应用中使用。这些框架通常提供了丰富的配置选项和高性能的缓存实现,可以根据应用需求进行定制。例如,Guava、Caffeine和Ehcache等是常见的Java开源框架,它们提供了LocalCache的实现,可以用于缓存计算结果、数据库查询结果等。 5、LocalCache在Guava实践 Guava cache 继承了 ConcurrentHashMap 的思路,使用多个 segments 方式的细粒度锁,在保证线程安全的同时,支持高并发场景需求。 1、CacheBuilder 缓存构建器。构建缓存的入口,指定缓存配置参数并初始化本地缓存。采用 Builder 设计模式提供了设置好各种参数的缓存对象。 CacheBuilder<Object,Object> cacheBuilder =CacheBuilder.newBuilder(); 2、LocalCache 数据结构。缓存核心类 LocalCache 数据结构与 ConcurrentHashMap 很相似,由多个 segment 组成,且各 segment 相对独立,互不影响,所以能支持并行操作,每个 segment 由一个 table 和若干队列组成。缓存数据存储在 table 中,其类型为AtomicReferenceArray,具体结构图及代码解释如下。 #Guava中LocalCache声明segments变量 final LocalCache.Segment<K, V>[] segments; #Guava中初始化segments this.segments = this.newSegmentArray(segmentCount); final LocalCache.Segment<K, V>[] newSegmentArray(int ssize) { return new LocalCache.Segment[ssize]; } #获取Segment Segment<K, V> segmentFor(int hash) { return segments[(hash >>> segmentShift) & segmentMask]; } #Guava中Segment声明table变量用于存储数据 volatile AtomicReferenceArray<LocalCache.ReferenceEntry<K, V>> table; V put(K key, int hash, V value, boolean onlyIfAbsent) { #保证线程安全 lock(); #获取数据 AtomicReferenceArray<ReferenceEntry<K, V>> table = this.table; int index = hash & (table.length() - 1); ReferenceEntry<K, V> first = table.get(index); for (ReferenceEntry<K, V> e = first; e != null; e = e.getNext()) { if (e.getHash() == hash && entryKey != null && map.keyEquivalence.equivalent(key, entryKey)) { } } } 3、在Guava中,CacheBuilder提供了一系列方法,用于指定缓存的大小、过期策略、并发级别等属性。 1.配置缓存属性:通过一系列方法来配置缓存的属性,例如: •maximumSize(long size):指定缓存的最大容量,当缓存达到最大容量时,根据缓存策略淘汰部分缓存项。 •expireAfterWrite(Duration duration):指定缓存项的写入后过期时间,过期后的缓存项将被自动移除。 •expireAfterAccess(Duration duration):指定缓存项的最后一次访问后过期时间,过期后的缓存项将被自动移除。 •concurrencyLevel(int level):指定并发级别,即同时可以进行缓存操作的线程数。 Cache<Object,Object> cache = cacheBuilder.maximumSize(1000) .expireAfterWrite(Duration.ofMinutes(10)) .concurrencyLevel(4) .build(); 2. 使用缓存:通过Cache对象的方法来进行缓存的读取、写入和移除操作。例如: •get(Object key):根据键获取缓存项的值。 •put(Object key, Object value):向缓存中添加或更新一个缓存项。 •invalidate(Object key):移除指定键的缓存项。 3. 其他功能:Guava的LocalCache还提供了其他功能,如统计信息、监听器、加载器等,用于监控缓存的状态、处理缓存未命中的情况等。 CacheStats stats = cache.stats(); cache.asMap().forEach((key, value)->System.out.println(key +": "+ value)); cache.cleanUp(); 总结来说,Guava的LocalCache使用CacheBuilder构建和配置缓存,通过Cache对象进行缓存的读取、写入和移除操作。开发人员可以根据自己的需求使用相应的方法和功能来定制和管理缓存。 6、后记 设计一个可用的 Cache 绝对不是一个普通的 Map 这么简单,这里小结一下关于 Guava Cache 的知识。 回归LocalCache 的源头,我是希望可以了解 设计一个缓存要考虑什么?,局部性原理 是一个系统性能提升的最直接的方式(编程上,硬件上当然也可以),缓存的出现就是根据 局部性原理 所设计的。 缓存作为存储金字塔的一部分,一定需要考虑以下几个问题: 1.何时加载 在设计何时加载的问题上,Guava Cache 提供了一个 Loader 接口,让用户可以自定义加载过程,在由 Cache 在找不到对象的时候主动调用 Loader 去加载,还通过一个巧妙的方法,既保证了 Loader 的只运行一次,还能保证锁粒度极小,保证并发加载时,安全且高性能。 2. 何时失效 失效处理上,Guava Cache 提供了基于容量、有限时间(读有限时、写有限时)等失效策略,在官方文档上也写明,在基于限时的情况下,并不是使用一个线程去单独清理过期 K-V,而是把这个清理工作,均摊到每次访问中。假如需要定时清理,也可以调用 CleanUp 方法,定时调用就可以了。 3. 如何保持热点数据有效性 在 Cache 容量有限时, LRU 算法是一个通用的解决方案,在源码中,Guava Cache 并不是严格地保证全局 LRU 的,只是针对一个 Segment 实现 LRU 算法。这个前提是 Segment 对用户来说是随机的,所以全局的 LRU 算法和单个 Segment 的算法是基本一致的。 4. 写回策略 在 Guava Cache 里,并没有实现任何的写回策略。原因在于,Guava Cache 是一个本地缓存,直接修改对象的数据,Cache 的数据就已经是最新的了,所以在数据能够写入 DB 后,数据就已经完成一致了。 参考文献:Google Guava Cache 全解析 作者:京东科技 游斌平 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

技术分享| anyRTC之RTN网络

RTN(Real-time Network)中文名:实时音视频传输网络。 RTN是最近几年由各大RTC的云厂商提出的一个全新架构的音视频实时传输网络概念。类似于直播的CDN网络,RTN是对音视频的实时性又强烈要求的场景而设计的,原理上全球端到端的时延通过RTN网络可以控制在300ms以内。 anyRTC是RTC的云厂商中较早一批提出RTN概念的厂商,anyRTC是如何实现RTN网络的呢?下面我们来详细介绍一下: 一.介绍 首先介绍几个专用名词: A.SN:推流节点 – 多种协议的客户端推流到此节点。 B.RN:路由节点 – 将流路由给不同区域的客户端。 C.GN:拉流节点 – 将流分发给多种协议的客户端。 D.RoutePath:路由线路 – 流从一个区域到另外一个区域的路径。 anyRTC实现的是可配置化的动态RTN网络,网络可大可小,最小的可以只有一台机器,最大的是可以支持千万级的并发,覆盖全球的RTN网络。 二.实现场景 1.单机版 单机服务只需要推流和拉流的功能,A用户推流,B用户拉流。 适用场景: A.测试,不需要复杂的网络架构。 B.业务量较小的私有化音视频通讯场景。 2.进阶版 如果业务中需要2个服务,这时候必须有RN节点,通过RN节点,可以将区域A的流路由到区域B,反之亦然。 适用场景: A.内外网穿透:在很多行业中,比如金融,公安,消防等领域,对于网络安全要求非常高,需要做到内外网隔离,通过固定端口进行数据互通。 B.跨区互通:比如一个公司新疆和上海都有业务,如果服务只部署在新疆或者上海,对应的另外一个区域的用户体验就会非常差,通过各自区域部署节点,本国用户用各自的节点,只有在两区域之间有互动时,通过RN把流中转给对方。 C.跨国运营:比如一个公司中国和美国都有业务,如果美国要求本国的数据必须本地化存储和传输,通过各自区域部署节点,本国用户用各自的节点,进行数据存储和传输,只有在两国之间有互动时,通过RN把流中转给对方。 3.高阶版 多区域的RTN网络,适用于高并发高接入量的应用场景,这时候RN服务独立出来,专门做流路由的工作,SN和GN也可以分离,因为当应对大并发时,拉流的业务需求会多得多。 适用场景: A.RTC云服务厂商,服务有大量RTC接入或者直播接入的场景。 B.多国运营,针对不同国家提供可落地的个性化服务,结合当地法律适配更多场景的运营策略。 C.更低延时的直播CDN分发,CDN厂家可以使用RTN网络来传输节点之间的数据流,然后在各自的落地点进行直播CDN分发。 D.更高规格的网络安全,在行业内,存在网络的隔离区特别多的业务需求,这时候可以使用多区域RTN部署,解决各个网络之间的透传。 E.垮多运营商,比如移动,联通,电信,沃达丰等,各个运营商之间如果直连效果可能不会太好,此时可以在不同运营商的机房中部署服务,RN节点部署在三线机房,通过RN节点进行数据互传。 三.总结 anyRTC通过可配置化的RTN网络,组建了一张全球的RTC传输网络,anyRTC的RTN网络自上线以来实现了超过1000+天的连续稳定运行,平均每日服务的客户接入量超过50w+。同时不久的将来,anyRTC也会开放RTN网络服务,敬请期待吧!

优秀的个人博客,低调大师

Apache Pulsar 技术系列 - Pulsar 总览

Apache Pulsar 是一个多租户、高性能的服务间消息传输解决方案,数据持久化依赖 Apache BookKeeper 实现,支持多租户、低延时、读写分离、跨地域复制、快速扩容、灵活容错等特性。本文将从以下几个方面为大家介绍 Apache Pulsar的设计原理和特性。 1、Apache Pulsar 架构 2、架构设计的优势 3、Pulsar 特性 4、总结 Apache Pulsar 架构 存储计算分离 Apache Pulsar 是 Pub/Sub 模型的消息系统,并且从设计上做了存储和计算的分离,如图一所示。 图一 Pulsar 架构 Apache Pulsar 主要包括 Broker, Apache BookKeeper, Producer, Consumer等组件。 Broker:无状态服务层,负责接收和传递消息,集群负载均衡等工作,Broker 不会持久化保存元数据,因此可以快速的上、下线。 Apache BookKeeper:有状态持久层,由一组名为 Bookie 的存储节点组成,持久化地存储消息。 Producer :数据生产者,负责发布数据到 Topic。 Consumer:数据消费者,负责从 Topic 订阅数据。 除了上述的组件之外,Apache Pulsar 还依赖 Zookeeper 作为元数据存储。与传统的消息系统相比,Apache Pulsar 在架构设计上采用了计算与存储分离的模式,Pub/Sub 相关的计算逻辑在 Broker 上完成,数据存储在 Apache BookKeeper 的 Bookie 节点上。 分片存储 除了存储、计算解耦分离的设计之外,Apache Pulsar 在存储设计上也不同于传统 MQ 的分区数据本地存储的模式,采用的是分片存储的模式,存储粒度比分区更细化、存储负载更均衡。Apache Pulsar 中的每个 Topic 分区本质上都是存储在 Apache BookKeeper 中的分布式日志。Topic 可以有多个分区,分区数据持久化时,分区是逻辑上的概念,实际存储的单位是分片(Segment)的,如图二,一个分区 Topic1-Part2 的数据由多个 Segment 组成, 每个 Segment 作为 Apache BookKeeper 中的一个 Ledger,均匀分布并存储在 Apache BookKeeper 群集中的多个 Bookie 节点中, 每个 Segment 具有 3 个副本。 图二 Pulsar 分片存储 下面可以通过图三来看分区和分片存储的区别。 图三 分片存储和分区存储 架构设计的优势 Apache Pulsar 计算与存储分离的架构,以及分片存储的设计为 Apache Pulsar 带来了相比于传统基于分区存储 MQ 的一些优势: Broker 和 Bookie 相互独立,方便实现独立的扩展以及独立的容错。 Broker 无状态,便于快速上、下线,更加适合于云原生场景。 分区存储不受限于单个节点存储容量。 分区数据分布均匀。 ... 可扩展性 由于消息服务层和持久存储层是分开的,因此 Apache Pulsar 可以独立地扩展存储层和服务层。 Broker 扩展 在 Pulsar 中 Broker 是无状态的,可以通过增加节点的方式实现快速扩容。当需要支持更多的消费者或生产者时,可以简单地添加更多的 Broker 节点来满足业务需求。Pulsar 支持自动的分区负载均衡,在 Broker 节点的资源使用率达到阈值时,会将负载迁移到负载较低的 Broker 节点,这个过程中分区也将在多个 Broker 节点中做平衡迁移,一些分区的所有权会转移到新的Broker节点。 Bookie扩展 存储层的扩容,通过增加 Bookie 节点来实现。通过资源感知和数据放置策略,流量将自动切换到新的 Bookie 节点中,整个过程不会涉及到不必要的数据搬迁,即不需要将旧数据从现有存储节点重新复制到新存储节点。 图四 Bookie 扩容 如图四所示,起始状态有四个存储节点,Bookie1, Bookie2, Bookie3, Bookie4,以 Topic1-Part2为例,当这个分区的最新的存储分片是 SegmentX 时,对存储层扩容,添加了新的 Bookie 节点,BookieX,BookieY,那么在存储分片滚动之后,新生成的存储分片, SegmentX+1,SegmentX+2,会优先选择新的 Bookie 节点(BookieX,BookieY)来保存数据。 容错 得益于计算与存储分离以及分片存储的设计,Pulsar 可以实现独立、灵活的容错。 Broker 容错 当 Broker 节点失败时, 以图五为例,当存储分片滚动到 SegmentX 时,Broker2 节点失败,此时生产者和消费者向其他的Broker发起请求,这个过程会触发分区的所有权转移,即将 Broker2 拥有的分区 Topic1-Part2 的所有权转移到其他的 Broker(Broker3)。在 Apache Pulsar 中数据存储和数据服务分离,所以新 Broker 接管分区的所有权时,它不需要复制 Partiton 的数据。新的分区 Owner(Broker3)会产生一个新的分片 SegmentX+1, 如果有新数据到来,会存储在新的分片Segment x+1上,不会影响分区的可用性。 图五 Broker 容错 Bookie容错 当 Bookie 节点失败时,如图六所示, 假设 Bookie 2 上的 Segment 4 损坏。Apache BookKeeper Auditor 会检测到这个错误并进行复制修复。Apache BookKeeper 中的副本修复是 Segment 级别的多对多快速修复,BookKeeper 可以从 Bookie 3 和 Bookie 4 读取 Segment 4 中的消息,并在 Bookie 1 处修复 Segment 4。如果是 Bookie 节点故障,这个 Bookie 节点上所有的 Segment 会按照上述方式复制到其他的Bookie节点。所有的副本修复都在后台进行,对Broker和应用透明,Broker 会产生新的Segment 来处理写入请求,不会影响分区的可用性。 图六 Bookie 容错 无限制的分区存储 分片存储解决了分区容量受单节点存储空间限制的问题,当容量不够时,可以通过扩容 Bookie 节点的方式支撑更多的分区数据,也解决了分区数据倾斜问题,数据可以均匀的分配在 Bookie 节点上。Broker 和 Bookie 灵活的容错以及无缝的扩容能力让 Apache Pulsar 具备非常高的可用性。 Pulsar 特性 基于上述的设计特点,Pulsar 提供了很多特性,以下做简要的介绍。 读写分离 Pulsar另外一个有吸引力的特性是提供了读写分离的能力,读写分离保证了在有大量滞后消费(磁盘IO会增加)时,不会影响服务的正常运行,尤其是不会影响到数据的写入。读写分离的能力由 Apache BookKeeper 提供,简单说一下 Bookie 存储涉及到的概念: Journals:Journal 文件包含了 BookKeeper事务日志,在 Ledger 更新之前,Journal 保证描述更新的事务写入到 Non-volatile 的存储介质上。 Entry logs:Entry 日志文件管理写入的 Entry,来自不同 ledger 的 entry 会被聚合然后顺序写入。 Index files:每个 Ledger都有一个对应的索引文件,记录数据在 Entry 日志文件中的 Offset 信息。 Entry 的读写入过程如图七所示,数据的写入流程: 数据首先会写入 Journal,写入 Journal 的数据会实时落到磁盘。 然后,数据写入到 Memtable ,Memtable 是读写缓存。 写入 Memtable 之后,对写入请求进行响应。 Memtable 写满之后,会 Flush 到 Entry Logger 和 Index cache,Entry Logger 中保存了数据,Index cache 保存了数据的索引信息,然后由后台线程将 Entry Logger 和 Index cache 数据落到磁盘。 数据的读取流程: 如果是 Tailing read 请求,直接从 Memtable 中读取 Entry。 如果是 Catch-up read(滞后消费)请求,先读取 Index信息,然后索引从 Entry Logger 文件读取 Entry。 图七 Bookie的数据写入和读取 一般在进行 Bookie 的配置时,会将 Journal 和Ledger 存储磁盘进行隔离,减少 Ledger 对于 Journal写入的影响,并且推荐 Journal 使用性能较好的 SSD 磁盘,读写分离主要体现在: 写入 Entry 时,Journal 中的数据需要实时写到磁盘,Ledger的数据不需要实时落盘,通过后台线程批量落盘,因此写入的性能主要受到 Journal 磁盘的影响。 读取 Entry 时,首先从 Memtable 读取,命中则返回;如果不命中,再从 Ledger 磁盘中读取,所以对于 Catch-up read 的场景,读取数据会影响 Ledger 磁盘的 IO,对 Journal 磁盘没有影响,也就不会影响到数据的写入。 所以,数据写入是主要是受 Journal 磁盘的负载影响,不会受Ledger 磁盘的影响。另外,Segment 存储的多个副本都可以提供读取服务,相比于主从副本的设计,Apache Pulsar 可以提供更好的数据读取能力。通过以上分析,Apache Pulsar 使用 Apache BookKeeper 作为数据存储,可以带来下列的收益: 支持将多个 Ledger 的数据写入到同一个 Entry logger 文件,可以避免分区膨胀带来的性能下降问题。 支持读写分离,可以在滞后消费场景导致磁盘IO上升时,保证数据写入的不受影响。 支持全副本读取,可以充分利用存储副本的数据读取能力。 多种消费模型 Apache Pulsar 提供了多种订阅方式来消费消息,分为三种类型:独占(Exclusive),故障切换(Failover)或共享(Share)。 图八 消费模型 Exclusive 独占订阅:在任何时间,一个消费者组(订阅)中有且只有一个消费者来消费 Topic 中的消息。 Failover 故障切换:多个消费者(Consumer)可以附加到同一订阅。但是,一个订阅中的所有消费者,只会有一个消费者被选为该订阅的主消费者。其他消费者将被指定为故障转移消费者。当主消费者断开连接时,分区将被重新分配给其中一个故障转移消费者,而新分配的消费者将成为新的主消费者。发生这种情况时,所有未确认(ack)的消息都将传递给新的主消费者。 Share 共享订阅:使用共享订阅,在同一个订阅背后,用户按照应用的需求挂载任意多的消费者。订阅中的所有消息以循环分发形式发送给订阅背后的多个消费者,并且一个消息仅传递给一个消费者。当消费者断开连接时,所有传递给它但是未被确认(ack)的消息将被重新分配和组织,以便发送给该订阅上剩余的剩余消费者。 多种ACK模型 消息确认(ACK)的目的就是保证当发生故障后,消费者能够从上一次停止的地方恢复消费,保证既不会丢失消息,也不会重复处理已经确认(ACK)的消息。在 Pulsar 中,每个订阅中都使用一个专门的数据结构--游标(Cursor)来跟踪订阅中的每条消息的确认(ACK)状态。每当消费者在分区上确认消息时,游标都会更新。Pulsar 提供两种消息确认方法: 单条确认(Individual Ack),单独确认一条消息。被确认后的消息将不会被重新传递。 和累积确认(Cumulative Ack),通过累积确认,消费者只需要确认它收到的最后一条消息。 图九说明了单条确认和累积确认的差异(灰色框中的消息被确认并且不会被重新传递)。对于累计确认,M12 之前的消息被标记为 Acked。对于单独进行 ACK,仅确认消息 M7 和 M12, 在消费者失败的情况下,除了 M7 和 M12 之外,其他所有消息将被重新传送。 图九 ACK模型 跨地域复制 Apache Pulsar 的跨地域复制机制(Geo-Replication)提供了一种全连接的异步复制,可以满足多个数据中心数据同步的使用场景。 图十 Geo-replication 如图十所示,有三个 Apache Pulsar 集群,分布于北京、上海和广州,用户创建的一个 Topic T1 设置了跨越三个数据中心做互备。在三个数据中心中,分别有三个生产者:P1、P2、P3,它们往主题 T1 中发布消息;有两个消费者:C1、C2,订阅了这个主题,接收主题中的消息。当消息由本数据中心的生产者发布成功后,会立即复制到其他两个数据中心。消息复制完成后,消费者不仅可以收到本数据中心产生的消息,也可以收到从其他数据中心复制过来的消息。 总结 Pulsar 采用了计算、存储分离的设计,并且存储在逻辑上分区,物理上分片,具有一些传统类 kafka 的 MQ 所不具备的优势,也解决了一些业界的痛点,Pulsar 目前社区比较活跃,还处于快速发展的阶段,除了以上的特性之外,Pulsar还可以支持事务、SQL查询、Function等功能,另外 Pulsar 支持 protocol handler,比如 KoP(Kafka on Pulsar), 可以原生支持 Kafka 协议的数据,对于这些特性,我们会在后续的文章中做介绍。

优秀的个人博客,低调大师

使用 dotMemory 优化 dotMemory | 技术解析

dotMemory1是 JetBrains 推出的一款 .NET 内存分析器。我要讲一个经典的内部测试故事,在故事里我们用自己的工具 dotMemory 和dotTrace2 优化了 dotMemory 的一种算法。我们还使用 dotTrace 对其进行了更多改进,并使用 BenchmarkDotNet3完成了优化过程。 最开始,一位同事在 Slack 中给我发送消息,告诉我他在 dotMemory 的支配树4上遇到了问题。树的数据计算时间太长了,他实在等不到进程结束。好在问题是内部的,我们收集内存快照并展开了调查。 在本地机器上重现问题时,我们发现内存使用以每秒 1.17 GB 的速度快速增长,迫使进程开始使用交换文件。发生这种情况通常就意味着无法在合理的时间范围内收到结果。接下来,该用 dotMemory 解决 dotMemory 中的问题了。 进程完全耗尽物理内存后,快照会难以捕获,甚至操作系统也不再稳定。因此,我们决定在内存使用开始快速增长时捕获快照,但物理内存还有一些剩余。dotMemory 控制台分析器5是完成这项工作的最佳工具: 此命令以分析模式启动dotMemory.UI.64.exe。它会在“private bytes”量达到 20 GB 时立即捕获快照,并在分析完成后在 dotMemory 中打开快照。在我们的情况中,我们不得不手动停止分析(否则我们最终会再次交换)。我们一直等到数据足够,然后按 Ctrl+C。 现在有了快照,我们在 dotMemory 中将其打开。首先,分析支配树 – 我的同事无法获得的支配树,我在快照中得到了: 内存中充斥着大约 6000 万个CompactDominatorTreeNode+Builder对象,每个对象都包含一个字典。显然,对于大多数字典来说,大小 < 容量,这意味着大量内存被浪费了。 我们必须看看这些字典的用途,也许我们不需要这么多?我选择了 CompactDominatorTreeNode+Builder节点并导航到它的声明(使用上下文菜单或按 Ctrl+L)。这将我导航到我的 IDE (Rider6) 并打开了相应的类。运行 Find Usages7(查找用法)将我带到了CompactDominatorTree.Build方法,其中包含支配树压缩算法。 介绍一点背景:首先,dotMemory 构建一个支配树,如下所示。对于每个对象,它会搜索专门保留它的对象并保存该保留对象,如果没有,则保存表示缺少此类保留对象的标记。树可能会变得非常大,没有必要“按原样”向用户展示。因此,dotMemory 在树的每一级按对象类型对树节点进行分组。CompactDominatorTreeNode+Builder表示正在构建的紧凑(压缩)树的节点,字典用于按类型对节点进行分组。 算法以“下级→上级”格式接收树,每个对象都与其支配上级匹配。它按顺序遍历快照中的所有对象。每有一个支配上级尚未被处理的对象,紧凑树中就会创建一个新的组节点。当前节点成为组节点中的下级节点(现有节点或新创建的节点)。 使用这种方法,树以任意顺序遍历,每个节点都必须存储一个字典,字典按类型对节点进行分组。在大多数情况下,这都不是问题,因为紧凑树比包含所有对象的树要小得多,并且没有显著的内存过度使用。但是这个快照属于极端情况,因为即使是紧凑的树也很大。 现在的问题是,“我们怎样才能使用更少的字典?”,如果我们只有一个带组合键的字典,该怎么办?这将迫使我们必须执行分解,再次导致内存过度使用或更复杂的计算。我们不得不考虑其他方案。 我们退后一步,更全面地分析问题。使用不同的方式遍历树如何?比如广度优先搜索?这种方式看起来很可行。一个具有常规键的字典就足够了。这样,每当我们构建完成紧凑树的新级别,我们都会清除字典,从而可以在下一次迭代中重用它。 不过注意:“下级→上级”格式不适合广度优先搜索,因为检索给定节点的下级节点的计算开销过大。我们需要不同的输入树格式。好在我们已经有了一个备选方案:dotMemory 也能将支配树存储为“上级→下级”邻接列表。这意味着,我们可以在不增加计算复杂性的情况下更改算法以使用广度优先搜索。 我们进行了相应编辑并运行。我们看到内存使用的增长速度比以前慢得多,从每秒 1.17 GB 变为仅仅每秒 7 MB,但该进程仍然未能完成而且再次开始使用交换文件。 我们回到绘图板。我们捕获了另一个快照并将其打开。新的支配树看起来像这样: 这次仅紧凑树就占用了 16 GB。这个大小合理吗?也许我们还可以用更经济的方式存储这棵树? 我们按类型对节点进行分组以查找我们有多少个节点: 在 16 GB 的总大小中,树的 9000 万个节点仅占用 6 GB。这有些可疑。我们导航到 CompactDominatorTree2+Node声明的代码: publicsealedclassNode{publicDfsNumberDfsNumber{get;}//8bytespublicTypeIdObjectsType{get;}//4bytespublicintObjectsCount{get;}//4bytespublicintRetainedObjectsCount{get;}//4bytespubliculongRetainedBytes{get;}//8bytespublicboolIsContainedInSet{get;}//1bytepublicNodeParent{get;}//8bytesinternalJetArray<Node>ChildrenImpl{get;}//8bytes//wehaveomittedunnecessarydetails} 这里的有效负载只有 45 字节,但加上标题和对齐,一个 Node 对象就占用了 72 字节。它保留的更多,平均 192 字节。为了查看详细信息,我们切换到 Instances(实例)选项卡,使用查询CompactDominatorTree2+Node !g !a筛选内容(!g排除泛型,!a排除数组)。这是一个随机实例: 实例详情: 这可是好些开销。 现在,我们可以清楚地看到JetMutableArray并不是为大型树存储下级节点的最有效方式。我们想到的第一个解决方案当然是优化下级节点的存储。例如,我们可以将它们存储在标准数组中。但我们选择了一条更激进的道路。 大型数据结构在 dotMemory 中很常见。例如,对象图被存储为邻接列表,使用两个通过整数数组索引相互引用的结构数组。这很有趣,因为在 dotMemory 中,我们刚刚停止使用托管数组而转移到我们自己的基于内存映射文件的实现。这有助于我们在访问元素时实现最小开销(C 中的原生内存索引形式),以及加载和保存数组的快速方式(完全在操作系统级别),并且在序列化/反序列化时没有开销。另外,即使没有我们的参与,这些数组的片段也可以从内存中卸载,帮助我们在顺序遍历数组时释放物理内存。 我们决定在紧凑支配树上使用相同的方式。我们还将IsContainedInSet特性变成了一个位标志,并消除了没有使用的Parent属性。最后,我们为树节点得到了以下结构: [StructLayout(LayoutKind.Sequential,Pack=4)]publicreadonlystructNode{publicreadonlyTypeIdObjectsType;privatereadonlyuint_objectsCount;publicintObjectsCount=>(int)(_objectsCount&0x7FFFFFFF);publicboolIsContainedInSet=>(_objectsCount&0x80000000)!=0;publicreadonlyintRetainedObjectsCount;publicreadonlyulongRetainedBytes;publicreadonlyDfsNumberDfsEnter;publicreadonlyRange<uint>Children; 值得注意的是,通过这种顺序表示,我们甚至可以只使用一个指向下级节点的整数链接。不过,我们使用了一个范围,该范围允许我们按RetainedBytes升序对构建树的下级节点进行排序以帮助我们构建旭日图。对于上面显示的表示,节点 #1、#2 和 #3 的顺序可能会改变。 我们屏住呼吸,运行了程序。成了!内存使用峰值仅为 12 GB。支配树成功构建,耗时 55 分钟 – 仍然比我们期望的要长,但可以接受。快照现在总共包含 2.75 亿个对象,紧凑树包含 2 亿个节点。 这显然是一个好结果。我们一开始无法将大小降至 32 GB 以下,计算需要很长时间,现在,它已经降到 12 GB 并能在 55 分钟内就绪。然而,我们还是感觉我们可以做得更好。55 分钟绝对算不上理想。我们决定查明这些时间都用在了哪里。进入 dotTrace: 好在我们不需要等待进程完成,记录几分钟的性能就足够了。我们使用--timeout=3m键在 3 分钟后自动停止分析。我们打开快照,应用筛选以识别正在执行我们任务的线程,这是长时间保持完全加载的线程。调用树是这样的: 令人震惊的是,92% 的时间显然都被Dictionary.Clear占用了!我们简直不敢相信。Clear在标准库字典上怎么会表现得如此糟糕?原来,问题是字典在算法的第一次迭代中已经膨胀到了 22K 的巨大元素,而随后的迭代通常只涉及几十个元素。Dictionary.Clear的计算复杂度与Capacity(不是Count)成正比,特别是buckets.Length,它与Capacity成线性关系。这意味着我们在不断清除空元素!事实证明,选择清除和重用字典时,我们对模型进行了过多的优化。 再退一步,我们现在尝试了最直接的方式 – 为每次迭代创建一个新字典。我们再次启动秒表,运行代码,这次充满期待。哇!1 分 46 秒!垃圾回收器上的负载增加了,但它分布均匀并且管理良好,我们使用 dotTrace 验证了这一事实。就是这样。我们在不到 2 分钟的时间内处理了 2.75 亿个对象,内存使用峰值仅为 12 GB。我们相当高兴,准备好将优化的代码提交到仓库。 后来,我们决定再做一次测试。我们在不同的快照上运行了旧算法和新算法,比较性能。我们找到了一个大小相同但拓扑不同的快照,旧算法也可以处理,然后把它馈送给两种算法。令我们大吃一惊的是,新算法比旧算法慢了 33%,尽管计算复杂度没有变化。但这就是另一个故事了,我们以后再讲。如果您有兴趣,请在下方留言或直接联系我们! 相关链接: dotMemory:https://www.jetbrains.com.cn/dotmemory/ dotTrace:https://www.jetbrains.com.cn/profiler/ BenchmarkDotNet:https://github.com/dotnet/BenchmarkDotNet 支配树:https://www.jetbrains.com/help/dotmemory/Retained_by.html dotMemory 控制台分析器:https://www.jetbrains.com.cn/dotmemory/download/#section=commandline Rider:https://www.jetbrains.com.cn/rider/ Find Usages:https://www.jetbrains.com/help/rider/Navigation_and_Search__Finding_Usages.html 本博文英文原作者:Ilya Ivanov 关于 dotMemory .NET 内存分析器 用于优化 .NET 应用程序的内存使用,检测内存泄漏和克服各类内存问题。 扫码查看详情页开启30天免费试用 »»» ⏬ 戳「阅读原文」了解更多 本文分享自微信公众号 - JetBrains(JetBrainsChina)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册