首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

复杂场景,从OpenTSDB迁移到TDengine的最佳实践

在上一篇文章中,我们介绍了运维监控场景下,如何从OpenTSDB迁移到TDengine。 如果应用特别复杂,或者应用领域并不是运维监控场景,本文将更加全面深入地介绍将OpenTSDB应用迁移到TDengine的高级话题。 其他场景的迁移评估与策略 1、TDengine 与 OpenTSDB 的差异 本节将详细介绍OpenTSDB与TDengine在系统功能层面上存在的差异。 读完本节之后,你可以全面地评估是否能将某些基于OpenTSDB的复杂应用迁移到TDengine上,以及迁移之后应该注意的问题。 TDengine当前只支持Grafana的可视化看板呈现,所以如果应用中使用的是其他看板(例如TSDash、Status Wolf等),那么暂时无法直接迁移到TDengine,需要将其重新适配到Grafana才可以正常运行。 截止到2.3.0.x 版本,TDengine只能够支持collectd和StatsD作为数据收集汇聚软件,当然后面会陆续提供更多的数据收集聚合软件的接入支持。如果收集端使用了其他类型的数据汇聚器,则需要适配到这两个数据汇聚端系统,才能正常写入。除了上述两个数据汇聚端软件协议以外,TDengine还支持通过 InfluxDB的行协议和OpenTSDB的数据写入协议、Json格式将数据直接写入,可以重写数据推送端的逻辑,使用TDengine支持的行协议来写入数据。 此外,如果应用中使用了OpenTSDB的以下特性,在迁移之前还需要了解以下注意事项: /api/stats:如果应用中使用了该项特性来监控OpenTSDB的服务状态,并在应用中建立了相关的逻辑来联动处理,那么这部分状态读取和获取的逻辑需要重新适配到TDengine。TDengine提供了全新的处理集群状态监控机制,来满足应用对其进行的监控和维护的需求。 /api/tree:如果依赖于OpenTSDB的该项特性来进行时间线的层级化组织和维护,那么便无法将其直接迁移至TDengine。TDengine采用了数据库->超级表->子表这样的层级来组织和维护时间线,归属于同一个超级表的所有的时间线在系统中同一个层级,但是可以通过不同标签值的特殊构造来模拟应用逻辑上的多级结构。 Rollup And PreAggregates:采用了Rollup和PreAggregates,需要应用来决定在合适的地方访问Rollup的结果,在某些场景下又要访问原始的结果,这种结构的不透明性让应用处理逻辑变得极为复杂而且完全不具有移植性。我们认为这种策略是时序数据库无法提供高性能聚合情况下的妥协与折中。TDengine暂不支持多个时间线的自动降采样和(时间段范围的)预聚合,由于 其拥有的高性能查询处理逻辑,即使不依赖于Rollup 和 (时间段)预聚合计算结果,也能够提供很高性能的查询响应,而且让你的应用查询处理逻辑更加简单。 Rate: TDengine提供了两个计算数值变化率的函数,分别是Derivative(其计算结果与InfluxDB的Derivative行为一致)和IRate(其计算结果与Prometheus中的IRate函数计算结果一致)。但是这两个函数的计算结果与 Rate 有细微的差别,但整体上功能更强大。此外,**OpenTSDB提供的所有计算函数,TDengine 均有对应的查询函数支持,并且TDengine的查询函数功能远超过OpenTSDB支持的查询函数,**可以极大地简化应用处理逻辑。 通过上面的介绍,相信你应该能够了解OpenTSDB迁移到TDengine带来的变化,这些信息也有助于你正确地判断是否可以接受将应用迁移到TDengine之上,体验TDengine提供的强大的时序数据处理能力和便捷的使用体验。 2、迁移策略 首先将基于OpenTSDB的系统进行迁移涉及到的数据模式设计、系统规模估算、数据写入端改造,进行数据分流、应用适配工作;之后将两个系统并行运行一段时间,再将历史数据迁移到 TDengine 中。当然如果你的应用中有部分功能强依赖于上述OpenTSDB特性,同时又不希望停止使用,可以考虑保持原有的OpenTSDB系统运行,同时启动 TDengine来提供主要的服务。 数据模型设计 一方面,TDengine 要求其入库的数据具有严格的模式定义。另一方面,TDengine 的数据模型相对于 OpenTSDB 来说又更加丰富,多值模型能够兼容全部的单值模型的建立需求。 现在让我们假设一个运维监控场景,我们使用了collectd收集设备的基础度量(metrics),包含了 memory、swap和disk 等几个度量,其在 OpenTSDB 中的模式如下: 序号 测量(metric) 值名称 类型 tag1 tag2 tag3 tag4 tag5 1 memory value double host memory_type memory_type_instance source 2 swap value double host swap_type swap_type_instance source 3 disk value double host disk_point disk_instance disk_type source TDengine要求存储的数据具有数据模式,即写入数据之前需创建超级表并指定超级表的模式。对于数据模式的建立,有两种方式来完成此项工作: 1)充分利用TDengine对OpenTSDB的数据原生写入的支持,调用TDengine提供的API将(文本行或 JSON 格式)数据写入,并自动化地建立单值模型。采用这种方式不需要对数据写入应用进行较大的调整,也不需要对写入的数据格式进行转换。 在C语言层面,TDengine提供了taos_insert_lines来直接写入OpenTSDB格式的数据(在2.3.x 版本中该函数对应的是 taos_schemaless_insert )。其代码参考示例请参见安装包目录下示例代码 schemaless.c。 2)在充分理解TDengine数据模型的基础上,结合生成数据的特点,手动建立OpenTSDB到TDengine的数据模型调整的映射关系。TDengine能够支持多值模型和单值模型,考虑到OpenTSDB均为单值映射模型,这里推荐使用单值模型在TDengine中进行建模。 单值模型 具体步骤如下:将度量(metrics)的名称作为 TDengine 超级表的名称,该超级表建成后具有两个基础的数据列—时间戳(timestamp)和值(value),超级表的标签等效于 度量 的标签信息,标签数量等同于度量 的标签的数量。子表的表名采用具有固定规则的方式进行命名:metric + '_' + tags1_value + '_' + tag2_value + '_' + tag3_value ...作为子表名称。 在TDengine中建立3个超级表: create stable memory(ts timestamp, val float) tags(host binary(12),memory_type binary(20), memory_type_instance binary(20), source binary(20)); create stable swap(ts timestamp, val double) tags(host binary(12), swap_type binary(20), swap_type_binary binary(20), source binary(20)); create stable disk(ts timestamp, val double) tags(host binary(12), disk_point binary(20), disk_instance binary(20), disk_type binary(20), source binary(20)); 对于子表使用动态建表的方式创建如下所示: insert into memory_vm130_memory_bufferred_collectd using memory tags(‘vm130’, ‘memory’, 'buffer', 'collectd') values(1632979445, 3.0656); 最终系统中会建立 340 个左右的子表,3个超级表。需要注意的是,如果采用串联标签值的方式导致子表名称超过系统限制(191字节),那么需要采用一定的编码方式(例如 MD5)将其转化为可接受的长度。 多值模型 如果想利用TDengine的多值模型能力,需要首先满足以下要求:不同的采集量具有相同的采集频率,且能够通过消息队列同时到达数据写入端,从而确保使用SQL语句将多个指标一次性写入。将度量的名称作为超级表的名称,建立具有相同采集频率且能够同时到达的数据多列模型。子表的表名采用具有固定规则的方式进行命名。上述每个度量均只包含一个测量值,因此无法将其转化为多值模型。 数据分流与应用适配 从消息队列中订阅数据,并启动调整后的写入程序写入数据。 数据开始写入持续一段时间后,可以采用SQL语句检查写入的数据量是否符合预计的写入要求。 统计数据量使用如下SQL语句: select count(*) from memory 完成查询后,如果写入的数据与预期的相比没有差别,同时写入程序本身没有异常的报错信息,那么可用确认数据写入是完整有效的。 TDengine不支持采用OpenTSDB的查询语法进行查询或数据获取处理,但是针对OpenTSDB的每种查询都提供了对应的支持。具体可以参考相关文档。 TDengine支持以标准的JDBC 3.0接口来操纵数据库,也可以使用其他类型的高级语言的连接器来查询读取数据,以适配应用。具体的操作和使用帮助也请参阅用户手册。 历史数据迁移 1、使用工具自动迁移数据 为了方便历史数据的迁移工作,我们为数据同步工具DataX提供了插件,能够将数据自动写入到TDengine中,需要注意的是DataX的自动化数据迁移只能够支持单值模型的数据迁移过程。 DataX 具体的使用方式及如何使用DataX将数据写入TDengine请参见其使用帮助手册github.com/taosdata/datax。 2、手动迁移数据 如果需要使用多值模型写入数据,就需要自行开发一个将数据从OpenTSDB导出的工具,然后确认哪些时间线能够合并导入到同一个时间线,再将可以同时导入的时间通过SQL语句写入数据库中。 手动迁移数据需要注意以下两个问题: 1)在磁盘中存储导出数据时,磁盘需要有足够的存储空间以便能够充分容纳导出的数据文件。为了避免全量数据导出后导致磁盘文件存储紧张,可以采用部分导入的模式,对于归属于同一个超级表的时间线优先导出,然后将导出部分的数据文件导入到TDengine系统中。 2)在系统全负载运行下,如果有足够的剩余计算和IO资源,可以建立多线程的导入机制,最大限度地提升数据迁移效率。考虑到数据解析对于CPU带来的巨大负载,需要控制最大的并行任务数量,以避免因导入历史数据而触发的系统整体过载。 由于TDegnine本身操作简易性,所以不需要在整个过程中进行索引维护、数据格式的变化处理等工作,整个过程只需要顺序执行即可。 当历史数据完全导入到TDengine以后,此时两个系统处于同时运行的状态,之后便可以将查询请求切换到TDengine上,从而实现无缝的应用切换。

优秀的个人博客,低调大师

springboot + aop + Lua分布式限流的最佳实践

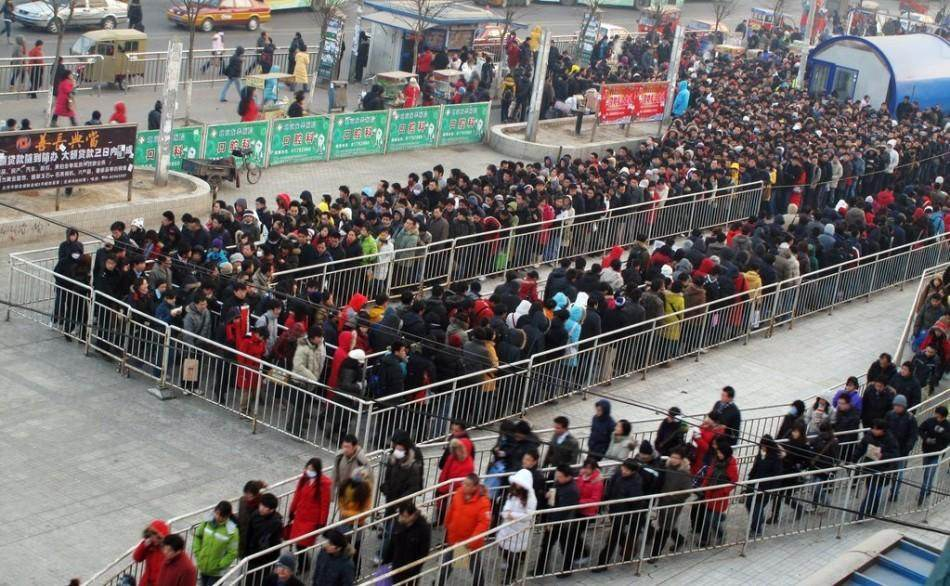
本文收录在 GitHub 地址 https://github.com/chengxy-nds/Springboot-Notebook 一、什么是限流?为什么要限流? 不知道大家有没有做过帝都的地铁,就是进地铁站都要排队的那种,为什么要这样摆长龙转圈圈?答案就是为了限流!因为一趟地铁的运力是有限的,一下挤进去太多人会造成站台的拥挤、列车的超载,存在一定的安全隐患。同理,我们的程序也是一样,它处理请求的能力也是有限的,一旦请求多到超出它的处理极限就会崩溃。为了不出现最坏的崩溃情况,只能耽误一下大家进站的时间。 限流是保证系统高可用的重要手段!!! 由于互联网公司的流量巨大,系统上线会做一个流量峰值的评估,尤其是像各种秒杀促销活动,为了保证系统不被巨大的流量压垮,会在系统流量到达一定阈值时,拒绝掉一部分流量。 限流会导致用户在短时间内(这个时间段是毫秒级的)系统不可用,一般我们衡量系统处理能力的指标是每秒的QPS或者TPS,假设系统每秒的流量阈值是1000,理论上一秒内有第1001个请求进来时,那么这个请求就会被限流。 二、限流方案 1、计数器 Java内部也可以通过原子类计数器AtomicInteger、Semaphore信号量来做简单的限流。 // 限流的个数 private int maxCount = 10; // 指定的时间内 private long interval = 60; // 原子类计数器 private AtomicInteger atomicInteger = new AtomicInteger(0); // 起始时间 private long startTime = System.currentTimeMillis(); public boolean limit(int maxCount, int interval) { atomicInteger.addAndGet(1); if (atomicInteger.get() == 1) { startTime = System.currentTimeMillis(); atomicInteger.addAndGet(1); return true; } // 超过了间隔时间,直接重新开始计数 if (System.currentTimeMillis() - startTime > interval * 1000) { startTime = System.currentTimeMillis(); atomicInteger.set(1); return true; } // 还在间隔时间内,check有没有超过限流的个数 if (atomicInteger.get() > maxCount) { return false; } return true; } 2、漏桶算法 漏桶算法思路很简单,我们把水比作是请求,漏桶比作是系统处理能力极限,水先进入到漏桶里,漏桶里的水按一定速率流出,当流出的速率小于流入的速率时,由于漏桶容量有限,后续进入的水直接溢出(拒绝请求),以此实现限流。 3、令牌桶算法 令牌桶算法的原理也比较简单,我们可以理解成医院的挂号看病,只有拿到号以后才可以进行诊病。 系统会维护一个令牌(token)桶,以一个恒定的速度往桶里放入令牌(token),这时如果有请求进来想要被处理,则需要先从桶里获取一个令牌(token),当桶里没有令牌(token)可取时,则该请求将被拒绝服务。令牌桶算法通过控制桶的容量、发放令牌的速率,来达到对请求的限制。 4、Redis + Lua 很多同学不知道Lua是啥?个人理解,Lua脚本和 MySQL数据库的存储过程比较相似,他们执行一组命令,所有命令的执行要么全部成功或者失败,以此达到原子性。也可以把Lua脚本理解为,一段具有业务逻辑的代码块。 而Lua本身就是一种编程语言,虽然redis 官方没有直接提供限流相应的API,但却支持了 Lua 脚本的功能,可以使用它实现复杂的令牌桶或漏桶算法,也是分布式系统中实现限流的主要方式之一。 相比Redis事务,Lua脚本的优点: 减少网络开销: 使用Lua脚本,无需向Redis 发送多次请求,执行一次即可,减少网络传输 原子操作:Redis 将整个Lua脚本作为一个命令执行,原子,无需担心并发 复用:Lua脚本一旦执行,会永久保存 Redis 中,,其他客户端可复用 Lua脚本大致逻辑如下: -- 获取调用脚本时传入的第一个key值(用作限流的 key) local key = KEYS[1] -- 获取调用脚本时传入的第一个参数值(限流大小) local limit = tonumber(ARGV[1]) -- 获取当前流量大小 local curentLimit = tonumber(redis.call('get', key) or "0") -- 是否超出限流 if curentLimit + 1 > limit then -- 返回(拒绝) return 0 else -- 没有超出 value + 1 redis.call("INCRBY", key, 1) -- 设置过期时间 redis.call("EXPIRE", key, 2) -- 返回(放行) return 1 end 通过KEYS[1] 获取传入的key参数 通过ARGV[1]获取传入的limit参数 redis.call方法,从缓存中get和key相关的值,如果为null那么就返回0 接着判断缓存中记录的数值是否会大于限制大小,如果超出表示该被限流,返回0 如果未超过,那么该key的缓存值+1,并设置过期时间为1秒钟以后,并返回缓存值+1 这种方式是本文推荐的方案,具体实现会在后边做细说。 5、网关层限流 限流常在网关这一层做,比如Nginx、Openresty、kong、zuul、Spring Cloud Gateway等,而像spring cloud - gateway网关限流底层实现原理,就是基于Redis + Lua,通过内置Lua限流脚本的方式。 三、Redis + Lua 限流实现 下面我们通过自定义注解、aop、Redis + Lua 实现限流,步骤会比较详细,为了小白能让快速上手这里啰嗦一点,有经验的老鸟们多担待一下。 1、环境准备 springboot 项目创建地址:https://start.spring.io,很方便实用的一个工具。 2、引入依赖包 pom文件中添加如下依赖包,比较关键的就是 spring-boot-starter-data-redis 和 spring-boot-starter-aop。 <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-aop</artifactId> </dependency> <dependency> <groupId>com.google.guava</groupId> <artifactId>guava</artifactId> <version>21.0</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> </dependency> <dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-lang3</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> <exclusions> <exclusion> <groupId>org.junit.vintage</groupId> <artifactId>junit-vintage-engine</artifactId> </exclusion> </exclusions> </dependency> </dependencies> 3、配置application.properties 在 application.properties 文件中配置提前搭建好的 redis 服务地址和端口。 spring.redis.host=127.0.0.1 spring.redis.port=6379 4、配置RedisTemplate实例 @Configuration public class RedisLimiterHelper { @Bean public RedisTemplate<String, Serializable> limitRedisTemplate(LettuceConnectionFactory redisConnectionFactory) { RedisTemplate<String, Serializable> template = new RedisTemplate<>(); template.setKeySerializer(new StringRedisSerializer()); template.setValueSerializer(new GenericJackson2JsonRedisSerializer()); template.setConnectionFactory(redisConnectionFactory); return template; } } 限流类型枚举类 /** * @author fu * @description 限流类型 * @date 2020/4/8 13:47 */ public enum LimitType { /** * 自定义key */ CUSTOMER, /** * 请求者IP */ IP; } 5、自定义注解 我们自定义个@Limit注解,注解类型为ElementType.METHOD即作用于方法上。 period表示请求限制时间段,count表示在period这个时间段内允许放行请求的次数。limitType代表限流的类型,可以根据请求的IP、自定义key,如果不传limitType属性则默认用方法名作为默认key。 /** * @author fu * @description 自定义限流注解 * @date 2020/4/8 13:15 */ @Target({ElementType.METHOD, ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) @Inherited @Documented public @interface Limit { /** * 名字 */ String name() default ""; /** * key */ String key() default ""; /** * Key的前缀 */ String prefix() default ""; /** * 给定的时间范围 单位(秒) */ int period(); /** * 一定时间内最多访问次数 */ int count(); /** * 限流的类型(用户自定义key 或者 请求ip) */ LimitType limitType() default LimitType.CUSTOMER; } 6、切面代码实现 /** * @author fu * @description 限流切面实现 * @date 2020/4/8 13:04 */ @Aspect @Configuration public class LimitInterceptor { private static final Logger logger = LoggerFactory.getLogger(LimitInterceptor.class); private static final String UNKNOWN = "unknown"; private final RedisTemplate<String, Serializable> limitRedisTemplate; @Autowired public LimitInterceptor(RedisTemplate<String, Serializable> limitRedisTemplate) { this.limitRedisTemplate = limitRedisTemplate; } /** * @param pjp * @author fu * @description 切面 * @date 2020/4/8 13:04 */ @Around("execution(public * *(..)) && @annotation(com.xiaofu.limit.api.Limit)") public Object interceptor(ProceedingJoinPoint pjp) { MethodSignature signature = (MethodSignature) pjp.getSignature(); Method method = signature.getMethod(); Limit limitAnnotation = method.getAnnotation(Limit.class); LimitType limitType = limitAnnotation.limitType(); String name = limitAnnotation.name(); String key; int limitPeriod = limitAnnotation.period(); int limitCount = limitAnnotation.count(); /** * 根据限流类型获取不同的key ,如果不传我们会以方法名作为key */ switch (limitType) { case IP: key = getIpAddress(); break; case CUSTOMER: key = limitAnnotation.key(); break; default: key = StringUtils.upperCase(method.getName()); } ImmutableList<String> keys = ImmutableList.of(StringUtils.join(limitAnnotation.prefix(), key)); try { String luaScript = buildLuaScript(); RedisScript<Number> redisScript = new DefaultRedisScript<>(luaScript, Number.class); Number count = limitRedisTemplate.execute(redisScript, keys, limitCount, limitPeriod); logger.info("Access try count is {} for name={} and key = {}", count, name, key); if (count != null && count.intValue() <= limitCount) { return pjp.proceed(); } else { throw new RuntimeException("You have been dragged into the blacklist"); } } catch (Throwable e) { if (e instanceof RuntimeException) { throw new RuntimeException(e.getLocalizedMessage()); } throw new RuntimeException("server exception"); } } /** * @author fu * @description 编写 redis Lua 限流脚本 * @date 2020/4/8 13:24 */ public String buildLuaScript() { StringBuilder lua = new StringBuilder(); lua.append("local c"); lua.append("\nc = redis.call('get',KEYS[1])"); // 调用不超过最大值,则直接返回 lua.append("\nif c and tonumber(c) > tonumber(ARGV[1]) then"); lua.append("\nreturn c;"); lua.append("\nend"); // 执行计算器自加 lua.append("\nc = redis.call('incr',KEYS[1])"); lua.append("\nif tonumber(c) == 1 then"); // 从第一次调用开始限流,设置对应键值的过期 lua.append("\nredis.call('expire',KEYS[1],ARGV[2])"); lua.append("\nend"); lua.append("\nreturn c;"); return lua.toString(); } /** * @author fu * @description 获取id地址 * @date 2020/4/8 13:24 */ public String getIpAddress() { HttpServletRequest request = ((ServletRequestAttributes) RequestContextHolder.getRequestAttributes()).getRequest(); String ip = request.getHeader("x-forwarded-for"); if (ip == null || ip.length() == 0 || UNKNOWN.equalsIgnoreCase(ip)) { ip = request.getHeader("Proxy-Client-IP"); } if (ip == null || ip.length() == 0 || UNKNOWN.equalsIgnoreCase(ip)) { ip = request.getHeader("WL-Proxy-Client-IP"); } if (ip == null || ip.length() == 0 || UNKNOWN.equalsIgnoreCase(ip)) { ip = request.getRemoteAddr(); } return ip; } } 7、控制层实现 我们将@Limit注解作用在需要进行限流的接口方法上,下边我们给方法设置@Limit注解,在10秒内只允许放行3个请求,这里为直观一点用AtomicInteger计数。 /** * @Author: fu * @Description: */ @RestController public class LimiterController { private static final AtomicInteger ATOMIC_INTEGER_1 = new AtomicInteger(); private static final AtomicInteger ATOMIC_INTEGER_2 = new AtomicInteger(); private static final AtomicInteger ATOMIC_INTEGER_3 = new AtomicInteger(); /** * @author fu * @description * @date 2020/4/8 13:42 */ @Limit(key = "limitTest", period = 10, count = 3) @GetMapping("/limitTest1") public int testLimiter1() { return ATOMIC_INTEGER_1.incrementAndGet(); } /** * @author fu * @description * @date 2020/4/8 13:42 */ @Limit(key = "customer_limit_test", period = 10, count = 3, limitType = LimitType.CUSTOMER) @GetMapping("/limitTest2") public int testLimiter2() { return ATOMIC_INTEGER_2.incrementAndGet(); } /** * @author fu * @description * @date 2020/4/8 13:42 */ @Limit(key = "ip_limit_test", period = 10, count = 3, limitType = LimitType.IP) @GetMapping("/limitTest3") public int testLimiter3() { return ATOMIC_INTEGER_3.incrementAndGet(); } } 8、测试 测试预期:连续请求3次均可以成功,第4次请求被拒绝。接下来看一下是不是我们预期的效果,请求地址:http://127.0.0.1:8080/limitTest1,用postman进行测试,有没有postman url直接贴浏览器也是一样。 可以看到第四次请求时,应用直接拒绝了请求,说明我们的 Springboot + aop + lua 限流方案搭建成功。 总结 以上 springboot + aop + Lua 限流实现是比较简单的,旨在让大家认识下什么是限流?如何做一个简单的限流功能,面试要知道这是个什么东西。上面虽然说了几种实现限流的方案,但选哪种还要结合具体的业务场景,不能为了用而用。 整理了几百本各类技术电子书,送给小伙伴们。关注公号回复【666】自行领取。和一些小伙伴们建了一个技术交流群,一起探讨技术、分享技术资料,旨在共同学习进步,如果感兴趣就加入我们吧! 无论你是刚入行、还是已经有几年经验的程序员,相信这份面试提纲都会给你不少助力,长按二维码关注 『 程序员内点事 』 ,回复 『 offer 』 自行领取,祝大家 offer 拿到手软

优秀的个人博客,低调大师

【最佳实践】Transforms数据透视让Elasticsearch数据更易分析

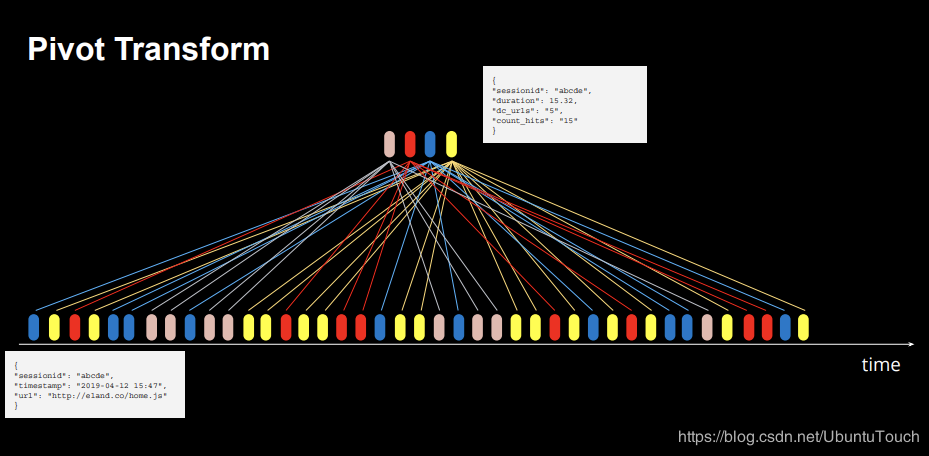
准备数据 在今天的练习中,我们将以 eCommerce 订单的样本例子来做练习。首先,准备阿里云elasticsearch 6.7 版本环境,并使用创建的账号密码登录Kibana,将数据导入到 Elasticsearch 中: 点击 Add data 按钮: 这样我们就完成了 eCommerce 数据的导入。如果您还不熟悉kibana_sample_data_ecommerce索引,请使用Kibana中的 Revenue仪表板浏览数据。 考虑一下你可能想从此电子商务数据中获得什么见解: 使用各种选项进行分组和汇总 透视数据涉及使用至少一个字段对其进行分组并应用至少一项聚合。 你可以预览转换后的数据,然后继续进行操作! 例如,你可能想按产品ID对数据进行分组,并计算每种产品的销售总数及其平均价格。 另外,你可能希望查看单个客户的行为,并计算每个

优秀的个人博客,低调大师

基于SLS+Blink的实时计算最佳实践

日志服务简介 阿里云的日志服务(SLS)是针对日志类数据的一站式服务,无需开发就能快捷完成海量日志数据的采集、消费、投递以及查询分析等功能,提升运维、运营效率。在采集端支持30多种写入方式,包括自研的客户端Logtail,开源软件如Logstash、Fluent,Flume,Beats等,各种语言的SDK/Producer,无论是嵌入式设备、网页、服务器、程序等都能轻松接入。在消费端,支持与Storm、Spark Streaming、Flink/Blink等大数据系统无缝对接。 阿里云实时计算(Blink) 阿里云实时计算是基于Apache Flink构建的一站式、高性能实时大数据处理平台,广泛适用于流式数据处理、离线数据处理等场景。阿里云实时计算提供了如下两种数据处理API: Flink SQL:通过DDL的方式定义Source和Sink,用SQL来实现数据的处理。 Flink Datastream: 在程序中使用各个Source和Sink的SDK,通过提交jar的方式运行托管的Flink Job。 通过这两种API,既可以把SLS作为数据源(Source),实现日志端到端的实时采集与处理,也可以把SLS作为结果的输出目标(Sink),在SLS对结果实时查询分析,配置可视化报表等。 Flink SQL Flink SQL是阿里云实时计算为了简化计算模型、降低用户使用实时计算门槛而设计的一套符合标准SQL语义的开发语言。 创建SLS源表 SLS源表对应SLS中的Logstore,表中的字段与Logstore中日志字段一一映射,像执行SQL一样流式处理SLS中的数据。除了Logstore所属的Region对应的Endpoint和Project之外,还需要具有读SLS Logstore权限的Access Key以及消费数据起始位置对应的时间点。 create table sls_stream( a INT, b INT, c VARCHAR ) with ( type ='sls', endPoint ='http://cn-hangzhou-share.log.aliyuncs.com', accessId ='<yourAccessId>', accessKey ='<yourAccessKey>', startTime = '2017-07-05 00:00:00', project ='<yourProjectName>', logStore ='<yourLogStoreName>', consumerGroup ='<yourConsumerGroupName>' ); Checkpoint SLS的底层存储Loghub,是一个类似Kafka的Append Only的存储系统,覆盖Kafka 100%的功能。与Kafka的partition类型,Logstore中的数据存储在每个Shard中。每个Shard都可以通过cursor或者时间戳,确定日志在Shard中的存储位置(对应Kafka中的Offset)。在消费过程中,为了支持程序重启时尽可能少的数据重复,需要将最新消费位置记录下来,用于进程重启之后继续消费。这个位置就是我们所说的checkpoint。目前,Flink SQL任务checkpoint保存在Flink的State中,如果任务Failover 或者暂停之后恢复,会从State中恢复消费位置继续消费。然而如果任务重启或者其他原因造成的State丢失,任务将从启动时指定的时间点开始消费。创建源表时建议指定参数consumerGroup,Blink将自动同步消费位置到SLS服务端,以用于在SLS控制台监控消费进度。注意:任务重启时不会使用SLS服务端的消费位置恢复。 创建SLS结果表 通过定义结果表,通过INSERT语句,把从源表中处理之后的数据写入到SLS的Logstore中。 create table sls_output( `name` VARCHAR, age BIGINT, birthday BIGINT )with( type='sls', endPoint='http://cn-hangzhou-corp.sls.aliyuncs.com', accessId='<yourAccessId>', accessKey='<yourAccessKey>', project='<yourProjectName>', logstore='<yourLogstoreName>' ); INSERT INTO sls_output SELECT age, birthday FROM source_table; Flink Datastream Flink SQL 的不足 Flink SQL已经能够实现许多场景下的数据处理需求,但是受限于SQL的表达能力,对于比较复杂的业务场景,SQL实现起来比较复杂。 对于DDL 的定义,需要指定固定的字段列表,对于日志场景而言,日志字段不固定的情况非常普遍,这就意味着很难提前定义好全部的字段。 在日志中,很多时候单个字段是JSON或者其他复杂的形式,如果要在SQL里面解析和处理这类字段,不如在程序中之间处理起来灵活。 对于这些场景,可以考虑使用Data Stream API,通过自定义程序,实现更复杂的业务逻辑。 Maven 依赖 SLS开发了一个与开源Flink集成的SDK,同样适用于Blink。 <dependency> <groupId>com.aliyun.openservices</groupId> <artifactId>flink-log-connector</artifactId> <version>0.1.19.1</version> </dependency> Github源码:https://github.com/aliyun/aliyun-log-flink-connector 消费SLS示例 public class ConsumerSample { private static final String SLS_ENDPOINT = ""; private static final String ACCESS_KEY_ID = ""; private static final String ACCESS_KEY_SECRET = ""; private static final String SLS_PROJECT = ""; private static final String SLS_LOGSTORE = ""; public static void main(String[] args) throws Exception { final ParameterTool params = ParameterTool.fromArgs(args); final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment(); env.getConfig().setGlobalJobParameters(params); env.setParallelism(1); env.enableCheckpointing(5000); env.getCheckpointConfig().setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE); env.getCheckpointConfig().enableExternalizedCheckpoints(CheckpointConfig.ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION); env.setStateBackend(new FsStateBackend("your checkpoint dir")); Properties configProps = new Properties(); configProps.put(ConfigConstants.LOG_ENDPOINT, SLS_ENDPOINT); configProps.put(ConfigConstants.LOG_ACCESSSKEYID, ACCESS_KEY_ID); configProps.put(ConfigConstants.LOG_ACCESSKEY, ACCESS_KEY_SECRET); configProps.put(ConfigConstants.LOG_MAX_NUMBER_PER_FETCH, "10"); configProps.put(ConfigConstants.LOG_CONSUMER_BEGIN_POSITION, Consts.LOG_FROM_CHECKPOINT); configProps.put(ConfigConstants.LOG_CONSUMERGROUP, "23_ots_sla_etl_product1"); configProps.put(ConfigConstants.LOG_CHECKPOINT_MODE, CheckpointMode.ON_CHECKPOINTS.name()); configProps.put(ConfigConstants.LOG_COMMIT_INTERVAL_MILLIS, "10000"); FastLogGroupDeserializer deserializer = new FastLogGroupDeserializer(); DataStream<FastLogGroupList> stream = env.addSource( new FlinkLogConsumer<>(SLS_PROJECT, SLS_LOGSTORE, deserializer, configProps)); stream.flatMap((FlatMapFunction<FastLogGroupList, String>) (value, out) -> { for (FastLogGroup logGroup : value.getLogGroups()) { int logCount = logGroup.getLogsCount(); for (int i = 0; i < logCount; i++) { FastLog log = logGroup.getLogs(i); // processing log } } }); stream.writeAsText("log-" + System.nanoTime()); env.execute("Flink consumer"); } } Checkpoint 与SQL类似,SDK也会把checkpoint保存到Flink State中,此外,还支持把Checkpoint同步到SLS服务端,这样当Flink本地的State无法恢复时,还能从服务端获取checkpoint,从而保证即便任务重启甚至重建,只要服务端的消费组没有删除,checkpoint就不会丢失。SDK同步checkpoint支持如下策略: 与Flink snapshotState同步,即在Flink调用snapshotState时,同步到服务端。默认是这种方式。 自动提交checkpoint,即定时提交checkpoint到服务端。好处是当Flink下游任务不支持exactly once时最大程度上避免数据重复。 不同步到SLS服务端。 处理结果写入SLS示例 public class ProducerSample { private static final String SLS_ENDPOINT = "cn-hangzhou.log.aliyuncs.com"; private static final String ACCESS_KEY_ID = ""; private static final String ACCESS_KEY = ""; private static final String SLS_PROJECT = ""; private static final String SLS_LOGSTORE = "test-flink-producer"; public static void main(String[] args) throws Exception { final ParameterTool params = ParameterTool.fromArgs(args); final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment(); env.getConfig().setGlobalJobParameters(params); env.setParallelism(3); DataStream<String> stream = env.addSource(new EventsGenerator()); Properties configProps = new Properties(); configProps.put(ConfigConstants.LOG_ENDPOINT, SLS_ENDPOINT); configProps.put(ConfigConstants.LOG_ACCESSSKEYID, ACCESS_KEY_ID); configProps.put(ConfigConstants.LOG_ACCESSKEY, ACCESS_KEY); configProps.put(ConfigConstants.LOG_PROJECT, SLS_PROJECT); configProps.put(ConfigConstants.LOG_LOGSTORE, SLS_LOGSTORE); FlinkLogProducer<String> logProducer = new FlinkLogProducer<>(new SimpleLogSerializer(), configProps); logProducer.setCustomPartitioner(new LogPartitioner<String>() { @Override public String getHashKey(String element) { String hash = ""; try { MessageDigest md = MessageDigest.getInstance("MD5"); md.update(element.getBytes()); hash = new BigInteger(1, md.digest()).toString(16); } catch (NoSuchAlgorithmException ignore) { } StringBuilder builder = new StringBuilder(); while (builder.length() < 32 - hash.length()) { builder.append("0"); } builder.append(hash); return builder.toString(); } }); stream.addSink(logProducer); env.execute("Flink producer"); } public static class EventsGenerator implements SourceFunction<String> { private volatile boolean running = true; @Override public void run(SourceContext<String> ctx) throws Exception { long seq = 0; while (running) { Thread.sleep(10); ctx.collect((seq++) + "-" + RandomStringUtils.randomAlphabetic(12)); } } @Override public void cancel() { running = false; } } } 任务监控 Metric监控 对于Flink SQL任务,Blink控制台提供了非常完备的监控报表,可以通过这些报表观察任务运行的状态,如延迟,内存状态,Failover等。Metric解释可以参考Blink作业运维相关文档:https://help.aliyun.com/document_detail/62482.html注意:SLS Datastream SDK暂时还没有实现Metric上报。 消费进度与监控报警 在SLS查看消费组对应的消费进度。SLS对于每个消费组会定时输出延迟日志,根据这个延迟日志结合SLS的告警,可以用于监控消费延迟。参考如何开通消费组日志:https://help.aliyun.com/document_detail/85663.html 任务日志采集 Blink支持把作业日志存储到SLS中,在作业编辑页面右侧的作业参数页面,配置Log4j appender: log4j.logger.org.apache.hadoop=OFF log4j.appender.loghub = com.alibaba.blink.log.loghub.BlinkLogHubAppender log4j.appender.loghub.Threshold = ERROR log4j.appender.loghub.projectName = <your SLS Project> log4j.appender.loghub.logstore = <your SLS Logstore> log4j.appender.loghub.endpoint = <your SLS Endpoint> log4j.appender.loghub.accessKeyId = <your Access Key ID> log4j.appender.loghub.accessKey = <your Access Key Secret> 常见问题 部分task没有读到数据 从SLS消费数据的本质就是从每个shard的指定位置开始消费,直到最新位置。然后单个shard不支持并发消费,也就是说一个shard最多被一个task消费到。而不管是SQL还是Data Stream,Shard分配的方式都是对shard本身的信息做hash,然后对task总数取模来分配的。假设某个shard hashcode是x,task 个数为y,当前task的id为z,那么仅当 x%y=z 时,当前task会消费这个shard。因此可能存在某个task没有分配到任何shard的情况。 消费太慢导致数据堆积 数据堆积的根本原因是写入速度超过了消费速度,而如何提高消费速度取决于具体的场景。常见的原因有: 下游处理节点慢导致source节点反压。这种情况可以通过观察Blink的反压状态是否是HIGH来确认,通过优化下游任务节点速度来解决。 Shard个数太少。当shard数量少于task个数时,无疑会造成部分task空跑的现象,此时增加task个数已经对总体的并发没有任何影响,此时可以尝试在SLS侧分裂shard个数解决。 消费组在多个作业之间没有产生分配shard的效果 Blink消费SLS的数据并没有使用消费组来实现均衡消费的效果,提供的消费组名称仅仅是用于在SLS服务端保存消费位点。如果需要类似Kafka 消费组的功能,应使用SLS的Consumer Library。参考文档https://help.aliyun.com/document_detail/28998.html Flink Datastream任务没有同步checkpoint到SLS服务端 检查Blink任务作业参数中的 blink.checkpoint.interval.ms 是否设置过大。 更多资料 Blink开发Datastream作业:https://help.aliyun.com/document_detail/111876.html定义SLS源表:https://help.aliyun.com/knowledge_detail/62521.html定义SLS结果表:https://help.aliyun.com/knowledge_detail/62529.html

优秀的个人博客,低调大师

springboot + aop的最佳实践,再也不怕双击666

唠唠叨叨 复工不到一个月疯狂的加班中,最近没什么时间写博客更文有点慢,好在做的项目中不全是增删改的业务逻辑,还是有一些比较有意思实用的技术点,所以整理出来分享给大家。和那些搞高端技术的大佬比不了,咱就是个还在一线搬砖的码农。 有没有遇到过这种情况:由于网速等原因,网页响应很慢,提交一次表单后发现服务久久没响应,然后你就疯狂点击提交按钮(12306就经常被这样怒怼),如果做过防重复提交还好,否则那是什么级别的灾难就不好说了。。。 今天主要是用 自定义注解、 AOP、· Guava 包中Cache来生成一种本地锁,来达到的防重复提交效果,整体的实现比较简单,没有什么太大的难度,代码也是比较少,,由于是基于内存的缓存,因此这种实现方式并不适用于分布式服务。旨在给大家介绍一种实现防重复提交的方案,要是有什么说的不对的地方大家温柔一点撕,毕竟人家还是个20出头30郎当岁的孩子。 Guava是什么? guava包是个啥?做过Java的小伙伴应该多少都有所了解,它是google “嫌弃” JAVA自带的类库不好用,自行研发的一套工具包,对JDK工具做了很好的拓展。例如:并发[Concurrency]、缓存[Caches]、 函数式风格[Functional idioms]、 字符串处理[Strings]等。 总之一句话guava包很好用多去了解下,能不造的轮子咱们就尽量不去造,因为咱们自己造的轮子可能不太圆。不多说废话了,来看看具体的实现。 代码撸起来 1、引入Guava包依赖 第一步引入Guava的依赖包没什么好说的 <dependency> <groupId>com.google.guava</groupId> <artifactId>guava</artifactId> <version>21.0</version> </dependency> 2、自定义注解 服务端实现防止重复提交,一般都是利用AOP自定义注解的的方式,作用于controller的入口方法。自定义一个LocalLock注解用于需要防止重复提交的方法上。 /** * 锁的注解 * */ @Target(ElementType.METHOD) @Retention(RetentionPolicy.RUNTIME) @Documented @Inherited public @interface LocalLock { /** * @author fly */ String key() default ""; } 注解定义好以后就需要做AOP拦截器切面的具体实现,在 interceptor() 方法上采用的是 Around(环绕增强) ,因此所有带 LocalLock 注解的都将被切面处理; @Around("execution(public * *(..)) && @annotation(com.chengxy.annotation.LocalLock)") 既然是缓存,那紧跟的属性一定要有过期时间,通过expireAfterWrite 设置缓存的过期时间,maximumSize设置缓存的个数。 通过在内存中查询key是否存在来判断是否让再次提交,和Redis的setNX方法是一个比较像。 这里我们设置同一个方法,5秒钟内相同参数的请求只允许执行一次。 那么这个注解该怎么用呢? @Aspect @Configuration public class LockMethodInterceptor { private static final Cache<String, Object> CACHES = CacheBuilder.newBuilder() // 最大缓存 100 个 .maximumSize(1000) // 设置写缓存后 5 秒钟过期 .expireAfterWrite(5, TimeUnit.SECONDS) .build(); @Around("execution(public * *(..)) && @annotation(com.chengxy.annotation.LocalLock)") public Object interceptor(ProceedingJoinPoint pjp) { MethodSignature signature = (MethodSignature) pjp.getSignature(); Method method = signature.getMethod(); LocalLock localLock = method.getAnnotation(LocalLock.class); String key = getKey(localLock.key(), pjp.getArgs()); if (!StringUtils.isEmpty(key)) { if (CACHES.getIfPresent(key) != null) { throw new RuntimeException("请勿重复请求"); } // 如果是第一次请求,就将 key 当前对象压入缓存中 CACHES.put(key, key); } try { return pjp.proceed(); } catch (Throwable throwable) { throw new RuntimeException("服务器异常"); } finally { // TODO 为了演示效果,这里就不调用 CACHES.invalidate(key); 代码了 } } /** * key 的生成策略,如果想灵活可以写成接口与实现类的方式(TODO 后续讲解) * * @param keyExpress 表达式 * @param args 参数 * @return 生成的key */ private String getKey(String keyExpress, Object[] args) { for (int i = 0; i < args.length; i++) { keyExpress = keyExpress.replace("arg[" + i + "]", args[i].toString()); } return keyExpress; } } 3、控制层的实现 我们将注解加在控制层方法上,key = "city:arg[0] key自己定义,arg[0]这个匹配规则表示替换成第一个参数。那么就实现city:token在一定时间内不可以重复提交了 @RestController @RequestMapping("/city") public class BookController { @LocalLock(key = "city:arg[0]") @GetMapping public String query(@RequestParam String token) { return "ok- " + token; } } 4、测试 接下来我们就测试一下,预期结果:5秒内只有第一次的提交会正常返回,其余的显示“请勿重复提交”,看看执行结果是不是我们预期的那样,这里用postman测试。 第一次请求正常响应: 紧接着请求第二次,返回结果“重复提交”,显然我们实现成功了 小福利: 获取到一些极客课程 ,嘘~,免费 送给小伙伴们。公号【程序员内点事】回复【极客】自行领取

优秀的个人博客,低调大师

HBase TB级数据规模不停机迁移最佳实践

背景 有关HBase集群如何做不停服的数据迁移一直都是云HBase被问的比较多的一个问题,目前有许多开源的工具或者HBase本身集成的方案在性能、稳定性、使用体验上都不是很好,因此阿里云提供了BDS迁移服务,可以帮助云上客户实现TB级数据规模不停机迁移 支持场景 HBase大版本升级, 1.x升级2.x 集群配置升级,8核16G升级为16核32G 集群网络环境变更,经典网络迁移到VPC 异地跨机房迁移 HBase业务拆分 方案介绍 开源方案 HBase不停机迁移主要包括三个部分:表结构的迁移、实时数据同步、历史全量数据迁移 表结构迁移 对于表结构迁移来说,开源的DataX还是HBase本身都不提供表结构迁移的功能,只能进行手动建表,手动建表会存在几个问题: 如果源集群表数据较多,客户手动建表比较麻烦 手动建表可能忽略表分区,导致目标表分区很不合理,迁移完之后

优秀的个人博客,低调大师

阿里云文件存储NAS开发测试环境最佳实践

软件开发过程中,开发成员经常需要把自己工作集成到项目中,通常每个成员每天至少集成一次。如果项目较小,对外部的依赖较小,那么软件集成可能不会是什么问题。但是目前很多软件项目特别是互联网项目面临着需求不明确,系统架构复杂,任务分配混乱等一系列问题,从而给持续集成带来许多麻烦。也给整个项目带来不必要的风险。持续集成作为敏捷开发重要的一步,其目的在于让产品快速迭代的同时,尽可能保持高质量。每一次代码更新,都要通过自动化测试来检测代码和功能的正确性,只有通过自动测试的代码才能进行后续的交付和部署。本文主要介绍如何将时下最流行的持续集成工具之一的Jenkins结合阿里云容器服务,实现自动测试和镜像构建推送。 接下来的演示是如何通过阿里云容器服务Jenkins实现自动测试和Docker镜像构建,实现高质量的持续集成。具体场景:每次代码提交到Git

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册