首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

VPC最佳实践(四):VPC中的访问控制

阿里云的专有网络目前没有网络的ACL,当前在专有网络中进行访问控制,依赖各个云产品的访问控制能力。在此为介绍云服务器 ECS 、云数据库 RDS 、负载均衡的访问控制功能。 ECS——安全组 安全组是一种虚拟防火墙,具备状态检测包过滤功能。安全组用于设置单台或多台云服务器的网络访问控制,它是重要的网络安全隔离手段,用于在云端划分安全域。 安全组是一个逻辑上的分组,这个分组是由同一个地域(Region)内具有相同安全保护需求并相互信任的实例组成。每个实例至少属于一个安全组,在创建的时候就需要指定。同一安全组内的实例之间网络互通,不同安全组的实例之间默认内网不通。可以授权两个安全组之间互访。 一个 VPC 类型的 ECS 实例只能加入本 VPC 的安全组。您可以随时授权和取消安全组规则。您的变更安全组规则会自动应用于与安全组相关联的EC
优秀的个人博客,低调大师

PgSQL · 应用案例 · "写入、共享、存储、计算" 最佳实践

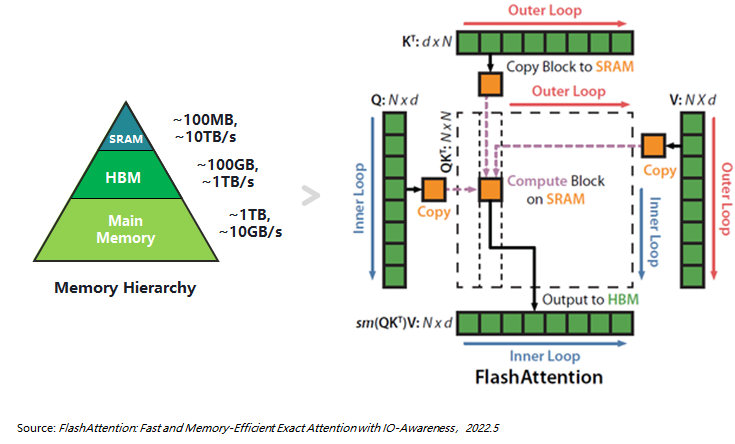
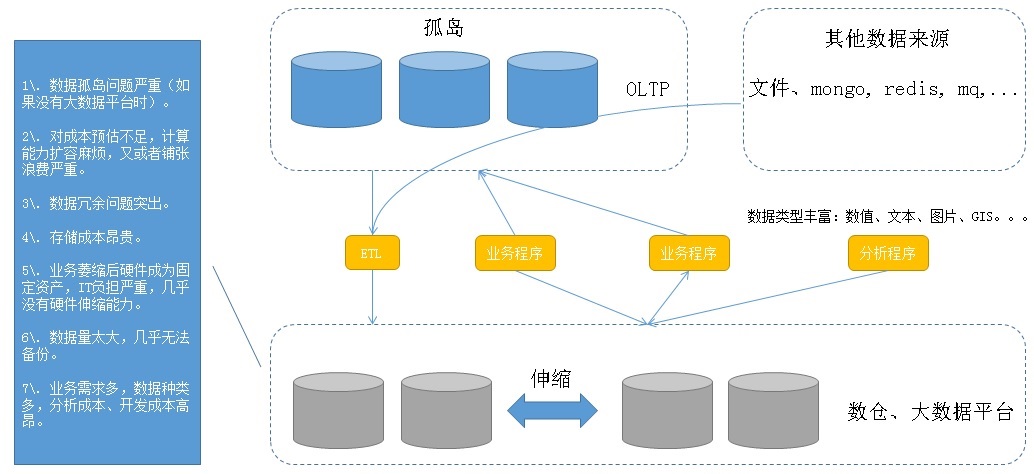
背景 数据是为业务服务的,业务方为了更加透彻的掌握业务本身或者使用该业务的群体,往往会收集,或者让应用埋点,收集更多的日志。 随着用户量、用户活跃度的增长,时间的积累等,数据产生的速度越来越快,数据堆积的量越来越大,数据的维度越来越多,数据类型越来越多,数据孤岛也越来越多。 日积月累,给企业IT带来诸多负担,IT成本不断增加,收益确不见得有多高。 上图描绘了企业中可能存在的问题: 1. 数据孤岛问题严重(如果没有大数据平台时)。 2. 对成本预估不足,计算能力扩容麻烦,又或者铺张浪费严重。 3. 数据冗余问题突出。 4. 存储成本昂贵。 5. 业务萎缩后硬件成为固定资产,IT负担严重,几乎没有硬件伸缩能力。 6. 数据量太大,几乎无法备份。 7. 业务需求多,数据种类多,分析成本、开发成本高昂。 本文将针对这个场景,给出一个比较合理的方案,灵活使用,可以

优秀的个人博客,低调大师

行为、审计日志 (实时索引/实时搜索) - 最佳实践

标签 PostgreSQL , ES , 搜索引擎 , 全文检索 , 日志分析 , 倒排索引 , 优化 , 分区 , 分片 , 审计日志 , 行为日志 背景 在很多系统中会记录用户的行为日志,行为日志包括浏览行为、社交行为、操作行为等。 典型的应用例如:数据库的SQL审计、企业内部的堡垒机(行为审计)等。 行为、审计日志的量与业务量或者操作量有关,为了满足企业实时查询的需求,通常需要构建搜索引擎,比如使用ES或者使用PostgreSQL的全文检索功能来实现。 如果使用PostgreSQL来构建,有几个优势,可以满足多个需求: 1. 明细存储的需求,除了需要建立索引的字段,明细字段也可以存储在PostgreSQL中。 2. 索引的需求,即建立日志行为字段的全文索引。 3. 多维度索引的需求,除了日志行为字段的索引,还可以建立其他字段的索引,例如时间维

优秀的个人博客,低调大师

最佳实践:基于Apache SeaTunnel从MySQL同步到PostgreSQL

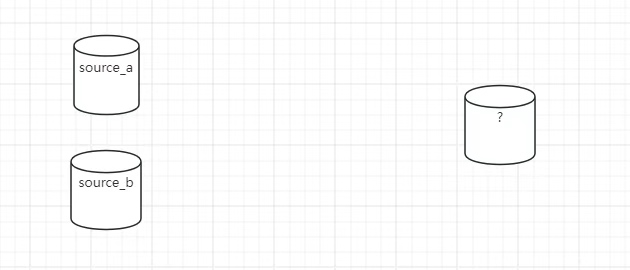
作者 | 陈飞 中付支付大数据工程师 今天和大家分享一个 简单但常见的 MySQL 到 MySQL 数据同步与合并场景案例,这个案例也是我在实际工作中遇到的问题,希望能抛砖引玉,欢迎有更丰富经验的大佬一起分享交流。 版本要求:Apache SeaTunnel --> Apache SeaTunnel-2.3.9 场景描述 在我们的业务系统中,存在两个 MySQL 源库: source_a source_b 这两个库中存在一张表结构相同的表,但数据来自不同的业务线,两边都会同时产生数据,因此存在 主键重复 的问题。 我们的目标是将这两个源库的表数据 合并同步到一个目标库(我们称为 C 库),以便于统一分析和查询。 面临的挑战 两个源库的表结构虽然一致,但主键重复,需要避免冲突 后续可能存在字段不一致或字段新增的需求 同步过程需尽量实时,且不能产生重复数据 解决方案 我们采用了如下方式来实现这个同步与合并的方案: 在 C 库新建目标表: 表结构需要覆盖两个源表的所有字段(当前一致,未来可能扩展) 增加一个额外的字段:data_source,用于标识数据来源(source_a 或 source_b) 不可为空的字段需要有默认值 设置联合主键与唯一约束 使用 原主键 + data_source 作为联合主键,确保不会因为两个源的主键重复而导致冲突 使用两个 Seatunnel 进程进行数据同步**: 分别使用 MySQL CDC 连接器 监听 source_a 与 source_b 在每条数据中打上来源标识字段 data_source 使用 JDBC Sink 写入到 C 库 实战演示 下面我们直接进入实战环节,关于 SeaTunnel 的基础知识,这里就不再赘述,上一期的大佬已经讲得非常清楚了,我们直接进入正题。 使用 MySQL CDC 前的准备工作 要使用 mysql-cdc 连接器,有两个必要的前置条件: MySQL 源库需开启 Binlog 日志 binlog_format 必须设置为 ROW binlog_row_image 设置为 FULL-- 检查当前配置 SHOWVARIABLESLIKE'binlog_format'; SHOWVARIABLESLIKE'binlog_row_image'; -- 如果未开启,可在 my.cnf 文件中添加以下配置: [mysqld] server-id = 1 log-bin = mysql-bin binlog-format = ROW binlog-row-image = FULL 以上权限说明及设置方式可以参考官网文档,文档中提供了详细的权限说明与示例,建议大家同步查阅。 准备拥有复制权限的账号 -- 创建同步账号 CREATE USER 'cdc_user'@'%' IDENTIFIED BY 'your_password'; -- 授予必要权限 GRANT SELECT, RELOAD, SHOW DATABASES, REPLICATION SLAVE, REPLICATION CLIENT ON *.* TO 'cdc_user'@'%'; FLUSH PRIVILEGES; 准备 SeaTunnel 运行包与插件 方式一:下载官方二进制包 适合 服务器可访问外网 且 无需复杂定制 的场景。 下载地址:官方 Releases 页面 需要手动添加插件及插件驱动(如 mysql-cdc, jdbc) 插件安装说明可参考官方文档:插件管理 wget "https://archive.apache.org/dist/seatunnel/${version}/apache-seatunnel-${version}-bin.tar.gz" config/plugin_config保留需要的插件 bin/install-plugin.sh 方式二:从 GitHub 克隆源码自行编译 适合对插件有特殊需求或希望获得完整插件支持的用户。 sh ./mvnw clean install -DskipTests -Dskip.spotless=true seatunnel-dist/target/apache-seatunnel-2.3.9-bin.tar.gz 自行编译后生成的包中默认已集成所有插件及对应依赖,无需额外操作。 本案例使用的插件: mysql-cdc jdbc 插件说明与驱动依赖也可参考对应的文档! Apache SeaTunnel 部署方式简介 SeaTunnel 支持多种部署方式: 使用 Seatunnel 自带引擎(Zeta) 作为 Spark / Flink 作业运行 使用 Zeta 引擎时的三种模式: 配置文件结构说明 集群搭建完成后,我们开始准备配置文件。 一般情况下,SeaTunnel 的配置文件可以分为以下四个部分: Env:引擎相关配置 Source:源数据读取配置 Transform:数据转换信息(可选) Sink:写出目标库的配置 Env引擎配置 parallelism:并行度,表示任务运行的并发度,数值越大越快,具体要结合资源情况设置。 job.mode:作业运行模式。由于我们使用的是 mysql-cdc 插件,因此必须设置为 Streaming 模式。 checkpoint.interval:检查点间隔,Streaming 模式下默认是 30 秒一次,可以根据需要调整。 Source数据源配置(MySQL CDC) 使用的插件是 mysql-cdc,需要配置以下内容: 连接信息:包括数据库地址、用户名、密码等。 库名与表名:可以通过 database-names 和 table-names 显式指定,也可以使用正则表达式模糊匹配。 startup.mode:CDC 的启动模式,默认为“先全量后增量”,适合大多数同步场景。如需了解其他启动模式的区别,可以参考官方文档。 server-id:MySQL 的 CDC 读取服务 ID,虽然可以不写,但建议明确指定,防止与已有的从库 ID 冲突。 MySQL 配置建议:在使用 mysql-cdc 前,需要确保 binlog 功能已开启; binlog-format 设置为 ROW; binlog-row-image 设置为 FULL; MySQL 账号需具备读取 binlog、主从复制、查询所有表等权限。 Transform数据转换配置(可选) 在本案例中,我们需要给每条数据添加一个字段,用于标识数据来源,例如:data_source 字段,值可以是 source_a 或 source_b。 这个转换过程使用 sql 插件实现,通过添加常量字段的方式,将数据来源信息加到每条数据中。 需要注意: 每个源表可以单独指定转换规则; source_table 是保留字,表示上一个处理环节中的表名。 Sink写入配置 Sink 使用的是 jdbc 插件,配置项主要包括: 目标库地址、驱动、用户名、密码等连接信息; 根据目标表结构生成写入 SQL; 如果字段或结构不一致,可以自定义写入语句以匹配表结构。 小结 以上配置组合完成后,我们就可以实现从多个源库(如 source_a 和 source_b)实时同步数据到目标库的需求。在同步的同时,我们还增强了字段,使数据能够被标识来源并统一写入。整个流程既支持复杂数据结构,又能灵活适配业务场景,是一个适合实际生产的数据集成案例。 Sink 写入优化与效果验证 在配置 Sink 时,我们还可以做一些写入性能方面的优化: 批量写入策略 批量大小 和 写入间隔:满足任意一个条件就会触发写入操作。 关键配置参数说明 schema_save_mode:结构保存策略如果结构已存在则忽略; 如果不存在,则根据上一个环节的输出结构自动创建。 data_save_mode:数据保存策略 这里我们选择的是 追加(append) 模式。 support_upsert_by_query_primary_key_exist:是否支持根据主键做 Upsert 本次开启了该功能,用于支持主键冲突时的更新。 primary_keys:指定写入数据的主键 这里必须指定,包括原表的主键和我们 transform 阶段新增的 data_source 字段。 提交任务 ./seatunnel.sh --config ../config/demo/collect_a.config -e cluster --cluster sz-seatunnel --name collect_a --async ./seatunnel.sh --config ../config/demo/collect_b.config -e cluster --cluster sz-seatunnel --name collect_b --async --config:指定配置文件 -e:运行模式 cluster/local --cluster:集群名称,部署集群时配置,默认是seatunnel --name:任务名称 --async:后台运行 实际运行效果验证 到这里,配置部分就全部完成了。接下来我们来看下实际运行的效果: 当前有 a 表和 b 表,c 表为空。 先运行 a 的同步进程。 查看 c 表,已经写入了 a 表的数据,且 data_source 字段为 source_a。 接着运行 b 的同步进程。 再查看 c 表,写入了 b 表的数据,data_source 字段为 source_b。 修改一下 a 表的数据。 因为我们设置了批量写入策略,这里等个两秒,再去看 c 表。 对应的数据已更新,符合预期。 到这里整个数据同步和合并的流程就全部完成啦!非常感谢大家的聆听 🙏,希望这个案例能为大家提供一些思路,也欢迎大家分享自己在 Apache SeaTunnel 使用中的更多经验,我们一起交流学习!

优秀的个人博客,低调大师

基于 Zadig + Ingress 实现单应用灰度发布最佳实践

在当前激烈的软件开发竞争中,工程师们面临着众多挑战,其中最为关键的是如何在发布过程中确保稳定性、可靠性以及高效性。为了解决这一问题,企业通常会根据业务架构和应用场景综合选择适用的发布策略。在我们之前的文章「基于 Istio + Zadig,零负担实现云原生全链路灰度发布」中,Zadig 为微服务架构提供了通用的全链路灰度发布方案。然而,在实际场景中,仍有许多业务处于单体架构或单应用发布阶段。因此,Zadig 结合 Ingress 提供了专为单应用生产发布场景设计的安全保障方案。 本文将详细介绍如何结合 Zadig 和 Ingress 实现生产稳定发布的基本原理,并通过实际案例演示在 Zadig 中的具体操作。 基本原理 说明:生产版本和新版本(蓝环境)在 Zadig 同一个生产环境中管理。 工作原理: 1. 部署蓝环境:复制当前 workload,设置新镜像,并创建一个 blue service 指向它。 2. 切换部分生产流量到蓝环境:在原来 ingress 基础上创建一个相同 Host 的 ingress-blue ,service 指向 blue service,并且开启 nginx.ingress.kubernetes.io/canary: "true",并按实际情况修改权重配置 nginx.ingress.kubernetes.io/canary-weight:20。 3. 蓝绿发布:将生产使用的 workload 镜像设置为新镜像。 4. 切断蓝环境流量:修改 ingress-blue 配置 nginx.ingress.kubernetes.io/canary: "false"。 5. 蓝绿清理:工作流执行完成后,无论最终为何种状态,删除 blue service、blue workload 。 下面将详细介绍如何在 Zadig 中结合 Ingress 实现安全、稳定、高效的生产发布。 项目准备 创建项目 创建项目,配置生产服务a、b、c。本示例源码和服务 YAML 配置参考项目。 在 a 服务 YAML 配置上添加 ingress 配置: apiVersion: networking.k8s.io/v1 kind: Ingress metadata: name: a-ingress annotations: nginx.ingress.kubernetes.io/rewrite-target: / spec: ingressClassName: koderover rules: - host: a-prod.edu.koderover.com http: paths: - path: / pathType: Prefix backend: service: name: a port: number: 8080 配置环境 1. 创建生产环境 prod > 管理服务 > 添加服务,选择 a、b、c。 2. 添加 ingress-blue ,为生产发布配置做准备。 在 a 服务 ingress-blue 配置如下: apiVersion: networking.k8s.io/v1 kind: Ingress metadata: name: a-ingress-blue annotations: nginx.ingress.kubernetes.io/rewrite-target: / nginx.ingress.kubernetes.io/canary: "false" nginx.ingress.kubernetes.io/canary-weight: "0" spec: ingressClassName: koderover rules: - host: a-prod.edu.koderover.com #此处和 a 服务 ingress 配置中使用的 host 保持一致 http: paths: - path: / pathType: Prefix backend: service: name: a-blue #指向 a 服务新版本的 service port: number: 8080 配置工作流 新建工作流 > 选择 「蓝绿发布」模板 > 配置工作流,工作流包含步骤和具体配置如下: 选择模板 工作流配置 1. 部署蓝绿环境:使用「部署蓝绿环境」任务,添加 服务 a。 部署蓝环境配置 2. 导 50 流量: 使用「更新 K8s YAML 任务」,选择 ingress-blue 配置,并设置 nginx.ingress.kubernetes.io/canary: "true",nginx.ingress.kubernetes.io/canary-weight: "50"。 导 50 流量配置 3. 检查新版本: 使用「通用任务」或者「测试」任务来配置对应的检查脚本,针对新版本进行自动化测试。 4. 审批:在生产升级阶段上开启「人工审批」,来保证发布的可靠性。 审批配置 5. 生产升级:使用「蓝绿发布」任务,注意配置中前置「部署蓝绿环境」任务需要正确选择。 生产升级配置 6. 切断流量:使用「更新 K8s YAML 任务」,选择 ingress-blue 配置,并设置nginx.ingress.kubernetes.io/canary: "false",nginx.ingress.kubernetes.io/canary-weight: "0"。 切断流量配置 执行生产发布 执行工作流 按照以下配置执行工作流: · 部署蓝环境:服务组件选择 myapp-1(a),以及选择需要发布的镜像 · 导 50 流量:选择 ingress-blue 资源 · 切断流量:选择 ingress-blue 资源 执行工作流 审批状态 工作流运行至待审批状态时,已完成自动部署蓝环境、导入 50% 流量到新版本中、对生产环境自动化测试验证三个操作。下面结合 Zadig 环境能力来验证流量走向是否符合预期。 效果验证 在发布过程中,服务 a 存在两组 deployment 和 service,分别为生产版本和新版本,此时,预期 50% 流量进入生产版本,50% 流量进入新版本。 发布过程中的服务情况 发布过程中 service 情况 执行以下请求,查看服务日志以验证流量分配结果。 for i in $(seq 1 100); do curl -X PUT http://a-prod.edu.koderover.com/api/v1/count; done 请求分别进入服务 a 生产版本和新版本的数量: 进入生产版本的请求数量 进入新版本的请求数量 人工审批通过后,工作流自动更新生产环境镜像,并将流量全部切回生产,最后清理所有临时资源。 生产版本升级完成 流量全部进入生产版本 至此,一次完整的生产发布已经完成。在实际使用过程中,可以结合监控数据在人工审批阶段控制新版本上线的时间,以确保在使用低峰时段进行生产发布,减少上线过程对用户的影响。 Zadig,让工程师更加专注创造 阅读原文/Zadig 在 Github/Zadig 在 Gitee 推荐阅读 : 200 小时深度体验分析,DevOps 选型重磅发布/Zadig vs. Jenkins 详细比对:时代的选择与开发者之选/基于 Istio + Zadig,零负担实现云原生全链路灰度发布/探索 Zadig 自测模式,一套环境多人协同,释开发者创造力!/ZADIG 专家版倾情上线:一键高效发布,119元/人月起,社区老友享年终福利!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册