首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

《Greenplum5.0 最佳实践》 访问HDFS存储 (七)

访问Hadoop集群中数据用到的工具有 外部表 external tables 和 gphdfs 协议, Greenplum 可以从 HDFS 上读取文件也可以向 HDFS 写文件。为了达到更快的性能,所有的段数据库是并行地读取 HDFS 中的数据。当Hadoop集群采用的是 Kerbes 实现集群中各个节点的认证的,以确保集群数据不被恶意攻击。那么 Greenplum 必须使用的用户为 gpadmin, 该用户拥有对外部表的读写权限在HDFS中,需要通过 Kerbes 的授权。为了实现对 gpadmin 的授权,需要验证和故障排除配置。(关于kerbes的信息参看参考文献) 前期准备工作 确保功能正常和网络正常 Greenplum 数据库集群 有 Kerberos-Hadoop 集群 (具体配置参考 Greenplum Database Release Notes for supported Hadoop version 都支持那些版本的HDFS ) Kerberos 秘钥服务 配置 Greenplum集群 Greenplum 必须安装 JRE, Hadoop 客户端文件, Kerberos 客户端文件。按照下面的顺序准备安装 在GPDB的所有节点上都安装相同版本的 JAVA 1.6 或者之后的版本。最好和 Hadoop 集群中配置的 JAVA环境一致。 使用命令为 java --version (可选项) 确认存在 Java 加密扩展 (Java Cryptography Extension JCE). 默认情况下该扩展包在 JAVA_HOME/lib/security 下。 如果安装的是 JDK, 那么其所在的文件路径为 JAVA_HOME/jre/lib/security, 这个文件有 local_policy.jar 和US_eport_policy.jar 。需要注意的是 Greenplum 和 Kerberos 都应该使用的相同的 JCE 版本。 在 .bashrc 或者 .bash_profile 中配置 JAVA_HOME 环境变量。 export JAVA_HOME=/usr/java/jd../ 执行如下代码使得环境变量生效source .bashrc source .bash_profile 安装 Kerberos 客户端, 在所有的Greenplum节点上。确保这个安装文件要和已有的 KDC 版本匹配 在centos 上执行如下命令: $ sudo yum -y install krb5-libs krb5-workstation $ kinit ## 用来确定是否安装成功 对Greenplum中的全部节点都安装 Hadoop 客户端, 参考 Hadoop 发行版相关的文件。 针对 Hadoop 设置Greenplum集群的参数配置。 版本为 gp_hadoop_target_version 参数用来确定 Hadoop 的版本。 gp_hadoop_home 确定Hadoop的安装路径 具体参考文章 《 Greenplum Database Release Notes 》 《Greenplum Database Reference Guide》 $ gpconfig -c gp_hadoop_target_version -v "hdp2" $ gpconfig -c gp_hadoop_home -v "/usr/lib/hadoop" 重新加载 Greenplum 的配置问价 postgresql.conf $ gpstop -u --- 使用如下命令确认参数的修改 $ gpconfig -s gp_hadoop_version $ gpconfig -s gp_hadoop_home </code></pre> 授权 Greenplum的角色可以在HDFS中拥有自己的可读写外部表, 包括的用户有 gpadmin 和 其他超级用户。 授权 SELECT 权限能够在 HDFS 上创建爱你可读外部表, 授权 *INSERT* 权限可以去写外部表在 *HDFS* 上 <pre><code> #= GRANT SELECT ON PROTOCOL gphdfs TO gpadmin; #= GRANT INSERT ON PROTOCOL gphdfs TO gpamdin; </code></pre> 将 Greenplum 数据库外部表权限授予外部表所有者角色。 <pre><code> #= ALTER ROLE HDFS_USER CREATEEXTTABLE (type='readable'); #= ALTER ROLE HDFS_USER CREATEEXTTABLE (type='writable'); </code></pre> 创建和安装秘钥文件 按照如下顺序执行 使用 root 用户登录到 KDC 服务器上 使用 kadmin.local 命令为 gpadmin 创建新的代理 <pre><code> # kadmin.local -q "addprinc -randkey gpadmin@LOCAL.DOMAIN" </code></pre> 使用 kadmin.local 创建为Greenplum集群的每一个节点创建一个 Kerberos 服务代理, 这个代理的名字应该是 name|role@REALM 格式,解释如下 *name* 是 *gphdfs* 服务的名称,默认情况下使用 *gphdfs* *role* 是 *Greenplum* 集群主机的 DNS 可解析的主机名称( hostname -f 命令) *REALM* 是 *Kerberos* 的realm, 例如 *LOCAL.DOMAIN* 例子如下,下面这些明亮用来向Greenplum数据库集群中的四个节点 (mdw.exam[ple.com smdw.example.com sdw1.example.com sdw2.example.com) <pre><code> # kadmin.local -q "addprinc -randkey6 gphdfs/mdw.example.com@LOCAL.DOMAIN" # kadmin.local -q "addprinc -randkey6 gphdfs/smdw.example.com@LOCAL.DOMAIN" # kadmin.local -q "addprinc -randkey6 gphdfs/smdw1.example.com@LOCAL.DOMAIN" # kadmin.local -q "addprinc -randkey6 gphdfs/smdw2.example.com@LOCAL.DOMAIN" 创建代理为每一个主机,使用相同的代理和realm,用每个主机的完整名称限定替换 位每个节点创建代理(gpadmin 和 gphdfs 服务代理)。 存储秘钥在一个方便的文件位置(例如:/etc/security/keytabs)。也可以将秘钥在稍后的时间内部署到各自的主机上。 <pre><code> # kadmin.local -q "xst -k /etc/security/keytabs/gphdfs.service.keytab gpadmin@LOCAL.DOMAIN" # kadmin.local -q "xst -k /etc/security/keytabs/mdw.service.keytrab gpadmin/mdw gphdfs/mdw.example.com@LOCAL.DOMAIN" # kadmin.local -q "xst -k /etc/security/keytabs//smdw.service.keytrab gpadmin/smdw gphdfs/smdw.example.com@LOCAL.DOMAIN" # kadmin.local -q "xst -k /etc/security/keytabs//smdw1.service.keytrab gpadmin/smdw1 gphdfs/smdw1.example.com@LOCAL.DOMAIN" # kadmin.local -q "xst -k /etc/security/keytabs//smdw1.service.keytrab gpadmin/smdw1 gphdfs/smdw2.example.com@LOCAL.DOMAIN" </code></pre> 修改 gphdfs.service.keytab 的访问者权限 # chown gpadmin:gpadmin /etc/security/keytabs/gphdfs.service.keytab # chmod 440 /etc/security/keytabs/gphdfs.service.keytab 复制秘钥文件到 gpadmin@LOCAL.DOMAIN 到GPDB的master节点上 # scp /etc/security/keytabs/gphdfs.service.keytab mdw_fqdn:/home/gpadmin/gphdfs.service.keytab 将对应的秘钥文件发送到对应的GPDB节点上 # scp /etc/security/keytabs/mdw.service.keytab mdw_fqdn:/home/gpadmin/mdw.service.keytab # scp /etc/security/keytabs/smdw.service.keytab smdw_fqdn:/home/gpadmin/smdw.service.keytab # scp /etc/security/keytabs/smdw1.service.keytab smdw1_fqdn:/home/gpadmin/smdw1.service.keytab # scp /etc/security/keytabs/smdw2.service.keytab smdw2_fqdn:/home/gpadmin/smdw2.service.keytab 为 Kerberos 配置 gphdfs 编辑Hadoop 的 core-site.xml 客户端配置文件在Greenplum中的所有的节点上。设置服务层的授权,使用的是 hadoop.security.authorization 参数为 true <property> <name>hadoop.serurity.authorization</name> <value>true</value> </preperty> 编辑集群的所有节点的 yarn-site.xml 客户端配置文件。设置资源管理器地址和yarn的kerberos 服务代理 <pre><code> <name>yarn.resourcemanger.address</name> <value>hostname:8032</value> <name>yarn.resourcemanger.principal</name> <value>yarn/hostname@DOMAIN</value> 编辑文件 hdfs-site.xml 客户端配置文件在全部的集群节点上。设置 NameNode 的代理, Kerberos 的秘钥文件dfs.namenode.kerberos.principal gphdfs 的协议代理,将会被 NameNode 使用。 dfs.namenode.https.principal 将会被 NameNode 的 安全 HTTP 协议使用 com.emc.greenplum.gpdb.hdfsconnector.serurity.user.keytab.file 对于 Kerberos HDFS 服务的秘钥文件路径, 例如路径是 /home/gpamdin/mdw.service.keytab ...com.emc.greenplum.gpdb.hdfsconnector.security.user.name gphdfs 代理的节点。 <name>dfs.namenode.kerberos.principal</name> <value>gphdfs/gpadmin@LOCAL.DOMAIN</value> <name>dfs.namenode.https.principal</name> <value>gphdfs/gpadmin@LOCAL.DOMAIN</value> <name>com.emc.greenplum.gpdb.hdfsconnector.security.user.keytab.file</name> <value>/home/gpadmin/gpadmin.hdfs.keytab</value> <name>com.emc.greenplum.gpdb.hdfsconnector.security.user.name</name> <value>gpadmin/@LOCAL.DOMAIN</value> 使用Greenplum去访问HDFS 确保 Greenplum 的所有节点可以通过 Kerberos 访问HDFS。在HDFS文件路径下,执行如下的命令 hdfs dfs -ls hdfs://namenode:8020 在HDFS上创建可读的外部表 按照如下步骤在Hadoop上创建可读外部表 创建一个逗号分隔符的文件, test1.txt 包含如下内容 25, Bill19,Anne32,Greg27,Gloria 将这个实例文件保存到HDFS中 hdfs dfs -put test1.txt hdfs://namenode:8020/tmp 登录到Greenplum数据库集群中,创建一个可以读的外部表,并将该外部表指向Hadoop路径 CREATE EXTERNAL TABLE test_hdfs (age int, name text) LOCATION ('gphdfs://namenode:8020/tmp/test1.txt')FORMAT 'text' (delimiter ','); 读取外部表的数据 SELECT * FROM test_hdfs; 在HDFS上创建可以写的外部表 创建可以写的外部表同样按照下面的步骤执行。 登录Greenplum数据库集群,创建一个指向HDFS上文件的外部表 test_hdfs2 CREATE WRITABLE EXTERNAL TABLE test_hdfs2 (like test_hdfs)LOCATION ('gphdfs://namenode:8020/tmp/test2.txt' )FORMAT 'text' (DELIMITER ','); 向外部表中写入数据 INSERT INTO test_hdfs2 SELECT * FROM test_hdfs; 检查新创建的外部表的文件是否在HDFS中 hdfs dfs -ls hdfs://namenode:8020/tmp/test2.txt 确认外部表文件中的内容 hdfs dfs -cat hdfs://namenode:8020/tmp/test2.txt 异常处理部分 强制环境变量 (Forcing Classpath) 当执行 SELECT 语句查询外部表数据的时候,如果遇到 "class not found" 错误。需要去编辑 $GPHOME/lib/hadoop-env.sh 文件。同时在文件的后面追加如下信息,且在 JAVA_LIBRARY_PATH设置之前。更新该文件 if [-d "/usr/hdp/current"]; thenfor f in /usr/hdp/current/*/.jar; do CLASSPATH=${CLASSPATH}:$f;donefi 允许 Kerberos 客户端可以Debug Messages 从Kerberos看到debug信息, 编辑 $GPHOME/lib/hadoop-env.sh 客户端脚本在集群的所有节点,设置 HADOOP_OPTS 环境变量 export HADOOP_OPTS="-Djava.net.prefIPv4Stack=true -Dsun.security.krb5.debug=true ${HADOOP_OPTS}" 调整段节点上 JVM 程序的内存 每一个段数据库都会加载一个JVM进程去读写HDFS上的外部文件,为了修改这个JVM进程内存的申请,需要修改环境变量 GP_JAVA_OPT在 $GPHOME/lib/hadoop-env.sh 客户端脚本编辑如下 export GP_JAVA_OPT=-Xmx1000m 确保 Kerberos 的安全设置 重新检查 /etc/krb5.conf 文件如果 AES256 加密文件不能使用,确保所有的节点都安装了 JCE 模块确保全波的加密文件中的所有加密类型与 krb5.conf 定义文件匹配 cat /etc/krb5.conf | egrep supported_enctypes 测试单个段数据的联通性 按照如下的步骤去测试 Greenplum 数据库节点去读取 HDFS 上的文件。这个测试方法执行的是 Greenplum 中的 HDFSReader JAVA类。可以用来帮助我们派出故障 将文件保存在HDFS中 hdfs dfs -put test1.txt hdfs://namenode:8020/tmp 在一个段数据库上测试, 创建环境脚本文件 env.sh, $ vi env.shexport JAVA_HOME=/usr/java/defaultexport HADOOP_HOME=/usr/lib/hadoopexport GP_HADOOP_CON_VERSIONM=hdp2export GP_HADOOP_CON_JARDIR=/usr/lib/hadoop 刷新环境变量文件 source /usr/local/greenplum-db/greenplum_path.shsource env.shsource $GPHOME/lib/hadoop-env.sh 测试 Greenplum 的 HDFS 的读能力 java com.emc.greenplum.gpdb.hdfsconnector.HDFSReader 0 32 TEXT hdp2 gphdfs://namenode:8020/tmp/test1.txt 参考文献">https://gpdb.docs.pivotal.io/500/best_practices/kerberos-hdfs.html>

优秀的个人博客,低调大师

VPC内网服务可用性监控最佳实践

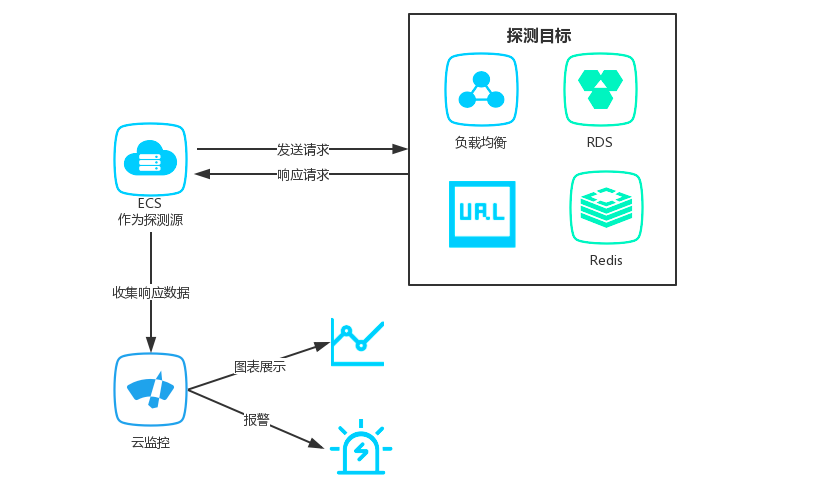
应用场景 随着越来越多的用户从经典网络迁移到更安全、更可靠的VPC网络环境,如何监控VPC内部服务是否正常响应就成为需要关注的问题。下面通过具体案例说明如何监控VPC内ECS上的服务是否可用、VPC内ECS到RDS、Redis的连通性如何、VPC内SLB是否正常响应。 原理说明 首先需要您在服务器上安装云监控插件,然后通过控制台配置监控任务,选择已安装插件的机器作为探测源,并配置需要探测的目标URL或端口。完成配置后,作为探测源的机器会通过插件每分钟发送一个HTTP请求或Telnet请求到目标URL或端口,并将响应时间和状态码收集到云监控进行报警和图表展示。 操作说明 使用前提 作为探测源的服务器需要安装云监控插件。 需要创建应用分组,并将作为探测源的机器加入分组。 使用步骤 登录云监控控制台,选择页面左侧菜单的应用分组,进入应用分组页面。 选择需要

优秀的个人博客,低调大师

HybridDB · 最佳实践 · 阿里云数据库PetaData

前言 随着互联网DT时代的高速发展,业界需要简单高效的数据处理方式在海量数据中挖掘价值,企业厂商和开源界目前较流行的的做法,是提供支持类SQL接口的数据库服务,或者是提供SDK接口的数据处理平台服务。 在SQL接口的数据库服务中,传统的关系数据库,如MySQL、PG等,处理海量数据显得越来越力不从心,既无法突破单机硬件资源限制,又无法并行利用多机硬件资源;大数据NewSQL数据库,必须依赖外部数据库保证数据的事务特性,并通过数据导入工具将完整提交的数据导入进来计算,系统复杂度和成本较高。 在SDK接口的数据处理平台服务中,用户需要进行再次开发,扩展性和自由度较好,但是上线周期较长,易用性较差,且需要长期维护代码,保证稳定性和性能。 那么问题来了,是否有一类产品,能够兼顾易用性、大容量、低成本,既支持高并发低延迟OLTP业务,又支持海量数据

优秀的个人博客,低调大师

阿里云运维部署工具AppDeploy最佳实践

阿里云AppDeploy版是一个通过SSH实现的流式命令行工具,可用于完成应用部署和远程运维管理,其工作于python平台上,具有良好的可移植性;AppDeploy将本地应用软件上传到远端服务器,并执行用户预定义的产品部署命令。 工具当前免费下载使用,地址: http://market.aliyun.com/products/53690006/cmgj000331.html http://market.aliyun.com/products/53690006/cmgj000321.html 本文通过三个使用场景介绍AppDeploy: 一、高效运维管理命令 1.实时监控服务器状态 执行命令: $adepcheck_status 将得到服务器的具体信息,包括ip、route、dns、resolve、iptables、mount、disk、load等。 也可以在命令后面加具体参数查看部分信息,例如: 当前支持:ip、route、dns、resolve、iptables、mount、diskload。 $adepcheck_status:resolve $adepcheck_status:disk 2.实时监控服务器带宽 在命令行执行: $adepcheck_bandwidth 将会得到下面动态数据: 其中红框内的数据分别为: ◆提示按”e”字母退出监控状态:此处注意输入格式。 ◆服务器流入带宽实时数据(动态显示):分别显示KB/s 和Mb/s两中常见数据格式。 ◆服务器流出带宽实时数据(动态显示):分别显示KB/s 和Mb/s两中常见数据格式。 3.文件的上传下载 通过命令行类似shell命令的方式实现: 具体操作的哪些服务器、用户名、密码信息由appdeploy.py文件定义。 文件上传命令格式: $adepput:localfile,remoteFolder ◆“put”、”:”、”localFile”、”,”、”remoteFolder”之间都没有空格。 ◆LocalFile:本地上传文件路径及名字,RemoteFolder:上传到服务器的具体目录。 文件下载命令格式: $adepget:remoteFile,localFolder ◆”get”、”:”、”remoteFile”、”,”、”localFolder”之间都没有空格。 ◆RemoteFile:从服务器上下载的文件名,localFolder:下载文件本地存放目录。 例如: 4.远程命令执行 通过命令行类似shell命令的方式实现: 具体操作的哪些服务器、用户名、密码信息由appdeploy.py文件定义。 命令远程执行格式: return(1xx|2xx|4xx|5xx)["text"]; $adeprun:shellCommand ◆“run”、”:”、”shellCommand”之间都没有空格。 ◆ShellCommand:指远端执行的命令,有空格时要用引号引起来。 5.一键更新服务器源 命令行输入: $adepupdate_source 可以更新服务器端的源配置,支持Ubuntu、Centos、Redhat、Opensuse、Debian等系统的多个版本源更新功能。 二、一键部署Web服务器之Mysql + Nginx + PHP 1.在appdeploy.py中输入以下定义 defruntime(): componets={“nginx”:“1.4.4″, “php”:“5.6.11″, “mysql”:“5.6.26″ } install_runtime(componets) 2.在命令行执行下面命令,由于全部为源码安装,安装会占用相对较长时间。 $adepruntime 3.应用部署上线:上传您的PHP项目 下面代码表示将本地PHP项目上传到服务器:/aliyun/www/phpwind目录。 defdeploy_php(): put(“./php/*”,“/aliyun/www/phpwind/”) 执行: $adepdeploy_php 4.检验应用部署效果 三、一键部署Web服务器之JDK + Mysql + Nginx + Tomcat 1.在appdeploy.py中输入以下定义: defruntime(): componets={“jdk”:“1.8.0″, “nginx”:“1.4.4″, “tomcat”:“7.0.63″, “mysql”:“5.6.26″ } install_runtime(componets) 2.在命令行执行下面命令,由于全部为源码安装,会占用相对较长时间。 $adepruntime 3.应用部署:上传您的java项目 下面任务会将本地java项目编译、打包、上传到服务器(基于Maven,appdeploy会自动检测您的maven程序是否安装,若没有安装,则会自动安装),最后上传到服务器的/aliyun/server/tomcat/webapps目录。 defpack_deploy(): componets={“plugin”:“maven”, “project_dir”:“./java/myFirstWebApp”, “web_dir”:“/aliyun/server/tomcat/webapps” } package(componets) deploy(componets) 执行: $adeppack_deploy 4.检验应用部署效果 作者:阿里云 来源:51CTO

优秀的个人博客,低调大师

HBase最佳实践-客户端超时机制

上篇博文结合一起线上问题介绍了HBase客户端基于退避算法的重试机制,并分析得出在某些场景下如果重试策略设置不当会导致长时间的业务阻塞。除了重试机制外,业务童鞋最关心的就是超时机制了。客户端超时设置对整个系统的稳定性以及敏感性至关重要,一旦没有超时设置或超时时间设置过长,服务器端的长时间卡顿必然会引起客户端阻塞等待,进而影响上层应用。好在HBase提供了多个客户端参数设置超时,主要包括hbase.rpc.timeout /hbase.client.operation.timeout /hbase.client.scanner.timeout.period。然而这些参数官方并没有给出具体的介绍,导致开发人员并不真正理解这些参数的含义。接下来本文分别对这三个参数进行介绍,应用童鞋可以根据自己的实际情况对这三个参数进行设置。 hbase.rpc.timeout 从字面意思就可知道,该参数表示一次RPC请求的超时时间。如果某次RPC时间超过该值,客户端就会主动关闭socket。此时,服务器端就会捕获到如下的异常: java.io.IOException: Connection reset by peer at sun.nio.ch.FileDispatcherImpl.read0(Native Method) at sun.nio.ch.SocketDispatcher.read(SocketDispatcher.java:39) at sun.nio.ch.IOUtil.readIntoNativeBuffer(IOUtil.java:223) at sun.nio.ch.IOUtil.read(IOUtil.java:197) at sun.nio.ch.SocketChannelImpl.read(SocketChannelImpl.java:384) at org.apache.hadoop.hbase.ipc.RpcServer.channelRead(RpcServer.java:2246) at org.apache.hadoop.hbase.ipc.RpcServer$Connection.readAndProcess(RpcServer.java:1496) .... 2016-04-14 21:32:40,173 WARN [B.DefaultRpcServer.handler=125,queue=5,port=60020] ipc.RpcServer: RpcServer.respondercallId: 7540 service: ClientService methodName: Multi size: 100.2 K connection: 10.160.247.139:56031: output error 2016-04-14 21:32:40,173 WARN [B.DefaultRpcServer.handler=125,queue=5,port=60020] ipc.RpcServer: B.DefaultRpcServer.handler=125,queue=5,port=60020: caught a ClosedChannelException, this means that the server was processing a request but the client went away. The error message was: null 上述异常经常发生在大量高并发读写业务或者服务器端发生了比较严重的Full GC等场景下,导致某些请求无法得到及时处理,超过了时间间隔。该值默认大小为60000ms,即1min。 hbase.client.operation.timeout 该参数表示HBase客户端发起一次数据操作直至得到响应之间总的超时时间,数据操作类型包括get、append、increment、delete、put等。很显然,hbase.rpc.timeout表示一次RPC的超时时间,而hbase.client.operation.timeout则表示一次操作的超时时间,有可能包含多个RPC请求。举个例子说明,比如一次Put请求,客户端首先会将请求封装为一个caller对象,该对象发送RPC请求到服务器,假如此时因为服务器端正好发生了严重的Full GC,导致这次RPC时间超时引起SocketTimeoutException,对应的就是hbase.rpc.timeout。那假如caller对象发送RPC请求之后刚好发生网络抖动,进而抛出网络异常,HBase客户端就会进行重试,重试多次之后如果总操作时间超时引起SocketTimeoutException,对应的就是hbase.client.operation.timeout。 hbase.client.scanner.timeout.period 看到这里为止,很多细心的童鞋都会发现,hbase.client.operation.timeout参数规定的超时基本涉及到了HBase所有的数据操作,唯独没有scan操作。然而scan操作却是最有可能发生超时的,也因此是用户最为关心的。HBase当然考虑到了这点,并提供了一个单独的超时参数进行设置:hbase.client.scanner.timeout.period。这个参数理解起来稍微有点复杂,需要对scan操作本身有比较全面的理解,这可能也是很多业务用户并不了解的地方。 首先,我们来看一个最简单的scan操作示例: public static void scan() { HTable table=(HTable) getHTablePool().getTable("tb_stu"); Scan scan=new Scan(); scan.setMaxResultSize(10000); scan.setCacheing(500); ResultScanner rs = table.getScanner(scan); for (Result r : rs) { for (KeyValue kv : r.raw()) { System.out.println(String.format("row:%s, family:%s, qualifier:%s, qualifiervalue:%s, timestamp:%s.”, Bytes.toString(kv.getRow()), Bytes.toString(kv.getFamily()), Bytes.toString(kv.getQualifier()), Bytes.toString(kv.getValue()), kv.getTimestamp())); } } } 很多人都会误认为一次scan操作就是一次RPC请求,实际上,一次请求大量数据的scan操作可能会导致多个很严重的后果:服务器端可能因为大量io操作导致io利用率很高,影响其他正常业务请求;大量数据传输会导致网络带宽等系统资源被大量占用;客户端也可能因为内存无法缓存这些数据导致OOM。基于此,HBase会将一次大的scan操作根据设置条件拆分为多个RPC请求,每次只返回规定数量的结果。上述代码中foreach(Result r :rs)语句实际上等价于Result r = rs.next(),每执行一次next()操作就会调用客户端发送一次RPC请求,参数hbase.client.scanner.timeout.period就用来表示这么一次RPC请求的超时时间,默认为60000ms,一旦请求超时,就会抛出SocketTimeoutException异常。 讲到这里,就借用宝地引申地讲讲另外两个相关的问题: 1. 上文提到一次大的scan操作会被拆分为多个RPC请求,那到底会拆分为多少个呢? 一次scan请求的RPC次数主要和两个因素相关,一个是本次scan的待检索条数,另一个是单次RPC请求的数据条数,很显然,两者的比值就是RPC请求次数。 一次scan的待检索条数由用户设置的条件决定,比如用户想一次获取某个用户最近一个月的所有操作信息,这些信息总和为10w条,那一次scan总扫瞄条数就是10w条。为了防止一次scan操作请求的数据量太大,额外提供了参数maxResultSize对总检索结果大小进行限制,该参数表示一次scan最多可以请求的数据量大小,默认为-1,表示无限制。 单次RPC请求的数据条数由参数caching设定,默认为100条。因为每次RPC请求获取到数据都会缓存到客户端,因此该值如果设置过大,可能会因为一次获取到的数据量太大导致客户端内存oom;而如果设置太小会导致一次大scan进行太多次RPC,网络成本高。 具体使用可以参考上文代码示例。 2. 经常有业务童鞋问道,在scan过程中RegionServer端偶尔抛出leaseException,是怎么回事? 看到leaseException就会想到租约机制,的确,HBase内部在一次完整的scan操作中引入了租约机制。为什么需要租约机制?这和整个scan操作流程有莫大的关系,上文讲到,一次完整的scan通常会被拆分为多个RPC请求,实际实现中,RegionServer接收到第一次RPC请求之后,会为该scan操作生成一个全局唯一的id,称为scanId。除此之外,RegionServer还会进行大量的准备工作,构建整个scan体系,构造需要用到的所有对象,后续的RPC请求只需要携带相同的scanId作为标示就可以直接利用这些已经构建好的资源进行检索。也就是说,在整个scan过程中,客户端其实都占用着服务器端的资源,此时如果此客户端意外宕机,是否就意味着这些资源永远都不能得到释放呢?租约机制就是为了解决这个问题。RegionServer接收到第一次RPC之后,除了生成全局唯一的scanId之外还会生成一个携带有超时时间的lease,超时时间可以通过参数hbase.regionserver.lease.period配置,一旦在超时时间内后续RPC请求没有到来(比如客户端处理太慢),RegionServer就认为客户端出现异常,此时会将该lease销毁并将整个scan所持有的资源全部释放,客户端在处理完成之后再发后续的RPC过来,检查到对应的lease已经不存在,就会抛出如下leaseExcption: org.apache.hadoop.hbase.regionserver.LeaseException: lease '-8841369309248784313’ does not exist at org.apache.hadoop.hbase.regionserver.Leases.removeLease(Leases.java:230) at org.apache.hadoop.hbase.regionserver.HRegionServer.next(HRegionServer.java:1847) at sun.reflect.GeneratedMethodAccessor11.invoke(Unknown Source) at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:25) at java.lang.reflect.Method.invoke(Method.java:597) at org.apache.hadoop.hbase.ipc.HBaseRPC$Server.call(HBaseRPC.java:570) at org.apache.hadoop.hbase.ipc.HBaseServer$Handler.run(HBaseServer.java:1039) 写在最后 一旦发生超时异常,很多童鞋的第一反应是会将超时时间设长。可以负责任的说,这样的处理是盲目的,不仅不能从本质上解决问题,还会使得整个系统处于特别不敏感的状态,在某些异常情况下,客户端就会因为超时时间设置太长而一直阻塞,进而导致上层业务长时间卡顿。因此在大多数情况下都不建议将超时时间设大,推荐的方法是找到超时的原因,分析超时原因是否可以避免。 文章最后再说说如何设置超时,用户可以通过修改配置文件hbase-site.xml来设置这几个参数,也可以通过代码的方式进行设置,如下所示: Confiuration conf = HBaseConfiguration.create(); conf.setInt("hbase.rpc.timeout",20000); conf.setInt("hbase.client.operation.timeout”,30000); conf.setInt("hbase.client.scanner.timeout.period",20000); HTable table = new HTable(conf,"tableName"); … 本文转载自:http://hbasefly.com 原文链接


优秀的个人博客,低调大师

HBase最佳实践-用好你的操作系统

终于又切回HBase模式了,之前一段时间因为工作的原因了解接触了一段时间大数据生态的很多其他组件(诸如Parquet、Carbondata、Hive、SparkSQL、TPC-DS/TPC-H等),虽然只是走马观花,但也受益良多。对视野、思维模式都有极其重要的作用,至少,扩展了大数据领域的对话圈。这里也斗胆建议朋友能在深入研究一门学问的同时博览周边学问,相信必然会大有裨益。 来说正题,操作系统这个话题其实很早就想拿出来和大家分享,拖到现在一方面是因为对其中各种理论理解并不十分透彻,怕讲不好;另一方面是这个问题好像一直以来都很少有人关注,这里算是给这个话题开个头。其实这几个参数前前后后看过好些次,但却一直没有吃透,前段时间趁着休假又把这些理论翻出来过了一遍,有了进一步的理解,这里权当整理梳理。下图是HBase官方文档上对操作系统环境的几点配置要求: 先不着急解释每个配置的具体含义,在这之前需要重点研究一个概念:swap,对,就这个大家或多或少听说过的名词,负责任的说,上述几个参数或多或少都与swap有些关联。 swap是干嘛的? 在Linux下,SWAP的作用类似Windows系统下的“虚拟内存”。当物理内存不足时,拿出部分硬盘空间当SWAP分区(虚拟成内存)使用,从而解决内存容量不足的情况。 SWAP意思是交换,顾名思义,当某进程向OS请求内存发现不足时,OS会把内存中暂时不用的数据交换出去,放在SWAP分区中,这个过程称为SWAPOUT。当某进程又需要这些数据且OS发现还有空闲物理内存时,又会把SWAP分区中的数据交换回物理内存中,这个过程称为SWAPIN。 当然,swap大小是有上限的,一旦swap使用完,操作系统会触发OOM-Killer机制,把消耗内存最多的进程kill掉以释放内存。 数据库系统为什么嫌弃swap? 显然,swap机制的初衷是为了缓解物理内存用尽而选择直接粗暴OOM进程的尴尬。但坦白讲,几乎所有数据库对swap都不怎么待见,无论MySQL、Oracal、MongoDB抑或HBase,为什么?这主要和下面两个方面有关: 1.数据库系统一般都对响应延迟比较敏感,如果使用swap代替内存,数据库服务性能必然不可接受。对于响应延迟极其敏感的系统来讲,延迟太大和服务不可用没有任何区别,比服务不可用更严重的是,swap场景下进程就是不死,这就意味着系统一直不可用……再想想如果不使用swap直接oom,是不是一种更好的选择,这样很多高可用系统直接会主从切换掉,用户基本无感知。 2.另外对于诸如HBase这类分布式系统来说,其实并不担心某个节点宕掉,而恰恰担心某个节点夯住。一个节点宕掉,最多就是小部分请求短暂不可用,重试即可恢复。但是一个节点夯住会将所有分布式请求都夯住,服务器端线程资源被占用不放,导致整个集群请求阻塞,甚至集群被拖垮。 从这两个角度考虑,所有数据库都不喜欢swap还是很有道理的! swap的工作机制 既然数据库们对swap不待见,那是不是就要使用swapoff命令关闭磁盘缓存特性呢?非也,大家可以想想,关闭磁盘缓存意味着什么?实际生产环境没有一个系统会如此激进,要知道这个世界永远不是非0即1的,大家都会或多或少选择走在中间,不过有些偏向0,有些偏向1而已。很显然,在swap这个问题上,数据库必然选择偏向尽量少用。HBase官方文档的几点要求实际上就是落实这个方针:尽可能降低swap影响。知己知彼才能百战不殆,要降低swap影响就必须弄清楚Linux内存回收是怎么工作的,这样才能不遗漏任何可能的疑点。 先来看看swap是如何触发的? 简单来说,Linux会在两种场景下触发内存回收,一种是在内存分配时发现没有足够空闲内存时会立刻触发内存回收;一种是开启了一个守护进程(swapd进程)周期性对系统内存进行检查,在可用内存降低到特定阈值之后主动触发内存回收。第一种场景没什么可说,来重点聊聊第二种场景,如下图所示: 这里就要引出我们关注的第一个参数:vm.min_free_kbytes,代表系统所保留空闲内存的最低限watermark[min],并且影响watermark[low]和watermark[high]。简单可以认为: watermark[min] = min_free_kbytes watermark[low] = watermark[min] * 5 / 4 = min_free_kbytes * 5 / 4 watermark[high] = watermark[min] * 3 / 2 = min_free_kbytes * 3 / 2 watermark[high] - watermark[low] = watermark[low] - watermark[min] = min_free_kbytes / 4 可见,LInux的这几个水位线与参数min_free_kbytes密不可分。min_free_kbytes对于系统的重要性不言而喻,既不能太大,也不能太小。 min_free_kbytes如果太小,[min,low]之间水位的buffer就会很小,在kswapd回收的过程中一旦上层申请内存的速度太快(典型应用:数据库),就会导致空闲内存极易降至watermark[min]以下,此时内核就会进行directreclaim(直接回收),直接在应用程序的进程上下文中进行回收,再用回收上来的空闲页满足内存申请,因此实际会阻塞应用程序,带来一定的响应延迟。当然,min_free_kbytes也不宜太大,太大一方面会导致应用程序进程内存减少,浪费系统内存资源,另一方面还会导致kswapd进程花费大量时间进行内存回收。再看看这个过程,是不是和Java垃圾回收机制中CMS算法中老生代回收触发机制神似,想想参数-XX:CMSInitiatingOccupancyFraction,是不是?官方文档中要求min_free_kbytes不能小于1G(在大内存系统中设置8G),就是不要轻易触发直接回收。 至此,基本解释了Linux的内存回收触发机制以及我们关注的第一个参数vm.min_free_kbytes。接下来简单看看Linux内存回收都回收些什么。Linux内存回收对象主要分为两种: 1.文件缓存,这个容易理解,为了避免文件数据每次都要从硬盘读取,系统会将热点数据存储在内存中,提高性能。如果仅仅将文件读出来,内存回收只需要释放这部分内存即可,下次再次读取该文件数据直接从硬盘中读取即可(类似HBase文件缓存)。那如果不仅将文件读出来,而且对这些缓存的文件数据进行了修改(脏数据),回收内存就需要将这部分数据文件写会硬盘再释放(类似MySQL文件缓存)。 2.匿名内存,这部分内存没有实际载体,不像文件缓存有硬盘文件这样一个载体,比如典型的堆、栈数据等。这部分内存在回收的时候不能直接释放或者写回类似文件的媒介中,这才搞出来swap这个机制,将这类内存换出到硬盘中,需要的时候再加载出来。 具体Linux使用什么算法来确认哪些文件缓存或者匿名内存需要被回收掉,这里并不关心,有兴趣可以参考这里。但是有个问题需要我们思考:既然有两类内存可以被回收,那么在这两类内存都可以被回收的情况下,Linux到底是如何决定到底是回收哪类内存呢?还是两者都会被回收?这里就牵出来了我们第二个关心的参数:swappiness,这个值用来定义内核使用swap的积极程度,值越高,内核就会积极地使用swap,值越低,就会降低对swap的使用积极性。该值取值范围在0~100,默认是60。这个swappiness到底是怎么实现的呢?具体原理很复杂,简单来讲,swappiness通过控制内存回收时,回收的匿名页更多一些还是回收的文件缓存更多一些来达到这个效果。swappiness等于100,表示匿名内存和文件缓存将用同样的优先级进行回收,默认60表示文件缓存会优先被回收掉,至于为什么文件缓存要被优先回收掉,大家不妨想想(回收文件缓存通常情况下不会引起IO操作,对系统性能影响较小)。对于数据库来讲,swap是尽量需要避免的,所以需要将其设置为0。此处需要注意,设置为0并不代表不执行swap哦! 至此,我们从Linux内存回收触发机制、Linux内存回收对象一直聊到swap,将参数min_free_kbytes以及swappiness进行了解释。接下来看看另一个与swap有关系的参数:zone_reclaim_mode,文档说了设置这个参数为0可以关闭NUMA的zonereclaim,这又是怎么回事?提起NUMA,数据库们又都不高兴了,很多DBA都曾经被坑惨过。那这里简单说明三个小问题:NUMA是什么?NUMA和swap有什么关系?zone_reclaim_mode的具体意义? NUMA(Non-Uniform Memory Access)是相对UMA来说的,两者都是CPU的设计架构,早期CPU设计为UMA结构,如下图(图片来自网络)所示: 为了缓解多核CPU读取同一块内存所遇到的通道瓶颈问题,芯片工程师又设计了NUMA结构,如下图(图片来自网络)所示: 这种架构可以很好解决UMA的问题,即不同CPU有专属内存区,为了实现CPU之间的”内存隔离”,还需要软件层面两点支持: 1.内存分配需要在请求线程当前所处CPU的专属内存区域进行分配。如果分配到其他CPU专属内存区,势必隔离性会受到一定影响,并且跨越总线的内存访问性能必然会有一定程度降低。 2.另外,一旦local内存(专属内存)不够用,优先淘汰local内存中的内存页,而不是去查看远程内存区是否会有空闲内存借用。 这样实现,隔离性确实好了,但问题也来了:NUMA这种特性可能会导致CPU内存使用不均衡,部分CPU专属内存不够使用,频繁需要回收,进而可能发生大量swap,系统响应延迟会严重抖动。而与此同时其他部分CPU专属内存可能都很空闲。这就会产生一种怪现象:使用free命令查看当前系统还有部分空闲物理内存,系统却不断发生swap,导致某些应用性能急剧下降。见叶金荣老师的MySQL案例分析:《找到MySQL服务器发生SWAP罪魁祸首》。 所以,对于小内存应用来讲,NUMA所带来的这种问题并不突出,相反,local内存所带来的性能提升相当可观。但是对于数据库这类内存大户来说,NUMA默认策略所带来的稳定性隐患是不可接受的。因此数据库们都强烈要求对NUMA的默认策略进行改进,有两个方面可以进行改进: 1.将内存分配策略由默认的亲和模式改为interleave模式,即会将内存page打散分配到不同的CPUzone中。通过这种方式解决内存可能分布不均的问题,一定程度上缓解上述案例中的诡异问题。对于MongoDB来说,在启动的时候就会提示使用interleave内存分配策略: WARNING: You are running on a NUMA machine. We suggest launching mongod like this to avoid performance problems: numactl –interleave=all mongod [other options] 2.改进内存回收策略:此处终于请出今天的第三个主角参数zone_reclaim_mode,这个参数定义了NUMA架构下不同的内存回收策略,可以取值0/1/3/4,其中0表示在local内存不够用的情况下可以去其他的内存区域分配内存;1表示在local内存不够用的情况下本地先回收再分配;3表示本地回收尽可能先回收文件缓存对象;4表示本地回收优先使用swap回收匿名内存。可见,HBase推荐配置zone_reclaim_mode=0一定程度上降低了swap发生的概率。 不都是swap的事 至此,我们探讨了三个与swap相关的系统参数,并且围绕Linux系统内存分配、swap以及NUMA等知识点对这三个参数进行了深入解读。除此之外,对于数据库系统来说,还有两个非常重要的参数需要特别关注: 1. IO调度策略:这个话题网上有很多解释,在此并不打算详述,只给出结果。通常对于sata盘的OLTP数据库来说,deadline算法调度策略是最优的选择。 2. THP(transparent huge pages)特性关闭。THP特性笔者曾经疑惑过很久,主要疑惑点有两点,其一是THP和HugePage是不是一回事,其二是HBase为什么要求关闭THP。经过前前后后多次查阅相关文档,终于找到一些蛛丝马迹。这里分四个小点来解释THP特性: (1)什么是HugePage? 网上对HugePage的解释有很多,大家可以检索阅读。简单来说,计算机内存是通过表映射(内存索引表)的方式进行内存寻址,目前系统内存以4KB为一个页,作为内存寻址的最小单元。随着内存不断增大,内存索引表的大小将会不断增大。一台256G内存的机器,如果使用4KB小页,仅索引表大小就要4G左右。要知道这个索引表是必须装在内存的,而且是在CPU内存,太大就会发生大量miss,内存寻址性能就会下降。 HugePage就是为了解决这个问题,HugePage使用2MB大小的大页代替传统小页来管理内存,这样内存索引表大小就可以控制的很小,进而全部装在CPU内存,防止出现miss。 (2)什么是THP(Transparent Huge Pages)? HugePage是一种大页理论,那具体怎么使用HugePage特性呢?目前系统提供了两种使用方式,其一称为Static Huge Pages,另一种就是Transparent Huge Pages。前者根据名称就可以知道是一种静态管理策略,需要用户自己根据系统内存大小手动配置大页个数,这样在系统启动的时候就会生成对应个数的大页,后续将不再改变。而Transparent Huge Pages是一种动态管理策略,它会在运行期动态分配大页给应用,并对这些大页进行管理,对用户来说完全透明,不需要进行任何配置。另外,目前THP只针对匿名内存区域。 (3)HBase(数据库)为什么要求关闭THP特性? THP是一种动态管理策略,会在运行期分配管理大页,因此会有一定程度的分配延时,这对追求响应延时的数据库系统来说不可接受。除此之外,THP还有很多其他弊端,可以参考这篇文章《why-tokudb-hates-transparent-hugepages》 (4)THP关闭/开启对HBase读写性能影响有多大? 为了验证THP开启关闭对HBase性能的影响到底有多大,本人在测试环境做了一个简单的测试:测试集群仅一个RegionServer,测试负载为读写比1:1。THP在部分系统中为always以及never两个选项,在部分系统中多了一个称为madvise的选项。可以使用命令echo never/always > /sys/kernel/mm/transparent_hugepage/enabled 来关闭/开启THP。测试结果如下图所示: 如上图,TPH关闭场景下(never)HBase性能最优,比较稳定。而THP开启的场景(always),性能相比关闭的场景有30%左右的下降,而且曲线抖动很大。可见,HBase线上切记要关闭THP。 总结 任何数据库系统的性能表现都与诸多因素相关,这里面有数据库本身的各种因素,比如数据库配置、客户端使用、容量规划、表scheme设计等,除此之外,基础系统对其的影响也至关重要,比如操作系统、JVM等。很多时候数据库遇到一些性能问题,左查右查都定位不了具体原因,这个时候就要看看操作系统的配置是否都合理了。本文从HBase官方文档要求的几个参数出发,详细说明了这些参数的具体意义。 本文转载自:http://hbasefly.com 原文链接

优秀的个人博客,低调大师

《Android和PHP开发最佳实践》一2.11 小结

2.11 小结 在本章中,首先我们学习了Android的系统框架和应用框架,然后熟悉了Android的四大核心要点和四大组件(活动Activity、服务Service、广播接收器Broadcast Receiver、内容提供者Content Provider),以及Android中一些常用的数据存储方式。随后,我们还学会了如何安装和配置Android的开发环境,并且动手开发了第一个Android应用Hello World项目,还学习了一些使用DDMS进行调试的方法。最后,建议大家回顾一下本章的所有知识点,如果感觉都已经理解掌握了的话,那么要恭喜,你已经成功迈出成为Android大师的第一步;当然,如果你感觉思路还有点不够清晰的话,请回头好好回顾并理解一下本章的内容,因为这些知识对你以后继续深入地学习Android系统是非常重要的。

优秀的个人博客,低调大师

《Android和PHP开发最佳实践 》一3.7 小结

3.7 小结 本章中我们比较全面地介绍了使用PHP语言进行开发的几个方面。从最基本的PHP语法、语言特点,到PHP面向对象编程思路、常用开发环境的介绍,再到PHP配套开发组件(Apache和MySQL等)和主流开发框架的分析和使用;如果大家能够把本章所介绍的这些知识全部掌握,那么可以说我们就已经具备了使用PHP语言进行互联网项目开发的基本条件,接下来还需要进一步学习的就是实战经验了。

优秀的个人博客,低调大师

VPC最佳实践(三):如何选择公网类产品?

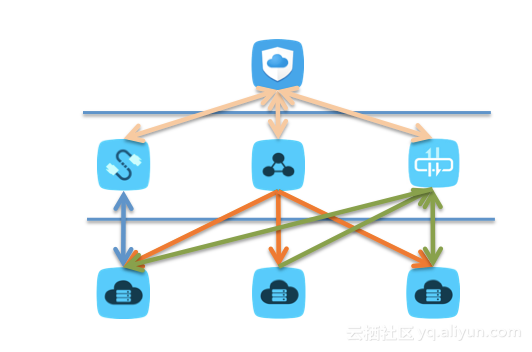
目前阿里云虚拟网络为用户提供了以下几种不同形态的公网类产品:负载均衡 (SLB),弹性公网IP (EIP),NAT网关。这几种产品分别适用于不同的场景,用户可通过这几种产品实现VPC资源与公网的互通。 产品使用场景核心关键词 产品 场景关键词 计量计费特性 SLB DNAT + 负载均衡七层转发/四层转发健康检查/高可用 预付费:按带宽后付费:按带宽/按流量 NAT网关 DNAT(IP映射/端口映射)SNAT(ECS访问互联网)共享带宽 后付费:按带宽 EIP 最简单的ECS连通公网的方式 预付费:按带宽后付费:按带宽/按流量 注:负载均衡的DNAT可支持一个“SLB IP+端口”映射到多个“ECS IP+端口”上,NAT网关的DNAT只支持一个“公网IP+端口”映射到一个“ECS IP+端口”上。 负载均衡SLB:支持入方向的端口映射(DNA

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册