首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

SpringBoot实战(五)之Thymeleaf

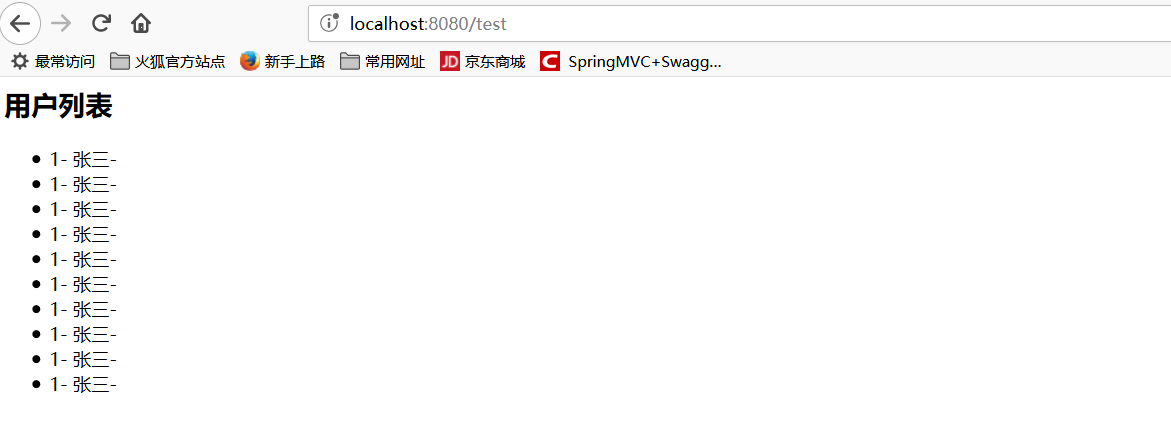
Thymeleaf同jsp、volocity、freemarker等共同的职能是MVC模式中的视图展示层,即View。 当然了,SpringBoot中也可以用jsp,不过不推荐这种用法,比较推崇的就是使用Thymeleaf。 关于Thymeleaf学习,建议参考官方文档:https://www.thymeleaf.org/documentation.html 官方文档例子,应有尽有。 之前接触过Thymeleaf是因为公司项目初建期间用过它搭建过测试环境,后来根据领导的指示,需要快速开发,而且当时对于Thymeleaf不是十分了解,当时对于它的了解认识只是展示前端数据的,同jsp职能一样,当然这也是它们的共性。比较详细的深入了解和使用,是帮助一位学妹解决毕业论文的项目问题。那时帮助她写了好十几个类代码和对应的十几个html代码。当时感触比较深的是,Thymeleaf是如此的好用,比jsp还好用,jsp要遍历之类,要么加<%%>,或者引用jstl标签库进行数据遍历等。而Thymeleat就不需要。简洁直观,我比较推崇Thymeleaf,特别是在前后端分离的项目,有的时候不用jsp,光纯html+js的确有点吃力,即便使用了vue.js或者angular.js、react.js等虽然增加了便利性,但是了,如果一个项目前端语言不是十分统一的话,对于将来维护成本方面会大大提高,不易维护。 Thymeleaf对于前后端分离,我认为还是不错的。 下面进入demo例子讲解: 一、导入maven依赖 <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>org.springframework</groupId> <artifactId>gs-uploading-files</artifactId> <version>0.1.0</version> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>1.5.8.RELEASE</version> </parent> <properties> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-thymeleaf</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project> 二、编写实体 package hello; public class User { private Integer id; private String name; public Integer getId() { return id; } public void setId(Integer id) { this.id = id; } public String getName() { return name; } public void setName(String name) { this.name = name; } } 三、编写Controller package hello; import java.util.ArrayList; import java.util.List; import org.springframework.stereotype.Controller; import org.springframework.ui.Model; import org.springframework.web.bind.annotation.GetMapping; @Controller public class TestController { @GetMapping(value="/test") public String test(Model model) { List<User> userList = new ArrayList<User>(); for (int i = 0; i <10; i++) { User user =new User(); user.setId(1); user.setName("张三"); userList.add(user); } model.addAttribute("users", userList); return "test"; } } 四、编写配置文件,将其放置在/src/main/resources下 application.properties server.port=8080 spring.thymeleaf.cache=false spring.thymeleaf.prefix=classpath:/templates/ spring.thymeleaf.check-template-location=true spring.thymeleaf.suffix=.html spring.thymeleaf.encoding=UTF-8 spring.thymeleaf.content-type=text/html spring.thymeleaf.mode=HTML5 五、在src/main/resources目录下新建templates目录并新建html文件 test.htm <html xmlns:th="http://www.thymeleaf.org"> <body> <h2>用户列表</h2> <div> <ul> <li th:each="user:${users}"> <span th:text="${user.id}"></span>- <span th:text="${user.name}"></span>- </li> </ul> </div> </body> </html> 六、编写启动类 package hello; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; @SpringBootApplication public class Application { public static void main(String[] args) { SpringApplication.run(Application.class, args); } } 最后结果如下图所示: 这里没有加入mysql或者其他数据相关的,如果要引用数据库,引用对应数据库的依赖和配置对应的数据库连接池即可。 这里可以参考我的关于Springboot+MyBatis+Thymeleaf 示例地址为:https://github.com/youcong1996/springboot-mybatis-demo

优秀的个人博客,低调大师

Java入门之继承(下)

Object类 Object类是所有类的父类 一个类没有使用extends关键字明确标识继承关系,则默认继承Object类 (包括数组) Java中的每个类都可以使用Object中定义的方法 可以在Java官方文档中查找Object类中的自带的方法 Object类官方文档 final关键字 final关键字修饰的类 , 表示该类不允许有子类,也就是说不允许被继承 final关键字修饰的方法, 不能修饰构造方法 该方法不允许被子类重写 可以正常被子类继承使用 final关键字修饰方法内部的变量(局部变量), 只要在具体被使用之前进行赋值即可 一旦赋值不允许被修改 final关键字修饰类当中成员属性时,只有在三个特定的位置可以对final修饰的成员属性进行赋值, 定义时直接初始化 构造方法中 构造代码块中 final关键字修饰引用类型的变量, 初始化之后不能再指向另一个对象,但对象的内容是可以改变的 可配合static使用 表示静态的不允许被修改的信息 /* * final eat()修饰方法 */ public final void eat(){ } public class Animal{ public final int age = 18; //final 修饰变量 并 赋值 } 注解 从JDK1.5版本引入的一个特性 可以声明在包、类、属性、方法、局部变量、方法参数等,的前面,用来对这些元素进行说明、解释。 注解可以按照两种不同的类别来进行区分: 按照运行机制来分 源码注解 :注解只在源码中存在,编译成.class文件注解就不存在了(例:@Override) 编译时注解 :注解在源码和.class文件中都存在 运行时注解 :在运行阶段还起作用,甚至会影响运行逻辑的注解(例:Spring注解:@Autowired) 按照来源区分 来自JDK的注解 :例:@Override 来自第三方的注解 :例:Spring注解:@Autowired 我们自己定义的注解 :自己编写的注解 @Override public void eat(){ // @Override 用来标识此方法是重写父类的一个方法 System.out.println(); }

优秀的个人博客,低调大师

Java入门之继承(上)

继承 概念: 一种类与类之间的关系 使用已存在的类的定义作为基础建立新类 新类的定义可以增加新的数据或功能,也可以用父类的功能,但不能选择性地继承父类,需全部把父类的东西继承过来。 子类只能继承父类非私有成员 特点: 1.利于代码复用 2.缩短开发周期 语法: 1.使用extends实现继承 2.单一继承,只能有一个父类 /* * Dog 为子类 又名派生类 * Animal 为父类 又名 超类、基类 */ class Dog extends Animal{ } 方法重载要求: 1.同一个类中 2.方法名相同,参数列表不同(参数顺序 、个数 、类型) 3.方法返回值、访问修饰符 4.与方法的参数名无关 方法重写要求: 1.有继承关系的子类中 ,子类重写父类方法 2.方法名,参数类型、顺序、个数 都要与父类的方法相同 3.方法返回值类型与父类兼容就可以,允许发生改变 4.访问修饰符,访问范围需要大于等于父类的访问范围 5.与方法的参数名无关 访问修饰符 公有的 public (允许任意位置使用) 私有的 private (只允许在本类中使用) 受保护的 protected (允许在当前类、同包子类/非子类、跨包子类调用、跨包非子类不能允许) 默认 (允许在当前类 同包子类调用;跨包子类/非子类不允许调用) super关键字 super代表父类对象的引用,通过super访问父类的成员 父类的构造方法不允许被继承,不允许被重写,但是会影响子类实例化过程 继承后的初始化顺序(子类对象的实例化过程) 父类静态成员 → 子类静态成员 → 父类对象构造 → 子类对象构造 子类的构造的过程中必须调用其父类的构造方法 如果子类的构造方法中没有显示的标注,则系统默认调用父类的无参构造方法 如果子类的构造方法中既没有显示标注,且父类中没有无参的构造方法,则编译错误 使用super调用父类指定的构造方法,必须在子类构造方法的第一行 public Cat(String name, int age){ super(name, age); } this 和 super this : 当前类对象的引用 访问当前类的成员方法、成员属性 访问当前类的构造方法 不能在静态方法中使用 super 访问父类的成员方法、成员属性 访问父类的构造方法 不能在静态方法中使用 this和super不能同时使使用 在继承(下)中会学习更深入的知识,敬请期待,很快更新。

优秀的个人博客,低调大师

Java 基础 之 while 循环

http://www.verejava.com/?id=16992618818220 /* while 循环 while(表达式){} 如果表达式为true 继续执行,否则退出循环 */ public class Test1 { /** * @param args the command line arguments */ public static void main(String[] args) { // 输出 1 - 5 之间(包括 1,5 本身)的数. int n=1; while(n<=5) // while 判断条件true 执行循环代码, 否则终止循环 { System.out.println(n); n++; } } } http://www.verejava.com/?id=16992618818220

优秀的个人博客,低调大师

Java 基础 之 分支语句

http://www.verejava.com/?id=16992614948219 import java.util.Scanner; public class Statement2 { public static void main(String[] args) { //分支语句 //定义一个按键码变量 Scanner in=new Scanner(System.in); System.out.println("请输入按键码..."); //int keyCode=in.nextInt(); //float keyCode=in.nextFloat(); //long keyCode=in.nextLong(); //boolean keyCode=true; //byte keyCode=(byte)in.nextInt(); //short keyCode=(short)in.nextInt(); //char keyCode=(char)in.nextInt(); switch(keyCode) { case 0: System.out.println("飞机向上移动"); break; case 1: System.out.println("飞机向下移动"); break; case 2: System.out.println("飞机向左移动"); break; case 3: System.out.println("飞机向右移动"); break; default: System.out.println("飞机不移动"); break; } /* 注意: 1. default: 是当没有任何匹配条件的时候默认自动执行 2. break:表示终止switch下面的判断语句执行, 如果没有break语句程序会继续往下执行 3. switch(表达式) 表达式只能是 byte,short,int,char类型常量 */ } } http://www.verejava.com/?id=16992614948219

优秀的个人博客,低调大师

Java 基础 之 条件语句

http://www.verejava.com/?id=16992610131518 /* 流程控制语句分为 1. 条件语句 2. 分支语句 3. 循环语句 */ import java.util.Scanner; public class Statement { public static void main(String[] args) { //1.条件语句 /* 包括: 1. if(表达式){语句} 2. if(表达式){语句}else{语句} 3. if(表达式){语句}else if{语句} */ Scanner in=new Scanner(System.in); System.out.println("请输入您的考试成绩..."); int score=in.nextInt(); if(score>=90) { System.out.println("奖励一朵红花"); } else if(score>=60&&score<90) { System.out.println("没有奖励,只有鼓励,革命尚为成功,同志继续努力"); } else if(score<60) { System.out.println("挨打"); } } } /* 如果在判断条件很多的时候if{}else{} 显得有点臃肿和难读, 这样的情况下我们一般选择 分支语句 switch(表达式){} */ http://www.verejava.com/?id=16992610131518

优秀的个人博客,低调大师

Java之解压流(ZipInputStream)

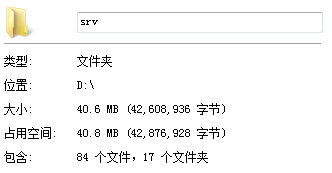
一、ZipInputStream相对于ZipOutputStream而言,使用上面简单的多了,相对的,既然存在压缩流,就会存在,解压的方式。 二、解压文件,流的使用过程中也是很常用的,在读取文件,根据文件类型进行处理,这样,就可以做到,最低成本的数据传输了 三、解压例子 /** * 提供给用户使用的解压工具 * @param srcPath * @param outPath * @throws IOException */ public static void decompressionFile(String srcPath, String outPath) throws IOException { //简单判断解压路径是否合法 if (!new File(srcPath).isDirectory()) { //判断输出路径是否合法 if (new File(outPath).isDirectory()) { if (!outPath.endsWith(File.separator)) { outPath += File.separator; } //zip读取压缩文件 FileInputStream fileInputStream = new FileInputStream(srcPath); ZipInputStream zipInputStream = new ZipInputStream(fileInputStream); //解压文件 decompressionFile(outPath, zipInputStream); //关闭流 zipInputStream.close(); fileInputStream.close(); } else { throw new RuntimeException("输出路径不合法!"); } } else { throw new RuntimeException("需要解压的文件不合法!"); } } /** * ZipInputStream是逐个目录进行读取,所以只需要循环 * @param outPath * @param inputStream * @throws IOException */ private static void decompressionFile(String outPath, ZipInputStream inputStream) throws IOException { //读取一个目录 ZipEntry nextEntry = inputStream.getNextEntry(); //不为空进入循环 while (nextEntry != null) { String name = nextEntry.getName(); File file = new File(outPath+name); //如果是目录,创建目录 if (name.endsWith("/")) { file.mkdir(); } else { //文件则写入具体的路径中 FileOutputStream fileOutputStream = new FileOutputStream(file); BufferedOutputStream bufferedOutputStream = new BufferedOutputStream(fileOutputStream); int n; byte[] bytes = new byte[1024]; while ((n = inputStream.read(bytes)) != -1) { bufferedOutputStream.write(bytes, 0, n); } //关闭流 bufferedOutputStream.close(); fileOutputStream.close(); } //关闭当前布姆 inputStream.closeEntry(); //读取下一个目录,作为循环条件 nextEntry = inputStream.getNextEntry(); } } 四、测试: public static void main(String[] args) throws IOException { decompressionFile("D:\\srv.zip", "D:\\test"); }

优秀的个人博客,低调大师

java之压缩流(ZipOutputStream)

一、文件压缩,是很有必要的,我们在进行文件,传输过程中,很多时候都是,都是单个文件单个文件发送接收,但是当数据量特别大,或者文件数量比较多的时候,这个时候就可以考虑文件压缩。 二、优势:文件压缩过后,只需要进行一次文件的传输就可以了。减少频繁发送的问题。缺点:文件大小会变大,如果传输过程中断了,风险较大。 三、实现: /** * 提供给用户使用的基本压缩类 * @param srcPath * @param outPath * @throws IOException */ public static void compressFile(String srcPath, String outPath) throws IOException { //读取源文件 File srcFile = new File(srcPath); //判断输出路径是否正确 File outFile = new File(outPath); //如果只是路劲加入对应的压缩名称 if (outFile.isDirectory()) { //用"/"作文判断标准 if (outPath.endsWith(File.separator)) { outPath += srcFile.getName().split("\\.")[0] + ".zip"; } else { outPath += File.separator + srcFile.getName().split("\\.")[0] + ".zip"; } } //读取文件流 FileOutputStream fileOutputStream = new FileOutputStream(outPath); ZipOutputStream zipOutputStream = new ZipOutputStream(fileOutputStream); //压缩文件 compressFile(srcFile, srcFile.getName(),zipOutputStream); //关闭流 zipOutputStream.close(); fileOutputStream.close(); } /** * 迭代方式进行文件压缩 * @param file * @param fileName * @param outputStream * @throws IOException */ private static void compressFile(File file, String fileName, final ZipOutputStream outputStream) throws IOException { //如果是目录 if (file.isDirectory()) { //创建文件夹 outputStream.putNextEntry(new ZipEntry(fileName+"/")); //迭代判断,并且加入对应文件路径 File[] files = file.listFiles(); Iterator<File> iterator = Arrays.asList(files).iterator(); while (iterator.hasNext()) { File f = iterator.next(); compressFile(f, fileName+"/"+f.getName(), outputStream); } } else { //创建文件 outputStream.putNextEntry(new ZipEntry(fileName)); //读取文件并写出 FileInputStream fileInputStream = new FileInputStream(file); BufferedInputStream bufferedInputStream = new BufferedInputStream(fileInputStream); byte[] bytes = new byte[1024]; int n; while ((n = bufferedInputStream.read(bytes)) != -1) { outputStream.write(bytes, 0, n); } //关闭流 fileInputStream.close(); bufferedInputStream.close(); } } 四、测试: public static void main(String[] args) throws IOException { compressFile("D:\\srv", "D:\\"); } 五、效果还是可以,此方式根据需要修改!

优秀的个人博客,低调大师

Java 基础 之 入门HelloWorld

http://www.verejava.com/?id=1699251664916 import java.lang.*; /** @author : 胡杨 @version : 1.0 1. //双斜杠代表注释, 是给人看的, 机器忽略不计 2. public 公有的, 是java 的关键字 3. class 叫 类, 每一个java文件里必须包含一个类 4. HelloWord 叫 类名, 类名可以跟文件名不一样, 但是规范一般写成一样 5. static 叫 静态的, main方法必须写static java 虚拟机才能找到 6. void 空 也就是没有返回值 7. main 叫主方法, 是java程序的入口, 必须这么写固定的, 否则程序不能运行. 8. String 字符串 是用双引号括起来的数字字符的一连串的组合 9. String[] 字符串数组 10. args 叫 main 方法的参数 11. System: 系统, out : 输出 println : 打印 12. 类名 后面{}部分叫做 类体 括号必须成对出现 13. 主方法main 后面 {} 部分叫做方法体 括号必须成对出现 14. import java.lang.*; 叫做 导入 java.lang下面的所有类, 但是java 默认 java.lang 下面的类已经导入, 所有 java.lang这个包也是java唯一可以省略不用导入的包. 编码规范: 1. 类名 第一个单词首字母大写, 如果有多个单词组成, 每个单词的首字母大写 2. java 是区分大小写的语言 3. 书写类体时{} 括号要成对出现 4. 书写方法体时{}括号要成对出现 5. 方法写在类体中 每个方法前面留一个 Tab 键空格 6. 方法中的执行语句 写作方法体中 每条执行语句 相对于方法前面留一个Tab 键空格, 并且每条执行语句后面都要写一个分号; 表示该条语句执行结束 */ public class HelloWorld { public static void main(String[] args) { //向控制台打印输出 Hello Word信息 然后换一行 System.out.println("Hello Word"); //向控制台打印输入信息, 但不换行 System.out.print("aaaa\t"); System.out.print("bbb"); } } http://www.verejava.com/?id=1699251664916

优秀的个人博客,低调大师

SDWebImage学习笔记之NSMapTable

NSDictionary/NSMutableArray浅析 我们在使用NSDictionary/NSMutableArray时,通常会使用NSString对象作为key,因为key必须遵循NSCopying协议,见NSMutableArray中的方法: - (void)setObject:(ObjectType)anObject forKey:(KeyType <NSCopying>)aKey; 在NSDictionary/NSMutableArray对象中,aKey对象被copy一份后存入,anObject对象则被强引用。来看一段代码: NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; { NSString *aKey = @"akey"; NSObject *aObject = [[NSObject alloc] init]; [aDictionary setObject:aObject forKey:aKey]; } NSLog(@"dictionary: %@", aDictionary); 打印日志: dictionary: { akey = "<NSObject: 0x60400001d3b0>"; } 本来作用于结束后,aKey变量指向的NSString对象(简称aKey对象)和aObject变量指向的NSObject对象(简称aObject对象)应该被自动释放,但是aDictionary变量指向的NSMutableDictionary对象(简称aDictionary对象)持有一份aObject对象的强引用,所以打印日志时,aDictionary对象不为空。 现在有一个Teacher类表示班主任信息,包含姓名name属性和年龄age属性,另有一个Student类表示学生信息,也包含姓名name属性和年龄age属性。那么一个班包含一个班主任(Teacher对象)和n个学生(Student数组),为了统计一个班的信息,需要把班主任和学生的信息及对应关系保存下来。 // Teacher.h @interface Teacher : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher @end // Student.h @interface Student : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Student.m @implementation Student @end // ViewController.m { NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; Teacher *teacher = [[Teacher alloc] init]; teacher.name = @"teacher"; teacher.age = 30; NSMutableArray *aArray = [[NSMutableArray alloc] initWithCapacity:0]; for (int i = 0; i < 3; i++) { Student *student = [[Student alloc] init]; student.name = [NSString stringWithFormat:@"student%d", i]; student.age = i; [aArray addObject:student]; } [aDictionary setObject:aArray forKey:teacher.name]; NSLog(@"%@", aDictionary); } 打印日志: dictionary:{ teacher = ( "<Student: 0x60000003aa00>", "<Student: 0x60000003a9c0>", "<Student: 0x60000003aa80>" ); } 这里将班主任的姓名作为key,这样会损失其他信息。如果想要将teacher对象作为key,则需要让Teacher类遵循NSCopying协议,而且NSDictionary/NSMutable使用hash表来实现key和value之间的映射和存储,所以作为key值的类型必须重写++- (NSUInteger)hash++和++- (BOOL)isEqual:(id)object++两个方法,其中hash方法计算该对象的hash值,hash值决定该对象在hash表中存储的位置,isEqual方法通过hash值来定位对象在hash表中的位置。具体代码如下: // Teacher.h @interface Teacher : NSObject<NSCopying> @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher - (id)copyWithZone:(NSZone *)zone { Teacher *teacher = [[Teacher allocWithZone:zone] init]; teacher.name = self.name; teacher.age = self.age; return teacher; } - (BOOL)isEqual:(id)object { // 比较hash值是否相等 return [self hash] == [object hash]; } - (NSUInteger)hash { // 调用父类的hash方法,也可以自定义 return [super hash]; } 打印日志: dictionary:{ "<Teacher: 0x600000027940>" = ( "<Student: 0x60c00022fa20>", "<Student: 0x60c00022fa00>", "<Student: 0x60c00022f960>" ); } NSMapTable浅析 NSMapTable继承自NSObject,自iOS6.0开始使用,NSMapTable是可变的。 NS_CLASS_AVAILABLE(10_5, 6_0) @interface NSMapTable<KeyType, ObjectType> : NSObject <NSCopying, NSCoding, NSFastEnumeration> NSMapTable有两个指定初始化方法和一个便捷初始化方法: // 指定初始化方法 - (instancetype)initWithKeyOptions:(NSPointerFunctionsOptions)keyOptions valueOptions:(NSPointerFunctionsOptions)valueOptions capacity:(NSUInteger)initialCapacity NS_DESIGNATED_INITIALIZER; - (instancetype)initWithKeyPointerFunctions:(NSPointerFunctions *)keyFunctions valuePointerFunctions:(NSPointerFunctions *)valueFunctions capacity:(NSUInteger)initialCapacity NS_DESIGNATED_INITIALIZER; // 便捷初始化方法 + (NSMapTable<KeyType, ObjectType> *)mapTableWithKeyOptions:(NSPointerFunctionsOptions)keyOptions valueOptions:(NSPointerFunctionsOptions)valueOptions; 初始化方法方法中有两个参数keyOptions和valueOptions,都是NSPointerFunctionsOptions类型,NSPointerFunctionsOptions是一个枚举类型, typedef NS_OPTIONS(NSUInteger, NSPointerFunctionsOptions) { // Memory options are mutually exclusive // default is strong NSPointerFunctionsStrongMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (0UL << 0), // use strong write-barrier to backing store; use GC memory on copyIn #if (TARGET_OS_MAC && !(TARGET_OS_EMBEDDED || TARGET_OS_IPHONE)) || TARGET_OS_WIN32 NSPointerFunctionsZeroingWeakMemory NS_ENUM_DEPRECATED_MAC(10_5, 10_8) = (1UL << 0), // deprecated; uses GC weak read and write barriers, and dangling pointer behavior otherwise #endif NSPointerFunctionsOpaqueMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (2UL << 0), NSPointerFunctionsMallocMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (3UL << 0), // free() will be called on removal, calloc on copyIn NSPointerFunctionsMachVirtualMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (4UL << 0), NSPointerFunctionsWeakMemory API_AVAILABLE(macos(10.8), ios(6.0), watchos(2.0), tvos(9.0)) = (5UL << 0), // uses weak read and write barriers appropriate for ARC // Personalities are mutually exclusive // default is object. As a special case, 'strong' memory used for Objects will do retain/release under non-GC NSPointerFunctionsObjectPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (0UL << 8), // use -hash and -isEqual, object description NSPointerFunctionsOpaquePersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (1UL << 8), // use shifted pointer hash and direct equality NSPointerFunctionsObjectPointerPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (2UL << 8), // use shifted pointer hash and direct equality, object description NSPointerFunctionsCStringPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (3UL << 8), // use a string hash and strcmp, description assumes UTF-8 contents; recommended for UTF-8 (or ASCII, which is a subset) only cstrings NSPointerFunctionsStructPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (4UL << 8), // use a memory hash and memcmp (using size function you must set) NSPointerFunctionsIntegerPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (5UL << 8), // use unshifted value as hash & equality NSPointerFunctionsCopyIn API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (1UL << 16), // the memory acquire function will be asked to allocate and copy items on input }; 常用的枚举值及对应的含义如下: NSPointerFunctionsStrongMemory: 强引用存储对象 NSPointerFunctionsWeakMemory: 弱引用存储对象 NSPointerFunctionsCopyIn:copy存储对象 就是说,如果NSMapTable的初始化方法为: NSMapTable *aMapTable = [[NSMapTable alloc] initWithKeyOptions:NSPointerFunctionsCopyIn valueOptions:NSPointerFunctionsStrongMemory capacity:0]; 或 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsCopyIn valueOptions:NSPointerFunctionsStrongMemory]; 那么就等同于NSMutableDictionay的初始化方法: NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; 或 NSMutableDictionary *aDictionary = [NSMutableDictionary dictionary]; 若初始方法修改为 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsWeakMemory valueOptions:NSPointerFunctionsStrongMemory]; 即对key值进行弱引用,就可以不用让Teacher类遵循NSCopying协议和重新跟hash有关的两个方法,代码如下: // Teacher.h @interface Teacher : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher @end // ViewController.m Teacher *teacher = [[Teacher alloc] init]; teacher.name = @"teacher"; teacher.age = 30;NSMutableArray *aArray = [[NSMutableArray alloc] initWithCapacity:0]; for (int i = 0; i < 3; i++) { Student *student = [[Student alloc] init]; student.name = [NSString stringWithFormat:@"student%d", i]; student.age = i; [aArray addObject:student]; } NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsWeakMemory valueOptions:NSPointerFunctionsStrongMemory]; [aMapTable setObject:aArray forKey:teacher]; NSLog(@"%@", aMapTable); 打印日志: NSMapTable { [10] <Teacher: 0x604000038a40> -> ( "<Student: 0x60400003c640>", "<Student: 0x60400003c660>", "<Student: 0x60400003c620>" ) } 这样的方法可以快速的将NSObject对象作为key存入到“字典”中。 由于NSDictionary/NSMutableArray会强引用value,使得value的引用计数+1,加入不希望怎么做,可以用NSMapTable来实现。 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsStrongMemory valueOptions:NSPointerFunctionsWeakMemory]; { NSObject *keyObject = [[NSObject alloc] init]; NSObject *valueObject = [[NSObject alloc] init]; [aMapTable setObject:valueObject forKey:keyObject]; NSLog(@"NSMapTable:%@", aMapTable); } NSLog(@"NSMapTable:%@", aMapTable); 打印日志: NSMapTable:NSMapTable { [6] <NSObject: 0x60c00000c690> -> <NSObject: 0x60c00000c730> } NSMapTable:NSMapTable { } 第一个NSLog打印出了key-value值,等到object对象指向的NSObject对象超出作用域,释放该对象,由于aMapTable弱引用object对象,aMapTable的中的key-value值会被安全的删除,第二个NSLog打印出的值为空。 NSMapTable与NSDictionary/NSMutableDictionary对比 NSDcitionary有一个可变类型NSMutableDictionary,NSMapTable没有可变类型,它本身就是可变的; NSDcitionary/NSMutableDictionary中对于key和value的内存管理方法唯一,即对key进行copy,对value进行强引用,而NSMapTable没有限制; NSDcitionary中对key值进行copy,不可改变,通常用字符串作为key值,只是key->object的映射,而NSMapTable的key是可变的对象,既可以实现key->object的映射,又可以实现object->object的映射。 遗留的问题 笔者才疏学浅,对NSMapTable与NSDictionary的内部结构了解不是很深,不清楚key-value是通过怎么样的方式绑定起来的,假如看到这篇文章的朋友有所了解,希望可以指点一二。
优秀的个人博客,低调大师

Go——小白学习之map

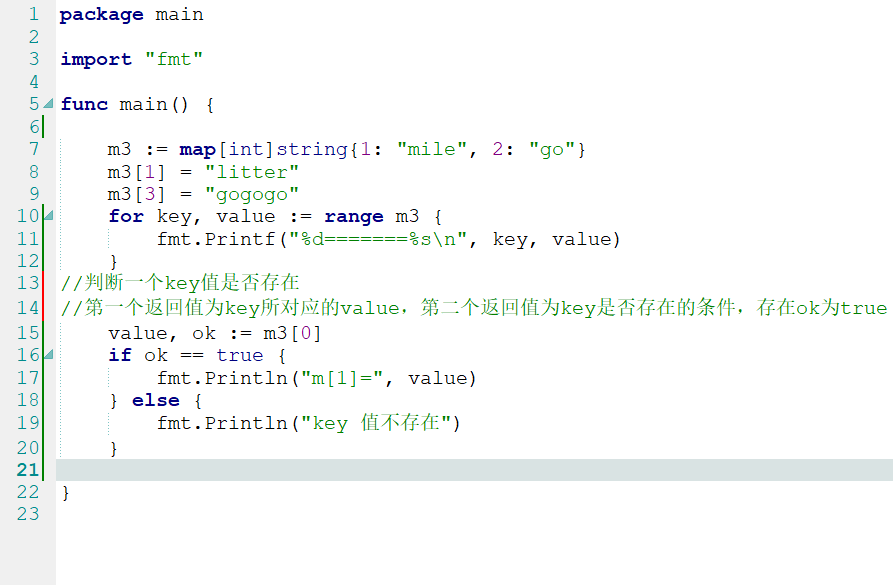
map的使用,key值唯一,打印出是无序的,注意坐标(key)与数组坐标不一样 定义: m3 := map[int]string{1: "mile", 2: "go"} m3[1] = "litter" m3[3] = "gogogo" //超出范围,错误 fmt.Println("m3=", m3) 遍历: 第一个运行结果的前提是 value OK:=m[1] range的使用,有两个返回值,在数组中也可以用到,一个是id,一个是value,id为下标,value为其对应的值,如果只想要其中一个值,可以使用 “_”

优秀的个人博客,低调大师

【NIO系列】——之TCP探秘

很开心,上半年发布的spring boot 2中,默认的web 容器是netty ,这说明“反应式” 容器已经是大势所趋,无论是go 语言的协从线程,还是java 基于reactor 线程模型,都是基于事件编程实现高并发的实例。这周开始我会讲关于NiO的一切,底层原理是什么,应用架构有哪些,如何利用其优势构建高性能服务器,欢迎关注。 在介绍NIO之前有必要了解下TCP协议,因为目前多数应用都是给予应用层进行操作,导致隐藏了大量的网路细节,知道这些细节以及原理对我们的问题排查很有益处。 一、TCP 特性 TCP 是一种面向连接的协议,它给用户进程提供可靠的全双工的字节流。确保数据包的可靠,有序,以及支持流量控制。关于TCP 为何要做这些,我们从以下几个方面入手: IP网络层为何不保证数据包的可靠性 TCP协议如何保证包可达、有序 TCP协议如

优秀的个人博客,低调大师

网络爬虫之抓取邮箱

import java.util.regex.Matcher; import java.util.regex.Pattern; /* 抓取邮箱号码 */ public class Demo7 { public static void main(String[] args) { String str = "有事没事联系:1122423@qq.com 有事没事联系:1122423@qq.com 有事没事联系:1122423@qq.com " + "有事没事联系:1122423@qq.com 有事没事联系:1122423@qq.com 有事没事联系:1122423@qq.com" + "有事没事联系:1122423@qq.com 有事没事联系:1122423@qq.com.cn 有事没事联:1122423@qq.com.cn" + "有事没事联系:1122423@163.com 有事没事联系:1122423@qq.net"; String reg = "[a-zA-Z1-9]\\w{1,11}@[a-zA-Z0-9]{2,}(\\.[a-z]{2,3}){1,2}"; /* 第一步: 先要把字符串的正则编译成Pattern对象 */ Pattern p = Pattern.compile(reg); /* 第二步: 把正则对象匹配字符串对象得到一个匹配器 */ Matcher m = p.matcher(str); while(m.find()){ System.out.println(m.group()); } } }

优秀的个人博客,低调大师

jQuery之validate验证表单

访问jQuery validate官网下载最新插件 https://jqueryvalidation.org/ validate是用来验证表单的 以前我们都是用js手动验证 现在可以通过这个插件直接调用别人写好的方法 更加简单方便 validate.js是建立在jquery之上的,所以得先导入jquery的类库 我是下载到本地了的jQuery和validate 然后直接引用 <script type="text/javascript" src="../../js/jquery-1.8.3.js"></script> <script type="text/javascript" src="../../js/jquery.validate.min.js"></script> validate主要有三步操作 1. 表单.validate()表示调用该插件 2. rules:定义规则 操作对象是表单内元素 3. messages:当违反规则的时候提示错误 操作对象是表单内元素 完整的: <!DOCTYPE html> <html> <head> <script type="text/javascript" src="../../js/jquery-1.8.3.js" ></script> <!--validate.js是建立在jquery之上的,所以得先导入jquery的类库--> <script type="text/javascript" src="../../js/jquery.validate.min.js" ></script> <script> $(function(){ $("#checkForm").validate({ rules:{ username:{ required:true, minlength:6 }, password:{ required:true, digits:true, minlength:6 } }, messages:{ username:{ required:"用户名不能为空!", minlength:"用户名不得少于6位!" }, password:{ required:"密码不能为空!", digits:"密码必须是整数!", minlength:"密码不得少于6位!" } } }); }); </script> </head> <body> <form action="#" id="checkForm"> 用户名:<input type="text" name="username" /><br /> 密码:<input type="password" name="password"/><br /> <input type="submit"/> </form> </body> </html> 效果图: 规则其实更多 : 可以参考 1 required:true 必须输入的字段。 2 remote:"check.php" 使用 ajax 方法调用 check.php 验证输入值。 3 email:true 必须输入正确格式的电子邮件。 4 url:true 必须输入正确格式的网址。 5 date:true 必须输入正确格式的日期。日期校验 ie6 出错,慎用。 6 dateISO:true 必须输入正确格式的日期(ISO),例如:2009-06-23,1998/01/22。只验证格式,不验证有效性。 7 number:true 必须输入合法的数字(负数,小数)。 8 digits:true 必须输入整数。 9 creditcard: 必须输入合法的信用卡号。 10 equalTo:"#field" 输入值必须和 #field 相同。 11 accept: 输入拥有合法后缀名的字符串(上传文件的后缀)。 12 maxlength:5 输入长度最多是 5 的字符串(汉字算一个字符)。 13 minlength:10 输入长度最小是 10 的字符串(汉字算一个字符)。 14 rangelength:[5,10] 输入长度必须介于 5 和 10 之间的字符串(汉字算一个字符)。 15 range:[5,10] 输入值必须介于 5 和 10 之间。 16 max:5 输入值不能大于 5。 17 min:10 输入值不能小于 10。

优秀的个人博客,低调大师

Unity 之命名规范(一)

一个优良的架构,个人认为不仅仅体现在设计的思想结构上,代码的命名规范也是至关重要的,一段的优雅的代码会让人看着赏心悦目,一个结构混乱,命名随意的代码会让人狂抓,尤其是在项目交接的时候,如果项目属于后者,那我只能说祝你好运了~ 微软的C#是结合众多开发者心血的结晶,但是C# 的命名看上去貌似就是一个人写的,每一行代码都遵循相同的准则。所以说,一个实力出众的公司都这么做,那么自己还有什么理由乱写呢?编写的代码,不仅仅是自己查阅修改,别人也能会来查阅、学习,本着互联网精神,我们更应该严格要求自己,让代码规范深深的烙印在我们潜意识中~ 最近也读到一篇文章 浅谈软件工程师的代码素养,【素养】这个词个人感觉在恰到不过了,素养二字不仅仅体现对技能的要求,又体现出一个软件工程师对自身的高标准和完美代码的追求(虽然这个世界上不存在完美的事情)~ 因为Unity 2018.1 :停止对MonoDevelop-Unity的支持,所以下面谈到的命名方式是以微软官方的命名方式为参考 相关地址 https://docs.microsoft.com/zh-cn/dotnet/standard/design-guidelines/index https://msdn.microsoft.com/zh-cn/library/ms229002%28VS.80%29.aspx http://www.dofactory.com/reference/csharp-coding-standards https://blogs.msdn.microsoft.com/brada/2005/01/26/internal-coding-guidelines 有错误或者不准确的地方欢迎留言指正 风格指南 Tabs&缩进 Tab 字符(\0x09) 不应在代码中使用。所有缩进应该用4个空格字符完成。(换句话说,一个Tab键的缩进应该用4个空格来代替) Bracing 打开花括号总是应该在开始块的语句后面的行首。大括号内容应缩进4个空格。例如: if (SomeExpression) { DoSomething(); } else { DoSomethingElse(); } case”语句应该像switch语句一样缩进: switch (SomeNumber) { case 0: DoSomething(); break; case 1: DoSomethingElse(); break; case 2: { int n = 1; DoAnotherThing(n); } break; } 大括号永远不应被视为可选项。即使对于单个语句块,您也应该始终使用大括号。这增加了代码的可读性和可维护性。(换句话说:就算一行函数也给老子加上大括号!!!) for (int i=0; i<100; i++) { DoSomething(i); } 单行语句 单行语句可以有在同一条线上开始和结束的括号。 public class Foo { int bar; public int Bar { get { return bar; } set { bar = value; } } } 据建议,所有的控制结构(if, while, for, etc)使用大括号,但它不是必需的。 评论 评论应该用来描述意图,算法概述和/或逻辑流程。 如果仅通过阅读评论,作者以外的人可以理解功能的预期行为和一般操作,那将是理想的。虽然没有最低评论要求,当然也有一些非常小的程序根本不需要评论,但希望大多数程序都会有反映程序员意图和方法的评论。(就是说说这些函数干什么的,为什么这么写,当时怎么想的) 版权声明 每个文件都应以版权声明开始。为了避免文档评论构建中出现错误,您不希望使用三斜杠文档评论,但使用XML可以使评论容易在未来取代。最终文本将因产品而异(您应该联系法律确切的文字),但应该类似于: //----------------------------------------------------------------------- // <copyright file="ContainerControl.cs" company="Microsoft"> // Copyright (c) Microsoft Corporation. All rights reserved. // </copyright> //----------------------------------------------------------------------- 文件评论 (可以理解为代码注释) 所有方法都应该使用XML文档注释。对于内部开发者评论,应该使用<devdoc>标签 public class Foo { /// <summary>Public stuff about the method</summary> /// <param name=”bar”>What a neat parameter!</param> /// <devdoc>Cool internal stuff!</devdoc> /// public void MyMethod(int bar) { … } } UNDONE§有一个大文档,里面有我们应该使用的所有评论标签......那是哪里? 评论风格 该//注释标记(两个斜杠)风格应该在大多数情况下使用。在可能的情况下,将注释放在代码上方而不是旁边。 这里有些例子: //这是WebClient通过代理工作所必需的 GlobalProxySelection.Select = new WebProxy("http://itgproxy"); //创建访问Internet资源的对象 WebClient myClient = new WebClient(); 当空间允许时,注释可以放在行的末尾 public class SomethingUseful { private int itemHash; // instance member private static bool hasDoneSomething; // static member } 间距 空间通过减少代码密度来提高可读性。以下是在代码中使用空格字符的一些准则: 请在函数参数之间逗号后使用单个空格。 Right: Console.In.Read(myChar, 0, 1); Wrong: Console.In.Read(myChar,0,1); 不要在圆括号和函数参数后面使用空格 Right: CreateFoo(myChar, 0, 1) Wrong: CreateFoo( myChar, 0, 1 ) 不要在函数名称和括号之间使用空格。 Right: CreateFoo() Wrong: CreateFoo () 不要在括号内使用空格 Right: x = dataArray[index]; Wrong: x = dataArray[ index ]; 在流控制语句之前使用单个空格 Right: while (x == y) Wrong: while(x==y) 在比较运算符之前和之后使用单个空格 Right: if (x == y) Wrong: if (x==y) 命名 遵循内部和外部成员的所有.NET Framework设计指南。其中的要点包括: 不要使用匈牙利符号 不要为成员变量(,m,s_等)使用前缀。如果你想区分本地变量和成员变量,你应该在C#中使用“this。”和“me。“在VB.NET中 请使用成员变量驼峰规则 请使用camelCasing作为参数 请使用局部变量驼峰规则 请使用PascalCasing的函数,属性,事件和类名 接口名称前缀加“I” 不要在枚举,类或委托前加任何字母 扩展公共规则(没有匈牙利语,没有成员变量的前缀等)的原因是产生一致的源代码外观。另外一个目标是拥有干净可读的来源。代码可读性应该是主要目标。 命名约定 Interop类 Interop包装器(DllImport语句)的类应遵循下面的命名约定: NativeMethods 不抑制非托管代码属性,这些方法可以在任何地方使用,因为将执行堆栈审核。 UnsafeNativeMethods 禁止非托管代码属性。这些方法具有潜在的危险性,任何这些方法的调用者都必须进行全面的安全检查,以确保使用安全并受到保护,因为不会执行堆栈审核。 SafeNativeMethods 禁止非托管代码属性。这些方法是安全的,并且可以相当安全地使用,即使不执行堆栈审核,调用者也不需要进行全面的安全性评估 class NativeMethods { private NativeMethods() {} [DllImport(“user32”)] internal static extern void FormatHardDrive(string driveName); } [SuppressUnmanagedCode] class UnsafeNativeMethods { private UnsafeNativeMethods() {} [DllImport(“user32”)] internal static extern void CreateFile(string fileName); } [SuppressUnmanagedCode] class SafeNativeMethods { private SafeNativeMethods() {} [DllImport(“user32”)] internal static extern void MessageBox(string text); } 所有互操作类必须是私有的,所有方法都必须是内部的。另外应该提供一个私有构造函数来防止实例化。 文件组织 源文件应该只包含一个公共类型,尽管允许多个内部类 源文件应该被赋予文件中公共类的名称 目录名称应该遵循该类的命名空间 例如,我期望在"System\Windows\Forms\Control.cs"找到公共类“System.Windows.Forms.Control” 类成员应该按照字母顺序排列,并分组成部分(字段,构造函数,属性,事件,方法,专用接口实现,嵌套类型) using语句应该在名称空间声明中 namespace MyNamespace { using System; public class MyClass : IFoo { // fields int foo; // constructors public MyClass() { … } // properties public int Foo { get { … } set { … } } // events public event EventHandler FooChanged { add { … } remove { … } } // methods void DoSomething() { … } void FindSomethind() { … } //private interface implementations void IFoo.DoSomething() { DoSomething(); } // nested types class NestedType { … } } }

优秀的个人博客,低调大师

Python之合并PDF文件

在日常的学习生活工作中,我们有时会遇到需要合并PDF文件的需求。这时,我们可以利用相关的PDF软件(如Adobe Acrobat Reader DC)来完成这个任务,幸运的是,Python也为我们提供了这方面的处理模块PyPDF2, 借用它,我们可以利用Python代码来很好地完成这项任务。 PyPDF2模块的相关参考文档网址为:https://pythonhosted.org/PyPDF2/ . 本文将介绍如何利用PyPDF2来完成PDF文件的合并。 首先我们在E盘的Cheats文件夹下有如下的PDF文件: 我们的Python代码完整如下: # -*- coding:utf-8*- # 利用PyPDF2模块合并同一文件夹下的所有PDF文件 # 只需修改存放PDF文件的文件夹变量:file_dir 和 输出文件名变量: outfile import os from PyPDF2 import PdfFileReader, PdfFileWriter import time # 使用os模块的walk函数,搜索出指定目录下的全部PDF文件 # 获取同一目录下的所有PDF文件的绝对路径 def getFileName(filedir): file_list = [os.path.join(root, filespath) \ for root, dirs, files in os.walk(filedir) \ for filespath in files \ if str(filespath).endswith('pdf') ] return file_list if file_list else [] # 合并同一目录下的所有PDF文件 def MergePDF(filepath, outfile): output = PdfFileWriter() outputPages = 0 pdf_fileName = getFileName(filepath) if pdf_fileName: for pdf_file in pdf_fileName: print("路径:%s"%pdf_file) # 读取源PDF文件 input = PdfFileReader(open(pdf_file, "rb")) # 获得源PDF文件中页面总数 pageCount = input.getNumPages() outputPages += pageCount print("页数:%d"%pageCount) # 分别将page添加到输出output中 for iPage in range(pageCount): output.addPage(input.getPage(iPage)) print("合并后的总页数:%d."%outputPages) # 写入到目标PDF文件 outputStream = open(os.path.join(filepath, outfile), "wb") output.write(outputStream) outputStream.close() print("PDF文件合并完成!") else: print("没有可以合并的PDF文件!") # 主函数 def main(): time1 = time.time() file_dir = r'E:\Cheats' # 存放PDF的原文件夹 outfile = "Cheat_Sheets.pdf" # 输出的PDF文件的名称 MergePDF(file_dir, outfile) time2 = time.time() print('总共耗时:%s s.' %(time2 - time1)) main() 运行上述Python代码,则会在同一目录下生成Cheat_Sheets.pdf文件,如下: 本次分享到此结束,欢迎代价交流~~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册