首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

我要做 Android 之Fragment

Q:谈一谈Fragment的生命周期? 一:首先说说时间节点:Fragment 是在 Android3.0+ 以后,Android 新增了 Fragments,在没有 Fragment 之前。一个屏幕只能放一个 Activity。这是一个起源时间大家什么时候引入。(ps:为了屏幕适配的原因翻译为碎片) Fragment 概要 学习 Fragment 的时候可以联系之前学习过的 Activity ,因为它们有很多相似点:都可包含布局,有自己的生命周期,Fragment 可看似迷你活动。正如 Fragment 的名字--碎片,它的出现是为了解决 Android 碎片化 ,它可作为Activity 界面的组成部分,可在 Activity 运行中实现动态地加入、移除和交换。一个 Activity 中可同时出现多个Fragment,一个 Fragment 也可在多个 Activity 中使用。 Activity 代表了一个屏幕的主体,而 Fragment 可以作为 Activity 的一个组成元素。 一个 Activity 可以有若干个(0或n)Fragment 构成。你可以把 Fragment 想象成 Activity 中的一个控件,只不过相对于一般控件,Fragment 与 Activity 联系更为紧密,随着 Activity 的生命周期变化,Fragment 也随之相应不同的生命周期函数。 Fragment 从功能上讲相当于一个子活动(Activity),它可以让多个活动放到同一个屏幕上,也就是对用户界面和功能的重用,因为对于大屏设备来说,纯粹的 Activity 有些力不从心。 fr01.png 2.Fragment生命周期 先来看官方文档提供的有关Fragment生命周期的图片。 fr02.png 由上图可以发现 Fragment 和 Activity 的生命周期很相似,可以说大致周期的情况是基本相同的。现在只需要在介绍几个 Activity 中没有讲过的新方法。 onAttach(): 当 Fragment 和 Activity 建立关联的时候调用 onCreateView() : 当 Fragment 创建视图的时候调用 onActivityCreated(): 当与 Fragment 相关联的 Activity 完成 onCreate() 之后调用 onDestoryView(): 当 Fragment 中的布局被移除的时候调用 onDetach(): 当 Fragment 和 Activity 解除关联的时候调用 所以根据 Activity 的周期方法我们可以大致判断周期画面 (1)打开页面的时候 onCreate -> onCreateView -> onActivityCreated -> onStart -> onResume (2)按下主屏幕键 onPause -> onStop (3)重新打开界面 onStart -> onResume (4)按后退键 onPause -> onStop -> onDestroyView -> onDestroy -> onDetach 加载到 Activity 中的 Fragment 在各种变化下方法的调用顺序更值得注意。需要提一句的是,Activity 的 FragmentManager 负责调用队列中 Fragment 的生命周期方法,只要 Fragment 的状态与 Activity 的状态保持了同步,托管 Activity 的 FragmentManager 便会继续调用其他生命周期方法以继续保持 Fragment 与 Activity 的状态一致。 注意注意注意 当 Activity 加入 Fragment (1)打开界面 Fragment onCreate() -> Fragment onCreateView() -> Activity onCreate() -> Fragment onActivityCreated() -> Activity onStart() -> Fragment onStart() -> Activity onResume() -> Fragment onResume() (2)按下主屏幕键 Fragment onPause() -> Activity onPause() -> Fragment onStop() -> Activity onStop() (3)重新打开界面 Activity onRestart() -> onActivity start() -> Fragment onStart() -> Activity onResume() -> Fragment onResume() (4)按后退键退出 Fragment onPause() -> Activity onPause() -> Fragment onStop() -> Activity onStop() -> Fragment onDestroyView() -> Fragment onDestroy() -> Fragment onDetach() -> Activity onDestroy() Fragment 生命周期与 Activity 生命周期的一个关键区别在于,Fragment 的生命周期方法是由托管 Activity 而不是操作系统调用的。 Activity 中生命周期方法都是 protected,而 Fragment 都是 public,也能印证了这一点,因为 Activity 需要调用 Fragment 那些方法并管理它。 三:加载 Fragment 方法 现在就来学习如何在 Activity 中加载 Fragment (1)静态加载:在托管 Activity 的 layout 文件中声明 Fragment 静态加载 Fragment 大致过程分为四步: fr03.png 我会在下方给出一个 demo 让大家感受以下 (ps:一定要自己动手写一遍,感受和看的真的不一样,会给你带来肌肉记忆。) 第一:新建一个 frag_layout.xml 布局,这是 Fragment 的布局,这里就只有一个显示 TextView 和 Button。 fr04.png 第二:新建一个 MyFragment 类并继承 Fragment,这里引用 v4 下的包,具有兼容性。顺便提一下,正常我们引入包的时候都用 v4 或者 v7 下的包,这里的包都是向下兼容,否则可能会出现意想不到的问题。我们在这里重写 onCreateView()方法,这个方法里通过 LayoutInflate 的 inflate() 方法将刚定义的 frag_layout 布局加载进来并得到一个 View,在 return 这个 view 就 OK。 fr07.png 第三:在 main_xml 布局中修改,使用 < fragment > 标签来添加碎片,并且切记切记要加上 android:name 属性。之后会有自动提示,加载的完整形式是 包名.类名 fr08.png 第四步:在 MainActivity 中加载main布局。现在MyFragment就完成了静态加载到 MainActivity 中,这时碎片里的控件自然也是活动的一个部分,可直接在活动中获取到 Button 的实例,来注册点击事件了。 fr09.png 看下运行结果: fr06.png second:动态加载:在托管 Activity 通过代码动态添加 动态加载的代码也非常简单,直接看例子。修改main.xml,将整个< fragment >删掉。但还保留一个LinerLayout的空间并且还给了 Id,为何这样做?马上揭秘。 fr11.png 接下来在MainActivity中添加几行代码: fr10.png 可将整个过程大致分为三个步骤: 第一步,先用 getFragmentManager() 方法获取一个FragmentManager对象,再通过它的 beginTransaction() 获取一个FragmentTransaction的实例。 第二步,用beginTransaction. add() 方法将MyFragemnt实例添加到main布局里LinearLayout里,终于知道之前铺垫的Id是怎么回事了。一定要注意,add()方法里的第一个参数是容器视图资源Id,而不是layout。容器视图资源Id有两个作用:告知FragmentManager,碎片视图应该出现在活动视图的什么地方;它也是FragmentManager队列中碎片的唯一标识符。而静态加载时碎片的唯一标识符正是在活动布局里< fragment>下的id。 第三步:调用beginTransaction. commit() 提交。另外,如果允许用户通过按下返回按键返回到前一个Fragment状态,在调用commit()之前先调用 addToBackStack(true) 方法。 这里注意到动态加载进来的Fragment里的控件并不能直接在活动中findViewById得到,那么如何实现点击效果呢,学完下一个知识点就有办法了。 Fragment 与 Activity 之间的通信 在活动中可以通过调用 FragmentManager 的 findFragmentById() 方法来得到相应碎片的实例,继而可以调用碎片里的方法。以上面demo举例,如果想得到静态加载碎片的实例,可在MainActivity添加代码如下: MyFragment myFragment = (MyFragment) getFragmentManager(). findFragmentById(R.id.fragment); 如果想得到动态加载碎片的实例,代码如下: MyFragment myFragment = (MyFragment)fragmentManager(). findFragmentById(R.id.layout); 在碎片中也可以通过调用getActivity()方法来得到和当前碎片相关联的活动实例,这样调用活动里的方法就变得轻而易举了。比如想在MyFragment得到MainActivity的实例: MainActivity activity = (MainActivity)getActivity(); 于是碎片和活动可以很方便地进行通信了。再想一想碎片和碎片之间如何进行通信?先在一个碎片中可以得到与它相关联的活动,然后再通过这个活动去获取另外一个碎片的实例,这样实现了不同碎片之间的通信了。 fr12.png 只要这样我们就有能够正常的使用了。 就我个人而言,正常 APP 中都是一个 Activity 带几个 Fragment,所以这时候我们需要通过适配器来实现。实现之后每一个 Fragment 对应的操作依然在各自的 Fragment 中来实现。而不是在 Activity 中。

优秀的个人博客,低调大师

Android 冷兵器 之 tools

前言 Android开发在所难免的就是UI的预览和调整,一般情况下都是直接run看效果,或者是使用AS的preview预览,但这同样带来个小问题,就是你的测试内容会跟随着代码被打包到apk中,如果没做容错的处理很有可能将测试内容展示给用户。 还有就是像一些列表是不支持预览效果的,比如ListView。 其实Android老早就有tools命名空间,作为一个开发快到一年的我,最近看到一篇文章才发现这个tools大用处,在此做个笔记。 直接看一下效果,最为清楚: XML中的代码区区几行,但是右侧的preview效果却很直接,还有就是这些数据并不会打到apk中,直接运行是没有任何效果的,这就是厉害之处!相关代码已提交到Github上: https://github.com/xiaweizi/AndroidToolsExample Android Tools 初步使用 既然是命名空间,那肯定就要在XML开头就要声明。 xmlns:tools="http://schemas.android.com/tools" 类似于 xmlns:android="http://schemas.android.com/apk/res/android" 然后就可以使用tools的相关属性了。属性功能很多很全,我就介绍一下常用的,文尾会贴上相关的文章链接。 View 相关 先从view相关说起,在XML中view的android任意属性值,可以直接替换成tools,这样就可以实现实时的预览效果,并且正式部署之后不会展示。有点类似于dataBinding中的default属性,以TextView为例。 //1. 原生 android:text="test text" //2. databinding android:text='@{viewModel.content, default="test text"}' //3. tools tools:text="test text" preview的效果是一样的,不过除了 1 以外,其他运行效果是根据代码中设置的内容决定的,真正做到了测试预览。 之前也说了,view的其他属性它都支持。 context 通过 tools:context="com.xiaweizi.androidtoolsexample.CommonActivity" 的方式在根部局引用,主要的作用声明该布局文件默认关联的Activity,引号传Activity类的完整包名。随之就可以开启一些与其相关的特性。比如日常点击事件中,就可以直接在XML中声明onClick的方法名,然后会有错误的lint提示,需要你在Activity中创建改方法,跟随着AS的智能指引,便可创建对应的方法。点击事件的处理便可以放在里面。 showIn tools:showIn="@layout/activity_other" 在使用include或者merge时,内层布局是预览不到外层的布局的。那通过showIn链接到外层布局,就可以直接连同外层布局一同展示出来。 layout 同样在XML中引用fragment布局也是预览不到效果的: 那通过: <fragment android:id="@+id/fragment" android:name="com.xiaweizi.androidtoolsexample.CommonFragment" android:layout_width="match_parent" android:layout_height="match_parent" tools:layout="@layout/layout_fragment_test" /> 的方式即可达到预览的效果。 进阶使用 tools除去上面的功能,更强大的在于支持列表的预览展示,也就是文章开头预览的效果,效果最明显的就是ListView。 ListView ListView 预览 // 1. 列表内容的布局 tools:listitem="@layout/list_content" // 2. 头布局的预览展示 tools:listheader="@layout/list_header" // 3. 脚布局的预览展示 tools:listfooter="@layout/list_footer" 一开始使用的时候发现不生效,后来发现需要给ListView设置id,就会立刻生效了。 GridView 同样也适用于GridView。 RecyclerView 说到RecyclerView一开始我以为只支持itemCount的设置,后来多谢以为小伙伴提的https://github.com/xiaweizi/AndroidToolsExample/issues/1 AndroidToolsExample/issues/1,我才发现可以支持复杂的列表展示! // 1. 设置展示 item 的数量 tools:itemCount="6" // 2. 设置布局方式 三种模式可以选择 // GridLayoutManager // LinearLayoutManager // StaggeredGridLayoutManager tools:layoutManager="GridLayoutManager" // 3. item 的布局 tools:listitem="@layout/list_content" // 4 设置布局的方向 tools:orientation="horizontal" // 5. 设置布局横、纵的列数 tools:spanCount="2" sample 有人会好奇列表的数据哪来的,没看你设置,竟然能做到每条数据都不一样。客官别急,接下来就是介绍一下@tools:sample/*的强大功能,作为预览视图的占位数据。看一看官网的使用介绍。 各种类型的数据都支持构造,这里我以例子作为展示: 每次使用,都会随机的更换不同的值,详情参见列表展示数据。 你以为这样就结束了吗?too young!除去原生给的数据支持,咱们也可以自己构造假的数据。 直接可以创建sample data,然后就可以创建文本或者json数据。如果是json数据,你必须先运行一下才能使用。那看一下如何使用。 先创建json数据: { "data": [ { "name": "张三", "phone": "@tools:sample/us_phones", "time": "@tools:sample/date/hhmmss", "avatar": "@tools:sample/avatars" }, { "name": "李四", "phone": "@tools:sample/us_phones", "time": "@tools:sample/date/hhmmss", "avatar": "@tools:sample/avatars" }, { "name": "赵五", "phone": "@tools:sample/us_phones", "time": "@tools:sample/date/hhmmss", "avatar": "@tools:sample/avatars" }, { "name": "王二麻", "phone": "@tools:sample/us_phones", "time": "@tools:sample/date/hhmmss", "avatar": "@tools:sample/avatars" } ] } 然后直接在XML中,通过@sample/的方式拿到数据。 使用和预览正如上图所示。 总结 Get了该技能,不说有多大用处吧,至少可以提高开发效率,和减少把测试代码部署到线上的失误率吧,相信会帮助到你的! 原文发布时间为:2018-09-6 本文作者:下位子 本文来自云栖社区合作伙伴“安卓巴士Android开发者门户”,了解相关信息可以关注“安卓巴士Android开发者门户”。

优秀的个人博客,低调大师

我要做 Android 之 Activity

1 说下 Activity 的生命周期 为了巩固所学知识点,为自己找工作做准备,一是为了能分享给更多的人,所以从已经拿了6家 offer 的小姐姐 https://www.jianshu.com/u/203b606b956c 博客里抓来了这些面试题目赶紧复(预)习一下。 首先说下 Activity 生命周期的回掉方法 ·//创建Activity public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); } //Activity快要变成可见的 @Override protected void onStart() { super.onStart(); } //Activity变成可见的,处于运行状态 @Override protected void onResume() { super.onResume(); } //其他Activity获得用户焦点,(Activity快要暂停了) @Override protected void onPause() { super.onPause(); } //Activity不再可见,处于停止状态 @Override protected void onStop() { super.onStop(); } //Activity快要被销毁了 @Override protected void onDestroy() { super.onDestroy(); } 相信很多小伙伴对这些方法都比较熟悉,只是如果问的再详细一点呢?更详细一点呢?你还会比较熟悉吗?我的答案是不熟悉,相信很多小伙伴都有感觉,忘记的时候直接去查不就好了,但是面试官可不管啊童鞋们。面试大佬们一看这都不会,回去等通知吧。。。 这里我们可以看到 Activity 生命周期中的三个嵌套循环:(什么,三个,我怎么只看到一个,,,) 一:Activity 的 全部生命周期 发生在调用 onCreate() 和 调用 onDestory() 之间。在 onCreate() 方法中执行全局状态的建立(例如定义布局),在 onDestroy() 方法中释放所有保存的资源。 二:Activity 的 可见生命周期 发生在调用 onStart() 和 onStop() 之间。在这个期间,用户能在屏幕上看见 Activity,和它进行交互。系统在 Activity 的完整寿命中可能多次调用 onStart() 和 onStop(), 正如 Activity 交替地对用户可见或隐藏。 三:Activity 的 前台生命期 发生在调用 onResume() 和 onPause() 之间。在这期间,Activity 在屏幕上所有其他 Activity 的前面,有用户输入焦点。一个 Activity 能频繁的在前台进入和出去之间转变。 看下图(其实估计很多同学都看过,看烂了,没办法,图片虐我千百遍,我待图片如初恋) andr01.png 我们书写两个 Activity,只有简单的显示功能 public class MainActivity extends AppCompatActivity { private Button btn_Second; private static final String TAG = "ActivityTest"; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); Log.d(TAG, "MainActivity onCreate"); btn_Second = findViewById(R.id.btn_second); btn_Second.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View v) { Intent intent = new Intent(MainActivity.this, SecondActivity.class); startActivity(intent); } }); } @Override protected void onStart() { Log.d(TAG, "MainActivity onStart"); super.onStart(); } @Override protected void onResume() { Log.d(TAG, "MainActivity onResume"); super.onResume(); } @Override protected void onPause() { Log.d(TAG, "MainActivity onPause"); super.onPause(); } @Override protected void onStop() { Log.d(TAG, "MainActivity onStop"); super.onStop(); } @Override protected void onDestroy() { Log.d(TAG, "MainActivity onDestroy"); super.onDestroy(); } } SecondActivity public class SecondActivity extends AppCompatActivity { private static final String TAG = "SecondActivity"; @Override protected void onCreate(@Nullable Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_second); Log.d(TAG, "SecondActivity onCreate"); } @Override protected void onStart() { Log.d(TAG, "MainActivity onStart"); super.onStart(); } @Override protected void onResume() { Log.d(TAG, "MainActivity onResume"); super.onResume(); } @Override protected void onPause() { Log.d(TAG, "MainActivity onPause"); super.onPause(); } @Override protected void onStop() { Log.d(TAG, "MainActivity onStop"); super.onStop(); } @Override protected void onDestroy() { Log.d(TAG, "MainActivity onDestroy"); super.onDestroy(); } } 1 运行后的打印结果 andr02.png 点击按钮之后的截图 andr03.png 大家可以看到,生命周期的执行顺序,首先调用 MainActivity 的 pause 方法,之后是 SecondActivity 的正常创建显示,和上一个图顺序相同。等 SecondActivity 完全显示之后,会调用 MainActivity 的 stop 方法,表示该 Activity 停止活动。 ps:这是正常的活动跳转调用。 那如果不正常呢? 2 比如点击弹出的不是一个 Activity,二是一个 dialog。把 theme 改成这样: andr06.png 运行结果是这样: andr04.png 可以发现此时 MainActivity 完全可见,所以此时的执行周期是怎样的呢? andr05.png 点击跳转之后只是执行了 MainActivity 方法,而没有执行 onStop 方法。记住,划重点啊朋友们。 3 若将SecondActivity改为不是Dialog,把上图中的 theme 这一行删掉即可。再点击跳转按钮: 依次调用了它的回调方法: onPause()->onStop() 4 当 Activity 处于运行状态的时候点击返回按钮, andr07.png 点击返回按钮,Activity由运行状态变为死亡状态,依次调用它的回调方法:onPause() -> onStop() -> onDestroy() 5 当 Activity 处于运行状态的时候,点击 home 键直接返回桌面 andr08.png Activity由运行状态变为停止状态,依次调用它的回调方法:onPause()->onStop() 6:Activity处于运行状态,旋转屏幕: andr09.png 可以看出,旋转屏幕是一个销毁Activity然后重新创建Activity的过程。运行->暂停->停止->死亡->运行依次调用回调方法: onPause() -> onStop -> onDestroy() -> onCreate() -> onStart() -> onResume() Activity处于运行状态,手机此时锁屏。 手机锁屏,此时由于Activity不可见,会进入停止状态。依次调用回调方法:onPause()->onStop() 8.当应用正在运行时,手机锁屏,然后解锁回到应用界面。应用从停止状态恢复到运行状态。依次调用回调方法:onRestart() -> onStart() -> onResume();注意此时是 onRestart 方法 看看我们这篇文章解决了几个问题? Q:说下Activity的生命周期? Q:onStart()和onResume()/onPause()和onStop()的区别? Q:Activity A启动另一个Activity B会回调哪些方法?如果Activity B是完全透明呢?如果启动的是一个Dialog呢? Activity1启动的时候 Activity1(onCreate)--->Activity1(onStart)--->Activity1(onResume) Activity1跳转到Activity2的时候(2完全覆盖了1) Activity1 (onPause)---> Activity1(onStop) Activity2(onCreate)--->Activity2(onStart)--->Activity2(onResume) 特殊: 如果2是透明的窗体或者对话框样式的主题,那么1就不会调用onStop方法; 如果1已经存在该Activity的栈中,则不会调用onCreate方法。 呐,我在最后列出了问题,也给出了总结和补充,欢迎小伙伴们留言。 愿我们成为真实的自己。

优秀的个人博客,低调大师

Flutter快速上车之Widget

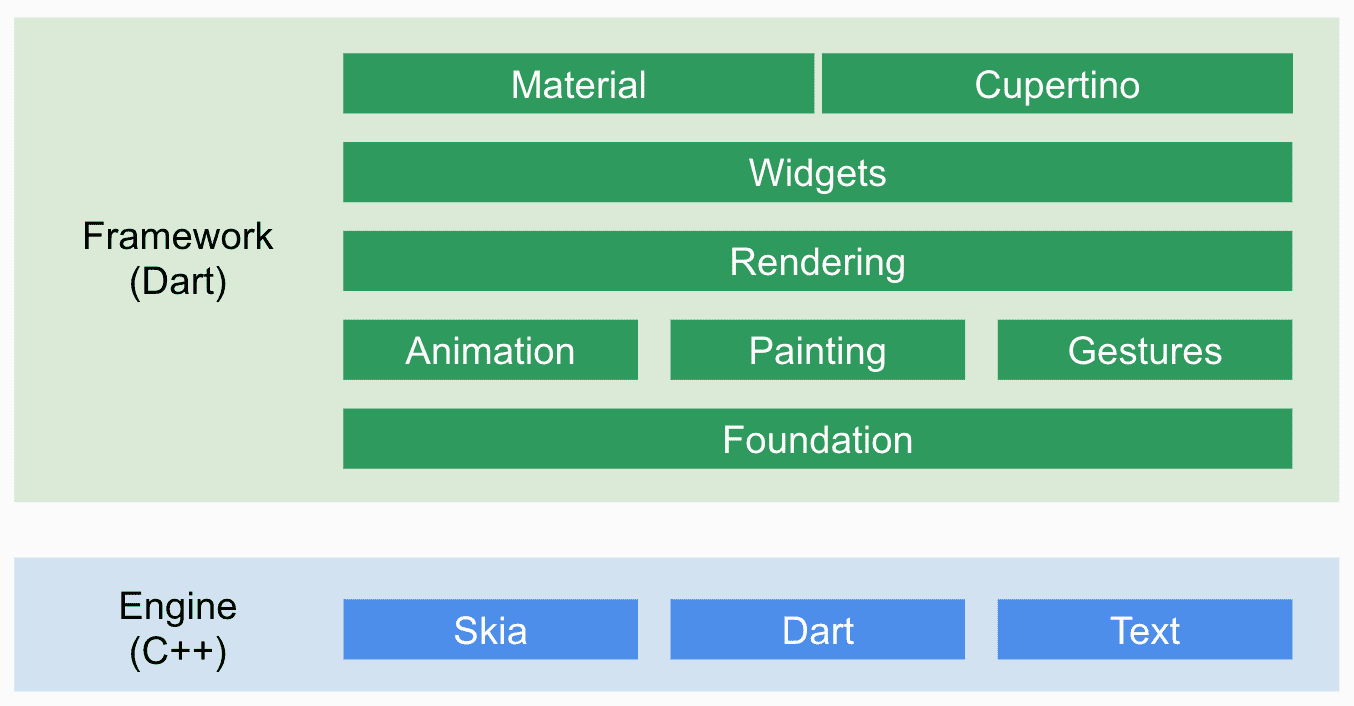
作者:闲鱼技术-意境 Flutter作为一种全新的响应式,跨平台,高性能的移动开发框架。从开源以来,已经得到越来越多开发者的喜爱。闲鱼是最早一批与谷歌展开合作,并在重要的商品详情页中使用上线的公司。一路走来,积累了大量的开发经验。虽然越来越多的技术大牛在flutter世界中弄得风声水起,但是肯定有很多的flutter小白希望能快速上手,享受flutter编程的乐趣。本文就是面向刚刚踏上futter的同学,从Flutter体系中最基本的一个概念widget入手学习Flutter。希望能助力每一位初学者。 可能大家要问的第一个问题是为什么从Widget开始? 从flutter的架构图中不难看出widget是整个视图描述的基础。Flutter 的核心设计思想便是 Everything’s a Widget 即一切即Widget。在flutter的

优秀的个人博客,低调大师

GO------小白之redis

redis 是一个开源的、使用c编写的支持网络交互的、科技与内存也可持久化的key-value数据库 go getgithub.com/garyburd/redigo 利用redis.Dail进行监听、返回一个连接器、可以使用go的类型断言将返回的interface转为对应的类型 可以利用pipe操作并发操作 可以进行发布订阅 事物操作 mysql和redis的区别: MySQL的数据存储在data目录下frm ibd后缀的文件中、存储在机器/服务器的硬盘中、所以MySQL读写数据都需要从硬盘读取、磁盘的容量、带宽的大小就影响了网站的访问速度、读取的方式、也就是sql语句、次数和效率也会影响读取效率 当访问量和并发都很大的时候、MySQL就撑不住了、MySQL的连接池并发数max为500-1000 可以选择慢查询优化、cdn、页面静态化、ngix负载均衡策略、分布式数据库来进行sql优化、也可以使用高速缓存、例如redis。 redis :高并发、内存高速cache、处理读写io的高并发容忍、将通常被使用来将那些经常被访问的内容缓存到内存中、主从同步(将数据同步到多台从数据库上、提高读取性能) redis不仅仅支持简单的k-v类型的数据、还支持list、set、zset、hash等数据结构的存储 redis单个value的最大限制是1GB redis在3.0版本后支持在服务器端构建分布式存储、redis Cluster是一个实现了分布式且允许单点故障的高级版本 链接数据库:redis.Dail("tcp","127.0.0.1:6379") 1、以redigo为例、当然还有redix、redix在操作查询删除添加时、用的是conn.Cmd import ( "github.com/garyburd/redigo/redis" "fmt" ) func connDb() { //redis作为中间件的数据库、需要和服务器相连 //创建监听器、创建连接请求 conn, err := redis.Dial("tcp", "127.0.0.1:6379") if err != nil { fmt.Println("redis.Dial error", err) return } defer conn.Close() saveDb( conn ) readFromDB( conn ) deleFromDB( conn ) } //写入 func saveDb( conn redis.Conn ){ //EX 为这个值得过期时间 //批量写入、单个写入的话、MSET改为SET _,err := conn.Do("MSET","name","superWang","SEX","F","EX","50") if err != nil{ fmt.Println("conn.Do error",err) } fmt.Println("save success") } func readFromDB( conn redis.Conn){ //单个读取数据,conn.Do的第一个参数为命令类型、因为我们是读取、所以是GET、其余参数为想要查找的值 username,err := redis.String(conn.Do("GET","name")) userSex,_ := redis.String(conn.Do("GET","SEX")) if err != nil{ fmt.Println("redis.String error",err) }else { fmt.Printf("Get mykey: %v \n",username) } fmt.Printf("Get mykey: %v \n",userSex) //批量读取 usernameall,_ := redis.Strings(conn.Do("MGET","SEX","name")) fmt.Printf("Get mykey: %v \n",usernameall) } func deleFromDB( conn redis.Conn){ _,err := conn.Do("DEL","name","SEX") if err != nil{ fmt.Println("deleFromDB error",err) } fmt.Println("delete success") } func main(){ connDb() } 运行结果为 解释一下EX过期时间:如果设置了这个时间、则在当前的key过期时间为设置时间、不设置则当前的key永远有效 看了很多文章、找了很多解释、想弄明白为什么要选择json作为读写到redis的通用配置格式 go的配置格式右ini,json,yaml,xml等等、xml比较繁琐、ini不适用于太多层次结构的 json中的RawMassage、它主要用来告诉go延迟解析 2、利用json类型转换的写入读取: package main import ( "github.com/garyburd/redigo/redis" "fmt" "encoding/json" ) func connDb() { //redis作为中间件的数据库、需要和服务器相连 //创建监听器、创建连接请求 conn, err := redis.Dial("tcp", "127.0.0.1:6379") if err != nil { fmt.Println("redis.Dial error", err) return } defer conn.Close() saveJsonDataToDB( conn ) readJsonDataFromDB( conn ) } //写json func saveJsonDataToDB( conn redis.Conn ){ imap := map[string]string{ "name" : "waiwaigo","phone":"1342132132" } //将map进行类型转换、转换成字符切片 value,_ := json.Marshal(imap) n,err := conn.Do("SETNX","jsonkey",value) if err != nil { fmt.Println("conn.Do SETNX error", err) return } if n == int64(1){ fmt.Println("success") } } //读json func readJsonDataFromDB( conn redis.Conn){ var imspGet map[string]string valueGet ,err := redis.Bytes(conn.Do("GET","jsonkey")) if err != nil { fmt.Println("redis.Bytes error", err) return } //将读取的数据转换为map类型 errshal := json.Unmarshal(valueGet,&imspGet) if errshal != nil { fmt.Println("son.Unmarshal error", err) return } for i,v :=range imspGet{ fmt.Println(i,v) } } func main(){ connDb() } 3、列表操作 package main import ( "github.com/garyburd/redigo/redis" "fmt" ) func connDb() { //redis作为中间件的数据库、需要和服务器相连 //创建监听器、创建连接请求 conn, err := redis.Dial("tcp", "127.0.0.1:6379") if err != nil { fmt.Println("redis.Dial error", err) return } defer conn.Close() saveListToDB( conn ) readListFromDB( conn ) } //写json func saveListToDB( conn redis.Conn ) { //写入列表、命令为lpush _, err := conn.Do("lpush", "username", "zhangsan") if err != nil { fmt.Println("conn.Do lpush error", err) return } _, err = conn.Do("lpush", "username", "lisi") if err != nil { fmt.Println("conn.Do lpush error", err) return } _, err = conn.Do("lpush", "username", "wangwu") if err != nil { fmt.Println("conn.Do lpush error", err) return } } //读列表 func readListFromDB( conn redis.Conn ){ //想要读取的下标值、这块我也不是太清楚、因为如果把1去掉就显示两个值,如果是0和2、就显示三个值 values,_ := redis.Values(conn.Do("lrange","username","1","2")) //计算列表中一共有几条数据 fmt.Printf("count : %d \n",len(values)) for _,v :=range values{ fmt.Println( string(v.([]byte))) } } func main(){ connDb() } 对于redis一般操作时,首先会创建一个连接规则(spec:= redis.Default().DB(0).Password(""),返回一个规则)自己创建 、然后创建一个新的syncClient、并连接到redis的服务器上使用,并指定ConnecttionSpec接口( client:=redis.NewSynchClientWithSpec(spec)、此时会返回一个错误信息、如果有错误则代表服务器连接失败)、接下来制定一个得到数据的规则( dbkey := "GAME:TEST:info")从client获取信息(value,err := client.Get(dbkey)此时返回一个值和错误信息、如果值为空则可以向客户端写入数据、client.Set,如果不为空则代表接收到数据)

优秀的个人博客,低调大师

Java 多线程 之 Runnable

http://www.verejava.com/?id=16992909097867 package com.thread; /** 注意: 1. 如果要启动一个线程必须调用,start()方法 2. 线程同时运行其实是,CPU分配给每个线程一段时间来顺序执行每个线程 3. 因为java是单继承的,所以为了提高可扩展性,一般使用第二种实现Runnable 的方式 概念上 可以理解为 他们 main MyThread 是同时进行 */ public class TestRunnable { public static void main(String[] args) { //实列话一个线程 MyThread2 t = new MyThread2(); Thread thread = new Thread(t, "汽车线程"); thread.start();//启动线程, run() 会自动调用 Thread thread2 = new Thread(t, "火车线程"); thread2.start();//启动线程, run() 会自动调用 try { for (int i = 0; i < 100; i++) { System.out.println(Thread.currentThread().getName() + i); Thread.sleep(1000); } } catch (Exception e) { e.printStackTrace(); } } } //Alt+Shit+S 可以找到父类的方法 class MyThread2 implements Runnable { @Override public void run() { try { for (int i = 0; i < 100; i++) { System.out.println(Thread.currentThread().getName() + i); Thread.sleep(1000); } } catch (Exception e) { e.printStackTrace(); } } } http://www.verejava.com/?id=16992909097867

优秀的个人博客,低调大师

Java 多线程 之 Thread

http://www.verejava.com/?id=16992902983966 package com.thread; /** 注意: 1. 如果要启动一个线程必须调用,start()方法 2. 线程同时运行其实是,CPU分配给每个线程一段时间来顺序执行每个线程 3. 因为java是单继承的,所以为了提高可扩展性,一般使用第二种实现Runnable 的方式 概念上 可以理解为 他们 main MyThread 是同时进行 */ public class TestThread { public static void main(String[] args) { //实列话一个线程 MyThread t = new MyThread(); t.start();//启动线程, run() 会自动调用 for (int i = 0; i < 1000; i++) { System.out.println("main " + i); } } } //Alt+Shit+S 可以找到父类的方法 class MyThread extends Thread { @Override public void run() { for (int i = 0; i < 1000; i++) { System.out.println("MyThread " + i); } } } http://www.verejava.com/?id=16992902983966

优秀的个人博客,低调大师

Android测试之Monkey Script

什么是Monkey Script Monkey Script是用来使Monkey执行特定操作的命令集合。 为什么要用MonkeyScript 由于Monkey的执行是随机的不能满足特定的需求,因此我们需要Monkey Script来使Monkey执行我们需要的特定操作。 如何使用Monkey Script 步骤一:编写脚本(test.txt) type=user #指明脚本类型 count=10 #脚本执行次数 speed=1.0 #命令执行速率 start data >> #用户脚本入口,下面是用户自己编写的脚本 # 上面是固定的格式头 # 启动Activity LaunchActivity(com.itfitness.monkeytest,com.itfitness.monkeytest.MainActivity) # 等待2秒 UserWait(2000) # 某一坐标点按下 DispatchPointer(10,10,0,200,100,1,1,-1,1,1,0,0) # 某一坐标点抬起 DispatchPointer(10,10,1,200,100,1,1,-1,1,1,0,0) # 以上按下抬起共同模拟屏幕点击 UserWait(1000) # 输入test DispatchString(test) UserWait(1000) DispatchPointer(10,10,0,200,150,1,1,-1,1,1,0,0) DispatchPointer(10,10,1,200,150,1,1,-1,1,1,0,0) UserWait(1000) 需要注意的是LaunchActivity()命令启动的Activity需要在AndroidManifest文件中中配置Activity的exported属性为true。 <activity android:name=".MainActivity" android:exported="true"> <intent-filter> <action android:name="android.intent.action.MAIN" /> <category android:name="android.intent.category.LAUNCHER" /> </intent-filter> </activity> 步骤二:将脚本导入手机内 adb命令 adb push test.txt data/local/tmp 步骤三:查看是否导入了手机内(这里我们可以看到有test.txt说明已经导入手机了) 步骤四:安装Apk adb install apk名.apk 步骤五:执行脚本 # monkey -f 脚本文件名 次数 monkey -f test.txt 100 补充:Monkeyscript API介绍 ●单击事件:DispatchPointer(downTime,eventTime,action,x,y,pressure,size,metaStat,xPrecision,yPrecision,device,edgeFlags) 这里我们只需要了解action、x、y即可 action:0表示按下,1表示抬起 x:这个事件的X坐标。 y:这个事件的Y坐标。 示例: DispatchPointer(10,10,0,200,150,1,1,-1,1,1,0,0) //按下 DispatchPointer(10,10,1,200,150,1,1,-1,1,1,0,0) //抬起 这里的x、y坐标可以通过Android sdk中自带的uiautomatorviewer工具来获取(uiautomatorviewer工具的使用) ●拖动:Drag(x1,y1,x2,y2,stepCount) 示例: Drag(300,500,300,300,15) //快速下滑 Drag(300,300,300,500,15) //快速上滑 ●双指缩放:PinchZoom(xstart1,ystart1,xstart2,ystart2,xend2,yend2,xend1,yend1,step) 示例: PinchZoom(400,400,200,300,550,550,700,700,3) //放大 ●执行shell命令:RunCmd(cmd) 示例: RunCmd(monkey -v 1000) ●发送tap事件(一个touchdown和touch up事件),时间长可以模拟长按,时间单位为ms Tap(x,y,tapDuration) ●启动唤醒设备:DeviceWakeUp() ●获取最后一个touch时间的点做长按:LongPress() ●按住duration时长:PressAndHold(x,y,duration) ●屏幕旋转:RotateScreen(rotationDegree,persist),rotationDegree只能支持0,90,180,270, persist 0/1 ● 对指定keycode模拟press事件:DispatchPress(KeyCode) KeyCode对照表 个人博客:https://myml666.github.io

优秀的个人博客,低调大师

Android测试之Monkey Runner

什么是MonkeyRunner monkeyrunner是Android sdk中自带的一个通过接收测试脚本(使用python语言编写的)来执行功能性测试的工具。 MonkeyRunner的使用 步骤一:启动MonkeyRecorder,在Android sdk的tools\bin目录下新建monkey_record.py将如下代码拷贝进去。 from com.android.monkeyrunner import MonkeyRunner as mr from com.android.monkeyrunner.recorder import MonkeyRecorder as recorder device = mr.waitForConnection() recorder.start(device) 步骤二:打开cmd进入Android sdk的tools\bin目录下执行如下操作 步骤四:进行录制 wait: 用来插入下一次操作的时间间隔,点击后即可设置时间,单位是秒 Press a Button:用来确定需要点击的按钮,包括menu、home、search,以及对按钮的press、down、up属性 Type Something:用来输入内容到输入框 Fling:用来进行拖动操作,可以向上、下、左、右,以及操作的范围 Export Actions:用来导出脚本,不需要后缀名,也可以添加后缀名.mr Refresh Display:用来刷新手机界面,估计只有在断开手机后,重新连接时才会用到 步骤五:编写用来运行录制的脚本的脚本,需要我们在Android sdk的tools\bin新建一个文件monkey_playback.py并将如下代码拷贝进去用来运行脚本。 import sys from com.android.monkeyrunner import MonkeyRunner CMD_MAP = { "TOUCH": lambda dev, arg: dev.touch(**arg), "DRAG": lambda dev, arg: dev.drag(**arg), "PRESS": lambda dev, arg: dev.press(**arg), "TYPE": lambda dev, arg: dev.type(**arg), "WAIT": lambda dev, arg: MonkeyRunner.sleep(**arg) } #Process a single file for the specified device. def process_file(fp, device): for line in fp: (cmd, rest) = line.split("|") try: rest = eval(rest) except: print ("unable to parse options") continue if cmd not in CMD_MAP: print ("unknown command: " + cmd) continue CMD_MAP[cmd](device, rest) def main(): file = sys.argv[1] fp = open(file, "r") device = MonkeyRunner.waitForConnection() process_file(fp, device) fp.close(); if __name__ == "__main__": main() monkey_playback.py 步骤六:运行脚本,回放完成 # 在cmd命令行中输入命令: monkeyrunner monkey_playback.py test.mr 补充:在运行monkeyrunner的时候可能会提示SWT folder '..\framework\x86_64' does not exist. Please set ANDROID_SWT to point to the folder conta,这需要我们对monkeyrunner.bat进行修改。 1).set frameworkdir=lib (纠正)==》set frameworkdir=..\lib 2).Dcom.android.monkeyrunner.bindir=..\framework -jar %jarpath% %* (纠正)==》Dcom.android.monkeyrunner.bindir=....\platform-tools -jar %jarpath% %* 个人博客:https://myml666.github.io

优秀的个人博客,低调大师

Java基础之SPI机制

欢迎访问陈同学博客原文 在前几天的译文 Java中的类加载器 中有部分关于ContextClassLoader的内容,涉及到SPI机制,本文将学习下相关知识。 什么是SPI? SPI全称为 Service Provider Interface,直译为 服务提供者接口,翻译成中文后比较拗口,难以理解。 简单来说,SPI通过将服务的接口与实现分离以实现解耦,提高程序拓展性的机制,达到插拔式的效果。相同的标准,各服务厂商可以提供不同的实现。这尤其适合于面对未知的实现或者对拓展开放的系统,可以先行制定标准,服务提供者根据标准提供实现即可。 Java中使用SPI机制的例子很多,例举几个: 数据库驱动 ( java.sql.Driver ),各数据库厂商(Mysql、Oracle等)可以遵守规范独立开发自己的驱动 Servlet容器初始化接口( javax.servlet.ServletContainerInitializer ),Tomcat提供了实现 Apache common-logging 中提供的日志接口,许多日志框架做了实现 稍微延伸一下,其实不仅仅是Java,像计算机行业的各种规范、协议也是类似的。甚至生活中的例子,如: 命题作文:设立标题,大家各自发挥成文 手机壳:根据手机尺寸标准,实现各式各样的手机壳 喜剧:以逗笑观众为标准,各表演者以不同的作品与形式为观众送去欢乐 扯的有点远,下面以一个简单例子演示下。 SPI HelloWorld 首先,了解下SPI机制的约定(约定优于配置理念): 在 META-INF/services/ 目录下创建一个以 接口全限定名 命名的文件,文件内容为 实现类的全限定名 使用 java.util.ServiceLoader 来动态加载 META-INF/services/ 下的实现类 实现类必须有一个无参构造器 假设森林动物园举行歌唱比赛,各参赛动物选手需高歌一曲。我们定义一个接口 Animal,标准为 sing() 唱歌。 创建一个普通maven项目,创建以下对象。 // Animal接口, 制定了 sing() 标准 public interface Animal { void sing(); } 三位参赛选手,分别实现了sing() 标准 Cat.java public class Cat implements Animal { public void sing() { System.out.println("喵~"); } } Cuckoo.java public class Cuckoo implements Animal { public void sing() { System.out.println("布谷~"); } } Dog.java public class Dog implements Animal { public void sing() { System.out.println("汪~"); } } 在resource下创建META-INF/services目录,下面创建以接口全限定名org.utopiavip.spi.Animal命名的文件,内容为三位实现者: org.utopiavip.spi.Cat org.utopiavip.spi.Dog org.utopiavip.spi.Cuckoo 将项目打成jar包。 在另一个项目中引入该jar包,测试类如下: public class SpiDemo { public ServiceLoader<Animal> serviceLoader = ServiceLoader.load(Animal.class); public static void main(String args[]) { SpiDemo spiDemo = new SpiDemo(); spiDemo.sing(); } public void sing() { for (Animal singer : serviceLoader) { singer.sing(); } } } 运行后输出如下: 喵~ 汪~ 布谷~ 小例子就完成了。 Mysql驱动Demo Mysql驱动包中对 java.sql.Driver 的实现类为 com.mysql.fabric.jdbc.FabricMySQLDriver 再看看接口和实现类的ClassLoader。 System.out.println(java.sql.Driver.class.getClassLoader()); System.out.println(com.mysql.fabric.jdbc.FabricMySQLDriver.class.getClassLoader()); 输出结果如下: null sun.misc.Launcher$AppClassLoader@135fbaa4 null表示Bootstrap class loader(SPI的接口都由Bootstrap class loader加载),而实现类是由AppClassLoader加载的。 ContextClassLoader 类加载规则中有这么一点:一个类中所关联的其他类都由当前类的加载器进行加载。 仍然以Driver为例,Java中使用DriverManager来获取JDBC连接,DriverManager 位于 rt.jar 中,由Bootstrap class loader负责加载。 java.sql.DriverManager.getConnection("url", "user", "pwd") 在getConnection()的调用过程中,需要加载 java.sql.Driver 的实现类 com.mysql.fabric.jdbc.FabricMySQLDriver,可Bootstrap class loader无法找到该实现类,因为FabricMySQLDriver由System class loader加载。 这是由于类加载的委派原则及可见性制约,Bootstrap class loader将无法获取子加载器System class loader中加载的FabricMySQLDriver类。 为了解决这个问题,提出了 ContextClassLoader 概念,绕开委派原则,既然当前的加载器是Bootstrap class loader,导致无法加载FabricMySQLDriver类,那就变更当前的class loader,想加载谁就加载谁!虽然有点流氓派头,但确实是这么干的。规则是人定的,变更规则成本太高,就搞点特殊化。 java.lang.Thread 有个NB的方法 setContextClassLoader(),用来变更当前线程的class loader。 public void setContextClassLoader(ClassLoader cl) { SecurityManager sm = System.getSecurityManager(); if (sm != null) { sm.checkPermission(new RuntimePermission("setContextClassLoader")); } contextClassLoader = cl; } contextClassLoader 取名也很有趣,当前线程的 context ClassLoader。特殊化也就搞一小会,不大范围搞。 /* The context ClassLoader for this thread */ private ClassLoader contextClassLoader; 小结 BB这么多,SPI其实非常简单:大佬们定规矩(规范),兄弟们实现后放到约定的地方(META-INF/service/),包装上写好是啥东西(接口全限定名),包装里写清楚东西放哪儿了(实现类全限定名)。 欢迎关注陈同学的公众号,一起学习,一起成长

优秀的个人博客,低调大师

Java 面向对象 之 多态

http://www.verejava.com/?id=16992838437553 /** 知识点: 多态 Polymorphism 1. 对象的多态性 分为三种: 方法的重载, 方法的覆盖, 对象的向上向下转型 2. 基本类型的向上向下转型 3. 对象的向上向下转型 : 必须发生在子类和父类之间 注意: 1. 子类对象 可以 转换成父类对象 但是转换后子类属性和方法不可见 当再转换成子类的时候 要强制类型转换 2. 如果直接实例父类然后 转成子类不允许 报异常 ClassCastException 3. 当子类复写了父类的方法, 子类转成父类后 调用的是子类复写的方法。 */ public class Polymorphism { public static void main(String[] args) { //类型的转换 byte a = 1; int b = 100; int c = 200; //小类型 -> 大类型 b = a; System.out.println(b); //大类型 -> 小类型 必须经过强制类型转换 并且转换以后可能丢失精度 a = (byte) c; System.out.println(a); //对象的向上向下转型 //对象向上转型 子类对象 -> 父类对象 子类对象有些属性和方法不可见 //经典语录(子类是父类) 学生是人 Person p = new Student("李明"); p.say(); //对象向下转型 父类对象 -> 子类对象 必须强制类型转换 // 人可以转换成学生 Student s = (Student) p; s.say(); s.study(); //Student s2=(Student)new Person(); //s2.say(); } } class Person { public void say() { System.out.println("说话"); } } class Student extends Person { private String name; public Student(String name) { this.name = name; } public void say() { System.out.println("说英语"); } public void study() { System.out.println("学习"); } } http://www.verejava.com/?id=16992838437553

优秀的个人博客,低调大师

JavaScript之数据类型

前言 JavaScript一共有6中数据类型: 基本数据类型(5):字符串(String)、数字(Number)、布尔(Boolean)、数组(Array)、空(Null)、未定义(Undefined) 复杂数据类型(1):对象(Object) 注意:Array、Date、Math、Error Set(ES6).....都是属于Object中 一、JS数据类型概述 1.1 简介 原始类型(基本类型):按值访问,可以操作保存在变量中实际的值。 原始类型汇总中null、undefined比较特殊。 引用类型:引用类型的值是保存在内存中的对象。 与其他语言不同的是,JavaScript不允许直接访问内存中的位置,也就是说不能直接操作 对象的内存空间。 在操作对象时,实际上是在操作对象的引用而不是实际的对象。所以引用类型的值是按引用 访问的。 1.2 typeof 操作符 由于js中的变量是松散类型的,所以它提供了一种检测当前变量的数据类型的方法,也就是typeof关键字。 关键字 值 类型 typeof 123 Number typeof 'abc' String typeof true Boolean typeof undefined Undefined typeof null Object typeof { } Object typeof [ ] Object typeof console.log() Function null类型进行typeof操作符后,结果是object,原因在于,null类型被当做一个空对象引用。 二、原始类型 2.1 Number类型 Number类型包含整数和浮点数(浮点数数值必须包含一个小数点,且小数点后面至少有一位数字)两种值。 js不区分 整型和 浮点型 特殊值 NaN (非数字类型) NaN跟任何值进行任何运算,结果仍然NaN.跟谁都不相等,包括自己。 特点 ① 涉及到的 任何关于NaN的操作,都会返回NaN ② NaN不等于自身。 isNaN() 函数用于检查其参数是否是非数字值。 isNaN(123) //false isNaN("hello") //true 一般NaN被动产生(数据类型转为Number,不能转为正常的数字,就是NaN) 函数 isNaN() 判断是不是NaN或者能不能转换为NaN 使用实例: //数字 var n1 = 10234; var n2 = 0x12; //十六进制 var n3 = 2e2; //科学计数法(小学知识) console.log(n1,n2,n3) //浮点精度问题 console.log(.1 + .2); //NaN 表示Not a number console.log(NaN) console.log(typeof(NaN)) //NaN的数据类型依然是number //NaN 跟 任何值(包括0) 进行任何运算 结果依然是NaN console.log(NaN * 0); //结果是NaN //NaN跟谁都不相等 console.log(NaN == NaN) //结果是false var num = 2344e1000; console.log(typeof(num)) //结果是infinity即无穷大 console.log(num) //数据类型依然为number console.log(isNaN(NaN)) //true console.log(isNaN('hello')) //true console.log(isNaN('123')) // false 字符串'123' 转为number 的时候 是 123 不是NaN 2.2 String类型 字符串是存储字符(比如 "Bill Gates")的变量。 字符串有length属性 字符串可以是引号中的任意文本。您可以使用单引号或双引号(没有区别)。 您可以在字符串中使用引号,只要不匹配包围字符串的引号即可。 var answer="It's alright"; var answer="He is called 'Johnny'"; var answer='He is called "Johnny"'; 2.3 Boolean类型 布尔(逻辑)只能有两个值:true 或 false。 var x=true; var y=false; 2.4 Null类型 和 Undefined类型 1) Null类型 被动产生 null类型被看做空对象指针,前文说到null类型也是空的对象引用。 2)Undefined类型只有一个值,即undefined值。使用var声明了变量,但未给变量初始化值,那么这个 变量的值就是undefined. Undefined 这个值表示变量不含有值。可以通过将变量的值设置为 null 来清空变量。 cars=null; person=null; 二、三大引用类型 js中对象是一组属性与方法的集合。这里就要说到引用类型了,引用类型是一种数据结构, 用于将数据和功能组织在一起。引用类型有时候也被称为对象定义,因为它们描述的是一类 对象所具有的属性和方法。 2.1 Object类型 我们看到的大多数类型值都是Object类型的实例,创建Object实例的方式有两种: 1)第一种是使用new操作符后跟Object构造函数 var person = new Object(); person.name = "Micheal"; person.age = 24; 2)第二种方式是使用对象字面量表示法 对象由花括号分隔。在括号内部,对象的属性以名称和值对的形式 (name : value) 来定义。 属性由逗号分隔 var person = { name : "Micheal", age : 24 }; 寻址的两种方式: name=person.name; name=person["name"]; 2.2 Array类型 数组的每一项可以用来保存任何类型的数据,也就是说,可以用数组的第一个位置来 保存字符串,第二个位置保存数值,第三个位置保存对象....另外,数组的大小是可 以动态调整的。 创建数组的基本方式有两种: 1)第一种是使用Array构造函数 var colors = new Array("red","blue","yellow"); var cars=new Array(); cars[0]="Saab"; cars[1]="Volvo"; cars[2]="BMW"; 2)第二种是使用数组字面量表示法 var colors = ["red","blue","yellow"]; 2.3 Function类型 每个函数都是Function类型的实例,而且都与其他引用类型一样具有属性和方法。 函数通常是使用函数声明语法定义的,如下所示 function sum(num1,num2){ return num1 + num2; }; 这和使用函数表达式定义函数的方式相差无几 var sun = function (){ return sum1 + sum2; }; 注意: 当您声明新变量时,可以使用关键词 "new" 来声明其类型: var carname=new String; var x= new Number; var y= new Boolean; var cars= new Array; var person= new Object; JavaScript 变量均为对象。当您声明一个变量时,就创建了一个新的对象。 提示:JavaScript具有隐含的全局概念,意味着你不声明的任何变量都会成为一个全局对象属性。

优秀的个人博客,低调大师

Java 面向对象 之 继承

http://www.verejava.com/?id=16992791427944 /** 知识点: 继承的基本概念和实现 1. 什么是继承 2. 继承的实现 3. 继承的限制 java 不运行多继承, 也就是只能继承一个类, 但是其父类可以再继承一个类 继承具有传递性 题目:学生继承了人的特征 思路: 1. 抽象出类: 学生(Student), 人(Person) 2. 找出类之间的关系: 学生 继承 人 Student extends Person 3. 找出属性: 人的特征(名字name,年龄age) 4. 找出方法: 人的动作(说话say) */ public class Inheritence { public static void main(String[] args) { //实例化一个 学生 Student s = new Student(); //给学生赋值名字和年龄 s.name = "李阳"; s.age = 22; //用带参数的构造方法实例化 子类 Student Student s2 = new Student("张涛", 23); } } class UFO //外星人类 { public UFO() { System.out.println("外星人实例化"); } } class Person extends UFO { protected String name; protected int age; public Person() { System.out.println("父类 Person 实例化"); } public Person(String name, int age) { System.out.println(name + " 的父类 Person 实例化"); } public void say() { System.out.println("说话"); } } /** Person 叫Student的父类 或 超类 Student 叫 Person 的子类 extends 表示继承关系 */ class Student extends Person { public Student() { super(); System.out.println("子类 Student 实例化"); } public Student(String name, int age) { super(name, age); System.out.println("子类 Student " + name + " 实例化"); } } /** 注意: 1. 子类不能访问父类的私有private 的属性 2. 子类可以访问父类的保护protected,public 属性 3. 当用不带参数的构造方法实例化子类的时候,先调用父类的不带参数的构造方法 实例化父类以后, 在实例化子类.(经典语录: 没有父类就没有子类) 4. 当用带参数的构造方法实例化子类时, 也默认先调用父类的不带参数的构造放法 后,再调用子类的带参数的构造方法 5. 如果要让父类带参数的构造方法调用, 必须用super 父类指针显示调用父类的构造方法 并且super 要在子类的构造方法的第一句。 6. 当不带参数的子类实例化时, 系统隐藏执行了 super(); */ http://www.verejava.com/?id=16992791427944

优秀的个人博客,低调大师

Spring(六)之自动装配

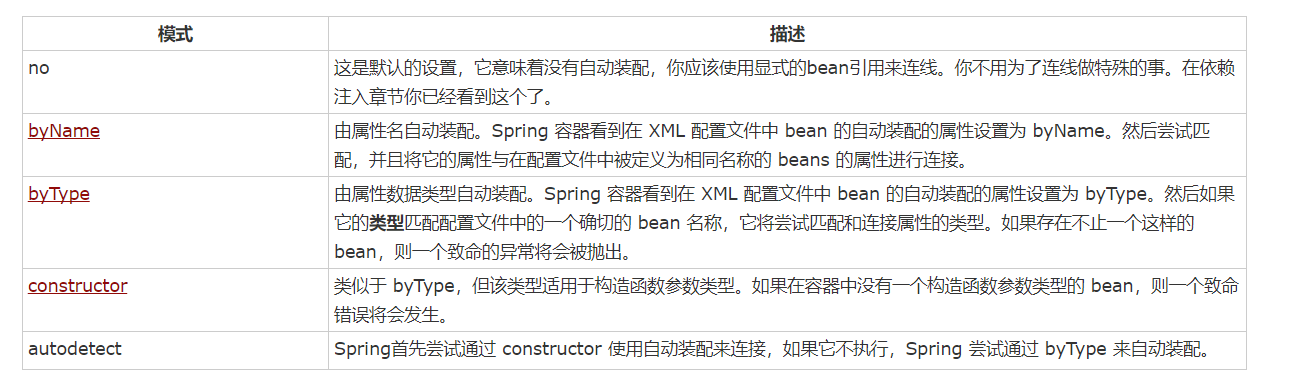
一、自动装配模型 下面是自动连接模式,可以用来指示Spring容器使用自动连接进行依赖注入。您可以使用元素的autowire属性为bean定义指定autowire模式。 可以使用byType或者constructor自动装配模式来连接数组和其他类型的集合。 自动装配的局限性 当自动装配始终在同一个项目中使用时,它的效果最好。如果通常不使用自动装配,它可能会使开发人员混淆的使用它来连接只有一个或两个 bean 定义。不过,自动装配可以显著减少需要指定的属性或构造器参数,但你应该在使用它们之前考虑到自动装配的局限性和缺点。 Spring 自动装配 ‘byName’ 这种模式由属性名称指定自动装配。Spring 容器看作 beans,在 XML 配置文件中 beans 的auto-wire属性设置为byName。然后,它尝试将它的属性与配置文件中定义为相同名称的 beans 进行匹配和连接。如果找到匹配项,它将注入这些 beans,否则,它将抛出异常。 例如,在配置文件中,如果一个 bean 定义设置为自动装配byName,并且它包含spellChecker属性(即,它有一个setSpellChecker(...)方法),那么 Spring 就会查找定义名为spellChecker的 bean,并且用它来设置这个属性。你仍然可以使用 <property> 标签连接其余的属性。下面的例子将说明这个概念。 (1)编写TextEditor.java package com.tutorialspoint; public class TextEditor { private SpellChecker spellChecker; private String name; public void setSpellChecker( SpellChecker spellChecker ){ this.spellChecker = spellChecker; } public SpellChecker getSpellChecker() { return spellChecker; } public void setName(String name) { this.name = name; } public String getName() { return name; } public void spellCheck() { spellChecker.checkSpelling(); } } (2)编写SpellChecker.java package com.tutorialspoint; public class SpellChecker { public SpellChecker() { System.out.println("Inside SpellChecker constructor." ); } public void checkSpelling() { System.out.println("Inside checkSpelling." ); } } (3)编写MainApp.java package com.tutorialspoint; import org.springframework.context.ApplicationContext; import org.springframework.context.support.ClassPathXmlApplicationContext; public class MainApp { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("Beans.xml"); TextEditor te = (TextEditor) context.getBean("textEditor"); te.spellCheck(); } } (4)Beans.xml <?xml version = "1.0" encoding = "UTF-8"?> <beans xmlns = "http://www.springframework.org/schema/beans" xmlns:xsi = "http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation = "http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans-4.0.xsd"> <!-- Definition for textEditor bean --> <bean id="textEditor" class="com.tutorialspoint.TextEditor" autowire="byName"> <property name="name" value="Generic Text Editor" /> </bean> <!-- Definition for spellChecker bean --> <bean id="spellChecker" class="com.tutorialspoint.SpellChecker"> </bean> </beans> (5)运行MainApp.java的main方法 结果如图: Spring 自动装配 ‘byType’ 这种模式由属性类型指定自动装配。Spring 容器看作 beans,在 XML 配置文件中 beans 的autowire属性设置为byType。然后,如果它的type恰好与配置文件中 beans 名称中的一个相匹配,它将尝试匹配和连接它的属性。如果找到匹配项,它将注入这些 beans,否则,它将抛出异常。 例如,在配置文件中,如果一个 bean 定义设置为自动装配byType,并且它包含SpellChecker类型的spellChecker属性,那么 Spring 就会查找定义名为SpellChecker的 bean,并且用它来设置这个属性。你仍然可以使用 <property> 标签连接其余属性。下面的例子将说明这个概念,你会发现和上面的例子没有什么区别,除了 XML 配置文件已经被改变。 byType示例与上述byName除了xml配置之外并无多大区别,只需将xml配置改为这样,运行对应的main方法即可: <?xml version = "1.0" encoding = "UTF-8"?> <beans xmlns = "http://www.springframework.org/schema/beans" xmlns:xsi = "http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation = "http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans-4.0.xsd"> <!-- Definition for textEditor bean --> <bean id="textEditor" class="com.tutorialspoint.TextEditor" autowire="byType"> <property name="name" value="Generic Text Editor" /> </bean> <!-- Definition for spellChecker bean --> <bean id="spellChecker" class="com.tutorialspoint.SpellChecker"> </bean> </beans> Spring 由构造函数自动装配 这种模式与byType非常相似,但它应用于构造器参数。Spring 容器看作 beans,在 XML 配置文件中 beans 的autowire属性设置为constructor。然后,它尝试把它的构造函数的参数与配置文件中 beans 名称中的一个进行匹配和连线。如果找到匹配项,它会注入这些 bean,否则,它会抛出异常。 例如,在配置文件中,如果一个 bean 定义设置为通过构造函数自动装配,而且它有一个带有SpellChecker类型的参数之一的构造函数,那么 Spring 就会查找定义名为SpellChecker的 bean,并用它来设置构造函数的参数。你仍然可以使用 <constructor-arg> 标签连接其余属性。下面的例子将说明这个概念。 一、编写TextEditor.java package com.tutorialspoint; public class TextEditor { private SpellChecker spellChecker; private String name; public TextEditor( SpellChecker spellChecker, String name ) { this.spellChecker = spellChecker; this.name = name; } public SpellChecker getSpellChecker() { return spellChecker; } public String getName() { return name; } public void spellCheck() { spellChecker.checkSpelling(); } } 二、编写SpellChecker.java package com.tutorialspoint; public class SpellChecker { public SpellChecker(){ System.out.println("Inside SpellChecker constructor." ); } public void checkSpelling() { System.out.println("Inside checkSpelling." ); } } 三、编写MainApp.java package com.tutorialspoint; import org.springframework.context.ApplicationContext; import org.springframework.context.support.ClassPathXmlApplicationContext; public class MainApp { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("Beans.xml"); TextEditor te = (TextEditor) context.getBean("textEditor"); te.spellCheck(); } } 四、编写Beans.xml <?xml version = "1.0" encoding = "UTF-8"?> <beans xmlns = "http://www.springframework.org/schema/beans" xmlns:xsi = "http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation = "http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans-4.0.xsd"> <!-- Definition for textEditor bean --> <bean id="textEditor" class="com.tutorialspoint.TextEditor"> <constructor-arg ref="spellChecker" /> <constructor-arg value="Generic Text Editor"/> </bean> <!-- Definition for spellChecker bean --> <bean id="spellChecker" class="com.tutorialspoint.SpellChecker"> </bean> </beans> 五、运行MainApp.java中的main方法 结果如下:

优秀的个人博客,低调大师

Spring(十二)之JDBC框架

JDBC 框架概述 在使用普通的 JDBC 数据库时,就会很麻烦的写不必要的代码来处理异常,打开和关闭数据库连接等。但 Spring JDBC 框架负责所有的低层细节,从开始打开连接,准备和执行 SQL 语句,处理异常,处理事务,到最后关闭连接。 所以当从数据库中获取数据时,你所做的是定义连接参数,指定要执行的 SQL 语句,每次迭代完成所需的工作。 Spring JDBC 提供几种方法和数据库中相应的不同的类与接口。我将给出使用JdbcTemplate类框架的经典和最受欢迎的方法。这是管理所有数据库通信和异常处理的中央框架类。 JdbcTemplate 类 JdbcTemplate 类执行 SQL 查询、更新语句和存储过程调用,执行迭代结果集和提取返回参数值。它也捕获 JDBC 异常并转换它们到 org.springframework.dao 包中定义的通用类、更多的信息、异常层次结构。 JdbcTemplate类的实例是线程安全配置的。所以你可以配置 JdbcTemplate 的单个实例,然后将这个共享的引用安全地注入到多个 DAOs 中。 使用 JdbcTemplate 类时常见的做法是在你的 Spring 配置文件中配置数据源,然后共享数据源 bean 依赖注入到 DAO 类中,并在数据源的设值函数中创建了 JdbcTemplate。 演示示例如下: (1)建立mysql数据库,并导入该脚本,库名可任意命名,这里命名为test,sql脚本为: CREATE TABLE Student( ID INT NOT NULL AUTO_INCREMENT, NAME VARCHAR(20) NOT NULL, AGE INT NOT NULL, PRIMARY KEY (ID) ); (2)创建实体 package com.tutorialspoint; public class Student { private Integer age; private String name; private Integer id; public void setAge(Integer age) { this.age = age; } public Integer getAge() { return age; } public void setName(String name) { this.name = name; } public String getName() { return name; } public void setId(Integer id) { this.id = id; } public Integer getId() { return id; } } (3)创建DAO package com.tutorialspoint; import java.util.List; import javax.sql.DataSource; public interface StudentDAO { /** * This is the method to be used to initialize * database resources ie. connection. */ public void setDataSource(DataSource ds); /** * This is the method to be used to create * a record in the Student table. */ public void create(String name, Integer age); /** * This is the method to be used to list down * a record from the Student table corresponding * to a passed student id. */ public Student getStudent(Integer id); /** * This is the method to be used to list down * all the records from the Student table. */ public List<Student> listStudents(); /** * This is the method to be used to delete * a record from the Student table corresponding * to a passed student id. */ public void delete(Integer id); /** * This is the method to be used to update * a record into the Student table. */ public void update(Integer id, Integer age); } (4)创建StudentMapper package com.tutorialspoint; import java.sql.ResultSet; import java.sql.SQLException; import org.springframework.jdbc.core.RowMapper; public class StudentMapper implements RowMapper<Student> { public Student mapRow(ResultSet rs, int rowNum) throws SQLException { Student student = new Student(); student.setId(rs.getInt("id")); student.setName(rs.getString("name")); student.setAge(rs.getInt("age")); return student; } } (5)创建StudentJDBCTemplate package com.tutorialspoint; import java.util.List; import javax.sql.DataSource; import org.springframework.jdbc.core.JdbcTemplate; public class StudentJDBCTemplate implements StudentDAO { private DataSource dataSource; private JdbcTemplate jdbcTemplateObject; public void setDataSource(DataSource dataSource) { this.dataSource = dataSource; this.jdbcTemplateObject = new JdbcTemplate(dataSource); } public void create(String name, Integer age) { String SQL = "insert into Student (name, age) values (?, ?)"; jdbcTemplateObject.update( SQL, name, age); System.out.println("Created Record Name = " + name + " Age = " + age); return; } public Student getStudent(Integer id) { String SQL = "select * from Student where id = ?"; Student student = jdbcTemplateObject.queryForObject(SQL, new Object[]{id}, new StudentMapper()); return student; } public List<Student> listStudents() { String SQL = "select * from Student"; List <Student> students = jdbcTemplateObject.query(SQL, new StudentMapper()); return students; } public void delete(Integer id){ String SQL = "delete from Student where id = ?"; jdbcTemplateObject.update(SQL, id); System.out.println("Deleted Record with ID = " + id ); return; } public void update(Integer id, Integer age){ String SQL = "update Student set age = ? where id = ?"; jdbcTemplateObject.update(SQL, age, id); System.out.println("Updated Record with ID = " + id ); return; } } (6)编写对应的Beans.xml <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans-3.0.xsd "> <!-- Initialization for data source --> <bean id="dataSource" class="org.springframework.jdbc.datasource.DriverManagerDataSource"> <property name="driverClassName" value="com.mysql.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="root"/> <property name="password" value="1234"/> </bean> <!-- Definition for studentJDBCTemplate bean --> <bean id="studentJDBCTemplate" class="com.tutorialspoint.StudentJDBCTemplate"> <property name="dataSource" ref="dataSource" /> </bean> </beans> (7)编写MainApp.java并运行 package com.tutorialspoint; import java.util.List; import org.springframework.context.ApplicationContext; import org.springframework.context.support.ClassPathXmlApplicationContext; public class MainApp { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("Beans.xml"); StudentJDBCTemplate studentJDBCTemplate = (StudentJDBCTemplate)context.getBean("studentJDBCTemplate"); System.out.println("------Records Creation--------" ); studentJDBCTemplate.create("Zara", 11); studentJDBCTemplate.create("Nuha", 2); studentJDBCTemplate.create("Ayan", 15); System.out.println("------Listing Multiple Records--------" ); List<Student> students = studentJDBCTemplate.listStudents(); for (Student record : students) { System.out.print("ID : " + record.getId() ); System.out.print(", Name : " + record.getName() ); System.out.println(", Age : " + record.getAge()); } System.out.println("----Updating Record with ID = 2 -----" ); studentJDBCTemplate.update(2, 20); System.out.println("----Listing Record with ID = 2 -----" ); Student student = studentJDBCTemplate.getStudent(2); System.out.print("ID : " + student.getId() ); System.out.print(", Name : " + student.getName() ); System.out.println(", Age : " + student.getAge()); } } 运行结果如下: 数据表数据由无变为有:

优秀的个人博客,低调大师

Java 面向对象 之 封装

http://www.verejava.com/?id=16992746970636 /** 测试 Person 类 步骤: 1. 如果要访问Person类必须, 先实例化一个 Person的对象 2. 然后通过返回的对象引用名 去访问该对象在类当中定义的 属性和方法 比如 对象引用名.name 对象应用名.age 对象引用名.say() */ public class TestPerson { public static void main(String[] args) { //对象的实例化 //其中 new Person(); 就是实例化Person对象, 返回一个Person的引用 //p 就是指向 new Person()在堆中生成的对象的一个引用名 Person p = new Person(); //用对象引用名 p 访问属性和方法 p.name = "李明"; p.age = 22; p.say();//李明开始自我介绍了 Person p2 = new Person(); p2.name = "王强"; p2.age = 23; p2.say();//王强开始自我介绍 //把p2指向的Person对象的地址赋值给p,这个时候p 指向的是 p2的对象 //这个时候开始生成的 李明 Person对象已经没有引用指向它, 属于垃圾对象 //当 GC来扫描的时候就会自动回收该对象 p = p2; p.say(); //注意: //如果只是声明一个空的 Person对象 ,而没有实例化, 这个时候访问属性和方法的 //时候编译期能通过,但是在运行期会报 NullPointerException 空指针异常 //Person p3=null; //p3.name="张胜"; //p3.age=24; //p3.say(); } } /* 1. 定义一个Person类 类由属性和方法组成 2. Person类当中有两个属性 :姓名,年龄 3. Person类区别于动物的一个重要方法是:说话 */ class Person { String name; int age; public void say() { System.out.println("我的名字叫:" + name + ",今年:" + age + "岁"); } } http://www.verejava.com/?id=16992746970636

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册