首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

Docker 安装ELK之(2)

先安装Docker [root@jiaxin-ceshi src]# curl -fsSL https://get.docker.com | bash -s docker --mirror Aliyun 启动docker [root@jiaxin-ceshi src]# service docker start Redirecting to /bin/systemctl start docker.service [root@jiaxin-ceshi src]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES [root@jiaxin-ceshi src]# docker search elk NAME DESCRIPTION STARS OFFICIAL AUTOMATED sebp/elk Collect, search and visualise log data with … 734 [OK] qnib/elk Dockerfile providing ELK services (Elasticse… 108 [OK] willdurand/elk Creating an ELK stack could not be easier. 95 [OK] sebp/elkx Collect, search and visualise log data with … 31 [OK] wazuh/ossec-elk Includes an OSSEC manager and an Elasticsear… 17 [OK] dtagdevsec/elk deprecated 9 [OK] elkozmon/zoonavigator-web Web client for ZooNavigator, web-based brows… 8 elkarbackup/elkarbackup ElkarBackup is a free open-source backup sol… 6 [OK] grubykarol/elk-docker elk docker image (derived from spujadas/elk-… 6 [OK] elkozmon/zoonavigator-api API for ZooNavigator, web-based browser/edit… 4 cdrocker/elk5 Elasticsearch 5, Kibana 5 and Logstash 5 on … 4 [OK] dockercisco/elklat Docker ELK stack for Nexus 2 portbase/elk-filebeat elk-filebeat 1 scality/elk 1 salgat/elk-cors ELK stack with CORS enabled for ElasticSearc… 1 [OK] codechimporg/unraid-dockers-elk ELK stack for docker on unraid 0 [OK] itherz/elk ELK Stack with some improvements (datetime f… 0 [OK] otasys/elk-redis An ELK stack with redis all in one container. 0 [OK] coralproject/elkhorn Elkhorn 0 [OK] d3tdistribution/elk-docker Stack ELK 0 [OK] eternaltyro/elk-aws-discovery Collect, search and visualize log data with … 0 [OK] cloudunit/elk-elasticsearch elk-elasticsearch 0 [OK] portbase/elk-elasticsearch elk-elasticsearch 0 portbase/elk-kibana elk-kibana 0 cloudunit/elk-kibana elk-kibana 0 [OK] 下载elk [root@jiaxin-ceshi src]# docker pull sebp/elk Using default tag: latest latest: Pulling from sebp/elk [root@jiaxin-ceshi src]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE sebp/elk latest a55642eacfef 8 days ago 1.45GB 然后运行elk [root@jiaxin-ceshi src]# docker run -d -p 5601:5601 -p 9200:9200 -p 5044:5044 -e ES_MIN_MEM=128m -e ES_MAX_MEM=1024m -it --name elk22 sebp/elk 6d2ffaaea11a2628f868d06746352a4ac566de91f04e2d0d25a6b03ef946eea4 [root@jiaxin-ceshi src]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 6d2ffaaea11a sebp/elk "/usr/local/bin/star…" 9 seconds ago Up 9 seconds 0.0.0.0:5044->5044/tcp, 0.0.0.0:5601->5601/tcp, 0.0.0.0:9200->9200/tcp, 9300/tcp

优秀的个人博客,低调大师

项目启动之spring篇

在之前终于是把项目跑起来了,也是踩了不少的坑,把bug还原了一遍又一遍,希望能看的更清楚。现在我们跳过tomcat再来看看spring是如何启动的。 项目启动过程之spring篇 1.创建WebApplicationContext # 首先我们在web.xml的配置了这么一个lisenner <listener-class>org.springframework.web.context.ContextLoaderListener</listener-class> # 从源码中找到该类,类中的方法都是调用父类来实现的,如此明显的装饰者模式。 public class ContextLoaderListener extends ContextLoader implements ServletContextListener { ..... } # 再看看ContextLoader这个类 public class ContextLoader { # 这个静态方法只为加载一个ContextLoader.properties文件,不出所料的这个文件跟类在同一个文件夹下。 # 文件中只有一句话 -> org.springframework.web.context.WebApplicationContext=org.springframework.web.context.support.XmlWebApplicationContext static { try { ClassPathResource resource = new ClassPathResource("ContextLoader.properties", ContextLoader.class); defaultStrategies = PropertiesLoaderUtils.loadProperties(resource); } catch (IOException var1) { throw new IllegalStateException("Could not load 'ContextLoader.properties': " + var1.getMessage()); } currentContextPerThread = new ConcurrentHashMap(1); } # 这个方法大致就是如果web.xml没有配置特殊的contextClass则会使用defaultStrategies中指定的类,也就是上面静态方法加载到的配置 XmlWebApplicationContext protected Class<?> determineContextClass(ServletContext servletContext) { String contextClassName = servletContext.getInitParameter("contextClass"); if (contextClassName != null) { try { return ClassUtils.forName(contextClassName, ClassUtils.getDefaultClassLoader()); } catch (ClassNotFoundException var4) { throw new ApplicationContextException("Failed to load custom context class [" + contextClassName + "]", var4); } } else { # 如果在web.xml中并未指定contextClass # 简单写成: contextClassName = "org.springframework.web.context.support.XmlWebApplicationContext" contextClassName = defaultStrategies.getProperty(WebApplicationContext.class.getName()); try { return ClassUtils.forName(contextClassName, ContextLoader.class.getClassLoader()); } catch (ClassNotFoundException var5) { throw new ApplicationContextException("Failed to load default context class [" + contextClassName + "]", var5); } } } protected WebApplicationContext createWebApplicationContext(ServletContext sc) { # 将里面代码简单写成: # return (ConfigurableWebApplicationContext)BeanUtils.instantiateClass(this.determineContextClass(sc)); } public WebApplicationContext initWebApplicationContext(ServletContext servletContext) { if (servletContext.getAttribute(WebApplicationContext.ROOT_WEB_APPLICATION_CONTEXT_ATTRIBUTE) != null) { .... } else { ..... # 此时就要开始创建 WebApplicationContext 了 try { if (this.context == null) { # 我们假定 this.context 的类型就是 XmlWebApplicationContext this.context = this.createWebApplicationContext(servletContext); } if (this.context instanceof ConfigurableWebApplicationContext) { ConfigurableWebApplicationContext cwac = (ConfigurableWebApplicationContext)this.context; if (!cwac.isActive()) { # 刚跑起的项目context一般都没被激活 if (cwac.getParent() == null) { # 很奇怪,loadParentContext返回的是 return null ?? ApplicationContext parent = this.loadParentContext(servletContext); cwac.setParent(parent); } # 这个方法主要是设置contextId,若没有在web.xml中指定,则会像这个样子: # org.springframework.web.context.WebApplicationContext:${contextPath} this.configureAndRefreshWebApplicationContext(cwac, servletContext); } } # 这个才是Lisener的关键,把创建的WebApplicationContext加入到servletContext中。 servletContext.setAttribute(WebApplicationContext.ROOT_WEB_APPLICATION_CONTEXT_ATTRIBUTE, this.context); ClassLoader ccl = Thread.currentThread().getContextClassLoader(); if (ccl == ContextLoader.class.getClassLoader()) { currentContext = this.context; } else if (ccl != null) { currentContextPerThread.put(ccl, this.context); } return this.context; ..... } } } # 在XWAC中提供了默认的配置文件位置 public class XmlWebApplicationContext extends AbstractRefreshableWebApplicationContext { public static final String DEFAULT_CONFIG_LOCATION = "/WEB-INF/applicationContext.xml"; public static final String DEFAULT_CONFIG_LOCATION_PREFIX = "/WEB-INF/"; public static final String DEFAULT_CONFIG_LOCATION_SUFFIX = ".xml"; ..... } 小结一下: tomcat启动时会给配置在web.xml中指定的lisener传递一个事件,让其初始化创建一个WebApplicationContext对象,并将其加入到ServletContext中。而在spring-web中ContextLoaderListener类为我们提供使用默认或自定义两种生成WebApplicationContext对象,需要使用自定义则需要在web.xml中指定contextClass属性,并且创建对应的类。创建好了context之后,下一步便是加载applicationContext中的bean了,暂时也还没有发现如何发起加载bean的过程,继续学习吧。。。

优秀的个人博客,低调大师

iOS 开发之密码规则

密码规则 / UIText​Input​Password​Rules 原文 也难怪 hipster 们着迷于工艺品和手工制品。不管是一片厚切鳄梨吐司、一瓶限量(非乳制)姜黄奶或一杯完美的手冲咖啡——其中的人情味是无法替代的。 相反,好密码和工艺品截然不同。密码应该完全没有任何意义,除非它是一个 90 年代骇客电影的标题或者一个密室逃脱游戏的答案。 有了 iOS 12 和 macOS Mojave 中的 Safari,生成可以想象到的最强、最没有意义、最难猜到的密码从未如此简单——这都要感谢一些新功能。 理想的密码策略非常简单:强制要求最少字符数(至少 8 位)并且允许长密码(64 位或者更多)。 其他更复杂的策略,像预置的安全问题、周期性的失效密码或者强制要求一些奇怪的符号,只不过让这些策略想要保护人感到厌烦。 但是不要太相信我说的话——我不是安全专家 相对的,请查看美国国家标准技术研究所最新发布(2017 年 6 月)的 Digital Identity Guidelines 好消息是越来越多的公司和组织开始注意安全性最佳实践了。坏消息则是改变这些事情需要进行一系列影响数百万人的大范围数据改动。事实上前面说到的安全性反面模式并不会很快消失,因为公司和政府做任何事情都需要花很久的时间。 自动式强密码 Safari 的自动填充从 iOS 8 起就可以生成密码了,但是它有一个缺点就是不能保证生成的密码符合某些服务的要求。 Apple 通过 iOS 12 和 macOS Mojave 里 Safari 中的自动式强密码功能来解决这个问题。 WebKit 工程师 Daniel Bates 在 3 月 1 日给 <acronym title="Web Hypertext Application Technology Working Group" style="max-width: 100%;">WHATWG</acronym> 提交了这个提案。6 月 6 日,WebKit 团队发布了 Safari Technology Preview 58,使用新属性 passwordrules 来支持强密码生成。同时,WWDC 发布了 iOS 12 beta SDK,包括新的 UIText<wbr style="max-width: 100%;">Input<wbr style="max-width: 100%;">Password<wbr style="max-width: 100%;">Rules API,还有验证码自动输入和联合身份验证等其他一些密码管理功能。 密码规则 密码规则就像是密码生成器的配方。根据一些简单的规则,密码生成器就可以随机生成满足服务提供方需求的新密码。 密码规则由一个或多个键值对组成: required: lower; required: upper; required: digit; allowed: ascii-printable; max-consecutive: 3; 键 每个规则可以指定下列键: required: 需要的字符类型 allowed: 允许使用的字符类型 max-consecutive: 允许字符连续出现次数的最大值 minlength: 密码最小长度 maxlength: 密码最大长度 required 和 allowed 键使用下面列出的字符类别作为值。max-consecutive、minlength 和 maxlength 使用非负整数作为值。 字符类别 required 和 allowed 键可以使用下面的字符类别作为值: upper (A-Z) lower (a-z) digits (0-9) special (-~!@#$%^&\*\_+=|(){}[:;"'<>,.? ]` 和空格) ascii-printable (U+0020 — 007f) unicode (U+0 — 10FFFF) 除了这些预置字符类别,还可以用方括号包住 ASCII 字符来指定自定义字符类别(比如 [abc])。 Apple 的 Password Rules Validation Tool 让你可以对不同的规则进行实验,并得到实时的结果反馈。甚至可以生成并下载上千个密码用来开发和测试! image.png 更多有关于密码规则的语法,请查看 Apple 的文档「Customizing Password AutoFill Rules」。 指定密码规则 在 iOS 上,给 UIText<wbr style="max-width: 100%;">Field 的 password<wbr style="max-width: 100%;">Rules 属性设置一个 UIText<wbr style="max-width: 100%;">Input<wbr style="max-width: 100%;">Password<wbr style="max-width: 100%;">Rules 对象(同时也应该将 text<wbr style="max-width: 100%;">Content<wbr style="max-width: 100%;">Type 属性设置为 .new<wbr style="max-width: 100%;">Password): Swift let newPasswordTextField = UITextField() newPasswordTextField.textContentType = .newPassword newPasswordTextField.passwordRules = UITextInputPasswordRules(descriptor: "required: upper; required: lower; required: digit; max-consecutive: 2; minlength: 8;") 在网页上,设置 <input> 元素(且 type="password")的 passwordrules 属性: <input type="password" passwordrules="required: upper; required: lower; required: special; max-consecutive: 3;"/> 如果没有指定,默认的密码规则是 allowed: ascii-printable。如果表单中有密码验证区域,它的密码规则会从上一个区域继承下来。 在 Swift 中生成密码规则 不光是只有你会觉得直接使用没有良好抽象的字符串格式令人感到不安。 下面是一种将密码规则封装成 Swift API 的方式(可以作为 Swift package 获取): enum PasswordRule { enum CharacterClass { case upper, lower, digits, special, asciiPrintable, unicode case custom(Set<Character>) } case required(CharacterClass) case allowed(CharacterClass) case maxConsecutive(UInt) case minLength(UInt) case maxLength(UInt) } extension PasswordRule: CustomStringConvertible { var description: String { switch self { case .required(let characterClass): return "required: \(characterClass)" case .allowed(let characterClass): return "allowed: \(characterClass)" case .maxConsecutive(let length): return "max-consecutive: \(length)" case .minLength(let length): return "minlength: \(length)" case .maxLength(let length): return "maxlength: \(length)" } } } extension PasswordRule.CharacterClass: CustomStringConvertible { var description: String { switch self { case .upper: return "upper" case .lower: return "lower" case .digits: return "digits" case .special: return "special" case .asciiPrintable: return "ascii-printable" case .unicode: return "unicode" case .custom(let characters): return "[" + String(characters) + "]" } } } 有了这个,我们就可以在代码里指定一些规则,然后用它们生成有效的密码规则语法字符串: let rules: [PasswordRule] = [ .required(.upper), .required(.lower), .required(.special), .minLength(20) ] let descriptor = rules.map{ "\($0.description);" } .joined(separator: " ") // "required: upper; required: lower; required: special; max-consecutive: 3;" 只要你愿意,你甚至可以扩展 UIText<wbr style="max-width: 100%;">Input<wbr style="max-width: 100%;">Password<wbr style="max-width: 100%;">Rules 给它添加一个接收 Password<wbr style="max-width: 100%;">Rule 数组的 convenience initializer。 extension UITextInputPasswordRules { convenience init(rules: [PasswordRule]) { let descriptor = rules.map{ $0.description } .joined(separator: "; ") self.init(descriptor: descriptor) } } 如果你是一个在个人认证信息上非常有感情的人,喜欢在密码输入区域中的小圆点后面输入你的大学、小狗或者最喜欢的运动团队,请考虑不要再这样做了。 就我个人来说,我无法想象没有密码管理器的日子。当你知道任何时候你都能访问到你需要的信息,并且只有你能访问到时,你的心灵将会获得极大的平静。 从现在开始改变,你就能完全利用上在之后今年发布的 iOS 12 和 macOS Mojave 的 Safari 中的这些改进。 作者 Mattt 翻译者 Bei Li — 2018年7月23日

优秀的个人博客,低调大师

Ignite集成Spark之IgniteDataFrames

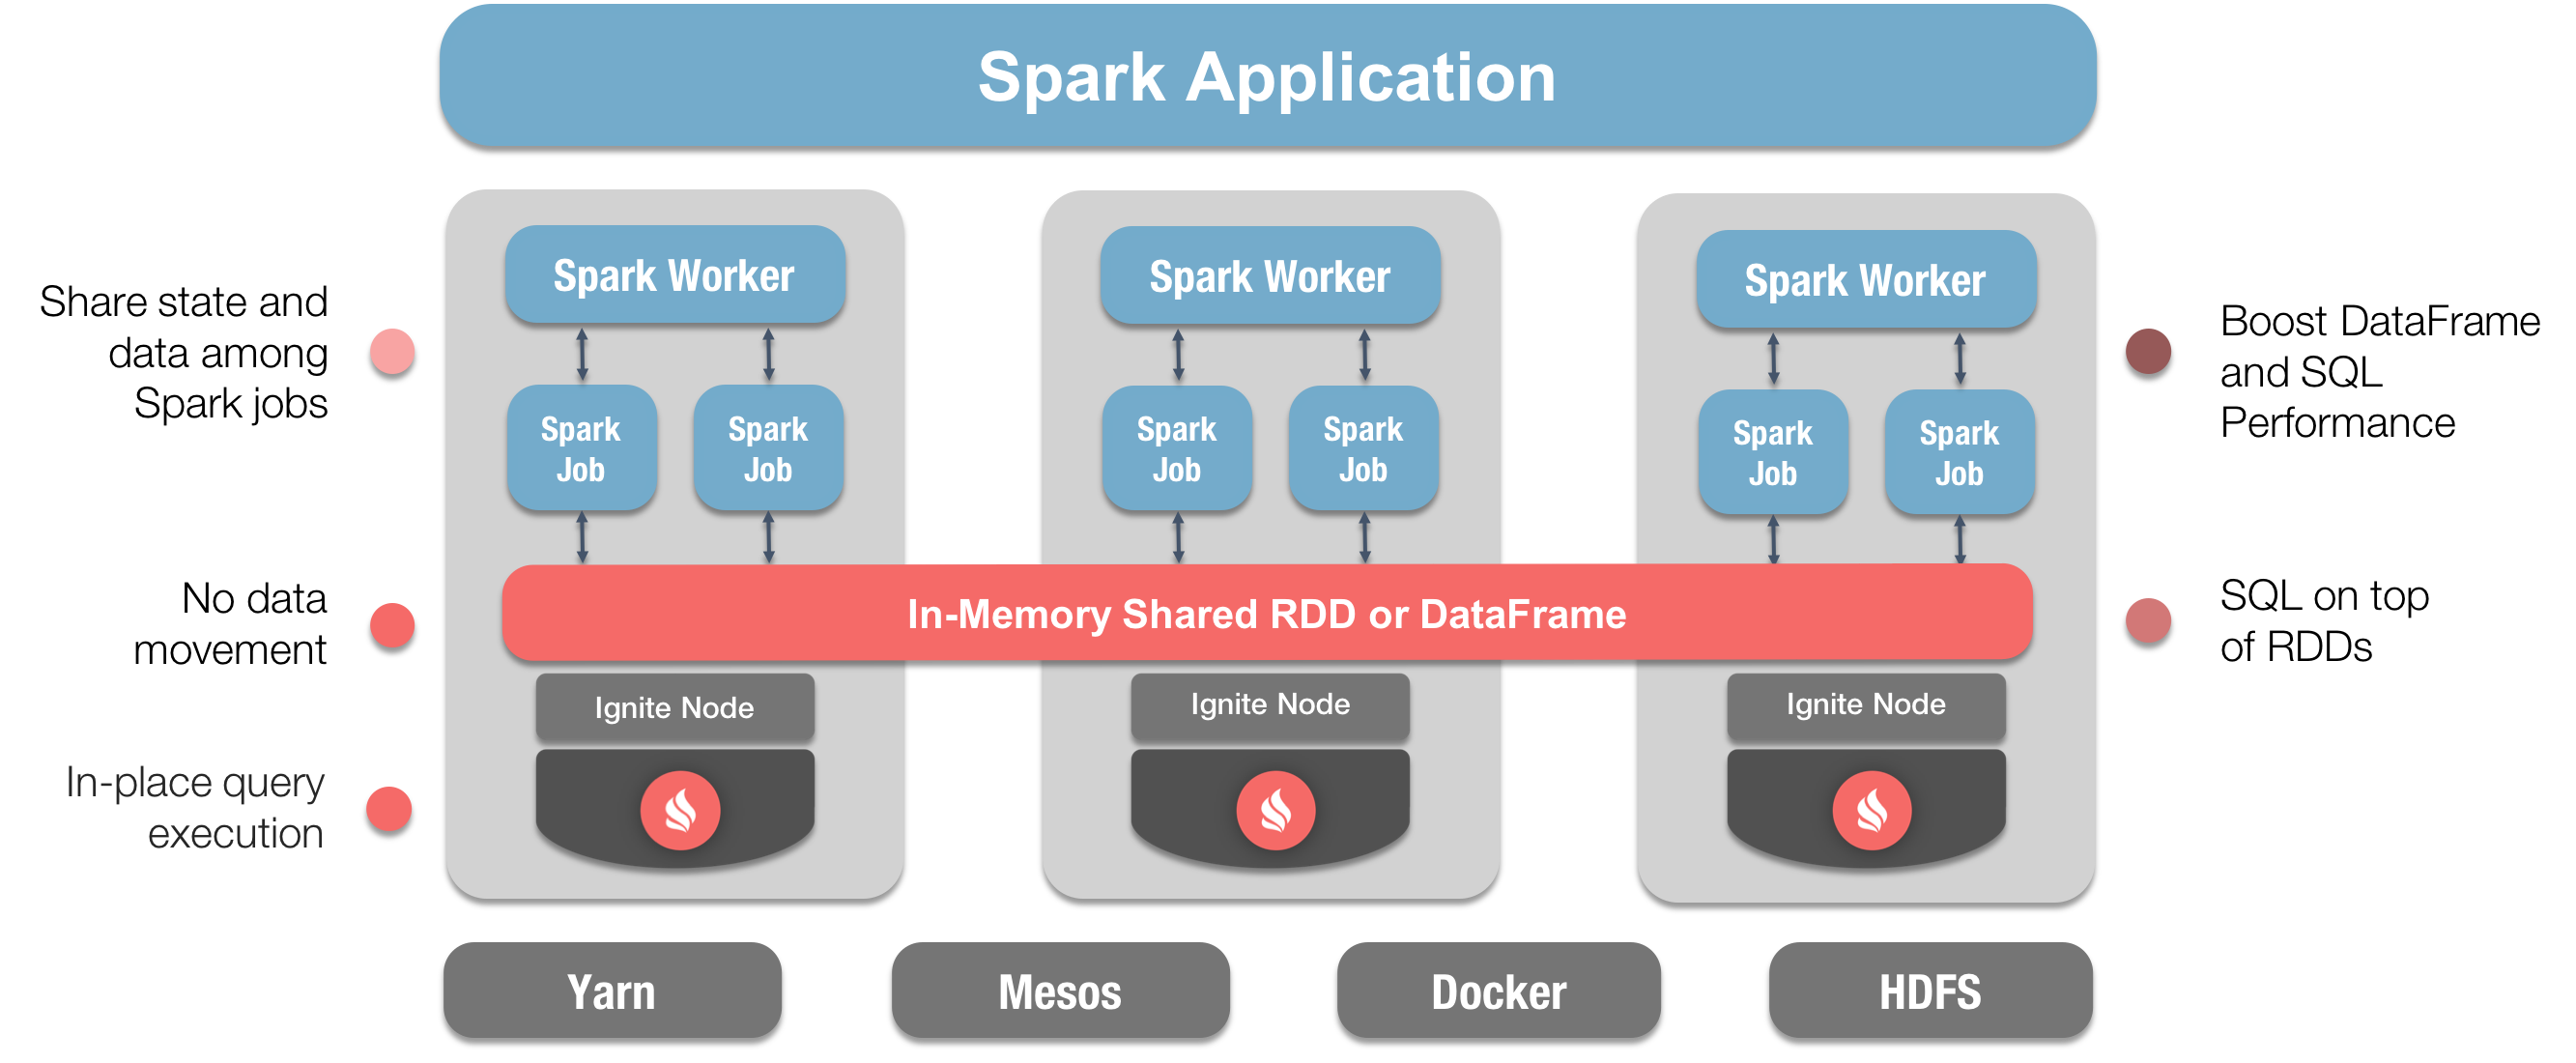
本系列共两篇文章,主要探讨如何将Ignite和Spark进行集成。 下面简要地回顾一下在第一篇文章中所谈到的内容。 Ignite是一个分布式的内存数据库、缓存和处理平台,为事务型、分析型和流式负载而设计,在保证扩展性的前提下提供了内存级的性能。 Spark是一个流式数据和计算引擎,通常从HDFS或者其他存储中获取数据,一直以来,他都倾向于OLAP型业务,并且聚焦于MapReduce类型负载。 因此,这两种技术是可以互补的。 将Ignite与Spark整合 整合这两种技术会为Spark用户带来若干明显的好处: 通过避免大量的数据移动,获得真正可扩展的内存级性能; 提高RDD、DataFrame和SQL的性能; 在Spark作业之间更方便地共享状态和数据。 下图中显示了如何整合这两种技术,并且标注了显著的优势: 在第一篇文章中,主要聚焦于IgniteRDD,而本文会聚焦于IgniteDataFrames。 IgniteDataframes Spark的DataFrame API为描述数据引入了模式的概念,Spark通过表格的形式进行模式的管理和数据的组织。 DataFrame是一个组织为命名列形式的分布式数据集,从概念上讲,DataFrame等同于关系数据库中的表,并允许Spark使用Catalyst查询优化器来生成高效的查询执行计划。而RDD只是跨集群节点分区化的元素集合。 Ignite扩展了DataFrames,简化了开发,改进了将Ignite作为Spark的内存存储时的数据访问时间,好处包括: 通过Ignite读写DataFrames时,可以在Spark作业之间共享数据和状态; 通过优化Spark的查询执行计划加快SparkSQL查询,这些主要是通过IgniteSQL引擎的高级索引以及避免了Ignite和Spark之间的网络数据移动实现的。 IgniteDataframes示例 下面通过一些代码以及搭建几个小程序的方式,了解Ignite DataFrames如何使用,如果想实际运行这些代码,可以从GitHub上下载。 一共会写两个Java的小应用,然后在IDE中运行,还会在这些Java应用中执行一些SQL。 一个Java应用会从JSON文件中读取一些数据,然后创建一个存储于Ignite的DataFrame,这个JSON文件Ignite的发行版中已经提供,另一个Java应用会从Ignite的DataFrame中读取数据然后使用SQL进行查询。 下面是写应用的代码: public class DFWriter { private static final String CONFIG = "config/example-ignite.xml"; public static void main(String args[]) { Ignite ignite = Ignition.start(CONFIG); SparkSession spark = SparkSession .builder() .appName("DFWriter") .master("local") .config("spark.executor.instances", "2") .getOrCreate(); Logger.getRootLogger().setLevel(Level.OFF); Logger.getLogger("org.apache.ignite").setLevel(Level.OFF); Dataset<Row> peopleDF = spark.read().json( resolveIgnitePath("resources/people.json").getAbsolutePath()); System.out.println("JSON file contents:"); peopleDF.show(); System.out.println("Writing DataFrame to Ignite."); peopleDF.write() .format(IgniteDataFrameSettings.FORMAT_IGNITE()) .option(IgniteDataFrameSettings.OPTION_CONFIG_FILE(), CONFIG) .option(IgniteDataFrameSettings.OPTION_TABLE(), "people") .option(IgniteDataFrameSettings.OPTION_CREATE_TABLE_PRIMARY_KEY_FIELDS(), "id") .option(IgniteDataFrameSettings.OPTION_CREATE_TABLE_PARAMETERS(), "template=replicated") .save(); System.out.println("Done!"); Ignition.stop(false); } } 在DFWriter中,首先创建了SparkSession,它包含了应用名,之后会使用spark.read().json()读取JSON文件并且输出文件内容,下一步是将数据写入Ignite存储。下面是DFReader的代码: public class DFReader { private static final String CONFIG = "config/example-ignite.xml"; public static void main(String args[]) { Ignite ignite = Ignition.start(CONFIG); SparkSession spark = SparkSession .builder() .appName("DFReader") .master("local") .config("spark.executor.instances", "2") .getOrCreate(); Logger.getRootLogger().setLevel(Level.OFF); Logger.getLogger("org.apache.ignite").setLevel(Level.OFF); System.out.println("Reading data from Ignite table."); Dataset<Row> peopleDF = spark.read() .format(IgniteDataFrameSettings.FORMAT_IGNITE()) .option(IgniteDataFrameSettings.OPTION_CONFIG_FILE(), CONFIG) .option(IgniteDataFrameSettings.OPTION_TABLE(), "people") .load(); peopleDF.createOrReplaceTempView("people"); Dataset<Row> sqlDF = spark.sql("SELECT * FROM people WHERE id > 0 AND id < 6"); sqlDF.show(); System.out.println("Done!"); Ignition.stop(false); } } 在DFReader中,初始化和配置与DFWriter相同,这个应用会执行一些过滤,需求是查找所有的id > 0 以及 < 6的人,然后输出结果。 在IDE中,通过下面的代码可以启动一个Ignite节点: public class ExampleNodeStartup { public static void main(String[] args) throws IgniteException { Ignition.start("config/example-ignite.xml"); } } 到此,就可以对代码进行测试了。 运行应用 首先在IDE中启动一个Ignite节点,然后运行DFWriter应用,输出如下: JSON file contents: +-------------------+---+------------------+ | department| id| name| +-------------------+---+------------------+ |Executive Committee| 1| Ivan Ivanov| |Executive Committee| 2| Petr Petrov| | Production| 3| John Doe| | Production| 4| Ann Smith| | Accounting| 5| Sergey Smirnov| | Accounting| 6|Alexandra Sergeeva| | IT| 7| Adam West| | Head Office| 8| Beverley Chase| | Head Office| 9| Igor Rozhkov| | IT| 10|Anastasia Borisova| +-------------------+---+------------------+ Writing DataFrame to Ignite. Done! 如果将上面的结果与JSON文件的内容进行对比,会显示两者是一致的,这也是期望的结果。 下一步会运行DFReader,输出如下: Reading data from Ignite table. +-------------------+--------------+---+ | DEPARTMENT| NAME| ID| +-------------------+--------------+---+ |Executive Committee| Ivan Ivanov| 1| |Executive Committee| Petr Petrov| 2| | Production| John Doe| 3| | Production| Ann Smith| 4| | Accounting|Sergey Smirnov| 5| +-------------------+--------------+---+ Done! 这也是期望的输出。 总结 通过本文,会发现使用Ignite DataFrames是如何简单,这样就可以通过Ignite DataFrame进行数据的读写了。 未来,这些代码示例也会作为Ignite发行版的一部分进行发布。 关于Ignite和Spark的集成,内容就是这些了。

优秀的个人博客,低调大师

Spring MVC之LocaleResolver详解

对于LocaleResolver,其主要作用在于根据不同的用户区域展示不同的视图,而用户的区域也称为Locale,该信息是可以由前端直接获取的。通过这种方式,可以实现一种国际化的目的,比如针对美国用户可以提供一个视图,而针对中国用户则可以提供另一个视图。本文主要讲解如果使用LocaleResolver来实现对用户不同视图切换的目的。 LocaleResolver是Spring提供的一个接口,其声明如下: public interface LocaleResolver { // 根据request对象根据指定的方式获取一个Locale,如果没有获取到,则使用用户指定的默认的Locale Locale resolveLocale(HttpServletRequest request); // 用于实现Locale的切换。比如SessionLocaleResolver获取Locale的方式是从session中读取,但如果 // 用户想要切换其展示的样式(由英文切换为中文),那么这里的setLocale()方法就提供了这样一种可能 void setLocale(HttpServletRequest request, @Nullable HttpServletResponse response, @Nullable Locale locale); } 针对LocaleResolver,Spring提供了几种实现方式,分别如下: FixedLocaleResolver:在声明该resolver时,需要指定一个默认的Locale,在进行Locale获取时,始终返回该Locale,并且调用其setLocale()方法也无法改变其Locale; CookieLocaleResolver:其读取Locale的方式是在session中通过Cookie来获取其指定的Locale的,如果修改了Cookie的值,页面视图也会同步切换; SessionLocaleResolver:其会将Locale信息存储在session中,如果用户想要修改Locale信息,可以通过修改session中对应属性的值即可; AcceptHeaderLocaleResolver:其会通过用户请求中名称为Accept-Language的header来获取Locale信息,如果想要修改展示的视图,只需要修改该header信息即可。 需要说明的是,Spring虽然提供的几个不同的获取Locale的方式,但这些方式处理FixedLocaleResolver以外,其他几个也都支持在浏览器地址栏中添加locale参数来切换Locale。对于Locale的切换,Spring是通过拦截器来实现的,其提供了一个LocaleChangeInterceptor,在该拦截器中的preHandle()方法中,Spring会读取浏览器参数中的locale参数,然后调用LocaleResolver.setLocale()方法来实现对Locale的切换。 这里我们以CookieLocaleResolver为例来讲解如何通过不同的Locale展示不同的视图。首先是我们的xml文件配置: <context:component-scan base-package="mvc"/> <mvc:annotation-driven/> <mvc:interceptors> <bean class="org.springframework.web.servlet.i18n.LocaleChangeInterceptor"/> <bean class="mvc.interceptor.MyHandlerInterceptor"/> </mvc:interceptors> <bean class="org.springframework.web.servlet.view.ResourceBundleViewResolver"/> <bean id="localeResolver" class="org.springframework.web.servlet.i18n.CookieLocaleResolver"> <property name="defaultLocale" value="zh_CN"/> </bean> 关于上述配置有三点需要说明: 指定了使用的LocaleResolver为CookieLocaleResolver,并且defaultLocale指定为zh_CN,需要注意的是,Spring中LocaleResolver的bean名称必须为localeResolver,因为Spring读取该bean时是通过该名称读取的; 上述配置总还指定了ViewResolver为ResourceBundleViewResolver,这里不能使用InternalResourceViewResolver,因为其不支持通过不同的Locale进行不同的视图切换,而ResourceBundleViewResolver是支持的; 配置中添加了LocaleChangeInterceptor的拦截器,用于对Locale的切换,如果不需要Locale切换的功能,可以不指定该拦截器。 对于后台接口的声明,其与一般的接口声明是没有区别的。如下是我们声明的一个接口: @Controller @RequestMapping("/user") public class UserController { @Autowired private UserService userService; @RequestMapping(value = "/detail", method = RequestMethod.GET) public ModelAndView detail(@RequestParam("id") long id, @ModelAttribute("message") String message, Locale locale) { System.out.println(message); ModelAndView view = new ModelAndView("user"); User user = userService.detail(id); view.addObject("user", user); view.addObject("locale", locale); return view; } } 上述接口返回的视图为user,并且将当前用户的Locale信息返回给了前端,可以看到,这里获取Locale数据的方式就只需要简单的声明一个类型为Locale的参数即可。 关于视图的展示,由于我们需要根据不同的Locale展示不同的视图,而在上述接口中,我们暂时没发现这样的路由。实际上,这个路由是通过ResourceBundleViewResolver类实现的,在使用该ViewResovler时,其会到class路径下查找名称为views的Resource Bundle,并且通过用户指定的Locale,唯一定位到某个Resource Bundle。然后在该Resource Bundle中查找指定的视图信息,比如这里接口返回的视图为user,那么就会在获取到的Resource Bundle查找user.(class)和user.url信息,这里user.(class)指定了展示该视图所需要的View对象的,而user.url则指定了具体的视图位置。比如如下配置的就是Locale分别为zh_CN和en_US的视图: # views_zh_CN.properties user.(class)=org.springframework.web.servlet.view.InternalResourceView user.url=/WEB-INF/view/user_zh_CN.jsp # views_en_US.properties user.(class)=org.springframework.web.servlet.view.InternalResourceView user.url=/WEB-INF/view/user_en_US.jsp 通过这种方式,ResourceBundleViewResolver就实现了针对不同的Locale来展示不同的视图的目的。如下是我们编写的两个分别用于zh_CN和en_US视图展示的jsp页面: <!-- user_zh_CN.jsp --> <%@ taglib prefix="spring" uri="http://www.springframework.org/tags" %> <%@ page contentType="text/html;charset=UTF-8" language="java" %> <html> <head> <title>User Jsp-zh CN</title> </head> <body> ${user.id}&nbsp;&nbsp;${user.name}&nbsp;&nbsp;${user.age}&nbsp;&nbsp;${locale} </body> </html> <!-- user_en_US.jsp --> <%@ taglib prefix="spring" uri="http://www.springframework.org/tags" %> <%@ page contentType="text/html;charset=UTF-8" language="java" %> <html> <head> <title>User Jsp-en US</title> </head> <body> ${user.id}&nbsp;&nbsp;${user.name}&nbsp;&nbsp;${user.age}&nbsp;&nbsp;${locale} </body> </html> 启动上述程序,我们在浏览器中键入http://localhost:8080/user/detail?id=1,可以看到其展示了如下视图: 1 Bob 27 zh_CN 如果我们添加名称为org.springframework.web.servlet.i18n.CookieLocaleResolver.LOCALE,值为en_US的cookie,那么其展示的页面切换如下: 1 Bob 27 en_US 这说明我们成功使用Cookie对Locale进行了切换。如果我们在浏览器地址栏中添加locale=zh_CN的参数,可以看到,页面展示又切换为了前面那种情况。 本文主要对LocaleResolver进行了讲解,并且演示了如何通过配置不同的LocaleResolver来达到实现展示不同的视图的目的。需要注意的是,我们的LocaleResolver的bean名称必须为localeResolver,并且需要指定的ViewResolver辅以支持,否则切换的视图可能无法正常工作。

优秀的个人博客,低调大师

Spring MVC之RequestMappingHandlerMapping匹配

对于RequestMappingHandlerMapping,使用Spring的同学基本都不会陌生,该类的作用有两个: 通过request查找对应的HandlerMethod,即当前request具体是由Controller中的哪个方法进行处理; 查找当前系统中的Interceptor,将其与HandlerMethod封装为一个HandlerExecutionChain。 本文主要讲解RequestMappingHandlerMapping是如何获取HandlerMethod和Interceptor,并且将其封装为HandlerExecutionChain的。 1.整体封装结构 RequestMappingHandlerMapping实现了HandlerMapping接口,该接口的主要方法如下: public interface HandlerMapping { // 通过request获取HandlerExecutionChain对象 HandlerExecutionChain getHandler(HttpServletRequest request) throws Exception; } 这里我们直接看RequestMappingHandlerMapping是如何实现该接口的: @Override @Nullable public final HandlerExecutionChain getHandler(HttpServletRequest request) throws Exception { // 通过request获取具体的处理bean,这里handler可能有两种类型:HandlerMethod和String。 // 如果是String类型,那么就在BeanFactory中查找该String类型的bean,需要注意的是,返回的 // bean如果是需要使用RequestMappingHandlerAdapter处理,那么也必须是HandlerMethod类型的 Object handler = getHandlerInternal(request); if (handler == null) { // 如果找不到处理方法,则获取自定义的默认handler handler = getDefaultHandler(); } if (handler == null) { return null; } if (handler instanceof String) { // 如果获取的handler是String类型的,则在当前BeanFactory中获取该名称的bean, // 并将其作为handler返回 String handlerName = (String) handler; handler = obtainApplicationContext().getBean(handlerName); } // 获取当前系统中配置的Interceptor,将其与handler一起封装为一个HandlerExecutionChain HandlerExecutionChain executionChain = getHandlerExecutionChain(handler, request); // 这里CorsUtils.isCorsRequest()方法判断的是当前请求是否为一个跨域的请求,如果是一个跨域的请求, // 则将跨域相关的配置也一并封装到HandlerExecutionChain中 if (CorsUtils.isCorsRequest(request)) { CorsConfiguration globalConfig = this.globalCorsConfigSource.getCorsConfiguration(request); CorsConfiguration handlerConfig = getCorsConfiguration(handler, request); CorsConfiguration config = (globalConfig != null ? globalConfig.combine(handlerConfig) : handlerConfig); executionChain = getCorsHandlerExecutionChain(request, executionChain, config); } return executionChain; } 从上面的代码可以看出,对于HandlerExecutionChain的获取,RequestMappingHandlerMapping首先会获取当前request对应的handler,然后将其与Interceptor一起封装为一个HandlerExecutionChain对象。这里在进行封装的时候,Spring会对当前request是否为跨域请求进行判断,如果是跨域请求,则将相关的跨域配置封装到HandlerExecutionChain中,关于跨域请求,读者可以阅读跨域资源共享 CORS 详解。 2. 获取HandlerMethod 关于RequestMappingHandlerMapping是如何获取handler的,其主要在getHandlerInternal()方法中,如下是该方法的源码: @Override protected HandlerMethod getHandlerInternal(HttpServletRequest request) throws Exception { // 获取当前request的URI String lookupPath = getUrlPathHelper().getLookupPathForRequest(request); if (logger.isDebugEnabled()) { logger.debug("Looking up handler method for path " + lookupPath); } // 获取注册的Mapping的读锁 this.mappingRegistry.acquireReadLock(); try { // 通过path和request查找具体的HandlerMethod HandlerMethod handlerMethod = lookupHandlerMethod(lookupPath, request); if (logger.isDebugEnabled()) { if (handlerMethod != null) { logger.debug("Returning handler method [" + handlerMethod + "]"); } else { logger.debug("Did not find handler method for [" + lookupPath + "]"); } } // 如果获取到的bean是一个String类型的,则在BeanFactory中查找该bean, // 并将其封装为一个HandlerMethod对象 return (handlerMethod != null ? handlerMethod.createWithResolvedBean() : null); } finally { // 释放当前注册的Mapping的读锁 this.mappingRegistry.releaseReadLock(); } } 上述方法中,其首先会获取当前request的uri,然后通过uri查找HandlerMethod,并且在最后,会判断获取到的HandlerMethod中的bean是否为String类型的,如果是,则在当前BeanFactory中查找该名称的bean,并且将其封装为HandlerMethod对象。这里我们直接阅读lookupHandlerMethod()方法: @Nullable protected HandlerMethod lookupHandlerMethod(String lookupPath, HttpServletRequest request) throws Exception { List<Match> matches = new ArrayList<>(); // 通过uri直接在注册的RequestMapping中获取对应的RequestMappingInfo列表,需要注意的是, // 这里进行查找的方式只是通过url进行查找,但是具体哪些RequestMappingInfo是匹配的,还需要进一步过滤 List<T> directPathMatches = this.mappingRegistry.getMappingsByUrl(lookupPath); if (directPathMatches != null) { // 对获取到的RequestMappingInfo进行进一步过滤,并且将过滤结果封装为一个Match列表 addMatchingMappings(directPathMatches, matches, request); } if (matches.isEmpty()) { // 如果无法通过uri进行直接匹配,则对所有的注册的RequestMapping进行匹配,这里无法通过uri // 匹配的情况主要有三种: // ①在RequestMapping中定义的是PathVariable,如/user/detail/{id}; // ②在RequestMapping中定义了问号表达式,如/user/?etail; // ③在RequestMapping中定义了*或**匹配,如/user/detail/** addMatchingMappings(this.mappingRegistry.getMappings().keySet(), matches, request); } if (!matches.isEmpty()) { // 对匹配的结果进行排序,获取相似度最高的一个作为结果返回,这里对相似度的判断时, // 会判断前两个是否相似度是一样的,如果是一样的,则直接抛出异常,如果不相同, // 则直接返回最高的一个 Comparator<Match> comparator = new MatchComparator(getMappingComparator(request)); matches.sort(comparator); if (logger.isTraceEnabled()) { logger.trace("Found " + matches.size() + " matching mapping(s) for [" + lookupPath + "] : " + matches); } // 获取匹配程度最高的一个匹配结果 Match bestMatch = matches.get(0); if (matches.size() > 1) { // 如果匹配结果不止一个,首先会判断是否是跨域请求,如果是, // 则返回PREFLIGHT_AMBIGUOUS_MATCH,如果不是,则会判断前两个匹配程度是否相同, // 如果相同则抛出异常 if (CorsUtils.isPreFlightRequest(request)) { return PREFLIGHT_AMBIGUOUS_MATCH; } Match secondBestMatch = matches.get(1); if (comparator.compare(bestMatch, secondBestMatch) == 0) { Method m1 = bestMatch.handlerMethod.getMethod(); Method m2 = secondBestMatch.handlerMethod.getMethod(); throw new IllegalStateException("Ambiguous handler methods mapped for" + " HTTP path '" + request.getRequestURL() + "': {" + m1 + ", " + m2 + "}"); } } // 这里主要是对匹配结果的一个处理,主要包含对传入参数和返回的MediaType的处理 handleMatch(bestMatch.mapping, lookupPath, request); return bestMatch.handlerMethod; } else { // 如果匹配结果是空的,则对所有注册的Mapping进行遍历,判断当前request具体是哪种情况导致 // 的无法匹配:①RequestMethod无法匹配;②Consumes无法匹配;③Produces无法匹配; // ④Params无法匹配 return handleNoMatch(this.mappingRegistry.getMappings().keySet(), lookupPath, request); } } 这里对于结果的匹配,首先会通过uri进行直接匹配,如果能匹配到,则在匹配结果中尝试进行RequestMethod,Consumes和Produces等配置的匹配;如果通过uri不能匹配到,则直接对所有定义的RequestMapping进行匹配,这里主要是进行正则匹配,如果能匹配到。如果能够匹配到,则对匹配结果按照相似度进行排序,并且对前两个结果相似度进行比较,如果相似度一样,则抛出异常,如果不一样,则返回相似度最高的一个匹配结果。如果无法获取到匹配结果,则对所有的匹配结果进行遍历,判断当前request具体是哪一部分参数无法匹配到结果。对于匹配结果的获取,主要在addMatchingMappings()方法中,这里我们继续阅读该方法的源码: private void addMatchingMappings(Collection<T> mappings, List<Match> matches, HttpServletRequest request) { for (T mapping : mappings) { T match = getMatchingMapping(mapping, request); if (match != null) { matches.add(new Match(match, this.mappingRegistry.getMappings().get(mapping))); } } } 对于RequestMapping的匹配,这里逻辑比较简单,就是对所有的RequestMappingInfo进行遍历,然后将request分别于每个RequestMappingInfo进行匹配,如果匹配上了,其返回值就不为空,最后将所有的匹配结果返回。如下是getMatchingMapping()方法的源码(其最终调用的是RequestMappingInfo.getMatchingCondition()方法): @Override @Nullable public RequestMappingInfo getMatchingCondition(HttpServletRequest request) { // 判断request请求的类型是否与当前RequestMethod匹配 RequestMethodsRequestCondition methods = this.methodsCondition.getMatchingCondition(request); // 判断request请求的参数是否与RequestMapping中params参数配置的一致 ParamsRequestCondition params = this.paramsCondition.getMatchingCondition(request); // 判断request请求的headers是否与RequestMapping中headers参数配置的一致 HeadersRequestCondition headers = this.headersCondition.getMatchingCondition(request); // 判断request的请求体类型是否与RequestMapping中配置的consumes参数配置的一致 ConsumesRequestCondition consumes = this.consumesCondition.getMatchingCondition(request); // 判断当前RequestMapping将要返回的请求体类型是否与request中Accept的header指定的一致 ProducesRequestCondition produces = this.producesCondition.getMatchingCondition(request); // 对于上述几个判断,如果匹配上了,那么其返回值都不会为空,因而这里会对每个返回值都进行判断, // 如果有任意一个为空,则说明没匹配上,那么就返回null if (methods == null || params == null || headers == null || consumes == null || produces == null) { return null; } // 对于前面的匹配,都是一些静态属性的匹配,其中最重要的uri的匹配,主要是正则匹配, // 就是在下面这个方法中进行的 PatternsRequestCondition patterns = this.patternsCondition.getMatchingCondition(request); // 如果URI没匹配上,则返回null if (patterns == null) { return null; } // 这里主要是对用户自定义的匹配条件进行匹配 RequestConditionHolder custom = this.customConditionHolder.getMatchingCondition(request); if (custom == null) { return null; } // 如果上述所有条件都匹配上了,那么就将匹配结果封装为一个RequestMappingInfo返回 return new RequestMappingInfo(this.name, patterns, methods, params, headers, consumes, produces, custom.getCondition()); } 可以看到,对于一个RequestMapping的匹配,主要包括:RequestMethod,Params,Headers,Consumes,Produces,Uri和自定义条件的匹配,如果这几个条件都匹配上了,才能表明当前RequestMapping与request匹配上了。 3. Interceptor的封装 关于Inteceptor的封装,由前述第一点可以看出,其主要在getHandlerExecutionChain()方法中,如下是该方法的源码: protected HandlerExecutionChain getHandlerExecutionChain(Object handler, HttpServletRequest request) { // 将当前handler封装到HandlerExecutionChain对象中 HandlerExecutionChain chain = (handler instanceof HandlerExecutionChain ? (HandlerExecutionChain) handler : new HandlerExecutionChain(handler)); // 获取当前request的URI,用于MappedInterceptor的匹配 String lookupPath = this.urlPathHelper.getLookupPathForRequest(request); // 对当前所有注册的Interceptor进行遍历,如果其是MappedInterceptor类型,则调用其matches() // 方法,判断当前Interceptor是否能够应用于该request,如果可以,则添加到HandlerExecutionChain中 for (HandlerInterceptor interceptor : this.adaptedInterceptors) { if (interceptor instanceof MappedInterceptor) { MappedInterceptor mappedInterceptor = (MappedInterceptor) interceptor; if (mappedInterceptor.matches(lookupPath, this.pathMatcher)) { chain.addInterceptor(mappedInterceptor.getInterceptor()); } } else { // 如果当前Interceptor不是MappedInterceptor类型,则直接将其添加到 // HandlerExecutionChain中 chain.addInterceptor(interceptor); } } return chain; } 对于拦截器,理论上,Spring是会将所有的拦截器都进行一次调用,对于是否需要进行拦截,都是用户自定义实现的。这里如果对于URI有特殊的匹配,可以使用MappedInterceptor,然后实现其matches()方法,用于判断当前MappedInterceptor是否能够应用于当前request。 4. 小结 本文首先讲解了Spring是如何通过request进行匹配,从而找到具体处理当前请求的RequestMapping的,然后讲解了Spring是如何封装Interceptor,将HandlerMethod和Interceptor封装为一个HandlerExecutionChain的。


优秀的个人博客,低调大师

Java 异常处理 之 实例

http://www.verejava.com/?id=16992994231782 package com.exception2; /** 题目: 老师正在给学生上课, 突然某个学生说网络断了, 老师你来帮助处理一下 没办法,我只能去找网管 */ //网管类 public class TestException3 { public static void main(String[] args) throws MyException { //实列化一个老师 Teacher t = new Teacher("胡杨"); //实列化学生 Student s = new Student("候文桌"); //老师 在 教学生上课 //网管说我来处理 t.teach(s); } } class Teacher { private String name; public Teacher(String name) { this.name = name; } //老师正在给学生上课 public void teach(Student s) throws MyException { //老师正在给学生上课 是一个持续的状态 int i = 0; while (true) { System.out.println(this.name + " 给 " + s.getName() + " 上课 "); i++; try { Thread.sleep(1000); if (i == 5) { //突然某个学生说网络断了 //抛出一个异常 //老师你来帮助处理一下 throw new MyException("突然" + s.getName() + "说网络断了"); } } catch (InterruptedException e) { e.printStackTrace(); } } } public String getName() { return name; } public void setName(String name) { this.name = name; } } class Student { private String name; public Student(String name) { this.name = name; } public String getName() { return name; } public void setName(String name) { this.name = name; } } class MyException extends Exception { private String message; public MyException(String message) { this.message = message; } public String getMessage() { return message; } public void setMessage(String message) { this.message = message; } } http://www.verejava.com/?id=16992994231782

优秀的个人博客,低调大师

我要做 Android 之 ContentProvider

相信大家对于 Android 顶顶大名的四大组件也不陌生了。今天我们来谈一谈 ContentProvider 的用法。什么东西都是基本最重要啊,可以人是一个健忘的动物,所以需要做下来笔记,常看常新。愿我们成为真实的自己。 ContentProvider概要 从系统提供的Provider访问数据 内容URI的组成 ContentResolve类 创建自己的Provider UriMater类 自定义一个Provider的步骤 ContentProvider 也有存储数据的功能,但是与安卓自带的数据库和 SharedPreferences 以及文件存储方法不同的是,后者保存下的数据只能被该应用程序使用,而前者可以让不同应用程序之间进行数据共享,它还可以选择只对哪一部分数据进行共享,从而保证程序中的隐私数据不会有泄漏风险。所以组件ContentProvider主要负责存储和共享数据。 ContentProvider有两种形式:可以使用现有的内容提供者来读取和操作相应程序中的数据,也可以创建自己的内容提供者给这个程序的数据提供外部访问接口。 2.从系统提供的Provider访问数据 既然ContentProvider有对外共享数据的功能,换句话说,其他应用程序可以通过ContentProvider对应用中的数据进行增删改查,之前学习SQLite数据存储的时候就提到过可以实现增删改查的各种辅助性方法,实际上ContentProvider是对SQLiteOpenHelper的进一步封装,不过不再用单纯的表名指明被操作的表,毕竟现在是其他程序访问它,而是用有一定格式规范的内容URI来代替。下面先来学习URI的组成。 (1)URI的组成 以之前学习数据库的demo为例,它的包名是com.example.myapplication,如果其他程序想访问该程序student.db中的student表,那么需要的内容URI如图所示: 01.png 可以看出内容 URI 可以非常清楚地表达出我们想要访问哪个程序中哪张表里的数据,但还没完,还需要将它解析成 Uri 对象才可以作为参数传入。通过调用 Uri.parse()方法,就可以将内容 URI 字符串解析成 Uri 对象了,代码如下: 02.png Uri 这个类就是专门做这种链接转换的。其实这种链接方式和 http 很像。content:是不能变化的,后面就是包名.provider ,也是一定的,最后就是表名。 (2)ContentResolve类 现在有了酷似“表名”的Uri,类似的,在ContentResolver类中提供的一系列用于对数据进行增删改查操作的方法也酷似SQLiteDatabase的那些辅助性方法:insert()方法用于添加数据,update()方法用于更新数据,delete()方法用于删除数据,query()方法用于查询数据。它们不仅方法名一样,连提供的参数都非常相似,见下图,红色部分是区别: 03.png 所以其他程序若想要访问ContentProvider中共享的数据的方法是: 第一:通过 Context 中的 getContentResolver() 方法实例化一个 ContentResolver 对象。 第二:调用该对象的增删改查方法去操作 ContentProvider 中的数据。 下面我们来看看查询联系人数据的基本代码: 04.png 别忘记在注册文件中声明权限 不但如此,Android 6.0 之后有了运行时权限,所以我们还要加上判断才可以。 05.png 这一部分是通用代码,大家可以在使用的过程中把这部分代码封装到 BaseActivity 中去。这样可以增加代码复用。 06.png 这是需要动态申请权限的图标,不过没关系,大家记不得可以去查找一下即可。 3.创建自己的Provider (1)UriMater类 UriMater 类有匹配内容 URI 的功能,在这里常用它的两个方法:一个是 addURI() 方法来传入 URI,它接收三个参数(权限,路径,一个自定义代码);另一个是 match() 方法用来匹配 URI,接收一个 Uri 对象,返回值是某个能够匹配这个 Uri 对象所对应的自定义代码,利用这个自定义代码,就可以判断出调用方期望访问的是哪张表中的数据了。 (2)自定义一个Provider的步骤 步骤一:新建一个类去继承ContentProvider。 步骤二:重写ContentProvider的六个抽象方法,方法及含义如图: public class MyProvider extends ContentProvider { // 在ContentProvider 创建后调用 @Override public boolean onCreate() { return false; } //该方法用于提供外部应用从 ContentProvider 中获取数据 @Nullable @Override public Cursor query(@NonNull Uri uri, @Nullable String[] projection, @Nullable String selection, @Nullable String[] selectionArgs, @Nullable String sortOrder) { return null; } @Nullable @Override //用于返回当前 Uri 代表的 MIME 类型 public String getType(@NonNull Uri uri) { return null; } //该方法用于提供外部应用从 ContentProvider 中插入数据 @Nullable @Override public Uri insert(@NonNull Uri uri, @Nullable ContentValues values) { return null; } //该方法用于提供外部应用从 ContentProvider 中删除数据 @Override public int delete(@NonNull Uri uri, @Nullable String selection, @Nullable String[] selectionArgs) { return 0; } //该方法用于提供外部应用从 ContentProvider 中修改数据 @Override public int update(@NonNull Uri uri, @Nullable ContentValues values, @Nullable String selection, @Nullable String[] selectionArgs) { return 0; } } 步骤三:在配置文件中进行注册,并注明属性: android:authorities即Provider的权限,形式是包名.provider android:name即Provider的全名,形式是包名.类名 android:exported="true"指明该Provider可被其它程序访问。 (3)例子:为student.db创建MyProvider 接下里还是给上篇的数据库demo创建一个自定义提供器MyProvider,然后在别的应用程序中通过MyProvider去操作student.db中的数据。 开始自定义提供器!一开始定义了四个常量,分别表示访问student表中的所有数据、访问student表中的单条数据(student/#用于表示student表中任意一行记录)、访问course表中的所有数据和访问course表中的单条数据。然后在静态代码块里对UriMatcher进行了初始化操作,将期望匹配的几种URI格式添加了进去。 07.png 接下来就是六个抽象方法的具体实现了,先看onCreate()方法,这里创建了一个MyHelper的实例,然后返回true表示内容提供器初始化成功,现在数据库就已经完成了创建或升级操作。 08.png 接下来是 getType()方法,需要返回一个MIME字符串。一个内容URI所对应的MIME字符串主要由三部分组分,Android对这三个部分做了以下格式规定:必须以vnd开头;如果内容URI以路径结尾,则后接android.cursor.dir/,如果内容URI以id结尾,则后接android.cursor.item/;最后接上vnd.< authority>.< path>。所以四个内容URI对应的MIME字符串分别是: 09.png 在query()方法里先获取到SQLiteDatabase的实例,然后根据传入的Uri参数判断出用户想要访问哪张表,再调用SQLiteDatabase的query()进行查询并将Cursor对象返回就好了。注意当访问的是单条数据时调用了Uri对象的getPathSegments()方法,它会将内容URI权限之后的部分以“/”符号进行分割,并把分割后的结果放入到一个字符串列表中,那这个列表的第0个位置存放的就是路径,第1个位置存放的就是id了。得到了id之后,再通过selection和selectionArgs参数进行约束,就实现了查询单条数据的功能。 补充部分:事务有关: 事务是恢复和并发控制的基本单位。 事务应该具有4个属性:原子性、一致性、隔离性、持久性。这四个属性通常称为ACID特性。 原子性(atomicity)。一个事务是一个不可分割的工作单位,事务中包括的诸操作要么都做,要么都不做。 一致性(consistency)。事务必须是使数据库从一个一致性状态变到另一个一致性状态。一致性与原子性是密切相关的。 隔离性(isolation)。一个事务的执行不能被其他事务干扰。即一个事务内部的操作及使用的数据对并发的其他事务是隔离的,并发执行的各个事务之间不能互相干扰。 持久性(durability)。持续性也称永久性(permanence),指一个事务一旦提交,它对数据库中数据的改变就应该是永久性的。接下来的其他操作或故障不应该对其有任何影响。 /** * SQLite的事务管理 */ public void transation() { SQLiteDatabase db = helper.getWritableDatabase(); // 事务开始 db.beginTransaction(); //事务的处理 try { db.execSQL("update person set age = age-1 where name = 'xiaohong'"); db.execSQL("update person set age = age+1 where name = 'xiaolan'"); //事务处理成功 db.setTransactionSuccessful(); } finally { //结束事务 db.endTransaction(); } } 当使用 sqlite 数据库批量插入数据的时候使用事务就可以提升效率。 在使用 sqlite 数据库的时候有那些可以优化的地方。 一:显示使用事务 Android中,无论是使用SQLiteDatabase的insert,delete等方法还是execSQL都开启了事务,来确保每一次操作都具有原子性,使得结果要么是操作之后的正确结果,要么是操作之前的结果。所以我们可以显示的支持事务,这样事务的操作打开次数会明显变少。 二:建立索引 创建索引的基本语法: CREATE INDEX index_name ON table_name; 三:及时关闭Cursor 四:耗时异步化 数据库的操作,属于本地IO,通常比较耗时,如果处理不好,很容易导致ANR,因此建议将这些耗时操作放入异步线程中处理。 今天状态不够好,前途漫漫不知路在何方。只能一步一步向前走。 愿我们成为真实的自己。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册