首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

Dubbo之SPI原理详解

SPI全称为Service Provider Interface,是一种服务提供机制,比如在现实中我们经常会有这种场景,就是对于一个规范定义方而言(可以理解为一个或多个接口),具体的服务实现方是不可知的(可以理解为对这些接口的实现类),那么在定义这些规范的时候,就需要规范定义方能够通过一定的方式来获取到这些服务提供方具体提供的是哪些服务,而SPI就是进行这种定义的。 1. jdk与Dubbo SPI对比 比较典型的SPI定义方式有jdk的SPI,其主要是在项目的META-INF/services目录下以接口的全路径名为文件名,然后在该文件中声明该接口的具体实现类有哪些。这里说的META-INF/services目录和其中的文件主要是在服务提供方的jar包中。这里的整体流程可以理解为,首先规范制定方会定义一个接口,比如com.jdk.spi.Fruit,然后其通过读取项目目录下(包括所依赖的jar包中)的META-INF/service名称为com.jdk.spi.Fruit的文件,获取其中定义的子类,接着读取并实例化该类的对象,作为目标接口的实现类来使用。通过这种方式,服务提供方只需要在其提供的jar包的META-INF/services目录中声明其提供的子类服务是什么即可。对于jdk的SPI,其主要存在两个问题: 为每个接口提供的服务一般尽量只提供一个,因为jdk的SPI默认会将所有目标文件中定义的所有子类都读取到返回使用; 当定义多个子类实现时,无法动态的根据配置来使用不同的配置; 基于上述两个问题,dubbo对jdk的SPI进行了扩展。从整体流程上而言,dubbo的SPI与jdk的SPI相似,也就是在规范制定方会定义一定的接口,然后读取项目的META-INF/dubbo/internal目录下的以接口全路径名定义的文件,最后通过所需要的key值来获取不同的子类实现。 2. Dubbo SPI示例 这里假设对于规范提供方定义了一个com.dubbo.spi.Fruit的接口,该接口的具体声明如下: @SPI public interface Fruit { void eat(); } 这里的@SPI注解的主要用于标识当前接口是一个dubbo的SPI接口。如下是规范制定方使用该接口的方式: public class ExtensionFactoryApp { public static void main(String[] args) { Fruit apple = ExtensionLoader.getExtensionLoader(Fruit.class).getExtension("banana"); apple.eat(); } } 这里ExtensionLoader.getExtensionLoader()方法会读取META-INF/dubbo/internal目录下的名称为com.dubbo.spi.Fruit的文件,然后getExtension("banana")方法会获取该文件中key值为banana的子类,并且进行实例化返回。通过这种方式,我们的规范定义方就不需要知道具体的Fruit实现类是什么,而只需要按照一定的规则进行读取并使用即可。 对于服务提供方而言,其首先需要在META-INF/dubbo/internal目录下定义一个名称为com.dubbo.spi.Fruit的文件,如下是该文件的内容: apple=com.dubbo.spi.impl.Apple banana=com.dubbo.spi.impl.Banana 可以看到,这里为Fruit接口定义了两个实现类Apple和Banana,对应的key分别为apple和banana。我们运行上述程序,可以看到如下输出: eat banana 3. 实现原理 通过上面的示例可以看出,dubbo对于SPI的实现主要是在ExtensionLoader这个类中,这个类主要有三个方法: public T getExtension(String name); public T getAdaptiveExtension(); public static <T> ExtensionLoader<T> getExtensionLoader(Class<T> type); getExtension():主要用于获取名称为name的对应的子类的对象,这里如果子类对象如果有AOP相关的配置,这里也会对其进行封装; getAdaptiveExtension():使用定义的装饰类来封装目标子类,具体使用哪个子类可以在定义的装饰类中通过一定的条件进行配置; getExtensionLoader():加载当前接口的子类并且实例化一个ExtensionLoader对象。 3.1 getExtension() 这里getExtension()方法的主要作用是获取name对应的子类对象返回。其实现方式是首先读取定义文件中的子类,然后根据不同的子类对象的功能的不同,比如使用@Adaptive修饰的装饰类和用于AOP的Wrapper类,将其封装到不同的缓存中。最后根据传入的name获取其对应的子类对象,并且使用相应的Wrapper类对其进行封装。如下是getExtension()方法的源码: @SuppressWarnings("unchecked") public T getExtension(String name) { if (name == null || name.length() == 0) { throw new IllegalArgumentException("Extension name == null"); } // 如果名称为true,则返回默认的子类对象,这里默认的子类对象的name定义在目标接口的@SPI注解中 if ("true".equals(name)) { return getDefaultExtension(); } // 查看当前是否已经缓存有保存目标对象的实例的Holder对象,缓存了则直接返回, // 没缓存则创建一个并缓存起来 Holder<Object> holder = cachedInstances.get(name); if (holder == null) { cachedInstances.putIfAbsent(name, new Holder<Object>()); holder = cachedInstances.get(name); } // 如果无法从Holder中获取目标对象的实例,则使用双检查法为目标对象创建一个实例 Object instance = holder.get(); if (instance == null) { synchronized (holder) { instance = holder.get(); if (instance == null) { // 创建name对应的子类对象的实例 instance = createExtension(name); holder.set(instance); } } } return (T) instance; } 可以看到,关于对于目标对象的获取,首先是从缓存里取,没取到才会进行创建。这里需要说明的是,如果传入的name为true,那么就会返回默认的子类实例,而默认的子类实例是通过其名称进行映射的,该名称存储在目标接口的@SPI注解中。如下是createExtension()方法的源码: @SuppressWarnings("unchecked") private T createExtension(String name) { // 获取当前名称对应的子类类型,如果不存在,则抛出异常 Class<?> clazz = getExtensionClasses().get(name); if (clazz == null) { throw findException(name); } try { // 获取当前class对应的实例,如果缓存中不存在,则实例化一个并缓存起来 T instance = (T) EXTENSION_INSTANCES.get(clazz); if (instance == null) { EXTENSION_INSTANCES.putIfAbsent(clazz, clazz.newInstance()); instance = (T) EXTENSION_INSTANCES.get(clazz); } // 为生成的实例通过其set方法注入对应的实例,这里实例的获取方式不仅可以通过SPI的方式 // 也可以通过Spring的bean工厂获取 injectExtension(instance); Set<Class<?>> wrapperClasses = cachedWrapperClasses; if (wrapperClasses != null && !wrapperClasses.isEmpty()) { for (Class<?> wrapperClass : wrapperClasses) { // 实例化各个wrapper对象,并将目标对象通过wrapper的构造方法传入, // 另外还会通过wrapper对象的set方法对其依赖的属性进行注入 instance = injectExtension((T) wrapperClass.getConstructor(type) .newInstance(instance)); } } return instance; } catch (Throwable t) { throw new IllegalStateException("Extension instance(name: " + name + ", class: " + type + ") could not be instantiated: " + t.getMessage(), t); } } 在createExtension()方法中,其主要做了三件事:a. 加载定义文件中的各个子类,然后将目标name对应的子类返回;b. 通过目标子类的set方法为其注入其所依赖的bean,这里既可以通过SPI,也可以通过Spring的BeanFactory获取所依赖的bean;c. 获取定义文件中定义的wrapper对象,然后使用该wrapper对象封装目标对象,并且还会调用其set方法为wrapper对象注入其所依赖的属性。 关于wrapper对象,这里需要说明的是,其主要作用是为目标对象实现AOP。wrapper对象有两个特点:a. 与目标对象实现了同一个接口;b. 有一个以目标接口为参数类型的构造函数。这也就是上述createExtension()方法最后封装wrapper对象时传入的构造函数实例始终可以为instance实例的原因。这里我们首先看getExtensionClasses()方法是如何实现的: private Map<String, Class<?>> getExtensionClasses() { Map<String, Class<?>> classes = cachedClasses.get(); if (classes == null) { synchronized (cachedClasses) { classes = cachedClasses.get(); if (classes == null) { // 加载定义文件,并且将定义的类按照功能缓存在不同的属性中,即: // a. 目标class类型缓存在cachedClasses; // b. wrapper的class类型缓存在cachedWrapperClasses; // c. 用于装饰的class类型缓存在cachedAdaptiveClass; classes = loadExtensionClasses(); cachedClasses.set(classes); } } } return classes; } 上述代码中,主要是在缓存中获取目标class的map缓存,如果不存在则通过定义文件加载。这里我们继续看loadExtensionClasses()的源码: private Map<String, Class<?>> loadExtensionClasses() { // 获取目标接口上通过@SPI注解定义的默认子类对应的名称,并将其缓存在cachedDefaultName中 final SPI defaultAnnotation = type.getAnnotation(SPI.class); if (defaultAnnotation != null) { String value = defaultAnnotation.value(); if ((value = value.trim()).length() > 0) { String[] names = NAME_SEPARATOR.split(value); if (names.length > 1) { throw new IllegalStateException("more than 1 default extension " + "name on extension " + type.getName() + ": " + Arrays.toString(names)); } if (names.length == 1) { cachedDefaultName = names[0]; } } } // 分别在META-INF/dubbo/internal、META-INF/dubbo、META-INF/services目录下 // 获取定义文件,并且读取定义文件中的内容,这里主要是通过META-INF/dubbo/internal // 获取目标定义文件 Map<String, Class<?>> extensionClasses = new HashMap<String, Class<?>>(); loadDirectory(extensionClasses, DUBBO_INTERNAL_DIRECTORY, type.getName()); loadDirectory(extensionClasses, DUBBO_INTERNAL_DIRECTORY, type.getName().replace("org.apache", "com.alibaba")); loadDirectory(extensionClasses, DUBBO_DIRECTORY, type.getName()); loadDirectory(extensionClasses, DUBBO_DIRECTORY, type.getName().replace("org.apache", "com.alibaba")); loadDirectory(extensionClasses, SERVICES_DIRECTORY, type.getName()); loadDirectory(extensionClasses, SERVICES_DIRECTORY, type.getName().replace("org.apache", "com.alibaba")); return extensionClasses; } 这里loadExtensionClasses()主要是分别从三个目录中读取定义文件,读取该文件,并且进行缓存。这里我们继续看loadDirectory()方法的源码: private void loadDirectory(Map<String, Class<?>> extensionClasses, String dir, String type) { String fileName = dir + type; try { Enumeration<java.net.URL> urls; ClassLoader classLoader = findClassLoader(); // 加载定义文件 if (classLoader != null) { urls = classLoader.getResources(fileName); } else { urls = ClassLoader.getSystemResources(fileName); } if (urls != null) { // 对定义文件进行遍历,依次加载定义文件的内容 while (urls.hasMoreElements()) { java.net.URL resourceURL = urls.nextElement(); loadResource(extensionClasses, classLoader, resourceURL); } } } catch (Throwable t) { logger.error("Exception when load extension class(interface: " + type + ", description file: " + fileName + ").", t); } } 这里主要是对每个目录进行加载,然后依次加载定义文件的内容,而对定义文件内容的处理主要是在loadResource()方法中,在对文件中每一行记录进行处理之后,其其最终是调用的loadClass()方法加载目标class的。如下是loadClass()方法的源码: private void loadClass(Map<String, Class<?>> extensionClasses, java.net.URL resourceURL, Class<?> clazz, String name) throws NoSuchMethodException { // 如果加载得到的子类不是目标接口的实现类,则抛出异常 if (!type.isAssignableFrom(clazz)) { throw new IllegalStateException("Error when load extension class(interface: " + type + ", class line: " + clazz.getName() + "), class " + clazz.getName() + "is not subtype of interface."); } // 如果子类上标注有@Adaptive注解,说明其是一个装饰类,则将其缓存在cachedAdaptiveClass中, // 需要注意的是,一个接口只能为其定义一个装饰类 if (clazz.isAnnotationPresent(Adaptive.class)) { if (cachedAdaptiveClass == null) { cachedAdaptiveClass = clazz; } else if (!cachedAdaptiveClass.equals(clazz)) { throw new IllegalStateException("More than 1 adaptive class found: " + cachedAdaptiveClass.getClass().getName() + ", " + clazz.getClass().getName()); } // 这里判断子类是否是一个wrapper类,判断方式就是检查其是否有只含一个目标接口类型参数的构造函数, // 有则说明其是一个AOP的wrapper类 } else if (isWrapperClass(clazz)) { Set<Class<?>> wrappers = cachedWrapperClasses; if (wrappers == null) { cachedWrapperClasses = new ConcurrentHashSet<Class<?>>(); wrappers = cachedWrapperClasses; } wrappers.add(clazz); } else { // 走到这里说明当前子类不是一个功能型的类,而是最终实现具体目标的子类 clazz.getConstructor(); if (name == null || name.length() == 0) { name = findAnnotationName(clazz); if (name.length() == 0) { throw new IllegalStateException("No such extension name for the class " + clazz.getName() + " in the config " + resourceURL); } } String[] names = NAME_SEPARATOR.split(name); if (names != null && names.length > 0) { // 获取子类上的@Activate注解,该注解的主要作用是对子类进行分组的, // 对于分组之后的子类,可以通过getActivateExtension()来获取 Activate activate = clazz.getAnnotation(Activate.class); if (activate != null) { cachedActivates.put(names[0], activate); } else { // 兼容alibaba版本的注解 com.alibaba.dubbo.common.extension.Activate oldActivate = clazz.getAnnotation(com.alibaba.dubbo.common.extension.Activate.class); if (oldActivate != null) { cachedActivates.put(names[0], oldActivate); } } // 将目标子类缓存到extensionClasses中 for (String n : names) { if (!cachedNames.containsKey(clazz)) { cachedNames.put(clazz, n); } Class<?> c = extensionClasses.get(n); if (c == null) { extensionClasses.put(n, clazz); } else if (c != clazz) { throw new IllegalStateException("Duplicate extension " + type.getName() + " name " + n + " on " + c.getName() + " and " + clazz.getName()); } } } } } 这里loadClass()方法主要作用是对子类进行划分,这里主要划分成了三部分:a. 使用@Adaptive注解标注的装饰类;b. 包含有目标接口类型参数构造函数的wrapper类;c. 目标处理具体业务的子类。 总结而言,getExtension()方法主要是获取指定名称对应的子类。在获取过程中,首先会从缓存中获取是否已经加载过该子类,如果没加载过,则通过定义文件加载,并且使用获取到的wrapper对象封装目标对象返回。 3.2 getAdaptiveExtension() 前面我们讲解了ExtensionLoader在加载了定义文件之后会对子类进行一个划分,其中就涉及到使用@Adaptive进行标注的子类,该子类的作用主要是用于对目标类进行装饰的,从而实现一定的目的。但是@Adaptive也可以标注在方法上,其使用的方式主要是在目标接口的某个方法上进行标注,这个时候,dubbo就会通过javassist字节码生成工具来动态的生成目标接口的子类对象,该子类会对该接口中标注了@Adaptive注解的方法进行重写,而其余的方法则默认抛出异常,通过这种方式可以达到对特定的方法进行修饰的目的。我们首先来阅读getAdaptiveExtension()方法的源码: @SuppressWarnings("unchecked") public T getAdaptiveExtension() { // 从缓存中获取装饰类的实例,存在则直接返回,不存在则创建一个缓存起来,然后返回 Object instance = cachedAdaptiveInstance.get(); if (instance == null) { if (createAdaptiveInstanceError == null) { synchronized (cachedAdaptiveInstance) { instance = cachedAdaptiveInstance.get(); if (instance == null) { try { // 创建一个装饰类的实例 instance = createAdaptiveExtension(); cachedAdaptiveInstance.set(instance); } catch (Throwable t) { createAdaptiveInstanceError = t; throw new IllegalStateException("fail to create adaptive" + " instance: " + t.toString(), t); } } } } else { throw new IllegalStateException("fail to create adaptive instance: " + createAdaptiveInstanceError.toString(), createAdaptiveInstanceError); } } return (T) instance; } 这里主要是从缓存中获取目标类的实例,不存在则创建一个该实例,这里我们直接阅读createAdaptiveExtension()方法的源码: @SuppressWarnings("unchecked") private T createAdaptiveExtension() { try { return injectExtension((T) getAdaptiveExtensionClass().newInstance()); } catch (Exception e) { throw new IllegalStateException("Can not create adaptive extension " + type + ", cause: " + e.getMessage(), e); } } 这里createAdaptiveExtension()首先委托给getAdaptiveExtensionClass()方法获取一个装饰类实例,然后通过injectExtension()方法调用该实例的set方法来注入其所依赖的属性值。如下是getAdaptiveExtensionClass()方法的源码: private Class<?> getAdaptiveExtensionClass() { // 获取目标extensionClasses,如果无法获取到,则在定义文件中进行加载 getExtensionClasses(); // 如果目标类型有使用@Adaptive标注的子类型,则直接使用该子类作为装饰类 if (cachedAdaptiveClass != null) { return cachedAdaptiveClass; } // 如果目标类型没有使用@Adaptive标注的子类型,则尝试在目标接口中查找是否有使用@Adaptive标注的 // 方法,如果有,则为该方法动态生成子类装饰代码 return cachedAdaptiveClass = createAdaptiveExtensionClass(); } 这里可以看到,只有目标接口没有使用@Adaptive标注的子类时,才会使用Javassist来为目标接口生成其子类的装饰方法。如下是createAdaptiveExtensionClass()方法的源码: private Class<?> createAdaptiveExtensionClass() { // 创建子类代码的字符串对象 String code = createAdaptiveExtensionClassCode(); ClassLoader classLoader = findClassLoader(); // 获取当前dubbo SPI中定义的Compiler接口的子类对象,默认是使用javassist, // 然后通过该对象来编译生成的code,从而动态生成一个class对象 org.apache.dubbo.common.compiler.Compiler compiler = ExtensionLoader.getExtensionLoader( org.apache.dubbo.common.compiler.Compiler.class).getAdaptiveExtension(); return compiler.compile(code, classLoader); } 上述代码中,首先动态生成目标接口的子类字符串,然后通过javassit来编译该子类字符串,从而动态生成目标class。关于如何编译目标代码字符串,这里主要有两种方式:jdk编译和javassist编译,读者可自行查阅其具体的编译原理,我们这里主要讲解dubbo SPI是如何生成子类代码的。由于createAdaptiveExtensionClassCode()方法主要是通过一些字符串的拼接操作来得到子类字符串,我们这里就直接展示dubbo中一个非常重要的接口Protocol,其生成的子类字符串的形式: package org.apache.dubbo.rpc; import org.apache.dubbo.common.extension.ExtensionLoader; public class Protocol$Adaptive implements org.apache.dubbo.rpc.Protocol { private static final org.apache.dubbo.common.logger.Logger logger = org.apache.dubbo.common.logger.LoggerFactory.getLogger(ExtensionLoader.class); private java.util.concurrent.atomic.AtomicInteger count = new java.util.concurrent.atomic.AtomicInteger(0); // 对于未使用@Adaptive标注的方法,子类中直接抛出异常 public void destroy() { throw new UnsupportedOperationException("method public abstract void" + " org.apache.dubbo.rpc.Protocol.destroy() of interface " + "org.apache.dubbo.rpc.Protocol is not adaptive method!"); } // 对于未使用@Adaptive标注的方法,子类中直接抛出异常 public int getDefaultPort() { throw new UnsupportedOperationException("method public abstract int " + "org.apache.dubbo.rpc.Protocol.getDefaultPort() of interface " + "org.apache.dubbo.rpc.Protocol is not adaptive method!"); } // 对于使用@Adaptive标注的类,则在子类中委托给其他的类进行处理 public org.apache.dubbo.rpc.Exporter export(org.apache.dubbo.rpc.Invoker arg0) throws org.apache.dubbo.rpc.RpcException { if (arg0 == null) { throw new IllegalArgumentException("org.apache.dubbo.rpc.Invoker argument == null"); } if (arg0.getUrl() == null) { throw new IllegalArgumentException("org.apache.dubbo.rpc.Invoker argument " + "getUrl() == null"); } org.apache.dubbo.common.URL url = arg0.getUrl(); String extName = (url.getProtocol() == null ? "dubbo" : url.getProtocol()); if (extName == null) { throw new IllegalStateException("Fail to get " + "extension(org.apache.dubbo.rpc.Protocol) name from url(" + url.toString() + ") use keys([protocol])"); } org.apache.dubbo.rpc.Protocol extension = null; try { extension = (org.apache.dubbo.rpc.Protocol) ExtensionLoader.getExtensionLoader( org.apache.dubbo.rpc.Protocol.class).getExtension(extName); } catch (Exception e) { if (count.incrementAndGet() == 1) { logger.warn("Failed to find extension named " + extName + " for type org.apache.dubbo.rpc.Protocol, will use default extension" + " dubbo instead.", e); } extension = (org.apache.dubbo.rpc.Protocol) ExtensionLoader.getExtensionLoader( org.apache.dubbo.rpc.Protocol.class).getExtension("dubbo"); } return extension.export(arg0); } public org.apache.dubbo.rpc.Invoker refer(java.lang.Class arg0, org.apache.dubbo.common.URL arg1) throws org.apache.dubbo.rpc.RpcException { if (arg1 == null) { throw new IllegalArgumentException("url == null"); } org.apache.dubbo.common.URL url = arg1; String extName = (url.getProtocol() == null ? "dubbo" : url.getProtocol()); if (extName == null) { throw new IllegalStateException("Fail to get " + "extension(org.apache.dubbo.rpc.Protocol) name from url(" + url.toString() + ") use keys([protocol])"); } org.apache.dubbo.rpc.Protocol extension = null; try { extension = (org.apache.dubbo.rpc.Protocol) ExtensionLoader.getExtensionLoader( org.apache.dubbo.rpc.Protocol.class).getExtension(extName); } catch (Exception e) { if (count.incrementAndGet() == 1) { logger.warn("Failed to find extension named " + extName + " for type " + "org.apache.dubbo.rpc.Protocol, will use default extension dubbo " + "instead.", e); } extension = (org.apache.dubbo.rpc.Protocol) ExtensionLoader.getExtensionLoader( org.apache.dubbo.rpc.Protocol.class).getExtension("dubbo"); } return extension.refer(arg0, arg1); } } 可以看到,子类中对于没有使用@Adaptive标注的方法,其实现时直接抛出异常,对于使用@Adaptive标注的方法,则对其进行实现,并且委托给其他的SPI提供者进行相关的处理。 3.3 getExtensionLoader() 这里getExtensionLoader()的主要作用是为当前接口类型实例化一个ExtensionLoader对象,然后将其缓存起来。如下是getExtensionLoader()方法的源码: @SuppressWarnings("unchecked") public static <T> ExtensionLoader<T> getExtensionLoader(Class<T> type) { if (type == null) { throw new IllegalArgumentException("Extension type == null"); } // 判断当前传入的如果不是接口,则抛出异常 if (!type.isInterface()) { throw new IllegalArgumentException("Extension type(" + type + ") is not interface!"); } // 这里主要是判断传入的接口上是否使用@SPI进行了标注,标注了该注解才表明当前 // 接口是一个dubbo的SPI接口 if (!withExtensionAnnotation(type)) { throw new IllegalArgumentException("Extension type(" + type + ") is not extension, because WITHOUT @" + SPI.class.getSimpleName() + " Annotation!"); } // 从缓存中读取当前类对应的ExtensionLoader对象,如果不存在,则实例化一个并且缓存起来 ExtensionLoader<T> loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type); if (loader == null) { EXTENSION_LOADERS.putIfAbsent(type, new ExtensionLoader<T>(type)); loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type); } return loader; } 这里可以看到,对于ExtensionLoader的获取,其实现过程比较简单,主要是从缓存中获取,如果缓存不存在,则实例化一个并且缓存起来。 4. 小结 本文首先对jdk的SPI和dubbo的SPI进行了简单的对比,说明了dubbo相对于jdk的SPI所提供的额外的动态配置性能;然后通过一个示例来展示了dubbo的SPI的使用方式;最后着重讲解了用于实现dubbo SPI的ExtensionLoader的实现原理。

优秀的个人博客,低调大师

SpringBoot之集成Spring AOP

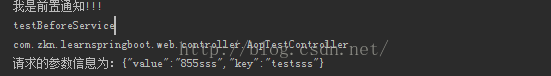
在开始之前,我们先把需要的jar包添加到工程里。新增Maven依赖如下: <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-aop</artifactId> </dependency> 接下来,我们进入正题。这里的涉及的通知类型有:前置通知、后置最终通知、后置返回通知、后置异常通知、环绕通知,下面我们就具体的来看一下怎么在SpringBoot中添加这些通知。 首先我们先创建一个Aspect切面类: @Component @Aspect publicclassWebControllerAop{ } 指定切点: //匹配com.zkn.learnspringboot.web.controller包及其子包下的所有类的所有方法 @Pointcut("execution(*com.zkn.learnspringboot.web.controller..*.*(..))") publicvoidexecuteService(){ } 接着我们再创建一个Controller请求处理类: packagecom.zkn.learnspringboot.web.controller; importorg.springframework.web.bind.annotation.RequestMapping; importorg.springframework.web.bind.annotation.RestController; /** *Createdbyzknon2016/11/19. */ @RestController @RequestMapping("/aop") publicclassAopTestController{ } 前置通知 配置前置通知: /** *前置通知,方法调用前被调用 *@paramjoinPoint */ @Before("executeService()") publicvoiddoBeforeAdvice(JoinPointjoinPoint){ System.out.println("我是前置通知!!!"); //获取目标方法的参数信息 Object[]obj=joinPoint.getArgs(); //AOP代理类的信息 joinPoint.getThis(); //代理的目标对象 joinPoint.getTarget(); //用的最多通知的签名 Signaturesignature=joinPoint.getSignature(); //代理的是哪一个方法 System.out.println(signature.getName()); //AOP代理类的名字 System.out.println(signature.getDeclaringTypeName()); //AOP代理类的类(class)信息 signature.getDeclaringType(); //获取RequestAttributes RequestAttributesrequestAttributes=RequestContextHolder.getRequestAttributes(); //从获取RequestAttributes中获取HttpServletRequest的信息 HttpServletRequestrequest=(HttpServletRequest)requestAttributes.resolveReference(RequestAttributes.REFERENCE_REQUEST); //如果要获取Session信息的话,可以这样写: //HttpSessionsession=(HttpSession)requestAttributes.resolveReference(RequestAttributes.REFERENCE_SESSION); Enumeration<String>enumeration=request.getParameterNames(); Map<String,String>parameterMap=Maps.newHashMap(); while(enumeration.hasMoreElements()){ Stringparameter=enumeration.nextElement(); parameterMap.put(parameter,request.getParameter(parameter)); } Stringstr=JSON.toJSONString(parameterMap); if(obj.length>0){ System.out.println("请求的参数信息为:"+str); } } 注意:这里用到了JoinPoint和RequestContextHolder。通过JoinPoint可以获得通知的签名信息,如目标方法名、目标方法参数信息等。通过RequestContextHolder来获取请求信息,Session信息。 接下来我们在Controller类里添加一个请求处理方法来测试一下前置通知: @RequestMapping("/testBeforeService.do") publicStringtestBeforeService(Stringkey,Stringvalue){ return"key="+key+"value="+value; } 前置通知拦截结果如下所示: 后置返回通知 配置后置返回通知的代码如下: /** *后置返回通知 *这里需要注意的是: *如果参数中的第一个参数为JoinPoint,则第二个参数为返回值的信息 *如果参数中的第一个参数不为JoinPoint,则第一个参数为returning中对应的参数 *returning限定了只有目标方法返回值与通知方法相应参数类型时才能执行后置返回通知,否则不执行,对于returning对应的通知方法参数为Object类型将匹配任何目标返回值 *@paramjoinPoint *@paramkeys */ @AfterReturning(value="execution(*com.zkn.learnspringboot.web.controller..*.*(..))",returning="keys") publicvoiddoAfterReturningAdvice1(JoinPointjoinPoint,Objectkeys){ System.out.println("第一个后置返回通知的返回值:"+keys); } @AfterReturning(value="execution(*com.zkn.learnspringboot.web.controller..*.*(..))",returning="keys",argNames="keys") publicvoiddoAfterReturningAdvice2(Stringkeys){ System.out.println("第二个后置返回通知的返回值:"+keys); } Controller里添加响应的请求处理信息来测试后置返回通知: @RequestMapping("/testAfterReturning.do") publicStringtestAfterReturning(Stringkey){ return"key=:"+key; } @RequestMapping("/testAfterReturning01.do") publicIntegertestAfterReturning01(Integerkey){ returnkey; } 当发送请求为:http://localhost:8001/aop/testAfterReturning.do?key=testsss&value=855sss时,处理结果如图所示: 当发送请求为:http://localhost:8001/aop/testAfterReturning01.do?key=55553&value=855sss时,处理结果如图所示: 后置异常通知 后置异常通知的配置方式如下: /** *后置异常通知 *定义一个名字,该名字用于匹配通知实现方法的一个参数名,当目标方法抛出异常返回后,将把目标方法抛出的异常传给通知方法; *throwing限定了只有目标方法抛出的异常与通知方法相应参数异常类型时才能执行后置异常通知,否则不执行, *对于throwing对应的通知方法参数为Throwable类型将匹配任何异常。 *@paramjoinPoint *@paramexception */ @AfterThrowing(value="executeService()",throwing="exception") publicvoiddoAfterThrowingAdvice(JoinPointjoinPoint,Throwableexception){ //目标方法名: System.out.println(joinPoint.getSignature().getName()); if(exceptioninstanceofNullPointerException){ System.out.println("发生了空指针异常!!!!!"); } } Controller里配置响应的请求处理类: @RequestMapping("/testAfterThrowing.do") publicStringtestAfterThrowing(Stringkey){ thrownewNullPointerException(); } 后置异常通知方法的处理结果如下所示: 后置最终通知 后置最终通知的配置方式如下: /** *后置最终通知(目标方法只要执行完了就会执行后置通知方法) *@paramjoinPoint */ @After("executeService()") publicvoiddoAfterAdvice(JoinPointjoinPoint){ System.out.println("后置通知执行了!!!!"); } Controller类配置相应的请求处理类: @RequestMapping("/testAfter.do") publicStringtestAfter(Stringkey){ thrownewNullPointerException(); } @RequestMapping("/testAfter02.do") publicStringtestAfter02(Stringkey){ returnkey; } 当发送请求为:http://localhost:8001/aop/testAfter.do?key=55553&value=855sss 当发送请求为:http://localhost:8001/aop/testAfter02.do?key=55553&value=855sss 环绕通知 环绕通知的配置方式如下: /** *环绕通知: *环绕通知非常强大,可以决定目标方法是否执行,什么时候执行,执行时是否需要替换方法参数,执行完毕是否需要替换返回值。 *环绕通知第一个参数必须是org.aspectj.lang.ProceedingJoinPoint类型 */ @Around("execution(*com.zkn.learnspringboot.web.controller..*.testAround*(..))") publicObjectdoAroundAdvice(ProceedingJoinPointproceedingJoinPoint){ System.out.println("环绕通知的目标方法名:"+proceedingJoinPoint.getSignature().getName()); try{ Objectobj=proceedingJoinPoint.proceed(); returnobj; }catch(Throwablethrowable){ throwable.printStackTrace(); } returnnull; } Controller对应的请求处理类如下: @RequestMapping("/testAroundService.do") publicStringtestAroundService(Stringkey){ return"环绕通知:"+key; } 当发送请求为:http://localhost:8001/aop/testAroundService.do?key=55553 当发送请求为:http://localhost:8001/aop/testAfter02.do?key=55553&value=855sss时,不符合环绕通知的切入规则,所以环绕通知不会 执行。 完整的AOP配置代码如下: packagecom.zkn.learnspringboot.aop; importcom.alibaba.fastjson.JSON; importcom.google.common.collect.Maps; importorg.aspectj.lang.JoinPoint; importorg.aspectj.lang.ProceedingJoinPoint; importorg.aspectj.lang.Signature; importorg.aspectj.lang.annotation.*; importorg.springframework.stereotype.Component; importorg.springframework.web.context.request.RequestAttributes; importorg.springframework.web.context.request.RequestContextHolder; importjavax.servlet.http.HttpServletRequest; importjavax.servlet.http.HttpSession; importjava.util.Enumeration; importjava.util.Map; /** *Createdbyzknon2016/11/18. */ @Component @Aspect publicclassWebControllerAop{ //匹配com.zkn.learnspringboot.web.controller包及其子包下的所有类的所有方法 @Pointcut("execution(*com.zkn.learnspringboot.web.controller..*.*(..))") publicvoidexecuteService(){ } /** *前置通知,方法调用前被调用 *@paramjoinPoint */ @Before("executeService()") publicvoiddoBeforeAdvice(JoinPointjoinPoint){ System.out.println("我是前置通知!!!"); //获取目标方法的参数信息 Object[]obj=joinPoint.getArgs(); //AOP代理类的信息 joinPoint.getThis(); //代理的目标对象 joinPoint.getTarget(); //用的最多通知的签名 Signaturesignature=joinPoint.getSignature(); //代理的是哪一个方法 System.out.println(signature.getName()); //AOP代理类的名字 System.out.println(signature.getDeclaringTypeName()); //AOP代理类的类(class)信息 signature.getDeclaringType(); //获取RequestAttributes RequestAttributesrequestAttributes=RequestContextHolder.getRequestAttributes(); //从获取RequestAttributes中获取HttpServletRequest的信息 HttpServletRequestrequest=(HttpServletRequest)requestAttributes.resolveReference(RequestAttributes.REFERENCE_REQUEST); //如果要获取Session信息的话,可以这样写: //HttpSessionsession=(HttpSession)requestAttributes.resolveReference(RequestAttributes.REFERENCE_SESSION); Enumeration<String>enumeration=request.getParameterNames(); Map<String,String>parameterMap=Maps.newHashMap(); while(enumeration.hasMoreElements()){ Stringparameter=enumeration.nextElement(); parameterMap.put(parameter,request.getParameter(parameter)); } Stringstr=JSON.toJSONString(parameterMap); if(obj.length>0){ System.out.println("请求的参数信息为:"+str); } } /** *后置返回通知 *这里需要注意的是: *如果参数中的第一个参数为JoinPoint,则第二个参数为返回值的信息 *如果参数中的第一个参数不为JoinPoint,则第一个参数为returning中对应的参数 *returning限定了只有目标方法返回值与通知方法相应参数类型时才能执行后置返回通知,否则不执行,对于returning对应的通知方法参数为Object类型将匹配任何目标返回值 *@paramjoinPoint *@paramkeys */ @AfterReturning(value="execution(*com.zkn.learnspringboot.web.controller..*.*(..))",returning="keys") publicvoiddoAfterReturningAdvice1(JoinPointjoinPoint,Objectkeys){ System.out.println("第一个后置返回通知的返回值:"+keys); } @AfterReturning(value="execution(*com.zkn.learnspringboot.web.controller..*.*(..))",returning="keys",argNames="keys") publicvoiddoAfterReturningAdvice2(Stringkeys){ System.out.println("第二个后置返回通知的返回值:"+keys); } /** *后置异常通知 *定义一个名字,该名字用于匹配通知实现方法的一个参数名,当目标方法抛出异常返回后,将把目标方法抛出的异常传给通知方法; *throwing限定了只有目标方法抛出的异常与通知方法相应参数异常类型时才能执行后置异常通知,否则不执行, *对于throwing对应的通知方法参数为Throwable类型将匹配任何异常。 *@paramjoinPoint *@paramexception */ @AfterThrowing(value="executeService()",throwing="exception") publicvoiddoAfterThrowingAdvice(JoinPointjoinPoint,Throwableexception){ //目标方法名: System.out.println(joinPoint.getSignature().getName()); if(exceptioninstanceofNullPointerException){ System.out.println("发生了空指针异常!!!!!"); } } /** *后置最终通知(目标方法只要执行完了就会执行后置通知方法) *@paramjoinPoint */ @After("executeService()") publicvoiddoAfterAdvice(JoinPointjoinPoint){ System.out.println("后置通知执行了!!!!"); } /** *环绕通知: *环绕通知非常强大,可以决定目标方法是否执行,什么时候执行,执行时是否需要替换方法参数,执行完毕是否需要替换返回值。 *环绕通知第一个参数必须是org.aspectj.lang.ProceedingJoinPoint类型 */ @Around("execution(*com.zkn.learnspringboot.web.controller..*.testAround*(..))") publicObjectdoAroundAdvice(ProceedingJoinPointproceedingJoinPoint){ System.out.println("环绕通知的目标方法名:"+proceedingJoinPoint.getSignature().getName()); try{//obj之前可以写目标方法执行前的逻辑 Objectobj=proceedingJoinPoint.proceed();//调用执行目标方法 returnobj; }catch(Throwablethrowable){ throwable.printStackTrace(); } returnnull; } } 完整的Controller类代码如下: packagecom.zkn.learnspringboot.web.controller; importorg.springframework.web.bind.annotation.RequestMapping; importorg.springframework.web.bind.annotation.RestController; /** *Createdbyzknon2016/11/19. */ @RestController @RequestMapping("/aop") publicclassAopTestController{ @RequestMapping("/testBeforeService.do") publicStringtestBeforeService(Stringkey,Stringvalue){ return"key="+key+"value="+value; } @RequestMapping("/testAfterReturning.do") publicStringtestAfterReturning(Stringkey){ return"key=:"+key; } @RequestMapping("/testAfterReturning01.do") publicIntegertestAfterReturning01(Integerkey){ returnkey; } @RequestMapping("/testAfterThrowing.do") publicStringtestAfterThrowing(Stringkey){ thrownewNullPointerException(); } @RequestMapping("/testAfter.do") publicStringtestAfter(Stringkey){ thrownewNullPointerException(); } @RequestMapping("/testAfter02.do") publicStringtestAfter02(Stringkey){ returnkey; } @RequestMapping("/testAroundService.do") publicStringtestAroundService(Stringkey){ return"环绕通知:"+key; } } 本文转自:http://lib.csdn.net/article/microservice/60453?knId=1899

优秀的个人博客,低调大师

SpringBoot 原理之 yaml 解析

导入 SpringBoot 的 snakeyaml 解析包 编写 yaml 文件 编写 yaml 文件对应的 class 编写 main 进行获取 导入 SpringBoot 的 snakeyaml 解析包 <dependency> <groupId>org.yaml</groupId> <artifactId>snakeyaml</artifactId> <version>1.23</version> </dependency> 编写 yaml 文件 id: 110 name: 'stuName' gender: '男' clas: id: 110 name: 'classesName' describe: 'describe' 编写 yaml 文件对应的 class public class Student { private Integer id; private String name; private String gender; private Classes clas; // getter(), setter(), toString(); } class Classes { private Integer id; private String name; private String describe; // getter(), setter(), toString(); } 编写 main 进行获取 public static void main(String[] args) { Yaml yaml = new Yaml(); Student result = yaml.loadAs(thisClass.class.getClassLoader() .getResourceAsStream("springboot.yaml"), Student.class); System.out.println(result); }

优秀的个人博客,低调大师

Dubbo分析之Serialize层

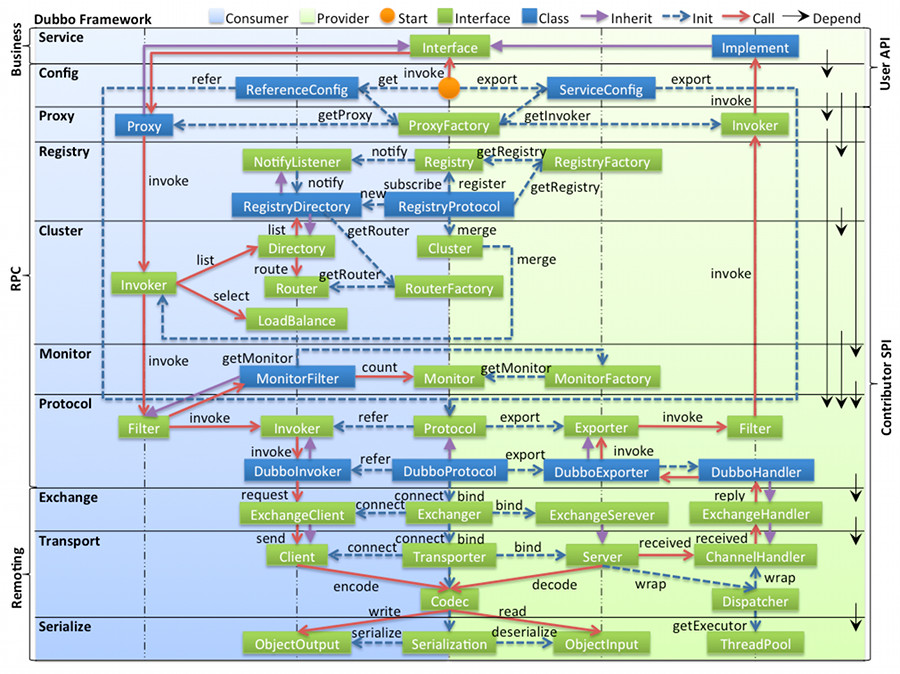
Dubbo整体设计 关于Dubbo的整体设计可以查看官方文档,下图可以清晰的表达Dubbo的整体设计: 1.图例说明 图中左边淡蓝背景的为服务消费方使用的接口,右边淡绿色背景的为服务提供方使用的接口,位于中轴线上的为双方都用到的接口;图中从下至上分为十层,各层均为单向依赖,右边的黑色箭头代表层之间的依赖关系;图中绿色小块的为扩展接口,蓝色小块为实现类,图中只显示用于关联各层的实现类;图中蓝色虚线为初始化过程,即启动时组装链,红色实线为方法调用过程,即运行时调时链,紫色三角箭头为继承,可以把子类看作父类的同一个节点,线上的文字为调用的方法; 2.各层说明 config 配置层:对外配置接口,以 ServiceConfig, ReferenceConfig 为中心,可以直接初始化配置类,也可以通过 spring 解析配置生成配置类;proxy 服务代理层:服务接口透明代理,生成服务的客户端 Stub 和服务器端 Skeleton, 以 ServiceProxy 为中心,扩展接口为 ProxyFactory;registry 注册中心层:封装服务地址的注册与发现,以服务 URL 为中心,扩展接口为 RegistryFactory, Registry, RegistryService;cluster 路由层:封装多个提供者的路由及负载均衡,并桥接注册中心,以 Invoker 为中心,扩展接口为 Cluster, Directory, Router, LoadBalance;monitor 监控层:RPC 调用次数和调用时间监控,以 Statistics 为中心,扩展接口为 MonitorFactory, Monitor, MonitorService;protocol 远程调用层:封装 RPC 调用,以 Invocation, Result 为中心,扩展接口为 Protocol, Invoker, Exporter;exchange 信息交换层:封装请求响应模式,同步转异步,以 Request, Response 为中心,扩展接口为 Exchanger, ExchangeChannel, ExchangeClient, ExchangeServer;transport 网络传输层:抽象 mina 和 netty 为统一接口,以 Message 为中心,扩展接口为 Channel, Transporter, Client, Server, Codec;serialize 数据序列化层:可复用的一些工具,扩展接口为 Serialization, ObjectInput, ObjectOutput, ThreadPool; 本文将从最底层的serialize层开始来对dubbo进行源码分析; 通讯框架 dubbo的底层通讯使用的是第三方框架,包括:netty,netty4,mina和grizzly;默认使用的是netty,分别提供了server端(服务提供方)和client端(服务消费方);下面已使用的netty为例来看那一下NettyServer的部分代码: protectedvoiddoOpen()throwsThrowable{ NettyHelper.setNettyLoggerFactory(); ExecutorServiceboss=Executors.newCachedThreadPool(newNamedThreadFactory("NettyServerBoss",true)); ExecutorServiceworker=Executors.newCachedThreadPool(newNamedThreadFactory("NettyServerWorker",true)); ChannelFactorychannelFactory=newNioServerSocketChannelFactory(boss,worker,getUrl().getPositiveParameter(Constants.IO_THREADS_KEY,Constants.DEFAULT_IO_THREADS)); bootstrap=newServerBootstrap(channelFactory); finalNettyHandlernettyHandler=newNettyHandler(getUrl(),this); channels=nettyHandler.getChannels();//https://issues.jboss.org/browse/NETTY-365 //https://issues.jboss.org/browse/NETTY-379 //finalTimertimer=newHashedWheelTimer(newNamedThreadFactory("NettyIdleTimer",true)); bootstrap.setOption("child.tcpNoDelay",true); bootstrap.setPipelineFactory(newChannelPipelineFactory(){@Override publicChannelPipelinegetPipeline(){ NettyCodecAdapteradapter=newNettyCodecAdapter(getCodec(),getUrl(),NettyServer.this); ChannelPipelinepipeline=Channels.pipeline();/*intidleTimeout=getIdleTimeout(); if(idleTimeout>10000){ pipeline.addLast("timer",newIdleStateHandler(timer,idleTimeout/1000,0,0)); }*/ pipeline.addLast("decoder",adapter.getDecoder()); pipeline.addLast("encoder",adapter.getEncoder()); pipeline.addLast("handler",nettyHandler);returnpipeline; } });//bind channel=bootstrap.bind(getBindAddress()); } 在启动服务提供方时就会调用此doOpen方法,用来启动服务端口,供消费方连接;以上代码就是常规的启动nettyServer端代码,因为本文重点介绍dubbo的序列化,所以这里主要看decoder和encoder,这两个类分别定义在NettyCodecAdapter中: privatefinalChannelHandlerencoder=newInternalEncoder();privatefinalChannelHandlerdecoder=newInternalDecoder(); 1.编码器 在NettyCodecAdapter定义了内部类InternalEncoder: privateclassInternalEncoderextendsOneToOneEncoder{ @Override protectedObjectencode(ChannelHandlerContextctx,Channelch,Objectmsg)throwsException{ com.alibaba.dubbo.remoting.buffer.ChannelBufferbuffer= com.alibaba.dubbo.remoting.buffer.ChannelBuffers.dynamicBuffer(1024); NettyChannelchannel=NettyChannel.getOrAddChannel(ch,url,handler);try{ codec.encode(channel,buffer,msg); }finally{ NettyChannel.removeChannelIfDisconnected(ch); }returnChannelBuffers.wrappedBuffer(buffer.toByteBuffer()); } } 此类其实是对codec的包装,本身并没有做编码处理,下面重点看一下codec类,此类是一个接口类,有多种实现类,Codec2源码如下: @SPIpublicinterfaceCodec2{ @Adaptive({Constants.CODEC_KEY})voidencode(Channelchannel,ChannelBufferbuffer,Objectmessage)throwsIOException; @Adaptive({Constants.CODEC_KEY})Objectdecode(Channelchannel,ChannelBufferbuffer)throwsIOException; enumDecodeResult{ NEED_MORE_INPUT,SKIP_SOME_INPUT } } 实现包括:TransportCodec,TelnetCodec,ExchangeCodec,DubboCountCodec以及ThriftCodec,当然也可以自行扩展;不可能启动时把每种类型都加载,dubbo是通过在配置文件中配置好所有的类型,然后在运行中需要什么类加载什么类,配置文件的具体路径:META-INF/dubbo/internal/com.alibaba.dubbo.remoting.Codec2,内容如下: transport=com.alibaba.dubbo.remoting.transport.codec.TransportCodectelnet=com.alibaba.dubbo.remoting.telnet.codec.TelnetCodecexchange=com.alibaba.dubbo.remoting.exchange.codec.ExchangeCodecdubbo=com.alibaba.dubbo.rpc.protocol.dubbo.DubboCountCodecthrift=com.alibaba.dubbo.rpc.protocol.thrift.ThriftCodec 获取具体Codec2的代码如下: protectedstaticCodec2getChannelCodec(URLurl){ StringcodecName=url.getParameter(Constants.CODEC_KEY,"telnet");if(ExtensionLoader.getExtensionLoader(Codec2.class).hasExtension(codecName)){returnExtensionLoader.getExtensionLoader(Codec2.class).getExtension(codecName); }else{returnnewCodecAdapter(ExtensionLoader.getExtensionLoader(Codec.class) .getExtension(codecName)); } } 通过在url中获取是否有关键字codec,如果有的话就获取当前的值,dubbo默认的codec为dubbo;如果没有值默认为telnet;这里有默认值为dubbo,所以实现类DubboCountCodec会被ExtensionLoader进行加载并进行缓存,下面具体看一下DubboCountCodec的编解码; privateDubboCodeccodec=newDubboCodec(); @Overridepublicvoidencode(Channelchannel,ChannelBufferbuffer,Objectmsg)throwsIOException{ codec.encode(channel,buffer,msg); } DubboCountCodec内部调用的是DubboCodec的encode方法,看一下如何对Request对象进行编码的,具体代码块如下: protectedvoidencodeRequest(Channelchannel,ChannelBufferbuffer,Requestreq)throwsIOException{ Serializationserialization=getSerialization(channel);//header. byte[]header=newbyte[HEADER_LENGTH];//setmagicnumber. Bytes.short2bytes(MAGIC,header); //setrequestandserializationflag. header[2]=(byte)(FLAG_REQUEST|serialization.getContentTypeId()); if(req.isTwoWay())header[2]|=FLAG_TWOWAY;if(req.isEvent())header[2]|=FLAG_EVENT; //setrequestid. Bytes.long2bytes(req.getId(),header,4); //encoderequestdata. intsavedWriteIndex=buffer.writerIndex(); buffer.writerIndex(savedWriteIndex+HEADER_LENGTH); ChannelBufferOutputStreambos=newChannelBufferOutputStream(buffer); ObjectOutputout=serialization.serialize(channel.getUrl(),bos);if(req.isEvent()){ encodeEventData(channel,out,req.getData()); }else{ encodeRequestData(channel,out,req.getData(),req.getVersion()); }out.flushBuffer();if(outinstanceofCleanable){ ((Cleanable)out).cleanup(); } bos.flush(); bos.close();intlen=bos.writtenBytes(); checkPayload(channel,len); Bytes.int2bytes(len,header,12); //write buffer.writerIndex(savedWriteIndex); buffer.writeBytes(header);//writeheader. buffer.writerIndex(savedWriteIndex+HEADER_LENGTH+len); } 前两个字节存放了魔数:0xdabb;第三个字节包含了四个信息分别是:是否是请求消息(还是响应消息),序列化类型,是否双向通信,是否是心跳消息;在请求消息中直接跳过了第四个字节,直接在5-12位置存放了requestId,是一个long类型,第四个字节在如果是编码响应消息中会存放响应的状态;代码往下看,buffer跳过了HEADER_LENGTH长度的字节,这里表示的是header部分的长度为16个字节,然后通过指定的序列化方式把data对象序列化到buffer中,序列化之后可以获取到data对象总共的字节数,用一个int类型来保存字节数,此int类型存放在header的最后四个字节中;最后把buffer的writerIndex设置到写完header和data的地方,防止数据被覆盖; 2.解码器 在NettyCodecAdapter定义了内部类InternalEncoder,同样是调用DubboCodec的decode方法,部分代码如下: publicObjectdecode(Channelchannel,ChannelBufferbuffer)throwsIOException{intreadable=buffer.readableBytes();byte[]header=newbyte[Math.min(readable,HEADER_LENGTH)]; buffer.readBytes(header);returndecode(channel,buffer,readable,header); } @OverrideprotectedObjectdecode(Channelchannel,ChannelBufferbuffer,intreadable,byte[]header)throwsIOException{//checkmagicnumber. if(readable>0&&header[0]!=MAGIC_HIGH ||readable>1&&header[1]!=MAGIC_LOW){intlength=header.length;if(header.length<readable){ header=Bytes.copyOf(header,readable); buffer.readBytes(header,length,readable-length); }for(inti=1;i<header.length-1;i++){if(header[i]==MAGIC_HIGH&&header[i+1]==MAGIC_LOW){ buffer.readerIndex(buffer.readerIndex()-header.length+i); header=Bytes.copyOf(header,i);break; } }returnsuper.decode(channel,buffer,readable,header); }//checklength. if(readable<HEADER_LENGTH){returnDecodeResult.NEED_MORE_INPUT; } //getdatalength. intlen=Bytes.bytes2int(header,12); checkPayload(channel,len); inttt=len+HEADER_LENGTH;if(readable<tt){returnDecodeResult.NEED_MORE_INPUT; } //limitinputstream. ChannelBufferInputStreamis=newChannelBufferInputStream(buffer,len); try{returndecodeBody(channel,is,header); }finally{if(is.available()>0){try{if(logger.isWarnEnabled()){ logger.warn("Skipinputstream"+is.available()); } StreamUtils.skipUnusedStream(is); }catch(IOExceptione){ logger.warn(e.getMessage(),e); } } } } 首先读取Math.min(readable, HEADER_LENGTH),如果readable小于HEADER_LENGTH,表示接收方连头部的16个字节还没接受完,需要等待接收;正常header接收完之后需要进行检查,主要包括:魔数的检查,header消息长度检查,消息体长度检查(检查消息体是否已经接收完成);检查完之后需要对消息体进行反序列化,具体在decodeBody方法中: @OverrideprotectedObjectdecodeBody(Channelchannel,InputStreamis,byte[]header)throwsIOException{byteflag=header[2],proto=(byte)(flag&SERIALIZATION_MASK); Serializations=CodecSupport.getSerialization(channel.getUrl(),proto);//getrequestid. longid=Bytes.bytes2long(header,4);if((flag&FLAG_REQUEST)==0){//decoderesponse. Responseres=newResponse(id);if((flag&FLAG_EVENT)!=0){ res.setEvent(Response.HEARTBEAT_EVENT); }//getstatus. bytestatus=header[3]; res.setStatus(status);if(status==Response.OK){try{ Objectdata;if(res.isHeartbeat()){ data=decodeHeartbeatData(channel,deserialize(s,channel.getUrl(),is)); }elseif(res.isEvent()){ data=decodeEventData(channel,deserialize(s,channel.getUrl(),is)); }else{ DecodeableRpcResultresult;if(channel.getUrl().getParameter( Constants.DECODE_IN_IO_THREAD_KEY, Constants.DEFAULT_DECODE_IN_IO_THREAD)){ result=newDecodeableRpcResult(channel,res,is, (Invocation)getRequestData(id),proto); result.decode(); }else{ result=newDecodeableRpcResult(channel,res,newUnsafeByteArrayInputStream(readMessageData(is)), (Invocation)getRequestData(id),proto); } data=result; } res.setResult(data); }catch(Throwablet){if(log.isWarnEnabled()){ log.warn("Decoderesponsefailed:"+t.getMessage(),t); } res.setStatus(Response.CLIENT_ERROR); res.setErrorMessage(StringUtils.toString(t)); } }else{ res.setErrorMessage(deserialize(s,channel.getUrl(),is).readUTF()); }returnres; }else{//decoderequest. Requestreq=newRequest(id); req.setVersion(Version.getProtocolVersion()); req.setTwoWay((flag&FLAG_TWOWAY)!=0);if((flag&FLAG_EVENT)!=0){ req.setEvent(Request.HEARTBEAT_EVENT); }try{ Objectdata;if(req.isHeartbeat()){ data=decodeHeartbeatData(channel,deserialize(s,channel.getUrl(),is)); }elseif(req.isEvent()){ data=decodeEventData(channel,deserialize(s,channel.getUrl(),is)); }else{ DecodeableRpcInvocationinv;if(channel.getUrl().getParameter( Constants.DECODE_IN_IO_THREAD_KEY, Constants.DEFAULT_DECODE_IN_IO_THREAD)){ inv=newDecodeableRpcInvocation(channel,req,is,proto); inv.decode(); }else{ inv=newDecodeableRpcInvocation(channel,req,newUnsafeByteArrayInputStream(readMessageData(is)),proto); } data=inv; } req.setData(data); }catch(Throwablet){if(log.isWarnEnabled()){ log.warn("Decoderequestfailed:"+t.getMessage(),t); }//badrequest req.setBroken(true); req.setData(t); }returnreq; } } 首先通过解析header部分的第三个字节,识别出是请求消息还是响应消息,还有使用哪种类型的序列化方式,然后分别进行序列化; 序列化和反序列化 通过以上对编码器解码器的了解,在编码器中需要序列化Request/Response,在解码器中需要序列化Request/Response,下面具体看看序列化和反序列化; 1.序列化 在编码器中需要获取具体的Serialization,具体代码如下: publicstaticSerializationgetSerialization(URLurl){returnExtensionLoader.getExtensionLoader(Serialization.class).getExtension( url.getParameter(Constants.SERIALIZATION_KEY,Constants.DEFAULT_REMOTING_SERIALIZATION)); } 同获取codec的方式,dubbo也提供了多种序列化方式,同时可以自定义扩展;通过在url中获取serialization关键字,如果获取不到默认为hession2;同样多种序列化类也配置在一个文件中,路径:META-INF/dubbo/internal/com.alibaba.dubbo.common.serialize.Serialization,具体内容如下: fastjson=com.alibaba.dubbo.common.serialize.fastjson.FastJsonSerializationfst=com.alibaba.dubbo.common.serialize.fst.FstSerializationhessian2=com.alibaba.dubbo.common.serialize.hessian2.Hessian2Serializationjava=com.alibaba.dubbo.common.serialize.java.JavaSerializationcompactedjava=com.alibaba.dubbo.common.serialize.java.CompactedJavaSerializationnativejava=com.alibaba.dubbo.common.serialize.nativejava.NativeJavaSerializationkryo=com.alibaba.dubbo.common.serialize.kryo.KryoSerialization dubbo默认提供了fastjson,fst,hessian2,java,compactedjava,nativejava和kryo多种序列化方式;每种序列化方式都需要实现如下三个接口类:Serialization,ObjectInput以及ObjectOutput;Serialization接口类: publicinterfaceSerialization{ bytegetContentTypeId(); StringgetContentType(); @Adaptive ObjectOutputserialize(URLurl,OutputStreamoutput)throwsIOException; @Adaptive ObjectInputdeserialize(URLurl,InputStreaminput)throwsIOException; } 其中的ContentTypeId就是在header中存放的序列化类型,反序列化的时候需要通过此id获取具体的Serialization,所以此ContentTypeId不能出现重复的,否则会被覆盖;ObjectInput接口类: publicinterfaceObjectOutputextendsDataOutput{ voidwriteObject(Objectobj)throwsIOException; } ObjectOutput接口类: publicinterfaceObjectInputextendsDataInput{ ObjectreadObject()throwsIOException,ClassNotFoundException; <T>TreadObject(Class<T>cls)throwsIOException,ClassNotFoundException; <T>TreadObject(Class<T>cls,Typetype)throwsIOException,ClassNotFoundException; } 分别提供了读取对象和写对象的接口方法,DataOutput和DataInput分别提供了对基本数据类型的读和写;序列化只需要调用writeObject方法将Data写入数据流即可;具体可以看一下编码器中调用的encodeRequestData方法: @OverrideprotectedvoidencodeRequestData(Channelchannel,ObjectOutputout,Objectdata,Stringversion)throwsIOException{ RpcInvocationinv=(RpcInvocation)data; out.writeUTF(version);out.writeUTF(inv.getAttachment(Constants.PATH_KEY));out.writeUTF(inv.getAttachment(Constants.VERSION_KEY)); out.writeUTF(inv.getMethodName());out.writeUTF(ReflectUtils.getDesc(inv.getParameterTypes())); Object[]args=inv.getArguments();if(args!=null)for(inti=0;i<args.length;i++){out.writeObject(encodeInvocationArgument(channel,inv,i)); }out.writeObject(inv.getAttachments()); } 默认使用的DubboCountCodec方式并没有直接将data写入流中,而是将RpcInvocation中的数据取出分别写入流; 2.反序列化 反序列化通过读取header中的序列化类型,然后通过如下方法获取具体的Serialization,具体在类CodecSupport中: publicstaticSerializationgetSerialization(URLurl,Byteid)throwsIOException{ Serializationserialization=getSerializationById(id); StringserializationName=url.getParameter(Constants.SERIALIZATION_KEY,Constants.DEFAULT_REMOTING_SERIALIZATION);//Checkif"serializationid"passedfromnetworkmatchestheidonthisside(onlytakeeffectforJDKserialization),forsecuritypurpose. if(serialization==null ||((id==3||id==7||id==4)&&!(serializationName.equals(ID_SERIALIZATIONNAME_MAP.get(id))))){thrownewIOException("Unexpectedserializationid:"+id+"receivedfromnetwork,pleasecheckifthepeersendtherightid."); }returnserialization; } privatestaticMap<Byte,Serialization>ID_SERIALIZATION_MAP=newHashMap<Byte,Serialization>(); publicstaticSerializationgetSerializationById(Byteid){returnID_SERIALIZATION_MAP.get(id); } ID_SERIALIZATION_MAP存放着ContentTypeId和具体Serialization的对应关系,然后通过id获取具体的Serialization,然后根据写入的顺序读取数据; 扩展序列化类型 dubbo本身对很多模块提供了很好的扩展功能,包括序列化功能,以下来分析一下如何使用protobuf来实现序列化方式; 1.整体代码结构 首先看一下整体的代码结构,如下图所示: 分别实现三个接口类:Serialization,ObjectInput以及ObjectOutput;然后在指定目录下提供一个文本文件; 2.引入扩展包 <dependency> <groupId>com.dyuproject.protostuff</groupId> <artifactId>protostuff-core</artifactId> <version>1.1.3</version></dependency><dependency> <groupId>com.dyuproject.protostuff</groupId> <artifactId>protostuff-runtime</artifactId> <version>1.1.3</version></dependency> 3.实现接口ObjectInput和ObjectOutput publicclassProtobufObjectInputimplementsObjectInput{ privateObjectInputStreaminput; publicProtobufObjectInput(InputStreaminputStream)throwsIOException{this.input=newObjectInputStream(inputStream); } ....省略基础类型... @Override publicObjectreadObject()throwsIOException,ClassNotFoundException{returninput.readObject(); } @Override public<T>TreadObject(Class<T>clazz)throwsIOException{try{byte[]buffer=(byte[])input.readObject(); input.read(buffer);returnSerializationUtil.deserialize(buffer,clazz); }catch(Exceptione){thrownewIOException(e); } } @Override public<T>TreadObject(Class<T>clazz,Typetype)throwsIOException{try{byte[]buffer=(byte[])input.readObject(); input.read(buffer);returnSerializationUtil.deserialize(buffer,clazz); }catch(Exceptione){thrownewIOException(e); } } } publicclassProtobufObjectOutputimplementsObjectOutput{ privateObjectOutputStreamoutputStream; publicProtobufObjectOutput(OutputStreamoutputStream)throwsIOException{this.outputStream=newObjectOutputStream(outputStream); } ....省略基础类型... @Override publicvoidwriteObject(Objectv)throwsIOException{byte[]bytes=SerializationUtil.serialize(v); outputStream.writeObject(bytes); outputStream.flush(); } @Override publicvoidflushBuffer()throwsIOException{ outputStream.flush(); } } 4.实现Serialization接口 publicclassProtobufSerializationimplementsSerialization{ @Override publicbytegetContentTypeId(){return10; } @Override publicStringgetContentType(){return"x-application/protobuf"; } @Override publicObjectOutputserialize(URLurl,OutputStreamout)throwsIOException{returnnewProtobufObjectOutput(out); } @Override publicObjectInputdeserialize(URLurl,InputStreamis)throwsIOException{returnnewProtobufObjectInput(is); } } 这里引入了一个新的ContentTypeId,需要保证和dubbo里面已存在的不要冲突 5.指定目录提供注册 在META-INF/dubbo/internal/目录下提供文件com.alibaba.dubbo.common.serialize.Serialization,内容如下: protobuf=com.dubboCommon.ProtobufSerialization 6.在提供方配置新的序列化方式 <dubbo:protocolname="dubbo"port="20880"serialization="protobuf"/> 这样就会使用新扩展的protobuf序列化方式来序列化对象; 总结 本文从dubbo整体设计的最底层serialization层来分析和了解dubbo,后面会逐层进行分析,对dubbo有一个更加透彻的了解; 示例代码地址 https://github.com/ksfzhaohui... https://gitee.com/OutOfMemory/blog


优秀的个人博客,低调大师

c++ 之 const整理

来源:https://www.cnblogs.com/cthon/p/9178701.html const对象不能够调用非const成员函数。 类的成员函数后面加 const,表明这个函数不会对这个类对象的数据成员(准确地说是非静态数据成员)作任何改变。 在设计类的时候,一个原则就是对于不改变数据成员的成员函数都要在后面加 const,而对于改变数据成员的成员函数不能加 const。所以 const 关键字对成员函数的行为作了更加明确的限定: (1)有 const 修饰的成员函数(指 const 放在函数参数表的后面,而不是在函数前面或者参数表内),只能读取数据成员,不能改变数据成员;没有 const 修饰的成员函数,对数据成员则是可读可写的。 (2)除此之外,在类的成员函数后面加 const 还有什么好处呢?那就是常量(即 const)对象可以调用 const 成员函数,而不能调用非const修饰的函数。 #include <stdio.h> #include <stdlib.h> #include <iostream> using namespace std; class A { public: void f() { cout<<"non const"<<endl; } void f() const { cout<<" const"<<endl; } }; int main(int argc, char **argv) { A a; a.f(); const A &b=a; b.f(); const A *c=&a; c->f(); A *const d=&a; d->f(); A *const e=d; e->f(); const A *f=c; f->f(); return 0; } 注意:两个成员函数如果只是常量性不同,是可以被重载的。 C++的const类型成员函数(解释为什么非const成员函数不能访问const类对象的数据成员) 1. 在C++中只有被声明为const的成员函数才能被一个const类对象调用。 如果要声明一个const类型的类成员函数,只需要在成员函数列表后加上关键字const, 例如: class Screen { public: char get() const; }; 在类体之外定义const成员函数时,还必须加上const关键字,例如: char Screen :: get() const { return _screen[_cursor]; } 若将成员函数声明为const,则不允许通过其修改类的数据成员。 值得注意的是,如果类中存在指针类型的数据成员即便是const函数只能保证不修改该指针的值,并不能保证不修改指针指向的对象。例如: class Name { public: void setName(const std::string &s) const; private: char *m_sName; }; void Name::setName(const std::string &s) const { m_sName = s.c_str(); // 错误!不能修改数据成员m_sName; for (int i = 0; i < s.size(); ++i) m_sName[i] = s[i]; // 不好的风格,但不是错误的 } 2. const成员函数可以被对应的具有相同形参列表的非const成员函数重载,例如: class Screen { public: char get(int x,int y); char get(int x,int y) const; }; int main() { const Screen cs; Screen cc2; char ch = cs.get(0, 0); // 调用const成员函数 ch = cs2.get(0, 0); // 调用非const成员函数 } 在这种情况下,类对象的常量性决定调用哪一个函数: 1、const成员函数可以访问非const对象的非const数据成员,const数据成员,也可以访问const对象内的所有数据成员(也就是说const成员函数谁都能访问呗?); 2、非const成员函数只可以访问非const对象的任意的数据成员(不能访问const对象的任意数据成员)(也就是说,非const成员函数除了const对象的数据成员,其余的都可以访问呗?); (上述原因可详见C++Primer(5th)231页。在默认情况下,this的类型是指向类类型非常量版本的常量指针,例如 Screen类中,this类型为 Screen *cosnt。当在成员函数的后面加上const关键字时,隐式的将this指针修改为 const Screen *const 即指向类类型常量版本的常量指针。根据初始化原则,我们不能将一个常量指针赋值给一个非常量指针(我前几天的疑惑,今天终于找到答案了)) 作为一种良好的编程风格,在声明一个成员函数时,若该成员函数并不对数据成员进行修改, 应尽可能将该成员函数声明为const成员函数。 3. const修饰的是谁? const成员函数的写法有两种 1、void fun(int a,int b) const{} 2、void const fun(int a,int b){} 这两种写法的本质是:void fun (const 类 *this, int a,int b); const修饰的不是形参a和b;const修饰的是属性this->a和this->b。与const所写的位置无关。 为什么? 因为c++对类的this指针做了隐藏,本质上,const指针修饰的是被隐藏的this指针所指向的内存空间(也就是this所指向的地址上存的值,this指针指向的地址默认就是const类型的,不可修改的。const成员函数使得this所指向的地址上存储的值也不可以被修改了),修饰的是this指针。 总结: 1)const成员函数可以访问非const对象的非const数据成员、const数据成员,也可以访问const对象内的所有数据成员; 2)非const成员函数可以访问非const对象的非const数据成员、const数据成员,但不可以访问const对象的任意数据成员; 3)作为一种良好的编程风格,在声明一个成员函数时,若该成员函数并不对数据成员进行修改操作,应尽可能将该成员函数声明为const成员函数。 4)如果只有const成员函数,非const对象是可以调用const成员函数的。当const版本和非const版本的成员函数同时出现时,非const对象调用非const成员函数。 补充: > 类中的const成员变量都要放在初始化列表之中进行 > const数据成员 > 引用数据成员 > 对象数据成员(内置类) const成员函数 > void print() const => const 类名 * const this > 在其内部是不能修改数据成员 > 只能调用const成员函数,不能调用非const成员函数 >const对象只能调用const成员函数,必须要提供一个const版本的成员函数 我觉得,我已经掌握了“茴”字的四种写法了,233333

优秀的个人博客,低调大师

Java入门之包装类

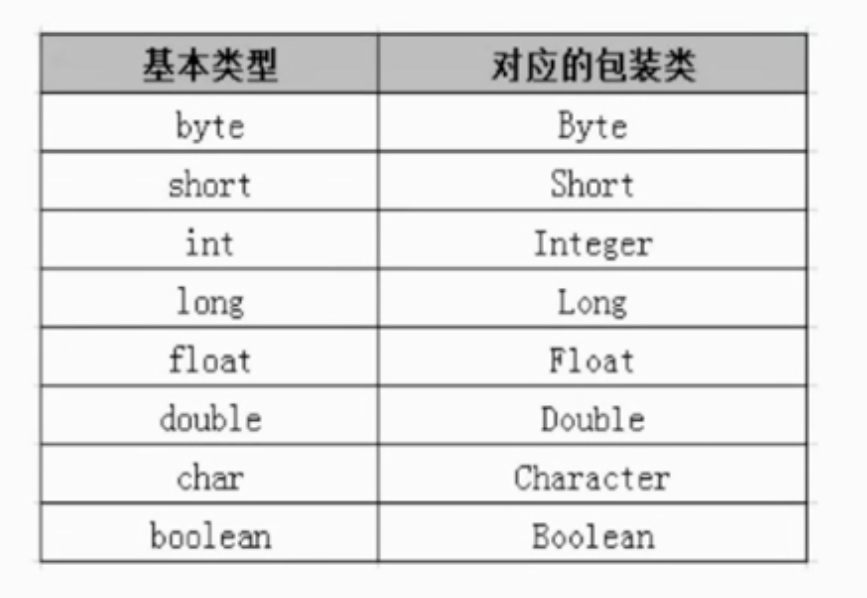
包装类用途 Java中有些异类(8种基本数据类型)它们不能像对象一样进行属性和方法的调用以及进行相互之间的对象化处理,包装类的存在就是为了解决这些异类产生的问题,让它们能像对象一样进行交互。 包装类与基本数据类型之间的关系 image.png 包装类的常用方法 Java中所有包装类都是存放在java.lang这个包中。 以Integer为例,介绍它常用的属性和方法 public final class Integer(){ } 所有的包装类都是用final修饰,不允许被继承,无子类。 image.png 基本数据类型和包装类的转换 装箱 : 基本数据类型转换为包装类 拆箱:包装类转换为基本数据类型 自动装箱(拆箱): int a = 1; Integer b = a; 手动装箱(拆箱): int a = 1; Integer b = new Integer(a); //拆箱 int c = b.intValue(); 基本数据类型和字符串之间转换 通过包装类完成基本数据类型和字符串之间转换。 public class Demo { public static void main(String[] args){ int a = 3; String name = Integer.toString(a); System.out.println(name); //1. int b = Integer.parseInt(name); //2.包装类的valueOf方法先将字符串转为包装类,再通过自动拆箱完成基本数据类型的转换 int d = Integer.valueOf(name); } } 补充知识 包装类对象的初始值 首先看下基本数据类型的初始值: image.png (注:上图中\u是unicode编码) 跟这些基本数据类型对应的包装类,它们的初始值是多少? 包装类的初始值为null。 包装类对象间比较 看代码: public class WrapperTest { public static void main(String[] args) { // TODO Auto-generated method stub Integer one=new Integer(100); Integer two=new Integer(100); System.out.println("one==two的结果:"+(one==two));//1 Integer three=100;//自动装箱 //Integer three=Integer.valueOf(100); //等号两端比较的是值 System.out.println("three==100的结果:"+(three==100));//2 自动拆箱 //执行这个语句时 编译器实际上执行的是这个:Integer four=Integer.valueOf(100); Integer four=100; System.out.println("three==four的结果:"+(three==four));//3 Integer five=200; System.out.println("five==200的结果:"+(five==200));//4 Integer six=200; System.out.println("five==six的结果:"+(five==six));//5 Double d1=Double.valueOf(100); System.out.println("d1==100的结果:"+(d1==100)); Double d2=Double.valueOf(100); System.out.println("d1==d2的结果:"+(d1==d2)); } } 上边代码这个部分:Integer.valueOf(100),为了执行的效率,在这个方法执行的过程中,java内存提供了一个类似于常量数组的缓存区(对象池),如果传入这个方法的参数是大于-128小于127这个范围,会去缓存区查找是否存在,如果有,直接产生,如果没有,实例化新的产生。这也就解释了为什么three==four打印出的值是ture。而five==six的结果是false。 八种基本数据类型中,除了float和double,其他的都是应用对象常量池这个概念的。 后续持续更新ing...

优秀的个人博客,低调大师

云上Hadoop之挑战

引言 在云上云行Hadoop,很多人担心性能。因为一提到虚拟化就会有人想到有成本,往往得出有偏见的结论-在云上运行肯定比物理机器上运行性能差。如果单独把10台物理机虚拟化跑Hadoop,这肯定是有部分性能的开销的。但是如果在公共云上,情况就不是这样了。因为公共云虚拟化的开销最终是由平台方来承担的,其一是平台方采购机器有规模优势,其二平台方可以在保证虚拟机性能的情况超卖部分资源。 平台卖给用户8core32g的虚拟机就保证有这个规格的能力的。 结合云上的弹性优势,企业的总体成本是会下降的。 在云上运行Hadoop对平台方还是面临一些挑战的,下面主要讲述这些挑战及平台方怎么解决的。 云上Hadoop的挑战-Shuffle Shuffle分为Push模式,Pull模式。Push模式就是直接通过网络发送到下一个节点,比如:storm、flink。

优秀的个人博客,低调大师

RocketMQ概念详细之NameServer

在Apache RocketMQ,域名服务器 被设计为协调分布式系统的每个组件,协调主要通过管理主题路由信息来实现。 管理由两部分组成: Broker定期更新保存在每一个NameServer中的元数据 NameServer为客户端提供服务,包括生产者,消费者和带有最新路由信息的命令行客户端。 因此,在启动broker和客户端之前,我们需要告诉它们如何通过向NameServer提供域名服务地址列表访问name servers。 在Apache RocketMQ,可以通过四种方式完成。 编程方式 对于Broker,你可以在broker配置文件中指定namesrvAddr=name-server-ip1:port;name-server-ip2:port。对于生产者和消费者,我们可以像下面提供 NameServer地址列表: //生产者 DefaultMQProducer producer = new DefaultMQProducer("please_rename_unique_group_name"); producer.setNamesrvAddr("name-server1-ip:port;name-server2-ip:port"); //消费者 DefaultMQPushConsumer consumer = new DefaultMQPushConsumer("please_rename_unique_group_name"); consumer.setNamesrvAddr("name-server1-ip:port;name-server2-ip:port"); 如果你使用 shell admin命令行,你可以像这样指定: sh mqadmin command-name -n name-server-ip1:port;name-server-ip2:port -X OTHER-OPTION 简单例子:sh mqadmin -n localhost:9876 clusterList 假设在NameServer节点查询集群信息。 如果你已经将admin tool整合在你自己的仪表盘,你可以: DefaultMQAdminExt defaultMQAdminExt = new DefaultMQAdminExt("please_rename_unique_group_name"); defaultMQAdminExt.setNamesrvAddr("name-server1-ip:port;name-server2-ip:port"); java选项 NameServer地址列表可以在启动前通过指定java选项 rocketmq.namesrv.addr 提供给你的应用。 环境变量 你可以export NAMESRV_ADDR 环境变量。如果设置,Brokers和clients将会检查和使用它。 HTTP Endpoint 如果你没有使用上面提到的方法指定NameServer地址列表,RocketMQ将访问以下http端点,每两分钟获取和更新NameServer地址列表,初始延迟10秒。 默认,端点: http://jmenv.tbsite.net:8080/rocketmq/nsaddr 你可以覆盖jmenv.tbsite.net使用java选项:rocketmq.namesrv.domain,你也可以覆盖nsaddr 部分使用java选项:rocketmq.namesrv.domain.subgroup。 如果你在生产中已经运行RocketMQ,推荐使用这种方法,因为它提供了最大的灵活性。你可以根据NameServer系统的负载动态增加或移除NameServer节点,而无需重新启动brokers 和clients。 优先级 Programmatic Way > Java Options > Environment Variable > HTTP Endpoint

优秀的个人博客,低调大师

RocketMQ概念详细之Consumer

消费者组和订阅 首先你应该关心的是不同的消费者群组可以独立的消费相同的主题,并且每个组都拥有自己的消费偏移量。请确保相同消费者内的每个消费者订阅一样的主题。 消息监听器 串行消费者将锁定每个消息队列以确保它被顺序消费。这会引起性能丢失,但当你关心消息顺序的实时这是很有用的。不推荐抛异常,你可以用返回ConsumeOrderlyStatus.SUSPEND_CURRENT_QUEUE_A_MOMENT 替代。 并行正如名字所说,消息者将会并行消费消息。为了好的性能推荐使用。不推荐抛异常,你可以使用返回ConsumeConcurrentlyStatus.RECONSUME_LATER 代替。 消费状态 对于MessageListenerConcurrently,你可以返回 RECONSUME_LATER 来告诉消费者,你现在不能马上消费并且想在稍后重新消费。然后你可以继续消费其他消息。对于MessageListenerOrderly,因为你关心顺序,你不能跳过消息,但你可以返回SUSPEND_CURRENT_QUEUE_A_MOMENT 来告诉消费者等待一会。 阻塞 不建议阻塞监听器,因为它会阻塞线程池,最后使消费进程停止。 线程数量 消费者内部使用ThreadPoolExecutor来处理消费,因此你通过设置setConsumeThreadMin 或setConsumeThreadMax 可以改变它。 从哪开始消费 当创建一个新的消费者组,需要决定它是否需要消费在broker中已经存在的历史消息。CONSUME_FROM_LAST_OFFSET 将会忽略历史消息,消费所有的之后产生的消息。CONSUME_FROM_FIRST_OFFSET 将会消费Broker中存在的每一个消息。CONSUME_FROM_TIMESTAMP ,消费指定时间戳之后产生的消息。 重复 很多情况下都会引起重复,例如: Producer重发消息(FLUSH_SLAVE_TIMEOUT情况) Consumer 关闭,一些偏移量未及时更新到Broker 如果你的应用不能容忍重复的话,你可能需要做一些额外的工作来处理。例如,你可以检查DB的唯一主键。

优秀的个人博客,低调大师

Java入门之异常处理

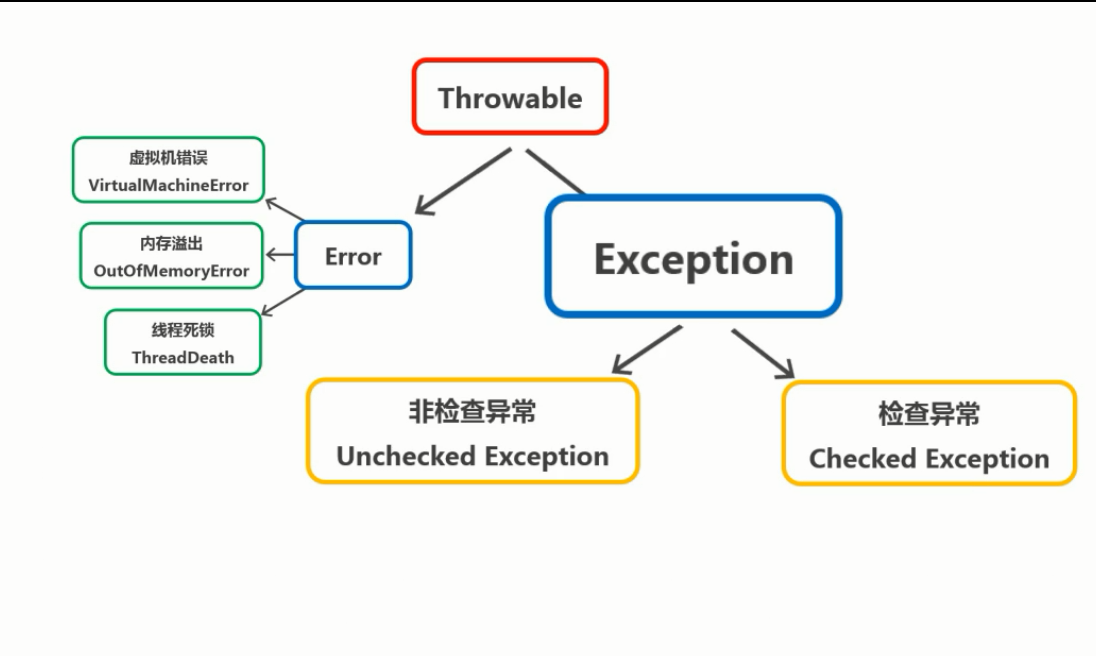
异常处理 如何处理异常 1. try-catch-finally 2. throw 3. throws 4. 自定义异常 5. 异常链 根类:Throwable 两个子类:Error、Exception image.png 上图中非检查异常,表示的是编译器不要求强制处理的异常,包括: image.png 检查异常:在程序编码阶段就被要求必须进行异常处理,否则编译无法通过。 image.png Java中异常通过五个关键字来实现: try catch finally throw throws image.png try-catch-finally public class TryDemo { public static void main(String[] args){ int a = 10; int b = 0; try { int c = a/b; }catch (ArithmeticException e){ System.out.println("出错了"); }finally { System.out.println("一定会执行"); } } } 使用多重catch结构处理异常 public class TryDemo { public static void main(String[] args){ int a = 10; int b = 0; try { int c = a/b; }catch (ArithmeticException e){ System.out.println("出错了"); }catch (Exception e){ System.out.println("33333"); } finally { System.out.println("一定会执行"); } } } Exception 父类异要放在最后一个catch块中。 注意:如果在finally块中和catch块中都有return语句,最终只会执行finally中的return,不会执行catch块中的return。在代码编写中不建议把return放到finally块中。 使用throws声明异常类型 public class TryDemo { public static void main(String[] args){ try { int result = test(); }catch (ArithmeticException e){ System.out.println(e); }catch (InputMismatchException e){ System.out.println(e); } } public static int test() throws ArithmeticException, InputMismatchException{ System.out.println("d"); } } 使用throw抛出异常对象 throw抛出的只能是可抛出类Throwable或者其子类的实例对象。 当方法当中包含throw抛出对象的语句时,常规的处理方法有两种: 方法一: public void method(){ try{ throw new 异常类型(); }catch(异常类型 e){ //处理异常 } } 方法二:谁调用了当前的方法谁就来处理异常 public void method() throws 异常类型{ throw new 异常类型(); } 自定义异常类 使用Java内置的异常类可以描述在编程时出现的大部分异常情况。 也可以通过自定义异常描述特定业务产生的异常类型。 所谓自定义异常,就是定义一个类去继承Throwable类或它的子类。 异常链 有时候我们在捕获一个异常后再抛出另一个异常。 异常链:将异常发生的原因一个传一个串起来,即把底层的异常信息传给上层 ,这样逐层抛出。

优秀的个人博客,低调大师

原生Js交互之DSBridge

文章链接:https://mp.weixin.qq.com/s/Iqd0dKM-ZW4UwkIgSTnvYg 在上一篇文章「android 记一次富文本加载之路」中 介绍了关于android加载富文本的方法,其中提到的加载html 文件的,app拿到后台的json格式数据,传到html模板文件里进行渲染交互,如下的一段html代码 设函数<img src="http://equation.kaoyanvip.cn/?mml=%3Cmath%20xmlns%3D%22http%3A%2F%2Fwww.w3.org%2F1998%2FMath%2FMathML%22%3E%3Cmi%3Ef%3C%2Fmi%3E%3Cmfenced%3E%3Cmrow%3E%3Cmi%3Ex%3C%2Fmi%3E%3Cmo%3E%2C%3C%2Fmo%3E%3Cmi%3Ey%3C%2Fmi%3E%3C%2Fmrow%3E%3C%2Fmfenced%3E%3Cmo%3E%3D%3C%2Fmo%3E%3Cmfenced%20open%3D%22%7B%22%20close%3D%22%22%3E%3Cmtable%20columnalign%3D%22left%22%3E%3Cmtr%3E%3Cmtd%3E%3Cmi%3Ex%3C%2Fmi%3E%3Cmi%3Ey%3C%2Fmi%3E%3Cmi%3Esin%3C%2Fmi%3E%3Cmfrac%3E%3Cmn%3E1%3C%2Fmn%3E%3Cmsqrt%3E%3Cmsup%3E%3Cmi%3Ex%3C%2Fmi%3E%3Cmn%3E2%3C%2Fmn%3E%3C%2Fmsup%3E%3Cmo%3E%2B%3C%2Fmo%3E%3Cmsup%3E%3Cmi%3Ey%3C%2Fmi%3E%3Cmn%3E2%3C%2Fmn%3E%3C%2Fmsup%3E%3C%2Fmsqrt%3E%3C%2Fmfrac%3E%3Cmo%3E%2C%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmsup%3E%3Cmi%3Ex%3C%2Fmi%3E%3Cmn%3E2%3C%2Fmn%3E%3C%2Fmsup%3E%3Cmo%3E%2B%3C%2Fmo%3E%3Cmsup%3E%3Cmi%3Ey%3C%2Fmi%3E%3Cmn%3E2%3C%2Fmn%3E%3C%2Fmsup%3E%3Cmo%3E%26%23x2260%3B%3C%2Fmo%3E%3Cmn%3E0%3C%2Fmn%3E%3Cmo%3E%2C%3C%2Fmo%3E%3C%2Fmtd%3E%3C%2Fmtr%3E%3Cmtr%3E%3Cmtd%3E%3Cmn%3E0%3C%2Fmn%3E%3Cmo%3E%2C%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmsup%3E%3Cmi%3Ex%3C%2Fmi%3E%3Cmn%3E2%3C%2Fmn%3E%3C%2Fmsup%3E%3Cmo%3E%2B%3C%2Fmo%3E%3Cmsup%3E%3Cmi%3Ey%3C%2Fmi%3E%3Cmn%3E2%3C%2Fmn%3E%3C%2Fmsup%3E%3Cmo%3E%3D%3C%2Fmo%3E%3Cmn%3E0%3C%2Fmn%3E%3Cmo%3E%2C%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3Cmo%3E%26%23xA0%3B%3C%2Fmo%3E%3C%2Fmtd%3E%3C%2Fmtr%3E%3C%2Fmtable%3E%3C%2Fmfenced%3E%3C%2Fmath%3E" alt="<math xmlns=&quot;http://www.w3.org/1998/Math/MathML&quot;><mi>f</mi><mfenced><mrow><mi>x</mi><mo>,</mo><mi>y</mi></mrow></mfenced><mo>=</mo><mfenced open=&quot;{&quot; close=&quot;&quot;><mtable columnalign=&quot;left&quot;><mtr><mtd><mi>x</mi><mi>y</mi><mi>sin</mi><mfrac><mn>1</mn><msqrt><msup><mi>x</mi><mn>2</mn></msup><mo>+</mo><msup><mi>y</mi><mn>2</mn></msup></msqrt></mfrac><mo>,</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><msup><mi>x</mi><mn>2</mn></msup><mo>+</mo><msup><mi>y</mi><mn>2</mn></msup><mo>&amp;#x2260;</mo><mn>0</mn><mo>,</mo></mtd></mtr><mtr><mtd><mn>0</mn><mo>,</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><msup><mi>x</mi><mn>2</mn></msup><mo>+</mo><msup><mi>y</mi><mn>2</mn></msup><mo>=</mo><mn>0</mn><mo>,</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo><mo>&amp;#xA0;</mo></mtd></mtr></mtable></mfenced></math>" class="wiris-tex">则<img src="http://equation.kaoyanvip.cn/?mml=%3Cmath%20xmlns%3D%22http%3A%2F%2Fwww.w3.org%2F1998%2FMath%2FMathML%22%3E%3Cmi%3Ef%3C%2Fmi%3E%3Cmo%3E(%3C%2Fmo%3E%3Cmi%3Ex%3C%2Fmi%3E%3Cmo%3E%2C%3C%2Fmo%3E%3Cmi%3Ey%3C%2Fmi%3E%3Cmo%3E)%3C%2Fmo%3E%3C%2Fmath%3E" alt="<math xmlns=&quot;http://www.w3.org/1998/Math/MathML&quot;><mi>f</mi><mo>(</mo><mi>x</mi><mo>,</mo><mi>y</mi><mo>)</mo></math>" class="wiris-tex">在点<img src="http://equation.kaoyanvip.cn/?mml=%3Cmath%20xmlns%3D%22http%3A%2F%2Fwww.w3.org%2F1998%2FMath%2FMathML%22%3E%3Cmo%3E(%3C%2Fmo%3E%3Cmn%3E0%3C%2Fmn%3E%3Cmo%3E%2C%3C%2Fmo%3E%3Cmn%3E0%3C%2Fmn%3E%3Cmo%3E)%3C%2Fmo%3E%3C%2Fmath%3E" alt="<math xmlns=&quot;http://www.w3.org/1998/Math/MathML&quot;><mo>(</mo><mn>0</mn><mo>,</mo><mn>0</mn><mo>)</mo></math>" class="wiris-tex">处 这段代码在部分手机上会显示异常,类似这种 这里使用腾讯的X5WebView ,加上适应屏幕大小 <meta name="viewport" content="width=device-width, initial-scale=1, maximum-scale=1" /> 后的显示效果 同时还需要与js进行交互,这里选用 DSBridge,支持X5内核。 gradle 关联 implementation 'com.github.wendux:DSBridge-Android:x5-3.0-SNAPSHOT' 使用 html 文件里需要引用这个库提供的js文件<script src="dsbridge.js"></script> dsbridge 的相对路径。 同时加上 <meta name="viewport" content="width=device-width, initial-scale=1, maximum-scale=1" /> 适应手机屏幕的大小 准备一个简单的html文件 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Title</title> <meta name="viewport" content="width=device-width, initial-scale=1, maximum-scale=1" /> <script src="dsbridge.js"></script> </head> <body> <div id="test"></div> </body> </html> div 块用于展示html代码的 原生传递值给js 通过webView.callHandler() 方法调用 第一个参数是约定注册的名称,与js接受处一致; 第二个参数是要传递的值,这里将data转成了 json String 的传给前端; 第三个参数是接受js返回的回调,可用于js接受成功后,再去通知原生。 HtmlData data = new HtmlData(); data.html = txt; webView.callHandler("nativeToJs", new Object[]{new Gson().toJson(data)}, new OnReturnValue<String>() { @Override public void onValue(String o) { } }); js接受传值,直接通过dsBridge.register() 方法接受 第一个参数是上面的注册名,与原生保持一致; 第二个是js的方法,参数data就是 传递的值,这里通过JSON.parse() 格式化,方法的return返回值就是传递给原生的,对应上面的第三个参数。 <script> dsBridge.register('nativeToJs', function (data) { var value = JSON.parse(data); document.getElementById("test").innerHTML = value.html; return "success" }); </script> js传值给原生 js通过dsBridge.call() 方法传值,简单模拟了点击事件来传递。 第一个参数是约定注册的名称,与原生接受处方法名一致; 第二个参数是要传递的值; 第三个参数是接受原生返回的回调。 function test(){ dsBridge.call("jsToNative", "test", function (res) { console.log(res) }); } 原生接受,通过JavascriptInterface注解,方法名与注册名一致 第一个参数是传递的值; 第二个参数可回调信息给js; webView.addJavascriptObject(new JsApi(), null); public class JsApi { @JavascriptInterface public void jsToNative(Object msg, CompletionHandler<String> handler) { handler.complete(msg+"回调给js"); } } 这里介绍的是简单的原生js交互的使用,更多的可以参考github文档https://github.com/wendux/DSBridge-Android 欢迎关注我的个人博客:https://www.manjiexiang.cn/ 更多精彩欢迎关注微信号:春风十里不如认识你 一起学习,一起进步,欢迎上车,有问题随时联系,一起解决!!!

优秀的个人博客,低调大师

RocketMQ概念详细之Producer

发送状态 当你发送一个消息,你将会获得包含SendStatus的SendResult。首先,我们假设消息 isWaitStoreMsgOK=true(默认true)。如果没有,我们会得到 SEND_OK,没有异常抛出的话。下面是每个状态的描述列表: FLUSH_DISK_TIMEOUT 如果broker设置 MessageStoreConfig’s 的 FlushDiskType=SYNC_FLUSH(默认ASYNC_FLUSH),在MessageStoreConfig’s 的syncFlushTimeoutbroker(默认5秒)内没有完成刷盘,你会获得此状态。 FLUSH_SLAVE_TIMEOUT 如果broker的角色是SYNC_MASTER(默认ASYNC_MASTER),在MessageStoreConfig’s 的syncFlushTimeoutbroker(默认5秒)内从Broker没有完成与主同步,你会获得此状态。 SLAVE_NOT_AVAILABLE 如果broker的角色是SYNC_MASTER(默认ASYNC_MASTER),但是配置的从Broker不存在,你会获得此状态。 SEND_OK SEND_OK也不意味着可靠。为了确保没有消息丢失,还应该启用 SYNC_MASTER或SYNC_FLUSH。 Duplication or Missing 如果得到FLUSH_DISK_TIMEOUT、FLUSH_SLAVE_TIMEOUT 和Broker正好关闭,你可以发现消息丢失。此时,你有两种选择,一个是放手可能引起消息丢失;另一个是重发消息,可能会使消息重复。通常我们建议重发和寻找一种方式处理消费时的重复删除。除非你感觉丢失的消息不重要。但请记住,当SLAVE_NOT_AVAILABLE时,重发时无用的。如果发生,你应该保留场景同时警告集群管理者。 超时 客户端发送请求到broker,然后等待响应,但如果等待时间过久且没有响应返回,客户端将会抛出RemotingTimeoutException异常。默认等待时间3秒。你可以使用send(msg, timeout) 代替 send(msg)传递超时参数。我们不建议等待时间太短,因为broker需要时间刷盘或与从同步。如果该值超过syncFlushTimeout,则该值可能影响不大,因为Broker可能会在超时之前返回FLUSH_SLAVE_TIMEOUT或FLUSH_SLAVE_TIMEOUT的响应。 消息大小 建议消息的大小不能超过512k。 异步发送 默认send(msg) 将会阻塞,直到响应返回。因此如果你关系性能,我们建议使用 send(msg, callback)以异步方式执行。 生产者群组 通常,生产者群组没有任何效果。但是如果你涉及事务,你应该注意。默认情况下,你只需要在同一个JVM上创建一个具有相同群组的生产者,就足够啦。 线程安全 生产者是线程安全的,你可以在业务解决方案中使用。 性能 如果在一个JVM上你需要多个producer用于大数据处理,我们建议: 这些(3~5够用)生产者使用异步发送 每个生产者设置实例名称

优秀的个人博客,低调大师

RocketMQ概念详细之broker

生产者角色 Broker的角色有ASYNC_MASTER,SYNC_MASTER 或SLAVE。如果不能容忍消息丢失,我们建议你部署SYNC_MASTER并为其附加SLAVE。如果消息丢失影响不大,但需要Broker一直可用,你可以使用SLAVE部署ASYNC_MASTER。如果仅想简单,你可能只需要一个没有SLAVE的ASYNC_MASTER。 刷盘类型 推荐异步刷盘,同步刷盘太昂贵且会引起大量性能下降。如果需要可靠性,推荐使用带有SLAVE的SYNC_MASTER 。 后续待完成

优秀的个人博客,低调大师

Envoy源码分析之Dispatcher

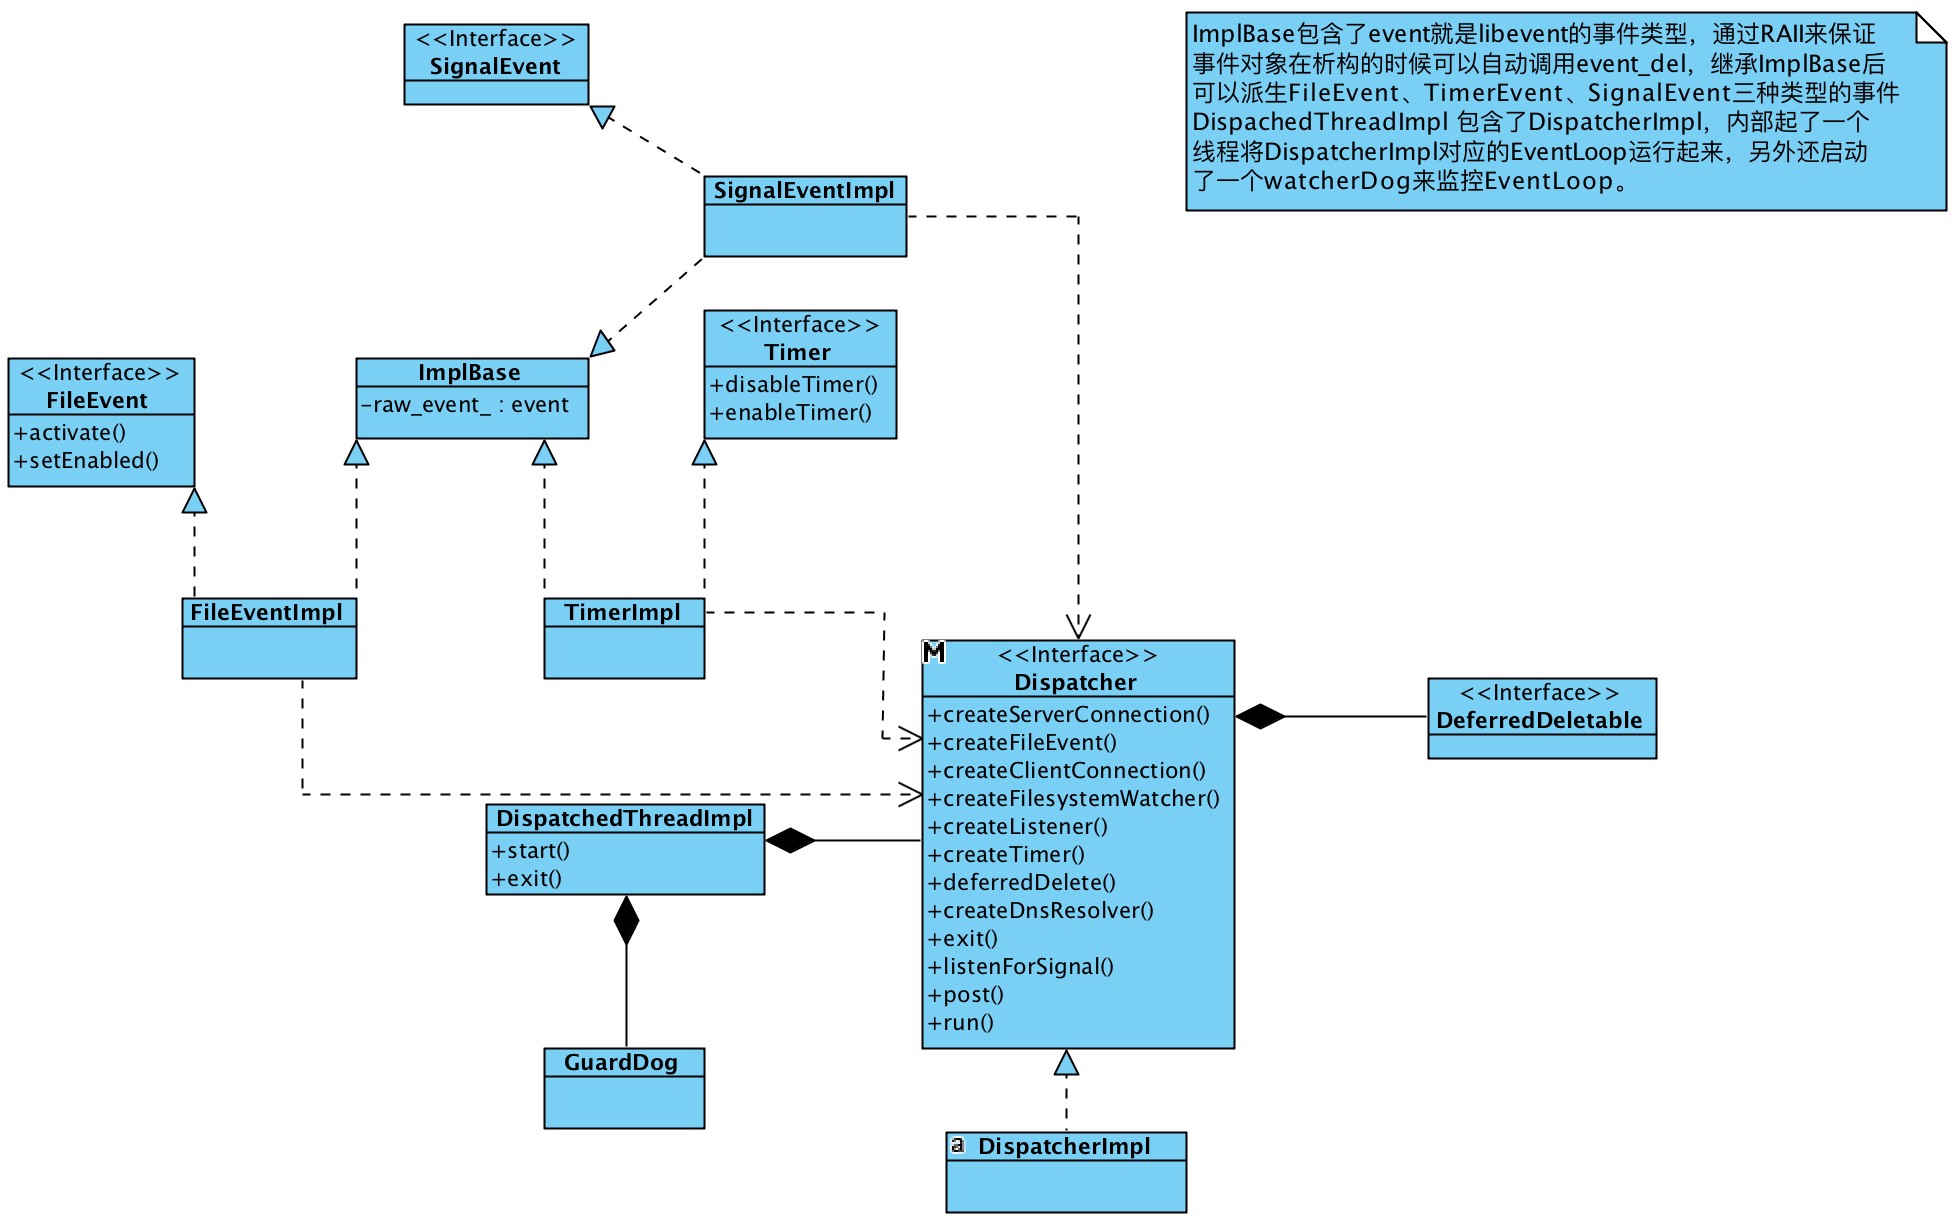
Dispatcher 在Envoy的代码中Dispatcher是随处可见的,可以说在Envoy中有着举足轻重的地位,一个Dispatcher就是一个EventLoop,其承担了任务队列、网络事件处理、定时器、信号处理等核心功能。在Envoy threading model这篇文章所提到的EventLoop(Each worker thread runs a “non-blocking” event loop)指的就是这个Dispatcher对象。这个部分的代码相对较独立,和其他模块耦合也比较少,但重要性却不言而喻。下面是与Dispatcher相关的类图,在接下来会对其中的关键概念进行介绍。 Dispatcher 和 Libevent Dispatcher本质上就是一个EventLoop,Envoy并没有重新实现,而是复用了Libevent中的event_base,在Libevent的基础上进行了二次封装并抽象出一些事件类,比如FileEvent、SignalEvent、Timer等。Libevent是一个C库,而Envoy是C++,为了避免手动管理这些C结构的内存,Envoy通过继承unique_ptr的方式重新封装了这些libevent暴露出来的C结构。 template <class T, void (*deleter)(T*)> class CSmartPtr : public std::unique_ptr<T, void (*)(T*)> { public: CSmartPtr() : std::unique_ptr<T, void (*)(T*)>(nullptr, deleter) {} CSmartPtr(T* object) : std::unique_ptr<T, void (*)(T*)>(object, deleter) {} }; 通过CSmartPtr就可以将Libevent中的一些C数据结构的内存通过RAII机制自动管理起来,使用方式如下: extern "C" { void event_base_free(event_base*); } struct evbuffer; extern "C" { void evbuffer_free(evbuffer*); } ..... typedef CSmartPtr<event_base, event_base_free> BasePtr; typedef CSmartPtr<evbuffer, evbuffer_free> BufferPtr; typedef CSmartPtr<bufferevent, bufferevent_free> BufferEventPtr; typedef CSmartPtr<evconnlistener, evconnlistener_free> ListenerPtr; 在Libevent中无论是定时器到期、收到信号、还是文件可读写等都是事件,统一使用event类型来表示,Envoy中则将event作为ImplBase的成员,然后让所有的事件类型的对象都继承ImplBase,从而实现了事件的抽象。 class ImplBase { protected: ~ImplBase(); event raw_event_; }; SignalEvent SignalEvent的实现很简单,通过evsignal_assign来初始化事件,然后通过evsignal_add添加事件使事件成为未决状态(关于Libevent事件状态见附录)。 class SignalEventImpl : public SignalEvent, ImplBase { public: // signal_num: 要设置的信号值 // cb: 信号事件的处理函数 SignalEventImpl(DispatcherImpl& dispatcher, int signal_num, SignalCb cb); private: SignalCb cb_; }; SignalEventImpl::SignalEventImpl(DispatcherImpl& dispatcher, int signal_num, SignalCb cb) : cb_(cb) { evsignal_assign( &raw_event_, &dispatcher.base(), signal_num, [](evutil_socket_t, short, void* arg) -> void { static_cast<SignalEventImpl*>(arg)->cb_(); }, this); evsignal_add(&raw_event_, nullptr); } Timer Timer事件暴露了两个接口一个用于关闭Timer,另外一个则用于启动Timer,需要传递一个时间来设置Timer的到期时间间隔。 class Timer { public: virtual ~Timer() {} virtual void disableTimer() PURE; virtual void enableTimer(const std::chrono::milliseconds& d) PURE; }; 创建Timer的时候会通过evtimer_assgin对event进行初始化,这个时候事件还处于未决状态而不会触发,需要通过event_add添加到Dispatcher中才能被触发。 class TimerImpl : public Timer, ImplBase { public: TimerImpl(Libevent::BasePtr& libevent, TimerCb cb); // Timer void disableTimer() override; void enableTimer(const std::chrono::milliseconds& d) override; private: TimerCb cb_; }; TimerImpl::TimerImpl(DispatcherImpl& dispatcher, TimerCb cb) : cb_(cb) { ASSERT(cb_); evtimer_assign( &raw_event_, &dispatcher.base(), [](evutil_socket_t, short, void* arg) -> void { static_cast<TimerImpl*>(arg)->cb_(); }, this); } disableTimer被调用时其内部会调用event_del来删除事件,使事件成为非未决状态,enableTimer被调用时则间接调用event_add使事件成为未决状态,这样一旦超时时间到了就会触发超时事件。 void TimerImpl::disableTimer() { event_del(&raw_event_); } void TimerImpl::enableTimer(const std::chrono::milliseconds& d) { if (d.count() == 0) { event_active(&raw_event_, EV_TIMEOUT, 0); } else { std::chrono::microseconds us = std::chrono::duration_cast<std::chrono::microseconds>(d); timeval tv; tv.tv_sec = us.count() / 1000000; tv.tv_usec = us.count() % 1000000; event_add(&raw_event_, &tv); } } 上面的代码在计算timer时间timeval的时候实现的并不优雅,应该避免使用像1000000这样的不具备可读性的数字常量,社区中有人建议可以改成如下的形式。 auto secs = std::chrono::duration_cast<std::chrono::seconds>(d); auto usecs = std::chrono::duration_cast<std::chrono::microseconds>(d - secs); tv.tv_secs = secs.count(); tv.tv_usecs = usecs.count(); FileEvent socket套接字相关的事件被封装为FileEvent,其上暴露了二个接口:activate用于主动触发事件,典型的使用场景比如: 唤醒EventLoop、Write Buffer有数据,可以主动触发下可写事件(Envoy中的典型使用场景)等;setEnabled用于设置事件类型,将事件添加到EventLoop中使其成为未决状态。 void FileEventImpl::activate(uint32_t events) { int libevent_events = 0; if (events & FileReadyType::Read) { libevent_events |= EV_READ; } if (events & FileReadyType::Write) { libevent_events |= EV_WRITE; } if (events & FileReadyType::Closed) { libevent_events |= EV_CLOSED; } ASSERT(libevent_events); event_active(&raw_event_, libevent_events, 0); } void FileEventImpl::setEnabled(uint32_t events) { event_del(&raw_event_); assignEvents(events); event_add(&raw_event_, nullptr); } 任务队列 Dispatcher的内部有一个任务队列,也会创建一个线程专们处理任务队列中的任务。通过Dispatcher的post方法可以将任务投递到任务队列中,交给Dispatcher内的线程去处理。 void DispatcherImpl::post(std::function<void()> callback) { bool do_post; { Thread::LockGuard lock(post_lock_); do_post = post_callbacks_.empty(); post_callbacks_.push_back(callback); } if (do_post) { post_timer_->enableTimer(std::chrono::milliseconds(0)); } } post方法将传递进来的callback所代表的任务,添加到post_callbacks_所代表的类型为vector<callback>的成员表变量中。如果post_callbacks_为空的话,说明背后的处理线程是处于非活动状态,这时通过post_timer_设置一个超时时间时间为0的方式来唤醒它。post_timer_在构造的时候就已经设置好对应的callback为runPostCallbacks,对应代码如下: DispatcherImpl::DispatcherImpl(TimeSystem& time_system, Buffer::WatermarkFactoryPtr&& factory) : ...... post_timer_(createTimer([this]() -> void { runPostCallbacks(); })), current_to_delete_(&to_delete_1_) { RELEASE_ASSERT(Libevent::Global::initialized(), ""); } runPostCallbacks是一个while循环,每次都从post_callbacks_中取出一个callback所代表的任务去运行,直到post_callbacks_为空。每次运行runPostCallbacks都会确保所有的任务都执行完。显然,在runPostCallbacks被线程执行的期间如果post进来了新的任务,那么新任务直接追加到post_callbacks_尾部即可,而无需做唤醒线程这一动作。 void DispatcherImpl::runPostCallbacks() { while (true) { std::function<void()> callback; { Thread::LockGuard lock(post_lock_); if (post_callbacks_.empty()) { return; } callback = post_callbacks_.front(); post_callbacks_.pop_front(); } callback(); } } DeferredDeletable 最后讲一下Dispatcher中比较难理解也很重要的DeferredDeletable,它是一个空接口,所有要进行延迟析构的对象都要继承自这个空接口。在Envoy的代码中像下面这样继承自DeferredDeletable的类随处可见。 class DeferredDeletable { public: virtual ~DeferredDeletable() {} }; 那何为延迟析构呢?用在哪个场景呢?延迟析构指的是将析构的动作交由Dispatcher来完成,所以DeferredDeletable和Dispatcher密切相关。Dispatcher对象有一个vector保存了所有要延迟析构的对象。 class DispatcherImpl : public Dispatcher { ...... private: ........ std::vector<DeferredDeletablePtr> to_delete_1_; std::vector<DeferredDeletablePtr> to_delete_2_; std::vector<DeferredDeletablePtr>* current_to_delete_; } to_delete_1_和to_delete_2_就是用来存放所有的要延迟析构的对象,这里使用两个vector存放,为什么要这样做呢?。current_to_delete_始终指向当前正要析构的对象列表,每次执行完析构后就交替指向另外一个对象列表,来回交替。 void DispatcherImpl::clearDeferredDeleteList() { ASSERT(isThreadSafe()); std::vector<DeferredDeletablePtr>* to_delete = current_to_delete_; size_t num_to_delete = to_delete->size(); if (deferred_deleting_ || !num_to_delete) { return; } ENVOY_LOG(trace, "clearing deferred deletion list (size={})", num_to_delete); if (current_to_delete_ == &to_delete_1_) { current_to_delete_ = &to_delete_2_; } else { current_to_delete_ = &to_delete_1_; } deferred_deleting_ = true; for (size_t i = 0; i < num_to_delete; i++) { (*to_delete)[i].reset(); } to_delete->clear(); deferred_deleting_ = false; } 上面的代码在执行对象析构的时候先使用to_delete来指向当前正要析构的对象列表,然后将current_to_delete_指向另外一个列表,这样在添加延迟删除的对象时,就可以做到安全的把对象添加到列表中了。因为deferredDelete和clearDeferredDeleteList都是在同一个线程中运行,所以current_to_delete_是一个普通的指针,可以安全的更改指针指向另外一个,而不用担心有线程安全问题。 void DispatcherImpl::deferredDelete(DeferredDeletablePtr&& to_delete) { ASSERT(isThreadSafe()); current_to_delete_->emplace_back(std::move(to_delete)); ENVOY_LOG(trace, "item added to deferred deletion list (size={})", current_to_delete_->size()); if (1 == current_to_delete_->size()) { deferred_delete_timer_->enableTimer(std::chrono::milliseconds(0)); } } 当有要进行延迟析构的对象时,调用deferredDelete即可,这个函数内部会通过current_to_delete_把对象放到要延迟析构的列表中,最后判断下当前要延迟析构的列表大小是否是1,如果是1表明这是第一次添加延迟析构的对象,那么就需要通过deferred_delete_timer_把背后的线程唤醒执行clearDeferredDeleteList函数。这样做的原因是避免多次唤醒,因为有一种情况是线程已经唤醒了正在执行clearDeferredDeleteList,在这个过程中又有其他的对象需要析构而加入到vector中。 到此为止deferredDelete的实现原理就基本分析完了,可以看出它的实现和任务队列的实现很类似,只不过一个是循环执行callback所代表的任务,另一个是对对象进行析构。最后我们来看一下deferredDelete的应用场景,却“为何要进行延迟析构?”在Envoy的源代码中经常会看到像下面这样的代码片段。 ConnectionImpl::ConnectionImpl(Event::Dispatcher& dispatcher, ConnectionSocketPtr&& socket, TransportSocketPtr&& transport_socket, bool connected) { ...... } // 传递裸指针到回调中 file_event_ = dispatcher_.createFileEvent( fd(), [this](uint32_t events) -> void { onFileEvent(events); }, Event::FileTriggerType::Edge, Event::FileReadyType::Read | Event::FileReadyType::Write); ...... } 传递给Dispatcher的callback都是通过裸指针的方式进行回调,如果进行回调的时候对象已经析构了,就会出现野指针的问题,我相信C++水平还可以的同学都会看出这个问题,除非能在逻辑上保证Dispatcher的生命周期比所有对象都短,这样就能保证在回调的时候对象肯定不会析构,但是这不可能成立的,因为Dispatcher是EventLoop的核心。 一个线程运行一个EventLoop直到线程结束,Dispatcher对象才会析构,这意味着Dispatcher对象的生命周期是最长的。所以从逻辑上没办法保证进行回调的时候对象没有析构。可能有人会有疑问,对象在析构的时候把注册的事件取消不就可以避免野指针的问题吗? 那如果事件已经触发了,callback正在等待运行呢? 又或者callback运行了一半呢?前者libevent是可以保证的,在调用event_del的时候可以把处于等待运行的事件取消掉,但是后者就无能为力了,这个时候如果对象析构了,那行为就是未定义了。沿着这个思路想一想,是不是只要保证对象析构的时候没有callback正在运行就可以解决问题了呢?是的,只要保证所有在执行中的callback执行完了,再做对象析构就可以了。可以利用Dispatcher是顺序执行所有callback的特点,向Dispatcher中插入一个任务就是用来对象析构的,那么当这个任务执行的时候是可以保证没有其他任何callback在运行。通过这个方法就完美解决了这里遇到的野指针问题了。 或许有人又会想,这里是不是可以用shared_ptr和shared_from_this来解这个呢? 是的,这是解决多线程环境下对象析构的秘密武器,通过延长对象的生命周期,把对象的生命周期延长到和callback一样,等callback执行完再进行析构,同样可以达到效果,但是这带来了两个问题,第一就是对象生命周期被无限拉长,虽然延迟析构也拉长了生命周期,但是时间是可预期的,一旦EventLoop执行了clearDeferredDeleteList任务就会立刻被回收,而通过shared_ptr的方式其生命周期取决于callback何时运行,而callback何时运行这个是没办法保证的,比如一个等待socket的可读事件进行回调,如果对端一直不发送数据,那么callback就一直不会被运行,对象就一直无法被析构,长时间累积会导致内存使用率上涨。第二就是在使用方式上侵入性较强,需要强制使用shared_ptr的方式创建对象。 总结 Dispatcher总的来说其实现还是比较简单明了的,比较容易验证其正确性,同样功能也相对较弱,和chromium的MessageLoop、boost的asio都是相似的用途,但是功能上差得比较多。好在这是专门给Envoy设计的,而且Envoy的场景也比较单一,不必做成那么通用的。另外一个我觉得比较奇怪的是,为什么在DeferredDeletable的实现中要用to_delete_1_和to_delete_2_两个队列交替来存放,其实按照我的理解一个队列即可,因为clearDeferredDeleteList和deferredDelete是保证在同一个线程中执行的,就和Dispatcher的任务队列一样,用一个队列保存所有要执行的任务,循环的执行即可。但是Envoy中没有这样做,我理解这样设计的原因可能是因为相比于任务队列来说延迟析构的重要性更低一些,大量对象的析构如果保存在一个队列中循环的进行析构势必会影响其他关键任务的执行,所以这里拆分成两个队列,多个任务交替的执行,就好比把一个大任务拆分成了好几个小任务顺序来执行。 附录 Libevent状态转换图 双十一广告:阿里云双十一1折拼团活动:已满6人,都是最低折扣了 【满6人】1核2G云服务器99.5元一年298.5元三年 2核4G云服务器545元一年 1227元三年 【满6人】1核1G MySQL数据库 119.5元一年 【满6人】3000条国内短信包 60元每6月 参团地址:http://click.aliyun.com/m/1000020293/ 作者: 中间件小哥 原文链接 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Java 之 Comparable vs Comparator

Comparable和Compator都是用于给集合排序的接口,但是他们之间的区别是什么呢。 Comparable: 这个接口只有一个方法compareTo。比如我们想通过年龄给用户排序,那么我们的用户要实现Comparable接口的方法,假如一旦要通过用户的评分进行排序,我们就必须要修改compareTo方法。 // o 是要比较的对象 // 返回负数,小于要比较的对象 // 返回 0 ,等于要比较的对象 // 返回正数,大于要比较的对象 public interface Comparable<T> { public int compareTo(T o); } Comparator: 这个接口有两个方法,equals和compare. 要进行比较的类不一定非要实现Comparator接口,由第三方的类实现这个接口来进行排序。 这样的话,排序的种类就可以有很多种,并且像对用户进行排序,我们可以通过年龄,姓名,评分等进行排序也不用修改用户类。我们要做的应该就是写 AgeComparator,NameComparator,RankComparator. public interface Comparator<T> { // 返回负数,第一个小于第二个的对象,o1 < o2 // 返回 0 ,对象相等 o1 = o2 // 返回正数,第一个大于第二个对象 o1 > o2 int compare(T o1, T o2); // 判断Compator之间是不是相同的 boolean equals(Object obj); } 案例 通过Comaparable排序 如果是通过评分(rank)进行排序,User类写法如下 public class User implements Comparable<User>{ private Integer id; private Integer rank; private Integer age; private String name; //getter and setter public User(Integer rank, Integer age, String name) { this.rank = rank; this.age = age; this.name = name; } // 通过rank进行排序 @Override public int compareTo(User o) { return this.getRank() - o.getRank(); } @Override public String toString() { return "User{" + "id=" + id + ", name='" + name + '\'' + ", rank=" + rank + ", age=" + age + '}'; } } 如果想要通过年龄进行排序,那么就要修改User对象。 public class User implements Comparable<User>{ private Integer id; private Integer rank; private Integer age; private String name; //getter and setter public User(Integer rank, Integer age, String name) { this.rank = rank; this.age = age; this.name = name; } // 通过rank进行排序 @Override public int compareTo(User o) { return this.getAge() - o.getAge(); } @Override public String toString() { return "User{" + "id=" + id + ", name='" + name + '\'' + ", rank=" + rank + ", age=" + age + '}'; } } 写测试类。 public class App { public static void main(String[] args) { List<User> list = new ArrayList<User>(); list.add(new User("aihe",100,23)); list.add(new User("weidong",80,25)); list.add(new User("zhangbo",85,28)); list.add(new User("leizhen",90,29)); Collections.sort(list); System.out.println(list); } } 通过Comparator进行排序 如果是通过Rank进行排序,创建RankComparator类。 public class RankComparator implements Comparator<User> { // 通过rank进行排序 public int compare(User o1, User o2) { return o1.getRank() - o2.getRank(); } } 如果是通过年龄进行排序,创建AgeComparator类。 public class AgeComparator implements Comparator<User> { // 通过age进行排序 public int compare(User o1, User o2) { return o1.getAge() - o2.getAge(); } } 测试类。 public class App { public static void main(String[] args) { List<User> list = new ArrayList<User>(); list.add(new User("aihe",100,23)); list.add(new User("weidong",80,25)); list.add(new User("zhangbo",85,28)); list.add(new User("leizhen",90,29)); Collections.sort(list,new RankComparator()); //Collections.sort(list,new AgeComparator()); System.out.println(list); } } 小结 如果我们的排序方式一般不会变化,我们知道要排序什么字段,在创建对象的时候可以直接实现Comparable接口。 如果我们还不清楚要比较什么字段,那么可以等到后续确定的时候实现Comparator接口,Comparator接口是从外部进行排序,不会对对象产生影响。 参考 Whats-the-difference-between-Comparable-and-Comparator-Interface-Java

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册