首页 文章 精选 留言 我的

精选列表

搜索[快速],共10000篇文章
优秀的个人博客,低调大师

带你快速上手

管理并发写入操作目录: 事务隔离说明 写入和读写操作 并发写入事务的潜在锁死情况 并发写入实例 一、事务隔离说明 openGauss基于MVCC(多版本并发控制)并结合两阶段锁的方式进行事务管理,其特点是读写之间不阻塞。SELECT是纯读操作,UPDATE和DELETE是读写操作。 读写操作和纯读操作之间并不会发生冲突,读写操作之间也不会发生冲突。每个并发事务在事务开始时创建事务快照,并发事务之间不能检测到对方的更改。 读已提交隔离级别中,如果事务T1提交后,事务T2就可以看到事务T1更改的结果。 可重复读级别中,如果事务T1提交事务前事务T2开始执行,则事务T1提交后,事务T2依旧看不到事务T1更改的结果,保证了一个事务开始后,查询的结果前后一致,不受其他事务的影响。 读写操作,支持的是行级锁,不同的事务可以并发更新同一个表,只有更新同一行时才需等待,后发生的事务会等待先发生的事务提交后,再执行更新操作。 READ COMMITTED:读已提交隔离级别,事务只能读到已提交的数据而不会读到未提交的数据,这是缺省值。 REPEATABLE READ: 事务只能读到事务开始之前已提交的数据,不能读到未提交的数据以及事务执行期间其它并发事务提交的修改。 二、写入和读写操作 关于写入和读写操作的命令: INSERT,可向表中插入一行或多行数据。 UPDATE,可修改表中现有数据。 DELETE,可删除表中现有数据。 COPY,导入数据。 INSERT和COPY是纯写入的操作。并发写入操作,需要等待,对同一个表的操作,当事务T1的INSERT或COPY未解除锁定时,事务T2的INSERT或COPY需等待,事务T1解除锁定时,事务T2正常继续。 UPDATE和DELETE是读写操作(先查询出要操作的行)。UPDATE和DELETE执行前需要先查询数据,由于并发事务彼此不可见,所以UPDATE和DELETE操作是读取事务发生前提交的数据的快照。写入操作,是行级锁,当事务T1和事务T2并发更新同一行时,后发生的事务T2会等待,根据设置的等待时长,若超时事务T1未提交则事务T2执行失败;当事务T1和事务T2并发更新的行不同时,事务T1和事务2都会执行成功。 三、并发写入事务的潜在死锁情况 只要事务涉及多个表的或者同一个表相同行的更新时,同时运行的事务就可能在同时尝试写入时变为死锁状态。事务会在提交或回滚时一次性解除其所有锁定,而不会逐一放弃锁定。例如,假设事务T1和T2在大致相同的时间开始: 如果T1开始对表A进行写入且T2开始对表B进行写入,则两个事务均可继续而不会发生冲突;但是,如果T1完成了对表A的写入操作并需要开始对表B进行写入,此时操作的行数正好与T2一致,它将无法继续,因为T2仍保持对表B对应行的锁定,此时T2开始更新表A中与T1相同的行数,此时也将无法继续,产生死锁,在锁等待超时内,前面事务提交释放锁,后面的事务可以继续执行更新,等待时间超时后,事务抛错,有一个事务退出。 如果T1,T2都对表A进行写入,此时T1更新1-5行的数据,T2更新6-10行的数据,两个事务不会发生冲突,但是,如果T1完成后开始对表A的6-10行数据进行更新,T2完成后开始更新1-5行的数据,此时两个事务无法继续,在锁等待超时内,前面事务提交释放锁,后面的事务可以继续执行更新,等待时间超时后,事务抛错,有一个事务退出。 四、并发写入示例 相同表的INSERT和DELETE并发 相同表的并发INSERT 相同表的并发UPDATE 数据导入和查询的并发 本章节以表test为例,分别介绍相同表的INSERT和DELETE并发,相同表的并发INSERT,相同表的并发UPDATE,以及数据导入和查询的并发的执行详情。 CREATE TABLE test(id int, name char(50), address varchar(255)); ①相同表的INSERT和DELETE并发 事务T1: START TRANSACTION; INSERT INTO test VALUES(1,'test1','test123'); COMMIT; 事务T2: START TRANSACTION; DELETE test WHERE NAME='test1'; COMMIT; 场景1: 开启事务T1,不提交的同时开启事务T2,事务T1执行INSERT完成后,执行事务T2的DELETE,此时显示DELETE 0,由于事务T1未提交,事务2看不到事务插入的数据; 场景2: READ COMMITTED级别 开启事务T1,不提交的同时开启事务T2,事务T1执行INSERT完成后,提交事务T1,事务T2再执行DELETE语句时,此时显示DELETE 1,事务T1提交完成后,事务T2可以看到此条数据,可以删除成功。 REPEATABLE READ级别 开启事务T1,不提交的同时开启事务T2,事务T1执行INSERT完成后,提交事务T1,事务T2再执行DELETE语句时,此时显示DELETE 0,事务T1提交完成后,事务T2依旧看不到事务T1的数据,一个事务中前后查询到的数据是一致的。 ②相同表的并发INSERT 事务T1: START TRANSACTION; INSERT INTO test VALUES(2,'test2','test123'); COMMIT; 事务T2: START TRANSACTION; INSERT INTO test VALUES(3,'test3','test123'); COMMIT; 场景1: 开启事务T1,不提交的同时开启事务T2,事务T1执行INSERT完成后,执行事务T2的INSERT语句,可以执行成功,读已提交和可重复读隔离级别下,此时在事务T1中执行SELECT语句,看不到事务T2中插入的数据,事务T2中执行查询语句看不到事务T1中插入的数据。 场景2: READ COMMITTED级别 开启事务T1,不提交的同时开启事务T2,事务T1执行INSERT完成后直接提交,事务T2中执行INSERT语句后执行查询语句,可以看到事务T1中插入的数据。 REPEATABLE READ级别 开启事务T1,不提交的同时开启事务T2,事务T1执行INSERT完成后直接提交,事务T2中执行INSERT语句后执行查询语句,看不到事务T1中插入的数据。 ③相同表的并发UPDATE 事务T1: START TRANSACTION; UPDATE test SET address='test1234' WHERE name='test1'; COMMIT; 事务T2: START TRANSACTION; UPDATE test SET address='test1234' WHERE name='test2'; COMMIT; 事务T3: START TRANSACTION; UPDATE test SET address='test1234' WHERE name='test1'; COMMIT; 场景1: 开启事务T1,不提交的同时开启事务T2,事务T1开始执行UPDATE,事务T2开始执行UPDATE,事务T1和事务T2都执行成功。更新不同行时,更新操作拿的是行级锁,不会发生冲突,两个事务都可以执行成功。 场景2: 开启事务T1,不提交的同时开启事务T3,事务T1开始执行UPDATE,事务T3开始执行UPDATE,事务T1执行成功,事务T3等待超时后会出错。更新相同行时,事务T1未提交时,未释放锁,导致事务T3执行不成功。 ④数据导入和查询的并发 事务T1: START TRANSACTION; COPY test FROM '...'; COMMIT; 事务T2: START TRANSACTION; SELECT * FROM test; COMMIT; 场景1: 开启事务T1,不提交的同时开启事务T2,事务T1开始执行COPY,事务T2开始执行SELECT,事务T1和事务T2都执行成功。事务T2中查询看不到事务T1新COPY进来的数据。 场景2: READ COMMITTED级别 开启事务T1,不提交的同时开启事务T2,事务T1开始执行COPY,然后提交,事务T2查询,可以看到事务T1中COPY的数据。 REPEATABLE READ级别 开启事务T1,不提交的同时开启事务T2,事务T1开始执行COPY,然后提交,事务T2 查询,看不到事务T1中COPY的数据。

优秀的个人博客,低调大师

如何快速调度 PTS 的百万并发能力

作者:灵苒 在实际的业务场景中,压测是必不可少的一环,无论是对服务器、数据库、网络等性能瓶颈的评估,还是如浏览、下单、支付等重要流量节点的业务连续性保障,亦或是搬站上云整体业务稳定性的预估,这些都需要性能压测来帮助你建立对系统和业务的完整认知。根据 Google 的统计,如果网站打开慢每 500 毫秒,用户访问量将下降 20%。根据 Amazon 统计,每慢 100 毫秒,交易额下降 1%。这些事件和统计数据为大家敲响了警钟,也客观说明了性能压测对于企业应用的重要性。 压测是通过模拟用户行为对业务系统发起请求,测算出系统的承载能力,并对系统做一次全面的体检,压测后可根据压测表现优化系统瓶颈,防止出现线上故障。 业界常见的压测软件 JMeter 和 PTS 目前 JMeter 是性能压测领域应用最广泛的开源软件。 对于场景简单,要求测试并发量不高的情况下,JMeter 本地测试就能满足需求。但随着互联网用户的增加,对系统承载更大并发的需求日渐提升,而单台 JMeter 施压机的施压能力有一定上限,所以需要使用多台施压机,以提高 JMeter 的施压能力,这就要使用到 JMeter 的分布式施压功能。 但 JMeter 的分布式压测前置准备较多,需要注意以下几点: 施压机的防火墙已关闭或打开了正确的端口。为 RMI 设置了 SSL 或禁用了它。 所有施压机都在同一个子网上。如果使用 192.xxx或10.xxx IP 地址,则服务器位于同一子网中。 所有施压机上使用相同版本的 JMeter 和 Java。 所有施压机都已经拷贝了切分好的 CSV 数据文件、依赖 jar 包等。 已配置好监控数据的收集。 由此可见 JMeter 的分布式压测需要自己协调各资源,前置准备比较麻烦,对实施压测的人员来说压测效率低。 PTS 是阿里云研发的性能测试工具,最初主要为了模拟双十一流量洪峰,如今已走过十个年头,在场景编排、压测执行、压测监控分析、报告总结等各方面能力相对完善,可提供百万并发、千万 TPS 流量发起能力,并且还能完全兼容 JMeter,可天然弥补 JMeter 在性能压测中的劣势。对使用 JMerer 无法绕过集群问题的用户是一个很好的选择。 PTS 的 JMeter 压测极大的简化了 JMeter 分布式压测流程,同时也降低了压测过程中对施压机的维护成本。使用 PTS 的 JMeter 压测,用户只需要在控制台配置需要使用的机器数,无须用户提前准备多台已安装相同 Java 和 JMeter 版本的施压机。同时无须用户根据施压机数量去切分 CSV 参数文件;压测结束后,PTS 会将监控数据汇总产生一个详细的压测报告供用户查阅。 相比于直接在命令行执行 JMeter 脚本来说,PTS 使用更加方便,可按需提供海量的施压能力,并且能提供简洁直观的监控和报告。 如何发起 PTS的 JMeter 压测 和所有压测的核心步骤一样,使用 PTS 的 JMeter 压测,也主要集中在创建场景、压测场景和查看报告三个步骤中。 1、创建场景:PTS 的 JMeter 压测以场景为核心,压测对象为一个场景,场景中包括JMeter(原生)脚本、JMeter 依赖(一系列依赖 jar 包和一系列 properties 配置)、及一些压测配置(PTS 压测的配置,例如公网/VPC 压测、并发量、引擎数量、压测时长等)。 2、压测场景:对场景的操作分为两方面,一是对场景配置的增删改查,二是对场景的压测和调试。 3、生成报告:每次对场景压测都会生成一个压测任务,同时生成一个报告,其中包括压测的关键指标,如 TPS、RT、成功率等,可辅助用户排查系统性能瓶颈。此外,PTS 默认将报告保存 30 天,可以随时查看历史报告,并且提供导出 PDF 格式的报告。 在压测领域,随着压测需求日益多样化,更多用户希望将云上的压测能力继承到自己的系统,或者根据自己的业务系统,编排自定义的压测平台,从而实现自动化定制化压测需求。 所以,为了方便用户便捷调度 PTS 百万并发的能力,PTS 开通了 JMeter 的 OpenAPI,提供了如下几类压测的核心功能:编辑场景、调试场景、压测场景、查看运行时数据、查看报告。 通过集成 OpenAPI,客户可以更加方便的在自己的业务场景实现 PTS 百万级并发压测的能力,实现场景的增、删、改、查等各种操作,一键启动压测,并在压测过程中,随时停止压测。同时生成的压测报告中,除了JMeter 原生的日志外,还有 PTS 针对某个采样器的成功率、TPS、RT 指标的聚合数据。另外还可以对报告进行查看报告列表、JMeter 原生日志以及 PTS 对 JMeter 采样器压测指标的聚合数据等功能。 那么还等什么呢?来,试着用 PTS 中 JMeter 的 OpenAPI 写一个属于你的百万级并发压测能力的压测平台吧! 附录: 具体步骤如下 引入 pom 依赖 <!--创建PTS场景需要的实体类,如果只使用JMeter压测则不需要引入--> <dependency> <groupId>com.aliyun</groupId> <artifactId>pts-api-entity</artifactId> <version>1.0.1</version> </dependency> <!--PTS Java SDK依赖。--> <dependency> <groupId>com.aliyun</groupId> <artifactId>pts20201020</artifactId> <version>1.8.10</version> </dependency> <!--阿里云核心库。--> <dependency> <groupId>com.aliyun</groupId> <artifactId>aliyun-java-sdk-core</artifactId> <version>4.5.2</version> </dependency> \ 复制下列代码 import com.aliyun.pts20201020.Client; import com.aliyun.pts20201020.models.*; import com.aliyun.teaopenapi.models.Config; import java.util.ArrayList; import java.util.List; import java.util.Map; public class StartingDemo { public static void main(String[] args) throws Exception { Client client = getClient(); // 创建场景 String sceneId = createScene(client); // 启动场景 String reportId = startTesting(client, sceneId); // 最多等待次数 int count = 0; // 查询是否已生成报告 while (!hasReport(client, reportId) && count++ < 20) { // 若报告还未生成,则等待(30s)一段时间再查询 // 根据压测时间酌情等待 Thread.sleep(30 * 1000); } // 查看报告 getJMeterReport(client, reportId); } private static boolean hasReport(Client client, String reportId) throws Exception { ListJMeterReportsRequest request = new ListJMeterReportsRequest(); // 分页设置 request.setPageNumber(1); request.setPageSize(1); // 查询条件设置 request.setReportId(reportId); ListJMeterReportsResponse response = client.listJMeterReports(request); return response.getBody().getReports().size() > 0; } private static void getJMeterReport(Client client, String reportId) throws Exception { // 查看机器日志 GetJMeterLogsResponse getJMeterLogsResponse = getJMeterLogs(client, reportId); List<Map<String, ?>> logs = getJMeterLogsResponse.getBody().getLogs(); // 查看采样器聚合数据 GetJMeterSampleMetricsResponse getJMeterSampleMetrics = getJMeterSampleMetrics(client, reportId); List<String> sampleMetricList = getJMeterSampleMetrics.getBody().getSampleMetricList(); // 查看采样日志 GetJMeterSamplingLogsResponse getJMeterSamplingLogs = getJMeterSamplingLogs(client, reportId); List<String> sampleResults = getJMeterSamplingLogs.getBody().getSampleResults(); } private static GetJMeterSamplingLogsResponse getJMeterSamplingLogs(Client client, String reportId) throws Exception { GetJMeterSamplingLogsRequest request = new GetJMeterSamplingLogsRequest(); // 分页设置 request.setPageNumber(1); request.setPageSize(10); // 条件设置 request.setReportId(reportId); GetJMeterSamplingLogsResponse response = client.getJMeterSamplingLogs(request); return response; } private static GetJMeterSampleMetricsResponse getJMeterSampleMetrics(Client client, String reportId) throws Exception { GetJMeterSampleMetricsRequest request = new GetJMeterSampleMetricsRequest(); // 设置报告id request.setReportId(reportId); GetJMeterSampleMetricsResponse response = client.getJMeterSampleMetrics(request); return response; } private static GetJMeterLogsResponse getJMeterLogs(Client client, String reportId) throws Exception { GetJMeterLogsRequest request = new GetJMeterLogsRequest(); // 分页设置 request.setPageNumber(1); request.setPageSize(10); // 查询的压测引擎索引 request.setReportId(reportId); GetJMeterLogsResponse response = client.getJMeterLogs(request); return response; } private static String startTesting(Client client, String sceneId) throws Exception { StartTestingJMeterSceneResponse startTestingSceneResponse = startTestingScene(client, sceneId); String reportId = startTestingSceneResponse.getBody().getReportId(); return reportId; } private static StartTestingJMeterSceneResponse startTestingScene(Client client, String sceneId) throws Exception { StartTestingJMeterSceneRequest request = new StartTestingJMeterSceneRequest(); request.setSceneId(sceneId); StartTestingJMeterSceneResponse response = client.startTestingJMeterScene(request); return response; } private static String createScene(Client client) throws Exception { SaveOpenJMeterSceneRequest request = new SaveOpenJMeterSceneRequest(); // 定义场景 SaveOpenJMeterSceneRequest.SaveOpenJMeterSceneRequestOpenJMeterScene scene = new SaveOpenJMeterSceneRequest.SaveOpenJMeterSceneRequestOpenJMeterScene(); // 设置场景名 scene.setSceneName("test"); // 设置文件列表,包括JMeter脚本、JMeter压测依赖jar包、配置额度数据文件等 List<SaveOpenJMeterSceneRequest.SaveOpenJMeterSceneRequestOpenJMeterSceneFileList> fileList = new ArrayList<SaveOpenJMeterSceneRequest.SaveOpenJMeterSceneRequestOpenJMeterSceneFileList>(); // 设置文件的属性 需要设置文件的名称和文件公网可访问的oss地址 SaveOpenJMeterSceneRequest.SaveOpenJMeterSceneRequestOpenJMeterSceneFileList testFile = new SaveOpenJMeterSceneRequest.SaveOpenJMeterSceneRequestOpenJMeterSceneFileList(); testFile.setFileName("baidu.jmx"); testFile.setFileOssAddress("https://pts-openapi-test.oss-cn-shanghai.aliyuncs.com/baidu.jmx"); fileList.add(testFile); scene.setFileList(fileList); // 设置场景并发,可设置为100万 scene.setConcurrency(1000000); // 设置引擎数量 说明:一台引擎最多能发500并发,最少1并发所以此处能设置的引擎数为[2,1000],另外引擎数量越多消耗vum越快 scene.setAgentCount(2000); // 设置压测持续时间 60s scene.setDuration(60); // 设置测试文件的名称,这个文件需包括在文件列表中 scene.setTestFile("baidu.jmx"); request.setOpenJMeterScene(scene); SaveOpenJMeterSceneResponse response = client.saveOpenJMeterScene(request); return response.getBody().getSceneId(); } private static Client getClient() throws Exception { // 填写自己的AK/SK String accessKeyId = "ak"; String accessKeySecret = "sk"; Config config = new Config(); config.setAccessKeyId(accessKeyId); config.setAccessKeySecret(accessKeySecret); Client client = new Client(config); return client; } } 填写自己的 ak/sk 在上述代码的 getClient 中填写正确的 ak/sk 点击启动 点击 main 方法启动 点击​​此处​​,前往 PTS 官网了解更多详情!

优秀的个人博客,低调大师

Bootstrap 4.6.1 版本发布,web 快速开发框架

Bootstrap 4.6.1 版本发布了,Bootstrap 是一款流行的 Web 开发框架,此版本带来以下更新: 用乘法和自定义函数替换 Sass 除法。#34571 将RFS 更新到 v8.1.0 。#34571 修复表单的输入组和验证图标。#32968 修复 Firefox 火狐浏览器中,moz-focusring带来的细微视觉错误。 删除SAFE_URL_PATTERN正则表达式的全局修饰符,以适应普通正则表达式的测试方法。#33153 在SAFE_URL_PATTERN中 加入sms。#35074 调整select.form-control反馈图标的位置和内间距。#33206 轮播:上下页切换使用按钮代替链接。#33165 v4:修复 Sass 文档默认变量不能被覆盖的问题。#33392 修复add()&subtract()计算复杂表达式容易出错的问题。#34047 改进了 add()&subtract()的计算逻辑。#34432 在下拉列表中移除aria-haspopup。#33624 下拉:现在可以在<li>标签里面放.dropdown-item。#33649 更新 JS 测试的 node 版本(删除 node 10,添加 node 16)。#33807 用 Libera IRC 服务器替换 Freenode 。#34050 修正了Navbar 文档描述的重复部分。#34208 启用0.x格式的负边距(之前 0.5 会被算成 0,现在正确算成 0.5)。#33593 删除thead规则 。#34426 修复了选择淡出类(fade class)后,show事件无法重新触发的问题。#34087 使用自定义文件输入进行输出组验证。#33239 添加eslint-plugin-qunit并收紧 JS 测试。#32270 将测试更新到Node 16 和 npm 8 。#35142 禁用链接清理。#34924 更新开发环境依赖模块。 更新公告:https://github.com/twbs/bootstrap/releases/tag/v4.6.1

优秀的个人博客,低调大师

JeeSite V4.3.0.2 快速开发平台发布

JeeSite Cloud v4.3.0.2 发布,具体更新内容如下: 升级内容 增加 Datagrid 的 options.gridMinMeight 最小高度设置 增加 web.securityMode 开关,控制一些风险功能的操作 优化 ztree 图标显示,可区分半选中状态 优化 oauth2 client 的超时时间,默认 30 秒 优化 Cloud 下或引入第三方插件的时候 Validator 可能会有冲突问题 优化 扩展 Lang 语言包时,如果没有定义的前端语言包,则不报错 优化 自定义登录页时,不在 adminPath 下的时候,地址不对问题 优化 uni-app h5 的流程图展示,可以拖拽 优化 Swagger Models 的扫描 修正 select2 禁用的时候,按空格可弹窗下拉框问题 修正 js.log 在 ie11 下报错兼容性问题 修正 Cloud 下消息内容可能会丢失问题 去掉 树表里的 parent 为空验证,因为无关紧要 字典 treeData 接口增加 cssClass 和 cssStyle 返回 菜单 获取菜单和权限接口增加 parentCode 参数返回 BPM 提交流程,自动完成相同处理人时,之前是读取的是全局表单,优化为如果有定义当前节点的流程选项,则读取当前节点的选项 BPM 增加根据流程 ids 和流程 keys 进行查询,支持 in 查询 BPM 修正 BpmTask 的 assigneeCode 显示不正确的问题 发布基于 Spring Authorization Server 的 OAuth2 服务端 升级 Shiro 1.8.0 CrudService 新增 updateStatusByIds 和 deleteByIds 批量方法 BPM 新增手机端风格的流程跟踪图和流程追踪界面 BPM 更正流程表单 URL 前面加///无效的问题 BPM 增加流程接口在线文档 对象存储:增加 baseDir 参数 字典接口:treeData 包含 status 为空的数据 文件管理:点击文件夹树刷新的时候,右侧列表显示根文件夹数据 模块管理:优化模块编码的验证,支持带减号,字母开头 layer.css 去掉top动画,不影响拖拽动作 form:checkbox 当 name 为空的时候不发送 !号开头的参数 国际化译文优化,访问日志国际化,感谢 SoleMan 分享 升级方法 修改pom.xml文件中的jeesite-parent版本号为4.3.0-SNAPSHOT 如果你导入了jeesite-common源码项目,请与git上的代码进行同步 如果你导入了jeesite-module-core源码项目,请与git上的代码进行同步 如果你是跨版本升级,请注意每一个版本的升级方法,业务上有调整的地方进行修改 执行root/package.bat(sh)打包脚本,强制更新依赖即可。

优秀的个人博客,低调大师

软件架构-zookeeper集群部署与快速入门

目前的公司是使用的阿里内部的dubbo,也就是EDAS,里面用了阿里自己的EDAS服务,如果是使用过dubbo的老铁,应该知道zookeeper,zookeeper在大数据和RPC通信上应用比较管饭。不管用过zookeeper没有,这次主要是介绍下zookeeper和集群的部署。这个必须要实际操作下,才能理解的深刻。源码:https://github.com/limingios/netFuture/ 【zookeeper】 (一)介绍zookeeper 历史 Zookeeper 最早起源于雅虎研究院的一个研究小组。在当时,研究人员发现,在雅虎内部很多大型系统基本都需要依赖一个类似的系统来进行分布式协调,但是这些系统往往都存在分布式单点问题。所以,雅虎的开发人员就试图开发一个通用的无单点问题的分布式协调框架,以便让开发人员将精力集中在处理业务逻辑上。关于“ZooKeeper”这个项目的名字,其实也有一段趣闻。在立项初期,考虑到之前内部很多项目都是使用动物的名字来命名的(例如著名的Pig项目),雅虎的工程师希望给这个项目也取一个动物的名字。时任研究院的首席科学家 RaghuRamakrishnan 开玩笑地说:“在这样下去,我们这儿就变成动物园了!”此话一出,大家纷纷表示就叫动物园管理员吧一一一因为各个以动物命名的分布式组件放在一起,雅虎的整个分布式系统看上去就像一个大型的动物园了,而 Zookeeper 正好要用来进行分布式环境的协调一一于是,Zookeeper 的名字也就由此诞生了。 为什么zookeeper会火 20世纪60年代,大型机被发明了出来,凭借自身的超强计算和I/O处理能力以及稳定、安全性,成为了世界的主流。但是大型机也有一些致命的问题,比如造价昂贵、操作复杂、单点问题等。特别是对大型机的人才的培养成本非常之高。随着这些问题的出现,不断影响了大型机的发展。而另一方面PC机性能的不断提升和网络普及,大家开始转向了使用小型机和普通的PC服务器来搭建分布式的计算机系统,来降级成本。而后分布式便不断火热起来。 zookeeper的官网 https://zookeeper.apache.org/ 下载地址: https://www-eu.apache.org/dist/zookeeper/ 源码地址:https://github.com/apache/zookeeper (二)集群部署 集群分为2类,一种是分布式集群,一种是伪分布式集群。分布式:每个应用在单独的独立主机上,端口都是一致的。伪分布式:多个应用在一台主机上,端口进行区别。伪分布式在实际生产环境很少。对于操作来说伪分布式集群更难一些。 mac 安装vgarant :https://idig8.com/2018/07/29/docker-zhongji-07/window安装vgaranthttps://idig8.com/2018/07/29/docker-zhongji-08/ 系统类型 IP地址 节点角色 CPU Memory Hostname Centos7 192.168.69.100 伪分布式 2 2G zookeeper-virtua Centos7 192.168.69.101 真分布式-领导者 2 2G zookeeper-Leader Centos7 192.168.69.102 真分布式-属下1 2 2G zookeeper-Follower1 Centos7 192.168.69.103 真分布式-属下2 2 2G zookeeper-Follower2 src的小技巧,这样就有颜色了,之前一直忽略了,看的眼疼,现在颜色分明了好多了。 (2.1)伪环境配置 还是用vagrant来,自从熟悉了vagrant 我基本没手动创建过虚拟机。 (2.1.1)基础设置 su #密码 vagrant cd ~ vi /etc/ssh/sshd_config sudo systemctl restart sshd vi /etc/resolv.conf 设置成8.8.8.8 service network restart ![](https://s4.51cto.com/images/blog/202103/29/f2f57966c3d058de71cd8876b72d400d.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/e4323f41090b580235fb1bb7799085b3.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/74a1b1cdbe2e9ed5a02c2548f32d43f7.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) >(2.1.2)jdk安装 >脚本在我的源码里面 ``` bash vi pro.sh sh pro.sh (2.1.3)zookeeper下载下载工具千万切记用最新的已经出到3.5.4,我还是用3.4.10 wget https://www-eu.apache.org/dist/zookeeper/zookeeper-3.4.10/zookeeper-3.4.10.tar.gz (2.1.4)解压zookeeper tar zxvf zookeeper-3.4.10.tar.gz (2.1.5)进入zk中的conf目录下拷贝3个文件 cd /root/zookeeper-3.4.10/conf cp zoo_sample.cfg zoo1.cfg cp zoo_sample.cfg zoo2.cfg cp zoo_sample.cfg zoo3.cfg (2.1.6) 编辑这3个文件zoo1.cfg,zoo2.cfg,zoo3.cfg (2.1.6.1)编辑zoo1.cfg vi zoo1.cfg dataDir=/apps/servers/data/d_1dataLogDir=/apps/servers/logs/logs_1clientPort=2181 # The number of milliseconds of each tick tickTime=2000 # The number of ticks that the initial # synchronization phase can take initLimit=10 # The number of ticks that can pass between # sending a request and getting an acknowledgement syncLimit=5 # the directory where the snapshot is stored. # do not use /tmp for storage, /tmp here is just # example sakes. dataDir=/apps/servers/data/d_1 dataLogDir=/apps/servers/logs/logs_1 # the port at which the clients will connect clientPort=2181 # the maximum number of client connections. # increase this if you need to handle more clients #maxClientCnxns=60 # # Be sure to read the maintenance section of the # administrator guide before turning on autopurge. # # http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance # # The number of snapshots to retain in dataDir #autopurge.snapRetainCount=3 # Purge task interval in hours # Set to "0" to disable auto purge feature #autopurge.purgeInterval=1 server.1=localhost:2187:2887 server.2=localhost:2188:2888 server.3=localhost:2189:2889 (2.1.6.2)编辑zoo2.cfg vi zoo2.cfg dataDir=/apps/servers/data/d_2dataLogDir=/apps/servers/logs/logs_2clientPort=2182 # The number of milliseconds of each tick tickTime=2000 # The number of ticks that the initial # synchronization phase can take initLimit=10 # The number of ticks that can pass between # sending a request and getting an acknowledgement syncLimit=5 # the directory where the snapshot is stored. # do not use /tmp for storage, /tmp here is just # example sakes. dataDir=/apps/servers/data/d_2 dataLogDir=/apps/servers/logs/logs_2 # the port at which the clients will connect clientPort=2182 # the maximum number of client connections. # increase this if you need to handle more clients #maxClientCnxns=60 # # Be sure to read the maintenance section of the # administrator guide before turning on autopurge. # # http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance # # The number of snapshots to retain in dataDir #autopurge.snapRetainCount=3 # Purge task interval in hours # Set to "0" to disable auto purge feature #autopurge.purgeInterval=1 server.1=localhost:2187:2887 server.2=localhost:2188:2888 server.3=localhost:2189:2889 (2.1.6.3)编辑zoo3.cfg vi zoo3.cfg dataDir=/apps/servers/data/d_3dataLogDir=/apps/servers/logs/logs_3clientPort=2183 # The number of milliseconds of each tick tickTime=2000 # The number of ticks that the initial # synchronization phase can take initLimit=10 # The number of ticks that can pass between # sending a request and getting an acknowledgement syncLimit=5 # the directory where the snapshot is stored. # do not use /tmp for storage, /tmp here is just # example sakes. dataDir=/apps/servers/data/d_3 dataLogDir=/apps/servers/logs/logs_3 # the port at which the clients will connect clientPort=2183 # the maximum number of client connections. # increase this if you need to handle more clients #maxClientCnxns=60 # # Be sure to read the maintenance section of the # administrator guide before turning on autopurge. # # http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance # # The number of snapshots to retain in dataDir #autopurge.snapRetainCount=3 # Purge task interval in hours # Set to "0" to disable auto purge feature #autopurge.purgeInterval=1 server.1=localhost:2187:2887 server.2=localhost:2188:2888 server.3=localhost:2189:2889 (2.1.7)创建data目录和日志目录 mkdir -p /apps/servers/data/d_1 mkdir -p /apps/servers/data/d_2 mkdir -p /apps/servers/data/d_3 mkdir -p /apps/servers/logs/logs_1mkdir -p /apps/servers/logs/logs_2mkdir -p /apps/servers/logs/logs_3 echo "1" >/apps/servers/data/d_1/myidecho "2" >/apps/servers/data/d_2/myidecho "3" >/apps/servers/data/d_3/myid ![](https://s4.51cto.com/images/blog/202103/29/bb0ddca4f266c6cd6403b404b78137a5.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) > (2.1.8)进入bin目录下输入命令 分别进行启动 ``` bash cd /root/zookeeper-3.4.10/bin sh zkServer.sh start ../conf/zoo1.cfg sh zkServer.sh start ../conf/zoo2.cfg sh zkServer.sh start ../conf/zoo3.cfg (2.1.9)进入每一个看看效果 source /etc/profile sh zkCli.sh -server localhost:2181 sh zkCli.sh -server localhost:2182 sh zkCli.sh -server localhost:2183 伪分布式其实就是这样就搭建完毕了。重点还是分布式的往下看。 (1.2)分布式环境配置 (1.2.1)基础设置(三台机器都需要设置) su #密码 vagrant cd ~ vi /etc/ssh/sshd_config sudo systemctl restart sshd vi /etc/resolv.conf 设置成8.8.8.8 service network restart ![](https://s4.51cto.com/images/blog/202103/29/8e99903cd4dd9b09d9678d7ca198e241.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/b568acb6d1a68f7dd273b9de8c28c4c9.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/40339ca5c1da8e223d163f09fdf662ef.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/34ff8d7ef04f5ecf8f9f22a2d3173118.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/57a2b18d8ed9be3e771109b235b19d27.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/de9aa1f23f76fe531c3f24a30817afac.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/1099f2467a970822e665d75894627044.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/7fb6e5410a73d2e47645441a788ece6d.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) ![](https://s4.51cto.com/images/blog/202103/29/9edf9d6539bf1d3ccc9a132089b57b05.png?x-oss-process=image/watermark,size_16,text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=) >(1.2.2)jdk安装(三台机器都需要设置) >脚本在我的源码里面 ``` bash vi pro.sh sh pro.sh (1.2.3)zookeeper下载(三台机器都需要设置)下载工具千万切记用最新的已经出到3.5.4,我还是用3.4.10为什么是三个,因为Zookeeper喜欢奇数不喜欢偶数。 wget https://www-eu.apache.org/dist/zookeeper/zookeeper-3.4.10/zookeeper-3.4.10.tar.gz (1.2.4)解压zookeeper tar zxvf zookeeper-3.4.10.tar.gz (1.2.4)配置cfg文件(三台机器都需要设置) cd ~ cd zookeeper-3.4.10/ cd conf cp zoo_sample.cfg zoo.cfg (1.2.5)配置cfg文件,其实这3个机器的配置文件是一样的,我就不重复写cfg了,就直接截图了 vi zoo.cfg # The number of milliseconds of each tick tickTime=2000 # The number of ticks that the initial # synchronization phase can take initLimit=10 # The number of ticks that can pass between # sending a request and getting an acknowledgement syncLimit=5 # the directory where the snapshot is stored. # do not use /tmp for storage, /tmp here is just # example sakes. dataDir=/tmp/zookeeper dataLogDir=/tmp/zookeeper/logs # the port at which the clients will connect clientPort=2181 # the maximum number of client connections. # increase this if you need to handle more clients #maxClientCnxns=60 # # Be sure to read the maintenance section of the # administrator guide before turning on autopurge. # # http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance # # The number of snapshots to retain in dataDir #autopurge.snapRetainCount=3 # Purge task interval in hours # Set to "0" to disable auto purge feature #autopurge.purgeInterval=1 server.0=192.168.69.101:2888:3888 server.1=192.168.69.102:2888:3888 server.2=192.168.69.103:2888:3888 (1.2.6)配置myid需要配置到上边dataDir=/tmp/zookeeper的目录下。 cd / cd tmp mkdir zookeeper cd zookeeper (1.2.6.1)192.168.69.101配置myid echo '0'&gt;myid cat myid (1.2.6.2)192.168.69.102配置myid echo '1'&gt;myid cat myid (1.2.6.3)192.168.69.103配置myid echo '2'&gt;myid cat myid 启动命令运行3台虚拟机下的zookeeper cd ~/zookeeper-3.4.10/bin sh zkServer.sh start ####(三) 概念梳理 (3.1)Zoo.cfg 配置 参数 意义 tickTime 2000 syncLimit Leader 和 follower 之间的通讯时长 最长不能超过initLimt*ticktime initLimt 接受客户端链接 zk 初始化的最长等待心跳时长initLimt*ticktime dataDir 数据目录 dataLogDir 日志文件 clientPort 客户端链接服务端端口号Server.A=B:C:D A:第几号服务器 B 服务 IP C 代表 Leader 和 follower 通讯端口 D 备用选 leader 端口 (3.2)角色 Leader: Leader 作为整个 ZooKeeper 集群的主节点,负责响应所有对 ZooKeeper 状态变更的请求。它会将每个状态更新请求进行排序和编号,以便保证整个集群内部消息处理的 FIFO,写操作都走 leader Follower : Follower 的逻辑就比较简单了。除了响应本服务器上的读请求外,follower 还要处理leader 的提议,并在 leader 提交该提议时在本地也进行提交。 另外需要注意的是,leader 和 follower 构成 ZooKeeper 集群的法定人数,也就是说,只有他们才参与新 leader的选举、响应 leader 的提议。 Observer : 如果 ZooKeeper 集群的读取负载很高,或者客户端多到跨机房,可以设置一些 observer服务器,以提高读取的吞吐量。Observer 和 Follower 比较相似,只有一些小区别:首先observer 不属于法定人数,即不参加选举也不响应提议;其次是 observer 不需要将事务持久化到磁盘,一旦 observer 被重启,需要从 leader 重新同步整个名字空间。 (3.3)Zookeeper 特性 Zookeeper 是一个由多个 server 组成的1.集群一个 leader,多个 follower2.每个 server 保存一份数据副本3.全局数据一致分布式读follower,写由 leader 实施更新请求转发,由 leader 实施更新请求顺序进行,来自同一个 client 的更新请求按其发送顺序依次执行数据更新原子性,4.一次数据更新要么成功,要么失败全局唯一数据视图,5.client 无论连接到哪个 server,数据视图都是一致的实时性,在一定事件范围内,client 能读到最新数据 PS:本次主要说说zookeeper的原理和集群部署,没有太详细的介绍里面的细节,下次说说zookeeper使用。

优秀的个人博客,低调大师

ProBuilder快速原型开发技术 ---进阶功能操作

本篇讲解PB的“碰撞体与触发器”、”模型的导出”、“第三方模型编辑”、“UnityManual API”四部分内容。一:碰撞体与触发器PB中对于碰撞检测与触发检测,有自己一套单独的组件,可以更好的配合使用。分别是Set Collider 与Set Trigger组件,下图的绿色部分为碰撞体,黄色为触发体。 二:模型的导出PB中有单独的模型导出方式,可以使用“Export”功能,导出各种文件格式,目前支持的格式有:.obj、.stl、.ply、.Asset、*.Prefab 等。 提示:此外模型的导出,也可以使用Unity内置的方式,即导出为*.UnityPackage格式。 三:第三方模型编辑“第三方模型编辑”是PB中一个很抢眼的功能。对于从3DMax 开发出来的第三方模型,PB可以通过“ProBuilderize”做二次编辑。 四:UnityManual API对于需要深入研究PB的小伙伴来说,笔者写的内容再多也许也是不够的。所以更多的内容,感兴趣朋友可以自己去Unity官方的 “UnityManual API”网站上查询更多更详细的内容。具体操作是,首先点击unity菜单的”Help”—>”Unity Manual” 在打开的网页中,可以通过输入关键词查询自己需要的更多内容,详细见下图。 今天关于ProBuilder的功能就介绍到这,下一篇笔者讲解ProBuilder的最后一部分,讲解什么呢?先卖个关子,敬请期待! 大家有什么学习上的问题,可以留言,欢迎一起讨论,共同进步!

优秀的个人博客,低调大师

kafka快速实战与原理了解(1)

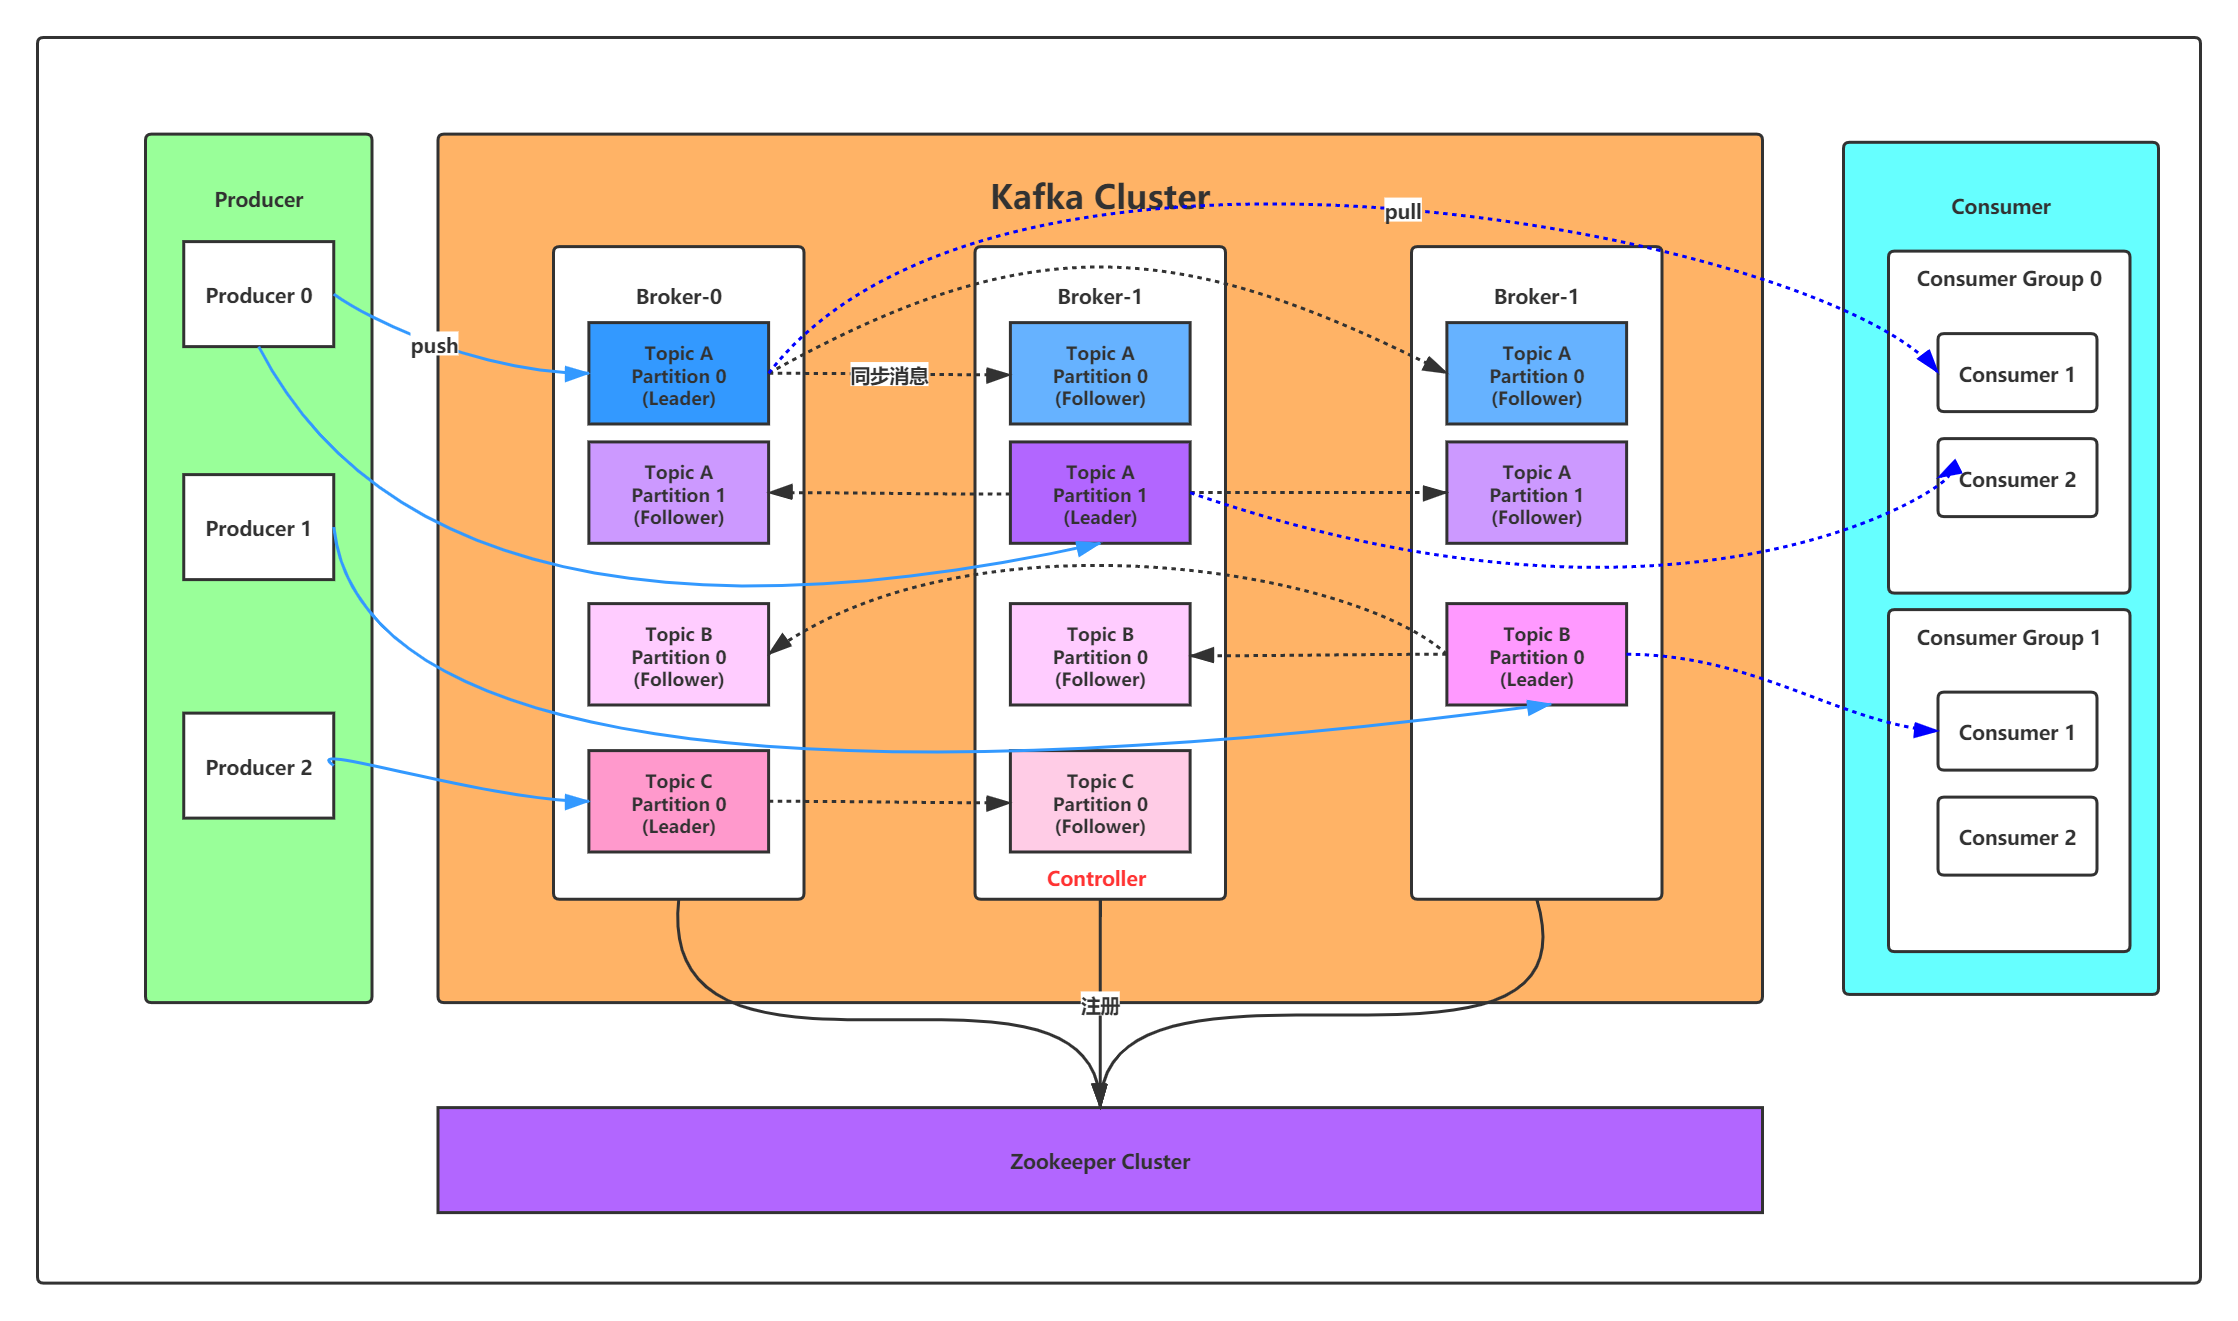
基本介绍 最初由Linkedin公司开发,2010捐给Apache 特性:分布式、分区、多副本 基于zk协调的分布式消息系统 可实时处理大数据量消息 应用场景:基于hadoop的批处理、Spark流失处理、web服务器日志、系统访问日志等 scala语言开发 业务应用场景 日志手机 消息系统 用户行为跟踪 运营指标监控 基本概念 Broker:消息处理节点,可理解为就是一个kafka节点 Topic:对消息进行归类 Producer/Consumer:生产者与消费者 ConsumerGroup:消费组,一条消息可被多个不同消费组消费,同一消费组内,只有一个消费者能消费某条消息 Partition:分区,物理概念,一个Topic可分为多个分区,每个分区内的消息是有序的;个人理解与RocketMQ中的Queue概念相似 基本使用 环境准备:kafka为Scala语言开发,需运行在jvm上,所以需准备JDK环境 kafka依赖zk做协调器,需安装zk 下载kafka,主要修改config/server.properties 关键属性: #broker.id属性在kafka集群中必须要是唯一 broker.id=0 #kafka部署的机器ip和提供服务的端口号 listeners=PLAINTEXT://192.168.65.60:9092 #kafka的消息存储文件 log.dir=/usr/local/data/kafka-logs #kafka连接zookeeper的地址,ZK集群以逗号隔开 zookeeper.connect=192.168.65.60:2181 启动脚本语法:kafka-server-start.sh [-daemon] server.properties 启动后可进入zk查看zk下的节点数据 停止:bin/kafka-server-stop.sh 创建主题 主题默认:分区数为1,副本数为1,最小写成功数为1 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 1 --topic test 主题在生产者发布消息时若不存在,则会自动创建 发送消息 自带bin/kafka-console-producer.sh命令客户端 bin/kafka-console-producer.sh --broker-list 192.168.65.60:9092 --topic test >this is a msg >this is a another msg 消费消息 自带消费消息命令终端:bin/kafka-console-consumer.sh bin/kafka-console-consumer.sh --bootstrap-server 192.168.65.60:9092 --topic test 带参数--from-beginning,表示可消费之前全部消息 带参数--whitelist "test|test-2" 同时消费多个主题 单播与多播 单播:一条消息只让一个消费者消费,类似Queue模式;我们让所有消费者在同一个消费者内即可实现; 多播:一条消息可让多个消费者同时都消费,类似发布订阅模式;我们让每个消费者存在不同消费组即可实现; 其他命令 // 查看消费组组名 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --list // 查看消费组消费偏移量 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --describe --group testGroup current-offset:当前消费组的已消费偏移量 log-end-offset:主题对应分区消息的结束偏移量(HW) lag:当前消费组未消费的消息数 Topic与Log Topic即为一个消息类别名称,同类消息一般发到同一Topic下 每个Topic下对应有多个分区日志文件 分区是一个有序的消息队列,消息被按序添加到commit log文件中 每个消息在一个分区中有唯一的标识,称为offset 不同分区中的消息,其offset可能相同 消息一般不会自动删除,默认被保留约最近7天 消费者基于自己在提交日志中消费的进度(offset)进行工作 offset由消费者自己维护 所以消费者可按序逐条消费commit log消息,也可指定offset来重复或跳过消费某些消息 // 创建2个分区的主题 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 2 --topic test1 查看下topic的情况 bin/kafka-topics.sh --describe --zookeeper 192.168.65.60:2181 --topic test1 leader节点:负责给定分区的所有读写请求 replicas节点:某分区存在的备份,不管是不是leader,甚至中途挂了都会列出 isr:是replicas的子集,只列存活且一同步备份了该分区的节点 消息日志主要存在分区文件夹以log结尾的文件 目前支持对topic分区数据量进行动态扩容,单不支持缩减 思考:为什么需要分区? 日志文件受到机器文件大小限制,分区后则可将不同分区放到集群中的不同机器上,相当于分布式存储;其次为了提高生产消息与消费消息的并行度;

优秀的个人博客,低调大师

小诺快速开发平台文档细化重构

转眼做开源已经过去三个月之久,通过每天跟跟其他小伙伴们的接触,也发现小诺框架有很多需要补充及修改的内容,同时也收到部分小伙伴的打赏金,这也使得我们小诺更有信心的持续发展下去的一部分。当初做开源的唯一目的也是为了全国各地广交朋友,并且做好一款自己使用,别的小伙伴及企业使用的脚手架轮子。 在此期间,我们也大量的接受使用者私聊问题处理,并且远程解决了很多由于操作引起的环境及调试问题,坚持做好脚手架的同时,服务为重才是小诺的核心,在精力能及的范围内让更多的初学者得到更好更有效的技术支持,也正好是我们小诺的初衷! 2020年3月1日我们发布了v1.3版本,在这个阶段代码生成也是作为一款脚手架不可缺少的功能,已实现每个字段的作用域配置,低代码化,在第三阶段完成主外键关联等相关生成模式。 同时,文档方面也使用了新的主题素材由 reco_luan作者提供的vuepress-theme-reco主题进一步打造了新的更细化的文档平台提供给各位开发者阅读理解小诺 此版本我们加入了基础篇文档,由于长时间发现部分初学者小伙伴对基础支撑有点不太理解,我们加入了最基础的jdk安装教程、maven安装教程、nodejs安装教程、idea导入小诺项目、lombok插件安装教程,相信此次更新的基础篇能帮助更多的初学者小伙伴运行使用小诺。

优秀的个人博客,低调大师

SkyWalking链路监控(一):SkyWalking快速搭建

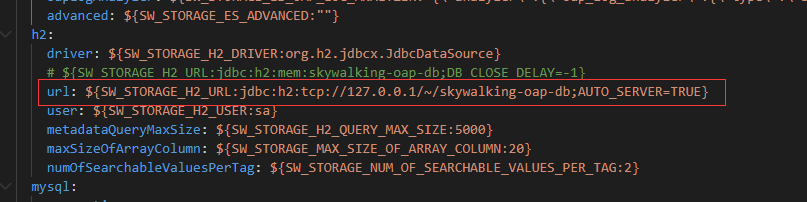
简介 当分布式系统服务比较多,特别是微服务,出现故障就很难排查。所以需要借助APM 系统进行排查(Application Performance Management,即应用性能管理),SkyWalking是APM 系统的一种,类似的产品还有CAT、Zipkin、Pinpoint。 SkyWalking和Pinpoint相比其他系统,做到了无侵入性。Pinpoint出现的时间长,文档也较为丰富,为多数公司使用。 国人开源的APM产品SkyWalking,探针采集数据粒度相较于 Pinpoint 来说略粗,但性能表现优秀。于2019年进入到Apache 基金会的孵化器毕业成为顶级项目;实属后起之秀,本文推荐使用SkyWalking。 搭建SkyWalking 下载SkyWalking 从官网下载SkyWalking APM,选择对应的版本。 下载之后解压即可。 配置数据库 Skywalking支持h2、mysql、ElasticSearch作为数据存储,官方推荐使用ElasticSearch。 根据具体业务,这里使用最方便的h2数据库做数据存储。h2是Skywalking自带的,为一种内存数据库。内存数据会因为服务故障、重启而丢失,并不适合长时间监控的场景,所以需要将其更改为文件数据库。 打开apache-skywalking-apm-es7-8.4.0\apache-skywalking-apm-bin-es7\config\application.yml文件,修改h2节点的url地址。 url: ${SW_STORAGE_H2_URL:jdbc:h2:tcp://127.0.0.1/~/skywalking-oap-db;AUTO_SERVER=TRUE} 启动 h2 TCP h2文件数据库需要启动 h2 TCP,否则Skywalking会因为监听不到9092端口而启动失败。 linux启动 h2 TCP 的方式: 新建启动脚本,运行即可,启动后就会在用户目录下(如administrator或root或home/user等用户目录)自动创建数据库文件skywalking-oap-db。 linux脚本如下 #!/usr/bin/env sh PRG="$0" PRGDIR=`dirname "$PRG"` [ -z "$OAP_HOME" ] && OAP_HOME=`cd "$PRGDIR/.." >/dev/null; pwd` OAP_LOG_DIR="${OAP_HOME}/logs" JAVA_OPTS=" -Xms64M -Xmx256M" if [ ! -d "${OAP_HOME}/logs" ]; then mkdir -p "${OAP_LOG_DIR}" fi _RUNJAVA=${JAVA_HOME}/bin/java [ -z "$JAVA_HOME" ] && _RUNJAVA=java CLASSPATH="$OAP_HOME/config:$CLASSPATH" for i in "$OAP_HOME"/oap-libs/h2*.jar do CLASSPATH="$i:$CLASSPATH" done OAP_OPTIONS=" -Doap.logDir=${OAP_LOG_DIR}" # 如果需要远程连接h2数据库,需将-tcp改为-tcpAllowOthers eval exec "\\"$_RUNJAVA\\" ${JAVA_OPTS} ${OAP_OPTIONS} -classpath $CLASSPATH org.h2.tools.Server -tcp \\ 2>${OAP_LOG_DIR}/h2Tcp.log 1> /dev/null &" if [ $? -eq 0 ]; then sleep 1 echo "SkyWalking h2Tcp started successfully!" else echo "SkyWalking h2Tcp started failure!" exit 1 fi windows启动 h2 TCP 的方式: 新建启动脚本,运行即可。windows脚本如下 @REM 如果需要远程查看h2数据库(tcp端口9092,页面访问端口8082),需将-tcp改为-tcpAllowOthers @echo off setlocal set OAP_PROCESS_TITLE=Skywalking-H2TcpServer set OAP_HOME=%~dp0%.. set OAP_OPTS="-Xms64M -Xmx256M -Doap.logDir=%OAP_HOME%\\logs" set CLASSPATH=%OAP_HOME%\\config;.; set CLASSPATH=%OAP_HOME%\\oap-libs\\*;%CLASSPATH% if defined JAVA_HOME ( set _EXECJAVA="%JAVA_HOME%\\bin\\java" ) if not defined JAVA_HOME ( echo "JAVA_HOME not set." set _EXECJAVA=java ) start "%OAP_PROCESS_TITLE%" %_EXECJAVA% "%OAP_OPTS%" -cp "%CLASSPATH%" org.h2.tools.Server -tcp endlocal 设置Java Agent Java Agent为Java探针,是java命令的一个参数。虚拟机启动的时候,在执行main方法前,会先找到javaagent 命令指定 jar 包,执行premain-class中的preman()方法。 设置方式如下: 复制apache-skywalking-apm-es7-8.4.0\apache-skywalking-apm-bin-es7\agent文件到监控目标服务器上,然后在启动命令中添加参数: windows参数如下: set SW_AGENT_NAME=eda-app-base-service set SW_AGENT_COLLECTOR_BACKEND_SERVICES=192.168.0.24:11800 set JAVA_TOOL_OPTIONS=-javaagent:E:\\tech\\agent\\skywalking-agent.jar SW_AGENT_NAME:设置服务名称 SW_AGENT_COLLECTOR_BACKEND_SERVICES:后端的 collector 端口及地址,设置为SkyWalking服务器IP:11800(默认端口) JAVA_TOOL_OPTIONS:agent文件夹下skywalking-agent.jar位置 Linux参数如下: # SkyWalking Agent 配置 export SW_AGENT_NAME=demo-application # 配置 Agent 名字。一般来说,我们直接使用 Spring Boot 项目的 `spring.application.name` 。 export SW_AGENT_COLLECTOR_BACKEND_SERVICES=127.0.0.1:11800 # 配置 Collector 地址。 export SW_AGENT_SPAN_LIMIT=2000 # 配置链路的最大 Span 数量。一般情况下,不需要配置,默认为 300 。主要考虑,有些新上 SkyWalking Agent 的项目,代码可能比较糟糕。 export JAVA_AGENT=-javaagent:/Users/yunai/skywalking/apache-skywalking-apm-bin-es7/agent/skywalking-agent.jar # SkyWalking Agent jar 地址。 # Jar 启动 java -jar $JAVA_AGENT -jar lab-39-demo-2.2.2.RELEASE.jar 具体变量可能因版本有所变化(本文版本为8.4.0),更多变量可在agent\config\agent.config查看。 启动运行 首先启动 h2 TCP 启动apache-skywalking-apm-es7-8.4.0\apache-skywalking-apm-bin-es7\bin\startup.bat,它会同时启动Skywalking-Webapp、Skywalking-Collector两个服务。 启动业务服务 访问http://127.0.0.1:8080,即可看到SkyWalking界面 如果8080端口被占用,可以通过apache-skywalking-apm-es7-8.4.0\apache-skywalking-apm-bin-es7\webapp\webapp.yml文件修改端口。 文章内容参考: Skywalking的存储配置与调优:https://blog.csdn.net/smooth00/article/details/96479544

优秀的个人博客,低调大师

MySQL中怎样快速找出超长索引

大家好,我是知数堂SQL 优化班老师 网名:骑龟的兔子 需求: 想要查找哪些索引太长了,这个SQL在5.7下跑的特别慢,8.0则挺快的,帮看下有啥优化方案没 具体SQL 和执行计划如下: SELECT c.TABLE_SCHEMA AS DB, c .TABLE_NAME AS TBL, c.COLUMN_NAME AS COL, c.CHARACTER_OCTET_LENGTH AS COL_LEN_BYTES, s.INDEX_NAME, s.SUB_PART * CHARACTER_OCTET_LENGTH/CHARACTER_MAXIMUM_LENGTH AS SUB_PART_LENFROM information_schema.COLUMNS c INNER JOIN information_schema.STATISTICS s USING(TABLE_SCHEMA, TABLE_NAME, COLUMN_NAME)INNER JOIN information_schema.TABLES t USING(TABLE_SCHEMA, TABLE_NAME) WHERE c.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test')AND c.DATA_TYPE IN ("varchar", "char", "text", "blob") AND ((CHARACTER_OCTET_LENGTH > 50 and SUB_PART is null) orSUB_PART * CHARACTER_OCTET_LENGTH/CHARACTER_MAXIMUM_LENGTH > 50)AND t.TABLE_ROWS > 10000ORDER BY COL_LEN_BYTES DESC;执行计划*************************** 1. row *************************** id: 1 select_type: SIMPLE table: c partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases; Using temporary; Using filesort*************************** 2. row *************************** id: 1 select_type: SIMPLE table: s partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases; Using join buffer (Block Nested Loop)*************************** 3. row *************************** id: 1 select_type: SIMPLE table: t partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_full_table; Scanned all databases; Using join buffer (Block Nested Loop)3 rows in set, 1 warning (0.01 sec)select count(*) from information_schema.tables;+----------+| count(*) |+----------+| 33600 |+----------+select count(*) from information_schema.COLUMNS;+----------+| count(*) |+----------+| 342967 |+----------+select count(*) from information_schema.STATISTICS;+----------+| count(*) |+----------+| 135167 |+----------+ 上面的SQL 运行450+ s 也运行不出来,最后kill掉了。 我们初步分析一下,从执行计划中 可以看出三个表都是ALL所以很慢 那添加索引不就行了吗,因为是系统表,所以不能随便添加! 那该怎么办?想到了AUTOKEY 就是临时索引,那思路就是改写SQL 达到生成临时索引,最终达到优化效果 改写的SQL 如下 SELECT c.TABLE_SCHEMA AS DB, c.TABLE_NAME AS TBL, c.COLUMN_NAME AS COL, c.CHARACTER_OCTET_LENGTH AS COL_LEN_BYTES, s.INDEX_NAME,s.SUB_PART * c.CHARACTER_OCTET_LENGTH/c.CHARACTER_MAXIMUM_LENGTH AS SUB_PART_LENFROM ( select c.TABLE_SCHEMA, c.TABLE_NAME, c.COLUMN_NAME ,c.CHARACTER_OCTET_LENGTH ,c.CHARACTER_MAXIMUM_LENGTH , c.DATA_TYPEfrom information_schema.COLUMNS c WHERE c.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND c.DATA_TYPE IN ("varchar", "char", "text", "blob") limit 10000000000) c INNER JOIN (select s.TABLE_SCHEMA, s.TABLE_NAME, s.COLUMN_NAME ,s.SUB_PART,s.INDEX_NAMEfrom information_schema.STATISTICS s WHERE s.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test')limit 10000000000 )s USING(TABLE_SCHEMA, TABLE_NAME, COLUMN_NAME)INNER JOIN information_schema.TABLES t USING(TABLE_SCHEMA, TABLE_NAME) WHERE c.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND c.DATA_TYPE IN ("varchar", "char", "text", "blob") AND ((c.CHARACTER_OCTET_LENGTH > 50 and s.SUB_PART is null) ors.SUB_PART * c.CHARACTER_OCTET_LENGTH/c.CHARACTER_MAXIMUM_LENGTH > 50)AND t.TABLE_ROWS > 10000ORDER BY COL_LEN_BYTES DESC;*************************** 1. row *************************** id: 1 select_type: PRIMARY table: t partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_full_table; Scanned all databases; Using temporary; Using filesort*************************** 2. row *************************** id: 1 select_type: PRIMARY table: <derived2> partitions: NULL type: refpossible_keys: <auto_key0> key: <auto_key0> key_len: 388 ref: information_schema.t.TABLE_SCHEMA,information_schema.t.TABLE_NAME rows: 2 filtered: 50.00 Extra: Using where*************************** 3. row *************************** id: 1 select_type: PRIMARY table: <derived3> partitions: NULL type: refpossible_keys: <auto_key0> key: <auto_key0> key_len: 582 ref: information_schema.t.TABLE_SCHEMA,information_schema.t.TABLE_NAME,c.COLUMN_NAME rows: 2 filtered: 100.00 Extra: Using where*************************** 4. row *************************** id: 3 select_type: DERIVED table: s partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases*************************** 5. row *************************** id: 2 select_type: DERIVED table: c partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases5 rows in set, 1 warning (0.01 sec) 结果来了 2463 rows in set, 417 warnings (23.39 sec) 但是经过几次运行之后 有时候是40多秒有时候甚至达到了166s 非常不稳定! 那分析下上面这个SQL的问题在哪里? 问题就是生成的AUTO KEY的量相对来说非常大!因为没有进行任何过滤 那现在的思路就是对生成的AUTOKEY的量 进行减少 我们通过相对小的表TABLES表生成autokey 之后STATISTICS ,COLUMNS 表分别跟 TABLES 表进行JOIN 然后减少数据量 达到减少生成AUOKEY 的量 减少 达到优化目的 ,具体的方法如下 select count(1) from (select s.TABLE_SCHEMA, s.TABLE_NAME, s.COLUMN_NAME ,s.SUB_PART,s.INDEX_NAMEfrom information_schema.STATISTICS s WHERE s.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') )s straight_join (select t.TABLE_SCHEMA, t.TABLE_NAMEfrom information_schema.TABLES t WHERE t.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND t.TABLE_ROWS > 10000limit 10000000000) t on s.TABLE_SCHEMA=t.TABLE_SCHEMA and s.TABLE_NAME =t.TABLE_NAME*************************** 1. row *************************** id: 1 select_type: PRIMARY table: s partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases*************************** 2. row *************************** id: 1 select_type: PRIMARY table: <derived3> partitions: NULL type: refpossible_keys: <auto_key0> key: <auto_key0> key_len: 388 ref: information_schema.s.TABLE_SCHEMA,information_schema.s.TABLE_NAME rows: 2 filtered: 100.00 Extra: Using index*************************** 3. row *************************** id: 3 select_type: DERIVED table: t partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_full_table; Scanned all databases3 rows in set, 1 warning (0.00 sec)+----------+| count(1) |+----------+| 7478 |+----------+1 row in set, 40 warnings (7.52 sec)select count(1) from ( select c.TABLE_SCHEMA, c.TABLE_NAME, c.COLUMN_NAME ,c.CHARACTER_OCTET_LENGTH ,c.CHARACTER_MAXIMUM_LENGTH , c.DATA_TYPEfrom information_schema.COLUMNS c WHERE c.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND c.DATA_TYPE IN ("varchar", "char", "text", "blob") ) c straight_join (select t.TABLE_SCHEMA, t.TABLE_NAMEfrom information_schema.TABLES t WHERE t.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND t.TABLE_ROWS > 10000limit 10000000000) t on c.TABLE_SCHEMA=t.TABLE_SCHEMA and c.TABLE_NAME =t.TABLE_NAME*************************** 1. row *************************** id: 1 select_type: PRIMARY table: c partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases*************************** 2. row *************************** id: 1 select_type: PRIMARY table: <derived3> partitions: NULL type: refpossible_keys: <auto_key0> key: <auto_key0> key_len: 388 ref: information_schema.c.TABLE_SCHEMA,information_schema.c.TABLE_NAME rows: 2 filtered: 100.00 Extra: Using index*************************** 3. row *************************** id: 3 select_type: DERIVED table: t partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_full_table; Scanned all databases3 rows in set, 1 warning (0.00 sec)+----------+| count(1) |+----------+| 8106 |+----------+1 row in set, 417 warnings (8.62 sec) 最终SQL 如下 SELECT c.TABLE_SCHEMA AS DB, c.TABLE_NAME AS TBL, c.COLUMN_NAME AS COL, c.CHARACTER_OCTET_LENGTH AS COL_LEN_BYTES, s.INDEX_NAME,s.SUB_PART * c.CHARACTER_OCTET_LENGTH/c.CHARACTER_MAXIMUM_LENGTH AS SUB_PART_LENfrom ( select c.TABLE_SCHEMA, c.TABLE_NAME, c.COLUMN_NAME ,c.CHARACTER_OCTET_LENGTH ,c.CHARACTER_MAXIMUM_LENGTH , c.DATA_TYPEfrom information_schema.COLUMNS c WHERE c.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND c.DATA_TYPE IN ("varchar", "char", "text", "blob") ) c straight_join (select t.TABLE_SCHEMA, t.TABLE_NAMEfrom information_schema.TABLES t WHERE t.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND t.TABLE_ROWS > 10000limit 10000000000) t on c.TABLE_SCHEMA=t.TABLE_SCHEMA and c.TABLE_NAME =t.TABLE_NAMEstraight_join(select s.* from (select s.TABLE_SCHEMA, s.TABLE_NAME, s.COLUMN_NAME ,s.SUB_PART,s.INDEX_NAMEfrom information_schema.STATISTICS s WHERE s.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') )s straight_join (select t.TABLE_SCHEMA, t.TABLE_NAMEfrom information_schema.TABLES t WHERE t.TABLE_SCHEMA not in ('information_schema','performance_schema','mysql','sys', 'test') AND t.TABLE_ROWS > 10000limit 10000000000) t on s.TABLE_SCHEMA=t.TABLE_SCHEMA and s.TABLE_NAME =t.TABLE_NAMElimit 10000000000) s on c.TABLE_SCHEMA=s.TABLE_SCHEMA and c.TABLE_NAME=s.TABLE_NAME and c.COLUMN_NAME =s.COLUMN_NAMEwhere ((c.CHARACTER_OCTET_LENGTH > 50 and s.SUB_PART is null) ors.SUB_PART * c.CHARACTER_OCTET_LENGTH/c.CHARACTER_MAXIMUM_LENGTH > 50)*************************** 1. row *************************** id: 1 select_type: PRIMARY table: c partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases*************************** 2. row *************************** id: 1 select_type: PRIMARY table: <derived3> partitions: NULL type: refpossible_keys: <auto_key0> key: <auto_key0> key_len: 388 ref: information_schema.c.TABLE_SCHEMA,information_schema.c.TABLE_NAME rows: 2 filtered: 100.00 Extra: Using index*************************** 3. row *************************** id: 1 select_type: PRIMARY table: <derived4> partitions: NULL type: refpossible_keys: <auto_key0> key: <auto_key0> key_len: 582 ref: information_schema.c.TABLE_SCHEMA,information_schema.c.TABLE_NAME,information_schema.c.COLUMN_NAME rows: 2 filtered: 100.00 Extra: Using where*************************** 4. row *************************** id: 4 select_type: DERIVED table: s partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_frm_only; Scanned all databases*************************** 5. row *************************** id: 4 select_type: DERIVED table: <derived6> partitions: NULL type: refpossible_keys: <auto_key0> key: <auto_key0> key_len: 388 ref: information_schema.s.TABLE_SCHEMA,information_schema.s.TABLE_NAME rows: 2 filtered: 100.00 Extra: Using index*************************** 6. row *************************** id: 6 select_type: DERIVED table: t partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_full_table; Scanned all databases*************************** 7. row *************************** id: 3 select_type: DERIVED table: t partitions: NULL type: ALLpossible_keys: NULL key: NULL key_len: NULL ref: NULL rows: NULL filtered: NULL Extra: Using where; Open_full_table; Scanned all databases7 rows in set, 1 warning (0.00 sec) 看起来稳定了,跑了几次,都没超过15秒 我的新一轮的SQL 优化课 即将在春节后开课 我是知数堂SQL 优化班老师~ ^^ 如有关于SQL优化方面疑问和一起交流的请加 并且 @兔子@知数堂SQL优化 高性能MySQL,SQL优化群 有叶金荣,吴炳锡 两位大神坐镇 :579036588 欢迎加入 知数堂大家庭。 我的微信公众号:SQL开发与优化(sqlturning) 扫码直达宝藏课程 本文分享自微信公众号 - 老叶茶馆(iMySQL_WX)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

5G推动智慧医疗快速发展

近日,国家工信部和卫健委办公厅联合组织开展“5G+医疗健康”应用试点项目申报工作,围绕急诊救治、远程诊断、远程治疗、远程重症监护(ICU)、中医诊疗、医院管理、智能疾控、健康管理等8个重点方向,鼓励各地、各单位创新5G应用场景,加速卫生健康网络基础设施改造,推动5G+智慧医疗创新发展,引发高度关注。 近年来,我国医疗领域问题不断凸显,一方面医疗人力和设备资源有限且区域分布不均衡,不少人面临着“看病难、看病贵、看病慢”等困扰;另一方面,现有医疗技术水平、效率和服务也不高,医院运营成本压力较大。在此背景下,为满足行业发展需求,智慧医疗成为破局的关键所在,而5G的出现则为智慧医疗带来了催化作用。 凭借高速率、低延迟、大容量的显著特点,5G网络能够深入到医疗诊治和医院管理的各个环节,提升医疗水平,增强医院管理,同时与人工智能、VR/AR、机器人等智能技术和装备相结合,协作医生与管理人员,减轻治疗和作业压力。除此以外,5G还能通过医疗服务的信息化、移动化和远程化,加速医疗资源的共享与下沉。 总而言之,5G的出现与应用能催化智慧医疗的进一步发展。目前,根据工信部最新数据透露,我国5G基站建设已经突破60万座,提前完成全年建设目标。同时5G网络覆盖也已取得不错成果,5G用户累计突破1亿人次,国内5G商用进程已是初具成效。在此背景下,未来伴随试点应用的不断开展,5G与医疗融合将真正成熟。 不过,在此之前,我国也还需要克服三方面的困难:其一是加快5G基站建设,完善5G专用网络覆盖,降低5G应用成本与价格;其二是加速5G技术研究,提升5G技术应用的安全性和可靠性;其三是强化行业标准与监管,为行业应用营造健康、有序环境。只有解决了网络、技术和标准三方面难题,发展才能最终取得理想结果。

优秀的个人博客,低调大师

XiaoNuo 快速开发平台代码生成发布啦

小诺团队做开源已经将近一个月,在平时忙碌的工作之余跟晚上的时间,也在抓紧时间做开发。 在此时间段当然我们的其他产品也不能停下来,就好比:xiaonuo-layui版本的工作流大模块、xiaonuo-cloud版本,相信很快跟小伙伴们见面。 为了加快cloud版本日程,小诺团队成员也由2人增加到3人!同时也欢迎其他有想法的小伙伴加入到我们的开源中一起做贡献,可以在官网获取联系方式与我们沟通! 此次一共发布了xiaonuo-vue版本与xiaonuo-layui版本的代码生成器,完全独立的模块,可拓展,可二次开发,为普通模块开发省去了大部分拷贝粘贴的时间。 可生成所有查询框、查询条件根据不同的需求进行删减,下个版本会在此基础上面增加详细到每个字段在各个代码模块下的配置 感兴趣的小伙伴可以关注下我们,全系版本都免费,我们的官网是:https://xiaonuo.vip

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册