首页 文章 精选 留言 我的

精选列表

搜索[审批流],共10000篇文章
优秀的个人博客,低调大师

C++的重载流输出运算符

// 下列代码输出什么? #include <iostream> #include <string> // typedef basic_ostream<char> ostream; class A { private: int m1,m2; public: A(int a, int b) { m1=a;m2=b; } operator std::string() const { return "str"; } operator int() const { return 2018; } }; int main() { A a(1,2); std::cout << a; return 0; }; 答案是2018, 因为类basic_ostream有成员函数operator<<(int), 而没有成员函数operator<<(const std::string&), 优先调用同名的成员函数,故输出2018,相关源代码如下: // 名字空间std中的全局函数 /usr/include/c++/4.8.2/bits/basic_string.h: template<typename _CharT, typename _Traits, typename _Alloc> inline basic_ostream<_CharT, _Traits>& operator <<(basic_ostream<_CharT, _Traits>& __os, const basic_string<_CharT, _Traits, _Alloc>& __str) { return __ostream_insert(__os, __str.data(), __str.size()); } // 类basic_ostream的成员函数 // std::cout为名字空间std中的类basic_ostream的一个实例 ostream: __ostream_type& basic_ostream::operator<<(int __n); // 下列代码有什么问题,如何修改? #include <iostream> #include <string> class A { public: int m1,m2; public: A(int a, int b) { m1=a;m2=b; } std::ostream& operator <<(std::ostream& os) { os << m1 << m2; return os; } }; int main() { A a(1,2); std::cout << a; return 0; }; 类basic_ostream没有成员函数“operator <<(const A&)”, 也不存在全局的: operator <<(const basic_ostream&, const A&) 而只有左操作数是自己时才会调用成员重载操作符, 都不符合,所以语法错误。 有两种修改方式: 1) 将“std::cout << a”改成“a.operator <<(std::cout)”, 2) 或定义全局的: std::ostream& operator<<(std::ostream& os, const A& a) { os << a.m1 << a.m2; return os; }

优秀的个人博客,低调大师

加速Splunk:NetApp SANtricity为你简化分析流

NetApp表示,最新版本的E系列全闪存阵列和磁盘阵列以及SANtricity操作软件,将会让Splunk这样的数据分析应用速度更快。 Hadoop和NoSQL数据库应用可以得到加速,尤其是在某些情况下会特别明显,采用新版本也是如此。另外,E系列磁盘阵列和EF系列全闪存阵列都配备了SANtricity操作系统,提供了简化的阵列数据访问性能,而没有额外的Data ONTAP数据服务开销。 NetApp公司产品、解决方案和服务市场副总裁Lee Caswell在他的声明中强调E系列优于基于白盒服务器的产品:"我们的SANtricity软件在磁盘阵列上使用的时候可以做高带宽的分析,在全闪存阵列上会表现出低延迟响应。通过将这种表现与企业可靠性、无与伦比的密度相结合,使得在针对实时分析应用的时候,E系列和EF系列阵列让企业存储在经济上甚至优于白盒服务器。" 新的操作系统版本提供了: 与配备内置磁盘的商用服务器相比,Splunk搜索性能最高可增加69% 在使用Dynamic Disk Pools进行数据重建的时候,相比采用RAID 5的商用服务器,Hadoop性能最高增加500% 针对NoSQL数据库,400GB SSD可以在近15分钟内重建,而采用商用服务器和直连存储的情况下需要将近10个小时 静态数据对性能的影响不到1%在,而采用内置磁盘驱动器的商用服务器影响近70% Dynamic Disk Pools (DDP)可以自动地增加或者减少,不需要管理空闲备用驱动器。这个磁盘池会进行动态均衡,可以同时添加或者删除12个驱动器,不需要(RAID)奇偶校验重新计算。 在0、1、3、5、6和10之间的RAID级动态前一,改变了现有驱动器上卷组的RAID层级,不需要把重新定位数据。DVE(Dynamic Volume Expansion)让你可以通过使用卷组或者DDP内的空闲容量来扩展现有卷的容量。还有一个SANtricity Performance App for Splunk Enterprise软件。 NetApp表示,SANtricity可以用于在单一架构内创建热数据、温数据、冷数据以及冻数据层。 NetApp已经跳脱出了Nimble Storage支持,称NetApp AutoSupport的预测技术速度问题解决之后提高了60%,P1情况发生几率减少85%。并将通过Arrow Electronics提供预配置的、经过验证的E系列捆绑套件,专门针对Splunk部署,采用集成的参考架构,可以想像一下,有点类似于FlexPod那样的E系列产品。原文发布时间为:2016年03月31日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

使用Docker做开发的建议团队工作流

意义 自从Docker进入到我们的工作流程之后给环境配置框架搭建,持续集成,持续交付方面带来了很多好处,首先相对于虚拟机来说,最直接的好处是带来了更小的镜像,同时程序以容器的方式运行不但启动速度快而且性能也好过虚拟机,同时它的配置可以非常快速的调整。其次对于开发来说,我们整个团队都使用的是Sublime+git的方式进行开发,使用Docker之后无论是什么平台只要有Shell都可以很方便的统一测试&开发环境。 Docker特性的使用 磁盘挂载(-v) 一直以来我们在使用Docker过程中都遵循着一个道理Docker只是一个环境他只是运行程序的一种手段。我们不能在docker中持久化数据,无论是文件还是数据库都是不允许的,因为很有可能测试结束之后会丢失数据。用于开发的Docker Image我们需要针对数据持久化新开方便调试使用的数据库,我们需要挂载针对应用的数据库持久化文件夹,当然我们还需要针对脚本进行目录挂载,如果是golang的话运行之前可能要自动化构建golang程序。 端口映射 虽然docker给我们提供了link的方法来实现容器之间的链接,但是我们依赖还是使用了最传统的端口映射的方式来进行服务的对外发布。因为我们觉得关系越简单,整个平台的服务就越稳定,虽然链接的这种方式并没有什么不好之处。 工作流程 定制容器准备开发&&运行环境 从Dockerfile开始部署环境,有两个方向上的选择,一种是自己定制操作系统,另外一种是依赖其他人做好的。 先说第一种方法:在我之前的blog中已经有提到,可以大概参考一下。 这种方法缺点主要在于,需要非常了解Linux或者至少做过LFS才能方便自己定制操作系统,要对业务底层依赖有一定了解。因为此方法需要精简image所以需要手动解决依赖问题。对于依赖比较多的情况不适用。 第二种方法,在之前的blog中也有提到过,有详细的过程以及Dockerfile参考。 这种方法构建的image大概100MB+虽然比虚拟机(按G来算)小了很多,但是在迁移分发Image的时候还是要注意(如果你没有自己的Docker Hub)。如果使用文件迁移请用save的方式来分发image,在上面链接的blog中有提到备份迁移的问题。 另外一个注意的地方,如果是用别人的image要注意安全,会不会里面挂了后门之类的,然后要摸清系统配置,准备好代码或可执行二进制文件的挂载位置,数据库持久化文件存放的位置等等都要摸清。最后在运行的时候都要给出挂载方案。 发布之后要做的事 因为Docker只是一个容器而不是项目中的一部分,所以只是项目实现的一种手段,具体应该如何使用它,需要一定的文档支撑,也就是开发业务流程文档。 文档中要详细的提出所有依赖的Service配置文件的位置,配置的状态,持久化目录位置,输出的端口,开发完成之后业务部署的位置这些关于项目的尽量能想到的信息,因为这套容器会跟着项目整个周期中作为基础设施的一部分在运行。 除了配置方面,第二部分是建议的使用方法流程,比如:要说清楚代码是在容器内部编译还是在其他容器中有做好的辅助工具编译,还是有一个独立的服务器(项目比较大的时候需要一个独立的构建服务器,甚至需要一个专门管理构建&&版本的同事),如果是脚本语言写的就不需要这么麻烦了。 项目发布 项目进行到一个阶段之后需要发布,把代码或可执行二进制文件直接构建到image里面就行了。注意先要判断项目是否要使用Docker。 好处总结 在文件持久化方面我们挂载的目录实现了统一,配置文件也实现了统一。 在PHP开发中再也不用担心目录大小写敏感,文件大小写敏感,目录长度限制等因为操作系统不统一的问题。 由于不同项目有不同的限制因素,因此在这里介绍总体的工作流程,项目中涉及到不同的应用服务只需要比较小的调整。 原文发布时间为:2015-06-09 本文来自云栖社区合作伙伴“Linux中国”

优秀的个人博客,低调大师

FPGA采集:高采样率数据流与存储

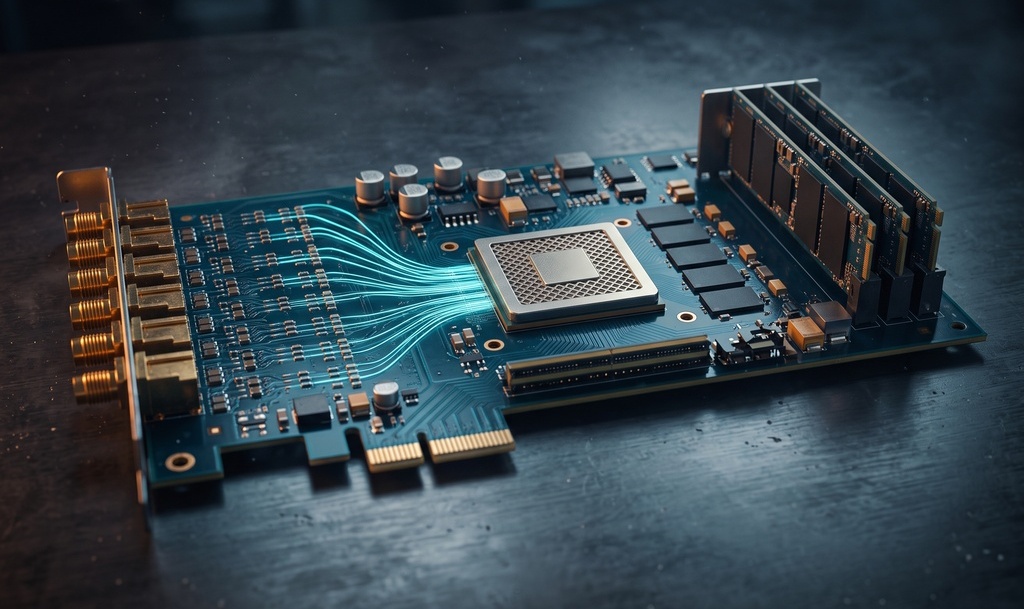
高采样率采集的瓶颈很少停在 ADC 分辨率上,而多半出在数据从采集通道到存储介质的"最后一公里":ADC 每个周期都在产出新样本,存储介质的带宽、延迟与耐久却是以毫秒乃至秒为尺度变化的量。两者之间必须插入一层吸收瞬时落差的缓冲,并把每一环的带宽算清楚。FPGA 的价值正在于此:片内并行完成滤波、抽取与打包,把速率压到后级能承受的水平,再以确定时序驱动 DDR 缓存与存储写入。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册