首页 文章 精选 留言 我的

精选列表

搜索[linux],共10000篇文章
优秀的个人博客,低调大师

使用last命令找出是谁重启了你的服务器(linux)

在运维过程中,经常出现推锅的情况,在我运维Azure的时候,有时会发生服务器重启,因为厂商没有把服务设置成开机自启的状态,在夜间重启后,到中午才发现服务有问题(MD,我想问问你们是干什么吃的),发现服务有问题,怀疑服务器重启啦,推锅活动开始了,厂商开发推锅运维,运维推锅监控,然后在推锅Azure,不过有多一半的问题是因为Azure虚机所在的物理节点故障导致虚机迁移(我不是在黑Azure,说实话易用性比不上国内的阿里云,但是如果你用的是全windwos架构,那你选择Azure是没错的,因为它可以和你本地的服务无缝迁移)说了这么多,就是一个服务器重启的事,还有一个就是就是因为服务崩了,导致服务不能正常工作,但是厂商就会推锅给运维,说是服务器重启了,没办法,你就要给他证明不是服务器的问题,现在的运维工作往往就是这样,所以我们可以使用last命令去查看重启记录还有登陆记录。 image.png 其中: 第一列:用户名 第二列:终端位置。(pts/0通过ssh或者telnet远程连接的用户,tty:直接连接到计算机或者本地用户) 第三列:登陆IP或者内核(看到0.0或者什么都没有,意味着用户通过本地终端连接,除了重启,内核版本会显示在状态中) 第四列:开始时间(如:sun apr 3 :四月三号星期天) 第五列:结束时间(still login in 还未退出,down:直到正常关机,crash:直到强制关机) 第六列:持续时间 命令参数: image.png

优秀的个人博客,低调大师

Linux运维课程 第一阶段 重难点摘要(四)CISCO

一、路由器接口操作: 1、#show running-config查看接口 2、#interface fastethernet 0/1进入f0/1配置(0/1,0代表插槽1代表端口、若是s0/0/0,第一个0表示路由器本身) 3、#interface fastEthernet 0/1 #description tachingroute接口描述 4、#do show running-config do可让命令在其它模式运行 5、#int f0/0 #no shutdown 激活接口,接口默认是关闭状态 6、#int f0/0 #ip add 192.168.1.10 255.255.255.0给端口配IP #do sh int f0/0 7、#show controllers s1/0确认此端是DCE端 #int s1/0 #clock rate 64000 #do sh contro s1/0 #bandwidth 1000 时钟频率,在生成环境下不用配置,一般由服务器运营商进行控制,时钟频率只对串口连接的路由器有效,串口用于老式的广域网连接的,主要用于E1网络(带宽2.048Mbps),现已被光纤取代。如使用串口连接两台路由器,仅在DCE端配置(数据通信设备),DTE不需配置(数据终端设备)。 8、#copy running-config startup-config保存配置 #erase startup-config删除配置 #reload 二、查看路由器验证配置 1、#ping IP地址探测IP是否畅通 2、traceroute域名或IP测试路由路径 3、telnet IP或域名端口远程管理或探测端口 4、#clear counters f0/0清除接口的计数器 5、#show ip interface查看接口IP信息 6、#show ip interface brief查看所有接口的IP信息及状态 7、#show protocols查看所有接口上的协议 三、高级IOS操作 1、路由器启动顺序 (1)路由器执行POST开机自检,检查硬件以验证设备的所有组件,POST存储在ROM中,并从中运行; (2)bottstrap查找并加载IOS,它位于ROM中,用于启动时加载IOS,加载IOS的顺序是闪存-TFTP服务器-ROM,默认从闪存中加载IOS; (3)IOS接管启动过程,并在NVRAM中查找启动配置文件(startup-config),破解密码的关键是忽略startup-config; (4)如果在NVRAM中找到startup-config,复制到RAM中,生成running-config,加载登录界面,如没找到startup-config,则向所有接口发送广播,查找TFTP,用于配置路由器,若没找到TFTP,则启动用户交互设置对话模式进行初始化配置。 注:NVRAM非易失性随机存储器,指断电后仍能保存数据,用于保存永久生效的配置文件。 2、破解密码 (1)console线连接路由器,开机60秒后按ctrl+break,中断启动过程,进入rom-moritor模式,此时提示符为rommon 1> (2)修改寄存器的值,>config 0x2142 (3)重启,>reset (4)#copy startup-config running-config #enable secret lamp (5)#config-register 0x2102 #copy run start 四、思科发现协议CDP(CISCO discovery protocol) 1、#show cdp #show cdp interface #cdp timer 60 #cdp holdtime 180获取定时器和保存时间信息 #cdp run激活CDP 2、#show cdp neighbors 收集邻居信息 #showcdp entry * #showcdp entry * protocol #showcdp entry * version 五、路由器备份、升级和恢复 1、#copy tftp: flash: #copy flash: tftp: 路由器的存储器主要有: ROM:一分IOS附本; RAM:IOS将随机访问存储器分成共享和主存,主要用来存储运行中的路由配置和与路由器协议有关的IOS数据结构; FLASH:存储IOS软件映像,闪存是可擦除内存,能用IOS的新版本覆写; NVRAM:存储系统的配置文件。 本文转自 chaijowin 51CTO博客,原文链接:http://blog.51cto.com/jowin/1634858,如需转载请自行联系原作者

优秀的个人博客,低调大师

掌握linux下vim与复制,删除,粘贴,块操作以及快速替换功能

掌握如下命令有什么好办法,我可以告诉你唯手熟尔!! 多看多练 对于VIM而言,复制,删除,粘贴的操作应该是非常多的。这次也做一个总结,关于处理VIM下的复制,删除,粘贴等操作。 学会使用帮助文件,命令的帮助入口,就是” :help 命令名“。例如,对于” j“命令,查看它的帮助,使用” :help j“ 先谈一下基于块的复制,删除,粘贴操作 使用块选的好处: 对于vim几乎提到的都是以行为单位的操作。那么如果我想要搞定的是一个区块范围呢(我特别喜欢像使用windows下的文本编辑器一样去使用块的选择 当我们按下 v 戒者 V 戒者 [Ctrl]+v 时, 这个时候光标移劢过癿地方就会开始反白。 区块选择的按键意义【不使用鼠标,来选择块】 v 字符选择,会将光标经过癿地方反白选择! V(大写) 行选择,会将光标经过癿行反白选择!(常用,配合上下左右键,进行区域选择,很爽!!!) [Ctrl]+v 区块选择,可以用长方形癿方式选择资料 y 将反白癿地方复制起来 d 将反白癿地方删除掉 批量替换列块 原始状态: 将光标指到第一行V处,然后ctrl-v选择,如下 选择完成后,接着按c键,输入你要替换后的文字,最后ESC,看看成果如下, 以行或者是以单词为单位的删除操作 对字符操作: x, X 在一行字当中,x 为向后删除一个字符 (相当亍 [del] 按键),X为向前删除一个字符(相当亍 [backspace] 亦即是退格键) (常用) nx n 为数字,连续向后删除 n 个字符。丼例来说,我要连续删除 10 个字符, 『10x』。 d$ 删除游标所在处,到该行行尾的所有字符 d0 删除游标所在处 ,到该行行首的所有字符 对行操作: dd 删除游标所在的那一整列(常用) ndd n 为数字。删除光标所在的行向下n行,例如 20dd 则是删除 20行 (常用) d1G 删除光标所在到第一行的所有数据 dG 删除光标所在到最后一行的所有数据 与移动相关 移动到行首:gg 移动到行尾 :字符$ 小注:命令”G“前可以加上数字,在这里,数字的含义并不是倍数,而是你打算跳转的行号。例如,你想跳转到文件的第1234行,只需输入”1234G“。 字符0:第一个非空字符前 字符^:第一个非空字符上 上下左右:h, j, k, l 小注:如同许多vim命令一样,可以在这些键前加一个数字,表示移动的倍数。例如,”10j“表示向下移动10行;”10l“表示向右移动10列。 翻页: 小注:通常使用CTRL-B和CTRL-F来进行翻页,它们的功能等同于PageUp和PageDown。CTRL-B和CTRL-F前也可以加上数字,来表示向上或向下翻多少页 小注: 在文件中移动,你可能会迷失自己的位置,这时使用”CTRL-G“命令,查看一下自己位置。这个命令会显示出光标的位置及其它信息。为了避免迷失,你可以打开行号显示;使用”:set number“命令后,会在每一行前显示出行号,可以更方便的定位的跳转(:help ‘number’) 移动到指定字符:使用f, t, F, T命令。 小注:“f“命令移动到光标右边的指定字符上,例如,”fx“,会把移动到光标右边的第一个’x'字符上。”F“命令则反方向查找,也就是移动到光标左边的指定字符上。 “t“命令和”f“命令的区别在于,它移动到光标右边的指定字符之前。例如,”tx“会移动到光标右边第一个’x'字符的前面。”T“命令是”t“命令的反向版本,它移动到光标右边的指定字符之后。 这四个命令只在当前行中移动光标,光标不会跨越回车换行符。 可以在命令前面使用数字,表示倍数。例如,”3fx“表示移动到光标右边的第3个’x'字符上。 “;“命令重复前一次输入的f, t, F, T命令,而”,“命令会反方向重复前一次输入的f, t, F, T命令。这两个命令前也可以使用数字来表示倍数。 与复制相关 yy 复制游标所在癿那一行(常用) y1G 复制光标所在列到第一列癿所有数据 yG 复制光标所在列到最后一列癿所有数据 y0 复制光标所在癿那个字符到该行行首癿所有数据 y$ 复制光标所在癿那个字符到该行行尾癿所有数据 复原以及重做操作 u 复原前一个劢作。(常用) [Ctrl]+r 重做上一个动作。(常用) 替换模式 关键是 “R “ 取代模式,它可以快速的替换以及插入数据(类似于 word中的 即点即输)的功能。 移动光标 命令 功能 h 光标左移 l(或空格键) 光标右移 k(或[Ctrl+p]) 光标上移 j(或[Ctrl+n]) 光标下移 [Ctrl+f] 向前翻页 [Ctrl+b] 向后翻页 [Ctrl+d] 向前翻半页 [Ctrl+u] 向后翻半页 1G 跳到文件首 40G 跳到第40行 G 跳到文件尾 [Ctrl+g] 显示当前行号及文件的百分比 :set number 显示所有带行号的行 在一行内移动光标 B、E和W命令的作用与b、e和w的作用一样,只是后者忽略了标点符号。 命令 功能 b 向后移动到单词首 e 向前移动到单词尾 w 向前移动到单词首 0或| 移动到行首 30| 移动到第30列 ^ 移动到本行的第一个单词的首字符 $ 移动到行尾 插入文本 命令 功能 i 在光标的左侧插入字符 20i-[Esc] 插入20个连字符 I 在行首插入字符 [Ctrl+v][Ctrl+b] 插入[Ctrl+b]字符 [Ctrl+v][Esc] 插入[Esc]字符 a 在光标的右侧添加文本 A 在行尾添加文本 o 在当前行下面插入一空行 O 在当前行上面插入一空行 :set showmode 当vi处在输入模式下时显示提示信息 :set sm 即时显示配对的)或} :set ts=n 把制表符设置为n(默认为8) :set ai 下一行从前一行的缩进位置开始 删除和移动文本 命令 功能 x 删除光标所在的字符 6x 删除光标位置的字符以及右侧的5个字符 X 删除前一个字符 dd 删除当前行 4dd 删除4行 64dd 删除64行 dw 删除一个单词 d0 删除到行首 d$ 删除到行尾 d 删除一个区域(只用于vim) p 把被剪切的文本粘贴到下面(整行)或右侧(部分行) P 把被剪切的文本粘贴到上面(整行)或左侧(部分行) "add 把当前行粘贴到缓冲区a里 "ap 把缓冲区a里的内容粘贴到当前位置 J 把当前行于下一行合并为一行 xp 调换两个字符的位置 修改文本 命令 功能 rch 把光标位置的字符替换为ch R 替换光标右边的文本 s 把光标所在的字符替换为任意个字符 S 替换整行内容 cw 修改一个单词 c 修改区域里的文本(vim) ~ 改变所扫描的或区域里的字母的大小写 !tr'[a-z]''[A-Z]' 把区域里的字母转换为大写(vim) !tr'[A-Z]''[a-z]' 把区域里的字母转换为小写(vim) 复制文本 命令 功能 yy 复制当前行 6yy 复制六行 yw 复制单词 y 复制区域(vim) p 把复制的文本粘贴到右边或下面 P 把复制的文本粘贴到左边或上面

优秀的个人博客,低调大师

Linux的企业-Hadoop(namenode,yarn 的高可用)Hbase 分布式部署

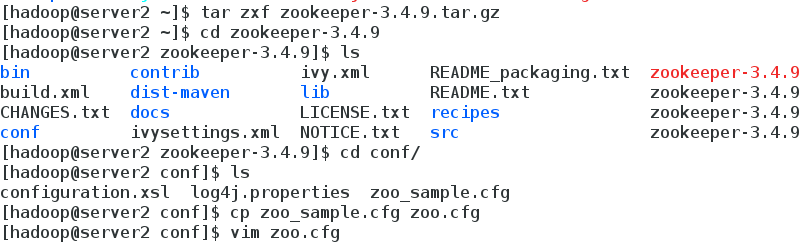
接上篇后续配置 一.配置环境 redhat6.5 server1 172.25.29(50).1 hadoop master nfs server2 172.25.29(50).2 zookeeper nfs server3 172.25.29(50).3 zookeeper nfs server4 172.25.29(50).4 zookeeper nfs server5 172.25.29(50).5 高可用备机 nfs 使用 nfs 共享同步配置文件,之前配置好java运行环境 二.Hadoop name node节点高可用配置 1.配置Zookeeper 集群,至少三台 2.在各节点启动zookeeper发现服务 3.Hadoop 配置 编辑 hdfs-site.xml 文件: <configuration> <!-- 指定 hdfs 的 nameservices 为 masters,和 core-site.xml 文件中的设置保持一 致 --> <property> <name>dfs.nameservices</name> <value>masters</value> </property> <!-- masters 下面有两个 namenode 节点,分别是 h1 和 h2 (名称可自定义) --> <property> <name>dfs.ha.namenodes.masters</name> <value>h1,h2</value> </property> <!-- 指定 h1 节点的 rpc 通信地址 --> <property> <name>dfs.namenode.rpc-address.masters.h1</name> <value>172.25.29.1:9000</value> </property> <!-- 指定 h1 节点的 http 通信地址 --> <property> <name>dfs.namenode.http-address.masters.h1</name> <value>172.25.29.1:50070</value> </property> <!-- 指定 h2 节点的 rpc 通信地址 --> <property> <name>dfs.namenode.rpc-address.masters.h2</name> <value>172.25.29.5:9000</value> </property> <!-- 指定 h2 节点的 http 通信地址 --> <property> <name>dfs.namenode.http-address.masters.h2</name> <value>172.25.29.5:50070</value> </property> <!-- 指定 NameNode 元数据在 JournalNode 上的存放位置 --> <property> <name>dfs.namenode.shared.edits.dir</name> <value>qjournal://172.25.29.2:8485;172.25.29.3:8485;172.25.29.4:8485/masters</value> </property> <!-- 指定 JournalNode 在本地磁盘存放数据的位置 --> <property> <name>dfs.journalnode.edits.dir</name> <value>/tmp/journaldata</value></property> <!-- 开启 NameNode 失败自动切换 --> <property> <name>dfs.ha.automatic-failover.enabled</name> <value>true</value> </property> <!-- 配置失败自动切换实现方式 --> <property> <name>dfs.client.failover.proxy.provider.masters</name> <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvid er</value> </property> <!-- 配置隔离机制方法,每个机制占用一行--> <property> <name>dfs.ha.fencing.methods</name> <value> sshfence shell(/bin/true) </value> </property> <!-- 使用 sshfence 隔离机制时需要 ssh 免密码 --> <property> <name>dfs.ha.fencing.ssh.private-key-files</name> <value>/home/hadoop/.ssh/id_rsa</value> </property> <!-- 配置 sshfence 隔离机制超时时间 --> <property> <name>dfs.ha.fencing.ssh.connect-timeout</name> <value>30000</value> </property> </configuration> 4.主机之间设置免密 5.格式化之前删除tmp下的数据,以免影响后面的操作 6.在三个 DN 上依次启动 journalnode(第一次启动 hdfs 必须先启动 journalnode) 7.格式化 HDFS 集群 8.启动 hdfs 集群 9.web登陆172.25.29.1:50070 测试:关闭server1的name node进程,master切换到5上 server1 kill -9 3184 server1宕掉,server5接管 三.Hadoop yarn 的高可用 1.在hadoop/etc/hadoop下编辑 mapred-site.xml 文件 2.在hadoop/etc/hadoop下编辑 yarn-site.xml 文件 <configuration> <!-- 配置可以在 nodemanager 上运行 mapreduce 程序 --> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <!-- 激活 RM 高可用 --> <property> <name>yarn.resourcemanager.ha.enabled</name> <value>true</value> </property><!-- 指定 RM 的集群 id --> <property> <name>yarn.resourcemanager.cluster-id</name> <value>RM_CLUSTER</value> </property> <!-- 定义 RM 的节点--> <property> <name>yarn.resourcemanager.ha.rm-ids</name> <value>rm1,rm2</value> </property> <!-- 指定 RM1 的地址 --> <property> <name>yarn.resourcemanager.hostname.rm1</name> <value>172.25.29.1</value> </property> <!-- 指定 RM2 的地址 --> <property> <name>yarn.resourcemanager.hostname.rm2</name> <value>172.25.29.5</value> </property> <!-- 激活 RM 自动恢复 --> <property> <name>yarn.resourcemanager.recovery.enabled</name> <value>true</value> </property> <!-- 配置 RM 状态信息存储方式,有 MemStore 和 ZKStore--> <property> <name>yarn.resourcemanager.store.class</name> <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</ value> </property> <!-- 配置为 zookeeper 存储时,指定 zookeeper 集群的地址 --> <property> <name>yarn.resourcemanager.zk-address</name> <value>172.25.29.2:2181,172.25.29.3:2181,172.25.29.4:2181</value> </property> </configuration> 3.启动 yarn 服务 server5 RM2 上需要手动启动 4.测试 在server1上 kill -9 3593 进程,master切换到server5上 四.Hbase 分布式部署 1.hbase 配置 指定 java 目录 指定 hadoop 目录,否则 hbase无法识别 hdfs 集群配置 2.vim hbase-site.xml <configuration> <!-- 指定 region server 的共享目录,用来持久化 HBase。这里指定的 HDFS 地址 是要跟 core-site.xml 里面的 fs.defaultFS 的 HDFS 的 IP 地址或者域名、端口必须一致。 --> <property> <name>hbase.rootdir</name> <value>hdfs://masters/hbase</value> </property> <!-- 启用 hbase 分布式模式 --> <property> <name>hbase.cluster.distributed</name> <value>true</value> </property> <!-- Zookeeper 集群的地址列表,用逗号分割。默认是 localhost,是给伪分布式用 的。要修改才能在完全分布式的情况下使用。 --> <property> <name>hbase.zookeeper.quorum</name> <value>172.25.29.2,172.25.29.3,172.25.29启动 hbase.4</value> </property> <!-- 指定数据拷贝 2 份,hdfs 默认是 3 份。 --> <property> <name>dfs.replication</name> <value>2</value> </property> <!-- 指定 hbase 的 master --> <property><name>hbase.master</name> <value>h1</value> </property> </configuration> 3.启动 hbase 4.备节点手动运行 5.查看配置结果 本文转自一百个小排 51CTO博客,原文链接:http://blog.51cto.com/anfishr/1975957,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux的企业-分布式文件系统mfs(moosefs)搭建与配置

一、MFS 特性: 1. Free(GPL) 2. 通用文件系统,不需要修改上层应用就可以使用 3. 可以在线扩容,体系架构可伸缩性极强。 4. 部署简单。 5. 高可用,可设置任意的文件冗余程度(提供比 raid1+0 更高的冗余级别,而绝对不会影响读或写的性能,只会加速) 6. 可回收在指定时间内删除的文件( “ 回收站 ” 提供的是系统级别的服务,不怕误操作了,提供类似 oralce 的闪回等高级 dbms 的即时回滚特性) 7. 提供 netapp,emc,ibm 等商业存储的 snapshot 特性。(可以对整个文件甚至在正在写入的文件创建文件的快照) 8. google filesystem 的一个 c 实现。 9. 提供 web gui 监控接口。 10. 提高随机读或写的效率。 11. 提高海量小文件的读写效率。可能的瓶颈: 1. master 本身的性能瓶颈。mfs 系统 master 存在单点故障如何解决? moosefs+drbd+heartbeat来保证 master 单点问题?不过在使用过程中不可能完全不关机和间歇性的网络中断! 2. 体系架构存储文件总数的可遇见的上限。(mfs 把文件系统的结构缓存到 master 的内存中,文件越多,master 的内存消耗越大,8g 对应 2500w 的文件数,2 亿文件就得 64GB 内存 )。 master 服务器 CPU 负载取决于操作的次数,内存的使用取决于文件和文件夹的个数。 二、MFS 文件系统结构:包含 4 种角色: 管理服务器 managing server (master) 元数据日志服务器 Metalogger server(Metalogger) 数据存储服务器 data servers (chunkservers) 客户机挂载使用 client computers 各种角色作用: 1. 管理服务器:负责各个数据存储服务器的管理,文件读写调度,文件空间回收以及恢复,多节点拷 贝。 2. 元数据日志服务器: 负责备份 master 服务器的变化日志文件,文件类型为changelog_ml.*.mfs,以便于在 master server 出问题的时候接替其进行工作。 3. 数据存储服务器:负责连接管理服务器,听从管理服务器调度,提供存储空间,并为客户提供数据传输。 4. 客户端:通过 fuse 内核接口挂接远程管理服务器上所管理的数据存储服务器,看起来共享的文件系统和本地 unix 文件系统使用一样的效果。 原始的读/写速度很明显是主要取决于所使用的硬盘的性能、网络的容量和拓扑结构的,使用的硬 盘和网络的吞吐量越好,整个系统的性能也就会越好。 三.mfs的安装配置 1.配置环境 redhat6.5 servre1:master 172.25.50.1 mfsmaster server2:chunk 172.25.50.2 server2:chunk 172.25.50.3 真机client:172.25.50.250 2.将mfs源码包变为rpm包安装 安装rpm-build软件 创建rpm包时需要的包依赖 3.在server1上安装mfsmaster 4.使用mfs分布式文件系统需要做好解析 master端 设置为mfsmaster 5.mfsmaster端无需配置,直接启动 master端三个端口正常启动,cgi web图形端口已经打开 6.在客户端做好解析,网页访问 四.server2和server3配置chunk 1.server2安装chunk 安装包依赖 2.server2配置解析 3.配置共享点chunk1 权限限制,在启动chunk server前,需确保用户mfs有权限读写将要被挂载的分区 4.启动chunk 查看数据 4.server3上的chunk配置和server2一样,共享点为chunk2 五.客户端连接 1.安装mfs 客户端软件,配置解析 2.创建挂载点并挂载mfsmount 3.在/mnt/mfs创建两个目录,并设置其文件存储份数 将目录dir1的储存份数设置为1 4.测试 拷贝passwd文件,查看信息: dir1一份 在server2上 dir2二份在server2和server3上 浏览器查看server2和server3 注:关闭一个chunkserver2(172.25.50.2)后,dir1无法查看,因为只存了一份在sevrer2上,但dir2没有影响,因为存了2份,chunkserver2重新启动后,恢复正常。 5.恢复垃圾箱文件: 误删: [root@foundtion50 mfs]# rm -fr /mnt/mfs/dir2/passwd [root@foundtion50mfs]# mfsgettrashtime dir2#查看垃圾箱中文件的保留时间 dir2: 86400##86400s=1day [root@foundtion50mfs]# mkdir /mnt/mfsdeta#创建目录 [root@foundtion50~]# ll -d /mnt/mfsdeta/ drwxr-xr-x 2 root root 4096 Sep 19 18:40 /mnt/mfsdeta/ [root@foundtion50~]# mfsmount -m /mnt/mfsdeta/#挂载 mfsmaster accepted connection with parameters: read-write,restricted_ip [root@foundtion50~]# cd /mnt/mfsdeta/ [root@foundtion50mfsdeta]# ls sustained trash [root@foundtion50mfsdeta]# cd trash/ [root@foundtion50trash]# find -type f ./004/00000004|dir2|passwd [root@foundtion50trash]# mv ./004/00000004\|dir2\|fstab undel/#恢复误删文件 [root@foundtion50trash]# ls /mnt/mfs/dir2/ passwd 本文转自一百个小排 51CTO博客,原文链接:http://blog.51cto.com/anfishr/1975415,如需转载请自行联系原作者

优秀的个人博客,低调大师

笔记:Linux下中小型网站常见的高负载高可用架构

先谈负载层: 一、F5等商业方案 F5为负载均衡器,具有链接高可用性,为商业设备。 二、LVS+Keeplived LVS为负载均衡器,Keeplived支持高可用。都为开源软件。 三、Nginx+Keeplived Nginx为负载均衡器,Keeplived支持高可用。都为开湖软件。其中Nginx针对多核CPU做了优化。 四、DNS轮循和视图 相比较前者DNS轮循缺少节点健康检查和自动剔除的功能。 再说说文件服务器层 一、专有存储设备的负载和高可用 商业设备,性价比不高,稳定性好。适合资金充裕的情况下使用。 二、Drbd+Heartbeat/Corosync+NFS 建议使用Corosync替代Heartbeat做心跳检测,使用Pacemaker来自动化管理集群。Drbd为存储层,相当于网络级别的软件Raid 1,Drbd也支持多主,即负载方式。 三、MooseFS分布式文件系统 性能不错。 四、Hadoop项目 更多的是使用它的分布计算功能。 本文转自xiaoyuwang 51CTO博客,原文链接:http://blog.51cto.com/wangxiaoyu/531161,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册