首页 文章 精选 留言 我的

精选列表

搜索[demo],共10000篇文章
优秀的个人博客,低调大师

《Redis 8.10 + Spring Boot 实战》第15招 生产化——从一个 Redis Demo 到真正可运行的 Spring Boot 服务

## 01、痛点 凌晨 3 点,订单服务突然报警,Redis 的 P99 从 2ms 飙到 300ms。群里没人敢动。有人说重启,有人说扩容,有人说是不是网络断了。折腾到天亮,最后发现是一个 5MB 的大 Key 被频繁读取,同时撞上 RDB 持久化 fork,CPU 单线程被堵死。这种场景太常见。 我是老李,见过很多团队把 Redis 当缓存用,set/get 走天下,一旦进入生产环境就裸奔。没有安全策略,没有连接治理,没有慢命令监控,没有容量规划。出问题只能靠猜。而官方其实已经给了标准答案:Spring Data Redis 4.1.1 支持 Redis Observability,Lettuce 可以和 Micrometer 集成,形成每个 Redis Command 的 Meter 和 Trace。Spring Boot 官方也推荐通过自动配置获得 Redis 指标和链路追踪能力。今天我们就用一套 redis-lab 把生产化能力收敛成工程。 ## 02、是什么 Redis 生产化不是装一个实例,而是围绕 Redis 建立完整的工程能力。它应该覆盖:Security、ACL、TLS、Connection、Timeout、Retry、Slow Command、Memory、Eviction、Persistence、Replication、Failover、Metrics、Tracing 和 Capacity Planning。换句话说,从客户端到网络再到服务端,每一层都要有明确的配置、指标和故障应对。 Spring Data Redis 4.1.1 的观测能力,就是在这套工程里补上了最关键的一环:命令级观测。Lettuce 会把每个 Redis 命令封装成 Metric 和 Trace Span,Micrometer 把这些数据接到 Prometheus、Grafana、Zipkin 或 Jaeger 等平台。Spring Boot 的自动配置进一步简化接入,你只需要引入依赖、开启 Actuator,就能看到 Redis 的命令延迟、错误率、连接池状态和链路追踪信息。 本文要完成的 redis-lab 是一个综合工程,包含商品缓存、库存扣减、用户签到、UV 统计、排行榜、分布式锁、限流、Streams 异步订单、Redis Search/Vector 检索、集群部署以及 Actuator/Micrometer 观测。这个实验跑通后,你对 Redis 生产化会有完整认知。 ## 03、为什么 为什么一定要做生产化?因为 Redis 是核心链路的加速层,几乎所有请求都会经过它。一旦它抖动,上游全部受影响。P99 从 2ms 涨到 300ms,可能的原因分布在很多层:客户端连接池耗尽、网络丢包重传、慢命令、热 Key、大 Key、CPU 饱和、内存使用过高导致 swap 或频繁淘汰、RDB/AOF 持久化阻塞、集群分片不均或节点故障转移。如果平时没有分层观测,出问题时你根本不知道应该看哪里。 另外,Redis 的命令执行是单线程的,一条慢命令会阻塞整个实例。生产环境里 KEYS、SMEMBERS、大范围 RANGE、复杂的 Lua 脚本都可能让延迟飙升。更隐蔽的是容量问题:内存达到 maxmemory 后开始淘汰,或者持久化 fork 导致写时复制卡顿。这些问题都必须提前纳入工程。官方推荐的 Micrometer 集成,让这些数据自动浮出水面,而不是等到用户投诉才去查。所以现在做 Redis,不接观测就是裸奔。 ## 04、架构 整个 redis-lab 的架构可以分成五层。 第一层是应用层,使用 Spring Boot 3.x + Spring Data Redis 4.1.1 + Lettuce。 第二层是客户端治理层,包含连接池参数、超时、重试、TLS 加密、ACL 用户隔离。 第三层是 Redis 服务层,可以部署单机、哨兵或集群,开启 AOF 和 RDB,设置 maxmemory 和淘汰策略。 第四层是功能层,也就是具体业务模块:缓存、库存、签到、UV、排行榜、锁、限流、Streams、Search/Vector。 第五层是观测层,通过 Micrometer 采集命令延迟、错误数、连接池使用率等指标,同时把每个命令包装成 Trace Span,Actuator 暴露 /actuator/prometheus 端点。Spring Data Redis 的自动配置会把 Lettuce 连接工厂和 Micrometer 桥接起来,不需要自己写埋点代码。 部署上,Cluster 模式使用哈希槽分片,每个节点配置副本,故障转移由哨兵或集群协议完成。 ## 05、实战 下面把 redis-lab 拆成模块逐个实现。代码以 Spring Boot 3.x 和 Java 17 为主。 **商品缓存**:使用 StringRedisTemplate,将商品对象序列化为 JSON 后写入,设置随机过期时间防止缓存雪崩,查不到时回源数据库并缓存空值防止穿透。核心逻辑如下: ``` key = product:{id} value = cache.get(key) if value is null then dbValue = productService.loadFromDb(id) if dbValue is null then cache.set(key, emptyJson, ttl=5min) else cache.set(key, json(dbValue), ttl=30min + random(0..10min)) end else return parse(value) end ``` **库存扣减**:用 Lua 脚本保证原子性,先检查库存再扣减,防止超卖。 ```lua local stock = tonumber(redis.call('GET', KEYS[1])) if stock and stock >= tonumber(ARGV[1]) then redis.call('DECRBY', KEYS[1], ARGV[1]) return 1 end return 0 ``` **用户签到**:使用位图,SETBIT sign:2025:05 1001 1 标记用户签到,BITCOUNT sign:2025:05 统计总签到数。 **UV 统计**:使用 HyperLogLog,PFADD uv:page1 userId 和 PFCOUNT uv:page1 得到近似 UV,省内存。 **排行榜**:使用 ZSet,ZADD rank:score 90 userId,ZREVRANGE rank:score 0 9 WITHSCORES 获取前 10 名。 **分布式锁**:推荐使用 Redisson,或者手写 SET NX PX 加 Lua 释放。要点是设置过期时间、使用唯一 token 防止误删、可重入与续期。命令如下: ``` SET lock:order token NX PX 30000 // 释放锁使用 Lua 保证 token 匹配 if redis.call('get', KEYS[1]) == ARGV[1] then return redis.call('del', KEYS[1]) else return 0 end ``` **限流**:可以用令牌桶或滑动窗口,一般用 Lua 原子实现。比如固定窗口:INCR rate:userId 并 EXPIRE,超过阈值拒绝。 **Streams 异步订单**:使用 XADD orders * field value 发送订单消息,XREADGROUP GROUP g1 c1 COUNT 10 STREAMS orders > 消费,处理完成后 XACK 确认。Spring Data Redis 提供了 StreamOperations,可以方便地操作消费者组。 **Redis Search/Vector**:使用 RediSearch 模块,创建向量索引,例如 FT.CREATE idx ON HASH PREFIX 1 product: SCHEMA embedding VECTOR HNSW 6 TYPE FLOAT32 DIM 128 DISTANCE_METRIC COSINE,然后使用 FT.SEARCH idx "*=>[KNN 10 @embedding $vec]" 做相似度检索。 **Cluster**:配置多条节点地址,Spring Data Redis 会自动识别集群拓扑。需要注意跨槽命令会报错,所以要设计好 Key 的哈希标签,例如 {order}:1001 保证同槽。 **Actuator/Micrometer 观测**:引入 spring-boot-starter-actuator 和 micrometer-registry-prometheus,启动后访问 /actuator/prometheus,可以看到 redis_command_seconds_max、redis_command_seconds_count、lettuce_command_seconds 等指标。链路追踪方面,Micrometer Tracing 会自动给每个 Redis 命令生成一个 span,包含命令名、耗时、结果状态。 把以上模块跑通后,你可以在 Grafana 里看到每个命令的延迟分位数,在链路追踪里看到一次请求经过哪些 Redis 命令,以及哪个命令占了大头。 ## 06、洞见 从这套实验里能提炼出几个关键认知。 第一,Redis 生产化必须分层,任何一层缺失都会让排障变成猜谜。 第二,命令级观测是核心,因为 Redis 是单线程的,命令延迟直接反映实例健康。 第三,键设计和命令复杂度是隐蔽杀手,大 Key、热 Key、集中过期、复杂 Lua 都会让 P99 飙升。 第四,原子操作要交给 Lua 或模块,不要用多次命令拼凑,否则存在竞争窗口。 第五,分布式锁和限流都有边界,锁要防误删和续期,限流要根据业务选择固定窗口、滑动窗口或令牌桶。 第六,Streams 提供了持久化消息和消费者组,但消费端必须幂等。 第七,RediSearch 向量检索适合推荐和语义搜索,但内存和索引构建成本要提前评估。 第八,集群不是银弹,跨槽命令、分片不均、故障转移期间的行为都需要理解。 最后,观测数据不能只看平均值,必须看 P99、P95 和错误率,否则会被平均值迷惑。 ## 07、行动 生产环境落地时,我建议按以下清单逐项检查。 安全方面,开启 ACL 分用户,最小权限;开启 TLS 加密;禁止公网暴露;定期审计。 连接方面,设置合理的连接池大小、超时时间、重试策略;避免连接泄漏。 命令方面,禁掉 KEYS、FLUSHALL 等危险命令;监控 SLOWLOG;限制 Lua 脚本执行时间。 内存方面,设置 maxmemory 和淘汰策略;监控内存碎片率;避免大 Key。 持久化方面,根据数据重要性选择 RDB + AOF;监控 fork 耗时和 fsync 延迟。 副本和集群方面,配置主从和自动故障转移;监控复制延迟和集群状态。 观测方面,接入 Micrometer 和 Tracing,建立延迟、错误、连接池、命令统计面板;容量规划要基于峰值流量和内存增长做预估。 下面重点解决那个测验故障:Redis P99 突然从 2ms 升到 300ms。按照客户端 → 网络 → Command → Key → CPU → Memory → Persistence → Cluster 的顺序诊断,每一步都有关键命令。 **第一步 客户端**:查看应用侧连接池是否耗尽,线程是否被阻塞,GC 是否频繁。检查 Lettuce 的连接池指标,比如 lettuce_pool_active_connections、lettuce_pool_idle_connections。如果连接池长时间满,说明请求堆积,Redis 处理不过来或网络延迟。同时检查应用日志是否有超时和重试。 **第二步 网络**:在应用机器和 Redis 节点之间做 ping 和 mtr,观察丢包和延迟。检查网卡错误、TCP 重传率,使用 ss -s 查看重传统计。如果是跨机房,检查专线带宽和延迟。很多时候 P99 突然升高是网络抖动导致,而不是 Redis 本身。 **第三步 Command**:登录 Redis 执行 SLOWLOG GET 20,查看最近慢命令。执行 INFO commandstats 看哪些命令调用量突然变大。特别是 KEYS、SMEMBERS、LRANGE 0 -1、复杂度高的 Lua 脚本。如果发现慢命令,进一步分析命令参数和键大小。 **第四步 Key**:使用 redis-cli --bigkeys 扫描大 Key,检查 OBJECT ENCODING key 看编码是否合理。集中过期也会造成延迟,查看 INFO keyspace 看过期数量变化。如果某个 Key 特别大,考虑拆分或改用哈希结构。 **第五步 CPU**:执行 INFO CPU 查看 used_cpu_sys 和 used_cpu_user,如果单核跑满,说明有慢命令或大量命令。Redis 是单线程执行命令,CPU 饱和会直接拖高所有命令延迟。可以使用 redis-cli --latency 观察实时延迟,配合 top 看进程 CPU。 **第六步 Memory**:执行 INFO memory,看 used_memory、maxmemory、mem_fragmentation_ratio、evicted_keys。如果内存达到上限并频繁淘汰,会引发延迟。检查是否发生 swap,free -h 看系统 swap 使用。高碎片率会导致内存浪费,必要时重启整理。 **第七步 Persistence**:执行 INFO persistence,看当前是否有 BGSAVE 或 AOF rewrite 正在进行。RDB 持久化 fork 会阻塞主进程,AOF fsync 如果配置为 always 且磁盘慢,会严重拖累延迟。监控 rdb_last_bgsave_time_sec 和 aof_last_rewrite_time_sec,如果这些操作刚好发生在故障时间点,基本可以锁定。 **第八步 Cluster**:如果是集群模式,检查 CLUSTER INFO 看集群状态,CLUSTER NODES 看节点角色。是否有节点正在故障转移、槽迁移、主从切换。执行 CLUSTER SLOTS 确认槽分布。如果某节点宕机或网络分区,会导致客户端重定向和超时。另外如果使用代理如 Codis/Proxy,也要检查代理层。 经过这八步,大部分 P99 飙升都能定位。定位后采取对应措施:慢命令优化或下线,大 Key 拆分,调整持久化策略,扩容 CPU 和内存,修复网络或集群。生产环境一定要在故障前完成观测建设,否则故障来了只能抓瞎。 ## 08、小结 Redis 生产化不是玄学,而是一套可以收敛成工程的实践。Spring Data Redis 4.1.1 与 Micrometer 的集成,让命令级观测变成默认能力。本文用一套 redis-lab 覆盖了缓存、库存、签到、UV、排行榜、锁、限流、Streams、检索、集群和观测,并给出了故障分层诊断手册。回到开头那个 P99 从 2ms 升到 300ms 的夜里,如果你有了这套工程,至少不会手足无措。生产环境,别让 Redis 裸奔。 ## 09、链接与概念说明 - Spring Data Redis 4.1.1 官方文档:介绍 RedisObservability、Lettuce 集成和自动配置。 - Micrometer:指标采集标准,支持 Prometheus、Graphite 等监控后端。 - Lettuce:高性能 Redis 客户端,支持同步、异步、响应式,内置观测能力。 - Redis 官方文档:包含 ACL、TLS、持久化、复制、集群、内存优化等主题。 - Redis Modules:RediSearch 提供全文检索和向量检索,RedisJSON 提供 JSON 数据类型。 - Prometheus / Grafana:指标存储和可视化平台,用于监控 Redis 命令延迟、错误率、连接池。 - redis-cli:Redis 命令行工具,可用于 SLOWLOG、--bigkeys、--latency、INFO 等诊断。

优秀的个人博客,低调大师

ROS2 机器人不是"跑个demo":QoS、生命周期、动作、实时性与多机部署的工程底线,附可运行代码

ROS2 的专业内核不是"建个节点发个话题",而是**通信契约可预期、启动顺序可编排、长任务可中断、控制回路可实时、多机可安全协同**。下面按生产级机器人系统拆解,每环给可运行代码。 ### 一、QoS:传感器数据用BEST_EFFORT,别让可靠传输拖垮控制回路 ROS2 最大的坑是默认QoS。激光雷达、IMU、相机数据量大且可丢,用RELIABLE会导致缓冲堆积、延迟暴涨;控制指令和状态机事件则必须RELIABLE。发布端和订阅端QoS不兼容会直接静默连不上。 ``` # qos_profiles.py from rclpy.qos import (QoSProfile, ReliabilityPolicy, HistoryPolicy, DurabilityPolicy, LivelinessPolicy) # 传感器:丢旧留新,尽力而为 SENSOR_QOS = QoSProfile( reliability=ReliabilityPolicy.BEST_EFFORT, history=HistoryPolicy.KEEP_LAST, depth=1, durability=DurabilityPolicy.VOLATILE, liveliness=LivelinessPolicy.AUTOMATIC, deadline=None, lifespan=None) # 控制/状态:可靠、保序、有深度 CTRL_QOS = QoSProfile( reliability=ReliabilityPolicy.RELIABLE, history=HistoryPolicy.KEEP_LAST, depth=10, durability=DurabilityPolicy.VOLATILE) # 参数/地图:RELIABLE + TRANSIENT_LOCAL,晚加入也能拿到 LATCHED_QOS = QoSProfile( reliability=ReliabilityPolicy.RELIABLE, history=HistoryPolicy.KEEP_LAST, depth=1, durability=DurabilityPolicy.TRANSIENT_LOCAL) ``` 工程约束:**depth 必须小**(传感器1,控制10),大depth只是把延迟藏起来;跨机器部署时检查DDS实现(CycloneDDS/FastDDS)的默认QoS是否被覆盖。 ### 二、生命周期节点:机器人启动是有顺序的状态机 电机驱动没就绪就下发速度、地图没加载就开导航,是常见事故。用生命周期节点把"配置→激活→去激活→清理"显式化,由launch统一编排。 ``` # motor_driver.py import rclpy from rclpy.lifecycle import LifecycleNode, TransitionCallbackReturn class MotorDriver(LifecycleNode): def __init__(self): super().__init__('motor_driver') self.pub = None def on_configure(self, state): self.declare_parameter('can_interface', 'can0') iface = self.get_parameter('can_interface').value if not self._open_can(iface): # 硬件自检 return TransitionCallbackReturn.FAILURE self.pub = self.create_lifecycle_publisher( std_msgs.msg.Float64, '/cmd_vel', 10) return TransitionCallbackReturn.SUCCESS def on_activate(self, state): self.get_logger().info('电机驱动已激活,允许下发速度') return super().on_activate(state) def on_deactivate(self, state): self._safe_stop() # 去激活必须先安全停车 return super().on_deactivate(state) def on_cleanup(self, state): self._close_can() return TransitionCallbackReturn.SUCCESS ``` 工程约束:`on_configure`做硬件自检,`on_activate`才允许发布,`on_deactivate`必须**先安全停车再释放资源**。launch里用`lifecycle_node`按依赖顺序激活,而不是`ros2 run`一把梭。 ### 三、Action:长任务必须有反馈、可取消、有超时 导航到点、机械臂抓取、巡检一圈都是分钟级任务,用Service会阻塞,用Topic没法反馈进度和取消。Action是唯一正确选择。 ``` # navigate_server.py import rclpy from rclpy.action import ActionServer, CancelResponse, GoalResponse from rclpy.action.server import ServerGoalHandle from nav2_msgs.action import NavigateToPose class NavServer(rclpy.node.Node): def __init__(self): super().__init__('nav_server') self._srv = ActionServer( self, NavigateToPose, 'navigate_to_pose', execute_callback=self.execute, goal_callback=self.on_goal, cancel_callback=lambda _: CancelResponse.ACCEPT, handle_accepted_callback=self.on_accepted) def on_goal(self, req): if self._battery_low(): return GoalResponse.REJECT # 业务前置校验 return GoalResponse.ACCEPT def execute(self, gh: ServerGoalHandle): fb = NavigateToPose.Feedback() for step in self._plan_and_drive(gh.request.goal): if gh.is_cancel_requested: gh.canceled(); return NavigateToPose.Result(success=False) fb.distance_remaining = step.remain gh.publish_feedback(fb) # 进度反馈 gh.succeed() return NavigateToPose.Result(success=True) ``` 工程约束:`goal_callback`做业务校验(电量、急停状态);执行循环里**每步检查`is_cancel_requested`**;结果必须显式`succeed/canceled/abort`,否则客户端永远等不到终态。 ### 四、执行器与回调组:别让单线程执行器堵住控制回路 默认`SingleThreadedExecutor`下一个慢回调会阻塞所有话题。控制回路、传感器、UI服务必须隔离到不同回调组,用`MultiThreadedExecutor`。 ``` # main.py import rclpy from rclpy.executors import MultiThreadedExecutor from rclpy.callback_groups import ReentrantCallbackGroup, MutuallyExclusiveCallbackGroup ctrl_group = MutuallyExclusiveCallbackGroup() # 控制:互斥,保序 sensor_group = ReentrantCallbackGroup() # 传感器:可并发 node.create_subscription(Twist, '/cmd_vel', ctrl_cb, 10, callback_group=ctrl_group) node.create_subscription(Image, '/camera', img_cb, 1, callback_group=sensor_group) executor = MultiThreadedExecutor(num_threads=4) executor.add_node(node); executor.spin() ``` 工程约束:同一硬件资源的回调放**互斥组**防并发写;耗时的图像处理放**可重入组**或独立节点;`num_threads`按CPU核数和回调耗时调,不是越大越好。 ### 五、实时性与零拷贝:控制线程不能被内存拷贝拖慢 高频控制(1kHz)下,Python节点和默认拷贝都是瓶颈。控制回路用C++节点,图像/点云用`loaned message`零拷贝。 ``` // zero_copy_pub.cpp(rclcpp片段) auto loaned = publisher_->borrow_loaned_message(); fill_pointcloud(loaned.get()); // 直接写共享内存 publisher_->publish(std::move(loaned)); // 无拷贝发布 ``` 工程约束:零拷贝要求发布订阅两端在同一进程或支持共享内存的DDS;控制节点设`SCHED_FIFO`实时优先级并锁内存(`mlockall`),否则页错误会造成抖动。 ### 六、多机与安全:DDS域隔离 + SROS2认证 多机器人同网段会互相发现造成串扰。用`ROS_DOMAIN_ID`隔离,生产环境启用SROS2做节点认证和加密。 ``` export ROS_DOMAIN_ID=42 # 不同机器人/租户不同域 export RMW_IMPLEMENTATION=rmw_cyclonedds_cpp ros2 security create_enclave /path/keystore /robot1 export ROS_SECURITY_ENCLAVE=/robot1 ROS_SECURITY_ENABLE=true ``` 工程约束:域ID要纳入部署配置管理;SROS2的权限文件按节点最小权限生成,别一把全开。 总结:ROS2 机器人的专业度不在跑通turtlesim,而在**QoS按数据类型选、生命周期管启动顺序、长任务用Action带反馈取消、回调组隔离控制回路、高频用C++和零拷贝、多机做域隔离和SROS2**这六件事。能给别人讲清楚"为什么传感器用BEST_EFFORT""去激活为什么要先安全停车",你就抓住了ROS2工程的命门。觉得有用点赞收藏,需要完整工程目录留言。

优秀的个人博客,低调大师

mahout demo——本质上是基于Hadoop的分步式算法实现,比如多节点的数据合并,数据排序,网路通信的效率,节点宕机重算,数据分步式...

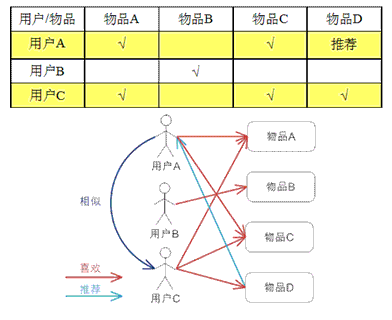
摘自:http://blog.fens.me/mahout-recommendation-api/ 测试程序:RecommenderTest.java 测试数据集:item.csv 1,101,5.0 1,102,3.0 1,103,2.5 2,101,2.0 2,102,2.5 2,103,5.0 2,104,2.0 3,101,2.5 3,104,4.0 3,105,4.5 测试程序:org.conan.mymahout.recommendation.job.RecommenderTest.java package org.conan.mymahout.recommendation.job; import java.io.IOException; import java.util.List; import org.apache.mahout.cf.taste.common.TasteException; import org.apache.mahout.cf.taste.eval.RecommenderBuilder; import org.apache.mahout.cf.taste.impl.common.LongPrimitiveIterator; import org.apache.mahout.cf.taste.model.DataModel; import org.apache.mahout.cf.taste.recommender.RecommendedItem; import org.apache.mahout.common.RandomUtils; public class RecommenderTest { final static int NEIGHBORHOOD_NUM = 2; final static int RECOMMENDER_NUM = 3; public static void main(String[] args) throws TasteException, IOException { RandomUtils.useTestSeed(); String file = "datafile/item.csv"; DataModel dataModel = RecommendFactory.buildDataModel(file); slopeOne(dataModel); } public static void userCF(DataModel dataModel) throws TasteException{} public static void itemCF(DataModel dataModel) throws TasteException{} public static void slopeOne(DataModel dataModel) throws TasteException{} ... 每种算法都一个单独的方法进行算法测试,如userCF(),itemCF(),slopeOne()…. 5. 基于用户的协同过滤算法UserCF 基于用户的协同过滤,通过不同用户对物品的评分来评测用户之间的相似性,基于用户之间的相似性做出推荐。简单来讲就是:给用户推荐和他兴趣相似的其他用户喜欢的物品。 举例说明: 基于用户的 CF 的基本思想相当简单,基于用户对物品的偏好找到相邻邻居用户,然后将邻居用户喜欢的推荐给当前用户。计算上,就是将一个用户对所有物品的偏好作为一个向量来计算用户之间的相似度,找到 K 邻居后,根据邻居的相似度权重以及他们对物品的偏好,预测当前用户没有偏好的未涉及物品,计算得到一个排序的物品列表作为推荐。图 2 给出了一个例子,对于用户 A,根据用户的历史偏好,这里只计算得到一个邻居 – 用户 C,然后将用户 C 喜欢的物品 D 推荐给用户 A。 上文中图片和解释文字,摘自:https://www.ibm.com/developerworks/cn/web/1103_zhaoct_recommstudy2/ 算法API: org.apache.mahout.cf.taste.impl.recommender.GenericUserBasedRecommender @Override public float estimatePreference(long userID, long itemID) throws TasteException { DataModel model = getDataModel(); Float actualPref = model.getPreferenceValue(userID, itemID); if (actualPref != null) { return actualPref; } long[] theNeighborhood = neighborhood.getUserNeighborhood(userID); return doEstimatePreference(userID, theNeighborhood, itemID); } protected float doEstimatePreference(long theUserID, long[] theNeighborhood, long itemID) throws TasteException { if (theNeighborhood.length == 0) { return Float.NaN; } DataModel dataModel = getDataModel(); double preference = 0.0; double totalSimilarity = 0.0; int count = 0; for (long userID : theNeighborhood) { if (userID != theUserID) { // See GenericItemBasedRecommender.doEstimatePreference() too Float pref = dataModel.getPreferenceValue(userID, itemID); if (pref != null) { double theSimilarity = similarity.userSimilarity(theUserID, userID); if (!Double.isNaN(theSimilarity)) { preference += theSimilarity * pref; totalSimilarity += theSimilarity; count++; } } } } // Throw out the estimate if it was based on no data points, of course, but also if based on // just one. This is a bit of a band-aid on the 'stock' item-based algorithm for the moment. // The reason is that in this case the estimate is, simply, the user's rating for one item // that happened to have a defined similarity. The similarity score doesn't matter, and that // seems like a bad situation. if (count <= 1) { return Float.NaN; } float estimate = (float) (preference / totalSimilarity); if (capper != null) { estimate = capper.capEstimate(estimate); } return estimate; } 测试程序: public static void userCF(DataModel dataModel) throws TasteException { UserSimilarity userSimilarity = RecommendFactory.userSimilarity(RecommendFactory.SIMILARITY.EUCLIDEAN, dataModel); UserNeighborhood userNeighborhood = RecommendFactory.userNeighborhood(RecommendFactory.NEIGHBORHOOD.NEAREST, userSimilarity, dataModel, NEIGHBORHOOD_NUM); RecommenderBuilder recommenderBuilder = RecommendFactory.userRecommender(userSimilarity, userNeighborhood, true); RecommendFactory.evaluate(RecommendFactory.EVALUATOR.AVERAGE_ABSOLUTE_DIFFERENCE, recommenderBuilder, null, dataModel, 0.7); RecommendFactory.statsEvaluator(recommenderBuilder, null, dataModel, 2); LongPrimitiveIterator iter = dataModel.getUserIDs(); while (iter.hasNext()) { long uid = iter.nextLong(); List list = recommenderBuilder.buildRecommender(dataModel).recommend(uid, RECOMMENDER_NUM); RecommendFactory.showItems(uid, list, true); } } 程序输出: AVERAGE_ABSOLUTE_DIFFERENCE Evaluater Score:1.0 Recommender IR Evaluator: [Precision:0.5,Recall:0.5] uid:1,(104,4.333333)(106,4.000000) uid:2,(105,4.049678) uid:3,(103,3.512787)(102,2.747869) uid:4,(102,3.000000) 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/7243282.html,如需转载请自行联系原作者

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码