首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | Dubbo 编解码那些事

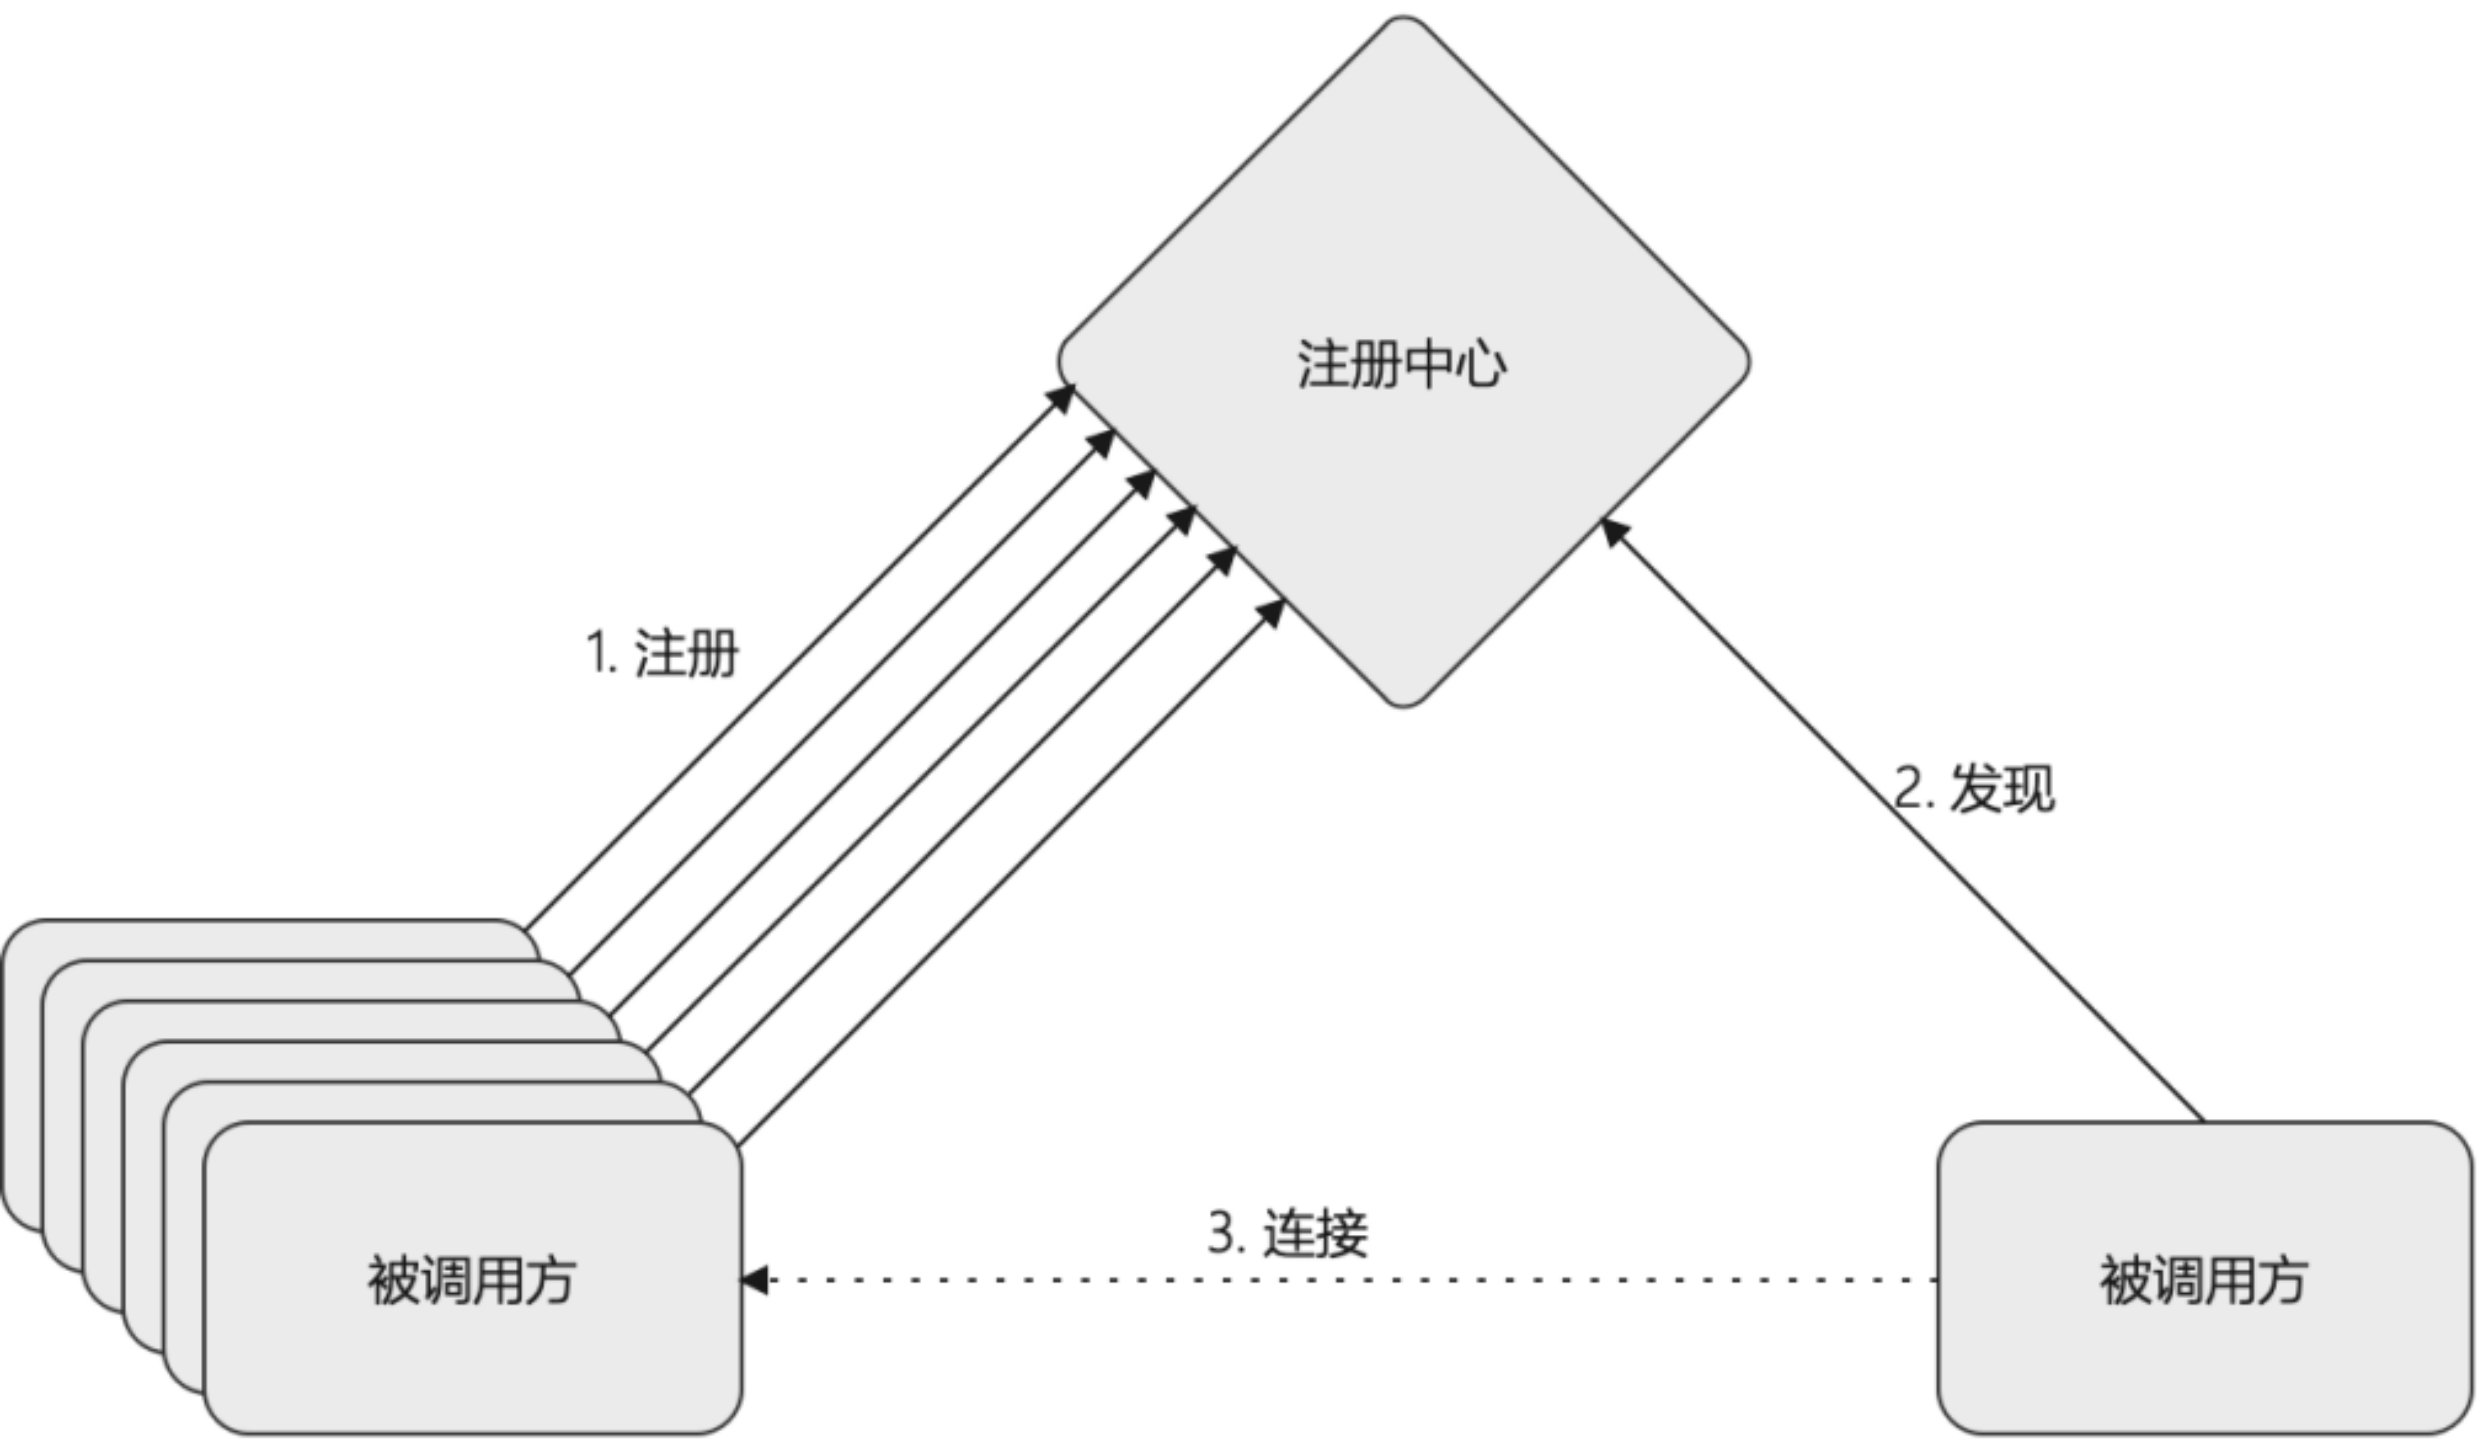
一、背景 笔者在一次维护基础公共组件的过程中,不小心修改了类的包路径。糟糕的是,这个类被各业务在facade中进行了引用、传递。幸运的是,同一个类,在提供者和消费者的包路径不一致,没有引起各业务报错。 怀揣着好奇,对于Dubbo的编解码做了几次的Debug学习,在此分享一些学习经验。 1.1 RPC的爱与恨 Dubbo作为Java语言的RPC框架,优势之一在于屏蔽了调用细节,能够像调用本地方法一样调用远程服务,不必为数据格式抓耳饶腮。正是这一特性,也引入来了一些问题。 比如引入facade包后出现jar包冲突、服务无法启动,更新facade包后某个类找不到等等问题。引入jar包,导致消费方和提供方在某种程度上有了一定耦合。 正是这种耦合,在提供者修改了Facade包类的路径后,习惯性认为会引发报错,而实际上并没有。最初认为很奇怪,仔细思考后才认为理应这样,调用方在按照约定的格式和协议基础上,即可与提供方完成通信。并不应该关注提供方本身上下文信息。(认为类的路径属于上下文信息)接下来揭秘Dubbo的编码解码过程。 二、Dubbo编解码 Dubbo默认用的netty作为通信框架,所有分析都是以netty作为前提。涉及的源码均为Dubbo - 2.7.x版本。在实际过程中,一个服务很有可能既是消费者,也是提供者。为了简化梳理流程,假定都是纯粹的消费者、提供者。 2.1 In Dubbo 借用Dubbo官方文档的一张图,文档内,定义了通信和序列化层,并没有定义"编解码"含义,在此对"编解码"做简单解释。 编解码 = dubbo内部编解码链路 + 序列化层 本文旨在梳理从Java对象到二进制流,以及二进制流到Java对象两种数据格式之间的相互转换。在此目的上,为了便于理解,附加通信层内容,以encode,decode为入口,梳理dubbo处理链路。又因Dubbo内部定义为Encoder,Decoder,故在此定义为"编解码"。 无论是序列化层,还是通信层,都是Dubbo高效、稳定运行的基石,了解底层实现逻辑,能够帮助我们更好的学习和使用Dubbo框架。 2.2 入口 消费者口在NettyClient#doOpen方法发起连接,初始化BootStrap时,会在Netty的pipeline里添加不同类型的ChannelHandler,其中就有编解码器。 同理,提供者在NettyServer#doOpen方法提供服务,初始化ServerBootstrap时,会添加编解码器。(adapter.getDecoder()- 解码器,adapater.getEncoder() - 编码器)。 NettyClient /** * Init bootstrap * * @throws Throwable */ @Override protected void doOpen() throws Throwable { bootstrap = new Bootstrap(); // ... bootstrap.handler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel ch) throws Exception { // ... ch.pipeline() .addLast("decoder", adapter.getDecoder()) .addLast("encoder", adapter.getEncoder()) .addLast("client-idle-handler", new IdleStateHandler(heartbeatInterval, 0, 0, MILLISECONDS)) .addLast("handler", nettyClientHandler); // ... } }); } NettyServer /** * Init and start netty server * * @throws Throwable */ @Override protected void doOpen() throws Throwable { bootstrap = new ServerBootstrap(); // ... bootstrap.group(bossGroup, workerGroup) .channel(NettyEventLoopFactory.serverSocketChannelClass()) .option(ChannelOption.SO_REUSEADDR, Boolean.TRUE) .childOption(ChannelOption.TCP_NODELAY, Boolean.TRUE) .childOption(ChannelOption.ALLOCATOR, PooledByteBufAllocator.DEFAULT) .childHandler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel ch) throws Exception { // ... ch.pipeline() .addLast("decoder", adapter.getDecoder()) .addLast("encoder", adapter.getEncoder()) .addLast("server-idle-handler", new IdleStateHandler(0, 0, idleTimeout, MILLISECONDS)) .addLast("handler", nettyServerHandler); } }); // ... } 2.3 消费端链路 消费者在发送消息时编码,接收响应时解码。 发送消息 ChannelInboundHandler ... NettyCodecAdapter#getEncoder() ->NettyCodecAdapter$InternalEncoder#encode ->DubboCountCodec#encode ->DubboCodec#encode ->ExchangeCodec#encode ->ExchangeCodec#encodeRequest DubboCountCodec类实际引用的是DubboCodec,因DubboCodec继承于ExchangeCodec,并未重写encode方法,所以实际代码跳转会直接进入ExchangeCodec#encode方法 接收响应 NettyCodecAdapter#getDecoder() ->NettyCodecAdapter$InternalDecoder#decode ->DubboCountCodec#decode ->DubboCodec#decode ->ExchangeCodec#decode ->DubboCodec#decodeBody ... MultiMessageHandler#received ->HeartbeatHadnler#received ->AllChannelHandler#received ... ChannelEventRunnable#run ->DecodeHandler#received ->DecodeHandler#decode ->DecodeableRpcResult#decode 解码链路相对复杂,过程中做了两次解码,在一次DubboCodec#decodeBody内,并未实际解码channel的数据,而是构建成DecodeableRpcResult对象,然后在业务处理的Handler里通过异步线程进行实际解码。 2.4 提供端链路 提供者在接收消息时解码,回复响应时编码。 接收消息 NettyCodecAdapter#getDecoder() ->NettyCodecAdapter$InternalDecoder#decode ->DubboCountCodec#decode ->DubboCodec#decode ->ExchangeCodec#decode ->DubboCodec#decodeBody ... MultiMessageHandler#received ->HeartbeatHadnler#received ->AllChannelHandler#received ... ChannelEventRunnable#run ->DecodeHandler#received ->DecodeHandler#decode ->DecodeableRpcInvocation#decode 提供端解码链路与消费端的类似,区别在于实际解码对象不一样,DecodeableRpcResult 替换成 DecodeableRpcInvocation。 体现了Dubbo代码里的良好设计,抽象处理链路,屏蔽处理细节,流程清晰可复用。 回复响应 NettyCodecAdapter#getEncoder() ->NettyCodecAdapter$InternalEncoder#encode ->DubboCountCodec#encode ->DubboCodec#encode ->ExchangeCodec#encode ->ExchangeCodec#encodeResponse 与消费方发送消息链路一致,区别在于最后一步区分Request和Response,进行不同内容编码 2.5 Dubbo协议头 Dubbo支持多种通信协议,如dubbo协议,http,rmi,webservice等等。默认为Dubbo协议。作为通信协议,有一定的协议格式和约定,而这些信息是业务不关注的。是Dubbo框架在编码过程中,进行添加和解析。 dubbo采用定长消息头 + 不定长消息体进行数据传输。以下是消息头的格式定义 **2byte:**magic,类似java字节码文件里的魔数,用来标识是否是dubbo协议的数据包。 **1byte:**消息标志位,5位序列化id,1位心跳还是正常请求,1位双向还是单向,1位请求还是响应; **1byte:**响应状态,具体类型见com.alibaba.dubbo.remoting.exchange.Response; **8byte:**消息ID,每一个请求的唯一识别id; **4byte:**消息体body长度。 以消费端发送消息为例,设置消息头内容的代码见ExchangeCodec#encodeRequest。 消息编码 protected void encodeRequest(Channel channel, ChannelBuffer buffer, Request req) throws IOException { Serialization serialization = getSerialization(channel); // header. byte[] header = new byte[HEADER_LENGTH]; // set magic number. Bytes.short2bytes(MAGIC, header); // set request and serialization flag. header[2] = (byte) (FLAG_REQUEST | serialization.getContentTypeId()); if (req.isTwoWay()) { header[2] |= FLAG_TWOWAY; } if (req.isEvent()) { header[2] |= FLAG_EVENT; } // set request id. Bytes.long2bytes(req.getId(), header, 4); // encode request data. int savedWriteIndex = buffer.writerIndex(); buffer.writerIndex(savedWriteIndex + HEADER_LENGTH); ChannelBufferOutputStream bos = new ChannelBufferOutputStream(buffer); ObjectOutput out = serialization.serialize(channel.getUrl(), bos); if (req.isEvent()) { encodeEventData(channel, out, req.getData()); } else { encodeRequestData(channel, out, req.getData(), req.getVersion()); } out.flushBuffer(); if (out instanceof Cleanable) { ((Cleanable) out).cleanup(); } bos.flush(); bos.close(); int len = bos.writtenBytes(); checkPayload(channel, len); // body length Bytes.int2bytes(len, header, 12); // write buffer.writerIndex(savedWriteIndex); buffer.writeBytes(header); // write header. buffer.writerIndex(savedWriteIndex + HEADER_LENGTH + len); } 三、Hessian2 前节梳理了编解码的流程,本节仔细看一看对象序列化的细节内容。 我们知道,Dubbo支持多种序列化格式,hessian2,json,jdk序列化等。hessian2是阿里对于hessian进行了修改,也是dubbo默认的序列化框架。在此以消费端发送消息序列化对象,接收响应反序列化为案例,看看hessian2的处理细节,同时解答前言问题。 3.1 序列化 前文提到,请求编码方法在ExchangeCodec#encodeRequest,其中对象数据的序列化为DubboCodec#encodeRequestData DubboCodec @Override protected void encodeRequestData(Channel channel, ObjectOutput out, Object data, String version) throws IOException { RpcInvocation inv = (RpcInvocation) data; out.writeUTF(version); // https://github.com/apache/dubbo/issues/6138 String serviceName = inv.getAttachment(INTERFACE_KEY); if (serviceName == null) { serviceName = inv.getAttachment(PATH_KEY); } out.writeUTF(serviceName); out.writeUTF(inv.getAttachment(VERSION_KEY)); out.writeUTF(inv.getMethodName()); out.writeUTF(inv.getParameterTypesDesc()); Object[] args = inv.getArguments(); if (args != null) { for (int i = 0; i < args.length; i++) { out.writeObject(encodeInvocationArgument(channel, inv, i)); } } out.writeAttachments(inv.getObjectAttachments()); } 我们知道,在dubbo调用过程中,是以Invocation作为上下文环境存储。这里先写入了版本号,服务名,方法名,方法参数,返回值等信息。随后循环参数列表,对每个参数进行序列化。在此,out对象即是具体序列化框架对象,默认为Hessian2ObjectOutput。这个out对象作为参数传递进来。 那么是在哪里确认实际序列化对象呢? 从头查看编码的调用链路,ExchangeCodec#encodeRequest内有如下代码: ExchangeCodec protected void encodeRequest(Channel channel, ChannelBuffer buffer, Request req) throws IOException { Serialization serialization = getSerialization(channel); // ... ObjectOutput out = serialization.serialize(channel.getUrl(), bos); if (req.isEvent()) { encodeEventData(channel, out, req.getData()); } else { encodeRequestData(channel, out, req.getData(), req.getVersion()); } // ... } out对象来自于serialization对象,顺着往下看。在CodecSupport类有如下代码: CodecSupport public static Serialization getSerialization(URL url) { return ExtensionLoader.getExtensionLoader(Serialization.class).getExtension( url.getParameter(Constants.SERIALIZATION_KEY, Constants.DEFAULT_REMOTING_SERIALIZATION)); } 可以看到,这里通过URL信息,基于Dubbo的SPI选择Serialization对象,默认为hessian2。再看看serialization.serialize(channel.getUrl(),bos)方法: Hessian2Serialization @Override public ObjectOutput serialize(URL url, OutputStream out) throws IOException { return new Hessian2ObjectOutput(out); } 至此,找到了实际序列化对象,参数序列化逻辑较为简单,不做赘述,简述如下:写入请求参数类型 → 写入参数字段名 → 迭代字段列表,字段序列化。 3.2 反序列化 相对于序列化而言,反序列化会多一些约束。序列化对象时,不需要关心接收者的实际数据格式。反序列化则不然,需要保证原始数据和对象匹配。(这里的原始数据可能是二进制流,也可能是json)。 消费端解码链路中有提到,发生了两次解码,第一次未实际解码业务数据,而是转换成DecodeableRpcResult。具体代码如下: DubboCodec @Override protected Object decodeBody(Channel channel, InputStream is, byte[] header) throws IOException { byte flag = header[2], proto = (byte) (flag & SERIALIZATION_MASK); // get request id. long id = Bytes.bytes2long(header, 4); if ((flag & FLAG_REQUEST) == 0) { // decode response... try { DecodeableRpcResult result; if (channel.getUrl().getParameter(DECODE_IN_IO_THREAD_KEY, DEFAULT_DECODE_IN_IO_THREAD)) { result = new DecodeableRpcResult(channel, res, is, (Invocation) getRequestData(id), proto); result.decode(); } else { result = new DecodeableRpcResult(channel, res, new UnsafeByteArrayInputStream(readMessageData(is)), (Invocation) getRequestData(id), proto); } data = result; } catch (Throwable t) { // ... } return res; } else { // decode request... return req; } } 关键点 1)对于解码请求还是解码响应做了区分,对于消费端而言,就是解码响应。对于提供端而言,即是解码请求。 2)为什么会出现两次解码?具体见这行: if (channel.getUrl().getParameter(DECODE_IN_IO_THREAD_KEY, DEFAULT_DECODE_IN_IO_THREAD)) { inv = new DecodeableRpcInvocation(channel, req, is, proto); inv.decode(); } else { inv = new DecodeableRpcInvocation(channel, req, new UnsafeByteArrayInputStream(readMessageData(is)), proto); } decode_in_io_thread_key - 是否在io线程内进行解码,默认是false,避免在io线程内处理业务逻辑,这也是符合netty的推荐做法。所以才有了异步的解码过程。 那看看解码业务对象的代码,还记得在哪儿吗?DecodeableRpcResult#decode DecodeableRpcResult @Override public Object decode(Channel channel, InputStream input) throws IOException { ObjectInput in = CodecSupport.getSerialization(channel.getUrl(), serializationType) .deserialize(channel.getUrl(), input); byte flag = in.readByte(); switch (flag) { case DubboCodec.RESPONSE_NULL_VALUE: // ... case DubboCodec.RESPONSE_VALUE_WITH_ATTACHMENTS: handleValue(in); handleAttachment(in); break; case DubboCodec.RESPONSE_WITH_EXCEPTION_WITH_ATTACHMENTS: // ... default: throw new IOException("Unknown result flag, expect '0' '1' '2' '3' '4' '5', but received: " + flag); } // ... return this; } private void handleValue(ObjectInput in) throws IOException { try { Type[] returnTypes; if (invocation instanceof RpcInvocation) { returnTypes = ((RpcInvocation) invocation).getReturnTypes(); } else { returnTypes = RpcUtils.getReturnTypes(invocation); } Object value = null; if (ArrayUtils.isEmpty(returnTypes)) { // This almost never happens? value = in.readObject(); } else if (returnTypes.length == 1) { value = in.readObject((Class<?>) returnTypes[0]); } else { value = in.readObject((Class<?>) returnTypes[0], returnTypes[1]); } setValue(value); } catch (ClassNotFoundException e) { rethrow(e); } } 这里出现了ObjectInput,那底层的序列化框架选择逻辑是怎么样的呢?如何保持与消费端的序列化框架一致? 每一个序列化框架有一个id见org.apache.dubbo.common.serialize.Constants; 1、请求时,序列化框架是根据Url信息进行选择,默认是hessian2 2、传输时,会将序列化框架标识写入协议头,具体见ExchangeCodec#encodeRequest#218 3、提供收到消费端的请求时,会根据这个id使用对应的序列化框架。 此次实际持有对象为Hessian2ObjectInput,由于readObject反序列化逻辑处理较为复杂,流程如下: 四、常见问题 问题1:提供端修改了Facade里的类路径,消费端反序列化为什么没报错? 答:反序列化时,消费端找不到提供端方返回的类路径时,会catch异常,以本地的返回类型为准做处理 问题2:编码序列化时,没有为什么写入返回值? 答:因为在Java中,返回值不作为标识方法的信息之一 问题3:反序列化流程图中,A与B何时会出现不一致的情况?A的信息从何处读取? 答:当提供端修改了类路径时,A与B会出现不一样;A的信息来源于,发起请求时,Request对象里存储的Invocation上下文,是本地jar包里的返回值类型。 问题4:提供者增删返回字段,消费者会报错吗? 答:不会,反序列化时,取两者字段交集。 问题5:提供端修改对象的父类信息,消费端会报错吗? 答:不会,传输中只携带了父类的字段信息,没有携带父类类信息。实例化时,以本地类做实例化,不关联提供方实际代码的父类路径。 问题6:反序列化过程中,如果返回对象子类和父类存在同名字段,且子类有值,父类无值,会发生什么? 答:在dubbo - 3.0.x版本,在会出现返回字段为空的情况。原因在于编码侧迭代传输字段集合时(消费端可能编码,提供端也可能编码),父类的字段信息在子类后面。解码侧拿到字段集合迭代解码时,通过字段key拿到反序列化器,此时子类和父类同名,那么第一次反射会设置子类值,第二次反射会设置父类值进行覆盖。 在dubbo - 2.7.x版本中,该问题已解决。解决方案也比较简单,在编码侧传输时,通过 Collections.reverse(fields)反转字段顺序。 JavaSerializer public JavaSerializer(Class cl, ClassLoader loader) { introspectWriteReplace(cl, loader); // ... List fields = new ArrayList(); fields.addAll(primitiveFields); fields.addAll(compoundFields); Collections.reverse(fields); // ... } 五、写在最后 编解码过程复杂晦涩,数据类型多种多样。笔者遇到和了解的终究有限,以最常见、最简单的数据类型梳理编解码的流程。如有错误疏漏之处,还请见谅。 作者:vivo互联网服务器团队-Sun wen

优秀的个人博客,低调大师

每日一博 | Hystrix 实战经验分享

一、背景 Hystrix是Netlifx开源的一款容错框架,防雪崩利器,具备服务降级,服务熔断,依赖隔离,监控(Hystrix Dashboard)等功能。 尽管说Hystrix官方已不再维护,且有Alibaba Sentinel等新框架选择,但从组件成熟度和应用案例等方面看,其实还是有很多项目在继续使用Hystrix中,本人所参与的项目就是其一。故结合个人的Hystrix实战经验与大家分享交流。 二、经验总结 2.1 隔离策略的选择 Hystrix提供两种资源隔离策略,线程池和信号量。它们之间的异同点如下: 而在使用缓存(本地内存缓存更适合该场景,Redis等网络缓存需要评估)时,我们可以使用信号量隔离策略,因为这类服务响应快,不会占用容器线程太长时间,而且也减少了线程切换的一些开销,提高了服务效率。 具体使用哪种策略,需根据业务场景综合评估。一般情况下,推荐使用线程池隔离。 2.2线程池大小与超时时间设置 在线程池隔离策略下,线程池大小及超时时间的设置至关重要,直接影响着系统服务的响应能力。如线程池大小若设置的太大会造成资源浪费及线程切换等开销;若设置的太小又支撑不了用户请求,造成请求排队。而超时时间设置的太长会出现部分长耗时请求阻塞线程,造成其它正常请求排队等待;若设置的太短又会造成太多正常请求被熔断。 对此Hystrix官方给的建议如图: 即转换为以下计算公式: 线程池大小 = 服务TP99响应时长(单位秒) * 每秒请求量 + 冗余缓冲值 超时时间(单位毫秒) = 1000(毫秒) / 每秒请求量 例如某服务TP99情况下每秒钟会接收30个请求,然后每个请求的响应时长是200ms,按如上公式计算可得:线程池大小 = 0.2 * 30 + 4(冗余缓冲值)= 10,超时时间 = 300ms 2.3 注解叠加 在实际开发中可能会遇到某外部调用方法有Hystrix注解与其它注解一起使用的情况,例如查询方法加上缓存注解。此时需特别注意注解间的执行顺序,避免出现非预期的结果: 缓存注解未生效 此时Hystrix注解切面的执行是在最外层,由于Hystrix内部执行是通过ProceedingJoinPoint.getTarget()获取目标对象,使用反射调用的方式直接执行到目标对象方法上,从而造成中间其它注解逻辑丢失。可通过指定注解执行顺序@Order解决保证Hystrix注解执行在最里层。 因缓存异常造成该查询方法被熔断 如果Hystrix注解切面的执行是在最外层,此时Hystrix熔断管理的方法逻辑除了第三方服务远程调用,也包括了缓存调用逻辑。如果缓存调用出现异常就会算作整个方法异常,从而引起整个方法被熔断。 2.4 服务的异常处理 先给大家时间看如下代码,检查是否存在问题: @HystrixCommand(fallbackMethod="queryUserByIdFallback") public User queryUserById(String userId) { if(StringUtils.isEmpty(userId)) { throw new BizException("参数不合法"); } Result<User> result; try { result = userFacade.queryById(userId); } catch(Exception e) { log.error("query user error. id={}", id, e); } if(result != null && result.isSuccess()) { return result.getData(); } return null; } Hystrix在运行过程中会根据调用请求的成功率或失败率信息来确定每个依赖命令的熔断器是否打开。如果打开,后续的请求都会被拒绝。由此可见,对异常的控制是Hystrix运行效果起很大影响。 再回头看上面的例子,会发现两个异常处理问题: 参数校验不通过时的异常处理 非法参数校验等非系统调用的异常失败不应该影响熔断逻辑,不应该算作失败统计范围内。对此优化建议是将参数校验放到远程调用封装方法的外面,或者封装成HystrixBadRequestException进行抛出。因为在Hystrix内部逻辑中HystrixBadRequestException异常已默认为不算作失败统计范围内。 try-catch远程调用的异常处理 对远程服务的直接调用进行try-catch会把异常直接“吞掉”,会直接造成Hystrix获取不到网络异常等服务不可用异常。建议在catch日志记录处理后将异常再throw出来。 2.5 fallback方法 Hystrix在依赖服务调用时通过增加fallback方法返回默认值的方式来支持服务优雅降级。但fallback的使用也有很多需要注意的地方,大致总结如下: fallback 方法访问级别、参数等要与对应依赖服务一致 fallback 方法中执行的逻辑尽量轻量,如用本地缓存或静态默认值,避免远程调用 如果fallback方法里有远程调用,建议也使用Hystrix包装起来,且保证与主命令线程池的隔离 对于写操作的远程调用不建议使用fallback降级 2.6 groupKey、commandKey、threadPoolKey 在使用Hystrix开发中肯定都见过这三个key,但很多人并不理解这三个key的意义以及对Hystrix的作用,尤其是threadPooKey,故在此总结下: groupKey 通过group key可以对命令方法进行分组,便于Hystrix数据统计、告警及dashboad展示。一般会根据远程服务的业务类型进行区分,如账户服务定义一个group key,订单服务定义另一个group key。 默认值是@HystrixCommand注解标注的方法所在的类名。 commandKey 具体命令方法的标识名称,常用于对该命令进行动态参数设置。 默认值是@HystrixCommand注解标注的方法名。 threadPoolKey 用于标识命令所归属的线程池,具有相同threadPoolKey的命令使用同一个线程池。 若该key不指定,默认值就是groupKey,即@HystrixCommand注解标注的方法所在的类名。 在实际项目中,我们会建议尽量通过threadPoolKey来指定线程池, 而不是通过groupKey的默认方式划分, 因为会存在某个命令需要跟同组其他命令进行线程隔离的场景,以避免互相影响。 2.7 参数优先级 Hystrix默认提供4个级别的参数值配置方式: 全局默认值(Default Value) Hystrix自身代码默认值,写死在源码中的值,使用方不配置任何参数情况下生效。 例:execution.isolation.thread.timeoutInMilliseconds超时时间全局默认值是1000,单位毫秒 动态全局默认参数(Default Property) 此类配置参数可变更全局默认值。 例:通过属性名hystrix.command.default.execution.isolation.thread.timeoutInMilliseconds设置的超时时间值 实例初始值(Instant Value) 熔断器实例初始值,配置此类参数后,不再使用默认值。即写在代码注解中的属性值。 例:@HystrixProperty(name ="execution.isolation.thread.timeoutInMilliseconds", value ="5000") 动态实例参数(Instant Property) 可动态调整一个熔断器实例的参数值 例:通过属性名hystrix.command.HystrixCommandKey.execution.isolation.thread.timeoutInMilliseconds设置的超时时间值 优先级关系: 动态实例参数(Instance Property)>实例初始值>动态全局默认参数(Default Property)>全局默认值(Default Value) 2.8 基于配置中心实现参数动态配置 Hystrix默认使用Archaius实现动态设置,而Archaius默认会加载classpath下的config.properties文件,可通过在配置文件中加入对应属性key-value实现动态控制Hystrix行为。在分布式项目中使用配置中心进行统一配置管理是标配,因此需要基于配置中心的扩展实现Hystrix参数动态配置功能。 通过跟踪HystrixCommand的创建,发现hystrix最终通过HystrixDynamicProperties实现类根据参数属性名获取值,而Hystrix本身提供了HystrixDynamicProperties类的扩展机制,见HystrixPlugins类367行代码,可知Hystrix提供四种扩展方法: 通过系统参数 基于Java SPI机制 Archaius动态属性扩展实现类(默认) Hystrix内置基于System.getProperty的HystrixDynamicProperties实现; 2.8.1 基于Java SPI机制 基于spi机制的扩展实现依赖两个类分别是HystrixDynamicProperties与HystrixDynamicProperty,其中HystrixDynamicProperties类是需要实现的Hystrix动态属性扩展spi接口,提供了多个获取动态属性的方法,接口定义如下: public interface HystrixDynamicProperties { /** * Requests a property that may or may not actually exist. * @param name property name, never <code>null</code> * @param fallback default value, maybe <code>null</code> * @return never <code>null</code> */ public HystrixDynamicProperty<String> getString(String name, String fallback); /** * Requests a property that may or may not actually exist. * @param name property name, never <code>null</code> * @param fallback default value, maybe <code>null</code> * @return never <code>null</code> */ public HystrixDynamicProperty<Integer> getInteger(String name, Integer fallback); /** * Requests a property that may or may not actually exist. * @param name property name, never <code>null</code> * @param fallback default value, maybe <code>null</code> * @return never <code>null</code> */ public HystrixDynamicProperty<Long> getLong(String name, Long fallback); /** * Requests a property that may or may not actually exist. * @param name property name * @param fallback default value * @return never <code>null</code> */ public HystrixDynamicProperty<Boolean> getBoolean(String name, Boolean fallback); } 而HystrixDynamicProperty类具体表示一个参数属性,且有动态变更的能力,接口定义如下: public interface HystrixDynamicProperty<T> extends HystrixProperty<T>{ public String getName(); /** * Register a callback to be run if the property is updated. * @param callback callback. */ public void addCallback(Runnable callback); } 其中addCallback方法是实现属性动态变更的核心所在,如其注释说明的那样,它会在属性变更时注册callback回调方法进行属性动态刷新。而这块动态刷新逻辑是Hystrix内部已实现的,对于我们只需要自定义扩展时将callback保存,然后在配置中心变更时触发对应属性对象的callback方法即可。 实现步骤如下: 1、定义HystrixDynamicProperty实现类 完成动态属性类的自定义实现,包括String/Integer/Long/Boolean四种类型动态属性态实现。 如上面HystrixDynamicProperty类描述中说的那样,需要对callback进行保存,并在在收到配置中心属性变更时触发这些属性的callback方法,来实现属性的动态变更。这块逻辑可以参照观察者模式进行设计实现。 代码如下: private abstract static class CustomDynamicProperty<T> implements HystrixDynamicProperty<T>, PropertyObserver { protected final String name; protected final T defaultValue; protected List<Runnable> callbacks; protected CustomDynamicProperty(String propName, T defaultValue) { this.name = propName; this.defaultValue = defaultValue; PropertyObserverManager.add(this); } @Override public String getName() { return name; } @Override public void addCallback(Runnable callback) { if (callbacks == null) callbacks = new ArrayList<>(1); this.callbacks.add(callback); } @Override public String keyName() { return name; } @Override public void update(PropertyItem item) { if(getName().equals(item.getName())) { for(Runnable r : callbacks) { r.run(); } } } } private static class StringDynamicProperty extends CustomDynamicProperty<String> { protected StringDynamicProperty(String propName, String defaultValue) { super(propName, defaultValue); } @Override public String get() { return ConfigManager.getString(name, defaultValue); } } private static class IntegerDynamicProperty extends CustomDynamicProperty<Integer> { protected IntegerDynamicProperty(String propName, Integer defaultValue) { super(propName, defaultValue); } @Override public Integer get() { String configValue = ConfigManager.get(name); if(StringUtils.isNotEmpty(configValue)) { return Integer.valueOf(configValue); } return defaultValue; } } private static class LongDynamicProperty extends CustomDynamicProperty<Long> { protected LongDynamicProperty(String propName, Long defaultValue) { super(propName, defaultValue); } @Override public Long get() { String configValue = ConfigManager.get(name); if(StringUtils.isNotEmpty(configValue)) { return Long.valueOf(configValue); } return defaultValue; } } private static class BooleanDynamicProperty extends CustomDynamicProperty<Boolean> { protected BooleanDynamicProperty(String propName, Boolean defaultValue) { super(propName, defaultValue); } @Override public Boolean get() { String configValue = ConfigManager.get(name); if(StringUtils.isNotEmpty(configValue)) { return Boolean.valueOf(configValue); } return defaultValue; } } 其中ConfigManager类暂时默认为配置中心配置管理类,提供参数获取与参数监听器等功能。而PropertyObserver类(keyName/update方法属于其定义)、PropertyObserverManager类就是参照观察者模式定义实现的,负责观察者的注册与通知管理,来完成动态属性与配置中心变更通知间的联动。这两个类实现比较简单就不展示描述。 2、定义HystrixDynamicProperties实现类 基于第1步定义的HystrixDynamicProperty扩展类完成HystrixDynamicProperties的自定义。代码如下: public class DemoHystrixDynamicProperties implements HystrixDynamicProperties { @Override public HystrixDynamicProperty<String> getString(String name, String fallback) { return new StringDynamicProperty(name, fallback); } @Override public HystrixDynamicProperty<Integer> getInteger(String name, Integer fallback) { return new IntegerDynamicProperty(name, fallback); } @Override public HystrixDynamicProperty<Long> getLong(String name, Long fallback) { return new LongDynamicProperty(name, fallback); } @Override public HystrixDynamicProperty<Boolean> getBoolean(String name, Boolean fallback) { return new BooleanDynamicProperty(name, fallback); } } 3、注册SPI实现类 在META-INF/services/添加名为com.netflix.hystrix.strategy.properties.HystrixDynamicProperties的文本文件,内容为第2步HystrixDynamicProperties自定义实现类全路径名。 2.8.2 基于默认Archaius进行扩展 Hystrix默认通过Archaius实现参数动态获取,而Archaius自身也提供自定义的参数获取方式,分别是 PolledConfigurationSource接口 和AbstractPollingScheduler类,其中PolledConfigurationSource接口表示配置获取源,AbstractPollingScheduler类表示配置定时刷新机制。 实现步骤如下: 1、创建配置获取源: public class CustomCfgConfigurationSource implements PolledConfigurationSource { private final static String CONFIG_KEY_PREFIX = "hystrix"; @Override public PollResult poll(boolean initial, Object checkPoint) throws Exception { Map<String, Object> map = load(); return PollResult.createFull(map); } private Map<String, Object> load() throws Exception{ Map<String, Object> map = new HashMap<>(); Set<String> keys = ConfigManager.keys(); for(String key : keys) { if(key.startsWith(CONFIG_KEY_PREFIX)) { map.put(key, ConfigManager.get(key)); } } return map; } } 其实现非常简单,核心实现就是poll方法,遍历配置中心中所有hystrix开头的配置参数并返回保存。 2、定义配置刷新方式: public class CustomCfgPollingScheduler extends AbstractPollingScheduler { private final static Logger logger = LoggerFactory.getLogger("CustomCfgPollingScheduler"); private final static String CONFIG_KEY_PREFIX = "hystrix"; @Override public void startPolling(PolledConfigurationSource source, final Configuration config) { super.startPolling(source, config); // ConfigManager.addListener(new ConfigListener() { @Override public void eventReceived(PropertyItem item, ChangeEventType type) { String name = item.getName(); if(name.startsWith(CONFIG_KEY_PREFIX)) { String newValue = item.getValue(); //新增&修改 if(ChangeEventType.ITEM_ADDED.equals(type) || ChangeEventType.ITEM_UPDATED.equals(type)) { addOrChangeProperty(name, newValue, config); } //删除 else if(ChangeEventType.ITEM_REMOVED.equals(type)) { deleteProperty(name, config); } else { logger.error("error config change event type {}.", type); } } } }); } private void addOrChangeProperty(String name, Object newValue, final Configuration config) { if (!config.containsKey(name)) { config.addProperty(name, newValue); } else { Object oldValue = config.getProperty(name); if (newValue != null) { if (!newValue.equals(oldValue)) { config.setProperty(name, newValue); } } else if (oldValue != null) { config.setProperty(name, null); } } } private void deleteProperty(String key, final Configuration config) { if (config.containsKey(key)) { config.clearProperty(key); } } @Override protected void schedule(Runnable pollingRunnable) { //IGNORE OPERATION } @Override public void stop() { //IGNORE OPERATION } } 但对应实际项目,通过定时刷新的方式一是不太实时,二是每次都得全量检查配置中心是否有修改,逻辑复杂,所以此处改用 ConfigManager.addListener 增加配置中心监听来实现。 3、定义并初始化自动配置: DynamicConfiguration dynamicConfiguration = new DynamicConfiguration(new CustomCfgConfigurationSource(), new CustomCfgPollingScheduler()); ConfigurationManager.install(dynamicConfiguration); 最后只需要在容器启动时执行以上初始化脚本即可。 细心的同学可能发现上面步骤中第3步,最终“安装”install到Hystrix配置管理类中的是 DynamicConfiguration类实现,且第2步的定时刷新类也比较鸡肋,就想着能否继续简化上面方案,只需要实现一个自定义的"DynamicConfiguration"就包含配置源获取与监听配置修改功能,实现如下: public class CustomCfgDynamicConfiguration extends ConcurrentMapConfiguration { private final static Logger logger = LoggerFactory.getLogger("CustomCfgDynamicConfiguration"); private final static String CONFIG_KEY_PREFIX = "hystrix"; public CustomCfgDynamicConfiguration() { super(); load(); initEvent(); } /** * 从配置中心全量加载Hystrix配置参数信息 */ private void load() { Set<String> keys = ConfigManager.keys(); for(String key : keys) { if(key.startsWith(CONFIG_KEY_PREFIX)) { map.put(key, ConfigManager.get(key)); } } } /** * 通过配置中心监听事件回调处理,针对Hystrix配置参数变更进行同步 */ private void initEvent() { ConfigManager.addListener(new ConfigListener() { @Override public void eventReceived(PropertyItem item, ChangeEventType type) { String name = item.getName(); if(name.startsWith(CONFIG_KEY_PREFIX)) { String newValue = item.getValue(); //新增&修改 if(ChangeEventType.ITEM_ADDED.equals(type) || ChangeEventType.ITEM_UPDATED.equals(type)) { addOrChangeProperty(name, newValue); } //删除 else if(ChangeEventType.ITEM_REMOVED.equals(type)) { deleteProperty(name); } else { logger.error("error config change event type {}.", type); } } } }); } /** * 新增或修改参数值 * @param name * @param newValue */ private void addOrChangeProperty(String name, Object newValue) { if (!this.containsKey(name)) { this.addProperty(name, newValue); } else { Object oldValue = this.getProperty(name); if (newValue != null) { if (!newValue.equals(oldValue)) { this.setProperty(name, newValue); } } else if (oldValue != null) { this.setProperty(name, null); } } } /** * 删除参数值 * @param key */ private void deleteProperty(String key) { if (this.containsKey(key)) { this.clearProperty(key); } } } 最后通过 ConfigurationManager.install(new CustomCfgDynamicConfiguration());“安装”该实现即可。 三、写在最后 笔者结合项目实战对Hystrix使用进行总结分享,有关于隔离策略、线程池设置、参数优先级等知识点讲解,也有关于注解叠加、异常处理、参数动态配置等具体问题解决方案,希望对大家有所帮助。 作者:vivo 官网商城开发团队

优秀的个人博客,低调大师

每日一博 | 硬核操作系统讲解

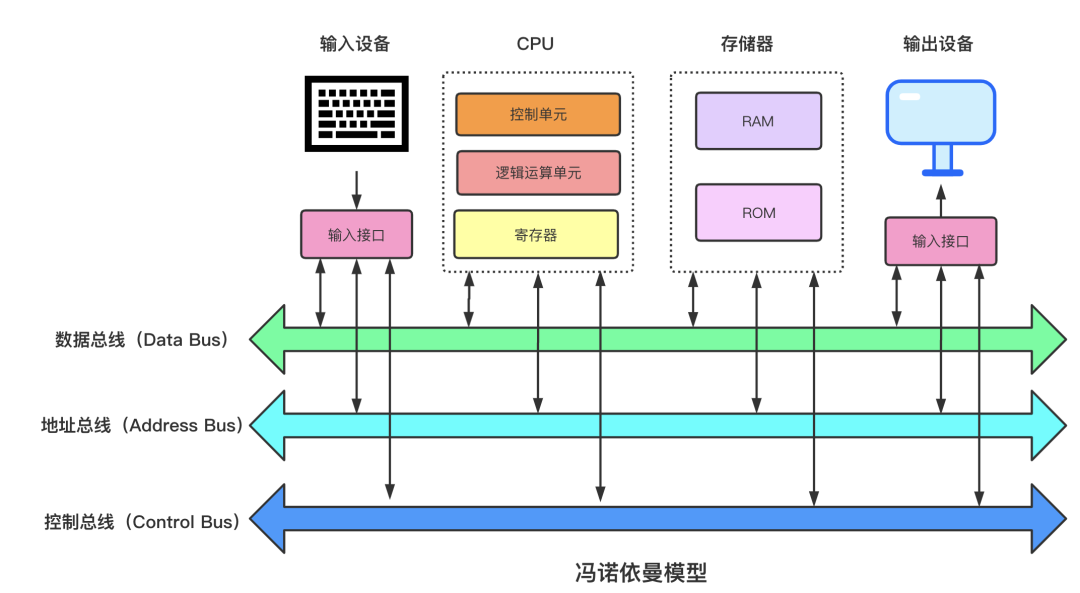
1 冯诺伊曼体系 1.1 冯诺伊曼体系简介 现代计算机之父冯诺伊曼最先提出程序存储的思想,并成功将其运用在计算机的设计之中,该思想约定了用二进制进行计算和存储,还定义计算机基本结构为 5 个部分,分别是中央处理器(CPU)、内存、输入设备、输出设备、总线。 存储器:代码跟数据在RAM跟ROM中是线性存储, 数据存储的单位是一个二进制位。最小的存储单位是字节。 总线:总线是用于 CPU 和内存以及其他设备之间的通信,总线主要有三种: 地址总线:用于指定 CPU 将要操作的内存地址。 数据总线:用于读写内存的数据。 控制总线:用于发送和接收信号,比如中断、设备复位等信号,CPU 收到信号后响应,这时也需要控制总线。 输入/输出设备:输入设备向计算机输入数据,计算机经过计算后,把数据输出给输出设备。比如键盘按键时需要和 CPU 进行交互,这时就需要用到控制总线。 CPU:中央处理器,类比人脑,作为计算机系统的运算和控制核心,是信息处理、程序运行的最终执行单元。CPU用寄存器存储计算时所需数据,寄存器一般有三种: 通用寄存器:用来存放需要进行运算的数据,比如需进行加法运算的两个数据。 程序计数器:用来存储 CPU 要执行下一条指令所在的内存地址。 指令寄存器:用来存放程序计数器指向的指令本身。 在冯诺伊曼体系下电脑指令执行的过程: CPU读取程序计数器获得指令内存地址,CPU控制单元操作地址总线从内存地址拿到数据,数据通过数据总线到达CPU被存入指令寄存器。 CPU分析指令寄存器中的指令,如果是计算类型的指令交给逻辑运算单元,如果是存储类型的指令交给控制单元执行。 CPU 执行完指令后程序计数器的值通过自增指向下个指令,比如32位CPU会自增4。 自增后开始顺序执行下一条指令,不断循环执行直到程序结束。 CPU位宽:32位CPU一次可操作计算4个字节,64位CPU一次可操作计算8个字节,这个是硬件级别的。平常我们说的32位或64位操作系统指的是软件级别的,指的是程序中指令多少位。 线路位宽:CPU操作指令数据通过高低电压变化进行数据传输,传输时候可以串行传输,也可以并行传输,多少个并行等于多少个位宽。 1.2 CPU 简介 Central Processing Unit 中央处理器,作为计算机系统的运算和控制核心,是信息处理、程序运行的最终执行单元。 CPU CPU核心:一般一个CPU会有多个CPU核心,平常说的多核是指在一枚处理器中集成两个或多个完整的计算引擎。核跟CPU的关系是:核属于CPU的一部分。 寄存器:最靠近CPU对存储单元,32位CPU寄存器可存储4字节,64位寄存器可存储8字节。寄存器访问速度一般是半个CPU时钟周期,属于纳秒级别, L1缓存:每个CPU核心都有,用来缓存数据跟指令,访问空间大小一般在32~256KB,访问速度一般是2~4个CPU时钟周期。 cat/sys/devices/system/cpu/cpu0/cache/index0/size#L1数据缓存 cat/sys/devices/system/cpu/cpu0/cache/index1/size#L1指令缓存 L2缓存:每个CPU核心都有,访问空间大小在128KB~2MB,访问速度一般是10~20个CPU时钟周期。 cat/sys/devices/system/cpu/cpu0/cache/index2/size#L2缓存容量大小 L3缓存:多个CPU核心共用,访问空间大小在2MB~64MB,访问速度一般是20~60个CPU时钟周期。 cat/sys/devices/system/cpu/cpu0/cache/index3/size#L3缓存容量大小 内存:多个CPU共用,现在一般是4G~512G,访问速度一般是200~300个CPU时钟周期。 固体硬盘SSD:现在台式机主流都会配备,上述的寄存器、缓存、内存都是断电数据立马丢失的,而SSD里不会丢失,大小一般是128G~1T,比内存慢10~1000倍。 机械盘HDD:很早以前流行的硬盘了,容量可在512G~8T不等,访问速度比内存慢10W倍不等。 访问数据顺序:CPU在拿数据处理的时候几乎也是按照上面说得流程来操纵的,只有上面一层找不到才会找下一层。 Cache Line : CPU读取数据时会按照 Cache Line 方式把数据加载到缓存中,每个Cacheline = 64KB,因为L1、L2是每个核独有到可能会触发伪共享,就是 所以可能会将数据划分到不同到CacheLine中来避免伪共享,比如在JDK8 新增加的 LongAdder 就涉及到此知识点。 伪共享:缓存系统中是以缓存行(cache line)为单位存储的,当多线程修改互相独立的变量时,如果这些变量共享同一个缓存行,就会无意中影响彼此的性能,这就是伪共享。 JMM: 数据经过种种分层会导致访问速度在不断提升,同时也带来了各种问题,多个CPU同时操作相同数据可能会造成各种BU个,需要加锁,这里在JUC并发已详细探讨过。 1.3 CPU 访问方式 CPU访问方式 内存数据映射到CPU Cache 时通过公式 Block N % CacheLineMax决定内存Block数据放到那个CPU Cache Line 里。CPU Cache 主要有4部分组成。 Cache Line Index :CPU缓存读取数据时不是按照字节来读取的,而是按照CacheLine方式存储跟读取数据的。 Valid Bit : 有效位标志符,值为0时表示无论 CPU Line 中是否有数据,CPU 都会直接访问内存,重新加载数据。 Tag:组标记,用来标记内存中不同BLock映射到相同CacheLine,用Tag来区分不同的内存Block。 Data:真实到内存数据信息。 CPU真实访问内存数据时只需要指定三个部分即可。 Cache Line Index :要访问到Cache Line 位置。 Tag:表示用那个数据块。 Offset:CPU从CPU Cache 读取数据时不是直接读取Cache Line整个数据块,而是读取CPU所需的数据片段,称为Word。如何找到Word就需要个偏移量Offset。 1.4 CPU 访问速度 访问耗时对比 如上图所示,CPU访问速度是逐步变慢,所以CPU访问数据时需尽量在距离CPU近的高速缓存区访问,根据摩尔定律CPU访问速度每18个月就会翻倍,而内存的访问每18个月也就增长10% 左右,导致的结果就是CPU跟内存访问性能差距逐步变大,那如何尽可能提高CPU缓存命中率呢? 1. 数据缓存:遍历数据时候按照内存布局顺序访问,因为CPU Cache是根据Cache Line批量操作数据的,所以你顺序读取数据会提速,道理跟磁盘顺序写一样。 指令缓存:尽可能的提供有规律的条件分支语句,让 CPU 的分支预测器发挥作用,进一步提高执行的效率,因为CPU是自带分支预测器,自动提前将可能需要的指令放到指令缓存区。 线程绑定到CPU:一个任务A在前一个时间片用CPU核心1 运行,后一个时间片用CPU核心2 运行,这样缓存L1、L2就浪费了。因此操作系统提供了将进程或者线程绑定到某一颗 CPU 上运行的能力。如 Linux 上提供了 sched_setaffinity 方法实现这一功能,其他操作系统也有类似功能的 API 可用。当多线程同时执行密集计算,且 CPU 缓存命中率很高时,如果将每个线程分别绑定在不同的 CPU 核心上,性能便会获得非常可观的提升。 1.5 操作系统 计算机结构 有了冯诺伊曼计算机体系后,电脑想要为用户提供便捷的服务还需要安装个操作系统 Operation System,操作系统是覆盖在硬件上的一层特殊软件,它管理计算机的硬件和软件资源,为其他应用程序提供大量服务。可以理解为操作系统是日常应用程序跟硬件之间的接口。日常你经常在用Windows/Linux 系统,操作系统给我们提供了超级大的便利,但是你了解操作系统么?操作系统是如何进行 内存管理、 进程管理、 文件管理、 输入输出管理的呢? 2 内存管理 你的电脑是32位操作系统,那可支持的最大内存就是4G,你有没有好奇为什么可以同时运行2个以上的2G内存的程序。应用程序不是直接使用的物理地址,操作系统为每个运行的进程分配了一套虚拟地址,每个进程都有自己的虚拟内存地址,进程是无法直接进行物理内存地址的访问的。至于虚拟地址跟物理地址的映射,进程是感知不到的!操作系统自身会提供一套机制将不同进程的虚拟地址和不同内存的物理地址进行映射。 虚拟内存 2.1 MMU Memory Management Unit 内存管理单元是一种负责处理CPU内存访问请求的计算机硬件。它的功能包括虚拟地址到物理地址的转换、内存保护、中央处理器高速缓存的控制。现代 CPU 基本上都选择了使用 MMU。 当进程持有虚拟内存地址的时候,CPU执行该进程时会操作虚拟内存,而MMU会自动的将虚拟内存的操作映射到物理内存上。 MMU 这里提一下,Java操作的时候你看到的地址是 JVM地址,不是真正的物理地址。 2.2 内存管理方式 操作系统主要采用内存分段和内存分页来管理虚拟地址与物理地址之间的关系,其中分段是很早前的方法了,现在大部分用的是分页,不过分页也不是完全的分页,是在分段的基础上再分页。 2.2.1 内存分段 JVM内存模型 我们以上图的JVM内存模型举例,程序员会认为我们的代码是由代码段、数据段、栈段、堆段组成。不同的段是有不同的属性的,用户并不关心这些元素所在内存的位置,而分段就是支持这种用户视图的内存管理方案。逻辑地址空间是由一组段构成。每个段都有名称和长度。地址指定了段名称和段内偏移。因此用户段编号和段偏移来指定不同属性的地址。而虚拟内存地址跟物理内存地址中间是通过段表进行映射的,口说无凭,看图吧。 内存分段管理 如上虚拟地址有 5 个段,各段按如图所示来存储。每个段都在段表中有一个条目,它包括段在物理内存内的开始的基地址和该段的界限长度。例如段 2 为 400 字节长,开始于位置 4300。因此对段 2 字节 53 的引用映射成位置 4300 + 53 = 4353。对段 3 字节 852 的引用映射成位置 3200 + 852 = 4052。 分段映射很简单,但是会导致内存碎片跟内存交互效率低。这里先普及下在内存管理中主要有内部内存碎片跟外部内存碎片。 内部碎片:已经被分配出去的的内存空间不经常使用,并且分配出去的内存空间大于请求所需的内存空间。 外部碎片:指可用空间还没有分配出去,但是可用空间由于大小太小而无法分配给申请空间的新进程的内存空间空闲块。 以上图为例,现在系统空闲是1400 + 800 + 600 = 2800。那如果有个程序想要连续的使用2000,内存分段模式下提供不了啊!上述三个是外部内存碎片。当然可以使用系统的Swap空间,先把段0写入到磁盘,然后再重新给段0分配空间。这样可以实现最终可用,可是但凡涉及到磁盘读写就会导致内存交互效率低。 swap空间利用 2.2.2 内存分页 内存分页,整个虚拟内存和物理内存切成一段段固定尺寸的大小。每个固定大小的尺寸称之为页Page,在 Linux 系统中Page = 4KB。然后虚拟内存跟物理内存之间通过页表来实现映射。 采用内存分页时内存的释放跟使用都是以页为单位的,也就不会产生内存碎片了。当空间还不够时根据操作系统调度算法,可能将最少用的内存页面 swap-out换出到磁盘,用时候再swap-in换入,尽可能的减少磁盘刷写量,提高内存交互效率。 分页模式下虚拟地址主要有页号跟页内偏移量两部分组成。通过页号查询页表找到物理内存地址,然后再配合页内偏移量就找到了真正的物理内存地址。 分页内存寻址 32位操作系统环境下进程可操作的虚拟地址是4GB,假设一个虚拟页大小为4KB,那需要4GB/4KB = 2^20 个页信息。一行页表记录为4字节,2^20等价于4MB页表存储信息。这只是一个进程需要的,如果10个、100个、1000个呢?仅仅是页表存储都占据超大内存了。 为了解决这个问题就需要用到 多级页表,核心思想就是局部性分配。在32位的操作系统中将将4G空间分为 1024 行页目录项目(4KB),每个页目录项又对应1024行页表项。如下图所示: 32位系统二级分页 控制寄存器cr3中存放了页目录的物理地址,通过cr3寄存器可以找到页目录,而32位线性地址中的Directory部分决定页目录中的目录项,而页目录项中存放了要找的页表的物理基地址,再结合线性地址中的中间10位页表项,就可以找到页框的页表项。线性地址中的Offset部分占12位,因此页框的物理地址 + 线性地址Offset部分 = 页框中的任何一个字节。 分页后一级页就等价于4G虚拟地址空间,并且如果一级页表中那些地址没有就不需要再创建二级页表了!核心思想就是按需创建,当系统给每个进程分配4G空间,进程不可能占据全部内存的,如果一级目录页只有10%用到了,此时页表空间 = 一级页表4KB + 0.1 * 4MB 。这比单独的每个进程占据4M好用多了! 多层分页的弊端就是访问时间的增加。 使用页表时读取内存中一页内容需要2次访问内存,访问页表项 + 并读取的一页数据。 使用二级页表的话需要三次访问,访问页目录项 + 访问页表项 + 访问并读取的一页数据。访存次数的增加也就意味着访问数据所花费的总时间增加。 而对于64位系统,二级分页就无法满足了,Linux 从2.6.11开始采用四级分页模型。 Page Global Directory 全局页目录项 Page Upper Directory 上层页目录项 Page Middle Directory 中间页目录项 Page Table Entry 页表项 Offset 偏移量。 64位寻址 2.2.2 TLB Translation Lookaside Buffer 可翻译为地址转换后援缓冲器,简称为快表,属于CPU内部的一个模块,TLB是MMU的一部分,实质是cache,它所缓存的是最近使用的数据的页表项(虚拟地址到物理地址的映射)。他的出现是为了加快访问数据(内存)的速度,减少重复的页表查找。当然它不是必须要有的,但有它,速度就更快。 TLB TLB很小,因此缓存的东西也不多。主要缓存最近使用的数据的数据映射。TLB结构如下图: TLB查询 如果一个需要访问内存中的一个数据,给定这个数据的虚拟地址,查询TLB,发现有hit,直接得到物理地址,在内存根据物理地址取数据。如果TLB没有这个虚拟地址miss,那么只能费力的通过页表来查找了。日常CPU读取一个数据的流程如下: CPU读取数据流程图 当进程地址空间进行了 上下文切换时,比如现在是进程1运行,TLB中放的是进程1的相关数据的地址,突然切换到进程2,TLB中原有的数据不是进程2相关的,此时TLB刷新数据有两种办法。 全部刷新:很简单,但花销大,很多不必刷新的数据也进行刷新,增加了无畏的花销。 部分刷新:根据标志位,刷新需要刷新的数据,保留不需要刷新的数据。 2.2.3 段页式管理 内存分段跟内存分页不是对立的,这俩可以组合起来在同一个系统中使用的,那么组合起来后通常称为段页式内存管理。段页式内存管理实现的方式: 先对数据不同划分出不同的段,也就是前面说的分段机制。 然后再把每一个段进行分页操作,也就是前面说的分页机制。 此时 地址结构 = 段号 + 段内页号 + 页内位移。 每一个进程有一张段表,每个段又建立一张页表,段表中的地址是页表的起始地址,而页表中的地址则为某页的物理页号。 段页式管理 同时我们经常看到两个专业词 逻辑地址跟 线性地址。 逻辑地址:指的是没被段式内存管理映射的地址。 线性地址:通过段式内存管理映射且页式内存管理转换前的地址,俗称虚拟地址。 目前 Intel X86 CPU 采用的是内存分段 + 内存分页的管理方式,其中分页的意思是在由段式内存管理所映射而成的的地址上再加上一层地址映射。 X86内存管理方式 2.2.4 Linux 内存管理 先说结论:Linux系统基于X86 CPU 而做的操作系统,所以也是用的段页式内存管理方式。 我们知道32位的操作系统可寻址范围是4G,操作系统会将4G的可访问内存空间分为 用户空间跟 内核空间。 内核空间:操作系统内核访问的区域,独立于普通的应用程序,是受保护的内存空间。内核态下CPU可执行任何指令,可自由访问任何有效地址。 用户空间:普通应用程序可访问的内存区域。被执行代码会受到CPU众多限制,进程只能访问映射其地址空间的页表项中规定的在用户态下可访问页面的虚拟地址。 那为啥要搞俩空间呢?现在嵌入式环境跟以前的WIN98系统是没有区分俩空间的,须知俩空间是CPU分的,而操作系统是在上面运行的,单一用户、单一任务服务的操作系统,是没有分所谓用户态和内核态的必要。用户态和内核态是因为有多用户,多任务的需求,然后在CPU硬件厂商配合之后,产生的一个操作系统解决多用户多任务需求的方案。方案就是限制,通过硬件手段(也只能硬件手段才能做到),限制某些代码,使其无法控制整个物理硬件,进而使各个不同用户,不同任务的代码,无权修改整个物理硬件,再进而保护操作系统的核心底层代码和其他用户的数据不被无意或者有意地破坏和盗取。 后来研究者根据 CPU的运行级别,分成了Ring0~Ring3四个级别。Ring0是最高级别,Ring1次之,Rng2更次之,拿Linux+x86来说, 操作系统内核的代码运行在最高运行级别Ring0上,可以使用特权指令,控制中断、修改页表、访问设备等。应用程序的代码运行在最低运行级别上Ring3上,不能做受控操作,只能访问用户被分配的空间。如果要做访问磁盘跟写文件等操作,那就要通过执行系统调用函数,执行系统调用的时候,CPU的运行级别会发生从Ring3到Ring0的切换,并跳转到系统调用对应的内核代码位置执行,这样内核就为你完成了设备访问,完成之后再从Ring0返回Ring3。这个过程也称作 用户态和内核态的切换。 用户态想要使用计算机设备或IO需通过系统调用完成sys call,系统调用就是让内核来做这些操作。而系统调用是影响整个当前进程上下文的,CPU提供了个软中断来是实现保护线程,获取系统调用号跟参数,交给内核对应系统调用函数执行。 Linux系统结构 可以看到每个应用程序都各自有独立的虚拟内存地址,但每个虚拟内存中对应的内核地址其实是相同的一大块,这样当进程切换到内核态后可以很方便地访问内核空间内存。比如Java代码创建线程 new Thread调用 start方法后跟踪 JVM源码你会发现是调用 pthread_create来创建线程的,这就涉及到了用户态到内核态的切换。 3 进程管理 3.1 进程基础知识 进程是程序的一次执行,是一个程序及其数据在机器上顺序执行时所发生的活动,是具有独立功能的程序在一个数据集合上的一次运行过程,是系统进行资源分配和调度的一个基本单位。进程的调度状态如下: 状态变化图 重点说下 挂起跟 阻塞: 阻塞一般是当系统执行IO操作时,此时进程进入阻塞状态,等待某个事件的返回。 挂起是指进程没有占有物理内存,被写到磁盘上了。这时进程状态是挂起状态。 阻塞挂起:进程被写入硬盘并等待某个事件的出现。 就绪挂起:进程被写入硬盘,进入内存可直接进入就绪状态。 3.2 PCB 为了描述跟控制进程的运行,系统为每个进程定义了一个数据结构——进程控制块 Process Control Block,它是进程实体的一部分,是操作系统中最重要的记录型数据结构。 PCB 的作用是使一个在多道程序环境下不能独立运行的程序,成为一个能独立运行的基本单位,一个能与其它进程并发执行的进程 : 作为独立运行基本单位的标志 实现间断性的运行方式 提供进程管理所需要的信息 提供进程调度所需要的信息 实现与其他进程的同步与通信 3.2.1 PCB 信息 PCB为实现上述功能,内部包含众多信息: 进程标识符:用于唯一地标识一个进程,一个进程通常有两种标识符: 内部进程标识符:标识各个进程,每个进程都有一个并且唯一的标识符,设置内部标识符主要是为了方便系统使用。 外部进程标识符:它由创建者提供,可设置用户标识,以指示拥有该进程的用户。往往是由用户进程在访问该进程时使用。一般为了描述进程的家族关系,还应设置父进程标识及子进程标识。 处理机状态:由各种寄存器组成。包含许多信息都放在寄存器中,方便程序restart。 通用寄存器、指令计数器、程序状态字PSW、用户栈指针等信息。 进程调度信息 进程状态:指明进程的当前状态,作为进程调度和对换时的依据。 进程优先级:用于描述进程使用处理机的优先级别的一个整数,优先级高的进程应优先获得处理机 进程调度所需的其它信息:与所采用的进程调度算法有关,如进程已等待CPU的时间总和、进程已执行的时间总和等。 事件:指进程由执行状态转变为阻塞状态所等待发生的事件,即阻塞原因。 资源清单 有关内存地址空间或虚拟地址空间的信息,所打开文件的列表和所使用的 I/O 设备信息。 3.2.2 PCB 组织方式 操作系统中有太多 PCB,如何管理是个问题,一般有如下方式。 线下数组 线性方式: 将系统所有PCB都组织在一张线性表中,将该表首地址存在内存的一个专用区域 实现简单,开销小,但是每次都需要扫描整张表,适合进程数目不多的系统 索引方式 索引方式: 将同一状态的进程组织在一个索引表中,索引表项指向相应的 PCB,不同状态对应不同的索引表。 链表方式 链接方式: 把同一状态的PCB链接成一个队列,形成就绪队列、阻塞队列、空白队列等。对其中的就绪队列常按进程优先级的高低排列,优先级高排在队前。 因为进程创建、销毁、调度频繁,所以一般采用此模式。 3.3 进程控制 进程控制是进程管理最基本的功能,主要包括创建新进程,终止已完成的进程,将发生异常的进程置于阻塞状态,将进程唤醒等。 3.3.1 进程创建 父进程可创建子进程,父进程终止后子进程也会被终止。子进程可继承父进程所有资源,子进程终止需将自己所继承的资源归还父进程。接下来看下创建的大致流程。 为新进程分配唯一进件标识号,然后创建一个空白PCB,需注意PCB数量是有限的,所以可能会创建失败。 尝试为新进程分配所需资源,如果资源不足进程会进入等待状态。 初始化PCB,有如下几个操作。 标识信息:将系统分配的标识符和父进程标识符填入新PCB 处理机状态信息:使程序计数器指向程序入口地址,使栈指针指向栈顶 处理机控制信息:将进程设为就绪/静止状态,通常设为最低优先级 如果进程调度队列能接纳新进程,就将进程插入到就绪队列,等待被调度运行。 3.3.2 进程终止 进程终止情况一般分为正常结束、异常结束、外界干预三种。 正常结束 异常结束 越界错:访问的存储区越出该进程的区域 保护错:试图访问不允许访问的资源,或以不适当的方式访问(写只读) 非法指令:试图执行不存在的指令(可能是程序错误地转移到数据区,数据当成了指令) 特权指令出错:用户进程试图执行一条只允许OS执行的指令 运行超时:执行时间超过指定的最大值 等待超时:进程等待某件事超过指定的最大值 算数运算错:试图执行被禁止的运算(被0除) I/O故障 外界干预 操作员或OS干预(死锁) 父进程请求,子进程完成父进程指定的任务时 父进程终止,所有子进程都应该结束 终止过程: 根据被终止进程的标识符,从PCB集合中检索出该PCB,读取进程状态 若处于执行状态则立即终止执行,将CPU资源分配给其他进程。 若进程有子孙进程则将其所有子孙进程终止。 全部资源还给父进程或操作系统。 该进程的PCB从所在队列/链表中移出。 3.3.3 进程阻塞 意思是该进程执行半路被阻塞,必须由某个事件进程唤醒该进程。常见的就是IO读取操作。常见阻塞时机/事件如下: 请求共享资源失败,系统无足够资源分配 等待某种操作完成 新数据尚未到达(相互合作的进程) 等待新任务 阻塞流程: 找到要被阻塞进程标识号对应的 PCB。 将该进程由运行状态转换为阻塞状态。 将该 进程PCB 插入的阻塞队列中去。 3.3.4 进程唤醒 唤醒 原语 wake up,一般和阻塞成对使用。唤醒过程如下: 从阻塞队列找到所需PCB。 PCB从阻塞队列溢出,然后变为就绪状态。 从阻塞队列溢出该PCB然后插入到就绪状态队列等待被分配CPU资源。 3.4 进程调度 进程数一般会大于CPU个数,进程状态切换主要由调度程序进行调度。一般情况下CPU调度时主要分为抢占式调度跟非抢占式调度。 非抢占式:让进程运行直到结束或阻塞的调度方式, 容易实现,适合专用系统。 抢占式:每个进程获得时间片才可以被CPU调度运行, 可防止单一进程长时间独占CPU 系统开销大。 3.4.1 进程调度原则 CPU 利用率 CPU利用率 = 忙碌时间 / 总时间。 调度程序应该尽量让 CPU 始终处于忙碌的状态,这可提高 CPU 的利用率。比如当发生IO读取时候,不要傻傻等待,去执行下别的进程。 系统吞吐量 系统吞吐量 = 总共完成多少个作业 / 总共花费时间。 长作业的进程会占用较长的 CPU 资源导致降低吞吐量,相反短作业的进程会提升系统吞吐量。 周转时间 周转时间 = 作业完成时间 - 作业提交时间。 平均周转时间 = 各作业周转时间和 / 作业数 带权周转时间 = 作业周转时间 / 作业实际运行时间 平均带权周转时间 = 各作业带权周转时间之和 / 作业数 尽可能使周转时间降低。 等待时间 指的是进程在等待队列中等待的时间,一般也需要尽可能短。 响应时间 响应时间 = 系统第一次响应时间 - 用户提交时间,在交互式系统中响应时间是衡量调度算法好坏的主要标准。 3.4.2 调度算法 FCFS 算法 First Come First Severd 先来先服务算法,遵循先来后端原则,每次从就绪队列拿等待时间最久的,运行完毕后再拿下一个。 该模式对长作业有利,适用 CPU 繁忙型作业的系统,不适用 I/O 型作业,因为会导致进程CPU利用率很低。 SJF 算法 Shortest Job First 最短作业优先算法,该算法会优先选择运行所需时间最短的进程执行,可提高吞吐量。 跟FCFS正好相反,对长作业很不利。 SRTN 算法 Shortest Remaining Time Next 最短剩余时间优先算法,可以认为是SJF的抢占式版本,当一个新就绪的进程比当前运行进程具有更短完成时间时,系统抢占当前进程,选择新就绪的进程执行。 有最短的平均周转时间,但不公平,源源不断的短任务到来,可能使长的任务长时间得不到运行。 HRRN 算法 Highest Response Ratio Next 最高响应比优先算法,为了平衡前面俩而生,按照响应优先权从高到低依次执行。属于前面俩的折中权衡。 优先权 = (等待时间 + 要求服务时间) / 要求服务时间 RR 算法 Round Robin 时间片轮转算法,操作系统设定了个时间片Quantum,时间片导致每个进程只有在该时间片内才可以运行,这种方式导致每个进程都会均匀的获得执行权。 时间片一般20ms~50ms,如果太小会导致系统频繁进行上下文切换,太大又可能引起对短的交互请求的响应变差。 HPF 算法 Highest Priority First 最高优先级调度算法,从就绪队列中选择最高优先级的进程先执行。 优先级的设置有初始化固定死的那种,也有在代码运转过程中根据等待时间或性能动态调整 这两种思路。 缺点是可能导致低优先级的一直无法被执行。 MFQ 算法 Multilevel Feedback Queue 多级反馈队列调度算法 ,可以认为是 RR 算法 跟 HPF 算法 的综合体。 系统会同时存在多个就绪队列,每个队列优先级从高到低排列,同时优先级越高获得是时间片越短。 新进程会先加入到最高优先级队列,如果新进程优先级高于当前在执行的进程,会停止当前进程转而去执行新进程。新进程如果在时间片内没执行完毕需下移到次优先级队列。 多级反馈队列调度算法 3.5 线程 3.5.1 线程定义 早期操作系统是没有线程概念的,线程是后来加进来的。为啥会有线程呢?那是因为以前在多进程阶段,经常会涉及到进程之间如何通讯,如何共享数据的问题。并且进程关联到PCB的生命周期,管理起来开销较大。为了解决这个问题引入了线程。 线程是进程当中的一个执行流程。同一个进程内的多个线程之间可以共享进程的代码段、数据段、打开的文件等资源。同时每个线程又都有一套独立的寄存器和栈来确保线程的控制流是独立的。 进程有个PCB来管理,同理操作系统通过 Thread Control Block线程控制块来实现线程的管控。 3.5.2 线程优缺点 优点 一个进程中可以同时存在1~N个线程,这些线程可以并发的执行。 各个线程之间可以共享地址空间和文件等资源。 缺点 当进程中的一个线程奔溃时,会导致其所属进程的所有线程奔溃。 多线程编程,让人头大的东西。 线程执行开销小,但不利于资源的隔离管理和保护,而进程正相反。 3.5.3 进程跟线程关联 进程: 是系统进行资源分配和调度的一个独立单位. 是程序的一次执行,每个进程都有自己的地址空间、内存、数据栈及其他辅助记录运行轨迹的数据 线程: 是进程的一个实体,是CPU调度和分派的基本单位,它是比进程更小的能独立运行的基本单位 所有的线程运行在同一个进程中,共享相同的运行资源和环境 线程一般是并发执行的,使得实现了多任务的并行和数据共享。 进程线程区别: 一个线程只能属于一个进程,而一个进程可以有多个线程,但至少有一个线程。 线程的划分尺度小于进程(资源比进程少),使得多线程程序的并发性高。 进程在执行过程中拥有独立的内存单元,而多个线程共享内存,从而极大地提高了程序的运行效率。 资源分配给进程,同一进程的所有线程共享该进程的所有资源。 CPU分配资源给进程,但真正在CPU上运行的是线程。 线程不能够独立执行,必须依存在进程中。 线程快在哪儿? 线程创建的时有些资源不需要自己管理,直接从进程拿即可,线程管理寄存器跟栈的生命周期即可。 同进程内多线程共享数据,所以进程数据传输可以用zero copy技术,不需要经过内核了。 进程使用一个虚拟内存跟页表,然后多线程共用这些虚拟内存,如果同进程内两个线程进行上下文切换比进程提速很多。 3.5.4 线程实现 在前面的内存管理中说到了内核态跟用户态。相对应的线程的创建也分为用户态线程跟内核态线程。 3.5.4.1 用户态线程 在用户空间实现的线程,由用户态的线程库来完成线程的管理。操作系统按进程维度进行调度,当线程在用户态创建时应用程序在用户空间内要实现线程的创建、维护和调度。操作系统对线程的存在一无所知!操作系统只能看到进程看不到线程。所有的线程都是在用户空间实现。在操作系统看来,每一个进程只有一个线程。 用户态线程 好处: 及时操作系统不支持线程模式也可以通过用户层库函数来支持线程模式,TCB 由用户级线程库函数来维护。 使用库函数模式实现线程可以避免用户态到内核态的切换。 坏处: CPU不知道线程存在,CPU的时间片切换是以进程为维度的,某个线程因为IO等操作导致线程阻塞,操作系统会阻塞整个进程,即使这个进程中其它线程还在工作。 用户态线程没法打断正在运行中的线程,除非线程主动交出CPU使用权。 3.5.4.2 内核态线程 在内核中实现的线程,是由内核管理的线程,线程对应的 TCB 在操作系统里,这样线程的创建、终止和管理都是由操作系统负责。内线程模式下一个用户线程对应一个内核线程。 内核态线程 注意:Linux中的JVM从1.2版以后是基于pthread实现的, 所以现在Java中线程的本质就是操作系统中的线程。 优点: 一个进程中某个线程阻塞不会影响其他内核线程运行。 用户态模式一个时间片分给多个线程,内核态模式直接分配给线程的时间片增加。 缺点: 内核级线程调度开销较大。调度内核线程的代价可能和调度进程差不多昂贵,代价要比用户级线程大很多。一个线程默认栈=1M,线程多了会导致内存消耗很大。 线程表是存放在操作系统固定的表格空间或者堆栈空间里,所以内核级线程的数量是有限的。 3.4.4.3 轻量级进程 最初的进程定义都包含程序、资源及其执行三部分,其中程序通常指代码,资源在操作系统层面上通常包括内存资源、IO资源、信号处理等部分,而程序的执行通常理解为执行上下文,包括对CPU的占用,后来发展为线程。在线程概念出现以前,为了减小进程切换的开销,操作系统设计者逐渐修正进程的概念,逐渐允许将进程所占有的资源从其主体剥离出来,允许某些进程共享一部分资源,例如文件、信号,数据内存,甚至代码,这就发展出轻量进程的概念。 Light-weight process 轻量级进程是内核支持的用户线程,它是基于内核线程的高级抽象,系统只有先支持内核线程才能有 LWP。一个进程可有1~N个LWP,每个 LWP 是跟内核线程一对一映射的,也就是 LWP 都是由一个内核线程支持。 LWP模式 轻量级进程本质还是进程,只是跟普通进程相比LWP跟其他进程共享大部分逻辑地址空间跟系统资源,LWP轻量体现在它只有一个最小的执行上下文和调度程序所需的统计信息。他是进程的执行部分,只带有执行相关的信息。 Linux特性: Linux中没有真正的线程,因为Linux并没有为线程准备特定的数据结构。在内核看来只有进程而没有线程,在调度时也是当做进程来调度。Linux所谓的线程其实是与其他进程共享资源的进程。但windows中确实有线程。 Linux中没有的线程,线程是由进程来模拟实现的。 所以在Linux中在CPU角度看,进程被称作轻量级进程LWP。 3.5.5 协程 3.5.5.1 协程定义 大多数web服务跟互联网服务本质上大部分都是 IO 密集型服务,IO 密集型服务的瓶颈不在CPU处理速度,而在于尽可能快速的完成高并发、多连接下的数据读写。以前有两种解决方案: 多进程:存在频繁调度切换问题,同时还会存在每个进程资源不共享的问题,需要额外引入进程间通信机制来解决。 多线程:高并发场景的大量 IO 等待会导致多线程被频繁挂起和切换,非常消耗系统资源,同时多线程访问共享资源存在竞争问题。 此时协程出现了,协程 Coroutines 是一种比线程更加轻量级的微线程。类比一个进程可以拥有多个线程,一个线程也可以拥有多个协程。可以简单的把协程理解成子程序调用,每个子程序都可以在一个单独的协程内执行。 协程 协程运行在线程之上,当一个协程执行完成后,可以选择主动让出,让另一个协程运行在当前线程之上。 协程并没有增加线程数量,只是在线程的基础之上通过分时复用的方式运行多个协程,而且协程的切换在用户态完成,切换的代价比线程从用户态到内核态的代价小很多,一般在Python、Go中会涉及到协程的知识,尤其是现在高性能的脚本Go。 3.5.5.2 协程注意事项 协程运行在线程之上,并且协程调用了一个阻塞IO操作,此时操作系统并不知道协程的存在,它只知道线程,因此在协程调用阻塞IO操作时,操作系统会让线程进入阻塞状态,当前的协程和其它绑定在该线程之上的协程都会陷入阻塞而得不到调度。 因此在协程中不能调用导致线程阻塞的操作,比如打印、读取文件、Socket接口等。协程只有和异步IO结合起来才能发挥最大的威力。并且协程只有在IO密集型的任务中才会发挥作用。 3.6 进程通信 进程的用户地址空间是相互独立的,不可以互相访问,但内核空间是进程都共享的,所以进程之间要通信必须通过内核。进程间通信主要通过管道、消息队列、共享内存、信号量、信号、Socket编程。 3.6.1 管道 管道主要分为匿名管道跟命名管道两种,可以实现数据的单向流动性。使用起来很简单,但是管道这种通信方式效率低,不适合进程间频繁地交换数据。 匿名管道: 日常Linux系统中的|就是匿名管道。指令的前一个输入是后一个指令的输出。 命名管道: 一般通过mkfifo SoWhatPipe创建管道。通过echo "sw" &gt; SoWhatPipe跟cat &lt; SoWhatPipe 实现输入跟输出。 匿名管道的实现依赖int pipe(int fd[2])函数,其中fd[0]是读取断描述符,fd[1]是管道写入端描述符。它的本质就是在内核中创建个属于内存的缓存,从一端输入无格式数据一端输出无格式数据,需注意管道传输大小是有限的。 管道通信底层 匿名管道的通信范围是存在父子关系的进程。由于管道没有实体,也就是没有管道文件,不会涉及到文件系统。只能通过 fork子进程来复制父进程 fd 文件描述符,父子进程通过共用特殊的管道文件实现跨进程通信,并且因为管道只能一端写入,另一端读出,所以通常父子进程遵从如下要求: 父进程关闭读取的 fd[0],只保留写入的 fd[1]。 子进程关闭写入的 fd[1],只保留读取的 fd[0]。 shell管道通信 需注意Shell执行匿名管道 a | b其实是通过Shell父进程fork出了两个子进程来实现通信的,而ab之间是不存在父子进程关系的。而命名管道是可以直接在不想关进程间通信的,因为有管道文件。 3.6.2 消息队列 消息队列 消息队列是保存在 内核中的消息链表, 会涉及到用户态跟内核态到来回切换,双方约定好消息体到数据结构,然后发送数据时将数据分成一个个独立的数据单元消息体,需注意消息队列及单个消息都有上限,日常我们到 RabbitMQ、 Redis 都涉及到消息队列。 3.6.3 共享内存 共享空间 现代操作系统对内存管理采用的是虚拟内存技术,也就是每个进程都有自己独立的虚拟内存空间,不同进程的虚拟内存映射到不同的物理内存中。所以,即使进程A和进程B虚拟地址是一样的,真正访问的也是不同的物理内存地址,该模式不涉及到用户态跟内核态来回切换,JVM 就是用的共享内存模式。并且并发编程也是个难点。 3.6.4 信号量 既然共享内存容易造成数据紊乱,那为了简单的实现共享数据在任意时刻只能被一个进程访问,此时需要信号量。 信号量其实是一个整型的计数器,主要用于实现进程间的互斥与同步,而不是用于缓存进程间通信的数据。 信号量表示资源的数量,核心点在于原子性的控制一个数据的值,控制信号量的方式有PV两种原子操作: P 操作会把信号量减去 -1,相减后如果信号量 < 0,则表明资源已被占用,进程需阻塞等待。相减后如果信号量 >= 0,则表明还有资源可使用,进程可正常继续执行。 V 操作会把信号量加上 1,相加后如果信号量 <= 0,则表明当前有阻塞中的进程,于是会将该进程唤醒运行。相加后如果信号量 > 0,则表明当前没有阻塞中的进程。 3.6.5 信号 对于异常状态下进程工作模式需要用到信号工作方式来通知进程。比如Linux系统为了响应各种事件提供了很多异常信号kill -l,信号是进程间通信机制中唯一的异步通信机制,可以在任何时候发送信号给某一进程。比如: kill -9 1412 ,表示给 PID 为 1412 的进程发送 SIGKILL 信号,用来立即结束该进程。 键盘 Ctrl+C 产生 SIGINT 信号,表示终止该进程。 键盘 Ctrl+Z 产生 SIGTSTP 信号,表示停止该进程,但还未结束。 有信号发生时,进程一般有三种方式响应信号: 执行默认操作:Linux操作系统为众多信号配备了专门的处理操作。 捕捉信号:给捕捉到的信号配备专门的信号处理函数。 忽略信号:专门用来忽略某些信号,但 SIGKILL 和 SEGSTOP是无法被忽略的,为了能在任何时候结束或停止某个进程而存在。 3.6.6 Socket编程 前面提到的管道、消息队列、共享内存、信号量和信号都是在同一台主机上进行进程间通信,那要想跨网络与不同主机上的进程之间通信,就需要 Socket 通信。 intsocket(intdomain,inttype,intprotocal) 上面是socket编程的核心函数,可以指定IPV4或IPV6类型,TCP或UDP类型。比如TCP协议通信的 socket 编程模型如下: Socket编程 服务端和客户端初始化 socket,得到文件描述符。 服务端调用bind,将绑定在 IP 地址和端口。 服务端调用 listen,进行监听。 服务端调用 accept,等待客户端连接。 客户端调用 connect,向服务器端的地址和端口发起连接请求。 服务端 accept 返回用于传输的 socket 的文件描述符。 客户端调用 write 写入数据,服务端调用 read 读取数据。 客户端断开连接时,会调用 close,那么服务端 read 读取数据的时候,就会读取到了EOF,待处理完数据后,服务端调用 close,表示连接关闭。 服务端调用 accept时,连接成功会返回一个已完成连接的 socket,后续用来传输数据。服务端有俩socket,一个叫作监听 socket,一个叫作已完成连接 socket。 成功连接建立之后双方开始通过 read 和 write 函数来读写数据。 UDP传输 UDP比较简单,属于类似广播性质的传输,不需要维护连接。但也需要 bind,每次通信时调用 sendto 和 recvfrom 都要传入目标主机的 IP 地址和端口。 3.7 多线程编程 既然多进程开销过大,那平常我们经常使用到的就是多线程编程了。期间可能涉及到内存模型、JMM、Volatile、临界区等等。这些在Java并发编程专栏有讲。 4 文件管理 4.1 VFS 虚拟文件系统 文件系统在操作系统中主要负责将文件数据信息存储到磁盘中,起到持久化文件的作用。文件系统的基本组成单元就是文件,文件组成方式不同就会形成不同的文件系统。 文件系统有很多种而不同的文件系统应用到操作系统后需要提供统一的对外接口,此时用到了一个设计理念没有什么是加一层解决不了的,在用户层跟不同的文件系统之间加入一个虚拟文件系统层 Virtual File System。 虚拟文件系统层定义了一组所有文件系统都支持的数据结构和标准接口,这样程序员不需要了解文件系统的工作原理,只需要了解 VFS 提供的统一接口即可。 虚拟文件系统 日常的文件系统一般有如下三种: 磁盘文件系统:就是我们常见的EXT 2/3/4系列。 内存文件系统:数据没存储到磁盘,占用内存数据,比如/sys、/proc。进程中的一些数据映射到/proc中了。 网络文件系统:常见的网盘挂载NFS等,通过访问其他主机数据实现。 4.2 文件组成 以Linux系统为例,在Linux系统中一切皆文件,Linux文件系统会为每个文件分配索引节点 inode跟目录项directory entry来记录文件内容跟目录层次结构。 4.2.1 inode 要理解inode要从文件储存说起。文件存储在硬盘上,硬盘的最小存储单位叫做扇区。每个扇区储存512字节。操作系统读取硬盘的时候,不会一个个扇区的读取,这样效率太低,一般一次性连续读取8个扇区(4KB)来当做一块,这种由多个扇区组成的块,是文件存取的最小单位。 文件数据都储存在块中,我们还必须找到一个地方储存文件的元信息,比如inode编号、文件大小、创建时间、修改时间、磁盘位置、访问权限等。几乎除了文件名以为的所有文件元数据信息都存储在一个叫叫索引节点inode的地方。可通过stat 文件名查看 inode 信息 每个inode都有一个号码,操作系统用inode号码来识别不同的文件。Unix/Linux系统内部不使用文件名,而使用inode号码来识别文件,用户可通过ls -i查看每个文件对应编号。对于系统来说文件名只是inode号码便于识别的别称或者绰号。特殊名字的文件不好删除时可以尝试用inode号删除,移动跟重命名不会导致文件inode变化,当用户尝试根据文件名打开文件时,实际上系统内部将这个过程分成三步: 系统找到这个文件名对应的inode号码。 通过inode号码,获取inode信息,进行权限验证等操作。 根据inode信息,找到文件数据所在的block,读出数据。 需注意 inode也会消耗硬盘空间,硬盘格式化后会被分成超级块、索引节点区和数据块区三个区域: 超级块区:用来存储文件系统的详细信息,比如块大小,块个数等信息。一般文件系统挂载后就会将数据信息同步到内存。 索引节点区:用来存储索引节点 inode table。每个inode一般为128字节或256字节,一般每1KB或2KB数据就需设置一个inode。一般为了加速查询会把索引数据缓存到内存。 数据块区:真正存储磁盘数据的地方。 df-i#查看每个硬盘分区的inode总数和已经使用的数量 sudodumpe2fs-h/dev/hda|grep"Inodesize"#查看每个inode节点的大小 4.2.2 目录 Unix/Linux系统中目录directory也是一种文件,打开目录实际上就是打开目录文件。目录文件内容就是一系列目录项的列,目录项的内容包含文件的名字、文件类型、索引节点指针以及与其他目录项的层级关系。 为避免频繁读取磁盘里的目录文件,内核会把已经读过的目录文件用目录项这个数据结构缓存在内存,方便用户下次读取目录信息,目录项可包含目录或文件,不要惊讶于可以保存目录,目录格式的目录项里面保存的是目录里面一项一项的文件信息。 4.2.3 软连接跟硬链接 软连接跟硬链接 硬链接:老文件A被创建若干个硬链接B、C后。A、B、C三个文件的inode是相同的,所以不能跨文件系统。同时只有ABC全部删除,系统才会删除源文件。 软链接:相当于基于老文件A新建了个文件B,该文件B有新的inode,不过文件B内容是老文件A的路径。所以软链接可以跨文件系统。当老文件A删除后,文件B仍然存在,不过找不到指定文件了。 [sowhat@localhost~]$ln[选项]源文件目标文件 选项: -s:建立软链接文件。如果不加"-s"选项,则建立硬链接文件; -f:强制。如果目标文件已经存在,则删除目标文件后再建立链接文件; 4.3 文件存储 说文件存储前需了解文件系统操作基本单位是数据块,而平常用户操作字节到数据块之间是需要转换的,当然这些文件系统都帮我们对接好了。接下来看文件系统是如何按照数据块, 文件在磁盘中存储时候主要分为连续空间存储跟非连续空间存储 4.3.1 连续空间存储 实现:连续空间存储的意思就跟数组存储一样,找个连续的空间一次性把数据存储进去,文件头存储起始位置跟数据长度即可。 优势:读写效率高,磁盘寻址一次即可。 劣势:容易产生空间碎片,并且文件扩容不方便。 连续存储 4.3.2 非连续空间存储之链表 隐式链表 实现:文件头包含StartBlock、EndBlock。每个BLock有隐藏的next指针,跟单向链表一样。 缺点:只能通过链式不断往下查找数据,不支持快速直接访问。 隐式链表 显式链表 实现:把每个Block中的next指针存储到内存文件分配表中,通过遍历数组方式实现拿到全部数据。 缺点:前面说1KB就有个inode指针,如果磁盘数据很大那就需要很大的文件分配表来存储映射关系了, 显示链表 4.3.3 非连续空间存储之索引 实现:整个文件类型一本新华字典,真实的数据块在词典实际位置存储着,但文件所需数据块的索引位置会被汇总起来形成目录索引放在字典前头。 优势:不会产生碎片,文件可动态扩容,并且支持顺序跟随机读写。 劣势:可能一个小文件都要占用一个目录索引,文件过大导致索引指针一个容不下,可能还需要有多级索引或索引+链表模式。 索引存储 这些存储方式各有利弊,所以操作系统才存储的时候一般是根据文件的大小进行动态的变化存储方式的,跟STL中的快排底层 = 快排 + 插入排序 + 堆排 一样的道理。 4.3.4 空闲空间管理 为了避免用户存储数据时候遍历全部磁盘空间来寻找可以数据块,一般有如下几种记录方法。 空闲表:动态的维护一个空闲数据块列表,每行存储空闲块的开始位置跟空闲长度。适合少量有少量空闲数据块时。 空闲表 空闲链表:将空闲的数据库用next指针串联起来,缺点是不能随机访问。 空闲链表 位图法:利用Bit的 01 表示数据块可用跟不可用,简单方便,inode跟空闲数据库都用的此方法。 位图法 5 输入输出管理 5.1 设备控制器跟驱动程序 5.1.1 设备控制器 设备控制器 操作系统为统一管理众多的设备并且屏蔽设备之间的差异,给每个设备都安装了个小CPU叫 设备控制器。每个设备控制器都知道自己对应外设的功能跟用法,并且每个 设备控制器都有独有的寄存器用来跟CPU通信。 读设备寄存器值了解设备状态,是否可以接收新指令。 操作系统给设备寄存器写入一些指令可以实现发送数据、接收数据等等操作。 控制器一般分为数据寄存器、命令寄存器跟状态寄存器,CPU 通过读、写设备控制器中的寄存器来便捷的控制设备: 数据寄存器:CPU 向 I/O 设备写入需要传输的数据,比如打印what,CPU 就要先发送一个w字符给到对应的 I/O 设备。 命令寄存器:CPU 发送命令来告诉 I/O 设备要进行输入/输出操作,于是就会交给 I/O 设备去工作,任务完成后,会把状态寄存器里面的状态标记为完成。 状态寄存器:用来告诉 CPU 现在已经在工作或工作已经完成,只有状态寄存标记成已完成,CPU 才能发送下一个字符和命令。 同时输入输出设备可分为块设备跟字符设备。 块设备:用来把数据存储在固定大小的块中,每个块有自己的地址,硬盘、U盘等是常见的块设备。块设备一般数据传输较大为避免频繁IO,控制器中有个可读写等数据缓冲区。Linux操作系统为屏蔽不同块设备带来的差异引入了通用块层,通用块层是处于文件系统和磁盘驱动中间的一个块设备抽象层,主要提供如下俩功能: 向上为文件系统和应用程序,提供访问块设备的标准接口,向下把各种不同的磁盘设备抽象为统一的块设备,并在内核层面提供一个框架来管理这些设备的驱动程序。 通用层还会给文件系统和应用程序发来的 I/O进行调度,主要目的是为了提高磁盘读写的效率。 字符设备:以字符为单位发送或接收一个字符流,字符设备是不可寻址的,也没有任何寻道操作,鼠标是常见的字符设备。 CPU一般通过IO端口跟内存映射IO来跟设备的控制寄存器和数据缓冲区进行通信 IO端口:每个控制寄存器被分配一个 I/O 端口,可以通过特殊的汇编指令操作这些寄存器,比如 in/out 类似的指令。 内存映射IO:将所有控制寄存器映射到内存空间中,这样就可以像读写内存一样读写数据缓冲区。 5.1.2 驱动接口 驱动程序 设备控制器屏蔽了设备细节,但每种设备的控制器的寄存器、缓冲区等使用模式都是不同的,它属于硬件。在操作系统图范畴内为了屏蔽设备控制器的差异,引入了设备驱动程序,不同设备到驱动程序会提供统一接口给操作系统来调用,这样操作系统内核会像调用本地代码一样使用设备驱动程序接口。 设备发出IO请求就是在设备驱动程序中来响应到,它会根据中断类型调用响应到中断处理程序进行处理。 中断请求流程 5.2 IO 控制 CPU发送指令让那个设备控制器去读写数据,完毕后如何通知CPU呢? 5.2.1 轮询模式 控制器中有个状态寄存器,CPU不断轮询查看寄存器状态,该模式会傻瓜式的一直占用CPU。 轮询模式 5.2.2 IO 中断请求 中断模式 控制器有个中断控制器,当设备完成任务后触发中断到中断控制器,中断控制器就通知 CPU来处理中断请求。中断有两种,一种是 软中断,比如代码调用 INT 指令触发。一种是 硬件中断,硬件通过中断控制器触发的。但中断方式对于频繁读写磁盘数据的操作就不太友好了,会频繁打断CPU。 这里说下磁盘高速缓存 PageCache,它是用来缓存最近被CPU访问的数据到内存中,并且还具有预读功能,可能你读前16KB数据,已经把后16KB数据给你缓存好了。 pagecache : 页缓存,当进程需读取磁盘文件时,linux先分配一些内存,将数据从磁盘读区到内存中,然后再将数据传给进程。当进程需写数据到磁盘时,linux先分配内存接收用户数据,然后再将数据从内存写到磁盘。同时pagecache由于大小受限,所以一般只缓存最近被访问的数据,数据不足时还需访问磁盘。 5.2.3 DMA 模式 Direct Memory Access 直接内存访问,在硬件DMA控制器的支持下,在进行 I/O 设备和内存的数据传输的时候,数据搬运的工作全部交给 DMA 控制器,而 CPU 不再参与任何与数据搬运相关的事情,让CPU 去处理别的事。 DMA模式 可以发现整个数据传输过程中CPU是不会直接参与数据搬运工作,由DMA来直接负责数据读取工作,现如今每个IO设备一般都自带DMA控制器。读数据时候仅仅在传送开始跟结束时需要CPU干预。 5.2.4 Zero Copy Zero Copy 全程不会通过 CPU 来搬运数据,所有的数据都是通过 DMA 来进行传输的,中间只需要经过2次上下文切换跟2次DMA数据拷贝,相比最原始读写方式至少速度翻倍。其实在Kafka中已经讲过Zero Copy了。 5.2.4.1 老版本读写 老版本的简单读写操作中间不对数据做任何操作。期间会发生4次用户态跟内核态的切换。2次DMA数据拷贝,2次CPU数据拷贝。 老式读写 提速方法就是需减少用户态与内核态的上下文切换和内存拷贝的次数。数据传输时从内核的读缓冲区拷贝到用户的缓冲区,再从用户缓冲区拷贝到 socket 缓冲区的这个过程是没有必要的。接下来 接下来按照三个版本说下Zero Copy 发展史。 5.2.4.2 mmap 跟 write mmap + write 思路就是用 mmap替代read函数,mmap调用时会 直接把内核缓冲区里的数据映射到用户空间,此时减少了一次数据拷贝,但仍然需要通过 CPU 把内核缓冲区的数据拷贝到 socket 缓冲区里,而且仍然需要 4 次上下文切换,因为系统调用还是 2 次。 buf=mmap(file,len); write(sockfd,buf,len); 5.2.4.3 sendfile Linux 内核版本 2.1版本提供了函数 sendfile()。 ssize_tsendfile(intout_fd,intin_fd,off_t*offset,size_tcount); out_fd:目的文件描述符 in_fd:源文件描述符 offset:源文件内偏移量 count:打算复制数据长度 ssize_t:实际上复制数据的长度 可以发现一个 sendfile = read + write,避免了2次用户态跟内核态来回切换,并且可以直接把内核缓冲区里的数据拷贝到 socket 缓冲区里,这样就只有 2 次上下文切换,和 3 次数据拷贝。 sendfile模式 5.2.4.4 真正的零拷贝 Linux 内核 2.4如果网卡支持SG-DMA 技术,可以减少通过 CPU 把内核缓冲区里的数据拷贝到 socket 缓冲区的过程。 $ethtool-keth0|grepscatter-gather scatter-gather:on SG-DMA 技术可以直接将内核缓存中的数据拷贝到网卡的缓冲区里,此过程不需要将数据从操作系统内核缓冲区拷贝到 socket 缓冲区中,这样就减少了一次数据拷贝。 ZeroCopy 5.2.4.5 文件传输规则 不要以为会了Zero Copy后,无论大小文件都用Zero Copy。实际工作中一般小文件采用Zero Copy技术,而大文件会用异步IO。至于为啥,且看如下分析: 前面说的数据从磁盘读到内核缓冲区就是读到PageCache中,PageCache具有缓存跟预读功能。但当传输超大文件时PageCache会不失效,因为大文件会快速占满PageCache区,但这些文件又只是一次访问,会造成其他热点小文件无法使用PageCache,所以索性不用PageCache,使用异步IO的了。至于异步IO是啥呢?下文在说。 5.3 IO分层 IO分层 Linux 存储系统的 I/O 由上到下可以分为 文件系统层、 通用块层、 设备层。 文件系统层向上为应用程序统一提供了标准的文件访问接口,向下会通过通用块层来存储和管理磁盘数据。 通用块层包括块设备的 I/O 队列和 I/O 调度器,通过IO调度器处理IO请求。 设备层包括硬件设备、设备控制器和驱动程序,负责最终物理设备的 I/O 操作。 Linux系统中的IO读取提速: 为提高文件访问效率会使用页缓存、索引节点缓存、目录项缓存等多种缓存机制,目的是为了减少对块设备的直接调用。 为了提高块设备的访问效率, 会使用缓冲区,来缓存块设备的数据。 6 End 小3W字,终于吹逼完了。希望读完可以让你对操作系统有个大概的印象,你在用Window,却不知经过30年的基础沉淀,Windows 的完整源代码树的大小超过 0.5 TB,涉及超过56万个文件夹,400 多万个文件,总规模超十亿行。再加上各个功能之间需要兼容性,可维护性,可管理性等这些随着代码的越来越多可推敲,最终产生了这样的一个艺术品! 参考 MMU:https://www.zhihu.com/question/63375062 安琪拉线程:https://t.1yb.co/hcge 小林OS:https://t.1yb.co/hwm7 本文分享自微信公众号 - sowhat1412(sowhat9094)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 切片传递的隐藏危机

提出疑问 在Go的源码库或者其他开源项目中,会发现有些函数在需要用到切片入参时,它采用是指向切片类型的指针,而非切片类型。这里未免会产生疑问:切片底层不就是指针指向底层数组数据吗,为何不直接传递切片,两者有什么区别? 例如,在源码log包中,Logger对象上绑定了formatHeader方法,它的入参对象buf,其类型是*[]byte,而非[]byte。 1func(l*Logger)formatHeader(buf*[]byte,ttime.Time,filestring,lineint){} 有以下例子 1funcmodifySlice(innerSlice[]string){ 2innerSlice[0]="b" 3innerSlice[1]="b" 4fmt.Println(innerSlice) 5} 6 7funcmain(){ 8outerSlice:=[]string{"a","a"} 9modifySlice(outerSlice)10fmt.Print(outerSlice)11}1213//输出如下14[bb]15[bb] 我们将modifySlice函数的入参类型改为指向切片的指针 1funcmodifySlice(innerSlice*[]string){ 2(*innerSlice)[0]="b" 3(*innerSlice)[1]="b" 4fmt.Println(*innerSlice) 5} 6 7funcmain(){ 8outerSlice:=[]string{"a","a"} 9modifySlice(&outerSlice)10fmt.Print(outerSlice)11}1213//输出如下14[bb]15[bb] 在上面的例子中,两种函数传参类型得到的结果都一样,似乎没发现有什么区别。通过指针传递它看起来毫无用处,而且无论如何切片都是通过引用传递的,在两种情况下切片内容都得到了修改。 这印证了我们一贯的认知:函数内对切片的修改,将会影响到函数外的切片。但,真的是如此吗? 考证与解释 在《你真的懂string与[]byte的转换了吗》一文中,我们讲过切片的底层结构如下所示。 1typeslicestruct{2arrayunsafe.Pointer3lenint4capint5} array是底层数组的指针,len表示长度,cap表示容量。 我们对上文中的例子,做以下细微的改动。 1funcmodifySlice(innerSlice[]string){ 2innerSlice=append(innerSlice,"a") 3innerSlice[0]="b" 4innerSlice[1]="b" 5fmt.Println(innerSlice) 6} 7 8funcmain(){ 9outerSlice:=[]string{"a","a"}10modifySlice(outerSlice)11fmt.Print(outerSlice)12}1314//输出如下15[bba]16[aa] 神奇的事情发生了,函数内对切片的修改竟然没能对外部切片造成影响? 为了清晰地明白发生了什么,将打印添加更多细节。 1funcmodifySlice(innerSlice[]string){ 2fmt.Printf("%p%v%p\n",&innerSlice,innerSlice,&innerSlice[0]) 3innerSlice=append(innerSlice,"a") 4innerSlice[0]="b" 5innerSlice[1]="b" 6fmt.Printf("%p%v%p\n",&innerSlice,innerSlice,&innerSlice[0]) 7} 8 9funcmain(){10outerSlice:=[]string{"a","a"}11fmt.Printf("%p%v%p\n",&outerSlice,outerSlice,&outerSlice[0])12modifySlice(outerSlice)13fmt.Printf("%p%v%p\n",&outerSlice,outerSlice,&outerSlice[0])14}1516//输出如下170xc00000c060[aa]0xc00000c080180xc00000c0c0[aa]0xc00000c080190xc00000c0c0[bba]0xc000022080200xc00000c060[aa]0xc00000c080 在Go函数中,函数的参数传递均是值传递。那么,将切片通过参数传递给函数,其实质是复制了slice结构体对象,两个slice结构体的字段值均相等。正常情况下,由于函数内slice结构体的array和函数外slice结构体的array指向的是同一底层数组,所以当对底层数组中的数据做修改时,两者均会受到影响。 但是存在这样的问题:如果指向底层数组的指针被覆盖或者修改(copy、重分配、append触发扩容),此时函数内部对数据的修改将不再影响到外部的切片,代表长度的len和容量cap也均不会被修改。 为了让读者更清晰的认识到这一点,将上述过程可视化如下。 可以看到,当切片的长度和容量相等时,发生append,就会触发切片的扩容。扩容时,会新建一个底层数组,将原有数组中的数据拷贝至新数组,追加的数据也会被置于新数组中。切片的array指针指向新底层数组。所以,函数内切片与函数外切片的关联已经彻底斩断,它的改变对函数外切片已经没有任何影响了。 注意,切片扩容并不总是等倍扩容。为了避免读者产生误解,这里对切片扩容原则简单说明一下(源码位于src/runtime/slice.go 中的 growslice 函数): 切片扩容时,当需要的容量超过原切片容量的两倍时,会直接使用需要的容量作为新容量。否则,当原切片长度小于1024时,新切片的容量会直接翻倍。而当原切片的容量大于等于1024时,会反复地增加25%,直到新容量超过所需要的容量。 到此,我们终于知道为什么有些函数在用到切片入参时,它需要采用指向切片类型的指针,而非切片类型。 1funcmodifySlice(innerSlice*[]string){ 2*innerSlice=append(*innerSlice,"a") 3(*innerSlice)[0]="b" 4(*innerSlice)[1]="b" 5fmt.Println(*innerSlice) 6} 7 8funcmain(){ 9outerSlice:=[]string{"a","a"}10modifySlice(&outerSlice)11fmt.Print(outerSlice)12}1314//输出如下15[bba]16[bba] 请记住,如果你只想修改切片中元素的值,而不会更改切片的容量与指向,则可以按值传递切片,否则你应该考虑按指针传递。 例题巩固 为了判断读者是否已经真正理解上述问题,我将上面的例子做了两个变体,读者朋友们可以自测。 测试一 1funcmodifySlice(innerSlice[]string){ 2innerSlice[0]="b" 3innerSlice=append(innerSlice,"a") 4innerSlice[1]="b" 5fmt.Println(innerSlice) 6} 7 8funcmain(){ 9outerSlice:=[]string{"a","a"}10modifySlice(outerSlice)11fmt.Println(outerSlice)12} 测试二 1funcmodifySlice(innerSlice[]string){ 2innerSlice=append(innerSlice,"a") 3innerSlice[0]="b" 4innerSlice[1]="b" 5fmt.Println(innerSlice) 6} 7 8funcmain(){ 9outerSlice:=make([]string,0,3)10outerSlice=append(outerSlice,"a","a")11modifySlice(outerSlice)12fmt.Println(outerSlice)13} 测试一答案 1[bba]2[ba] 测试二答案 1[bba]2[bb] 你做对了吗? 往期推荐 你真的懂string与[]byte的转换了吗 一文读懂channel设计 Go是如何设计Map的 Go工具之vet——静态诊断器 Go定时任务库:cron Golang技术分享 长按识别二维码关注我们 更多golang学习资料 回复关键词1024 本文分享自微信公众号 - Golang技术分享(gh_1ac13c0742b7)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 梯度下降极简入门

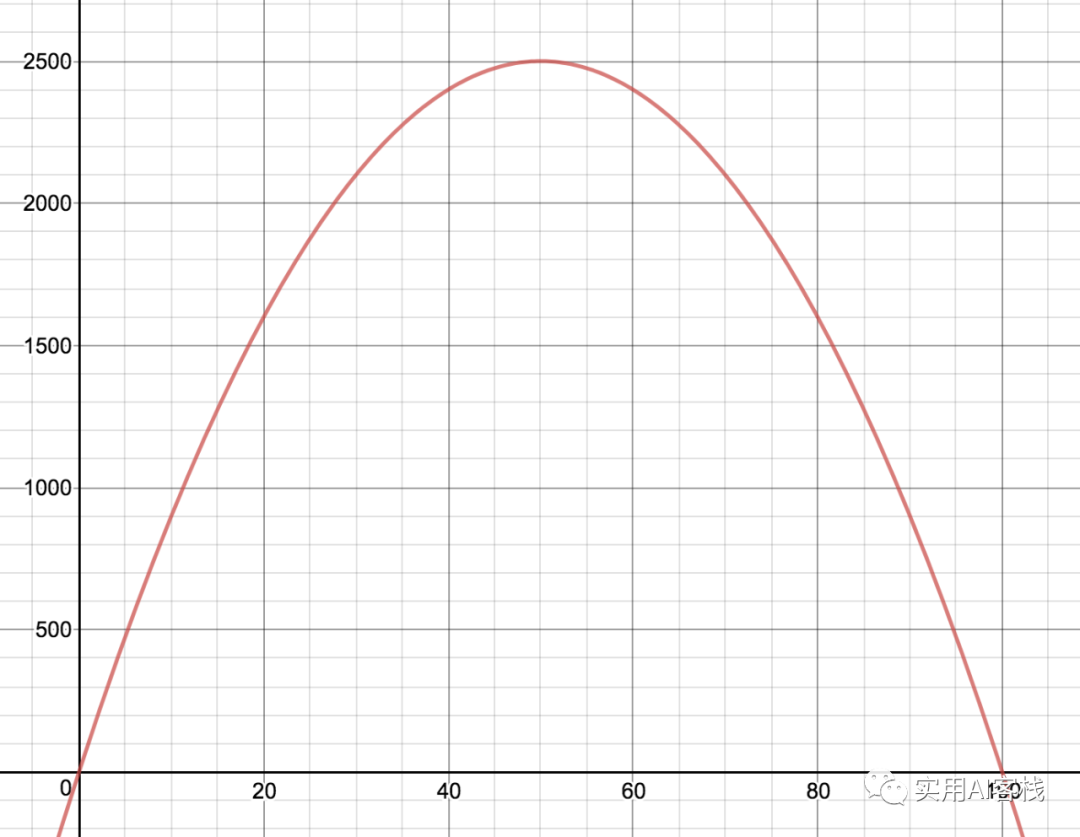
导 语 梯度下降及其变体被用作训练过程的关键部分在机器学习中广泛使用。梯度下降中的“梯度”是指单变量导数的推广形式,即多元变量求导。 梯度下降法是解决“优化问题”的迭代方法,其中优化问题是指围绕寻找函数的全局最小值或最大值而展开的数学问题。我们将很快看到,对于简单的优化问题可以不用梯度下降。当事情变得复杂时,我们则需要用诸如梯度下降之类的迭代法,当然和神经网络相关的优化问题确实足够复杂。 01 重新回顾优化问题 假设你已经购买了200米的铁丝网。您想使用此围栏为羊群创建一个矩形牧场。如何确定使牧场内部面积最大化时,牧场对应的长度和宽度? 使用标准的分析方法来解决这个问题,我们首先要写一个方程式来表示我们的问题。首先,我们知道两件事: area(面积)=length(长度)*width(宽度)(2 * length)+(2 * width)= 200 但是我们想用一个变量而不是两个变量来表示面积,所以我们可以求解这两个方程中的第二个变量的宽度: 2 * width = 200–2 * lengthwidth = [200-2 * length] / 2width = 100 - length 现在我们可以用100- length代替width,则: area= length * [100–length]area = f(length)=100 * length- length² 取面积的导数: area’=100-2*length;length=50 现在,我们找到了函数的“临界点”,即一阶导数等于零时对应的长度,当然函数在该点处的斜率也为零。我们关心这种值,因为它们是唯一能对应函数最小值或函数最大值的数。在临界点处,该点两侧的值可能都小于或都大于临界点处的值。因为函数中该点外的斜率都不为零,这意味着临界点上一边的点对应的面积将小于该临界点对应的面积,而另一边的点对应的面积将大于该临界点对应的面积。也就是说,该函数在非临界点处正在增加或减少,因此不能为最大值或最小值。 area’=100-2*length=0-->length=50 这表明如果存在全局最大值或最小值,则必须在长度= 50时发生。也就是说,如果矩形的长度存在最佳选择,则为50米。可能存在临界点既不是最小值也不是最大值,所以应该检测已发现的临界点确实是最值。在微积分课程中,有相关的检验方法(比如二阶导数检验),现在用更简单的方法(类似梯度下降法)来解决该问题,比如在临界点长度= 50的左右两侧测试2个点。 f(49)= 4900–2401 = 2499f(50)= 5000–2500 = 2500f(51)= 5100–2601 = 2499 这并不能确认矩阵面积最大时对应长度值就是50,或者某些时候有比50更好的点,不过这种近似的方法最终将应用于训练模型。对于这个简单的问题,通过绘制函数了解该方法和实际的误差: 02 梯度下降—迭代式猜测 那么这与梯度下降方法有什么关系呢?梯度下降方法比较粗糙,就像刚才所做的那些不精确的猜测一样。看上去它是比随机猜测稍强一点的显得杂乱的体系,不过它将最终成为我们解决围栏问题的方法: 猜测围栏的最佳长度 计算此时的梯度值 根据梯度的值,调整猜测 重复猜测直到满足条件则终止 假设我们随机选取57当作长度的第一个猜测值,在57处,面积函数的导数为: f(57)=100*57 - 57*57 = 2451f'(57)=100–2*(57)=-14 ‍ length = 57处的斜率不为0,因此不是临界点。此外斜率为-14表示如果将长度增加 1,则面积将减小 14(假设函数的斜率不变)。梯度下降使用此值作为进行下一个猜测的指导。比如要增加面积的值,因为斜率是负数,所以应该57基础上减小长度,以此增加面积的值。 然而即使知道当前应该减少length的值,也没有先验的方法可以确切地知道“合适”的数来调整我们的当前的猜测(length=57)。在像TensorFlow这样的软件包中,我们用来调整当前length的快慢将由一个称为“学习率”的超参数控制,可以在训练时设置该参数。提高学习率将导致梯度下降对当前当前length调整很快;减小学习率会导致梯度下降对当前当前length调整较慢。现在假设将当前length减少3,虽然有点武断,但实际上效果可以接受。 57–3 = 54f(54)= 5400–(54²)-->f(54)= 5400–2916 -->f(54)= 2484 2484大于2451,说明找到的面积比上次大。再次使用导数来检查是否处于临界点,如果不是,则调整猜测值: f'(54)= 100–2 * 54 = 100–108 = -8 我们的当前猜测值(54)仍然很大,斜率-8低于-14,应该适当减缓对当前猜测值的更改幅度,比如在54基础上减少2,则: f(52)= 5200–52² --> f(52)= 5200–2704 -->f(52)= 2496 我们将重复此过程,直到找到一个临界点。或者直到f'(length)的值非常接近零,才能认为length已足够接近临界点。手工完成此过程是重复且繁琐的,但是计算机善于解决重复繁琐的任务。通俗点说,将像在爬山和滚球,一直沿着抛物线上升,直到无法进一步上升为止。 请注意导数(蓝色),它在最大值的右边是负数,在最大值的左边是正数。在这种情况下,很容易找到最大值。 由于试图找到面积的最大值,上面的示例称之为“梯度上升”更好。在梯度下降中,每次计算梯度值时都将其相反数。 马上将提到的梯度下降和在神经网络里面用到的梯度下降有两个不一样的地方。首先,神经网络对应的函数比f(length)更复杂。我们的神经网络具有成千上万的可调参数,而其中f(length)只有一个。我们使用诸如梯度下降之类的迭代方法主要是因为神经网络模型非常复杂,而不是选用之前查找临界点时的分析过程。计算当前如此庞大规模的神经网络所表示的一般性的函数导数根本不可行。第二个区别是,在此示例中,有一个充当标准结果的实函数,并且发现了该函数的最佳值。在神经网络中,没有显式的函数;取而代之的是,我们尝试创建一个不存在标准结果的函数。 03 用于函数查找的梯度下降 在前面的示例中,使用梯度下降方法沿该曲线可以找到最佳值。在机器学习中,对于训练集中的数据,我们希望创建一条曲线来更好地拟合这些数据。回顾一下刚刚研究的围栏问题,将它转化为我们更倾向于用机器学习解决的问题。 我们从围栏数据库中收集了很多数据样本。我们数据集中的每个数据点的背景都是来自用100米围栏材料来建造矩形牧场。每个数据点有2个参数:围栏一侧的长度和围栏的面积。在这个问题中,不是尝试找到围栏的最佳长度,而是试图找到一个函数,该函数可以根据给定的边长来预测矩形围栏的面积。我们的输入数据如下所示: 看起来数据中有一个模式,我们可以使用机器学习来定义模式吗? 机器学习解决此问题的方法是认为:“看起来有点像某种数学函数,想知道到底是哪个函数?”,更进一步,我们猜测该函数是某种抛物线函数,则该函数的一般表达式是: F(x)=ax²+ bx 在数据集中已知x值和y值,现在我们将使用梯度下降法来找到a和b的最佳值。为此,我们引入了另一个函数--损失函数,并运行梯度下降以最小化损失函数。将F(x)当作“正在进行训练的函数”,其中x仍然是围栏一侧的长度,y是围栏的真实面积。单次预测的绝对误差为: L(x)= | F(x)- y | 我们需要给误差加上绝对值。如果不这样做且连续做两次预测,假设一次错了1000,另一次错了-1000,则两次错误刚好抵消,实际上这样一共错了两次。 最终我们会用这样的一个损失函数:平均绝对误差,它是数据集中所有的点对应L(x)的平均值。使用诸如均方误差之类的指标更为常见,但是不同的损失函数对不同的数据集。 假设我们随机选择权重的起始值:a = -2和b = 30。在对应的F(x)变为: L(x)= | -2x²+ 30x-y | 接下来的内容略带技巧性。我们想要调整a和b的值以最小化损失函数。因此我们需要计算损失函数对a和b的梯度(偏导数)。以前的函数中,x的值可以不断变化。但是这个问题里面,情况并非如此。x的值始终只是我们数据集中的某个固定值。因此单个数据点对应的损失函数为:L(a, b) = ax² + bx – y,其中x、y是常数。 使用平均绝对误差的损失函数为: L(a,b)=1/m*SUM(|F(a,b)—yi|)L(a,b)=(1 / m)* SUM(|axi²+ bxi — yi |) 其中xi和yi代表我们数据集中的单个数据点,而m是我们数据集中点的总数。这里有两个细节上的问题:一个是我们必须使用链式规则来计算涉及绝对值的梯度;另一个是绝对值函数在预测值恰好等于真实值的点上是不可求导的,并且。 如果平均绝对误差为0,可以通过停止计算梯度来解决不可导的问题。这是有实际意义的。如果我们在这个数据点上的预测值与实际值都符,那么就不需要用改善绝对误差的方式来调整模型: d | x |/ dx = 1,如果x为正d | x |/ dx = -1,如果x为负则损失函数对a、b求偏导数可以写成:L(a, b) = (1/m) * SUM( | axi² + bxi — yi | )L’_a(a, b) = (1 / m) * SUM( 1 * xi² ); F(xi) > yiL’_a(a, b) = (1 / m) * SUM( -1 * xi² ); F(xi) < yiL’_b(a, b) = (1 / m) * SUM( 1 * x ); F(xi) > yL’_b(a, b) = (1 / m) * SUM( -1 * x );F(xi) < yi 这些公式实际上为我们提供了一个非常简单的更新规则:如果我们的预测太小,则将a和b都增大。如果我们的预测太大,则将a和b都减小。 深刻地理解梯度下降以及优化损失函数的思路可以更好地理解过拟合之类的问题,同时它还可以帮助我们更好地了解神经网络训练的过程。 1 END 1 长 按 关 注 获取最新AI资讯与实战案例 实用AI客栈 小编微信号 : langu86 本文分享自微信公众号 - 实用AI客栈(gh_0b0b5e56231f)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | C++ 代码整洁之道

整洁的代码在团队中无疑是很受欢迎的,可以高效的被其它成员理解和维护,本文参考《C++代码整洁之道》和《Google C++编码规范》,结合自己的一些想法整理如下: C++本身作为面向对象语言,首先介绍下面向对象一般涉及到的开发原则。 面向对象开发原则 依赖倒置原则:针对接口编程,依赖于抽象而不依赖于具体,抽象(稳定)不应依赖于实现细节(变化),实现细节应该依赖于抽象,因为稳定态如果依赖于变化态则会变成不稳定态。 开放封闭原则:对扩展开放,对修改关闭,业务需求是不断变化的,当程序需要扩展的时候,不要去修改原来的代码,而要灵活使用抽象和继承,增加程序的扩展性,使易于维护和升级,类、模块、函数等都是可以扩展的,但是不可修改。 单一职责原则:一个类只做一件事,一个类应该仅有一个引起它变化的原因,并且变化的方向隐含着类的责任。 里氏替换原则:子类必须能够替换父类,任何引用基类的地方必须能透明的使用其子类的对象,开放关闭原则的具体实现手段之一。 接口隔离原则:接口最小化且完备,尽量少public来减少对外交互,只把外部需要的方法暴露出来。 最少知道原则:一个实体应该尽可能少的与其他实体发生相互作用。 将变化的点进行封装,做好分界,保持一侧变化,一侧稳定,调用侧永远稳定,被调用侧内部可以变化。 优先使用组合而非继承,继承为白箱操作,而组合为黑箱,继承某种程度上破坏了封装性,而且父类与子类之间耦合度比较高。 针对接口编程,而非针对实现编程,强调接口标准化。 C++开发原则 通过上述面向对象开发原则的理解可以细化到具体C++开发原则。 保持简单和直接原则(KISS, Keep it simple and stupid):保持代码尽可能简单,如果需求需要的话,才在代码中引入灵活的可变点,只添加那些可使整体变得更简单的局部复杂的东西。 不需要原则(YAGNI, You're not gonna need it):总是在你真正需要的时候再实现他们,而不是在你只是预见到你将来会需要他们而去实现,在真正需要的时候再写代码,那时再重构也来得及。 避免复制原则(DRY, Do not repeat yourself):不要复制,不要重复,这是相当危险的操作,你修改一处代码的时候总能记得去修改另外一处或另外多处你曾经复制的代码吗? 信息隐藏原则:一段代码调用了另外一段代码,调用者不应该知道被调用者代码的实现,否则调用者就有可能修改被调用者的实现来实现某些功能,而这有可能引发其它调用者的bug。 高内聚低耦合原则:类似单一职责原则,明确每个模块的具体责任,尽量少的依赖于其它模块。 最少惊讶原则:函数功能要与函数名字功能一致,难道你要在一个getter()函数去更改成员变量的值吗? 更干净原则(自命名):离开露营地的时候,应让露营地比你来之前还要干净,当发现代码中有需要改进或者风格不好的地方,应该立刻改掉,不要care这段代码的原作者是谁,也不要care这是谁的模块,代码所有权是集体的,每个团队成员在任何时候都应该可以对任何代码进行更改和扩展。 关于面向对象设计原则可以参考一文让你搞懂设计模式 注重单元测试 重要性就不多说了,防患于未然,构建大型系统尤其需要进行单元测试,保证代码质量,可以防患于未然。一般都讲究测试驱动开发,开发一个功能首先要想好怎么测试,先把测试代码写好,再去开发对应的需求。通过单元测试也有利于开发者更好的进行接口的设计,主要说下良好的单元测试的原则。 单元测试的原则 保证单元测试的代码的质量,单元测试的代码也是代码,不应该和产品代码区别对待,而且单元测试的代码再写出bug更影响测试效率。 单元测试的命名, 每个测试单元需要根据具体测试内容进行相应的命名,方便定位分析问题,好的命名如果出现问题时通过测试单元的名字基本就可以定位问题。 保证单元测试的独立性,每个测试单元都是独立的,不依赖于其它测试单元,不要构建测试单元的上下文,上面的测试单元出问题影响到下面的单元测试的设计是很不友好的。 尽量保证一个测试单元使用一个断言,保证测试单元内部的一个相对独立性,上面的断言阻碍了下面的断言测试也是不好的设计。 保证单元测试环境的独立,保证每个测试单元都有独立的环境,不依赖于其它环境,每个测试单元都要是个独立的可运行的实例,每个单元测试结束后记得清理环境。 没必要对第三方库和外部系统做单元测试,只对自己写的代码进行测试。 单元测试尽量不要涉及数据库,数据库的状态是全局的,测试不能保证独立性,而且数据库的访问也是缓慢的,影响单元测试的速度,如果真的需要可以模拟数据库在内容中进行测试,其实通常是在系统集成和系统测试级别时去测试数据库。 不要混淆测试代码和产品代码,产品代码中不应依赖测试代码。 测试必须要快速执行,确保秒级别,大型系统的单元测试也就几分钟而已,单元测试不要访问数据库、磁盘、网络等外设。 找一些测试替身,例如有些数据需要通过网络获取,那可以利用依赖注入做一个网络替身的类模拟这些数据的产生,可以研究研究Google mock。 良好的命名 无论是什么语言,函数和变量的良好命名都是很有必要的,通过函数的名字我们就可以知道这个函数里代码的作用,而不是通过写注释,个人一直倾向于用代码自解释。 文件命名 文件名字要全部小写,中间用_相连,后缀名为.cc和.h 类型命名 类型名称的每个单词首字母均大写, 不包含下划线: MyExcitingClass, MyExcitingEnum. 变量命名 不要将变量的类型在名字中体现,这样以后变量类型改变的话还需要去改动变量名,充分利用IDE的功能,变量 (包括函数参数) 和数据成员名一律小写, 单词之间用下划线连接. 类的成员变量以下划线结尾, 但结构体的就不用, 如: a_local_variable, a_struct_data_member, a_class_data_member_. class TableInfo {...private:string table_name_; // 好 - 后加下划线.string tablename_; // 好.static Pool<TableInfo>* pool_; // 好.int i_table; // 不好,不要将变量的类型在名字中体现}; 常量命名 声明为 constexpr 或 const 的变量, 或在程序运行期间其值始终保持不变的, 命名时以 “k” 开头, 大小写混合 const int kDaysInAWeek = 7; 函数命名 常规函数使用大小写混合, 取值和设值函数则要求与变量名匹配: MyExcitingFunction(), MyExcitingMethod(), my_exciting_member_variable(), set_my_exciting_member_variable(). 枚举命名 和常量一致 enum UrlTableErrors { kOK = 0, kErrorOutOfMemory, kErrorMalformedInput,}; Tip: 除非像swap函数里tmp那种一目了然,否则不要搞无意义的命名,函数名变量名字宁可特别长也要写清楚究竟是什么意思,不要用缩写,一个变量尽量在临近使用前才定义,可读性强也可更好利用cpu cache。 编辑器 团队可以统一使用相同的编辑器,个人目前使用的是VS Code编辑器,同时每个项目使用统一的.clang_format文件,统一规范代码格式,所有的换行符都要用LF格式,不要用CRLF格式,在右下角可以设置。 个人的.clang-format文件如下,是在google风格的基础上做了些修改: BasedOnStyle: GoogleIndentWidth: 4ColumnLimit: 120SortIncludes: trueMaxEmptyLinesToKeep: 2 C++编码规范要点小总结 每个头文件都要使用#define避免被重复引用 命名格式 <PROJECT>_<PATH>_<FILE>_H_#ifndef FOO_BAR_BAZ_H_#define FOO_BAR_BAZ_H_...#endif // FOO_BAR_BAZ_H_ 或使用#pragma once,而#define方式更通用 鼓励在 .cc 文件内使用匿名命名空间或 static 声明. 使用具名的命名空间时, 其名称可基于项目名或相对路径. 禁止使用 using 指示, 禁止使用内联命名空间(inline namespace) 一行尽量不要超过120个字符,一个函数尽量不要超过40行,同时一个文件尽量控制在500行内. 所有的引用形参如不做改动一律加const,在任何可能的情况下都要使用 const或constexpr new内存的地方尽量使用智能指针,c++11 就尽量用std::unique_ptr替代std::auto_ptr 合理使用移动语义,减少内存拷贝,参考左值引用、右值引用、移动语义、完美转发,你知道的不知道的都在这里 禁止使用 RTTI,尽量在编译期间就确定参数类型,不要搞运行时识别typeid这种代码 使用 C++ 的类型转换, 如 static_cast<>(). 不要使用 int y = (int)x 或 int y = int(x) 等转换方式 明确使用前置++还是后置++的具体含义,如不考虑返回值,尽量使用效率高的前置++ (++i) 不要使用uint类型,如果需要使用大整型可以考虑int64,否则类型的隐式类型转换会带来很多麻烦 如无特殊必要不要使用宏,可以考虑使用const或constexpr替代宏,宏的全局作用域很麻烦,如果非要用在马上要使用时才进行 #define, 使用后要立即 #undef google文档说一定不要用宏来控制条件编译(但是我自己还没有查到不用宏如何控制条件编译,或许就不要搞条件编译) 尽可能用 sizeof(varname) 代替 sizeof(type).使用 sizeof(varname) 是因为当代码中变量类型改变时会自动更新. 您或许会用 sizeof(type) 处理不涉及任何变量的代码,比如处理来自外部或内部的数据格式,这时用变量就不合适了 类型名如果过长的话可以考虑使用auto关键字 注释统一使用 // ,不要通过注释禁用代码,擅用git,不要为易懂的代码写注释 写完代码后记得format,VS Code(windows快捷键) shift + alt + F ,每个项目最好都有统一的.clang_format文件 使用C++的string和stream替代C语言风格的char*,使用std::ostream和std::cout替代printf()、sprintf()等 尽量使用STL标准库的容器而不是C语言风格的数组,数组的越界访问之类当时是不会报错的,反而可能弄脏堆栈信息,导致奇奇怪怪难以排查的bug 可以更多的使用模板元编程,尽量多的使用constexpr等编译器计算,编译器是我们的好搭档,个人认为模板元编程以后会是C++的主流技术 可以考虑更多的使用异常处理方式,而不是C语言风格的errno错误码等,这里可以参考你的c++团队还在禁用异常处理吗? 附:本文不是技术文章,介绍较为主观,可能和很多人想法有所冲突,各位可以结合自己的经历经验酌情参考。 参考资料 《C++代码整洁之道》 https://zh-google-styleguide.readthedocs.io/en/latest/google-cpp-styleguide/contents/ REVIEW ◆ ◆ 往期回顾 c++11新特性,所有知识点都在这了! 你的c++团队还在禁用异常处理吗? 内存对齐之格式修订版 c++11新特性之智能指针 本文分享自微信公众号 - 程序喵大人(dmjjzl1)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 八叉说内容提炼

统一语言的坏味道: dao对于ddd来说是坏味道,因为它是纯技术层面数据访问内容。使用它,说明程序员放弃了对于业务逻辑领域归属的考量——不应该让业务去找技术归属。repository比dao好一些,它应该存在于聚合根上,如果确实考虑了业务对于数据的操作的封装,它就是好的。如果仍然对于数据库对象各产生一个操作对象,还是仅仅对dao一个重命名,没有意义。 业务的数据逻辑可以拆分为对象的逻辑和集合的逻辑,引入集合逻辑对象,有助于明确业务逻辑,减少坏味道。 低代码是行业毒瘤: 形式逻辑和历史事实证明,让不懂代码的人写代码的想法是错的。图灵邱奇定律:没有一个模型可以跨越另一个模型提供额外的能力。图灵完备意味着提供完整能力,非程序员无法跨越编程知识而掌握,非图灵完备意味着功能缺失。非程序员不能借助一种新语言跨越编码细节,实现程序编写。最终还是会落在程序员头上。 测试金字塔和测试策略: 系统需要两类测试:发现问题的测试和定位问题的测试。功能测试覆盖代码量大,主要用于发现问题,单元测试、组件测试和集成测试覆盖代码量小,用于定位问题。单元测试本身一般已经不能验证功能是否正确,需要构造等效测试,把功能测试等效为一系列单元测试,使得它能帮你定位问题。所以测试金字塔只是一种实现策略的结论,本质上,你要思考你的测试策略能不能帮你达到上述目的,怎样帮你达到目的,怎么实现效率最高,来具体设计测试策略。 六边形架构还值得选择么: 六边形架构核心价值是通过适配器桥接,定义边界输入输出,把业务和技术的内容分离,来保持技术架构改变时,业务可以不变。但实际上需求变化比技术架构变化要快的多。六边形架构本身是基于单体架构假设的一种设计,当时认为是变化,需要隔离的部分,今天已经不再是变化的了。考虑架构时,应当先从部署结构和物理形态考虑:今天的部署和当时非常不同,所以六边形架构基于过时设计,不能适应今天的情况。只有从最基本的原理思考,怎样隔离和适应变化,才是有效的架构设计的思路。 面向对象仍然是默认的选项么: 面向对象的前提是数据完备于内存中,这种情况下,把数据模型和数据处理的逻辑放在一起是合适的实现。后来出现数据库之后,数据不再是完备的,完整的面向对象就不存在,自然而然的出现贫血模型。seviceless的架构完全把逻辑和数据剥离,而hadoop则倒置为代码迁移给数据源去执行。这些新兴事物提示我们,面向对象不应该被看作一种默认的实现。从restful接口外部看,无论是否是面向对象的设计,都是无关的。 TDD和瀑布没什么区别: 瀑布需要完备的文档,在纸面预演开发过程,完备的思考和解决可能遇到的问题。TDD将需求拆分成任务,每个任务大约15min左右,都是用测试用例表达的。在这一过程中澄清需求和发现技术能力缺失,去尝试补充能力。殊途同归,都是软件开发的良好实践。 好的showcase: 好的showcase就是没有惊喜,也没有意外的。你可以先通过与showcase各方私下沟通,趟平问题。可能有人挑战,但要保证基本盘。最好的是让一部分业务方回答其他业务方的问题。showcase在敏捷中非常重要,没有通过的情况客户可以不付钱。showcase可以弥补客户对敏捷项目的当前状态把握的缺失。showcase不需要开发人员发光,可以把舞台给客户和领导,让他们多表现。 为什么说《领域驱动设计》已经过时了: 领域驱动设计通过领域建模解决业务复杂度问题。根本复杂度来自业务,进一步看,来自运维模式和业务模式变化的时候,it如何去跟随。而领域驱动设计没有这方面内容,它没有对变化点建模和描述的内容。对于一个企业来说,用户渠道变化最快,运维模式次之,业务模式最次。在不同的速率上,系统稳定的程度不同,适用于ddd的程度就不同。对于相对稳定的系统,ddd的建模是有效的,对于变化速率高的部分,ddd建模会额外的增加成本和复杂程度,而它本身在付出高成本后旋即被抛弃,适用ddd的策略会十分荒唐。 中台三问: 中台与平台不同在于,平台是对业务流程的封装,抽象的是个别能力和技术能力。中台试图抽象业务模式或业务流程,在不同前台需求中抽象公共服务模块,避免成为大后台。它需要开发者思考和抽象企业依靠什么做业务,什么样的业务在驱动各个模块运转。 1.如何避免中台成为一个单点,以至于中台瘫痪导致系统瘫痪 中台没有必要按单点部署,也不需要所有前台访问相同实例。完全可以是相同的逻辑,分离的部署。复用的只是抽象的能力。 2.中台实现前台的定制需求与中台实现通用需求的矛盾如何解决 中台开发者思维的出发点是我是什么,而非你是什么,你有什么需求需要我满足。观察前台业务的目的是给自己找到主体性。 3.中台在企业结构中,会给it与业务的合作带来怎样的冲击和影响 康威定律:线型系统和线型组织架构间有潜在的异质同态特性。成立服务中台的组织架构会带来中台和前台的张力,但这不是问题,会帮助中台服务找到边界,达到平衡。 微服务拆分粒度: 对于单体应用,业务高峰到来时,各个业务部分有不同的弹性需要,单体的扩展不能支持这一点。以部署需要为微服务边界拆分,符合微服务设计的最初目的。微服务架构是在云原生时代,把弹性放在核心地位的架构。有时也基于发布周期解耦的考量,会拆分微服务。 对于通常被认为的微服务能提供服务重用功能来说,实际上不存在计算的重用的瓶颈,往往带有数据和逻辑的内容是需要重用的。所以无服务并不是微服务的趋势,它们是不同的。复用是一个潜在的收益,而非明确的收益,不应该以复用作为拆分微服务的原因。 基于细胞特化的架构思想,也可以制造相同的单体部署,通过其所处位置的不同,发挥不同的功能,并且通过定制网关解决弹性的问题。这样做方便功能的延续和复用,解决一部分cap和代码架构层面遇到的困难。也侧面说明了,微服务不是越微越好。 领域逻辑与运维逻辑: 业务逻辑分为领域逻辑和运维逻辑,领域逻辑是通用的,与具体公司的运作无关的,与所处行业地区等有关。企业谈业务需求一般没有领域概念,而是提软件的运维逻辑。所以市场上软件定制也有两个思路,一个是要求企业适应软件的运维逻辑,做对应组织调整;一个是软件存在通用功能,定制运维逻辑,也会要求企业适应,但程度会低。今天的环境下,无法抛开运维逻辑谈领域逻辑,设计软件的时候要多做相关思考。 DDD遇到业务系统,还是最佳实践么: 领域的复杂度和业务的复杂度不是同一维度的问题,DDD提出时,系统多是在领域的维度复杂,目前的多数系统主要复杂度在业务方面。对业务的抽象会体现在中台,而不是领域中。所以当遇到业务复杂度高的系统,不应当首选DDD,直接开发会更好。 *内容来自对八叉说栏目内容的笔记

优秀的个人博客,低调大师

每日一博 | 揭开链表的真面目

链表是一种常见的数据结构,链表是由一连串的结点组成,这个节点就是链结点,每个链结点都由数据域和指针域两部分组成。 使用链表结构可以克服数组结构需要预先知道数据大小的缺点,链表结构可以充分利用计算机内存空间,实现灵活的内存动态管理。但是链表失去了数组随机读取的优点,同时链表由于增加了结点的指针域,空间开销比较大。 链表比较好的一种理解是:将链表看成一个火车,每个车厢之间都是相互连接的,只要找到火车头,就可以找到具体的车身。链表也是,我们只关心它的头。 一 单向链表 1.1 单向链表原理图 单向链表的一个链结点包含数据域和下一个链结点的指针。头结点也包含数据域和指针域,但是一般为了方便查找,头节点不写数据,最后一个结点的指针指向空。 1.2 实现单向链表的存储等操作 创建一个链结点的实体类 publicclassNode{//数据域publiclongdata;//指针域publicNodenext;publicNode(longvalue){this.data=value;}} 1.2.1 插入一个节点 在头节点后插入一个结点,第一步需要将新插入的结点指向头结点指向的结点,第二步将头结点指向新插入的结点。插入结点只需要改变一个引用,所以复杂度为O(1)。 i publicclassLinkList{privateNodehead;/***在头节点之后插入一个节点*/publicvoidinsertFirst(longvalue){Nodenode=newNode(value);node.next=head;head=node;}} 1.2.2 头结点后删除一个结点 在头结点后删除一个结点,就是让头结点指向这个结点的下一个结点。复杂度也是O(1)。 publicNodedeleteFirst(){Nodetmp=head;head=tmp.next;returntmp;} 1.2.3 根据数据域查找结点 查找需要比对每个结点的数据,理论上查找一个结点平均需要N/2次,所以复杂度为O(N)。 publicNodefind(longvalue){Nodecurrent=head;while(current.data!=value){if(current.next==null){returnnull;}current=current.next;}returncurrent;} 1.2.4 根据数据与删除结点 查找需要比对每个结点的数据,理论上删除一个结点平均需要N/2次,所以复杂度为O(N)。 publicNodedelete(intvalue){Nodecurrent=head;//当前结点的前一个结点Nodepre=head;while(current.data!=value){if(current.next==null){returnnull;}pre=current;current=current.next;}if(current==head){head=head.next;}else{pre.next=current.next;}returncurrent;} 二 双端链表 2.1 双端链表原理图 双端链表是在单向链表的基础上,头结点增加了一个尾结点的引用。 2.2 实现双端链表的存储等操作 2.2.1 从头部插入结点 如果链表为空,则设置尾结点就是新添加的结点。复杂度为O(1)。 publicclassFirstLastLinkList{privateNodefirst;privateNodelast;/***在头结点之后插入一个节点*/publicvoidinsertFirst(longvalue){Nodenode=newNode(value);if(first==null){last=node;}node.next=first;first=node;}} 2.2.2 从尾部插入结点 如果链表为空,则设置头结点为新添加的结点,否则设置尾结点的后一个结点为新添加的结点。复杂度为O(1)。 publicvoidinsertLast(longvalue){Nodenode=newNode(value);if(first==null){first=node;}else{last.next=node;}last=node;} 2.2.3 从头部进行删除 判断头结点是否有下一个结点,如果没有则设置尾结点为null,复杂度为O(1)。 publicNodedeleteFirst(){Nodetmp=first;if(first.next==null){last=null;}first=tmp.next;returntmp;} 三 双向链表 3.1 双向链表原理图 每个结点除了保存对后一个结点的引用外,还保存着对前一个结点的引用。 3.2 实现双向链表的存储等操作 链结点实体类 publicclassNode{//数据域publiclongdata;//后一个结点指针域publicNodenext;//前一个结点指针域publicNodeprev;publicNode(longvalue){this.data=value;}} 3.2.1 从头部插入结点 如果链表为空,则设置尾结点为新添加的结点,如果不为空,还需要设置头结点的前一个结点为新添加的结点。插入结点只需要改变两个结点的引用,所以复杂度为O(1)。 publicclassDoubleLinkList{privateNodefirst;privateNodelast;/***在头结点之后插入一个节点*/publicvoidinsertFirst(longvalue){Nodenode=newNode(value);if(first==null){last=node;}else{first.prev=node;}node.next=first;first=node;}} 3.2.2 从尾部插入结点 如果链表为空,则设置头结点为新添加的结点,否则设置尾结点的后一个结点为新添加的结点。同时设置新添加的结点的前一个结点为尾结点。插入结点只需要改变1个结点的引用,所以复杂度为O(1)。 publicvoidinsertLast(longvalue){Nodenode=newNode(value);if(first==null){first=node;}else{last.next=node;node.prev=last;}last=node;} 3.2.3 从头部删除结点 判断头结点是否有下一个结点,如果没有则设置尾结点为null,否则设置头结点的下一个结点的prev为null。复杂度也为O(1)。 publicNodedeleteFirst(){Nodetmp=first;if(first.next==null){last=null;}else{first.next.prev=null;}first=tmp.next;returntmp;} 3.2.4 从尾部删除结点 如果头结点后没有其他结点,则设置头结点为null,否则设置尾结点的前一个结点的next为null,设置尾结点为前一个结点。复杂度为O(1)。 publicNodedeleteLast(){Nodetmp=last;if(first.next==null){first=null;}else{last.prev.next=null;}last=last.prev;returnlast;} 四 总结 链表包含一个头结点和多个结点,头结点包含一个引用,这个引用通常叫做first,它指向链表的第一个链结点。结点的next为null,则意味着这个结点是尾结点。与数组相比,链表更适合做插入、删除操作,而查找操作的复杂度更高。还有一个优势就是链表不需要初始化内存大小,不会造成内存溢出(数组中插入元素个数超过数组长度)或内存浪费(声明的数组长度比实际放的元素长)。 < END > 往期精选 ☞ 揭开数组的真面目 ☞ 聊聊Mysql中的int(1) ☞ 如何有效防止SQL注入攻击 ☞ 《RabbitMQ》什么是死信队列 ☞ 《RabbitMQ》如何保证消息不被重复消费 ☞ 《RabbitMQ》如何保证消息的可靠性 本文分享自微信公众号 - Java旅途(Javatrip)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 滴滴数据分析实践

↑ 点击上方 “凹凸数据”关注 + 星标 ~ 每天更新,干货&福利不断 hi,我是 Rilke Yang 这是一篇我关于滴滴的数据实战,之前首发在和鲸,这次投稿到凹凸数据,希望能够帮助到大家~ 原文链接:https://www.kesci.com/home/project/5f06b0193af6a6002d0fa357 随着企业日常经营活动的进行,企业内部必然产生了各式各样的数据,如何利用这些数据得出有益的见解,并支持我们下一步的产品迭代以及领导决策就显得尤为重要。 A/B测试是互联网企业常用的一种基于数据的产品迭代方法,它的主要思想是在控制其他条件不变的前提下对不同(或同一、同质)样本设计不同实验水平(方案),并根据最终的数据变现来判断自变量对因变量的影响;A/B测试的理论基础主要源于数理统计中的假设检验部分,此部分统计学知识读者可自行探索。 长话短说,本次实战用到的数据集分为两个Excel文件,其中test.xlsx为滴滴出行某次A/B测试结果数据,city.xlsx为某城市运营数据。 数据说明 test.xlsx city.xlsx date:日期 date:日期 group:组别(控制组/实验组) hour:时点 requests:订单请求数 requests:请求数 gmv:成交总额 trips:订单数 coupon per trip:每单优惠券金额 supply hours:可服务时长 trips:订单数 average minutes of trips:平均订单时长(分钟) canceled requests:取消请求数 pETA:顾客预计等待时长 aETA:顾客实际等待时长 utiliz:司机在忙率 test.xlsx 数据可以用来判断实验条件对此次A/B测试的结果影响是否显著;city.xlsx 数据可以用来探索该城市运营中出现的问题,根据关键结论辅助决策。 在本文中,我们将使用该数据来做A/B测试效果分析与城市运营分析。 一、A/B测试效果分析 1、数据导入 #A/B测试结果数据导入importpandasaspdtest=pd.read_excel('/home/kesci/input/didi4010/test.xlsx')test.head() 2、计算ROI #计算优惠券投入相对gmv的ROItest['ROI']=test['gmv']/(test['couponpertrip']*test['trips'])test.head() 3、requests检验 数据共58条,对照组与实验组各29条,样本量<30。 3.1 requests方差检验 记两组requests方差分别为从c1,c2 零假设H0:c1=c2;备选假设:H1:c1≠c2 显著性水平取0.05 #levene检验requests是否齐方差requests_A=test[test.group=='control'].requestsrequests_B=test[test.group=='experiment'].requestsimportscipy.statsasstst.levene(requests_A,requests_B) p值大于0.05,不拒绝原假设,因此可认为两组实验requests齐方差。 3.2 requests均值检验 该数据为同一样本实验前后的不同水平,因此选用配对样本t检验。 记两组requests均值分别为从u1,u2 零假设H0:u1=u2;备选假设:H1:u1≠u2 显著性水平取0.05 #配对样本t检验(两独立样本t检验之前需检验是否齐方差,此处不需要)st.ttest_rel(requests_A,requests_B) p值大于0.05,不拒绝原假设,因此可认为实验条件对requests影响不显著。 4、gmv检验 4.1 gmv方差检验 #levene检验gmv是否齐方差gmv_A=test[test.group=='control'].gmvgmv_B=test[test.group=='experiment'].gmvst.levene(gmv_A,gmv_B) p值大于0.05,不拒绝原假设,因此可认为两组实验gmv齐方差。 4.2 gmv均值检验 #配对样本t检验(两独立样本t检验之前需检验是否齐方差,此处不需要)st.ttest_rel(gmv_A,gmv_B) p值小于0.05,拒绝原假设,因此可认为实验条件对gmv有显著影响。 5、ROI检验 5.1 ROI方差检验 #levene检验ROI是否齐方差ROI_A=test[test.group=='control'].ROIROI_B=test[test.group=='experiment'].ROIst.levene(ROI_A,ROI_B) p值大于0.05,不拒绝原假设,因此可认为两组实验ROI齐方差。 5.2 ROI均值检验 #配对样本t检验(两独立样本t检验之前需检验是否齐方差,此处不需要)st.ttest_rel(ROI_A,ROI_B) p值小于0.05,拒绝原假设,因此可认为实验条件对ROI有显著影响。 二、城市运营分析 1、数据导入 #导入该城市运营相关数据city=pd.read_excel('/home/kesci/input/didi4010/city.xlsx')city.head() #查看数据有无缺失值city.info() 2、数据探索 2.1 单量最多的时间点 req_hour=city.groupby(['hour'],as_index=True).agg({'requests':sum},inplace=True)req_hour #绘制各时点订单请求柱状图importmatplotlib.pyplotaspltreq_hour.plot(kind='bar')plt.xticks(rotation=0)plt.show() 可见,在11、12、13这三个时间点内,12点用户发起订单的需求是最大的,其次是13点,11点。 司机运营平台应考虑加大该时点车辆供应。 2.2 单量最多的日期 req_date=city.groupby(['date'],as_index=True).agg({'requests':sum},inplace=True)req_date.sort_values('date').head() #绘制订单请求数随日期变化的折线图req_date.plot(kind='line')plt.show() 单月订单请求数随日期的变化呈周期性变化,我们猜测4个峰值分别对应4个周末,周末用户出行需求较大。 经验证发现猜想与数据吻合,因此司机运营平台应考虑加大周末、节假日的车辆供给。 2.3 各时段订单完成率 com_hour=city.groupby(['hour'],as_index=False).agg({'requests':sum,'trips':sum},inplace=True)com_hour['rate']=com_hour['trips']/com_hour['requests']com_hour 13点订单需求较多,但订单完成率仅47%,说明较多订单没有得到及时相应。 客运部应重点关注13点订单相应时长,排查具体原因。 2.4 单月每日订单完成率 com_date=city.groupby(['date'],as_index=True).agg({'requests':sum,'trips':sum},inplace=True)com_date['rate']=com_date['trips']/com_date['requests']com_date.sort_values('date').head() #绘制订单完成率随日期变化的折线图com_date.rate.plot(kind='line')plt.show() 单月每日订单完成率规律不太明显,但几个谷值基本都出现在周末附近,说明客户出行需求的提升可能导致响应率的降低。 2.5 顾客等待时间 importnumpyasnpeta_hour=city.groupby(['hour'],as_index=True).agg({'pETA':np.mean,'aETA':np.mean},inplace=True)eta_hour #绘制顾客等待时长复合柱状图eta_hour.plot(kind='bar') 以上可见,无论哪个时点,用户实际等待时长均明显大于用户预计等待时长。 各时点用户等待时长差异不明显,但13点最高。 客运部一方面应提升用户预计等待时长的准确性,另一方面优化平台派单逻辑等。 2.6 司机在忙率 city['busy']=city['supplyhours']*city['utiliz']city.head() busy_hour=city.groupby(['hour'],as_index=False).agg({'supplyhours':sum,'busy':sum})busy_hour['utiliz']=busy_hour['busy']/busy_hour['supplyhours']busy_hour 12点司机在忙总时长最长,在忙率也最高,用户订单请求也最多,说明车辆总数偏少。 2.7 订单时长 trip_min=city.groupby(['hour'],as_index=False).agg({'averageminutesoftrips':np.mean})trip_min 12点用户订单需求较多,同时订单时长最长,说明这个时间点是一个非常重要的时间点。 supply_hour=city.groupby(['hour'],as_index=False).agg({'supplyhours':np.mean})supply_hour 13点订单量也较大,此时点司机服务时长较短。 为优化用户出行体验,司机运营平台可联合客运部可考虑此时段尽量分配总服务时长较长的司机来接单(经验较为丰富)。 3、后续思考方向: 提升顾客预计等待时长预测准确度(需要历史数据进行预测) 加大车辆投入(分车辆不同等级来看,因此可能需要车辆相关信息表) 优化用户体验(需要客诉相关数据) 优化平台派单逻辑(需要订单的位置相关数据) 个性化需求(需要用户属性、及其他行为数据) 本文相关代码下载: https://alltodata.cowtransfer.com/s/9bb9acdc15ae40 推荐一本书,本周末统一上架 感谢北京大学出版社的大力支持 PS 当当新用户优惠码:DPC3CX 满60-20,亲测可以换手机号使用 本文分享自微信公众号 - 凹凸数据(alltodata)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Flutter Dojo 的设计之道

认识Flutter是在18年,移动端开发日趋成熟的情况下,很多开发者都在寻求跨平台开发的终极法门,在经过了webview、RN的痛苦之后,Flutter的出现,给跨平台开发带来了一线曙光。自此,便开始了Flutter的学习之路,布道师之路,修仙之路。 筑基 Flutter的学习曲线很奇怪,像坐过山车一样,初学很简单,上手几天,很快就能写一些基本的界面,但是很快就遇到了瓶颈,因为官方的Widget越来越多,越来越复杂,学了忘,忘了学,有些人突破了,成为了一代先驱,有些人则被搞的一团雾水,大骂一声,垃圾Flutter,毁我青春。 相信大部分上手的开发者,都会抱怨两个问题,一是Widget太多,二是嵌套太多。嵌套太多的问题,没什么好解释的,大部分有这种抱怨的人,都是因为不知道如何正确的使用茫茫多的Widget而恼羞成怒的。 对于UI界面来说,树形结构是表现UI最好的方式,当然可以通过很多其它的方式来减少嵌套,但simple is fast,Android xml布局中,嵌套近十层的布局比比皆是,这对于写UI来说,并不会造成什么困扰。 但是Widget太多,确实是一个比较麻烦的问题,这里的学习什么考验开发者的学习能力,Flutter虽然在设计Widget方面略显随意,但是官方所给出的Widget,几乎都是比较实用的,覆盖了开发的方方面面,只用常用的那些Widget,确实也可以完成大部分UI的开发,但是,掌握更多的官方Widget,会让你的开发更加方便。 我在学习的过程中,自然也遇到了这些问题,经过一年多的沉淀,逐渐对整个架构有了一些认识,所以也萌生了一些想法,想通过一个Flutter App,来帮助初学者、进阶者快速掌握Flutter,这才有了Flutter Dojo的雏形。 Dojo,源自日语「道場」。我希望的是通过Flutter Dojo让初学者快速掌握官方Widget的常用使用方法,让进阶者掌握Flutter开发组件、封装组件的基本思路,让学有小成者更加高效、更加快速的进行Flutter开发。 所以,我在最开始的时候,将Flutter Dojo分为了下面几个部分: Widgets UI Pattern Animations Back-end Util Flutter Dojo的设计主要围绕下面三个部分展开: 良好的演示效果 简单明了的代码 好看的界面设计 整个项目的代码都以上面几点作为目标,代码力图简洁,不使用复杂的架构设计和抽象,每一部分的演示代码几乎都可以单独使用,同时尽可能的美化UI。 Widgets Widgets部分的设计思路是为了演示Flutter中茫茫多的Widget的具体使用场景和功能,虽然只使用Flutter提供的一些基本Widget,已经可以实现大部分的界面、功能开发,但是,了解更多的Widget,可以让开发者的开发思路更广,使用更加合适的Widget来完成合适的开发场景。 经过迭代,Widgets部分已经完善了官方的所有Widget,以及官方在Category中未列举但是有很大实用价值的Widget。 UI Pattern UI Pattern部分的设计思路是为了帮助开发者了解如何使用Flutter来拆分大部分APP中的界面模板,通过Flutter实现一个个UI组件,来组合成完整的Flutter界面。 通过UI Pattern的学习,可以让开发者了解Flutter的具体解题思路,如何拆分UI的实现套路。 Animations Animations部分的设计思路是为了让开发者对Flutter的动画有一个完整的认识,针对不同的场景使用不同的动画方案,同时,对大部分常见的动画场景进行梳理,完成动画场景的归类。 Back-end Util Back-end Util这部分主要是针对Flutter中的非UI场景知识点进行的梳理,包括数据持久化、解析、状态管理等等。 最初的这一版,在GitHub的私有仓库迭代了将近一年,才终于基本定型Release出来。 出窍 有了具体的设计思路后,我就开始构思如何来实现了,Flutter Dojo,首先是一个Demo,即演示类的App,所以,它一定是重在代码,但却可以通过Demo的分解,将功能演示出来,其次,虽然说是Demo,但绝不是一个粗制滥造的UI,长得好看,才叫Flutter Dojo,长的丑,只能叫Flutter Demo。所以,最后的设计风格调整了好几次,最终定稿如下。 这四个部分,是Flutter Dojo的核心功能,分别对应了上面提到的四个部分。 Widgets Widgets部分的设计完全按照官方的Flutter Widget Category来进行分类。 一级分类和二级分类,分类整理了官方的所有Widget和简介。 当然,核心是每个Widget的使用场景的展示。 这里只展示了几个Widget的演示界面,更多的Widget,请自行使用。 UI Pattern UI Pattern的分类,我是按照组件的功能进行划分的。 Animations Animations的分类同样是根据动画构建类型来进行分类的。 Back-end Util Flutter虽然说是一个UI跨平台框架,但是其征途依然是星辰大海,所以即使是非UI的东西,Flutter依然会包含,所以,这部分就展示的是各种非UI的Flutter开发技术点。 有了这四部分的加持,Flutter Dojo的核心功能就算是完备了,当然,这里面的分类和Demo依然在不停的更新中,所以,Flutter Dojo只会越来越完善,不过万变不离其宗,其设计思想依然是围绕着这四个方面展开的。 至此,Flutter Dojo 1.0 发布。 分神 在设计完这四个核心的方向之后,我开始自己使用Flutter Dojo来巩固Flutter的学习,在使用过程中,逐渐发现了一些不足,比如在使用App的时候,不能查看代码,虽然场景设计的是通过界面来掌握Flutter Widget的学习,但是,并不是所有的场景都能完美的让你学到这个Widget的使用精髓,所以,在App端查看代码是一个刚需,在学习场景的时候,遇到不懂的地方,可以直接通过查看代码来了解具体的使用原理。 其次,Flutter Dojo的代码设计为copy anywhere的,Demo中的代码,几乎全部是可以完全复制使用的,这也是为了初学者考虑,整个代码不包含复用、继承等架构设计,开发者通过单个的Demo示例就可以完全掌握,而不是要先了解其它基类、抽象的实现等等,所以要实现代码的轻松copy功能。 另外,由于Widget和Pattern分类越来越多,查看起来经常会忘记分类的具体位置,所以,搜索功能也是亟需添加的。 因此,在Flutter Dojo 1.0的基础之上,2.0版本新增了搜索、查看源代码以及分享功能。 搜索功能非常强大,支持模糊匹配、前后缀匹配,效率高、速度快。 查看源代码功能,使用Markdown解析源代码,可以直接在App中查看代码。 分享功能可直接将源代码分享出去,实现copy anywhere。 至此,Flutter Dojo 2.0 发布。 合体 Flutter Dojo经过两个版本的迭代,不仅仅在功能上更加完善了,分类和Demo的拆解也更加优秀了,所以,在Flutter Dojo 3.0上,我增加了一些信息流的设计,让开发者在学习这些现有知识的基础上,能够更加好的接触到一些更新的Flutter文章,所以,这里我设计了一个Feed功能,将掘金上的Flutter Tag下的文章聚合到Flutter Dojo中。 至此,Flutter Dojo 3.0 发布。 渡劫 本篇是Flutter Dojo解析文章的总纲,后面会有一系列文章来进行分析Flutter Dojo中那些不为人知的秘密。 飞升 Flutter Dojo具体该怎么使用呢?首先,大家可以在GitHub下载最新的Flutter Dojo Apk Github Actions APK download 或者在【百度应用市场】【小米应用市场】搜索【Flutter dojo】下载最新的Apk文件安装。 先熟悉整体结构,在空闲时间,对感兴趣的Demo进行学习,遇到难点,可以通过App内置的查看代码功能查看具体代码,或者通过分析功能将代码copy出来分析。 当你觉得整体差不多后,可以将整个工程clone下来,针对代码和工程做进一步的学习。 修仙 Flutter Dojo开源至今,受到了很多Flutter学习者和爱好者的喜爱,也有越来越多的人加入到Flutter的学习中来,所以我建了个Flutter修仙群,但是人数太多,所以分成了【Flutter修仙指南】【Flutter修仙指北】两个群,对Flutter感兴趣的朋友,可以添加我的微信,注明加入Flutter修仙群。 项目地址: https://github.com/xuyisheng/flutter_dojo 欢迎大家前来star,让更多的开发者享受到Flutter的开发乐趣。 本文分享自微信公众号 - Android群英传(android_heroes)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 写好测试,提升应用质量

相信在国内一些中小型公司,开发者很少会去写软件测试相关的代码。当然这背后有一些原因在。本文就讲讲 iOS 开发中的软件测试相关的内容。 一、 测试的重要性 测试很重要!测试很重要!测试很重要!重要的事情说三遍。 场景1:每次我们写完代码后都需要编译运行,以查看应用程序的表现是否符合预期。假如改动点、代码量小,那验证成本低一些,假如不符合预期,则说明我们的代码有问,人工去排查问题花费的时间也少一些。假如改动点很多、受影响的地方较多,我们首先要大概猜测受影响的功能,然后去定位问题、排查问题的成本就很高。 场景2:你新接手的 SDK 某个子功能需要做一次技术重构。但是你只有在公司内部的代码托管平台上可以看到一些 Readme、接入文档、系统设计文档、技术方案评估文档等一堆文档。可能你会看完再去动手重构。当你重构完了,找了公司某条业务线的 App 接入测试,点了几下发现发生了奔溃。😂 心想,本地测试、debug 都正常可是为什么接入后就 Crash 了。其实想想也好理解,你本地重构只是确保了你开发的那个功能运行正常,你很难确保你写的代码没有影响其他类、其他功能。假如之前的 SDK 针对每个类都有单元测试代码,那你在新功能开发完毕后完整跑一次单元测试代码就好了,保证每个 Unit Test 都通过、分支覆盖率达到约定的线,那么基本上是没问题的。 场景3:在版本迭代的时候,计划功能 A,从开发、联调、测试、上线共2周时间。老司机做事很自信,这么简单的 UI、动画、交互,代码风骚,参考服务端的「领域驱动」在该 feature 开发阶段落地试验了下。联调、本地测试都通过了,还剩3天时间,本以为测试1天,bug fix 一天,最后一天提交审核。代码跟你开了个玩笑,测试完 n 个 bug(大大超出预期)。为了不影响 App 的发布上架,不得不熬夜修 bug。将所有的测试都通过测试工程师去处理,这个阶段理论上质量应该很稳定,不然该阶段发现代码异常、技术设计有漏洞就来不及了,你需要协调各个团队的资源(可能接口要改动、产品侧要改动),这个阶段造成改动的成本非常大。 相信大多数开发者都遇到过上述场景的问题。其实上述这几个问题都有解,那就是“软件测试”。 二、软件测试 1. 分类 软件测试就是在规定的条件下对应用程序进行操作,以发现程序错误,衡量软件质量,并对其是否能满足设计要求进行评估的过程。 合理应用软件测试技术,就可以规避掉第一部分的3个场景下的问题。 软件测试强调开发、测试同步进行,甚至是测试先行,从需求评审阶段就先考虑好软件测试方案,随后才进行技术方案评审、开发编码、单元测试、集成测试、系统测试、回归测试、验收测试等。 软件测试从测试范围分为:单元测试、集成测试、系统测试、回归测试、验收测试(有些公司会谈到“冒烟测试“,这个词的精确定义不知道,但是学软件测试课的时候按照范围就只有上述几个分类)。工程师自己负责的是单元测试。测试工程师、QA 负责的是集成测试、系统测试。 单元测试(Unit Testing):又称为模块测试,是针对程序模块(软件设计的最小单位)来进行正确性检验的测试工作。「单元」的概念会比较抽象,它不仅仅是我们所编写的某个方法、函数,也可能是某个类、对象等。 软件测试从开发模式分为:面向测试驱动开发 TDD (Test-driven development)、面向行为驱动开发 BDD (Behavior-driven development)。 2. TDD TDD 的思想是:先编写测试用例,再快速开发代码,然后在测试用例的保证下,可以方便安全地进行代码重构,提升应用程序的质量。一言以蔽之就是通过测试来推动开发的进行。正是由于这个特点,TDD 被广泛使用于敏捷开发。 也就是说 TDD 模式下,首先考虑如何针对功能进行测试,然后去编写代码实现,再不断迭代,在测试用例的保证下,不断进行代码优化。 优点:目标明确、架构分层清晰。可保证开发代码不会偏离需求。每个阶段持续测试 缺点:技术方案需要先评审结束、架构需要提前搭建好。假如需求变动,则前面步骤需要重新执行,灵活性较差。 3. BDD BDD 即行为驱动开发,是敏捷开发技术之一,通过自然语言定义系统行为,以功能使用者的角度,编写需求场景,且这些行为描述可以直接形成需求文档,同时也是测试标准。 BDD 的思想是跳出单一的函数,针对的是行为而展开的测试。BDD 关心的是业务领域、行为方式,而不是具体的函数、方法,通过对行为的描述来验证功能的可用性。BDD 使用 DSL (Domin Specific Language)领域特定语言来描述测试用例,这样编写的测试用例非常易读,看起来跟文档一样易读,BDD 的代码结构是 Given->When->Then。 优点:各团队的成员可以集中在一起,设计基于行为的计测试用例。 4. 对比 根据特点也就是找到了各自的使用场景,TDD 主要针对开发中的最小单元进行测试,适合单元测试。而 BDD 针对的是行为,所以测试范围可以再大一些,在集成测试、系统测试中都可以使用 TDD 编写的测试用例一般针对的是开发中的最小单元(比如某个类、函数、方法)而展开,适合单元测试。 BDD 编写的测试用例针对的是行为,测试范围更大一些,适合集成测试、系统测试阶段。 三、 单元测试编码规范<a name="codeRules"></a> 本文的主要重点是针对日常开发阶段工程师可以做的事情,也就是单元测试而展开。 编写功能、业务代码的时候一般会遵循 kiss 原则 ,所以类、方法、函数往往不会太大,分层设计越好、职责越单一、耦合度越低的代码越适合做单元测试,单元测试也倒逼开发过程中代码分层、解耦。 可能某个功能的实现代码有30行,测试代码有50行。单元测试的代码如何编写才更合理、整洁、规范呢? 1. 编码分模块展开 先贴一段代码。 - (void)testInsertDataInOneSpecifiedTable { XCTestExpectation *exception = [self expectationWithDescription:@"测试数据库插入功能"]; // given [dbInstance removeAllLogsInTableType:PCTLogTableTypeMeta]; NSMutableArray *insertModels = [NSMutableArray array]; for (NSInteger index = 1; index <= 10000; index++) { PCTLogMetaModel *model = [[PCTLogMetaModel alloc] init]; model.log_id = index; // ... [insertModels addObject:model]; } // when [dbInstance add:insertModels inTableType:PCTLogTableTypeMeta]; // then [dbInstance recordsCountInTableType:PCTLogTableTypeMeta completion:^(NSInteger count) { XCTAssert(count == insertModels.count, @"「数据增加」功能:异常"); [exception fulfill]; }]; [self waitForExpectationsWithCommonTimeout]; } 可以看到这个方法的名称为 testInsertDataInOneSpecifiedTable,这段代码做的事情通过函数名可以看出来:测试插入数据到某个特定的表。这个测试用例分为3部分:测试环境所需的先决条件准备;调用所要测试的某个方法、函数;验证输出和行为是否符合预期。 其实,每个测试用例的编写也要按照该种方式去组织代码。步骤分为3个阶段:Given->When->Then。 所以单元测试的代码规范也就出来了。此外单元测试代码规范统一后,每个人的测试代码都按照这个标准展开,那其他人的阅读起来就更加容易、方便。按照这3个步骤去阅读、理解测试代码,就可以清晰明了的知道在做什么。 2. 一个测试用例只测试一个分支 我们写的代码有很多语句组成,有各种逻辑判断、分支(if...else、swicth)等等,因此一个程序从一个单一入口进去,过程可能产生 n 个不同的分支,但是程序的出口总是一个。所以由于这样的特性,我们的测试也需要针对这样的现状走完尽可能多的分支。相应的指标叫做「分支覆盖率」。 假如某个方法内部有 if...else...,我们在测试的时候尽量将每种情况写成一个单独的测试用例,单独的输入、输出,判断是否符合预期。这样每个 case 都单一的测试某个分支,可读性也很高。 比如对下面的函数做单元测试,测试用例设计如下 - (void)shouldIEatSomething { BOOL shouldEat = [self getAteWeight] < self.dailyFoodSupport; if (shouldEat) { [self eatSomemuchFood]; } else { [self doSomeExercise]; } } - (void)testShouldIEatSomethingWhenHungry { // .... } - (void)testShouldIEatSomethingWhenFull { // ... } 3. 明确标识被测试类 这条主要站在团队合作和代码可读性角度出发来说明。写过单元测试的人都知道,可能某个函数本来就10行代码,可是为了测试它,测试代码写了30行。一个方法这样写问题不大,多看看就看明白是在测试哪个类的哪个方法。可是当这个类本身就很大,测试代码很大的情况下,不管是作者自身还是多年后负责维护的其他同事,看这个代码阅读成本会很大,需要先看测试文件名 代码类名 + Test 才知道是测试的是哪个类,看测试方法名 test + 方法名 才知道是测试的是哪个方法。 这样的代码可读性很差,所以应该为当前的测试对象特殊标记,这样测试代码可读性越强、阅读成本越低。比如定义局部变量 _sut 用来标记当前被测试类(sut,System under Test,软件测试领域有个词叫做被测系统,用来表示正在被测试的系统)。 #import <XCTest/XCTest.h> #import "PCTLogPayloadModel.h" @interface PCTLogPayloadModelTest : PCTTestCase { PCTLogPayloadModel *_sut; } @end @implementation PCTLogPayloadModelTest - (void)setUp { [super setUp]; PCTLogPayloadModel *model = [[PCTLogPayloadModel alloc] init]; model.log_id = 1; // ... _sut = model; } - (void)tearDown { _sut = nil; [super tearDown]; } - (void)testGetDictionary { NSDictionary *payloadDictionary = [_sut getDictionary]; XCTAssert([(NSString *)payloadDictionary[@"report_id"] isEqualToString:@"001"] && [payloadDictionary[@"size"] integerValue] == 102 && [(NSString *)payloadDictionary[@"meta"] containsString:@"meiying"], @"PCTLogPayloadModel 的 「getDictionary」功能异常"); } @end 4. 使用分类来暴露私有方法、私有变量 某些场景下写的测试方法内部可能需要调用被测对象的私有方法,也可能需要访问被测对象的某个私有属性。但是测试类里面是访问不到被测类的私有属性和私有方法的,借助于 Category 可以实现这样的需求。 为测试类添加一个分类,后缀名为 UnitTest。如下所示 PrismClient 类有私有属性 @property (nonatomic, strong) NSString *name;,私有方法 - (void)hello。为了在测试用例中访问私有属性和私有方法,写了如下分类 // PCTPrismClientTest.m @interface PrismClient (UnitTest) - (NSString *)name; - (void)hello; @end @implementation PCTPrismClientTest - (void)testPrivatePropertyAndMethod { NSLog(@"%@",[PrismClient sharedInstance].name); [[PrismClient sharedInstance] hello]; } @end 四、 单元测试下开发模式、技术框架选择 单元测试是按照测试范围来划分的。TDD、BDD 是按照开发模式来划分的。因此就有各种排列组合,这里我们只关心单元测试下的 TDD、BDD 方案。 在单元测试阶段,TDD 和 BDD 都可以适用。 1. TDD TDD 强调不断的测试推动代码的开发,这样简化了代码,保证了代码质量。 思想是在拿到一个新的功能时,首先思考该功能如何测试,各种测试用例、各种边界 case;然后完成测试代码的开发;最后编写相应的代码以满足、通过这些测试用例。 TDD 开发过程类似下图: <a name="TDDStructure"></a> 先编写该功能的测试用例,实现测试代码。这时候去跑测试,是不通过的,也就是到了红色的状态 然后编写真正的功能实现代码。这时候去跑测试,测试通过,也就是到了绿色的状态 在测试用例的保证下,可以重构、优化代码 抛出一个问题:TDD 看上去很好,应该用它吗? 这个问题不用着急回答,回答了也不会有对错之分。开发中经常是这样一个流程,新的需求出来后,先经过技术评审会议,确定宏观层面的技术方案、确定各个端的技术实现、使用的技术等,整理出开发文档、会议文档。工期评估后开始编码。事情这么简单吗?前期即使想的再充分、再细致,可能还是存在特殊 case 漏掉的情况,导致技术方案或者是技术实现的改变。如果采用 TDD,那么之前新功能给到后,就要考虑测试用例的设计、编写了测试代码,在测试用例的保证下再去实现功能。如果遇到了技术方案的变更,之前的测试用例要改变、测试代码实现要改变。可能新增的某个 case 导致大部分的测试代码和实现代码都要改变。 如何开展 TDD** 新建一个工程,确保 “Include Unit Tests” 选项是选中的状态 创建后的工程目录如下 删除 Xcode 创建的测试模版文件 TDDDemoTests.m 假如我们需要设计一个人类,它具有吃饭的功能,且当他吃完后会说一句“好饱啊”。 那么按照 TDD 我们先设计测试用例。假设有个 Person 类,有个对象方法叫做吃饭,吃完饭后会返回一个“好饱啊”的字符串。那测试用例就是 步骤 期望 结果 实例化 Person 对象,调用对象的 eat 方法 调用后返回“好饱啊” ? 实现测试用例代码。创建继承自 Unit Test Case class 的测试类,命名为 工程前缀+测试类名+Test,也就是 TDDPersonTest.m。 因为要测试 Person 类,所以在主工程中创建 Person 类 因为要测试人类在吃饭后说一句“好饱啊”。所以设想那个类目前只有一个吃饭的方法。于是在 TDDPersonTest.m 中创建一个测试函数 -(void)testReturnStatusStringWhenPersonAte;函数内容如下 - (void)testReturnStatusStringWhenPersonAte { // Given Person *somebody = [[Person alloc] init]; // When NSString *statusMessage = [somebody performSelector:@selector(eat)]; // Then XCTAssert([statusMessage isEqualToString:@"好饱啊"], @"Person 「吃饭后返回“好饱啊”」功能异常"); } Xcode 下按快捷键 Command + U,跑测试代码发现是失败的。因为我们的 Person 类根本没实现相应的方法 从 TDD 开发过程可以看到,我们现在是红色的 “Fail” 状态。所以需要去 Person 类中实现功能代码。Person 类如下 #import "Person.h" @implementation Person - (NSString *)eat { [NSThread sleepForTimeInterval:1]; return @"好饱啊";; } @end 再次运行,跑一下测试用例(Command + U 快捷键)。发现测试通过,也就是TDD 开发过程中的绿色 “Success” 状态。 例子比较简单,假如情况需要,可以在 -(void)setUp 方法里面做一些测试的前置准备工作,在 -(void)tearDown 方法里做资源释放的操作 假如 eat 方法实现的不够漂亮。现在在测试用例的保证下,大胆重构,最后确保所有的 Unit Test case 通过即可。 2. BDD 相比 TDD,BDD 关注的是行为方式的设计,拿上述“人吃饭”举例说明。 和 TDD 相比第1~4步骤相同。 BDD 则需要先实现功能代码。创建 Person 类,实现 -(void)eat;方法。代码和上面的相同 BDD 需要引入好用的框架 Kiwi,使用 Pod 的方式引入 因为要测试人类在吃饭后说一句“好饱啊”。所以设想那个类目前只有一个吃饭的方法。于是在 TDDPersonTest.m 中创建一个测试函数 -(void)testReturnStatusStringWhenPersonAte;函数内容如下 #import "kiwi.h" #import "Person.h" SPEC_BEGIN(BDDPersonTest) describe(@"Person", ^{ context(@"when someone ate", ^{ it(@"should get a string",^{ Person *someone = [[Person alloc] init]; NSString *statusMessage = [someone eat]; [[statusMessage shouldNot] beNil]; [[statusMessage should] equal:@"好饱啊"]; }); }); }); SPEC_END 3. XCTest 开发步骤 Xcode 自带的测试系统是 XCTest,使用简单。开发步骤如下 在 Tests 目录下为被测的类创建一个继承自 XCTestCase 的测试类。 删除新建的测试代码模版里面的无用方法 - (void)testPerformanceExample、- (void)testExample。 跟普通类一样,可以继承,可以写私有属性、私有方法。所以可以在新建的类里面,根据需求写一些私有属性等 在 - (void)setUp 方法里面写一些初始化、启动设置相关的代码。比如测试数据库功能的时候,写一些数据库连接池相关代码 为被测类里面的每个方法写测试方法。被测类里面可能是 n 个方法,测试类里面可能是 m 个方法(m >= n),根据我们在第三部分:单元测试编码规范里讲过的 一个测试用例只测试一个分支,方法内部有 if、switch 语句时,需要为每个分支写测试用例 为测试类每个方法写的测试方法有一定的规范。命名必须是 test+被测方法名。函数无参数、无返回值。比如 - (void)testSharedInstance。 测试方法里面的代码按照 Given->When->Then 的顺序展开。测试环境所需的先决条件准备;调用所要测试的某个方法、函数;使用断言验证输出和行为是否符合预期。 在 - (void)tearDown 方法里面写一些释放掉资源或者关闭的代码。比如测试数据库功能的时候,写一些数据库连接池关闭的代码 断言相关宏 /*! * @function XCTFail(...) * Generates a failure unconditionally. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTFail(...) \ _XCTPrimitiveFail(self, __VA_ARGS__) /*! * @define XCTAssertNil(expression, ...) * Generates a failure when ((\a expression) != nil). * @param expression An expression of id type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNil(expression, ...) \ _XCTPrimitiveAssertNil(self, expression, @#expression, __VA_ARGS__) /*! * @define XCTAssertNotNil(expression, ...) * Generates a failure when ((\a expression) == nil). * @param expression An expression of id type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNotNil(expression, ...) \ _XCTPrimitiveAssertNotNil(self, expression, @#expression, __VA_ARGS__) /*! * @define XCTAssert(expression, ...) * Generates a failure when ((\a expression) == false). * @param expression An expression of boolean type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssert(expression, ...) \ _XCTPrimitiveAssertTrue(self, expression, @#expression, __VA_ARGS__) /*! * @define XCTAssertTrue(expression, ...) * Generates a failure when ((\a expression) == false). * @param expression An expression of boolean type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertTrue(expression, ...) \ _XCTPrimitiveAssertTrue(self, expression, @#expression, __VA_ARGS__) /*! * @define XCTAssertFalse(expression, ...) * Generates a failure when ((\a expression) != false). * @param expression An expression of boolean type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertFalse(expression, ...) \ _XCTPrimitiveAssertFalse(self, expression, @#expression, __VA_ARGS__) /*! * @define XCTAssertEqualObjects(expression1, expression2, ...) * Generates a failure when ((\a expression1) not equal to (\a expression2)). * @param expression1 An expression of id type. * @param expression2 An expression of id type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertEqualObjects(expression1, expression2, ...) \ _XCTPrimitiveAssertEqualObjects(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertNotEqualObjects(expression1, expression2, ...) * Generates a failure when ((\a expression1) equal to (\a expression2)). * @param expression1 An expression of id type. * @param expression2 An expression of id type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNotEqualObjects(expression1, expression2, ...) \ _XCTPrimitiveAssertNotEqualObjects(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertEqual(expression1, expression2, ...) * Generates a failure when ((\a expression1) != (\a expression2)). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertEqual(expression1, expression2, ...) \ _XCTPrimitiveAssertEqual(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertNotEqual(expression1, expression2, ...) * Generates a failure when ((\a expression1) == (\a expression2)). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNotEqual(expression1, expression2, ...) \ _XCTPrimitiveAssertNotEqual(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertEqualWithAccuracy(expression1, expression2, accuracy, ...) * Generates a failure when (difference between (\a expression1) and (\a expression2) is > (\a accuracy))). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param accuracy An expression of C scalar type describing the maximum difference between \a expression1 and \a expression2 for these values to be considered equal. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertEqualWithAccuracy(expression1, expression2, accuracy, ...) \ _XCTPrimitiveAssertEqualWithAccuracy(self, expression1, @#expression1, expression2, @#expression2, accuracy, @#accuracy, __VA_ARGS__) /*! * @define XCTAssertNotEqualWithAccuracy(expression1, expression2, accuracy, ...) * Generates a failure when (difference between (\a expression1) and (\a expression2) is <= (\a accuracy)). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param accuracy An expression of C scalar type describing the maximum difference between \a expression1 and \a expression2 for these values to be considered equal. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNotEqualWithAccuracy(expression1, expression2, accuracy, ...) \ _XCTPrimitiveAssertNotEqualWithAccuracy(self, expression1, @#expression1, expression2, @#expression2, accuracy, @#accuracy, __VA_ARGS__) /*! * @define XCTAssertGreaterThan(expression1, expression2, ...) * Generates a failure when ((\a expression1) <= (\a expression2)). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertGreaterThan(expression1, expression2, ...) \ _XCTPrimitiveAssertGreaterThan(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertGreaterThanOrEqual(expression1, expression2, ...) * Generates a failure when ((\a expression1) < (\a expression2)). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertGreaterThanOrEqual(expression1, expression2, ...) \ _XCTPrimitiveAssertGreaterThanOrEqual(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertLessThan(expression1, expression2, ...) * Generates a failure when ((\a expression1) >= (\a expression2)). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertLessThan(expression1, expression2, ...) \ _XCTPrimitiveAssertLessThan(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertLessThanOrEqual(expression1, expression2, ...) * Generates a failure when ((\a expression1) > (\a expression2)). * @param expression1 An expression of C scalar type. * @param expression2 An expression of C scalar type. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertLessThanOrEqual(expression1, expression2, ...) \ _XCTPrimitiveAssertLessThanOrEqual(self, expression1, @#expression1, expression2, @#expression2, __VA_ARGS__) /*! * @define XCTAssertThrows(expression, ...) * Generates a failure when ((\a expression) does not throw). * @param expression An expression. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertThrows(expression, ...) \ _XCTPrimitiveAssertThrows(self, expression, @#expression, __VA_ARGS__) /*! * @define XCTAssertThrowsSpecific(expression, exception_class, ...) * Generates a failure when ((\a expression) does not throw \a exception_class). * @param expression An expression. * @param exception_class The class of the exception. Must be NSException, or a subclass of NSException. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertThrowsSpecific(expression, exception_class, ...) \ _XCTPrimitiveAssertThrowsSpecific(self, expression, @#expression, exception_class, __VA_ARGS__) /*! * @define XCTAssertThrowsSpecificNamed(expression, exception_class, exception_name, ...) * Generates a failure when ((\a expression) does not throw \a exception_class with \a exception_name). * @param expression An expression. * @param exception_class The class of the exception. Must be NSException, or a subclass of NSException. * @param exception_name The name of the exception. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertThrowsSpecificNamed(expression, exception_class, exception_name, ...) \ _XCTPrimitiveAssertThrowsSpecificNamed(self, expression, @#expression, exception_class, exception_name, __VA_ARGS__) /*! * @define XCTAssertNoThrow(expression, ...) * Generates a failure when ((\a expression) throws). * @param expression An expression. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNoThrow(expression, ...) \ _XCTPrimitiveAssertNoThrow(self, expression, @#expression, __VA_ARGS__) /*! * @define XCTAssertNoThrowSpecific(expression, exception_class, ...) * Generates a failure when ((\a expression) throws \a exception_class). * @param expression An expression. * @param exception_class The class of the exception. Must be NSException, or a subclass of NSException. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNoThrowSpecific(expression, exception_class, ...) \ _XCTPrimitiveAssertNoThrowSpecific(self, expression, @#expression, exception_class, __VA_ARGS__) /*! * @define XCTAssertNoThrowSpecificNamed(expression, exception_class, exception_name, ...) * Generates a failure when ((\a expression) throws \a exception_class with \a exception_name). * @param expression An expression. * @param exception_class The class of the exception. Must be NSException, or a subclass of NSException. * @param exception_name The name of the exception. * @param ... An optional supplementary description of the failure. A literal NSString, optionally with string format specifiers. This parameter can be completely omitted. */ #define XCTAssertNoThrowSpecificNamed(expression, exception_class, exception_name, ...) \ _XCTPrimitiveAssertNoThrowSpecificNamed(self, expression, @#expression, exception_class, exception_name, __VA_ARGS__) 经验小结 XCTestCase 类和其他类一样,你可以定义基类,这里面封装一些常用的方法。 // PCTTestCase.h #import <XCTest/XCTest.h> NS_ASSUME_NONNULL_BEGIN @interface PCTTestCase : XCTestCase @property (nonatomic, assign) NSTimeInterval networkTimeout; /** 用一个默认时间设置异步测试 XCTestExpectation 的超时处理 */ - (void)waitForExpectationsWithCommonTimeout; /** 用一个默认时间设置异步测试的 @param handler 超时的处理逻辑 */ - (void)waitForExpectationsWithCommonTimeoutUsingHandler:(XCWaitCompletionHandler __nullable)handler; /** 生成 Crash 类型的 meta 数据 @return meta 类型的字典 */ - (NSDictionary *)generateCrashMetaDataFromReport; @end NS_ASSUME_NONNULL_END // PCTTestCase.m #import "PCTTestCase.h" #import ... @implementation PCTTestCase #pragma mark - life cycle - (void)setUp { [super setUp]; self.networkTimeout = 20.0; // 1. 设置平台信息 [self setupAppProfile]; // 2. 设置 Mget 配置 [[TITrinityInitManager sharedInstance] setup]; // .... // 3. 设置 PrismClient [[PrismClient sharedInstance] setup]; } - (void)tearDown { [super tearDown]; } #pragma mark - public Method - (void)waitForExpectationsWithCommonTimeout { [self waitForExpectationsWithCommonTimeoutUsingHandler:nil]; } - (void)waitForExpectationsWithCommonTimeoutUsingHandler:(XCWaitCompletionHandler __nullable)handler { [self waitForExpectationsWithTimeout:self.networkTimeout handler:handler]; } - (NSDictionary *)generateCrashMetaDataFromReport { NSMutableDictionary *metaDictionary = [NSMutableDictionary dictionary]; NSDate *crashTime = [NSDate date]; metaDictionary[@"MONITOR_TYPE"] = @"appCrash"; // ... metaDictionary[@"USER_CRASH_DATE"] = @([crashTime timeIntervalSince1970] * 1000); return [metaDictionary copy]; } #pragma mark - private method - (void)setupAppProfile { [[CMAppProfile sharedInstance] setMPlatform:@"70"]; // ... } @end 上述说的基本是开发规范相关。测试方法内部如果调用了其他类的方法,则在测试方法内部必须 Mock 一个外部对象,限制好返回值等。 在 XCTest 内难以使用 mock 或 stub,这些是测试中非常常见且重要的功能 例子 这里举个例子,是测试一个数据库操作类 PCTDatabase,代码只放某个方法的测试代码。 - (void)testRemoveLatestRecordsByCount { XCTestExpectation *exception = [self expectationWithDescription:@"测试数据库删除最新数据功能"]; // 1. 先清空数据表 [dbInstance removeAllLogsInTableType:PCTLogTableTypeMeta]; // 2. 再插入一批数据 NSMutableArray *insertModels = [NSMutableArray array]; NSMutableArray *reportIDS = [NSMutableArray array]; for (NSInteger index = 1; index <= 100; index++) { PCTLogMetaModel *model = [[PCTLogMetaModel alloc] init]; model.log_id = index; // ... if (index > 90 && index <= 100) { [reportIDS addObject:model.report_id]; } [insertModels addObject:model]; } [dbInstance add:insertModels inTableType:PCTLogTableTypeMeta]; // 3. 将早期的数据删除掉(id > 90 && id <= 100) [dbInstance removeLatestRecordsByCount:10 inTableType:PCTLogTableTypeMeta]; // 4. 拿到当前的前10条数据和之前存起来的前10条 id 做比较。再判断当前表中的总记录条数是否等于 90 [dbInstance getLatestRecoreds:10 inTableType:PCTLogTableTypeMeta completion:^(NSArray<PCTLogModel *> * _Nonnull records) { NSArray<PCTLogModel *> *latestRTentRecords = records; [dbInstance getOldestRecoreds:100 inTableType:PCTLogTableTypeMeta completion:^(NSArray<PCTLogModel *> * _Nonnull records) { NSArray<PCTLogModel *> *currentRecords = records; __block BOOL isEarlyData = NO; [latestRTentRecords enumerateObjectsUsingBlock:^(PCTLogModel * _Nonnull obj, NSUInteger idx, BOOL * _Nonnull stop) { if ([reportIDS containsObject:obj.report_id]) { isEarlyData = YES; } }]; XCTAssert(!isEarlyData && currentRecords.count == 90, @"***Database「删除最新n条数据」功能:异常"); [exception fulfill]; }]; }]; [self waitForExpectationsWithCommonTimeout]; } 3. 测试框架 1. Kiwi BDD 框架里的 Kiwi 可圈可点。使用 CocoaPods 引入 pod 'Kiwi'。看下面的例子 被测类(Planck 项目是一个基于 WebView 的 SDK,根据业务场景,发现针对 WebView 的大部分功能定制都是基于 WebView 的生命周期内发生的,所以参考 NodeJS 的中间件思想,设计了基于生命周期的 WebView 中间件) #import <Foundation/Foundation.h> @interface TPKTrustListHelper : NSObject +(void)fetchRemoteTrustList; +(BOOL)isHostInTrustlist:(NSString *)scheme; +(NSArray *)trustList; @end 测试类 SPEC_BEGIN(TPKTrustListHelperTest) describe(@"Middleware Wrapper", ^{ context(@"when get trustlist", ^{ it(@"should get a array of string",^{ NSArray *array = [TPKTrustListHelper trustList]; [[array shouldNot] beNil]; NSString *first = [array firstObject]; [[first shouldNot] beNil]; [[NSStringFromClass([first class]) should] equal:@"__NSCFString"]; }); }); context(@"when check a string wether contained in trustlist ", ^{ it(@"first string should contained in trustlist",^{ NSArray *array = [TPKTrustListHelper trustList]; NSString *first = [array firstObject]; [[theValue([TPKTrustListHelper isHostInTrustlist:first]) should] equal:@(YES)]; }); }); }); SPEC_END 例子包含 Kiwi 的最基础元素。SPEC_BEGIN 和 SPEC_END 表示测试类;describe 描述需要被测试的类;context 表示一个测试场景,也就是 Given->When->Then 里的 Given;it 表示要测试的内容,也就是也就是 Given->When->Then 里的 When 和 Then。1个 describe 下可以包含多个 context,1个 context 下可以包含多个 it。 Kiwi 的使用分为:Specs、 Expectations 、 Mocks and Stubs 、Asynchronous Testing 四部分。点击可以访问详细的说明文档。 it 里面的代码块是真正的测试代码,使用链式调用的方式,简单上手。 测试领域中 Mock 和 Stub 非常重要。Mock 模拟对象可以降低对象之间的依赖,模拟出一个纯净的测试环境(类似初中物理课上“控制变量法”的思想)。Kiwi 也支持的非常好,可以模拟对象、模拟空对象、模拟遵循协议的对象等等,点击 Mocks and Stubs 查看。Stub 存根可以控制某个方法的返回值,这对于方法内调用别的对象的方法返回值很有帮助。减少对于外部的依赖,单一测试当前行为是否符合预期。 针对异步测试,XCTest 则需要创建一个 XCTestExpectation 对象,在异步实现里面调用该对象的 fulfill 方法,最后设置最大等待时间和完成的回调 - (void)waitForExpectationsWithTimeout:(NSTimeInterval)timeout handler:(nullable XCWaitCompletionHandler)handler; 如下例子 XCTestExpectation *exception = [self expectationWithDescription:@"测试数据库插入功能"]; [dbInstance removeAllLogsInTableType:PCTLogTableTypeMeta]; NSMutableArray *insertModels = [NSMutableArray array]; for (NSInteger index = 1; index <= 10000; index++) { PCTLogMetaModel *model = [[PCTLogMetaModel alloc] init]; model.log_id = index; // 。。。 [insertModels addObject:model]; } [dbInstance add:insertModels inTableType:PCTLogTableTypeMeta]; [dbInstance recordsCountInTableType:PCTLogTableTypeMeta completion:^(NSInteger count) { XCTAssert(count == insertModels.count, @"**Database「数据增加」功能:异常"); [exception fulfill]; }]; [self waitForExpectationsWithCommonTimeout]; 2. expecta、Specta expecta 和 Specta 都出自 orta 之手,他也是 Cocoapods 的开发者之一。太牛逼了,工程化、质量保证领域的大佬。 Specta 是一个轻量级的 BDD 测试框架,采用 DSL 模式,让测试更接近于自然语言,因此更易读。 特点: 易于集成到项目中。在 Xcode 中勾选 Include Unit Tests ,和 XCTest 搭配使用 语法很规范,对比 Kiwi 和 Specta 的文档,发现很多东西都是相同的,也就是很规范,所以学习成本低、后期迁移到其他框架很平滑。 Expecta 是一个匹配(断言)框架,相比 Xcode 的断言 XCAssert,Excepta 提供更加丰富的断言。 特点: Eepecta 没有数据类型限制,比如 1,并不关心是 NSInteger 还是 CGFloat 链式编程,写起来很舒服 反向匹配,很灵活。断言匹配用 except(...).to.equal(...),断言不匹配则使用 .notTo 或者 .toNot 延时匹配,可以在链式表达式后加入 .will、.willNot、.after(interval) 等 4. 小结 Xcode 自带的 XCTestCase 比较适合 TDD,不影响源代码,系统独立且不影响 App 包大小。适合简单场景下的测试。且每个函数在最左侧又个测试按钮,点击后可以单独测试某个函数。 Kiwi 是一个强大的 BDD 框架,适合稍微复杂写的项目,写法舒服、功能强大,模拟对象、存根语法、异步测试等满足几乎所有的测试场景。不能和 XCTest 继承。 Specta 也是一个 BDD 框架,基于 XCTest 开发,可以和 XCTest 模版集合使用。相比 Kiwi,Specta 轻量一些。开发中一般搭配 Excepta 使用。如果需要使用 Mock 和 Stud 可以搭配 OCMock。 Excepta 是一个匹配框架,比 XCTest 的断言则更加全面一些。 没办法说哪个最好、最合理,根据项目需求选择合适的组合。 五、网络测试 我们在测试某个方法的时候可能会遇到方法内部调用了网络通信能力,网络请求成功,可能刷新 UI 或者给出一些成功的提示;网络失败或者网络不可用则给出一些失败的提示。所以需要对网络通信去看进行模拟。 iOS 中很多网络都是基于 NSURL 系统下的类实现的。所以我们可以利用 NSURLProtocol 的能力来监控网络并 mock 网络数据。如果感兴趣可以查看这篇文章。 开源项目 OHHTTPStubs 就是一个对网络模拟的库。它可以拦截 HTTP 请求,返回 json 数据,定制各种头信息。 Stub your network requests easily! Test your apps with fake network data and custom response time, response code and headers! 几个主要类及其功能:HTTPStubsProtocol 拦截网络请求;HTTPStubs 单例管理 HTTPStubsDescriptor 实例对象;HTTPStubsResponse 伪造 HTTP 请求。 HTTPStubsProtocol 继承自 NSURLProtocol,可以在 HTTP 请求发送之前对 request 进行过滤处理 + (BOOL)canInitWithRequest:(NSURLRequest *)request { BOOL found = ([HTTPStubs.sharedInstance firstStubPassingTestForRequest:request] != nil); if (!found && HTTPStubs.sharedInstance.onStubMissingBlock) { HTTPStubs.sharedInstance.onStubMissingBlock(request); } return found; } firstStubPassingTestForRequest 方法内部会判断请求是否需要被当前对象处理 紧接着开始发送网络请求。实际上在 - (void)startLoading 方法中可以用任何网络能力去完成请求,比如 NSURLSession、NSURLConnection、AFNetworking 或其他网络框架。OHHTTPStubs 的做法是获取 request、client 对象。如果 HTTPStubs 单例中包含 onStubActivationBlock 对象,则执行该 block,然后利用 responseBlock 对象返回一个 HTTPStubsResponse 响应对象。 OHHTTPStubs 的具体 API 可以查看文档。 举个例子,利用 Kiwi、OHHTTPStubs 测试离线包功能。代码如下 @interface HORouterManager (Unittest) - (void)fetchOfflineInfoIfNeeded; @end SPEC_BEGIN(HORouterTests) describe(@"routerTests", ^{ context(@"criticalPath", ^{ __block HORouterManager *routerManager = nil; beforeAll(^{ routerManager = [[HORouterManager alloc] init]; }); it(@"getLocalPath", ^{ __block NSString *pagePath = nil; dispatch_after(dispatch_time(DISPATCH_TIME_NOW, (int64_t)(4 * NSEC_PER_SEC)), dispatch_get_main_queue(), ^{ pagePath = [routerManager filePathOfUrl:@"http://***/resource1"]; }); [[expectFutureValue(pagePath) shouldEventuallyBeforeTimingOutAfter(5)] beNonNil]; __block NSString *rescPath = nil; dispatch_after(dispatch_time(DISPATCH_TIME_NOW, (int64_t)(4 * NSEC_PER_SEC)), dispatch_get_main_queue(), ^{ rescPath = [routerManager filePathOfUrl:@"http://***/resource1"]; }); [[expectFutureValue(rescPath) shouldEventuallyBeforeTimingOutAfter(5)] beNonNil]; }); it(@"fetchOffline", ^{ [HOOfflineManager sharedInstance].offlineInfoInterval = 0; [OHHTTPStubs stubRequestsPassingTest:^BOOL(NSURLRequest *request) { return [request.URL.absoluteString containsString:@"h5-offline-pkg"]; } withStubResponse:^OHHTTPStubsResponse*(NSURLRequest *request) { NSMutableDictionary *dict = [NSMutableDictionary dictionary]; dict[@"code"] = @(0); dict[@"data"] = @"f722fc3efce547897819e9449d2ac562cee9075adda79ed74829f9d948e2f6d542a92e969e39dfbbd70aa2a7240d6fa3e51156c067e8685402727b6c13328092ecc0cbc773d95f9e0603b551e9447211b0e3e72648603e3d18e529b128470fa86aeb45d16af967d1a21b3e04361cfc767b7811aec6f19c274d388ddae4c8c68e857c14122a44c92a455051ae001fa7f2b177704bdebf8a2e3277faf0053460e0ecf178549e034a086470fa3bf287abbdd0f79867741293860b8a29590d2c2bb72b749402fb53dfcac95a7744ad21fe7b9e188881d1c24047d58c9fa46b3ebf4bc42a1defc50748758b5624c6c439c182fe21d4190920197628210160cf279187444bd1cb8707362cc4c3ab7486051af088d7851846bea21b64d4a5c73bd69aafc4bb34eb0862d1525c4f9a62ce64308289e2ecbc19ea105aa2bf99af6dd5a3ff653bbe7893adbec37b44a088b0b74b80532c720c79b7bb59fda3daf85b34ef35"; NSData *data = [NSJSONSerialization dataWithJSONObject:dict options:0 error:nil]; return [OHHTTPStubsResponse responseWithData:data statusCode:200 headers:@{@"Content-Type":@"application/json"}]; }]; [routerManager fetchOfflineInfoIfNeeded]; [[HOOfflineInfo shouldEventually] receive:@selector(saveToLocal:)]; }); }); }); SPEC_END 😂 插一嘴,我贴的代码已经好几次可以看到不同的测试框架组合了,所以不是说选了框架 A 就完事,根据场景选择最优解。 六、UI 测试 上面文章大篇幅的讲了单元测试相关的话题,单元测试十分适合代码质量、逻辑、网络等内容的测试,但是针对最终产物 App 来说单元测试就不太适合了,如果测试 UI 界面的正确性、功能是否正确显然就不太适合了。Apple 在 Xcode 7 开始推出的 UI Testing 就是苹果自己的 UI 测试框架。 很多 UI 自动化测试框架的底层实现都依赖于 Accessibility,也就是 App 可用性。UI Accessibility 是 iOS 3.0 引入的一个人性化功能,帮助身体不便的人士方便使用 App。 Accessibility 通过对 UI 元素进行分类和标记。分类成类似按钮、文本框、文本等类型,使用 identifier 来区分不同 UI 元素。无痕埋点的设计与实现里面也使用 accessibilityIdentifier 来绑定业务数据。 使用 Xcode 自带的 UI测试则在创建工程的时候需要勾选 “Include UI Tests”。 像单元测试意义,UI 测试方法命名以 test 开头。将鼠标光标移到方法内,点击 Xcode 左下方的红色按钮,开始录制 UI 脚本。 解释说明: /*! Proxy for an application that may or may not be running. */ @interface XCUIApplication : XCUIElement // ... @end XCUIApplication launch 来启动测试。XCUIApplication 是 UIApplication 在测试进程中的代理,用来和 App 进行一些交互。 使用 staticTexts来获取当前屏幕上的静态文本(UILabel)元素的代理。等价于 [app descendantsMatchingType:XCUIElementTypeStaticText]。XCUIElementTypeStaticText 参数是枚举类型。 typedef NS_ENUM(NSUInteger, XCUIElementType) { XCUIElementTypeAny = 0, XCUIElementTypeOther = 1, XCUIElementTypeApplication = 2, XCUIElementTypeGroup = 3, XCUIElementTypeWindow = 4, XCUIElementTypeSheet = 5, XCUIElementTypeDrawer = 6, XCUIElementTypeAlert = 7, XCUIElementTypeDialog = 8, XCUIElementTypeButton = 9, XCUIElementTypeRadioButton = 10, XCUIElementTypeRadioGroup = 11, XCUIElementTypeCheckBox = 12, XCUIElementTypeDisclosureTriangle = 13, XCUIElementTypePopUpButton = 14, XCUIElementTypeComboBox = 15, XCUIElementTypeMenuButton = 16, XCUIElementTypeToolbarButton = 17, XCUIElementTypePopover = 18, XCUIElementTypeKeyboard = 19, XCUIElementTypeKey = 20, XCUIElementTypeNavigationBar = 21, XCUIElementTypeTabBar = 22, XCUIElementTypeTabGroup = 23, XCUIElementTypeToolbar = 24, XCUIElementTypeStatusBar = 25, XCUIElementTypeTable = 26, XCUIElementTypeTableRow = 27, XCUIElementTypeTableColumn = 28, XCUIElementTypeOutline = 29, XCUIElementTypeOutlineRow = 30, XCUIElementTypeBrowser = 31, XCUIElementTypeCollectionView = 32, XCUIElementTypeSlider = 33, XCUIElementTypePageIndicator = 34, XCUIElementTypeProgressIndicator = 35, XCUIElementTypeActivityIndicator = 36, XCUIElementTypeSegmentedControl = 37, XCUIElementTypePicker = 38, XCUIElementTypePickerWheel = 39, XCUIElementTypeSwitch = 40, XCUIElementTypeToggle = 41, XCUIElementTypeLink = 42, XCUIElementTypeImage = 43, XCUIElementTypeIcon = 44, XCUIElementTypeSearchField = 45, XCUIElementTypeScrollView = 46, XCUIElementTypeScrollBar = 47, XCUIElementTypeStaticText = 48, XCUIElementTypeTextField = 49, XCUIElementTypeSecureTextField = 50, XCUIElementTypeDatePicker = 51, XCUIElementTypeTextView = 52, XCUIElementTypeMenu = 53, XCUIElementTypeMenuItem = 54, XCUIElementTypeMenuBar = 55, XCUIElementTypeMenuBarItem = 56, XCUIElementTypeMap = 57, XCUIElementTypeWebView = 58, XCUIElementTypeIncrementArrow = 59, XCUIElementTypeDecrementArrow = 60, XCUIElementTypeTimeline = 61, XCUIElementTypeRatingIndicator = 62, XCUIElementTypeValueIndicator = 63, XCUIElementTypeSplitGroup = 64, XCUIElementTypeSplitter = 65, XCUIElementTypeRelevanceIndicator = 66, XCUIElementTypeColorWell = 67, XCUIElementTypeHelpTag = 68, XCUIElementTypeMatte = 69, XCUIElementTypeDockItem = 70, XCUIElementTypeRuler = 71, XCUIElementTypeRulerMarker = 72, XCUIElementTypeGrid = 73, XCUIElementTypeLevelIndicator = 74, XCUIElementTypeCell = 75, XCUIElementTypeLayoutArea = 76, XCUIElementTypeLayoutItem = 77, XCUIElementTypeHandle = 78, XCUIElementTypeStepper = 79, XCUIElementTypeTab = 80, XCUIElementTypeTouchBar = 81, XCUIElementTypeStatusItem = 82, }; 通过 XCUIApplication 实例化对象调用 descendantsMatchingType: 方法得到的是 XCUIElementQuery 类型。比如 @property (readonly, copy*) XCUIElementQuery *staticTexts; /*! Returns a query for all descendants of the element matching the specified type. */ - (XCUIElementQuery *)descendantsMatchingType:(XCUIElementType)type; descendantsMatchingType 返回所有后代的类型匹配对象。childrenMatchingType 返回当前层级子元素的类型匹配对象 /*! Returns a query for direct children of the element matching the specified type. */ - (XCUIElementQuery *)childrenMatchingType:(XCUIElementType)type; 拿到 XCUIElementQuery 后不能直接拿到 XCUIElement。和 XCUIApplication 类似,XCUIElement 不能直接访问 UI 元素,它是 UI 元素在测试框架中的代理。可以通过 Accessibility 中的 frame、identifier 来获取。 对比很多自动化测试框架都需要找出 UI 元素,也就是借助于 Accessibility 的 identifier。这里的唯一标识生成对比为 UIAutomation 添加自动化测试标签的探索] 第三方 UI 自动化测试框架挺多的,可以查看下典型的 appium、macaca。 七、 测试经验总结 TDD 写好测试再写业务代码,BDD 先写实现代码,再写基于行为的测试代码。另一种思路是没必要针对每个类的私有方法或者每个方法进行测试,因为等全部功能做完后针对每个类的接口测试,一般会覆盖据大多数的方法。等测试完看如果方法未被覆盖,则针对性的补充 Unit Test。 目前,UI 测试(appium) 还是建议在核心逻辑且长时间没有改动的情况下去做,这样子每次发版本的时候可以当作核心逻辑回归了,目前来看价值是方便后续的迭代和维护上有一些便利性。其他的功能性测试还是走 BDD。 对于类、函数、方法的走 TDD,老老实实写 UT、走 UT 覆盖率的把控。 UITesting 还是建议在核心逻辑且长时间没有改动的情况下去做,这样子每次发版本的时候可以当作核心逻辑回归,目前来看价值是方便后续的迭代和维护上有一些便利性。例如用户中心 SDK 升级后,当时有了UITesing,基本上免去了测试人员介入。 如果是一些活动页和逻辑经常变动的,老老实实走测试黑盒... 我觉得一直有个误区,就是觉得自动测试是为了质量,其实质量都是附送的,测试先行是让开发更快更爽的 WWDC 这张图也很清楚,UI 其实需要的占比较小,还是要靠单测驱动。 参考资料 维基百科:测试驱动开发
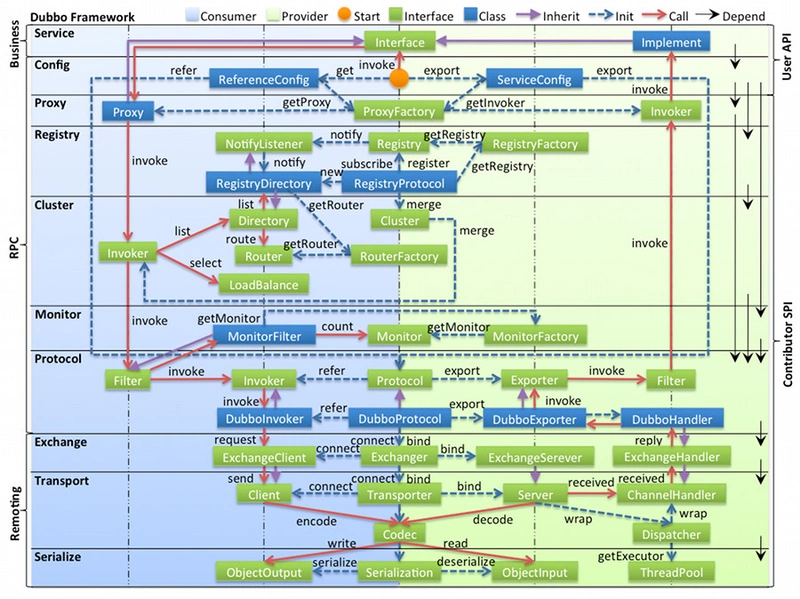
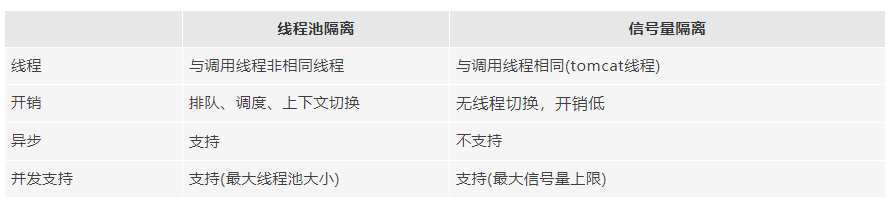
优秀的个人博客,低调大师

每日一博 | 向强大的 SVG 迈进

作者:凹凸曼 - 暖暖 SVG 即 Scalable Vector Graphics 可缩放矢量图形,使用XML格式定义图形。 一、SVG印象 SVG 的应用十分广泛,得益于 SVG 强大的各种特性。 1.1、 矢量 可利用 SVG 矢量的特点,描出深圳地铁的轮廓: 1.2、iconfont SVG 可依据一定的规则,转成 iconfont 使用: 1.3、 foreignObject 利用 SVG 的 foreignObject 标签实现截图功能,原理:foreignObject 内部嵌入 HTML 元素: <svg xmlns="http://www.w3.org/2000/svg"> <foreignObject width="120" height="60"> <p style="font-size:20px;margin:0;">凹凸实验室 欢迎您</p> </foreignObject> </svg> 截图实现流程: 首先声明一个基础的 svg 模版,这个模版需要一些基础的描述信息,最重要的,它要有 <foreignObject></foreignObject> 这对标签; 将要渲染的 DOM 模版模版嵌入 foreignObject 即可; 利用 Blob 构建 svg 对象; 利用 URL.createObjectURL(svg) 取出 URL。 1.4、SVG SMIL 由于微信编辑器不允许嵌入 <style><script><a> 标签,利用SVG SMIL 可进行微信公众号极具创意的图文排版设计,包括动画与交互。 但是也要注意,标签里不允许有id,否则会被过滤或替换掉。 点击 "凹凸实验室" 后,围绕 "凹凸实验室" 中心旋转 360度,点击0.5秒后 出现 https://aotu.io/ ,动画只运行一次。 下图为 GIF循环演示: 代码如下: <svg width="360" height="300" xmlns="http://www.w3.org/2000/svg"> <g> <!-- 点击后 运行transform旋转动画,restart="never"表示只运行一次 --> <animateTransform attributeName="transform" type="rotate" begin="click" dur="0.5s" from="0 100 80" to="360 100 80" fill="freeze" restart="never" /> <g> <text font-family="microsoft yahei" font-size="20" x="50" y="80"> 凹凸实验室 </text> </g> <g style="opacity: 0;"> <!-- 同一个初始位置以及大致的宽高,触发点击事件 --> <text font-family="microsoft yahei" font-size="20" x="50" y="80">https://aotu.io/</text> <!-- 点击后 运行transform移动动画,改变文本的位置 --> <animateTransform attributeName="transform" type="translate" begin="click" dur="0.1s" to="0 40" fill="freeze" restart="never" /> <!-- 点击0.5秒后 运行opacity显示动画 --> <animate attributeName="opacity" begin="click+0.5s" from="0" to="1" dur="0.5s" fill="freeze" restart="never" /> </g> </g> </svg> 以上是鄙人对SVG的大致印象,最近的需求开发再次刷新了我的认知,那就是 SVG实现非比例缩放 以及 小程序不支持SVG标签的处理,下面容我来讲述一番。 二、SVG 实现非比例缩放 我们熟知的 iconfont,可通过改变字体大小缩放,但是这是 比例缩放,那如何实现 SVG 的非比例缩放呢? 如下图所示,如何将 一只兔子 非比例缩放? 划重点:实现非比例缩放主要涉及三个知识点:viewport、viewBox和preserveAspectRatio,viewport 与viewBox 结合可实现缩放的功能,viewBox 与 preserveAspectRatio 结合可实现非比例的功能。 2.1、viewport viewport 表示SVG可见区域的大小。 viewport 就像是我们的显示器屏幕大小,超出区域则隐藏,原点位于左上角,x 轴水平向右,y 轴垂直向下。 通过类似CSS的属性 width、height 指定视图大小: <svg width="400" height="200"></svg> 2.2、viewBox viewBox值有4个数字:x, y, width, height 。 其中 x:左上角横坐标,y:左上角纵坐标,width:宽度,height:高度。 原点默认位于左上角,x 轴水平向右,y 轴垂直向下。 <svg width="400" height="200" viewBox="0 0 200 100"></svg> 显示器屏幕的画面,可以特写,可以全景,这就是 viewBox。 viewBox 可以想象成截屏工具选中的那个框框,和 viewport 作用的结果就是 把框框中的截屏内容再次在 显示器 中全屏显示。 (图片来源:SVG 研究之路 (23) - 理解 viewport 與 viewbox) 2.3、preserveAspectRatio 上图的红色框框和蓝色框框,恰好和显示器的比例相同,如果是下图的绿色框框,怎样在显示器屏幕中显示呢? 2.3.1、 定义 preserveAspectRatio 作用的对象是 viewBox,使用方法如下: preserveAspectRatio="[defer] <align> [<meetOrSlice>]" // 例如 preserveAspectRatio="xMidYMid meet" 其中 defer 此时不是重点,暂且忽略,主要了解 align 和 meetOrSlice 的 用法: align:由两个名词组成,分别代表 viewbox 与 viewport 的 x 方向、y方向的对齐方式。 值 含义 xMin viewport 和 viewBox 左边对齐 xMid viewport 和 viewBox x轴中心对齐 xMax viewport 和 viewBox 右边对齐 YMin viewport 和 viewBox 上边缘对齐。注意Y是大写。 YMid viewport 和 viewBox y轴中心点对齐。注意Y是大写。 YMax viewport 和 viewBox 下边缘对齐。注意Y是大写。 meetOrSlice:表示如何维持高宽的比例,有三个值 meet、slice、none。 meet - 默认值,保持纵横比缩放 viewBox 适应 viewport,可能会有余留的空白。 slice - 保持纵横比同时比例小的方向放大填满 viewport,超出的部分被剪裁掉。 none - 扭曲纵横比以充分适应 viewport。 2.3.2、 例子 例子1:preserveAspectRatio="xMidYMid meet" 表示 绿色框框 与 显示器的 x 方向、y方向的 中心点 对齐; 例子2:preserveAspectRatio="xMidYMin slice" 表示 绿色框框 与 显示器的 x 方向 中心点 对齐,Y 方向 上边缘对齐,保持比例放大填满 显示屏 后超出部分隐藏; 例子3:preserveAspectRatio="xMidYMid slice" 表示 绿色框框 与 显示器的 x 方向、y方向的 中心点 对齐,保持比例放大填满显示屏 后超出部分隐藏; 例子4:preserveAspectRatio="none" 不管三七二十一,随意缩放绿色框框,填满 显示屏即可;这就是非比例缩放的答案了。 三、小程序不支持svg标签怎么办 微信小程序官方不支持 SVG 标签的,但是决定曲线救国,相当于自己实现了一个SVG标签:使用小程序内置的 Canvas 渲染器, 在 Cax 中实现 SVG 标准的子集,使用 JSX 或者 HTM(Hyperscript Tagged Markup) 描述 SVG 结构行为表现。 但是今天我想讲讲其他的。 我们知道,小程序虽然不支持 SVG 标签,但是支持 svg 转成 base64 后作为 background-image 的 url,如 background-image: url("data:image/svg+xml.......) 。 但是我这边还有个需求,随时更改 SVG 每个路径的颜色,即 颜色可配置: 来回转 Base64 肯定是比较麻烦的,有没有更好的方式呢? 直接贴答案:对于SVG图形,还有更好的实现方式,就是直接使用SVG XML格式代码,无需进行base64转换。 3.1、URL 编码 直接使用 SVG XML 格式代码,首先要了解 Data URI的格式。 划重点:base64非必选项,不指定的时候,后面的 <data> 将使用 URL编码。 3.1.1、入门 百分号编码(Percent-encoding), 也称作URL编码(URL encoding),是特定上下文的统一资源定位符 (URL)的编码机制。 原理:ASCII 字符 = % + 两位 ASCII 码(十六进制)。 例如,字符 a 对应的 ASCII 码为 0x61,那么 URL 编码后得到 %61 。 3.1.2、URL 编码压缩 前言: Data URI 的格式中的 <data> 完全使用URL 编码也是可以的,如 encodeURIComponent('<svg version="1.1" viewBox= …</svg>')。 但是和转义前原始SVG相比,可读性差了很多,而且占用体积也变大了。 如果深入了解URL 编码的话,<data> 没必要全部编码的。 正文: RFC3986文档规定,URL中只允许包含 未保留字符 以及 所有保留字符。 未保留字符:包含英文字母(a-zA-Z)、数字(0-9)、-_.~ 4个特殊字符。对于未保留字符,不需要百分号编码。 保留字符:具有特殊含义的字符 :/?#[]@ (分隔Url的协议、主机、路径等组件) 和 !$&'()*+,;= (用于在每个组件中起到分隔作用的,如&符号用于分隔查询多个键值对)。 受限字符或不安全字符:直接放在Url中的时候,可能会引起解析程序的歧义,因此这部分需要百分号编码,如%、空格、双引号"、尖号 <>等等。 综上所述,只需要对 受限字符或不安全字符 进行编码即可。 JS 处理比较简单,利用 replace 将 需要编码的字符 替换掉 即可,基本替换 以下的符号 就够用了: svgToUrl (svgData) { encoded = encoded .replace(/<!--(.*)-->/g, '') // 亲测必须去掉注释 .replace(/[\r\n]/g, ' ') // 亲测最好去掉换行 .replace(/"/g, `'`) // 单引号是保留字符,双引号改成单引号减少编码 .replace(/%/g, '%25') .replace(/&/g, '%26') .replace(/#/g, '%23') .replace(/{/g, '%7B') .replace(/}/g, '%7D') .replace(/</g, '%3C') .replace(/>/g, '%3E') return `data:image/svg+xml,${encoded}` } 如果使用在 CSS 中,可利用 SASS版本3.3以上 的 三个API 对 SVG字符串做替换处理。 str_insert(string, insert, index): 从 $string 第 $index 插入字符 $insert; str_index(string, substring): 返回 $substring 在 $string 中第一个位置; str_slice(string, start_at, end_at = nil): 返回从字符 $string 中第 $start_at 开始到 $end_at 结束的一个新字符串。 前人已有总结,可前往 https://github.com/leeenx/sass-svg/blob/master/sass-encodeuri.scss 查看完整代码。 3.2、SVG 压缩 一般从 Sketch 导出 SVG ,冗余代码比较多,有条件的话建议使用 SVGO 压缩SVG的原本体积,比如清除换行、重复空格;删除文档声明;删除注释;删除desc描述等等。 四、总结 SVG强大的地方在于,出其不意,炫酷,与众不同。 无论是微信公众号花式排版,foreignObject 标签实现截图,实现非比例缩放,或者 背景图直接使用 SVG XML 格式代码,还是上文没有提及的路径动画、描边动画、图形裁剪、滤镜等等,都可以玩出新的花样。 SVG 一个属性可成就一篇文章,学习 SVG 可以说是在挑战自己,欢迎加入 SVG 的学习队列。 五、参考内容 · 推荐阅读 三看 SVG Web 动效 URL编码的奥秘 学习了,CSS中内联SVG图片有比Base64更好的形式 超级强大的SVG SMIL animation动画详解 详细教你微信公众号正文页SVG交互开发 SVG <foreignObject>简介与截图等应用 欢迎关注凹凸实验室博客:aotu.io 或者关注凹凸实验室公众号(AOTULabs),不定时推送文章:

优秀的个人博客,低调大师

每日一博 | Elasticsearch 索引设置的总结

在使用ES时,我们常见的就是需要生成一个template来定义索引的设置,分词器,Mapping.本文将基于项目经验来总结一些常用的配置。 Index设置 index.refresh_interval 配置一个刷新时间,将index buffer刷新到os cache的时间间隔,刷新到os cache的数据才可以被索引到,默认是1s.如果对实时性搜索要求不高的地方,可设置时间为30s,提高性能。 number_of_replicas 对于集群数据节点 >=2 的场景,建议副本至少设置为 1(一主一从,共两个副本), 可以提高集群容错和搜索吞吐量(副本分片可用于查询)。 index.number_of_shards 主副本的分片数,默认是5个,最大值限制为1024个,这个值是分片数可适当的增加,提高索引的并发性能,但是分片越多,也会导致资源耗费越高,索引要根据访问并发数和ES集群的资源来设置。经验公式:分片数 = 索引大小/分片大小经验值 30GB,官方推荐Shard值在 20-40GB性能最好,日志类:单分片<50GB;搜索类:单分片<20GB。不足100G,可直接设置3-5个分片(结合节点数和扩展性),超过100G则可以按照如上经验公式来规划。 index.max_result_window 索引能够查询到最大数据量,from+size深分页的最大条数,默认是10000,适当限制这个值可以防止深分页内存占用过多,如果全量导出,需要使用Scroll游标办法。 index.store.preload 默认情况下,Elasticsearch完全依靠操作系统文件系统缓存来缓存I / O操作.可以设置index.store.preload,以告知操作系统在打开时将热索引文件的内容加载到内存中。默认值为空,即不提前加载索引到内存中,常见的值有["nvd", "dvd", "tim", "doc", "dim"]。对应的norms, doc values, terms dictionaries, postings lists, points,常见的设置为index.store.preload =["nvd", "dvd"],即提前加载norms评分信息和doc value数据到内存,便于快速索引。 index.sort.field和 index.sort.order 建立索引的排序字段,写入的时候就按照顺序写入。对于一些具备顺序的字段,可以提前设置,比如时间字段。配置见下 { "settings" : { "index" : { "sort.field" : "date", // 字段名字 "sort.order" : "desc" // 升序 asc 和降序 desc } } } Mapping设置 动态映射 mapping的通用配置,dynamic_templates配置动态类型转换,将一个类型转换为另一个类型 { "mappings": { "_doc": { "dynamic_templates": [ { "strings_as_keywords": { "match_mapping_type": "string", "mapping": { "type": "keyword" } } } ], "_source": { "enabled": true }, "properties": { ..... } } } } 字段类型 官方文档:https://www.elastic.co/guide/en/elasticsearch/reference/6.8/mapping.html#_field_datatypes a simple type liketext,keyword,date,long,double,booleanorip. a type which supports the hierarchical nature of JSON such asobjectornested. or a specialised type likegeo_point,geo_shape, orcompletion. 常见的类型和搜索类型的联系 (1)text 类型作用:分词,将大段的文字根据分词器切分成独立的词或者词组,以便全文检索。 适用于:email 内容、某产品的描述等需要分词全文检索的字段; 不适用:排序或聚合(Significant Terms 聚合例外) (2)keyword 类型:无需分词、整段完整精确匹配。 适用于:email 地址、住址、状态码、分类 tags。 常见的搜索类型使用的字段类型 term 精确匹配 核心功能:不受到分词器的影响,属于完整的精确匹配。 应用场景:精确、精准匹配。 适用类型:keyword。 prefix 前缀匹配 核心功能:前缀匹配。 应用场景:前缀自动补全的业务场景。 适用类型:keyword。 wildcard 模糊匹配 核心功能:匹配具有匹配通配符表达式 keyword 类型的文档。支持的通配符:*,它匹配任何字符序列(包括空字符序列);?,它匹配任何单个字符。 应用 场景:请注意,选型务必要慎重!此查询可能很慢多组关键次的情况下可能会导致宕机,因为它需要遍历多个术语。为了防止非常慢的通配符查询,通配符 不能以任何一个通配符*或?开头。 适用类型:keyword。 match 分词匹配 核心功能:全文检索,分词词项匹配。 应用场景:实际业务中较少使用,原因:匹配范围太宽泛,不够准确。 适用类型:text。 match_phrase 短语匹配 核心功能:match_phrase 查询首先将查询字符串解析成一个词项列表,然后对这些词项进行搜索; 只保留那些包含 全部 搜索词项,且 位置"position" 与搜索词 项相同的文档。 应用场景:业务开发中 90%+ 的全文检索都会使用 match_phrase 或者 query_string 类型,而不是 match。 适用类型:text。 multi_match 多组匹配 核心功能:match query 针对多字段的升级版本。 应用场景:多字段检索。 适用类型:text。 query_string 类型 核心功能:支持与或非表达式+其他N多配置参数。 应用场景:业务系统需要支持自定义表达式检索。 适用类型:text。 bool 组合匹配 核心功能:多条件组合综合查询。 应用场景:支持多条件组合查询的场景。 适用类型:text 或者 keyword。一个 bool 过滤器由三部分组成: must ——所有的语句都 必须(must) 匹配,与 AND 等价。 must_not ——所有的语句都 不能(must not) 匹配,与 NOT 等价。 should ——至少有一个语句要匹配,与 OR 等价。 filter——必须匹配,运行在非评分&过滤模式。 range范围搜索类型 适用类型:long,integer,double或者date properties 字段的参数设置 ES 索引template模板参考例子 PUT _template/test_template { "index_patterns": [ "test_index_*", "test_*" ], "settings": { "number_of_shards": 1, "number_of_replicas": 1, "max_result_window": 100000, "refresh_interval": "30s" }, "mappings": { "properties": { "id": { "type": "long" }, "title": { "type": "keyword" }, "content": { "analyzer": "ik_max_word", "type": "text", "fields": { "keyword": { "ignore_above": 256, "type": "keyword" } } }, "available": { "type": "boolean" }, "review": { "type": "nested", "properties": { "nickname": { "type": "text" }, "text": { "type": "text" }, "stars": { "type": "integer" } } }, "publish_time": { "type": "date", "format": "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd||epoch_millis" }, "expected_attendees": { "type": "integer_range" }, "ip_addr": { "type": "ip" }, "suggest": { "type": "completion" } } } }

优秀的个人博客,低调大师

每日一博|Dubbo 负载均衡的实现

前言 负载均衡是指在集群中,将多个数据请求分散在不同单元上进行执行,主要为了提高系统容错能力和加强系统对数据的处理能力。 在 Dubbo 中,一次服务的调用就是对所有实体域 Invoker 的一次筛选过滤,最终选定具体调用的 Invoker。首先在 Directory 中获取全部 Invoker 列表,通过路由筛选出符合规则的 Invoker,最后再经过负载均衡选出具体的 Invoker。所以 Dubbo 负载均衡机制是决定一次服务调用使用哪个提供者的服务。 整体结构 Dubbo 负载均衡的分析入口是 org.apache.dubbo.rpc.cluster.loadbalance.AbstractLoadBalance 抽象类,查看这个类继承关系。 这个被 RandomLoadBalance、LeastActiveLoadBalance、RoundRobinLoadBalance 及 ConsistentHashLoadBalance 类继承,这四个类是 Dubbo 中提供的四种负载均衡算法的实现。 名称 说明 RandomLoadBalance 随机算法,根据权重设置随机的概率 LeastActiveLoadBalance 最少活跃数算法,指请求数和完成数之差,使执行效率高的服务接收更多请求 RoundRobinLoadBalance 加权轮训算法,根据权重设置轮训比例 ConsistentHashLoadBalance Hash 一致性算法,相同请求参数分配到相同提供者 以上则是 Dubbo 提供的四种负载均衡算法。 从上图中,看到 AbstractLoadBalance 实现了 LoadBalance 接口,同时是一个 SPI 接口,指定默认实现为 RandomLoadBalance 随机算法机制。 抽象类 AbstractLoadBalance 中,实现了负载均衡通用的逻辑,同时给子类声明了一个抽象方法供子类实现其负载均衡的逻辑。 public abstract class AbstractLoadBalance implements LoadBalance { /** * * @param 运行时间(毫秒) * @param 预热时间(毫秒) * @param 要计算的 Invoker 权重值 */ static int calculateWarmupWeight(int uptime, int warmup, int weight) { // 计算预热时期的权重 int ww = (int) ((float) uptime / ((float) warmup / (float) weight)); // 返回的权重值区间在: 1 ~ weight return ww < 1 ? 1 : (ww > weight ? weight : ww); } @Override public <T> Invoker<T> select(List<Invoker<T>> invokers, URL url, Invocation invocation) { // 校验 invokers 是否为空 if (CollectionUtils.isEmpty(invokers)) { return null; } // 当到达负载均衡流程时,invokers 中只有一个 Invoker 时,直接返回该 Invoker if (invokers.size() == 1) { return invokers.get(0); } // 在不同负载均衡策略中完成具体的实现 return doSelect(invokers, url, invocation); } // 声明抽象方法,在子类中具体实现 protected abstract <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation); protected int getWeight(Invoker<?> invoker, Invocation invocation) { // 获取当前Invoker配置的权重值 int weight = invoker.getUrl().getMethodParameter(invocation.getMethodName(), WEIGHT_KEY, DEFAULT_WEIGHT); if (weight > 0) { // 服务启动时间 long timestamp = invoker.getUrl().getParameter(REMOTE_TIMESTAMP_KEY, 0L); if (timestamp > 0L) { // 服务已运行时长 int uptime = (int) (System.currentTimeMillis() - timestamp); // 服务预热时间,默认 DEFAULT_WARMUP = 10 * 60 * 1000 ,预热十分钟 int warmup = invoker.getUrl().getParameter(WARMUP_KEY, DEFAULT_WARMUP); // 如果服务运行时长小于预热时长,重新计算出预热时期的权重 if (uptime > 0 && uptime < warmup) { weight = calculateWarmupWeight(uptime, warmup, weight); } } } // 保证最后返回的权重值不小于0 return weight >= 0 ? weight : 0; } } 在 AbstractLoadBalance 中,getWeight 和 calculateWarmupWeight 方法是获取和计算当前 Invoker 的权重值。 getWeight 中获取当前权重值,通过 URL 获取当前 Invoker 设置的权重,如果当前服务提供者启动时间小于预热时间,则会重新计算权重值,对服务进行降权处理,保证服务能在启动初期不分发设置比例的全部流量,健康运行下去。 calculateWarmupWeight 是重新计算权重值的方法,计算公式为:服务运行时长 / (预热时长 / 设置的权重值),等价于(服务运行时长 / 预热时长) * 设置的权重值,同时条件服务运行时长 < 预热时长。由该公式可知,预热时长和设置的权重值不变,服务运行时间越长,计算出的值越接近 weight,但不会等于 weight。 在返回计算后的权重结果中,对小于1和大于设置的权重值进行了处理,当重新计算后的权重小于1时返回1;处于1和设置的权重值之间时,直接返回计算后的结果;当权重大于设置的权重值时(因为条件限制,不会出现该类情况),返回设置的权重值。所以得出结论:重新计算后的权重值为 1 ~ 设置的权重值,运行时间越长,计算出的权重值越接近设置的权重值。 配置方式 服务端 通过 XML 配置方式: <!-- 服务级别配置 --> <dubbo:service id="xXXXService" interface="top.ytao.service.XXXXService" class="top.ytao.service.impl.XXXXServiceImpl" loadbalance="负载策略" /> <!-- 方法级别配置 --> <dubbo:service id="xXXXService" interface="top.ytao.service.XXXXService" class="top.ytao.service.impl.XXXXServiceImpl"> <dubbo:method name="方法名" loadbalance="负载策略"/> </dubbo:service> 通过 Properties 配置: dubbo.service.loadbalance=负载策略 通过注解方式: @Service(loadbalance = "负载策略") 客户端 通过 XML 配置方式: <!-- 服务级别配置 --> <dubbo:reference id="xXXXService" interface="top.ytao.service.XXXXService" loadbalance="负载策略" /> <!-- 方法级别配置 --> <dubbo:reference id="xXXXService" interface="top.ytao.service.XXXXService"> <dubbo:method name="方法名" loadbalance="负载策略"/> </dubbo:reference> 通过 Properties 配置: dubbo.reference.loadbalance=负载策略 通过注解配置方式: @Reference(loadbalance = "负载策略") 实现方式也可通过 Dubbo-Admin 管理后台进行配置,如图: 随机算法 加权随机算法负载均衡策略(RandomLoadBalance)是 dubbo 负载均衡的默认实现方式,根据权重分配各个 Invoker 随机选中的比例。这里的意思是:将到达负载均衡流程的 Invoker 列表中的 权重进行求和,然后求出单个 Invoker 权重在总权重中的占比,随机数就在总权重值的范围内生成。 如图,假如当前有192.168.1.10和192.168.1.11两个负载均衡的服务,权重分别为 4、6 ,则它们的被选中的比例为 2/5、3/5。 当生成随机数为 6 时,就会选中192.168.1.11的服务。 dubbo 中 RandomLoadBalance 的 doSelect 实现代码: public class RandomLoadBalance extends AbstractLoadBalance { public static final String NAME = "random"; @Override protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) { // Invoker 数量 int length = invokers.size(); // 标识所有 Invoker 的权重是否都一样 boolean sameWeight = true; // 用一个数组保存每个 Invoker 的权重 int[] weights = new int[length]; // 第一个 Invoker 的权重 int firstWeight = getWeight(invokers.get(0), invocation); weights[0] = firstWeight; // 求和总权重 int totalWeight = firstWeight; for (int i = 1; i < length; i++) { int weight = getWeight(invokers.get(i), invocation); // 保存每个 Invoker 的权重到数组总 weights[i] = weight; // 累加求和总权重 totalWeight += weight; // 如果不是所有 Invoker 的权重都一样,就给标记上 sameWeight = false if (sameWeight && weight != firstWeight) { sameWeight = false; } } // 计算随机数取到的 Invoker,条件是必须总权重大于0,并且每个 Invoker 的权重都不一样 if (totalWeight > 0 && !sameWeight) { // 基于 0~总数 范围内生成随机数 int offset = ThreadLocalRandom.current().nextInt(totalWeight); // 计算随机数对应的 Invoker for (int i = 0; i < length; i++) { offset -= weights[i]; if (offset < 0) { return invokers.get(i); } } } // 如果所有 Invoker 的权重都一样则随机从 Invoker 列表中返回一个 return invokers.get(ThreadLocalRandom.current().nextInt(length)); } } 以上就是加权随机策略的实现,这里比较主要关注计算生成的随机数对应的 Invoker。通过遍历权重数组,生成的数累减当前权重值,当 offset 为 0 时,就表示 offset 对应当前的 Invoker 服务。 以生成的随机数为 6 为例,遍历 Invokers 长度: 第一轮:offset = 6 - 4 = 2 不满足 offset < 0,继续遍历。 第二轮:offset = 2 - 6 = -4 满足 offset < 0,返回当前索引对应的 Invoker。因为 offset 返回负数,表示 offset 落在当前 Invoker 权重的区间里。 加权随机策略并非一定按照比例被选到,理论上调用次数越多,分布的比例越接近权重所占的比例。 最少活跃数算法 最小活跃数负载均衡策略(LeastActiveLoadBalance)是从最小活跃数的 Invoker 中进行选择。什么是活跃数呢?活跃数是一个 Invoker 正在处理的请求的数量,当 Invoker 开始处理请求时,会将活跃数加 1,完成请求处理后,将相应 Invoker 的活跃数减 1。找出最小活跃数后,最后根据权重进行选择最终的 Invoker。如果最后找出的最小活跃数相同,则随机从中选中一个 Invoker。 public class LeastActiveLoadBalance extends AbstractLoadBalance { public static final String NAME = "leastactive"; @Override protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) { // Invoker 数量 int length = invokers.size(); // 所有 Invoker 中的最小活跃值都是 -1 int leastActive = -1; // 最小活跃值 Invoker 的数量 int leastCount = 0; // 最小活跃值 Invoker 在 Invokers 列表中对应的下标位置 int[] leastIndexes = new int[length]; // 保存每个 Invoker 的权重 int[] weights = new int[length]; // 总权重 int totalWeight = 0; // 第一个最小活跃数的权重 int firstWeight = 0; // 最小活跃数 Invoker 列表的权重是否一样 boolean sameWeight = true; // 找出最小活跃数 Invoker 的下标 for (int i = 0; i < length; i++) { Invoker<T> invoker = invokers.get(i); // 获取最小活跃数 int active = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName()).getActive(); // 获取权重 int afterWarmup = getWeight(invoker, invocation); // 保存权重 weights[i] = afterWarmup; // 如果当前最小活跃数为-1(-1为最小值)或小于leastActive if (leastActive == -1 || active < leastActive) { // 重置最小活跃数 leastActive = active; // 重置最小活跃数 Invoker 的数量 leastCount = 1; // 保存当前 Invoker 在 Invokers 列表中的索引至leastIndexes数组中 leastIndexes[0] = i; // 重置最小活跃数 invoker 的总权重值 totalWeight = afterWarmup; // 记录当前 Invoker 权重为第一个最小活跃数 Invoker 的权重 firstWeight = afterWarmup; // 因为当前 Invoker 重置为第一个最小活跃数 Invoker ,所以标识所有最小活跃数 Invoker 权重都一样的值为 true sameWeight = true; // 如果当前最小活跃数和已声明的最小活跃数相等 } else if (active == leastActive) { // 记录当前 Invoker 的位置 leastIndexes[leastCount++] = i; // 累加当前 Invoker 权重到总权重中 totalWeight += afterWarmup; // 如果当前权重与firstWeight不相等,则将 sameWeight 改为 false if (sameWeight && i > 0 && afterWarmup != firstWeight) { sameWeight = false; } } } // 如果最小活跃数 Invoker 只有一个,直接返回该 Invoker if (leastCount == 1) { return invokers.get(leastIndexes[0]); } if (!sameWeight && totalWeight > 0) { // 根据权重随机从最小活跃数 Invoker 列表中选择一个 int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight); for (int i = 0; i < leastCount; i++) { int leastIndex = leastIndexes[i]; offsetWeight -= weights[leastIndex]; if (offsetWeight < 0) { return invokers.get(leastIndex); } } } // 如果所有 Invoker 的权重都一样则随机从 Invoker 列表中返回一个 return invokers.get(leastIndexes[ThreadLocalRandom.current().nextInt(leastCount)]); } } 这段代码的整个逻辑就是,从 Invokers 列表中筛选出最小活跃数的 Invoker,然后类似加权随机算法策略方式选择最终的 Invoker 服务。 轮询算法 加权轮询负载均衡策略(RoundRobinLoadBalance)是基于权重来决定轮询的比例。普通轮询会将请求均匀的分布在每个节点,但不能很好调节不同性能服务器的请求处理,所以加权负载均衡来根据权重在轮询机制中分配相对应的请求比例给每台服务器。 public class RoundRobinLoadBalance extends AbstractLoadBalance { public static final String NAME = "roundrobin"; private static final int RECYCLE_PERIOD = 60000; protected static class WeightedRoundRobin { private int weight; private AtomicLong current = new AtomicLong(0); private long lastUpdate; public int getWeight() { return weight; } public void setWeight(int weight) { this.weight = weight; current.set(0); } public long increaseCurrent() { return current.addAndGet(weight); } public void sel(int total) { current.addAndGet(-1 * total); } public long getLastUpdate() { return lastUpdate; } public void setLastUpdate(long lastUpdate) { this.lastUpdate = lastUpdate; } } private ConcurrentMap<String, ConcurrentMap<String, WeightedRoundRobin>> methodWeightMap = new ConcurrentHashMap<String, ConcurrentMap<String, WeightedRoundRobin>>(); private AtomicBoolean updateLock = new AtomicBoolean(); /** * get invoker addr list cached for specified invocation * <p> * <b>for unit test only</b> * * @param invokers * @param invocation * @return */ protected <T> Collection<String> getInvokerAddrList(List<Invoker<T>> invokers, Invocation invocation) { String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName(); Map<String, WeightedRoundRobin> map = methodWeightMap.get(key); if (map != null) { return map.keySet(); } return null; } @Override protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) { // key 为 接口名+方法名 String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName(); // 查看缓存中是否存在相应服务接口的信息,如果没有则新添加一个元素到缓存中 ConcurrentMap<String, WeightedRoundRobin> map = methodWeightMap.get(key); if (map == null) { methodWeightMap.putIfAbsent(key, new ConcurrentHashMap<String, WeightedRoundRobin>()); map = methodWeightMap.get(key); } // 总权重 int totalWeight = 0; long maxCurrent = Long.MIN_VALUE; // 当前时间戳 long now = System.currentTimeMillis(); // 最大 current 的 Invoker Invoker<T> selectedInvoker = null; // 保存选中的 WeightedRoundRobin 对象 WeightedRoundRobin selectedWRR = null; // 遍历 Invokers 列表 for (Invoker<T> invoker : invokers) { // 从缓存中获取 WeightedRoundRobin 对象 String identifyString = invoker.getUrl().toIdentityString(); WeightedRoundRobin weightedRoundRobin = map.get(identifyString); // 获取当前 Invoker 对象 int weight = getWeight(invoker, invocation); // 如果当前 Invoker 没有对应的 WeightedRoundRobin 对象,则新增一个 if (weightedRoundRobin == null) { weightedRoundRobin = new WeightedRoundRobin(); weightedRoundRobin.setWeight(weight); map.putIfAbsent(identifyString, weightedRoundRobin); } // 如果当前 Invoker 权重不等于对应的 WeightedRoundRobin 对象中的权重,则重新设置当前权重到对应的 WeightedRoundRobin 对象中 if (weight != weightedRoundRobin.getWeight()) { weightedRoundRobin.setWeight(weight); } // 累加权重到 current 中 long cur = weightedRoundRobin.increaseCurrent(); // 设置 weightedRoundRobin 对象最后更新时间 weightedRoundRobin.setLastUpdate(now); // 最大 current 的 Invoker,并赋值给相应的变量 if (cur > maxCurrent) { maxCurrent = cur; selectedInvoker = invoker; selectedWRR = weightedRoundRobin; } // 累加权重到总权重中 totalWeight += weight; } // 如果 Invokers 列表中的数量不等于缓存map中的数量 if (!updateLock.get() && invokers.size() != map.size()) { if (updateLock.compareAndSet(false, true)) { try { // 拷贝 map 到 newMap 中 ConcurrentMap<String, WeightedRoundRobin> newMap = new ConcurrentHashMap<String, WeightedRoundRobin>(); newMap.putAll(map); // newMap 转化为 Iterator Iterator<Entry<String, WeightedRoundRobin>> it = newMap.entrySet().iterator(); // 循环删除超过设定时长没更新的缓存 while (it.hasNext()) { Entry<String, WeightedRoundRobin> item = it.next(); if (now - item.getValue().getLastUpdate() > RECYCLE_PERIOD) { it.remove(); } } // 将当前newMap服务缓存中 methodWeightMap.put(key, newMap); } finally { updateLock.set(false); } } } // 如果存在被选中的 Invoker if (selectedInvoker != null) { // 计算 current = current - totalWeight selectedWRR.sel(totalWeight); return selectedInvoker; } // 正常情况这里不会到达 return invokers.get(0); } } 上面选中 Invoker 逻辑为:每个 Invoker 都有一个 current 值,初始值为自身权重。在每个 Invoker 中current = current + weight。遍历完 Invoker 后,current 最大的那个 Invoker 就是本次选中的 Invoker。选中 Invoker 后,将本次 current 值计算current = current - totalWeight。 以上面192.168.1.10和192.168.1.11两个负载均衡的服务,权重分别为 4、6 。基于选中前current = current + weight、选中后current = current - totalWeight计算公式得出如下 请求次数 选中前 current 选中后 current 被选中服务 1 [4, 6] [4, -4] 192.168.1.11 2 [8, 2] [-2, 2] 192.168.1.10 3 [2, 8] [2, -2] 192.168.1.11 4 [6, 4] [-4, 4] 192.168.1.10 5 [0, 10] [0, 0] 192.168.1.11 一致性 Hash 算法 一致性 Hash 负载均衡策略(ConsistentHashLoadBalance)是让参数相同的请求分配到同一机器上。把每个服务节点分布在一个环上,请求也分布在环形中。以请求在环上的位置,顺时针寻找换上第一个服务节点。如图所示: 同时,为避免请求散列不均匀,dubbo 中会将每个 Invoker 再虚拟多个节点出来,使得请求调用更加均匀。 一致性 Hash 修改配置如下: <!-- dubbo 默认只对第一个参数进行 hash 标识,指定hash参数 --> <dubbo:parameter key="hash.arguments" value="1" /> <!-- 虚拟节点数量 --> <dubbo:parameter key="hash.nodes" value="200" /> 一致性 Hash 实现如下: public class ConsistentHashLoadBalance extends AbstractLoadBalance { public static final String NAME = "consistenthash"; /** * Hash nodes name */ public static final String HASH_NODES = "hash.nodes"; /** * Hash arguments name */ public static final String HASH_ARGUMENTS = "hash.arguments"; private final ConcurrentMap<String, ConsistentHashSelector<?>> selectors = new ConcurrentHashMap<String, ConsistentHashSelector<?>>(); @SuppressWarnings("unchecked") @Override protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) { // 获取请求的方法名 String methodName = RpcUtils.getMethodName(invocation); // key = 接口名+方法名 String key = invokers.get(0).getUrl().getServiceKey() + "." + methodName; // invokers 的 hashcode int identityHashCode = System.identityHashCode(invokers); // 查看缓存中是否存在对应 key 的数据,或 Invokers 列表是否有过变动。如果没有,则新添加到缓存中,并且返回负载均衡得出的 Invoker ConsistentHashSelector<T> selector = (ConsistentHashSelector<T>) selectors.get(key); if (selector == null || selector.identityHashCode != identityHashCode) { selectors.put(key, new ConsistentHashSelector<T>(invokers, methodName, identityHashCode)); selector = (ConsistentHashSelector<T>) selectors.get(key); } return selector.select(invocation); } // ConsistentHashSelector class ... } doSelect 中主要实现缓存检查和 Invokers 变动检查,一致性 hash 负载均衡的实现在这个内部类 ConsistentHashSelector 中实现。 private static final class ConsistentHashSelector<T> { // 存储虚拟节点 private final TreeMap<Long, Invoker<T>> virtualInvokers; // 节点数 private final int replicaNumber; // invoker 列表的 hashcode,用来判断 Invoker 列表是否变化 private final int identityHashCode; // 请求中用来作Hash映射的参数的索引 private final int[] argumentIndex; ConsistentHashSelector(List<Invoker<T>> invokers, String methodName, int identityHashCode) { this.virtualInvokers = new TreeMap<Long, Invoker<T>>(); this.identityHashCode = identityHashCode; URL url = invokers.get(0).getUrl(); // 获取节点数 this.replicaNumber = url.getMethodParameter(methodName, HASH_NODES, 160); // 获取配置中的 参数索引 String[] index = COMMA_SPLIT_PATTERN.split(url.getMethodParameter(methodName, HASH_ARGUMENTS, "0")); argumentIndex = new int[index.length]; for (int i = 0; i < index.length; i++) { argumentIndex[i] = Integer.parseInt(index[i]); } for (Invoker<T> invoker : invokers) { // 获取 Invoker 中的地址,包括端口号 String address = invoker.getUrl().getAddress(); // 创建虚拟节点 for (int i = 0; i < replicaNumber / 4; i++) { byte[] digest = md5(address + i); for (int h = 0; h < 4; h++) { long m = hash(digest, h); virtualInvokers.put(m, invoker); } } } } // 找出 Invoker public Invoker<T> select(Invocation invocation) { // 将参数转为字符串 String key = toKey(invocation.getArguments()); // 字符串参数转换为 md5 byte[] digest = md5(key); // 根据 md5 找出 Invoker return selectForKey(hash(digest, 0)); } // 将参数拼接成字符串 private String toKey(Object[] args) { StringBuilder buf = new StringBuilder(); for (int i : argumentIndex) { if (i >= 0 && i < args.length) { buf.append(args[i]); } } return buf.toString(); } // 利用 md5 匹配到对应的 Invoker private Invoker<T> selectForKey(long hash) { // 找到第一个大于当前 hash 的 Invoker Map.Entry<Long, Invoker<T>> entry = virtualInvokers.ceilingEntry(hash); if (entry == null) { entry = virtualInvokers.firstEntry(); } return entry.getValue(); } // hash 运算 private long hash(byte[] digest, int number) { return (((long) (digest[3 + number * 4] & 0xFF) << 24) | ((long) (digest[2 + number * 4] & 0xFF) << 16) | ((long) (digest[1 + number * 4] & 0xFF) << 8) | (digest[number * 4] & 0xFF)) & 0xFFFFFFFFL; } // md5 运算 private byte[] md5(String value) { MessageDigest md5; try { md5 = MessageDigest.getInstance("MD5"); } catch (NoSuchAlgorithmException e) { throw new IllegalStateException(e.getMessage(), e); } md5.reset(); byte[] bytes = value.getBytes(StandardCharsets.UTF_8); md5.update(bytes); return md5.digest(); } } 一致 hash 实现过程就是先创建好虚拟节点,虚拟节点保存在 TreeMap 中。TreeMap 的 key 为配置的参数先进行 md5 运算,然后将 md5 值进行 hash 运算。TreeMap 的 value 为被选中的 Invoker。 最后请求时,计算参数的 hash 值,去从 TreeMap 中获取 Invoker。 总结 Dubbo 负载均衡的实现,技巧上还是比较优雅,可以多多学习其编码思维。在研究其代码时,需要仔细研究其实现原理,否则比较难懂其思想。 推荐阅读 《Dubbo 路由机制的实现》 《Dubbo 扩展点加载机制:从 Java SPI 到 Dubbo SPI》 《Dubbo之服务消费原理》 《Dubbo之服务暴露》 《你必须会的 JDK 动态代理和 CGLIB 动态代理》 关注公众号 『ytao』 坚持原创技术文章输出,专注但不限于 Java 相关技术。

优秀的个人博客,低调大师

每日一博|Dubbo 分析之心跳设计

前言 谈到RPC肯定绕不开TCP通信,而主流的RPC框架都依赖于Netty等通信框架,这时候我们还要考虑是使用长连接还是短连接: 短连接:每次通信结束后关闭连接,下次通信需要重新创建连接;优点就是无需管理连接,无需保活连接; 长连接:每次通信结束不关闭连接,连接可以复用,保证了性能;缺点就是连接需要统一管理,并且需要保活; 主流的RPC框架都会追求性能选择使用长连接,所以如何保活连接就是一个重要的话题,也是本文的主题,下面会重点介绍一些保活策略; 为什么需要保活 上面介绍的长连接、短连接并不是TCP提供的功能,所以长连接是需要应用端自己来实现的,包括:连接的统一管理,如何保活等;如何保活之前我们了解一下为什么需要保活?主要原因是网络不是100%可靠的,我们创建好的连接可能由于网络原因导致连接已经不可用了,如果连接一直有消息往来,那么系统马上可以感知到连接断开;但是我们系统可能长时间没有消息来往,导致系统不能及时感知到连接不可用,也就是不能及时处理重连或者释放连接;常见的保活策略使用心跳机制由应用层来实现,还有网络层提供的TCP Keepalive保活探测机制; TCP Keepalive机制 TCP Keepalive是操作系统实现的功能,并不是TCP协议的一部分,需要在操作系统下进行相关配置,开启此功能后,如果连接在一段时间内没有数据往来,TCP将发送Keepalive探针来确认连接的可用性,Keepalive几个内核参数配置: tcp_keepalive_time:连接多长时间没有数据往来发送探针请求,默认为7200s(2h); tcp_keepalive_probes:探测失败重试的次数默认为10次; tcp_keepalive_intvl:重试的间隔时间默认75s; 以上参数可以修改到/etc/sysctl.conf文件中;是否使用Keepalive用来保活就够了,其实还不够,Keepalive只是在网络层就行保活,如果网络本身没有问题,但是系统由于其他原因已经不可用了,这时候Keepalive并不能发现;所以往往还需要结合心跳机制来一起使用; 心跳机制 何为心跳机制,简单来讲就是客户端启动一个定时器用来定时发送请求,服务端接到请求进行响应,如果多次没有接受到响应,那么客户端认为连接已经断开,可以断开半打开的连接或者进行重连处理;下面以Dubbo为例来看看是如何具体实施的; Dubbo2.6.X 在HeaderExchangeClient中启动了定时器ScheduledThreadPoolExecutor来定期执行心跳请求: ScheduledThreadPoolExecutor scheduled =newScheduledThreadPoolExecutor(2,newNamedThreadFactory("dubbo-remoting-client-heartbeat",true)); 在实例化HeaderExchangeClient时启动心跳定时器: private void startHeartbeatTimer() { stopHeartbeatTimer(); if (heartbeat > 0) { heartbeatTimer = scheduled.scheduleWithFixedDelay( new HeartBeatTask(new HeartBeatTask.ChannelProvider() { @Override public Collection<Channel> getChannels() { return Collections.<Channel>singletonList(HeaderExchangeClient.this); } }, heartbeat, heartbeatTimeout), heartbeat, heartbeat, TimeUnit.MILLISECONDS); } } heartbeat默认为60秒,heartbeatTimeout默认为heartbeat*3,可以理解至少出现三次心跳请求还未收到回复才会任务连接已经断开;HeartBeatTask为执行心跳的任务: public void run() { long now = System.currentTimeMillis(); for (Channel channel : channelProvider.getChannels()) { if (channel.isClosed()) { continue; } Long lastRead = (Long) channel.getAttribute(HeaderExchangeHandler.KEY_READ_TIMESTAMP); Long lastWrite = (Long) channel.getAttribute(HeaderExchangeHandler.KEY_WRITE_TIMESTAMP); if ((lastRead != null && now - lastRead > heartbeat) || (lastWrite != null && now - lastWrite > heartbeat)) { // 发送心跳 } if (lastRead != null && now - lastRead > heartbeatTimeout) { if (channel instanceof Client) { ((Client) channel).reconnect(); } else { channel.close(); } } } } 因为Dubbo双端都会发送心跳请求,所以可以发现有两个时间点分别是:lastRead和lastWrite;当然时间和最后读取,最后写的时间间隔大于heartbeat就会发送心跳请求;如果多次心跳未返回结果,也就是最后读取消息时间大于heartbeatTimeout会判定当前是Client还是Server,如果是Client会发起reconnect,Server会关闭连接,这样的考虑是合理的,客户端调用是强依赖可用连接的,而服务端可以等待客户端重新建立连接;以上只是介绍的Client,同样Server端也有相同的心跳处理,在可以查看HeaderExchangeServer; Dubbo2.7.0 Dubbo2.7.0的心跳机制在2.6.X的基础上得到了加强,同样在HeaderExchangeClient中使用HashedWheelTimer开启心跳检测,这是Netty提供的一个时间轮定时器,在任务非常多,并且任务执行时间很短的情况下,HashedWheelTimer比Schedule性能更好,特别适合心跳检测; HashedWheelTimer heartbeatTimer = new HashedWheelTimer(new NamedThreadFactory("dubbo-client-heartbeat", true), tickDuration, TimeUnit.MILLISECONDS, Constants.TICKS_PER_WHEEL); 分别启动了两个定时任务:startHeartBeatTask和startReconnectTask: private void startHeartbeatTimer() { AbstractTimerTask.ChannelProvider cp = () -> Collections.singletonList(HeaderExchangeClient.this); long heartbeatTick = calculateLeastDuration(heartbeat); long heartbeatTimeoutTick = calculateLeastDuration(heartbeatTimeout); HeartbeatTimerTask heartBeatTimerTask = new HeartbeatTimerTask(cp, heartbeatTick, heartbeat); ReconnectTimerTask reconnectTimerTask = new ReconnectTimerTask(cp, heartbeatTimeoutTick, heartbeatTimeout); // init task and start timer. heartbeatTimer.newTimeout(heartBeatTimerTask, heartbeatTick, TimeUnit.MILLISECONDS); heartbeatTimer.newTimeout(reconnectTimerTask, heartbeatTimeoutTick, TimeUnit.MILLISECONDS); } HeartbeatTimerTask:用来定时发送心跳请求,心跳间隔时间默认为60秒;这里重新计算了时间,其实就是在原来的基础上除以3,其实就是缩短了检测间隔时间,增大了及时发现死链的概率;分别看一下两个任务: protected void doTask(Channel channel) { Long lastRead = lastRead(channel); Long lastWrite = lastWrite(channel); if ((lastRead != null && now() - lastRead > heartbeat) || (lastWrite != null && now() - lastWrite > heartbeat)) { Request req = new Request(); req.setVersion(Version.getProtocolVersion()); req.setTwoWay(true); req.setEvent(Request.HEARTBEAT_EVENT); channel.send(req); } } 同上检测最后读写时间和heartbeat的大小,注:普通请求和心跳请求都会更新读写时间; protected void doTask(Channel channel) { Long lastRead = lastRead(channel); Long now = now(); if (lastRead != null && now - lastRead > heartbeatTimeout) { if (channel instanceof Client) { ((Client) channel).reconnect(); } else { channel.close(); } } } 同样的在超时的情况下,Client重连,Server关闭连接;同样Server端也有相同的心跳处理,在可以查看HeaderExchangeServer; Dubbo2.7.1-X 在Dubbo2.7.1之后,借助了Netty提供的IdleStateHandler来实现心跳机制服务: public IdleStateHandler( long readerIdleTime, long writerIdleTime, long allIdleTime, TimeUnit unit) { this(false, readerIdleTime, writerIdleTime, allIdleTime, unit); } readerIdleTime:读超时时间; writerIdleTime:写超时时间; allIdleTime:所有类型的超时时间; 根据设置的超时时间,循环检查读写事件多久没有发生了,在pipeline中加入IdleSateHandler之后,可以在此pipeline的任意Handler的userEventTriggered方法之中检测IdleStateEvent事件;下面看看具体Client和Server端添加的IdleStateHandler: Client端 protected void initChannel(Channel ch) throws Exception { final NettyClientHandler nettyClientHandler = new NettyClientHandler(getUrl(), this); int heartbeatInterval = UrlUtils.getHeartbeat(getUrl()); ch.pipeline().addLast("client-idle-handler", new IdleStateHandler(heartbeatInterval, 0, 0, MILLISECONDS)) .addLast("handler", nettyClientHandler); } Client端在NettyClient中添加了IdleStateHandler,指定了读写超时时间默认为60秒;60秒内没有读写事件发生,会触发IdleStateEvent事件在NettyClientHandler处理: public void userEventTriggered(ChannelHandlerContext ctx, Object evt) throws Exception { if (evt instanceof IdleStateEvent) { try { NettyChannel channel = NettyChannel.getOrAddChannel(ctx.channel(), url, handler); Request req = new Request(); req.setVersion(Version.getProtocolVersion()); req.setTwoWay(true); req.setEvent(Request.HEARTBEAT_EVENT); channel.send(req); } finally { NettyChannel.removeChannelIfDisconnected(ctx.channel()); } } else { super.userEventTriggered(ctx, evt); } } 可以发现接收到IdleStateEvent事件发送了心跳请求;至于Client端如何处理重连,同样在HeaderExchangeClient中使用HashedWheelTimer定时器启动了两个任务:心跳任务和重连任务,感觉这里已经不需要心跳任务了,至于重连任务其实也可以放到userEventTriggered中处理; Server端 protected void initChannel(NioSocketChannel ch) throws Exception { int idleTimeout = UrlUtils.getIdleTimeout(getUrl()); final NettyServerHandler nettyServerHandler = new NettyServerHandler(getUrl(), this); ch.pipeline().addLast("server-idle-handler", new IdleStateHandler(0, 0, idleTimeout, MILLISECONDS)) .addLast("handler", nettyServerHandler); } Server端指定的超时时间默认为60*3秒,在NettyServerHandler中处理userEventTriggered public void userEventTriggered(ChannelHandlerContext ctx, Object evt) throws Exception { if (evt instanceof IdleStateEvent) { NettyChannel channel = NettyChannel.getOrAddChannel(ctx.channel(), url, handler); try { channel.close(); } finally { NettyChannel.removeChannelIfDisconnected(ctx.channel()); } } super.userEventTriggered(ctx, evt); } Server端在指定的超时时间内没有发生读写,会直接关闭连接;相比之前现在只有Client发送心跳,单向发送心跳;同样的在HeaderExchangeServer中并没有启动多个认为,仅仅启动了一个CloseTimerTask,用来检测超时时间关闭连接;感觉这个任务是不是也可以不需要了,IdleStateHandler已经实现了此功能; 综上:在使用IdleStateHandler的情况下来同时在HeaderExchangeClient启动心跳+重连机制,HeaderExchangeServer启动了关闭连接机制;主要是因为IdleStateHandler是Netty框架特有了,而Dubbo是支持多种底层通讯框架的包括Mina,Grizzy等,应该是为了兼容此类框架存在的; 总结 本文首先介绍了RPC中引入的长连接方式,继而引出长连接的保活机制,为什么需要保活?然后分别介绍了网络层保活机制TCP Keepalive机制,应用层心跳机制;最后已Dubbo为例看各个版本中对心跳机制的进化。

优秀的个人博客,低调大师

每日一博 | Scrum vs Kanban,如何选择?

两大方法 虽然敏捷诞生只有20年的时间,但却帮助了很多企业取得了成功,在这期间也出现了各种敏捷方法论和思想体系,这篇文章,我们试图去讨论一个问题:对于准备实施敏捷的团队,在Scrum和Kanban两种方法之间如何选择?(特别说明:有人会说Kanban其实是一套思想体系,不是方法论,这里我们不想陷入概念之争,只想解释他们适用的场景,所以下文中都会称呼他们为方法,而不会刻意加以区分)。 Scrum和Kanban两者都作为符合精益思想和敏捷的思考结果,他们之间必然会有一些相似点: 两者都限制开发中工作数目 两者都是通过透明度来驱动过程改进 两者都提倡提及时且稳定的交付价值 两者都基于自组织型团队 两者都要求把工作细分 两者都是基于经验数据持续优化 再来看看两者之间的一些区别: 下面结合实例来演示Scrum和Kanban这两种方法如何在Worktile Agile中体现。 Scrum 在标准的Scrum流程定义中,有两个关键的产物:Product Backlog和Sprint Backlog,以及四个关键的会议:计划会议、每日立会、评审会议和回顾会议。 在Worktile Agile产品中,我们把Product Backlog分为需求和缺陷,其中需求部分使用Epic-Feature-User Story三级体系来表示。 Epic:史诗,表示比较大的特性,开发周期一般是1-3月,用于产品路线图的规划 Feature:特性,表示相对小一些的特性,开发周期一般是1-3周,用于产品版本的规划 User Story:用户故事,表示最小的用户场景,开发周期一般是1-3天,用于迭代规划。 图1 Worktile Agile中需求管理 在每个迭代开始时会召开计划会议,全员都会参加,这个会议最重要的事情就是确定Sprint Backlog,由Product Owner按照优先级介绍Product Backlog,然后团队决定是否把某一个条目放入当前迭代。 图2 Worktile Agile中迭代规划 迭代进行的时间内,每天都会有10-15分钟的站立会议,团队中每个成员基于Worktile中的迭代任务板介绍前一个工作日所做的事情,以及遇到的问题。 图3 Worktile Agile中的迭代任务板 迭代结束时召开评审会议,在评审会议上每个人基于产品演示自己在这个迭代中所完成的成果,团队成员可以针对完成的事项提一些建议。在评审会议结束后,团队成员会一起召开迭代回顾会,回顾会是Scrum迭代实践中的最后一环,也是最重要的一环,迭代回顾会将整个迭代形成了闭环。回顾会上大家提出的问题通过迭代回顾面板记录。 图4 Worktile Agile中的迭代回顾面板 在Scrum实践中,大部分团队都会忽视版本管理,迭代是针对Scrum团队的活动行为,而版本管理是针对产品的,它定义的是一个批量的概念,用于版本进度管理和交付风险管理,明确在一个版本中的最终交付物,Worktile Agile中你可以创建版本并把它与迭代关联,或者只是单纯的设置某个用户故事/缺陷属于某个版本 图5 Worktile Agile中的版本管理 Kanban 对于一个团队采用Kanban方法来管理是否能够成功,取决于使用Kanban后能否为你的团队带来以下几点改进: 帮助团队可视化整个链条的价值流动 帮助团队识别价值流动中的风险点 帮助团队度量价值流动中的各种浪费,并加以消除 基于这些考虑,在Worktile Agile中的Kanban项目类型,目前支持以下的能力: 能够清晰定义在制品WIP 能够清晰定义在制品限制WIP Limit 明确定义DoD 支持多泳道分割 图6 Worktile Agile中的Kanban项目 在Worktile Agile中的同一个项目中,支持同时创建多个看板,便于你根据业务场景的不同,或者团队角色的不同定义多个看板,并且可以针对每个看板的需要进行个性化的配置。 图7 根据团队的需要个性化你的看板 因地制宜 讲完了Scrum和Kanban的基础知识,以及在Worktile Agile中对于Scrum和Kanban的支持,我们来看看在实际团队落地时,如何结合实际情况在二者之间选择。 如果你的团队是产品导向型的,推荐使用Scrum;如果是研究导向型的,比如性能优化、编码优化等不确定性非常大的,推荐使用Kanban。 团队规模适中,5-9人左右,并且有跨功能团队成员,推荐使用Scrum;相反如果你的团队规模比较小,只有2-5人左右,推荐使用Kanban,相对效率较高。 产品或者项目交付是按照一定的周期来计算,比如每2周或每个月要求有一个新的版本,推荐使用Scrum;如果产品或者项目的交付不是按周期来计算,而是按照某个特定的事件为标志,比如性能提升了10%发布一个新版,推荐使用Kanban。 当然这些只不过是一点经验之谈,具体还要看团队的实际情况,因地制宜,来推动敏捷在团队的真正落地,而不是流于形式。 Worktile 官网:worktile.com 本文作者:Worktile CTO Terry 文章首发于「Worktile官方博客」,转载请注明出处。

优秀的个人博客,低调大师

每日一博 | 无监督学习算法

本文首发自公众号:RAIS,点击直接关注。 前言 本系列文章为 《Deep Learning》 读书笔记,可以参看原书一起阅读,效果更佳。 无监督学习算法 就是无监督的一种学习方法,太抽象,有一种定义(这种定义其实不够准确,无监督和监督之间界限模糊)是说如果训练集有标签的就是有监督学习,无标签的就是无监督,没有标签,意味着不知道结果。有监督学习算法可以知道一堆图片它们是狗的照片,无监督学习算法只能知道它们是一类,但这一类叫什么就不知道了。 无监督学习算法没有标签,因此训练的也往往是没有明确目标的,对于结果也可能不好说是好是坏,在本质上来说,无监督学习算法是一种概率统计的方法,在数据中可以发现一些潜在的结构。这么说还是不够清楚,举几个例子说明无监督学习方法有什么作用: 用户分类:马云说每天晚上有五十万的人会浏览淘宝,什么也不买,他也不知道为什么,那既然有如此大的流量,不能浪费,进行精准推荐,会不会效果很好呢?在庞大的用户群中,找到和你很相似的用户,也说不出来哪里相识,反正就是相似,他买过的东西你还没买过,推荐给你,你会不会就冲动了呢? 发现异常:对于网站来说,防止 DDOS 攻击就需要在巨大的请求中找到那些非法请求(广义上的非法,并非单纯指参数非法),进行丢弃不进行服务,这可能就需要无监督学习算法,找到那些和正常用户不一样的请求,也说不出来哪里不一样,反正就是不一样,直接抛弃请求,不进行服务,那攻击带来的影响就会降低一些。 表示 表示是深度学习的核心主题之一,一个经典的无监督学习任务是找到数据的最佳表示,去除那些无关紧要不影响大局或影响因子极小的因素,找到数据最核心最关键的简单表示,这里的简单表示包括低纬表示、稀疏表示和独立表示。 低纬表示:将 x 中的信息尽可能压缩在一个较小的表示中,通常会产生比原始的高维数据具有较小或较弱依赖关系的元素; 稀疏表示:将数据集嵌入到输入项大多数为零的表示中,通常会用于需要增加维数的情况,使得大部分为零的表示不会丢失很多信息; 独立表示:试图分开数据分布中变化的来源,使得表示的维度是相互独立的。 主成分分析 主成分分析(PAC)是经典的降维算法,是一种无监督学习。主成分顾名思义,主要的成分,与之相对应的就是非主要的成分。举个例子,矩阵中有些向量可以用其他的某些向量线性表示,线性相关,那这个向量有一点多余了,去除后不影响原来的空间,基于这样的思想,我们可以考虑将矩阵压缩,在减小矩阵维数的同时尽可能保留原来的信息。 对于方阵的特征分解,就是线性代数中的方法: $$ X=QΛQ^{-1} $$ 其中 X 是 m*m 的矩阵,X 对应的协方差矩阵为: $$ Var(x)=\frac{1}{m-1}X^TX $$ PAC 通过线性变换找到一个 Var(x) 是对角矩阵的线性表示:z=$W^TX$ 对于任意矩阵,奇异值分解(SVD)是最接近于特征分解的,同样这里也是: $$ X=U∑W^T $$ 其中 X 是 m*n 的矩阵;U 是 m*m 的方阵,其中的正交向量称作左奇异向量;∑ 是 m*n 矩阵,除对角线元素外都是零,对角线上的元素称为奇异值;W 是 n*n 的矩阵,其中的正交向量称为右奇异向量。具体的求法步骤为: U:求 $XX^T$ 的特征值和特征向量,再单位化; W:求 $X^TX$ 的特征值和特征向量,再单位化; ∑:将 $XX^T$ 的特征值求平方根。 以 W 作为特征向量基,可以得到原来的特征向量方程,$U^TU=I, W^TW=I$: $$ X^TX=(U∑W^T)^TU∑W^T=W(∑)^{2}W^T $$ X 的方差: $$ Var(x)=\frac{1}{m-1}X^TX=\frac{1}{m-1}W(∑)^{2}W^T $$ z 的协方差满足对角的要求: $$ Var(z)=\frac{1}{m-1}Z^TZ=\frac{1}{m-1}(∑)^2 $$ K-maeans 聚类(K-均值聚类) 聚类与分类是不同的,分类的类别是已知的,需要根据训练集进行训练和学习,找到不同的特征,再喂入测试集输出结果;聚类是事先不知道数据会被分成几类,通过聚类分析将数据分成几个群体。具体方法: 随机将找到 K 个特殊数据点; 其他的数据点根据距离分成 K 类; 然后在 K 类中每个类别中重新推选 K 个特殊的数据点; 如果新选定的数据点与之前选定的数据点距离较大,则根据新的数据点重复步骤 2 之后的步骤; 如果新的数据点和原来的数据点距离在一定阈值内,算法结束。 K-means 聚类优点是快,简单,对于数据点属于一团一团的数据效果很好,但是比较严重的问题是有可能根据初始值的不同分类效果不同且不好,比如汽车图片分类,有可能按照是卡车还是小轿车分类,也有可能是根据红色还是白色分类甚至有些是错误的,这一点需要注意,在不合适的地方此方法可能达不到目标。 总结 本文介绍了主成分分析和 K-means 聚类两种非监督学习方法。 本文首发自公众号:RAIS,点击直接关注。由于各平台 Markdown 解析差异,有些公式显示效果不好,请到我 个人维护网站 查看。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册