首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 几点 PostgreSQL 读书笔记

前言 几条PG读书笔记,并谈谈个人浅见,欢迎讨论。 我去年出差略多,于是在路上把目前主要的两本PostgreSQL书大概翻了翻,做了些笔记,谈点个人看法。 以下简称PG,反正都懂。文内对PG有误解或说错的地方还请批评指正。 第一部分笔记,基于《PostgreSQL修炼之道》一书为主。该书唐成著,2015年出版。此时PG的最新版本应该是9.4。本文亦有基于其他资料。 注:以下“唐老师”指唐成老师,“张老师”指张文升老师。 1. AUTOCOMMIT关键字 事务自动提交模式关键字AUTOCOMMIT,只能大写,小写不行,大小写混合也不行。 唐老师: AUTOCOMMIT,是指psql默认autocommit是on的,我见过的多数人喜欢自动提交。如果觉得这样不安全,可以在.psqlrc中一次性配置好,就不同改了。 点评:这个是小事,但用起来稍微有点不太方便。 2. 什么时候开始表分区 建议当表大小超过PG可用的物理内存时,就开始做表分区。不太了解这个建议是怎么得来的... 唐老师:这个表具体多大该建分区,不同人有不同的认识。通常如果超过内存大小,cache的作用就很弱了。所以超过了物理内存大小,一定应该分区了。 实际上,目前机器的内存都比较大,如512G,实际上表远远没有到512G大小就应该建分区。我个人认为超过32GB,就应该建成分区表。 点评:个人看法,表分区并不是必要的,要综合考虑这个表的宽度(行平均长度)、事务活跃度、数据分布情况,不一而同。 3. 最大事务ID不能超过INT32 事务ID不能超过4字节(32-bit)整数,而且还存在回卷的问题。 唐老师:关于事物ID 32bit的问题,实际上不是把32bit改成64bit就解决问题了。个人认为如果只是改成64bit,实际上没有太大用处。 PG比较保守,32bit虽然可以到20亿,但一般参数设置到2亿,就开始vacuum了。实际中还不如直接把autovacuumfreezemax_age从2亿设置成8亿。 这本质还是一个垃圾回收的问题,就像java的垃圾回收,永远有人说需要优化。 另外,vacuum目前对单个表不能并发,当表比较大时,会导致vacuum很长时间。 张老师:这个历史遗留问题,不过autovacuum近几年的改进可以很大程度缓解事务回滚的问题,但还是治标不治本。 有商业公司将事务号改为int64了,但改动比较多,所以一直没有合并到master,主要依靠运维人员解决,当然,int64是根本的方案,应该包含在以后的发行版中。 点评:虽然通过调整优化回收机制可以缓解这个问题,但我还是觉得升级到64位INT会更好一些。 4. 主从复制功能 最最最要命的,PG直到9.0(2010年发布)才开始支持主从复制,而MySQL在2000年发布3.23版本时就支持了,早了10年,但B乎上有人说MySQL 8.0终于追上PG 9.6的主要功能。 唐老师:关于主备库,实际上不是说9.0之前搭建不了主备库,也可以搭建。就是延迟太大,不方便。当然也可以自己写程序来实现减少延迟,但总之就是不方便。这也是别人说PG太学院派的原因,这么重要的功能不早点加上。 点评:对于互联网,一年的变化就已经非常大了,主从复制这个功能晚了十年才推出,的确很不应该。 5. 版本管理机制 看了下PG的发版模式,大感惊讶。前阵子,同天同时发布12.2、11.7、10.12、9.6.17、9.5.21 和9.4.26共6个版本。再看release notes,以9.0系列为例,基本上每个月都会发布个小版本。这么频繁发版,产品路线规划和版本管理挺堪忧的,做过产品和项目管理的同学们应该有此体会。 这里,其实还有个花边小料。PG发版其实是被各个大商业公司控制的,这些公司想加啥功能,不想加啥功能,都是他们几个巨头说了算。为什么维护那么多大版本,也是因为巨头各自的利益平衡。我道听途说的哈,不对这个料的真假负责。 唐老师:版本的发布,这是误解。PG是固定每个季度发一个小版本,发这个季度发现的问题都修掉。而一般小版本基本不加功能,只修bug。而发现一个bug,这个bug可能在不同的大版本中都是同一个问题。通常所以12.2、11.7、10.12等等这些实际上是一个发布。 PG一年才发布一个大版本,相当于把功能累积一年,才发布,所以发布并不频繁。一般小版本升级很容易,只需要换二进制程序就可以了。另小版本修复的bug,大多是一些比较偏门的bug,有一些用户有时小版本也懒得升级。 巨头们控制,我的认知是这是阴谋论,不存在这个问题。只是PG内核组的人,比较保守,如果你对代码做了大量的修改,内核组的人认为无法review代码和测试发现你的代码的bug,可能就不接受。小修小改,他们最容易接受。大的功能需要拆很多次提交才行。如PG的并行功能,实际上在9.5版本,一些并行的代码就提交进入了,但这些代码只是一些框架和支持代码,不提供任何 可以使用的功能。然后9.6在作出一些并行的功能。后面在慢慢完善这个功能。 张老师:关于版本发布的问题,PG的支持版本是5年,你看到的更新版本是针对不同的LTS的release,这个比较好理解。不过PG是被大公司控制的好像不合理,可以订阅PG官方的邮件了解一下合并到master的情况。 点评:个人还是对PG的发版机制保留意见,对个人用户来说,可能可以避免了被迫升级新版本的“痛苦”,但从项目管理角度说,并行太多计划,相信也会对项目质量有一定影响,见仁见智吧。 6. 第三方插件升级 PG有很多功能需要安装插件,如果做版本升级时候,这些插件也要升级适配。比较要命的是,这些插件大多不是原生的,是第三方提供的,升级适配性比较差。MySQL也有第三方引擎,不过几个主流的引擎都是有比较给力的公司/团队在维护,跟随新版本方面还算及时。 唐老师:PG插件。如果PG插件没有与PG的SQL执行器或优化器等核心功能绑定以及在数据库中创建自己的元数据表,通常是可以做到二进制兼容的。如你自己只是几个bit位运算的函数。这是升级是比较方便的,只要把你的插件的.so拷贝到新版本上就可以了。但如果与版本有关了,升级就有一些麻烦。另一些第三方的差距,质量也是层次不齐,使用的时候需要注意。 点评:个人感觉PG的第三方插件比MySQL更多些,管理起来也不容易。 7. 表分区实现方式 据说在PG11前,表分区是通过触发器插件实现的,这个感觉有点诧异... 唐老师:分区,实际上PG11的之前的分区都是通过很早之前的 表继承来实现的。 而在PG10之前,需要手工建触发器或创建规则来辅助完成分区。这些分区存在一个问题,一方面是触发器,性能会导致插入性能低(当然看你的应用,如果对性能没有这么敏感,其实也没有问题),另就是当分区很多时,而表继承是可以让各个分区的表结构不一样的,这样每个分区都有独立元数据,硬解析的代价与与分区数成线性关系,导致分区很多时,硬解析代价变的很大(硬解析达到1毫秒以上)。 另关于分区,实际上表继承的功能,在某些场景下,用很多的一些作用。如在线的腾挪数据。用作分区,只是表继承的一个方面。当然,如果PG开始就没有表继承的功能,那么表分区的功能估计早都完善了。因为有表继承的功能导致全面的分区功能没有这么急迫,所以拖到了PG12版本才彻底完善好了。 当然在PG9.X时代,有第三方的插件pg_pathman,用这个插件实现分区功能也非常好,功能也很强大。但因为社区核心组的人都是一些很严谨的人,而pg_pathman的代码量比较大,同时修改的都是很核心的部分,所以没有把pg_pathman的代码直接合并到内核中,而是慢慢根据pg_pathman的原理,在经历了PG10、11、12后,才把分区表的功能给完善了。 张老师:PG10之前的表分区是该吐槽,用继承表搞分区不止麻烦,性能还不好。不过PG12的分区表确实有一些可圈可点的地方,可以关注。另外,PG的分区表不支持逻辑复制,这点也不好。 点评:不知道PG铁粉会不会说“yeah,PG的分区比MySQL的更牛逼?” 8. PG没有UNDO LOG 都知道PG著名的"问题",即不记录undo log,而是在表空间中记录每条数据的N个历史版本以实现MVCC,但也带来了后续的vacumn行为,不知道这个"问题"现在有无更好的解决办法。 唐老师: 无undo log。实际上目前vacuum只要合理的配置,并不是什么严重的问题。但目前小白很多,不会做合理的配置,导致这方面的问题较多。对于高并发的数据库,就需要DBA的用心维护。但大家总是想,不需要深入了解这个问题,对PG的默认参数不做修改,就让PG数据库能马上支持高并发的业务场景,目前看这个问题无解。PG9.6或更前面的版本,默认创建出来的数据库的默认参数,有一些在我们一般使用中是不太合理的。到后续版本的PG,如PG10,创建出来的默认参数就合理了一些。当然这可能也有一些历史原因,一些参数默认都是按机械硬盘来设置的。一些加快vacuum同时又要减少对线上业务影响的参数默认没有打开。 点评:PG的MVCC实现机制的确独树一帜,在恢复回滚时确实有优势,但伴随的vacumn问题始终是个阴影。 另一本由谭峰和张文升主笔的《PostgreSQL实战》笔记以后找机会再聊。 受限于个人对PG的认识水平,本文仅涉及到几个很小的方面。本文也并不表示我对PG的态度就是负面的,PG也是个伟大的数据库,MySQL亦是如此,各有所爱吧,止战,各自发力造福技术社区才是正道。 全文完 本文首发https://mp.weixin.qq.com/s/_UWUHyvBf7Uz5_d_f20Bqg

优秀的个人博客,低调大师

每日一博 | 过拟合与欠拟合

本文首发自公众号:RAIS ​前言 本系列文章为 《Deep Learning》 读书笔记,可以参看原书一起阅读,效果更佳。 构建复杂的机器学习算法 上一篇文章中我们介绍了什么叫做机器学习算法极其具体的定义和所关心的问题,比较简单,接下来的文章我们将介绍一些设计学习算法的基本准则。 误差 泛化:机器学习的目的是在新的输入上具有良好的表现,而不是已有的数据,这很好理解,在新的数据上表现良好的能力叫做 泛化。 在机器学习中,总是存在误差的,百分之百的确定的事件已经不是机器学习研究的范围了。既然如此,就一定存在误差,训练过程在训练集上误差称作 训练误差,泛化后的在新的输入上的误差称为 泛化误差 或 测试误差。我们都希望误差尽可能的小,并且相比较而言泛化误差减小更重要(毕竟解决问题才是最重要的)。 这里会遇到一个问题就是我们往往只能得到训练数据集,没有什么好的办法提前获取模型交付生产环境后所新输入的数据,针对这样的问题,我们往往在收集统计训练数据时,尽量接近实际生产环境,并且假设数据之间是 独立同分布 的,称为 数据生成分布,基于这样的原因,我们会假设训练误差和测试误差两者的期望是一样的。因此我们针对数据集,具体的做法就会是先尽可能的减小 训练误差,让模型在已有的数据上表现良好,然后再尽可能减小 测试误差 与训练误差之间的差距,这样就会得到一个测试误差较低的模型。 欠拟合和过拟合 上面描述的过程中,会遇到两个问题,过拟合和欠拟合。 针对训练集,如果训练出的模型类似于将每一个训练集的数据映射到其结果上,训练误差几乎为 0,但是这样的网络关注了训练集中的每一个数据的每一个细节,甚至极其特殊的细节,本应该被忽略,却由于过度追求训练误差而被放大了,这是不可取的,这样训练出的网络处于过拟合状态,对新的输入,尤其是包含特殊细节的输入,会导致其结果不够准确,会导致过拟合。 另外一种情况是训练出的网络针对训练集中的特征点训练不充分,没有抓住尽可能多的特点,也会导致网络训练的不够,处于欠拟合状态。 容量 网络中模型节点的参数多少,代表着拟合各种函数的能力,称作 容量,节点越多,所关注的网络的特征就越多,过多会导致过拟合,过少会导致欠拟合,因此控制网络的容量就很重要。 一种控制容量的算法是选择 假设空间,具体的实现就是选择解决方案的函数集。比如线性回归算法将关于其输入的所有线性函数作为假设空间,广义线性回归的假设空间包含多项式函数,而不仅仅是线性函数。在实际的情况中,找到最合适的拟合函数容量比较难,往往是找到一个大致的容量。 表示容量:我们可以从哪些函数族中选择拟合函数; 有效容量:有可能小于表示容量,基本达到最初的目标,只找到了一个效果还不错但并非完全完美的拟合函数。 一些概念 奥卡姆剃刀:在同样能够解释已知观测的现象中,应该挑选最简单一个(像不像物理上追求大一统的理论)。 VC 维:Vapnic-Chervonenkis Dimension,用来度量容量。如二维假设空间,如果平面上有两个点,分成两类,可能有四种情况;三个点有八种情况;四个点有十四种情况,这样整个平面就分为了相应的部分,无穷的假设点分为了有限的部分。 非参数模型:参数模型学习的函数在观测到新数据前,参数向量的分量个数是有限且固定的,非参数模型没有这些限制。 最近临近回归 线性回归的做法是训练出固定长度的向量作为权重,最近临近算法则不同,而是存储了所有的训练集中的数据,所需要测量的测试点分别与训练集中的点计算距离,认为距离最近的点就和测试点所在同一个类别中,返回同一个回归目标。 贝叶斯误差 也称 贝叶斯错误率,应用贝叶斯分类规则分类器的错误率,贝叶斯分类规则在最小分类错误率上是最优的,因此在所有分类问题中,贝叶斯误差是一个分类器对某个类别所能达到的最低的分类错误率。 没有免费午餐定理 在所有可能的数据生成分布上平均后,每个分类算法在未事先观测的点上都有相同的错误率;换一句话说,没有任何一种机器学习算法是适用于所有情况的;再换一句话说,在某些问题上算法 A 比算法 B 更好,则一定有另外一些问题,算法 B 比算法 A 更好。这告诉我们不要去试图找到一个大一统的算法理论,而应该根据实际问题去寻找相应的最优的算法。 正则化 这个问题真的是太复杂了,在本书这种级别的书,在后面有一整章来讨论这个问题,非常重,因此很幸运在这里可以简单的先进行简单了解,在后面的文章中详细介绍。 在上面的过拟合的图中,也在本篇文章的第一个图,通过过拟合的曲线,我们可以想一下究竟是什么样的函数能是这样的曲线,一定是这个函数好多项,其中变量的次数非常高,例如这样子的,当然这是随便一个例子,并不一定完全是这个图的图像: 对于这个还算简单的问题,用这么复杂的函数去拟合,有点过于追求拟合程度了,过犹不及,这不好。怎么办呢,假设后面四项的系数 a 接近于 0,是不是可以后面这些项对于整个函数来说贡献的值就微乎其微了,则这个函数退化为二次函数,这是我们认为拟合程度最好的情况,这就是一种正则化的方法。在后续的文章中还会介绍大量正则化的形式。总结 欠拟合和过拟合是常见机器学习中的拟合不好的情况,上面介绍了相关内容。 本文首发自公众号:RAIS

优秀的个人博客,低调大师

每日一博 | JDK 14 新特性详解

JDK14新特性详解,2020-03-17正式发布 JDK13新特性详解,2019-09-17正式发布 JDK12新特性详解,2019-03-19正式发布 JDK11新特性详解,2018-09-25正式发布 JDK10新特性详解,2018-03-20正式发布 JDK9 新特性详解,2017-09-21正式发布 JDK8 新特性详解,2014-03-18正式发布 预览版:该功能在当前版本可以使用,如果效果不是很好的话,可能以后的其他版本就会删去该功能。 最终版:该功能在之前版本效果很好,之后的每个版本中都会存在该功能。 1、Switch(最终版) 和之前的jdk12、13功能一样,只不过确定下来为最终版 int numLetters = switch (day) { case MONDAY, FRIDAY, SUNDAY -> 6; case TUESDAY -> 7; case THURSDAY, SATURDAY -> 8; case WEDNESDAY -> 9; }; 2、垃圾回收器(更新优化) 1、Windows的ZGC:现在可以在Windows上作为实验功能使用,要启用它,请使用JVM标志-XX:+UnlockExperimentalVMOptions -XX:+UseZGC。 2、Mac的ZGC:现在可作为macOS上的实验功能使用。要启用它,请使用JVM标志-XX:+UnlockExperimentalVMOptions -XX:+UseZGC。 3、并行GC的改进:并行GC已采用与其他收集器相同的任务管理机制来调度并行任务。这可能会显着提高性能。由于这一变化,以下产品标志 已过时:-XX:BindGCTaskThreadsToCPUs,-XX:UseGCTaskAffinity,和-XX:GCTaskTimeStampEntries。 4、G1NUMA感知内存分配:现在尝试跨垃圾收集在年轻一代的同一NUMA节点上分配并保留对象。这类似于并行GC NUMA意识。G1尝试使用 严格的交错在所有可用的NUMA节点上均匀分配Humongous和Old区域。从年轻一代复制到老一代的对象的放置是随机的。这些新的NUMA感知 内存分配试探法通过使用-XX:+UseNUNMA命令行选项自动启用。 3、Record(预览功能) @Data @AllArgsConstructor class Group { // 组名 private String name; // 人数 private int nums; } 使用它可以替代构造器、equal方法、toString方法,hashCode方法 Point(String name,int nums){} Java语言中一种新型的类型声明。像枚举一样enum, record是类的受限形式。它声明其表示形式,并提交与该表示形式匹配的API。记录放弃了类通常享有的自由:将API与表示分离的能力。作为回报,记录获得了很大程度的简洁性。 4、货币格式(优化) 可以通过 NumberFormat.getCurrencyInstance(Locale)使用“ u-cf-account” Unicode区域设置扩展名来获得具有记帐样式的 货币格式实例,其中金额在某些区域设置中用括号表示,例如,Locale.US,它将格式化为($3.27)而不是-$3.27。 而之前的版本是前边结果为负数。 5、NIO的Channel通道 阐明ReadableByteChannel.read()的规范和规格DatagramChannel.receive(),FileChannel.read(ByteBuffer,long),Read ableByteChannel.read(),ScatteringByteChannel.read()方法已经在此版本已经更新到指定的IllegalArgumentException,如果 (任何)缓冲区参数(S)是只读的抛出。 6、删除功能 1、CMS垃圾收集器已被删除。-XX:UseConcMarkSweepGC和别名-Xconcgc,-Xnoconcgc以及所有CMS特定选项(太多,无法列出)都已废弃。 2、删除了安全库java.security.acl API 7、instanceof的模式匹配(预览版) 提供模式匹配来 增强Java编程语言instanceof if (obj instanceof String s) { // can use s here } else { // can't use s here } 8、弃用功能 线程: 不建议使用线程挂起、删除,下面的方法中涉及的线程挂起Thread,并且Thread已在本版本中晚期弃用,Thread.suspend(),Thread. resume(),ThreadGroup.suspend(),ThreadGroup.resume(),ThreadGroup.allowThreadSuspension(boolean)这些方法将在 将来的版本中删除。 垃圾回收器: 弃用ParallelScavenge + SerialOld GC组合,任何UseParallelOldGC用于启用此垃圾回收算法组合的命令行选项的使用,都会引 起弃用警告。嵌入式替换是通过-XX:+UseParallelGC在命令行上使用ParallelScavenge + ParallelOld垃圾收集器。 椭圆曲线: security-libs / javax.crypto,已过时的旧椭圆曲线去除。 9、注意点 线程中断状态始终可用: 该规范java.lang.Thread::interrupt允许实现仅跟踪活动线程的中断状态,并且以前就是这种情况。从此版本开始,a的中断状态 Thread始终可用,并且如果您在线程t启动之前或终止之后中断线程,查询t.isInterrupted()将返回true。 DatagramSocket.send和MulticastSocket.send抛出IllegalArgumentException当套接字没有连接和数据包不包含地址: 如果套接字未连接且没有套接字地址,send则由DatagramSocket和定义的方法MulticastSocket已更改为抛出。 MulticastSocketgetOption(IP_MULTICAST_IF)未设置传出接口时返回null: 该MulticastSocket方法getOption已更改为符合中描述的行为StanndardSocketOptions.IP_MULTCAST_IF。如果没有设置接口, MulticastSocket.getOption(StanndardSocketOptions.IP_MULTCAST_IF)现在返回null。 MulticastSocket上getOption /的SetOption为IP_MULTICAST_LOOP个符合随着StandardSocketOptions.IP_MULTICAST_LOOP规范的行为: 该MulticastSocket方法getOption和setOption已更改以符合所描述的行为StandardSocketOptions.IP_MULTICAST_LOOP规范, MulticastSocket.getOption(StanndardSocketOptions.IP_MULTCAST_IF)现在,如果启用了环回模式,则返回true。 设置MulticastSocket.getOption(StanndardSocketOptions.IP_MULTCAST_IF)启用回送模式。

优秀的个人博客,低调大师

每日一博 | Charles 从入门到精通

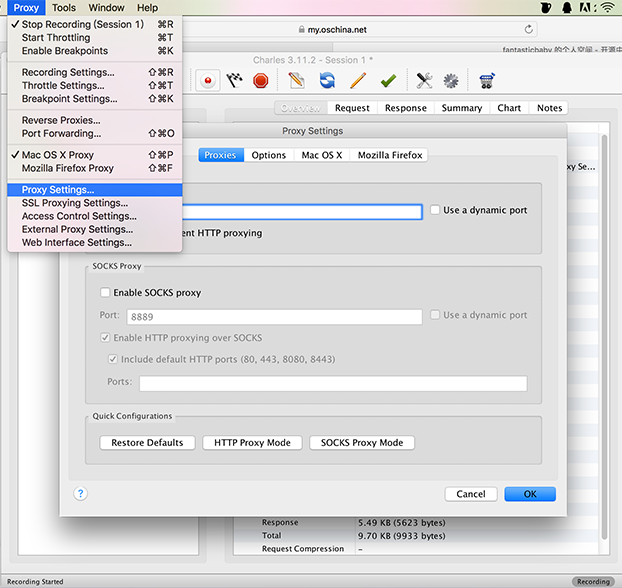
内容清单 Charles 的简介 安装 Charles Charles 初始化设置 过滤网络请求 截取HTTP/HTTPS数据 模拟弱网环境 修改网络请求 修改服务器返回内容 服务器压力测试 反向代理 解决与翻墙软件的冲突 Charles 的简介 Charles 是目前最主流的网络调试工具(Charles、Fiddler、Wireshark...)之一,对于一个开发者来说与网络打交道是日常需求,因此很多时候我们需要调试参数、返回的数据结构、查看网络请求的各种头信息、协议、响应时间等等。所以了解 Charles 并使用它 Charles 通过将自己设置为系统的网络访问代理服务器,这样所有的网络请求都会通过它,从而实现了网路请求的截获和分析。 Chareles 不仅可以分析电脑本机的网络请求(HTTP 和 HTTPS),还可以分析移动端设备的网络请求。 Charles 是收费软件,作者开发出这样一个方便开发者使用的伟大工具,我们鼓励使用正版软件,但是对于一些囊中羞涩或者学生来说,有破解版的更好,别担心,这些我都准备好了,下一个 section 会讲解如何下载安装。 安装 Charles 方式1: Charles 官网地址,根据你的电脑操作系统选择合适的下载方式。此时下载下来的是需要收费的,不差钱的同学当然可以直接购买。购买链接 方式2:按照方式1的方式去官网下载,然后下载相应 JAR包。这里以 MAC 为例,打 Finder,选择应用程序,选中 Charles,右击并选择“显示包内容”,看到 Contents 目录,点击进去选择 Java 文件夹,将下载下来的 JAR包 拖进去替换。至此,完成了 Charles 的破解。 Charles 初始化设置 Charles 的工作原理是将自身设置为系统的代理服务器来捕获所有的网络请求。所以使用 Charles ,我们必须设置 Charles 为系统的代理服务器。 打开 Charles,当第一次启动的时候如果没有购买或者没有破解,会有倒计时,之后会看到软件的主界面,然后会请求你赋予它为系统代理的权限。点击授权会让你输入当前系统用户的密码。当然你也可以忽略或者拒绝该请求,然后等想要抓包的时候将它设置为系统的代理服务器。步骤:**选择菜单中的“Proxy” -> "Mac OS X Proxy"。**如下图: 之后你的电脑上的任何网络请求都可以在 Charles 的请求面板中看到 看看 Charles 的主界面 图上红色圈1:这里代表所有网络请求的展示方式。分别名为 “Structure” 和 “Sequence”。 Structure 将所有的网络请求按照域名划分并展示 Sequence 将所有的网络请求按照时间排序并展示 图上红色圈2:一些的网络请求设置比如 HTTPS 以及端口等信息都在这个菜单栏设置 图上红色圈3:证书设置都在这里进行 过滤网络请求 由于 Charles 可以将电脑或者设置过的手机的所有网络请求捕获到,而且我们分析网络传输应该是针对某个特定的网络下的抓包分析,为了清楚明显地看到我们感兴趣的网络请求通常会用到 Charles 的**“过滤网络请求的功能”**。 方法1:在 Charles 主面板的左侧所有网络请求的下方可以看到看到一个 ”Filter“ 输入栏,在这里你可以输入关键词来筛选出自己感兴趣的网络请求。比如我想分析的网络请求来自于”www.baidu.com" 下,你可以在下面输入"baidu"即可。 方法2:在 Charles 菜单栏的顶部会看到 “Proxy” 的选项,点击菜单栏选择 “Proxy” -> "Recording Settings" 。选择 “include”。看到面板上面有一个 “Add” 按钮,点击后在弹出的面板里面设置好我们需要分析的网络请求的协议、主机名、端口、路径、参数,当然你也可以只设置一些主要的信息,比如协议和主机名的组合。 方法3:一般打开 Charles 并设置好配置信息后(比如电脑本机或者设置过代理的手机)所有的网络请求都将在 Charles 的面板上显示,同时我们感兴趣的网络请求如果也在面板上显示的话,“Structure”模式下可以选中需要分析的网络请求,鼠标右击选择**“Focus”。“Sequence”模式下可以在面板的网络请求显示面板的右下角看到一个Focus**按钮,点击勾选后 Charles 只会显示你感兴趣的网络请求。 截取HTTP/HTTPS数据 截取 HTTP 请求 Charles 的主要目的是抓取捕获网络请求,这里以 iPhone 的抓包为例讲解。 Charles 的设置 要截获 iPhone 的网络请求就需要为 Charles 开启代理功能。在菜单栏选择**“Proxy” ->"Proxy Settings"。填写代理的端口号并将“Enable transparent HTTP proxying”**勾选上。 iPhone 上的设置 在电脑“系统偏好设置”中心打开网络查看本机 IP 地址,打开手机“设置”->“无线局域网”,进入当前使用的网络,点击进入当前 WIFI 的详情页(可以看到当前 WIFI 的基本信息,包括子网掩码、端口、IP地址、路由器),在最下角可以看到**“DNS”和“HTTP代理”2个section。我们点击“配置代理”**,设置 HTTP 代理选中“手动”。服务器处填写电脑ip地址,端口写8888。设置好后,我们打开 iPhone 上的任意需要网络请求的应用,就可以看到 Charles 弹出请求的确认菜单,单击"Allow"按钮,即可完成设置。 截取 HTTPS 请求 如果你需要捕获 HTTPS 协议的网络请求,那么则需要安装 Charles 的 CA 证书。步骤如下; 首先需要在 MAC 上安装证书。点击 Charles 顶部的菜单栏,选择 “Help” -> "SSL Proxying" -> "Install Charles Root Certificate"。 在 keychain 处将新安装的证书设置为永久信任 即使安装了 CA 证书,Charles 默认是不捕获 HTTPS 协议的网络请求,所以我们需要对某个主机下的网络请求抓包分析的话,选中该网络请求右击选中 “SSL Proxying Enabled”。这样就可以看到我们感兴趣的HTTPS 网络请求了。 如果你需要捕获移动设备的 HTTPS 网络请求,则需要在移动设备上安装证书并作简单的设置 选择 Charles 顶部菜单栏选择 “Help” ->"Install Charles Root Certificate on a Mobile Device or Remote Browser"。然后就可以看到 Charles 弹出的安装说明了。 在手机设置好 Charles 代理的情况下,在手机浏览器输入 “chls.pro/ssl”。安装提示下载好CA证书。 验证刚刚安装的 CA证书 iPhone 打开设置 -> 通用 -> 关于本机 -> 证书信任设置 -> 开启开关 在 Charles 菜单栏 Proxy -> SSL Proxying Setting -> 点击 Add 按钮 -> 在弹出的对对话框设置需要监听的 HTTPS 域(*:代表通配符) 设置完毕,尽情抓取你想要的 HTTPS 网络请求吧。 模拟弱网环境 在平时开发的时候我们经常需要模拟弱网环境,并作弱网环境下的适配工作。Charles 为我们提供了这个服务。 在 Charles 菜单栏选择 “Proxy” -> "Throttle Settings"。在弹出的面板上设置网络请求的参数(上行,下行带宽、利用率、可靠性等等信息)。如下图所示。 如果你想对指定主机进行弱网环境下的测试,可以点击上图的“Add”按钮,在弹出的面板上设置协议、主机、端口来对指定的主机进行弱网设置。 修改网络请求 对于捕获的网络请求,我们经常需要修改网络请求的cookie、Headers、Url等信息。Charles 提供了对网络请求的编辑和重发功能。只需要选中需要修改编辑的网络请求,在对应的右上角看到有一个“钢笔”的按钮,点击后就可以对选中的网络请求进行编辑了,编辑好后可以在右下角看到 Execute 按钮。这样我们编辑后的网络请求就可以被执行了。 修改服务器返回内容 很多时候为了方便调试代码,我们会有这种需求,修改接口返回的数据节点或者内容、甚至是状态码。比如数据为空、数据异常、请求失败、多页数据的情况。 Charles 为我们提供了超实用的功能,“Map(Map Local、Map Remote)功能”、Rewrite功能、Breakpoints功能 ,都可以实现修改服务端返回数据的功能。但是有区别和适用场景: Map 功能适合长期地将某一请求重定向到另一个指定的网络地址或者本地 JSON 文件 Rewrite 功能适合对网络请求进行一些正则替换 Breakpoints 功能适合对网络请求进行一些临时性的修改(类似于我们开发的断点作用) Map 功能 Map 功能分为 Map Local(将某个网络请求重定向到本地 JSON 文件) 和 Map Remote 功能(将网络请求重定向到另一个网络接口)。 在 Charles 菜单栏选择 “Tools” -> "Map Remote" 或 “Map Local” 即可进入相应的功能模块。 Map Remote 功能 适合于切换线上到本地、测试服务到正式服务的场景。比如下图从正式服务切换到测试服务 Map Local 功能 我们需要填写重定向的原地址信息和本地目标文件。我们可以先将某个接口的响应内容保存下来(选择对应的网络请求,右击点击 Save Response )成为 data.json 文件。然后我们编辑里面的 status 、message、data 等信息为我们想要的目标映射文件。 如下所示,我将一个网络请求的内容映射到我本地的一个 JSON 文件。之后这个请求的内容都从网络变为返回我本地的数据了。 Map Local 可能会存在一个小缺陷,其返回的 HTTP Response Header 与正常的网络请求不一样,如果程序设置了校验 Header 信息,此时 Map Local 就会失败,解决办法是同时使用 Rewrite功能将相关的HTTP 头部信息 rewrite 成我们需要的信息 Rewrite 功能 Rewrite 适合对某个网络请求进行正则替换,以达到修改结果的目的。 假如我的 App 的界面上的显示的功能模块及其点击事件是根据接口来完成的,我想实现替换功能模块的名称的目的。步骤:点击顶部菜单栏的**“Tools” -> "Rewrite"**。在弹出的面板上勾选 “Enable Rewrite”。点击左下角的 Add按钮,在右上角的 **Name:**处写好本次配置的名称(如果有多个 Rewrite,为了后期容易区分)。 可以针对特定的网络请求进行 Rewrite。可以点击右上角 Location 面板下面的 Add按钮。在弹出的面板上设置网络请求配置信息。注意此时需要同时设置 Protocol、Port、Host、Path信息(我测试加了 Protocol、Host、Port这3个是无效的) 然后对指定的 Type 和 Action 进行 Rewrite。 Type 主要有 Add Header、Modify Header、Remove Header、Host、Path等等。 Where 可以选择 Request 和 Response。指的是下面的修改是针对 Request 还是 Response 完成设置后点击 Apply 按钮,即可生效。下次继续请求该网络,返回的内容就是我们刚刚设置的内容。比如当前的“政策法规”要变成“哈哈哈,我是假的政策法规”。这时候就可以使用 Rewrite 功能 Breakpoints 功能 Breakpoints 相比于其他几个修改网络请求的特点是只是针对当前的网络请求,Breakpoints 只存在于设置过的当前的网络请求,Charles 关闭后下次打开 Breakpoints 消失了。想要修改网络请求 Breakpoints 步骤最简单,跟我们调试工具里面设置的断点一样方便。 对于我们设置了 Breakpoints 的网络请求, Charles 会在下次继续访问该请求的时候停止掉,就跟 debug 一样。此时我们可以 Edit Request,修改过 Request 之后点击右下角的 Execute 按钮。然后等到服务端返回的时候继续是断点状态,此时可以 Edit Response。步骤: 选中某个网络请求 -> 右击 -> 点击“Breakpoints”。 如下图:对该接口设置了 Breakpoints。请求网络后 Edit Response,点击 execute 后服务端返回的结果就是我们编辑的内容了。 服务器压力测试 我们可以使用 Charles 的 Repeat 功能地对服务器进行并发访问进行压力测试。步骤:**选中某个网络请求 -> 右击 -> Repeat Advanced -> 在弹出的面板里面设置总共的迭代次数(Iterations)、并发数(Concurrency) -> 点击“OK” 。**开始执行可以看到以设置的并发数的规模,进行总共达设置的总共迭代次数的访问。(专业的压力测试工具:Load Runner) 反向代理 Charles 的反向代理功能允许我们将本地指定端口的请求映射到远程的另一个端口上。设置:点击顶部菜单栏 Proxy -> 点击 Reverse Proxies。 如下所示,我将本地的 8080 端口映射到远程的 80 端口上,点击 OK 生效后,当我继续访问本地的 80 端口,实际返回的就是远程 80 端口的提供的内容了。 解决与翻墙软件的冲突 Charles 的工作原理是把自己设置为系统的代理服务器,但是我们开发者经常会利用 VPN 翻墙访问谷歌查找资料(这些翻墙软件的工作原理也是把自己设置成为系统的代理服务器),为了2者和平共处。我们可以在 Charles 的 External Proxy Settings 中将翻墙的代理端口等信息填写。同时我们需要关闭翻墙软件的自动设置,更改为**“手动模式”**。(使其不主动修改系统代理) 总结 Charles 功能强大、界面简洁,读完这篇文章并做出练习,相信你能很快掌握它,“工欲善其事,必先利其器” ,掌握了它,相信可以为你大大提高开发中调试网络的效率。Enjoy yourself 参考链接 唐巧的博客

优秀的个人博客,低调大师

每日一博 | 谈谈数据库架构

无论是构建什么样的应用,大都离不开数据。而在应用的架构设计中,如何设计数据库,使用什么类型的数据库,就是一个架构师必须了解的。所有的数据库的共同点都是以某种方式存储数据,以某种接口来访问存储的数据。我们今天就来看看不同类型的数据库架构和它们的使用场景。 关系型数据库 关系型数据库以数据表Table为核心来存储数据。数据是一行一行的表记录Record。表之间通过关联关系相互关联。 关系模型是表(行,列)组成的二维结构。SQL是关系型数据库的统一查询接口。 关系型数据库的架构设计,主要是要解决存储和事务。存储是要解决数据的查询问题。而事务则包含了四个特性,A(原子性)C(一致性)I(隔离性)D(持久性)。 上图是一个关系型数据库的典型架构。索引的存在是为了提高数据查询的性能。 索引通常是B/B+树。在没有索引的情况下,通过ID来查找一条数据记录的时间复杂度是O(n),也就是说随着数据量的增加,查询的速度随线性增加。这个是用户不能接受的。在建立了索引之后,如上图所示,访问记录需要从树的根节点通过两次跳转,达到记录。也就是说访问的速度取决于树的深度。这样的时间复杂度为O(log n) 。访问速度受数据量的影响非常小。(其实在海量数据的情况下,即使是O(log n)也是个问题) 日志是关系型数据库的另一个核心架构设计概念。因为每一个数据库的操作都会以日志的形式记录。系统可以方便的进行事务的回滚。利用日志。系统可以通过日志回放的方式,构建任何一个时间点的系统状态。 优点: 通过事务处理保持数据的一致性 数据更新的开销很小 可以进行Join等复杂查询 20多年的技术历程,技术成熟 缺点: 数据读写必须经过sql解析,大量数据、高并发下读写性能不足 为保证数据一致性,需要加锁,影响并发操作 无法适应非结构化的存储 数据库中存储的对象与实际的对象实体有一定的差别 水平扩展困难,很难提供高扩展性和高可用性。 数据库庞大,价格昂贵 比较流行的关系型数据库有Oracle,MySQL,PostgresSQL等等 键值数据库 为了解决关系型数据库的各种限制和问题,各种NoSQL的数据库出现了。键值数据库就是其中一种。 键-值数据库,或键-值存储,是设计用来存储、检索和管理关联数组的数据存储范式,关联数组是现今更常称为“字典”或散列表的一种数据结构。字典包含对对象或记录的一个收集,依次、记录内有多个不同的“域”或称字段,再次、每个字段都包含数据。这些记录使用唯一标识这个记录的“键”来存储和检索,键还用来在数据库中快速的找到数据。 来自wikipedia的定义 键值数据库大大的简化了关系型数据库的表模型。所有的数据存在一个hash中,只包含key和value。 用户可以通过Key来查找记录。而记录的内容可以是任何东西,他们不需要遵守相同的表结构。这样就类似面向对象的封装和多态。 不同于多数的关系数据库,由于不使用占位符或输入参数来表示可选值,键-值数据库经常比同等的关系数据库使用更少的内存。 键值数据库由于其简单的数据模型,而非常适用于水平扩展。我们之前提到了关系型数据库很难提供高并发的大数据量的读取操作。因为关系的存在,数据表的水平分割是非常困难(虽然可以做到)。而键值数据库就很容易经行水平扩展,从而得到非常好的大规模读写的性能。 优点: 容易水平扩展Scalability,提供大数据量的读写性能。 缺点: 由于key-value数据库中没有schema,所以它是不提供数据之间的关系和数据的完备性的,所有的这些东西都落到了应用程序一端,其实也就是开发人员的头上。这无疑加重了开发人员的负担。 易用性,这里的易用性主要是由于SQL的支持。因为大部分程序员都非常数据SQL,但是对于键值数据库,大部分没有SQL的支持,使用起来就不如SQL那么方便。 流行的键值数据库有Redis,DynamoDB,Memcached等。 键值数据库牺牲了复杂性而打来了性能的显著提升。键值数据库由于其简单和高效性,常常被用作系统的缓存。 这里略微提一下DynamoDB,DynamoDB虽然是以Key-Value为核心构建的数据库,但是它也支持了一些扩展。如下图,DynamoDB有Primary Key和Secondary Key,Primary Key中又包含了Partition Key和Sort Key。用户可以通过设计对应的Key来实现相应的业务查询。 文档数据库 文档数据库是另一种类型的NoSQL数据库,他主要是为了解决关系型数据库的表结构固定,不灵活,不支持非结构化数据的问题而诞生的。 文档型数据库存贮的对象是文档对象,而非表。文档通常用JSON或者BSON来表示,例如如下的文档对象。 [ { "id": 1, "content": "test a" }, { "id": 2, "content": "test b" } ] 相比较关系型数据库,他的主要优点是: 灵活的Schema. 没有固定的schema,插入数据行灵活,对时常变更的应用友好,免去了关系数据库DDL之苦。 相关的数据都是存在一起的,比如一个人曾在多家公司任职这样的信息,可以存在一行里,查询时只访问这一行就行了,但在关系数据库里,这样一对多的关系,往往涉及join。 更加接近于应用端组织数据的方式,开发者用起来更加简单、易学。 大部分的文档数据库也拥有比较好的水平扩展性 Scalability 当然没有免费的午餐,文档型数据库也会有缺点: 跨多个文档的查询比较困难 事务的支持比较差,或者不支持 文档型数据库占用的存贮空间较大 比较流行的文档数据库有MongoDB,Couchbase, DynamoDB (是的,DynamoDB也是一种文档引擎,它支持文档型的内容多为key value的value) 文档型数据库很适合那些表结构经常改变,数据的逻辑结构没又没那么复杂不需要多表查询操作,数据量又比较大的应用场景。 搜索引擎数据库 搜索是大数据场景最常见的需求,就是要找到符合某个搜索条件的数据是否存在,并返回。 基于搜索架构的数据库通常的核心技术是倒排表索引和布隆过滤器。 倒排表索引对于每一个需要搜索的关键词建立一个他所在文档的引用记录。这样就可以快速找到对应的需要搜索的文档。 而布隆过滤器是一种类似Hash的技术,对于每一个文档,生成一个类似bitmap的对象,如果一个关键词在该文档中出现,该关键词的hash对应的bit位就会被置为1。这样当一个新的词如果他的hash中有一位对应的bit位的布隆过滤器的值为0,则可以肯定该关键词没有出现在该文档中。当然,如果所有的hash位都为1,也不能保证该词一定出现在该文档中。利用布隆过滤器,可以快速排除不包含搜索内容的文档,这个也是搜索引擎广泛采用的技术。 搜索型数据库的优点: 搜索是大数据最常见的场景,对于海量数据的搜索,基于搜索引擎的数据库提供了非常好的功能支持。 缺点: 由于需要搜索的数据量比较大,基于搜索的数据库往往是比较消耗资源的。 流行的基于搜索的数据库有Elastic Search,Splunk,Solr。 其中Elastic和Solr都是构建在Apache Lucene上的分布式搜索引擎。 搜索引擎数据库常常被用于系统的运维和监控。我们通常会把一些日志信息导入到基于搜索引擎的数据库中来进行分析和监控。 列式/宽列存储数据库 我这里把列存储数据库和宽列数据库放在一起,它们其实是有些差异的。 传统 OLTP 数据库通常采用行式存储。所有的列依次排列构成一行,以行为单位存储,再配合以 B+ 树或 SS-Table 作为索引,就能快速通过主键找到相应的行数据。行式存储对于 OLTP 场景是很自然的:大多数操作都以实体为单位,即大多为增删改查一整行记录,显然把一行数据存在物理上相邻的位置是个很好的选择。 然而,对于 OLAP 场景,一个典型的查询需要遍历整个表,进行分组、排序、聚合等操作,这样一来按行存储的优势就不复存在了。更糟糕的是,分析型 SQL 常常不会用到所有的列,而仅仅对其中某些感兴趣的列做运算,那一行中那些无关的列也不得不参与扫描。 列式存储就是为这样的需求设计的。同一列的数据被一个接一个紧挨着存放在一起,表的每列构成一个长数组。 显然,列式存储对于 OLTP 不友好,一行数据的写入需要同时修改多个列。但对 OLAP 场景有着很大的优势: 当查询语句只涉及部分列时,只需要扫描相关的列 每一列的数据都是相同类型的,彼此间相关性更大,对列数据压缩的效率较高 列式存储是为了分析而优化的,它的优点是分析查询的速度快。但不支持事务,一般对写操作不友好。 面向列存储的数据库有:Google Dremel,Apache Parquet 在关系型数据库中,不能将宽列存储与面向列存储相混淆。这是一个内部概念,用于提高RDBMS针对OLAP工作负载的性能,并存储表中的数据,而不是逐条记录,而是逐列存储。 宽列存储(也称为可扩展记录存储)将数据存储在记录中,并且能够容纳大量动态列。由于列名和记录键不是固定的,并且一条记录可以包含数十亿列,因此宽列存储可以看作是二维键值存储。 宽列存储与文档存储共享Shema-free的特性,但是实现却大不相同。 宽列存储的优点: 高可靠性 高效性 面向列 可伸缩 可在廉价PC Server搭建大规模结构化存储集群 宽列存储的缺点: 由于数据表之间是分离的,不支持join 读的性能明显不如写入的性能 支持的查询比较简单 宽列数据库比较流行的有:Cassandra,HBase, Google bigtable 时序数据库 时间序列DBMS是为处理时间序列数据而优化的数据库管理系统:每个条目都与时间戳关联。 例如,时间序列数据可以由所谓的物联网中的传感器,智能电表或RFID生成,或者可以描述高频股票交易系统的股票报价器。 时间序列DBMS旨在有效地收集,存储和查询具有高交易量的各种时间序列。尽管可以使用其他类别的DBMS(从键值存储到关系系统)来管理时间序列数据,但是特定的挑战通常需要专门的系统。 例如。像“ SELECT SENSOR1_CPU_FREQUENCY / SENSOR2_HEAT”之类的查询会根据每个时间的重叠区域将两个时间序列合并在一起,并输出单个复合时间序列。 时序数据库的特点有一点类似我们之前的OLAP,它们都是写多读少。要按照指定的维度进行读取和聚合。 流行的时序数据库有: InfluxDB, Prometheus, Kdb+ 等等 图数据库 图数据库,也称为面向图的数据库,将图结构中的数据表示为节点和边,即节点之间的关系。它们允许轻松处理该形式的数据,并且可以简单地计算图形的特定属性,例如从一个节点到另一节点所需的步骤数。 图数据库通常不会在所有节点上提供索引,在这种情况下,无法基于属性值直接访问节点。 通常,在图计算中,基本的数据结构表达就是: G=(V, E) V=vertex(节点) E=edge(边) 使用图(或者网)的方式来表达现实世界的关系很直接、自然,易于建模。比如某人喜欢看某电影,就可以建立一条边连接这个人和这部电影,这条边就叫做“喜欢”边,同时这个人还可以有其它边,比如“朋友”边、“同学”边等,同样这个电影也可以有其它边,比如“导演”边、“主演”边等,这样就构建了自然的关系网。 图数据库可以很高效的插入大量数据。图数据库面向的应用领域数据量可能都比较大,比如知识图谱、社交关系、风控关系等,总数据量级别一般在亿或十亿以上,有的甚至达到百亿边。mysql不做分表分库的情况下插入百万数据基本就慢到不行,图数据库基本能胜任亿级以上的数据,比如neo4j、titan(janus)、hugegraph等图数据库,持续插入十亿级的数据基本还能保持在一个较高的速度。 图数据库可以很高效的查询关联数据。传统关系型数据库不擅长做关联查询,特别是多层关联(比如查我的好友的好友有哪些人),因为一般来说都需要做表连接,表连接是一个很昂贵的操作,涉及到大量的IO操作及内存消耗。图数据库对关联查询一般都进行针对性的优化,比如存储模型上、数据结构、查询算法等,防止局部数据的查询引发全部数据的读取。 图数据库提供了针对图检索的查询语言,比如Gremlin、Cypher等图数据库语言。图查询语言大大方便了关联分析业务的持续开发,传统方案在需求变更时往往要修改数据存储模型、修改复杂的查询脚本,图数据库已经把业务表达抽象好了,比如上面的2层好友查询,Gremlin实现为g.V(me).out('friend').out('friend'),如果需要改为2层同学查询,那调整一下把好友换为同学即可g.V(me).out('classmate').out('classmate')。 图数据库提供了专业的分析算法、工具。比如ShortestPath、PageRank、PersonalRank、Louvain等等,不少图数据库还提供了数据批量导入工具,提供了可视化的图显示界面,使得数据的分析结果更加直观展示出来。 流行的图数据库有Neo4J,Dgraph,TigerGraph 除了上述提到的数据库类型,还有其它的一些例如对象数据库,事件数据库,内容数据库等,我这里就不列出了,大家可以在用到的时候其查找相应的内容。 希望上述内容能够帮助架构师在选择架构中的数据存储的时候,有所帮助! 参考 Architecture of a Database System Cassandra笔记 HBase基础知识,面向列的实时分布式数据库 时序数据库特点与对比 reco171 图数据库的应用有哪些优点?

优秀的个人博客,低调大师

每日一博 | 前端 Docker 镜像体积优化

如果 2019 年技术圈有十大流行词,容器化肯定占有一席之地,随着 Docker 的风靡,前端领域应用到 Docker 的场景也越来越多,本文主要来讲述下开源的分布式图数据库 Nebula Graph 是如何将 Docker 应用到可视化界面中,并将 1.3G 的 Docker 镜像优化到 0.3G 的实践经验。 为什么要用 Docker 对于前端日常开发而言,有时也会用到 Docker,结合到Nebula Graph Studio (分布式图数据库 Nebula Graph 的图形界面工具)使用 Docker 主要基于以下考虑: 统一运行环境:我们的工具背后有好几个服务组合在一起,诸如不同技术栈的现有服务,纯前端的静态资源。 用户使用成本低:目前云服务还在开发中,想让用户对服务组合无感,能直接在本地一键启动应用并使用。 快速部署:团队本就提供有 Nebula镜像版本 实践,给了我们前端一些参考和借鉴。 Docker 镜像的构建 既然要使用 Docker 来承载我们的应用,就得将项目进行镜像构建。与所有 build 镜像类似,需要配置一份命名为Dockerfile 的文件,文件是一些步骤的描述,简单来说就是把项目复制到镜像里,并设置好启动方式: # 选择基础镜像 FROM node:10 # 设置工作目录 WORKDIR /nebula-web-console # 把当前项目内容拷贝到镜像中的 /nebula-web-console 目录下 ADD . /nebula-web-console # 在镜像中下载前端依赖 RUN npm install # 执行构建 RUN npm run build EXPOSE 7001 # 镜像启动时执行的部署命令 CMD ["npm", "run", "docker-start"] Docker 镜像体积优化 如果按照上述的配置文件来构建 Docker 镜像,以我们的项目为例,将会生成一个体积约为 1.3GB 的镜像,这个看起来有点吓人,因为即使在网速快的用户电脑光下载镜像也需要等待不少时间,这是不能接受的。 在调研了相应的资料后,了解到可以从以下几个方面缩小 Docker 镜像体积进行优化: 基础镜像源的选择 所谓基础镜像源,就是我们在进行构建步骤时,选择的一个基础环境(如上 node:10),通过查看 Dockerhub 上有关 Node.js 的基础环境镜像时,我们会发现有多个版本,虽然都是 Node.js相关基础镜像,但不同版本,他们除了 Node.js 版本不同外,在内部集成的环境也不一样,例如带有 alpine 的版本,相当于是一个比较精巧的 Linux 系统镜像,在此版本运行的容器中会发现不存在我们常规系统中所附带的工具,比如 bash、curl 等,由此来缩小体积。 根据项目实际需要,当我把基础镜像换为 alpine 版本后,再次进行构建,此时镜像体积已大幅度减小,从 1.3GB 直降为 500+MB,体积优化效果明显,所以当你发现自己构建的镜像体积过大时,可以考虑从更换基础镜像源的方式来着手,看看是否使用了过于臃肿的镜像源。 Multi-stage 构建镜像 所谓 multi-stage 即是 Docker 镜像构建的时候采取的策略,详细可点击链接提供的资料。 Docker 构建规则 简言之就是利用 Docker 构建提供的规则:Dockerfile 的操作都会增加一个所谓镜像的“层”,每一层都会增加镜像体积,通过采用多步骤策略,每一步骤包含具有相同意义的一系列操作(例如构建,部署),步骤与步骤之间通过产物镜像引用的方式,由此来缩减最终构建镜像所需要的层数,具体操作比如: # 设置第一步骤产生的镜像,并命名为builder FROM node:10-alpine as builder WORKDIR /nebula-web-console # 复制当前项目内容至镜像中 ADD . /nebula-web-console # 进行相应的构建 RUN npm install RUN npm run build .... # 进行第二步骤构建 FROM node:10-alpine WORKDIR /nebula-web-console # 复制第一步构建镜像的产物内容至当前镜像,只用到了一层镜像层从而节约了之前构建步骤的镜像层数 COPY --from=builder . /nebula-web-console CMD ["npm", "run", "docker-start"] .dockerignore 类似我们熟悉的 .gitignore,就是当我们在进行 COPY 或 ADD 文件复制操作时,将不必要的文件忽略掉(诸如文档文件、git文件、node_modules以及一些非生成必要文件等),从而减小镜像体积,更详细内容可参考文档连接:.dockerignore。 操作合并 基于上述提到在 Dockerfile 构建镜像的过程做,每一个操作都会在前一步镜像基础上增加一“层”,可以利用 & 来合并多个操作,减少层数,比如: # 以下两个操作分别代表两层 RUN npm install RUN npm run build 改为: # 使用 & 后变了为一层 RUN npm install && npm run build 由此我们减少了层数的增加,即减少了镜像的体积。同时,在构建镜像的过程中,我们也可以通过在达到相同目的的前提下,尽量减少不必要的操作来减少“层数”的添加。 前端常规性体积优化 压缩丑化代码,移除源码 此操作可以放在构建步骤阶段,这样会进一步缩小镜像的文件体积。 node_modules 只下载生产环境需要的代码 此操作可以放在部署阶段,只下载生产环境所需要的第三方依赖代码: npm install --production 。 公共资源放在CDN 如果镜像被期待运行在联网环境,可以考虑将一些体积相比较大的公共文件(图片、第三方库等)放在CDN服务 器上,将部分资源剥离出去,也会进一步缩小体积。 ... 以上只作为一个线索参考,更多前端常规的优化步骤,都可以迁移至镜像中进行,毕竟和我们本地开发一样,镜像构建也是一个运行代码的环境嘛。 小结 以上便是我在此次使用 Docker 镜像来运行我们 Nebula Studio 所用到的一些优化镜像体积的方法,希望能给需要的人一些帮助和参考,可能还有一些认识不准确的地方,欢迎指出,同样欢迎你来试用 Nebula Graph Studio:https://github.com/vesoft-inc/nebula-web-docker

优秀的个人博客,低调大师

每日一博 | 聊聊计算和存储分离

1.背景 这篇文章是我一直想写的一篇,因为“计算和存储分离”最近几年在大家的视野中出现得越来越多,但其实很多对于其到底代表着什么也是模糊不清,这里我查阅了很多的资料再结合平时自己的理解,聊聊到底什么是“计算和存储分离” 2.何为计算?何为存储? 要了解计算和存储分离到底是什么,那么我们就需要理解什么是计算,什么是存储。 计算这个单词有运算之义,和数学的关系密不可分。大家回想一下以前数学考试的时候,那一道道的数学题怎么得出结果的,这一过程其实称之为计算。那我们这里谈论的其实是计算机计算,所以我们可以得出通过计算机得到问题的结果这个就叫做计算机计算,也就是我们这里所谈论的"计算"。 对于存储来说,这个概念比较难以定义,很多人都简单的认为这个是硬盘,U盘等。但其实在我们的计算机计算过程中和存储是密不可分的,我们知道CPU是由控制器、运算器和寄存器组成的,我们在运行一段程序的时候我们的指令是存储在我们的存储器的,我们所执行的每一个步骤都和存储分离不开。比如我们以前考试的时候选择题,大家关心的只是你选择是否正确,不会关心你的运算过程,你的运算结果可以看做是硬盘,需要持久化给评卷人看,而你的计算过程类似草稿纸,虽然不需要给评卷人看,但是一样的是实实在在的写在了纸上。 上面我们说了在计算机中计算和存储其实是分离不开的,我们想想如果将计算和存储分离开来,通过高速网络进行交互,那么我们的CPU的每一条指令都需要通过网络传输,而我们的网络传输和我们当前的CPU速度完全不匹配,所以我们的计算和存储分离其实是一个伪需求,当然在未来的某一天如果我们的网络传输的时间可以忽略不计,计算和存储分离也就能真正的实现了。 计算和存储分离既然是一个伪需求,那为什么这么多人还在提及呢?那就需要重新再定义一下他们的含义,我们将计算过程中的存储归纳为计算,只关注问题和结果,这就是我们新的“存储”的定义,就类似我们考试的时候草稿纸不需要存放,可以任意撕毁一样。 那这里我们来做一个最终的定义,我们后面所讲的“存储”都是需要持久化的,可以是U盘,硬盘,网盘等等,我们所讲的“计算”其实就是我们的计算过程所需要的CPU和内存等。 3.为何需要计算和存储分离 计算和存储分离并不是现在才出现的一个新名词,在20年前就有NAS-网络附加存储这个东西,本质上也就是使用TCP/IP协议的以太网文件服务器。当时如果想要大规模的存储,就会让服务器将数据保存到NAS这个上面,但是NAS价格及其昂贵,并且扩展比较困难,NAS也就不适用于高速发展的互联网应用。 这个时候谷歌摒弃了之前的观念“移动存储到计算”,采取了“移动计算到存储的观念”,将计算和存储耦合了,因为当时的网络速度对比现在来说慢了几百倍,网络速度跟不上我们的需要。在在典型的MapReduce部署中计算和存储都在同一个集群中进行,比如后续的hadoop。这里其实也就是用本地IO速度来替换网络传输速度。 随着技术的进步,我们的网络速度也越来越快,我们的瓶颈不再是网络速度,但是我们的磁盘I/O速度却没有明显的速度增长,计算和存储融合的架构缺点也再逐渐暴露: 机器的浪费:业务是计算先达到瓶颈的,还是存储先达到瓶颈的。这两种情况往往是不一样的,往往时间点也是不一样的。在架构里就存在一定的浪费。如果说计算不够,也是加一台机器;存储不够,还是加一台机器。所以这里就会存在很多浪费。 机器配比需要频繁更新:一般来说在一个公司内机器的配型比较固定比如提供好几种多少核,多少内存,多少存储空间等等。但是由于业务在不断的发展,那么我们的机器配型也需要不断的更新。 扩展不容易:如果我们存储不够了通常需要扩展,计算和存储耦合的模式下如果扩展就需要存在迁移大量数据。 由于计算和存储耦合的缺点越来越多,并且网络速度越来越快,现在架构又在重新向计算和存储分离这一方向重新开始发展。 4.谁在使用计算和存储分离 上面我们讲了很多理论相关的知识,相信大家已经对“计算和存储分离”已经有一定的认识了,那么其到底在哪些地方做了使用呢?其影响比较大的有两块,一个是数据库,另外一个是消息队列,接下来我会具体讲下这两块到底是怎么利用“计算和存储分离”的。 4.1 数据库 一谈到数据库我们不得不想到MySql,这个应该也是大家最熟悉的数据库,下面是Mysql的一个主从架构图: 可以看见我们的master接收数据的变更,我们的从数据库读取binlog信息,重放binlog从而达到数据复制。 在Mysql的主从架构中有很多问题: 主库的写入压力比较大的时候,主从复制的延迟会变得比较高,由于我们其复制的是binlog,他会走完所有的事务。 增加从节点速度慢,由于我们需要将数据全量的复制到从节点,如果主节点此时存量的数据已经很多,那么扩展一个从节点速度就会很慢高。 对于数据量比较大的数据库,备份的速度很慢。 成本变高,如果我们的数据库的容量比较大,那么我们相应的所有从节点的容量都需要和猪数据库一样大,我们的成本将会随着我们所需要从数据库的数量进行线性增加。 这一切的问题好像都在指引着我们走向计算和存储分离的道路,让所有的节点都共享一个存储。在2014年,在AWS大会上,AWS就宣布推出Aurora。这是一个面向亚马逊关系数据库服务(RDS)的兼容MySQL的数据库引擎,Aurora完美契合了企业级数据库系统对高可用性、性能和扩展性、云服务托管的需求。目前的Aurora可跨3个可用区的6-路复制、30秒内便可完成故障转移、同时具备快速的crash recovery能力。在性能方面,Aurora现在比RDS MySQL5.6和5.7版本快5倍。 Aurora将MySQL存储层变为为独立的存储节点,在Aurora中认为日志即数据,将日志彻底从Mysql计算节点中抽离出来,都由存储节点进行保存,并且也取消了undolog用于减小计算存储之间的交互和传输数据带宽。 同样的在阿里的团队中,也借鉴了Aurora的思想,并在其上面做了很多优化,由于Aurora对于Mysql-Innodb的存储引擎修改较大,后续的Mysql的更新,必然成本很大,所以阿里的团队在保有了原有的MySQL IO路径的基础之上推出了PolarDB。其设计架构图如下: 这里我们需要关注下面几个东西: libfis:这是一个文件系统库,提供了供计算节点访问底层存储的API接口,进行文件读写和元数据更新等操作,有了这个之后计算节点就不需要关心存储的数据到底在哪。 ChunkServer可以认为是一个独立的存储子节点,每个ChunkServer管理着一块SSD硬盘,多个ChunkServer组成Polardb存储节点,对于计算节点来说只需要认为其是一个大的存储节点就好。 PolarSwitch:是部署在计算节点的Daemon,它负责接收libpfs发送而来的文件IO请求,PolarSwitch将其划分为对应的一到多个Chunk,并将请求发往Chunk所属的ChunkServer完成访问。 当然PolarDB还有很多其他的细节,大家有兴趣可以阅读阿里云的官方文档,通过这种共享存储的方式,我们就可以根据自己的业务来进行不同的配置申请,比如我们的对并发要求不高,对数据量要求很大,那么我们就可以申请大量的存储空间,计算资源相对来说就可以较小,如果我们对并发要求很高,尤其是读请求,那么我们就可以申请多台读机器直到满足我们要求为止。 其实不止是这些,现在很多的数据库都在逐渐向“计算和存储分离”靠拢,包括现在的OceanBase ,TiDB等等。所以“计算和存储分离”应该是未来数据库的主要发展方向。 4.2 消息队列 我在之前写过很多关于消息队列的文章,有Kafka的,也有RocketMQ的,不论是Kafka还是RocketMQ其设计思想都是利用本地机器的磁盘来进行保存消息队列,这样其实是由一定的弊端的: 数据有限,使用者两个消息队列的同学应该深有感触,一般会服务器保存最近几天的消息,这样的目的是节约存储空间,但是就会导致我们要追溯一些历史数据的时候就会导致无法查询。 扩展成本高,在数据库中的弊端在这里同样也会展现。 针对这些问题ApachePulsar出现了,pulsar最初由Yahoo开发,在18年的时候一举将kafka连续两年InfoWorld最佳开源数据平台奖夺了过来。 在Pulsar的架构中,数据计算和数据存储是单独的两个结构: 数据计算也就是Broker,其作用和Kafka的Broker类似,用于负载均衡,处理consumer和producer等,如果业务上consumer和producer特别的多,我们可以单独扩展这一层。 数据存储也就是Bookie,pulsar使用了Apache Bookkeeper存储系统,并没有过多的关心存储细节,这一点其实我们也可以借鉴参考,当设计这样的一个系统的时候,计算服务的细节我们需要自己多去思考设计,而存储系统可以使用比较成熟的开源方案。 Pulsar理论上来说存储是无限的,我们的消息可以永久保存,有人会说难道硬盘不要钱吗?当然不是我们依然要钱,在Pulsar可以进行分层存储,我们将旧的消息移到便宜的存储方案中,比如AWS的s3存储,而我们当前最新的消息依然在我们比较贵的SSD上。在这个模式下不仅是存储是无限,我们的计算资源扩展也是无限的,因为我们的计算资源基本上是无状态的,扩展是没有任何成本的,所以Pulsar也搞出了一个多租户的功能,而不用每个团队单独去建立一个集群,之前在美团的确也是这样的,比较重要的BG基本上都有自己的Mafka集群,防止互相影响。 Kafka最新的一些提议,也在向这些方面靠拢,比如也在讨论是否支持分层存储,当然是否采用“计算和存储分离”架构这个也是不一定的,但是我认为“计算和存储分离”的方向也是消息队列未来发展的主要方向。 总结 “计算和存储分离”随着云原生的发展,在各种系统中出现的次数越来越多,希望大家读完这篇文章能对其有个简单的认识。同时如果大家未来在设计系统的时候,这个方案也可以作为选择方案之一进行考虑。 如果大家觉得这篇文章对你有帮助,你的关注和转发是对我最大的支持,O(∩_∩)O:

优秀的个人博客,低调大师

每日一博 | 被“误解”的 Java AIO

为什么说 AIO 受”误解“,虽然这个”误解“被打上了双引号,但还是不得不承认它的发展状况并不好。AIO 是 Java 7 开始提供的新特性,而这个”新特性“到如今都成了陈年老酒还鲜有人去品味它。要知道 Java 7 可是在 2011年7月份发布的,市面上基于 AIO 实现的通信框架竟然寥寥无几,关于这项技术的介绍文章也普遍比较粗略。通过阅读那些介绍 AIO 的文章,似乎从学术层面大家就不怎么待见这项技术。 作为 AIO 的学习者、受益者,我觉得有必要先对网上的一些 ”偏见“ 表达一下自己的观点。如果能有幸在认知上搭成共识,之后的学习交流会更加顺畅一点。通常偏见源于比较,AIO 与 BIO、NIO 的对比明细如表所示。 BIO NIO AIO 客户端 : I/O 线程数 1 : 1 N : 1 N : 0 I/O类型 同步阻塞 同步非阻塞 异步非阻塞 API使用难度 简单 复杂 一般 调试难度 简单 复杂 一般 可靠性 差 高 高 吞吐量 低 高 高 适用场景 适用于连接数量不多,并发量不高的场景。充分发挥易编程的优势。 适用于对连接数量以及稳定性、实时性有较高要求的场景,采用 NIO 或 AIO 能有效缓解网络 I/O 造成的机器负载。 同NIO 误解一 通过上表的比较可以看出 AIO 的性价比应该是优于 NIO 的,而实际情况却是大多数人更偏爱与 NIO,准确的说应该是偏爱 NIO 通信框架:Netty。这本无可厚非,Netty 确实是一款非常优秀的项目,可是很多人错误的解读了 Netty 在 Github 上关于不支持 AIO 的理由,这更加遏制了 AIO 的发展。 Not faster than NIO (epoll) on unix systems (which is true) 这句话表达的本意应该是:NIO 和 AIO 在 unix 系统上使用的都是 epoll 模式,本质都是一样的。但Not faster than NIO在一定程度上会让人误解为 AIO 没 NIO 快。 这里可以采用假设的方式来论证这个观点是不成立的。 假设: epoll 表现的性能为 x=100; 通信框架因为要解决并发调度与资源分配问题,对 epoll 进行封装后会存在一定的性能损耗,以 y 表示。 最终性能表现结果应该是 r=x-y。 论证: 某款 NIO 框架基于 epoll 封装后的性能损耗值:y=5,则它所发挥的最终性能为:x-y=95。 如果有一款 AIO 框架能将性能损耗值控制在:y=(0,5) ,那最终性能便高于 NIO 框架。如 y>5,则性能低于 NIO 框架。 结论: 以底层模型是 kqueue、epoll、select 还是 IOCP 来比较 NIO 和 AIO 的性能是不严谨的,决定权在于框架实现能挖掘出多少基础能力。否则同样采用 NIO 技术,为什么不同的框架还是会有高低之分。 误解二 Linux 系统的 AIO 还不成熟。如果是这个原因的话,不妨先看下:http://lse.sourceforge.net/io/aio.html,其中核心的一句话:Support for kernel AIO has been included in the 2.6 Linux kernel.请注意,Linux 内核自 2.6 版本起已支持AIO模式。 这是个很奇怪的现象,似乎曾经不支持 AIO 就觉得永远不支持,曾经出现的 bug 就永远存在。正如 JAVA NIO 的空轮训 bug ,如今都已经发展到 Java 13 了,依旧还有人坚信这个 bug 一直在。坦白的讲,我没有去验证过 Java AIO 在 Linux 环境下是否是真正意义的 AIO,也没有复现出 NIO 的空轮训 bug。但如果因为某种原因放弃持续学习,那对于事物的认知和见识就只能停留在过去。 所以”Linux 系统的 AIO 还不成熟“也不会成为我抛弃 AIO 的理由。 误解三 需要为每一个连接预先分配读缓存。这个确实是客观存在的情况,AIO 的使用方式是调用读写接口将ByteBuffer对象注册进去,当事件完成后以回调的形式触发CompletionHandler,所以必须要事先分配好缓存空间。 但是有一个细节可能会被大家忽略掉,即便采用 NIO,当遇到半包/粘包的的情况,还是需要有一个缓存对象来暂存这份不完整的数据。尤其在高并发场景下,半包/粘包现象很容易加剧,此时 NIO 需要分配的缓存并不比 AIO 节省多少。 即使假设理想状态下并不存在半包/粘包问题,AIO 通信的预分配形式又能额外消耗多少内存。为每个连接分配 1024 字节的读缓存,在1万个并发连接的条件下也才消耗不到 10MB 内存,试问现实场景下一台 Java 应用服务器需要同时支撑多少个并发,1万?5万?10万?。 目前已知的通信框架通常会配备内存池,在这种前提下 AIO 也只是将内存池中的资源提前利用起来而已。在同等的内存池配置,相同的并发压力下,如果 AIO 暴露出内存方面的问题,我们再来做 AIO 和 NIO 的选择。 总结 本文并不是要将 NIO 和 AIO 对立起来,这两项技术都非常吸引人,喜欢技术的朋友可以在这方面钻研很久。个人推荐纯粹出于学习优先考虑 NIO,因为难度更高,更具挑战性,将要面临和需要解决的问题更多。在学习的过程中如果遇到困惑,可以再去翻一下 AIO 的源码,里面有很多值得借鉴的设计。

优秀的个人博客,低调大师

每日一博 | 图解 Kafka 水印备份机制

高可用是很多分布式系统中必备的特征之一,Kafka 日志的高可用是通过基于 leader-follower 的多副本同步实现的,每个分区下有多个副本,其中只有一个是 leader 副本,提供发送和消费消息,其余都是 follower 副本,不断地发送 fetch 请求给 leader 副本以同步消息,如果 leader 在整个集群运行过程中不发生故障,follower 副本不会起到任何作用,问题就在于任何系统都不能保证其稳定运行,当 leader 副本所在的 broker 崩溃之后,其中一个 follower 副本就会成为该分区下新的 leader 副本,那么问题来了,在选为新的 leader 副本时,会导致消息丢失或者离散吗?Kafka 是如何解决 leader 副本变更时消息不会出错?以及 leader 与 follower 副本之间的数据同步是如何进行的?带着这几个问题,我们接着往下看,一起揭开 Kafka 水印备份的神秘面纱。 水印相关概念 在讲解水印备份之前,我们必须要先搞清楚几个关键的术语以及它们的含义,下面我用一张图来示意 Kafka 分区副本的位移信息: 如上图所示,绿色部分表示已完全备份的消息,对消费者可见,紫色部分表示未完全备份的消息,对消费者不可见。 LEO(last end offset):日志末端位移,记录了该副本对象底层日志文件中下一条消息的位移值,副本写入消息的时候,会自动更新 LEO 值。 HW(high watermark):从名字可以知道,该值叫高水印值,HW 一定不会大于 LEO 值,小于 HW 值的消息被认为是“已提交”或“已备份”的消息,并对消费者可见。 leader 会保存两个类型的 LEO 值,一个是自己的 LEO,另一个是 remote LEO 值,remote LEO 值就是 follower 副本的 LEO 值,意味着 follower 副本的 LEO 值会保存两份,一份保存到 leader 副本中,一份保存到自己这里。 remote LEO 值有什么用呢? 它是决定 HW 值大小的关键,当 HW 要更新时,就会对比 LEO 值(也包括 leader LEO),取最小的那个做最新的 HW 值。 以下介绍 LEO 和 HW 值的更新机制: LEO 更新机制: leader 副本自身的 LEO 值更新:在 Producer 消息发送过来时,即 leader 副本当前最新存储的消息位移位置 +1; follower 副本自身的 LEO 值更新:从 leader 副本中 fetch 到消息并写到本地日志文件时,即 follower 副本当前同步 leader 副本最新的消息位移位置 +1; leader 副本中的 remote LEO 值更新:每次 follower 副本发送 fetch 请求都会包含 follower 当前 LEO 值,leader 拿到该值就会尝试更新 remote LEO 值。 leader HW 更新机制: leader HW 更新分为故障时更新与正常时更新: 故障时更新: 副本被选为 leader 副本时:当某个 follower 副本被选为分区的 leader 副本时,kafka 就会尝试更新 HW 值; 副本被踢出 ISR 时:如果某个副本追不上 leader 副本进度,或者所在 broker 崩溃了,导致被踢出 ISR,leader 也会检查 HW 值是否需要更新,毕竟 HW 值更新只跟处于 ISR 的副本 LEO 有关系。 正常时更新: producer 向 leader 副本写入消息时:在消息写入时会更新 leader LEO 值,因此需要再检查是否需要更新 HW 值; leader 处理 follower FETCH 请求时:follower 的 fetch 请求会携带 LEO 值,leader 会根据这个值更新对应的 remote LEO 值,同时也需要检查是否需要更新 HW 值。 follower HW 更新机制: follower 更新 HW 发生在其更新 LEO 之后,每次 follower Fetch 响应体都会包含 leader 的 HW 值,然后比较当前 LEO 值,取最小的作为新的 HW 值。 图解水印备份过程 在了解了 Kafka 水印备份机制的相关概念之后,下面我用图来帮大家更好地理解 Kafka 的水印备份过程,假设某个分区有两个副本,min.insync.replica=1: Step 1:leader 和 follower 副本处于初始化值,follower 副本发送 fetch 请求,由于 leader 副本没有数据,因此不会进行同步操作; Step 2:生产者发送了消息 m1 到分区 leader 副本,写入该条消息后 leader 更新 LEO = 1; Step 3:follower 发送 fetch 请求,携带当前最新的 offset = 0,leader 处理 fetch 请求时,更新 remote LEO = 0,对比 LEO 值最小为 0,所以 HW = 0,leader 副本响应消息数据及 leader HW = 0 给 follower,follower 写入消息后,更新 LEO 值,同时对比 leader HW 值,取最小的作为新的 HW 值,此时 follower HW = 0,这也意味着,follower HW 是不会超过 leader HW 值的。 Step 4:follower 发送第二轮 fetch 请求,携带当前最新的 offset = 1,leader 处理 fetch 请求时,更新 remote LEO = 1,对比 LEO 值最小为 1,所以 HW = 1,此时 leader 没有新的消息数据,所以直接返回 leader HW = 1 给 follower,follower 对比当前最新的 LEO 值 与 leader HW 值,取最小的作为新的 HW 值,此时 follower HW = 1。 基于水印备份机制的一些缺陷 从以上步骤可看出,leader 中保存的 remote LEO 值的更新总是需要额外一轮 fetch RPC 请求才能完成,这意味着在 leader 切换过程中,会存在数据丢失以及数据不一致的问题,下面我用图来说明存在的问题: 数据丢失 前面也说过,leader 中的 HW 值是在 follower 下一轮 fetch RPC 请求中完成更新的,如上图所示,有副本 A 和 B,其中 B 为 leader 副本,A 为 follower 副本,在 A 进行第二段 fetch 请求,并接收到响应之后,此时 B 已经将 HW 更新为 2,如果这是 A 还没处理完响应就崩溃了,即 follower 没有及时更新 HW 值,A 重启时,会自动将 LEO 值调整到之前的 HW 值,即会进行日志截断,接着会向 B 发送 fetch 请求,但很不幸的是此时 B 也发生宕机了,Kafka 会将 A 选举为新的分区 Leader。当 B 重启后,会从 向 A 发送 fetch 请求,收到 fetch 响应后,拿到 HW 值,并更新本地 HW 值,此时 HW 被调整为 1(之前是 2),这时 B 会做日志截断,因此,offsets = 1 的消息被永久地删除了。 可能你会问,follower 副本为什么要进行日志截断? 这是由于消息会先记录到 leader,follower 再从 leader 中拉取消息进行同步,这就导致 leader LEO 会比 follower 的要大(ollower之间的offset也不尽相同,虽然最终会一致,但过程中会有差异),假设此时出现 leader 切换,有可能选举了一个 LEO 较小的 follower 成为新的 leader,这时该副本的 LEO 就会成为新的标准,这就会导致 follower LEO 值有可能会比 leader LEO 值要大的情况,因此 follower 在进行同步之前,需要从 leader 获取 LastOffset 的值(该值后面会有解释),如果 LastOffset 小于 当前 LEO,则需要进行日志截断,然后再从 leader 拉取数据实现同步。 可能你还会问,日志截断会不会造成数据丢失? 前面也说过,HW 值以上的消息是没有“已提交”或“已备份”的,因此消息也是对消费者不可见,即这些消息不对用户作承诺,也即是说从 HW 值截断日志,并不会导致数据丢失(承诺用户范围内)。 数据不一致/离散 以上情况,需要满足以下其中一个条件才会发生: 宕机之前,B 已不在 ISR 列表中,unclean.leader.election.enable=true,即允许非 ISR 中副本成为 leader; B 消息写入到 pagecache,但尚未 flush 到磁盘。 分区有两个副本,其中 A 为 Leader 副本,B 为 follower 副本,A 已经写入两条消息,且 HW 更新到 2,B 只写了 1条消息,HW 为 1,此时 A 和 B 同时宕机,B 先重启,B 成为了 leader 副本,这时生产者发送了一条消息,保存到 B 中,由于此时分区只有 B,B 在写入消息时把 HW 更新到 2,就在这时候 A 重新启动,发现 leader HW 为 2,跟自己的 HW 一样,因此没有执行日志截断,这就造成了 A 的 offset=1 的日志与 B 的 offset=1 的日志不一样的现象。 leader epoch 为了解决 HW 更新时机是异步延迟的,而 HW 又是决定日志是否备份成功的标志,从而造成数据丢失和数据不一致的现象,Kafka 引入了 leader epoch 机制,在每个副本日志目录下都创建一个 leader-epoch-checkpoint 文件,用于保存 leader 的 epoch 信息,如下,leader epoch 长这样: 它的格式为 (epoch offset),epoch指的是 leader 版本,它是一个单调递增的一个正整数值,每次 leader 变更,epoch 版本都会 +1,offset 是每一代 leader 写入的第一条消息的位移值,比如: (0, 0) (1, 300) 以上第二个版本是从位移300开始写入消息,意味着第一个版本写入了 0-299 的消息。 leader epoch 具体的工作机制如下: 1)当副本成为 leader 时: 这时,如果此时生产者有新消息发送过来,会首先新的 leader epoch 以及 LEO 添加到 leader-epoch-checkpoint 文件中。 2)当副本变成 follower 时: 发送 LeaderEpochRequest 请求给 leader 副本,该请求包括了 follower 中最新的 epoch 版本; leader 返回给 follower 的相应中包含了一个 LastOffset,如果 follower last epoch = leader last epoch,则 LastOffset = leader LEO,否则取大于 follower last epoch 中最小的 leader epoch 的 start offset 值,举个例子:假设 follower last epoch = 1,此时 leader 有 (1, 20) (2, 80) (3, 120),则 LastOffset = 80; follower 拿到 LastOffset 之后,会对比当前 LEO 值是否大于 LastOffset,如果当前 LEO 大于 LastOffset,则从 LastOffset 截断日志; follower 开始发送 fetch 请求给 leader 保持消息同步。 基于 leader epoch 的工作机制,我们接下来看看它是如何解决水印备份缺陷的: (1)解决数据丢失: 如上图所示,A 重启之后,发送 LeaderEpochRequest 请求给 B,由于 B 还没追加消息,此时 epoch = request epoch = 0,因此返回 LastOffset = leader LEO = 2 给 A,A 拿到 LastOffset 之后,发现等于当前 LEO 值,故不用进行日志截断。就在这时 B 宕机了,A 成为 leader,在 B 启动回来后,会重复 A 的动作,同样不需要进行日志截断,数据没有丢失。 (2)解决数据不一致/离散 如上图所示,A 和 B 同时宕机后,B 先重启回来成为分区 leader,这时候生产者发送了一条消息过来,leader epoch 更新到 1,此时 A 启动回来后,发送 LeaderEpochRequest(follower epoch = 0) 给 B,B 判断 follower epoch 不等于 最新的 epoch,于是找到大于 follower epoch 最小的 epoch = 1,即 LastOffset = epoch start offset = 1,A 拿到 LastOffset 后,判断小于当前 LEO 值,于是从 LastOffset 位置进行日志截断,接着开始发送 fetch 请求给 B 开始同步消息,避免了消息不一致/离散的问题。 更多精彩文章请关注作者维护的公众号「后端进阶」,这是一个专注后端相关技术的公众号。 关注公众号并回复「后端」免费领取后端相关电子书籍。 欢迎分享,转载请保留出处。

优秀的个人博客,低调大师

每日一博 | Akka Typed 系列:协议&行为

引言 2019年11月6号LightBend公司发布了AKKA 2.6版本,带来了类型安全的actor,新的Akka Cluster底层通信设施——Artery,带来了更好的稳定性,使用Jackson进行消息序列化,支持SLF4J日志接口。Akka Typed与之前的经典actor编程模式有较大的不同,本文翻译自Manuel Bernhardt——Akka技术推广大使,在2019年7月发布的系列文章:Tour of Akka Typed: Protocols and Behaviors,文中的示例代码原是scala,考虑到scala普及程度不高,译文全部转成java代码。 本系列课程我们一起来探索Akka Typed,新的Akka Actor API显著优于经典的Actor API。其实Akka Typed早在4月份就已经可以用于生产环境了,但是API还是被标记为可能会改变,随着2.6正式版发布日期的临近,抢先看一下带来了哪些新的变化。 如果你对之前的Akka不熟悉,不用担心,保证你能看懂;如果你对Akka很熟悉,也不要飘飘然,本课程可以帮助你在实际工作中更好的掌握Akka Typed。 为什么使用Akka Typed actor编程模型是一个强有力的抽象模型,尤其擅长解决真实世界建模,容错、并发、分布式系统问题。actor抽象编程模型构建于在互相独立的actor之间发送消息的基础之上,actor可以创建子actor,并负责监管,当子actor出现错误的时候可以重启或者重新创建,这套容错机制给整个actor系统带来了自愈能力。 经典的Akka actor API非常简单,就是一组接受并处理消息的函数 package puffin; import akka.actor.AbstractActor; import akka.actor.ActorRef; // 继承AbstractActor即可使用Actor API public class OrderProcessor extends AbstractActor { @Override public Receive createReceive() { return createReceive().onMessage(OrderProcessor.ProcessOrder.class, order -> { ActorRef connection = context().actorOf(BankConnection.props(order.bankIdentifier)); connection.tell(BankConnection.ExecuteOrder(order)); }).build(); } } 这种编程模型和API在多线程环境中具有显著的优势,每个actor顺序处理接收到的消息,actor的内部状态也只有它本身可以修改,这比并发的修改共享状态容易多了。 天下没有免费的午餐,actor编程模型也有它的缺点,槽点在这篇文章中有提到:Akka anti-patterns series 这些年来我在一些稍微大一些的Akka工程中见到的最大的问题是actor系统随着业务越做越大,并且非常难以扩展。根本原因是这套Akka API没有强制用户采用“协议优先”的规范。实际上Akka官方教程里最先讲述的就是清晰的定义组件之间的通信协议(也就是消息),并使用全路径访问消息。已上面的例子来说,OrderProcessor的通信协议定义如下: // scala中的message定义多使用伴生对象 // java中通常使用static类来定义message // 集群环境中messages需要支持序列化,如采用protobuf定义 public interface Command{} class ProcessOrder implements Command { BankId bank; AccountId fromAccount; AccountId toAccount; Amount amount; } 即便你遵照Akka最佳实践,但还是无法保证给actor发送一些它不支持消息,actor的receive方法会接受任意类型的消息,当它收到不支持的消息时,便自动转给unhandled方法,此方法默认只会打日志记录一下(需要正确的配置日志打印机制),这对新人来说太坑了,你找不到任何错误,但是系统就是无法正常工作。 更深层次的原因在于缺少一种机制来帮助我们维护actor之间的通信协议。随着消息类型增多,很容易忘记这些actor都支持什么类型的消息。通过单元测试和严格的日志级别会有助于缓解这种问题(只要接受到不支持的消息就打warn日志),但是仍然无法完全避免。 Akka Typed就是为了解决这个问题,新的API是为“协议优先”设计的,在实现功能之前,你必须花一点时间想一想每一个actor要处理哪些消息。经典的Actor API的最佳实践也是如此,但却是可选的,你需要在实现的过程中使要处理消息条理清晰。 看过许多真实的Akka System分享之后,有一点必须强调一下:开发Akka Typed的目的不仅仅是为了以结构化的方式组织消息以及防止丢失那一点点actor不支持的消息,它的主要目的是引导我们优先考虑系统设计。设计一组恰到好处的actor,适当的通信粒度,正确的消息模式,这样就可以构建一个强大的系统,但是它的核心却非常简单,就像高考一样简单。但是我见到太多过度设计,大家倾向于设计过多的actor以及消息,引入了不必要的复杂度,最后尾大不掉,Martin Thompson曾经这样评价微软的WSL: WSL越做越好,一个双用途的机器呼之欲出。 Loving how Windows Subsystem for Linux (WSL) keeps getting better. A dual purpose machine is almost there. 构建一个处理支付业务的系统 本系列教程以支付系统为例进行讲解,这个领域的业务知识永远不会过时,而且我刚好在这方面有很多经验,Akka也非常适合构建高吞吐,低延迟的交易系统。 我们的支付系统将支持多种支付方式:各种信用卡(Visa、MasterCard)以及Apple Pay、PayPal、支付宝、微信等你能想到的都给它整上。每种支付形式都会有不同的校验逻辑,比如重复支付等问题。 为了支撑多种更多样的支付方式,我们的系统切分为一下几个部分,便于动态添加新的支付方式: API 系统入口,负责认证,接收多种格式的请求,转发给对应的输出组件。本教程会采用非常简单的实现。 Payment Handler 系统核心,根据请求参数从配置组件获取具体的处理器,并控制整个支付流程,如验证、执行等。 Configuration 存储API用户和可用的支付方式关系(契约) Payment processors 它们负责处理具体的支付逻辑,真实系统中会包含很多支付方式,在这里我们以简单的信用卡支付为例,它通常会需要调用其它组件或者第三方系统才能完成支付逻辑,但为了简单起见,我们不考虑这些外部依赖。 真实的系统中可能会有更多的关注点,比如支付方法的注册逻辑,但是就学习Akka Typed而言,上面列举的业务知识已经足够了。 Akka Typed 定义协议 前面我们已经讲过使用Akka Typed可以非常容易的定义协议,但什么是“协议”呢?协议仅仅是“消息”吗?简单来说协议就是:定义一组消息,在两个及以上的组件之间按特定的顺序和组合传递。常见的协议有TCP、HTTPS等,而我们定义的是应用层的协议。你可以认为协议就是增强版的API:API只定义了个体之间的调用格式(参数、请求内容、响应内容等),协议描述了怎么通过组件之间的相互调用使系统到达期望的状态。 在Akka Typed API中,协议由一组消息class和对应类型的actor组成。下面的例子展示了从configuration组件获取配置数据的协议: import akka.actor.typed.ActorRef; public interface ConfigurationMessage { class RetrieveConfiguration implements ConfigurationMessage { public MerchantId merchantId; public ActorRef<ConfigurationResponse> replyTo; public RetrieveConfiguration(MerchantId merchantId, ActorRef<ConfigurationResponse> replyTo) { this.merchantId = merchantId; this.replyTo = replyTo; } } } public interface ConfigurationResponse { class ConfigurationFound implements ConfigurationResponse { public MerchantId merchantId; public MerchantConfiguration merchantConfiguration; public ConfigurationFound(MerchantId merchantId, MerchantConfiguration merchantConfiguration) { this.merchantId = merchantId; this.merchantConfiguration = merchantConfiguration; } } class ConfigurationNotFound implements ConfigurationResponse { public MerchantId merchantId; public ConfigurationNotFound(MerchantId merchantId) { this.merchantId = merchantId; } } } public class MerchantId { public String id; public MerchantId(String id) { this.id = id; } } public class BankIdentifier { public String id; public BankIdentifier(String id) { this.id = id; } } public class MerchantConfiguration { public BankIdentifier bankIdentifier; public MerchantConfiguration(BankIdentifier bankIdentifier) { this.bankIdentifier = bankIdentifier; } } 这个例子遵循了请求-响应的消息设计模式,欲知更多详情,请参见本书:Reactive Design Patterns 如果你以前用过经典的Actor API,你会发现这里的实现方式有两个不同的地方,第一个是消息发送者的引用包含在消息的定义中,经典的Actor API是通过Akka提供的sender()方法来获取发送者的。第二个是消息class中包含的ActorRef是有类型的,发送者使用它的时候就可以清楚的知道应该发送什么类型的消息。我们使用接口ConfigurationResponse定义了配置数据的返回格式,它有两个实现类,这样发送者就可以发送两种格式的消息。 看了Actor的定义之后,就能理解为什么Akka Typed比经典的Actor更容易且更安全的解决协议问题,Configuration的定义如下: import akka.actor.typed.javadsl.AbstractBehavior; import akka.actor.typed.javadsl.ActorContext; public class Configuration extends AbstractBehavior<ConfigurationMessage> { private Configuration(ActorContext<ConfigurationMessage> context) { super(context); } // ... } 我们定义的actor继承AbstractBehavior,并带有指定的类型,它只能处理ConfigurationMessage类型的消息,编译器可以帮助我们检查消息的发送者发送的消息是否正确。 上面的例子中我们使用面向对象的编程方式定义了Actor,稍后我们会展示函数式编程风格。 完成第一个强类型的actor Configuration提供查询功能:根据商户Id查询支付方式。我们继续使用面向对象的编程方式,如果使用过经典的Akka API,你对这种使用方式应该非常熟悉。 继承AbstractBehavior就必须实现onMessage方法,它返回一个Behavior: import akka.actor.typed.Behavior; import akka.actor.typed.javadsl.AbstractBehavior; import akka.actor.typed.javadsl.ActorContext; import akka.actor.typed.javadsl.Behaviors; import akka.actor.typed.javadsl.Receive; import java.util.HashMap; import java.util.Map; // AbstractBehavior 是面向对象风格的切入点 public class Configuration extends AbstractBehavior<ConfigurationMessage> { public static Behavior<ConfigurationMessage> create() { return Behaviors.setup(context -> new Configuration(context)); } private Configuration(ActorContext<ConfigurationMessage> context) { super(context); } // 存储商户Id和支付方式的配置信息 private Map<MerchantId, MerchantConfiguration> configurations = new HashMap<>(); @Override public Receive<ConfigurationMessage> createReceive() { // 最后返回下次接受消息对应的行为 // 这里简单的返回当前行为即可 return newReceiveBuilder().onMessage(ConfigurationMessage.RetrieveConfiguration.class, retrieveConfiguration -> { MerchantId id = retrieveConfiguration.merchantId; MerchantConfiguration configuration = configurations.get(id); if (configuration != null) { // 使用异步通知的方式发送配置数据给请求者 retrieveConfiguration.replyTo.tell(new ConfigurationResponse.ConfigurationFound(id, configuration)); } else { retrieveConfiguration.replyTo.tell(new ConfigurationResponse.ConfigurationNotFound(id)); } // 最后返回下次接收消息对应的行为 // 这里简单的返回当前行为即可 return this; }).build(); } } 这个actor与我们在本文开头使用经典的actor API定义的actor非常相似:覆盖onMessage方法,并根据指定的消息类型做出对应的响应。 不同点在于onMessage对应的方法返回的是一个Behavior,一个actor接收到消息之后的行为包含如下3个步骤: 发送一条或多条消息给其他的actor 创建子acotr 返回一个新的行为,准备接收下一个消息 在Akka Typed API中,一个Behavior即代表了处理当前消息的行为,也表明了如何处理下一个消息——通过返回一个新的Behavior。也可以只是返回当前行为(就像上面的例子一样),因为使用面向对象风格的actor继承自AbstractBehavior,它本身就是一个Behavior,所以可以使用return this。 本系列教程后面会讨论更多关于Behavior的用法,使用Akka Typed API定义的actor的一个优点就是非常容易组合和测试。 Typed Akka TestKit可以帮助你轻而易举的对actor进行测试: import akka.actor.testkit.typed.javadsl.TestKitJunitResource; import akka.actor.testkit.typed.javadsl.TestProbe; import akka.actor.typed.ActorRef; import org.junit.ClassRule; import org.junit.Test; import puffin.Configuration; import puffin.ConfigurationMessage; import puffin.ConfigurationResponse; import puffin.MerchantId; import static junit.framework.TestCase.assertEquals; public class ConfigurationTest { @ClassRule public static final TestKitJunitResource testKit = new TestKitJunitResource(); @Test public void test() { // 定义一个测试探针 TestProbe<ConfigurationResponse> testProbe = testKit.createTestProbe(); ActorRef<ConfigurationMessage> configurationActor = testKit.spawn(Configuration.create()); MerchantId unknownMerchantId = new MerchantId("unknown"); // 发送一条测试消息,发送者为测试探针 configurationActor.tell(new ConfigurationMessage.RetrieveConfiguration(unknownMerchantId, testProbe.getRef())); ConfigurationResponse.ConfigurationNotFound response = testProbe.expectMessageClass(ConfigurationResponse.ConfigurationNotFound.class); assertEquals(response.merchantId, unknownMerchantId); } } acotr的监管 Actor System为actor提供运行环境、分配资源、基础设施。在这个系统中,每一个actor都有一个父actor,最顶层的actor叫做根节点(root),使用/代表,它的两个直接子actor是/user和/system,/user用于在用户空间创建子actor,/system属于akka系统内部管理,所以我们创建的所有的actor都从属于/user。 Akka Typed与经典的Actor API有一个非常重要的不同点:/user的处理逻辑。在经典的Akka API中,Akka提供的/useractor负责监管一切;但是Akka Typed把这个权力交给了用户。也就是说应用程序的开发者在实现actor的时候同时也必须多考虑一下actor都会有哪些行为。 在创建Configuration actor的时候,我们大可以直接把它传给ActorSystem并把它作为监管者,但当创建更多actor的时候,这些actor全部都由Configuration actor监管就不合适了。而且在actor模型中父监管机制采用级联的方式处理actor失败的问题:父actor负责决定如何处理子actor(当它抛异常的时候),因此如何对actor分组直接影响了监管策略。同样的我们应该使用一个专用的父actor做为监管actor,由它来决定如何处理子actor的失败问题。Akka Typed API中默认的监管策略是停止失败的子actor(经典的Akka API是重启)。由我们指定监管actor可以开发更灵活的监管策略,根据不同的异常做出相应的决策。综上所述我们决定使用PaymentProcessor actor做为所有actor的监管者,actor层级如下图所示: PaymentProcessor的功能目前非常简单,启动的时候创建一个子actor——Configuration,它是无状态的,也不接收任何消息,这次我们使用函数式编程的风格,无需继承任何接口,只需要返回一个Behavior: import akka.actor.typed.Behavior; import akka.actor.typed.javadsl.Behaviors; public class PaymentProcessor { public static Behavior<Void> create() { return Behaviors.setup(context -> { context.getLog().info("Typed Payment Processor started"); context.spawn(Configuration.create(), "config"); return Behaviors.empty(); }); } } Behaviors.setup()方法是创建Behavior的入口,该方法包含一个ActorContext变量,我们用它打日志,记录actor已经启动,并使用spawn()方法创建了一个Configuration actor,第一个参数用于创建actor,第二个参数是actor的名字,它在actor路径中是/user/config。 因为PaymentProcessor不处理任何消息,所以这里使用了Behavior<Void>。 Configuration actor使用静态的create函数创建Behavior: public static Behavior<ConfigurationMessage> create() { return Behaviors.setup(context -> new Configuration(context)); } 现在万事俱备,只欠东风,需要启动ActorSystem来创建我们的监管actor。Akka提供了静态方法用来创建监管actor: import akka.actor.typed.ActorSystem; public class Main { public static void main(String[] args) { ActorSystem<Void> actorSystem = ActorSystem.create(PaymentProcessor.create(), "typed-payment-processor"); } } 搞定!现在运行Main方法,就可以看到PaymentProcessor启动了: [2019-11-24 18:24:41,269] [INFO] [puffin.PaymentProcessor] [typed-payment-processor-akka.actor.default-dispatcher-3] [akka://typed-payment-processor/user] - Typed Payment Processor started 欲知后事如何,且听下回分解。 Akka2.6前后比较 每篇文章的最后,我们都会有一个小表格对比经典的Akka API和Akka Typed API的不同之处,借助你对经典Akka API的理解可以更快的掌握Akka Typed API。 经典的Akka API Akka Typed API ActorRef ActorRef<T> extends Actor extends AbstractBehavior<T> (面向对象风格) context.actorOf context.spawn() Akka提供监管actor 用户自定义一个Behavior传给ActorSystem作为监管actor 默认的监管策略:重启失败的actor 默认的监管策略:停止子actor

优秀的个人博客,低调大师

每日一博 | 通俗视频编码技术入门

1、引言 如今我们所处的时代,是移动互联网时代,也可以说是视频时代。从快播到抖音,从“三生三世”到“延禧攻略”,我们的生活,被越来越多的视频元素所影响。 而这一切,离不开视频拍摄技术的不断升级,还有视频制作产业的日益强大。 此外,也离不开通信技术的飞速进步。试想一下,如果还是当年的56K Modem拨号,或者是2G手机,你还能享受到现在动辄1080P甚至4K的视频体验吗? 除了视频拍摄工具和网络通信技术升级之外,我们能享受到视频带来的便利和乐趣,还有一个重要因素,就是视频编码技术的突飞猛进。 视频编码技术涉及的内容太过专业和庞杂,市面上的书籍或博客多数都只是枯燥的技术概念罗列,对于新手来说读完依旧蒙逼是常态,本文将借此机会,专门给大家做一个关于视频编码的零基础科普。 2、图像基础知识 2.1 什么是像素? 说视频之前,先要说说图像。图像,大家都知道,是由很多“带有颜色的点”组成的。这个点,就是“像素点”。 像素点的英文叫Pixel(缩写为PX)。这个单词是由 Picture(图像) 和 Element(元素)这两个单词的字母所组成的。 ▲ 电影《像素大战(Pixels)》,2015年 像素是图像显示的基本单位。我们通常说一幅图片的大小,例如是1920×1080,就是长度为1920个像素点,宽度为1080个像素点。乘积是2,073,600,也就是说,这个图片是两百万像素的。 1920×1080,这个也被称为这幅图片的分辨率。 ▲ 分辨率也是显示器的重要指标 2.2 什么是PPI? 那么,我们经常所说的PPI又是什么东西呢? PPI,就是“Pixels Per Inch”,每英寸像素数。也就是,手机(或显示器)屏幕上每英寸面积,到底能放下多少个“像素点”。这个值当然是越高越好啦!PPI越高,图像就越清晰细腻。 以前的功能机,例如诺基亚,屏幕PPI都很低,有很强烈的颗粒感。 后来,苹果开创了史无前例的“视网膜”(Retina)屏幕,PPI值高达326(每英寸屏幕有326像素),画质清晰,再也没有了颗粒感。 2.3 颜色在计算机里是如何表示的? 像素点必须要有颜色,才能组成缤纷绚丽的图片。那么,这个颜色,又该如何表示呢? 大家都知道,我们生活中的颜色,可以拥有无数种类别。 ▲ 光是妹纸们的口红色号,就足以让我们这些屌丝瞠目结舌。。。 在计算机系统里,我们不可能用文字来表述颜色。不然,就算我们不疯,计算机也会疯掉的。在数字时代,当然是用数字来表述颜色。这就牵出了“彩色分量数字化”的概念。 以前我们美术课学过,任何颜色,都可以通过红色(Red)、绿色(Green)、蓝色(Blue)按照一定比例调制出来。这三种颜色,被称为“三原色”。 在计算机里,R、G、B也被称为“基色分量”。它们的取值,分别从0到255,一共256个等级(256是2的8次方)。所以,任何颜色,都可以用R、G、B三个值的组合表示。 ▲ RGB=(183,67,21) 通过这种方式,一共能表达多少种颜色呢?256×256×256=16,777,216种,因此也简称为1600万色。RGB三色,每色有8bit,这种方式表达出来的颜色,也被称为24位色(占用24bit)。这个颜色范围已经超过了人眼可见的全部色彩,所以又叫真彩色。再高的话,对于我们人眼来说,已经没有意义了,完全识别不出来。 3、视频编码基础知识 3.1 视频和图像和关系 好了,刚才说了图像,现在,我们开始说视频。所谓视频,大家从小就看动画,都知道视频是怎么来的吧?没错,大量的图片连续起来,就是视频。 衡量视频,又是用的什么指标参数呢?最主要的一个,就是帧率(Frame Rate)。在视频中,一个帧(Frame)就是指一幅静止的画面。帧率,就是指视频每秒钟包括的画面数量(FPS,Frame per second)。 帧率越高,视频就越逼真、越流畅。 3.2 未经编码的视频数据量会有多大? 有了视频之后,就涉及到两个问题: 一个是存储; 二个是传输。 而之所以会有视频编码,关键就在于此:一个视频,如果未经编码,它的体积是非常庞大的。 以一个分辨率1920×1280,帧率30的视频为例: 共:1920×1280=2,073,600(Pixels 像素),每个像素点是24bit(前面算过的哦); 也就是:每幅图片2073600×24=49766400 bit,8 bit(位)=1 byte(字节); 所以:49766400bit=6220800byte≈6.22MB。 这是一幅1920×1280图片的原始大小,再乘以帧率30。 也就是说:每秒视频的大小是186.6MB,每分钟大约是11GB,一部90分钟的电影,约是1000GB。。。 吓尿了吧?就算你现在电脑硬盘是4TB的(实际也就3600GB),也放不下几部大姐姐啊!不仅要存储,还要传输,不然视频从哪来呢?如果按照100M的网速(12.5MB/s),下刚才那部电影,需要22个小时。。。再次崩溃。。。 正因为如此,屌丝工程师们就提出了,必须对视频进行编码。 3.3 什么是编码? 编码:就是按指定的方法,将信息从一种形式(格式),转换成另一种形式(格式)。视频编码:就是将一种视频格式,转换成另一种视频格式。 编码的终极目的,说白了,就是为了压缩。各种五花八门的视频编码方式,都是为了让视频变得体积更小,有利于存储和传输。 我们先来看看,视频从录制到播放的整个过程,如下: 首先是视频采集。通常我们会使用摄像机、摄像头进行视频采集。限于篇幅,我就不打算和大家解释CCD成像原理了。 采集了视频数据之后,就要进行模数转换,将模拟信号变成数字信号。其实现在很多都是摄像机(摄像头)直接输出数字信号。信号输出之后,还要进行预处理,将RGB信号变成YUV信号。 前面我们介绍了RGB信号,那什么是YUV信号呢? 简单来说,YUV就是另外一种颜色数字化表示方式。视频通信系统之所以要采用YUV,而不是RGB,主要是因为RGB信号不利于压缩。在YUV这种方式里面,加入了亮度这一概念。在最近十年中,视频工程师发现,眼睛对于亮和暗的分辨要比对颜色的分辨更精细一些,也就是说,人眼对色度的敏感程度要低于对亮度的敏感程度。 所以,工程师认为,在我们的视频存储中,没有必要存储全部颜色信号。我们可以把更多带宽留给黑—白信号(被称作“亮度”),将稍少的带宽留给彩色信号(被称作“色度”)。于是,就有了YUV。 YUV里面的“Y”,就是亮度(Luma),“U”和“V”则是色度(Chroma)。 大家偶尔会见到的Y'CbCr,也称为YUV,是YUV的压缩版本,不同之处在于Y'CbCr用于数字图像领域,YUV用于模拟信号领域,MPEG、DVD、摄像机中常说的YUV其实就是Y'CbCr。 ▲ YUV(Y'CbCr)是如何形成图像的 YUV码流的存储格式其实与其采样的方式密切相关。(采样,就是捕捉数据) 主流的采样方式有三种: 1)YUV4:4:4; 2)YUV4:2:2; 3)YUV4:2:0。 具体解释起来有点繁琐,大家只需记住,通常用的是YUV4:2:0的采样方式,能获得1/2的压缩率。 这些预处理做完之后,就是正式的编码了。 有关视频编码的更多专业知识,可以详细阅读以下文章: 《即时通讯音视频开发(一):视频编解码之理论概述》 《即时通讯音视频开发(二):视频编解码之数字视频介绍》 《即时通讯音视频开发(三):视频编解码之编码基础》 《即时通讯音视频开发(四):视频编解码之预测技术介绍》 《即时通讯音视频开发(五):认识主流视频编码技术H.264》 4、视频编码的实现原理 4.1 视频编码技术的基本原理 前面我们说了,编码就是为了压缩。要实现压缩,就要设计各种算法,将视频数据中的冗余信息去除。当你面对一张图片,或者一段视频的时候,你想一想,如果是你,你会如何进行压缩呢? ▲ 对于新垣女神,我一bit也不舍得压缩… 我觉得,首先你想到的,应该是找规律。是的,寻找像素之间的相关性,还有不同时间的图像帧之间,它们的相关性。 举个例子:如果一幅图(1920×1080分辨率),全是红色的,我有没有必要说2073600次[255,0,0]?我只要说一次[255,0,0],然后再说2073599次“同上”。 如果一段1分钟的视频,有十几秒画面是不动的,或者,有80%的图像面积,整个过程都是不变(不动)的。那么,是不是这块存储开销,就可以节约掉了? ▲ 以上图为例,只有部分元素在动,大部分是不动的 是的,所谓编码算法,就是寻找规律,构建模型。谁能找到更精准的规律,建立更高效的模型,谁就是厉害的算法。 通常来说,视频里面的冗余信息包括: 视频编码技术优先消除的目标,就是空间冗余和时间冗余。 接下来,就和大家介绍一下,究竟是采用什么样的办法,才能干掉它们。以下内容稍微有点高能,不过我相信大家耐心一些还是可以看懂的。 4.2 视频编码技术的实现方法 视频是由不同的帧画面连续播放形成的。 这些帧,主要分为三类,分别是: 1)I帧; 2)B帧; 3)P帧。 I帧:是自带全部信息的独立帧,是最完整的画面(占用的空间最大),无需参考其它图像便可独立进行解码。视频序列中的第一个帧,始终都是I帧。 P帧:“帧间预测编码帧”,需要参考前面的I帧和/或P帧的不同部分,才能进行编码。P帧对前面的P和I参考帧有依赖性。但是,P帧压缩率比较高,占用的空间较小。 ▲ P帧 B帧:“双向预测编码帧”,以前帧后帧作为参考帧。不仅参考前面,还参考后面的帧,所以,它的压缩率最高,可以达到200:1。不过,因为依赖后面的帧,所以不适合实时传输(例如视频会议)。 ▲ B帧 通过对帧的分类处理,可以大幅压缩视频的大小。毕竟,要处理的对象,大幅减少了(从整个图像,变成图像中的一个区域)。 如果从视频码流中抓一个包,也可以看到I帧的信息,如下: 我们来通过一个例子看一下。 这有两个帧: 好像是一样的? 不对,我做个GIF动图,就能看出来,是不一样的: 人在动,背景是没有在动的。 第一帧是I帧,第二帧是P帧。两个帧之间的差值,就是如下: 也就是说,图中的部分像素,进行了移动。移动轨迹如下: 这个,就是运动估计和补偿。 当然了,如果总是按照像素来算,数据量会比较大,所以,一般都是把图像切割为不同的“块(Block)”或“宏块(MacroBlock)”,对它们进行计算。一个宏块一般为16像素×16像素。 ▲ 将图片切割为宏块 好了,我来梳理一下。 对I帧的处理,是采用帧内编码方式,只利用本帧图像内的空间相关性。对P帧的处理,采用帧间编码(前向运动估计),同时利用空间和时间上的相关性。简单来说,采用运动补偿(motion compensation)算法来去掉冗余信息。 需要特别注意,I帧(帧内编码),虽然只有空间相关性,但整个编码过程也不简单。 如上图所示,整个帧内编码,还要经过DCT(离散余弦变换)、量化、编码等多个过程。限于篇幅,加之较为复杂,今天就放弃解释了。 那么,视频经过编码解码之后,如何衡量和评价编解码的效果呢? 一般来说,分为客观评价和主观评价。客观评价,就是拿数字来说话。例如计算“信噪比/峰值信噪比”。 信噪比的计算,我就不介绍了,丢个公式,有空可以自己慢慢研究... 除了客观评价,就是主观评价了。主观评价,就是用人的主观感知直接测量,额,说人话就是——“好不好看我说了算”。 5、视频编码的国际标准 5.1 视频编码格式的标准化 接下来,我们再说说标准(Standard)。任何技术,都有标准。自从有视频编码以来,就诞生过很多的视频编码标准。 提到视频编码标准,先介绍几个制定标准的组织。 首先,就是大名鼎鼎的ITU(国际电信联盟)。 ITU是联合国下属的一个专门机构,其总部在瑞士的日内瓦。 ITU下属有三个部门: 1)分别是ITU-R(前身是国际无线电咨询委员会CCIR); 2)ITU-T(前身是国际电报电话咨询委员会CCITT); 3)ITU-D。 除了ITU之外,另外两个和视频编码关系密切的组织,是ISO/IEC。 ISO大家都知道,就是推出ISO9001质量认证的那个“国际标准化组织”。IEC,是“国际电工委员会”。1988年,ISO和IEC联合成立了一个专家组,负责开发电视图像数据和声音数据的编码、解码和它们的同步等标准。这个专家组,就是大名鼎鼎的MPEG,Moving Picture Expert Group(动态图像专家组)。 三十多年以来,世界上主流的视频编码标准,基本上都是它们提出来的: 1)ITU提出了H.261、H.262、H.263、H.263+、H.263++,这些统称为H.26X系列,主要应用于实时视频通信领域,如会议电视、可视电话等; 2)ISO/IEC提出了MPEG1、MPEG2、MPEG4、MPEG7、MPEG21,统称为MPEG系列。 ITU和ISO/IEC一开始是各自捣鼓,后来,两边成立了一个联合小组,名叫JVT(Joint Video Team,视频联合工作组)。 JVT致力于新一代视频编码标准的制定,后来推出了包括H.264在内的一系列标准。 ▲ 压缩率对比 ▲ 视频编码标准的发展关系 大家特别注意一下上图里面的HEVC,也就是现在风头正盛的H.265。 作为一种新编码标准,相比H.264有极大的性能提升,目前已经成为最新视频编码系统的标配。 最后,我再说说封装。 5.2 视频数据的封装 对于任何一部视频来说,只有图像,没有声音,肯定是不行的。所以,视频编码后,加上音频编码,要一起进行封装。 封装:就是封装格式,简单来说,就是将已经编码压缩好的视频轨和音频轨按照一定的格式放到一个文件中。再通俗点,视频轨相当于饭,而音频轨相当于菜,封装格式就是一个饭盒,用来盛放饭菜的容器。 目前主要的视频容器有如下:MPG、VOB、MP4、3GP、ASF、RMVB、WMV、MOV、Divx、MKV、FLV、TS/PS等。 封装之后的视频,就可以传输了,你也可以通过视频播放器进行解码观看。(本文同步发布于:http://www.52im.net/thread-2840-1-1.html)

优秀的个人博客,低调大师

每日一博 | Spring 事务传播属性详解

Spring事务传播属性有那么难吗?看这一篇就够了 笔者文笔功力尚浅,如有不妥,请慷慨指出,必定感激不尽 学习东西要知行合一,如果只是知道理论而没实践过,那么掌握的也不会特别扎实,估计过几天就会忘记,接下来我们一起实践来学习Spring事务的传播属性。 传播属性 传播属性定义的是当一个事务方法碰到另一个事务方法时的处理行为,一共有七种行为,定义如下 传播性 值 描述 PROPAGATION_REQUIRED 0 支持当前事务,如果没有就新建事务 PROPAGATION_SUPPORTS 1 支持当前事务,如果没有就不以事务的方式运行 PROPAGATION_MANDATORY 2 支持当前事务,如果当前没事务就抛异常 PROPAGATION_REQUIRES_NEW 3 无论当前是否有事务,都会新起一个事务 PROPAGATION_NOT_SUPPORTED 4 不支持事务,如果当前存在事务,就将此事务挂起不以事务方式运行 PROPAGATION_NEVER 5 不支持事务,如果有事务就抛异常 PROPAGATION_NESTED 6 如果当前存在事务,在当前事务中再新起一个事务 其实只看概念的话已经很直截了当了说明了每个传播性的作用,此时我们再用具体的例子演示一下每个传播性属性下的行为。 此次演示我们使用的是H2数据库,这个数据库是作用在内存里面的,所以对于我们演示事务效果来说正好,无需我们在进行其他的配置了,我们新建一个表。将下面语句放在schema.sql文件里面即可,SpringBoot程序在启动的时候就会自动为我们在内存里面建立这样的一个表。 CREATE TABLE FOO (ID INT IDENTITY, BAR VARCHAR(64)); 演示之前我们会定义两个类FooService和BarService。我们使用BarService 里面的方法进行调用FooService 中的方法。 环境准备 在进行事务演示之前,其实可以分为以下几种情况,根据排列组合,我们可以得出以下八种情况 调用者:有无事务 调用者:是否有异常 被调用者:有无事务**(这个是通过传播属性进行控制的)**所以并不在排列组合中 被调用者:是否有异常 调用者是否有事务 调用者是否有异常 被调用者是否有异常 有 有 有 有 有 无 有 无 有 有 无 无 无 有 有 无 有 无 无 无 有 无 无 无 异常类 其中的RollbackException是我们自己定义的一个异常类 @Service public class BarServiceImpl implements BarService{ @Autowired private FooService fooService; // PROPAGATION_REQUIRED演示 无事务 @Override public void testRequiredNoTransactional() throws RollbackException { fooService.testRequiredTransactional(); } } 调用者 在BarService中定义两个方法,一个是带着事务的,一个是不带事务的 // 有事务 @Override @Transactional(rollbackFor = Exception.class) public void hasTransactional() throws RollbackException { } // 无事务 @Override public void noTransactional() throws RollbackException { } 接下来我们就根据俄上面定义的八种情况进行事务传播属性的学习。 PROPAGATION_REQUIRED 在此传播属性下,被调用方是否新建事务取决去调用者是否带着事务。 想要了解这个传播属性的特性,其实我们演示上面八种情况的两个例子就够了 调用者是否有事务 调用者是否有异常 被调用者是否有异常 无 无 有 有 有 无 第一种情况我们在被调用者抛出异常的情况下,如果查询不到插入的数据,那么就说明被调用者在调用者没有事务的情况下自己新建了事务。 第二种情况我们在调用者抛出异常的情况下,如果查询不到插入的数据,那么就说明被调用者在调用者有事务的情况下就加入当前事务了。 我们先来看一下被调用者的类的方法例子。 @Service public class FooServiceImpl implements FooService { @Autowired private JdbcTemplate jdbcTemplate; // REQUIRED传播属性-被调用者有异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.REQUIRED) public void testRequiredHasException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ("+Global.REQUIRED_HAS_EXCEPTION+")"); throw new RollbackException(); } // REQUIRED传播属性-被调用者无异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.REQUIRED) public void testRequiredNoException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ("+Global.REQUIRED_NO_EXCEPTION+")"); } } 接下来我们看一下调用者方法的例子 @Service public class BarServiceImpl implements BarService{ @Autowired private FooService fooService; // 有事务 @Override @Transactional(rollbackFor = Exception.class) public void hasTransactional() throws RollbackException { // 调用者有事务,抛异常 被调用者无异常 fooService.testRequiredNoException(); throw new RollbackException(); } // 无事务 @Override public void noTransactional() throws RollbackException { // 调用者无事务,不抛异常 被调用者有异常 fooService.testRequiredHasException(); } } 此时我们在程序调用时进行查询 String noException = Global.REQUIRED_NO_EXCEPTION; String hasException = Global.REQUIRED_HAS_EXCEPTION; try { barService.noTransactional(); }catch (Exception e){ log.info("第一种情况 {}", jdbcTemplate .queryForObject("SELECT COUNT(*) FROM FOO WHERE BAR='"+hasException+"'", Long.class)); } try { barService.hasTransactional(); }catch (Exception e){ log.info("第二种情况 {}", jdbcTemplate .queryForObject("SELECT COUNT(*) FROM FOO WHERE BAR='"+noException+"'", Long.class)); } 查看打印出来的日志 2019-10-16 13:02:04.142 INFO 11869 --- [ main] c.e.t.t.TransactionApplication : 第一种情况 0 2019-10-16 13:02:04.143 INFO 11869 --- [ main] c.e.t.t.TransactionApplication : 第二种情况 0 我们看到我们都没有查到相应的数据,说明数据都回滚了。此时我们应该就理解了那句话支持当前事务,如果没有就新建事务。 PROPAGATION_SUPPORTS 被调用者是否有事务,完全依赖于调用者,调用者有事务则有事务,调用者没事务则没事务。 接下来我们还是用上面的两个例子进行演示 调用者是否有事务 调用者是否有异常 被调用者是否有异常 无 无 有 有 有 无 第一种情况:被调用者抛出异常的情况下,如果仍能查询到数据,说明事务没有回滚,说明被调用者没有事务 第二种情况:调用者抛出异常情况下,如果查不到数据,说明两个方法在一个事务中 接下来仍然是例子演示 被调用者,只是将@Transactional 注解中的propagation 属性更换为了Propagation.SUPPORTS // SUPPORTS传播属性-被调用者有异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.SUPPORTS) public void testSupportsHasException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.SUPPORTS_HAS_EXCEPTION+"')"); throw new RollbackException(); } // SUPPORTS传播属性-被调用者无异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.SUPPORTS) public void testSupportsNoException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.SUPPORTS_NO_EXCEPTION+"')"); } 调用者和上面的例子调用一样,我们直接查看执行效果 2019-10-16 13:50:27.738 INFO 12174 --- [ main] c.e.t.t.TransactionApplication : 第一种情况 1 2019-10-16 13:50:27.741 INFO 12174 --- [ main] c.e.t.t.TransactionApplication : 第二种情况 0 我们看到了在第一种情况下查到了数据,说明在第一种情况下被调用者是没有事务的。此时我们应该就理解了这句话 支持当前事务,如果没有就不以事务的方式运行。 PROPAGATION_MANDATORY 依然是这两个例子进行演示 调用者是否有事务 调用者是否有异常 被调用者是否有异常 无 无 有 有 有 无 第一种情况:因为调用者没有事务,所以此传播属性下应该是抛异常的 第二种情况:被调用者的事务和调用者事务是同样的 接下来是被调用者的代码例子 // MANDATORY传播属性-被调用者有异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.MANDATORY) public void testMandatoryHasException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.SUPPORTS_HAS_EXCEPTION+"')"); throw new RollbackException(); } // MANDATORY传播属性-被调用者无异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.MANDATORY) public void testMandatoryNoException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.SUPPORTS_NO_EXCEPTION+"')"); } 调用者和上面的例子调用一样,我们直接查看执行效果 2019-10-16 13:58:39.178 ERROR 12317 --- [ main] c.e.t.t.TransactionApplication : org.springframework.transaction.IllegalTransactionStateException: No existing transaction found for transaction marked with propagation 'mandatory' 2019-10-16 13:58:39.276 INFO 12317 --- [ main] c.e.t.t.TransactionApplication : 第一种情况 0 2019-10-16 13:58:39.281 INFO 12317 --- [ main] c.e.t.t.TransactionApplication : 第二种情况 0 我们发现和我们推测一样,说明被调用者是不会自己新建事务的,此时我们应该就理解了这句话支持当前事务,如果当前没事务就抛异常。 PROPAGATION_REQUIRES_NEW 此传播属性下,无论调用者是否有事务,被调用者都会新建一个事务 调用者是否有事务 调用者是否有异常 被调用者是否有异常 无 无 有 有 有 无 第一种情况:调用者无事务,被调用者会新建事务,所以查不到数据 第二种情况:调用者有事务,被调用者会新建一个事务,所以调用者抛异常影响不到被调用者,所以能查到数据 接下来我们演示代码。 被调用者 // REQUIRES_NEW传播属性-被调用者有异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.REQUIRES_NEW) public void testRequiresNewHasException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.REQUIRES_NEW_HAS_EXCEPTION+"')"); throw new RollbackException(); } // REQUIRES_NEW传播属性-被调用者无异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.REQUIRES_NEW) public void testRequiresNewNoException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.REQUIRES_NEW_NO_EXCEPTION+"')"); } 调用者的例子和上面的相同,我们直接来看执行情况 2019-10-16 16:29:20.296 INFO 15553 --- [ main] c.e.t.t.TransactionApplication : 第一种情况 0 2019-10-16 16:29:20.298 INFO 15553 --- [ main] c.e.t.t.TransactionApplication : 第二种情况 1 我们发现和我们的推论是一样的,说明调用者的事务和被调用者的事务完全无关。此时我们应该就理解这句话了无论当前是否有事务,都会新起一个事务。 PROPAGATION_NOT_SUPPORTED 无论调用者是否有事务,被调用者都不以事务的方法运行 同样是这两个例子 调用者是否有事务 调用者是否有异常 被调用者是否有异常 无 无 有 有 有 无 第一种情况:被调用者都不会有事务,那么在抛异常之后就能查到相应的数据 第二种情况:在调用者有事务的情况下,被调用者也会在无事务环境下运行,所以我们依然能查到数据 接下来验证我们的猜测 // NOT_SUPPORTED传播属性-被调用者有异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.NOT_SUPPORTED) public void testNotSupportHasException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.NOT_SUPPORTS_HAS_EXCEPTION+"')"); throw new RollbackException(); } // NOT_SUPPORTED传播属性-被调用者无异常抛出 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.NOT_SUPPORTED) public void testNotSupportNoException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.NOT_SUPPORTS_NO_EXCEPTION+"')"); } 然后查看执行结果 2019-10-16 16:38:35.065 INFO 15739 --- [ main] c.e.t.t.TransactionApplication : 第一种情况 1 2019-10-16 16:38:35.067 INFO 15739 --- [ main] c.e.t.t.TransactionApplication : 第二种情况 1 我们可以看到在最后两种情况都查到了数据,根据演示效果应该可以理解这句话了,不支持事务,如果当前存在事务,就将此事务挂起不以事务方式运行。 PROPAGATION_NEVER 调用者有事务,被调用者就会抛出异常 调用者是否有事务 调用者是否有异常 被调用者是否有异常 无 无 有 有 有 无 这个就不演示,相信大家看到这里应该都会明白在第一种情况下我们是能够查到数据的。在第二种情况下由于调用者带着事务,所以会抛异常。 PROPAGATION_NESTED 此传播属性下,被调用者的事务是调用者的事务的子集。 我们重点说一下NESTED的传播属性的特性 调用者是否有事务 说明 有 被调用者会新起一个事务,此事务和调用者事务是一个嵌套的关系 无 被调用者会自己新起一个事务 关于什么是嵌套事务的关系,我们用下面三个例子能够进行演示。 调用者是否有事务 调用者是否有异常 被调用者是否有异常 无 无 有 有 有 无 有 无 有 第一种情况:如果查不到数据,则说明在调用者无事务情况下,被调用者会新起一个事务 第二种情况:如果查不到数据,说明外层事务能够影响内层事务 第三种情况:如果查到数据,说明内层事务不影响外层事务 接下来我们编写具体的代码 // NESTED传播属性-回滚事务 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.NESTED) public void testNestedHasException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.NESTED_HAS_EXCEPTION+"')"); // TransactionAspectSupport.currentTransactionStatus().setRollbackOnly(); throw new RollbackException(); } // NESTED传播属性-不回滚事务 @Override @Transactional(rollbackFor = Exception.class,propagation = Propagation.NESTED) public void testNestedNoException() throws RollbackException { jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.NESTED_NO_EXCEPTION+"')"); } 然后接下来的调用者也会有点区别 @Override @Transactional() public void hasTransactionalNoException() throws RollbackException { // NESTED传播属性 - 调用者有事务,不抛异常 被调用者有异常 jdbcTemplate.execute("INSERT INTO FOO (BAR) VALUES ('"+Global.NESTED_HAS_EXCEPTION_TWO+"')"); fooService.testNestedHasException(); } 然后执行效果 2019-10-16 18:01:06.387 INFO 17172 --- [ main] c.e.t.t.TransactionApplication : 第一种情况 0 2019-10-16 18:01:06.389 INFO 17172 --- [ main] c.e.t.t.TransactionApplication : 第二种情况 0 2019-10-16 18:01:06.390 INFO 17172 --- [ main] c.e.t.t.TransactionApplication : 第三种情况 1 可以看出来嵌套事务的本质就是外层会影响内层,内层不影响外层。而REQUIRES_NEW则是互不影响。 总结 到现在我们已经全部分析完了七种传播属性,从写这篇文章开始到结束其中也碰到过一些坑,有些是不自己实践一遍是根本不知道的,所以我还是建议读者看完这篇文章以后自己进行实践,演示各种情况,只有这样才能够烂熟于心。 本文代码地址

优秀的个人博客,低调大师

每日一博 | 你知道字节序吗?

最近在调一个自定义报文的接口时,本来以为挺简单的,发现踩了好几个坑,其中一个比较“刻骨铭心”的问题就是数据的字节序问题。 背景 自定义报文,调用接口,服务端报文解析失败 iOS 小端序 查看 iOS 设备使用的端序 if (NSHostByteOrder() == NS_LittleEndian) { NSLog(@"NS_LittleEndian"); } if (NSHostByteOrder() == NS_BigEndian) { NSLog(@"NS_BigEndian"); } else { NSLog(@"Unknown"); } 概念 字节序,字节顺序,又称端序或尾序(Endianness),在计算机科学领域中,指「存储器」中或者「数字通信链路」中,组成多字节的字的字节排列顺序。 在几乎所有的机器上,多字节对象都被存储为连续的字节序列。例如在 C 语言中,一个 int 类型的变量 x 地址为 0x100,那么其对应的地址表达式 &x 的值为 0x100,且 x 的4个字节将被存储在存储器的 0x100,0x101,0x102,0x103 位置。 字节的排列方式有2个通用规则。例如一个多位整数,按照存储地址从低到高排序的字节中,如果该整数的最低有效字节(类似于最低有效位)排在最高有效字节前面,则成为**“小端序“;反之成为”大端序“**。在计算机网络中,字节序是一个必须要考虑的因素,因为不同类型的机器可能采用不同标准的字节序,所以均需要按照网络标准进行转化。 假设一个类型为 int 的变量 x,位于地址 0x100 处,它的值为 0x01234567,地址范围为 0x100~0x103字节,其内部的排列顺序由机器决定,也就是和 CPU 有关,和操作系统无关。 大端序(Big Endian):也叫大尾序。高字节存储在内存的低地址 | 地址增长方向 |内存地址序号|16进制| |:- |:-|:-| |↓ |0x100| 01| |↓ |0x101| 23| |↓ |0x102| 45| |↓|0x103| 67| 小端序(Little Endian):也叫小尾序。低字节存储在内存的低地址 | 地址增长方向 |内存地址序号|16进制| |:- |:-|:-| |↓ |0x100| 67| |↓ |0x101| 45| |↓ |0x102| 23| |↓|0x103| 01| 缘起 “endian”一词来源于十八世紀愛爾蘭作家乔纳森·斯威夫特(Jonathan Swift)的小说《格列佛游记》(Gulliver's Travels)。小说中,小人国为水煮蛋该从大的一端(Big-End)剥开还是小的一端(Little-End)剥开而争论,争论的双方分别被称为“大端派”和“小端派”。以下是1726年关于大小端之争历史的描述: “我下面要告诉你的是,Lilliput和Blefuscu这两大强国在过去36个月里一直在苦战。战争开始是由于以下的原因:我们大家都认为,吃鸡蛋前,原始的方法是打破鸡蛋较大的一端,可是当今皇帝的祖父小时候吃鸡蛋,一次按古法打鸡蛋时碰巧将一个手指弄破了。因此他的父亲,当时的皇帝,就下了一道敕令,命令全体臣民吃鸡蛋时打破鸡蛋较小的一端,违令者重罚。老百姓们对这项命令极其反感。历史告诉我们,由此曾经发生过6次叛乱,其中一个皇帝送了命,另一个丢了王位。这些叛乱大多都是由Blefuscu的国王大臣们煽动起来的。叛乱平息后,流亡的人总是逃到那个帝国去寻求避难。据估计,先后几次有11000人情愿受死也不肯去打破鸡蛋较小的一端。关于这一争端,曾出版过几百本大部著作,不过大端派的书一直是受禁的,法律也规定该派任何人不得做官。” —— 《格列夫游记》 第一卷第4章 蒋剑锋(译) 1980年,丹尼·科恩(Danny Cohen),一位网络协议的早期开发者,在其著名的论文"On Holy Wars and a Plea for Peace"中,为平息一场关于字节该以什么样的顺序传送的争论,而第一次引用了该词。 字节顺序 对于单一的字节(a byte),大部分处理器以相同的顺序处理位元(bit),因此单字节的存放方法和传输方式一般相同。 对于多字节数据,如整数(32位机中一般占4字节),在不同的处理器的存放方式主要有两种:大、小端序。 拓展 以内存中0x0A0B0C0D的存放方式为例,分别有以下几种方式: 注:0x 前缀代表十六进制。 大端序 数据以8bit为单位: 地址增长方向 → ... 0x0A 0x0B 0x0C 0x0D ... 示例中,最高位字节是0x0A 存储在最低的内存地址处。下一个字节0x0B存在后面的地址处。正类似于十六进制字节从左到右的阅读顺序。 数据以16bit为单位: 地址增长方向 → ... 0x0A0B 0x0C0D ... 最高的16bit单元0x0A0B存储在低位。 小端序 数据以8bit为单位: 地址增长方向 → ... 0x0D 0x0C 0x0B 0x0A ... 最低位字节是0x0D 存储在最低的内存地址处。后面字节依次存在后面的地址处。 数据以16bit为单位: 地址增长方向 → ... 0x0C0D 0x0A0B ... 最低的16bit单元0x0C0D存储在低位。 更改地址的增长方向: 当更改地址的增长方向,使之由右至左时,表格更具有可阅读性。 ← 地址增长方向 ... 0x0A 0x0B 0x0C 0x0D ... 最低有效位(LSB)是0x0D 存储在最低的内存地址处。后面字节依次存在后面的地址处。 ← 地址增长方向 ... 0x0A0B 0x0C0D ... 最低的16bit单元0x0C0D存储在低位。 混合序(英:middle-endian)具有更复杂的顺序。以 PDP-11 为例,0x0A0B0C0D 被存储为: 32bit在PDP-11的存储方式 地址增长方向 → ... 0x0B 0x0A 0x0D 0x0C ... 可以看作高16bit和低16bit以大端序存储,但16bit内部以小端存储。 处理器体系 x86、MOS Technology 6502、Z80、VAX、PDP-11等处理器为小端序; Motorola 6800、Motorola 68000、PowerPC 970、System/370、SPARC(除V9外)等处理器为大端序; ARM、PowerPC(除PowerPC 970外)、DEC Alpha、SPARC V9、MIPS、PA-RISC及IA64的字节序是可配置的。 网络字节顺序(NBO) 通常我们认为,在网络传输的字节顺序即为网络字节序为标准顺序,考虑到与协议的一致以及与其他平台产品的互通,在程序发送数据包的时候,将主机字节序转换为网络字节序,收数据包处将网络字节序转换为主机字节序。 NBO(Network Byte Order):按照从高到低的顺序存储,在网络上使用统一的网络字节顺序,可以避免兼容性问题。TCP/IP中规定好的一种数据表示格式,与具体的 CPU 类型、操作系统等无关。从而保证数据在不同主机之间传输时能够被正确解释。网络字节序采用大端序。 主机字节顺序 HBO 主机字节顺序(HBO:Host Byte Order):不同机器 HBO 不相同,与 CPU 有关。计算机存储数据有两种字节优先顺序:Big Endian 和 Little Endian。Internet 以 Big Endian 顺序在网络上传输,所以对于在内部是以 Little Endian 方式存储数据的机器,在网络通信时就需要进行转换。 如何转换 由于 Internet 和 Intel 处理器的字节顺序不同,所以开发者需要使用 Sockets API 提供的标准转换函数。 BSD Socket 提供了转换函数 htons() : unsigned short 从主机序转换到网络序 htonl(): unsigned long 从主机序转换到网络序 ntohs():unsigned short 从网络序转换到主机序 ntohl():unsigned long 从网络序转换到主机序 之前的代码采用端序转换 - (NSData *)handlePayloadData:(NSArray *)rawArray { if (rawArray.count == 0) { return 0; } // 2. 加密压缩处理:(meta 整体先加密再压缩,payload一条条先加密再压缩) __block NSMutableString *metaStrings = [NSMutableString string]; __block NSMutableArray<NSData *> *payloads = [NSMutableArray array]; // 2.1. 遍历拼接model,取出 meta,用 \n 拼接 [rawArray enumerateObjectsUsingBlock:^(id _Nonnull obj, NSUInteger idx, BOOL * _Nonnull stop) { if (PCT_IS_CLASS(obj, PCTLogPayloadModel)) { PCTLogPayloadModel *payloadModel = (PCTLogPayloadModel *)obj; BOOL shouldAppendLineBreakSymbol = idx < (rawArray.count - 1); [metaStrings appendString:[NSString stringWithFormat:@"%@%@", payloadModel.meta, shouldAppendLineBreakSymbol ? @"\n" : @""]]; // 2.2 判断是否需要上传 payload 信息。如果需要则将 payload 取出。(Payload 可能为空) if ([self needUploadPayload:payloadModel]) { if (payloadModel.payload) { NSData *payloadData = [PCTDataSerializer compressAndEncryptWithData:payloadModel.payload]; [payloads addObject:payloadData]; } } } }]; if (metaStrings.length == 0) { return nil; } NSData *metaData = [PCTDataSerializer compressAndEncryptWithString:metaStrings]; __block NSMutableData *headerData = [NSMutableData data]; unsigned short metaLength = (unsigned short)metaData.length; HTONS(metaLength); // 处理2字节的大端序 [headerData appendData:[NSData dataWithBytes:&metaLength length:sizeof(metaLength)]]; Byte payloadCountbytes[] = {payloads.count}; NSData *payloadCountData = [[NSData alloc] initWithBytes:payloadCountbytes length:sizeof(payloadCountbytes)]; [headerData appendData:payloadCountData]; [payloads enumerateObjectsUsingBlock:^(NSData * _Nonnull obj, NSUInteger idx, BOOL * _Nonnull stop) { unsigned int payloadLength = (unsigned int)obj.length; HTONL(payloadLength); // 处理4字节的大端序 [headerData appendData:[NSData dataWithBytes:&payloadLength length:sizeof(payloadLength)]]; }]; __block NSMutableData *uploadData = [NSMutableData data]; // 先添加 header 基础信息,不需要加密压缩 [uploadData appendData:[headerData copy]]; // 再添加 meta 信息,meta 信息需要先压缩再加密 [uploadData appendData:metaData]; // 再添加 payload 信息 [payloads enumerateObjectsUsingBlock:^(NSData * _Nonnull obj, NSUInteger idx, BOOL * _Nonnull stop) { [uploadData appendData:obj]; }]; return [uploadData copy]; } 参考资料 维基百科:字节序

优秀的个人博客,低调大师

每日一博 | 该如何选择消息队列?

在高并发业务场景下,消息队列在流量削峰、解耦上有不可替代的作用。当前使用较多的消息队列有 RabbitMQ、RocketMQ、ActiveMQ、Kafka、ZeroMQ、Pulsar 等。 消息队列这么多,到底该选择哪款消息队列呢? 选择消息队列的基本标准 虽然这些消息队列在功能和特性方面各有优劣,但我们在选择的时候要有一个基本标准。 首先,必须是开源的产品。开源意味着,如果有一天你使用的消息队列遇到了一个影响你系统业务的 Bug,至少还有机会通过修改源代码来迅速修复或规避这个 Bug,解决你的系统的问题,而不是等待开发者发布的下一个版本来解决。 其次,这个产品必须是近年来比较流行并且有一定社区活跃度的产品。流行的好处是,只要使用场景不太冷门,遇到 Bug 的概率会非常低,因为大部分遇到的 Bug,其他人早就遇到并且修复了。在使用过程中遇到的一些问题,也比较容易在网上搜索到类似的问题,然后很快的找到解决方案。还有一个优势就是,流行的产品与周边生态系统会有一个比较好的集成和兼容。 最后,作为一款及格的消息队列,必须具备的几个特性包括: 消息的可靠传递:确保不丢消息; Cluster:支持集群,确保不会因为某个节点宕机导致服务不可用,当然也不能丢消息; 性能:具备足够好的性能,能满足绝大多数场景的性能要求。 接下来看一下有哪些符合上面这些条件,可供选择的开源消息队列。 RabbitMQ 首先,我们来看下消息队列 RabbitMQ。RabbitMQ 于 2007 年发布,是使用 Erlang 编程语言编写的,最早是为电信行业系统之间的可靠通信设计的,也是少数几个支持 AMQP 协议的消息队列之一。 RabbitMQ:轻量级、迅捷,它的宣传口号,也很明确地表明了 RabbitMQ 的特点:Messaging that just works,开箱即用的消息队列。也就是说,RabbitMQ 是一个相当轻量级的消息队列,非常容易部署和使用。 RabbitMQ 一个比较有特色的功能是支持非常灵活的路由配置,和其他消息队列不同的是,它在生产者(Producer)和队列(Queue)之间增加了一个 Exchange 模块,可以理解为交换机。 Exchange 模块的作用和交换机非常相似,根据配置的路由规则将生产者发出的消息分发到不同的队列中。路由的规则也非常灵活,甚至可以自己来实现路由规则。如果正好需要这个功能,RabbitMQ 是个不错的选择。 RabbitMQ 的客户端支持的编程语言大概是所有消息队列中最多的。 接下来说下 RabbitMQ 的几个问题: RabbitMQ 对消息堆积的支持并不好,当大量消息积压的时候,会导致 RabbitMQ 的性能急剧下降。 RabbitMQ 的性能是这几个消息队列中最差的,大概每秒钟可以处理几万到十几万条消息。如果应用对消息队列的性能要求非常高,那不要选择 RabbitMQ。 RabbitMQ 使用的编程语言 Erlang,扩展和二次开发成本高。 RocketMQ RocketMQ 是阿里巴巴在 2012 年开源的消息队列产品,用 Java 语言实现,在设计时参考了 Kafka,并做出了自己的一些改进,后来捐赠给 Apache 软件基金会,2017 正式毕业,成为 Apache 的顶级项目。RocketMQ 在阿里内部被广泛应用在订单,交易,充值,流计算,消息推送,日志流式处理,Binglog 分发等场景。经历过多次双十一考验,它的性能、稳定性和可靠性都是值得信赖的。 RocketMQ 有着不错的性能,稳定性和可靠性,具备一个现代的消息队列应该有的几乎全部功能和特性,并且它还在持续的成长中。 RocketMQ 有非常活跃的中文社区,大多数问题可以找到中文的答案。RocketMQ 使用 Java 语言开发,源代码相对比较容易读懂,容易对 RocketMQ 进行扩展或者二次开发。 RocketMQ 对在线业务的响应时延做了很多的优化,大多数情况下可以做到毫秒级的响应,如果你的应用场景很在意响应时延,那应该选择使用 RocketMQ。 RocketMQ 的性能比 RabbitMQ 要高一个数量级,每秒钟大概能处理几十万条消息。 RocketMQ 的劣势是与周边生态系统的集成和兼容程度不够。 Kafka Apache Kafka 是一个分布式消息发布订阅系统。它最初由 LinkedIn 公司基于独特的设计实现为一个分布式的日志提交系统,之后成为 Apache 项目的一部分。 在早期的版本中,为了获得极致的性能,在设计方面做了很多的牺牲,比如不保证消息的可靠性,可能会丢失消息,也不支持集群,功能上也比较简陋,这些牺牲对于处理海量日志这个特定的场景都是可以接受的。 但是,随后几年 Kafka 逐步补齐了这些短板,当下的 Kafka 已经发展为一个非常成熟的消息队列产品,无论在数据可靠性、稳定性和功能特性等方面都可以满足绝大多数场景的需求。 Kafka 与周边生态系统的兼容性是最好的没有之一,尤其在大数据和流计算领域,几乎所有的相关开源软件系统都会优先支持 Kafka。 Kafka 性能高效、可扩展良好并且可持久化。它的分区特性,可复制和可容错都是不错的特性。 Kafka 使用 Scala 和 Java 语言开发,设计上大量使用了批量和异步的思想,使得 Kafka 能做到超高的性能。Kafka 的性能,尤其是异步收发的性能,是三者中最好的,但与 RocketMQ 并没有量级上的差异,大约每秒钟可以处理几十万条消息。 在有足够的客户端并发进行异步批量发送,并且开启压缩的情况下,Kafka 的极限处理能力可以超过每秒 2000 万条消息。 但是 Kafka 异步批量的设计带来的问题是,它的同步收发消息的响应时延比较高,因为当客户端发送一条消息的时候,Kafka 并不会立即发送出去,而是要等一会儿攒一批再发送,在它的 Broker 中,很多地方都会使用这种先攒一波再一起处理的设计。当你的业务场景中,每秒钟消息数量没有那么多的时候,Kafka 的时延反而会比较高。所以,Kafka 不太适合在线业务场景。 消息队列对比 Kafka RocketMQ RabbitMQ 单机吞吐量 十万级 十万级 万级 开发语言 Java & Scala Java Erlang 消息延迟 毫秒级 毫秒级 微秒级 消息丢失 参数优化配置后可做到0丢失 参数优化配置后可做到0丢失 有较低的概率丢失 消费模式 Pull Pull+Push Pull+Push topic数量对吞吐量的影响 topic达到几十,几百个时,吞吐量会大幅度下降 topic达到几百,几千个时,吞吐量会有较小幅度的下降 \ 可用性 非常高(分布式) 非常高(主从) 高(主从) 总结 吞吐量高,微秒级延时,分布式高可用,最好是支持较少topic数量,会有消息重复现象 可支撑大规模topic数量,方便二次开发和扩展 不支持集群动态扩容,扩展和二次开发难 总结 本文分别介绍了 RabbitMQ,RocketMQ 和 Kafka 几种常见的消息队列,阐述了各种消息队列的主要特点和优劣势。 在了解了上面这些开源消息队列各自的特点和优劣势后,对于消息队列及相关技术选型,相信你会有更深入的理解和认识。以下几条选择的建议可以参考: 如果消息队列不是将要构建系统的重点,对消息队列功能和性能没有很高的要求,只需要一个快速上手易于维护的消息队列,建议使用 RabbitMQ。 如果系统使用消息队列主要场景是处理在线业务,比如在交易系统中用消息队列传递订单,需要低延迟和高稳定性,建议使用 RocketMQ。 如果需要处理海量的消息,像收集日志、监控信息或是埋点这类数据,或是你的应用场景大量使用了大数据、流计算相关的开源产品,那 Kafka 是最适合的消息队列。 每一个消息队列都有自己的优劣势,需要根据现有系统的情况,选择最适合的消息队列,更多细节和原理性的东西,还需在实践中见真知! 参考 http://1t.click/aA3A

优秀的个人博客,低调大师

每日一博 | 测试驱动开发(TDD)入门

测试驱动开发(TDD)入门 测试驱动开发,英文全称 Test-Driven Development(简称 TDD),是由Kent Beck 先生在极限编程(XP)中倡导的开发方法。以其倡导先写测试程序,然后编码实现其功能得名。 本文不打算扯过多的理论,而是通过操练的方式,带着大家去操练一下,让同学们切身感受一下 TDD,究竟是怎么玩的。开始之前先说一下 TDD 的基本步骤。 TDD 的步骤 写一个失败的测试 写一个刚好让测试通过的代码 重构上面的代码 简单设计原则 重构可以遵循简单设计原则: 简单设计原则,优先级从上至下降低,也就是说 「通过测试」的优先级最高,其次是代码能够「揭示意图」和「没有重复」,「最少元素」则是让我们使用最少的代码完成这个功能。 操练 Balanced Parentheses 是我在 cyber-dojo 上最喜欢的一道练习题之一,非常适合作为 TDD 入门练习。 先来看一下题目: Write a program to determine if the the parentheses (), the brackets [], and the braces {}, in a string are balanced. For example: {{)(}} is not balanced because ) comes before ( ({)} is not balanced because ) is not balanced between {} and similarly the { is not balanced between () [({})] is balanced {}([]) is balanced {()}[[{}]] is balanced 我来翻译一下: 写一段程序来判断字符串中的小括号 () ,中括号 [] 和大括号 {} 是否是平衡的(正确闭合)。 例如: {{)(}} 是没有闭合的,因为 ) 在 ( 之前。 ({)} 是没有闭合的,因为 ) 在 {} 之间没有正确闭合,同样 { 在 () 中间没有正确闭合。 [({})] 是平衡的。 {}([]) 是平衡的。 {()}[[{}]] 是平衡的。 需求清楚了,按照一个普通程序员的思维需要先思考一下,把需求理解透彻而且思路要完整,在没思路的情况下完全不能动手。 而使用 TDD 首先要将需求拆分成很小的任务,每个任务足够简单、独立,通过完成一个个小任务,最终交付一个完整的功能。 这个题目起码有两种技术方案,我们先来尝试第一种。 先来拆分第一步: 输入一个空字符串,期望是平衡的,所以返回 true 。 我们来先写测试: import assert from 'assert'; describe('Parentheses', function() { it('如果 输入字符串为 "" ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute(''), true); }); }); 此时运行测试: Parentheses 如果 输入字符串为 "" ,当调用 Parentheses.execute(),则结果返回 true: ReferenceError: Parentheses is not defined at Context.Parentheses (test/parentheses.spec.js:5:18) 接下来写这个 case 的实现: export default { execute(str) { if (str === '') { return true; } } }; 运行: Parentheses ✓ 如果 输入字符串为 "" ,当调用 Parentheses.execute(),则结果返回 true 1 passing (1ms) 第二步: 输入符串为 (),期望的结果是 true 。 先写测试: it('如果 输入字符串为 () ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('()'), true); }); 运行、失败!因为篇幅原因这里就不再贴报错结果。 然后继续写实现: export default { execute(str) { if (str === '') { return true; } if (str === '()') { return true; } return false; } }; 这个实现虽然有点傻,但的确是通过了测试,回顾一下 “简单设计原则” ,以上两步代码都过于简单,没有值得重构的地方。 第三步: 输入符串为 ()(),期望的结果是 true 。 测试: it('如果 输入字符串为 ()() ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('()()'), true); }); 运行、失败! 实现: export default { execute(str) { if (str === '') { return true; } if (str === '()') { return true; } if (str === '()()') { return true; } return false; } }; 这个实现更傻,傻到我都不好意思往上贴,回顾一下 TDD 的步骤「通过测试」,可以重构了。 其中 if (str === '()') 与 if (str === '()()') 看起来有些重复,来看看是否可以这样重构一下: export default { execute(str) { if (str === '') { return true; } const replacedResult = str.replace(/\(\)/gi, ''); if (replacedResult === '') { return true; } return false; } }; 将字符串中的 () 全部替换掉,如果替换后的字符串结果等于 '' 则是正确闭合的。 运行,通过! 我们再来增加一个case : it('如果 输入字符串为 ()()( ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('()()('), false); }); 运行,通过! 第四步 输入符串为 [],期望的结果是 true 。 测试: it('如果 输入字符串为 [] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('[]'), true); }); 运行、失败! 实现: export default { execute(str) { if (str === '') { return true; } let replacedResult = str.replace(/\(\)/gi, ''); replacedResult = replacedResult.replace(/\[\]/gi, ''); if (replacedResult === '') { return true; } return false; } }; 运行,通过! 正则表达式可以将两条语句合并成一条,但是合并成一条语句的可读性较差,所以这里写成了两句。 第五步: 输入符串为 {},期望的结果是 true 。 测试: it('如果 输入字符串为 {} ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{}'), true); }); 实现: export default { execute(str) { if (str === '') { return true; } let replacedResult = str.replace(/\(\)/gi, ''); replacedResult = replacedResult.replace(/\[\]/gi, ''); replacedResult = replacedResult.replace(/\{\}/gi, ''); if (replacedResult === '') { return true; } return false; } }; 运行、通过! 第六步: 输入符串为 [({})],期望的结果是 true 。 写测试: it('如果 输入字符串为 [({})] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('[({})]'), true); }); 运行、失败! 原因是我们的替换逻辑是有顺序的,当替换完成的结果有值,如果等于输入值则返回 false,如果不等于输入值则继续替换, 这里用到了递归。 来修改一下实现代码: export default { execute(str) { if (str === '') { return true; } let replacedResult = str.replace(/\(\)/gi, ''); replacedResult = replacedResult.replace(/\[\]/gi, ''); replacedResult = replacedResult.replace(/\{\}/gi, ''); if (replacedResult === '') { return true; } if (replacedResult === str) { return false; } return this.execute(replacedResult); } }; 运行、通过! 再添加一些测试用例: it('如果 输入字符串为 {}([]) ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{}([])'), true); }); it('如果 输入字符串为 {()}[[{}]] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{()}[[{}]]'), true); }); it('如果 输入字符串为 {{)(}} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('{{)(}}'), false); }); it('如果 输入字符串为 ({)} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('({)}'), false); }); 运行、通过! 这个功能我们就这样简单的实现了,需求如此,所以这个方案有些简陋,甚至我们都没有做错误处理。在这里我们不花太多时间进行重构,直接进入方案二。 方案二 我们将需求扩展一下: 输入字符串为: const fn = () => { const arr = [1, 2, 3]; if (arr.length) { alert('success!'); } }; 判断这个字符串的括号是否正确闭合。 通过刚刚 git 提交的记录找到第二步重新拉出一个分支: git log git checkout <第二步的版本号> -b plan-b 运行、通过! 测试已经有了,我们直接修改实现: export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === '(') { pipe.push(chart); } if (char === ')') { pipe.pop(); } } if (!pipe.length) return true; return false; } }; 这个括号的闭合规则是先进后出的,使用数组就 ok。 运行、通过! 第三步: 上面的实现满足这个任务,但是有一个明显的漏洞,当输入只有一个 ) 时,期望得到返回 false ,我们增加一个 case: it('如果 输入字符串为 ) ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute(')'), false); }); 运行、失败! 再修改实现: export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === '(') { pipe.push(char); } if (char === ')') { if (pipe.pop() !== '(') return false; } } if (!pipe.length) return true; return false; } }; 运行、通过!如果 pop() 的结果不是我们放进去管道里的值,则认为没有正确闭合。 重构一下,if 语句嵌套的没有意义: export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === '(') { pipe.push(char); } if (char === ')' && pipe.pop() !== '(') { return false; } } if (!pipe.length) return true; return false; } }; ( ) 在程序中应该是一组常量,不应当写成字符串,所以继续重构: const PARENTHESES = { OPEN: '(', CLOSE: ')' }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === PARENTHESES.OPEN) { pipe.push(char); } if (char === PARENTHESES.CLOSE && pipe.pop() !== PARENTHESES.OPEN) { return false; } } if (!pipe.length) return true; return false; } }; 运行、通过! 再增加几个case: it('如果 输入字符串为 ()() ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('()()'), true); }); it('如果 输入字符串为 ()()( ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('()()('), false); }); 第四步: 如果输入字符串为 ] ,这结果返回 false 测试: it('如果 输入字符串为 ] ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute(']'), false); }); 运行、失败! 这个逻辑很简单,只要复制上面的逻辑就ok。 实现: const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === PARENTHESES.OPEN) { pipe.push(char); } if (char === PARENTHESES.CLOSE && pipe.pop() !== PARENTHESES.OPEN) { return false; } if (char === BRACKETS.OPEN) { pipe.push(char); } if (char === BRACKETS.CLOSE && pipe.pop() !== BRACKETS.OPEN) { return false; } } if (!pipe.length) return true; return false; } }; 运行、通过! 接下来我们开始重构,这两段代码完全重复,只是判断条件不同,如果后面增加 } 逻辑也是相同,所以这里我们将重复的代码抽成函数。 const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; const holderMap = { '(': PARENTHESES, ')': PARENTHESES, '[': BRACKETS, ']': BRACKETS, }; const compare = (char, pipe) => { const holder = holderMap[char]; if (char === holder.OPEN) { pipe.push(char); } if (char === holder.CLOSE && pipe.pop() !== holder.OPEN) { return false; } return true; }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (!compare(char, pipe)) { return false; } } if (!pipe.length) return true; return false; } }; 运行、通过! 第五步 输入符串为 },期望的结果是 false 。 测试: it('如果 输入字符串为 } ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('}'), false); }); 运行、失败! Parentheses 如果 输入字符串为 } ,当调用 Parentheses.execute(),则结果返回 false: TypeError: Cannot read property 'OPEN' of undefined at compare (src/parentheses.js:22:4) at Object.execute (src/parentheses.js:45:12) at Context.it (test/parentheses.spec.js:29:48) 报错信息和我们期望的不符,原来是 } 字符串没有找到对应的 holder 会报错,来修复一下: const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; const holderMap = { '(': PARENTHESES, ')': PARENTHESES, '[': BRACKETS, ']': BRACKETS, }; const compare = (char, pipe) => { const holder = holderMap[char]; if (!holder) return true; if (char === holder.OPEN) { pipe.push(char); } if (char === holder.CLOSE && pipe.pop() !== holder.OPEN) { return false; } return true; }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (!compare(char, pipe)) { return false; } } if (!pipe.length) return true; return false; } }; 运行、失败!这次失败的结果与我们期望是相同的,然后再修改逻辑。 const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; const BRACES = { OPEN: '{', CLOSE: '}' }; const holderMap = { '(': PARENTHESES, ')': PARENTHESES, '[': BRACKETS, ']': BRACKETS, '{': BRACES, '}': BRACES }; const compare = (char, pipe) => { const holder = holderMap[char]; if (!holder) return true; if (char === holder.OPEN) { pipe.push(char); } if (char === holder.CLOSE && pipe.pop() !== holder.OPEN) { return false; } return true; }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (!compare(char, pipe)) { return false; } } if (!pipe.length) return true; return false; } }; 因为前面的重构,增加 {} 的支持只是增加一些常量的配置。 运行、通过! 再增加些 case: it('如果 输入字符串为 [({})] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('[({})]'), true); }); it('如果 输入字符串为 {}([]) ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{}([])'), true); }); it('如果 输入字符串为 {()}[[{}]] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{()}[[{}]]'), true); }); it('如果 输入字符串为 {{)(}} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('{{)(}}'), false); }); it('如果 输入字符串为 ({)} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('({)}'), false); }); 运行、通过! 再加最后一个 case: const inputStr = ` const fn = () => { const arr = [1, 2, 3]; if (arr.length) { alert('success!'); } }; `; it(`如果 输入字符串为 ${inputStr} ,当调用 Parentheses.execute(),则结果返回 false`, () => { assert.equal(Parentheses.execute(inputStr), true); }); 完成! 总结 通过上面的练习,相信大家应该能够感受到 TDD 的威力,有兴趣的同学可以不使用 TDD 将上面的功能重新实现一遍,对比一下两次实现的时间和质量就知道要不要学习 TDD 这项技能。 资料 https://martinfowler.com/bliki/BeckDesignRules.html 《测试驱动开发的艺术》 本文代码

优秀的个人博客,低调大师

每日一博 | JDK 13 新特性详解

JDK8 新特性详解,2014-03-18正式发布 JDK9 新特性详解,2017-09-21正式发布 JDK10新特性详解,2018-03-20正式发布 JDK11新特性详解,2018-09-25正式发布 JDK12新特性详解,2019-03-19正式发布 JDK13新特性详解,2019-09-17正式发布 1、switch优化更新 JDK11以及之前的版本: switch (day) { case MONDAY: case FRIDAY: case SUNDAY: System.out.println(6); break; case TUESDAY: System.out.println(7); break; case THURSDAY: case SATURDAY: System.out.println(8); break; case WEDNESDAY: System.out.println(9); break; } JDK12版本 switch (day) { case MONDAY, FRIDAY, SUNDAY -> System.out.println(6); case TUESDAY -> System.out.println(7); case THURSDAY, SATURDAY -> System.out.println(8); case WEDNESDAY -> System.out.println(9); } JDK13版本 static void howMany(int k) { System.out.println( switch (k) { case 1 -> "one" case 2 -> "two" default -> "many" } );} 2、文本块升级 2.1、html例子 JDK13之前 String html = "<html>\n" + " <body>\n" + " <p>Hello, world</p>\n" + " </body>\n" + "</html>\n"; JDK13优化的: String html = """ <html> <body> <p>Hello, world</p> </body> </html> """; 2.2、SQL变化 JDK13之前 String query = "SELECT `EMP_ID`, `LAST_NAME` FROM `EMPLOYEE_TB`\n" + "WHERE `CITY` = 'INDIANAPOLIS'\n" + "ORDER BY `EMP_ID`, `LAST_NAME`;\n"; JDK13 String query = """ SELECT `EMP_ID`, `LAST_NAME` FROM `EMPLOYEE_TB` WHERE `CITY` = 'INDIANAPOLIS' ORDER BY `EMP_ID`, `LAST_NAME`; """; 2.3、解释 文本块 """ line 1 line 2 line 3 """ 相当于字符串文字: "line 1\nline 2\nline 3\n" 3、动态CDS档案 目标: 提高应用程序类 - 数据共享(AppCDS)的可用性。消除了用户进行试运行以创建每个应用程序的类列表的需要。-Xshare:dump使用类列表由该选项启用的静态归档应继续工作。这包括内置类加载器和用户定义的类加载器的类。 4、取消使用未使用的内存 摘要: 增强ZGC以将未使用的堆内存返回给操作系统。 动机: ZGC目前没有取消提交并将内存返回给操作系统,即使该内存长时间未使用。对于所有类型的应用程序和环境,此行为并非最佳, 尤其是那些需要关注内存占用的应用程序和环境 例如:通过使用支付资源的容器环境。应用程序可能长时间处于空闲状态并与许多其 他应用程序共享或竞争资源的环境。应用程序在执行期间可能具有非常不同的堆空间要求。 例如,启动期间所需的堆可能大于稳态执行期间稍后所需的堆。HotSpot中的其他垃圾收集器,如G1和Shenandoah,今天提供 了这种功能,某些类别的用户发现它非常有用。将此功能添加到ZGC将受到同一组用户的欢迎。 5、重新实现旧版套接字API 摘要: 使用更简单,更现代的实现替换java.net.Socket和java.net.ServerSocketAPI 使用的底层实现,易于维护和调试。新的实 现很容易适应用户模式线程,也就是光纤,目前正在Project Loom中进行探索。 动机: 在java.net.Socket和java.net.ServerSocketAPI,以及它们的底层实现,可以追溯到JDK 1.0。实现是遗留Java和C代 码的混合,维护和调试很痛苦。该实现使用线程堆栈作为I/O缓冲区,这种方法需要多次增加默认线程堆栈大小。该实现使用本机数据 结构来支持异步关闭,这是多年来微妙可靠性和移植问题的根源。该实现还有几个并发问题,需要进行大修才能正确解决。在未来的光 纤世界环境中,而不是在本机方法中阻塞线程,当前的实现不适用于目的。 6、FileSystems.newFileSystem新方法 核心库/ java.nio中添加了FileSystems.newFileSystem(Path,Map <String,?>)方法 添加了三种新方法java.nio.file.FileSystems,以便更轻松地使用将文件内容视为文件系统的文件系统提供程序。 1、newFileSystem(Path) 2、newFileSystem(Path, Map<String, ?>) 3、newFileSystem(Path, Map<String, ?>, ClassLoader)添加为newFileSystem(Path, Map<String, ?>) 已使用现有2-arg newFileSystem(Path, ClassLoader)并指定类加载器 的代码创建源(但不是二进制)兼容性问题。null.例如,由于引用newFileSystem不明确,因此无法编译以下内容:FileSystem fs = FileSystems.newFileSystem(path, null);为了避免模糊引用,需要修改此代码以将第二个参数强制转换为java.lang.ClassLoader。 7、nio新方法 核心库/ java.nio中新的java.nio.ByteBuffer批量获取/放置方法转移字节而不考虑缓冲区位置。 java.nio.ByteBufferjava.nio现在,其他缓冲区类型定义绝对批量get和put传输连续字节序列的方法,而不考虑或影响缓冲 区位置。 8、核心库/ java.time 新日本时代名称Reiwa,此更新中添加了代表新Reiwa时代的实例。与其他时代不同,这个时代没有公共领域。它可以通过调用 JapaneseEra.of(3)或获得JapaneseEra.valueOf("Reiwa")。JDK13及更高版本将有一个新的公共领域来代表这个时代。 NewEra从2019年5月1日开始的日本时代的占位符名称“ ”已被新的官方名称取代。依赖占位符名称(请参阅JDK-8202088)获 取新时代单例(JapaneseEra.valueOf("NewEra"))的应用程序将不再起作用。请参阅JDK-8205432 9、核心库/ java.util中:I18N 支持Unicode 12.1,此版本将Unicode支持升级到12.1,其中包括以下内容: java.lang.Character支持12.1级的Unicode字符数据库,其中12.0从11.0开始增加554个字符,总共137,928个 字符。这些新增内容包括4个新脚本,总共150个脚本,以及61个新的表情符号字符。U+32FF SQUARE ERA NAME REIWA从 12.0开始,12.1只添加一个字符。java.text.Bidi和java.text.Normalizer类分别支持12.0级的Unicode标准附件, #9和#15。java.util.regexpackage支持基于12.0级Unicode标准附件#29的扩展字形集群。 10、热点/ GC 10.1 JEP 351 ZGC取消提交未使用的存储器 10.2 添加了-XXSoftMaxHeapSize标志 10.3 ZGC支持的最大堆大小从4TB增加到16TB 11、安全库/ java.security 11.1 该com.sun.security.crl.readtimeout系统属性设置为CRL检索的最大读取超时,单位为秒。如果尚未设置该属性, 或者其值为负,则将其设置为默认值15秒。值0表示无限超时。 11.2 新的keytool -showinfo -tls用于显示TLS配置信息的命令keytool -showinfo -tls添加了一个显示TLS配置信 息的新命令。 11.3 SunMSCAPI提供程序现在支持以下一代加密(CNG)格式读取私钥。这意味着CNG格式的RSA和EC密钥可从Windows密钥 库加载,例如“Windows-MY”。与EC(签名算法SHA1withECDSA,SHA256withECDSA等等)也支持。 12、删除功能 删除的部分功能: 12.1 核心库/java.net中,不再支持Pre-JDK 1.4 SocketImpl实现java.net.SocketImpl此版本已删除对为 JavaSE1.3及更早版本编译的自定义实现的支持。此更改对SocketImpl为Java SE 1.4(2002年发布)或更新版本编译 的实现没有影响。 12.2 核心库/java.lang中,删除运行时跟踪方法,过时的方法traceInstructions(boolean),并 traceMethodCalls(boolean)已经从删除java.lang.Runtime类。这些方法对许多版本都不起作用,它们 的预期功能由Java虚拟机工具接口(JVMTI)提供。

优秀的个人博客,低调大师

每日一博 | Vue 项目实践@树洞(一)

项目名称 树洞(tree-hole) 项目背景 有些话不适合对任何人说,何不对着树洞发泄一下。 树洞的想法源自于一个朋友对知己的看法,最初设计有一点像漂流瓶。不过,这样的想法有一点傻。如果要严格匹配出一个知己需要大量的用户,需要大数据支持,一个初级产品是不可能有如此的用户群。于是,我联想到了电影《解忧杂货铺》,这样就可以避开大数据,同时对不法行为也是一种拦截。当然,如果要做成一个成型的产品需要一个漫长的过程。 这样的产品在市面上是存在的,有成功的,也有失败的。当我开始做个项目的时候也并没有要把它做完整,毕竟想法不完整,同时还需要进行一些必要的知识补救。也就是说这只是一个Demo,并不完整的东西,仅仅是为了练习一下技术。最初也想做成一个完整的项目,而且也聚集了一些朋友,不过做到后面有些不尽人意了。大家抱着不挣钱练技术的心态是建设不出好的项目来,而且我觉得主要工作在后端。另外,大家也似乎都很忙,沟通成本也太高了,只好作罢。 所以,在这儿也就不做项目的结构介绍,等做成完整项目之后再做一个全面的输出。毕竟只有一个人弄,还要去学后端,这是又一个漫长的过程。 技术选型 近期主要研究的是vue,之前对比过vue-cli2和vue-cli3的差异,vue-cli3更简洁。但是之前没有研究明白,因此这次选用vue-cli3脚手架来进行研究。为什么研究vue?毕竟是中国人自己搞出来的,必须支持一下。 由于没有UI做图,于是选用一个UI组件库来解决这个难题。相对来说,我个人觉得vux更适合一些,其余的大多是基于商城,组件也并没那么丰富。但是它的缺点就是在某些情况下因为scoped的原因修改内置样式修改不了,于是改用vant。vant应该基于ant-design,设计漂亮,组件易用。 移动端适配之前一直用的rem,rem的适配通常是通过JS动态改变根字体大小来完成,这就需要多一个JS的流程。当然,可以通过css的方式来固定根字体大小,缺点也很明显。淘宝前端emfe团队给了一个相对成熟的适配方式flexible,配合px2rem-loader(px2rem)使用也是相当方便的。关于flexible适配,可以阅读一下《使用Flexible实现手淘H5页面的终端适配》。 我并没使用它们做过实际开发,只是研究的时候发现flexible的适配方式我没搞懂。当viewport缩放动态修改的时候,rem根值也同时动态更改,最后效果和预想的不太一样。于是我只好写死viewport,这样才能恢复我要的效果。可能是我配置的方式没对,以后有空再研究。px2rem我比较喜欢它将特定的样式根据dpr生成适配样式,不过它貌似不能处理行内样式,当然vue极少用行内样式。 另外,emfe在准备更新flexible 2.0版本的时候放弃了更新,改为推荐vw实现适配。rem适配并不完美,可以阅读下大漠老师的文章《再聊移动端页面的适配》。vw是不是就完美呢,也不是,px换成vw会产生像素差。我之前讲过,浮点数始终是不精确的,浮点数还原回px就会发现少了一点。这在移动端还是可以忍受的,关于使用详细可以查阅《如何在Vue项目中使用vw实现移动端适配》。于是,适配我选用vw,感受一下效果。 准备工作 ## 构建项目 ## 之前使用的是vue-cli 2,卸掉它,换成vue-cli 3。第一个差别是vue-cli的包名称改为了@vue/cli。如果需要继续使用vue-cli 2的工作方式,需要安装@vue/cli-init包,项目构建命令和vue-cli 2相同。vue-cli其实就是一个模版拷贝的过程,大量的配置会导致模版难以维护,于是重构了vue-cli 3,做了一些初步的封装,开箱即用。你不做任何配置就可以进行开发工作,如果要折腾,可以去修改配置项。 vue-cli 3更换完成,使用vue create命令生成项目,接下来根据需要勾选默认配置。具体的就不啰嗦了,官网文档对配置项做了大致的说明,再不明白可以搜索网上教程。我不太喜欢ESLint这个东西,因为在使用非ES写法的时候就会提示,很烦躁,明明就是正确的JS语法。对比一下,vue-cli 2和vue-cli 3构建的项目,如图: 从结构上看3.x更加简洁,将2.x的build目录、config目录隐藏了起来,改为了使用vue.config.js来完成配置,默认是没有这个文件的,需要自己在项目目录下新建。类似这种配置方式在很多地方都有用到,比如环境变量、测试工具的配置等等。相对于2.x在配置文件内部去做手脚要高明得多,统一管理便于维护。3.x将不需要编译的资源统一放到了public文件夹,包括index.html文件,去掉了2.x的static目录。3.x去掉了router目录,将路由直接放到src下(router.js)。 3.x在src下默认新增了store.js、registerServiceWorker.js两个文件。store.js自不必说,vuex文件,管理vue状态。registerServiceWorker.js说实话,我没有在网上查到太多的资料,大多讲解是针对react的这个文件。vue-cli 3的构建方式是学习了react的脚手架,原理上它们应该是相通的,它的目的是使项目变成一个PWA(Progressive Web Application)。也就是说,注册一个服务来进行缓存,下一次即使没有网络,这个应用依然可以访问。 3.x还多了一个叫做插件的东西,通过vue add命令来添加,在src下会多一个plugins目录。我的理解插件就像被二次封装的模板库,执行添加命令,这个库按照生成器规定的方式被部署到对应的文件中,从而是vue-cli得到扩展。因而vue add并不能取代npm install,具体的介绍可以查看官方文档。只不过,到底有些什么已经可用的插件在官网上看不到,只能通过vue ui在图形界面上查看安装。我是不太喜欢这种傻瓜式的构建方式,特别中二。再加上插件开发者水平参差不齐,不见得符合自己开发的意愿。除了特殊的情况,我更喜欢自己去安装,编写需要的文件。 再来看看,package.json文件,3.x简洁了很多,2.x不少依赖包都不见了。(ps:图中vue3的dependencies中vant是为了展示插件这个目录添加进去的,不是3.x新增内容。)编译运行命令变成了一个名为vue-cli-service的命令,它的底层还是启动一个webpack-dev-server,只不过附带了一些其它功能。换句话说,它其实也是一个插件。如果要更深层次地了解它的工作原理,那么只有去翻源码。此外,2.x中比如browserslist这个字段,在3.x也是存在的,由于我选择配成的文件.browserslistrc。有很多配置文件都可以放入package.json中,个人认为,放在单个文件更加直观更利于维护。 关于vue-cli 3其他相关的介绍,只有移步官网,里面讲解更全面。不得不吐槽,咱啥时候能彻底和IE说拜拜,简直是bull shit,这给前端开发增加了太多的难题! ## 引入UI组件库 ## 前面介绍插件已经引入了vant,引入方式:执行vue ui启动GUI,导入项目。切换到插件 -> 添加插件,选中并安装插件vue-cli-plugin-vant。接下来在plugins目录下就会出现vant.js文件,该文件已将vant引入,而且这个文件也在main.js上引入。vant.js引入有一个Locale变量,我开了代码提示,这时就开始报错了。这并不是什么大问题,但时常会让人莫名其妙。 通过插件安装是其中一种方式,另一种同样通过GUI图形界面,切换到依赖 -> 安装依赖,切换依赖包的环境,选中并安装vant。 这不是程序员的操作方式,于是我选择命令行安装依赖。 # 通过 npm 安装 npm i vant -S 有四种方式引入组件,第一种:老方法,这似乎是不太美丽的做法。 <!-- 引入样式 --> <link rel="stylesheet" href="https://cdn.jsdelivr.net/npm/vant@2.2/lib/index.css"> <!-- 引入组件 --> <script src="https://cdn.jsdelivr.net/npm/vue/dist/vue.min.js"></script> <script src="https://cdn.jsdelivr.net/npm/vant@2.2/lib/vant.min.js"></script> <script> var Vue = window.Vue; var vant = window.vant; // 注册 Lazyload 组件 Vue.use(vant.Lazyload); // 调用函数式组件 vant.Toast('提示'); </script> 第二种:在main.js导入所有组件,当然也可以像插件那样提一个文件出来。 import Vue from 'vue'; import Vant from 'vant'; import 'vant/lib/index.css'; Vue.use(Vant); 第三种:手动按需引入组件。 import Button from 'vant/lib/button'; import 'vant/lib/button/style'; 第四种:自动按需引入组件,这才是工程化的做法。 # 安装插件 npm i babel-plugin-import -D // 在 babel.config.js 中配置 module.exports = { plugins: [ ['import', { libraryName: 'vant', libraryDirectory: 'es', style: true }, 'vant'] ] }; // 插件会自动将代码转化为按需引入形式 import { Button } from 'vant'; 由于我全项目依靠vant,所以,我使用了第二种方式,但这是不科学的,关于这个后面会提到。 ## vw适配 ## 前面介绍技术选型已经做了介绍,下面直接操作。 # 安装依赖包 npm i postcss-aspect-ratio-mini postcss-px-to-viewport postcss-write-svg postcss-cssnext postcss-viewport-units cssnano cssnano-preset-advanced postcss-import postcss-url --S // 配置postcss.config.js module.exports = { plugins: { "postcss-import": {}, "postcss-url": {}, "postcss-aspect-ratio-mini": {}, "postcss-write-svg": { uft8: false }, "postcss-cssnext": {}, "postcss-px-to-viewport": { viewportWidth: 375, unitPrecision: 3, viewportUnit: 'vw', selectorBlackList: ['.ignore', '.hairlines'], minPixelValue: 1, mediaQuery: false }, "postcss-viewport-units": { "silence": true }, "cssnano": { preset: 'advanced', autoprefixer: false, "postcss-zindex": false } } } viewportWidth我配置的375,iphone6设计图,按1倍图处理,因为很多库是使用的1倍图的实际像素来进行适配的。如果不想转换直接使用1倍图像素,可以在selectorBlackList加入'van'来屏蔽转换,'van'是vant库所有样式的前缀。 最后解决vw适配的兼容问题,这个polyfill原理很简单,相当于将vw单位还原为该分辨率的实际像素。 <script src="<%= BASE_URL %>js/viewport-units-buggyfill.min.js"></script> <script src="<%= BASE_URL %>js/viewport-units-buggyfill.hacks.min.js"></script> <script>window.onload=function(){window.viewportUnitsBuggyfill.init({hacks:window.viewportUnitsBuggyfillHacks})}</script> 这儿需要注意的是不能使用字体图标,字体图标使用content来完成的,这个polyfill也使用了content。我不解的是postcss-px-to-viewport也使用了,却没有影响。其实,并不建议使用字体图标,字体图标通常包含很大的资源。 最后 这只是技术选型上的配置,配置还并没有完成,比如接口请求封装、打包处理等等。 # 跑下代码 npm run serve ## 代码仓库 ## https://gitee.com/IanLew/tree-hole.git ## @树洞系列## vue项目实践@树洞(一) vue项目实践@树洞(二) vue项目实践@树洞(三)

优秀的个人博客,低调大师

每日一博 | 实践 DDD 领域驱动设计

说明 领域驱动设计最近又火了。概念不断被提及,但是相信对于像笔者一样的很多开发者对于其如何应用都一头雾水。 正如《实现领域驱动设计》中作者提到的不同公司的业务能力开发能力和成熟度不一样,DDD为了解决复杂业务为生,并不适合所有的软件项目,对于很多初创公司而言,业务本身就是模糊的,只是需要做出一个MVP(最小可行性产品)来试探商业模式,采用ddd显得过“重”了一点,反而给团队成员带来额外的负担,所以团队管理者首先应该关注的是软件系统是否值得做出DDD投入。 不过不管黑猫白猫,能抓到老鼠就是好猫。我们以电商业务来演练和实践ddd的部分理论,并解释ddd的概念。 战略设计阶段 领域:即业务是属于哪块,电商领域,保险领域,零售领域,又可细化分为子领域。如电商下(订单交易领域、库存领域、会员领域、物流领域....) 领域专家:一般指熟悉对应领域的产品经理项目经理 子域:子域可细分为核心子域、通用子域和支撑子域,简单理解为哪部分是比较核心的就可称作核心子域,哪些功能偏边缘化叫支撑域。 互联网公司的敏捷开发模式的产品研发流程从收集需求、PRD评审、技术模块拆分这些前期流程。而战略设计即在这个阶段完成,顾名思义侧重于从宏观上对业务进行拆分,和对未来走向的预测。 DDD的目的是为了领域专家更好地与开发进行沟通合作,使得代码更好地传达业务规则。 最初的需求方可能会提一些凌乱的需求。 为了更好地传达规则,领域专家将需求整合提取出领域的概念,技术/项目管理者一起划分好子域和限界上下文。各方统一所谓的通用语言并在以后的协作中使用。比如电商业务中双方约定好中商家用户和买家用户的概念,用户和账户的概念,交易订单和支付订单、物流订单、售后订单的概念,以实现后期沟通顺畅。 最终产出:划分出了哪些子领域、上下文映射图是怎样的。 贴一个电商业务的上下文映射图(下单交易上下文为下游,其他皆为上游): 而各个上下文的交互方式,即集成限界上下文的方式其实就是我们常说的系统交互方式:RPC调用、REST接口调用、消息队列通信。 怎么理解限界上下文和子域的关系? **限界上下文:**是一个显示边界,领域模型即存在于这个边界之内。在边界内,通用语言有特定明确的意义。 ps:是不是觉得每个字都认得,但是不知道表达了什么意思.... 在理解限界上下文和子域上确实有点费劲。笔者当时的疑惑主要是:为什么要用上下文映射图而不是子域交互图,子域划分出来不就说明边界已经明确了么,为什么还专门搞一个限界上下文的概念。 关于限界上下文,贴一下个人理解: 接下来要咬文嚼字一些了。 1、从“限界”二字来说。限界上下文明确了业务范围和职责边界。针对上面问题“子域中不是已经有边界的概念了么”。可以思考一个有意思的事,子域有边界,还是说因为有了边界才有子域。听到过一个非常到位的类比:如果没有细胞壁,如何定义细胞质? 2、从“上下文”来说。上下文关注的是两个系统交互时的环境,或者说语境。 举个例子:小学是一个子域,中学是一个子域。升学这个事件动作则要上下文表达。 通用语言要在限界上下文(语境)中保证其明确意义。举个例子,商家管理上下文中,我们(平台)说的用户指的是商家而不是买家,支付上下文中,我们以支付单为核心,语境无需引入物流单、库存等词汇。 通常来说,我们可以近似地认为子域和限界上下文一一对应的。 战术设计阶段 截止到此,我们已经划分好了子域,对开发人员来说,已经拆分好了项目。各个团队可以针对自己的子域进行独立开发了。对于ddd而言,我们开始进行战术设计阶段。战略设计关心做什么,战术设计则更关心技术实现细节,即:怎么做。 先说下ddd中推荐的六边形架构: 这里要吐槽一下六边形架构这个命名,搞得好像有六个什么东西一样。其实只是根据视觉形状起的名。现在叫端口与适配器架构。 转换一下是这样的 **严格分层架构:**某层只能与直接位于其下方的层发生耦合 **松散分层架构:**允许上方层可以与任意下方层发生耦合。 这里采用松散分层架构。也可按依赖倒置原则, 基础层依赖领域层的一些东西(常见的就是实体Entity) 适配器层: 负责接口转换,即是最外层请求处理类,将外部请求转化为内部API能理解的输入。对于REST接口可能是一个controller类; 对于dubbo调用来说是开放出去的provider服务类; 对于grpc调用来说,是protobuf请求对象转换处理类; 对于消息机制来说,对应的是消息的监听器 如此采用端口适配器模式,可以不影响内部服务,只需在适配器层进行增改。尽管大家不知道六边形架构的定义,但相信很多人是这样做的。无须赘述。 应用层:负责协调领域层的接口实现前端展示或返回需要。 领域层:定义领域实体和逻辑。包括实体、值对象、领域服务、领域事件、资源库。 基础层:如数据库相关。 实体和值对象 实体: 有唯一业务标识 有自己的业务属性和行为 属性可变,有自己的生命周期 值对象: 可以有唯一业务标识 有自己的业务属性和行为 一旦定义不可改变 二者的关系可总结为:值对象关心对象是什么样的,实体侧重描述对象是哪个? 提到有自己的业务属性和行为这块,想想这不就是我们年轻时说的面向对象编程的思想码? 但是回顾一下会发现,这个思想好像被很多人抛诸脑后很久了,定义的对象类都成了一个个的pojo,只有属性和属性对应getter和seter方法,也就是ddd中所说的失血模型。 **失血模型:**只含属性和对应的getter/setter方法,无业务处理逻辑 贫血模型:包含不依赖持久化的部分领域逻辑,依赖持久的逻辑被放在领域服务层。 充血模型:绝大数业务逻辑都放在其中,包括持久化逻辑。少数不适合的逻辑被提取出来放在领域服务层中。 胀血模型:主张不需要领域服务层,把一些业务逻辑都放在模型对象中处理 领域服务 胀血模型主张把所有的业务逻辑放在模型中处理,但是事实上有些逻辑并不是适合放在某个领域对象中处理。比如 1、领域对象间的转换 2、某些场景下需要多个领域对象作为输入值,结果产生一个值对象。 区别于应用层的服务,领域服务处理的是业务逻辑。应用层负责对领域服务处理结果进行渲染和组装返回给前端。ps:针对查询类的操作,建议作为应用层的查询服务单独拎出来,因为查询尝尝涉及到多个维度的查询,或把多个领域对象的查询结果组装成一个返回值对象。 举个栗子:订单领域需要向商家(PC端)和买家(APP端),商家端按发货条件时间查询所有买家的订单,操作发货处理售后等流程。买家端完成下单、查询个人订单。在应用层我们抽象三个应用处理出来,公用的查询应用、商家端应用(关联商家权限控制上下文)、买家端应用(关联买家权限控制上下文)。 领域事件 领域事件即领域业务周期中一些关键行为,关键的定义是其他地方需要依赖此事件推送业务流转。如订单被支付这个事件,需要触发库存扣减、商家待结算账户余额增加等操作。关于领域事件处理方法:跨子域处理常用消息队列发布/订阅模式,同项目处理常用注册事件监听器处理。不多描述。 聚合和资源库 领域对象之间常常有依赖关系。比如主订单-子订单(商品)项,子订单依附于主订单存在,二者的关系称作聚合,主订单作为聚合根。 @Data publicclassTradeOrderEntity { //订单号 StringorderNo; // 商品详情 List<OrderItemDetailEntity> orderItemDetails; 我们通过为每一个聚合选择一个根,并通过根来控制所有对边界内的对象的访问。外部对象只能持有根的引用;由于根控制了访问,因此我们无法绕过它去修改内部元素。所以在ddd中,资源库Repository是面向聚合根操作的,可对多个dao对象的组合使用。 @Repository public class TradeOrderRepository { @Autowired TradeOrderMapper tradeOrderMapper; @Autowired OrderItemDetailMapper orderItemDetailMapper; } 关于其中一些思想,笔者也没有想清楚,所谓知行合一,恐怕很多方法论要真的遇到问题了才会理解其价值。先整理到这。最后针对Java后端开发同学,提供一个模块分层的框架供参考 思考 无忌,我教你的还记得多少?” “回太师傅,我只记得一大半” “ 那,现在呢?” “已经剩下一小半了” “那,现在呢?” “我已经把所有的全忘记了!” “好,你可以上了…”

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册