首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | ByteHouse 实时导入技术演进

更多技术交流、求职机会,欢迎关注字节跳动数据平台微信公众号,回复【1】进入官方交流群 ByteHouse 是火山引擎上的一款云原生数据仓库,为用户带来极速分析体验,能够支撑实时数据分析和海量离线数据分析;便捷的弹性扩缩容能力,极致的分析性能和丰富的企业级特性,助力客户数字化转型。 本文将从需求动机、技术实现及实际应用等角度,介绍基于不同架构的 ByteHouse 实时导入技术演进。 内部业务的实时导入需求 ByteHouse 实时导入技术的演进动机,起初于字节跳动内部业务的需求。 在字节内部,ByteHouse 主要还是以 Kafka 为实时导入的主要数据源(本文都以 Kafka 导入为例展开描述,下文不再赘述)。对于大部分内部用户而言,其数据体量偏大;所以用户更看重数据导入的性能、服务的稳定性以及导入能力的可扩展性。而对于数据延时性,大多数用户只要是秒级可见就能满足其需求。基于这样的场景,ByteHouse 进行了定制性的优化。 分布式架构下的高可用 社区原生分布式架构 ByteHouse 首先沿用了 Clickhouse 社区的分布式架构,但分布式架构有一些天然性架构层面的缺陷,这些痛点主要表现在三个方面: 节点故障:当集群机器数量到达一定规模以后,基本每周都需要人工处理节点故障。对于单副本集群在某些极端 case 下,节点故障甚至会导致数据丢失。 读写冲突:由于分布式架构的读写耦合,当集群负载达到一定程度以后,用户查询和实时导入就会出现资源冲突——尤其是 CPU 和 IO,导入就会受到影响,出现消费 lag。 扩容成本:由于分布式架构数据基本都是本地存储,在扩容以后,数据无法做 Reshuffle,新扩容的机器几乎没有数据,而旧的机器上磁盘可能已经快写满,造成集群负载不均的状态,导致扩容并不能起到有效的效果。 这些是分布式架构天然的痛点,但是由于其天然的并发特性,以及本地磁盘数据读写的极致性能优化,可以说有利有弊。 社区实时导入设计 High-Level 消费模式:依托 Kafka 自身的 rebalance 机制做消费负载均衡。 两级并发 基于分布式架构的实时导入核心设计其实就是两级并发: 一个 CH 集群通常有多个 Shard,每个 Shard 都会并发做消费导入,这就是第一级 Shard 间的多进程并发; 每个 Shard 内部还可以使用多个线程并发消费,从而达到很高的性能吞吐。 攒批写入 就单个线程来说,基本消费模式是攒批写入——消费一定的数据量,或者一定时间之后,再一次性写入。攒批写入可以更好地实现性能优化,查询性能提升,并降低后台 Merge 线程的压力。 无法满足的需求 上述社区的设计与实现,还是无法满足用户的一些高级需求: 首先部分高级用户对数据的分布有着比较严格的要求,比如他们对于一些特定的数据有特定的 Key,希望相同 key 的数据落盘到同一个 Shard(比如唯一键需求)。这种情况下,社区 High Level 的消费模式是无法满足的。 其次是 High level 的消费形式 rebalance 不可控,可能最终会导致 Clickhouse 集群中导入的数据在各个 Shard 之间分配不均。 当然,消费任务的分配不可知,在一些消费异常情景下,想要排查问题也变得非常困难;对于一个企业级应用,这是难以接受的。 自研分布式架构消费引擎 HaKafka 为了解决上述需求,ByteHouse 团队基于分布式架构自研了一种消费引擎——HaKafka。 高可用(Ha) HaKafka 继承了社区原有 Kafka 表引擎的消费优点,再重点做了高可用的 Ha 优化。 就分布式架构来谈,其实每个 Shard 内可能都会有多个副本,在每个副本上都可以做 HaKafka 表的创建。但是 ByteHouse 只会通过 ZK 选一个 Leader,让 Leader 来真正地执行消费流程,其他节点位于 Stand by 状态。当 Leader 节点不可用了,ZK 可以在秒级将 Leader 切到 Stand by 节点继续消费,从而实现一种高可用。 Low—Level 消费模式 HaKafka 的消费模式从 High Level 调整到了 Low Level 模式。Low Level 模式可以保证 Topic Partition 有序和均匀地分配到集群内各个 shard;与此同时,Shard 内部可以再一次用多线程,让每个线程来消费不同 Partition。从而完全继承了社区 Kafka 表引擎两级并发的优点。 在 Low-Level 消费模式下,上游用户只要在写入 Topic 的时候,保证没有数据倾斜,那么通过 HaKafka 导入到 Clickhouse 里的数据肯定也是均匀分布在各个 shard 的。 同时,对于有特殊数据分布需求——将相同 Key 的数据写到相同 Shard——的高级用户,只要在上游保证相同 Key 的数据写入相同 Partition,那么导入 ByteHouse 也就能完全满足用户需求,很好地支持唯一键等场景。 场景一: 基于上图可见,假设有一个双副本的 Shard,每个副本都会有一张相同的 HaKafka 表处于 Ready 的状态。但是只有通过 ZK 选主成功的 leader 节点上,HaKafka 才会执行对应的消费流程。当这个 leader 节点宕机以后, 副本 Replica 2 会自动再被选为一个新的 Leader,继续消费,从而保证高可用。 场景二: 在节点故障场景下,一般需要执行替换节点流程。对于分布式节点替换有一个很繁重的操作——拷贝数据。 如果是一个多副本的集群,一个副本故障,另一个副本是完好的。我们很自然希望在节点替换阶段,Kafka 消费放在完好的副本 Replica 2 上,因为其上旧数据是完备的。这样 Replica 2 就始终是一个完备的数据集,可以正常对外提供服务。这一点 HaKafka 是可以保证的。HaKafka 选主的时候,如果确定有某一个节点在替换节点流程当中,会避免将其选为 Leader。 导入性能优化:Memory Table HaKafka 还做到了 Memory Table 的优化。 考虑这样一个场景:业务有一个大宽表,可能有上百列的字段 或者上千的 Map-Key。由于 ClickHouse 每一个列都会对应落盘为一个具体的文件,列越多,每次导入写的文件也就越多。那么,相同消费时间内,就会频繁地写很多的碎文件,对于机器的 IO 是很沉重的负担,同时给 MERGE 带来很大压力;严重时甚至导致集群不可用。为了解决这种场景,我们设计了 Memory Table 实现导入性能优化。 Memory Table 的做法就是每一次导入数据不直接刷盘,而是存在内存中;当数据达到一定量以后,再集中刷盘,减少 IO 操作。Memory Table 可以提供对外查询服务的,查询会路由到消费节点所在的副本去读 memory table 里边的数据,这样保证了不影响数据导入的延时性。从内部使用经验来看,Memory Table 不仅很好地解决了部分大宽表业务导入需求,而且导入性能最高可以提升 3 倍左右。 云原生新架构 鉴于上文描述的分布式架构的天然缺陷,ByteHouse 团队一直致力于对架构进行升级。我们选择了业务主流的云原生架构,新的架构在 2021 年初开始服务字节内部业务,并于 2023 年初进行了代码开源(ByConity)。 云原生架构本身有着很天然的自动容错能力以及轻量级的扩缩容能力。同时,因为它的数据是云存储的,既实现了存储计算分离,数据的安全性和稳定性也得到了提高。当然,云原生架构也不是没有缺点,将原来的本地读写改为远端读写,必然会带来一定的读写性能损耗。但是,以一定的性能损耗来换取架构的合理性,降低运维成本,其实是利大于弊的。 上图是 ByteHouse 云原生架构的架构图,本文针对实时导入这块介绍几个重要的相关组件。 Cloud Service 首先,总架构分为三层,第一层是 Cloud Service,主要包含 Server 和 Catlog 两个组件。 这一层是服务入口,用户的所有请求包括查询导入都从 Server 进入。 Server 只对请求做预处理,不具体执行;在 Catlog 查询元信息后,把预处理的请求和元信息下发到 Virtual Warehouse 执行。 Virtual Warehouse Virtual Warehouse 是执行层。不同的业务,可以有独立的 Virtual Warehouse,从而做到资源隔离。现在 Virtual Warehouse 主要分为两类,一类是 Default,一类是 Write,Default 主要做查询,Write 做导入,实现读写分离。 VFS 最底层是 VFS(数据存储),支持 HDFS、S3、aws 等云存储组件。 基于云原生架构的实时导入设计 在云原生架构下,Server 端不做具体的导入执行,只做任务管理。因此在 Server 端,每个消费表会有一个 Manager,用来管理所有的消费执行任务,并将其调度到 Virtual Warehouse 上执行。 因为继承了 HaKafka 的 Low Level 消费模式,Manager 会根据配置的消费任务数量,将 Topic Partition 均匀分配给各个任务;消费任务的数量是可配置的,上限是 Topic Partition 数目。 基于上图,大家可以看到左边是 Manager ,从 catalog 拿到对应的 Offset,然后根据指定的消费任务数目,来分配对应的消费 Partition、并调度到 Virtual Warehouse 的不同节点来执行。 新的消费执行流程 因为云原生新架构下是有事务 Transaction 保证的,所有操作都希望在一个事务内完成,也更加的合理化。 依托云原生新架构下的 Transaction 实现,每个消费任务的消费流程主要包括以下步骤: 消费开始前,Worker 端的任务会先通过 RPC 请求,向 Server 端请求创建一个事务; 执行 rdkafka::poll(),消费一定时间(默认 8s)或者足够大的 block; 将 block 转化为 Part 并 Dump 到 VFS(此时数据不可见); 通过 RPC 请求向 Server 发起事务 Commit 请求(事务中 Commit 的数据包括:dump 完成的 part 元数据以及对应 Kafka offset) 事务提交成功(数据可见) 容错保证 从上述消费流程里可以看到,云原生新架构下的消费,容错保证主要是基于 Manager 和 Task 的双向心跳以及快速失败策略: Manager 本身会有一个定期的探活,通过 RPC 检查调度的 Task 是否在正常执行; 同时每个 Task 会在消费中借助事务 RPC 请求来校验自己的有效性,一旦校验失败,它可以自动 kill; 而 Manager 一旦探活失败,则会立即拉起一个新的消费任务,实现秒级的容错保证。 消费能力 关于消费能力的话,上文提到它是一个可扩展性的,消费任务数量可以由用户来配置,最高可以达到 Topic 的 Partition 数目。如果 Virtual Warehouse 中节点负载高的话,也可以很轻量地扩节点。 当然,Manager 调度任务实现了基本的负载均衡保证——用 Resource Manager 来做任务的管理和调度。 语义增强:Exactly—Once 最后,云原生新架构下的消费语义也有一个增强——从分布书架构的 At-Least-Once 升级到 Exactly—Once。 因为分布式架构是没有事务的,只能做到一个 At-Least-Once,就是任何情况下,保证不丢数据,但是一些极端情况可能会有重复消费发生。到了云原生架构,得益于 Transaction 的实现,每一次消费都可以通过事务让 Part 和 Offset 实现原子性提交,从而达到 Exactly—Once 的语义增强。 Memory buffer 对应 HaKafka 的 memory table,云原生架构同样实现了导入内存缓存 Memory Buffer。 与 Memory Table 不同的是,Memory Buffer 不再绑定到 Kafka 的消费任务上,而是实现为存储表的一层缓存。这样 Memory Buffer 就更具有通用性,不仅是 Kafka 导入可以使用,像 Flink 小批量导入的时候也可以使用。 同时,我们引入了一个新的组件 WAL 。数据导入的时候先写 WAL,只要写成功了,就可以认为数据导入成功了——当服务启动后,可以先从 WAL 恢复未刷盘的数据;之后再写 Memory buffer,写成功数据就可见了——因为 Memory Buffer 是可以由用户来查询的。Memory Buffer 的数据同样定期刷盘,刷盘后即可从 WAL 中清除。 业务应用及未来思考 最后简单介绍实时导入在字节内部的使用现状,以及下一代实时导入技术的可能优化方向。 ByteHouse 的实时导入技术是以 Kafka 为主,每天的数据吞吐是在 PB 级,导入的单个线程或者说单个消费者吞吐的经验值在 10-20MiB/s。(这里之所以强调是经验值,因为这个值不是一个固定值,也不是一个峰值;消费吞吐很大程度上取决于用户表的复杂程度,随着表列数增加,导入性能可能会显著降低,无法使用一个准确的计算公式。因此,这里的经验值更多的是字节内部大部分表的导入性能经验值。) 除了 Kafka,字节内部其实还支持一些其他数据源的实时导入,包括 RocketMQ、Pulsar、MySQL(MaterializedMySQL)、 Flink 直写等。 关于下一代实时导入技术的简单思考: 更通用的实时导入技术,能够让用户支持更多的导入数据源。 数据可见延时和性能的一个折衷。 点击跳转 ByteHouse云原生数据仓库 了解更多

优秀的个人博客,低调大师

每日一博 | 100 行 shell 写个 Docker

作者:vivo 互联网运维团队- Hou Dengfeng 本文主要介绍使用shell实现一个简易的Docker。 一、目的 在初接触Docker的时候,我们必须要了解的几个概念就是Cgroup、Namespace、RootFs,如果本身对虚拟化的发展没有深入的了解,那么很难对这几个概念有深入的理解,本文的目的就是通过在操作系统中以交互式的方式去理解,Cgroup/Namespace/Rootfs到底实现了什么,能做到哪些事情,然后通过shell这种直观的命令行方式把我们的理解组合起来,去模仿Docker实现一个缩减的版本。 二、技术拆解 2.1 Namespace 2.1.1 简介 Linux Namespace是Linux提供的一种内核级别环境隔离的方法。学习过Linux的同学应该对chroot命令比较熟悉(通过修改根目录把用户限制在一个特定目录下),chroot提供了一种简单的隔离模式:chroot内部的文件系统无法访问外部的内容。Linux Namespace在此基础上,提供了对UTS、IPC、mount、PID、network、User等的隔离机制。Namespace是对全局系统资源的一种封装隔离,使得处于不同namespace的进程拥有独立的全局系统资源,改变一个namespace中的系统资源只会影响当前namespace里的进程,对其他namespace中的进程没有影响。 Linux Namespace有如下种类: 2.1.2 Namespace相关系统调用 amespace相关的系统调用有3个,分别是clone(),setns(),unshare()。 clone: 创建一个新的进程并把这个新进程放到新的namespace中 setns: 将当前进程加入到已有的namespace中 unshare: 使当前进程退出指定类型的namespace,并加入到新创建的namespace中 2.1.3 查看进程所属Namespace 上面的概念都比较抽象,我们来看看在Linux系统中怎么样去get namespace。 系统中的每个进程都有/proc/[pid]/ns/这样一个目录,里面包含了这个进程所属namespace的信息,里面每个文件的描述符都可以用来作为setns函数(2.1.2)的fd参数。 #查看当前bash进程关联的Namespace# ls -l /proc/$$/nstotal 0lrwxrwxrwx 1 root root 0 Jan 17 21:43 ipc -> ipc:[4026531839]lrwxrwxrwx 1 root root 0 Jan 17 21:43 mnt -> mnt:[4026531840]lrwxrwxrwx 1 root root 0 Jan 17 21:43 net -> net:[4026531956]lrwxrwxrwx 1 root root 0 Jan 17 21:43 pid -> pid:[4026531836]lrwxrwxrwx 1 root root 0 Jan 17 21:43 user -> user:[4026531837]lrwxrwxrwx 1 root root 0 Jan 17 21:43 uts -> uts:[4026531838] #这些 namespace 文件都是链接文件。链接文件的内容的格式为 xxx:[inode number]。 其中的 xxx 为 namespace 的类型,inode number 则用来标识一个 namespace,我们也可以把它理解为 namespace 的 ID。 如果两个进程的某个 namespace 文件指向同一个链接文件,说明其相关资源在同一个 namespace 中。以ipc:[4026531839]例, ipc是namespace的类型,4026531839是inode number,如果两个进程的ipc namespace的inode number一样,说明他们属于同一个namespace。 这条规则对其他类型的namespace也同样适用。 #从上面的输出可以看出,对于每种类型的namespace,进程都会与一个namespace ID关联。 #当一个namespace中的所有进程都退出时,该namespace将会被销毁。在 /proc/[pid]/ns 里放置这些链接文件的作用就是,一旦这些链接文件被打开,只要打开的文件描述符(fd)存在,那么就算该namespace下的所有进程都结束了,但这个namespace也会一直存在,后续的进程还可以再加入进来。 2.1.4 相关命令及操作示例 本节会用UTS/IPC/NET 3个Namespace作为示例演示如何在linux系统中创建Namespace,并介绍相关命令。 2.1.4.1 IPC Namespace IPC namespace用来隔离System V IPC objects和POSIX message queues。其中System V IPC objects包含消息列表Message queues、信号量Semaphore sets和共享内存Shared memory segments。为了展现区分IPC Namespace我们这里会使用到ipc相关命令: # nsenter: 加入指定进程的指定类型的namespace中,然后执行参数中指定的命令。# 命令格式:nsenter [options] [program [arguments]]# 示例:nsenter –t 27668 –u –I /bin/bash## unshare: 离开当前指定类型的namespace,创建且加入新的namesapce,然后执行参数中执行的命令。# 命令格式:unshare [options] program [arguments]# 示例:unshare --fork --pid --mount-proc readlink /proc/self## ipcmk:创建shared memory segments, message queues, 和semaphore arrays# 参数-Q:创建message queues# ipcs:查看shared memory segments, message queues, 和semaphore arrays的相关信息# 参数-a:显示全部可显示的信息# 参数-q:显示活动的消息队列信息 下面将以消息队列为例,演示一下隔离效果,为了使演示更直观,我们在创建新的ipc namespace的时候,同时也创建新的uts namespace,然后为新的uts namespace设置新hostname,这样就能通过shell提示符一眼看出这是属于新的namespace的bash。示例中我们用两个shell来展示: shell A #查看当前shell的uts / ipc namespace number # readlink /proc/$$/ns/uts /proc/$$/ns/ipcuts:[4026531838]ipc:[4026531839] #查看当前主机名# hostnamemyCentos #查看ipc message queues,默认情况下没有message queue# ipcs -q ------ Message Queues --------key msqid owner perms used-bytes messages #创建一个message queue# ipcmk -QMessage queue id: 131072# ipcs -q ------ Message Queues --------key msqid owner perms used-bytes messages 0x82a1d963 131072 root 644 0 0 -----> 切换至shell B执行------------------------------------------------------------------ #回到shell A之后我们可以看下hostname、ipc等有没有收到影响# hostnamemyCentos # ipcs -q ------ Message Queues --------key msqid owner perms used-bytes messages 0x82a1d963 131072 root 644 0 0 #接下来我们尝试加入shell B中新的Namespace# nsenter -t 30372 -u -i /bin/bash [root@shell-B:/root]# hostnameshell-B # readlink /proc/$$/ns/uts /proc/$$/ns/ipcuts:[4026532382]ipc:[4026532383] # ipcs -q ------ Message Queues --------key msqid owner perms used-bytes messages #可以看到我们已经成功的加入到了新的Namespace中 shell B #确认当前shell和shell A属于相同Namespace # readlink /proc/$$/ns/uts /proc/$$/ns/ipcuts:[4026531838]ipc:[4026531839] # ipcs -q ------ Message Queues --------key msqid owner perms used-bytes messages0x82a1d963 131072 root 644 0 0 #使用unshare创建新的uts和ipc Namespace,并在新的Namespace中启动bash # unshare -iu /bin/bash #确认新的bash uts/ipc Namespace Number # readlink /proc/$$/ns/uts /proc/$$/ns/ipcuts:[4026532382]ipc:[4026532383] #设置新的hostname与shell A做区分 # hostname shell-B # hostnameshell-B #查看之前的ipc message queue # ipcs -q ------ Message Queues --------key msqid owner perms used-bytes messages #查看当前bash进程的PID# echo $$30372 切换回shell A <----- 2.1.4.2 Net Namespace Network namespace用来隔离网络设备, IP地址, 端口等. 每个namespace将会有自己独立的网络栈,路由表,防火墙规则,socket等。每个新的network namespace默认有一个本地环回接口,除了lo接口外,所有的其他网络设备(物理/虚拟网络接口,网桥等)只能属于一个network namespace。每个socket也只能属于一个network namespace。当新的network namespace被创建时,lo接口默认是关闭的,需要自己手动启动起。标记为"local devices"的设备不能从一个namespace移动到另一个namespace,比如loopback, bridge, ppp等,我们可以通过ethtool -k命令来查看设备的netns-local属性。 我们使用以下命令来创建net namespace。 相关命令: ip netns: 管理网络namespace 用法: ip netns list ip netns add NAME ip netns set NAME NETNSID ip [-all] netns delete [NAME] 下面使用ip netns来演示创建net Namespace。 shell A #创建一对网卡,分别命名为veth0_11/veth1_11# ip link add veth0_11 type veth peer name veth1_11 #查看已经创建的网卡#ip a1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 inet 127.0.0.1/8 scope host lo valid_lft forever preferred_lft forever2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP qlen 1000 link/ether 5e:75:97:0d:54:17 brd ff:ff:ff:ff:ff:ff inet 192.168.1.1/24 brd 192.168.1.255 scope global eth0 valid_lft forever preferred_lft forever3: br1: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN qlen 1000 link/ether 00:00:00:00:00:00 brd ff:ff:ff:ff:ff:ff inet 172.18.0.1/24 scope global br1 valid_lft forever preferred_lft forever96: veth1_11@veth0_11: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN qlen 1000 link/ether 5e:75:97:0d:54:0e brd ff:ff:ff:ff:ff:ff97: veth0_11@veth1_11: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN qlen 1000 link/ether a6:c7:1f:79:a6:a6 brd ff:ff:ff:ff:ff:ff #使用ip netns创建两个net namespace# ip netns add r1# ip netns add r2# ip netns listr2r1 (id: 0) #将两个网卡分别加入到对应的netns中# ip link set veth0_11 netns r1# ip link set veth1_11 netns r2#再次查看网卡,在bash当前的namespace中已经看不到veth0_11和veth1_11了# ip a1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 inet 127.0.0.1/8 scope host lo valid_lft forever preferred_lft forever2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP qlen 1000 link/ether 5e:75:97:0d:54:17 brd ff:ff:ff:ff:ff:ff inet 192.168.1.1/24 brd 192.168.1.255 scope global eth0 valid_lft forever preferred_lft forever3: br1: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN qlen 1000 link/ether 00:00:00:00:00:00 brd ff:ff:ff:ff:ff:ff inet 172.18.0.1/24 scope global br1 valid_lft forever preferred_lft forever #接下来我们切换到对应的netns中对网卡进行配置#通过nsenter --net可以切换到对应的netns中,ip a展示了我们上面加入到r1中的网卡# nsenter --net=/var/run/netns/r1 /bin/bash# ip a1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:0097: veth0_11@if96: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state DOWN qlen 1000 link/ether a6:c7:1f:79:a6:a6 brd ff:ff:ff:ff:ff:ff link-netnsid 1 #对网卡配置ip并启动# ip addr add 172.18.0.11/24 dev veth0_11# ip link set veth0_11 up# ip a1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:0097: veth0_11@if96: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state LOWERLAYERDOWN qlen 1000 link/ether a6:c7:1f:79:a6:a6 brd ff:ff:ff:ff:ff:ff link-netnsid 1 inet 172.18.0.11/24 scope global veth0_11 valid_lft forever preferred_lft forever -----> 切换至shell B执行------------------------------------------------------------------ #在r1中ping veth1_11# ping 172.18.0.12PING 172.18.0.12 (172.18.0.12) 56(84) bytes of data.64 bytes from 172.18.0.12: icmp_seq=1 ttl=64 time=0.033 ms64 bytes from 172.18.0.12: icmp_seq=2 ttl=64 time=0.049 ms...#至此我们通过netns完成了创建net Namespace的小实验 shell B #在shell B中我们同样切换到netns r2中进行配置#通过nsenter --net可以切换到r2,ip a展示了我们上面加入到r2中的网卡# nsenter --net=/var/run/netns/r2 /bin/bash# ip a1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:0096: veth1_11@if97: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state DOWN qlen 1000 link/ether 5e:75:97:0d:54:0e brd ff:ff:ff:ff:ff:ff link-netnsid 0 #对网卡配置ip并启动# ip addr add 172.18.0.12/24 dev veth1_11# ip link set veth1_11 up# ip a1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:0096: veth1_11@if97: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP qlen 1000 link/ether 5e:75:97:0d:54:0e brd ff:ff:ff:ff:ff:ff link-netnsid 0 inet 172.18.0.12/24 scope global veth1_11 valid_lft forever preferred_lft forever inet6 fe80::5c75:97ff:fe0d:540e/64 scope link valid_lft forever preferred_lft forever #尝试ping r1中的网卡# ping 172.18.0.11PING 172.18.0.11 (172.18.0.11) 56(84) bytes of data.64 bytes from 172.18.0.11: icmp_seq=1 ttl=64 time=0.046 ms64 bytes from 172.18.0.11: icmp_seq=2 ttl=64 time=0.040 ms...#可以完成通信 切换至shell A执行 <----- 示意图 2.2 Cgroup 2.2.1 简介 Cgroup和namespace类似,也是将进程进行分组,但它的目的和namespace不一样,namespace是为了隔离进程组之间的资源,而cgroup是为了对一组进程进行统一的资源监控和限制。 Cgroup作用: 资源限制(Resource limiting): Cgroups可以对进程组使用的资源总额进行限制。如对特定的进程进行内存使用上限限制,当超出上限时,会触发OOM。 优先级分配(Prioritization): 通过分配的CPU时间片数量及硬盘IO带宽大小,实际上就相当于控制了进程运行的优先级。 资源统计(Accounting): Cgroups可以统计系统的资源使用量,如CPU使用时长、内存用量等等,这个功能非常适用于计费。 进程控制(Control):Cgroups可以对进程组执行挂起、恢复等操作。 Cgroups的组成: task: 在Cgroups中,task就是系统的一个进程。 cgroup: Cgroups中的资源控制都以cgroup为单位实现的。cgroup表示按照某种资源控制标准划分而成的任务组,包含一个或多个子系统。一个任务可以加入某个cgroup,也可以从某个cgroup迁移到另外一个cgroup。 subsystem:一个subsystem就是一个内核模块,被关联到一颗cgroup树之后,就会在树的每个节点(进程组)上做具体的操作。subsystem经常被称作"resource controller",因为它主要被用来调度或者限制每个进程组的资源,但是这个说法不完全准确,因为有时我们将进程分组只是为了做一些监控,观察一下他们的状态,比如perf_event subsystem。到目前为止,Linux支持13种subsystem(Cgroup v1),比如限制CPU的使用时间,限制使用的内存,统计CPU的使用情况,冻结和恢复一组进程等。 hierarchy:一个hierarchy可以理解为一棵cgroup树,树的每个节点就是一个进程组,每棵树都会与零到多个subsystem关联。在一颗树里面,会包含Linux系统中的所有进程,但每个进程只能属于一个节点(进程组)。系统中可以有很多颗cgroup树,每棵树都和不同的subsystem关联,一个进程可以属于多颗树,即一个进程可以属于多个进程组,只是这些进程组和不同的subsystem关联。如果不考虑不与任何subsystem关联的情况(systemd就属于这种情况),Linux里面最多可以建13颗cgroup树,每棵树关联一个subsystem,当然也可以只建一棵树,然后让这棵树关联所有的subsystem。当一颗cgroup树不和任何subsystem关联的时候,意味着这棵树只是将进程进行分组,至于要在分组的基础上做些什么,将由应用程序自己决定,systemd就是一个这样的例子。 2.2.2 查看Cgroup信息 查看当前系统支持的subsystem #通过/proc/cgroups查看当前系统支持哪些subsystem# cat /proc/cgroups#subsys_name hierarchy num_cgroups enabledcpuset 11 1 1cpu 4 67 1cpuacct 4 67 1memory 5 69 1devices 7 62 1freezer 8 1 1net_cls 6 1 1blkio 9 62 1perf_event 3 1 1hugetlb 2 1 1pids 10 62 1net_prio 6 1 1 #字段含义#subsys_name: subsystem的名称#hierarchy:subsystem所关联到的cgroup树的ID,如果多个subsystem关联到同一颗cgroup树,那么他们的这个字段将一样,比如这里的cpu和cpuacct就一样,表示他们绑定到了同一颗树。如果出现下面的情况,这个字段将为0: 当前subsystem没有和任何cgroup树绑定 当前subsystem已经和cgroup v2的树绑定 当前subsystem没有被内核开启#num_cgroups: subsystem所关联的cgroup树中进程组的个数,也即树上节点的个数#enabled: 1表示开启,0表示没有被开启(可以通过设置内核的启动参数“cgroup_disable”来控制subsystem的开启). 查看进程所属cgroup #查看当前shell进程所属的cgroup# cat /proc/$$/cgroup11:cpuset:/10:pids:/system.slice/sshd.service9:blkio:/system.slice/sshd.service8:freezer:/7:devices:/system.slice/sshd.service6:net_prio,net_cls:/5:memory:/system.slice/sshd.service4:cpuacct,cpu:/system.slice/sshd.service3:perf_event:/2:hugetlb:/1:name=systemd:/system.slice/sshd.service #字段含义(以冒号分为3列):# 1. cgroup树ID,对应/proc/cgroups中的hierachy# 2. cgroup所绑定的subsystem,多个subsystem使用逗号分隔。name=systemd表示没有和任何subsystem绑定,只是给他起了个名字叫systemd。# 3. 进程在cgroup树中的路径,即进程所属的cgroup,这个路径是相对于挂载点的相对路径。 2.2.3 相关命令 使用cgroup cgroup相关的所有操作都是基于内核中的cgroup virtual filesystem,使用cgroup很简单,挂载这个文件系统就可以了。一般情况下都是挂载到/sys/fs/cgroup目录下,当然挂载到其它任何目录都没关系。 查看下当前系统cgroup挂载情况。 #过滤系统挂载可以查看cgroup# mount |grep cgrouptmpfs on /sys/fs/cgroup type tmpfs (ro,nosuid,nodev,noexec,mode=755)cgroup on /sys/fs/cgroup/systemd type cgroup (rw,nosuid,nodev,noexec,relatime,xattr,release_agent=/usr/lib/systemd/systemd-cgroups-agent,name=systemd)cgroup on /sys/fs/cgroup/hugetlb type cgroup (rw,nosuid,nodev,noexec,relatime,hugetlb)cgroup on /sys/fs/cgroup/perf_event type cgroup (rw,nosuid,nodev,noexec,relatime,perf_event)cgroup on /sys/fs/cgroup/cpu,cpuacct type cgroup (rw,nosuid,nodev,noexec,relatime,cpuacct,cpu)cgroup on /sys/fs/cgroup/memory type cgroup (rw,nosuid,nodev,noexec,relatime,memory)cgroup on /sys/fs/cgroup/net_cls,net_prio type cgroup (rw,nosuid,nodev,noexec,relatime,net_prio,net_cls)cgroup on /sys/fs/cgroup/devices type cgroup (rw,nosuid,nodev,noexec,relatime,devices)cgroup on /sys/fs/cgroup/freezer type cgroup (rw,nosuid,nodev,noexec,relatime,freezer)cgroup on /sys/fs/cgroup/blkio type cgroup (rw,nosuid,nodev,noexec,relatime,blkio)cgroup on /sys/fs/cgroup/pids type cgroup (rw,nosuid,nodev,noexec,relatime,pids)cgroup on /sys/fs/cgroup/cpuset type cgroup (rw,nosuid,nodev,noexec,relatime,cpuset) #如果系统中没有挂载cgroup,可以使用mount命令创建cgroup#挂载根cgroup# mkdir /sys/fs/cgroup# mount -t tmpfs cgroup_root /sys/fs/cgroup #将cpuset subsystem关联到/sys/fs/cgroup/cpu_memory# mkdir /sys/fs/cgroup/cpuset# sudo mount -t cgroup cpuset -o cgroup /sys/fs/cgroup/cpuset/ #将cpu和memory subsystem关联到/sys/fs/cgroup/cpu_memory# mkdir /sys/fs/cgroup/cpu_memory# sudo mount -n -t cgroup -o cpu,memory cgroup /sys/fs/cgroup/cpu_memory 除了mount命令之外我们还可以使用以下命令对cgroup进行创建、属性设置等操作,这也是我们后面脚本中用于创建和管理cgroup的命令。 # Centos操作系统可以通过yum install cgroup-tools 来安装以下命令 cgcreate: 在层级中创建新cgroup。 用法: cgcreate [-h] [-t <tuid>:<tgid>] [-a <agid>:<auid>] [-f mode] [-d mode] [-s mode] -g <controllers>:<path> [-g ...] 示例: cgcreate -g *:student -g devices:teacher //在所有的挂载hierarchy中创建student cgroup,在devices hierarchy挂载点创建teacher cgroup cgset: 设置指定cgroup(s)的参数 用法: cgset [-r <name=value>] <cgroup_path> ... 示例: cgset -r cpuset.cpus=0-1 student //将student cgroup的cpuset控制器中的cpus限制为0-1 cgexec: 在指定的cgroup中运行任务 用法: cgexec [-h] [-g <controllers>:<path>] [--sticky] command [arguments] 示例: cgexec -g cpu,memory:test1 ls -l //在cpu和memory控制器下的test1 cgroup中运行ls -l命令 2.3 Rootfs 2.3.1 简介 Rootfs 是 Docker 容器在启动时内部进程可见的文件系统,即 Docker容器的根目录。rootfs 通常包含一个操作系统运行所需的文件系统,例如可能包含典型的类 Unix 操作系统中的目录系统,如 /dev、/proc、/bin、/etc、/lib、/usr、/tmp 及运行 Docker 容器所需的配置文件、工具等。 就像Linux启动会先用只读模式挂载rootfs,运行完完整性检查之后,再切换成读写模式一样。Docker deamon为container挂载rootfs时,也会先挂载为只读模式,但是与Linux做法不同的是,在挂载完只读的rootfs之后,Docker deamon会利用联合挂载技术(Union Mount)在已有的rootfs上再挂一个读写层。container在运行过程中文件系统发生的变化只会写到读写层,并通过whiteout技术隐藏只读层中的旧版本文件。 Docker支持不同的存储驱动,包括 aufs、devicemapper、overlay2、zfs 和 vfs 等,目前在 Docker 中,overlay2 取代了 aufs 成为了推荐的存储驱动。 2.3.2 overlayfs overlayFS是联合挂载技术的一种实现。除了overlayFS以外还有aufs,VFS,Brtfs,device mapper等技术。虽然实现细节不同,但是他们做的事情都是相同的。Linux内核为Docker提供的overalyFS驱动有2种:overlay2和overlay,overlay2是相对于overlay的一种改进,在inode利用率方面比overlay更有效。 overlayfs通过三个目录来实现:lower目录、upper目录、以及work目录。三种目录合并出来的目录称为merged目录。 lower:可以是多个,是处于最底层的目录,作为只读层。 upper:只有一个,作为读写层。 work:为工作基础目录,挂载后内容会被清空,且在使用过程中其内容用户不可见。 merged:为最后联合挂载完成给用户呈现的统一视图,也就是说merged目录里面本身并没有任何实体文件,给我们展示的只是参与联合挂载的目录里面文件而已,真正的文件还是在lower和upper中。所以,在merged目录下编辑文件,或者直接编辑lower或upper目录里面的文件都会影响到merged里面的视图展示。 2.3.3 文件规则 merged层目录会显示离它最近层的文件。层级关系中upperdir比lowerdir更靠近merged层,而多个lowerdir的情况下,写的越靠前的目录离merged层目录越近。相同文件名的文件会依照层级规则进行“覆盖”。 2.3.4 overlayFS如何工作 读: 如果文件在容器层(upperdir),直接读取文件; 如果文件不在容器层(upperdir),则从镜像层(lowerdir)读取; 写:①首次写入: 如果在upperdir中不存在,overlay执行cow操作,把文件从lowdir拷贝到upperdir,由于overlayfs是文件级别的(即使文件只有很少的一点修改,也会产生的cow的行为),后续对同一文件的在此写入操作将对已经复制到容器的文件的副本进行操作。值得注意的是,cow操作只发生在文件首次写入,以后都是只修改副本。②删除文件和目录: 当文件在容器被删除时,在容器层(upperdir)创建whiteout文件,镜像层(lowerdir)的文件是不会被删除的,因为他们是只读的,但whiteout文件会阻止他们显示。 2.3.5 在系统里创建overlayfs shell # 创建所需的目录# mkdir upper lower merged work# echo "lower" > lower/in_lower.txt# echo "upper" > upper/in_upper.txt # 在lower和upper中都创建 in_both文件# echo "lower" > lower/in_both.txt# echo "upper" > upper/in_both.txt #查看下我们当前的目录及文件结构# tree ..|-- lower| |-- in_both.txt| `-- in_lower.txt|-- merged|-- upper| |-- in_both.txt| `-- in_upper.txt`-- work #使用mount命令将创建的目录联合挂载起来# mount -t overlay overlay -o lowerdir=lower,upperdir=upper,workdir=work merged #查看mount结果可以看到已经成功挂载了# mount |grep overlayoverlay on /data/overlay_demo/merged type overlay (rw,relatime,lowerdir=lower,upperdir=upper,workdir=work) #此时再查看文件目录结构# tree ..|-- lower| |-- in_both.txt| `-- in_lower.txt|-- merged| |-- in_both.txt| |-- in_lower.txt| `-- in_upper.txt|-- upper| |-- in_both.txt| `-- in_upper.txt`-- work `-- work#可以看到merged中包含了lower和upper中的文件#然后我查看merge中的in_both文件,验证了上层目录覆盖下层的结论# cat merged/in_both.txtupper #上面我们验证了挂载后overlayfs的读,接下来我们去验证下写#我们在merged中创建一个新文件,并查看# touch merged/new_file# tree ..|-- lower| |-- in_both.txt| `-- in_lower.txt|-- merged| |-- in_both.txt| |-- in_lower.txt| |-- in_upper.txt| `-- new_file|-- upper| |-- in_both.txt| |-- in_upper.txt| `-- new_file`-- work `-- work#可以看到新文件实际是放在了upper目录中 #下面我们看下如果删除了lower和upper中都有的文件会怎样# rm -f merged/in_both.txt# tree ..|-- lower| |-- in_both.txt| `-- in_lower.txt|-- merged| |-- in_lower.txt| |-- in_upper.txt| `-- new_file|-- upper| |-- in_both.txt| |-- in_upper.txt| `-- new_file`-- work `-- work #从文件目录上看只有merge中没有了in_both文件,但是upper中的文件已经发生了变化# ll upper/in_both.txtc--------- 1 root root 0, 0 Jan 21 19:33 upper/in_both.txt#upper/in_both.txt已经变成了一个空的字符文件,且覆盖了lower层的内容 三 、Bocker 3.1 功能演示 第二部分中我们对Namespace,cgroup,overlayfs有了一定的了解,接下来我们通过一个脚本来实现个建议的Docker。脚本源自于https://github.com/p8952/bocker,我做了image/pull/存储驱动的部分修改,下面先看下脚本完成后的示例: 3.2 完整脚本 脚本一共用130行代码,完成了上面的功能,也算符合我们此次的标题了。为了大家可以更深入的理解脚本内容,这里就不再对脚本进行拆分讲解,以下是完整脚本。 #!/usr/bin/env bashset -o errexit -o nounset -o pipefail; shopt -s nullgloboverlay_path='/var/lib/bocker/overlay' && container_path='/var/lib/bocker/containers' && cgroups='cpu,cpuacct,memory';[[ $# -gt 0 ]] && while [ "${1:0:2}" == '--' ]; do OPTION=${1:2}; [[ $OPTION =~ = ]] && declare "BOCKER_${OPTION/=*/}=${OPTION/*=/}" || declare "BOCKER_${OPTION}=x"; shift; done function bocker_check() { case ${1:0:3} in img) ls "$overlay_path" | grep -qw "$1" && echo 0 || echo 1;; ps_) ls "$container_path" | grep -qw "$1" && echo 2 || echo 3;; esac} function bocker_init() { #HELP Create an image from a directory:\nBOCKER init <directory> uuid="img_$(shuf -i 42002-42254 -n 1)" if [[ -d "$1" ]]; then [[ "$(bocker_check "$uuid")" == 0 ]] && bocker_run "$@" mkdir "$overlay_path/$uuid" > /dev/null cp -rf --reflink=auto "$1"/* "$overlay_path/$uuid" > /dev/null [[ ! -f "$overlay_path/$uuid"/img.source ]] && echo "$1" > "$overlay_path/$uuid"/img.source [[ ! -d "$overlay_path/$uuid"/proc ]] && mkdir "$overlay_path/$uuid"/proc echo "Created: $uuid" else echo "No directory named '$1' exists" fi} function bocker_pull() { #HELP Pull an image from Docker Hub:\nBOCKER pull <name> <tag> tmp_uuid="$(uuidgen)" && mkdir /tmp/"$tmp_uuid" download-frozen-image-v2 /tmp/"$tmp_uuid" "$1:$2" > /dev/null rm -rf /tmp/"$tmp_uuid"/repositories for tar in $(jq '.[].Layers[]' --raw-output < /tmp/$tmp_uuid/manifest.json); do tar xf /tmp/$tmp_uuid/$tar -C /tmp/$tmp_uuid && rm -rf /tmp/$tmp_uuid/$tar done for config in $(jq '.[].Config' --raw-output < /tmp/$tmp_uuid/manifest.json); do rm -f /tmp/$tmp_uuid/$config done echo "$1:$2" > /tmp/$tmp_uuid/img.source bocker_init /tmp/$tmp_uuid && rm -rf /tmp/$tmp_uuid} function bocker_rm() { #HELP Delete an image or container:\nBOCKER rm <image_id or container_id> [[ "$(bocker_check "$1")" == 3 ]] && echo "No container named '$1' exists" && exit 1 [[ "$(bocker_check "$1")" == 1 ]] && echo "No image named '$1' exists" && exit 1 if [[ -d "$overlay_path/$1" ]];then rm -rf "$overlay_path/$1" && echo "Removed: $1" else umount "$container_path/$1"/merged && rm -rf "$container_path/$1" && ip netns del netns_"$1" && ip link del dev veth0_"$1" && echo "Removed: $1" cgdelete -g "$cgroups:/$1" &> /dev/null fi } function bocker_images() { #HELP List images:\nBOCKER images echo -e "IMAGE_ID\t\tSOURCE" for img in "$overlay_path"/img_*; do img=$(basename "$img") echo -e "$img\t\t$(cat "$overlay_path/$img/img.source")" done} function bocker_ps() { #HELP List containers:\nBOCKER ps echo -e "CONTAINER_ID\t\tCOMMAND" for ps in "$container_path"/ps_*; do ps=$(basename "$ps") echo -e "$ps\t\t$(cat "$container_path/$ps/$ps.cmd")" done} function bocker_run() { #HELP Create a container:\nBOCKER run <image_id> <command> uuid="ps_$(shuf -i 42002-42254 -n 1)" [[ "$(bocker_check "$1")" == 1 ]] && echo "No image named '$1' exists" && exit 1 [[ "$(bocker_check "$uuid")" == 2 ]] && echo "UUID conflict, retrying..." && bocker_run "$@" && return cmd="${@:2}" && ip="$(echo "${uuid: -3}" | sed 's/0//g')" && mac="${uuid: -3:1}:${uuid: -2}" ip link add dev veth0_"$uuid" type veth peer name veth1_"$uuid" ip link set dev veth0_"$uuid" up ip link set veth0_"$uuid" master br1 ip netns add netns_"$uuid" ip link set veth1_"$uuid" netns netns_"$uuid" ip netns exec netns_"$uuid" ip link set dev lo up ip netns exec netns_"$uuid" ip link set veth1_"$uuid" address 02:42:ac:11:00"$mac" ip netns exec netns_"$uuid" ip addr add 172.18.0."$ip"/24 dev veth1_"$uuid" ip netns exec netns_"$uuid" ip link set dev veth1_"$uuid" up ip netns exec netns_"$uuid" ip route add default via 172.18.0.1 mkdir -p "$container_path/$uuid"/{lower,upper,work,merged} && cp -rf --reflink=auto "$overlay_path/$1"/* "$container_path/$uuid"/lower > /dev/null && \ mount -t overlay overlay \ -o lowerdir="$container_path/$uuid"/lower,upperdir="$container_path/$uuid"/upper,workdir="$container_path/$uuid"/work \ "$container_path/$uuid"/merged echo 'nameserver 114.114.114.114' > "$container_path/$uuid"/merged/etc/resolv.conf echo "$cmd" > "$container_path/$uuid/$uuid.cmd" cgcreate -g "$cgroups:/$uuid" : "${BOCKER_CPU_SHARE:=512}" && cgset -r cpu.shares="$BOCKER_CPU_SHARE" "$uuid" : "${BOCKER_MEM_LIMIT:=512}" && cgset -r memory.limit_in_bytes="$((BOCKER_MEM_LIMIT * 1000000))" "$uuid" cgexec -g "$cgroups:$uuid" \ ip netns exec netns_"$uuid" \ unshare -fmuip --mount-proc \ chroot "$container_path/$uuid"/merged \ /bin/sh -c "/bin/mount -t proc proc /proc && $cmd" \ 2>&1 | tee "$container_path/$uuid/$uuid.log" || true ip link del dev veth0_"$uuid" ip netns del netns_"$uuid"} function bocker_exec() { #HELP Execute a command in a running container:\nBOCKER exec <container_id> <command> [[ "$(bocker_check "$1")" == 3 ]] && echo "No container named '$1' exists" && exit 1 cid="$(ps o ppid,pid | grep "^$(ps o pid,cmd | grep -E "^\ *[0-9]+ unshare.*$1" | awk '{print $1}')" | awk '{print $2}')" [[ ! "$cid" =~ ^\ *[0-9]+$ ]] && echo "Container '$1' exists but is not running" && exit 1 nsenter -t "$cid" -m -u -i -n -p chroot "$container_path/$1"/merged "${@:2}"} function bocker_logs() { #HELP View logs from a container:\nBOCKER logs <container_id> [[ "$(bocker_check "$1")" == 3 ]] && echo "No container named '$1' exists" && exit 1 cat "$container_path/$1/$1.log"} function bocker_commit() { #HELP Commit a container to an image:\nBOCKER commit <container_id> <image_id> [[ "$(bocker_check "$1")" == 3 ]] && echo "No container named '$1' exists" && exit 1 [[ "$(bocker_check "$2")" == 0 ]] && echo "Image named '$2' exists" && exit 1 mkdir "$overlay_path/$2" && cp -rf --reflink=auto "$container_path/$1"/merged/* "$overlay_path/$2" && sed -i "s/:.*$/:$(date +%Y%m%d-%H%M%S)/g" "$overlay_path/$2"/img.source echo "Created: $2"} function bocker_help() { #HELP Display this message:\nBOCKER help sed -n "s/^.*#HELP\\s//p;" < "$1" | sed "s/\\\\n/\n\t/g;s/$/\n/;s!BOCKER!${1/!/\\!}!g"} [[ -z "${1-}" ]] && bocker_help "$0" && exit 1case $1 in pull|init|rm|images|ps|run|exec|logs|commit) bocker_"$1" "${@:2}" ;; *) bocker_help "$0" ;;esac README Bocker 使用100行bash实现一个docker,本脚本是依据bocker实现,更换了存储驱动,完善了pull等功能。 前置条件 为了脚本能够正常运行,机器上需要具备以下组件: overlayfs iproute2 iptables libcgroup-tools util-linux >= 2.25.2 coreutils >= 7.5 大部分功能在centos7上都是满足的,overlayfs可以通过modprobe overlay挂载。 另外你可能还要做以下设置: 创建bocker运行目录 /var/lib/bocker/overlay,/var/lib/bocker/containers 创建一个IP地址为 172.18.0.1/24 的桥接网卡 br1 确认开启IP转发 /proc/sys/net/ipv4/ip_forward = 1 创建iptables规则将桥接网络流量转发至物理网卡,示例:iptables -t nat -A POSTROUTING -s 172.18.0.0/24 -o eth0 -j MASQUERADE 实现的功能 dockerbuild + dockerpull dockerimages dockerps dockerrun dockerexec dockerlogs dockercommit dockerrm/dockerrmi Networking Quota Support / CGroups +bocker init 提供了有限的 bocker build 能力 四、总结 到此本文要介绍的内容就结束了,正如开篇我们提到的,写出最终的脚本实现这样一个小玩意并没有什么实用价值,真正的价值是我们通过100行左右的脚本,以交互式的方式去理解Docker的核心技术点。在工作中与容器打交道时能有更多的思路去排查、解决问题。 END 猜你喜欢 Dubbo 中 Zookeeper 注册中心原理分析 委派模式——从SLF4J说起 vivo 故障定位平台的探索与实践 规则引擎Drools在贷后催收业务中的应用 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 数据存储,链表还是数组?

引言 链表和数组是两种不同的数据存储方式。链表是一种物理存储单元上非连续、非顺序的存储结构,数据元素的逻辑顺序是通过链表中的指针链接次序实现的。数组是把具有相同类型的若干元素按有序的形式组织起来的一种形式,数组中的各元素的存储是有先后顺序的,它们在内存中按照这个先后顺序连续存放在一起。本文将对这两种存储方式的优缺点做一个大致的介绍,并详细介绍链表在操作系统中定义和使用的方式。 一、链表和数组 链表是链式的存储结构,数组是顺序的存储结构,其在内存存储上的不同形式决定了其各自的特点。 链表通过指针来链接元素,链表中的结点顺序关系由指针来体现;数组将元素按次序依次存储,元素顺序关系由元素在数组中的位置(下标)确定。 链表节点的存储单元在程序执行时动态向系统申请,链表的结点个数可按需要增减;数组元素的存储单元在数组定义时分配,其元素个数是固定的,对于不是固定长度的列表,用可能最大长度的数组来描述。 链表插入删除元素不需要移动元素,且较为容易实现长度扩充,但是寻找某个元素较为困难;数组寻找某个元素较为简单,但插入与删除比较复杂。 总体来说,链表使用指针将一系列数据节点链接成数据链,相对于数组,它具有良好的动态性,建立链表时不需要提前知道数据量,可以随时分配空间,可以高效地在链表中的任意位置插入或者删除数据。操作系统中存在着大量的基础数据结构链表和链表项,理解链表对理解操作系统至关重要。 二、单向链表和双向链表 通常链表数据结构包含两部分,一部分是数据域,用于存储数据;另外一部分是指针域,用于建立与其它节点的关系。链表项中可以包含一个指向下一个链表项的指针而不包含指向上一个链表的指针,也可以两者都包含,前者称为单向链表,后者为双向链表。 OneOS物联网操作系统中提供的链表不包含数据域,使用时不是在链表结构中包含数据,而是在用户的数据结构中包含链表节点,操作系统中提供了双向链表及单向链表的一些比较通用的操作接口。 2.1 单向链表 OneOS操作系统中的单向链表包含一个节点指针,这个节点指针指向下一个节点。OneOS操作系统中的单向链表是一个非循环链表,单向链表本身首尾并非相连,单向链表中的最后一个节点指向OS_NULL(循环链表单向链表中的最后一个节点指向单向链表中的第一个节点),其示意图如下所示。 OneOS操作系统中单向链表节点的结构体如下所示。 struct os_slist_node { struct os_slist_node *next; /* Point to next node */ }; 2.2 双向链表 OneOS操作系统中的双向链表包含了两个结点指针,一个节点指针指向下一个节点,另一个节点指针指向上一个节点。OneOS操作系统中的双向链表是一个循环链表,双向链表本身首尾相连,双向链表最后一个节点的指向下一个节点的节点指针指向第一个节点,第一个节点的指向上一个节点的节点指针指向最后一个节点,其示意图如下所示。 OneOS操作系统中双向链表节点的结构体如下所示。 struct os_list_node { struct os_list_node *next; /* Point to next node */ struct os_list_node *prev; /* point to previous node */ }; 三、应用示例 单向链表应用示例 #include <oneos_config.h>#include <dlog.h>#include <os_errno.h>#include <shell.h>#include <string.h>#include <os_memory.h>#include <os_list.h> #define TEST_TAG "TEST" #define STUDENT_NUM 10#define TEST_NAME_MAX 16 char *name[STUDENT_NUM] = {"xiaoming", "xiaohua", "xiaoqiang", "xiaoli", "xiaofang", "zhangsan", "lisi", "wangwu", "zhaoliu", "qianqi"};uint32_t score[STUDENT_NUM] = {70, 83, 68, 80, 88, 86, 78, 92, 55, 82}; struct student_score { os_slist_node_t list_node; char name[TEST_NAME_MAX]; uint32_t id; uint32_t score; };typedef struct student_score student_score_t; void single_list_sample(void) { uint32_t i = 0; os_slist_node_t list_head = OS_SLIST_INIT(list_head); student_score_t *data; os_slist_node_t *node_temp; os_slist_node_t *node; LOG_W(TEST_TAG, "single_list_sample insert data"); for (i = 0; i < STUDENT_NUM; i++) { data = os_malloc(sizeof(student_score_t)); data->id = i; memset(data->name, 0, TEST_NAME_MAX); strncpy(data->name, name[i], TEST_NAME_MAX); data->score = score[i]; if (i < STUDENT_NUM/2) { LOG_W(TEST_TAG, "insert tail -- id:%d score:%d name:%s", data->id, data->score, data->name); os_slist_add_tail(&list_head, &data->list_node); } else { LOG_W(TEST_TAG, "insert front-- id:%d score:%d name:%s", data->id, data->score, data->name); os_slist_add(&list_head, &data->list_node); } } LOG_W(TEST_TAG, "single_list_sample show result"); os_slist_for_each(node, &list_head) { data = os_slist_entry(node, student_score_t, list_node); LOG_W(TEST_TAG, "id:%d score:%d name:%s", data->id, data->score, data->name); } LOG_W(TEST_TAG, "single_list_sample list_len is:%d", os_slist_len(&list_head)); LOG_W(TEST_TAG, "single_list_sample delete the score less than 60"); os_slist_for_each_safe(node, node_temp, &list_head) { data = os_slist_entry(node, student_score_t, list_node); if (data->score < 60) { LOG_W(TEST_TAG, "delete -- id:%d score:%d name:%s", data->id, data->score, data->name); os_slist_del(&list_head, &data->list_node); os_free(data); } } LOG_W(TEST_TAG, "single_list_sample list_len is:%d", os_slist_len(&list_head)); LOG_W(TEST_TAG, "single_list_sample show result, and then delete"); os_slist_for_each_safe(node, node_temp, &list_head) { data = os_slist_entry(node, student_score_t, list_node); LOG_W(TEST_TAG, "delete -- id:%d score:%d name:%s", data->id, data->score, data->name); os_slist_del(&list_head, &data->list_node); os_free(data); } LOG_W(TEST_TAG, "single_list_sample list_len is:%d", os_slist_len(&list_head)); } SH_CMD_EXPORT(test_single_list, single_list_sample, "test single list"); 运行结果 sh>test_single_list W/TEST: single_list_sample insert data W/TEST: insert tail -- id:0 score:70 name:xiaoming W/TEST: insert tail -- id:1 score:83 name:xiaohua W/TEST: insert tail -- id:2 score:68 name:xiaoqiang W/TEST: insert tail -- id:3 score:80 name:xiaoli W/TEST: insert tail -- id:4 score:88 name:xiaofang W/TEST: insert front-- id:5 score:86 name:zhangsan W/TEST: insert front-- id:6 score:78 name:lisi W/TEST: insert front-- id:7 score:92 name:wangwu W/TEST: insert front-- id:8 score:55 name:zhaoliu W/TEST: insert front-- id:9 score:82 name:qianqi W/TEST: single_list_sample show result W/TEST: id:9 score:82 name:qianqi W/TEST: id:8 score:55 name:zhaoliu W/TEST: id:7 score:92 name:wangwu W/TEST: id:6 score:78 name:lisi W/TEST: id:5 score:86 name:zhangsan W/TEST: id:0 score:70 name:xiaoming W/TEST: id:1 score:83 name:xiaohua W/TEST: id:2 score:68 name:xiaoqiang W/TEST: id:3 score:80 name:xiaoli W/TEST: id:4 score:88 name:xiaofang W/TEST: single_list_sample list_len is:10 W/TEST: single_list_sample delete the score less than 60 W/TEST: delete -- id:8 score:55 name:zhaoliu W/TEST: single_list_sample list_len is:9 W/TEST: single_list_sample show result, and then delete W/TEST: delete -- id:9 score:82 name:qianqi W/TEST: delete -- id:7 score:92 name:wangwu W/TEST: delete -- id:6 score:78 name:lisi W/TEST: delete -- id:5 score:86 name:zhangsan W/TEST: delete -- id:0 score:70 name:xiaoming W/TEST: delete -- id:1 score:83 name:xiaohua W/TEST: delete -- id:2 score:68 name:xiaoqiang W/TEST: delete -- id:3 score:80 name:xiaoli W/TEST: delete -- id:4 score:88 name:xiaofang W/TEST: single_list_sample list_len is:0 双向链表应用示例 #include <oneos_config.h>#include <dlog.h>#include <os_errno.h>#include <shell.h>#include <string.h>#include <os_memory.h>#include <os_list.h> #define TEST_TAG "TEST" #define STUDENT_NUM 10#define TEST_NAME_MAX 16 char *name[STUDENT_NUM] = {"xiaoming", "xiaohua", "xiaoqiang", "xiaoli", "xiaofang", "zhangsan", "lisi", "wangwu", "zhaoliu", "qianqi"};uint32_t score[STUDENT_NUM] = {70, 83, 68, 80, 88, 86, 78, 92, 55, 82}; struct student_score { os_list_node_t list_node; char name[TEST_NAME_MAX]; uint32_t id; uint32_t score; };typedef struct student_score student_score_t; void list_sample(void) { uint32_t i = 0; os_list_node_t list_head = OS_LIST_INIT(list_head); student_score_t *data; student_score_t *data_temp; os_list_node_t *node; os_list_node_t *node_temp; LOG_W(TEST_TAG, "list_sample insert data"); for (i = 0; i < STUDENT_NUM; i++) { data = os_malloc(sizeof(student_score_t)); data->id = i; memset(data->name, 0, TEST_NAME_MAX); strncpy(data->name, name[i], TEST_NAME_MAX); data->score = score[i]; if (i < STUDENT_NUM/2) { LOG_W(TEST_TAG, "insert tail -- id:%d score:%d name:%s", data->id, data->score, data->name); os_list_add_tail(&list_head, &data->list_node); } else { LOG_W(TEST_TAG, "insert front-- id:%d score:%d name:%s", data->id, data->score, data->name); os_list_add(&list_head, &data->list_node); } } LOG_W(TEST_TAG, "list_sample show result"); os_list_for_each_entry(data, &list_head, student_score_t, list_node) { LOG_W(TEST_TAG, "id:%d score:%d name:%s", data->id, data->score, data->name); } LOG_W(TEST_TAG, "list_sample list_len is:%d", os_list_len(&list_head)); LOG_W(TEST_TAG, "list_sample delete the score less than 60"); os_list_for_each_entry_safe(data, data_temp, &list_head, student_score_t, list_node) { if (data->score < 60) { LOG_W(TEST_TAG, "delete -- id:%d score:%d name:%s", data->id, data->score, data->name); os_list_del(&data->list_node); os_free(data); } } LOG_W(TEST_TAG, "list_sample list_len is:%d", os_list_len(&list_head)); LOG_W(TEST_TAG, "list_sample show result, and then delete"); os_list_for_each_safe(node, node_temp, &list_head) { data = os_list_entry(node, student_score_t, list_node); LOG_W(TEST_TAG, "delete -- id:%d score:%d name:%s", data->id, data->score, data->name); os_list_del(&data->list_node); os_free(data); } LOG_W(TEST_TAG, "list_sample list_len is:%d", os_list_len(&list_head)); } SH_CMD_EXPORT(test_list, list_sample, "test list"); 运行结果 sh>test_list W/TEST: list_sample insert data W/TEST: insert tail -- id:0 score:70 name:xiaoming W/TEST: insert tail -- id:1 score:83 name:xiaohua W/TEST: insert tail -- id:2 score:68 name:xiaoqiang W/TEST: insert tail -- id:3 score:80 name:xiaoli W/TEST: insert tail -- id:4 score:88 name:xiaofang W/TEST: insert front-- id:5 score:86 name:zhangsan W/TEST: insert front-- id:6 score:78 name:lisi W/TEST: insert front-- id:7 score:92 name:wangwu W/TEST: insert front-- id:8 score:55 name:zhaoliu W/TEST: insert front-- id:9 score:82 name:qianqi W/TEST: list_sample show result W/TEST: id:9 score:82 name:qianqi W/TEST: id:8 score:55 name:zhaoliu W/TEST: id:7 score:92 name:wangwu W/TEST: id:6 score:78 name:lisi W/TEST: id:5 score:86 name:zhangsan W/TEST: id:0 score:70 name:xiaoming W/TEST: id:1 score:83 name:xiaohua W/TEST: id:2 score:68 name:xiaoqiang W/TEST: id:3 score:80 name:xiaoli W/TEST: id:4 score:88 name:xiaofang W/TEST: list_sample list_len is:10 W/TEST: list_sample delete the score less than 60 W/TEST: delete -- id:8 score:55 name:zhaoliu W/TEST: list_sample list_len is:9 W/TEST: list_sample show result, and then delete W/TEST: delete -- id:9 score:82 name:qianqi W/TEST: delete -- id:7 score:92 name:wangwu W/TEST: delete -- id:6 score:78 name:lisi W/TEST: delete -- id:5 score:86 name:zhangsan W/TEST: delete -- id:0 score:70 name:xiaoming W/TEST: delete -- id:1 score:83 name:xiaohua W/TEST: delete -- id:2 score:68 name:xiaoqiang W/TEST: delete -- id:3 score:80 name:xiaoli W/TEST: delete -- id:4 score:88 name:xiaofang W/TEST: list_sample list_len is:0 更详细的API介绍欢迎前往OneOS官网文档中心查看。 文档中心 (10086.cn) OneOS源码仓库:https://gitee.com/cmcc-oneos/OneOS

优秀的个人博客,低调大师

每日一博 | 代码影响范围工具探索

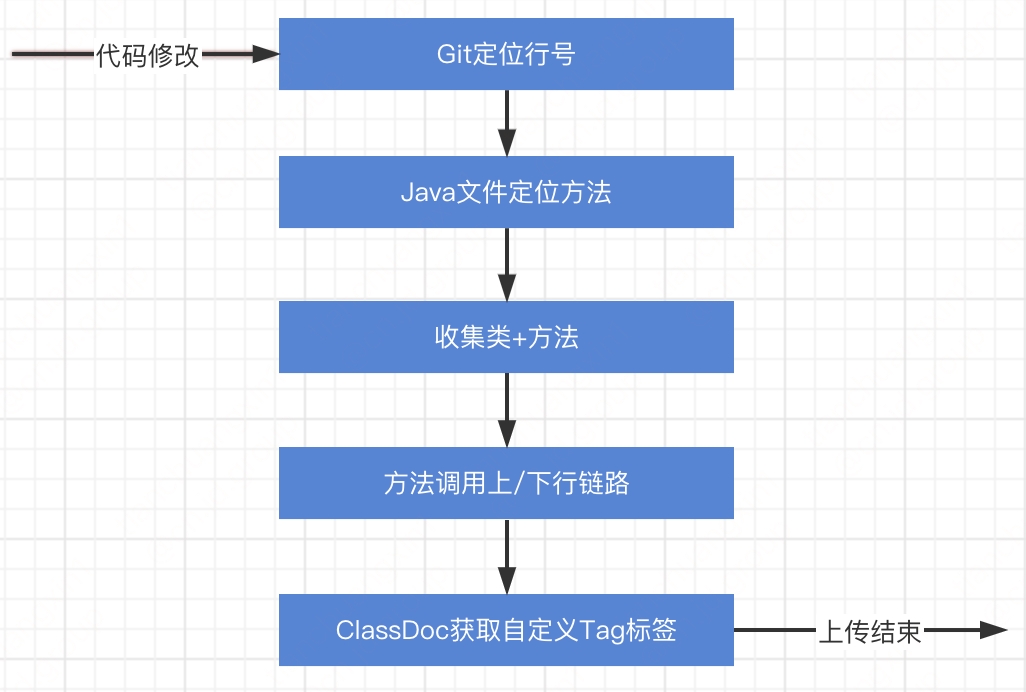
作者:京东零售田创新、耿蕾 一、背景 1.祖传代码不敢随意改动,影响范围无法评估。并且组内时常有因为修改了某块代码,导致其他业务受到影响,产生bug,影响生产。 2.研发提测完成后,测试进入测试后经常会向研发询问本次需求改动影响范围,以此来确定测试用例,以达到精准测试,提升整个需求的质量,缩短交付周期。 那么,如何才能规避这种隐患?有没有一种工具能够协助代码研发及review人员更加精确的判断当前代码改动影响范围,有没有一种方法能够提供除了业务逻辑条件验证,针对代码作用范围,给测试人员提供精确验证链路? 二、方案调研 技术方案调研 经过各方资料查找及比对,最终我们整理了两个满足我们需求的方案: 1.IDEA提供了显示调用指定Java方法向上的完整调用链的功能,可以通过“Navigate -> Call Hierarchy”菜单(快捷键:control+option+H)使用,缺点是并没有向下的调用链生成。 2.开源框架调研:wala/soot静态代码分析工具。 针对上述的调研,大致确认了两种方案,集中分析两种方案的优劣,来制定符合我们目前情况的方案: 工具名称 优势 劣势 是否符合 Call Hierarchy 支持方法向上调用链 功能比较单一,数据无操作性 否 wala/soot静态代码分析 能够完善的分析Java中任何逻辑包括方法调用链,且满足我们目前的需求 臃肿,复杂繁琐,功能过于庞大 否 经过前期的比较以及相关工具的资料调研、工具功能分析,并考虑到后期一些个性化功能定制开发,以上工具不太满足我们目前的需求,所以决定自己动手,丰衣足食,尝试重新开发一个能够满足我们需求的工具,来协助研发以及测试人员。 三、方案制定 预期:工具尽量满足全自动化,研发只需要接入即可,减少研发参与,提升整个调用链展示和测试的效率。并且调用链路应该在研发打包的过程中触发,然后将数据上传至服务端,生成调用链路图。 上述方案制定完成后,需要进一步确认实现步骤。前期我们确认了工具的大概的方向,并进行步骤分解,根据具体的功能将整个工具拆分成六个步骤 1.确认修改代码位置(行号)。与git代码管理关联,能够使用git命令,去提取研发最近一次提交代码的有变动的代码行数。 2.根据步骤1确认收集到影响的类+方法名+类变量。 3.根据2中确认的类+方法名称生成向上和向上的调用链。包括jar/aar包。 4.根据3中生成的调用链完成流程图的展示。 5.自定义注释标签Tag说明当前业务,并提取Tag内容。 6.本地数据生成并上传服务端生成调用流程图。 整体流程图如下: 四、方案实施 1.定位源代码修改位置行号。 ​ 首先我们使用 git diff --unified=0 --diff-filter=d HEAD~1 HEAD命令 输出最近一次提交修改的内容,且已只git diff 会按照固定格式输出。 ​ 通过提交增、删、改的修改,执行git diff命令,对输出内容进行观察。 ​ 举例:某次提交修改了两个文件,如下 ​ RecommendVideoManager.java ScrollDispatchHelper.java git diff命令执行后,输出以下内容: 技术方案: a.按行读取输出内容,读取到到diff 行,则识别为一个新的文件,并用正则表达式提取文件名 : String[] lines = out.toString().split("\\r?\\n"); Pattern pattern = Pattern.compile("^diff --git a/\\S+ b/(\\S+)"); b.用正则表达式提取 @@ -149 +148,0 @@ ,用来解析代码修改行数: Pattern pattern = Pattern.compile("^@@ -[0-9]+(,[0-9]+)? \\+([0-9]+)(,[0-9]+)? @@"); c.针对我们的需求,我们只关心本次修改影响的是那个方法,不关心具体影响了哪些行数,所以我们只需要 int changeLineStart = Integer.parseInt(m.group(2)); 就拿到了本次修改,修改开始的代码行数, 在结合ASM就可以获取到本次改动影响的具体方法。 2.利用获取的行号定位具体的方法。 ​ 根据上述1步骤中定位出研发每次提交的修改的Java源文件和改动的行号位置,我们需要定位修改代码行号所归属的方法名称,再由方法名称+类名+包名去定位本次修改的影响链路。 如何去定位? 首先确定的是,研发在工程中只能修改的是工程中的源文件,所以我们可以在遍历收集整个工程的源文件的过程中根据已知的修改行号来确定修改的方法名称,进而知道整个方法的调用链路。而对对于那些没有落到方法体范围之内的行号,基本上可以确认为类变量或常量,考虑到对于常量修改也可能影响到业务逻辑,所以我们也会对修改的Field进行上下调用的范围的查找,所以需要记录。所以整个过程分成两个部分: ​ a.遍历源码Class文件,获取整个类的Field; ​ b.遍历Class文件的过程中,通过visitMethod遍历整个方法体,记录方法的初始行号和结束行号,来定位方法; 首先是a部分,确认Field,ClassVisitor提供现成的方法: @Override public FieldVisitor visitField(int access, String name, String desc, String signature, Object value) { Log.i("jingdong","Field name is :%s desc is %s: ",name,desc); return super.visitField(access, name, desc, signature, value); } 所以我们可以在文件中直接获得整个类的Field。然后去根据行数去判断是否有对Fields有修改。如果Fields有修改,那么我们可以根据上述方法去比对,那么就可以获得哪个Field被修改。 接下来是b部分,在遍历Class文件的过程中,通过visitMethod方法,重写AdviceAdapter类来提供MethodVisitor,在遍历过程中,完确定研发修改影响的类及方法,具体实现可分为以下步骤: 2.1 获取源文件编译好的Class文件; apk的编译过程中有很多的task需要执行,各个任务环环相扣有序的执行,我们要获取编译好的Class文件,需要在特定的任务之间。我们知道在Java Compiler之后,不管是R.java抑或是aidl,再或者是Java interfaces都会编译成.class文件,在编译完成后会接着完成dex的编译,所以我们尽可能的在dex编译之前完成class文件的处理,这种仅仅是考虑到宿主或者单独的插件工程方案,但是对于主站业务来说,会有各种各样的组件aar,aar的编译编译不会走dex编译,所以针对这些组件工程,我们也需要考虑到,简单的方式就是我们去监听aar编译的task,然后再做一些处理,所以在Plugin的apply方法中需要进行区分处理,代码如下: project.afterEvaluate { def android = project.extensions.android def config = project.method if (config.enable) { //应用级别 if (project.plugins.hasPlugin('com.android.application')) { android.applicationVariants.all { variant -> MethodTransform.inject(project, variant) } }else{ //aar编译处理-- //这里我们是在compileReleaseJavaWithJavac之后运行自定义Task Task javaWithJavacTask = project.tasks.findByName("compileReleaseJavaWithJavac") if (javaWithJavacTask != null) { def customTask = project.tasks.create("JDcustomTask", JdParseClassTask.class) javaWithJavacTask.finalizedBy(customTask) }else { new GradleException("创建task失败~~") } } } } 两者的处理逻辑一致,也就是在Task的监听有些区别,所以下面我们不重复复述,以MethodTransform为主线进行讲解。 那有的同学就问了,为啥我们不直接对源文件.java文件进行处理呢? 因为,就目前京东主站项目而言,各个aar模块相互调用,如果我们仅仅使用源文件进行扫描,各个aar或者jar包的调用链会断掉不全面,影响代码review人员及测试人员的测试用例完整度。 接下来是代码实现,我们监听任务执行,并针对需要监听的任务开展我们的Class收集操作: //Project project.getGradle().getTaskGraph().addTaskExecutionGraphListener(new TaskExecutionGraphListener() { @Override public void graphPopulated(TaskExecutionGraph taskGraph) { for (Task task : taskGraph.getAllTasks()) { //对满足我们需求的Task执行前, if(task.name.equalsIgnoreCase("transformClassesWithDexForDebug")){ //执行我们的TrasnsformTask //省略。。。。 }}}}) 2.2 排除非class文件的干扰,对源文件路径进行递归遍历; 代码的编译长短对研发的影响很大,所以编译时长很宝贵,需要我们尽量的减少编译的时长,所以我们在执行我们自定义的Transform过程中,需要过滤并排除非Class文件,减少不必要的浪费。经过整理主要为:R文件以及R文件的内部类R$*文件,包括R$string、R$styleable等等,所以,在遍历处理过程中我们需要对R文件及R$*文件过滤。 public static final String[] UN_VISITOR_CLASS = {"R.class", "R$"}; 2.3 提供ClassVisitor类和MethodClass去搜集Class及对应Method,并定位 这个步骤是最主要的一部分,这一部分主要获取两部分数据,第一部分是研发修改直接影响到的类和方法;第二部分是遍历整个源文件的所获得的类信息,主要包括类+各个方法以及各个方法体,也就是方法中的指令; 在拿到transformInvocation后我们进行源文件文件夹遍历和所有jar包的遍历,在外层我们定义好存储被影响的类列表(changedClassesList),和包含类信息的列表(classesInfoList),将两个列表作为参数,传递进去在遍历过程中赋值。这里值得注意的是,在进行jar解析过程中不需要进行changedClassesList,因为对于本工程来说研发人员不会直接对jar文件中文件操作。 //修改类列表 List<LinkedClassInfo> changedClassesList = new ArrayList<>() //类信息列表 List<Map<String, List<Map<String, List<MethodInsInfo>>>>> classesInfoList = new ArrayList<Map<String, List<Map<String, List<MethodInsInfo>>>>>() transformInvocation.inputs.each { TransformInput input -> //所有源文件生成的class input.directoryInputs.each { DirectoryInput dirInput -> collectDir(dirInput, isIncremental, classesInfoList, changedClassesList) } //所有jar包集合 input.jarInputs.each { JarInput jarInput -> if (jarInput.getStatus() != Status.REMOVED) { //可以取到jar包集合 collectJar(jarInput, isIncremental, classesInfoList,jarOutputFile) } } } 在对源文件遍历过程中,我们进行定位搜寻。 遍历源文件根节点并读取: if (file != null) { //根布局目录进行循环遍历 File[] files = file.listFiles() files.each { File f -> if (f.isDirectory()) { collectJar(f, classList,changedClasss,changedLineInfoMap) } else { boolean isNeed = true //对文件类型进行校验,排除一些无意义的配置性文件 //省略。。。 if (isNeed) { try { //类集合(包含:类名+方法名+方法指令) Map<String, List<Map<String, List<MethodInsInfo>>>> mClassMethodsList = new HashMap<String, List<Map<String, List<MethodInsInfo>>>>() ClassReader cr = new ClassReader(new FileInputStream(f)) ClassWriter cw = new ClassWriter(ClassWriter.COMPUTE_FRAMES) //重写ClassVisitorAdapter ClassVisitorAdapter ca = new ClassVisitorAdapter(cw, mClassMethodsList,changedClasss ,changedLineInfoMap ) cr.accept(ca, ClassReader.EXPAND_FRAMES) classList.add(mClassMethodsList) //将类的整个方法和指令加进去 } catch (RuntimeException re) { re.printStackTrace() } catch (IOException e) { e.printStackTrace() } } } } } 重写ClassVisitor,ASM提供的visit方法可以很方便的去识别这个类的各种信息,而我们用到的信息为两种,一种是接口类型的判定,一种是当前类的类名。对于接口,我们没有必要去进行Method的访问,对获得的类名信息我们进行判定当前类是否是git最后提交有做过修改的的类: @Override public void visit(int version, int access, String name, String signature, String superName, String[] interfaces) { cv.visit(version, access, name, signature, superName, interfaces); owner = name;//类名 //判定不为接口类型 isInterface = (access & Opcodes.ACC_INTERFACE) != 0; //这里判断是否修改是否包含此类 if (this.mChangedLineInfoMap!=null&&mChangedLineInfoMap.size()>0){ for (Map.Entry<String,ChangedLineInfo> changedLineInfoEntry:this.mChangedLineInfoMap.entrySet()){ String filePath = changedLineInfoEntry.getKey(); if(filePath.contains(owner)){ //包含此类 linkedClassInfo= new LinkedClassInfo(); linkedClassInfo.className = owner; mChangedLineInfo= changedLineInfoEntry.getValue(); methodNameList = new ArrayList<>(); linkedClassInfo.methodNameList = methodNameList; } } } } `在上述的visit中我们定位了当前类是否与上次git提交的是否有关,接下来我们需要MethodVisitor中进行有选择的拦截对应的Method的访问。 重写MethodVisitor在visitMethod中进行拦截处理,如果git修改相关在当前类中,则我们在访问Method时,进行方法体行数定位。 mv = new MethodVisterAdapter(mv, owner, access, //省略。。。 mChangedLineInfo //更改行数位置 ); 在MethodVisitor中,我们可以通过系统方法定位访问方法的每条方法指令及指令对应的行数,所以我们只要重写visitLineNumber方法即可实时的在visitMethodInsn方法中拿到方法体访问行数,这里有个小的注意点就是,我们在调用visitLineNumber返回的line不是我们理解意义上的方法名称部分开始,而是从方法体的第一行代码计算开始,所以我们在做判断的时候,需要注意,相对方法体的首行,我们更关心方法体的变更,所以我们只需要判定落在visitMethodInsn中的更改即可。有需要更加精细的判定,小伙伴可以进行更加精细的调研。 以下是visitLineNumber方法: @Override public void visitLineNumber(int line, Label start) { this.lineNumber = line;//置换lineNumber super.visitLineNumber(line, start); } 知道了方法体开始的地方,我们也需要知道结束的位置,获取到结束位置后,我们就能轻松的定位到我们需要的定位的方法体,从而获得方法名称,进一步获得类的名称。ASM在MethodVisitor中提供了visitEnd方法,表示方法体访问结束,那么我们就可以在visitEnd中进行定位: @Override public void visitEnd() { super.visitEnd(); int startLine = this.startLineNumber; int endLine = this.lineNumber; boolean isContained = false; if (this.mChangedLineInfo!=null&&mChangedLineInfo.lineNumbers!=null&&mChangedLineInfo.lineNumbers.size()>0){ for (String line : this.mChangedLineInfo.lineNumbers){ if (line!=null){ int lineNum = Integer.parseInt(line); //是否落在xx方法中 if (lineNum>=startLine&&lineNum<=endLine){ isContained = true; break; } } } } if (isContained&&this.methodNameList!=null){ //包含在此方法中 MethodName nameContained = new MethodName(); nameContained.methodName = name; this.methodNameList.add(nameContained); } //保存 methodInsMapList.put(name, mMethodInsInfoList); } 至此,我们通过自定义ClassVisitor和MethodVisitor完成了对源文件的搜集和定位。 总结一下思路:首先我们拉取了研发最后一次在Git上提交的代码,通过分析并找出规律,配合正则表达式匹配的方式,拿到修改的后缀为java的文件,又进一步的寻找规律筛选出对应java文件修改的行号;其次遍历工程源文件,利用自定义ClassVisitor和MethodVisitor进行类信息的收集包括类名、方法以及方法体指令,并在访问过程中提交后有修改痕迹的文件通过行号进行定位;最后完成收集集合的填充。这整个过程中用到很多比较重要方法,比如:CLassVisitor中的visit、visitMethod、visitEnd,以及MethodVisitor中的visitLineNumber、visitMethodInsn、visitEnd等。 3.遍历查找对应方法的上行链路和下行链路 在二步骤中完成了定位类与方法,并且完成了整个工程的源文件遍历收集,接下来就能逐步的整理出来,修改方法在整个工程中所带来的影响, 3.1 方法上行链路数据生成; 这一步骤相对来说比较简单,对于在上一步骤中,我们得到的上次的git提交定位数据,及整个工程的源文件类中方法信息的集合,我们只需要将改变的list集合在工程源文件信息集合递归循环,便能得到对应方法的上行调用链。而遍历的思路则是,递归向上扫描调用了变更集合中的类以及方法,以此递归循环遍历,只要调用到相关联的方法就被收集,对于Android应用来说,研发所写业务逻辑,基本上终止于Activity或者Applicantion中,所以向上的是有终点的。 如下是一个简图: 3.2方法下行链路数据生成; 方法的下行链路相比上行链路来说更为分散,需要我们去定位变更方法体中所有的指令,也就是扫描方法体,以及方法体各个指令的上行链路,并且在日常的开发过程中,我们的方法中有很大一部分调用的系统API,所以下行链路的扫描对比上行链路更为复杂。而对于研发或者测试,系统的API可能对我们的影响较小,所以在扫描下行链路的过程中,我们需要去识别当前方法体指令是否为系统API。 在识别去除系统API后,剩下的即是我们的业务逻辑方法,那么又回到了方法体中各个指令的上行链路扫描,方法跟上行链路一致。 对于系统的API以及一些三方库,我们大致总结了一下几种,供大家参考: public static final String[] SYSTEM_PACKAGES = {"java/*", "javax/*", "android/*", "androidx/*","retrofit2/*","com/airbnb/*","org/apache/*"}; 示意图如下: 至此,我们完成了方法上/下行链路的搜索。 4.注释及自定义Tag 上面三个步骤,我们们完成了对应方法上/下行链路功能开发,但是整条链路上只是包含了对应的类名+方法名,对于研发来讲,对应的类的作用以及方法的实现是什么逻辑比较清楚,但是仅仅局限于研发,对于测试人员可能没什么用,也只是一堆代码而已。针对这一问题,我们想到了注释,各个研发组在很早之前就开始接入京东自研的EOS来规范代码的注释,经过这么长时间的打磨也趋于完善。我们可以通过注释的方式来与对应的业务逻辑。我们设想能够通过某些手段去完成注释的获取,但是,注释可能也不能完全的去表达当前的业务逻辑,我们还需要提供具体的业务逻辑标注。 怎么解决呢?其实,总结起来就是,我们要说明上/下行链路涉及到的类和方法解释以及业务说明,并且可以利用一些特殊的标记去完成对应的一些特殊逻辑说明。 基于代码的注释,我们可以很容易的想到JavaDoc,包括Android的开发环境Android studio中也自带了可以生成源文件的javadoc(路径:Tools-->Generate JavaDoc),执行命令后几秒钟后,生成了一份完整的文档。 既然自带的工具可以完成Java文件注释的提取,那么我们也可以在代码中获取到对应的注释,经过相关资料,了解到,JDK中自带的tools.jar包可以完成JavaDoc的提取。 在将tools包上传Maven后在gradle中进行依赖,基本就完成了环境的配置。经过多方资料的查找及demo实验,tools包支持命令的形式生JavaDoc。这里需要注意的是,我们不需要html形式的javadoc文档形式,所以需要进行一些自定义的东西来达到我们自己的要求。 官方文档是这样说的: If you run javadoc without the-docletcommand-line option, it will default to the standard doclet to produce HTML-format API documentation. 也就说,我们需要在命令行中添加 -doclet来进行自定义文档。并且给出自定义的Doclet类: public static class JDDoclet { public static boolean start(RootDoc root) { JDJavaDocReader.root = root; return true; } } 接下来简单的封装tools中的execute方法: public synchronized static RootDoc readDocs(String source, String classpath,String sourcepath) { if (!Strings.isNullOrEmpty(source)){ //java源文件或者为包名 List<String> args = Lists.newArrayList("-doclet", JDDoclet.class.getName(), "-quiet","-encoding","utf-8","-private"); if(!Strings.isNullOrEmpty(classpath)){ args.add("-classpath");//source的class位置,可以为null,如果不提供无法获取完整注释信息(比如无法识别androidx.annotation.NonNull) args.add(classpath); } if(!Strings.isNullOrEmpty(sourcepath)){ args.add("-sourcepath"); args.add(sourcepath); } args.add(source); int returnCode = com.sun.tools.javadoc.Main.execute(JDJavaDocReader.class.getClassLoader(),args.toArray(new String[args.size()])); if(0 != returnCode){ Log.i(TAG,"javadoc ERROR CODE = %d\n", returnCode); } } return root; } 其中命令中参数,感兴趣的小伙伴可以查看官方文档,这里就不再赘述了。 基本封装完成后,就可以直接使用了,但是考虑到在遍历使用的过程中会出现多次调用解析ClassDoc的问题,这里还是建议将解析过的Java文件进行缓存处理,方便直接调用,也能减少整个编译的时间,并且在解析过程中我们也需要排除系统类的解析。 //....略 if(classDoc!=null){ javaDocFile.append("\n\n") //获取类注释并写入文件 javaDocFile.append(classDoc.getClassComment()) javaDocFile.append(className+"\n") doc = classDoc.getClassDoc() } //....略 if (doc!=null){ for (MethodDoc methodDoc : doc.methods()) { //添加自定义Tag methodDoc.tags(MethodBuildConstants.CUSTOM_TAG) if (method.methodName.trim() == methodDoc.name().trim()){ Tag[] tags = methodDoc.tags() if (tags!=null&&tags.length>0){ //取自定义Tag内容 for (int i = 0;i<tags.length;i++){ if (tags[i].name() == "@"+MethodBuildConstants.CUSTOM_TAG){ javaDocFile.append(tags[i].text()+"\n") javaDocFile.append(method.methodName+"\n") } } }else{//如果没有tag则输出对应的所有注释 javaDocFile.append(methodDoc.commentText()+"\n") javaDocFile.append(method.methodName+"\n") } } } } 这里我们也给出自定义Tag,当然,在项目中可以根据自己的业务名称进行命名。 /** * 自定义tag标签 */ public static final String CUSTOM_TAG = "LogicIntroduce"; 完成了功能的开发,我们需要在代码中中进行验证,测试如下: /** * 打印方法(谁调用就会被打印),会打印两次 * @LogicIntroduce 这个是自定义Tag getPrintMethod方法 */ public static void getPrintMethod(){ System.out.println("我被调用了"); getPrintMethod2(); } 当我们的方法调用链涉及到getPrintMethod()时,就会提取@LogicIntroduce标签后面的内容,达到了获取业务逻辑说明注释的目的。这样对于那些不动代码的非研发人员,也能够非常清晰的看懂这部分代码涉及到的业务逻辑,测试也能够着重的进行测试了。 本地输出: 影响类:com/jd/fragment/test/utils/TestUtils.java (测试类) 影响方法: getPrintMethod(这个是自定义Tag getPrintMethod方法) 5.推荐实际业务使用 方法的调用上下链路在上述步骤中已经生成,我们可以在MarkDown中简单的生成调用链,至于要遵循什么样的格式,大家可以自己查阅,相对比较简单不再展开。下面是推荐位最近一次修改涉及到的部分流程图: 代码修改位置输出为: com/jingdong/xxx/RecommendItem.java //被修改的文件 252 //修改的行 向上调用链展示: 向下调用链,我们只取本方法体: 相关Javadoc输出: //上行调用链 影响类:com/jingdong/xxx/RecommendItem(推荐位基础数据bean对象) 影响方法: productExpoData(生成曝光数据给外部使用) generateExpoData(商卡构造曝光用数据) setData(服务端JSON数据解析) 影响类:com/jingdong/xxx/RecommendProductPageView (推荐UI组件) 影响方法: toRecomendList(网络接口返回数据) 影响类:com/jingdong/xxx/RecommendProductPageView$3(服务端数据处理(内部类)) 影响方法: toList(接口数据处理) //下行调用链 影响类:com/jingdong/xxx/RecommendItem(推荐位基础数据bean对象) 影响方法: productExpoData(生成曝光数据给外部使用) -com/jd/xxx/JDJSONObject 五、总结 经过上面的描述,我们整体上完成了再Android端的代码影响范围工具探索,过程中完成了Git定位,生成方法调用的上、下链路,以及通过JDK工具jar包完成注释以及自定义Tag的内容获取,也通过MarkDown生成了对应的流程图。下面是整个工程的流程说明图: 对于这个工具来说,我们仅仅是对Android客户端的探索开发,目前已在推荐组进行试用,使用过程中还有一些问题以及流程需要进一步改善和优化,比如,当一个方法被多处调用则生成的关系图就会过去庞大,不容易被阅读;无法突出调用链节点的一些关键节点;JavaDoc强依赖于研发,如果注释不规范或者不写,那整个链路的说明就会断掉等等,我们会持续性的去优化打磨这个工具,也会在使用过程中添加一些更贴近业务的功能,或者调整部分流程,比如说会在本地编译触发或者手动触发,或者添加一些JavaDoc的模板等等。这些功能会在业务使用过程中进行调整。后续,也会在服务端铺开,逐步的拓展业务面,为我们的业务开发交付降本增效。 参考文档: https://docs.oracle.com/javase/7/docs/technotes/guides/javadoc/doclet/overview.html https://git-scm.com/docs/git-diff

优秀的个人博客,低调大师

每日一博 | 玩转 Go 链路追踪

前言 链路追踪是每个微服务架构下必备的利器,go-zero 当然早已经为我们考虑好了,只需要在配置中添加配置即可使用。 关于 go-zero 如何追踪的原理追溯,之前已经有同学分享,这里我就不再多说,如果有想了解的同学去 https://mp.weixin.qq.com/s/hJEWcWc3PnGfWfbPCHfM9g 这个链接看就好了。默认会在 api 的中间件与 rpc 的 interceptor 添加追踪,如果有不了解 go-zero 默认如何使用默认的链路追踪的,请移步我的开源项目 go-zero-looklook 文档 https://github.com/Mikaelemmmm/go-zero-looklook/blob/main/doc/chinese/12-%E9%93%BE%E8%B7%AF%E8%BF%BD%E8%B8%AA.md。 今天我想讲的是,除了 go-zero 默认在 api 的 middleware 与 rpc 的 interceptor 中帮我们集成好的链路追踪,我们想自己在某些本地方法添加链路追踪代码或者我们想在 api 发送一个消息给 mq 服务时候想把整个链路包含 mq 的 producer、consumer 穿起来,在 go-zero 中该如何做。 场景 我们先简单讲一下我们的小 demo 的场景,一个请求进来调用 api 的 Login 方法,在 Login 方法中先调用 rpc 的 GetUserByMobile 方法,之后在调用 api 本地的 local 方法,紧接着调用 rabbitmq 传递消息到 mq 服务。 go-zero 默认集成了 jaeger、zinpink,这里我们就以 jaeger 为例 我们希望看到的链路是 rpc.GetUserByMobile" data-original="https://img-blog.csdnimg.cn/910d8fbfd04b4c6196b3e38479c1679b.png"> 也就是 api 衍生出来三条子链路,api.producerMq 有一条调用 mq.Consumer 的子链路。 我们想要将一个方法添加到链路中需要两个因素,一个 traceId,一个span,当我们在同一个 traceId 下开启 span 把相关的 span 都串联起来,如果想形成父子关系,就要把 span 之间相互串联起来,因为「微服务实践」公众号中讲解原理太多,我这里就简单提一下不涉及过多,如果不是特别熟悉原理可以看文章开头推荐的文章,这里我们只需要知道 traceId 与 spanId 关系就好。 核心业务代码 1、首先 API 中 LoginLogic 代码 type LoginLogic struct { logx.Logger ctx context.Context svcCtx *svc.ServiceContext } func NewLoginLogic(ctx context.Context, svcCtx *svc.ServiceContext) *LoginLogic { return &amp;LoginLogic{ Logger: logx.WithContext(ctx), ctx: ctx, svcCtx: svcCtx, } } type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (l *LoginLogic) Login(req *types.RegisterReq) (*types.AccessTokenResp, error) { resp, err := l.svcCtx.UserRpc.GetUserByMobile(l.ctx, &amp;usercenter.GetUserByMobileReq{ Mobile: req.Mobile, }) if err != nil { return &amp;types.AccessTokenResp{}, nil } l.local() tracer := otel.GetTracerProvider().Tracer(trace.TraceName) spanCtx, span := tracer.Start(l.ctx, "send_msg_mq", oteltrace.WithSpanKind(oteltrace.SpanKindProducer)) carrier := &amp;propagation.HeaderCarrier{} otel.GetTextMapPropagator().Inject(spanCtx, carrier) producer := rabbit.NewRabbitmqPublisher(RabbitmqDNS) msg := &amp;MsgBody{ Carrier: carrier, Msg: req.Mobile, } b, err := json.Marshal(msg) if err != nil{ panic(err) } if err := producer.Publish(spanCtx, ExchangeName, RoutineKeys, b); err != nil { logx.Errorf("Publish Fail , msg :%s , err:%v", msg, err) } span.End() return &amp;types.AccessTokenResp{ AccessExpire: resp.User.Id, }, err } func (l *LoginLogic) local() { tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _ , span := tracer.Start(l.ctx, "local", oteltrace.WithSpanKind(oteltrace.SpanKindInternal)) defer span.End() // 执行你的代码 ..... } 2、rpc 中 GetUserByMobile 的代码 func (s *Logic) GetUserByMobile(context.Context, *usercenterPb.GetUserByMobileReq) (*usercenterPb.GetUserByMobileResp, error) { vo := &amp;usercenterPb.UserVo{ Id: 1, } return &amp;usercenterPb.GetUserByMobileResp{ User: vo, }, nil } 3、mq 中 Consumer 的代码 type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (c *consumer) Consumer(ctx context.Context, data []byte) error { var msg MsgBody if err := json.Unmarshal(data, &amp;msg); err != nil { logx.Errorf(" consumer err : %v", err) } else { logx.Infof("consumerOne Consumer , msg:%+v", msg) wireContext := otel.GetTextMapPropagator().Extract(ctx, msg.Carrier) tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _, span := tracer.Start(wireContext, "mq_consumer_msg", oteltrace.WithSpanKind(oteltrace.SpanKindConsumer)) defer span.End() } return nil } 代码详解 1、go-zero 默认集成 当一个请求进入 api 后,我们可以在 go-zero 源码中查看到 https://github.com/zeromicro/go-zero/blob/master/rest/engine.go#L92。go-zero 已经在 api 的 middleware 中帮我们添加了第一层 trace,当进入 Login 方法内,我们调用了 rpc 的 GetUserByMobile 方法,通过 go-zero 的源码 https://github.com/zeromicro/go-zero/blob/master/zrpc/internal/rpcserver.go#L55 可以看到在 rpc 的 interceptor 也默认帮我们添加好了,这两层都是 go-zero 默认帮我们做好的。 2、本地方法 当调用完 rpc 的 GetUserByMobile 之后,api 调用了本地的 local,如果我们想在整个链路上体现出来调用了本地 local 方法,那默认的 go-zero 是没有帮我们做的,需要我们手动来添加。 tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _ , span := tracer.Start(l.ctx, "local", oteltrace.WithSpanKind(oteltrace.SpanKindInternal)) defer span.End() // 执行你的代码 ..... 我们通过上面代码拿到 tracer,ctx 之后开启一个 local 的 span,因为 start 时候会从 ctx 获取父 span 所以会将 local 方法与 Login 串联起父子调用关系,这样就将本次操作加入了这个链路 3、mq 的 producer 到 mq 的 consumer 我们在mq传递中如何串联起来这个链路呢?也就是形成 api.Login-&gt;api.producer-&gt;mq.Consumer。 想一下原理,虽然跨越了网络,api 可以通过 header 传递,rpc 可以通过 metadata 传递,那么 mq 是不是也可以通过 header、body 传递就可以了,按照这个想法来看下我门的代码。 tracer := otel.GetTracerProvider().Tracer(trace.TraceName) spanCtx , span := tracer.Start(l.ctx, "send_msg_mq", oteltrace.WithSpanKind(oteltrace.SpanKindProducer)) carrier := &amp;propagation.HeaderCarrier{} otel.GetTextMapPropagator().Inject(spanCtx,carrier) producer := rabbit.NewRabbitmqPublisher(RabbitmqDNS) msg := &amp;MsgBody{ Carrier: carrier, Msg: req.Mobile, } b , err := json.Marshal(msg) if err != nil{ panic(err) } if err := producer.Publish(spanCtx, ExchangeName, RoutineKeys, b); err != nil { logx.Errorf("Publish Fail, msg :%s, err:%v", msg, err) } span.End() 首先获取到了这个全局的 tracer,然后开启一个 producer 的 span,跟 local 方法一样,我们开启 producer 的 span 时候也是通过 ctx 获取到上一级父级 span,这样就可以将 producer 的 span 与 Login 形成父子 span 调用关系,那我们想将 producer 的 span 与 mq 的 consumer 中的 span 形成调用父子关系怎么做?我们将 api.producer 的 spanCtx 注入到 carrier 中,这里我们通过 mq 的 body 将 carrier 发送给 consumer,发送完成我们 stop 我们的 producer,那么 producer 的这层链路完成了。 随后我们来看 mq-consumer 在接收到 body 消息之后怎么做的。 type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (c *consumer) Consumer(ctx context.Context, data []byte) error { var msg MsgBody if err := json.Unmarshal(data, &amp;msg); err != nil { logx.Errorf(" consumer err : %v", err) } else { logx.Infof("consumerOne Consumer , msg:%+v", msg) wireContext := otel.GetTextMapPropagator().Extract(ctx, msg.Carrier) tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _, span := tracer.Start(wireContext, "mq_consumer_msg", oteltrace.WithSpanKind(oteltrace.SpanKindConsumer)) defer span.End() } return nil } consumer 接收到消息后反序列化出来 Carrier *propagation.HeaderCarrier,然后通过 otel.GetTextMapPropagator().Extract 取出来 api.producer 注入的 wireContext,在通过 tracer.Start、wireContext 创建 consumer 的 span,这样 consumer 就是 api.producer 的子 span,就形成了调用链路关系,最终我们得到的关系就是 rpc.GetUserByMobile" data-original="https://img-blog.csdnimg.cn/910d8fbfd04b4c6196b3e38479c1679b.png"> 让我们来调用一下 Logic 方法,看下 jaeger 中的链路如果与我们预想的链路一致,so happy~ 项目地址 go-zero 微服务框架:https://github.com/zeromicro/go-zero https://gitee.com/kevwan/go-zero go-zero 微服务最佳实践项目:https://github.com/Mikaelemmmm/go-zero-looklook 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

每日一博 | 跨机房 ES 同步实战

作者:谢泽华 背景 众所周知单个机房在出现不可抗拒的问题(如断电、断网等因素)时,会导致无法正常提供服务,会对业务造成潜在的损失。所以在协同办公领域,一种可以基于同城或异地多活机制的高可用设计,在保障数据一致性的同时,能够最大程度降低由于机房的仅单点可用所导致的潜在高可用问题,最大程度上保障业务的用户体验,降低单点问题对业务造成的潜在损失显得尤为重要。 同城双活,对于生产的高可用保障,重大的意义和价值是不可言喻的。表面上同城双活只是简单的部署了一套生产环境而已,但是在架构上,这个改变的影响是巨大的,无状态应用的高可用管理、请求流量的管理、版本发布的管理、网络架构的管理等,其提升的架构复杂度巨大。 结合真实的协同办公产品:京办(为北京市政府提供协同办公服务的综合性平台)生产环境面对的复杂的政务网络以及京办同城双活架构演进的案例,给大家介绍下京办持续改进、分阶段演进过程中的一些思考和实践经验的总结。本文仅针对ES集群在跨机房同步过程中的方案和经验进行介绍和总结。 架构 1. 部署Logstash在金山云机房上,Logstash启动多个实例(按不同的类型分类,提高同步效率),并且和金山云机房的ES集群在相同的VPC 2. Logstash需要配置大网访问权限,保证Logstash和ES原集群和目标集群互通。 3. 数据迁移可以全量迁移和增量迁移,首次迁移都是全量迁移后续的增加数据选择增量迁移。 4. 增量迁移需要改造增加识别的增量数据的标识,具体方法后续进行介绍。   原理 Logstash工作原理   Logstash分为三个部分input 、filter、ouput: 1. input处理接收数据,数据可以来源ES,日志文件,kafka等通道. 2. filter对数据进行过滤,清洗。 3. ouput输出数据到目标设备,可以输出到ES,kafka,文件等。 增量同步原理 1. 对于T时刻的数据,先使用Logstash将T以前的所有数据迁移到有孚机房京东云ES,假设用时∆T 2. 对于T到T+∆T的增量数据,再次使用logstash将数据导入到有孚机房京东云的ES集群 3. 重复上述步骤2,直到∆T足够小,此时将业务切换到华为云,最后完成新增数据的迁移 适用范围:ES的数据中带有时间戳或者其他能够区分新旧数据的标签 流程   准备工作 1. 创建ECS和安装JDK忽略,自行安装即可 2. 下载对应版本的Logstash,尽量选择与Elasticsearch版本一致,或接近的版本安装即可 https://www.elastic.co/cn/downloads/logstash 1) 源码下载直接解压安装包,开箱即用 2)修改对内存使用,logstash默认的堆内存是1G,根据ECS集群选择合适的内存,可以加快集群数据的迁移效率。   3. 迁移索引 Logstash会帮助用户自动创建索引,但是自动创建的索引和用户本身的索引会有些许差异,导致最终数据的搜索格式不一致,一般索引需要手动创建,保证索引的数据完全一致。 以下提供创建索引的python脚本,用户可以使用该脚本创建需要的索引。 create_mapping.py文件是同步索引的python脚本,config.yaml是集群地址配置文件。 注:使用该脚本需要安装相关依赖 yum install -y PyYAML yum install -y python-requests 拷贝以下代码保存为 create_mapping.py: import yaml import requests import json import getopt import sys def help(): print """ usage: -h/--help print this help. -c/--config config file path, default is config.yaml example: python create_mapping.py -c config.yaml """ def process_mapping(index_mapping, dest_index): print(index_mapping) # remove unnecessary keys del index_mapping["settings"]["index"]["provided_name"] del index_mapping["settings"]["index"]["uuid"] del index_mapping["settings"]["index"]["creation_date"] del index_mapping["settings"]["index"]["version"] # check alias aliases = index_mapping["aliases"] for alias in list(aliases.keys()): if alias == dest_index: print( "source index " + dest_index + " alias " + alias + " is the same as dest_index name, will remove this alias.") del index_mapping["aliases"][alias] if index_mapping["settings"]["index"].has_key("lifecycle"): lifecycle = index_mapping["settings"]["index"]["lifecycle"] opendistro = {"opendistro": {"index_state_management": {"policy_id": lifecycle["name"], "rollover_alias": lifecycle["rollover_alias"]}}} index_mapping["settings"].update(opendistro) # index_mapping["settings"]["opendistro"]["index_state_management"]["rollover_alias"] = lifecycle["rollover_alias"] del index_mapping["settings"]["index"]["lifecycle"] print(index_mapping) return index_mapping def put_mapping_to_target(url, mapping, source_index, dest_auth=None): headers = {'Content-Type': 'application/json'} create_resp = requests.put(url, headers=headers, data=json.dumps(mapping), auth=dest_auth) if create_resp.status_code != 200: print( "create index " + url + " failed with response: " + str(create_resp) + ", source index is " + source_index) print(create_resp.text) with open(source_index + ".json", "w") as f: json.dump(mapping, f) def main(): config_yaml = "config.yaml" opts, args = getopt.getopt(sys.argv[1:], '-h-c:', ['help', 'config=']) for opt_name, opt_value in opts: if opt_name in ('-h', '--help'): help() exit() if opt_name in ('-c', '--config'): config_yaml = opt_value config_file = open(config_yaml) config = yaml.load(config_file) source = config["source"] source_user = config["source_user"] source_passwd = config["source_passwd"] source_auth = None if source_user != "": source_auth = (source_user, source_passwd) dest = config["destination"] dest_user = config["destination_user"] dest_passwd = config["destination_passwd"] dest_auth = None if dest_user != "": dest_auth = (dest_user, dest_passwd) print(source_auth) print(dest_auth) # only deal with mapping list if config["only_mapping"]: for source_index, dest_index in config["mapping"].iteritems(): print("start to process source index" + source_index + ", target index: " + dest_index) source_url = source + "/" + source_index response = requests.get(source_url, auth=source_auth) if response.status_code != 200: print("*** get ElasticSearch message failed. resp statusCode:" + str( response.status_code) + " response is " + response.text) continue mapping = response.json() index_mapping = process_mapping(mapping[source_index], dest_index) dest_url = dest + "/" + dest_index put_mapping_to_target(dest_url, index_mapping, source_index, dest_auth) print("process source index " + source_index + " to target index " + dest_index + " successed.") else: # get all indices response = requests.get(source + "/_alias", auth=source_auth) if response.status_code != 200: print("*** get all index failed. resp statusCode:" + str( response.status_code) + " response is " + response.text) exit() all_index = response.json() for index in list(all_index.keys()): if "." in index: continue print("start to process source index" + index) source_url = source + "/" + index index_response = requests.get(source_url, auth=source_auth) if index_response.status_code != 200: print("*** get ElasticSearch message failed. resp statusCode:" + str( index_response.status_code) + " response is " + index_response.text) continue mapping = index_response.json() dest_index = index if index in config["mapping"].keys(): dest_index = config["mapping"][index] index_mapping = process_mapping(mapping[index], dest_index) dest_url = dest + "/" + dest_index put_mapping_to_target(dest_url, index_mapping, index, dest_auth) print("process source index " + index + " to target index " + dest_index + " successed.") if __name__ == '__main__': main() 配置文件保存为config.yaml: # 源端ES集群地址,加上http:// source: http://ip:port source_user: "username" source_passwd: "password" # 目的端ES集群地址,加上http:// destination: http://ip:port destination_user: "username" destination_passwd: "password" # 是否只处理这个文件中mapping地址的索引 # 如果设置成true,则只会将下面的mapping中的索引获取到并在目的端创建 # 如果设置成false,则会取源端集群的所有索引,除去(.kibana) # 并且将索引名称与下面的mapping匹配,如果匹配到使用mapping的value作为目的端的索引名称 # 如果匹配不到,则使用源端原始的索引名称 only_mapping: true # 要迁移的索引,key为源端的索引名字,value为目的端的索引名字 mapping: source_index: dest_index 以上代码和配置文件准备完成,直接执行 python create_mapping.py 即可完成索引同步。 索引同步完成可以取目标集群的kibana上查看或者执行curl查看索引迁移情况: GET _cat/indices?v   全量迁移 Logstash配置位于config目录下。 用户可以参考配置修改Logstash配置文件,为了保证迁移数据的准确性,一般建议建立多组Logstash,分批次迁移数据,每个Logstash迁移部分数据。 配置集群间迁移配置参考:    input{ elasticsearch{ # 源端地址 hosts => ["ip1:port1","ip2:port2"] # 安全集群配置登录用户名密码 user => "username" password => "password" # 需要迁移的索引列表,以逗号分隔,支持通配符 index => "a_*,b_*" # 以下三项保持默认即可,包含线程数和迁移数据大小和logstash jvm配置相关 docinfo=>true slices => 10 size => 2000 scroll => "60m" } } filter { # 去掉一些logstash自己加的字段 mutate { remove_field => ["@timestamp", "@version"] } } output{ elasticsearch{ # 目的端es地址 hosts => ["http://ip:port"] # 安全集群配置登录用户名密码 user => "username" password => "password" # 目的端索引名称,以下配置为和源端保持一致 index => "%{[@metadata][_index]}" # 目的端索引type,以下配置为和源端保持一致 document_type => "%{[@metadata][_type]}" # 目标端数据的_id,如果不需要保留原_id,可以删除以下这行,删除后性能会更好 document_id => "%{[@metadata][_id]}" ilm_enabled => false manage_template => false } # 调试信息,正式迁移去掉 stdout { codec => rubydebug { metadata => true }} } 增量迁移 预处理: 1. @timestamp 在elasticsearch2.0.0beta版本后弃用 https://www.elastic.co/guide/en/elasticsearch/reference/2.4/mapping-timestamp-field.html 2. 本次对于京办从金山云机房迁移到京东有孚机房,所涉及到的业务领域多,各个业务线中所代表新增记录的时间戳字段不统一,所涉及到的兼容工作量大,于是考虑通过elasticsearch中预处理功能pipeline进行预处理添加统一增量标记字段:gmt_created_at,以减少迁移工作的复杂度(各自业务线可自行评估是否需要此步骤)。 PUT _ingest/pipeline/gmt_created_at { "description": "Adds gmt_created_at timestamp to documents", "processors": [ { "set": { "field": "_source.gmt_created_at", "value": "{{_ingest.timestamp}}" } } ] } 3. 检查pipeline是否生效 GET _ingest/pipeline/* 4. 各个index设置对应settings增加pipeline为默认预处理 PUT index_xxxx/_settings { "settings": { "index.default_pipeline": "gmt_created_at" } } 5. 检查新增settings是否生效 GET index_xxxx/_settings   增量迁移脚本 schedule-migrate.conf index:可以使用通配符的方式 query: 增量同步的DSL,统一gmt_create_at为增量同步的特殊标记 schedule: 每分钟同步一把,"* * * * *" input { elasticsearch { hosts => ["ip:port"] # 安全集群配置登录用户名密码 user => "username" password => "password" index => "index_*" query => '{"query":{"range":{"gmt_create_at":{"gte":"now-1m","lte":"now/m"}}}}' size => 5000 scroll => "5m" docinfo => true schedule => "* * * * *" } } filter { mutate { remove_field => ["source", "@version"] } } output { elasticsearch { # 目的端es地址 hosts => ["http://ip:port"] # 安全集群配置登录用户名密码 user => "username" password => "password" index => "%{[@metadata][_index]}" document_type => "%{[@metadata][_type]}" document_id => "%{[@metadata][_id]}" ilm_enabled => false manage_template => false } # 调试信息,正式迁移去掉 stdout { codec => rubydebug { metadata => true }} } 问题: mapping中存在join父子类型的字段,直接迁移报400异常   [2022-09-20T20:02:16,404][WARN ][logstash.outputs.elasticsearch] Could not index event to Elasticsearch. {:status=>400, :action=>["index", {:_id=>"xxx", :_index=>"xxx", :_type=>"joywork_t_work", :routing=>nil}, #<LogStash::Event:0x3b3df773>], :response=>{"index"=>{"_index"=>"xxx", "_type"=>"xxx", "_id"=>"xxx", "status"=>400, "error"=>{"type"=>"mapper_parsing_exception", "reason"=>"failed to parse", "caused_by"=>{"type"=>"illegal_argument_exception", "reason"=>"[routing] is missing for join field [task_user]"}}}}} 解决方法: https://discuss.elastic.co/t/an-routing-missing-exception-is-obtained-when-reindex-sets-the-routing-value/155140 https://github.com/elastic/elasticsearch/issues/26183 结合业务特征,通过在filter中加入小量的ruby代码,将_routing的值取出来,放回logstah event中,由此问题得以解决。 示例: 

优秀的个人博客,低调大师

每日一博 | 单体分层应用架构剖析

分层单体架构风格是分层思想在单体架构中的应用,其关注于技术视角的职责分层。同时,基于不同层变化速率的不同,在一定程度上控制变化在系统内的传播,有助于提升系统的稳定性。但这种技术视角而非业务视角的关注点隔离,导致了问题域与工程实现之间的Gap,这种割裂会导致系统认知复杂度的提升。 作者:倪新明 1 经典单体分层架构 1.1 四层单体架构风格 经典的四层单体分层架构如下图所示,应用在逻辑上划分为展现层、业务层、持久层及数据存储层,每层的职责如下: • 展现层:负责给最终用户展现信息,并接受用户的输入触发系统的业务逻辑。用户可以是使用系统的人,也可以是其他软件系统。 • 业务层:关注系统业务逻辑的实现 • 持久层:负责数据的存取 • 数据存储层:底层的数据存储设施   这种分层单体架构可能是大多数开发人员最早接触、最为熟悉的应用架构风格,其特点是: • 层间的依赖关系由上到下逐层向下直接依赖,每层都是关闭状态,请求的数据流向从上到下,必须严格通过每个分层进行流转,而不能进行穿透调用。 • 关注点隔离:通过分层将系统的关注点进行垂直分配,每层只关注自身层边界内的职责,层间职责相互独立不存在交叉。比如业务层负责处理系统的核心业务逻辑,而持久层则关注于对数据的存取。 除了关注点隔离这一维度,分层也在 “变化” 的维度进行隔离。每层的变化速率不同,由下级上逐层增加,展现层的变化速率最快,数据存储层变化速率最低。通过严格层依赖关系约束,尽量降低低层变化对上层的影响。这个特点的上下文是分层之间依赖于抽象,而非依赖于具体。当实现发生变化而接口契约不变时,变更范围框定在当前层。但,如果是接口契约的变更,则可能会直接影响到上游的依赖层。 这种分层架构风格具有明显的优势: • 分层模型比较简单,理解和实现成本低 • 开放人员接受度和熟悉程度高,认知和学习成本低 1.2 五层单体架构风格 四层架构面临的问题是: • 层间数据效率问题: 由于层间调用关系的依赖约束,层间的数据流转需要付出额外成本 • 业务层服务能力的复用性:业务层中处于对等地位的组件或模块之间存在共享服务的诉求 从复用性的角度考虑,如下所示的五层架构中,通过引入中间层解决复用问题。将共享服务从业务层沉淀到通用服务层,以提高复用性。其特点是: • 引入通用服务层提供通用服务,提高复用性 • 通用服务层是开放层,允许调用链路穿透,业务层可以按需直接访问更下层的持久层   相比于四层架构,五层分层架构的主要优势是:通过中间层的引入一定程度解决系统的复用性问题。但从反向角度看,正是由于中间层的引入导致了如下问题: • 引入中间层降低了数据传输效率,提高了开发实现成本 • 有造成系统混乱度提升的风险:由于通用服务层的开放性导致业务层可以穿透调用。但这种是否需要进行穿透的场景无法形成统一的判定原则,往往依赖于实现人员的个人经验进行权衡,同一个业务场景由不同的开发人员实现可能会有不同的判定结果(在四层架构中如果放开层间调用约束也会存在该问题)。随着业务需求迭代,系统的依赖关系一定会日趋增加,最终形成复杂的调用关系,也导致系统复杂性上升,增加团队成员的认知成本。   2 单体分层架构的共性问题探讨 当然,正是由于其极高的接受度,也造成了大家对分层的认知误区,认为分层是必然的“默认选项” ,从而忽略了分层的本质。分层到底是为了解决什么问题? 分层本质上是处理复杂性的一种方式:将复杂性在不同级别进行抽象,通过分层进行职责隔离,以此降低认知成本。同时,通过分层形成的“屏障”,控制变化在系统间的传播,提升系统稳定性。 不论是四层架构还是五层架构都是分层思想在单体应用架构风格下的实践,这种分层模式存在的固有问题主要体现在以下几个方面: • 分层对系统复杂度和效率的影响 • 变化真的能完全隔离吗? • 问题域与解决方案的隔离 2.1 分层对系统复杂度和效率的影响 如上文所述,分层架构中各层的变化速度不同。越往上变化越快,稳定性越低,越往下变化越慢,稳定性越高。比如,展现层的用户展示逻辑可能频繁变化,对应于不同的场景诉求展示数据及形式都可能不同。   如果划分层次越多,层间依赖关系越严格,则系统的调用链路和依赖关系会更加清晰。但,请求及响应的链路越长,层间数据转换有额外成本。即使引入各种数据转换工具,比如MapStruct,实现起来依然会感觉非常繁琐和重复。 如果划分层次越多,层间依赖关系宽松,允许跨层调用(如下所示的从展现层调用持久层只是一个示意),则能在一定程度降低数据频繁转换的成本。但: • 其一:如何判定是否要跨层调用很难形成统一的严格判定标准,只能进行粗粒度划分。因此,在实现过程中会有不同的判定结果,系统的调用关系会随着代码规模增长而日趋复杂。当然,团队可以加强代码评审的粒度,每次评审基于是否穿透调用进行讨论、判断并达成一致。但实际经验是,由于人为因素,靠严格的代码评审并不能保证决策的一致性。 • 其二:如果允许跨层调用,则意味着 “模型” 的穿透,低层的模型会直接暴露在更上层,这与我们追求的组件内聚性和模型的封装性存在冲突 注:层间的依赖约束是一种架构决策,可以考虑通过自动化单元测试机制进行保证,具体参考 《 基于ArchUnit守护系统架构 》 《 轻量级的架构决策记录机制 - ADR》 2.2 变化的隔离 我们对分层有一个普遍的、“先入为主” 的认知,分层能够隔离变化。首先会想到的例子,比如,如果底层的数据库发生了变更,又或者ORM框架发生了变更,那么,我们只需要修改DAO层的实现,而不需要更改上层的业务层代码。 • 你真的会替换数据库吗?你真的会替换ORM框架吗?有可能,但概率非常低,大部分系统并不会发生这种场景。 • 发生替换就真的能隔离吗?如果你的层间不是依赖于抽象,而是依赖于具体,那么隔离也无从谈起。 • 即使层间依赖于抽象,变化就真的隔离了吗?实现发生变化的直接结果就是依赖方需要引用新的实现,这种变化也同样会影响到上层。只不过是这种变化可能交由IOC容器了 但,这个是变化隔离的全部吗? • 如果是展现层需要增加一个新的字段,而当前数据库模型中没有? • 如果是数据库中需要增加一个新的字段,而展现层和业务逻辑层不关心? • 如果是...... 所以,引起系统变化的原因很多,场景各异,业务诉求亦不相同,分层对变化隔离程度也不相同: 分层可以控制变化在系统内的传播,由于变化场景的多样化,分层不能完全的隔离变化。   2.3 问题域与解决方案的割裂 重新思考下上文提到的分层单体架构的特点之一:关注点隔离,展现层、业务层、数据访问层、存储层等各层聚焦于自身的职责。这种关注点的本质是什么? 技术视角的隔离!!! 每层都是从技术视角将技术关注点进行隔离,而非业务领域视角。技术视角是研发友好的,作为开发人员,天然的可以理解和接受这种技术维度的统一语言:DAO层只负责处理数据相关逻辑,Controller层之服务处理Restful API相关,RPC层只处理与外部系统的跨进程调用等等。 而对于非常核心的业务概念,比如以订单为例,在单体分层架构下需要回答这样一个问题:“订单组件” 在哪里? 在经典的分层单体架构风格中,典型的实现如下图所示: • OrderConroller:Spring技术栈下的系统访问的Rest接口 • OrderService/OrderServiceImpl:订单的核心业务逻辑实现服务,实现诸如下单、取消订单等逻辑 • OrderDAO/OrdeDAOImpl:订单数据的存取   订单组件并不是以一个单一的、内聚的事物存在,其组成元素OrderService以及其依赖的OrderDAO分散于不同的层,因此,这种模式下订单组件只是逻辑性、概念性的存在。作为业务域的核心抽象,订单组件没有真实的、直观的、内聚的反映在代码实现中。我们在工程代码库中寻找“订单组件”: • 首先,在工程顶层最先看到的是技术视角的Module(Maven Module):web、service 、dao • 然后,需要在各层导航才能一窥其全貌 在IDE的支持下,这种导航并不会很复杂。但问题的根本在于:认知成本的增加。 我们去了解系统,天然的是从业务域而非技术域出发,单体分层恰恰是从技术域而非业务域出发,这种不同导致业务域与实现间的割裂,增加了对系统的认知成本。 实现要反应抽象,组件化思维本质上一种模块化思维,通过内聚性和封装性,将问题空间进行拆分成子空间,分而治之。对外通过接口提供组件能力,屏蔽内部的复杂性。接口契约的大小粒度需要权衡,粒度越小,能力提供越约聚焦,理解和接入成本越低,但通用性越差。接口契约粒度越大,则通用性越强,但理解和接入复杂性越高。   将组件化思维应用于单体分层架构,引申出模块化单体架构风格。应用架构按照问题域进行模块化组织,而非基于技术关注点进行拆分。组件内部遵循内聚性原则,其内包含了实现组件能力所需要的各个元素及交互关系。组件之间通过统一的、合适粒度的接口契约进行交互,不直接依赖于组件的内部能力或模型。同时,组织良好的模块化单体应用架构也是进行微服务拆分的重要保证。如果你无法在单体架构中进行优雅的模块化组织,又何谈合理的微服务拆分呢?  3 结语 单体分层架构风格是分层思想在单体架构中的应用,其关注于技术视角的职责分层。同时,基于不同层变化速率的不同,在一定程度上控制变化在系统内的传播,有助于提升系统的稳定性。但这种技术视角而非业务视角的关注点隔离,导致了问题域与工程实现之间的Gap,这种割裂会导致系统认知复杂度的提升。将组件化思维应用于单体分层架构,模块化单体技术视角的分层拉回至业务域视角的模块化,一定程度上降低业务与工程实现间的隔离。良好的模块化是单体走向微服务的重要基石,如果模块化设计较差的系统,不仅会增加微服务拆分的成本,更为重要的是,会增加形成分布式单体的概率和风险。

优秀的个人博客,低调大师

每日一博 | Seata AT 模式代码级详解

文| 刘月财 seata-go 项目负责人 北京小桔科技有限公司【滴滴】开发工程师 赵新(花名:于雨) 蚂蚁集团 Seata 项目开源负责人 本文5343字 阅读14分钟 背景 Seata 四种事务模式中,AT 事务模式是阿里体系独创的事务模式,对业务无侵入,也是 Seata 用户最多的一种事务模式,兼具易用性与高性能。 目前,Seata 社区正大力推进其多语言版本建设,Go、PHP、JS 和 Python 四个语言版本基本完成了 TCC 事务模式的实现。参照 Seata v1.5.2 版本的 AT 模式的实现,并结合 Seata 官方文档,本文尝试从代码角度详解 Seata AT 事务模式的详细流程,目的是梳理 Seata Java 版本 AT 模式的实现细节后,在多语言版本后续开发中,优先实现 AT 事务模式。 1、什么是 AT 模式? AT 模式是一种二阶段提交的分布式事务模式,它采用了本地 undo log 的方式来数据在修改前后的状态,并用它来实现回滚。从性能上来说,AT 模式由于有 undo log 的存在,一阶段执行完可以立即释放锁和连接资源,吞吐量比 XA 模式高。用户在使用 AT 模式的时候,只需要配置好对应的数据源即可,事务提交、回滚的流程都由 Seata 自动完成,对用户业务几乎没有入侵,使用便利。 2、AT 模式与 ACID 和 CAP 谈论数据库的事务模式,一般都会先谈论事务相关的 ACID 特性,但在分布式场景下,还需要考虑其 CAP 性质。 2.1 AT 与 ACID 数据库事务要满足原子性、一致性、持久性以及隔离性四个性质,即 ACID 。在分布式事务场景下,一般地,首先保证原子性和持久性,其次保证一致性,隔离性则因为其使用的不同数据库的锁、数据 MVCC 机制以及相关事务模式的差异, 具有多种隔离级别,如 MySQL 自身事务就有读未提交(Read Uncommitted)、读已提交(Read Committed)、可重复读(Repeatable Read)、序列化(Serializable)等四种隔离级别。 2.1.1 AT模式的读隔离 在数据库本地事务隔离级别读已提交(Read Committed) 或以上的基础上,Seata(AT 模式)的默认全局隔离级别是读未提交(Read Uncommitted) 。 如果应用在特定场景下,必须要求全局的读已提交,目前 Seata 的方式是通过 SELECT FOR UPDATE 语句的代理。 SELECT FOR UPDATE 语句的执行会查询全局锁,如果全局锁被其他事务持有,则释放本地锁(回滚 SELECT FOR UPDATE 语句的本地执行)并重试。这个过程中,查询是被 block 住的,直到全局锁拿到,即读取的相关数据是已提交的,才返回。 出于总体性能上的考虑,Seata 目前的方案并没有对所有 SELECT 语句都进行代理,仅针对 FOR UPDATE 的 SELECT 语句。 详细例子参考 Seata 官网:https://seata.io/zh-cn/docs/dev/mode/at-mode.html 2.1.2 AT 模式的写隔离 AT 会对写操作的 SQL 进行拦截,提交本地事务前,会向 TC 获取全局锁,未获取到全局锁的情况下,不能进行写,以此来保证不会发生写冲突: - 一阶段本地事务提交前,需要确保先拿到全局锁; - 拿不到全局锁,不能提交本地事务; - 拿全局锁的尝试被限制在一定范围内,超出范围将放弃,并回滚本地事务,释放本地锁。 详细例子参考 Seata 官网:https://seata.io/zh-cn/docs/dev/mode/at-mode.html 2.2 AT 与 CAP Seata 所有的事务模式在一般情况下,是需要保证 CP,即一致性和分区容错性,因为分布式事务的核心就是要保证数据的一致性(包括弱一致性)。比如,在一些交易场景下,涉及到多个系统的金额的变化,保证一致性可以避免系统产生资损。 分布式系统不可避免地会出现服务不可用的情况,如 Seata 的 TC 出现不可用时,用户可能希望通过服务降级,优先保证整个服务的可用性,此时 Seata 需要从 CP 系统转换为一个保证 AP 的系统。 比如,有一个服务是给用户端提供用户修改信息的功能,假如此时 TC 服务出现问题,为了不影响用户的使用体验,我们希望服务仍然可用,只不过所有的 SQL 的执行降级为不走全局事务,而是当做本地事务执行。 AT 模式默认优先保证 CP,但提供了配置通道让用户在 CP 和 AP 两种模式下进行切换: - 配置文件的tm.degrade-check参数,其值为true则分支事务保证 AP,反之保证 CP; - 手动修改配置中心的service.disableGlobalTransaction属性为true,则关闭全局事务实现 AP。 3、AT 数据源代理 在 AT 模式中,用户只需要配置好 AT 的代理数据源即可, AT 的所有流程都在代理数据源中完成,对用户无感知。 AT 数据源代理的整体类结构如下图: AT 事务数据源代理类结构图【fromhttps://seata.io/zh-cn/docs/dev/mode/xa-mode.html】 AT 的数据源代理中,分别对目标数据库的 DataSource 、 Connection 和 Statement 进行了代理,在执行目标 SQL 动作之前,完成了 RM 资源注册、 undo log 生成、分支事务注册、分支事务提交/回滚等操作,而这些操作对用户并无感知。 下面的时序图中,展示了 AT 模式在执行过程中,这几个代理类的动作细节: 注:图片建议在 PC 端查看 4、AT 模式流程 以下是 AT 模式的整体流程,从这里可以看到分布式事务各个关键动作的执行时机,每个动作细节,我们后面来讨论: 注:图片建议在 PC 端查看 4.1 一阶段 在 AT 模式的第一阶段, Seata 会通过代理数据源,拦截用户执行的业务 SQL ,假如用户没有开启事务,会自动开启一个新事务。如果业务 SQL 是写操作(增、删、改操作)类型,会解析业务 SQL 的语法,生成 SELECT SQL 语句,把要被修改的记录查出来,保存为 “before image” 。然后执行业务 SQL ,执行完后用同样的原理,将已经被修改的记录查出来,保存为 “after image” ,至此一个 undo log 记录就完整了。随后 RM 会向 TC 注册分支事务, TC 侧会新加锁记录,锁可以保证 AT 模式的读、写隔离。RM 再将 undo log 和业务 SQL 的本地事务提交,保证业务 SQL 和保存 undo log 记录 SQL 的原子性。 4.2 二阶段提交 AT 模式的二阶段提交,TC 侧会将该事务的锁删除,然后通知 RM 异步删除 undo log 记录即可。 4.3 二阶段回滚 如果 AT 模式的二阶段是回滚,那么 RM 侧需要根据一阶段保存的 undo log 数据中的 before image 记录,通过逆向 SQL 的方式,对在一阶段修改过的业务数据进行还原即可。 但是在还原数据之前,需要进行脏数据校验。因为在一阶段提交后,到现在进行回滚的中间这段时间,该记录有可能被别的业务改动过。校验的方式,就是用 undo log 的 after image 和现在数据库的数据做比较,假如数据一致,说明没有脏数据;不一致则说明有脏数据,出现脏数据就需要人工进行处理了。 5、关键代码模块 如下是 AT 模式整个流程的主要模块,我们从中可以了解开发 AT 模式需要做哪些事情: 5.1 Undo log数据格式 undo log 存在表 undo_log 表中,undo_log 表的表结构如下: rollback_info 存放了业务数据修改前后的内容,数据表存放的是经过压缩后的格式,他的明文格式如下: { "branchId":2828558179596595558, "sqlUndoLogs":[ { "afterImage":{ "rows":[ { "fields":[ { "keyType":"PRIMARY_KEY", "name":"id", "type":4, "value":3 }, { "keyType":"NULL", "name":"count", "type":4, "value":70 } ] } ], "tableName":"stock_tbl" }, "beforeImage":{ "rows":[ { "fields":[ { "keyType":"PRIMARY_KEY", "name":"id", "type":4, "value":3 }, { "keyType":"NULL", "name":"count", "type":4, "value":100 } ] } ], "tableName":"stock_tbl" }, "sqlType":"UPDATE", "tableName":"stock_tbl" } ], "xid":"192.168.51.102:8091:2828558179596595550" } 5.2 UndoLogManager UndoLogManager 负责 undo log 的新加、删除、回滚操作,不同的数据库有不同的实现(不同数据库的 SQL 语法会不同),公共逻辑放在了 AbstractUndoLogManager 抽象类中,整体的类继承关系如下图: 注:图片建议在 PC 端查看 插入和删除 undo log 的逻辑都比较简单,直接操作数据表就行。这里重点看下回滚 undo log 的逻辑: 源码分析如下: @Override public void undo(DataSourceProxy dataSourceProxy, String xid, long branchId) throws TransactionException { Connection conn = null;b ResultSet rs = null; PreparedStatement selectPST = null; boolean originalAutoCommit = true; for (; ; ) { try { conn = dataSourceProxy.getPlainConnection(); // The entire undo process should run in a local transaction. // 开启本地事务,确保删除undo log和恢复业务数据的SQL在一个事务中commit if (originalAutoCommit = conn.getAutoCommit()) { conn.setAutoCommit(false); } // Find UNDO LOG selectPST = conn.prepareStatement(SELECT_UNDO_LOG_SQL); selectPST.setLong(1, branchId); selectPST.setString(2, xid); // 查出branchId的所有undo log记录,用来恢复业务数据 rs = selectPST.executeQuery(); boolean exists = false; while (rs.next()) { exists = true; // It is possible that the server repeatedly sends a rollback request to roll back // the same branch transaction to multiple processes, // ensuring that only the undo_log in the normal state is processed. int state = rs.getInt(ClientTableColumnsName.UNDO_LOG_LOG_STATUS); // 如果state=1,说明可以回滚;state=1说明不能回滚 if (!canUndo(state)) { if (LOGGER.isInfoEnabled()) { LOGGER.info("xid {} branch {}, ignore {} undo_log", xid, branchId, state); } return; } String contextString = rs.getString(ClientTableColumnsName.UNDO_LOG_CONTEXT); Map<String, String> context = parseContext(contextString); byte[] rollbackInfo = getRollbackInfo(rs); String serializer = context == null ? null : context.get(UndoLogConstants.SERIALIZER_KEY); // 根据serializer获取序列化工具类 UndoLogParser parser = serializer == null ? UndoLogParserFactory.getInstance() : UndoLogParserFactory.getInstance(serializer); // 反序列化undo log,得到业务记录修改前后的明文 BranchUndoLog branchUndoLog = parser.decode(rollbackInfo); try { // put serializer name to local setCurrentSerializer(parser.getName()); List<SQLUndoLog> sqlUndoLogs = branchUndoLog.getSqlUndoLogs(); if (sqlUndoLogs.size() > 1) { Collections.reverse(sqlUndoLogs); } for (SQLUndoLog sqlUndoLog : sqlUndoLogs) { TableMeta tableMeta = TableMetaCacheFactory.getTableMetaCache(dataSourceProxy.getDbType()).getTableMeta( conn, sqlUndoLog.getTableName(), dataSourceProxy.getResourceId()); sqlUndoLog.setTableMeta(tableMeta); AbstractUndoExecutor undoExecutor = UndoExecutorFactory.getUndoExecutor( dataSourceProxy.getDbType(), sqlUndoLog); undoExecutor.executeOn(conn); } } finally { // remove serializer name removeCurrentSerializer(); } } // If undo_log exists, it means that the branch transaction has completed the first phase, // we can directly roll back and clean the undo_log // Otherwise, it indicates that there is an exception in the branch transaction, // causing undo_log not to be written to the database. // For example, the business processing timeout, the global transaction is the initiator rolls back. // To ensure data consistency, we can insert an undo_log with GlobalFinished state // to prevent the local transaction of the first phase of other programs from being correctly submitted. // See https://github.com/seata/seata/issues/489 if (exists) { deleteUndoLog(xid, branchId, conn); conn.commit(); if (LOGGER.isInfoEnabled()) { LOGGER.info("xid {} branch {}, undo_log deleted with {}", xid, branchId, State.GlobalFinished.name()); } } else { // 如果不存在undo log,可能是因为分支事务还未执行完成(比如,分支事务执行超时),TM发起了回滚全局事务的请求。 // 这个时候,往undo_log表插入一条记录,可以使分支事务提交的时候失败(undo log) insertUndoLogWithGlobalFinished(xid, branchId, UndoLogParserFactory.getInstance(), conn); conn.commit(); if (LOGGER.isInfoEnabled()) { LOGGER.info("xid {} branch {}, undo_log added with {}", xid, branchId, State.GlobalFinished.name()); } } return; } catch (SQLIntegrityConstraintViolationException e) { // Possible undo_log has been inserted into the database by other processes, retrying rollback undo_log if (LOGGER.isInfoEnabled()) { LOGGER.info("xid {} branch {}, undo_log inserted, retry rollback", xid, branchId); } } catch (Throwable e) { if (conn != null) { try { conn.rollback(); } catch (SQLException rollbackEx) { LOGGER.warn("Failed to close JDBC resource while undo ... ", rollbackEx); } } throw new BranchTransactionException(BranchRollbackFailed_Retriable, String .format("Branch session rollback failed and try again later xid = %s branchId = %s %s", xid, branchId, e.getMessage()), e); } finally { try { if (rs != null) { rs.close(); } if (selectPST != null) { selectPST.close(); } if (conn != null) { if (originalAutoCommit) { conn.setAutoCommit(true); } conn.close(); } } catch (SQLException closeEx) { LOGGER.warn("Failed to close JDBC resource while undo ... ", closeEx); } } } } 备注:需要特别注意下,当回滚的时候,发现 undo log 不存在,需要往 undo_log 表新加一条记录,避免因为 RM 在 TM 发出回滚请求后,又成功提交分支事务的场景。 5.3 Compressor 压缩算法 Compressor 接口定义了压缩算法的规范,用来压缩文本,节省存储空间: public interface Compressor { /** * compress byte[] to byte[]. * @param bytes the bytes * @return the byte[] */ byte[] compress(byte[] bytes); /** * decompress byte[] to byte[]. * @param bytes the bytes * @return the byte[] */ byte[] decompress(byte[] bytes); } 目前已经实现的压缩算法有如下这些: 5.4 UndoLogParser 序列化算法 Serializer 接口定义了序列化算法的规范,用来序列化代码: public interface UndoLogParser { /** * Get the name of parser; * * @return the name of parser */ String getName(); /** * Get default context of this parser * * @return the default content if undo log is empty */ byte[] getDefaultContent(); /** * Encode branch undo log to byte array. * * @param branchUndoLog the branch undo log * @return the byte array */ byte[] encode(BranchUndoLog branchUndoLog); /** * Decode byte array to branch undo log. * * @param bytes the byte array * @return the branch undo log */ BranchUndoLog decode(byte[] bytes); } 目前已经实现的序列化算法有如下这些: 5.5 Executor 执行器 Executor 是 SQL 执行的入口类, AT 在执行 SQL 前后,需要管理 undo log 的 image 记录,主要是构建 undo log ,包括根据不同的业务 SQL ,来组装查询 undo log 的 SQL 语句;执行查询 undo log 的 SQL ,获取到镜像记录数据;执行插入 undo log 的逻辑(未提交事务)。 ​public interface Executor<T> {​ /** * Execute t. * * @param args the args * @return the t * @throws Throwable the throwable */ T execute(Object... args) throws Throwable;} 针对不同的业务 SQL ,有不同的 Executor 实现,主要是因为不同操作/不同数据库类型的业务 SQL ,生成 undo log 的 SQL 的逻辑不同,所以都分别重写了 beforeImage() 和 afterImage() 方法。整体的继承关系如下图所示: 注:图片建议在 PC 端查看 为了直观地看到不同类型的 SQL 生成的 before image SQL 和 after iamge SQL ,这里做个梳理。假如目标数据表的结构如下: public interface Executor<T> { /** * Execute t. * * @param args the args * @return the t * @throws Throwable the throwable */ T execute(Object... args) throws Throwable; } 注:图片建议在 PC 端查看 5.6 AsyncWorker AsyncWorker 是用来做异步执行的,用来做分支事务提交和 undo log 记录删除等操作。 6、关于性能 并不存在某一种完美的分布式事务机制可以适应所有场景,完美满足所有需求。无论 AT 模式、TCC 模式还是 Saga 模式,本质上都是对 XA 规范在各种场景下安全性或者性能的不足的改进。Seata 不同的事务模式是在一致性、可靠性、易用性、性能四个特性之间进行不同的取舍。 近期 Seata 社区发现有同行,在未详细分析 Java 版本 AT 模式的代码的详细实现的情况下,仅对某个早期的 Go 版本的 Seata 进行短链接压测后,质疑 AT 模型的性能及其数据安全性,请具有一定思辨能力的用户朋友们在接受这个结论前仔细查阅其测试方法与测试对象,区分好 “李鬼” 与 “李逵”。 实际上,这个早期的 Go 版本实现仅参照了 Seata v1.4.0,且未严格把 Seata AT 模式的所有功能都予以实现。话说回来,即便其推崇的 Seata XA 模式,其也依赖于单 DB 的XA 模式。而当下最新版本的 MySQL XA 事务模式的 BUG 依然很多,这个地基并没有其想象中的那样百分百稳固。 由阿里与蚂蚁集团共建的 Seata,是我们多年内部分布式事务工程实践与技术经验的结晶,开源出来后得到了多达 150+ 以上行业同行生产环境的验证。开源大道既长且宽,这个道路上可以有机动车道也有非机动车道,还可以有人行道,大家携手把道路拓宽延长,而非站在人行道上宣传机动车道危险性高且车速慢。 7、总结 Seata AT 模式依赖于各个 DB 厂商的不同版本的 DB Driver(数据库驱动),每种数据库发布新版本后,其 SQL 语义及其使用模式都可能发生改变。随着近年 Seata 被其用户们广泛应用于多种业务场景,在开发者们的努力下,Seata AT 模式保持了编程接口与其 XA 模式几乎一致,适配了几乎所有的主流数据库,并覆盖了这些数据库的主要流行版本的 Driver:真正做到了把分布式系统的 “复杂性”留在了框架层面,把易用性和高性能交给了用户。 当然,Seata Java 版本的 XA 和 AT 模式还有许多需要完善与改进的地方,遑论其它多语言版本的实现。欢迎对 Seata 及其多语言版本建设感兴趣的同行参与到 Seata 的建设中来,共同努力把 Seata 打造成一个标准化分布式事务平台。 本周推荐阅读 Go内存泄漏,pprof 够用了么? Go 原生插件使用问题全解析 Go 代码城市上云--KusionStack 实践 Seata-php 半年规划

优秀的个人博客,低调大师

每日一博 | 不用 Swagger,那我用啥?

@[toc] 上周松哥写了一篇文章和小伙伴们分享 Swagger3 在 Spring Boot 中的用法,评论中有不少小伙伴推荐 Spring Doc,松哥趁着休息时间抽空看了下,这个东西确实不错,不存在和 Spring Boot 之间的兼容问题,于是就撸了这篇文章和小伙伴们分享。一起来看看这个好玩的文档生成工具吧! 1. OpenApi 在正式学习 Spring Doc 之前,先给大家介绍一下 OpenAPI。 OpenApi 是一个业界的 API 文档标准,是一个规范,这个规范目前有两大实现,分别是: SpringFox SpringDoc 其中 SpringFox 其实也就是我们之前所说的 Swagger,SpringDoc 则是我们今天要说的内容。 OpenApi 就像 JDBC 一样,制定了各种各样的规范,而 Swagger 和 SpringDoc 则类似于各种各样的数据库驱动,是具体的实现。 所以可能很多小伙伴也发现了,Swagger 和 Spring Doc 有一些相似的地方,这就是因为他们都遵守了相同的规范。 不过呢,Swagger 更新有点慢吞吞的,为了能够和新版的 Spring Boot 整合,还是 SpringDoc 更值得体验一把。 SpringDoc 支持: OpenAPI 3 Spring-boot,全版本都支持。 JSR-303 中提供的一些注解,例如 @NotNull、@Min、@Max 以及 @Size 等。 Swagger-ui:SpringDoc 提供的接口 JSON 也可以通过 Swagger-ui 展示出来。 OAuth 2 ... 2. 引入 SpringDoc 小伙伴们知道,这种生成接口文档的工具,一般来说都是两方面的功能: 生成接口文档 JSON。 渲染接口文档 JSON。 所以,当我们使用 SpringDoc 的时候,如果只是想要生成接口文档 JSON,那么只需要添加如下依赖即可: <dependency> <groupid>org.springdoc</groupid> <artifactid>springdoc-openapi-webmvc-core</artifactid> <version>1.6.9</version> </dependency> 此时,就会针对项目中的接口自动生成接口的 JSON 文档,类似下面这样: 这样的 JSON 信息开发者可以自行将之绘制出来,也可以使用网上一些现成的工具例如 Knife4j 之类的。当然你要是不想费事,也可以使用 SwaggerUI 将之绘制出来,如果想使用网页,那么就不要使用上面的依赖,用下面这个依赖,不仅可以生成 JSON 接口,还可以生成渲染后的网页: <dependency> <groupid>org.springdoc</groupid> <artifactid>springdoc-openapi-ui</artifactid> <version>1.6.9</version> </dependency> 网页效果如下图: 这个网页看着眼熟,其实就是 Swagger UI。 这个网页上有一个输入框,输入的内容是 /v3/api-docs,这个地址就是这个网页想要渲染的 JSON 的地址,如果开发者修改了生成的 JSON API 文档的地址,那么就需要手动在这个输入框中输入一下 JSON API 文档的地址。 默认的 JSON API 文档地址是: /v3/api-docs 默认的网页 UI 地址是: /swagger-ui/index.html 如果需要配置,则可以在 Spring Boot 的 application.properties 中直接进行配置: springdoc.swagger-ui.path=/javaboy-ui springdoc.api-docs.path=/javaboy-api 不过这两个配置并不是真的修改了访问路径,这两个相当于给访问路径取了一个别名,访问这两个时会自动重定向到对应的路径上。 3. 结合 Spring Security 如果我们的项目中使用了 Spring Security,那么部分接口的参数可能会比较特殊,例如下面这个接口: @RestController public class HelloController { @GetMapping("/hello") public String hello(@AuthenticationPrincipal User user) { System.out.println("user = " + user); return "hello"; } } 这个接口的参数加上了一个 @AuthenticationPrincipal 注解表示当前登录成功的用户对象,这个参数在实际使用中,并不需要前端传递,服务端会自动注入该参数。 但是!如果使用了 SpringDoc,通过网页去调用这个接口的时候,这个参数就必须要要传递,对于这种问题,我们可以引入如下依赖自动帮我们解决: <dependency> <groupid>org.springdoc</groupid> <artifactid>springdoc-openapi-security</artifactid> <version>1.6.9</version> </dependency> 这个依赖会自动帮我们忽略掉接口中带有 @AuthenticationPrincipal 注解的参数,这样我们在通过 swagger-ui 去进行接口测试的时候就不需要传递这个参数了。 4. 结合 Spring Data Rest Spring Boot 中提供了 Spring Data Rest,结合 Jpa 可以非常方便的构建出 Restful 应用。但是这种 Restful 应用不需要开发者自己写接口,那么怎么生成接口文档呢(连接口在哪里都不知道)?针对于此,SpringDoc 也提供了相关的支持,我们一起来看下。 4.1 Spring Data Rest 创建工程 首先创建一个 Spring Boot 工程,引入 Web 、 Jpa 、 MySQL 、Rest Repositories 依赖: 配置数据库 主要配置两个,一个是数据库,另一个是 Jpa: spring.datasource.username=root spring.datasource.password=1234 spring.datasource.url=jdbc:mysql:///test02?serverTimezone=Asia/Shanghai spring.jpa.hibernate.ddl-auto=update spring.jpa.show-sql=true spring.jpa.database=mysql spring.jpa.database-platform=mysql spring.jpa.properties.hibernate.dialect=org.hibernate.dialect.MySQL57Dialect 这里的配置,和 Jpa 中的基本一致。 前面三行配置了数据库的基本信息,包括数据库连接池、数据库用户名、数据库密码、数据库连接地址以及数据库驱动名称。 接下来的五行配置了 JPA 的基本信息,分别表示生成 SQL 的方言、打印出生成的 SQL 、每次启动项目时根据实际情况选择是否更新表、数据库平台是 MySQL。 这两段配置是关于 MySQL + JPA 的配置,没用过 JPA 的小伙伴可以参考松哥之前的 JPA 文章:http://www.javaboy.org/2019/0407/springboot-jpa.html 构建实体类 @Entity(name = "t_book") public class Book { @Id @GeneratedValue(strategy = GenerationType.IDENTITY) private Long id; @Column(name = "book_name") private String name; private String author; //省略 getter/setter } public interface BookRepository extends JpaRepository<book,long> { } 这里一个是配置了一个实体类 Book,另一个则是配置了一个 BookRepository ,项目启动成功后,框架会根据 Book 类的定义,在数据库中自动创建相应的表,BookRepository 接口则是继承自 JpaRepository ,JpaRepository 中自带了一些基本的增删改查方法。 好了,代码写完了。 啥?你好像啥都没写啊?是的,啥都没写,啥都不用写,一个 RESTful 风格的增删改查应用就有了,这就是 Spring Boot 的魅力! 测试 此时,我们就可以启动项目进行测试了,使用 POSTMAN 来测试(大家也可以自行选择趁手的 HTTP 请求工具)。 此时我们的项目已经默认具备了一些接口,我们分别来看: 根据 id 查询接口 http://127.0.0.1:8080/books/{id} 这个接口表示根据 id 查询某一本书: 分页查询 http://127.0.0.1:8080/books 这是一个批量查询接口,默认请求路径是类名首字母小写,并且再加一个 s 后缀。这个接口实际上是一个分页查询接口,没有传参数,表示查询第一页,每页 20 条数据。 查询结果中,除了该有的数据之外,也包含了分页数据: 分页数据中: size 表示每页查询记录数 totalElements 表示总记录数 totalPages 表示总页数 number 表示当前页数,从0开始计 如果要分页或者排序查询,可以使用 _links 中的链接。http://127.0.0.1:8080/books?page=1&amp;size=3&amp;sort=id,desc 。 添加 也可以添加数据,添加是 POST 请求,数据通过 JSON 的形式传递,如下: 添加成功之后,默认会返回添加成功的数据。 修改 修改接口默认也是存在的,数据修改请求是一个 PUT 请求,修改的参数也是通过 JSON 的形式传递: 默认情况下,修改成功后,会返回修改成功的数据。 删除 当然也可以通过 DELETE 请求根据 id 删除数据: 删除成功后,是没有返回值的。 不需要几行代码,一个基本的增删改查就有了。 这些都是默认的配置,这些默认的配置实际上都是在 JpaRepository 的基础上实现的,实际项目中,我们还可以对这些功能进行定制。 查询定制 最广泛的定制,就是查询,因为增删改操作的变化不像查询这么丰富。对于查询的定制,非常容易,只需要提供相关的方法即可。例如根据作者查询书籍: public interface BookRepository extends JpaRepository<book,long> { List<book> findBookByAuthorContaining(@Param("author") String author); } 注意,方法的定义,参数要有 @Param 注解。 定制完成后,重启项目,此时就多了一个查询接口,开发者可以通过 http://localhost:8080/books/search 来查看和 book 相关的自定义接口都有哪些: 查询结果表示,只有一个自定义接口,接口名就是方法名,而且查询结果还给出了接口调用的示例。我们来尝试调用一下自己定义的查询接口: 开发者可以根据实际情况,在 BookRepository 中定义任意多个查询方法,查询方法的定义规则和 Jpa 中一模一样(不懂 Jpa 的小伙伴,可以参考干货|一文读懂 Spring Data Jpa!,或者在松哥个人网站 www.javaboy.org 上搜索 JPA,有相关教程参考)。但是,这样有一个缺陷,就是 Jpa 中方法名太长,因此,如果不想使用方法名作为接口名,则可以自定义接口名: public interface BookRepository extends JpaRepository<book, long> { @RestResource(rel = "byauthor",path = "byauthor") List<book> findBookByAuthorContaining(@Param("author") String author); } @RestResource 注解中,两个参数的含义: rel 表示接口查询中,这个方法的 key path 表示请求路径 这样定义完成后,表示接口名为 byauthor ,重启项目,继续查询接口: 除了 rel 和 path 两个属性之外,@RestResource 中还有一个属性,exported 表示是否暴露接口,默认为 true ,表示暴露接口,即方法可以在前端调用,如果仅仅只是想定义一个方法,不需要在前端调用这个方法,可以设置 exported 属性为 false 。 如果不想暴露官方定义好的方法,例如根据 id 删除数据,只需要在自定义接口中重写该方法,然后在该方法上加 @RestResource 注解并且配置相关属性即可。 public interface BookRepository extends JpaRepository<book, long> { @RestResource(rel = "byauthor",path = "byauthor") List<book> findBookByAuthorContaining(@Param("author") String author); @Override @RestResource(exported = false) void deleteById(Long aLong); } 另外生成的 JSON 字符串中的集合名和单个 item 的名字都是可以自定义的: @RepositoryRestResource(collectionResourceRel = "bs",itemResourceRel = "b",path = "bs") public interface BookRepository extends JpaRepository<book, long> { @RestResource(rel = "byauthor",path = "byauthor") List<book> findBookByAuthorContaining(@Param("author") String author); @Override @RestResource(exported = false) void deleteById(Long aLong); } path 属性表示请求路径,请求路径默认是类名首字母小写+s,可以在这里自己重新定义。 其他配置 最后,也可以在 application.properties 中配置 REST 基本参数: spring.data.rest.base-path=/api spring.data.rest.sort-param-name=sort spring.data.rest.page-param-name=page spring.data.rest.limit-param-name=size spring.data.rest.max-page-size=20 spring.data.rest.default-page-size=0 spring.data.rest.return-body-on-update=true spring.data.rest.return-body-on-create=true 配置含义,从上往下,依次是: 给所有的接口添加统一的前缀 配置排序参数的 key ,默认是 sort 配置分页查询时页码的 key,默认是 page 配置分页查询时每页查询页数的 key,默认是size 配置每页最大查询记录数,默认是 20 条 分页查询时默认的页码 更新成功时是否返回更新记录 添加成功时是否返回添加记录 这是 Spring Data Rest 的一个简单用法,接下来我们来看如何给这个生成的文档。 4.2 生成接口文档 对于这种你都没看到接口的,我们只需要添加如下依赖,就可以自动生成 API 文档了,如下: <dependency> <groupid>org.springdoc</groupid> <artifactid>springdoc-openapi-data-rest</artifactid> <version>1.6.9</version> </dependency> <dependency> <groupid>org.springdoc</groupid> <artifactid>springdoc-openapi-ui</artifactid> <version>1.6.9</version> </dependency> 生成的接口文档如下: 5. 结合 Actuator 在之前的 Spring Boot 教程中,松哥还和大家介绍过 Spring Boot 中的 actuator,这个工具可以自行生成项目运行数据的端点(endpoints),如果想把这些端点也纳入到 SpringDoc 中来,那么只需要添加如下配置即可: springdoc.show-actuator=true 至于 SpringDoc 会显示多少个 Actuator 端点出来,那就要看 Actuator 暴露出来多少端点了,最终显示效果如下: 不过这里还有一个玩法! SpringDoc 扮演的角色毕竟不是业务功能,而是项目的辅助功能,所以,我们可以将之从业务中剥离,放到 Actuator 中,毕竟 Actuator 专干这种事。那么只需要增加如下两个配置即可: springdoc.use-management-port=true management.endpoints.web.exposure.include=openapi, swagger-ui management.server.port=9090 配置完成后,将来就可以在 Actuator 中去查看接口文档和对应的页面了,访问地址是: http://localhost:9090/actuator/swagger-ui/index.html 6. 切换到 Swagger 如果你在项目中已经使用了 Swagger 了,那么也可以非常方便的切换到 SpringDoc 上面来,切换的时候,首先引入 SpringDoc 依赖: <dependency> <groupid>org.springdoc</groupid> <artifactid>springdoc-openapi-ui</artifactid> <version>1.6.9</version> </dependency> Swagger 和 SpringDoc 注解的对应关系如下: @Api → @Tag @ApiIgnore → @Parameter(hidden = true) or @Operation(hidden = true) or @Hidden @ApiImplicitParam → @Parameter @ApiImplicitParams → @Parameters @ApiModel → @Schema @ApiModelProperty(hidden = true) → @Schema(accessMode = READ_ONLY) @ApiModelProperty → @Schema @ApiOperation(value = "foo", notes = "bar") → @Operation(summary = "foo", description = "bar") @ApiParam → @Parameter @ApiResponse(code = 404, message = "foo") → @ApiResponse(responseCode = "404", description = "foo") 以前我们在 Swagger 中配置接口扫描的方式如下: @Bean public Docket publicApi() { return new Docket(DocumentationType.SWAGGER_2) .select() .apis(RequestHandlerSelectors.basePackage("org.github.springshop.web.public")) .paths(PathSelectors.regex("/public.*")) .build() .groupName("springshop-public") .apiInfo(apiInfo()); } @Bean public Docket adminApi() { return new Docket(DocumentationType.SWAGGER_2) .select() .apis(RequestHandlerSelectors.basePackage("org.github.springshop.web.admin")) .paths(PathSelectors.regex("/admin.*")) .apis(RequestHandlerSelectors.withMethodAnnotation(Admin.class)) .build() .groupName("springshop-admin") .apiInfo(apiInfo()); } 现在在 SpringDoc 中则按照如下方式进行配置即可(还可以按照注解去标记需要生成接口文档的方法): @Configuration public class SpringDocConfig { @Bean public GroupedOpenApi publicApi() { return GroupedOpenApi.builder() .group("springshop-public") .pathsToMatch("/public/**") .build(); } @Bean public GroupedOpenApi adminApi() { return GroupedOpenApi.builder() .group("springshop-admin") .pathsToMatch("/admin/**") .addOpenApiMethodFilter(method -&gt; method.isAnnotationPresent(RequestMapping.class)) .build(); } } 当然,如果你并不需要对接口文档进行分组,那么也可以不使用 Java 配置,直接在 application.properties 中进行配置即可: springdoc.packages-to-scan=org.javaboy.spring_doc.controller springdoc.paths-to-match=/** 在 SpringDoc 中,如果你想配置 Swagger UI,则可以通过如下方式进行配置: @Bean OpenAPI springShopOpenAPI() { return new OpenAPI() .info(new Info().title("江南一点雨") .description("Spring Boot 教程") .version("v0.0.1") .license(new License().name("Apache 2.0").url("http://www.javaboy.org"))) .externalDocs(new ExternalDocumentation() .description("一些描述信息") .url("https://github.com/lenve/vhr")); } 好啦,常见用法大概就是这样,感兴趣的小伙伴可以去试试哦~关于 SpringDoc 的更多玩法,大家也可以参考官方文档:springdoc.org。</book></book,></book></book,></book></book,></book></book,long></book,long>

优秀的个人博客,低调大师

每日一博 | 推荐算法架构 —— 粗排

导语 | 粗排是介于召回和精排之间的一个模块,是典型的精度与性能之间trade-off的产物。理解粗排各技术细节,一定要时刻把精度和性能放在心中。 本篇将深入重排这个模块进行阐述。 一、总体架构 粗排是介于召回和精排之间的一个模块。它从召回获取上万的候选item,输出几百上千的item给精排,是典型的精度与性能之间trade-off的产物。对于推荐池不大的场景,粗排是非必选的。粗排整体架构如下: 二、粗排基本框架:样本、特征、模型 目前粗排一般模型化了,基本框架也是包括数据样本、特征工程、深度模型三部分。 (一)数据样本 目前粗排一般也都模型化了,其训练样本类似于精排,选取曝光点击为正样本,曝光未点击为负样本。但由于粗排一般面向上万的候选集,而精排只有几百上千,其解空间大很多。只使用曝光样本作为训练,但却要对曝光和非曝光同时预测,存在严重的样本选择偏差(SSB问题),导致训练与预测不一致。相比精排,显然粗排的SSB问题更严重。 (二)特征工程 粗排的特征也可以类似于精排,由于其计算延迟要求高,只有10ms~20ms,故一般可以粗分为两类: 普通特征:类似精排,user、context、item三部分。有哪些特征,以及特征如何处理,可以参看精排的特征工程部分。 交叉特征:user和item之间的交叉特征,对提升模型精度很有帮助。但由于交叉特征枚举过多,难以离线计算和存储。实时打分时又不像user特征只用计算一次,延迟较高。故对于交叉特征要谨慎使用。 (三)深度模型 粗排目前已经基本模型化,其发展历程主要分为四个阶段: 第一代:人工规则策略,可以基于后验统计,构建一个人工规则。比如融合item的历史CTR、CVR、类目价格档、销量等比较核心的因子。人工规则准确率低,也没有个性化,也不可能实时更新。 第二代:LR线性模型,有一定的个性化和实时性能力,但模型过于简单,表达能力偏弱。 第三代:DSSM双塔内积深度模型。它将user和item进行解耦合,分别通过两个Tower独立构建。从而可以实现item向量离线存储,降低线上predict延迟。主要有两种范式: item和user均离线存储。这个方案只需要计算user和item的内积即可,计算延迟低。由于user是离线存储的,故可以使用复杂的模型,提升表达能力。但user侧的实时性较差,对于用户行为不能实时捕捉。 item离线,user实时。item相对user,实时性要求没那么高。由于一次打分是针对同一个用户的,故user侧只需要实时计算一次即可,速度也很快。目前这个方案使用较多。 第四代:item和user隔离,导致二者没有特征交叉能力,模型表达能力弱。故又提出了以COLD为代表的第四代模型,轻量级MLP粗排模型。它通过SE block实现特征裁剪,并配合网络剪枝和工程优化,可以实现精度和性能之间的trade-off。 三、粗排优化 粗排的几个主要问题: 精度和特征交叉问题:经典的DSSM模型优点很多,目前在粗排上广泛应用,其最核心的缺点就是缺乏特征交叉能力。正所谓成也萧何败萧何,正是由于user和item分离,使得DSSM性能很高。但反过来也是由于二者缺乏交叉,导致模型表达能力不足,精度下降。典型的精度和性能之间的trade-off。 低延迟要求:粗排延迟要求高,一般只有10ms~20ms,远低于精排的要求。 SSB问题:粗排解空间比精排大很多,和精排一样只使用曝光样本,导致严重的样本选择偏差问题。 (一)精度提升 精度提升的方案主要有精排蒸馏和特征交叉,主要还是要优化特征交叉问题。 精排蒸馏 精排模型作为teacher,对粗排模型进行蒸馏学习,从而提升粗排效果,这已经成为了目前粗排训练基本范式 特征交叉 特征交叉可以在特征层面,也可以在模型层面实现。特征层面就是手工构造交叉特征,作为模型底层输入,仍然可以在独立的Tower中。模型层面则使用FM或者MLP等实现自动交叉。主要方法有: 特征蒸馏:teacher和student使用相同的网络结构,teacher模型使用普通特征和交叉特征,student则只使用普通特征。student从teacher中可以学到交叉特征的高阶信息。 加入交叉特征:特征层面构建手工交叉特征,独立的Tower中使用。由于交叉特征难以离线存储,实时计算空间也很大,故这个独立的Tower不能过于复杂。那我们第一时间就想到了wide&deep模型。deep部分仍然使用DSSM双塔,wide部分则为交叉特征。 轻量级MLP:模型层面实现特征交叉,不进行独立分塔。比如COLD,通过特征裁剪、网络剪枝、工程优化等方式降低时延,而不是靠独立分塔。 (二)延迟降低 精度和性能一直以来都是一个trade-off,很多方案都是在二者之间寻找平衡。粗排的性能要求更高,其延迟必须控制在10ms~20ms以内。性能优化有很多常见方法。 主要有以下方法: 特征裁剪:如COLD,不重要的特征先滤掉,自然就降低了整体延迟。这一层可以做在模型内,从而可以个性化和实时更新。 量化和定点化:比如32bit降低为8bit,可以提升计算和存储性能。 网络剪枝:network pruning,包括突触剪枝、神经元剪枝、权重矩阵剪枝等方法,不展开了。 模型蒸馏:model distillation,上文已经提到了,不展开了。 网络结构搜索NAS:使用更轻量级,效果更好的模型。可以尝试网络结构搜索NAS。 (三)SSB问题 粗排解空间比精排大很多,和精排一样只使用曝光样本,导致严重的样本选择偏差问题。可以把未曝光样本的精排打分给利用起来,缓解SSB问题。 作者简介 谢杨易 腾讯应用算法研究员。

优秀的个人博客,低调大师

每日一博 | 深度解析 Jetpack Compose 布局

Jetpack Compose 是用于构建原生 Android 界面的新工具包。它可简化并加快 Android 上的界面开发,使用更少的代码、强大的工具和直观的 Kotlin API,快速让应用生动而精彩。Compose 使用全新的组件——可组合项 (Composable) 来布局界面,使用 修饰符 (Modifier) 来配置可组合项。 本文会为您讲解由可组合项和修饰符提供支持的组合布局模型,并深入探究其背后的工作原理以及它们的功能,让您更好地了解所用布局和修饰符的工作方式,和应如何以及在何时构建自定义布局,从而实现满足确切应用需求的设计。 如果您更喜欢通过视频了解本文内容,请 点击这里 观看。 布局模型 Compose 布局系统的目标是提供易于创建的布局,尤其是 自定义布局。这要求布局系统具备强大的功能,使开发者能创建应用所需的任何布局,并且让布局具备优异的性能。接下来,我们来看看 Compose 的布局模型 是如何实现这些目标的。 Jetpack Compose 可将状态转换为界面,这个过程分为三步: 组合、布局、绘制。组合阶段执行 可组合函数,这些函数可以生成界面,从而创建界面树。例如,下图中的 SearchResult 函数会生成对应的界面树: △ 可组合函数生成对应的界面树 可组合项中可以包含逻辑和控制流,因此可以根据不同的状态生成不同的界面树。在布局阶段,Compose 会遍历界面树,测量界面的各个部分,并将每个部分放置在屏幕 2D 空间中。也就是说,每个节点决定了其各自的宽度、高度以及 x 和 y 坐标。在绘制阶段,Compose 将再次遍历这棵界面树,并渲染所有元素。 本文将深入探讨布局阶段。布局阶段又细分为两个阶段: 测量和放置。这相当于 View 系统中的 onMeasure 和 onLayout。但在 Compose 中,这两个阶段会交叉进行,因此我们把它看成一个布局阶段。将界面树中每个节点布局的过程分为三步: 每个节点必须测量自身的所有子节点,再决定自身的尺寸,然后放置其子节点。如下例,单遍即可对整个界面树完成布局。 △ 布局过程 其过程简述如下: 测量根布局 Row; Row 测量它的第一个子节点 Image; 由于 Image 是一个不含子节点的叶子节点,它会测量自身尺寸并加以报告,还会返回有关如何放置其子节点的指令。Image 的叶子节点通常是空节点,但所有布局都会在设置其尺寸的同时返回这些放置指令; Row 测量它的第二个子节点 Column; Column 测量其子节点,首先测量第一个子节点 Text; Text 测量并报告其尺寸以及放置指令; Column 测量第二个子节点 Text; Text 测量并报告其尺寸以及放置指令; Column 测量完其子节点,可以决定其自身的尺寸和放置逻辑; Row 根据其所有子节点的测量结果决定其自身尺寸和放置指令。 测量完所有元素的尺寸后,将再次遍历界面树,并且会在放置阶段执行所有放置指令。 Layout 可组合项 我们已经了解这个过程涉及的步骤,接下来看一下它的实现方式。先看看组合阶段,我们采用 Row、Column、Text 等更高级别的可组合项来表示界面树,每个高级别的可组合项实际上都是由低级别的可组合项构建而成。以 Text 为例,可以发现它由若干更低级别的基础构建块组成,而这些可组合项都会包含一个或多个 Layout 可组合项。 △ 每个可组合项都包含一个或多个 Layout Layout 可组合项是 Compose 界面的基础构建块,它会生成 LayoutNode。在 Compose 中,界面树,或者说组合 (composition) 是一棵 LayoutNode 树。以下是 Layout 可组合项的函数签名: @Composable fun Layout( content: @Composable () -> Unit, modifier: Modifier = Modifier, measurePolicy: MeasurePolicy ) { … } △ Layout 可组合项的函数签名 其中,content 是可以容纳任何子可组合项的槽位,出于布局需要,content 中也会包含子 Layout。modifier 参数所指定的修饰符将应用于该布局,这在下文中会详细介绍。measurePolicy 参数是 MeasurePolicy 类型,它是一个函数式接口,指定了布局测量和放置项目的方式。一般情况下,如需实现自定义布局的行为,您要在代码中实现该函数式接口: @Composable fun MyCustomLayout( modifier: Modifier = Modifier, content: @Composable () -> Unit ) { Layout( modifier = modifier, content = content ) { measurables: List<Measurable>, constraints: Constraints -> // TODO 测量和放置项目 } } △ 实现 MeasurePolicy 函数式接口 在 MyCustomLayout 可组合项中,我们调用 Layout 函数并以 Trailing Lambda 的形式提供 MeasurePolicy 作为参数,从而实现所需的 measure 函数。该函数接受一个 Constraints 对象来告知 Layout 它的尺寸限制。Constraints 是一个简单类,用于限制 Layout 的最大和最小宽度与高度: class Constraints { val minWidth: Int val maxWidth: Int val minHeight: Int val maxHeight: Int } △ Constraints measure 函数还会接受 List<Measurable> 作为参数,这表示的是传入的子元素。Measurable 类型会公开用于测量项目的函数。如前所述,布局每个元素需要三步: 每个元素必须测量其所有子元素,并以此判断自身尺寸,再放置其子元素。其代码实现如下: @Composable fun MyCustomLayout( content: @Composable () -> Unit, modifier: Modifier = Modifier ) { Layout( modifier = modifier, content = content ) { measurables: List<Measurable>, constraints: Constraints -> // placeables 是经过测量的子元素,它拥有自身的尺寸值 val placeables = measurables.map { measurable -> // 测量所有子元素,这里不编写任何自定义测量逻辑,只是简单地 // 调用 Measurable 的 measure 函数并传入 constraints measurable.measure(constraints) } val width = // 根据 placeables 计算得出 val height = // 根据 placeables 计算得出 // 报告所需的尺寸 layout (width, height) { placeables.foreach { placeable -> // 通过遍历将每个项目放置到最终的预期位置 placeable.place( x = … y = … ) } } } } △ 布局每个元素的代码示例 上述代码中使用了 Placeable 的 place 函数,它还有一个 placeRelative 函数可用于从右到左的语言设置中,当使用该函数时,它会自动对坐标进行水平镜像。 请注意,API 在设计上可阻止您尝试放置未经测量的元素,place 函数只适用于 Placeable,也就是 measure 函数的返回值。在 View 系统中,调用 onMeasure 以及 onLayout 的时机由您决定,而且调用顺序没有强制要求,但这会产生一些微妙的 bug 以及行为上的差异。 自定义布局示例 MyColumn 示例 △ Column Compose 提供一个 Column 组件用于纵向排布元素。为了理解这个组件背后的工作方式及其使用 Layout 可组合项的方式,我们来实现自己的一个 Column。暂且将其命名为 MyColumn,其实现代码如下: @Composable fun MyColumn( modifier: Modifier = Modifier, content: @Composable () -> Unit ) { Layout( modifier = modifier, content = content ) { measurables, constraints -> // 测量每个项目并将其转换为 Placeable val placeables = measurables.map { measurable -> measurable.measure(constraints) } // Column 的高度是所有项目所测得高度之和 val height = placeables.sumOf { it.height } // Column 的宽度则为内部所含最宽项目的宽度 val width = placeables.maxOf { it.width } // 报告所需的尺寸 layout (width, height) { // 通过跟踪 y 坐标放置每个项目 var y = 0 placeables.forEach { placeable -> placeable.placeRelative(x = 0, y = y) // 按照所放置项目的高度增加 y 坐标值 y += placeable.height } } } } △ 自定义 Column VerticalGrid 示例 △ VerticalGrid 我们再来看另一个示例: 构建常规网格。其部分代码实现如下: @Composable fun VerticalGrid( modifier: Modifier = Modifier, columns: Int = 2, content: @Composable () -> Unit ) { Layout( content = content, modifier = modifier ) { measurables, constraints -> val itemWidth = constraints.maxWidth / columns // 通过 copy 函数保留传递下来的高度约束,但设置确定的宽度约束 val itemConstraints = constraints.copy ( minWidth = itemWidth, maxWidth = itemWidth, ) // 使用这些约束测量每个项目并将其转换为 Placeable val placeables = measurables.map { it.measure(itemConstraints) } … } } △ 自定义 VerticalGrid 在该示例中,我们通过 copy 函数创建了新的约束。这种为子节点创建新约束的概念就是实现自定义测量逻辑的方式。创建不同约束来测量子节点的能力是此模型的关键,父节点与子节点之间并没有协商机制,父节点会以 Constraints 的形式传递其允许子节点的尺寸范围,只要子节点从该范围中选择了其尺寸,父节点必须接受并处理子节点。 这种设计的优点在于我们可以单遍测量整棵界面树,并且禁止执行多个测量循环。这是 View 系统中存在的问题,嵌套结构执行多遍测量过程可能会让叶子视图上的测量次数翻倍,Compose 的设计能够防止发生这种情况。实际上,如果您对某个项目进行两次测量,Compose 会抛出异常: △ 重复测量某个项目时 Compose 会抛出异常 布局动画示例 由于具备更强的性能保证,Compose 提供了新的可能性,例如为布局添加动画。Layout composable 不仅可以创建通用布局,还能创建出符合应用设计需求的专用布局。以 Jetsnack 应用中的自定义底部导航为例,在该设计中,如果某项目被选中,则显示标签;如果未被选中,则只显示图标。而且,设计还需要让项目的尺寸和位置根据当前选择状态执行动画。 △ Jetsnack 应用中的自定义底部导航 我们可以使用自定义布局来实现该设计,从而对布局变化的动画处理进行精确控制: @Composable fun BottomNavItem( icon: @Composable BoxScope.() -> Unit, text: @Composable BoxScope.() -> Unit, @FloatRange(from = 0.0, to = 1.0) animationProgress: Float ) { Layout( content = { // 将 icon 和 text 包裹在 Box 中 // 这种做法能让我们为每个项目设置 layoutId Box( modifier = Modifier.layoutId(“icon”) content = icon ) Box( modifier = Modifier.layoutId(“text”) content = text ) } ) { measurables, constraints -> // 通过 layoutId 识别对应的 Measurable,比依赖项目的顺序更可靠 val iconPlaceable = measurables.first {it.layoutId == “icon” }.measure(constraints) val textPlaceable = measurables.first {it.layoutId == “text” }.measure(constraints) // 将放置逻辑提取到另一个函数中以提高代码可读性 placeTextAndIcon( textPlaceable, iconPlaceable, constraints.maxWidth, constraints.maxHeight, animationProgress ) } } fun MeasureScope.placeTextAndIcon( textPlaceable: Placeable, iconPlaceable: Placeable, width: Int, height: Int, @FloatRange(from = 0.0, to = 1.0) animationProgress: Float ): MeasureResult { // 根据动画进度值放置文本和图标 val iconY = (height - iconPlaceable.height) / 2 val textY = (height - textPlaceable.height) / 2 val textWidth = textPlaceable.width * animationProgress val iconX = (width - textWidth - iconPlaceable.width) / 2 val textX = iconX + iconPlaceable.width return layout(width, height) { iconPlaceable.placeRelative(iconX.toInt(), iconY) if (animationProgress != 0f) { textPlaceable.placeRelative(textX.toInt(), textY) } } } △ 自定义底部导航 使用自定义布局的时机 希望以上示例能帮助您了解自定义布局的工作方式以及这些布局的应用理念。标准布局强大而灵活,但它们也需要适应很多用例。有时,若您知道具体的实现需求,使用自定义布局可能更加合适。 当您遇到以下场景时,我们推荐使用自定义布局: 难以通过标准布局实现的设计。虽然可以使用足够多的 Row 和 Column 构建大部分界面,但这种实现方式有时难以维护和升级; 需要非常精确地控制测量和放置逻辑; 需要实现布局动画。我们正在开发可对放置进行动画处理的新 API,未来可能不必自行编写布局就能实现; 需要完全控制性能。下文会详细介绍这一点。 修饰符 至此,我们了解了 Layout 可组合项以及构建自定义布局的方式。如果您使用 Compose 构建过界面,就会知道 修饰符 在布局、配置尺寸和位置方面发挥着重要作用。通过前文的示例可以看到,Layout 可组合项接受修饰符链作为参数。修饰符会装饰它们所附加的元素,可以在布局自身的测量和放置操作之前参与测量和放置。接下来我们来看看它的工作原理。 修饰符分很多不同的类型,可以影响不同的行为,例如绘制修饰符 (DrawModifier)、指针输入修饰符 (PointerInputModifier) 以及焦点修饰符 (FocusModifier)。本文我们将重点介绍布局修饰符 (LayoutModifier),该修饰符提供了一个 measure 方法,该方法的作用与 Layout 可组合项基本相同,不同之处在于,它只作用于单个 Measurable 而不是 List<Measurable>,这是因为修饰符的应用对象是单个项目。在 measure 方法中,修饰符可以修改约束或者实现自定义放置逻辑,就像布局一样。这表示您并不总是需要编写自定义布局,如果只想对单个项目执行操作,则可以改用修饰符。 以 padding 修饰符为例,该工厂函数以修饰符链为基础,创建能够捕获所需 padding 值的 PaddingModifier 对象。 fun Modifier.padding(all: Dp) = this.then(PaddingModifier( start = all, top = all, end = all, bottom = all ) ) private class PaddingModifier( val start: Dp = 0.dp, val top: Dp = 0.dp, val end: Dp = 0.dp, val bottom: Dp = 0.dp ) : LayoutModifier { override fun MeasureScope.measure( measurable: Measurable, constraints: Constraints ): MeasureResult { val horizontal = start.roundToPx() + end.roundToPx() val vertical = top.roundToPx() + bottom.roundToPx() // 按 padding 尺寸收缩外部约束来修改测量 val placeable = measurable.measure(constraints.offset(-horizontal, -vertical)) val width = constraints.constrainWidth(placeable.width + horizontal) val height = constraints.constrainHeight(placeable.height + vertical) return layout(width, height) { // 按所需的 padding 执行偏移以放置内容 placeable.placeRelative(start.roundToPx(), top.roundToPx()) } } } △ padding 修饰符的实现 除了通过上例中的方式覆写 measure 方法实现测量,您也可以使用 Modifier.layout,在无需创建自定义布局的情况下直接通过修饰符链向任意可组合项添加自定义测量和放置逻辑,如下所示: Box(Modifier .background(Color.Gray) .layout { measurable, constraints -> // 通过修饰符在竖直方向添加 50 像素 padding 的示例 val padding = 50 val placeable = measurable.measure(constraints.offset(vertical = -padding)) layout(placeable.width, placeable.height + padding) { placeable.placeRelative(0, padding) } } ) { Box(Modifier.fillMaxSize().background(Color.DarkGray)) } △ 使用 Modifier.layout 实现布局 虽然 Layout 接受单个 Modifier 参数,该参数会建立一个按顺序应用的修饰符链。我们通过示例来了解它与布局模型的交互方式。我们将分析下图修饰符的效果及其工作原理: △ 修饰符链的效果示例 首先,我们为 Box 设置尺寸并将其绘制出来,但这个 Box 放置在了父布局的左上角,我们可以使用 wrapContentSize 修饰符将 Box 居中放置。wrapContentSize 允许内容测量其所需尺寸,然后使用 align 参数放置内容,align 参数的默认值为 Center,因此可以省略这个参数。但我们发现,Box 还是在左上角。这是因为大多数布局都会根据其内容自适应调整尺寸,我们需要让测量尺寸占据整个空间,以便让 Box 在空间内居中。因此,我们在 wrapContentSize 前面添加 fillMaxSize 布局修饰符来实现这个效果。 △ 修饰符链的应用过程 我们来看一下这些修饰符是如何实现此效果的。您可以借助下图动画来辅助理解该过程: △ 修饰符链的工作原理 假设这个 Box 要放入最大尺寸为 200*300 像素的容器内,容器会将相应的约束传入修饰符链的第一个修饰符中。fillMaxSize 实际上会创建一组新约束,并设置最大和最小宽度与高度,使之等于传入的最大宽度与高度以便填充到最大值,在本例中是 200*300 像素。这些约束沿着修饰符链传递以测量下一个元素,wrapContentSize 修饰符会接受这些参数,它会创建新的约束来放宽对传入约束的限制,从而让内容测量其所需尺寸,也就是宽 0-200,高 0-300。这看起来只像是对 fillMax 步骤的反操作,但请注意,我们是使用这个修饰符实现项目居中的效果,而不是重设项目的尺寸。这些约束沿着修饰符链传递到 size 修饰符,该修饰符创建具体尺寸的约束来测量项目,指定尺寸应该正好是 50*50。最后,这些约束传递到 Box 的布局,它执行测量并将解析得到的尺寸 (50*50) 返回到修饰符链,size 修饰符因此也将其尺寸解析为 50*50,并据此创建放置指令。然后 wrapContent 解析其大小并创建放置指令以居中放置内容。因为 wrapContent 修饰符知道其尺寸为 200*300,而下一个元素的尺寸为 50*50,所以使用居中对齐创建放置指令,以便将内容居中放置。最后,fillMaxSize 解析其尺寸并执行放置操作。 修饰符链的执行方式与布局树的工作方式非常相像,差异在于每个修饰符只有一个子节点,也就是链中的下一个元素。约束会向下传递,以便后续元素用其测量自身尺寸,然后返回解析得到的尺寸,并创建放置指令。该示例也说明了 修饰符顺序的重要性。通过使用修饰符对功能进行组合,您可以很轻松地将不同的测量和布局策略组合在一起。 高级功能 接下来将介绍布局模型的一些高级功能,虽然您不一定总是需要这些功能,但它们能够帮助您构建更高级的功能。 固有特性测量 (Intrinsic Measurement) 前文提到过,Compose 使用单遍布局系统。这个说法并不完全正确,布局并不总是能通过单遍操作就得以完成,有时我们也需要了解有关子节点尺寸的信息才能最终确定约束。 以弹出式菜单为例。假设有一个包含五个菜单项的 Column,如下图所示,它的显示基本上是正常的,但是可以看到,每个菜单项的尺寸却不相同。 △ 菜单项的尺寸不相同 我们很容易想到,让每个菜单项都占用允许的最大尺寸即可: △ 每个菜单项都占有允许的最大尺寸 但这么做也没能完全解决问题,因为菜单窗口会扩大到其最大尺寸。有效的解决方法是使用最大固有宽度来确定尺寸: △ 使用最大固有宽度来确定尺寸 这里确定了 Column 会尽力为每个子节点提供所需的空间,对 Text 而言,其宽度是单行渲染全部文本所需的宽度。在确定固有尺寸后,将使用这些值设置 Column 的尺寸,然后,子节点就可以填充 Column 的宽度了。 如果使用最小值而非最大值,又会发生什么呢? △ 使用最小固有宽度来确定尺寸 它将确定 Column 会使用子节点的最小尺寸,而 Text 的最小固有宽度是每行一个词时的宽度。因此,我们最后得到一个按词换行的菜单。 如需详细了解固有特性测量,请参阅 Jetpack Compose 中的布局 Codelab 中的 "固有特性" 部分。 ParentData 到目前为止,我们看到的修饰符都是通用修饰符,也就是说,它们可以应用于任何可组合项。有时,您的布局提供的一些行为可能需要从子节点获得一些信息,这便要用到 ParentDataModifier。 我们回到前面那个在父节点中居中放置蓝色 Box 的示例。这一次,我们将这个 Box 放在另一个 Box 中。Box 中的内容在一个称为 BoxScope 的接收器作用域内排布。BoxScope 定义了只在 Box 内可用的修饰符,它提供了一个名为 Align 的修饰符。这个修饰符刚好能够提供我们要应用到蓝色 Box 的功能。因此,如果我们知道蓝色 Box 位于另一个 Box 内,就可以改用 Align 修饰符来定位它。 △ 在 BoxScope 中可以改用 Align 修饰符来定位内容 Align 是一个 ParentDataModifier 而不是我们之前看到的那种布局修饰符,因为它只是向其父节点传递一些信息,所以如果不在 Box 中,该修饰符便不可用。它包含的信息将提供给父 Box,以供其设置子布局。 您也可以为自己的自定义布局编写 ParentDataModifier,从而允许子节点向父节点告知一些信息,以供父节点在布局时使用。 对齐线 (Alignment Lines) 我们可以使用对齐线根据布局顶部、底部或中心以外的标准来设置对齐。最常用的 对齐线 是文本基线。假设需要实现这样一个设计: △ 需要实现设计图中的图标和文本对齐 我们很自然就能想到这样来实现它: Row { Icon(modifier = Modifier .size(10. dp) .align(Alignment.CenterVertically) ) Text(modifier = Modifier .padding(start = 8.dp) .align(Alignment.CenterVertically) ) } △ 有问题的对齐实现 仔细观察,会发现图标并没有像设计稿那样对齐在文本的基线上。 △ 图标和文本居中对齐,图标底部没有落在文本基线上 我们可以通过以下代码进行修复: Row { Icon(modifier = Modifier .size(10. dp) .alignBy { it.measuredHeight } ) Text(modifier = Modifier .padding(start = 8.dp) .alignByBaseline() ) } △ 正确的对齐实现 首先,对 Text 使用 alignByBaseline 修饰符。而图标既没有基线,也没有其他对齐线,我们可以使用 alignBy 修饰符让图标对齐到我们需要的任何位置。在本例中,我们知道图标的底部是对齐的目标位置,因此将图标的底部进行对齐。最终便实现了期望的效果: △ 图标底部与文本基线完美对齐 由于对齐功能会穿过父节点,因此,处理嵌套对齐时,只需设置父节点的对齐线,它会从子节点获取相应的值。如下例所示: △ 未设置对齐的嵌套布局 △ 通过父节点设置对齐线 您甚至可以在自定义布局中创建自己的自定义对齐,从而允许其他可组合项对齐到它。 BoxWithConstraints BoxWithConstraints 是一个功能强大且很实用的布局。在组合中,我们可以根据条件使用逻辑和控制流来选择要显示的内容,但是,有时候可能希望根据可用空间的大小来决定布局内容。 从前文中我们知道,尺寸信息直到布局阶段才可用,也就是说,这些信息一般无法在组合阶段用来决定要显示的内容。此时 BoxWithConstraints 便派上用场了,它与 Box 类似,但它将内容的组合推迟到布局阶段,此时布局信息已经可用了。BoxWithConstraints 中的内容在接收器作用域内排布,布局阶段确定的约束将通过该作用域公开为像素值或 DP 值。 @Composable fun BoxWithConstraints( ... content: @Composable BoxWithConstraintsScope.() -> Unit ) // BoxWithConstraintsScope 公开布局阶段确定的约束 interface BoxWithConstraintsScope : BoxScope { val constraints: Constraints val minWidth: Dp val maxWidth: Dp val minHeight: Dp val maxHeight: Dp } △ BoxWithConstraints 和 BoxWithConstraintsScope 它内部的内容可以使用这些约束来选择要组合的内容。例如,根据最大宽度选择不同的呈现方式: @Composable fun MyApp(...) { BoxWithConstraints() { // this: BoxWithConstraintsScope when { maxWidth < 400.dp -> CompactLayout() maxWidth < 800.dp -> MediumLayout() else -> LargeLayout() } } } △ 在 BoxWithConstraintsScope 中根据最大宽度选择不同的布局 性能 我们介绍了单遍布局模型如何防止在测量或放置方面花费过多时间,也演示了布局阶段两个不同的子阶段: 测量和放置。现在,我们将介绍性能相关的内容。 尽量避免重组 单遍布局模型的设计效果是,任何只影响项目的放置而不影响测量的修改都可以单独执行。以 Jetsnack 为例: △ Jetsnack 应用中产品详情页的协调滚动效果 这个产品详情页包含协调滚动效果,页面上的一些元素根据滚动操作进行移动或缩放。请注意标题区域,这个区域会随着页面内容而滚动,最后固定在屏幕的顶部。 @Composable fun SnackDetail(...) { Box { val scroll = rememberScrollState(0) Body(scroll) Title(scroll = scroll.value) ... } } @Composable fun Body(scroll: ScrollState) { Column(modifier = Modifier.verticalScroll(scroll)) { … } } △ 详情页的大致实现 为了实现此效果,我们将不同元素作为独立的可组合项叠放在一个 Box 中,提取滚动状态并将其传入 Body 组件。Body 会使用滚动状态进行设置以使内容能够垂直滚动。在 Title 等其他组件中可以观察滚动位置,而我们的观察方式会对性能产生影响。例如,使用最直接的实现,简单地使用滚动值对内容进行偏移: @Composable fun Title(scroll: Int) { Column( modifier = Modifier.offset(scroll) ) { … } } △ 简单地使用滚动值偏移 Title 的内容 这种方法的问题是,滚动是一个可观察的状态值,读取该值所处的作用域规定了状态发生变化时 Compose 需要重新执行的操作。在此示例中,我们要读取组合中的滚动偏移值,然后使用它来创建偏移修饰符。只要滚动偏移值发生变化,Title 组件都需要重新组合,也就需要创建并执行新的偏移修饰符。由于滚动状态是从组合中读取的,任何更改都会导致重组,在重组时,还需要进行布局和绘制这两个后续阶段。 不过,我们不是要更改显示的内容,而是更改内容的位置。我们还可以进一步提高效率,通过修改一下实现,不再接受原始滚动位置,而是传递一个可以提供滚动位置的函数: @Composable fun Title(scrollProvider: () -> Int) { Column( modifier = Modifier.offset { val scroll = scrollProvider() val offset = (maxOffset - scroll).coerceAtLeast(minOffset) IntOffset(x = 0, y = offset) } ) { … } } △ 使用提供滚动位置的函数代替原始滚动位置 这时,我们可以在不同的时间只调用此 Lambda 函数并读取滚动状态。这里使用了 offset 修饰符,它接受能提供偏移值的 Lambda 函数作为参数。这意味着在滚动发生变化时,不需要重新创建修饰符,只在放置阶段才会读取滚动状态的值。所以,当滚动状态变化时我们只需要执行放置和绘制操作,不需要重组或测量,因此能够提高性能。 再回到底部导航的示例,它存在同样的问题,我们可以用相同方法加以修正: @Composable fun BottomNavItem( icon: @Composable BoxScope.() -> Unit, text: @Composable BoxScope.() -> Unit, animationProgress: () -> Float ) { … val progress = animationProgress() val textWidth = textPlaceable.width * progress val iconX = (width - textWidth - iconPlaceable.width) / 2 val textX = iconX + iconPlaceable.width return layout(width, height) { iconPlaceable.placeRelative(iconX.toInt(), iconY) if (animationProgress != 0f) { textPlaceable.placeRelative(textX.toInt(), textY) } } } △ 修正后的底部导航 我们使用了能提供当前动画进度的函数作为参数,因此不需要重组,只执行布局即可。 您需要掌握一个原则: 只要可组合项或修饰符的参数可能频繁发生更改,都应当保持谨慎,因为这种情况可能导致过度组合。只有在更改显示内容时,才需要重组,更改显示位置或显示方式则不需要这么做。 BoxWithConstraints 可以根据布局执行组合,是因为它会在布局阶段启动子组合。出于性能考虑,我们希望尽量避免在布局期间执行组合。因此,相较于 BoxWithConstraints,我们倾向于使用会根据尺寸更改的布局。当信息类型随尺寸更改时才使用 BoxWithConstraints。 提高布局性能 有时候,布局不需要测量其所有子节点便可获知自身大小。举个例子,有如下构成的卡片: △ 布局卡片示例 图标和标题构成标题栏,剩下的是正文。已知图标大小为固定值,标题高度与图标高度相同。测量卡片时,就只需要测量正文,它的约束就是布局高度减去 48 DP,卡片的高度则为正文的高度加上 48 DP。 △ 测量过程只测量正文尺寸 系统识别出只测量了正文,因此它是决定布局尺寸的唯一重要子节点,图标和文本仍然需要测量,但可以在放置过程中执行。 △ 放置过程测量图标和文本 假设标题是 "Layout",当标题发生变化时,系统不必重新执行布局的测量操作,因此不会重新测量正文,从而省去不必要的工作。 △ 标题发生变化时不必重新测量 总结 在本文中,我们介绍了自定义布局的实现过程,还使用修饰符构建和合并布局行为,进一步降低了满足确切功能需求的难度。此外,还介绍了布局系统的一些高级功能,例如跨嵌套层次结构的自定义对齐,为自有布局创建自定义 ParentDataModifier,支持自动从右向左设置,以及将组合操作推迟到布局信息已知时,等等。我们还了解如何执行单遍布局模型,如何跳过重新测量以使其只执行重新放置操作的方法,熟练使用这些方法,您将能编写出通过手势进行动画处理的高性能布局逻辑。 对布局系统的理解能够帮助您构建满足确切设计需求的布局,从而创建用户喜爱的优秀应用。如需了解更多,请查阅以下列出的资源: Jetpack Compose 使用入门文档 Jetpack Compose 学习路线图 Jetpack Compose 相关示例 欢迎您 点击这里 向我们提交反馈,或分享您喜欢的内容、发现的问题。您的反馈对我们非常重要,感谢您的支持!

优秀的个人博客,低调大师

每日一博 | 单链表解题思维

一、概念 链表由一组零散的结点通过指针连接而成,每个结点都包含当前结点内容和后继指针。相对于数组,它不受固于存储空间的限制,可更快捷地进行插入和删除操作,主要有以下几种类型: 1、单链表 指针指向下一个节点,终点指向null 2、双链表 指针指向前一个节点和后一个节点 3、循环链表 最后一个节点指向第一个节点 在解决链表相关问题时,先执行三步骤,再敲下代码会更清晰 确定解题的链表类型 画图理清思路 确定边界条件 不同于数组,JS官方还没有提供一个直接的链表API,可通过对象的方式模拟出链表,其结构为 const head = { data: 1, next: { data: 2, next: null, }, }; 二、leetcode 最常见相关题型 1、合并两个有序链表 将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的 示例: 输入: l1 = [1,2,4], l2 = [1,3,4] 输出: [1,1,2,3,4,4] 步骤: 解题的链表类型是单链表 思路: l1 与 l2 是有序递增的,因此 l1.val 与 l2.val 的较小值就是合并后链表的最小值 依次递归 大小节点的比较,直到 l1 l2 均为 null 边界条件:递归到任意链表为 null 即可停止,并将 next 指向另外的链表 var mergeTwoLists = function(l1, l2) { if (l1 === null) { return l2 } else if (l2 === null) { return l1 } else if (l1.val < l2.val) { l1.next = mergeTwoLists(l1.next, l2) return l1 } else { l2.next = mergeTwoLists(l2.next, l1) return l2 } }; 2、环形链表 给定一个链表,判断链表中是否有环。如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。如果链表中存在环,返回 true 否则返回 false 。要求用 O(1) 内存解决此问题 pos 表示链表尾连接到链表中的位置,若 pos 是 -1 则该链表中没有环 示例: 输入:head = [3,2,0,-4], pos = 1 输出:true // 链表中有一个环,其尾部连接到第二个节点 步骤: 解题的链表类型是单链表 思路: 龟兔赛跑算法:利用快慢双指针,快指针走两步,慢指针走一步 如果链表存在环,则两个速度不同的指针必定会相遇。并且从相遇点和链表头结点同时往下走,会在环起点相遇 边界条件: 快指针指向 null 停止,无环 快慢指针指向同一个节点,有环 var hasCycle = function(head) { if(!head || !head.next) return false; let slow = head.next; let fast = head.next.next; while(slow !== fast ) { if(!fast || !fast.next) return false; slow = slow.next; fast = fast.next.next; } return true } 3、反转链表 给你单链表的头节点 head ,请你使用迭代或递归地反转链表,并返回反转后的链表 示例: 输入: head = [1,2,3,4,5] 输出: [5,4,3,2,1] 步骤: 解题的链表类型是单链表 迭代思路: 将单链表的每个节点的后继指针指向它的前驱节点 边界条件: 当链表 null 停止 链表仅有一个节点 var reverseList = function(head) { if(!head || !head.next) return head; let prev = null; let cur = head; while(cur) { const curNext = cur.next; // 反转后赋值给prev指针 cur.next = prev; prev = cur; // 链接到下一个节点 cur = curNext; } return prev }; 4、链表的中间结点 给定一个头结点为 head 的非空单链表,返回链表的中间结点,如果有两个中间结点,则返回第二个中间结点(给定链表的结点数介于 1 和 100 之间) 示例: 输入: [1,2,3,4,5] 输出: 3 输入: [1,2,3,4,5,6] 输出: 4 步骤: 解题的链表类型是单链表 思路: 快指针p2的位移是慢指针p1的2倍,所以当p2走到链表尾部时,p1刚好走了一半,指向链表的中点。 下题同理 边界条件: 快指针指向 null 时,慢指针刚好处于中间位置 var middleNode = function(head) { if(!head || !head.next) return head; let slow = head; let fast = head; while(fast && fast.next) { slow = slow.next; fast = fast.next.next; } return slow }; 5、删除链表倒数第 n 个结点 给你一个链表,删除链表的倒数第 n 个结点,并且返回链表的头结点 示例: 输入:head = [1,2,3,4,5], n = 2 输出:[1,2,3,5] 步骤: 解题的链表类型是单链表 思路: 快指针一次性走完n个节点,接着两个指针一起往后走,直到快指针指向null,此时慢指针就是倒数第n个节点 添加哨兵处理第n个节点 边界条件: 快指针指向 null 时,慢指针所在位置就是倒数第n个节点 const removeNthFromEnd = function (head, n) { // 哨兵 let preHead = new ListNode(0) preHead.next = head let slow = preHead; let fast = preHead; // 先走n步 while (n--) { fast = fast.next } // 一起走 while (fast && fast.next) { fast = fast.next slow = slow.next } slow.next = slow.next.next return preHead.next; }; 6、回文链表 给你一个单链表的头节点 head ,请你判断该链表是否为回文链表。如果是,返回 true ;否则,返回 false 示例: 输入: head = [1,2,2,1] 输出: true 步骤: 解题的链表类型是单链表 思路: 借助数组,将链表丢进数组 设置前后指针,前后指针理应相同,若不同则不是回文 循环结束若没有返回false则是回文 边界条件: 前后指针不一致 循环结束 var isPalindrome = function (head) { const res = [] while (head) { res.push(head.val); head = head.next } let pre = 0; let last = res.length - 1; while (pre < last) { if (res[pre] !== res[last]) return false; pre++; last--; } return true } 8、相交链表 给你两个单链表的头节点 headA 和 headB ,请你找出并返回两个单链表相交的起始节点。题目数据保证整个链式结构中不存在环。 注意: 函数返回结果后,链表必须 保持其原始结构(需复制新的链表) 如果两个链表没有交点,返回 null 程序尽量满⾜ O(n) 时间复杂度,且仅⽤ O(1) 内存 示例: 输入:intersectVal = 4, listA = [1,2,3,4,5], listB = [6,7,4,5], skipA = 3, skipB = 2 // 在 A 中,相交节点前有 3 个节点;在 B 中,相交节点前有 2 个节点 输出:Intersected at '4' // 相交节点的值为 4 (注意,如果两个链表相交则不能为 0) 步骤: 解题的链表类型是单链表 思路: 同上,寻找AB链表的高度差并消除,已知相交点之后的长度必须相等 AB双指针同时前进,当短链表B的指针遍历完成时,双指针的长度差刚好是双链表的长度差,将B指针指向A链表的头节点,跟着A指针再一次遍历,直到A指针遍历完成 同样将A指针指向B链表的头节点,B指针向前一步,则消除了链表的高度差 边界条件: 指针指向null时,切换指向链表 AB链表值相等 var getIntersectionNode = function (headA, headB) { if (!headA || !headB) return null; let pA = headA; let pB = headB; while (pA !== pB) { pA = pA !== null ? pA.next : headB; pB = pB !== null ? pB.next : headA; } return pA; } 9、链表求和 给定两个用链表表示的整数,每个节点包含一个数位,这些数位是反向存放的,也就是个位排在链表首部。编写函数对这两个整数求和,并用链表形式返回结果 示例: 输⼊:(7 -> 1 -> 6) + (5 -> 9 -> 2),即617 + 295 输出:2 -> 1 -> 9,即912 步骤: 解题的链表类型是单链表 思路: 输出的是新链表,因此需要创建一个链表 由于是反向存储,则链表从个位数开始计算,大于十则进位 进位,首先考虑⽤carry存储每次的进位,余数存储进创建的节点 边界条件: 双链表指向null时,遍历完成 遍历完成,carry不为0,则还需前进一位 const addTwoNumbers = function (l1, l2) { // 哨兵 let preHead = new ListNode(0) let carry = 0; let pre = preHead; while (l1 || l2) { let sum = 0; if (l1) { sum += l1.val l1 = l1.next } if (l2) { sum += l2.val l2 = l2.next } sum += carry carry = Math.floor(sum / 10) pre.next = new ListNode(sum % 10) pre = pre.next } if (carry > 0) { pre.next = new ListNode(carry) pre = pre.next } return preHead.next } 进阶:思考⼀下,假设这些数位是正向存放的,⼜该如何解决呢? 输⼊:(6 -> 1 -> 7) + (2 -> 9 -> 5),即617 + 295 输出:9 -> 1 -> 2,即912

优秀的个人博客,低调大师

每日一博 | B 树详解与实现

1. 前言 红黑树的实现并不困难,但仅根据其定义去理解背后的设计思想却是相当不容易的。 相比较而言,B树是非常直观且容易理解的,了解B树之后,再去看红黑树,就会发现红黑树其实是4阶B树的一种等价实现,红黑树的查找、插入、删除、着色和旋转都可以在4阶B树中一一找到对应关系。 另外,B树及其变体也广泛地运用于数据库系统,譬如MySQL、MongoDB……等。 这篇文章中,我会先介绍 B树的由来,接着介绍其定义和概念,然后通过图例和流程图来说明相关操作,最后会给出其代码实现。 代码仓库:https://github.com/patricklaux/perfect-code 系列文章 (1) 深度优先遍历之递归和非递归遍历 (2) 深度优先遍历之 Morris 遍历 (3) 一种无需队列的层序遍历算法 IDDFS (4) 深度分析AVL树的实现与优化 (5) B树详解与实现【本文】 2. 由来 B 树是由 Rudolf Bayer 和 Edward McCreight 在波音实验室工作期间提出的,论文 “Organization and maintenance of large ordered indices1” 发表于1972年。 B 树是多叉查找树的一种实现,而多叉查找树是二叉查找树的推广。 与内存相比,磁盘具有持久性、大容量和单位存储价格便宜等优点。 但磁盘相对于内存而言是非常缓慢的,二叉树这种内存数据结构并不能很好地应用于磁盘存储。 磁盘读写以页为单位,分页大小为 4KB 时,读取 1B 数据与 4KB 数据均需一次磁盘I/O,耗时几乎相等。 另外,磁盘顺序读写比随机读写的性能要好得多,当读写连续的数据页时,通常都会有不错的性能表现。 因此,根据磁盘数据读写的这些特点,为减少磁盘I/O,很自然的一个想法就是将多个数据项合并存入到一个节点,节点大小恰好是页大小的整数倍。 如下图所示,多个二叉树节点合并成一个节点,这样二叉查找树就变成了多叉查找树 (M-ary search tree)。 图2.1:节点合并(图片来源于参考资料[2]) 一棵完全二叉树 (complete binary tree) 的层数大约为 \(log_2n\),一棵完全多叉树 (complete M-ary tree) 的层数大约为 \(log_mn\),n 为数据记录数。 这意味着,如果有 100万条数据记录,当以二叉树的形式存储到磁盘,搜索一条数据记录约需 20次磁盘I/O:\(log_21000000≈20\); 如图2.1 所示,通过将 7个节点合并成一个数据页存储到磁盘,变成一棵 8叉搜索树,那么搜索一条数据记录仅需约 7次磁盘I/O:\(log_81000000≈7\); 而当将分支因子扩展到 128,那么搜索一条数据记录仅需约 3次磁盘I/O:\(log_{128}1000000≈3\)。 3. 定义与概念 3.1. 定义 一棵 m 阶 B 树 (B-Tree) 是满足如下性质的多叉查找树: (1) 每个内部节点至多有 m 个子节点; (2) 每个内部节点至少有 m/2 个子节点(根除外); (3) 如根节点为内部节点,其至少有 2 个子节点; (4) 具有 K 个子节点的内部节点有 K-1 个键; (5) 所有外部节点的层级均相同,且不携带信息。 图3.1:5阶 B树​ 3.2. 概念 叶子节点 叶子节点在原论文中是指包含键的最底层节点(见参考资料1)。 但 Knuth 则认为叶子节点比包含键的最底层节点再低一级,叶子节点即外部节点(见参考资料2)。 这里采用原论文中的描述,叶子节点与外部节点并非同一概念。 外部节点 外部节点指的是不在树中的节点,其可能是空指针,也可能指向其它数据文件等。 由于 B 树中外部节点不携带信息,因此通常用空指针或一个特殊的空节点来指代。 但在 B 树的变体 B+ 树中,外部节点存储了键关联的数据信息,是有实际用途的。 提示:由于B树 的外部节点无实际用途,后续图示将省略外部节点。 内部节点 很多文献都可以看到“内部节点”这个名词,但都没有给出严格定义,所以经常有不同的理解。 我倾向于认为内部节点与外部节点是相互对应的概念,如果一个节点不是外部节点,那么其就是内部节点。 为避免歧义,这里先下一个定义:B 树中所有包含键的节点均为内部节点。 阶(order) 一个节点可能包含的最大子节点数,即 B树定义中的 m。 图3.1 是一棵 5阶B树,根据定义 1 和 2,根以外的内部节点至少有 ⌈m/2⌉=⌈5/2⌉=3 个子节点,且至多有 m=5 个子节点,因此 5阶 B树又称为 (3, 5) 树。 同理,3阶B树又称为 (2, 3) 树(或 2-3 树),4阶B树又称为 (2, 4) 树(或 2-3-4 树),6阶B树又称为 (3, 6) 树,7阶B树又称为 (4, 7) 树…… 定义2 是为了避免 B 树简单地退化成二叉树。 注:m/2 的计算是向上取整,如 3/2=1.5,向上取整后为 2;5/2=2.5,向上取整后为 3。 键 这里用 k 来表示每个内部节点包含的键的数量。 根据定义 4,根节点具有 [2, m] 个子节点,那么其可能包含的键数量: \(1 \leqslant k \leqslant m-1\) ; 根节点以外的内部节点具有 [m/2, m] 个子节点,那么其可能包含的键数量:\(m/2-1 \leqslant k \leqslant m-1\); 如图3.1 所示的 5 阶 B 树,根节点可能包含 1 至 4 个键,其它内部节点可能包含 2 至 4 个键。 信息 信息指的是键关联的值,又或是键关联的数据在文件的索引地址等。 B 树中并不关心信息为何种形式,这取决于具体的实现。 根节点 当 B 树为空树时,根节点用空指针或一个特殊的空节点来指代,这时根节点是外部节点;其它情况下根节点是内部节点。 高度 B 树的高度计算含外部节点,空树时高度为 0,如图3.1 所示的 5 阶B树,其高度为 3。 4. 实现 4.1. 节点定义 class Node<K, V> { //节点当前包含的键数量 int size; // 父节点 Node<K, V> parent; // 数据项数组(每一个数据项是一个键值对,根据键升序排列) Pair<K, V>[] items; // 子节点数组(根据键升序排列) Node<K, V>[] children; ​ Node(int order) { this.items = new Pair[order - 1]; this.children = new Node[order]; } ​ Node(int order, Pair<K, V> item) { this.items = new Pair[order - 1]; this.children = new Node[order]; this.items[size++] = item; } } 有序性 图4.1:节点示意 观察图4.1,我们可以发现: 一个节点中,键是升序存储的,譬如 C < F。 一个节点中,其子节点也是升序存储的,譬如 【A B】< 【D E】< 【G H】。 对于任意一个内部节点,K 表示键集合,P 表示子节点集合,那么有: \(P_0 < K_0 < P_1 < K_1 < P_2 < K_2 <...<P_{n}<K_n<P_{n+1}\) 如图4.1 所示:【A B】< C < 【D E】< F < 【G H】 如果用二叉查找树来类比,那么 \(P_0\) 是 \(K_0\) 的左孩子; \(P_1\) 既是 \(K_0\) 的右孩子,也是 \(K_1\) 的左孩子; \(P_2\) 是 \(K_1\) 的右孩子。 特别说明 为避免实现过于复杂,这里省略从外存读取数据文件并转换为主存节点的过程,直接在主存中读写子节点。 如果是从外存读取数据文件,子节点数组保存的应该是子节点在数据文件中的索引地址,类似于如下定义: // 子节点索引数组 long[] children; ​ // 根据索引从数据文件读取数据并转换为节点 Node<K, V> readFromSecondary(File dataFile, long position); ​ // 主存中的节点修改后根据索引写入数据文件 boolean writeToSecondary(Node<K,V> p, File dataFile, long position); 4.2. 查找 依惯例,先从最简单的查找开始。 4.2.1. 查找流程 图4.2:查找流程​ 4.2.2. 代码实现 @Override public V get(K key) { Assert.notNull(key); if (root == null) { return null; } // 1.先根据 Key 找到包含该 Key 的节点 Tuple2<Integer, Node<K, V>> tuple2 = search(key); int pos = tuple2.getT1(); Node<K, V> x = tuple2.getT2(); Pair<K, V> item = x.items[pos]; // 2.如果 pos 对应的数据项不为空且两个键相同,返回值;否则返回空 if (item != null && compare(item.getKey(), key) == 0) { return item.getValue(); } return null; } ​ /** * 查找键所在的节点 及 键在该节点的索引位置 * * @param key 键 * @return 返回二元组:(索引位置, 节点) */ private Tuple2<Integer, Node<K, V>> search(K key) { Node<K, V> p = root; while (true) { // 1. 二分查找(m 为中值,upper 为上界,lower 为下界) int m = p.size / 2, upper = p.size, lower = 0; while (m >= lower && m < upper) { int cmp = compare(p.items[m].getKey(), key); if (cmp > 0) { upper = m; m = m - Math.round((float) (m - lower) / 2); } else if (cmp < 0) { lower = m; m = m + Math.round((float) (upper - m) / 2); } else { // 1.1.节点包含该键 return Tuples.of(m, p); } } // 1.2.节点不包含该键 // 1.2.1.已到达叶子节点,结束查找 if (p.isLeaf()) { return Tuples.of(m, p); } // 1.2.2.未到达叶子节点,查找子节点 p = p.children[m]; } } 4.2.3. 性能分析 B树查找过程是从根节点开始逐层向下查找(节点内部执行二分查找),如果一直未命中,递归查找过程会直到叶子节点为止。 因此,最坏情况下 B树的查找时间复杂度为: \(C_{max}=h(log_2m)\) 对于B树来说,节点内部的二分查找在主存中进行,因此时间消耗非常少,所以我们更关心耗时的外存访问次数,也就是 h 的取值范围。 那么,我们这就来求高度 h 的上界和下界。 设 N 为 B树中的数据项数量,高度为 h,阶为 m。 假设高度 h 一定,当树中所有节点包含的数据项数量均为最大值,此时树中的数据项数量最多。 第0层:\(L_0=(m-1)m^0\) 第1层:\(L_1=(m-1)m^1\) 第2层:\(L_2=(m-1)m^2\) 第3层:\(L_3=(m-1)m^3\) …… 第h层:\(L_h=(m-1)m^h\) 所有层求和,可得树中的数据项的最大数量: (式4.1) : \(N_{max}=(m-1)\sum_{k=0}^{h}m^k=(m-1)\frac{(m^h-1)}{m-1}=m^h-1 (h ≥ 1)\) 假设高度 h 一定,当树中所有节点包含的数据项数量均为最小值,此时树中的数据项数量最少。 第0层:\(L_0=1\) 第1层:\(L_1=2(⌈m/2⌉-1)(⌈m/2⌉)^0\) 第2层:\(L_2=2(⌈m/2⌉-1)(⌈m/2⌉)^1\) 第3层:\(L_3=2(⌈m/2⌉-1)(⌈m/2⌉)^2\) …… 第h层:\(L_h=2(⌈m/2⌉-1)(⌈m/2⌉)^{h-1}\) 所有层求和,可得树中的数据项的最小数量: (式4.2): \(N_{min}=1+2(⌈m/2⌉-1)\frac{{⌈m/2⌉}^{h-1}-1}{⌈m/2⌉-1}=2(⌈m/2⌉^{h-1})-1 (h ≥ 1)\) 当B树中的数据项数量N一定时,每个节点包含的键数量最多时 h 最小,因此由式4.1 可得高度 h 的最小值: (式4.3): \(h_{min}=log_m(N+1) (h ≥ 1)\) 当B树中的数据项数量N一定时,每个节点包含的键数量最少时 h 最大,由式4.2 可得高度 h 的最大值: (式4.4): \(h_{max}=log_{⌈m/2⌉}(\frac{N+1}{2})+1 (h ≥ 1)\) 综合式4.3 和式 4.4,可得出高度 h 的上界和下界: (式4.5): \(log_m(N+1) \leqslant h \leqslant log_{⌈m/2⌉}(\frac{N+1}{2})+1 (h ≥ 1)\) 4.3. 插入 4.3.1. 插入流程 图4.3:插入流程 插入新数据项,需先执行查找:如果命中则替换原数据项;如果未命中,则找到相应的叶子节点。 当将新数据项存入到节点,可能会导致节点包含的数据项数量超过允许的最大值,因此需要通过分裂来解决上溢问题。 插入操作稍稍有些复杂,我们先看看下面的插入示例。 4.3.2. 插入示例 插入-1 这是一棵 5阶B树,因此一个内部节点最多会有 4个键和 5个子节点。 接下来,会演示插入 Y 和 Z,看看是如何通过分裂来解决上溢问题。 插入-2 对节点【L O R U】进行二分查找,该节点无 Y 键且非叶子节点,Y 比 U大,进入下一层:U的右孩子; 对节点【V W X】进行二分查找,该节点无 Y 键且是叶子节点,Y 比 X 大,Y 保存到 X 的右侧; 节点【V W X Y】包含的数据项未超过最大值4,结束。 插入-3 对节点【L O R U】进行二分查找,该节点无 Z 键且非叶子节点,Z 比 U大,进入下一层:U的右孩子; 对节点【V W X Y】进行二分查找,该节点无 Z 键且是叶子节点,Z 比 Y 大,Z 保存到 Y 的右侧; 节点【V W X Y Z】包含的数据项超过最大值4,需处理上溢问题。 插入-4 提取节点【V W X Y Z】的最中间数据项 X 保存到父节点【L O R U】; 以 X 为界将其它数据项分裂成两个子节点【V W】和【Y Z】; 节点【L O R U X】包含的数据项超过最大值4,需处理上溢问题。 插入-5 节点【L O R U X】为根节点,提取节点【L O R U X】的最中间数据项 R 作为新的根节点,树的高度+1; 以 R 为界将其它数据项分裂成两个子节点【L O】和【U X】,结束。 小结 观察上面的例子,我们可以发现对于上溢问题:可能需要递归向上分裂,直到根节点才结束。 4.3.3. 代码实现 @Override public void put(K key, V value) { Assert.notNull(key); Assert.notNull(value); // 1.如果为空树,创建根节点并添加键值对 if (root == null) { root = new Node<>(maxOrder, Pairs.of(key, value)); size.increment(); height.increment(); return; } // 2.查找键,并判断键是否已存在 Tuple2<Integer, Node<K, V>> tuple2 = search(key); int pos = tuple2.getT1(); Node<K, V> x = tuple2.getT2(); Pair<K, V> item = x.items[pos]; if (item != null && compare(item.getKey(), key) == 0) { // 2.1. 当前节点已存在该 Key x.setItem(pos, Pairs.of(key, value)); return; } // 2.2. 键不在树中,增加树的size size.increment(); // 3.添加键值对到最底层的内部节点 x.addItem(pos, Pairs.of(key, value)); // 4. 上溢处理 solveOverflow(x); } 4.3.4. 上溢处理 private void solveOverflow(Node<K, V> x) { // 判断当前节点是否上溢(键数量超过允许的最大值) while (x.size > maxElement) { Node<K, V> p = x.parent; // 1.如果出现上溢,提取当前节点最中间的数据项 Pair<K, V> item = x.items[median]; int pos = 0; if (p == null) { // 2.父节点为空,说明当前节点为 root,创建新的根节点 root = p = new Node<>(maxOrder); // 2.1.树高 +1 height.increment(); } else { // 3.获取中间数据项在父节点中的插入位置 pos = position(p, x); } // 4.当前节点最中间的数据项并添加到父节点 p.addItem(pos, item); // 5.当前节点分裂成两个子节点并添加到父节点 split(p, x, pos); // 6.父节点设为当前节点 x = p; } } ​ /** * 上溢节点分裂为两个节点 * * @param p 父节点 * @param x 上溢节点 * @param pos 索引位置 */ private void split(Node<K, V> p, Node<K, V> x, int pos) { Node<K, V> lc = new Node<K, V>(maxOrder).setItems(x, 0, median); Node<K, V> rc = new Node<K, V>(maxOrder).setItems(x, median + 1, maxElement - median); p.setChild(pos, lc); p.addChild(pos + 1, rc); } 4.4. 删除 4.4.1. 删除流程 图4.4:删除流程​ 删除数据项,如果待删除的数据项所在的节点非叶子节点,需要与其前驱交换数据项,然后再从叶子节点开始执行删除。 当将数据项删除之后,可能会导致节点包含的数据项数量小于允许的最小值,因此需要通过旋转和合并来解决下溢问题。 还是一样,我们先看看具体的删除示例。 4.4.2. 删除示例 删除-01 这是一棵 5阶B树,因此根节点至少有1个键和2个子节点,其它内部节点至少会有 2个键和 3个子节点。 接下来,会演示删除 K, V 和 Y,看看是如何通过旋转和合并解决下溢问题。 删除-02 根据键 K 找到节点【K N】,该节点非叶子节点,找到 K 的前驱 J。 删除-03 K 和 J 交换。 删除-04 删除 K; 节点【H I】的剩余数据项数量为 2,没有下溢问题,结束。 删除-05 根据键 V 找到节点【U V】,该节点为叶子节点,无需交换,直接删除 V。 删除 V 后节点【U】的数据项数量少于2,出现下溢问题; 节点【U】的左兄弟没有富余节点,右兄弟有富余节点,因此通过左旋来解决下溢问题; 删除-06 父节点的 W 移入【U】节点,当前节点变成【U W】,父节点的变成【T】; 右兄弟节点的 X 移入父节点;父节点的变成【T X】,右兄弟节点变成【Y Z】。 删除-07 旋转完成后如上图,结束。 删除-08 根据键 Y 找到节点【Y Z】,该节点为叶子节点,直接删除 Y; 删除 Y 后节点【Z】仅余 1 个键,出现下溢问题; 节点【Z】的左兄弟和右兄弟均没有富余节点,因此需要通过合并来解决下溢问题。 删除-09 父节点【T X】的 X 移入【Z】节点,该节点变成【X Z】,父节点变成【T】; 节点【X Z】和其左兄弟【U W】合并,合并后变成【U W X Z】; 父节点【T】仅余一个键,出现下溢问题。 删除-10 节点【T】的左兄弟没有富余节点,因此需要通过合并来解决下溢问题; 父节点的 Q 移入节点【T】,节点【T】变成【Q T】; 节点【Q T】与左兄弟【J N】合并,合并后变成【J N Q T】; 父节点【】已经没有键,且父节点为根节点; 节点【J N Q T】设为根节点,树的高度减 1。 删除-11 合并完成后如上图,结束。 小结 观察上面的例子,我们可以发现对于下溢问题: 如果兄弟节点有富余,那么一次旋转操作即可结束; 如果兄弟节点无富余,合并操作可能导致父节点再次出现下溢,最坏情况下需要递归执行到根节点才结束。 4.4.3. 代码实现 @Override public V remove(K key) { Assert.notNull(key); // 1.查找键所在节点 Tuple2<Integer, Node<K, V>> tuple2 = search(key); int pos = tuple2.getT1(); Node<K, V> x = tuple2.getT2(); Pair<K, V> item = x.items[pos]; // 2.如果键不存在于树中,结束 if (item == null || compare(item.getKey(), key) != 0) { return null; } // 3.如果键存在于树中,删除数据项,树包含的数据项数量减1 size.decrement(); V oldVal = item.getValue(); if (x.isLeaf()) { // 3.1.如果是叶子节点,直接删除 x.deleteItem(pos); } else { // 3.2.如果是非叶节点,与前驱交换数据项,前驱必定为叶子节点 x = predecessor(x, pos); } // 4.解决下溢问题 solveUnderflow(x); // 5.返回旧值 return oldVal; } ​ /** * 与前驱交换数据项 * * @param x 待删除键的节点 * @param pos 键的索引位置 * @return 前驱节点 */ private Node<K, V> predecessor(Node<K, V> x, int pos) { Node<K, V> pred = x.children[pos]; while (!pred.isLeaf()) { pred = pred.children[pred.size]; } // 1.前驱节点中的最后一个数据项即为前驱 int swapIndex = pred.size - 1; x.items[pos] = pred.items[swapIndex]; // 2.前驱节点删除已交换的数据项 pred.deleteItem(swapIndex); // 3.返回前驱节点 return pred; } 4.4.4.下溢处理 /** * 下溢处理 * * @param x 当前节点 */ private void solveUnderflow(Node<K, V> x) { while (x.size < median) { Node<K, V> p = x.parent; if (p == null) { // 1.当前节点为根节点,且已无数据项,其唯一子节点设为根节点 if (x.size == 0) { root = x.children[0]; height.decrement(); } return; } int pos = position(p, x); // 2. 旋转 if (pos > 0) { Node<K, V> sl = p.children[pos - 1]; // 2.1.左兄弟有富余数据项,右旋 if (sl.size > median) { rotateRight(p, x, sl, pos); return; } } if (pos < p.size) { Node<K, V> sr = p.children[pos + 1]; // 2.2.右兄弟有富余数据项,左旋 if (sr.size > median) { rotateLeft(p, x, sr, pos); return; } } // 3. 合并 if (pos > 0) { merge(p, p.children[pos - 1], x, pos - 1); } else { merge(p, x, p.children[pos + 1], pos); } x = p; } } ​ /** * 获取子节点在父节点中的索引位置 * * @param p 父节点 * @param x 子节点 * @return 索引位置 */ private int position(Node<K, V> p, Node<K, V> x) { for (int i = 0; i <= p.size; i++) { if (x == p.children[i]) { return i; } } return -1; } ​ /** * 右旋 * * @param p 父节点 * @param x 当前节点 * @param sl 当前节点的左兄弟 * @param pos 父节点中用于旋转的数据项索引位置 */ void rotateRight(Node<K, V> p, Node<K, V> x, Node<K, V> sl, int pos) { x.addItem(0, p.items[pos]); p.setItem(pos, sl.items[sl.size - 1]); sl.deleteItem(sl.size - 1); x.addChild(0, sl.children[sl.size]); sl.deleteChild(sl.size); } ​ /** * 左旋 * * @param p 父节点 * @param x 当前节点 * @param sr 当前节点的右兄弟 * @param pos 父节点中用于旋转的数据项索引位置 */ void rotateLeft(Node<K, V> p, Node<K, V> x, Node<K, V> sr, int pos) { x.addItem(x.size, p.items[pos]); p.setItem(pos, sr.items[0]); sr.deleteItem(0); x.addChild(x.size, sr.children[0]); sr.deleteChild(0); } ​ /** * 合并兄弟节点 * * @param p 父节点 * @param l 左孩子节点 * @param r 右孩子节点 * @param pos 父节点中用于合并的数据项索引位置 */ void merge(Node<K, V> p, Node<K, V> l, Node<K, V> r, int pos) { l.addItem(l.size, p.items[pos]); p.deleteItem(pos); p.deleteChild(pos + 1); l.merge(r); } 5. 小结 这篇文章介绍了 B 树的基本操作,实现其实并不复杂,全部代码也就是400行,完整代码在这里:BTree。 如果有兴趣的话,加上锁和读写数据文件的相关代码,其实就可以看作是一个极简的数据库了。 当然,要实现一个真正可用的数据库,还需要考虑锁、事务、缓存、写日志、数据文件、网络协议、SQL解析等,这就不那么容易了。 下一篇文章,我将会结合 4 阶 B 树来介绍红黑树的设计和操作,欢迎继续关注。 参考资料 [ 1] Bayer R , McCreight E . Organization and maintenance of large ordered indices[J]. acta informatica, 1972. [ 2] Donald E. Knuth. "The Art of Computer Programming. Volume III: Sorting and Searching." Addison-Wesley, 2014. [ 3] 邓俊辉. 数据结构(C++语言版)[M]. 清华大学出版社, 2013.

优秀的个人博客,低调大师

每日一博 | KubeSphere 后端源码深度解析

这篇文章我们将学习在 vscode 上的 ssh remote 插件基础上,尝试 debug 和学习 KubeSphere 后端模块架构。 前提 安装好 vscode 以及 ssh remote container 插件; 在远程主机上安装好 kubenertes 容器 " 操作系统 " 和 KubeSphere >= v3.1.0 云“控制面板”; 安装 go >=1.16; 在 KubeSphere 上安装了需要 debug 的 ks 组件,如 devops、kubeedge 或者 whatever, 如果是默认激活的组件,像 monitoring,不需要去激活。 配置 launch 文件 $ cat .vscode/launch.json { // 使用 IntelliSense 了解相关属性。 // 悬停以查看现有属性的描述。 // 欲了解更多信息,请访问: https://go.microsoft.com/fwlink/?linkid=830387 "version": "0.2.0", "configurations": [ { "name": "ks-apiserver", "type": "go", "request": "launch", "mode": "auto", "program": "${workspaceFolder}/cmd/ks-apiserver/apiserver.go" } ] } ks-apiserver 调试依赖文件 在相对路径 cmd/ks-apiserver/ 下配置 kubesphere.yaml。 首先,查看集群之中的 cm 配置文件 : $ kubectl -n kubesphere-system get cm kubesphere-config -oyaml 因为上述 configmap 中差少 kubeconfig 相关配置,所以需要将上述 yaml 文件拷贝出来整合以下。 为啥要用添加 kubeconfig 文件? 主要是因为 k8s 在创建 client 时需要这么一个文件 , 而容器中会用到 inclusterconfig 就不需要添加了。 感兴趣可以看下 client-go 的例子: https://github.com/kubernetes/client-go/blob/master/examples/in-cluster-client-configuration/main.go#L41 https://github.com/kubernetes/client-go/blob/master/examples/out-of-cluster-client-configuration/main.go#L53 所以完整的配置启动文件如下: $ cat ./cmd/ks-apiserver/kubesphere.yaml kubernetes: kubeconfig: "/root/.kube/config" master: https://192.168.88.6:6443 $qps: 1e+06 burst: 1000000 authentication: authenticateRateLimiterMaxTries: 10 authenticateRateLimiterDuration: 10m0s loginHistoryRetentionPeriod: 168h maximumClockSkew: 10s multipleLogin: True kubectlImage: kubesphere/kubectl:v1.20.0 jwtSecret: "Xtc8ZWUf9f3cJN89bglrTJhfUPMZR87d" oauthOptions: clients: - name: kubesphere secret: kubesphere redirectURIs: - '*' network: ippoolType: none monitoring: endpoint: http://prometheus-operated.kubesphere-monitoring-system.svc:9090 enableGPUMonitoring: false gpu: kinds: - resourceName: nvidia.com/gpu resourceType: GPU default: True notification: endpoint: http://notification-manager-svc.kubesphere-monitoring-system.svc:19093 kubeedge: endpoint: http://edge-watcher.kubeedge.svc/api/ gateway: watchesPath: /var/helm-charts/watches.yaml namespace: kubesphere-controls-system 除了 kubernetes, 第一层的 key 表示我们集群中已经按照或者默认激活的 ks 组件,现在就可以通过 F5 来启动 debug 了。 在 debug 之前,你可能会问,这个配置文件为啥要放在 /cmd/ks-apiserver/kubesphere.yaml? 我们先来探索一波 ks-apiserver 的运行逻辑。 启动 ks-apiserver 查看 cmd/ks-apiserver/app/server.go 的逻辑 : // Load configuration from file conf, err := apiserverconfig.TryLoadFromDisk() TryLoadFromDisk 的逻辑如下: viper.SetConfigName(defaultConfigurationName) // kubesphere viper.AddConfigPath(defaultConfigurationPath) // /etc/kubesphere // Load from current working directory, only used for debugging viper.AddConfigPath(".") // Load from Environment variables viper.SetEnvPrefix("kubesphere") viper.AutomaticEnv() viper.SetEnvKeyReplacer(strings.NewReplacer(".", "_")) // 上面一顿配置之后,单步调试,ReadInConfig这一步读取的文件路径是 // v.configPaths:["/etc/kubesphere","/root/go/src/kubesphere.io/kubesphere/cmd/ks-apiserver"] if err := viper.ReadInConfig(); err != nil { if _, ok := err.(viper.ConfigFileNotFoundError); ok { return nil, err } else { return nil, fmt.Errorf("error parsing configuration file %s", err) } } conf := New() // 初始化各组件配置 // 从读取的实际路径配置文件来反序列化到conf这个struct if err := viper.Unmarshal(conf); err != nil { return nil, err } return conf, n 上面的注释,解释了需要在指定路径下添加 kubesphere.yaml 启动 ks-apiserver 命令行。 我们接着往下撸,这里使用 cobra.Command 这个 package 来做命令行的集成: func Run(s *options.ServerRunOptions, ctx context.Context) error { // NewAPIServer 通过给定的配置启动apiserver实例,绑定实例化的各组件的client // 这一步还通过AddToScheme来注册一些自定义的GVK到k8s,最终暴露为apis API // 借助rest.Config和scheme 初始化runtimecache和runtimeClient apiserver, err := s.NewAPIServer(ctx.Done()) if err != nil { return err } // PrepareRun 主要是使用resful-go集成kapis API // 上一步绑定了各组件的client,这一步就可以调用各组件的client来访问对应组件的server端了 // 猜猜4.0后端可插拔架构会是什么样子的? err = apiserver.PrepareRun(ctx.Done()) if err != nil { return nil } // 运行各种informers同步资源,并开始ks-apiserver监听请求 return apiserver.Run(ctx) } s.NewAPIServer(ctx.Done()) 主要是创建一个 apiserver 实例。创建 apiserver 实例这一步,还通过 scheme 注册 ks 自定义的 GVK 到 k8s, 暴露为 apis 请求路径的 API。 PrepareRun 主要是使用 resful-go 框架集成了各子模块代理请求或集成服务, 暴露为 kapis 请求路径的 API 功能 。 apiserver.Run(ctx) 则是做了资源同步,并启动 server 监听。 下面分开阐述说明。 NewAPIServer 首先是绑定各种 client 和 informers: // 调用各组件的NewForConfig方法整合clientset kubernetesClient, err := k8s.NewKubernetesClient(s.KubernetesOptions) if err != nil { return nil, err } apiServer.KubernetesClient = kubernetesClient informerFactory := informers.NewInformerFactories(kubernetesClient.Kubernetes(), kubernetesClient.KubeSphere(),kubernetesClient.Istio(), kubernetesClient.Snapshot(), kubernetesClient.ApiExtensions(), kubernetesClient.Prometheus()) apiServer.InformerFactory = informerFactory ... // 根据kubesphere.yaml或者kubesphere-config configmap的配置来绑定ks组件的client ... 初始化绑定完毕后 , 会启动一个 server 来响应请求 , 所以这里会做一个 addr 绑定 : ... server := &http.Server{ Addr: fmt.Sprintf(":%d", s.GenericServerRunOptions.InsecurePort), } if s.GenericServerRunOptions.SecurePort != 0 { certificate, err := tls.LoadX509KeyPair(s.GenericServerRunOptions.TlsCertFile, s.GenericServerRunOptions.TlsPrivateKey) if err != nil { return nil, err } server.TLSConfig = &tls.Config{ Certificates: []tls.Certificate{certificate}, } server.Addr = fmt.Sprintf(":%d", s.GenericServerRunOptions.SecurePort) } sch := scheme.Scheme if err := apis.AddToScheme(sch); err != nil { klog.Fatalf("unable add APIs to scheme: %v", err) } ... 注意这一步 apis.AddToScheme(sch), 将我们定义的 GVK 注册到 k8s 中。 顺带一提,GVK 指的是 Group,Version, Kind, 举个栗子: {Group: "", Version: "v1", Resource: "namespaces"} {Group: "", Version: "v1", Resource: "nodes"} {Group: "", Version: "v1", Resource: "resourcequotas"} ... {Group: "tenant.kubesphere.io", Version: "v1alpha1", Resource: "workspaces"} {Group: "cluster.kubesphere.io", Version: "v1alpha1", Resource: "clusters"} ... Scheme 管理 GVK 和 Type 的关系 , 一个 GVK 只能对应一个 reflect.Type, 一个 reflect.Type 可能对应多个 GVK;此外,Scheme 还聚合了 converter 及 cloner, 用来转换不同版本的结构体和获取结构体值的拷贝;限于篇幅有限,感兴趣的童鞋可以深入探索下。 回归正文,下面我们看下怎么注入 scheme 的: // AddToSchemes may be used to add all resources defined in the project to a Schemevar AddToSchemes runtime.SchemeBuilder // AddToScheme adds all Resources to the Schemefunc AddToScheme(s *runtime.Scheme) error { return AddToSchemes.AddToScheme(s)} 而 AddToSchemes 这个类型的是[]func(*Scheme) error 的别名,只需要在 package apis 下的接口文件中实现相应的 init() 方法来导入实现的版本 API,就可以注入 Scheme 中。 举个例子: $ cat pkg/apis/addtoscheme_dashboard_v1alpha2.go package apis import monitoringdashboardv1alpha2 "kubesphere.io/monitoring-dashboard/api/v1alpha2" func init() { AddToSchemes = append(AddToSchemes, monitoringdashboardv1alpha2.SchemeBuilder.AddToScheme) } 也就是,我们开发的插件集成的版本化资源,必须实现 xxx.SchemeBuilder.AddToScheme 功能,才能注册到 scheme 中,最终暴露为 apis 访问 API 服务。 至此,所有子模块对应的 client 已经与这个 apiserver 绑定。 PrepareRun 下面,我们探讨下 PrepareRun 是怎么注册 kapis 以及绑定 handler 的。 主要是通过 restful-go 框架来实现的。 restful-go 框架使用 container 来 hold 住拥有特定 GVR 的 webservice, 一个 webserver 可以绑定多个 router,允许 container 或者 webserver 添加自定义拦截器,也就是调用 filter 方法。 func (s *APIServer) PrepareRun(stopCh <-chan struct{}) error { // container来hold住拥有特定GVR的webservice s.container = restful.NewContainer() // 添加请求Request日志拦截器 s.container.Filter(logRequestAndResponse) s.container.Router(restful.CurlyRouter{}) // 发生Recover时,绑定一个日志handler s.container.RecoverHandler(func(panicReason interface{}, httpWriter http.ResponseWriter) { logStackOnRecover(panicReason, httpWriter) }) // 每个API组都构建一个webservice,然后根据路由规则来并绑定回调函数 // 通过AddToContainer来完成绑定 s.installKubeSphereAPIs() // 注册metrics指标: ks_server_request_total、ks_server_request_duration_seconds // 绑定metrics handler s.installMetricsAPI() // 为有效请求增加监控计数 s.container.Filter(monitorRequest) for _, ws := range s.container.RegisteredWebServices() { klog.V(2).Infof("%s", ws.RootPath()) } s.Server.Handler = s.container // 添加各个调用链的拦截器, 用于验证和路由分发 s.buildHandlerChain(stopCh) return nil } 上面主要使用 restful-go 框架给 s.Server.handler 绑定了一个 container, 添加了各种拦截器。 在 s.installKubeSphereAPIS() 这一步安装 GVR 绑定了 kapis 代理,具体是这样实现的: // 调用各api组的AddToContainer方法来向container注册kapi: urlruntime.Must(monitoringv1alpha3.AddToContainer(s.container, s.KubernetesClient.Kubernetes(), s.MonitoringClient, s.MetricsClient, s.InformerFactory, s.KubernetesClient.KubeSphere(), s.Config.OpenPitrixOptions)) // 详细来说,各个组件实现的AddToContainer方法 // 为带有GroupVersion信息的webserver添加route,不同路由路径绑定不同的handler ws := runtime.NewWebService(GroupVersion) // 给子路由绑定回调函数 ws.Route(ws.GET("/kubesphere"). To(h.handleKubeSphereMetricsQuery). Doc("Get platform-level metric data."). Metadata(restfulspec.KeyOpenAPITags, []string{constants.KubeSphereMetricsTag}). Writes(model.Metrics{}). Returns(http.StatusOK, respOK, model.Metrics{})). Produces(restful.MIME_JSON) 我们知道 apis 对应 k8s 的请求,而在 ks 中 kapis 对应子组件的代理请求,由 ks-apiserver 自身或者转发目标组件 server 来提供响应,那么 ks-apiserver 是怎么区分这些请求的? 答案是通过 buildHandlerChain 来进行分发的。 buildHandlerChain 上面说到 buildHandlerChain 构建了各种服务的拦截器,按序排列如下。 handler = filters.WithKubeAPIServer(handler, s.KubernetesClient.Config(), &errorResponder{}) if s.Config.AuditingOptions.Enable { handler = filters.WithAuditing(handler, audit.NewAuditing(s.InformerFactory, s.Config.AuditingOptions, stopCh)) } handler = filters.WithAuthorization(handler, authorizers) if s.Config.MultiClusterOptions.Enable { clusterDispatcher := dispatch.NewClusterDispatch(s.InformerFactory.KubeSphereSharedInformerFactory().Cluster().V1alpha1().Clusters()) handler = filters.WithMultipleClusterDispatcher(handler, clusterDispatcher) } handler = filters.WithAuthentication(handler, authn) handler = filters.WithRequestInfo(handler, requestInfoResolver) WithRequestInfo 这个 filter 定义了如下逻辑: info, err := resolver.NewRequestInfo(req) --- func (r *RequestInfoFactory) NewRequestInfo(req *http.Request) (*RequestInfo, error) { ... defer func() { prefix := requestInfo.APIPrefix if prefix == "" { currentParts := splitPath(requestInfo.Path) //Proxy discovery API if len(currentParts) > 0 && len(currentParts) < 3 { prefix = currentParts[0] } } // 通过api路由路径中的携带apis还是kapis就可以区分 if kubernetesAPIPrefixes.Has(prefix) { requestInfo.IsKubernetesRequest = true } }() ... // URL forms: /clusters/{cluster}/* if currentParts[0] == "clusters" { if len(currentParts) > 1 { requestInfo.Cluster = currentParts[1] } if len(currentParts) > 2 { currentParts = currentParts[2:] } } ... } 代码很多,我就不一一截图了,大概意思可以从注释看到: // NewRequestInfo returns the information from the http request. If error is not nil, RequestInfo holds the information as best it is known before the failure // It handles both resource and non-resource requests and fills in all the pertinent information for each. // Valid Inputs: // // /apis/{api-group}/{version}/namespaces // /api/{version}/namespaces // /api/{version}/namespaces/{namespace} // /api/{version}/namespaces/{namespace}/{resource} // /api/{version}/namespaces/{namespace}/{resource}/{resourceName} // /api/{version}/{resource} // /api/{version}/{resource}/{resourceName} // // Special verbs without subresources: // /api/{version}/proxy/{resource}/{resourceName} // /api/{version}/proxy/namespaces/{namespace}/{resource}/{resourceName} // // Special verbs with subresources: // /api/{version}/watch/{resource} // /api/{version}/watch/namespaces/{namespace}/{resource} // // /kapis/{api-group}/{version}/workspaces/{workspace}/{resource}/{resourceName} // / // /kapis/{api-group}/{version}/namespaces/{namespace}/{resource} // /kapis/{api-group}/{version}/namespaces/{namespace}/{resource}/{resourceName} // With workspaces: // /kapis/clusters/{cluster}/{api-group}/{version}/namespaces/{namespace}/{resource} // /kapis/clusters/{cluster}/{api-group}/{version}/namespaces/{namespace}/{resource}/{resourceName} 通过路由定义的信息,就可以区分这个请求是什么级别的,以及这个请求要分发到哪个 server 了。 我们给各个 filter 的回调函数加上断点, 然后做个小实验看下拦截器的拦截顺序是怎样的。 假设远程云主机的服务已经启动,服务端口在 9090,以及你为 anonymous 这个 globalrole 设定了 monitoring.kubesphere.io 这个组下资源类型为 ClusterDashboard 的访问权限。当然了,你也可以用有访问权限的账号来直接测试。 接下来,我们来发送一个 kapis 请求,看这个链路怎么跳跃的: curl -d '{"grafanaDashboardUrl":"https://grafana.com/api/dashboards/7362/revisions/5/download", "description":"this is a test dashboard."}' -H "Content-Type: application/json" localhost:9090/kapis/monitoring.kubesphere.io/v1alpha3/clusterdashboards/test1/template 测试结果如下: WithRequestInfo -> WithAuthentication -> WithAuthorization -> WithKubeAPIServer Run 这个方法主要干了两件事,一是启动 informers 同步资源 , 二是启动 ks apiserver。 func (s *APIServer) Run(ctx context.Context) (err error) { // 启动informer工厂,包括k8s和ks的informers // 同步资源,包括k8s和ks的GVR // 检查GVR是否存在,不存在报错警告,存在就同步 err = s.waitForResourceSync(ctx) if err != nil { return err } shutdownCtx, cancel := context.WithCancel(context.Background()) defer cancel() go func() { <-ctx.Done() _ = s.Server.Shutdown(shutdownCtx) }() // 启动server klog.V(0).Infof("Start listening on %s", s.Server.Addr) if s.Server.TLSConfig != nil { err = s.Server.ListenAndServeTLS("", "") } else { err = s.Server.ListenAndServe() } return err } 至此,调用完 Run 方法后,ks-apiserver 就启动了。 现在我们做一下简单总结: 根据配置文件创建 ks-apiserver 实例 , 该实例调用了三个关键方法,分别是 NewAPIServer、PrepareRun 以及 Run 方法; NewAPIServer 通过给定的配置,绑定各个模块的 client,将自定义的 GVK 注册到 Scheme,暴露 apis 路由服务; PrepareRun 通过 restful-go 框架来注册、绑定 kapi 路由和回调函数,用来自身响应或者下发组件 server 查询合并数据返回给客户端 ; 最后 , 调用 Run 方法,同步资源并启动 ks-apiserver 服务; GVK 探索实战 显然,我们只需要关注各模块的 AddToContainer 方法就行了。 iam.kubesphere.io pkg/kapis/iam/v1alpha2/register.go 从代码注释来看,这个模块管理着 users、clustermembers、globalroles、clusterroles、workspaceroles、roles、workspaces groups 、workspace members、devops members 等账号角色的 CRUD。 现在我们可以在 handler 中打上断点,去请求这些 api。 $ curl "localhost:9090/kapis/iam.kubesphere.io/v1alpha2/users" $ curl "localhost:9090/kapis/iam.kubesphere.io/v1alpha2/clustermembers" $ curl "localhost:9090/kapis/iam.kubesphere.io/v1alpha2/users/admin/globalroles" ... kubeedge.kubesphere.io pkg/kapis/kubeedge/v1alpha1/register.go 代码里面使用的代理转发请求: func AddToContainer(container *restful.Container, endpoint string) error { proxy, err := generic.NewGenericProxy(endpoint, GroupVersion.Group, GroupVersion.Version) if err != nil { return nil } return proxy.AddToContainer(container) } 也就是 kapis/kubeedge.kubesphere.io 的请求会转发到 http://edge-watcher.kubeedge.svc/api/,也就是 kubeedge 这个 namespace 下的 service,相关的接口集成在那里。 关于整合边缘计算平台的集成,除了需要做一个主流边缘框架的快速安装和集成外,还可以集成一个类似 edge-shim 的适配器,大概需要从一下几个方面考虑: 代理 endpoint: 现在的 kubeedge 就是使用代理模式转发; 健康检查接口:至少要确保云端的组件已经成功部署; 事件、长期日志、审计等可观测组件的支持; 其他边缘辅助功能,如文件或者配置下发等; notification.kubesphere.io pkg/kapis/notification/v2beta1/register.go 这个组下的 api 主要实现了 notification 的全局或租户级别的 config 和 receivers 资源的 CRUD。 config 资源 用于配置对接通知渠道相关参数的一些配置,分为全局的和租户级别的 config 资源; reciever 资源 用于配置接收者的一些配置信息,区分全局的和租户级别的接收者; 我们挑选一个回调函数进行剖析: ws.Route(ws.GET("/{resources}"). To(h.ListResource). Doc("list the notification configs or receivers"). Metadata(KeyOpenAPITags, []string{constants.NotificationTag}). Param(ws.PathParameter("resources", "known values include configs, receivers, secrets")). Param(ws.QueryParameter(query.ParameterName, "name used for filtering").Required(false)). Param(ws.QueryParameter(query.ParameterLabelSelector, "label selector used for filtering").Required(false)). Param(ws.QueryParameter("type", "config or receiver type, known values include dingtalk, email, slack, webhook, wechat").Required(false)). Param(ws.QueryParameter(query.ParameterPage, "page").Required(false).DataFormat("page=%d").DefaultValue("page=1")). Param(ws.QueryParameter(query.ParameterLimit, "limit").Required(false)). Param(ws.QueryParameter(query.ParameterAscending, "sort parameters, e.g. ascending=false").Required(false).DefaultValue("ascending=false")). Param(ws.QueryParameter(query.ParameterOrderBy, "sort parameters, e.g. orderBy=createTime")). Returns(http.StatusOK, api.StatusOK, api.ListResult{Items: []interface{}{}})) func (h *handler) ListResource(req *restful.Request, resp *restful.Response) { // 租户或用户的名称 user := req.PathParameter("user") // 资源类型,configs/recievers/secrets resource := req.PathParameter("resources") // 通知渠道 dingtalk/slack/email/webhook/wechat subresource := req.QueryParameter("type") q := query.ParseQueryParameter(req) if !h.operator.IsKnownResource(resource, subresource) { api.HandleBadRequest(resp, req, servererr.New("unknown resource type %s/%s", resource, subresource)) return } objs, err := h.operator.List(user, resource, subresource, q) handleResponse(req, resp, objs, err) } 我们看下 list object 的逻辑: // List objects. func (o *operator) List(user, resource, subresource string, q *query.Query) (*api.ListResult, error) { if len(q.LabelSelector) > 0 { q.LabelSelector = q.LabelSelector + "," } filter := "" // 如果没有给定租户的名称,则获取全局的对象 if user == "" { if isConfig(o.GetObject(resource)) { // type=default对config资源来说是全局的 filter = "type=default" } else { // type=global对receiever资源来说是全局的 filter = "type=global" } } else { // 否则就给过滤器绑定租户名称 filter = "type=tenant,user=" + user } // 组装过滤标签 q.LabelSelector = q.LabelSelector + filter ... // 通过过滤标签获取cluster或者namespace下的指定资源 res, err := o.resourceGetter.List(resource, ns, q) if err != nil { return nil, err } if subresource == "" || resource == Secret { return res, nil } results := &api.ListResult{} ... } 这样一来,就实现了租户级别的通知告警 CR 配置的 CRUD,这些 CR 是这么分类的: config 分为全局 type = default, 租户 type = tenant 两种级别; reciever 分为全局 type = global, 租户 type = tenant 两种级别; 那么 config 和 reciever 怎么相互绑定、告警是如何通过渠道给租户发消息的? https://github.com/kubesphere/notification-manager/blob/master/pkg/webhook/v1/handler.go#L45 https://github.com/kubesphere/notification-manager/blob/master/pkg/notify/notify.go#L66 notification-manager 简称 nm,我这里断章取义地简要回答一下。 功能方面: 全局配置 reciever 通过配置的渠道将所有的 alerts 发送给其定义好的接收者名单, 配置了租户信息的 reciever 只能通过渠道发送当前 ns 下的 alerts; reciever 中可以通过配置 alertSelector 参数来进一步过滤告警消息; 通过修改名为 notification-manager-template 的 confimap 来定制发送消息模板; 告警到通知的流程: nm 使用端口 19093 和 API 路径 /api/v2/alerts 接收从 Alertmanager 发送的告警 ; 回调函数接受 alerts 转换为 notification 模板数据,按照 namespace 区分告警数据; 遍历所有 Recievers,每个 ns 下启动一个协程来发送消息, 而这里每个 ns 对应着多个通知渠道,因此也使用 waitgroup 来并发编排完成任务; monitoring.kubesphere.io pkg/kapis/monitoring/v1alpha3/register.go 将监控指标分为平台级、节点级、workspaces、namespaces、pods 等级别,不仅可以获取总的统计,还能获取 nodes/namespaces/workspaces 下的所有 pods/containers 等监控指标。 我们查看回调函数,以 handleNamedMetricsQuery 为例分析: 遍历给定指标级别下的合法 metric 指标,根据请求参数中 metricFilter 的来过滤指标名; 判断为范围查询还是实时查询,来调取 monitoring 包中相关方法,通过对应的 client 请求后端获取结果返回; 代码如下: func (h handler) handleNamedMetricsQuery(resp *restful.Response, q queryOptions) { var res model.Metrics var metrics []string // q.namedMetrics 是一组按照监控指标级别分类好的拥有promsql expr定义的完整指标名数组 // 监控指标级别分类是根据 monitoring.Levelxxx在上一个栈里细分的,i.e: monitoring.LevelPod for _, metric := range q.namedMetrics { if strings.HasPrefix(metric, model.MetricMeterPrefix) { // skip meter metric continue } // 根据请求参数中的指标名来过滤 ok, _ := regexp.MatchString(q.metricFilter, metric) if ok { metrics = append(metrics, metric) } } if len(metrics) == 0 { resp.WriteAsJson(res) return } // 判断是否是范围查询还是实时查询,继续调用相关函数 // 主要还是用prometheus client去查询promsql, 边缘节点的指标目前通过metrics server来查询 if q.isRangeQuery() { res = h.mo.GetNamedMetricsOverTime(metrics, q.start, q.end, q.step, q.option) } else { res = h.mo.GetNamedMetrics(metrics, q.time, q.option) if q.shouldSort() { res = *res.Sort(q.target, q.order, q.identifier).Page(q.page, q.limit) } } resp.WriteAsJson(res) } 现在,我们将视角移植到 : pkg/models/monitoring/monitoring.go:156 以 GetNamedMetricsOverTime 为例,这里阐述了会合并 prometheus 和 metrics-server 的查询结果进行返回: func (mo monitoringOperator) GetNamedMetricsOverTime(metrics []string, start, end time.Time, step time.Duration, opt monitoring.QueryOption) Metrics { // 获取prometheus client查询结果,主要使用sync.WaitGroup并发查询,每个指标启动一个goroutine,最后将结果和并返回 ress := mo.prometheus.GetNamedMetricsOverTime(metrics, start, end, step, opt) // 如果metrics-server激活了 if mo.metricsserver != nil { //合并边缘节点数据 edgeMetrics := make(map[string]monitoring.MetricData) for i, ressMetric := range ress { metricName := ressMetric.MetricName ressMetricValues := ressMetric.MetricData.MetricValues if len(ressMetricValues) == 0 { // this metric has no prometheus metrics data if len(edgeMetrics) == 0 { // start to request monintoring metricsApi data mr := mo.metricsserver.GetNamedMetricsOverTime(metrics, start, end, step, opt) for _, mrMetric := range mr { edgeMetrics[mrMetric.MetricName] = mrMetric.MetricData } } if val, ok := edgeMetrics[metricName]; ok { ress[i].MetricData.MetricValues = append(ress[i].MetricData.MetricValues, val.MetricValues...) } } } } return Metrics{Results: ress} } 此外,monitoring 包还定义了各监控查询 client 的接口方法,可以按需探索: GetMetric(expr string, time time.Time) Metric GetMetricOverTime(expr string, start, end time.Time, step time.Duration) Metric GetNamedMetrics(metrics []string, time time.Time, opt QueryOption) []Metric GetNamedMetricsOverTime(metrics []string, start, end time.Time, step time.Duration, opt QueryOption) []Metric GetMetadata(namespace string) []Metadata GetMetricLabelSet(expr string, start, end time.Time) []map[string]string tenant.kubesphere.io 再聊 api 之前,顺带一提多租户在隔离的安全程度上,我们可以将其分为软隔离 (Soft Multi-tenancy) 和硬隔离 (Hard Multi-tenancy) 两种。 软隔离更多的是面向企业内部的多租需求; 硬隔离面向的更多是对外提供服务的服务供应商,需要更严格的隔离作为安全保障。 这个 group 下比较重要的部分是实现租户查询 logs/audits/events: 以查询日志为例: func (h *tenantHandler) QueryLogs(req *restful.Request, resp *restful.Response) { // 查询上下文中携带的租户信息 user, ok := request.UserFrom(req.Request.Context()) if !ok { err := fmt.Errorf("cannot obtain user info") klog.Errorln(err) api.HandleForbidden(resp, req, err) return } // 解析查询的参数,比如确定属于哪个ns/workload/pod/container的查询、时间段,是否为柱状查询等 queryParam, err := loggingv1alpha2.ParseQueryParameter(req) if err != nil { klog.Errorln(err) api.HandleInternalError(resp, req, err) return } // 导出数据 if queryParam.Operation == loggingv1alpha2.OperationExport { resp.Header().Set(restful.HEADER_ContentType, "text/plain") resp.Header().Set("Content-Disposition", "attachment") // 验证账号是否有权限 // admin账号可以导出所有ns的日志,租户只能导出本ns的日志 // 组装loggingclient进行日志导出 err := h.tenant.ExportLogs(user, queryParam, resp) if err != nil { klog.Errorln(err) api.HandleInternalError(resp, req, err) return } } else { // 验证账号是否有权限 // admin账号可以查看所有ns的日志,租户只能查看本ns的日志 // 组装loggingclient进行日志返回 result, err := h.tenant.QueryLogs(user, queryParam) if err != nil { klog.Errorln(err) api.HandleInternalError(resp, req, err) return } resp.WriteAsJson(result) } } 由于篇幅有限,只对以上 GVR 进行了调试,感兴趣可以深入了解~ 本文由博客一文多发平台 OpenWrite 发布!
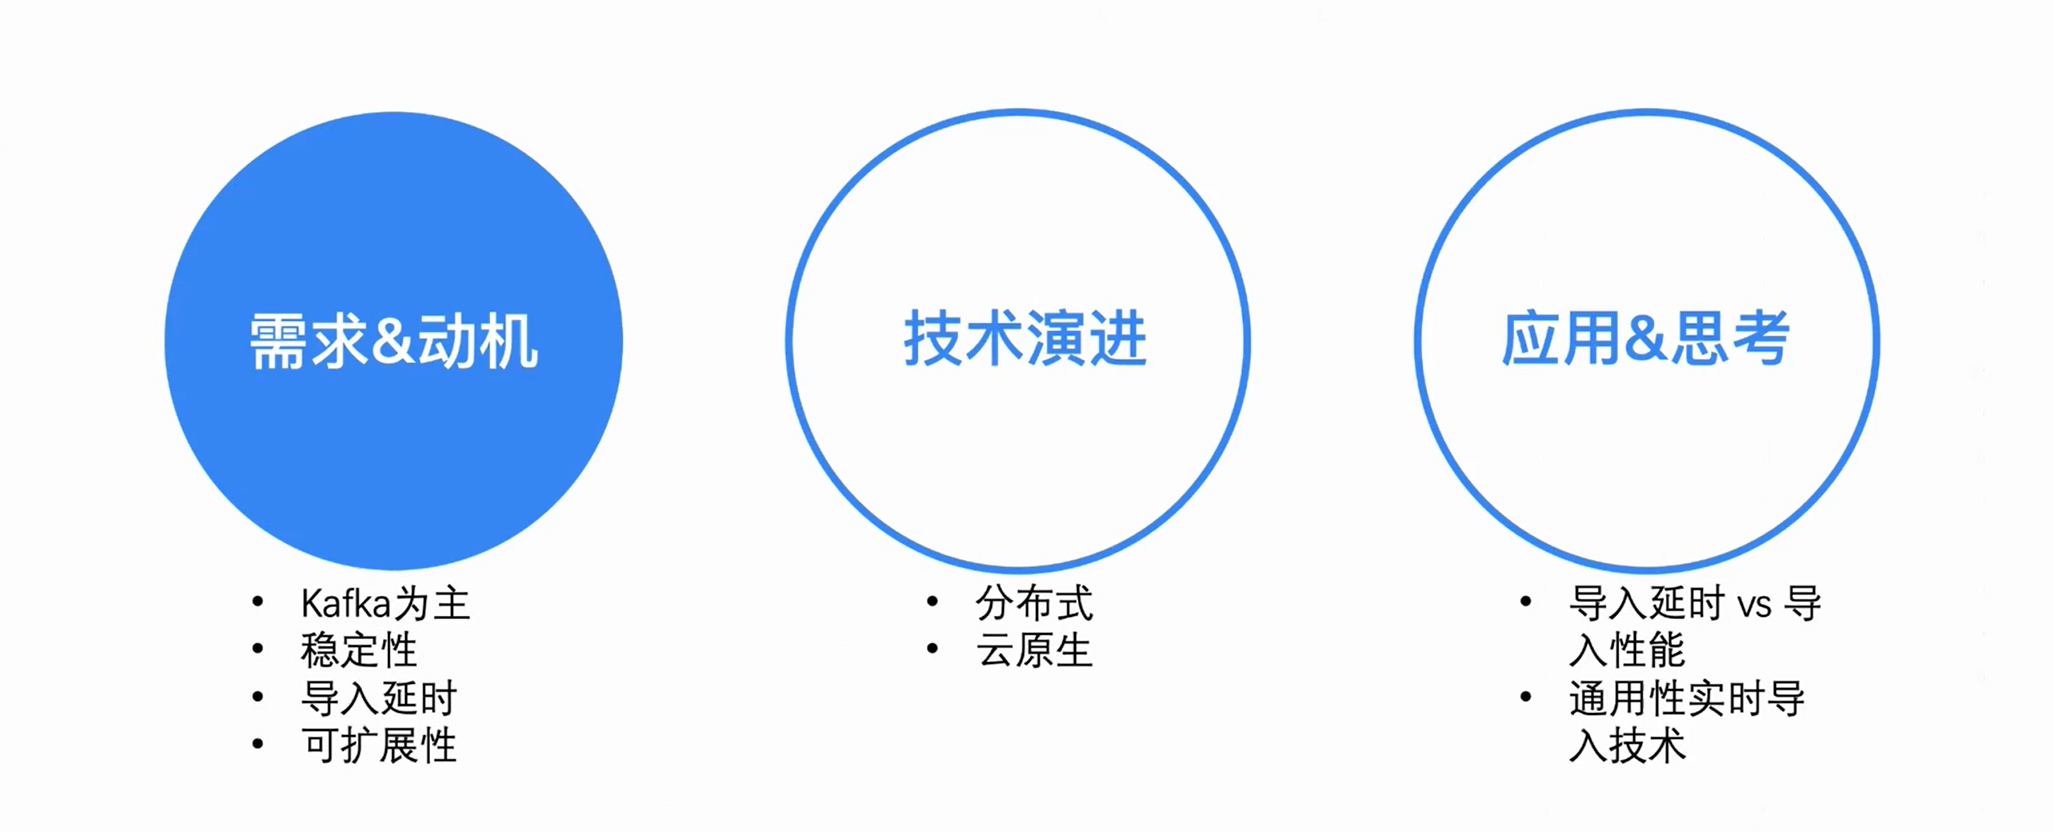
优秀的个人博客,低调大师

每日一博 | SparkSQL 的入门实践教程

摘要:Spark SQL是用于处理结构化数据的模块。与Spark RDD不同的是,Spark SQL提供数据的结构信息(源数据)和性能更好,可以通过SQL和DataSet API与Spark SQL进行交互。 本文分享自华为云社区《【SparkSQL笔记】SparkSQL的入门实践教程(一)》,作者:Copy工程师。 1.Spark SQL概述 Spark SQL是用于处理结构化数据的模块。与Spark RDD不同的是,Spark SQL提供数据的结构信息(源数据)和性能更好,可以通过SQL和DataSet API与Spark SQL进行交互。 2.Spark SQL编程入门 Spark SQL模块的编程主入口点是SparkSession,SparkSession对象不仅为用户提供了创建DataFrame对象、读取外部数据源并转化为DataFrame对象以及执行sql查询的API,还负责记录着用户希望Spark应用如何在Spark集群运行的控制、调优参数,是Spark SQL的上下文环境,是运行的基础。 2.1 创建SparkSession SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); master("local")和new SparkConf().setMaster("local")一个样子,SparkSession包含了SparkContext,SqlContext等,是更强大的入口对象,也是更统一的入口。 appName("SparkSQLDemo1")设置任务名称 config():设置配置属性,并且有多个重载方法: public synchronized SparkSession.Builder config(String key, String value) public synchronized SparkSession.Builder config(String key, long value) public synchronized SparkSession.Builder config(String key, double value) public synchronized SparkSession.Builder config(String key, boolean value) public synchronized SparkSession.Builder config(SparkConf conf) Spark 2.0中的SparkSession为Hive提供了强大的内置支持,包括使用HiveQL编写查询语句,访问Hive UDF以及从Hive表读取数据的功能。若是仅以学习为目的去测试这些功能时,并不需要在集群中特意安装Hive即可在Spark本地模式下测试Hive支持。 2.2 创建DataFrame SparkSession对象提供的API,可以从现有的RDD,Hive表或其他结构化数据源中创建DataFrame对象。 在这里说明一下,DataSet是DataFrame的替代品,比DataFrame更强大。DataFrame等价于DataSet[Row] public static void main(String[] args) { SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); System.out.println(sparkSession.version()); Dataset<Row> json = sparkSession.read().json("D:\\sparksqlfile\\jsondata\\student.json"); //show方法是展示所有的数据,也可以show(int rownums) 展示前N条数据 json.show(); sparkSession.close(); } 样例数据: {"id":1,"name":"小红","age":"19","phone":"111"} {"id":2,"name":"王明","age":"20","phone":"222"} {"id":3,"name":"诸葛亮","age":"21","phone":"333"} {"id":4,"name":"王茂","age":"23","phone":"444"} {"id":5,"name":"三毛","age":"17","phone":"555"} {"id":6,"name":"老张","age":"16","phone":"666"} 日志打印: INFO 2019-11-25 20:26 - org.apache.spark.sql.catalyst.expressions.codegen.CodeGenerator[main] - Code generated in 18.6628 ms +---+---+----+-----+ |age| id|name|phone| +---+---+----+-----+ | 19| 1| 小红| 111| | 20| 2| 王明| 222| | 21| 3| 诸葛亮| 333| | 23| 4| 王茂| 444| | 17| 5| 三毛| 555| | 16| 6| 老张| 666| +---+---+----+-----+ INFO 2019-11-25 20:26 - org.spark_project.jetty.server.ServerConnector[main] - Stopped Spark@23db87{HTTP/1.1}{0.0.0.0:4040} 可以看到,已经解析了json数据文件,并且还解析json中的字段名称,解析成表的字段名称,而且如果你的json的key值中有不一致的,都会解析成字段名称,只不过没有值的默认为null 例如: 日志打印: 看到没有,所有的不同key值都有。 2.3 DataFrame基本操作 DataFrame为我们提供了灵活、强大且底层自带优化的API,例如select、where、orderBy、groupBy、limit、union这样的算子操作,DataFrame提供这一系列算子对开发者来说非常熟悉,而DataFrame正是将SQL select语句的各个组成部分封装为同名API,用以帮助程序员通过select、where、orderBy等DataFrame API灵活地组合实现sql一样的逻辑表达。因此,DataFrame编程仅需像SQL那样简单地对计算条件、计算需求、最终所需结果进行声明式的描述即可,而不需要像RDD编程那样一步步地对数据集进行原始操作。 DataFrame API的使用实例(以上面的json数据为例): 以树形格式输出DataSet对象的结构信息 Dataset<Row> json = sparkSession.read().json("D:\\sparksqlfile\\jsondata\\student.json"); // 展示DataSet结构信息 json.printSchema(); 日志打印: root |-- age: string (nullable = true) |-- id: long (nullable = true) |-- name: string (nullable = true) |-- phone: string (nullable = true) 表的结构信息已经按照树形结构出来了,是根据json文件的value值判定的。 2. 通过DataSet的Select()方法查询数据集中一列或者多列 SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); Dataset<Row> json = sparkSession.read().json("D:\\sparksqlfile\\jsondata\\student.json"); // 定义字段 Column id = new Column("id"); Column name = new Column("name"); // 查询单个字段 json.select("id").show(); // 查询多个字段 json.select(id,name).show(); // 关闭saprkSesison 这里的close和stop是一个样 2.1.X开始用close 2.0.X使用的stop sparkSession.close(); Select 还有一个select(String col, String... cols)第一个参数不是很明白,后面再补充吧。还有这里有个对象Column是非常重要的,以后所有的java开发sparkSQL都会用到这个对象,这个对象就是我们在数据库中用到的字段,并且该对象有丰富的方法对字段做操作。 3. 组合使用DataSet对象的select(),where(),orderBy()方法查找id大于3的同学的id,姓名,年龄以及电话,按id的降序排列 这里为了更能直观的展示结果,我修改了json文件,添加了几行数据: {"id":1,"name":"小红","age":"19","phone":"111"} {"id":2,"name":"王明","age":"20","phone":"222"} {"id":3,"name":"诸葛亮","age":"21","phone":"333"} {"id":4,"name":"王茂","age":"23","phone":"444"} {"id":5,"name":"三毛","age":"17","phone":"555"} {"id":6,"name":"老张","age":"16","phone":"666"} {"id":7,"name":"张好","age":"16","phone":"777"} {"id":8,"name":"王流","age":"16","phone":"888"} where条件查询有两种形式: public Dataset<T> where(Column condition) public Dataset<T> where(String conditionExpr) 第一种是通过Column对象操作条件查询,第二种是通过直接写条件查询 // 条件查询 // id > 3 Column id = new Column("id").gt(3); // age = 16 Column name = new Column("age").equalTo("16"); // id > 3 and age =16 Column select = id.and(name); // 直接书写条件 json.select("id","name","age","phone").where("id > 3 and age = 16").orderBy(new Column("id").desc()).show(); // 通过多个where生成 id > 3 and age =16 json.select("id","name","age","phone").where(id).where(name).orderBy(new Column("id").desc()).show(); // 通过Column操作转换得到 id > 3 and age =16 json.select("id","name","age","phone").where(select).orderBy(new Column("id").desc()).show(); 这三个的写法是一样的,结果也是一样的。 4.使用DataSet对象提供的groupBy()方法进而学生年龄分布 // 分组查询 // 单个字段分组查询 json.groupBy(new Column("age")).count().show(); // 多个字段分组查询 ArrayStack<Column> stack = new ArrayStack<>(); stack.push(new Column("id")); stack.push(new Column("age")); json.groupBy(stack).count().show(); // 多个字段分组查询 json.groupBy(new Column("id"),new Column("age")).count().show(); group()分组有很多形式: 至于你想怎么写,只要正确就可以。 如果你想对字段操作,比如我们经常会这样写sqlselect age+1 from student,呢么sparkSQL完全可以实现,只需要这样既可:new Column("age").plus(1) 这就代表着age + 1 上面的实例中很好地展示了通过灵活组合使用DataSet提供的API可以实现SQL一样清晰简明的逻辑表达,如果采用RDD编程,首先RDD对JSON这种文件格式并不敏感,会像读取文本文件一样按行读取JSON文件,转化为RDD[String],而不会像DataSet那样自动解析JSON格式数据并且自动推断出结构信息(Schema),因此我们必须在程序中首先实例化一个JSON解析器用于解析JSON字符串得到真实数据组成的数组,实际是将RDD[String]转化为由一行行记录着多个共有字段数值的数组组成的RDD[Array[String]],进而使用map、filter、takeOrdered、distinct、union等RDD算子操作进行具体一步步地数据操作来实现业务逻辑。 相比之下,我们看出有时候同样的数据量,同样的分析需求,用RDD编程实现不仅代码量更大,而且会极有可能因为程序员不良操作加重集群的开销,而采用DataFrame API组合编程有时仅需一行代码即可实现复杂的分析需求。 2.4 执行SQL查询 SparkSession为用户提供了直接执行sql语句的SparkSession.sql(String sqlText)方法,sql语句可直接作为字符串传入sql()方法中,sql查询所得到结果依然为DataFrame对象。在Spark SQL模块上直接执行sql语句的查询需要首先将标志着结构化数据源的DataSet对象注册成临时表,进而在sql语句中对该临时表进行查询操作,具体步骤如下例所示: SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); Dataset<Row> json = sparkSession.read().json("D:\\sparksqlfile\\jsondata\\student.json"); // 注册临时表 json.createOrReplaceTempView("student"); // sql查询 用select * from student 也可以 Dataset<Row> sql = sparkSession.sql("select id,name,age,phone from student"); sql.show(); // 关闭saprkSesison 这里的close和stop是一个样 2.1.X开始用close 2.0.X使用的stop sparkSession.close(); 结果显示: 由上述操作,可看出DataSet是Spark SQL核心的数据抽象,读取的数据源需要转化成DataSet对象,才能利用DataSet各种API进行丰富操作,也可将DataSet注册成临时表,从而直接执行SQL查询,而DataFrame上的操作之后返回的也是DataFrame对象。 另外,因为本小结所讲述的是如何通过SparkSession提供的SQL接口直接进行SQL查询,而关于具体完成业务需求所需的SQL语句如何来编写,大家可以直接百度查询相关SQL教程进行学习。Spark SQL的SQL接口全面支持SQL的select标准语法,包括SELECT DISTINCT、from子句、where子句、order by字句、group by子句、having子句、join子句,还有典型的SQL函数,例如avg()、count()、max()、min()等,除此之外,Spark SQL在此基础上还提供了大量功能强大的可用函数,可嵌入sql语句中使用,有聚合类函数、时间控制类函数、数学统计类函数、字符串列控制类函数等,感兴趣或有这方面分析需求的读者具体可查看官方文档http://spark.apache.org/docs/latest/api/scala/index.html#org.apache.spark.sql 2.5 全局临时表 全局临时表(globe temporary view )于临时表(temporary view)是相对的,全局临时表的作用范围是某个Spark应用程序内所有会话(SparkSession),它会持续存在,在所有会话中共享,直到该Spark应用程序终止 因此,在同一个应用中,在不同的session中都需要用到一张临时表,呢么该临时表可以注册为全局临时表,避免多余I/O,提高系统执行效率,当然如果某个临时表只在整个应用中的某个session中使用,仅需要注册为局部临时表,避免不必要的内存存储全局临时表 注意,全局临时表与系统保留的数据库global_temp相关联,引用时需要使用global_temp标识。 实例: SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); Dataset<Row> json = sparkSession.read().json("D:\\sparksqlfile\\jsondata\\student.json"); // 注册临时表 json.createOrReplaceTempView("student"); // sql查询 Dataset<Row> sql = sparkSession.sql("select * from student"); sql.show(); // 注册为全局临时表 try { json.createGlobalTempView("student_glob"); } catch (AnalysisException e) { e.printStackTrace(); } // 当前session查询全局临时表 Dataset<Row> sqlGlob = sparkSession.sql("select * from global_temp.student_glob"); sqlGlob.show(); // 创建新的SparkSeesion 查询全局临时表 Dataset<Row> newSqlGlob = sparkSession.newSession().sql("select * from global_temp.student_glob"); newSqlGlob.show(); // 关闭saprkSesison 这里的close和stop是一个样 2.1.X开始用close 2.0.X使用的stop sparkSession.close(); 显示的结果都是一样的。 2.6 DataSet实现WordCount Dataset[T]中对象的序列化并不使用Java标准序列化或Kryo,而是使用专门的编码器对对象进行序列化以便通过网络进行处理或传输。虽然编码器和标准序列化都负责将对象转换为字节,但编码器是根据Dataset[T]的元素类型(T)动态生成,并且允许Spark无须将字节反序列化回对象的情况下即可执行许多操作(如过滤、排序和散列),因此避免了不必要的反序列化导致的资源浪费,更加高效。 SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); Dataset<String> stringDataset = sparkSession.read().textFile("D:\\sparksqlfile\\jsondata\\word.txt"); // 分割每行的字符串 Dataset<String> dataset = stringDataset.flatMap(new FlatMapFunction<String, String>() { @Override public Iterator<String> call(String s) throws Exception { String[] split = s.split("\t", -1); return Arrays.asList(split).iterator(); } },Encoders.STRING()); // 根据key值分组 KeyValueGroupedDataset<String, String> groupByKey = dataset.groupByKey(new MapFunction<String, String>() { @Override public String call(String value) throws Exception { return value.toLowerCase(); } },Encoders.STRING()); // 求和展示数据 groupByKey.count().show(); // 关闭saprkSesison 这里的close和stop是一个样 2.1.X开始用close 2.0.X使用的stop sparkSession.close(); 日志打印: 元数据: im runnig man you are yes haha yes you wein im niu you are yes haha you are yes haha 2.7 将RDDs转化为DataFrame 除了调用SparkSesion.read().json/csv/orc/parquet/jdbc方法从各种外部结构化数据源创建DataFrame对象外,Spark SQL还支持将已有的RDD转化为DataSet对象,但是需要注意的是,并不是由任意类型对象组成的RDD均可转化为DataSet对象,只有当组成RDD[T]的每一个T对象内部具有公有且鲜明的字段结构时,才能隐式或显式地总结出创建DataSet对象所必要的结构信息(Schema)进行转化,进而在DataSet上调用RDD所不具备的强大丰富的API,或执行简洁的SQL查询。 Spark SQL支持将现有RDDs转换为DataSet的两种不同方法,其实也就是隐式推断或者显式指定DataSet对象的Schema。 实例数据: 王明 13 17865321121 南京市天龙寺小区一栋 五年级一班 刘红 14 15643213452 南京市天龙寺小区二栋 五年级一班 张三 15 15678941247 南京市天龙寺小区三栋 五年级二班 诸葛刘芳 14 14578654123 南京市天龙寺小区一栋 五年级一班 1.使用反射机制(Reflection)推理出schema结构信息 第一种将RDDs转化为DataFrame的方法是使用SparkSQL内部反射机制自动推断包含特定类型对象的RDD的schema(RDD的结构信息)进行隐士转化。采用这种方式转化为DataSet对象,往往是因为被转化的RDD[T]所包含的T对象本身就是具有典型一维表严格的字段结构的对象,因此SparkSQL很容易就可以自动推断出合理的Schema。这种基于反射机制隐式地创建DataSet的方法往往仅需要简洁的代码即可完成转化,并且运行效果良好。 SparkSQL的Scala接口支持自动包含样例类(case class)对象的RDD转换为DataSet对象。在样例类的声明中已预先定义了表的结构信息,内部通过反射机制即可读取样例类的参数的名称,类型,转化为DataSet对象的Schema。样例类不仅可以包含Int,Double,String,这样的简单数据类型,也可以嵌套或包含复杂类型,例如Seq或Arrays。 实例:将学生样例对象的RDD隐式转换为DataSet对象 public static void main(String[] args) { SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); // 读取文件转成JavaRDD JavaRDD<String> stringRDD = sparkSession.sparkContext().textFile("D:\\sparksqlfile\\jsondata\\student.txt",1).toJavaRDD(); // JavaRDD<String> 转为 JavaRDD<Person> JavaRDD<Person> personRDD = stringRDD.map(new Function<String, Person>() { @Override public Person call(String v1) { String[] split = v1.split("\t", -1); return new Person(split[0],Integer.valueOf(split[1]),split[2],split[3],split[4]); } }); // RDD 转换为 DataSet Dataset<Row> personDataSet = sparkSession.createDataFrame(personRDD, Person.class); personDataSet.show(); // 注册临时表 personDataSet.createOrReplaceTempView("person"); // 查询临时表 Dataset<Row> selectDataSet = sparkSession.sql("select * from person where age between 14 and 15"); selectDataSet.show(); // 遍历DataSet 通过下标获取 name的Ds Dataset<String> nameDs = selectDataSet.map(new MapFunction<Row, String>() { @Override public String call(Row value) { // Row 的 字段排序是按照字典排序的 所以 第四个才是name字段 return "name:"+value.getString(3); } }, Encoders.STRING()); nameDs.show(); // Row通过指定字段名获取字段值 返回Object对象 Dataset<String> nameDs2 = selectDataSet.map(new MapFunction<Row, String>() { @Override public String call(Row value) { return "name:"+value.getAs("name"); } }, Encoders.STRING()); nameDs2.show(); // 关闭saprkSesison 这里的close和stop是一个样 2.1.X开始用close 2.0.X使用的stop sparkSession.close(); } 日志截图: 2.开发者指定Schema RDD转化为Dataset的第二种方法是通过编程接口,允许先创建一个schema,然后将其应用到现有的RDD[Row],较前一种方法由样例类或基本数据类型(Int,String)对象组成的RDD通过sparkSession.createDataFrame直接隐式转换为iDataset不同,不仅需要根据需求以及数据结构构建schema,而且需要将RDD[T]转化为Row对象组成的RDD[Row],这样方法虽然代码多了一些,但也提供了更高的自由度和灵活性。 当case类不能提前定义时(例如:数据集结构信息已经包含在每一行,一个文本数据集的字段对不同用户来说需要被解析成不同的字段名),这时就可以通过以下三部完成Dataset的转换: (1):根据需求从源RDD转化为RDD of Rows (2):创建由符合在步骤1中创建的RDD中的Rows结构的StructType表示的模式。 (3):通过SparkSession提供的createDataFrame方法将模式应用于行的RDD。 由此可见,将RDD转化为Dataset的实质就是,赋予RDD内部包含特定类型对象的结构信息,使Dataset掌握更丰富的结构与信息(可以理解为传统数据库的表头,表头包含个字段名称,类型等信息),如此一来,便更好地说明Dateset支持sql查询了。 实例: SparkSession sparkSession = SparkSession.builder().master("local").appName("SparkSQLDemo1").config("spark.testing.memory", 471859200).getOrCreate(); // 读取文件转成JavaRDD JavaRDD<String> peopleRDD = sparkSession.sparkContext().textFile("D:\\sparksqlfile\\jsondata\\student.txt",1).toJavaRDD(); String[] schemaString = {"name", "age"}; // 创建自定义schema List<StructField> fields = new ArrayList<>(); for (String s : schemaString) { fields.add(DataTypes.createStructField(s,DataTypes.StringType,true)); } StructType schema = DataTypes.createStructType(fields); // JavaRDD<String> 转为JavaRDD<Row>行记录 JavaRDD<Row> rowRdd = peopleRDD.map(new Function<String, Row>() { @Override public Row call(String v1) { String[] split = v1.split("\t", -1); return RowFactory.create(split[0],split[1]); } }); // JavaRDD转DataSet Dataset<Row> personDataset = sparkSession.createDataFrame(rowRdd, schema); personDataset.show(); 2.8 用户自定义函数 ​ 除了利用Dataset丰富的内置函数变成外,还可以自己编程满足特定分析需求的用户自定义函数(UDF)并加以使用,SparkSQL中主要支持创建用户自定义无类型聚合函数和用户自定义强类型聚合函数 1.用户自定义无类型聚合函数 用户自定义的无类型聚合函数必须继承UserDefinedAggregateFunction抽象类,进而重写父类中的抽象成员变量和成员方法。其实重写父类抽象成员变量,方法的过程即是实现用户自定义函数的输入,输出规范以及计算逻辑的过程。 实例:求取平均值的函数 UDF函数代码: public class MyAverage extends UserDefinedAggregateFunction { private StructType inputSchema; private StructType bufferSchema; public MyAverage() { ArrayList<StructField> inputFields = new ArrayList<>(); inputFields.add(DataTypes.createStructField("inputColumn",DataTypes.LongType,true)); inputSchema = DataTypes.createStructType(inputFields); ArrayList<StructField> bufferFields = new ArrayList<>(); bufferFields.add(DataTypes.createStructField("sum",DataTypes.LongType,true)); bufferFields.add(DataTypes.createStructField("count", DataTypes.LongType,true)); bufferSchema = DataTypes.createStructType(bufferFields); } // Data types of input arguments of this aggregate function // 聚合函数输入参数的数据类型(其实是该函数所作用的Dataset指定列的数据类型) @Override public StructType inputSchema() { return inputSchema; } // Data types of values in the aggregation buffer // 聚合函数的缓冲器结构,返回之前定义了用于记录累加值和累加数的字段结构 @Override public StructType bufferSchema() { return bufferSchema; } // The data type of the returned value // 聚合函数返回值的数据类型 @Override public DataType dataType() { return DataTypes.DoubleType; } // Whether this function always returns the same output on the identical input // 此函数是否始终在相同输入上返回相同输出 @Override public boolean deterministic() { return true; } // Initializes the given aggregation buffer. The buffer itself is a `Row` that in addition to // standard methods like retrieving a value at an index (e.g., get(), getBoolean()), provides // the opportunity to update its values. Note that arrays and maps inside the buffer are still // immutable. // 初始化给定的buffer聚合缓冲器 // buffer 聚合缓冲器其本身是一个Row对象,因此可以调用其标准方法访问buffer内的元素,例如在索引处检索一个值 @Override public void initialize(MutableAggregationBuffer buffer) { buffer.update(0,0L); buffer.update(1,0L); } // Updates the given aggregation buffer `buffer` with new input data from `input` @Override public void update(MutableAggregationBuffer buffer, Row input) { if (!input.isNullAt(0)){ long updatedSum = buffer.getLong(0) + input.getLong(0); long updatedCount = buffer.getLong(1)+1; buffer.update(0,updatedSum); buffer.update(1,updatedCount); } } // Merges two aggregation buffers and stores the updated buffer values back to `buffer1` @Override public void merge(MutableAggregationBuffer buffer1, Row buffer2) { long mergedSum = buffer1.getLong(0) + buffer2.getLong(0); long mergedCount = buffer1.getLong(1) + buffer2.getLong(1); buffer1.update(0,mergedSum); buffer1.update(1,mergedCount); } @Override public Object evaluate(Row buffer) { return ((double)buffer.getLong(0))/buffer.getLong(1); } } 运行代码: public static void main(String[] args) { SparkSession sparkSession = SparkSession.builder().master("local").appName("XXXXXXXXXX").config("spark.testing.memory", 471859200).getOrCreate(); // 读取文件 Dataset<Row> df = sparkSession.read().json("D:\\sparksqlfile\\jsondata\\student5.json"); // 注册自定义函数 sparkSession.udf().register("myAverage",new MyAverage()); // 显示原始数据 df.createOrReplaceTempView("student"); df.show(); // 使用自定义UDF求平均值 Dataset<Row> result = sparkSession.sql("SELECT myAverage(age) as average_salary FROM student"); result.show(); } 日志打印: 2.用户自定义强类型聚合函数 用户自定义强类型聚合函数需继承Aggregator抽象类,同样需要重写父类抽象方法(reduce,merge,finish)以实现自定义聚合函数的计算逻辑。用户定义的强类型聚合函数相比于前一种UDF,内部与特定数据集的数据类型紧密结合,增强了紧密型,安全性,但降低了适用性。 实例:求用户平均值的强类型聚合函数 数据实体类: // 定义Employee样例类型规范聚合函数输入数据的数据类型 public class Employee implements Serializable { private String name; private long age; private String sex; private String institute; private String phone; public Employee() { } public Employee(String name, long age, String sex, String institute, String phone) { this.name = name; this.age = age; this.sex = sex; this.institute = institute; this.phone = phone; } public String getName() { return name; } public void setName(String name) { this.name = name; } public long getAge() { return age; } public void setAge(long age) { this.age = age; } public String getSex() { return sex; } public void setSex(String sex) { this.sex = sex; } public String getInstitute() { return institute; } public void setInstitute(String institute) { this.institute = institute; } public String getPhone() { return phone; } public void setPhone(String phone) { this.phone = phone; } @Override public String toString() { return "Employee{" + "name='" + name + '\'' + ", age=" + age + ", sex='" + sex + '\'' + ", institute='" + institute + '\'' + ", phone='" + phone + '\'' + '}'; } } 定义聚合函数缓冲器: // 定义Average样例类规范buffer聚合缓冲器的数据类型 public class Average implements Serializable { private long sum; private long count; public Average() { } public Average(long sum, long count) { this.sum = sum; this.count = count; } public long getSum() { return sum; } public void setSum(long sum) { this.sum = sum; } public long getCount() { return count; } public void setCount(long count) { this.count = count; } @Override public String toString() { return "Average{" + "sum=" + sum + ", count=" + count + '}'; } } UDF代码: // 用户自定义的强类型聚合函数必须继承Aggregator抽象类,注意需要传入聚合函数输入数据,buffer缓冲器以及返回的结果的泛型参数 public class MyAverage2 extends Aggregator<Employee,Average,Double> { // A zero value for this aggregation. Should satisfy the property that any b + zero = b // 定义聚合的零值,应该满足任何b + zero = b @Override public Average zero() { return new Average(0L, 0L); } // Combine two values to produce a new value. For performance, the function may modify `buffer` // and return it instead of constructing a new object // 定义作为Average对象的buffer聚合缓冲器如何处理每一条输入数据(Employee对象)的聚合逻辑, // 与上例的求取平均值的无类型聚合函数的update方法一样,每一次调用reduce都会更新buffer聚合函数的缓冲器 // 并将更新后的buffer作为返回值 @Override public Average reduce(Average buffer, Employee employee) { long newSum = buffer.getSum() + employee.getAge(); long newCount = buffer.getCount() + 1; buffer.setSum(newSum); buffer.setCount(newCount); return buffer; } // Merge two intermediate values // 与上例的求取平均值的无类型聚合函数的merge方法实现的逻辑相同 @Override public Average merge(Average b1, Average b2) { long mergeSum = b1.getSum() + b2.getSum(); long mergeCount = b1.getCount() + b2.getCount(); b1.setSum(mergeSum); b1.setCount(mergeCount); return b1; } // Transform the output of the reduction // 定义输出结果的逻辑,reduction表示buffer聚合缓冲器经过多次reduce,merge之后的最终聚合结果 // 仍为Average对象记录着所有数据的累加,累加次数 @Override public Double finish(Average reduction) { System.out.println("////////////////"+((double) reduction.getSum()) / reduction.getCount()); return ((double)reduction.getSum())/reduction.getCount(); } // Transform the output of the reduction // 指定中间值的编码器类型 @Override public Encoder<Average> bufferEncoder() { return Encoders.bean(Average.class); } // Specifies the Encoder for the final output value type // 指定最终输出的编码器类型 @Override public Encoder<Double> outputEncoder() { return Encoders.DOUBLE(); } } 运行代码: public static void main(String[] args) { SparkSession sparkSession = SparkSession.builder().master("local").appName("XXXXXXXXXX").config("spark.testing.memory", 471859200).getOrCreate(); Encoder<Employee> employeeEncoder = Encoders.bean(Employee.class); // 读取文件 Dataset<Employee> employeeDataset = sparkSession.read().json("D:\\sparksqlfile\\jsondata\\student5.json").as(employeeEncoder); employeeDataset.show(); // 将函数转换为'TypedColumn' 并给他一个名字 MyAverage2 myAverage2 = new MyAverage2(); TypedColumn<Employee, Double> average_salary = myAverage2.toColumn().name("average_salary"); // 使用自定义强类型UDF求平均值 Dataset<Double> result = employeeDataset.select(average_salary); result.show(); } 日志: 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 全面分析 toString 与 valueOf

基本上,所有JS数据类型都拥有这两个方法,null除外。它们俩是位于原型链上的方法,也是为了解决javascript值运算与显示的问题。 valueOf 和 toString 几乎都是在出现操作符(+-*/==><)时被调用(隐式转换)。 toString 返回一个表示该对象的字符串,当对象表示为文本值或以期望的字符串方式被引用时,toString方法被自动调用。 1. 手动调用看看什么效果 嗯,跟介绍的一样,没骗人,全部都转成了字符串。 比较特殊的地方就是,表示对象的时候,变成[object Object],表示数组的时候,就变成数组内容以逗号连接的字符串,相当于Array.join(',')。 leta={} letb=[1,2,3] letc='123' letd=function(){console.log('fn')} console.log(a.toString())//'[objectObject]' console.log(b.toString())//'1,2,3' console.log(c.toString())//'123' console.log(d.toString())//'function(){console.log('fn')}' 2. 最精准的类型判断 这种属于更精确的判断方式,在某种场合会比使用 typeof & instanceof 来的更高效和准确些。 toString.call(()=>{})//[objectFunction] toString.call({})//[objectObject] toString.call([])//[objectArray] toString.call('')//[objectString] toString.call(22)//[objectNumber] toString.call(undefined)//[objectundefined] toString.call(null)//[objectnull] toString.call(newDate)//[objectDate] toString.call(Math)//[objectMath] toString.call(window)//[objectWindow] 3. 什么时候会自动调用呢 使用操作符的时候,如果其中一边为对象,则会先调用toSting方法,也就是隐式转换,然后再进行操作。 letc=[1,2,3] letd={a:2} Object.prototype.toString=function(){ console.log('Object') } Array.prototype.toString=function(){ console.log('Array') returnthis.join(',')//返回toString的默认值(下面测试) } Number.prototype.toString=function(){ console.log('Number') } String.prototype.toString=function(){ console.log('String') } console.log(2+1)//3 console.log('s')//'s' console.log('s'+2)//'s2' console.log(c<2)//false(一次=>'Array') console.log(c+c)//"1,2,31,2,3"(两次=>'Array') console.log(d>d)//false(两次=>'Object') 4. 重写toString方法 既然知道了有 toString 这个默认方法,那我们也可以来重写这个方法 classA{ constructor(count){ this.count=count } toString(){ return'我有这么多钱:'+this.count } } leta=newA(100) console.log(a)//A{count:100} console.log(a.toString())//我有这么多钱:100 console.log(a+1)//我有这么多钱:1001 Nice. valueOf 返回当前对象的原始值。 具体功能与toString大同小异,同样具有以上的自动调用和重写方法。 这里就没什么好说的了,主要为两者间的区别,有请继续往下看🙊🙊 letc=[1,2,3] letd={a:2} console.log(c.valueOf())//[1,2,3] console.log(d.valueOf())//{a:2} 两者区别 共同点:在输出对象时会自动调用。 不同点: 默认返回值不同,且存在优先级关系。 二者并存的情况下,在数值运算中,优先调用了valueOf,字符串运算中,优先调用了toString。 看代码方可知晓: classA{ valueOf(){ return2 } toString(){ return'哈哈哈' } } leta=newA() console.log(String(a))//'哈哈哈'=>(toString) console.log(Number(a))//2=>(valueOf) console.log(a+'22')//'222'=>(valueOf) console.log(a==2)//true=>(valueOf) console.log(a===2)//false=>(严格等于不会触发隐式转换) 结果给人的感觉是,如果转换为字符串时调用toString方法,如果是转换为数值时则调用valueOf方法。 但其中的 a + '22' 很不和谐,字符串合拼应该是调用toString方法。为了追究真相,我们需要更严谨的实验。 暂且先把 valueOf 方法去掉 classA{ toString(){ return'哈哈哈' } } leta=newA() console.log(String(a))//'哈哈哈'=>(toString) console.log(Number(a))//NaN=>(toString) console.log(a+'22')//'哈哈哈22'=>(toString) console.log(a==2)//false=>(toString) 去掉 toString 方法看看 classA{ valueOf(){ return2 } } leta=newA() console.log(String(a))//'[objectObject]'=>(toString) console.log(Number(a))//2=>(valueOf) console.log(a+'22')//'222'=>(valueOf) console.log(a==2)//true=>(valueOf) 发现有点不同吧?!它没有像上面 toString 那样统一规整。对于那个 [object Object],我估计是从 Object 那里继承过来的,我们再去掉它看看。 classA{ valueOf(){ return2 } } leta=newA() Object.prototype.toString=null; console.log(String(a))//2=>(valueOf) console.log(Number(a))//2=>(valueOf) console.log(a+'22')//'222'=>(valueOf) console.log(a==2)//true=>(valueOf) 总结:valueOf偏向于运算,toString偏向于显示。 在进行对象转换时,将优先调用 toString方法,如若没有重写 toString,将调用 valueOf 方法;如果两个方法都没有重写,则按 Object的 toString输出。 在进行 强转字符串类型时,将优先调用 toString 方法,强转为数字时优先调用 valueOf。 使用运算操作符的情况下, valueOf的优先级高于 toString。 Symbol.toPrimitive MDN:Symbol.toPrimitive 是一个内置的 Symbol 值,它是作为对象的函数值属性存在的,当一个对象转换为对应的原始值时,会调用此函数。 是不是有点懵???把它当做一个函数就行了~~ 作用:同 valueOf()和 toString()一样,但是优先级要高于这两者; 该函数被调用时,会被传递一个字符串参数 hint ,表示当前运算的模式,一共有三种模式: string:字符串类型 number:数字类型 default:默认 下面来看看实现吧: classA{ constructor(count){ this.count=count } valueOf(){ return2 } toString(){ return'哈哈哈' } //我在这里 [Symbol.toPrimitive](hint){ if(hint=="number"){ return10; } if(hint=="string"){ return"HelloLibai"; } returntrue; } } consta=newA(10) console.log(`${a}`)//'HelloLibai'=>(hint=="string") console.log(String(a))//'HelloLibai'=>(hint=="string") console.log(+a)//10=>(hint=="number") console.log(a*20)//200=>(hint=="number") console.log(a/20)//0.5=>(hint=="number") console.log(Number(a))//10=>(hint=="number") console.log(a+'22')//'true22'=>(hint=="default") console.log(a==10)//false=>(hint=="default") 比较特殊的是(+)拼接符,这个属于default的模式。 划重点:此方法不兼容IE,尴尬到我不想写出来了~~ 面试题分析 以下几道大厂必考的面试题,完美呈现出 toString 与 valueOf 的作用。 1. a===1&&a===2&&a===3 为 true 双等号(==):会触发隐式类型转换,所以可以使用 valueOf 或者 toString 来实现。 每次判断都会触发valueOf方法,同时让value+1,才能使得下次判断成立。 classA{ constructor(value){ this.value=value; } valueOf(){ returnthis.value++; } } consta=newA(1); if(a==1&&a==2&&a==3){ console.log("HiLibai!"); } 全等(===):严格等于不会进行隐式转换,这里使用 Object.defineProperty 数据劫持的方法来实现 letvalue=1; Object.defineProperty(window,'a',{ get(){ returnvalue++ } }) if(a===1&&a===2&&a===3){ console.log("HiLibai!") } 上面我们就是劫持全局window上面的a,当a每一次做判断的时候都会触发get属性获取值,并且每一次获取值都会触发一次函数实行一次自增,判断三次就自增三次,所以最后会让公式成立。 注: defineProperty 可参考这篇文章学习,点我进入传送门 自:大厂面试题分享:如何让(a===1&&a===2&&a===3)的值为true? 2. 实现一个无限累加函数 问题:用 JS 实现一个无限累加的函数 add,示例如下: add(1);//1 add(1)(2);//3 add(1)(2)(3);//6 add(1)(2)(3)(4);//10 //以此类推 functionadd(a){ functionsum(b){//使用闭包 a=b?a+b:a;//累加 returnsum; } sum.toString=function(){//只在最后一次调用 returna; } returnsum;//返回一个函数 } add(1)//1 add(1)(2)//3 add(1)(2)(3)//6 add(1)(2)(3)(4)//10 add函数内部定义 sum函数并返回,实现连续调用 sum函数形成了一个闭包,每次调用进行累加值,再返回当前函数 sum add()每次都会返回一个函数 sum,直到最后一个没被调用,默认会触发 toString方法,所以我们这里重写 toString方法,并返回累计的最终值 a 这样说才能理解: add(10): 执行函数add(10),返回了sum函数,注意这一次没有调用sum,默认执行sum.toString方法。所以输出10; add(10)(20): 执行函数add(10),返回sum(此时a为10),再执行sum(20),此时a为30,返回sum,最后调用sum.toString()输出30。add(10)(20)...(n)依次类推。 3. 柯里化实现多参累加 这里是上面累加的升级版,实现多参数传递累加。 add(1)(3,4)(3,5)//16 add(2)(2)(3,5)//12 functionadd(){ //1把所有参数转换成数组 letargs=Array.prototype.slice.call(arguments) //2再次调用add函数,传递合并当前与之前的参数 letfn=function(){ letarg_fn=Array.prototype.slice.call(arguments) returnadd.apply(null,args.concat(arg_fn)) } //3最后默认调用,返回合并的值 fn.toString=function(){ returnargs.reduce(function(a,b){ returna+b }) } returnfn } //ES6写法 functionadd(){ letargs=[...arguments]; letfn=function(){ returnadd.apply(null,args.concat([...arguments])) } fn.toString=()=>args.reduce((a,b)=>a+b) returnfn; } 本文分享自微信公众号 - JavaScript忍者秘籍(js-obok)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Hive:如何避免数据倾斜

1. hive中桶的概述 对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分。Hive也是 针对某一列进行桶的组织。Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记录存放在哪个桶当中。 把表(或者分区)组织成桶(Bucket)有两个理由: (1)获得更高的查询处理效率。 桶为表加上了额外的结构,Hive 在处理有些查询时能利用这个结构。具体而言,连接两个在(包含连接列的)相同列上划分了桶的表,可以使用 Map 端连接 (Map-side join)高效的实现。比如JOIN操作。对于JOIN操作两个表有一个相同的列,如果对这两个表都进行了桶操作。那么将保存相同列值的桶进行JOIN操作就可以,可以大大较少JOIN的数据量。 (2)使取样(sampling)更高效。 在处理大规模数据集时,在开发和修改查询的阶段,如果能在数据集的一小部分数据上试运行查询,会带来很多方便。 创建带桶的 table createtablebucketed_user(idint,namestring)clusteredby(id)sortedby(name)into4bucketsrowformatdelimitedfieldsterminatedby'\t'storedastextfile; 首先,我们来看如何告诉Hive—个表应该被划分成桶。我们使用CLUSTERED BY 子句来指定划分桶所用的列和要划分的桶的个数: CREATETABLEbucketed_user(idINT)nameSTRING)CLUSTEREDBY(id)INTO4BUCKETS; 在这里,我们使用用户ID来确定如何划分桶(Hive使用对值进行哈希并将结果除 以桶的个数取余数。这样,任何一桶里都会有一个随机的用户集合(PS:其实也能说是随机,不是吗?)。 对于map端连接的情况,两个表以相同方式划分桶。处理左边表内某个桶的 mapper知道右边表内相匹配的行在对应的桶内。因此,mapper只需要获取那个桶 (这只是右边表内存储数据的一小部分)即可进行连接。这一优化方法并不一定要求 两个表必须桶的个数相同,两个表的桶个数是倍数关系也可以。用HiveQL对两个划分了桶的表进行连接,可参见“map连接”部分(P400)。 桶中的数据可以根据一个或多个列另外进行排序。由于这样对每个桶的连接变成了高效的归并排序(merge-sort), 因此可以进一步提升map端连接的效率。以下语法声明一个表使其使用排序桶: CREATETABLEbucketed_users(idINT,nameSTRING)CLUSTEREDBY(id)SORTEDBY(idASC)INTO4BUCKETS; 我们如何保证表中的数据都划分成桶了呢?把在Hive外生成的数据加载到划分成 桶的表中,当然是可以的。其实让Hive来划分桶更容易。这一操作通常针对已有的表。 Hive并不检查数据文件中的桶是否和表定义中的桶一致(无论是对于桶 的数量或用于划分桶的列)。如果两者不匹配,在査询时可能会碰到错 误或未定义的结果。因此,建议让Hive来进行划分桶的操作。 2.hive中join优化 mapside join 方法一: select/*+MAPJOIN(time_dim)*/count(*)fromstore_salesjointime_dimon(ss_sold_time_sk=t_time_sk) 方法二:这个可以由hive自动进行map端join sethive.auto.convert.join=true;selectcount(*)fromstore_salesjointime_dimon(ss_sold_time_sk=t_time_sk) 执行下面这段代码将会产生两个map-only方法: select/*+MAPJOIN(time_dim,date_dim)*/count(*)fromstore_salesjointime_dimon(ss_sold_time_sk=t_time_sk)joindate_dimon(ss_sold_date_sk=d_date_sk)wheret_hour=8andd_year=2002 设置下面两个属性hive将会进行自动执行上述过程,第一个属性默认为true,第二个属性是设置map端join适合读取内存文件的大小。 sethive.auto.convert.join.noconditionaltask=true;sethive.auto.convert.join.noconditionaltask.size=10000000; Sort-Merge-Bucket (SMB) joins可以被转化为SMB map joins。 我们只需要设置一下几个参数即可: sethive.auto.convert.sortmerge.join=true;sethive.optimize.bucketmapjoin=true;sethive.optimize.bucketmapjoin.sortedmerge=true; 已设置大表选择的策略 使用下面属性: sethive.auto.convert.sortmerge.join.bigtable.selection.policy=org.apache.hadoop.hive.ql.optimizer.TableSizeBasedBigTableSelectorForAutoSMJ; 几种策略设置 org.apache.hadoop.hive.ql.optimizer.AvgPartitionSizeBasedBigTableSelectorForAutoSMJ(default)org.apache.hadoop.hive.ql.optimizer.LeftmostBigTableSelectorForAutoSMJorg.apache.hadoop.hive.ql.optimizer.TableSizeBasedBigTableSelectorForAutoSMJ 详细请参考一下连接:hive中进行连接方案详解(https://cwiki.apache.org/confluence/display/Hive/LanguageManual+Joins) 3,数据倾斜 Hive的执行是分阶段的,map处理数据量的差异取决于上一个stage的reduce输出,所以如何将数据均匀的分配到各个reduce中,就是解决数据倾斜的根本所在。 操作 原因 1,数据在节点上分布不均 2,key分布不均(key中存在个别值数据量比较大,比如NULL,那么join时就会容易发生数据倾斜) 3,count(disctinct key),在数据两比较大的时候容易发生数据倾斜,因为count(distinct)是按照group by字段进行分组的 4,group by的使用容易造成数据倾斜 5,业务数据本身的特性 6,建表时考虑不周 7,某些SQL语句本身就有数据倾斜 表现 任务进度长时间维持在99%左右,查看任务监控页面发现只有少量reduce任务未完成。因为其处理的数据量和其他reduce差异过大。单一reduce的记录数与平均记录数差异过大,通常可能达到3倍甚至更多。最长时长远大于平均时长。 4,数据倾斜的解决方案 参数调节 sethive.map.aggr=true;Map端部分聚合,相当于Combinersethive.groupby.skewindata=true; 有数据倾斜的时候进行负载均衡,当选项设定为 true,生成的查询计划会有两个 MR Job。第一个 MR Job 中,Map 的输出结果集合会随机分布到 Reduce 中,每个 Reduce 做部分聚合操作,并输出结果,这样处理的结果是相同的 Group By Key 有可能被分发到不同的 Reduce 中,从而达到负载均衡的目的;第二个 MR Job 再根据预处理的数据结果按照 Group By Key 分布到 Reduce 中(这个过程可以保证相同的 Group By Key 被分布到同一个 Reduce 中),最后完成最终的聚合操作。 SQL语句调节: 如何Join 关于驱动表的选取,选用join key分布最均匀的表作为驱动表 做好列裁剪和filter操作,以达到两表做join的时候,数据量相对变小的效果。 大小表Join 使用map join让小的维度表(1000条以下的记录条数) 先进内存。在map端完成reduce. 大表Join大表 把空值的key变成一个字符串加上随机数,把倾斜的数据分到不同的reduce上,由于null值关联不上,处理后并不影响最终结果。 count distinct大量相同特殊值 容易倾斜,当xx字段存在大量的某个值时,NULL或者空的记录 解决思路 将特定的值,进行特定的处理。比如是null,过滤掉,where case 特定方式转换特定的值,使得这些值不一样,同时这些值不影响分析。 group by维度过小:Group by在Map端进行部分数据合并 sethive.map.aggr;-->是否在Map端进行数据聚合,默认设置为true;sethive.groupby.mapaggr.checkinterval ;-->在Map端进行聚合操作的条目数。 进行负载均衡负载均衡 sethive.groupby.skewindata;默认值是false,需要设置成true;当设置为true时,会变成两个MapReduce; 第一个MR JOb中,map的输出结果会随机分布到Reduce中,每个Reduce做部分聚合操作,并输出结果,这样出来的结果相同的Group By Key有可能被分发到不同的Reduce中,从而达到辅助均衡目的。 第二个MR JOb,会根据预处理数据结果按照key分布到Reduce中,最终完成聚合操作。 5,典型的业务场景 空值产生的数据倾斜 场景:如日志中,常会有信息丢失的问题,比如日志中的 user_id,如果取其中的 user_id 和 用户表中的user_id 关联,会碰到数据倾斜的问题。 解决方法1:user_id为空的不参与关联 select*fromlogajoinusersbona.user_idisnotnullanda.user_id=b.user_idunionallselect*fromlogawherea.user_idisnull; 解决方法2 :赋与空值分新的key值 select*fromlogaleftouterjoinusersboncasewhena.user_idisnullthenconcat(‘hive’,rand())elsea.user_idend=b.user_id; 结论:方法2比方法1效率更好,不但io少了,而且作业数也少了。解决方法1中 log读取两次,jobs是2。解决方法2 job数是1 。这个优化适合无效 id (比如 -99 , ’’, null 等) 产生的倾斜问题。把空值的 key 变成一个字符串加上随机数,就能把倾斜的数据分到不同的reduce上 ,解决数据倾斜问题。 不同数据类型关联产生数据倾斜 场景:用户表中user_id字段为int,log表中user_id字段既有string类型也有int类型。当按照user_id进行两个表的Join操作时,默认的Hash操作会按int型的id来进行分配,这样会导致所有string类型id的记录都分配到一个Reducer中。 解决方法:把数字类型转换成字符串类型 select*fromusersaleftouterjoinlogsbona.usr_id=cast(b.user_idasstring) 小表不小不大,怎么用 map join 解决倾斜问题 使用 map join解决小表(记录数少)关联大表的数据倾斜问题,这个方法使用的频率非常高,但如果小表很大,大到map join会出现bug或异常,这时就需要特别的处理。以下例子: select*fromlogaleftouterjoinusersbona.user_id=b.user_id; users 表有 600w+ 的记录,把 users 分发到所有的 map 上也是个不小的开销,而且 map join 不支持这么大的小表。如果用普通的 join,又会碰到数据倾斜的问题。 解决方法: select/*+mapjoin(x)*/*fromlogaleftouterjoin(select/*+mapjoin(c)*/d.*from(selectdistinctuser_idfromlog)cjoinusersdonc.user_id=d.user_id)xona.user_id=b.user_id; 假如,log里user_id有上百万个,这就又回到原来map join问题。所幸,每日的会员uv不会太多,有交易的会员不会太多,有点击的会员不会太多,有佣金的会员不会太多等等。所以这个方法能解决很多场景下的数据倾斜问题。 6,数据倾斜总结 使map的输出数据更均匀的分布到reduce中去,是我们的最终目标。由于Hash算法的局限性,按key Hash会或多或少的造成数据倾斜。大量经验表明数据倾斜的原因是人为的建表疏忽或业务逻辑可以规避的。在此给出较为通用的步骤: 1、采样log表,哪些user_id比较倾斜,得到一个结果表tmp1。由于对计算框架来说,所有的数据过来,他都是不知道数据分布情况的,所以采样是并不可少的。 2、数据的分布符合社会学统计规则,贫富不均。倾斜的key不会太多,就像一个社会的富人不多,奇特的人不多一样。所以tmp1记录数会很少。把tmp1和users做map join生成tmp2,把tmp2读到distribute file cache。这是一个map过程。 3、map读入users和log,假如记录来自log,则检查user_id是否在tmp2里,如果是,输出到本地文件a,否则生成的key,value对,假如记录来自member,生成的key,value对,进入reduce阶段。 4、最终把a文件,把Stage3 reduce阶段输出的文件合并起写到hdfs。 如果确认业务需要这样倾斜的逻辑,考虑以下的优化方案: 1、对于join,在判断小表不大于1G的情况下,使用map join 2、对于group by或distinct,设定 hive.groupby.skewindata=true 历史好文推荐 面试!什么是数据仓库? 4万字全面掌握数据库, 数据仓库, 数据集市,数据湖,数据中台 从0到1搭建大数据平台之计算存储系统 从0到1搭建大数据平台之调度系统 从0到1搭建大数据平台之数据采集系统 如何从0到1搭建大数据平台 从0到1搭建自助分析平台 本文分享自微信公众号 - 数据社(DataClub)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Android 应用安装优化实战

疑问: (1)了解APK安装流程有什么好处 (2)了解APK安装流程可以解决什么问题 一、可以在安装流程里做什么 安装就分为下面三个阶段,每个阶段可以做些什么工作,可以帮助我们优化安装流程,解决安装后的一些问题呢? (1)安装前、安装中:这两个阶段,第三方应用做不了什么,一般是应用分发APP应用商店、游戏中心、浏览器、应用宝这些应用会关注这两个状态。 (2)安装后:这个阶段,无论是内置应用还是第三方应用,或多或少的会遇到一些问题,如so文件找不到,图片存储、缓存数据等出现异常等... 二、安装前 安装前无非是根据自己的应用情况,选择一种可以使用的安装方法。 2.1 pm命令安装方法 对于具有系统签名的厂商应用,具备静默安装能力,使用pm命令即可实现。 String cmd = "pm install -r -d /data/data/android.apk" Runtime run = Runtime.getRuntime(); Process process = run.exec(cmd); 2.2 包安装管理器安装 非系统签名的应用宝这种应用,只能使用包安装管理器进行安装。 Intent intent = new Intent(Intent.ACTION_VIEW); intent.setFlags(Intent.FLAG_ACTIVITY_NEW_TASK); intent.setDataAndType(Uri.parse("file://" + apkfile.toString()), "application/vnd.android" + ".package-archive"); mContext.startActivity(intent); 2.3 session命令安装 使用session安装的原因,是因为从Android 8.0开始,pm命令无法实现静默安装,否则会直接显示安装失败。但是网上并未发现对静默方法的适配方案,也许这是因为这个兼容只有厂商关注,第三方应用不关注这个方法的兼容。下面给出兼容方案: int sessionId = packageInstaller.createSession(params); InstallLog.d(TAG, "doPackageStage creat sessionId is : " + sessionId); final byte[] buffer = new byte[65536]; session = packageInstaller.openSession(sessionId); final InputStream in = new FileInputStream(file); final long sizeBytes = file.length(); final OutputStream out = session.openWrite("PackageInstaller", 0, sizeBytes); try { int c; while ((c = in.read(buffer)) != -1) { out.write(buffer, 0, c); } session.fsync(out); } catch (IOException ex) { InstallLog.e(TAG, "doPackageStage ioException : " + ex.getMessage(), ex); } finally { InstallUtils.closeQuietly(in); InstallUtils.closeQuietly(out); } 该方法是从packageManager中抽取出的代码,可实现应用的静默安装。 三、安装中 3.1 APK的结构 APK文件其实是zip格式,一般包含一个或多个dex文件、resources.arsc、AndroidManifest.xml、res目录、META-INF目录及包含so库的lib目录: 3.2 安装过程中涉及的存储目录 system/app——内置应用,也就是系统自带的应用程序,无法删除。 data/app——用户程序安装的目录,有删除权限。安装时把apk文件复制到此目录。 data/data——存放应用程序的数据,比如一些sp缓存数据。 data/dalvik-cache——将APK中的dex文件安装到dalvik-cache目录下(dex文件是dalvik虚拟机的可执行文件,其大小约为原始APK文件大小的四分之一)。 3.3 安装主要流程 安装过程概括为:复制APK安装包到/data/app目录下,解压并扫描安装包,向资源管理器注入APK资源,解析AndroidManifest文件,并在/data/data目录下创建对应的应用数据目录,然后针对dalvik/art环境优化dex文件,保存到dalvik-cache目录,将AndroidManifest文件解析出的组件、权限注册到PackageManagerService,完成后发送广播。 3.4 安装中可以优化的点 安装中,这个过程看上去没有什么可以做的,但是对于厂商应用来说,应用的安装速度,却是可以有很大的提升空间的。如应用更新的差分包升级就是一种常见的增量更新方式。 经过一系列测试与验证,发现应用安装的速度,本身与一些因素有关,最主要的是CPU的使用频率。 众所周知,现在的手机较为高端,为8核,但是在应用安装过程中,分析trace文件,可以确认,并不是8核线程全负荷工作去完成一个应用的安装,而是一部分线程运行在高核,一部分在低核。 3.4.1CPU的工作频率介绍 cpuinfo_max_freq cpuinfo_min_freq :分别给出了 CPU 硬件所支持的最高运行频率及最低运行频率, cpuinfo_cur_freq则会从CPU 硬件寄存器中读取CPU 当前所处的运行频率。 Governor在选择合适的运行频率时只会在scaling_max_freq 和 scaling_min_freq 所确定的频率范围内进行选择。 scaling_cur_freq返回的是cpufreq 模块缓存的CPU当前运行频率,而不会对CPU 硬件寄存器进行检查。 scaling_available_governors会告诉用户当前有哪些 governors 可供用户使用。 scaling_driver则会显示该 CPU 所使用的变频驱动程序。 Scaling_governor则会显示当前的管理策略,往这个上 echo 其他类型会有相应的转变。 scaling_setspeed:需将 governor 类型切换为 userspace ,才会出现,往这个文件 echo 数值,会切换主频。 基于此,可以在应用安装时,提升CPU的工作频率,即可使CPU运行在合适的频率。 2.4.2 提升CPU的工作频率 除了可以直接根据安装速度判断安装速度是否提升外,也可以根据下面日志判断提频是否有效: adb shell cat /sys/devices/system/cpu/cpu0/cpufreq/cpuinfo_cur_freq adb shell cat /sys/devices/system/cpu/cpu7/cpufreq/cpuinfo_cur_freq 可以直接看到频率变化: 微信安装速度可以由前面CPU低频时的20s,提升到CPU频率较高时的10s左右。 注意:频率不是越高越好,频率越高,手机耗电会越高,容易发热。 四、安装后 应用安装后,会遇到各种各样的问题,启动失败,合规整改(这个其实在应用开发时就要完成),那么哪些问题又是可能遇到,又可以借助apk的安装流程去解决的 4.1 targetsdkversion=30 不得不做的事情 在《符合 Google Play 的目标 API 级别要求》一文中,根据google官方要求,需要对隐私权限进行管控,强制执行分区存储,这就要求,每个应用不得在sd卡进行资源存储。那么问题来了,假如你的项目使用了Glide,Glide的存储路径之前设置到了sd卡下面,现在又无法使用外部存储目录,该怎么办? 当了解了apk的安装流程之后,知道应用的数据会存储在data/data/packagename下面,这就给Glide的资源存储提供了一个内部文件夹,唯一要做的事情,就是为了防止data/data占用过大,把Glide的存储目录设置个上限即可。 4.2 libmmkv.so无法找到问题解决 4.2.1 现象 如果你的应用接了腾讯的mmkv,你可能遇到了这样的问题: java.lang.UnsatisfiedLinkError dalvik.system.PathClassLoader[DexPathList[[zip file "/data/app/packagename-Sxe4_uU3WXx-ckI5DyG3UA==/base.apk"],nativeLibraryDirectories=[/data/app/packagename-Sxe4_uU3WXx-ckI5DyG3UA==/lib/arm, /system/fake-libs, /data/app/packagename-Sxe4_uU3WXx-ckI5DyG3UA==/base.apk!/lib/armeabi-v7a, /system/lib, /system/vendor/lib, /system/vendor/lib/hw]]] couldn't find "libmmkv.so" Runtime.java 1011 java.lang.UnsatisfiedLinkError: dalvik.system.PathClassLoader[DexPathList[[zip file "/data/app/packagename-Sxe4_uU3WXx-ckI5DyG3UA==/base.apk"],nativeLibraryDirectories=[/data/app/packagename-Sxe4_uU3WXx-ckI5DyG3UA==/lib/arm, /system/fake-libs, /data/app/packagename-Sxe4_uU3WXx-ckI5DyG3UA==/base.apk!/lib/armeabi-v7a, /system/lib, /system/vendor/lib, /system/vendor/lib/hw]]] couldn't find "libmmkv.so" at java.lang.Runtime.loadLibrary0(Runtime.java:1011) at java.lang.System.loadLibrary(System.java:1657) at com.tencent.mmkv.MMKV.a(SourceFile:3) 这个表示应用加载libmmkv.so出现异常。 4.2.2 分析原因 出现问题的原因是什么:根据日志可以确认,是找不到应用data/app/文件夹下面的libmmkv.so文件。 4.2.3 解决问题 前面提到,应用的数据会存储在data/data下面,这个路径下面也包含了应用解压之后的so库,所以可以做一件事情解决上面libmmkv.so的问题,重链接data/data下面的资源到data/app下面,实现资源共享。实践证明该方案完全可行,有效解决了so库找不到的问题。 五、疑问解答 (1)了解APK安装流程有什么好处 从apk发起安装,安装中、一直到安装结束,应用状态的变化,CPU的使用,资源的共享,牵涉到一系列知识点,这些知识点是可以串联起来的,对提升个人的知识体系有帮助。当然,由于文章篇幅有限,本文章只是作为一个引导,大致说明安装过程中存在什么知识点,PMS、文件管理、进程拉起等等安全可以另起一章节进行介绍,后续会介绍这些方面的内容。 (2)了解APK安装流程可以解决什么问题 厂商应用更多的关注安装前、安装中遇到的问题,第三方应用关注安装后遇到的问题。掌握了安装过程中的每一个环节,通过上面的分析,可以知道,能够快速帮助定位问题。 作者:vivo互联网客户端团队-Xu Jie

优秀的个人博客,低调大师

每日一博 | 大数据软件开源版图

开源一词最初是指开源软件(OSS)。开源软件是源代码可以任意获取的计算机软件,任何人都能查看、修改和分发他们认为合适的代码。 开源软件依托同行评审和社区生产,皆以分散、协作的方式开发。开源软件由社区开发,而非单个作者或公司,因此通常成本更低、更灵活,寿命比专有软件更长。 开源已成为一种超越软件生产界限的运动和工作方式。开源运动旨在利用开源软件的价值和分散的生产模型,为其社区和行业的问题寻找新的解决方法。 Redhat对于开源的定义 刚哥在软件行业摸爬滚打了二十多年了,经历了开源软件的发展,感触颇多。最早,刚开始做软件开发的时候,开源软件非常有限,很多东西都需要自己去打造,当然,程序员这个群体对于造轮子,那是情有独钟的,技术上无可厚非,但是从效率上就差了不少了。今天的软件业和软件从业人员其实是非常幸福的,开源社区提供的诸多选项极大的提高了软件开发的生产率,而云计算也使得软件的大规模部署和运行变的简单。软件从业者可以花出更多的时间来关注自己的业务,这是实实在在的进步。 我本人是开源软件的忠实拥护者,很早就开始在开源中国写博客,关注各种开源软件,自己贡献过一些小品级别的开源软件,每每发现了新的开源软件,也会发送给开源中国,总共投递了超过40个开源软件。我是看着开源中国从一个小网站做到今天的,希望红薯带着开源中国越办越好。 我有幸在大数据这个领域先后做了数据可视化,数据的准备和采集,机器学习,以及现在负责一个大数据软件端到端的架构,对于大数据软件领域有不少的了解,今天就来和大家分享一下我眼中,大数据软件开源领域的版图。 在上图中,我把大数据开源软件的版图分类为:数据摄取(data ingestion),数据流传输(data streaming),数据管道(data pipeline),元数据仓库(metastore),对象/文件存储(object/file storage),数据湖/数据格式(data format/data lake),OLAP数据仓库(OLAP/ data warehouse),即席查询(Ad hoc query),流分析(stream analytics),图数据库(graph database),时序数据库(time serials database),机器学习运维(MLOps),搜索引擎(search engine),元数据管理(metadata management),数据可视化(data visualization)。 大数据领域的开源软件数量繁多,我不可能一一覆盖,同时因为软件的功能有可能用于不同的场景,上面的分类也不一定准确。但是我们可以看到大数据开源软件的基本图景,这里做个简单的总结: 大数据的开源软件是大数据领域的基石,各种大数据产品和解决方案都离不开这些开源软件的支持。flink,spark,kafka,elastic是构建大数据栈的常客。 以为Hadoop为核心的大数据生态曾经是大数据领域的标准,但是我们看到从趋势上来看,新兴的大数据软件中,hadoop所扮演的角色越来越不重要,Hadoop的存储HDFS正在被各种以S3为主的数据湖的解决方案所取代,Mapduce的计算模型被数据仓库/Spark/Flink的计算所取代。 大部分的开源软件背后都是有大型软件厂商,或者独立软件开发商来运营,以开源为营销手段,扩大用户群体和知名度。但是开源厂商正在受到云计算的竞争和威胁,开源厂商迫于生计,开始通过修改软件许可证(Elastic/Mongo)来打击云厂商。 新兴大数据开源软件,也受到了大厂商和风险投资的关注,例如Datadog收购Vector,Databrick收购Redash。 国内的大数据开源产品受到关注,例如Nebula Graph,Milvus,DorisDB,Plato,TiDB(TiBD没有在本文中覆盖)等等 开源软件毫无疑问是大数据领域基础中的基础,各种大数据产品和解决方案都离不开这些开源软件的支持。flink,spark,kafka,elastic, zookeeper 是构建大数据栈的常客,你尽可放心大胆地选用。 以Hadoop为核心的大数据生态曾经是大数据领域的标准,当我们说到大数据的时候,不可避免地会涉及Hadoop生态系统。但是我们看到从趋势上来看,新兴的大数据软件中,hadoop所扮演的角色越来越不重要,Hadoop的存储HDFS正在被各种以S3为主的数据湖的解决方案所取代,Mapduce的计算模型被数据仓库/Spark/Flink的计算所取代。 Apache基金会宣布退役的Hadooop项目包含: Apex:基于 HadoopYARN 的统一大数据流和批处理平台 Chukwa:基于 Hadoop 分布式文件系统(HDFS)构建的,用于监视大型分布式系统的数据收集系统 Crunch,提供了用于编写、测试和运行 MapReduce(包括 HadoopMapReduce)管道的框架 Eagle:一种分析解决方案,可在包括 Hadoop 在内的大数据平台上迅速识别安全和性能问题 Falcon:针对 Hadoop 的数据处理和管理解决方案,设计用于数据移动、数据管道协调、生命周期管理和数据发现 Hama:一种用于大数据分析的框架,运行在 Hadoop 上,并且基于 BulkSynchronousParallel 范式 Lens,提供了统一的分析界面,将 Hadoop 与传统数据仓库深度集成在一起 Marmotta:链接数据的开放平台 Metron:专注于实时大数据安全性 PredictionIO:一种用于管理和部署生产就绪的预测服务的机器学习服务器 Sentry:一种用于对 ApacheHadoop 中的数据和元数据执行细粒度授权的系统 Tajo:Hadoop 上的大数据仓库系统 Twill,它使用 HadoopYARN 的分布式功能和类似的编程模型来运行线程 与此同时以Hadoop运营为主的公司Cloudera,也举步维艰。最近有消息称Cloudera想卖身,可是谁会出手呢?IBM在收购红帽子后,会把Cloudera也并入旗下吗?我们拭目以待。与此相对应的,风光无限的Snowflake火热上市,如今的市值突破700亿美元的天文数字。IT圈毫无疑问也是喜新厌旧的。 开源软件要发展,离不开组织的力量,我们看到大数据开源软件背后的三个主要的力量:Apache基金会,大的软件厂商和创业公司。 大数据里面的明星项目大多来自apache基金会,包括我们之前提到的kafka,Spark,Flink等。 Apache软件基金会(Apache Software Foundation,简称为ASF),是专门为支持开源软件项目而办的一个非营利性组织。在它所支持的Apache项目与子项目中,所发行的软件产品都遵循Apache许可证(Apache License)。 Apache这个名字还有流传着一段有意思的故事。因为这个服务器是在NCSA HTTPd服务器的基础之上,通过众人努力,不断地修正、打补丁(Patchy)的产物,被戏称为“A Patchy Server”(一个补丁服务器)。在这裡,因为“A Patchy”与“Apache”是谐音,故最后正式命名为“Apache Server”。 另外一只主要的力量就是大的软件和互联网厂商,例如谷歌是Kubernetes和Tensorflow的拥有者,Databrick拥有Spark。Deltalake等产品。 最后就是创业公司,现在大数据行业创业公司非常多,大多数也是采用的了开源的形式来为自己的软件背书。 这三股力量并不是对立的,它们融合在一起推进开源事业的发展,大多数的厂商愿意把自己的软件贡献给apache,甚至以能入选Apache基金会的顶级项目为荣,而创业公司也会借着开源的力量走向成熟,变大变强。例如谷歌,Databrick,Elastic也都是从创业开始他们的脚步。 开源厂商正在受到云计算的竞争和威胁,开源厂商迫于生计,开始通过修改软件许可证来打击云厂商。这里归根结底都是商业利益,对于开源厂商,它们之所以愿意贡献他们的代码,并不是像“雷锋”一样助人为乐,不图回报的。任何的公司都是以盈利为目标的。以AWS为首的云厂商,自己本身有很强大的技术实力,把开源的东西拿过来,在云上打个服务就开始赚钱了,对于这样的“白嫖”,开源厂商自然是很不爽!这样的对抗,短期不会改变。 新兴的大数据软件越来越受到市场尤其是资本的追捧。Databrick收购了redash,Datadog收购vector来完善他们的大数据软件版图。国内的PinCAP/涛思/Kyligence也纷纷获得数目不小的投资。大数据软件越来越被重视。 上面的这些没有包含国内的内容,我们也看一看国内大数据开源的情况: 国产开源大数据软件的现状是: 数据库和数据仓库领域很热闹,聚集了很多玩家,其中TiDB无论从融资还是社区活跃度,都是该领域最受追捧的产品 在数据可视化领域,百度Echart和蚂蚁金服的AntV是该领域的领导者,完全不弱于该领域传统的开源领导者Highcharts 在机器学习领域,华为的Mindsopre和百度的飞浆社区活跃度很高 华为为开源社区贡献了不少产品,包含Apache CarbonData,Apache OpenLooKong,OpenGauss,MindSpore,其它大公司也有自己的明星产品,百度的飞浆和ECharts,蚂蚁金服的AntV,阿里的PolarDB 当然,国内和国外的划分也不一定能分得那么清楚,我们知道Flink背后有阿里巴巴,Apache Pulsar背后也是有一个国内为主的组织在运作。 对比国内和国外大数据开源软件的情况,我做了一些简单的数据分析: 从社区的活跃度来看,国内的大数据开源软件整体的活跃度和认知度都会低一些,在github上有1w以上star的项目有十多个,而国内只有5/6家,但是这几家都值得大家关注。 从语言采用的角度来看,Java/Python/C/C++是主力。未来我想也许会有越来越多的Golang/Rust的项目出现。 总结 本文对大数据开源领域的现状做了一个简要的分析,也分析了国内和国外在大数据开源软件版图上的差异。希望开源软件,尤其是国内的大数据开源软件未来有很好的发展。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册