首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

【博文精读】Chrome CSS 2025年回顾

本文由体验技术团队申君健原创。 序言 近日发现 Chrome 官方技术平台 chrome.dev 发布了一篇极具价值的 CSS 技术总结文章,原文链接为:CSS-Wrapped-2025,Wrapped 单词在这里是打包,总结,回顾的意思。Chrome官方罗列了2025年的新增CSS和组件特性等,有需要的小伙伴可以关注一下。此外,Chrome 官方亦发布了 2024 年度的 CSS 特性回顾文章,链接为:CSS-Wrapped-2024,可以对照查阅。 《CSS Wrapped 2025》一文共分为三个核心章节,分别是可定制的组件(Customizable Components)、 下一代交互(Next-gen Interactions)、 优化的人体工程学(Optimized ergonomics)。 由于精力时间有限,本文先精读第一部分,有机会再分享后续部分。 2025 全年,Chrome发布的版本为 132~143,本文的特性也集中在这个范围,它有很多全新的概念,或者是去年CSS概念的一些延伸。前端人员总不能第一时间使用新特性,以兼容性为借口忽视新技术,我也是一样。所以借此文章中新特性为提纲,全面总结该特性的知识,补充我的一些理解和总结。同时每一个新特性还准备一句话的解释 和 完整示例,方便大家快速了解。Chrome 143升级好了吗,开始带你飞! 一、命令调用器 (Invoker Commands) 一句话的解释 命令调用器是通过Button元素,向Dialog,popover元素或任意元素上触发一个动作命令。 完整示例 命令调用器特性兼具声明式语法的高可读性优势,且能有效减少 JavaScript 代码的编写量。在该特性中,Button 元素被定义为 "命令源",接收命令执行的元素则为 "命令目标"。 命令源:⭐仅 Button 元素才允许当命令源,它添加以下属性: 【attr】commandfor: 属性值为命令目标元素的 id,用于关联对应的命令目标。 【attr】command: 用于指定点击 Button 元素后触发的命令动作,其属性值说明如下: | 命令 | 行为目标 | 等效js | 备注 | | -------------- | ---------- | --------------------- | ------------------------------------------- | | show-modal | 打开dialog | dialog.showModal() | | | close | 关闭dialog | dialog.close() | | | request-close | 请求关闭dialog | dialog.requestClose() | 可取消: ev.preventDefault() | | show-popover | 打开popover | el.showPopover() | | | hide-popover | 关闭popover | el.hidePopover() | | | toggle-popover | 切换popover | el.togglePopover() | | | --any-command | 自定义命令 | - | 事件名必须 -- 打头 目标上监听command事件 非冒泡,可取消的事件 | 【prop】command: 同上 【prop】commandForElement: 同 commandfor ,值为HTMLElement对象。 命令目标: 通常是 dialog, popover元素,为它们添加一个事件: 【event】command: 触发在目标元素上的事件。 其中事件参数 event.command 是命令值。 兼容性 支持chrome135+ ff144+, polyfill 方案。 总结 该特性的核心价值不仅在于减少 JavaScript 代码量,更在于实现了更好的可读性,更好的语义化,更好的AI识别。Dialog元素是存在较久的冷门标签,Popover API是近两年的新特性,之前操作他们必须通过Javascript代码。 该特性也是一个微型的通知系统,某些程度上可以代替 new CustomEvent的使用。同样的,更好的可读性,参见图片翻转的示例。 命令源只能是Button,某种程度上限制了它的使用。 二、对话框轻量关闭(Dialog Light Dismiss) 一句话的解释 继 Popover Api 引入 Light Dismiss 之后,Dialog 也支持了它 完整示例 Light Dismiss 直接翻译就是轻量关闭,友好关闭,具体是指通过点击 ::backdrop 区域、按下 Esc 键即可触发目标元素自动关闭的交互行为。Light Dismiss同样的具备声明式可阅读性,还能避免Javascript的使用。 <dialog closedby="none"> 不触发关闭 </dialog> <dialog closedby="closerequest">接受 esc或其它js触发 </dialog> <dialog closedby="any"> 接受任何触发 </dialog> Light Dismiss 通常是用户在交互过程中预期的默认行为,这一设计不仅体现了 Chrome 对用户使用体验人体工程学的关注,更彰显了其对开发者开发体验人体工程学的重视。开发者无需进行额外开发,即可获得预期的合理结果。延伸了解它的一些细节: closerequest 与 any 的相比,它不接受点击::backdrop区域关闭;此外移动端的手指侧滑或导航回退也会触发closerequest的行为。 dialog.requestClose()在dialog元素上触发 cancel 和 close事件, 而dialog.close() 只触发close事件。 在cancel事件中执行ev.preventDefault()可阻止关闭。 dialog元素没有open事件,但它有 toggle, beforetoggle事件, 用来监听打开关闭。 事件对象的oldState,newState用来判断切换的方向。 此外,只有dialog 和 弹出层支持这2个事件名。 兼容性 支持chrome134+ ff141+, polyfill 方案。 延伸理解 Popover API 的Light Dismiss <button popovertarget="mypopover" popovertargetaction="toggle">切换显示</button> <div id="mypopover" popover>这是一个 auto 弹出层</div> 命令源:⭐仅 Button 元素和Input(type=button)才允许当命令源,它添加以下属性: 【attr】popovertarget: 其值为popover元素id 【attr】popovertargetaction: 点击的命令动作,其值为: 'hide' | 'show' | 'toggle' 触发popover还可以用传统的Javascript, 或者Button的commands 模式,比如: el.showPopover() popover层: 任意添加了 [popover] 属性的元素 【attr】popover: 设置元素为一个弹出层,它最早支持以下2个值: auto: 自动模式,也是默认值。 auto即符合Light Dismiss默认关闭行为。同一个页面上,auto类别的元素只能显示一个。 manual: 手动模式。必须显示的声明popovertargetaction,或调用Javascript函数才触发,比如:el.showPopover()。同一个页面上,manual类别元素可显示多个。 参考完整示例,对比 Dialog 与 Popover API : 都支持Invoker Commands 和 Light Dismiss 都支持Javascript控制和声明式表达: dialog元素的closedby 和 popover元素的popover属性 都会产生一个Top Layer, 无须z-index就能置顶元素,且不受父元素的position影响。 命令源和命令目标之间会隐式的产生aria-details关联aria-expanded,用于触发焦点导航等。 Popover API的这些特性兼容性为:chrome114+, ff125+ 三、增强Popover (popover="hint") 与 兴趣调用(Interest Invoker) 一句话的解释 hint暗示:一种更轻量的触发行为的popover类别 完整示例 在上小节中,已经讲了popover原有的2个类别,今年它又新增了一个类别:hint 暗示。这种hint弹出层,不仅可以用原来的方法触发它,还增加了一种兴趣调用触发。 兴趣调用Interest Invoker是指:通过非点击事件,比如hover,mouseover,mouseout, focus,blur 它的变化。悬浮就显示,离开就隐藏,十分符合tooltip组件场景。 <button interestfor="mypopover1">悬浮触发 hint1 弹出层</button> <div id="mypopover1" popover='hint'>这是一个 hint1 弹出层</div> 命令源:它新增以下相关内容: 【attr】interestfor: 属性值为 hint类别的popover元素id 【css-rule】interest-delay: 设置悬浮触发和离开隐藏的时间。 它是复合属性: interest-delay-start, interest-delay-end。默认触发的时间是 0.5s。 【css-selector】 :interest-source 和 :interest-target 是指,如果当前兴趣正在发生,那么触发源和hint 弹出层就分别为具有上面的伪类。类似于 dialog打开时,dialog:open的伪类一样。详见上面示例。 hint 弹出层:新增以下事件: 【event】interest: 触发显示的InterestEvent事件, 事件的source指向触发源元素。 【event】loseinterest: 离开失去的InterestEvent事件,事件的source指向触发源元素。 兴趣调用与前面2节的内容有一些重要的差异: 强调必须非点击事件,场景对应"悬而未决"的状态,可以配合popover="hint"使用。 触发源更广泛,不仅是Button元素,还允许 <a>, <button>,<area>,SVG <a> 。 hint类别不影响auto类别的弹窗,不会主动触发auto弹窗关闭。 长期以来Web标准对hover行为是淡视的,只有title属性和 :hover的伪类,一直缺少关键的hover事件。此次提供 interest事件,借此可以变相的视为一种hover事件 兼容性 支持chrome 142+, 不支持:ff,safari, polyfill 方案。 四、可自定义的select (Customizable select) 一句话的解释 增强的select 和 option 元素,丰富的伪类、伪元素,定制更容易 完整示例 可定制的select增加了很多dom规范和伪类,伪元素,内容太多不宜展开细述,感兴趣看上面的完整MDN示例,我已经增加详细的注释。此处仅列出一些重要的概念和事项,以便能快速理解: base-select 设置: select 和 ::picker(select)伪元素都必须添加规则: appearance: base-select ,以区别于传统select样式。 弹出层::picker(select)特性: 它渲染在页面顶层Top Layer,这意味着它会显示在所有其他内容之上,不会被父容器裁剪。浏览器还会根据视口中的可用空间自动调整下拉列表的位置和翻转。 增强的option: 传统的option元素仅支持 label,value属性和selected,disabled的布尔属性。option中嵌套有其它元素,都是会忽略的。 增强后的option元素支持嵌套span,img等等普通元素,但要避免嵌套 a, input 等交互元素就行了。 新增 selectedcontent 元素: 该元素必须遵循 select > button > selectedcontent 的嵌套结构,详见示例。 select的选择值(即change事件)之后,选中的option的节点会被cloneNode创建副本,插入到selectedcontent中,所以他们结构一样,但不是同一个元素实例。 同时button是惰性的,不响应focus等,行为更像是 div。 option 和 selectedcontent 的子项,都可以用普通的 css 选择器去分别控制样式。 select 借用 Popover API 它隐式借用了非常多的Popover 特性,比如 :popover-open伪类,无需anchor-name的隐式的锚点引用,且可以定义弹出层与锚点的位置关系,溢出翻转等等。 select的multiple 和 optgroup 未增强 这意味着多选和分组功能,需要重新实现,对于组件库的作者来说,这无疑得回退到传统方案,幸好有Popover API。 兼容性: 支持 chrome 135+ , ff,safari均 不支持😭,polyfill 方案 这个方案并非真正意义的polyfill, 它使用自定义的 webComponent技术实现了平替。 五、滚动控制伪元素(::scroll-marker/button()) 一句话的解释 为滚动容器的添加伪元素,用于控制容器滚动 完整示例 HTML早早添加了dialog, detail 等元素,但一直没有增加一个轮播图元素,今年只抠抠搜搜添加了三个伪元素,或许是因为添加一个新元素需要考虑的事情太多。 ::scroll-button() 滚动容器按钮的伪元素,点击它会触发容器滚动。它非常类似于 ::before, ::after作用, 都需要content才显示,且呈现在容器的内部。 每个容器最多有4个滚动方向,括号的作用是指定滚动方向,可取值:*, left,right,up,down, block-end,block-start, inline-end,inline-start等。 按钮伪元素具有状态,比如容器滚动到两端之后,滚动按钮会自动禁用。 它具有以下状态: enabled, disabled,hover,active,focus ::scroll-marker 是滚动容器中,指示滚动项的伪元素,它同样也需要content才显示。 它具有 :target-current 伪类, 表示滚动到当前滚动项。当然, :hover, :active等伪类也能使用 ::scroll-marker-group 是呈现在滚动容器内部的伪元素,收集容纳所有的::scroll-marker元素。 marker-group元素自身没有高度,但可以设置边框,布局,间距等内容。 兼容性: 支持chrome 135+ , ff,safari均 不支持😭。由于它是css 特性,无法Polyfill, 建议使用传统的div去实现即可! 六、设置滚动标记组容器(scroll-target-group) 一句话的解释 设置元素为滚动容器 完整示例 CSS属性 scroll-target-group 用来指定一个元素为滚动标记组容器, 它只有2个值: none: 元素非滚动标记组容器 auto: 元素为滚动标记组容器 滚动标记组容器中通常包含锚点链接列表等,配合伪类 :target-current 来突出显示某个锚点,效果非常类似传统的Anchor组件,当容器滚动时,可以高亮指定的目录项,不过这些都是浏览器自动完成的,不需要一行javascript。 它与::scroll-marker-group 有某些相似点: ::scroll-marker-group:是在某个元素内部,创建一个伪元素容器,用来容纳::sroll-marker, 都是伪元素。 scroll-target-group: 是把一个真实元素变为滚动容器,内部放真实的link 类元素,所以控制上会更灵活。 从官方的态度看,这2个概念极其相近,都是定义了一个滚动容器,且内部的锚点行为一致,均支持伪类 :target-current 代表高亮状态,避免Javascript去滚动和设置高亮等。 兼容性: 支持 chrome 140+ ,但ff,safari均 不支持😭,且css 特性无法Polyfill。 七、锚定容器查询(Anchored Container Queries) 一句话的解释 锚点定位时,翻转状态可以查询完整示例 2024年的CSS回顾中,介绍了CSS锚点定位------- anchor positioning, 实现类似 Tooltip组件的效果,让一个弹出层锚定到目标元素周围,且能自动翻转到适合位置,避免使用Javascript。 它的兼容性: chrome125+, safari26+, ff 不支持。 下面例子演示了:CSS锚点定位。tooltip会锚定在button的上下, 当滚动到边界时,会自动翻转显示。 .my-button { anchor-name: --my-btn-anchor; /* 定义一个名为 --my-btn-anchor 的锚点 */ } .my-tooltip { position: absolute; /* 或 fixed */ position-anchor: --my-btn-anchor; /* 关联到上面定义的锚点 */ position-area: bottom; position-try-fallbacks: flip-block; } 思考一个问题:如果my-tooltip元素有小三角指示方向,那么简单的翻转后,小三角的位置怎么旋转呢? 答案是:定位元素无法意识(be aware)状态,小三角方向会错误。 此问题的解决方案即本次新增了CSS锚定容器查询能力,它通过指定tooltip的 container-type: anchored, 然后使用@container anchored 的查询语法,就让tooltip查询到,意识到自身的翻转状态(fallbacks 状态)。 .tooltip { container-type: anchored; /* 默认在下方, 小三角向上,位置在底部 */ &::before { content: '▲'; position: absolute; bottom: 100%; } } /** 当容器查询到锚点变化 */ @container anchored(fallback: flip-block) { .tooltip::before { /* 小三角向下,并移到到顶部 */ content: '▼'; bottom: auto; top: 100%; } } 要讲明白锚点定位需要很大篇幅,且该示例复杂,大家可以转到官网查看示例。 目前 container-type: anchored 的文档连MDN上都没有,是比较新的概念。 container-type有效值: normal: 元素不支持任何查询 size: 支持 inline 和 block 元素的尺寸的高度和宽度查询 inline-size: 仅支持 inline 元素的尺寸的宽度查询 scroll-state: 支持滚动态的偏移量和是否滚动到底等查询,chrome 133+, 但ff,safari均不支持 anchored: 锚点查询 兼容性: container-type: anchored 支持 chrome 143+ ,但ff,safari均不支持😭,且css 特性无法Polyfill。 总结 通过以上种种新特性,可以看出chrome 不仅关注使用用户体验,更关注开发者体验。通过增加类似command属性,或者Light Dismiss的默认行为,以及滚动容器,滚动容器伪元素等技巧,让许多场景都可以无Javascript实现了。 不仅大大减少开发代码,还有极强的DOM可读性。 我目前从事于组件库开发。在组件库的开发时,所采用的技术通常是落后于浏览器最新技术的,理由就是为了兼容用户浏览器。比如 dialog 元素已经是广泛兼容,但目前仍没有见到哪个组件库使用它。通过这次梳理技术,感觉借助 dialog 以及 popover api 可以极大简化以往的组件开发,诸如:监听按键,计算z-index,计算弹出层位置,监听滚动进行位置跟随等等,这些是问题bug集中爆发区,现在基本都可以无Js代码的实现了。 另外,前面的诸多未广泛兼容的技术,大都有相应的Polyfill,尤其是属性,函数和事件的Polyfill基本都能找到。CSS的新伪类,伪元素虽然很难有Polyfill,但可以用添加类名的方案来兼容,辅助以一些Js事件就可以实现某种程度上的polyfill。oddbird.tech是一家服务公司,得到过Google的赞助,它们一直关注开发Popover API和 Anchor positioning的兼容方案。这些方案都让我们以及早的使用新技术进行开发。 如果只需要支持最新的浏览器,前端的春天来了! 关于OpenTiny 欢迎加入 OpenTiny 开源社区。添加微信小助手:opentiny-official 一起参与交流前端技术~ OpenTiny 官网:https://opentiny.design OpenTiny 代码仓库:https://github.com/opentiny TinyVue 源码:https://github.com/opentiny/tiny-vue TinyEngine 源码: https://github.com/opentiny/tiny-engine 欢迎进入代码仓库 Star🌟TinyEngine、TinyVue、TinyNG、TinyCLI、TinyEditor~ 如果你也想要共建,可以进入代码仓库,找到 good first issue 标签,一起参与开源贡献~

优秀的个人博客,低调大师

每日一博 | LangChain 原理学习笔记

最新越发觉得AI的发展,对未来是一场革命,LangChain已经在工程设计上有了最佳实践,类似于AI时代的编程模型或编程框架,有点Spring框架的意思。之前在LangChain上也有些最佳实践,所以在这里分享记录下。 LangChain解决什么问题 LangChain是基于LLM之上的,在应用层和底层LLM之前的一个很好的编程框架,如果把LLM比喻为各种类型的数据库、中间件等这些基础设施,应用层是各种业务逻辑的组合之外,那么LangChain就负责桥接与业务层和底层LLM模型,让开发者可以快速地实现对接各种底层模型和快速实现业务逻辑的软件开发框架。 那么LangChain是如何做到的呢?试想一下,现在底层有一个大模型的推理能力,除了在对话框手动输入跟他聊天之外。如何用计算机方式跟它互动呢?如果把一次LLM调用当作一个原子能力,如何编排这些原子能力来解决一些业务需求呢?Langchain就是来解决这个事情的。 LangChain的几个核心概念 ▐Model I/O 这里重点把背后的LLM模型做了一层封装,开发者可以通过更改配置的方式快速切换底层LLM模型,比如chatgpt,chatGLM、通义千问等模型。 同时还有些高阶功能:比如提供了缓存等功能,这样对于语义上类似的query,如果缓存有,那么langchain可以快速返回结果,而不需要调用大模型。 ▐Retriver 检索是为了解决大模型打通用户的本身数据,做一些面向业务属性的东西。这里的检索并非传统的关系型数据库,更多的是与大模型的本身逻辑相似的,比如向量数据库。 一个经典的结合LLM和外部用户的文档进行智能答疑的场景 文档->分词->embedding->向量数据库 query->向量数据库查询->TOP N->上下文+ 用户提问 + prompt -> LLM -> 返回结果 一个经典的图如下: 关键技术:文档如何拆分、embedding过程、 TOPN 向量距离的选择 embedding技术选型 embedding是将现实中的物体通过向量化的方法转化为高维向量,可被机器学习模型所识别。他是一种映射,同时也保证了能清晰地表达现实物体的特征。基于此,可以进行一些归类分析、回归分析等。 现在市面上常见的embedding方法有通义千问的embedding等方法。 向量数据库: 向量数据库底层存储的是一堆向量,它提供了根据向量相似度进行查询的能力,一般情况下,向量相似度代表了现实世界中物体的相似度。比如”我的名字是小明“ 和“我叫小明”这两句话所代表的含义几乎是相同的,那么在embedding之后,基于向量数据库进行查询的时候,它们俩的相似度就会很近。 ▐Chain 各种类型的chain,chain代表了各种业务类型的组合,类似于工作流的编排。 ▐Memory LLM本身提供了记忆的能力,同时提供了接口,开发者可以将历史的对话记录传入给LLM。LangChain需要使用外部存储保存这些历史的会话和记忆。可以使用数据库、缓存等进行保存。 ▐Agent 重点是代理工具 代理工具可以让应用程序基于大模型的推理能力,然后进行代理工具或代理服务的调用。因为LLM是没有“联网”的能力的,如果想解决特定的应用场景,代理工具是个完美的选择。 代理工具通常包含三个方面:用户输入、prompt编排LLM思考与路由代理的过程、背后的代理服务。其中难点可能就在于prompt设计了。通常的“套路”是这样的: ReAct 模型 输入:用户的问题 思考过程:如果是情况1(这个是需要LLM进行意图识别进行思考的),那么推理和提取出一些关键参数,调用agent1,如果是情况2,那么推理和提取出一些关键参数,调用agent2 Act:调用agent1对应一个JSON格式化的输入,调用function1,返回结果。 观察:观察调用后的结果,再结合推理的能力,再进行循环思考。 LangChain的在实际场景中的实践 集团内部开发了一个JAVA版本的LangChain框架,以下实践基于此框架与开源大模型chatGLM-6B进行。 ▐淘宝开放平台智能问答 淘宝开放平台对内托管了上万个API,每天在内部群里都会有开发者咨询API发布问题,之前我们是通过NLP来实现智能问答的,现将它升级为基于大模型的智能问答,以下是具体的技术实现过程。 知识库Embedding过程 由于之前已经沉淀好了很多知识库,都是Question-Answer的这种形式,这里我们对Question,也就是问题进行Embedding,此处采用通义千问提供的Embedding方法。 知识库embedding: TongYiEmbeddings embeddings = new TongYiEmbeddings();embeddings.setServerAccessId(ALINLP_EMBEDDINGS_ACCESSID);embeddings.setServerUrl(ALINLP_EMBEDDINGS_SERVER_URL);embeddings.setServerUuid(ALINLP_EMBEDDINGS_UUID);Document document = new Document();document.setPageContent(rawText);List<Document> documents = embeddings.embedDocument(Arrays.asList(document));Document vecDocument= documents.get(0);// 向量化知识String embeddingString = JSON.toJSONString(vecDocument.getEmbedding()).replaceAll("\\[", "{").replaceAll("\\]", "}");return embeddingString; 向量数据库存储和查询 此处采用hologres向量数据库,图中红框表示知识库问题与回答在数据库中具体的向量化存储数据。 向量距离数据库查询: select origin_content as originContent, origin_title as originTitle, pm_approx_squared_euclidean_distance(embedding_title, #{embeddingTitle}) as distancefrom vs_knowledgeorder by distance asclimit #{limit} 大模型问答链路 问答chain的基本实现: //1. 初始化ChatGLM的参数ChatGLMV2Internal chatGLMV2Internal = new ChatGLMV2Internal();chatGLMV2Internal.setTemperature(0.01d);chatGLMV2Internal.setMaxLength(2048);//2. 提示词编写PromptTemplate prompt = new PromptTemplate();String template = "已知信息:\n" +"{context} \n" +"\n" +"根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说 “根据已知信息无法回答该问题” 或 “没有提供足够的相关信息”,不允许在答案中添加编造成分,答案请使用中文。问题是:{question}";prompt.setTemplate(template);//3. 向量数据库检索配置,比如最大向量距离RetrievalQA qa = new RetrievalQA();qa.setRecommend(5);qa.setMaxDistanceValue(10000.0d);qa.setLlm(chatGLMV2Internal);qa.setPrompt(prompt);qa.setRetriever(holoRetriver.asRetriever());qa.init();//4. LLM大模型问答Map<String, Object> inputs = new HashMap<>();inputs.put("question", question);inputs.put("input", question);Map<String, Object> outputs = qa.run(inputs);llmKonwledgeDO.setContent(String.valueOf(outputs.get("text")));// 补充 doclistreturn llmKonwledgeDO; ▐AI Agent实践 以下实现了一个网关API调用日志解析的agent。 Agent工具注册: this.setName("ApiLogTool");this.setDescription("这是一个调用日志查询接口,如果[{question}]中包含requestId关键字,你可以请求这个工具与日志系统进行交互,调用这个工具。\n" + "请先提取出requestId的值,将它赋值为value。调用参数:[{\"requestId\": \"value\", \"type\": \"String\", \"description\": \"调用请求id\"}]。"); 工具解析: Map<String,Object> parse = (Map<String,Object>)JSON.parse(toolInput);if(parse.get("requestId")==null){ return new ToolExecuteResult("");}String requestId = parse.get("requestId").toString();ApiLogSearchQuery apiLogSearchQuery = new ApiLogSearchQuery();//日志查询解析处理 思考决策逻辑: public static final String FORMAT_INSTRUCTIONS_CH ="用户提出了一个问题: {question} \n" +"你可以选择使用下面这些工具:\n"+"{tool_list_description}"+"\n"+"同时你的思考过程如下:"+"Thought: 每一次你需要首先思考你应该做什么\n" +"Action: 你需要决定是否使用工具,应该是[{tool_names}] 中的一个Action,格式为JSON。如果匹配不到工具,就不要思考了,直接返回结果,请不要把思考过程返回给用户。\n" +"Input: 如果匹配到工具,使用的工具的输入参数,赋值给params\n" +"Observation: 如果匹配到工具,工具的输出结果 格式为[]。\n" +"Answer: 每一步回答问题的答案,格式为JSON。你可以多次使用Thought/Action/Input/Observation/Answer来一步一步的思考如何回答问题。\n"; 个人小思考 未来微服务HSF这种形式会向上往 agent工厂或者agent服务框架这种形式演进,因为这个框架搭好了后,后面各个业务方快速集成到agent服务上,可被上层AI应用层调用 如果多个agent联动了,才是真正的智能 如何定义agent? Agent体系架构可以分为慎思型、反应型和混合型。 慎思型构建负责规划和推理行为,反应型构建处理需要快速响应的重要事件。 信念-期望-意图(Belief-Desire-ltension, BDI) 体系架构是混合型体系架构的一个重要类型。 Agent的表示形式,Agent的行为可以被描述成好像拥有信念、期望和意图等思维状态。信念表示Agent拥有的知识,期望描述Agent追求的目标,意图说明Agent选择计划以实现哪些目标。 openai提供的agent概念 团队介绍 我们是淘天集团商家与开放平台团队,目前主要围绕商家的日常经营场景,为中小商家提供高效易用的电商工具。 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | PostgreSQL 数据脱敏方式盘点

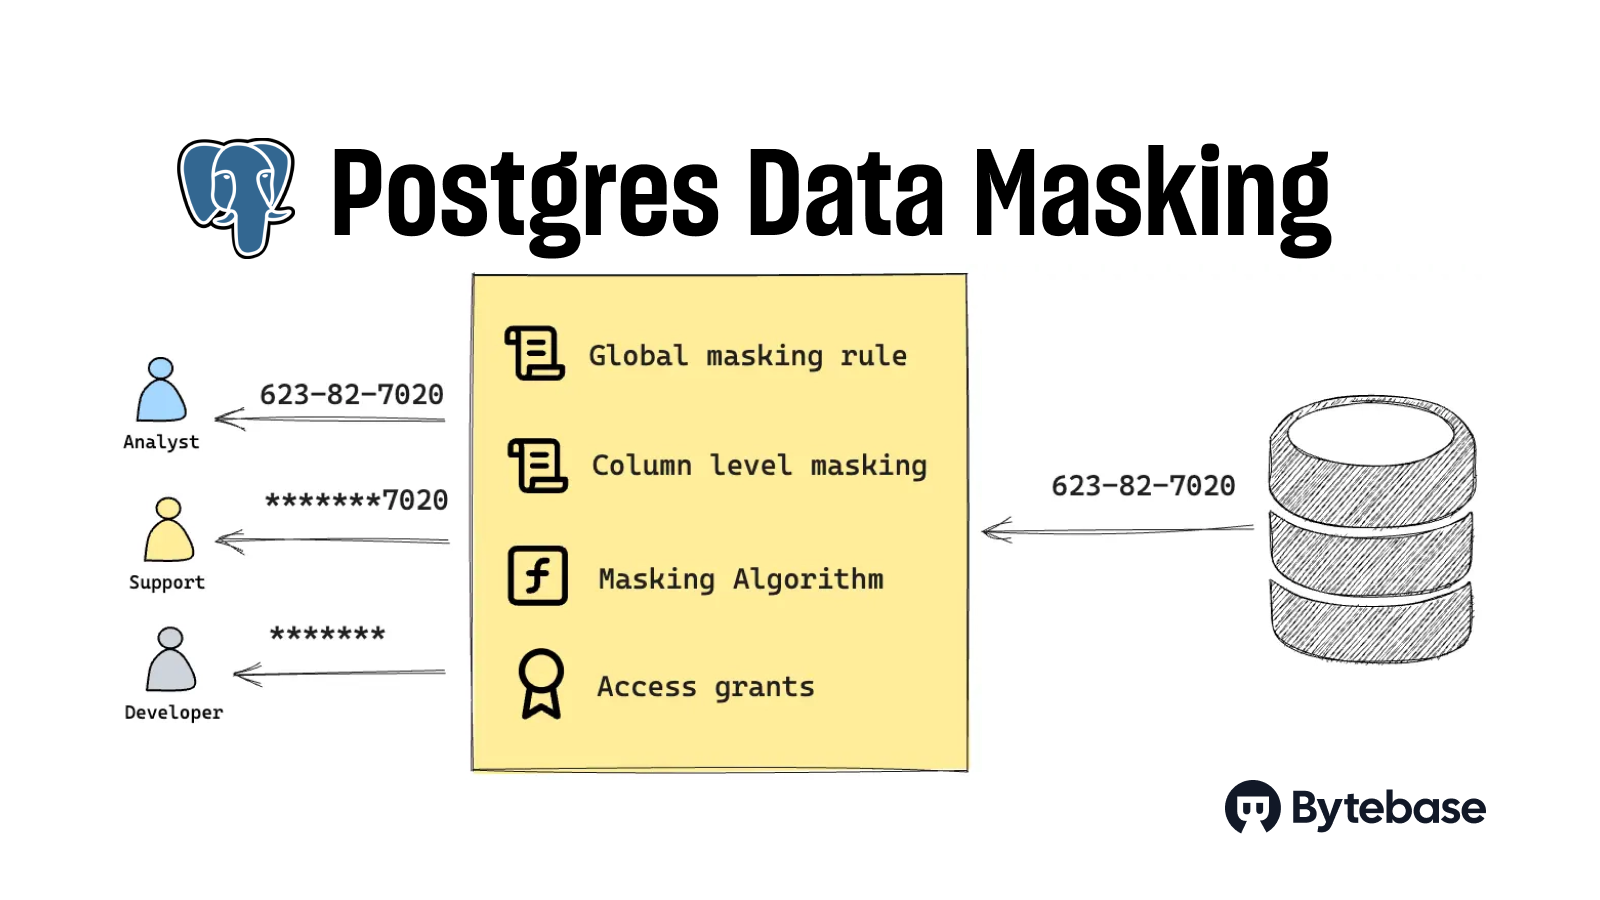
数据脱敏是一种广泛采用的保护敏感数据(如信用卡,社保卡,地址等信息)的方法。脱敏数据不仅仅是为了保护你和客户的数据安全,在一些情况下,法律也有相应要求,最著名的例子就是 GDPR。 市面上也有各种不同的数据脱敏方法,例如遮挡,替换,洗牌和加密,适用于不同场景。通过对敏感数据进行脱敏处理,组织能够降低数据泄露和未经授权访问的风险,同时仍然能够使用真实数据进行开发、测试和分析等任务。 本文来盘点一下 PostgreSQL 的几种常用脱敏方式。 PostgreSQL Anonymizer PostgreSQL Anonymizer 是个社区贡献的扩展 ,可以为 PostgreSQL 添加不同的数据脱敏选项和方法。它将脱敏配置存储在 PostgreSQL 的 SECURITY LABEL(安全标签)中。 动态脱敏 PostgreSQL Anonymizer 实现动态脱敏的方式是通过将定义某个角色为 "MASKED" 以及脱敏规则。被授予 "MASKED" 角色的用户将无法访问原始数据,而其他角色仍然可以访问。它现已支持多种的脱敏语法,你甚至可以编写自己的规则。 这种方法有一定的局限性,例如在他们文档中 有提到,如果你同时使用脱敏插件和 GUI 工具如 DBeaver 或 pgAdmin 进行查询的时候可能会出现问题;对于某些查询来说,动态脱敏可能非常慢。此外,不同的脱敏变体需要不同的视图,在角色或底层表发生变化时,这又很快变得难以管理起来。 静态脱敏 PostgreSQL Anonymizer 还支持静态脱敏,可以直接转换原始数据集。比如可以用虚假数据替换原始数据,添加噪音或者混淆数据以隐藏敏感信息。 静态脱敏的原则是更新包含至少一个被脱敏列的所有表的所有行。基本上意味着 PostgreSQL 将重写磁盘上的所有数据。所以请注意,这种方法会破坏原始数据,并且是一个比较缓慢的过程。因此,在使用静态脱敏之前,请三思而后行。 Bytebase 动态数据脱敏 Bytebase 动态数据脱敏 不依赖于 PostgreSQL 视图或其用户,而是通过 Bytebase 内部管理脱敏策略和授权管理。当用户通过 SQL 编辑器查询时,会自动应用动态脱敏策略。 Bytebase 动态数据脱敏包括以下组件: 全局脱敏规则:工作空间的「管理员」和「DBA」可以批量定义全局脱敏规则。例如,可以将所有名为 email 的列脱敏程度设置为「半脱敏」。这样,修改脱敏策略就无需手动修改数千列了,还节省了维护视图的麻烦。 列脱敏规则:工作空间的「管理员」和「DBA」可以将列设置为不同的脱敏级别。列脱敏规则优先于全局脱敏规则。 访问未脱敏数据:对于脱敏数据,工作空间的「管理员」和「DBA」可以授予特定用户访问未脱敏数据的权限。 📣 工作空间的「管理员」和「DBA」均为 Bytebase 的角色。 对比 PostgreSQL Anonymizer 的优势在于它是在数据库本身中实现的。因此,无论查询如何发送到数据库,数据脱敏规则都会被强制执行。对于 Bytebase 动态数据脱敏,查询必须通过 SQL 编辑器才会强制执行。 Bytebase 动态数据脱敏的优势在于其与所有 PostgreSQL 发行版(和 MySQL 发行版🐬)都兼容,且支持细粒度的脱敏策略和访问权限。只要团队通过 Bytebase SQL 编辑器来查询数据库,那么 Bytebase 动态数据脱敏可以保障组织敏感数据的安全。 🔧 欢迎跟着教程来试试 Bytebase 动态数据脱敏。 💡 更多资讯,请关注 Bytebase 公号:Bytebase

优秀的个人博客,低调大师

每日一博 | MYSQL 事务的底层原理

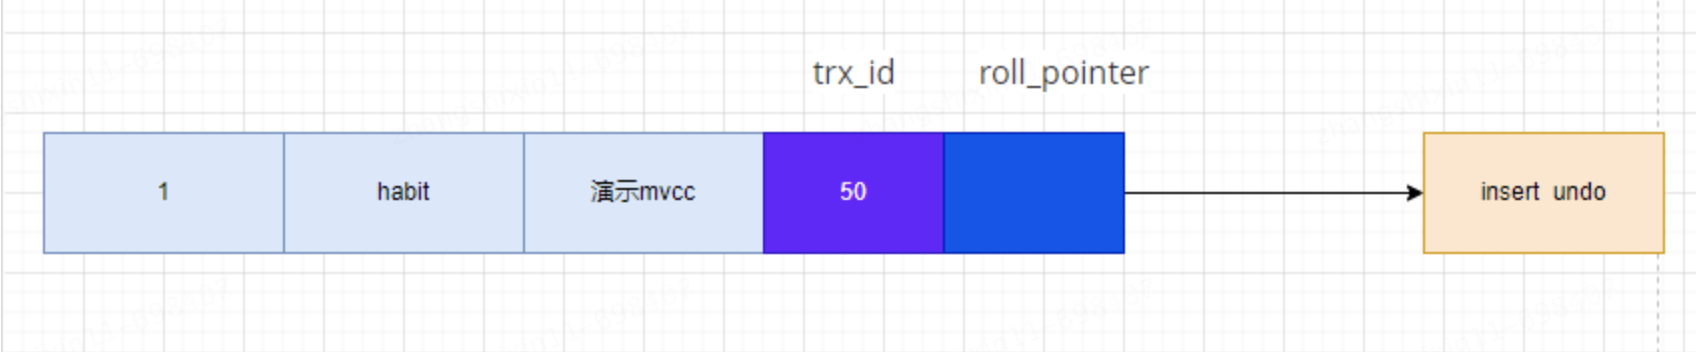
事务的底层原理 在事务的实现机制上,MySQL 采用的是 WAL:Write-ahead logging,预写式日志,机制来实现的。 在使用 WAL 的系统中,所有的修改都先被写入到日志中,然后再被应用到系统中。通常包含 redo 和 undo 两部分信息。 为什么需要使用 WAL,然后包含 redo 和 undo 信息呢?举个例子,如果一个系统直接将变更应用到系统状态中,那么在机器掉电重启之后系统需要知道操作是成功了,还是只有部分成功或者是失败了。如果使用了 WAL,那么在重启之后系统可以通过比较日志和系统状态来决定是继续完成操作还是撤销操作。 redo log 称为重做日志,每当有操作时,在数据变更之前将操作写入 redo log,这样当发生掉电之类的情况时系统可以在重启后继续操作。 undo log 称为撤销日志,当一些变更执行到一半无法完成时,可以根据撤销日志恢复到变更之间的状态。 MySQL 中用 redo log 来在系统 Crash 重启之类的情况时修复数据,而 undo log 来保证事务的原子性。 事务 id 一个事务可以是一个只读事务,或者是一个读写事务:可以通过 START TRANSACTION READ ONLY 语句开启一个只读事务。 在只读事务中不可以对普通的表进行增、删、改操作,但可以对用户临时表做增、删、改操作。 可以通过 START TRANSACTION READ WRITE 语句开启一个读写事务,或者使用 BEGIN、START TRANSACTION 语句开启的事务默认也算是读写事务。 在读写事务中可以对表执行增删改查操作。 如果某个事务执行过程中对某个表执行了增、删、改操作,那么 InnoDB 存储引擎就会给它分配一个独一无二的事务 id,针对 MySQL 5.7 分配方式如下: 对于只读事务来说,只有在它第一次对某个用户创建的临时表执行增、删、改操作时才会为这个事务分配一个事务 id,否则的话是不分配事务 id 的。 对于读写事务来说,只有在它第一次对某个表执行增、删、改操作时才会为这个事务分配一个事务 id,否则的话也是不分配事务 id 的。 有的时候虽然开启了一个读写事务,但是在这个事务中全是查询语句,并没有执行增、删、改的语句,那也就意味着这个事务并不会被分配一个事务 id。 这个事务 id 本质上就是一个数字,它的分配策略和隐藏列 row_id 的分配策略大抵相同,具体策略如下: 服务器会在内存中维护一个全局变量,每当需要为某个事务分配一个事务 id 时,就会把该变量的值当作事务 id 分配给该事务,并且把该变量自增 1。 每当这个变量的值为 256 的倍数时,就会将该变量的值刷新到系统表空间的页号为 5 的页面中一个称之为 Max Trx ID 的属性处,这个属性占用 8 个字节的存 储空间。 当系统下一次重新启动时,会将上边提到的 Max Trx ID 属性加载到内存中,将该值加上 256 之后赋值给全局变量,因为在上次关机时该全局变量的值可能大于Max Trx ID 属性值。 这样就可以保证整个系统中分配的事务 id 值是一个递增的数字。先被分配 id 的事务得到的是较小的事务 id,后被分配 id 的事务得到的是较大的事务 id。 mvcc 全称 Multi-Version Concurrency Control,即多版本并发控制,主要是为了提高数据库的并发性能。 同一行数据平时发生读写请求时,会上锁阻塞住。但 MVCC 用更好的方式去处理读写请求,做到在发生读写请求冲突时不用加锁。 这个读是指的快照读,而不是当前读,当前读是一种加锁操作,是悲观锁。 MVCC 原理 在事务并发执行遇到的问题如下: 脏读:如果一个事务读到了另一个未提交事务修改过的数据,那就意味着发生了脏读; 不可重复读:如果一个事务只能读到另一个已经提交的事务修改过的数据,并且其他事务每对该数据进行一次修改并提交后,该事务都能查询得到最新值,那就意味着发生了不可重复读; 幻读:如果一个事务先根据某些条件查询出一些记录,之后另一个事务又向表中插入了符合这些条件的记录,原先的事务再次按照该条件查询时,能把另一个事务插入的记录也读出来,那就意味着发生了幻读,幻读强调的是一个事务按照某个相同条件多次读取记录时,后读取时读到了之前没有读到的记录,幻读只是重点强调了读取到了之前读取没有获取到的记录。 MySQL 在 REPEATABLE READ 隔离级别下,是可以很大程度避免幻读问题的发生的。 版本链 对于使用 InnoDB 存储引擎的表来说,它的聚簇索引记录中都包含两个必要的隐藏列: trx_id:每次一个事务对某条聚簇索引记录进行改动时,都会把该事务的事务 id 赋值给 trx_id 隐藏列; roll_pointer:每次对某条聚簇索引记录进行改动时,都会把旧的版本写入到 undo 日志中,然后这个隐藏列就相当于一个指针,可以通过它来找到该记录修 改前的信息; 演示 -- 创建表 CREATE TABLE mvcc_test ( id INT, name VARCHAR(100), domain varchar(100), PRIMARY KEY (id) ) Engine=InnoDB CHARSET=utf8; -- 添加数据 INSERT INTO mvcc_test VALUES(1, 'habit', '演示mvcc'); 假设插入该记录的事务 id=50,那么该条记录的展示如图:  假设之后两个事务 id 分别为 70、90 的事务对这条记录进行 UPDATE 操作。 trx_id=70 trx_id=90 begin   begin   update mvcc_test set name='habit_trx_id_70_01' where id=1  update mvcc_test set name='habit_trx_id_70_02' where id=1  commit   update mvcc_test set name='habit_trx_id_90_01' where id=1  update mvcc_test set name='habit_trx_id_90_02' where id=1  commit 每次对记录进行改动,都会记录一条 undo 日志,每条 undo 日志也都有一个 roll_pointer 属性,可以将这些 undo 日志都连起来,串成一个链表。  对该记录每次更新后,都会将旧值放到一条 undo 日志中,就算是该记录的一个旧版本,随着更新次数的增多,所有的版本都会被 roll_pointer 属性连接成一个链表,把这个链表称之为版本链,版本链的头节点就是当前记录最新的值。另外,每个版本中还包含生成该版本时对应的事务 id。于是可以利用这个记录的版本链来控制并发事务访问相同记录的行为,那么这种机制就被称之为:多版本并发控制,即 MVCC。 ReadView 对于使用 READ UNCOMMITTED 隔离级别的事务来说,由于可以读到未提交事务修改过的记录,所以直接读取记录的最新版本就好了。 对于使用 SERIALIZABLE 隔离级别的事务来说,InnoDB 使用加锁的方式来访问记录。 对于使用 READ COMMITTED 和 REPEATABLE READ 隔离级别的事务来说,都必须保证读到已经提交了的事务修改过的记录,也就是说假如另一个事务已经修改了记录但是尚未提交,是不能直接读取最新版本的记录的,核心问题就是:READ COMMITTED 和 REPEATABLE READ 隔离级别在不可重复读和幻读上的区别是从哪里来的,其实结合前面的知识,这两种隔离级别关键是需要判断一下版本链中的哪个版本是当前事务可见的。 为此,InnoDB 提出了一个 ReadView 的概念,这个 ReadView 中主要包含 4 个比较重要的内容: m_ids:表示在生成 ReadView 时当前系统中活跃的读写事务的事务id 列表; min_trx_id:表示在生成 ReadView 时当前系统中活跃的读写事务中最小的事务 id,也就是 m_ids 中的最小值; max_trx_id:表示在生成 ReadView 时系统中应该分配给下一个事务的 id 值,注:max_trx_id 并不是 m_ids 中的最大值,事务 id 是递增分配的。比方说现在有 id 为 1,2,3 这三个事务,之后 id 为 3 的事务提交了。那么一个新的读事务在生成 ReadView 时,m_ids 就包括 1 和 2,min_trx_id 的值就是 1,max_trx_id 的值就是 4; creator_trx_id:表示生成该 ReadView 的事务的事务 id; 有了这个 ReadView,这样在访问某条记录时,只需要按照下边的步骤判断记录的某个版本是否可见: 如果被访问版本的 trx_id 属性值与 ReadView 中的 creator_trx_id 值相同,意味着当前事务在访问它自己修改过的记录,所以该版本可以被当前事务访问; 如果被访问版本的 trx_id 属性值小于 ReadView 中的 min_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 前已经提交,所以该版本可以被当前事务访问; 如果被访问版本的 trx_id 属性值大于或等于 ReadView 中的 max_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 后才开启,所以该版本不可以被当前事务访问; 如果被访问版本的 trx_id 属性值在 ReadView 的 min_trx_id 和 max_trx_id之间 min_trx_id < trx_id < max_trx_id,那就需要判断一下 trx_id 属性值是不是在 m_ids 列表中,如果在,说明创建 ReadView 时生成该版本的事务还是活跃的,该版本不可以被访问;如果不在,说明创建 ReadView 时生成该版本的事务已经被提交,该版本可以被访问; 如果某个版本的数据对当前事务不可见的话,那就顺着版本链找到下一个版本的数据,继续按照上边的步骤判断可见性,依此类推,直到版本链中的最后一个版本。如果最后一个版本也不可见的话,那么就意味着该条记录对该事务完全不可见,查询结果就不包含该记录; 在 MySQL 中,READ COMMITTED 和 REPEATABLE READ 隔离级别的一个非常大的区别就是它们生成 ReadView 的时机不同。 还是以表 mvcc_test 为例,假设现在表 mvcc_test 中只有一条由事务 id 为 50 的事务插入的一条记录,接下来看一下 READ COMMITTED 和 REPEATABLE READ 所谓的生成 ReadView 的时机不同到底不同在哪里。 READ COMMITTED: 每次读取数据前都生成一个 ReadView; 比方说现在系统里有两个事务id 分别为 70、90 的事务在执行: -- T 70 UPDATE mvcc_test SET name = 'habit_trx_id_70_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_70_02' WHERE id = 1; 此时表 mvcc_test 中 id 为 1 的记录得到的版本链表如下所示:  假设现在有一个使用 READ COMMITTED 隔离级别的事务开始执行: -- 使用 READ COMMITTED 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' 这个 SELECE1 的执行过程如下: 在执行 SELECT 语句时会先生成一个 ReadView,ReadView 的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,在 m_ids 列表内,所以不符合可见性要求第 4 条:如果被访问版本的 trx_id 属性值在 ReadView 的 min_trx_id 和 max_trx_id之间 min_trx_id < trx_id < max_trx_id,那就需要判断一下trx_id 属性值是不是在 m_ids 列表中,如果在,说明创建 ReadView 时生成该版本的事务还是活跃的,该版本不可以被访问;如果不在,说明创建 ReadView 时生成该版本的事务已经被提交,该版本可以被访问。根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_01,该版本的 trx_id 值也为 70,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值,所以这个版本是符合要求的第 2 条:如果被访问版本的 trx_id 属性值小于 ReadView 中的 min_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 前已经提交,所以该版本可以被当前事务访问。最后返回的版本就是这条列 name 为 habit 的记录。 之后,把事务 id 为 70 的事务提交一下,然后再到事务 id 为 90 的事务中更新一下表 mvcc_test 中 id 为 1 的记录: -- T 90 UPDATE mvcc_test SET name = 'habit_trx_id_90_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_90_02' WHERE id = 1; 此时表 mvcc 中 id 为 1 的记录的版本链就长这样:  然后再到刚才使用 READ COMMITTED 隔离级别的事务中继续查找这个 id 为 1 的记录,如下: -- 使用 READ COMMITTED 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 均未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' -- SELECE2:Transaction 70 提交,Transaction 90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit_trx_id_70_02' 这个SELECE2 的执行过程如下: 在执行 SELECT 语句时又会单独生成一个 ReadView,该 ReadView 的 m_ids 列表的内容就是[90],min_trx_id 为90,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_90_02,该版本的 trx_id 值为 90,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_90_01,该版本的 trx_id 值为 90,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,小于 ReadView 中的 min_trx_id 值 90,所以这个版本是符合要求的,最后返回这个版本中列 name 为 habit_trx_id_70_02 的记录。 以此类推,如果之后事务 id 为 90 的记录也提交了,再次在使用 READ COMMITTED 隔离级别的事务中查询表 mvcc_test 中 id 值为 1 的记录时,得到的结果就是 habit_trx_id_90_02 了。 总结:使用 READ COMMITTED 隔离级别的事务在每次查询开始时都会生成一个独立的 ReadView。 REPEATABLE READ:在第一次读取数据时生成一个 ReadView; 对于使用 REPEATABLE READ 隔离级别的事务来说,只会在第一次执行查询语句时生成一个 ReadView,之后的查询就不会重复生成了。 比方说现在系统里有两个事务id 分别为 70、90 的事务在执行: -- T 70 UPDATE mvcc_test SET name = 'habit_trx_id_70_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_70_02' WHERE id = 1; 此时表 mvcc_test 中 id 为 1 的记录得到的版本链表如下所示:  假设现在有一个使用 REPEATABLE READ 隔离级别的事务开始执行: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列name 的值为'habit' 这个 SELECE1 的执行过程如下: 在执行 SELECT 语句时会先生成一个 ReadView,ReadView 的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_01,该版本的 trx_id 值也为 70,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值,所以这个版本是符合要求的,最后返回的就是这条列name 为 habit 的记录。 之后,把事务 id 为 70 的事务提交一下,然后再到事务 id 为 90 的事务中更新一下表 mvcc_test 中 id 为 1 的记录: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; UPDATE mvcc_test SET name = 'habit_trx_id_90_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_90_02' WHERE id = 1; 此刻,表 mvcc_test 中 id 为 1 的记录的版本链就长这样:  然后再到刚才使用 REPEATABLE READ 隔离级别的事务中继续查找这个 id 为 1 的记录,如下: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 均未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' -- SELECE2:Transaction 70 提交,Transaction 90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' 这个 SELECE2 的执行过程如下: 因为当前事务的隔离级别为 REPEATABLE READ,而之前在执行 SELECE1 时已经生成过 ReadView 了,所以此时直接复用之前的 ReadView,之前的 ReadView的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91, creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_90_02,该版本的 trx_id 值为 90,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_90_01,该版本的 trx_id 值为 90,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,而 m_ids 列表中是包含值为 70 的事务 id 的,所以该版本也不符合要求,同理下一个列 name 的内容是 habit_trx_id_70_01 的版本也不符合要求。继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值 70,所以这个版本是符合要求的,最后返回给用户的版本就是这条列 name 为 habit 的记录。 也就是说两次 SELECT 查询得到的结果是重复的,记录的列 name 值都是 habit,这就是可重复读的含义。如果之后再把事务 id 为 90 的记录提交了,然后再到刚才使用 REPEATABLE READ 隔离级别的事务中继续查找这个 id 为 1 的记录,得到的结果还是 habit。 MVCC 下的幻读解决和幻读现象 REPEATABLE READ 隔离级别下 MVCC 可以解决不可重复读问题,那么幻读呢?MVCC 是怎么解决的?幻读是一个事务按照某个相同条件多次读取记录时,后读取时读到了之前没有读到的记录,而这个记录来自另一个事务添加的新记录。 可以想想,在 REPEATABLE READ 隔离级别下的事务 T1 先根据某个搜索条件读取到多条记录,然后事务 T2 插入一条符合相应搜索条件的记录并提交,然后事务 T1 再根据相同搜索条件执行查询。结果会是什么?按照 ReadView 中的比较规则中的第 3 条和第 4 条不管事务 T2 比事务 T1 是否先开启,事务 T1 都是看不到 T2 的提交的。 但是,在 REPEATABLE READ 隔离级别下 InnoDB 中的 MVCC 可以很大程度地避免幻读现象,而不是完全禁止幻读。怎么回事呢?来看下面的情况:  首先在事务 T1 中执行:select * from mvcc_test where id = 30; 这个时候是找不到 id = 30 的记录的。 在事务 T2 中,执行插入语句:insert into mvcc_test values(30,'luxi','luxi'); 此时回到事务 T1,执行: update mvcc_test set domain='luxi_t1' where id=30; select * from mvcc_test where id = 30; 事务T1 很明显出现了幻读现象。 在 REPEATABLE READ 隔离级别下,T1 第一次执行普通的 SELECT 语句时生成了一个 ReadView,之后 T2 向 mvcc_test 表中新插入一条记录并提交。 ReadView 并不能阻止 T1 执行 UPDATE 或者 DELETE 语句来改动这个新插入的记录,由于 T2 已经提交,因此改动该记录并不会造成阻塞,但是这样一来,这条新记录的 trx_id 隐藏列的值就变成了 T1 的事务 id。之后 T1 再使用普通的 SELECT 语句去查询这条记录时就可以看到这条记录了,也就可以把这条记录返回给客户端。因为这个特殊现象的存在,可以认为 MVCC 并不能完全禁止幻读。 mvcc 总结 从上边的描述中可以看出来,所谓的 MVCC(Multi-Version Concurrency Control ,多版本并发控制)指的就是在使用 READ COMMITTD、REPEATABLE READ 这两种隔离级别的事务在执行普通的 SELECT 操作时访问记录的版本链的过程,这样子可以使不同事务的读写、写读操作并发执行,从而提升系统性能。 READ COMMITTD、REPEATABLE READ 这两个隔离级别的一个很大不同就是:生成 ReadView 的时机不同,READ COMMITTD 在每一次进行普通 SELECT 操作前都会生成一个 ReadView,而 REPEATABLE READ 只在第一次进行普通 SELECT 操作前生成一个 ReadView,之后的查询操作都重复使用这个 ReadView 就好了,从而基本上可以避免幻读现象。 InnoDB 的 Buffer Pool 对于使用 InnoDB 作为存储引擎的表来说,不管是用于存储用户数据的索引,包括:聚簇索引和二级索引,还是各种系统数据,都是以页的形式存放在表空间中的,而所谓的表空间只不过是 InnoDB 对文件系统上一个或几个实际文件的抽象,也就是说数据还是存储在磁盘上的。 但是磁盘的速度慢,所以 InnoDB 存储引擎在处理客户端的请求时,当需要访问某个页的数据时,就会把完整的页的数据全部加载到内存中,即使只需要访问一个页的一条记录,那也需要先把整个页的数据加载到内存中。将整个页加载到内存中后就可以进行读写访问了,在进行完读写访问之后并不着急把该页对应的内存空间释放掉,而是将其缓存起来,这样将来有请求再次访问该页面时,就可以省去磁盘 IO 的开销了。 Buffer Pool InnoDB 为了缓存磁盘中的页,在 MySQL 服务器启动的时候就向操作系统申请了一片连续的内存,这块连续内存叫做:Buffer Pool,中文名:缓冲池。 默认情况下 Buffer Pool 只有 128M 大小。 查看该值:show variables like 'innodb_buffer_pool_size'; 可以在启动服务器的时候配置 innodb_buffer_pool_size 参数的值,它表示 Buffer Pool 的大小,配置如下: [server] innodb_buffer_pool_size = 268435456 其中,268435456 的单位是字节,也就是指定 Buffer Pool 的大小为 256M,Buffer Pool 也不能太小,最小值为 5M,当小于该值时会自动设置成 5M。 启动 MySQL 服务器的时候,需要完成对 Buffer Pool 的初始化过程,就是先向操作系统申请 Buffer Pool 的内存空间,然后把它划分成若干对控制块和缓 存页。但是此时并没有真实的磁盘页被缓存到 Buffer Pool 中,之后随着程序的运行,会不断的有磁盘上的页被缓存到 Buffer Pool 中。 在 Buffer Pool 中会创建多个缓存页,默认的缓存页大小和在磁盘上默认的页大小是一样的,都是 16KB。 那么怎么知道该页在不在 Buffer Pool 中呢? 在查找数据的时候,先通过哈希表中查找 key 是否在哈希表中,如果在证明 Buffer Pool 中存在该缓存也信息,如果不存在证明不存该缓存也信息,则通过读取磁盘加载该页信息放到 Buffer Pool 中,哈希表中的 key 是通过表空间号+ 页号作组成的,value 是 Buffer Pool 的缓存页。 flush 链表的管理 如果修改了 Buffer Pool 中某个缓存页的数据,那它就和磁盘上的页不一致了,这样的缓存页也被称为:脏页。最简单的做法就是每发生一次修改就立即同步到磁盘上对应的页上,但是频繁的往磁盘中写数据会严重的影响程序的性能。所以每次修改缓存页后,并不着急把修改同步到磁盘上,而是在未来的某个时间进行同步。 但是如果不立即同步到磁盘的话,那之后再同步的时候怎么知道 Buffer Pool 中哪些页是脏页,哪些页从来没被修改过呢?总不能把所有的缓存页都同步到磁盘上吧,如果 Buffer Pool 被设置的很大,那一次性同步会非常慢。 所以,需要再创建一个存储脏页的链表,凡是修改过的缓存页对应的控制块都会作为一个节点加入到一个链表中,因为这个链表节点对应的缓存页都是需要被刷新到磁盘上的,所以也叫 flush 链表。 刷新脏页到磁盘 后台有专门的线程每隔一段时间负责把脏页刷新到磁盘,这样可以不影响用户线程处理正常的请求。 从 flush 链表中刷新一部分页面到磁盘,后台线程也会定时从 flush 链表中刷新一部分页面到磁盘,刷新的速率取决于当时系统是不是很繁忙。这种刷新页面的方式被称之为:BUF_FLUSH_LIST。 redo 日志 redo 日志的作用 InnoDB 存储引擎是以页为单位来管理存储空间的,增删改查操作其实本质上都是在访问页面,包括:读页面、写页面、创建新页面等操作。在真正访问页面之前,需要把在磁盘上的页缓存到内存中的 Buffer Pool 之后才可以访问。但是在事务的时候又强调过一个称之为持久性的特性,就是说对于一个已经提交的事务,在事务提交后即使系统发生了崩溃,这个事务对数据库中所做的更改也不能丢失。 如果只在内存的 Buffer Pool 中修改了页面,假设在事务提交后突然发生了某个故障,导致内存中的数据都失效了,那么这个已经提交了的事务对数据库中所做的更改也就跟着丢失了,这是所不能忍受的。那么如何保证这个持久性呢?一个很简单的做法就是在事务提交完成之前把该事务所修改的所有页面都刷新到磁盘,但是这个简单粗暴的做法有些问题: 刷新一个完整的数据页太浪费了;有时候仅仅修改了某个页面中的一个字节,但是在 InnoDB 中是以页为单位来进行磁盘 IO 的,也就是说在该事务提交时不得不将一个完整的页面从内存中刷新到磁盘,一个页面默认是16KB 大小,只修改一个字节就要刷新 16KB 的数据到磁盘上显然是太浪费了。 随机 IO 刷起来比较慢;一个事务可能包含很多语句,即使是一条语句也可能修改许多页面,该事务修改的这些页面可能并不相邻,这就意味着在将某个事务修改的 Buffer Pool 中的页面刷新到磁盘时,需要进行很多的随机 IO,随机 IO 比顺序 IO 要慢,尤其对于传统的机械硬盘来说。 只是想让已经提交了的事务对数据库中数据所做的修改永久生效,即使后来系统崩溃,在重启后也能把这种修改恢复出来。其实没有必要在每次事务提交时就把该事务在内存中修改过的全部页面刷新到磁盘,只需要把修改了哪些东西记录一下就好,比方说:某个事务将系统表空间中的第 5 号页面中偏移量为 5000 处的那个字节的值 0 改成 5 只需要记录一下:将第 5 号表空间的 5 号页面的偏移量为 5000 处的值更新为:5。 这样在事务提交时,把上述内容刷新到磁盘中,即使之后系统崩溃了,重启之后只要按照上述内容所记录的步骤重新更新一下数据页,那么该事务对数据库中所做的修改又可以被恢复出来,也就意味着满足持久性的要求。因为在系统崩溃重启时需要按照上述内容所记录的步骤重新更新数据页,所以上述内容也被称之为:重做日志,即:redo log。与在事务提交时将所有修改过的内存中的页面刷新到磁盘中相比,只将该事务执行过程中产生的 redo log 刷新到磁盘的好处如下: redo log 占用的空间非常小存储表空间 ID、页号、偏移量以及需要更新的值所需的存储空间是很小的; redo log 是顺序写入磁盘的在执行事务的过程中,每执行一条语句,就可能产生若干条 redo log,这些日志是按照产生的顺序写入磁盘的,也就是使用顺序 IO; redo log 的写入过程 InnoDB 为了更好的进行系统崩溃恢复,把一次原子操作生成的 redo log 都放在了大小为 512 字节的块(block)中。 为了解决磁盘速度过慢的问题而引入了 Buffer Pool。同理,写入 redo log 时也不能直接写到磁盘上,实际上在服务器启动时就向操作系统申请了一大片称之为 redo log buffer 的连续内存空间,即:redo log 缓冲区,也可以简称:log buffer。这片内存空间被划分成若干个连续的 redo log block,可以通过启动参数innodb_log_buffer_size 来指定 log buffer 的大小,该启动参数的默认值为:16MB。 向 log buffer 中写入 redo log 的过程是顺序的,也就是先往前边的 block 中写,当该 block 的空闲空间用完之后再往下一个 block 中写。 redo log 刷盘时机 log buffer 什么时候会写入到磁盘呢? log buffer 空间不足时,如果不停的往这个有限大小的 log buffer 里塞入日志,很快它就会被填满。InnoDB 认为如果当前写入 log buffer 的 redo log 量已 经占满了 log buffer 总容量的大约一半左右,就需要把这些日志刷新到磁盘上。 事务提交时,必须要把修改这些页面对应的 redo log 刷新到磁盘。 后台有一个线程,大约每秒都会刷新一次 log buffer 中的 redo log 到磁盘。 正常关闭服务器时等等。 undo 日志 事务需要保证原子性,也就是事务中的操作要么全部完成,要么什么也不做。但是偏偏有时候事务执行到一半会出现一些情况,比如: 情况一:事务执行过程中可能遇到各种错误,比如服务器本身的错误,操作系统错误,甚至是突然断电导致的错误。 情况二:程序员可以在事务执行过程中手动输入 ROLLBACK 语句结束当前的事务的执行。 这两种情况都会导致事务执行到一半就结束,但是事务执行过程中可能已经修改了很多东西,为了保证事务的原子性,需要把东西改回原先的样子,这个过程就称之为回滚,即:rollback,这样就可以造成这个事务看起来什么都没做,所以符合原子性要求。 每当要对一条记录做改动时,都需要把回滚时所需的东西都给记下来。 比方说: 插入一条记录时,至少要把这条记录的主键值记下来,之后回滚的时候只需要把这个主键值对应的记录删掉。 删除了一条记录,至少要把这条记录中的内容都记下来,这样之后回滚时再把由这些内容组成的记录插入到表中。 修改了一条记录,至少要把修改这条记录前的旧值都记录下来,这样之后回滚时再把这条记录更新为旧值。 这些为了回滚而记录的这些东西称之为撤销日志,即:undo log。这里需要注意的一点是,由于查询操作并不会修改任何用户记录,所以在查询操作执行时,并不需要记录相应的 undo log。 undo 日志的格式 为了实现事务的原子性,InnoDB 存储引擎在实际进行增、删、改一条记录时,都需要先把对应的 undo 日志记下来。一般每对一条记录做一次改动,就对应着一条 undo 日志,但在某些更新记录的操作中,也可能会对应着 2 条 undo 日志。 一个事务在执行过程中可能新增、删除、更新若干条记录,也就是说需要记录很多条对应的 undo 日志,这些 undo 日志会被从 0 开始编号,也就是说根据生成的顺序分别被称为第 0 号 undo 日志、第 1 号 undo 日志、...、第 n 号 undo 日志等,这个编号也被称之为 undo no。 这些 undo 日志是被记录到类型为 FIL_PAGE_UNDO_LOG 的页面中。这些页面可以从系统表空间中分配,也可以从一种专门存放 undo 日志的表空间,也就是所谓的 undo tablespace 中分配。 作者:京东物流 张士欣 来源:京东云开发者社区 自圆其说Tech 转载请注明来源

优秀的个人博客,低调大师

每日一博 | ZGC 关键技术分析

一、引言 垃圾回收对于Javaer来说是一个绕不开的话题,工作中涉及到的调优工作也经常围绕垃圾回收器展开。面对不同的业务场景没有一个统一的垃圾回收器能保证可GC性能。因此对程序员来说不仅要会编写业务代码,同时也要卷一下JVM底层原理和调优知识。这种局面可能因为ZGC的出现而发生改变,新一代回收器ZGC几乎不需要调优的情况下GC停顿时间可以降低到亚秒级。 Oracle从JDK11开始正式引入ZGC,ZGC设计三大目标: 支持TB级内存 (8M~4TB) 。 停顿时间控制在10ms之内 (生产环境实际观测在微秒级) ,停顿不会随着堆的大小,或者活跃对象的大小而增加。 对程序吞吐量影响小于15%。 ZGC是如何设计怎么达到这个目标的呢?本文将从ZGC算法的关键特性入手,通过分析ZGC周期处理过程来理解这些特性,探索ZGC设计思想。 二、ZGC术语 非分代:将对内存划分为新生代和老年代 (G1已经逻辑分代) ,ZGC取消分代设计,每个GC周期都将标记整个堆中的所有活动对象。 页面: ZGC将堆空间分解成一块块区域,这些区域叫做页面,ZGC通过页面来回收内存。 并发性: GC和线程和业务线程同时运行 。 ZGC的高度并发设计,几乎所有GC工作、标记和堆碎片整理都是和业务线程 (mutators) 同时运行的,只包含了短暂的STW同步暂停。 并行: 多个线程进行GC线程同时工作,加快回收速度。 标记-复制算法: 标记-复制算法主要包括以下3个过程。 标记阶段,即从GC Roots集合开始,分析对象可达性,标记出活跃对象。 图1:可达性分析后对象的引用状态 对象转移阶段,即把活跃对象复制到新的内存地址上。 重定位阶段,因为转移导致对象的地址发生了变化,在重定位阶段,所有指向对象旧地址的指针都要调整到对象新的地址上。 标记-复制算法的最大优势就是防止堆内存碎片化的出现,复制的过程就可以对堆内存进行整理。ZGC、CMS和G1都是采用了标记-复制算法,但是不同的实现导致了很大的性能差异。 三、ZGC性能数据 ZGC设计致力于提供几毫秒的最大暂停时间,同时保证吞吐量不受影响。下面是SPECjbb2015针对OpenJDK中的不同收集器运行的性能测试数据。在128G堆内存下,无论是延迟还是吞吐量上面ZGC的性能表现都高于其他收集器。 图2:SPECjbb2015GC性能评分 图3: SPECjbb2015GC延迟比较 四、ZGC关键特性 ZGC的周期是高度并发的,并发性越高意味着GC工作时对业务线程的影响越小,SPECjbb2015的性能报告可以看出ZGC在延迟上比G1低10倍以上,ZGC的工作周期只有三个阶段是STW的,其他阶段完全并发。这得益于ZGC在堆视图并发一致性设计上的改进。我们都清楚在并发的场景下需要协调各个线程对共享资源达成一致性,常用的手段就是对资源加锁,而在垃圾回收器下的思路也是类似,如果GC线程工作是需要锁定对象资源进行处理,业务线程则需要全部暂停,这就产生了STW (Stop The Word) 。以往的垃圾回收器都是让GC线程和业务线程就堆中对象地址达成一致,对象在发生转移时业务线程是不能访问的 (因为对象的地址发生了变化) ,无论G1还是CMS对象在进行复制时都是需要STW。ZGC使用到的着色指针(Colored Pointer)和读屏障(Load Barrier)技术,可以让所有线程在并发的条件下就指针的颜色 (状态) 达成一致,而不是对象地址。因此,ZGC可以并发的复制对象,这大大的降低了GC的停顿时间。我们先对着色指针和读屏障有个初步的理解,然后在通过ZGC回收周期来看这2项技术的具体运用。 着色指针(Colored Pointer) 在指针中嵌入元数据(使用地址中的高阶位来实现),这种通过在指针存储元数据的技术就叫做着色指针 (Colored Pointer) 。ZGC中指针始终是64位结构,由元位(指针的颜色)和地址位组成。地址位数决定了理论上支持的最大堆大小,ZGC使用42位存储地址也就意味着ZGC最大支持4TB堆内存。如图所示,低42位是地址位,中间4位是元位,高18位未使用。四个元位是Finalized ( F )、Remapped ( R )、Marked1 ( M1 ) 和Marked0 ( M0)。 图4: 64位地址使用示意图 ZGC中将指定上的标记通过颜色来表示,颜色可以是“good” (地址有效) 或“bad” (地址可能无效) 。指针的颜色由其元位的状态决定:F、R、M1和M0。“good”是R、M1、M0元位中的一个被设置,另外三个未设置,比如0100、0010和 0001属于“good”颜色。通过在指针上的颜色就能区分出对象状态,不用额外做内存访问,这使得ZGC在标记和转移阶段会更快。 通过设置地址元位的状态,可以形成不同地址视图,ZGC同一物理堆内存被映射到虚拟地址空间三次,从而产生同一物理内存的三个“视图”,GC活动的不同时期会只存在一个活跃视图,根据垃圾回收的周期ZGC通过切换不同视图标来记出对象的颜色。 下图是虚拟地址的空间划分: 图5:虚拟地址空间划分和多视图映射 [0~4TB) 对应Java堆; [4TB ~ 8TB) 称为M0地址空间; [8TB ~ 12TB) 称为M1地址空间; [12TB ~ 16TB) 预留未使用; [16TB ~ 20TB) 称为Remapped空间。 ZGC是不分代的,这意味着垃圾回收是需要扫描整个堆空间,地址视图将整个Java堆分成多个部分,并为每个部分分配一个虚拟内存段。在垃圾回收时,ZGC只需要扫描其中一个虚拟内存段,并将其作为当前视图映射到实际的内存位置。同时,ZGC会将其他虚拟内存段映射到虚拟地址上,这些内存段不会被收集器扫描。 读屏障(Load Barrier) ZGC 通过利用读屏障而不是写入屏障,与HotSpot JVM中以前的GC (CMS,G1等) 算法显著不同。读屏障解决了并发转移时对象指针更新问题:在转移期间,如果移动对象而不用更新引用对象的传入指针(移动的对象可能被堆中的任何其他对象所引用),就会产生悬空指针 (已经被释放的内存空间或者无效的内存地址,访问悬空指针会出现问题) 。通过读屏障技术能够捕获此类悬空指针对象,并触发代码,更新对象的新位置,从而“修复”悬空指针。为了跟踪对象如何移动,以便在加载时固定悬空指针,ZGC中使用转发表 (forwarding tables ) 来将重定位前(旧)地址映射到重定位后(新)地址。无论是业务线程作为使用者访问对象,还是GC线程遍历堆中的所有活动对象(在标记期间)都有可能会触发读屏障。 ZGC读屏障如何实现呢?举个例子,代码var x = obj.field。x是一个位于堆栈上的局部变量,field是一个位于堆上的指针。业务线程在操作堆对象时触发读屏障。读屏障的执行路径有快 (fast path) 和慢 (slow path) 两种,如果正在加载的指针有效状态 (good color) ,则采用加载屏障的快速路径,否则,采用慢速路径。快速路径实际上是空的,而慢速路径包含计算有效状态指针的逻辑:检查对象是否已经(或即将)重新定位,如果是,则查找或生成新的地址。读屏障除了能让触发读屏障的线程读取到最新地址,同时还具有自我修复指针(self-healed)的功能,这意味着读屏障会修改指针的状态,以便后续其他线程访问时能执行快速路径。无论采用哪条路径,都会返回正确状态的地址。下面用伪代码表示ZGC在执行读屏障时的大体逻辑: /** slot 是值线程栈中的局部变量,也就是屏障要操作的目标对象 */ unintptr_t barrier(unintptr_t *slot,unintptr_t addr){ //快速路径,fast path if(is_good_or_null(addr))return addr; //慢速路径,slow path good_addr = process(addr); //自我修复 self_heal(slot,addr,good_addr); return good_addr; } /* 自我修复,将指针恢复到正常状态 */ void self_heal(unintptr_t *slot,unintptr_t old_addr,unintptr_t new_addr){ if(new_addr == 0)return; while(true){ if(CAS(slot,&old_addr,new_addr) return; if(is_good_or_null(old_addr)) return; } } ZGC的读屏障可能被GC线程和业务线程触发,并且只会在访问堆内对象时触发,访问的对象位于GC Roots时不会触发,这也是扫描GC Roots时需要STW的原因。 下面是一个简化的示例代码,展示了读屏障的触发时机。 Object o = obj.FieldA // 从堆中读取引用,需要加入屏障 <Load barrier> Object p = o // 无需加入屏障,因为不是从堆中读取引用 o.dosomething() // 无需加入屏障,因为不是从堆中读取引用 int i = obj.FieldB //无需加入屏障,因为不是对象引用 五、ZGC执行周期 如下图 所示,ZGC 周期由三个 STW 暂停和四个并发阶段组成:标记/重新映射( M/R )、并发引用处理( RP )、并发转移准备( EC ) 和并发转移( RE )。为了读者能快速理解,下面对ZGC执行过程进行了大量简化。 图6:ZGC周期表示 初始标记(STW1) ZGC 初始标记执行包含三个主要任务。 地址视图被设置成M0 (或M1) ,M0还是M1根据前一周期交替设置的。 重新分配新的页面给业务线程创建对象,ZGC只会处理当前周期之前分配的页面。 初始标记只会存活的根对象被标记为M0 (M1) ,并被加入标记栈进行并发标记。 GC周期中地址视图窗口 图7:ZGC周期中状态窗口划分 并发标记(M/R) 并发标记的任务有2个: 第一,并发标记线程从待标记的对象列表出发,根据对象引用关系图遍历对象的成员变量,递归进行标记。 第二,计算,并更新关联页面的活跃度信息。活动信息是页面上的活动字节数,用于选择将要回收的页面,这些对象将作为堆碎片整理的一部分进行重新定位。 下面伪代码是并发标记的主要过程: while(obj in mark_stack){ //标记存活对象,当且仅当该对象未被标记并且当前线程成功标记该对象时才返回true success = mark_obj(obj); if(success){ for(e in obj->ref_fields()){ MarkBarrier(slot_of_e,e); } } } //GC线程调用 //EC是待回收页面的集合 void MarkBarrier(uintptr_t *slot,unintptr_t addr){ if(is_null(addr))return; //判断是否在待回收集合内 if(is_pointing_into(addr,EC)){ //地址重映射到当前GC视图 good_addr = remap(addr); } else { good_addr = good_color(addr); } //访问的对象添加到标记栈 mark_stack->add(good_addr); self_heal(slot,addr,good_addr); } //读屏障前面有介绍过,由业务线程调用 void LoadBarrier(uintptr_t *slot,unintptr_t addr){ if(is_null(addr))return; if(is_pointing_into(addr,EC)){ good_addr = remap(addr); } else { good_addr = good_color(addr); } mark_stack->add(good_addr); self_heal(slot,addr,good_addr); return good_addr; } 代码片段显示了并发标记阶段的GC线程主循环。mark_obj()当且仅当该对象未被标记并且当前线程成功标记该对象时才返回 true。它在内部使用原子操作(compare and swap,CAS)来设置位图中的位,因此它是线程安全的。MarkBarrier()遍历该对象的成员属性,完成对象引用的标记。并发标记时业务线程也在运行,此前如果业务线程访问对象将执行LoadBarrier()协助GC线程完成对象标记。 再标记阶段(STW2) 再标记阶段的主要任务有3个: 执行修复任务,指线程运行C2编译的代码,在进入再标记阶段时可能发生漏标。 结束标记,并发标记后业务线程本地标记栈可能存在待标记的对象,执行本步骤的目的就是对这些待标记对象进行标记。 执行部分非强根并行标记。 并发转移准备(EC) 并发转移准备任务: 筛选所有可以被回收的页面 选择垃圾比较多的页面作为页面转移集 初始转移(STW3) 初始转移主要以下过程: 调整地址视图:将地址视图从M0或者M1调整为Remapped,说明进入真正的转移,此后所有分配的对象视图都是Remapped。 重定位TLAB:因为地址视图调整,所以要调整TLAB中地址的视图。 开始转移:从根集合出发,遍历根对象的直接引用的对象,对这些对象进行转移。 初始转移是STW的,其处理时间和GC Roots的数量成正比,一般情况耗时非常短。 并发转移(RE) 初始转移完成了GC Roots对象重定位,在并发转移阶段将对前面步骤确定的转移集 (EC) ,对转移集的每一页执行转移。 并发转移的过程可以抽象成如下伪代码过程: //GC线程主循环遍历EC的页面,将个将EC集页面中对象进行转移 for (page in EC){ for(obj in page){ relocate(obj); } } //该方法GC和业务线程都有可能执行,如果是业务线程访问对象会先进行转移在进行操作 unintptr_t relocate(unintptr_t obj) { //获取对象的地址转发表 ft = forwarding_tables_get(obj); if (ft->exist(obj)){ return ft->get(obj); } new_obj = copy(obj); //CAS写对象转发表数据 if(ft->insert(obj,new_obj)){ return new_obj; } //CAS发生竞争,写转发表失败,释放分配的内存 dealloc(new_obj) return ft->get(obj); } 转发表的作用是存储对转移后旧地址到新地址的映射,转发表的数据存储在页面中,转移完成的页面即可被回收掉。 并发转移完成之后整个ZGC周期完成。 六、ZGC算法演示 为了说明ZGC算法,下图演示了示例中的所有阶段。 图8:ZGC算法演示 图8(1)显示了堆的初始状态,应用启动后ZGC完成了初始化。 在图8(2)中,选择M0作为全局标记,并且所有根指针都被标记成M0。然后,所有根都被推送到标记堆栈,该标记堆栈在并发标记 (M/R) 期间由GC线程消耗。 如图8(3)所示,图中用合适的颜色绘制对象本身,以表明它们已被标记,即使指针有状态。 在图8(4) 中,选择存活对象最少的页面(中间的页面)作为转移候选集 (EC) 。 随后,在图8(5)中,全局标记被设置为Remmaped,并且所有根指针都已更新Remmaped。如果根指向EC,则相应的对象将被重新定位,并且根指针更新为新地址。 在图8(6)中,EC中的对象被转移,并且地址记录被逐出页面中转发表上,用于新旧地址转换。当并发转移阶段结束时,当前GC周期也会结束。当前周期内整个EC都会被回收。这里可能有个疑问,对象的旧地址还没有更新,页面如果被回收了如何还能访问对象呢?原因是回收的是页面中对象存储空间,转发表不会被回收,如果此时业务线程访问这些对象,会触发读屏障的慢路径位,失效指针会被修复。对于没有访问到的失效指针,直到下一个GC并发标记 (M/R) 阶段才会被修复。 在图8(7)中,下一个GC循环开始,M1被选择为全局状态(M0 和 M1 之间交替使用)。 在图8(8)中,并发标记阶段 (M/R) 通过查询转发表失效的指标被映射到新位置。 最后,在图8(9)中,上一周期EC页面的转发表被回收,为即将到来的并发转移 (RE) 阶段做准备。 七、总结 ZGC是一个十分复杂的JVM子系统,没办法通过一篇文章把所有的细节描述清楚。本文详细探讨了ZGC的着色指针和读屏障关键技术,他们也是ZGC中创新点,最后通过一个示例对ZGC算法过程做了一个简化版的演示。通过对ZGC这种复杂系统的学习,让我也体会到分析复杂系统时没必要一开始就过多的纠结实现细节,可以先从关键流程入手再层层深入。 ZGC的高并发设计造就了它的高性能,背后要归功于着色指针和读屏障运用,当然除了这2项还有其他精妙的设计比如:内存模型,并发模型,预测算法等这里不展开,读者可以参考其他文章。了解ZGC的基本原理可以帮助优化应用程序的性能,为应用调优做些知识储备。最后,ZGC有卓越的性能和稳定性表现,我们在选择GC选型时可以优先考虑使用ZGC。 参考内容: [1]彭成寒:《新一代垃圾回收器ZGC设计与实现》.机械工业出版社, 2019. [2]https://tech.meituan.com/2020/08/06/new-zgc-practice-in-meituan.html [3]https://www.baeldung.com/jvm-zgc-garbage-collector [4]https://openjdk.org/projects/zgc/ [5]https://www.jfokus.se/jfokus18/preso/ZGC--Low-Latency-GC-for-OpenJDK.pdf *文 / byteyangyang 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | 再玩玩 B 端搭建

一、背景 在 B 端领域深耕多年,接触了成百上千的 B 端页面,发现对于 B 端产品需求和 C 端有着明显的差异,B端产品一般是基于现有的“业务”形态,将传统线下工作,通过程序化、系统化、信息化转换为线上产品,从而提升企业协同效率,降低办公成本。需求一般来源于产品战略定位、使用者个性需求等。 其中 B 端各种各样的功能,其实就是很多 CURD 页面的堆砌,对于 B 端这些页面其实调性是差不多的,使用低频,页面重复度高,表格表单为主,功能性多且杂。 每个公司都会结合自己实际的业务抽象出一套搭建系统来解决 B 端场景的 CRUD 重复页面的方案,核心就在于标准和规则的制定,对于 B 端搭建早就不是什么新鲜玩意,B 端搭建平台的难点本身不在于有多少技术壁垒,更多的是在于从产品到研发再到测试整个流程的标准化,以及和业务的紧紧贴合,只有这样才能发挥搭建平台的价值。 二、标准 为什么说核心是标准,引用一个之前看到的通俗易懂的例子,我们小时候逢年过节穿的衣服,都是去裁缝店选一下材料、量一下尺寸,等个半个来月,讨回来就可以穿了,衣服合身又喜欢。镜头切回今天,我们只需要在天猫、淘宝上看看图片、选择合适的尺寸就可以下单了,第二天就可以穿上,偶尔一丝不合身,偶尔大街上撞衫,但我们并不在意,因为我们享受到了更多的便利与高效,受益于这个产业制定了很多的标准化模型,比如身材模型:S、M、L、XL、XXL,我们不再需要每次都去量身高尺寸,现在标准化生产出来的衣服可以满足超过 90% 的需求,除明星或特殊场景之外也不会费心思去量身定制。 服装、饮食、汽车乃至各行各业发展至今都已经形成非常成熟、高效的产业链,软件研发行业同样如此,业务需求在增长且变化快,越是技术密集型的工种越容易带来人力不足的瓶颈,这就越需要更多的标准和模型的制定,标准越趋于统一,就越高效,有时候 “放弃创造力才是最大的创造力”,可以预见,未来绝大多数场景将使用标准化模板通过无定制或低定制来完成业务需求。 三、定位 B 端搭建平台,设计方案上主要首先要想明白这几个问题: pro-code,low-code,还是 no-code? 用户群体是谁?产品?运营?开发? 什么样的页面适合用B端搭建平台?需要制定什么样的标准? 我们的业务特点是什么?怎么样的搭建方案最贴切我们的业务? 针对目前B 端的业务,更加倾向于少量代码编写的 low-code,主要综合以下几点考虑: 成本和效率因素:使用 low-code 可以实现快速搭建应用程序的目标,而无需具备高深的编程技能。low-code 搭建平台提供了丰富的预定义组件和集成工具,可以减少开发时间和成本,提高开发效率。 简化开发过程:采用 low-code 搭建平台,用户只需要通过简单的拖放操作和配置即可实现应用程序的设计和开发。low-code 搭建平台提供了一个可视化的开发环境,使得开发者可以更加专注于业务逻辑的实现。 提供更高的可定制性:使用 low-code 搭建平台,用户可以根据自己的需求,快速构建自定义的组件和应用程序,而无需编写大量的代码。用户可以选择在模板中制作自己喜欢的界面和布局,并自定义相关的数据驱动器和互动部件。 降低维护负担:使用 low-code 搭建平台开发的应用程序通常会降低维护和更新的负担。平台通常支持升级和维护的自动化机制,同时在应用程序中,许多功能也由后台机制自动化完成,简化了开发者的工作。 因为有一定的编写代码成本,所以使用用户群体就是开发,对于比较偏配置的页面,适合用B端搭建平台。 四、详细设计 弄清楚了定位,结合目前后台当前业务域的业务特点,主打配置+规则的搭建平台乐高应运而生,下面是乐高平台的主要设计和结构,主要为了解决规则配置类的 CURD 页面。 业务流程 完整流程 整体架构 分层设计 整体采用前后端分离的架构设计,分为视图层、模板层、引擎层。 视图层‍ 视图层具备完善的开发和生产流程:基于国际JSON Schema标准,开发出独立的组件 -> 组件经过不同形式的排列组合,形成最终的产品界面。 页面抽象定义如下: 视图层如下图所示,主要分为三个部分: 组件池:组件池是页面的骨架部分,由内置和自定义的各个组件组装而成。可以通过拖动组件进行排列组合,即时的在预览区域展示出效果。 画布:画布占据了页面的中间部分。画布由各个组件拼接而成。可以通过预览能看到完整的页面,也可以通过查看按钮预览生成的JSON Schema脚本。 属性模块:每个组件,都有可配置的属性,选中组件可以对其属性进行配置。如,配置按钮组件的名称、字段名、是否必填等,都取决于组件开发者对该组件的预留项。 模板层 统一收敛所有功能入口,对底层数据存储和接口协议进行升级,提供统一的接口协议、鉴权、审批、灰度、回滚等功能。 模板层主要包含三个部分: Json Schema管理:提供通用的schema接口协议,包含schema数据管理,各组件数据源统一查询接口,一键还原schema数据等功能。 模板数据管理:包含模板数据落地,模板数据校验、解析、搜索,以及模板数据与schema脚本的映射关系。 规则引擎适配:对模板数据进行分组,解析schema脚本和模板数据得到规则因子,根据配置的规则 + 因子项组装规则表达式,将实际业务逻辑翻译成规则引擎能够识别的表达式。 引擎层 规则引擎实现了将业务决策从应用程序代码中分离出来,并使用预定义的语义模块编写业务决策。通过入参和规则表达式计算结果。 规则引擎主要包含四个部分: 规则组:对同类规则进行分组,规则组内的规则可以互斥,也可以存在优先级。 规则因子:对应规则表达式中的已知条件。 规则:因子 + 表达式组成,代表一条判定逻辑。 结果:规则引擎输出的场景处理方案。 规则引擎执行流程: 逻辑编排 以某个案例作为一个通用的业务场景,看看如何落地到业务当中,业务流程大致如下: 关键用例: 然后 B 端页面进行逻辑编排,最后通过规则引擎计算出结果,规则因子和结果会根据业务提前定义好。 C 端进行消费 存储设计 五、思考 低代码平台一直被业界调侃为“行业毒瘤”,相反,它是一种非常有前途的技术趋势。低代码搭建平台可以帮助企业降低开发成本、缩短开发周期、增加灵活性,降本增效。 但是,有人认为低代码平台有着一些潜在的问题,这也是“低代码平台是行业毒瘤”这一说法背后的原因: 可定制性差:低代码平台提供的模块化组件和界面模板可定制性有限,有可能不能满足某些用户的特殊需求,这使得它在某些场景下的协作和管理有一定的限制。 依赖平台技术构架:许多低代码平台采用特有的技术架构和编程方式,容易给开发者学习和成长带来困难,也会导致平台的依赖性增加。 风险管理不完善:低代码平台对于数据安全等问题的风险管理还存在一些缺陷。在使用低代码平台开发的应用程序可能无法满足某些重要的数据管理要求,例如安全性、隐私保护等因素。 存在即合理,低代码平台本身并非行业毒瘤,只是一个优势和劣势都非常明显的技术,切不可因噎废食,一棍子打死所有,但如果没有充分考量和处理相关的问题,使用低代码平台开发的应用程序可能会带来一些风险和限制。因此,在选择平台时应根据实际需求,权衡各种因素,谨慎抉择。 低代码要利用,但是一定要“谨慎”,适合自己业务才是最好的。 *文/jawil 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | Redis 流量镜像的实现

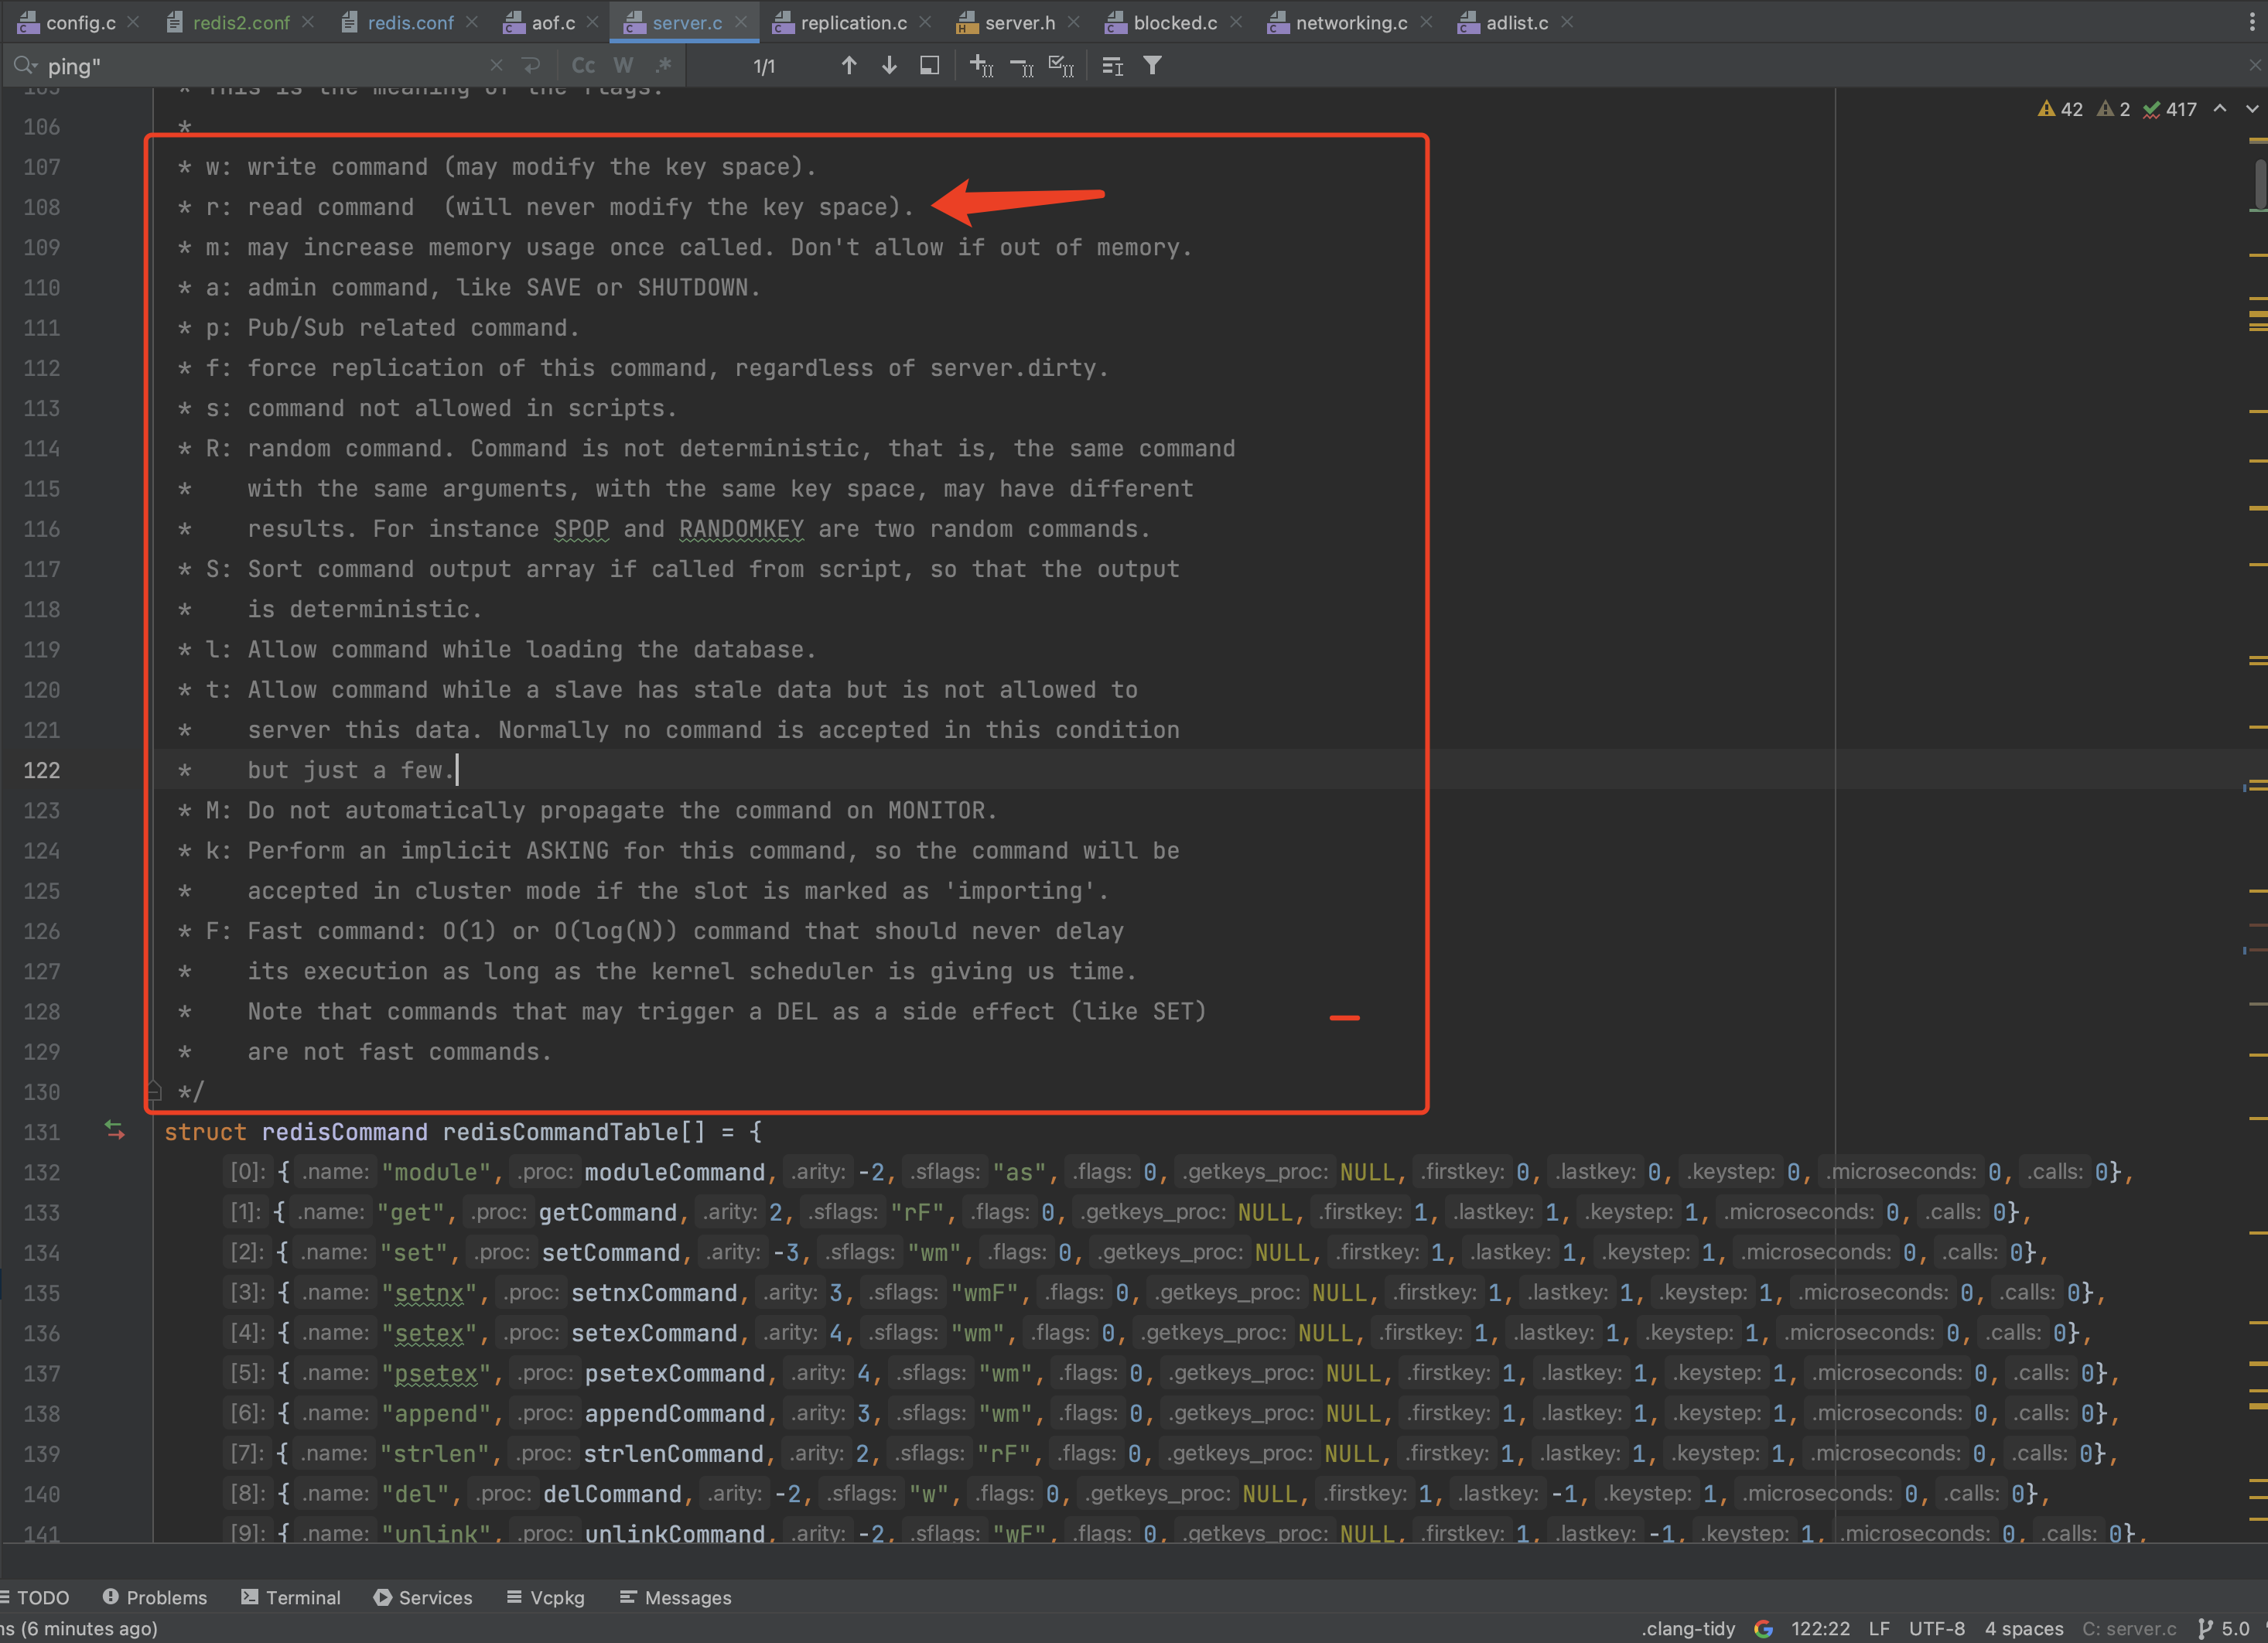
背景 对 Redis 场景降本增效,涉及到将部分 Redis 实例迁移到类似社区 pika 这种支持 Redis 协议的基于 SSD 磁盘存储的项目(阿里云 Tair),降低存储成本。迁移过程需要进行性能验证,除了基本的选型压测之外,还必须对每个业务场景做全指令的性能覆盖,才能确保业务迁移的性能以及指令兼容稳定性。常规的做法是需要业务开发配合在工程里进行流量双发,或者小范围流量灰度。 以上这个问题,不管哪种方式都需要投入更多的人力和时间,对降本增效本身这件事情来说,大大降低了 roi 。如果能够做到直接将原 Redis 的所有读流量重放到目标 Redis SSD 的实例,则迁移整件事件 SRE 可以完成 99% ,而且将大大缩短迁移实例的时间,所以 Redis 流量镜像这个需求就应运而生了。 tips:我们的数据迁移方案采用阿里云的 DTS ,DTS 是基于 Redis 主从复制的原理实现的,所以写流量性能在数据同步过程就可以直接验证了 调研 Google 上、Github 上逛了一圈,没有十分契合的东西,所以最后决定自研。查到的一些相关信息如下: 阿里云的 SLS Redis 审计日志 阿里云的 Redis 实例支持将 Redis 的执行日志丢到 SLS(一个日志记录查询的产品) 记录,但是只有写流量的记录,达不到 Redis 读流量回放的需求。 pika redis-copy 工具:https://github.com/OpenAtomFoundation/pika/issues/2044 这个工具已经被 pika 项目丢弃了。目前只有文档,仓库里已经没有相关的代码了。不过本文实现也是基于和 pika 的实现原理一样的 istio 实现 Redis 流量镜像:https://github.com/cloudnativeto/cloudnativeto.github.io/issues/76 基于 istio 做 Redis 的镜像流量,必须接入 istio 才行,局限性太大了,而且引入一个新的 istio 组件需要做很多的稳定性测试,所以这个路线就直接否了 实现 直接接入正题,采用 Redis 的 monitor 指令来实现这个需求。 /** * @author kl (http://kailing.pub) * @since 2023/9/27 */ public class RedisMonitorTest { static final JedisPool targetRedisPool = new JedisPool("127.0.0.1", 6398); static final JedisPool sourceRedisPool = new JedisPool("127.0.0.1", 6379); static final Set<String> redisReadCommands = new HashSet<>(Arrays.asList( "get", "strlen", "exists", "getbit", "getrange", "substr", "mget", "llen", "lindex", "lrange", "sismember", "scard", "srandmember", "sinter", "sunion", "sdiff", "smembers", "sscan", "zrange", "zrangebyscore", "zrevrangebyscore", "zrangebylex", "zrevrangebylex", "zcount", "zlexcount", "zrevrange", "zcard", "zscore", "zrank", "zrevrank", "zscan", "hget", "hmget", "hlen", "hstrlen", "hkeys", "hvals", "hgetall", "hexists", "hscan", "randomkey", "keys", "scan", "dbsize", "type", "sync", "psync", "ttl", "touch", "pttl", "dump", "object", "memory", "bitcount", "bitpos", "georadius_ro", "georadiusbymember_ro", "geohash", "geopos", "geodist", "pfcount", "xrange", "xrevrange", "xlen", "xread", "xpending", "xinfo", "lolwut" )); public static void main(String[] args) { try (Jedis jedis = sourceRedisPool.getResource()) { jedis.monitor(new JedisMonitor() { @Override public void onCommand(String command) { sendCommand(command); } }); } } public static void sendCommand(String commandStr) { String[] parts = commandStr.split("\""); if (parts.length < 2) { return; } String cmd = parts[1]; List<String> args = new ArrayList<>(); for (int i = 3; i < parts.length; i += 2) { args.add(parts[i]); } if (redisReadCommands.contains(cmd.toLowerCase())) { ProtocolCommand command = () -> cmd.getBytes(StandardCharsets.UTF_8); try (Jedis jedis = targetRedisPool.getResource()) { try { long startTime = System.currentTimeMillis(); jedis.sendCommand(command, args.toArray(new String[0])); System.out.println(cmd + ":" + (System.currentTimeMillis() - startTime)); } catch (Exception e) { System.err.println(cmd + e.getMessage()); } } } } } 以上是一段可以直接执行的伪代码,将sourceRedis 的所有读流量转发到targetRedis 执行 实现解析 上面采用的 Java 的 Redis 客户端 jedis 来开发,首先调用了 monitor 这个指令,这个指令是一个阻塞指令,会一直订阅 Redis 服务端的指令执行记录,记录的格式如下: 1695869359.747056 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869359805247076" "LIMIT" "0" "1" 1695869359.748040 [0 127.0.0.1:64257] "EXISTS" "asynq:{sys}:paused" 1695869359.748259 [0 127.0.0.1:64257] "EXISTS" "asynq:{sync}:paused" 1695869359.748578 [0 127.0.0.1:64257] "EXISTS" "asynq:{default}:paused" 1695869359.748916 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869359869190783" "LIMIT" "0" "1" 1695869359.749154 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869359877625076" "LIMIT" "0" "1" 1695869359.749348 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869359878760313" "LIMIT" "0" "1" 1695869359.749530 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869359882064571" "LIMIT" "0" "1" 1695869359.779048 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869360024586886" "LIMIT" "0" "1" 1695869359.785898 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869360031603858" "LIMIT" "0" "1" 1695869359.786092 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869360031656719" "LIMIT" "0" "1" 1695869359.786923 [0 127.0.0.1:64257] "ZRANGEBYSCORE" "delayed_tasks" "0" "1695869360031666910" "LIMIT" "0" "1" 所以我们只要解析出指令,然后发送到目标实例就好了 这里还涉及到一个问题,怎么过滤出只有读指令的记录? 我尝试过问 chatGPT ,但是他一点都不靠谱,不是少了读的指令,就是用其他写指令凑数。所以不可信。好在 Redis 服务端对每个指令都进行了打标,区分了读指令还是写指令。 所以只需要把所有的只读指令打印到控制台复制出来就解决这个问题了。 注意事项 Redis monitor 指令是一个对 Redis 性能有损的指令,官方测试会对单实例 Redis 降低 50% 左右的性能,我实际测试在 Redis 实际负载不高的情况下,这个影响可以忽略不计(特别高 QPS 的实例谨慎使用)。因为 Redis 单机 QPS 能支撑 10W 。比如线上实时 QPS 1W ,使用 monitor 的时候,QPS 和 RT 几乎没有变化。 另外需要注意,monitor 长时间运行会增加 Redis 的内存消耗,所以如果做性能验证,最好控制下时间,不要一直跑。 monitor 文档:https://redis.io/commands/monitor/ 结语 在本篇博客中,我们探讨了 Redis 流量镜像的实现方法和其在降本增效方面的重要性。我们了解到,传统的验证方式在迁移 Redis 实例时需要大量的人力和时间投入,降低了降本增效的 ROI。为了解决这一问题,引入了 Redis 流量镜像的需求。 通过将原 Redis 的所有读流量直接重放到目标 Redis SSD 实例,我们可以高效地完成迁移实例的过程,减少了 SRE 的工作量,并显著缩短了迁移时间。这种方法不仅提高了迁移过程的效率,还降低了成本和风险,使得降本增效的目标更加可行和实现。通过采用这种方法,我们可以更高效地迁移 Redis 实例,并在降低成本、提高效率的同时保持业务的性能和稳定性。 谢谢您的阅读!如果您有任何问题或想法,请随时参与评论留言。

优秀的个人博客,低调大师

每日一博 | 代码层面探索前端性能

前言 最近在做性能优化,具体优化手段,网上铺天盖地,这里就不重复了。 性能优化可分为以下几个维度:代码层面、构建层面、网络层面。 本文主要是从代码层面探索前端性能,主要分为以下 4 个小节。 使用 CSS 替代 JS 深度剖析 JS 前端算法 计算机底层 使用 CSS 替代 JS 这里主要从动画和 CSS 组件两个方面介绍。 CSS 动画 CSS2 出来之前,哪怕要实现一个很简单的动画,都要通过 JS 实现。比如下面红色方块的水平移动: 对应 JS 代码: let redBox = document.getElementById('redBox') let l = 10 setInterval(() => { l+=3 redBox.style.left = `${l}px` }, 50) 1998 年的 CSS2 规范,定义了一些动画属性,但由于受当时浏览器技术限制,这些特性并没有得到广泛的支持和应用。 直到 CSS3 的推出,CSS 动画得到了更全面地支持。同时,CSS3 还引入了更多的动画效果,使得 CSS 动画在今天的 Web 开发中得到了广泛的应用。 那么 CSS3 都能实现什么动画,举几个例子: 过渡(Transition)- 过渡是 CSS3 中常用的动画效果之一,通过对一个元素的某些属性进行变换,使元素在一段时间内从一个状态平滑地过渡到另一个状态。 动画(Animation)- 动画是 CSS3 中另一个常用的动画效果,其用于为一个元素添加一些复杂的动画效果,可以通过关键帧(@keyframes)来定义一串动画序列。 变换(Transform)- 变换是 CSS3 中用于实现 2D/3D 图形变换效果的一种技术,包括旋转、缩放、移动、斜切等效果。 把上面的例子改写成 CSS 代码如下: #redBox { animation: mymove 5s infinite; } @keyframes mymove { from {left: 0;} to {left: 200px;} } 同样的效果,用样式就能实现,何乐而不为呢。 需要指出的是,CSS 的动画仍在不断发展和改进,随着新的浏览器特性和 CSS 版本的出现,CSS 动画的特性也在不断地增加和优化,以满足日益复杂的动画需求和更好的用户体验。 CSS 组件 在一些知名的组件库中,有些组件的大部分 props 是通过修改 CSS 样式实现的,比如 Vant 的Space组件。 Props 功能 CSS 样式 direction 间距方向 flex-direction: column; align 对齐方式 align-items: xxx; fill 是否让 Space 变为一个块级元素,填充整个父元素 display: flex; wrap 是否自动换行 flex-wrap: wrap; 再比如 Ant Design 的Space组件。 Props 功能 CSS 样式 align 对齐方式 align-items: xxx; direction 间距方向 flex-direction: column; size 间距大小 gap: xxx; wrap 是否自动换行 flex-wrap: wrap; 这类组件完全可以封装成 SCSS 的 mixin 实现(LESS 也一样),既能减少项目的构建体积(两个库的 Space 组件 gzip 后的大小分别为 5.4k 和 22.9k),又能提高性能。 查看组件库某个组件的体积,可访问连接。 比如下面的 space mixin: /* * 间距 * size: 间距大小,默认是 8px * align: 对齐方式,默认是 center,可选 start、end、baseline、center * direction: 间距方向,默认是 horizontal,可选 horizontal、vertical * wrap: 是否自动换行,仅在 horizontal 时有效,默认是 false */ @mixin space($size: 8px, $direction: horizontal, $align: center, $wrap: false) { display: inline-flex; gap: $size; @if ($direction == 'vertical') { flex-direction: column; } @if ($align == 'center') { align-items: center; } @if ($align == 'start') { align-items: flex-start; } @if ($align == 'end') { align-items: flex-end; } @if ($align == 'baseline') { align-items: baseline; } @if ($wrap == true) { @if $direction == 'horizontal' { flex-wrap: wrap; } } } 类似的组件还有 Grid、Layout 等。 再说下图标,下面是 Ant Design 图标组件的第一屏截图,有很多仅用 HTML + CSS 就可以轻松实现。 实现思路: 优先考虑只使用样式实现 仅靠样式满足不了,就先增加一个标签,通过这个标签和它的两个伪元素 ::before 和 ::after 实现 一个标签实在不够,再考虑增加额外的标签 比如实现一个支持四个方向的实心三角形,仅用几行样式就可以实现(上面截图是 4 个图标): /* 三角形 */ @mixin triangle($borderWidth: 10, $shapeColor: #666, $direction: up) { width: 0; height: 0; border: if(type-of($borderWidth) == 'number', #{$borderWidth} + 'px', #{$borderWidth}) solid transparent; $doubleBorderWidth: 2 * $borderWidth; $borderStyle: if(type-of($doubleBorderWidth) == 'number', #{$doubleBorderWidth} + 'px', #{$doubleBorderWidth}) solid #{$shapeColor}; @if($direction == 'up') { border-bottom: $borderStyle; } @if($direction == 'down') { border-top: $borderStyle; } @if($direction == 'left') { border-right: $borderStyle; } @if($direction == 'right') { border-left: $borderStyle; } } 总之,能用 CSS 实现的就不用 JS,不仅性能好,而且还跨技术栈,甚至跨端。 深度剖析 JS 介绍完了 CSS,再来看 JS,主要从基本语句和框架源码两个方面深入。 if-else 语句的优化 先了解下 CPU 是如何执行条件语句的。参考如下代码: const a = 2 const b = 10 let c if (a > 3) { c = a + b } else { c = 2 * a } CPU 执行流程如下: 我们看到,在执行到指令 0102 时候,由于不满足 a > 3 这个条件,就直接跳转到 0104 这个指令去执行了;而且,计算机很聪明,如果它在编译期间发现 a 永远不可能大于 3,它就会直接删除 0103 这条指令,然后,0104 这条指令就变成了下一条指令,直接顺序执行,也就是编译器的优化。 那么回到正题,假如有以下代码: function check(age, sex) { let msg = '' if (age > 18) { if (sex === 1) { msg = '符合条件' } else { msg = ' 不符合条件' } } else { msg = '不符合条件' } } 逻辑很简单,就是筛选出 age > 18 并且 sex == 1 的人,代码一点儿问题都没有,但是太啰嗦,站在 CPU 的角度来看,需要执行两次跳转操作,当 age > 18 时,就进入内层的 if-else 继续判断,也就意味着再次跳转。 其实我们可以直接优化下这个逻辑(通常我们也是这样做的,但是可能知其然而不知其所以然): function check(age, sex){ if (age > 18 && sex ==1) return '符合条件' return '不符合条件' } 所以,逻辑能提前结束就提前结束,减少 CPU 的跳转。 Switch 语句的优化 其实 switch 语句和 if-else 语句的区别不大,只不过写法不同而已,但是,switch 语句有个特殊的优化,那就是数组。 参考以下代码: function getPrice(level) { if (level > 10) return 100 if (level > 9) return 80 if (level > 6) return 50 if (level > 1) return 20 return 10 } 我们改成 switch 语句: function getPrice(level) { switch(level) case 10: return 100 case 9: return 80 case 8: case 7: case 6: return 50 case 5: case 4: case 3: case 2: case 1: return 20 default: return 10 } 看着没啥区别,其实编译器会把它优化成一个数组,其中数组的下标为 0 到 10,不同下标对应的价格就是 return 的数值,也就是: 而我们又知道,数组是支持随机访问的,速度极快,所以,编译器对 switch 的这个优化就会大大提升程序的运行效率,这可比一条一条执行命令快多了。 那么,我还写个毛的 if-else 语句啊,我直接全部写 switch 不就行了? 不行!因为编译器对 switch 的优化是有条件的,它要求你的 code 必须是紧凑的,也就是连续的。 这是为什么呢?因为我要用数组来优化你啊,你如果不是紧凑的,比如你的 code 是 1、50、51、101、110,我就要创建一个长度 110 的数组来存放你,只有这几个位置有用,岂不是浪费空间! 所以,我们在使用 switch 的时候,尽量保证_code 是紧凑的数字类型_的。 循环语句的优化 其实循环语句跟条件语句类似,只不过写法不同而已,循环语句的优化点是以减少指令为主。 我们先来看一个中二的写法: function findUserByName(users) { let user = null for (let i = 0; i < users.length; i++) { if (users[i].name === '张三') { user = users[i] } } return user } 如果数组长度是 10086,第一个人就叫张三,那后面 10085 次遍历不就白做了,真拿 CPU 不当人啊。 你直接这样写不就行了: function findUserByName(users) { for (let i = 0; i < users.length; i++) { if (users[i].name === '章三') return users[i] } } 这样写效率高,可读性强,也符合我们上述的_逻辑能提前结束就提前结束_这个观点。CPU 直接感谢你全家。 其实,这里还有一点可以优化的地方,就是我们的数组长度可以提取出来,不必每次都访问,也就是这样: function findUserByName(users) { let length = users.length for (let i = 0; i < length; i++) { if (users[i].name === '章三') return users[i] } } 这看起来好像有点吹毛求疵了,确实是,但是如果考虑到性能的话,还是有点用的。比如有的集合的 size() 函数,不是简单的属性访问,而是每次都需要计算一次,这种场景就是一次很大的优化了,因为省了很多次函数调用的过程,也就是省了很多个 call 和 return 指令,这无异是提高了代码的效率的。尤其是在循环语句这种容易量变引起质变的情况下,差距就是从这个细节拉开的。 函数调用过程参考: 对应代码如下: let a = 10 let b = 11 function sum (a, b) { return a + b } 说完了几个基础语句,再来看下我们经常使用的框架内部,很多地方的性能都值得探索。 diff 算法 Vue 和 React 中都使用了虚拟 DOM,当执行更新时,要对比新旧虚拟 DOM。如果没有任何优化,直接严格 diff 两颗树,时间复杂度是 O(n^3),根本不可用。所以 Vue 和 React 必须使用 diff 算法优化虚拟 DOM: Vue2 - 双端比较: 类似上面的图: 定义 4 个变量,分别为:oldStartIdx、oldEndIdx、newStartIdx 和 newEndIdx 判断 oldStartIdx 和 newStartIdx 是否相等 判断 oldEndIdx 和 newEndIdx 是否相等 判断 oldStartIdx 和 newEndIdx 是否相等 判断 oldEndIdx 和 newStartIdx 是否相等 同时 oldStartIdx 和 newStartIdx 向右移动;oldEndIdx 和 newEndIdx 向左移动 Vue3 - 最长递增子序列: 整个过程是基于 Vue2 的双端比较再次进行优化。比如上面这个截图: 先进行双端比较,发现前面两个节点(A 和 B)和最后一个节点(G)是一样的,不需要移动 找到最长递增子序列 C、D、E(新旧 children 都包含的,最长的顺序没有发生变化的一组节点) 把子序列当成一个整体,内部不用进行任何操作,只需要把 F 移动到它的前面,H 插入到它的后面即可 React - 仅右移: 上面截图的比较过程如下: 遍历 Old 存下对应下标 Map 遍历 New,b 的下标从 1 变成了 0,不动(是左移不是右移) c 的下标从 2 变成了 1,不动(也是左移不是右移) a 的下标从 0 变成了 2,向右移动,b、c 下标都减 1 d 和 e 位置没变,不需要移动 总之,不管用什么算法,它们的原则都是: 只比较同一层级,不跨级比较 Tag 不同则删掉重建(不再去比较内部的细节) 子节点通过 key 区分(key 的重要性) 最后也都成功把时间复杂度降低到了 O(n),才可以被我们实际项目使用。 setState 真的是异步吗 很多人都认为 setState 是异步的,但是请看下面的例子: clickHandler = () => { console.log('--- start ---') Promise.resolve().then(() => console.log('promise then')) this.setState({val: 1}, () => {console.log('state...', this.state.val)}) console.log('--- end ---') } render() { return <div onClick={this.clickHandler}>setState</div> } 实际打印结果: 如果是异步的话,state 的打印应该在微任务 Promise 后执行。 为了解释清这个原因,必须先了解 JSX 里的事件机制。 JSX 里的事件,比如 onClick={() => {}},其实叫合成事件,区别于我们常说的自定义事件: // 自定义事件 document.getElementById('app').addEventListener('click', () => {}) 合成事件都是绑定在 root 根节点上,有前置和后置操作,拿上面的例子举例: function fn() { // fn 是合成事件函数,内部事件同步执行 // 前置 clickHandler() // 后置,执行 setState 的 callback } 可以想象有函数 fn,里面的事件都是同步执行的,包括 setState。fn 执行完,才开始执行异步事件,即 Promise.then,符合打印的结果。 那么 React 为什么要这么做呢? 因为要考虑性能,如果要多次修改 state,React 会先合并这些修改,合并完只进行一次 DOM 渲染,避免每次修改完都渲染 DOM。 所以 setState_本质是同步_,日常说的“异步”是不严谨的。 前端算法 讲完了我们的日常开发,再来说说算法在前端中的应用。 友情提示:算法一般都是针对大数据量而言,区别于日常开发。 能用值类型就不用引用类型 先来看一道题。 求 1-10000 之间的所有对称数,例如:0, 1, 2, 11, 22, 101, 232, 1221... 思路 1 - 使用数组反转、比较:数字转换为字符串,再转换为数组;数组 reverse,再 join 为字符串;前后字符串进行对比。 function findPalindromeNumbers1(max) { const res = [] if (max <= 0) return res for (let i = 1; i <= max; i++) { // 转换为字符串,转换为数组,再反转,比较 const s = i.toString() if (s === s.split('').reverse().join('')) { res.push(i) } } return res } 思路 2 - 字符串头尾比较:数字转换为字符串;字符串头尾字符比较。 function findPalindromeNumbers2(max) { const res = [] if (max <= 0) return res for (let i = 1; i <= max; i++) { const s = i.toString() const length = s.length // 字符串头尾比较 let flag = true let startIndex = 0 // 字符串开始 let endIndex = length - 1 // 字符串结束 while (startIndex < endIndex) { if (s[startIndex] !== s[endIndex]) { flag = false break } else { // 继续比较 startIndex++ endIndex-- } } if (flag) res.push(res) } return res } 思路 3 - 生成翻转数:使用 % 和 Math.floor 生成翻转数;前后数字进行对比(全程操作数字,没有字符串类型)。 function findPalindromeNumbers3(max) { const res = [] if (max <= 0) return res for (let i = 1; i <= max; i++) { let n = i let rev = 0 // 存储翻转数 // 生成翻转数 while (n > 0) { rev = rev * 10 + n % 10 n = Math.floor(n / 10) } if (i === rev) res.push(i) } return res } 性能分析:越来越快 思路 1- 看似是 O(n),但数组转换、操作都需要时间,所以慢 思路 2 VS 思路3 - 操作数字更快(电脑原型就是计算器) 总之,尽量不要转换数据结构,尤其数组这种有序结构,尽量不要用内置 API,如 reverse,不好识别复杂度,数字操作最快,其次是字符串。 尽量用“低级”代码 还是直接上一道题。 输入一个字符串,切换其中字母的大小写 如,输入字符串 12aBc34,输出字符串 12AbC34 思路 1 - 使用正则表达式。 function switchLetterCase(s) { let res = '' const length = s.length if (length === 0) return res const reg1 = /[a-z] const reg2 = /[A-Z] for (let i = 0; i < length; i++) { const c = s[i] if (reg1.test(c)) { res += c.toUpperCase() } else if (reg2.test(c)) { res += c.toLowerCase() } else { res += c } } return res } 思路 2 - 通过 ASCII 码判断。 function switchLetterCase2(s) { let res = '' const length = s.length if (length === 0) return res for (let i = 0; i < length; i++) { const c = s[i] const code = c.charCodeAt(0) if (code >= 65 && code <= 90) { res += c.toLowerCase() } else if (code >= 97 && code <= 122) { res += c.toUpperCase() } else { res += c } } return res } 性能分析:前者使用了正则,慢于后者 所以,尽量用“低级”代码,慎用语法糖、高级 API 或者正则表达式。 计算机底层 最后说一些前端需要了解的计算机底层。 从“内存”读数据 我们通常说的:从内存中读数据,就是把数据读入寄存器中,但是我们的数据不是直接从内存读入寄存器的,而是先读入一个高速缓存中,然后才读入寄存器的。 寄存器是在 CPU 内的,也是 CPU 的一部分,所以 CPU 从寄存器读写数据非常快。 这是为啥呢?因为从内存中读数据太慢了。 你可以这么理解:CPU 先把数据读入高速缓存中,以备使用,真正使用的时候,就从高速缓存中读入寄存器;当寄存器使用完毕后,就把数据写回到高速缓存中,然后高速缓存再在合适的时机将数据写入到存储器。 CPU 运算速度非常快,而从内存读数据非常慢,如果每次都从内存中读写数据,那么势必会拖累 CPU 的运算速度,可能执行 100s,有 99s 都在读取数据。为了解决这个问题,我们就在 CPU 和存储器之间放了个高速缓存,而 CPU 和高速缓存之间的读写速度是很快的,CPU 只管和高速缓存互相读写数据,而不管高速缓存和存储器之间是怎么同步数据的。这样就解决了内存读写慢的问题。 二进制的位运算 灵活运用二进制的位运算不仅能提高速度,熟练使用二进制还能节省内存。 假如给定一个数 n,怎么判断 n 是不是 2 的 n 次方呢? 很简单啊,直接求余就行了。 function isPowerOfTwo(n) { if (n <= 0) return false let temp = n while (temp > 1) { if (temp % 2 != 0) return false temp /= 2 } return true } 嗯,代码没毛病,不过不够好,看下面代码: function isPowerOfTwo(n) { return (n > 0) && ((n & (n - 1)) == 0) } 大家可以用 console.time 和 console.timeEnd 对比下运行速度便知。 我们可能还会看到一些源码里面有很多 flag 变量,对这些 flag 进行按位与或按位或运算来检测标记,从而判断是否开启了某个功能。他为什么不直接用布尔值呢?很简单,这样效率高还节省内存。 比如 Vue3 源码中的这段代码,不仅用到了按位与和按位或,还用到了左移: export const enum ShapeFlags { ELEMENT = 1, FUNCTIONAL_COMPONENT = 1 << 1, STATEFUL_COMPONENT = 1 << 2, TEXT_CHILDREN = 1 << 3, ARRAY_CHILDREN = 1 << 4, SLOTS_CHILDREN = 1 << 5, TELEPORT = 1 << 6, SUSPENSE = 1 << 7, COMPONENT_SHOULD_KEEP_ALIVE = 1 << 8, COMPONENT_KEPT_ALIVE = 1 << 9, COMPONENT = ShapeFlags.STATEFUL_COMPONENT | ShapeFlags.FUNCTIONAL_COMPONENT } if (shapeFlag & ShapeFlags.ELEMENT || shapeFlag & ShapeFlags.TELEPORT) { ... } if (hasDynamicKeys) { patchFlag |= PatchFlags.FULL_PROPS } else { if (hasClassBinding) { patchFlag |= PatchFlags.CLASS } if (hasStyleBinding) { patchFlag |= PatchFlags.STYLE } if (dynamicPropNames.length) { patchFlag |= PatchFlags.PROPS } if (hasHydrationEventBinding) { patchFlag |= PatchFlags.HYDRATE_EVENTS } } 结语 文章从代码层面讲解了前端的性能,有深度维度的: JS 基础知识深度剖析 框架源码 也有广度维度的: CSS 动画、组件 算法 计算机底层 希望能让大家拓宽前端性能的视野,如果对文章感兴趣,欢迎留言讨论~~~ 作者:京东零售杨进军 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

每日一博 | 稳定性建设框架

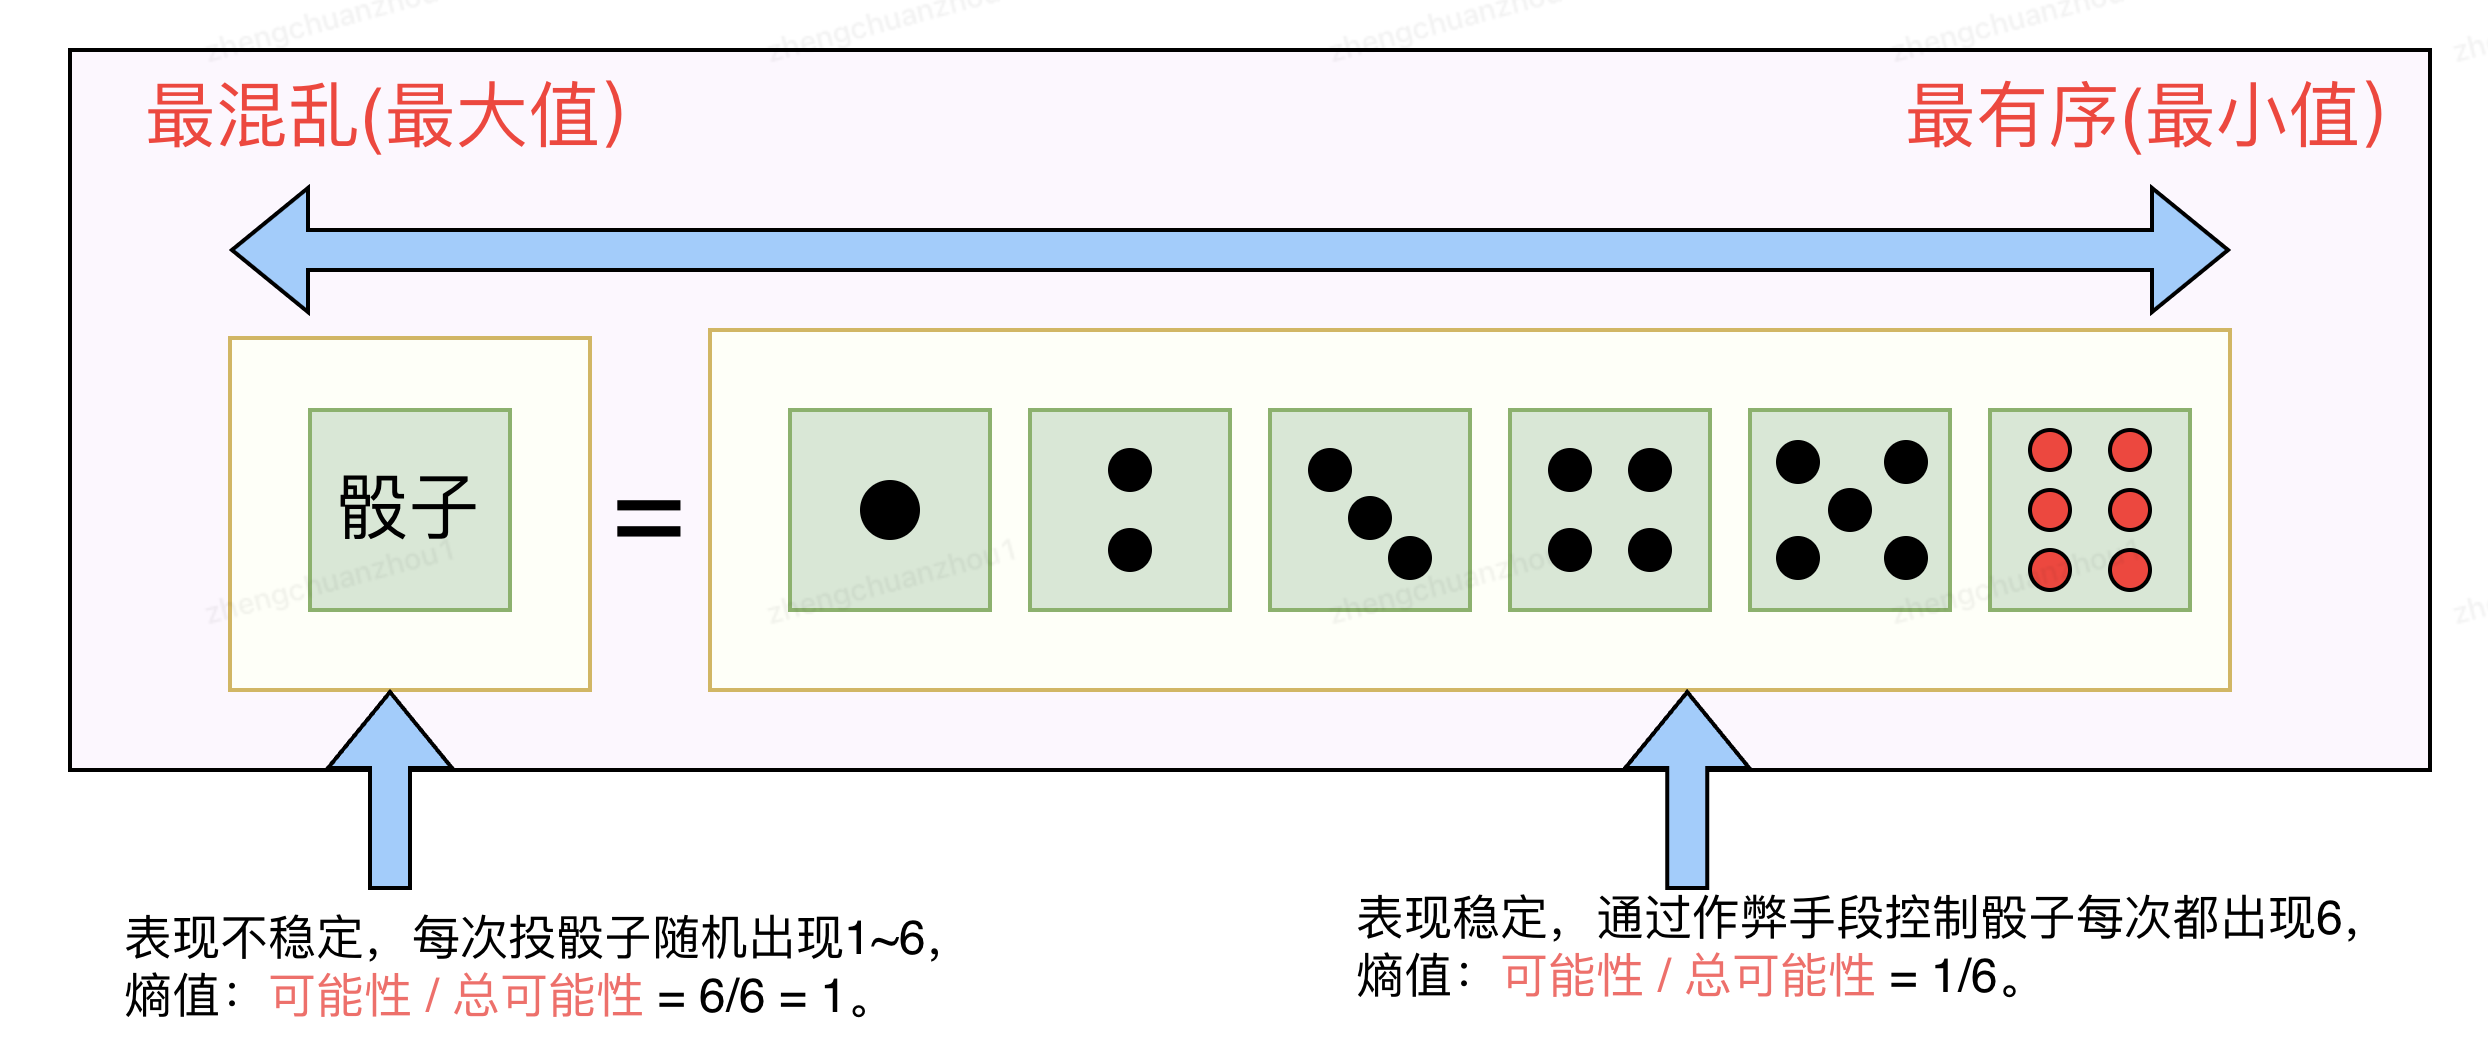
一、为什么要做稳定性建设 1、从熵增定律引出稳定性建设的必要性 物理学上,用“熵”来描述一个体系的混乱程度。卡尔·弗里德曼提出熵增定律,他认为在一个封闭的系统内,如果没有外力的作用,一切物质都会从有序状态向无序状态发展。 如果我们不希望系统变混乱,有什么办法呢?答案是对抗熵增定律,对抗熵增定律的方法是借助外力,让系统从混乱回归有序。举个例子: 下图中,我们使用“熵”值来衡量“骰子系统”的混乱程度,1(最大值)表示“最混乱”,意味着我们不能控制“投骰子”的结果,每次投骰子的结果会在1~6随机出现,系统表现不稳定;1/6(最小值)表示“最有序”,意味着我们能够控制“投骰子”的结果,系统表现稳定,比如我们希望每次投筛子的结果都是6,我们可以引入作弊手段(即借助外力),让每次投骰子结果都是6。 熵增定律同样适合软件系统,一个软件系统刚发布时是有序的,熵值趋于1,随着不断迭代,慢慢变成混乱的、脆弱的,从而导致线上问题频发,熵值趋于0,我们需要借助外力,即稳定性治理手段,提高系统熵值,让系统恢复稳定。 2、稳定性建设的意义 如下图分析,系统不稳定会产生真金白银的损失,因此,稳定性建设的意义是:不是让业务多挣钱,而是让业务不丢钱! 3、稳定性衡量公式 ① 公式 通过如下公式衡量系统稳定性:Availability = MTTF / (MTTF + MTTR) ②公式说明 MTTF (Mean Time To Failure,平均无故障时间),指系统无故障运行的平均时间,取所有从系统开始正 常运行到发生故障之间的时间段的平均值,即: MTTF =ΣT1/ N。 MTTR (Mean Time To Repair,平均修复时间),指系统从发生故障到维修结束之间的时间段的平均值,即: MTTR =Σ(T2+T3)/ N。 ③公式量化 通常是“SLA是几个9”去衡量,对应下表: ④常见问题 问题:SLA应该按照哪个维度去定义?接口、应用、业务? 答:都可以,只要讲清楚是接口SLA,还是应用SLA,还是业务SLA就可以。但注意:提到应用SLA,应该等于核心接口的最差SLA;提到业务SLA应该等于黄金链路的最差SLA。 问题:SLA时间计算周期应该多少? 答:都可以,主要讲清楚计算周期就可以,一般以年为单位更具代表性。 4、常见误区 ①不要认为“分布式环境是稳定的” 认为:网络是可靠的,带宽是无限的,网络的拓扑不会变,延时为0,传输开销为0 实际:网络会抖动,带宽有上限,存在down机导致的拓扑变化,存在响应超时的概率,等等。 ②不要有“确定性思维”,要有“不确定思维” 认为:遵守经验法则,if x then y。举例:我见过天鹅是白色的,所以世界上所有天鹅都是白色的;这个系统一直运行良好,所以未来也不会有问题。 应该:世界是不确定的,if x then maybe y。举例:天鹅还有黑色的。 ③不要“甩锅”,要有“主人翁精神” 认为:故障是因为他们系统挂了,我们只需要打电话通知一下,慢慢等着恢复就行。 应该:提前思考依赖系统故障了,我们如何让我们用户尽可能的正常运行;故障出现了,共同想办法解决问题。 二、业界现状 1、技术现状 互联网的发展,带来越来越大的流量,为了支撑越来越大的流量,架构也一直在演进:单体应用架构 -> 垂直应用架构 -> 分布式架构 -> SOA架构 -> 微服务架构 -> 服务网格。当前流行的微服务架构中,在应用层面、基建层面上都会有一些保障稳定性的机制: 应用层面的稳定性保障机制 以SpringCloud全家桶为例,提供了很多组件,帮助我们保障系统稳定性,如下图: 基建层面的稳定性保障机制 基建层面上,也会有一些稳定性保障机制,如下表: 2、落地现状 根据所见所闻,当前技术团队做稳定性治理一般采用如下2种方法: 运动式的搞一波稳定性建设 当线上故障频发,通常会搞个“稳定性治理专项”,定义一些治理点,并给出方案,然后运动式的搞一波。一般经过治理后,稳定性会明显好转,但是由于是运动式的搞,随着业务不断迭代,根据“熵增定律”, 稳定性又变差。 缺点:不能闭环的搞,治理时稳定性好转,不治理时稳定性变差,给人感觉技术团队一直出问题。 点状的搞,针对每个点专项闭环治理 比如搞个“慢SQL治理专项”,通过监控平台发现慢SQL,给研发发工单,并考核时效;比如搞个“限流治理专项”,让所有接口配置限流参数,配置限流告警策略。 缺点:研发会感觉稳定性专项很多,也不清楚价值,有时候会应付了事,达不到稳定性治理的目标。 三、稳定系治理应该如何开展 将稳定性建设分为3个阶段:事前预防,事中止损,事后复盘,针对这3个阶段,建设思路分别是: 1、事前预防 稳定性建设本质上是对抗熵增原理的过程,具体是通过一些技术手段(比如超时治理、限流治理、降级治理、慢SQL等),提前对系统可能出现的故障,建设应对措施,从而让系统按照设计目标去运行。 注意:稳定性治理的手段很多,每落实一种治理手段,稳定性就能提升一点,可以列出所有已知的治理手段,然后按照优先级逐个治理。 2、事中止损 按照稳定性衡量公式(如下图),降低T2或T3可以提升SLA,因此,出现故障后,应该尽可能的降低T2和T3。降低T2的方法是尽快发现系统出现故障,需要依赖监控和告警能力;降低T3的方法是尽快解决问题,需要先止损后找原因,需要一套明确的SOP提高效率。 3、事后复盘 复盘的目标不是定责,而是为避免再犯,因此,在复盘过程中要追到直接原因和根本原因,这2者有很大区别:直接原因指的是因果关系,表达“因为干了什么,所以导致什么”;根本原因是流程规范、认知迭代层面的问题,比如“因为分支规范不是master上线,导致上丢代码,如果改用gitflow则能够能够完全避免上丢代码的问题”。 关于直接原因和根本原因的举例:陈胜吴广起义,直接原因是:下大雨,可能会迟到,迟到要杀头,所以造反了;根本原因是:秦朝严苛的制度,即使没有那场雨,即使没有陈胜吴广,也会有下一场雨,下一个张胜某广,因为别的原因进行起义。 四、稳定系治理框架 如上一章节所述,当我们从“事前预防,事中止损,事后复盘”的角度去挖掘稳定性治理手段,会发现有很多业界流行的手段,比如超时治理、限流治理、系统隔离、常态化压测、慢SQL治理等等。 然而技术资源永远有限,能够拿出15%的比例做稳定性治理,已经很不错了;另外,业务的不同发展阶段需要的稳定性手段不一样,不同稳定性治理手段的ROI也不一样,因此,我们需要回答一个问题:在有限的研发资源下,如何去按部就班的去搞稳定性治理。 最佳实践是:搭建一个稳定性治理的框架,把稳定性治理手段填充进去,根据业务所处阶段,选择适合当下的稳定性治理手段,可以通过如下的表格进行管理: 备注:稳定性治理框架建起来后,治理手段可以随时增加、减少,框架的价值是给我们一个全景图,让我们知道该干什么、在干什么,而不是瞎干。 五、具体治理方案 根据上一章节的稳定性治理框架,接下来要做的就是针对某个治理手段,出具体的治理方案,要求具体方案能够形成闭环,并融入到研发过程中去,比如: “慢SQL治理”的落地方案 定义慢SQL的标准,即执行时间超过多少ms算慢SQL 通过监控平台发现慢SQL 给研发负责人发治理工单 验收治理效果 “超时治理”的落地方案 为每个接口定义合适的超时时间 每周巡检一次接口,发现超时时间不合理的接口 修正超时时间 六、写在最后 稳定性治理是一个长期的过程,要把稳定性的工作融入到研发过程中,一方面要有意识尽量别埋坑,比如微服务强调中间件隔离,我们就不要混用中间件了,另一方面稳定性问题要一步到位,比如治理超时时间,要有个完整规范定义超时时间,并在研发过程中对新增接口、历史接口都配置合理,且能够动态更新。 作者:京东物流 郑传洲 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

每日一博 | RocketMQ 事务消息初体验

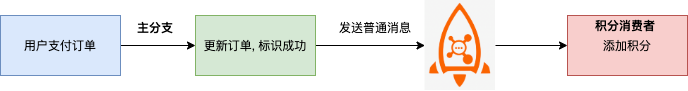
事务消息是 RocketMQ 的高级特性之一 。这篇文章,笔者会从应用场景、功能原理、实战例子三个模块慢慢为你揭开事务消息的神秘面纱。 1 应用场景 举一个电商场景的例子:用户购物车结算时,系统会创建支付订单。 用户支付成功后支付订单的状态会由未支付修改为支付成功,然后系统给用户增加积分。 通常我们会使用普通消费方案,该方案能够发挥 MQ 的优势:异步和解耦 , 同时架构设计非常简单。 用户购物车结算时,系统创建支付订单; 支付成功后,更新订单的状态从未支付修改为支付成功; 发送一条普通消息到消息队列服务端; 积分服务消费消息,添加积分记录。 但该方案有个非常直观的缺点:容易出现不一致的现象。 假如先发送消息,后修改订单状态,消息发送成功,订单没有执行成功,需要回滚整个事务(订单数据事务回滚,积分服务消费时,需要先反查事务状态,若事务提交,才插入积分记录)。 假如先修改订单状态,后发送消息,订单状态修改成功,但消息发送失败,需要补偿操作才能保持最终一致。 假如先修改订单,后发送消息,订单状态修改成功,但消息发送超时,此时无法判断需要回滚订单还是提交订单变更。 我们看到,为了完善普通消费方案,业务层还需要做到两点:补偿机制和提供事务状态查询接口。 要做到这两点,难不难呢? 不难,但是业务层代码会比较混乱,更优的方案还是得从中间件层面解决。 2 功能原理 RocketMQ 事务消息是支持在分布式场景下保障消息生产和本地事务的最终一致性。交互流程如下图所示: 1、生产者将消息发送至 Broker 。 2、Broker 将消息持久化成功之后,向生产者返回 Ack 确认消息已经发送成功,此时消息被标记为"暂不能投递",这种状态下的消息即为半事务消息。 3、生产者开始执行本地事务逻辑。 4、生产者根据本地事务执行结果向服务端提交二次确认结果( Commit 或是 Rollback ),Broker 收到确认结果后处理逻辑如下: 二次确认结果为 Commit :Broker 将半事务消息标记为可投递,并投递给消费者。 二次确认结果为 Rollback :Broker 将回滚事务,不会将半事务消息投递给消费者。 5、在断网或者是生产者应用重启的特殊情况下,若 Broker 未收到发送者提交的二次确认结果,或 Broker 收到的二次确认结果为 Unknown 未知状态,经过固定时间后,服务端将对消息生产者即生产者集群中任一生产者实例发起消息回查。 生产者收到消息回查后,需要检查对应消息的本地事务执行的最终结果。 生产者根据检查到的本地事务的最终状态再次提交二次确认,服务端仍按照步骤4对半事务消息进行处理。 笔者认为事务消息的精髓在于: 本地事务执行成功,消费者才能消费事务消息; 消息回查本身就是补偿机制的实现,事务生产者需提供了事务状态查询接口。 3 实战例子 为了便于大家理解事务消息 ,笔者新建一个工程用于模拟支付订单创建、支付成功、赠送积分的流程。 首先,我们创建一个真实的订单主题:order-topic 。 然后在数据库中创建三张表 订单表、事务日志表、积分表。 最后我们创建一个 Demo 工程,生产者模块用于创建支付订单、修改支付订单成功,消费者模块用于新增积分记录。 接下来,我们展示事务消息的实现流程。 <strong style="font-size: 15px;line-height: inherit;color: black;">1、创建支付订单</strong> 调用订单生产者服务创建订单接口 ,在 t_order 表中插入一条支付订单记录。 <strong style="font-size: 15px;line-height: inherit;color: black;">2、调用生产者服务修改订单状态接口</strong> 接口的逻辑就是执行事务生产者的 sendMessageInTransaction 方法。 生产者端需要配置事务生产者和事务监听器。 发送事务消息的方法内部包含三个步骤 : 事务生产者首先发送半事务消息,发送成功后,生产者才开始执行本地事务逻辑。 事务监听器实现了两个功能:执行本地事务和供 Broker 回查事务状态 。 执行本地事务的逻辑内部就是执行 orderService.updateOrder 方法。 方法执行成功则返回 LocalTransactionState.COMMIT_MESSAGE , 若执行失败则返回 LocalTransactionState.ROLLBACK_MESSAGE 。 需要注意的是: orderService.updateOrder 方法添加了事务注解,并将修改订单状态和插入事务日志表放进一个事务内,避免订单状态和事务日志表的数据不一致。 最后,生产者根据本地事务执行结果向 Broker 提交二次确认结果。 Broker 收到生产者确认结果后处理逻辑如下: 二次确认结果为 Commit :Broker 将半事务消息标记为可投递,并投递给消费者。 二次确认结果为 Rollback :Broker 将回滚事务,不会将半事务消息投递给消费者。 <strong style="font-size: 15px;line-height: inherit;color: black;">3、积分消费者消费消息,添加积分记录</strong > 当 Broker 将半事务消息标记为可投递时,积分消费者就可以开始消费主题 order-topic 的消息了。 积分消费者服务,我们定义了消费者组名,以及订阅主题和消费监听器。 在消费监听器逻辑里,幂等非常重要 。当收到订单信息后,首先判断该订单是否有积分记录,若没有记录,才插入积分记录。 而且我们在创建积分表时,订单编号也是唯一键,数据库中也必然不会存在相同订单的多条积分记录。 4 总结 RocketMQ 事务消息是支持在分布式场景下保障消息生产和本地事务的最终一致性。 编写一个实战例子并不复杂,但使用事务消息时需要注意如下三点: 1、事务生产者和消费者共同协作才能保证业务数据的最终一致性; 2、事务生产者需要实现事务监听器,并且保存事务的执行结果(比如事务日志表) ; 3、消费者要保证幂等。消费失败时,通过重试、告警+人工介入等手段保证消费结果正确。 本文涉及到的工程源码,笔者已上传到 Github ,感兴趣的同学可以了解一下,若有疑问直接加笔者好友,一起交流技术,一起成长。 笔者会在后续的文章里,详细解析事务消息的实现原理,敬请期待。 实战代码地址: https://github.com/makemyownlife/rocketmq4-learning 如果我的文章对你有所帮助,还请帮忙点赞、在看、转发一下,你的支持会激励我输出更高质量的文章,非常感谢!

优秀的个人博客,低调大师

每日一博 | 关于 MQ,你了解多少?

导语 本文梳理笔者 MQ 知识,从消息中间件的基础知识讲起,在有了基础知识后,对市面上各主流的消息中间件进行详细的解析,包括 RabbitMQ、RocketMQ、Kafka、Pulsar,最后再横向对比这几款主流的消息中间件。 消息中间件历史 介绍 MQ 的文章网上千千万,最好的学习途径还是官方文档,文中介绍的这几款 MQ 都在努力推广自己,所以文档在权威性、全面性、专业性、时效性都是无人能及其左右,现在的官网文档甚至自己做竞品比对,比如 RocketMQ 就自己放了比对表格在首页。所以要学好哪一款MQ,就去看它的官网吧,地址放在文末参考资料中了。 最好的学习方法是带着问题去寻找答案,以费曼学习法为标准,产出可教学的资料,所以本文多是个人的所学梳理和所想记录,个人知识有限,难免有所疏漏,文中有错误和疏漏请不吝赐教,感谢! 消息中间件的发展已经有近40年历史,早在上个世纪80年代就诞生了第一款消息队列 The Information Bus。 到90年代 IBM、Oracle、Microsoft 纷纷推出自家的MQ,但都是收费且闭源的产品,主要面向高端的企业用户,这些MQ一般都采用高端硬件,软硬件一体机交付,需要采购专门的维护服务,MQ本身的架构是单机的架构,用户的自主性较差。 进入新世纪后,随着技术成熟,人们开始讨论MQ的协议,诞生了JMS、AMPQ 两大协议标准,随之分别有 ActiveMQ、RabbitMQ的具体实现,并且是开源共建的,这使得这两款MQ在当时迅速流行开来,MQ的使用门槛也随之降低,越来越多系统融入了MQ作为基础能力。 再后来PC互联网、移动互联网的爆发式发展,由于传统的消息队列无法承受亿级用户的访问流量和海量数据传输,诞生了互联网消息中间件,核心能力是全面采用分布式架构、具备很强的横向扩展能力,开源典型代表有 Kafka、RocketMQ、Pulsar。Kafka 的诞生还将消息中间件从Messaging领域延伸到了 Streaming 领域,从分布式应用的异步解耦场景延伸到大数据领域的流存储和流计算场景。Pulsar 更是在 Kafka 之后集大家之成,在企业级应用上做得更好,存储和计算分离的设计使得拓展更加轻松。 如今,IoT、云计算、云原生引领了新的技术趋势。面向IoT的场景,消息队列开始从云内服务端应用通信,延伸到边缘机房和物联网终端设备,支持 MQTT 等物联网标准协议也成了各大消息队列的标配,我们看到 Pulsar、Kafka、RocketMQ 都在努力跟随时代步伐,拓展自己在各种使用场景下的能力。 消息中间件基础定义 在早些年 MQ 一直被叫做消息队列,就可以定义为传递消息的容器,随着时代的发展,MQ 都在努力拓展出来越来越多的功能,越来越多需求加在 MQ 纸上,消息中间件的能力越来越强,应用的场景也越来越多,如果非要用一个定义来概括只能是抽象出来一些概念,概括为跨服务之间传递信息的软件。 用途 异步处理 可以把接口请求根据业务的时效性程度,将不紧急的处理逻辑生成消息、事件放到 MQ 当中,再由专门的系统处理该消息、事件;如日志上报、归档事件、数据推送、数据分析、触发策略、变更推荐、添加积分、发送通知消息等。 削峰填谷 作为系统内部的一个消息池,抵抗洪峰,对后端服务起到保护作用。流量洪峰进来的时候,会转换为消息落到 MQ 当中,后端服务可以根据自己的处理能力来,流量不会直接冲击到后端服务,特别是落库、IO 等操作。 服务解耦 减少系统、模块之间直接对接带来的耦合,交互统一按 MQ 中消息的协议,按需生产和消费,耦合程度大大降低。 发布订阅 系统产生的行为不需要通过接口等方式来通知到相关服务,只需要发布一次消息,订阅者都能消费到消息,执行服务自身的本职工作。 当然,一切收益都是有代价的,对于系统架构本身来说,会引入新组件,带来系统复杂度的提升,整体系统的可靠性也会是挑战,增加消息中间件的运维成本,还会带来整体系统一致性的问题。所以需要权衡自身系统是否有必要引入 MQ,能解决什么痛点,投入产出能否让组织满意,对于本身流量不大的系统来说,保持简单架构是皆大欢喜的事情,毕竟,越简单越稳定,越耐用。 消息模型 队列模型 一种是消息队列,生产者往队列写消息,消费者从这个队列消费消息,当然生产者可以是多个,消费者也可以是多个,但是一条消息只能被消费一次,具体怎么做的,这就涉及到具体的使用需求和每一款消息中间件的实现了,后面第二部分的时候会涉及到。这是最早的消息模型,这也是为什么消息队列 MQ 这个名字也一直有人在用吧。 订阅模型 后来上个世纪80年代有人提出发布订阅模式,就是 Topic 模式,生产者发布的消息,消息中间件会把消息投递给每一个订阅者,这个投递的过程有可能是推也可能是拉,支持哪一种也要看每一款的具体实现。 消息协议 常见的消息协议: 接下来举例 AMPQ 协议的生产、消费过程标准。 AMQP 协议 高级消息队列协议(Advanced Message Queuing Protocol),一个提供统一消息服务的应用层标准高级消息队列协议,是应用层协议的一个开放标准,为面向消息的中间件设计。基于此协议的客户端与消息中间件可传递消息,并不受客户端/中间件不同产品,不同的开发语言等条件的限制。 生产消息 消费消息 MQTT 协议 MQTT(消息队列遥测传输)是 ISO 标准(ISO/IEC PRF 20922)下基于发布/订阅范式的消息协议。它工作在 TCP/IP 协议族上,是为硬件性能低下的远程设备以及网络状况糟糕的情况下而设计的发布/订阅型消息协议。 MQTT 协议是轻量、简单、开放和易于实现的,这些特点使它适用范围非常广泛。在很多情况下,包括受限的环境中,如:机器与机器(M2M)通信和物联网(IoT)。其在,通过卫星链路通信传感器、偶尔拨号的医疗设备、智能家居、及一些小型化设备中已广泛使用。 其他协议 另外还有 STOMP、OpenMessaging 等,这里不做展开。当前市面上主流的消息中间件多是有自定义的协议发展起来的,如 Kafka 在最开始并不算是一个消息中间件,而是用于日志记录系统的一部分,所以并不是基于某种中间件消息协议来做的,而是基于 TCP/IP,根据自定义的消息格式,来传递日志消息,为满足对于消息丢失是有一定容忍度的;在后来逐步发展到可以支持正好一次(Exactly Once)语义,实际上是通过 At Least Once + 幂等性 = Exactly Once 。 将服务器的 ACK 设置为-1,可以保证 Procedure 到 Broker 不会丢失数据即 At Least Once;相对的,服务器级别设置为0,可以保证生产者发送消息只会发一次,即 At Most Once 语义但是,一些非常重要的消息,如交易数据,下游消费者要求消息不重不漏,即 Exactly Once,精准一次,在0.11版本之前,Kafka 是无能为力的,只能通过设置ACK=-1,然后业务消费者自己去重。 0.11版本之后,Kafka 引入了幂等性概念,Procedure 无论向 Broker 发送多少次消息,Broker 只会持久化一条:At Least Once + 幂等性 = Exactly Once。要启用幂等性,只需要将 Procedure 参数中的 enable.idempotence 设置为 True 即可,Kafka 的幂等性实现其实就是将原来在下游做的去重放在了数据上游。开启幂等性的 Procedure 在初始化的时候会分配一个 PID,发往同一个 Partition 的消息会带一个 Sequence Number,而 Broker 端会对做缓存,当相同主键消息提交时,Broker 只会持久化一条。 基于这个理解我们看下 Kafka 的消息报文格式定义, 协议概要: 再展开看 Message 的定义: 基于 TCP/IP 协议,通过定义消息格式,在请求和响应中做可靠性保证。且随着发展在修改协议,比如 Timestamp 是为了增加时间索引,在 0.10.0 版本后增加的,用于根据时间戳快速查找特定消息的位移值,优化 Kafka 读取历史消息缓慢的问题。 Streaming、Eventing 场景下目前还没有看到有公认消息协议的出现。 往下的篇幅将展开介绍 RabbitMQ、RocketMQ、Kafka、Pulsar 这四款主流消息中间件的基础知识。 RabbitMQ 基于 Erlang 语言开发实现,单机性能表现不错,横向拓展能力较弱,可用于吞吐量在万级的系统当中。 消息模式 RabbitMQ 支持简单模式、工作队列模式、发布/订阅模式、路由模式、主题模式和 RPC 模式。 简单模式 队列模式 发布订阅模式 路由模式 主题模式 RPC模式 以上所有模式实际上都及基于消息队列来实现的,发布订阅模式和主体模式,也是通过队列来实现的,对交换器绑定后再通过路由规则来分发消息到队列中,也就是 BindingKey 和 RoutingKey,由于 RoutingKey 不能重复,也就意味着队列收到的消息不能一样,而每条消息只会发送给订阅列表里的一个消费者,从而就是没有消费者组的概念,无法做到真正的发布订阅。带着这个理解看 RabbitMQ 架构就会比较清晰了。 RabbitMQ 架构 上图是单机的架构,那么集群架构是怎么样的呢? HA-Proxy 一款提供高可用性、负载均衡以及基于 TCP 和 HTTP 应用的代理软件,主要是做负载均衡的7层,也可以做4层负载均衡。 Keepalived 是集群管理中保证集群高可用的一个服务软件,其功能类似于 Heartbeat,用来防止单点故障。 虽然是高可用方案,但总体来说横向扩展能力较弱。 RabbitMQ 就介绍到这里,更多信息可查看官网。 未完待续 此篇是消息队列基础知识的上半部分,下半部分会对现代主流的消息队列进行介绍,包括 RocketMQ、Kafka、Pulsar,以及这几款 MQ 之间的对比。 往期 推荐 《腾讯云消息队列产品3月产品动态》 《腾讯云微服务产品3月产品动态》 《万字干货:Kafka 高可靠高性能原理探究》 《解决异构系统集成难题,富融银行这样做》 《Apache Pulsar 技术系列 - Pulsar 总览》 《解决创新业务的三大架构难题,央广购物用对了这个关键策略》 《详解 Apache Pulsar 消息生命周期》 《基于腾讯云微服务引擎(TSE) ,轻松实现云上全链路灰度发布》 扫描下方二维码关注本公众号, 了解更多微服务、消息队列的相关信息! 解锁超多鹅厂周边! 戳原文,查看更多 消息队列 CKafka 的 信息! 点个在看你最好看 本文分享自微信公众号 - 腾讯云中间件(gh_6ea1bc2dd5fd)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 探索 Xcode 15 新特性

一、版本说明 XCode 15 beta 发布于 2023 年 6月5日, 可支持 macOS 13.3 或以上版本, 你可以按需下载需要的平台。 二、新增特性 1.代码智能提示 (Code completion) •创建新的文件在引用时的提示 首先创建一个新的文件 然后,在引用的地方,输入文件首字母会立即自动弹出补全提示。 函数调用时列出所有可能的参数排列 在没有提示的情况下,调用函数时如何传参往往是比较困难的,不知道可以传哪些参数, 现在 XCode 将列出所有可供选择的可能,你可以更轻松找到合适的参数列表并选择它。 自动分析代码上下文,并给出最合适的建议。 例如在 Text 组件调用中,输入"点号" 后,在弹出的提示列表中的最上方会提示 font (此时 Text 还没设置 font ),这是因为XCode分析了上下文,“识别出” 这是一个 Text, 并且此时还没有设置过字体,你可能需要它,因此将字体放在建议的最上方。 2.资产文件作为变量引用 (Asset catalogs) 过去资产文件如图片是以 “字符串” 作为图片名称在代码中被引用,现在直接通过类似变量的标识符去引用它,它可以接受编译时的检查。 资产引用的编译检查 修改资产的名称为 “MultipleClouds ” 后,引用处产生了编译错误 这是因为此前资产的名称是 "clouds", 现在,编译器提示你修改它为 "MultipleClouds"。 代码中引用图片资产的智能推荐 编辑资产的名称时,可以获得XCode 的智能推荐。 3.本地化资源集中管理 (Localization) 旧项目的本地化文件迁移 XCode 设置中 选择 Edit > Convert to string catalog, 此时 XCode 会自动扫描工程中的 storyboards、.strings、 以及 .stringsdict 类型的文件。并将其列在下图所示的列表中,你可以根据需要选择部分或全部文件进行迁移。 迁移完成后,所有的本地化翻译将被整合到一个 Localization 目录中,你还可以查看到不同语言翻译的进度。 追踪代码中的字符串变化 每次构建时,XCode 会自动提取代码中的所有字符串。当添加新字符串或删除某个字符串时,本地化目录会标记出受影响的地方,并给出 “陈旧” 和 “新增” 的标记进行凸显,从而提示你去翻译或者删除它。 4.文档 (Documentation) 新的文档卡片样式 文档小助手 选择小助手,然后选择文档预览。 左边是代码,右边可以看到对应的文档,你可以实时编辑和预览,这看起来有点像 MD。 5.新增 Swift 宏 (Swift macros) 系统部分框架已经实现了宏,如 Swift standard library、foundation、 以及一个新的 Swift data framework. 创建宏包 (macro package) 使用快捷键 Command-Shift-A, 然后在弹出的输入框中输入 New package 可以快速创建一个带有样例代码的宏包,你可以修改并实现它。 然后选择 Swift Macro 以下是一个已经实现的宏包 EnumHelper,而CaseDetection 被实现为一个宏,宏的代码和一般的 swfit 代码没什么大的区别。 以下是引用了宏包 EnumHelper 中的宏 @CaseDetection,它默认会隐藏了宏实现, 展开宏和断点调试 当你需要时,你可以选择展开宏,通过 Editor > Expand Macro 可以展开它。 展开后,还可以使用断点,如下图所示: 6.运行时预览 (Previews) 基于宏快速创建一个预览实例 使用宏 #Preview 快速创建一个预览实例, 在右侧边栏可以看到预览效果。 以下继续添加了一个带名称的预览实例,当有多个预览实例时,可以在右侧边栏的左上角切换tab 预览对应实例。 AppKit 及UIKit 的预览支持 为了兼容非SwiftUI 的代码,可支持对旧工程的 Appkit 及 UIKit 添加预览。 Widget 预览支持 7.书签功能 (Bookmark) 添加书签 你可能经常会遇到忘记此前关注或使用的一些重要代码,在你想要找到之前的那些代码时,你发现没有办法快速找到它。现在,通过添加可命名的书签来标记他们。 添加完成后,书签被展示在左边栏的书签tab下。 书签分组 你可以将多个书签打包成一个组,作为有关联性的代码。 你也可以设置一个组名,便于搜索和理解。 设置为代办或完成 你可以将书签作为任务来管理,比如你可以将书签设置为完成状态,它将会在左侧显示一个对勾。 8.代码版本控制 (Source Control Navigation) 版本控制面板 在新的面板中,所有的版本改动将集中在一个文件中一起预览,通过上下滑动可以看到多个文件的修改内容,从而避免来回切换修改的文件。 修改的预览是可交互的,你可以通过操作来扩大预览区域,从而查看当前修改处的更多上下文。 除了预览,你还可以直接在当前界面下继续编辑,编辑完成后,可以提交 commit,然后push。 可通过左侧的竖条修改状态。 小结:代码修改的预览、编辑、提交、推送都在同一页面下,减少不必要的界面切换,操作更便捷。 9.测试 (Testing) 测试面板 Apple 对新的测试面板使用Swift 进行了重写,提速了45%,下图案例列出了测试计划中的测试用例。 查看测试结果 测试结果的整体统计信息看起来简明扼要,主要包括: Top Insights: 分析测试结果,给出一些问题分析的建议,包括错误的原因、分布、最耗时的测试用例。 Tests: 展示测试用的统计数据,包例成功率,按机型、语言分类,以及错误列表。 可交互的测试用例回放 测试用例的详情信息可以被查看,它展示了自动化的测试步骤,以及标出发生错误的节点,你可以通过以上信息来帮助找出问题的原因。 10.调试 (Debugging) 控制台引入 OSLog 的支持 OSLog 可用来很好的捕获运行时信息。它可定义及收集结构化的日志信息,使日志看起来井井有条,接下来让我们看看如何使用它。 首先,使用 OSLog 编写一段日志: 默认情况下,日志的元信息是被隐藏的,仅显示开发者输入的日志信息,控制台中对不同严重程度(如 info、 notice 、error 等)的日志,标记为不同的颜色以示区分。 你可以选择性的添加展示日志的分类,包括子系统类别等元信息。 还可以过滤不同严重程序的日志。 最后,我们可以通过操作某条日志,跳转到日志代码定义处。 11.分发 (Distributing) 新增 TestFlight 包的备注信息 你可以给 TestFlight 的包添加一些附属的备注信息,例如需要测试哪些内容的说明,这些信息会被展示给获取 TF包的测试者。 查看框架签名 XCode 引入了XCFrameWork 可以对签名的框架进行验签,从而显示其来源,并保障其完整性不被破坏,从而建立框架的信任机制。 隐私清单 框架作者可以给自己的框架添加隐私清单,来说明隐私的使用情况和如何保护敏感数据。隐私清单会与框架捆绑一起签名,因此,隐私清单是可被信任的。 来看看下图所示的隐私清单: 你可以使用XCode可以生成和查看完整的隐私报告 TestFlight 仅分发到内部测试 当修复问题时,你不希望测试包被真实用户看见,这时你可以通过勾选 “仅分发给内部测试” 然后只分发给自己公司或团队的测试者 ,这样可以防止被误发给共测用户。 以下是另外一个操作内部测试的路径 三、总结 XCode15 在开发效率和性能、安全提升上主要表现为以下概括的内容: 更简洁: 主要体现在宏、文档、和日志上。 更智能: 提升自动补全代码能力、提升测试分析能力。 更便捷: 包拆分下载、代码补全、书签、git集中管理,本地化集中管理。 更安全: 图片资产符号化管理, 通过对框架和隐私的处理,使得代码更加安全。 作者:京东零售 王晰源 来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 大语言模型技术原理

在今天这个时代,人们的工作和生活已经离不开数据访问,而几乎所有平台背后的数据存储和查询都离不开数据库。SQL作为一种数据库的查询和处理语言历史悠久,最早由IBM于上世纪70年代初研究关系数据模型时提出,后续发展为一种广泛使用的数据库标准访问接口。 今天大语言模型的发展给了我们一个契机,重新审视这层标准,如何让人们以更加自然的方式访问数据库,数据以更直接、更灵活的方式返回给客户。由于历史发展的原因,从数据库分析出一个结论,需要“分析人员+报表前端+数据后端+SQL+数据存储”的全路径,这一使用范式在未来将受到挑战。除了自然语言本身的优势外,语境的上下文学习能力、迁移学习和文字总结能力也有很大的发挥空间,带着这些思考,我们有必要了解一下大语言模型背后的发展及其技术原理。 一、大语言模型的发展 大语言模型作为一个被验证可行的方向,其“大”体现在训练数据集广,模型参数和层数大,计算量大,其价值体现在通用性上,并且有更好的泛化能力。相较于传统特定领域训练出来的语言模型,有更广泛的应用场景。这篇文章参考Google和OpenAI相关论文及部分作者的补充,结合我的理解尝试用大家普遍看得明白的语言,对其技术发展和主要实现进行解析。 1.1 Transformer模型的提出 在Transformer提出之前,自然语言处理领域的主流模型是循环神经网络(RNN,recurrent neural network),使用递归和卷积神经网络进行语言序列转换。2017年,谷歌大脑团队在人工智能领域的顶会NeurIPS发表了一篇名为“Attention is all you need”的论文,首次提出了一种新的简单网络架构,即 Transformer,它完全基于注意力机制(attention),完全摒弃了循环递归和卷积。 递归模型通常沿输入和输出序列的符号位置进行计算,来预测后面的值。但这种固有的顺序性质阻碍了训练样例内的并行化,因为内存约束限制了样例之间的批处理。而注意力机制允许对依赖项进行建模,而无需考虑它们在输入或输出序列中的距离。 Transformer避开了递归网络的模型体系结构,并且完全依赖于注意力机制来绘制输入和输出之间的全局依存关系。 在八个P100 GPU上进行了仅仅12个小时的训练之后,Transformer就可以在翻译质量方面达到新的最先进水平,体现了很好的并行能力。成为当时最先进的大型语言模型(Large Language Model, LLM)。 总结两个核心突破: 突破了远距离文本依赖的学习限制,避开了递归网络的模型体系结构,并且完全依赖于注意力机制来绘制输入和输出之间的全局依赖关系。关联来自两个任意输入或输出位置的信号所需的操作数随着距离增加,原来需要线性增长或对数增长,现在被收敛成一个常量,并通过多注意头机制保障了准确性。 可高度并行进行训练,这对发挥硬件红利以及快速迭代模型非常重要。 下图是论文提到的Transformer模型,对编码器和解码器使用堆叠式的自注意力和逐点式、全连接层,分别如图1的左半部分(编码器)和右半部分(解码器)所示,相关技术细节后面会重点讲到。 Transformer模型 OpenAI基于该工作基础上发展了GPT(Generative Pre-training)生成式预训练模型,这里借用网上一张图简单改过,相关细节将在后面展开。 GPT的发展 1.2 生成式预训练初现潜力:GPT-1 2018年,OpenAI公司发表了论文“Improving Language Understanding by Generative Pre-training”, 使用的模型有两个阶段,第一阶段是无监督预训练,基于海量的文本集通过Transformer学习一个大容量的语言模型,第二阶段基于标注数据进行参数微调。得到的一般任务不可知模型(或称为通用模型)优于经过判别训练的模型,在论文选定的12种数据集中有9个取得更好效果。 在 GPT-1 中,采用了 12 层Transformer 的结构作为解码器,每个 Transformer 层是一个多头的自注意力机制,然后通过全连接得到输出的概率分布。 这次实践对OpenAI来讲,我觉得是奠定了他们往这个路线发展的核心因素,主要有几个重点突破: 1、证明了通用模型训练具有很大的价值潜力。之前用于学习特定任务的标注数据难以获得,导致模型效果不能持续提升,而通过Transformer无监督训练+少量标注数据的Finetune就取得了更优的效果。 2、论文尝试增加Transformer中间层, 在从2层到12层的数量增加中,平均每增加1层能够提升9%的准确性。加上Transformer本身具备并行能力,这在GPU上无疑潜力巨大。 3、论文发现在第二步的Finetune中添加语言建模作为辅助学习目标,能够提高监督模型的泛化能力,并加速收敛。说明在更海量的数据集时,模型会更收益于辅助学习目标。 生成式预训练初现潜力GPT-1 虽然论文摘要重点强调了该模型在缺少标注数据情况下对特定任务的优势,但其实以上三点发现对OpenAI后续技术路线影响重大。但GPT-1在生成长文本时,仍然会出现信息遗忘和重复等问题,和特定领域的模型对比还有很多不足。 1.3 泛化能力突破:GPT-2 2019年,OpenAI发表了最新进展,一篇“Language Models are Unsupervised Multitask Learners”的论文。重点实践了更大的模型更广的数据集具有更好的泛化能力。GPT-1是12层的transformer,BERT最深是24层的transformer,GPT-2则是48层,共有15亿个参数的transformer,训练集叫WebText,是从4500万个链接提取文本去重后,得到800万文档共40GB文本。 论文认为现有系统用单个任务来训练的单个领域数据集,是缺乏模型泛化能力的主要原因,因此在更广的数据集上,GPT-2采用了多任务(multitask)的方式,每一个任务都要保证其损失函数能收敛,不同的任务共享主体transformer参数。 最终训练出来的模型在不需要任何参数和模型改动下,在zero-shot(零样本)任务中,在8个数据集中有7个表现为业界最优,这个泛化能力可以说已经很强大了,并且在机器翻译场景取得亮眼结果,GPT也是在2.0出来后,开始备受关注。 1.4 更大参数更大数据集:GPT3 之前的模型要在特定领域有更好表现,依然需要上千条标注样本数据来进行finetune,很大程度影响了模型的通用性,而人类能够根据前面一句话知道语境(in-context),从而正确回答问题。GPT3就通过调大参数(1750亿)来测试in-context 学习能力,并在没有finetune情况下得到以下数据。在参数不断增加的同时,分为三种场景看回答准确率表现:Zero-shot(0样本),One-shot(只给一个标准样本),Few-shot(少量标准样本,1000条左右)。下图可以看到模型参数和样本集对正确性的影响,随着参数增多,Few-shot相比Zero-shot的提升效果在拉大,说明越大的参数对样本具有更强的泛化能力。 三种场景 模型参数和样本集对正确性的影响 论文做了不同参数的验证工作,n(params)是参数梳理,n(layers)是模型层数,d(model)是FFN层数的1/4,d(head)是多注意头的维数,所有测试使用的上下文token数是2048。 验证结果 GPT-3 在 GPT-2 追求无监督和零次学习的特征基础上进行了改进,转而追求无监督模式下的 few-shot(少量学习)。GPT-3采用了 96 层的多头 Transformer,上下文窗口大小提升至 2048 个 token ,基于更大的数据集 45TB 的文本数据训练,在多个 NLP 数据集上实现了出色的性能。GPT-3更多的工作在工程问题上,比如数据污染处理,GPU并行时减少节点间网络交互和负载均衡等。 论文测试了超过24中场景,GPT-3在许多NLP数据集上实现了强大的性能,包括翻译、问题回答和完形填空任务,以及一些需要实时推理或领域适应的任务,如解读单词、在句子中使用新单词或执行3位数字算术。论文还表明,在few-shot设置下,GPT-3可以生成人类评估者难以区分的新闻文章。 1.5 火爆的ChatGPT:GPT 3.5 2022年3月,OpenAI再次发表论文“Training language models to follow instructions with human feedback”,通过人工反馈和微调,使语言模型与用户对各种任务的意图保持一致。并推出了InstructGPT模型,InstructGPT 是基于 GPT-3 的一轮增强优化,所以也被称为 GPT-3.5。尽管GPT3.5还会犯一些简单的错误,但论文工作表明利用人类反馈进行微调是一个很有前景的方向。 论文提供了一种方法,能通过对人类反馈进行微调,使语言模型在广泛的任务应用中更好地遵从使用者意图。从一组人工编写的prompts和通过OpenAI API提交的prompts开始,论文收集了所需模型行为的标记样本数据集,并使用监督学习对GPT-3进行微调。然后,论文对模型输出进行人工排名,使用来自人类反馈的强化学习(Reinforcement Learning from Human Feedback,RLHF)进一步微调这个监督模型。InstructGPT模型的参数为1.3B,而GPT-3模型的参数为175B,约为InstructGPT模型的130倍,但InstructGPT模型的输出却优于GPT-3模型的输出。 训练过程首先聘请了40个承包商来标注数据,收集提交给OpenAI的prompts的人工答案样本集,以及一些人工写的prompts作为训练监督学习的基线。然后,在更大的prompts集上对比OpenAI的输出,并人工标记差距,据此训练出一个奖励模型(Reward Model)来预测人类喜好的输出。最后用PPO来最大化这个奖励模型和fine-tune对监督模型的效果。这部分具体技术细节将在后面展开。论文认为模型如果有价值观的话,体现更多的是标注者的价值观念而不是更广泛人的价值观。 对人类任务意图的识别,是一个非常重要的能力。ChatGPT 采用 InstructGPT 相同结构的模型,针对 Chat 进行了专门的优化, 同时开放到公众测试训练,以便产生更多有效标注数据。基于人类反馈的强化学习(RLHF)是 ChatGPT 区别于其他生成类模型的最主要特点,该法帮助模型尽量减少有害的、不真实的及有偏见的输出,提升自然沟通效果。 同时,为了更好地支持多轮对话,ChatGPT 引入了一种基于堆栈的上下文管理的机制,帮助 ChatGPT 跟踪和管理多轮对话中的上下文信息,从而在多轮对话中生成连贯自然的回复。 1.6 当前的技术局限性 专业的领域,缺乏语料训练的情况下,GPT无法生成合适的回答。 可信度问题,缺乏答案的具体来源。 时效性问题,大模型底层训练数据是过往数据,再一次训练的成本很高。 数理问题会一本正经地胡说八道,Stephen Wolfram创造了计算知识搜索引擎和计算语言wolfram,有机会将自然语言转为计算符号再进行计算,解决这一问题。 模型的训练方法有个致命的问题,训练好的模型在回答问题时,在各个答案里选一个最优答案,但答案依然可能是错的,模型本质是黑盒的,目前还未能对内部逻辑进行分解,无法保证不产生有害或伤害客户的描述。如果调教训练模型更加谨慎,可能会拒绝回答(以避免提示的误报)。有时模型最终对一个短语没有反应,但对问题/短语稍作调整,它最终会正确回答。 二、主要技术细节 Google的论文比较简短,看到刘岩推荐的Jay Alammer对Transformer的讲解,这里也做了部分引用,这里希望用大家看得懂的话,抽取主要技术细节讲清楚。 从数学或机器学习的角度来看,语言模型都是对词语序列的概率相关性分布的建模,即利用已经说过的语句(语句可以作为数学中的向量)作为输入条件,预测下一个时刻不同语句甚至语言集合出现的概率分布。 GPT生成式预训练模型也是根据语料概率来自动生成回答的每一个字,ChatGPT在此基础上通过使用基于人类反馈的强化学习(Reinforcement Learning from Human Feedback,RLHF)来干预增强学习以取得更好效果。 2.1 什么是Transformer? 本文重点介绍Transformer核心结构和技术点,略过训练优化部分。 编解码组件结构 Transformer 本质上是一个 Encoder-Decoder 架构,包括编码组件和解码组件。比如在机器翻译任务中,将一种语言的一个句子作为输入,然后将其翻译成另一种语言的一个句子作为输出。编码组件和解码组件可以有很多层,比如Google刚提出时的论文用的是6层,后面GPT-1是12层,然后到GPT-3是96层。 Encoder-Decoder 架构 每个编码器由两个子层组成:Self-Attention 层(自注意力层)和 Position-wise Feed Forward Network(前馈网络,缩写为 FFN),每个编码器的结构都是相同的,但是它们使用不同的权重参数。编码器的输入会先流入 Self-Attention 层。它可以让编码器在对特定词进行编码时使用输入句子中的其他词的信息(可以理解为:当我们翻译一个词时,不仅只关注当前的词,而且还会上下文关注其他词的信息)。 解码器也有编码器中这两层,但是它们之间还有一个编解码注意力层(即 Encoder-Decoder Attention),其用来帮助解码器关注输入句子中需要关注的相关部分。 Encoder-Decoder Attention 编码器对文本的处理 对文本处理和通常的 NLP 任务一样,首先使用词嵌入算法(Embedding)将每个词转换为一个词向量(vector)。在 Transformer 论文摘要提到词嵌入向量的维度是 512,所有编码器都会接收到包含多个大小为 512 的向量列表(List of vectors)。嵌入仅发生在最底层的编码器中,其他编码器接收的是上一个编码器的输出。这个列表大小是我们可以设置的参数——基本上这个参数就是训练数据集中最长句子的长度。对输入序列完成嵌入操作后,每个词都会流经编码器内的两层,然后逐个编码器向上传递。 编码器对文本的处理 Self-Attention 原理 之前说Transformer的自注意机制突破了文本关注距离的限制,因此非常关键。先看这样一个句子: The animal didn't cross the street because it was too tired 这个句子中的"it"代表什么意思,是animal,还是street还是其他?这个对人来说很容易,但对模型来说不简单。self-Attention就是用来解决这个问题,让it指向animal。通过加权之后可以得到类似图8的加权情况,The animal获得最大关注。 Self-Attention 原理 在self-attention中,每个单词有3个不同的向量,它们分别是Query向量( Q ),Key向量( K )和Value向量( V ),长度均是64。它们是通过3个不同的权值矩阵由嵌入向量 X 乘以三个不同的权值矩阵 W^Q , W^K ,W^V 得到,其中三个矩阵的尺寸也是相同的。均是 512×64 。 Query,Key,Value的概念取自于信息检索系统,举个简单的搜索的例子来说。当你在某电商平台搜索某件商品(年轻女士冬季穿的红色薄款羽绒服)时,你在搜索引擎上输入的内容便是Query,然后搜索引擎根据Query为你匹配Key(例如商品的种类,颜色,描述等),然后根据Query和Key的相似度得到匹配的内容(Value)。 self-attention中的Q,K,V也是起着类似的作用,在矩阵计算中,点积是计算两个矩阵相似度的方法之一,因此式1中使用了QK^T进行相似度的计算。接着便是根据相似度进行输出的匹配,这里使用了加权匹配的方式,而权值就是query与key的相似度。 多注意头机制 Multi-headed attention增强了自注意能力,其一是扩展了关注的位置,使之同时关注多个不同位置,其二是它为注意力层提供了多个“表示子空间”,如论文用了8个注意头,那就有8组不同的Q/K/V矩阵,每个输入的词向量都被投影到8个表示子空间中进行计算。 具体流程如下图,“Thinking Machines"的词向量经过最下面那层编码器后,使用不同的权重矩阵进行 8 次自注意力计算,就可以得到 8 个不同的 Z矩阵(0-7)。然后将8个Z矩阵拼接起来,和权重矩阵W0相乘,就得到最终的矩阵 Z,这个矩阵包含了所有注意力头的信息。这个矩阵会输入到 FFN 层。 矩阵会输入到 FFN 层 现在重新看之前的例子,在多注意头机制下,"it" 关注的词有哪些,顶部的8种颜色代表8个注意头,可以看到有个注意头最关注"the animal",另一个注意头关注"tired",从某种意义上说,模型对“it”这个词的表示融入了“animal”和“tired”的表示。 多注意头机制 因此多注意头本质上是用更多个角度进行注意力计算再统一起来,能够增强对句子上下文的完整理解。 解码器的联动 在解码器中,Transformer block比编码器中多了个encoder-cecoder attention。在encoder-decoder attention中,Q来自于解码器的上一个输出, K 和 V 则来自于编码器的输出。这些向量将在每个解码器的 Encoder-Decoder Attention 层被使用,帮助解码器把注意力关注到输入序列的合适位置。 下图显示在翻译I am a student过程中,每一轮解码器都生成一个词,如图示生成到"a"时,"a"会加入作为下一轮的输入Q,然后解码器结合输入和编码器的K、V,生成"student"。 2.2 ChatGPT是如何提升训练效果的? ChatGPT的背后是大型语言模型 (Large Language Model,LLM) 生成领域的新训练范式:RLHF (Reinforcement Learning from Human Feedback) ,即基于来自人类反馈的强化学习来优化语言模型。关于RLHF训练有个TAMER框架(Training an Agent Manually via Evaluative Reinforcement)值得参考。 RLHF 是一项涉及多个模型和不同训练阶段的复杂概念,这里我们按三个步骤分解: 预训练一个语言模型 (LM) ; 聚合问答数据并训练一个奖励模型 (Reward Model,RM) ; 用强化学习 (RL) 方式微调 LM。 GPT3训练后的大语言模型是根据概率分布,计算出下一个最大可能的词,他不管事实逻辑上的准确性,也没有所谓的意识,所以有时会一本正经地胡说八道。RLHF是用生成文本的人工反馈作为性能衡量标准,或更进一步用该反馈作为奖励来优化模型,使得在一般文本数据语料库上训练的语言模型能和复杂的人类价值观对齐。具体步骤如下: 首先,我们使用经典的预训练目标训练一个语言模型。对这一步的模型,OpenAI 在其第一个流行的 RLHF 模型 InstructGPT 中使用了较小版本的 GPT-3。然后进行以下步骤: 训练监督策略语言模型 GPT-3本身无法识别人类指令蕴含的不同意图,也很难判断生成内容是否高质量。为了解决这一问题,训练过程是从数据集中随机抽取问题,由标注人员给出高质量答案,相当于提供了一系列人工编写的prompts和对应的答案数据集。然后用这些人工标注好的数据集微调GPT3.5模型,获得SFT模型(Supervised Fine-Tune)。 训练奖励模型 训练方法:根据第一阶段的模型,随机抽取问题,给出多个不同的回答,人工选出最优答案进行标注,有点类似教学辅导。将高质量答案的奖励值进入下一轮强化学习RL,训练一个奖励模型来预测人类偏好的输出。 RM 的训练是 RLHF 区别于旧范式的开端。这一模型接收一系列文本并返回一个标量奖励,数值上对应人的偏好。我们可以用端到端的方式用 LM 建模,或者用模块化的系统建模 (比如对输出进行排名,再将排名转换为奖励) 。这一奖励数值将对后续无缝接入现有的强化学习 RL 算法至关重要。 关于模型选择方面,RM 可以是另一个经过微调的 LM,也可以是根据偏好数据从头开始训练的 LM。例如 Anthropic 提出了一种特殊的预训练方式,即用偏好模型预训练 (Preference Model Pretraining,PMP) 来替换一般预训练后的微调过程。微调LM被认为对样本数据的利用率更高,但对于哪种 RM 更好尚无定论。 近端策略优化 (Proximal Policy Optimization,PPO) 使用PPO优化奖励模型的策略。使用奖励模型的输出作为标量奖励,并使用PPO算法对监督策略进行微调,以优化该奖励。 训练方法:PPO的核心目的是将在线的人工学习转为离线学习,机器自己给自己打分。利用第二阶段训练好的奖励模型,在数据集中随机抽取问题,使用PPO模型生成多个回答,并用上一阶段训练好的RM模型分别给出质量分数。把回报分数按排序依次传递,产生策略梯度,通过强化学习的方式更新PPO模型参数。 最后步骤2和步骤3可以循环迭代,可以不断完善模型。 PPO算法补充说明: 长期以来出于工程和算法原因,人们认为用强化学习训练 LM 是不可能的。而目前多个组织找到的可行方案是使用策略梯度强化学习 (Policy Gradient RL) 算法、近端策略优化 (Proximal Policy Optimization,PPO) 微调初始 LM 的部分或全部参数。PPO 算法已经存在了相对较长的时间,有大量关于其原理的指南,因而成为 RLHF 中的有利选择。 我们将微调任务表述为 RL 问题。首先,该策略 (policy) 是一个接受提示并返回一系列文本 (或文本的概率分布) 的 LM。这个策略的行动空间 (action space) 是 LM 的词表对应的所有词元 (一般在 50k 数量级) ,观察空间 (observation space) 是可能的输入词元序列(词汇量 ^ 输入标记的数量,比较大) 。奖励函数是偏好模型和策略转变约束 (Policy shift constraint) 的结合。 PPO 算法确定的奖励函数具体计算如下:将提示x输入初始 LM 和当前微调的 LM,分别得到了输出文本y1,y2,将来自当前策略的文本传递给 RM 得到一个标量的奖励rθ。将两个模型的生成文本进行比较,计算差异的惩罚项,惩罚每个训练批次中生成大幅偏离初始模型的RL策略,以确保模型输出合理连贯的文本。 PPO 算法确定的奖励函数 总体来说,ChatGPT 在人工标注的prompts和回答里训练出SFT监督策略模型,再通过随机问题由模型给出多个答案,然后人工排序,生成奖励模型,再通过PPO强化训练增强奖励效果。最终ChatGPT能够更好理解指令的意图,并且按指令完成符合训练者价值观的输出。 最后,大语言模型作为一个被验证可行的方向,其“大”体现在数据集广泛,参数和层数大,计算量大,其价值体现在通用性上,有广泛的应用场景。大语言模型能够发展,主要还是模型具备很好的并行扩展性,随着数据量和计算量的增加,主要挑战在工程和调优上。海外除了GPT、还有LLama、PaLM等,国内目前也有很多相应的研究,因为很多基础技术以前就存在,最近国内追赶速度也很快,我们预期国内半年左右能够到GPT 3.5水平。NineData也非常看好这个方向,并且已经将大语言模型应用到NineData平台的SQL开发中,支持通过自然语言直接查找、变更数据,提供数据库问题和知识问答、数据库SQL优化建议等多项能力,后续我们还将推出更多有价值的功能,欢迎登陆使用。 https://www.ninedata.cloud 作者简介: 陈长城(天羽),玖章算术技术副总裁,前阿里云资深技术专家,在数据库领域深耕15年,主导了阿里数据库基础架构演进(IOE到分布式、异地多活、容器化存计分离)和云原生数据库工具体系建设。 陈长城(天羽),玖章算术技术副总裁,前阿里云资深技术专家 参考文献: Google Brain: “Attention is all you need” OpenAI: “Improving Language Understanding by Generative Pre-training” OpenAI: “Language Models are Unsupervised Multitask Learners” OpenAI: “Language Models are Few-Shot Learner” OpenAI: “Training language models to follow instructions with human feedback” Luke Cheng:https://github.com/huggingface/blog/blob/main/zh/rlhf.md Jay Alammar: http://jalammar.github.io/illustrated-transformer/

优秀的个人博客,低调大师

每日一博 | 如何优雅的处理异常

作者:京东零售 秦浩然 一、什么是异常 Java 语言按照错误严重性,从 throwale 根类衍生出 Error 和 Exception 两大派系。 Error(错误): 程序在执行过程中所遇到的硬件或操作系统的错误。错误对程序而言是致命的,将导致程序无法运行。常见的错误有内存溢出,jvm 虚拟机自身的非正常运行,calss 文件没有主方法。程序本生是不能处理错误的,只能依靠外界干预。Error 是系统内部的错误,由 jvm 抛出,交给系统来处理。 Exception(异常): 程序正常运行中,可以预料的意外情况。比如数据库连接中断,空指针,数组下标越界。异常出现可以导致程序非正常终止,也可以预先检测,被捕获处理掉,使程序继续运行。Exception(异常)按照性质,又分为编译异常(受检异常)和运行时异常(非受检异常)。 ◦ 编译异常: 又叫可检查异常,通常时由语法错和环境因素(外部资源)造成的异常。比如输入输出异常 IOException,数据库操作 SQLException。其特点是,Java 语言强制要求捕获和处理所有非运行时异常。通过行为规范,强化程序的健壮性和安全性。 ◦ 运行时异常: 又叫不检查异常 RuntimeException,这些异常一般是由程序逻辑错误引起的,即语义错。比如算术异常,空指针异常 NullPointerException,下标越界 IndexOutOfBoundsException。运行时异常应该在程序测试期间被暴露出来,由程序员去调试,而避免捕获。 二、处理异常方式 代码中,我们最常见到的处理异常的方式就是:try-catch try { // 业务逻辑 } catch (Exception e) { // 捕获到异常的逻辑 } 或者是再进一步区分下异常类型: try { // 业务逻辑 } catch (IOException ie) { // 捕获到IO异常的逻辑 } catch (Exception e) { // 捕获到其他异常的逻辑 } 三、如何抛出异常 我们通常可以用抛出异常的方式来控制代码流程,然后在网关处统一catch异常来返回错误code。这在一定程度上可以简化代码流程控制,如下所示: @Override public UserVO queryUser(Long id) { UserDO userDO = userMapper.queryUserById(id); if (Objects.isNull(userDO)) { throw new RuntimeException("用户不存在"); //用户不存在抛出异常 } return userDO.toVo(); } 上面这种抛出异常的方式,虽然简化了代码流程,但是在存在多种错误场景时,没有办法细分具体的错误类型。如:用户不存在的错误、用户没有权限的错误; 聪明如你,一定想到了自定义异常,如下: @Override public UserVO queryUser(Long id) { UserDO userDO = userMapper.queryUserById(id); if (Objects.isNull(userDO)) { throw new UserNotFoundException(); //用户不存在抛出对应异常 } if(!checkLicence(userDO)) { throw new BadLicenceException(); //用户无权限抛出对应异常 } return userDO.toVo(); } 确实,自定义异常可以解决错误场景细分的问题。进一步的,我们可以对系统流程不同阶段、不同业务类型分别自定义异常,但这需要自定义大量的异常; 四、如何优雅的抛出异常 上面的方式,可以区分出错误场景了,但是还存在一些缺点。如:可读性差、需要定义大量的自定义异常; 那我们下面就去优化上面的问题; 用断言增加代码的可读性; @Override public UserVO queryUser(Long id) { UserDO userDO = userMapper.queryUserById(id); Assert.notNull(userDO, "用户不存在"); //用断言进行参数的非空校验 return userDO.toVo(); } 断言虽然代码简洁、可读性好,但是缺乏像上述自定义异常一样可以明确区分错误场景,这就引出我们的究极方案:自定义断言; 自定义断言; 我们用自定义断言的方式,综合上面自定义异常和断言的优点,在断言失败后,抛出我们制定好的异常。代码如下: • 自定义异常基本类 @Getter @Setter public class BaseException extends RuntimeException { // 响应码 private IResponseEnum responseEnum; // 参数信息 private Object[] objs; public BaseException(String message, IResponseEnum responseEnum, Object[] objs) { super(message); this.responseEnum = responseEnum; this.objs = objs; } public BaseException(String message, Throwable cause, IResponseEnum responseEnum, Object[] objs) { super(message, cause); this.responseEnum = responseEnum; this.objs = objs; } } • 自定义断言接口 public interface MyAssert { /** * 创建自定义异常 * * @param objs 参数信息 * @return 自定义异常 */ BaseException newException(Object... objs); /** * 创建自定义异常 * * @param msg 描述信息 * @param objs 参数信息 * @return 自定义异常 */ BaseException newException(String msg, Object... objs); /** * 创建自定义异常 * * @param t 接收验证异常 * @param msg 描述信息 * @param objs 参数信息 * @return 自定义异常 */ BaseException newException(Throwable t, String msg, Object... objs); /** * 校验非空 * * @param obj 被验证对象 */ default void assertNotNull(Object obj, Object... objs) { if (obj == null) { throw newException(objs); } } /** * 校验非空 * * @param obj 被验证对象 */ default void assertNotNull(Object obj, String msg, Object... objs) { if (obj == null) { throw newException(msg, objs); } } } 上述代码我们可以看出基本设计,就是在我们自定义断言失败后抛出我们自定义异常。 下面是具体的实现案例: • 自定义业务异常类,继承自异常基本类 public class BusinessException extends BaseException { public BusinessException(IResponseEnum responseEnum, Object[] args, String msg) { super(msg, responseEnum, args); } public BusinessException(IResponseEnum responseEnum, Object[] args, String msg, Throwable t) { super(msg, t, responseEnum, args); } } • 响应code枚举接口定义 public interface IResponseEnum { /** * 返回code码 * * @return code码 */ String getCode(); /** * 返回描述信息 * * @return 描述信息 */ String getMsg(); } • 自定义业务异常类断言定义,实现自定义断言失败后对应的自定义异常的定义; public interface BusinessExceptionAssert extends IResponseEnum, MyAssert { @Override default BaseException newException(Object... args) { return new BusinessException(this, args, this.getMsg()); //断言失败后,抛出自定义异常 } @Override default BaseException newException(String msg, Object... args) { return new BusinessException(this, args, msg); //断言失败后,抛出自定义异常 } @Override default BaseException newException(Throwable t, String msg, Object... args) { return new BusinessException(this, args, msg, t); //断言失败后,抛出自定义异常 } } • 用枚举的方式,代替BadLicenceException、UserNotFoundException自定义异常。 public enum ResponseEnum implements IResponseEnum, BusinessExceptionAssert { BAD_LICENCE("0001", "无权访问"), USER_NOT_FOUND("1001", "用户不存在"), ; private final String code, msg; ResponseEnum(String code, String msg) { this.code = code; this.msg = msg; } @Override public String getCode() { return code; } @Override public String getMsg() { return msg; } } 使用实例 自定义断言失败抛出自定义异常 @Override public UserVO queryUser(Long id) { UserDO userDO = userMapper.queryUserById(id); ResponseEnum.USER_NOT_FOUND.assertNotNull(userDO); //自定义断言失败抛出自定义异常 return userDO.toVo(); } 网关处统一catch异常,识别异常场景 public static void main(String[] args) { UserService userService = new UserServiceImpl(new UserMapperImpl()); UserController userController = new UserController(userService); try { UserVO vo = userController.queryUser(2L); //执行业务逻辑 } catch (BusinessException e) { System.out.println(e.getResponseEnum().getCode()); //出现异常,错误code:1001 System.out.println(e.getMessage()); //出现异常,错误msg:用户不存在 } } 五、如何优雅的处理异常 网关处统一处理异常,这属于常规操作,这里不再赘述,简单举例如下: @ControllerAdvice public class BusinessExceptionHandler { @ExceptionHandler(value = BusinessException.class) @ResponseBody public Response handBusinessException(BaseException e) { return new Response(e.getResponseEnum().getCode(), e.getResponseEnum().getMsg()); //统一处理异常 } } 综上,我们采用自定义断言的方式,结合了断言的可读性高的优势和自定义异常区分错误场景的优势。并且,有新增的错误场景,我们只需要在错误码枚举中新增对应枚举即可。

优秀的个人博客,低调大师

每日一博 | 京东 LBS 推荐算法实践

作者:京东零售 郑书剑 1、推荐LBS业务介绍 1.1 业务场景 现有的同城购业务围绕京东即时零售能力搭建了到店、到家两种业务场景。同城业务与现有业务进行互补,利用高频,时效性快的特点,可以有效提升主站复访复购频次,是零售的重要战略方向。 1.2 名词解释 LBS:基于位置的服务(Location Based Services)。 下文LBS商品代指京东小时购商品;LBS推荐代指京东基于地理位置的推荐能力,需要考虑到附近的供给和履约能力。 B2C:直接面向消费者销售产品和服务商业的零售模式。 下文B2C商品代指京东主站商品,包括自营/pop等非小时购商品;B2C推荐指主站主流推荐能力,不需要考虑当前地理位置的供给,而是面向全国用户的推荐模式。 1.3 推荐模式 主要推荐模式集中在一下四种流量场域: 1、附近-商品推feeds推荐; 2、附近-纯门店推荐; 3、附近-门店-商品列表页推荐; 4、主站核心推荐场景lbs商品混排推荐(首页为你推荐、购物车、我的京东等); 2、推荐系统设计 目前主站核心场景从支持b2c商品推荐,b2c内容素材/聚合素材推荐拓展到更丰富的业务形式,支持lbs业务逻辑推荐,给用户带来更多元化的体验,同时给线下商家和运营提供了更丰富的流量渗透策略。 目前lbs商品推荐架构和b2c商品推荐架构的推荐流程紧密的耦合在一起,上线lbs商品推荐相关策略,都需要考虑到b2c推荐业务的逻辑无diff,效率低,兼容性差,迭代成本高,不利于后续优化策略的快速迭代。通过对lbs商品推荐的整体链路进行升级,与目前的b2c商品推荐链路进行解耦,提升系统的拓展性,更易维护,提高算法策略接入的效率。b2c商品和lbs商品均具备独立quota空间,推荐链路更加清晰,效果优化空间更大。 3、算法实践 3.1 概述 我们的前端展现形态分为纯商品、纯门店、门店-商品三种形态,且推荐位分布较多,为了减少人力维护成本,同时考虑到LBS推荐模式和传统电商模式的差异,以及流量场域分布和推荐展示形态的区别,我们针对LBS推荐能力进行了单独的设计,抽象出一套推荐模板可以同时解决三种推荐模式,支持跨场景复用。 首先前端请求入参用户当前的经纬度信息,推荐系统从gis系统获取当前可履约的门店信息;推荐系统根据用户个性化信息和门店-商品信息,为用户推荐感兴趣的附近门店-商品。 此时的item粒度为门店+商品粒度,为了同时保证用户对门店和商品兴趣的同时感知,区别于b2c商品的推荐模式,我们将整个系统分为两个阶段。在一阶段对用户感兴趣的门店进行推荐,在二阶段对用户的感兴趣的门店下的商品进行推荐。在两个阶段内完成门店推荐、商品推荐、门店-商品推荐三种模式,三种推荐模式可复用算子达到80+%,覆盖站点从京东主站到小程序,覆盖场景从首页-为你推荐到营销推荐位,总计覆盖核心推荐位30+。 3.2 LBS召回算法实践 3.2.1 背景概述 背景:LBS推荐是基于地理位置的推荐场景,和主站b2c推荐模式有所差异;用户对更多维度的因素敏感,如门店质量,配送距离,配送时效等等; 所以推荐系统需要在召回的时候就考虑到这些体验因素,所以我们将LBS的召回算法设计成两阶段的模式。一阶段根据用户兴趣(user-store兴趣)和门店质量(ka/销量/距离/时效)等因素召回用户感兴趣的高质量/距离近/配送快的门店。在二阶段进行商品召回用于召回用户感兴趣的商品。 同时我们面临着以下几个问题: 冷启问题:我们是新业务+新场景,新品多,新用户多,相比较成熟的b2c场景,lbs场景交互稀疏问题严重; 跨场域兴趣迁移:用户在b2c场景和lbs场景的兴趣表达往往是不一样的,不同场景的兴趣表达往往存在着一定的差异和联系,怎么精准捕捉和表达用户跨场景体现出的兴趣是新场景初期发展的重要工作; 兴趣激发周期短:lbs场景用户决策成本低,转化链路短,高转化场景下更要关注物品相关关系的表达; 我们初期也对以上几个问题进行了简单的探索,通过跨域兴趣探索和优化i2i关联关系简单的验证了我们的想法。 3.2.2 召回算法实践 1、冷启动召回 冷启动召回一般有以下几种方案: •商圈热门:缺点是和user无关,纯热门item召回,相关性差;这里我们将全局热销/poi热销商品作为兜底召回,用于补充; •cross domain:是一种基于不同场域(如京东b2c场景/lbs场景)共同用户的行为将不同域的用户映射到同一个向量空间,然后借助其他域的丰富行为提升本域冷启动用户的召回效果。 我们这里主要针对cross domain的方式进行了一些简单探索来优化跨场域用户的冷启体验效果。 1)潜客画像召回:根据用户在b2c场景的相关行为(诸如偏好类目是否为lbs转化优势类目)以及是否对lbs相关场景有前置行为的用户(推荐下浏览过附近/搜索内点击过小时购通栏等),来判断当前用户是否为lbs的潜在转化用户,给这些用户推荐其在b2c偏好下的高转化lbs商品; 2)跨域类目召回:通过对b2c/lbs共现商品进行挖掘,得到b2c到lbs的类目协同关系,根据用户在b2c场景下的偏好类目推荐对应的lbs类目下的商品; 3)跨域i2i召回:结合b2c/lbs的用户的跨场域行为,对lbs商品和b2c商品进行i2i关系挖掘,得到b2c sku到lbs sku的相似相关关系,使用b2c的用户行为为其推荐lbs商品; 4)间接召回:基于b2c召回结果,为用户召回相似相关的lbs商品。 2、i2i直接召回 基于用户在lbs场景的行为直接召回lbs商品,常见方法有如itemCF,swingCF等。 我们针对lbs场景高转化的特点对i2i召回进行了针对性的优化。我们对lbs场景的用户行为进行了分析,发现用户的点击行为体现了商品的相似性(同品比较等),订单行为体现了商品之间的相关关系(搭配购等),但是用户的订单行为往往非常稀疏,且考虑到lbs商品还含有地域属性,直接使用订单行为构建相关的i2i关系得到的结果非常稀疏,召回的下发占比往往比较低。 于是我们把订单的i2i关系抽象为类目-类目,产品词-产品词的的粗粒度相关关系。然后对全站lbs行为进行i2i关系挖掘,得到的结果使用粗粒度相关关系进行过滤,得到了比直接使用定订单行为构建i2i关系更丰富的结果,召回效率也比相似关系的效率更高。 3、向量化召回 i2i vs embed:i2i的相似相关关系表现的更加精准,但是覆盖率低;embed方式新颖性好,覆盖率高,但是关系表达相对不这么精准。 为了解决前文中提到的问题,对用户行为进行预处理,对异常用户和异常表现的商品先进行过滤,防止脏数据对整体数据分布造成影响,行为选取时,优先保留订单行为附近的用户行为(高质量行为),同时历史行为序列进行了session划分,保证行为的连续性和相关性,更能体现出用户决策周期内的集中兴趣,优化i-i的关联关系。 模型方面我们采用了随机游走的graph embedding建模方式,和传统方案差异不大:行为序列挖掘 -> 同构图构建 -> 带权重游走序列采样 -> skip-gram+负采样训练,得到物品的item embedding。 同时这里的用户行为序列的选取也可以参考跨域的思路,使用b2c行为进行补充,进一步解决lbs场域召回稀疏的问题。线上即可以使用i2i的方式进行召回,也可以使用u2i的方式进行召回。相比i2i直接召回,曝光占比更高,效率更高。 4、其他召回通道 还有诸如其他的根据品类兴趣和常购行为的兴趣画像召回,复购、常购召回等。 3.3 排序模型实践 排序准备方面,由于历史遗留原因,目前无论是用户在lbs场域的行为,还是lbs商品画像都有所缺失。于是第一步,我们首先对基础数据进行了维护:1)统一了全站lbs行为接入口径:通过门店pv和商详的pv埋点,捕捉全站lbs行为;2)建立了user-sku和user-store的用户画像和lbs商品画像。 排序特征方面:在复用了b2c商品的部分精排特征的基础上,构建了lbs场景的特有特征,如lbs场景用户行为序列,lbs场景商品/门店反馈特征,以及配送时效,配送费,配送距离等context类特征。 模型优化方面:引入了用户在b2c场景的用户行为,同时引入了b2c训练样本做样本增强。 模型结构方面:在模型输入的方面分为和b2c共享的部分,以及lbs独立特征输入的部分,异构b2c/lbs用户行为序列提取多场域用户兴趣,与B2C场景进行多场景联合优化。上线时进行拆图,仅使用lbs task tower进行打分。 4、总结 lbs推荐能力作为创新业务,我们通过模板化推荐能力,快速承接推荐位30+,支持三种推荐模式,初期快速的助力了全渠道的业务发展。 后续针对业务理解,经过对LBS推荐链路的独立拆分,以及召回和精排迭代优化。在首页-为你推荐上,lbs商品曝光UV占比相对Q3提升 488% ,CTR相对Q3提升159.52%。同时带动整体大盘指标提升,首页整体浏览深度显著提升0.39%,推荐整体uctr显著提升0.79%,推荐人均三级类目点击数显著提升0.76%,推荐外页uctr显著提升0.37%。 后续我们将继续结合场景特点和业务理解,逐渐完善优化LBS流量分发能力,更好服务商家和用户,提升京东LBS推荐能力。

优秀的个人博客,低调大师

每日一博 | 测试用例设计指南

作者:京东物流王玉坤 软件测试设计是测试过程中重要的测试活动,怎么样设计测试用例能提高我们测试的效率和质量,从以下几个方面做了简单的讲解。 1 测试用例设计原则 测试用例设计的基本原则包括:有效性、清晰性、可复用性、可维护性、完整性、兼容性、易操作性、可管理性、可评估性 有效性:测试用例步骤必须描述清晰,不能出现模棱两可的以及重复的话语,测试用例应该按照一定的顺序进行编写,这样执行的时候效率比较高。 清晰性:用例的操作步骤要描述清晰,包含清晰的输入数据以及预期输出,验证点必须明确清晰,并能突出重点,对于流程性的用例建议按照流程顺序进行用例安排,从第一个验证点到最后一个验证点,组成流程的开始到结束,方便测试执行。 测试用例包含前置条件的必须将前置条件描述清楚,包括入口等。 可复用性:可重复使用,并尽量将具有相似功能的测试用例抽象并归类。 可维护性:测试用例因为业务需求发生变更的时候,需要及时更新维护测试用例,做到测试用例的实时性与有效性,测试用例需要细化和不断的完善,是个循序渐进的过程。 完整性:用例是否完成并覆盖所有需求点,做到对需求的完全理解。 兼容性:测试用例要包含新老版本的兼容、新老数据兼容、浏览器兼容等测试点。 可管理性:能够检测测试人员的测试进度、工作量等。 可评估性:测试用例的通过率和缺陷的数目是评估软件质量的好坏的标准。 2 测试用例的生命周期 软件测试用例的设计阶段包含:需求分析、测试用例设计、测试用例实现、测试用例执行、测试用例管理 2.1 需求分析 测试用例过程的第一步是确定测什么,标识出测试点,并且对测试点进行优先级的划分。 2.2 测试用例设计 测试用例设计确定了如何来测试已经分析出的测试点。 测试设计的主要点是确定测试预期结果。为了确定测试预期结果,测试人员不仅需要关注测试输出,同时也需要注意测试数据和测试环境的前后置条件。假如测试用例没有测试的预期结果,则测试用例对于测试结果的对错判断是毫无意义的。 测试预期结果可以是各种各样的,包括需要创建或者输出的结果,也可以是需要更新或者变更的结果,也可以是删除的结果。每个测试用例都应该清楚的描述测试的预期结果。这样,就需要测试人员具有被测系统相关的丰富的知识和经验,才可能对软件系统的测试输出作出正确的评估。假如测试输出结果评估认为是正确的,那么就可以作为测试用例的期望输出结果。 2.3 测试用例实现 测试用例实现的过程包括准备测试脚本、测试输入、测试数据以及预期结果等。测试脚本指的是按照标准的语法组织数据或者指令。测试执行之前,首先必须满足测试前置条件,比如一个测试用例需要用到配置好的一些数据,那么这个数据就必须提前创建等。 2.4 测试用例执行 通过运行测试用例来对被测系统进行测试。对于手动测试来说,主要参照测试用例的步骤来进行测试执行,比较预期结果和实际结果、并记录测试过程中发现的问题。 对于自动化测试过程,执行时需要借助测试工具,运行测试用例脚本等,记录测试结果。 执行测试时如实际结果和预期结果是一样的,则认为是通过的,如果不一样,那用例执行失败,或存在问题,对于用例执行失败,需要进一步的检查,确定是软件问题还是用例的预期结果有问题,或者是数据问题,环境问题引起的,需要从不同的方面进行问题分析。 2.5 测试用例管理 1)测试用例组织 每一个项目,其测试用例的数目都非常多。如何来组织、跟踪和维护测试用例是一件非常重要的事情。如何来组织测试用例,是测试成功与否的一个重要因素,也是提高测试效率的一个重要步骤。 测试用例的组织,可以用不同的方法来进行组织或者分类: 按照软件功能模块组织:软件系统一般是根据软件的功能模块来进行工作任务分配的。因此,根据软件功能模块进行测试用例设计和执行等是很常用的一种方法。根据模块来组织测试用例,可以保证测试用例能够覆盖每个系统模块,达到较好的模块测试覆盖率。 按照测试用例优先级组织:测试用例是有优先级的。对于任何软件,实现穷尽测试是不现实的。在有限的资源和时间内,首先应该执行优先级高的测试用例。 按照功能模块进行划分是最常用的,我们也可以结合起来使用,比如在按照功能模块划分的基础上,再进行不同优先级的划分。 2)测试用例跟踪 测试用例的跟踪主要是针对测试执行过程中测试用例的状态来进行的,通过测试状态的跟踪和管理,从而实现测试过程和测试有效性的管理和评估。 测试用例执行的跟踪:在测试执行的过程中,对测试用例的状态进行跟踪,可以有效的将测试过程量化。比如,执行一轮测试过程中,测试的测试用例数目是多少,测试用例中通过、未通过、未测试的比例各是多少。这些数据可以提供一些信息来判断软件项目执行的质量和执行进度,并对测试进度、状态提供明确的数据,有利于测试进度和测试重点的控制。 3)测试用例维护 测试用例并不是一成不变的,当一个阶段测试过程结束后,会发现一些测试用例编写的不合理,或者需求发生了变化,这都需要对当前的一些测试用例进行修改和更新,从而使测试用例具有可复用性。 3 测试用例编写要素 用例编号:用例的唯一标识 测试模块:测试用例所属模块 用例标题:测试用例的简要说明 前提条件:用例执行的前提 测试步骤:执行用例步骤 预期结果:应该得到的结果 优先级:用例重要程度 4 功能测试用例设计方法 4.1 等价类划分法 等价类划分法的定义 输入具有代表性的数据子集 等价类划分法分类 有效等价类:满足需求的 无效等价类:不满足需求的 适用范围 具有单个输入的功能 步骤 明确需求 确定有效和无效等价类 编写测试用例 举例 需求:下单若是函速达,需要允许快递员修改,且限定包裹数必须为1,重量要<0.5kg。 4.2 边界值分析法 边界值的定义 对于输入等价类和输出等价类而言稍高于其边界或者稍低于其边界的一些特定情况 边界值范围 正好等于 刚刚好大于 刚刚好小于 边界值分析法中的三个点 上点:边界上的点 离点:距离边界最近的点 内点:范围内的点 举例:1-100 ,上点:1 100 离点:0 99 2 101 内点:50 适用范围 有输入参数,且输入类型或范围长度有边界时(适用于题目需求中有长度或者范围的情况) 和等价类一起使用,适用于单个功能的输入的情况 步骤 明确需求 确定有效和无效等价类 明确题目条件中的边界值 编写测试用例 举例 4.3 判定表法 适用条件 判定表表示的是有多个输入和多个输出,而且输入与输入之间相互的组合关系,输入和输出之间有相互的制约和依赖关系 组成部分 条件桩:题目条件中的所有的测试输入 动作桩:题目条件中的所有输出 条件项:测试输入的取值 动作项:测试输出的取值 步骤 明确条件桩 明确动作桩 对条件桩进行全组合 明确每个组合对应的动作桩 设计测试用例 举例 4.4 因果图法 因果图法定义 理论中是通向判定表的一个中间过程 适用范围 因果图是一种利用图解法来分析输入的各种组合情况,从而设计测试用例的方法,它适用于检查程序输入条件的各种组合情况 因果图法的核心 所谓的原因就是输入,所谓的结果就是输出。 因果图的因 —输入条件 因果图的果 -输入结果 因果图基本符号 关系 恒等:若Ci是1,则ei也是1;否则ei是0 非:若ci是1,则ei是0;否则ei是1 或:若c1或c2或c3是1,则ei是1;否则ei是0 与:若c1和c2都是1,则ei是1;否则ei是0 步骤 标识输入和输出 画出因果图 将因果图转换为判定表 生成测试用例 举例 需求:某软件规格说明书包含这样的要求:第一列字符必须是A或B,第二列字符必须是一个数字,在此情况下进行文件的修改,但如果第一列字符不正确,则给出信息L;如果第二列字符不是数字,则给出信息M。 转化为判定表 最终转化为测试用例。 4.5 正交分析法 定义 正交法又叫正交试验法,又叫正交排列法,使用最小的测试过程集合获得最大的测试覆盖率,(测试用例的条数写的少一点,而测出的bug多一点),正交试验设计法,是从大量的试验点中挑选出适量的,有代表性的点,应用依据伽罗瓦理论导出的“正交表”,合理安排试验的一种科学的试验设计方法。 正交表的概念:一种特制的表,一般的正交表标记为Ln(mk) n表示行数,也就是需要测试组合的次数 k表示的列数,表示控件的个数(因素的个数,或是因子的个数) m是每个控件包含的取值个数(各因素的水平数,即各因素的状态数) 如:L9( 34 ) 有4个控件 每个控件有3个取值 9为需要测试的组合个数、有9条测试用例 叫4因素3水平 步骤 根据需求形成因子状态表—-因子:控件名称 状态:每个控件对应的取值 确定所采用的正交表 将正交表中的数字用文字代替 一行就是一条测试用例 举例 注意 如果各个因子的状态数是不统一的,几乎不可能出现均匀的情况时,选择正交表为 等于或略大于因子数,状态数,且试验次数最少 生成正交试验表的一些方法 在线生成:https://jaccz.github.io/pairwise/tools.html 输入每个控件和控件的取值 生成的表 正交试验的实例表可套用到用例中http://www.york.ac.uk/depts/maths/tables/orthogonal.htm 正交试验的实例表可套用到用例中http://support.sas.com/techsup/technote/ts723_Designs.txt 4.6 场景法-流程图法 定义 模拟用户操作时的场景,主要用于测试多个功能之间的组合使用情况 为什么要用户场景法 用户角度:用户平时使用的不是单个功能,而是多个功能组合起来进行使用 测试人员角度:平时测试的都是单个功能点进行测试,为了保证测试的全面性,考虑多个功能之间组合测试的场景 场景法的适用范围 多个功能之间的组合测试 往往在冒烟测试时经常使用 场景法中两个重要的概念 基本流:按照正确的业务流程操作的一种路径 备选流:出现错误的操作流程 步骤 确定项目角色 明确角色的常用功能 根据需求构建测试场景 一个场景就是一条case 5 安全性测试设计 安全测试是在软件产品开发基本完成时,验证产品是否符合安全需求定义和产品质量标准的过程。安全测试是检查系统对非法侵入渗透的防范能力。 包含的测试点如下: sql注入 明文传输 越权访问 短信邮箱验证 鉴权缺失 密码安全 数据健壮性等

优秀的个人博客,低调大师

每日一博 | React Hooks 源码深度解析

作者:京东零售 郑炳懿 前言 React Hooks是React16.8 引入的一个新特性,它允许函数组件中使用state和其他 React 特性,而不必使用类组件。Hooks是一个非常重要的概念,因为它们提供了更简单、更易于理解的React开发体验。 React Hooks的核心源码主要包括两个部分:React内部的Hook管理器和一系列预置的Hook函数。 首先,让我们看一下React内部的Hook管理器。这个管理器是React内部的一个重要机制,它负责管理组件中的所有Hook,并确保它们在组件渲染期间以正确的顺序调用。 内部Hook管理器 示例: const Hook = { queue: [], current: null, }; function useState(initialState) { const state = Hook.current[Hook.queue.length]; if (!state) { Hook.queue.push({ state: typeof initialState === 'function' ? initialState() : initialState, setState(value) { this.state = value; render(); }, }); } return [state.state, state.setState.bind(state)]; } function useHook(callback) { Hook.current = { __proto__: Hook.current, }; try { callback(); } finally { Hook.current = Hook.current.__proto__; } } function render() { useHook(() => { const [count, setCount] = useState(0); console.log('count:', count); setTimeout(() => { setCount(count + 1); }, 1000); }); } render(); 在这个示例中,Hook对象有两个重要属性:queue和current。queue存储组件中所有Hook的状态和更新函数,current存储当前正在渲染的组件的Hook链表。useState和useHook函数则分别负责创建新的Hook状态和在组件中使用Hook。 预置 Hook 函数 useState Hook 以下是useState Hook的实现示例: function useState(initialState) { const hook = updateWorkInProgressHook(); if (!hook.memoizedState) { hook.memoizedState = [ typeof initialState === 'function' ? initialState() : initialState, action => { hook.queue.pending = true; hook.queue.dispatch = action; scheduleWork(); }, ]; } return hook.memoizedState; } 上述代码实现了useState Hook,其主要作用是返回一个state和更新函数的数组,state 初始值为initialState。 在这个实现中,updateWorkInProgressHook()函数用来获取当前正在执行的函数组件的 fiber 对象并判断是否存在对应的hook。它的实现如下: function updateWorkInProgressHook() { const fiber = getWorkInProgressFiber(); let hook = fiber.memoizedState; if (hook) { fiber.memoizedState = hook.next; hook.next = null; } else { hook = { memoizedState: null, queue: { pending: null, dispatch: null, last: null, }, next: null, }; } workInProgressHook = hook; return hook; } getWorkInProgressFiber()函数用来获取当前正在执行的函数组件的fiber对象,workInProgressHook则用来存储当前正在执行的hook对象。在函数组件中,每一个useState调用都会创建一个新的 hook 对象,并将其添加到fiber对象的hooks链表中。这个hooks链表是通过fiber对象的memoizedState属性来维护的。 我们还需要注意到在useState Hook的实现中,每一个hook对象都包含了一个queue对象,用来存储待更新的状态以及更新函数。scheduleWork()函数则用来通知React调度器有任务需要执行。 在React的源码中,useState函数实际上是一个叫做useStateImpl的内部函数。 下面是useStateImpl的源码: function useStateImpl<S>(initialState: (() => S) | S): [S, Dispatch<SetStateAction<S>>] { const dispatcher = resolveDispatcher(); return dispatcher.useState(initialState); } 可以看到,useStateImpl函数的作用就是获取当前的dispatcher并调用它的useState方法,返回一个数组,第一个元素是状态的值,第二个元素是一个dispatch函数,用来更新状态。这里的resolveDispatcher函数用来获取当前的dispatcher,其实现如下: function resolveDispatcher(): Dispatcher { const dispatcher = currentlyRenderingFiber?.dispatcher; if (dispatcher === undefined) { throw new Error('Hooks can only be called inside the body of a function component. (https://fb.me/react-invalid-hook-call)'); } return dispatcher; } resolveDispatcher函数首先尝试获取当前正在渲染的fiber对象的dispatcher属性,如果获取不到则说 明当前不在组件的渲染过程中,就会抛出一个错误。 最后,我们来看一下useState方法在具体的dispatcher实现中是如何实现的。我们以useReducer的 dispatcher为例,它的实现如下: export function useReducer<S, A>( reducer: (prevState: S, action: A) => S, initialState: S, initialAction?: A, ): [S, Dispatch<A>] { const [dispatch, currentState] = updateReducer<S, A>( reducer, // $FlowFixMe: Flow doesn't like mixed types [initialState, initialAction], // $FlowFixMe: Flow doesn't like mixed types reducer === basicStateReducer ? basicStateReducer : updateStateReducer, ); return [currentState, dispatch]; } 可以看到,useReducer方法实际上是调用了一个叫做updateReducer的函数,返回了一个包含当前状态和dispatch函数的数组。updateReducer的实现比较复杂,涉及到了很多细节,这里不再展开介绍。 useEffect Hook useEffect是React中常用的一个Hook函数,用于在组件中执行副作用操作,例如访问远程数据、添加/移除事件监听器、手动操作DOM等等。useEffect的核心功能是在组件的渲染过程结束之后异步执行回调函数,它的实现方式涉及到 React 中的异步渲染机制。 以下是useEffect Hook的实现示例: function useEffect(callback, dependencies) { // 通过调用 useLayoutEffect 或者 useEffect 方法来获取当前的渲染批次 const batch = useContext(BatchContext); // 根据当前的渲染批次判断是否需要执行回调函数 if (shouldFireEffect(batch, dependencies)) { callback(); } // 在组件被卸载时清除当前 effect 的状态信息 return () => clearEffect(batch); } 在这个示例中,useEffect接收两个参数:回调函数和依赖项数组。当依赖项数组中的任何一个值发生变化时, React会在下一次渲染时重新执行useEffect中传入的回调函数。 useEffect函数的实现方式主要依赖于React中的异步渲染机制。当一个组件需要重新渲染时,React会将所有的state更新操作加入到一个队列中,在当前渲染批次结束之后再异步执行这些更新操作,从而避免在同一个渲染批次中连续执行多次更新操作。 在useEffect函数中,我们通过调用useContext(BatchContext)方法来获取当前的渲染批次,并根据shouldFireEffect方法判断是否需要执行回调函数。在回调函数执行完毕后,我们需要通过clearEffect方法来清除当前effect的状态信息,避免对后续的渲染批次产生影响。 总结 总的来说,React Hooks的实现原理并不复杂,它主要依赖于React内部的fiber数据结构和调度系统,通过这些机制来实现对组件状态的管理和更新。Hooks能够让我们在函数组件中使用状态和其他React特性,使得函数组件的功能可以和类组件媲美。 除了useState、useEffect等hook,React还有useContext等常用的Hook。它们的实现原理也基本相似,都是利用fiber架构来实现状态管理和生命周期钩子等功能。 以上是hook简单实现示例,它们并不是React中实际使用的代码,但是可以帮助我们更好地理解hook的核心实现方式。

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册