首页 文章 精选 留言 我的

精选列表

搜索[日活数],共10000篇文章
优秀的个人博客,低调大师

开源数仓 Greenplum 归档:Cloudberry Database 接棒再出发

引子 近日,知名开源数据仓库项目 Greenplum Database 的 GitHub 仓库被突然归档,引发了数据库社区的极大关注。Greenplum Database 作为成熟优秀的金融级数据仓库项目,在国内外拥有丰富的落地案例。作为 Greenplum Database 生态一员,我们对此感到十分可惜。 由于多种考虑,我们于去年发起了 Cloudberry Database ── 一个 Greenplum Database 的衍生项目,能够实现对 Greenplum Database 的原生兼容且无缝迁移,但没有对外大规模推广,一直潜心开发和打磨。鉴于当前 Greenplum Database 事件突发,我们想聊一聊我们的观察和思考。 正文 Greenplum Database 自 2003 年诞生起至今已有超过 20 多年的演进历史,自其 2015 年宣布开源以来至今已有近 10 年的发展历史。Greenplum 基于 Postgres 并采用大规模并行处理架构(MPP)打造的、支持 PB 量级的分布式数据仓库系统,也影响了其他后来同类产品的发展。Greenplum Database 拥有众多丰富的用户案例,在包括金融、电信运营商、制造业等在内的众多行业落地并扮演关键的数据平台角色,历经数十年打磨,成为最为成熟的数据仓库和大规模数据分析解决方案之一。 很多人常规的认知是将大数据与 Hadoop 划了等号,但事实不是这样。面对同一个问题,解决方案多种多样,而不是唯一。我们看到 Hadoop 在大数据分析的普及和市场培养方面发挥了关键作用,但它自身诸多缺陷让它在大多数分析场景下成为负担,如 Hadoop 技术堆栈过于复杂、组件过多,对于中小企业来说如果构建起一套完整的 Hadoop 大数据分析方案,必须拥有一支具备顶尖技术的专家团队,这对大多数中小企业来说投入过大。相比 Hadoop 的大数据分析解决方案,Greenplum Database 基于 MPP 架构,利用分布式查询,在分析效能、SQL 支持度、部署和运维成本方面具有明显的优势。 当然,我们不能说 Greenplum Database 很完美。随着数据源愈发多样、各种业务场景对数据的分析处理能力要求愈发复杂,近年来如 AI/机器学习、流处理、实时计算、图计算、时序数据、湖仓等新的计算需求迸发和业务架构演进,这对传统的分析系统发起了挑战。我们可以看到来自开源基金会及各服务厂商面对新需求新挑战推出了很多有竞争力的开源项目和商业化服务。 在万马驰骋的时代,Greenplum Database 能够有所应对但还不够。Greenplum Database 原维护团队或利用现有的 PostgreSQL 生态扩展或自研扩展来支持相关方向需求,如联合多所高校发起开源机器学习项目 Apache MADlib 实现数据库内分析、利用 PostGIS 实现地理空间数据的分析等。但 Greenplum Database 本身是由商业公司所有,很多场景所需的先进功能仅存在于商业公司推出的企业版本,社区用户除了付费购买企业版、或投入巨大的研发力量自己定制开发外无法获得更多亟需的能力。 当前用户格外关注数据库系统性能和安全特性,Greenplum Database 社区版本在此投入资源也不多。Greenplum Database 在 PostgreSQL 内核升级方面非常缓慢,许多来自 PostgreSQL 上游的先进特性与功能无法快速推送给社区用户,经过多年推动才将内核升级到 PostgreSQL 12 但很快 PostgreSQL 官方将于 2024 年 11 月停止维护这一版本。 近年来 Greenplum Database 在新功能推出、更新步伐上多是小修小补,特别是在数据库性能方面也没有明显的改进,与其他涌现出来的新生代开源项目竞争缺乏声量。 发起 Cloudberry Database 我们对 Greenplum Database 怀有感情,抱有热情,并且相信 Greenplum Database 可以持续拥有更加美好的发展前景,但我们也在问自己——如何才能实现这一初衷呢?这个课题在我们团队内部酝酿了多年,经常拿出来碰撞脑暴,最终我们的解决方案是另起炉灶,发起 Cloudberry Database 开源项目。 我们团队的数据库开发者一大部分来自 EMC/Pivotal/VMware 公司,都是 Greenplum Database 原始团队核心成员或决策者,曾经在一起共事互相熟悉,大部分人亲力推动 Greenplum Database 从闭源到开源、社区从小到大,一路走来,这就是我们对 Greenplum Database 怀有感情的原因。目前我们是除了 VMware(现归属博通)外拥有 Greenplum 原始开发者数量第一大的团队,技术储备和实力处于绝对靠前位置。 我们自己大部分都是多年的开源开发者,除了深度参与 Greenplum Database 开源或商业开发外,还拥有一批 Apache HAWQ PMC 成员及 Committer、Apache MADlib 和 PostgreSQL 等开源项目贡献者。我们熟悉社区驱动的开发机制,懂得“上游优先”(Upstream First)的道理,认同开源带来的潜力和价值。在过去几年,我们坚持向 Greenplum Database 和 PostgreSQL 上游提交贡献、反馈我们在商业客户获得的修改建议。但向 Greenplum Database 贡献能被接受的仅限于小修小改,稍大的功能和变动我们无法掌握主动权,难以合并到 Greenplum Database 代码主分支。 Greenplum Database 虽然说是开源项目,但从底层上来说它所属于一家商业公司并由其掌控,缺乏社区决策和达成共识的机制。很明显,我们期待的 Greenplum Database 发展步调、路线图与官方团队很不一样,我们理解并尊重 Greenplum Database 团队的做事风格。 同时,过去几年我们看到 Greenplum Database 的商业公司归属和维护团队始终处于动荡之中,这给社区和用户信心带来动摇,增加了不确定性。2023 年博通宣布收购 VMware 这一事件又让不确定性加重,直到今天我们看到 Greenplum Database 在 GitHub 上的源码仓库已被归档,项目全部过往 Issue、Pull Request 等记录已经消失、中文网站也不可访问,这对一个知名开源项目来说是不可承受之重,覆水难收再难回头。虽说还可以继续下载项目源码,但这种铲除社区根基的操作相当于为社区判了死刑、让社区用户信心归零。没有社区,代码只能是代码,不可能继续演化且保持蓬勃生机。 单独维护分支、另起炉灶是个艰难的事情,需要研发、运营等资源大量投入,经过多年的探索和技术积累,我们形成了健康的商业循环,确保既能够支撑业务正常运转又能长期投入开源。我们在 2023 年 6 月底公开了 Cloudberry Database 仓库,如上所述,这一过程酝酿了多年也准备了多年,不是仓促之举。我们在代码仓库公开后并没有对外大规模宣传推广,一直在梳理过去数年我们在 Greenplum Database 上的技术储备和改进并制定计划将其一一开源出来,只是没有料到 Greenplum Database 的变动来得如此之快! 我们的工作概述 针对社区用户亟需 Greenplum Database 优化的地方,我们制定了路线图(https://github.com/orgs/cloudberrydb/discussions/369)并在逐步改进,这是 Cloudberry Database 发挥独特价值之处。如果你有其他需求或建议,欢迎在 GitHub 留言讨论。 下面和大家简单介绍下我们计划、正在进行或已完成的一些工作。 支持轻松升级 PostgreSQL 内核版本。 原有 Greenplum Database 功能实现对 PostgreSQL 内核具有很强的侵入性,导致升级 PostgreSQL 版本非常困难。我们采取当前 PostgreSQL 生态流行的方式,以“扩展插件/Library”模式重构部分功能实现,降低与 PostgreSQL 内核的强耦合度,可以轻松实现 PostgreSQL 内核版本升级。如果你想在 Cloudberry Database 中增加什么功能,都可以像拼积木一样灵活扩展,这一策略贯穿到整个 Cloudberry Database 设计与开发之中。(已开源) 支持统一管理非结构化数据。 面对 AI 应用带来的非结构化数据管理挑战,我们在 Cloudberry Database 中引入了“Directory Table”概念特性,用于存储、管理和分析非结构化数据对象,实现集中管理和统一处理文档、音视频等非结构化数据。在此基础上,用户只需要使用简单的 SQL 语句就可以调用各种计算引擎,实现高效的数据加工和应用开发,降低非结构化语料数据的处理成本。(已开源) 多场景综合优化性能。 性能优化是个系统工程,涉及到多个方面,不同场景处理方式也不一样。我们重点推动了,如: 实现向量化,提升查询性能。当需要处理大规模数据集时,向量化执行引擎可以显著提高计算效率。通过将数据向量化,可以同时处理多个数据元素,利用并行计算和 SIMD 指令集加速计算过程。我们内部已经实现基于 Cloudberry Database 内核的向量化插件,会明显提升优化查询语句的性能。(准备开源) 下推聚集运算。聚集下推是使聚集操作的运算更接近数据源的一种优化技术。目前 Cloudberry Database 已支持将聚集运算下推,即将聚集算子提前到连接算子之前进行计算。在合适的场景下,聚集下推能够明显地减少连接算子或者聚集算子的输入集大小,进而提升算子的执行性能。(已开源) 实现增量物化视图、自动物化视图支持查询优化。(已开源) 增量物化视图是物化视图的一种特殊形式,当数据在基础表中发生变化时(例如插入、更新、删除操作),增量物化视图不需要重新计算整个视图中的所有数据。相反,它只更新那些自上次刷新以来发生变化的部分,这样可以节省大量的计算资源和时间,显著提高性能,尤其是在处理大型数据集时。 支持在查询规划阶段自动使用物化视图来计算部分或全部查询(即 AQUMV),这一功能特别适用于在大表上进行的查询,能显著提高查询处理时间。 使用 RuntimeFilter 优化 HashJoin 查询性能。RuntimeFilter 是在执行 HashJoin 运算时,实时产生过滤器 (Filter) 的优化技术,可以在执行 HashJoin 前预先对数据进行筛选,更快地执行 HashJoin。在某些场景下,通过 RuntimeFilter 优化能够使执行效率翻倍。HashJoin 常用于小表和大表的连接。Cloudberry Database 在执行 HashJoin 运算时,通常基于待连接的两表中较小的表来构建哈希表,然后循环地根据较大表中的元组,在哈希表中查找连接键匹配的元组来实现连接。(已开源) 同时,我们还实现了动态分区消除、针对不同运算符在查询不同阶段予以释放或重新分配内存、并发创建索引、并发执行查询、AO/AOCO 索引扫描(IndexScan)支持,以及提供基于规则的查询优化手段和基于代价的查询优化手段帮助用户生成更高效的查询执行计划等等。(已开源) 实现行列混合存储。 我们基于 Cloudberry Database 实现了行列混合存储方案,该方案结合了行式存储和列式存储的优点,旨在提高数据库的查询性能,尤其是缓存效率。该方案适合处理大量写入和频繁查询的复杂 OLAP 应用,既适应云环境下基于对象存储的存储模型,也能适应线下传统基于物理文件的存储方式。(准备开源) 支持全文检索引擎。 我们使用 ZomboDB 支持 Cloudberry Database 和 Elasticsearch 协同工作,让 Cloudberry Database 拥有 Elasticsearch 丰富的全文检索和文本分析能力。ZomboDB 支持大多数 Cloudberry Database 的 SQL 语法,可以管理 Elasticsearch 集群上的索引,并且保证事务层面上文本检索的正确性。(准备开源) 实现安全增强。 除 PostgreSQL 原有安全插件外,Cloudberry Database 提供了丰富的权限设置选项,满足不同用户和不同级别的对象需求,支持配置密码安全策略,可将策略应用于一个或多个用户,支持密码强度检查;支持数据脱敏或漂白,去除数据中的敏感信息;支持透明数据加密 TDE 功能,提升静态数据的安全性;除支持常用的 AES 加密算法外,支持国密算法、密文认证等等。(已开源) 支持集群弹性扩缩容。 Greenplum Database 已实现一定的集群扩容功能,Cloudberry Database 在此基础上将其持续增强,并实现了在集群资源空闲时的集群缩容功能。(已开源) 友好的图形化管理工具。 我们正在实现 Cloudberry Database 的图形化管理工具,可支持用户在图形界面中部署 Cloudberry Database 集群,可以提供各个粒度包括集群级、表级、Query 级的监控信息,支持 SQL Editor 等。(准备开源) 我们也将推动流处理、湖仓一体等方案开源,通过连接器(Connector)或 Foreign Data Wrapper(FDW)形式,从 Kafka 中加载实时数据,或将 Hive 集群数据(含 Iceberg 和 Hudi 表格式)加载到 Cloudberry Database,打通数据仓库和数据湖;推动适配国产操作系统和服务器等等。(准备开源) 我们的原则与态度 站在巨人的肩膀上,反哺上游 向 PostgreSQL、Greenplum Database 等伟大开源项目及背后参与的公司、个人及强大的社区致敬!我们没有“独我创造”的执念,没有完全从头来过。站在巨人的肩膀上,这是加速创新的方式,也是开源带来的益处。我们认为借助现有优秀开源技术加上创新,并提供良好的产品体验,也会赢得用户和社区的信任。 我们不会刻意制造 Cloudberry Database 与 Greenplum Database 两个项目的冲突,也不会在媒体上抨击 Greenplum Database 来彰显自己,而是计划将在 Cloudberry Database 做出的创新,如果仍适用于 Greenplum Database,像之前一样将其贡献回 Greenplum Database,虽然达成共识有很大难度,但现在看来这一愿望彻底没法实现了。我们决定后续更加专注于反哺贡献 PostgreSQL 上游,虽然 PostgreSQL 对贡献的接受更是难上加难。 关注体验,不刻意制造障碍 我们的目标是保持 Cloudberry Database 对 Greenplum Database 的原生级兼容和无缝迁移,努力让大家以原先使用 Greenplum Database 的方式继续使用 Cloudberry Database。不会为了刻意强调某些功能特性源自我而非源自它而人为制造阻碍,或者搞一些特立独行,这样做体验不会好。我们尽力保持原有的 Greenplum Database 体验和习惯,但不可避免还是会存在一些不同,因为有些地方总需要改变才能创新。 坚持宽容开源协议 在许可协议上,我们采用了较为宽容的 Apache License V2.0,你可以自由使用、复制、修改、或将 Cloudberry Database 再分发或打包成自己的商业产品与服务。我们不担心你的商业服务与我们产生冲突,这反而会促进社区和生态的繁荣,这就是我们采用 Apache License 许可的原因。 保持开放 我们欢迎同行团队参与维护,不对任何团队设置门槛,努力构建开放、基于社区的开发和决策机制。Greenplum Database 在国内有着丰富的生态和衍生版本,较大的云服务商几乎都提供了基于 Greenplum Database 的商业数据仓库服务。我们了解到这些团队都在从事重复的开发工作,社区力量没有得到集中。 我们欢迎大家参与到 Cloudberry Database 项目和社区中来,集结力量重新出发。 展望 社区治理 当前我们没有制定比较复杂的社区治理规则,即使制定了规则文本,社区也并不会按照刻意设置的路径发展,过早设计也容易束缚整个社区的创造力和活力。相信随着 Cloudberry Database 社区成员越来越多样化,将会诞生更加符合项目的社区治理方式。坚持开放,分享决策,期待好的创意生长出来。 我们拥有保持项目中立的初心,但如何从机制和底层上来长期坚持呢?将 Cloudberry Database 捐赠给开源基金会是一个比较合理的选项。目前很多开源基金会都有比较成熟的项目和社区治理体系,此举可以让项目得到更好的孵化。我们正在与相关基金会孵化器导师密切沟通之中,期待后续有明显的进展。 持续开发,携手前行 我们发起 Cloudberry Database 的决策对于我们来说虽然困难,但不孤单。很多合作伙伴和用户在我们仓库公开前就已经加入进来,开始着手将 Cloudberry Database 部署在关键业务上,与我们一起打磨和优化。 通过上面的工作概述,相信大家也能看到我们的目标很大,正在/计划推进的事项非常之多,很多功能特性、以及周边组件、文档的工作量巨大,单凭有限力量很难快速推出,在此诚邀原有 Greenplum 生态企业加入进来,携手向世界交付一个优秀的开源项目! 关于 Cloudberry Database Cloudberry Database是面向分析和 AI 场景打造的下一代统一型开源数据库。作为 Greenplum 衍生版本,兼容 Greenplum 生态,同时搭载 PostgreSQL 14.4 内核,具备众多 Greenplum 不具备的特性功能,支持丰富的数据类型和数仓 / AI 混合负载,可开展 SQL 分析、机器学习、全文检索、HTAP 等任务,通过数据存储加密、联合⾝份验证等技术手段,帮助企业更方便地自建高效稳定的数据底座。

优秀的个人博客,低调大师

Windows 11 月活跃设备数超过 4 亿台

根据 Windows Central 的报道,微软内部数据显示,目前运行 Windows 11 的月活跃设备已超过 4 亿台,并且正在稳步增长,预计到 2024 年初达到 5 亿台。 从这份数据来看,Windows 11普及率明显要比上一代 Windows 10 更慢。Windows 11 于 2021 年 10 月发布,这意味着它花了大约两年的时间才达到这一里程碑,相比 Windows 10 要慢得多,后者在一年多的时间里就达到了同样的水平。 Windows Central 称,采用率的差异可归因于两个操作系统不同的发布策略。Windows 10 最初作为 Windows 7 和 Windows 8 的限时免费升级而推出,微软一直在敦促用户在免费升级期结束前尽快升级。 相比之下,Windows 11 的发布较为平静,而且由于 TPM 的要求,支持的 PC 数量较少,因此采用率较低。 虽然 Windows 11 采用率到达里程碑的速度没有 Windows 10 快,但这也已经超出了微软自己对 Windows 11 采用率的预期。 根据流量监测机构 StatCounter 的数据,Windows 10 仍然以 71.62% 的市场份额牢牢控制着桌面 Windows 市场。与此同时,Windows 11 占所有 Windows 桌面安装量的 23.64%。Windows 7 的市场份额下降到 3.33%,而 Windows XP 的市场份额仅为 0.34%。 根据微软的内部指标,Windows 11 的势头很强劲。尽管最初存在争议和兼容性问题,但微软通过频繁的更新和预览选项,让 Windows 11 对新设备和现有设备都充满了吸引力。

优秀的个人博客,低调大师

对比分析数仓中行列存的特性

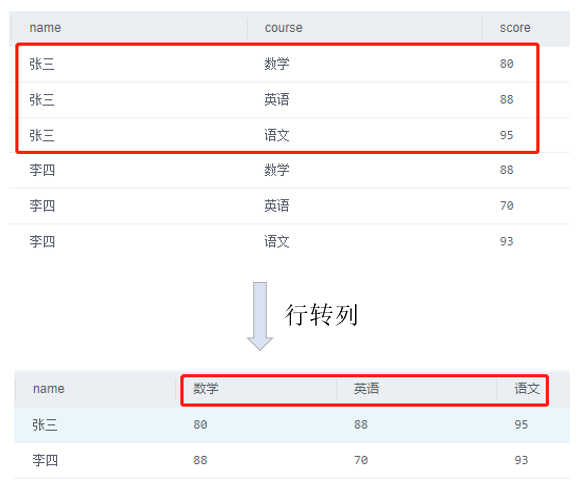
摘要:行存表示了一种数据的存储方式,是最传统的一种存储方式。 本文分享自华为云社区《【玩转PB级数仓GaussDB(DWS)】行列存对比的一些事》,作者:sevenjiang。 行存表示了一种数据的存储方式,是最传统的一种存储方式。对于GaussDB(DWS)来说可以认为其表示存储引擎的基础实现,在其之上逐步构筑了列存和hdfs之类的存储特性。如下简单介绍下行列存使用的一些对比。 集群设置介绍: 参数default_orientation控制建表不指定存储方式的默认行为。 通过如下建表显式设置可以指定行列存储: ORIENTATION 指定表数据的存储方式,即行存方式、列存方式,该参数设置成功后就不再支持修改。 取值范围: • ROW,表示表的数据将以行式存储。 行存储适合于OLTP业务,此类型的表上交互事务比较多,一次交互会涉及表中的多个列,用行存查询效率较高。 • COLUMN,表示表的数据将以列式存储。 列存储适合于数据仓库业务,此类型的表上会做大量的汇聚计算,且涉及的列操作较少 适用场景: 列储存优势: 列的数据特征比较相似,适合压缩,压缩比很高; 表列的个数比较多,但是访问的列个数比较少, 列存可以大大减少不必要的IO读, 提高性能; 基于列批量数据的运算,CPU的cache命中率比较高,性能比较好; 列存储引擎更适合OLAP大数据统计分析的场景。 列储存劣势: 列存表(delta表但默认并没有启用)不适合小量 insert 及update操作 行存储优势: 点查询(返回记录少,基于索引的简单查询); 增、删、改操作较多的场景; 主要使用整张表的内容,而不是单独某几个列,并且所关注的内容不需要通过任何聚集运算,推荐使用行式存储。 对比现状: 类型支持范围不同; 不支持表达式索引,索引失效; 行存默认btree索引,列存默认psort,主健是813版本支持的,老版本不支持; 老版本列存复制表不支持更新,813版本支持 ; 表级的check约束列存不支持 ; cu锁的问题,并发更新会报错 ; 没有并发更新,但是开启delta表,更新/delete概率出错; 小CU的问题突出,引发空间膨胀,性能问题等 ; exchange要求表的with中option一致; 列存导入实现方式: 列存表推荐使用批量插入(INSERT INTO SELECT/COPY),单行记录插入会造成空间浪费,访问效率下降; 导入数据按列缓存,默认每60000行(通过max_batchrow修改)或者1G的大小生成CU; 生成CU时,根据数据类型,默认low压缩级别(通过compression修改),进行压缩。 先写入CUDesc,再写入CU,同时将CU插入到数据复制队列。最后写入VCU; CU文件是追加写(APPEND ONLY)。 分区表注意: 每一个分区是一个独立的列存表; vector batch的进入,单条数据进入bulkload_row; 下盘、读取的处理; 内存自适应。 存在行列存join情况: 行存列存JOIN 转换的执行计划不符合预期,可以通过 set enable_force_vector_engine = on; 进行下优化: enable_force_vector_engine 参数说明:对于支持向量化的执行器算子,如果其子节点是非向量化的算子,通过设置此参数为on,强制生成向量化的执行计划。 当打开enable_force_vector_engine开关时,无论是行存表、列存表或者是行列混存,如果plantree中不包含不支持向量化的场景,则强制走向量化执行引擎。 参数类型:USERSET 取值范围:布尔型 默认值:off 手工基础行转列操作,如果表有业务执行,需要进行加锁或者事务中执行,视图和索引进行单独处理: create table schema.row_table1 (like schema.table1 including all EXCLUDING RELOPTIONS EXCLUDING INDEXES) WITH (ORIENTATION=column; insert into schema.row_table1 select * from schema.table1; ALTER TABLE schema.row_table1 ADD CONSTRAINT row_table1_pk PRIMARY KEY (xxx_id); alter table rename schema.table1 to col_table1; alter table rename schema.row_table1 to table1; 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册