首页 文章 精选 留言 我的

精选列表

搜索[AI功能],共10000篇文章
优秀的个人博客,低调大师

GitHub 宣布禁用 Google FLoC 功能

GitHub 宣布在所有 GitHub Pages 网站上推出一个新的 HTTP 标头,使用户能够从他们的 GitHub 仓库中直接创建网站。实际上,GitHub 网站返回的这个标头,是为了让网站所有者选择不接受谷歌 FLoC 追踪。 随着对用户隐私保护的重视,越来越多的浏览器已经开始阻止广告商的第三方 cookies。对此,Google 推出了一项名为 Federated Learning of Cohorts(即FLoC)的新广告追踪技术。FLoC 的工作原理是将数千名具有相似浏览历史的用户归为一个 "用户群( cohort )",这个 "用户群" 是通过设备上的机器学习分析你的网络浏览历史而创建的。你所访问的网站列表不会暴露出来(联合学习),只有 "用户群 ID "会暴露并用于广告。 相对于服务器(或广告网络)在全球范围内跟踪用户并记录他们的浏览历史来说,FLoC 将这一责任交给了用户的个人网络浏览器。也就是说,每个被选为FLoC 试验的谷歌浏览器实例都将被归入特定的 "群组",或最能代表其最近网络浏览习惯的群体。在本地存储的具有相同浏览历史的数千个浏览器(属于同一 "群组")将被分配一个共享的 "群组 "标识符,当被要求时,将与一个网站共享。 然而,谷歌用 FLOC 取代第三方追踪 cookies 的提议遭到了许多业内人士的抵制,包括 EFF、微软、Mozilla Firefox、WordPress、Vivaldi、Brave 和 DuckDuckGo,他们反对任何形式的用户追踪。现在,整个 github.com 域名都设置了这个头,表明 GitHub 不希望其访问者在访问任何 GitHub 页面时被纳入谷歌 FLoC的 "队列 "中。 有趣的是,GitHub 关于这个话题的公告相当简洁,其中没有提到谷歌 FLoC 的地方,昨天发布的博客文章仅仅说明 "所有由 github.io 域名提供服务的 GitHub Pages 网站现在都会有一个 Permissions-Policy: interest-cohort=() 头的设置"。据悉,目前 FLoC 仅在澳大利亚、巴西、加拿大、印度、印度尼西亚、日本、墨西哥、新西兰、菲律宾和美国的 "一小部分用户" 中推出。

优秀的个人博客,低调大师

BeetlSQL 3.2.10 发布,Query 功能增强

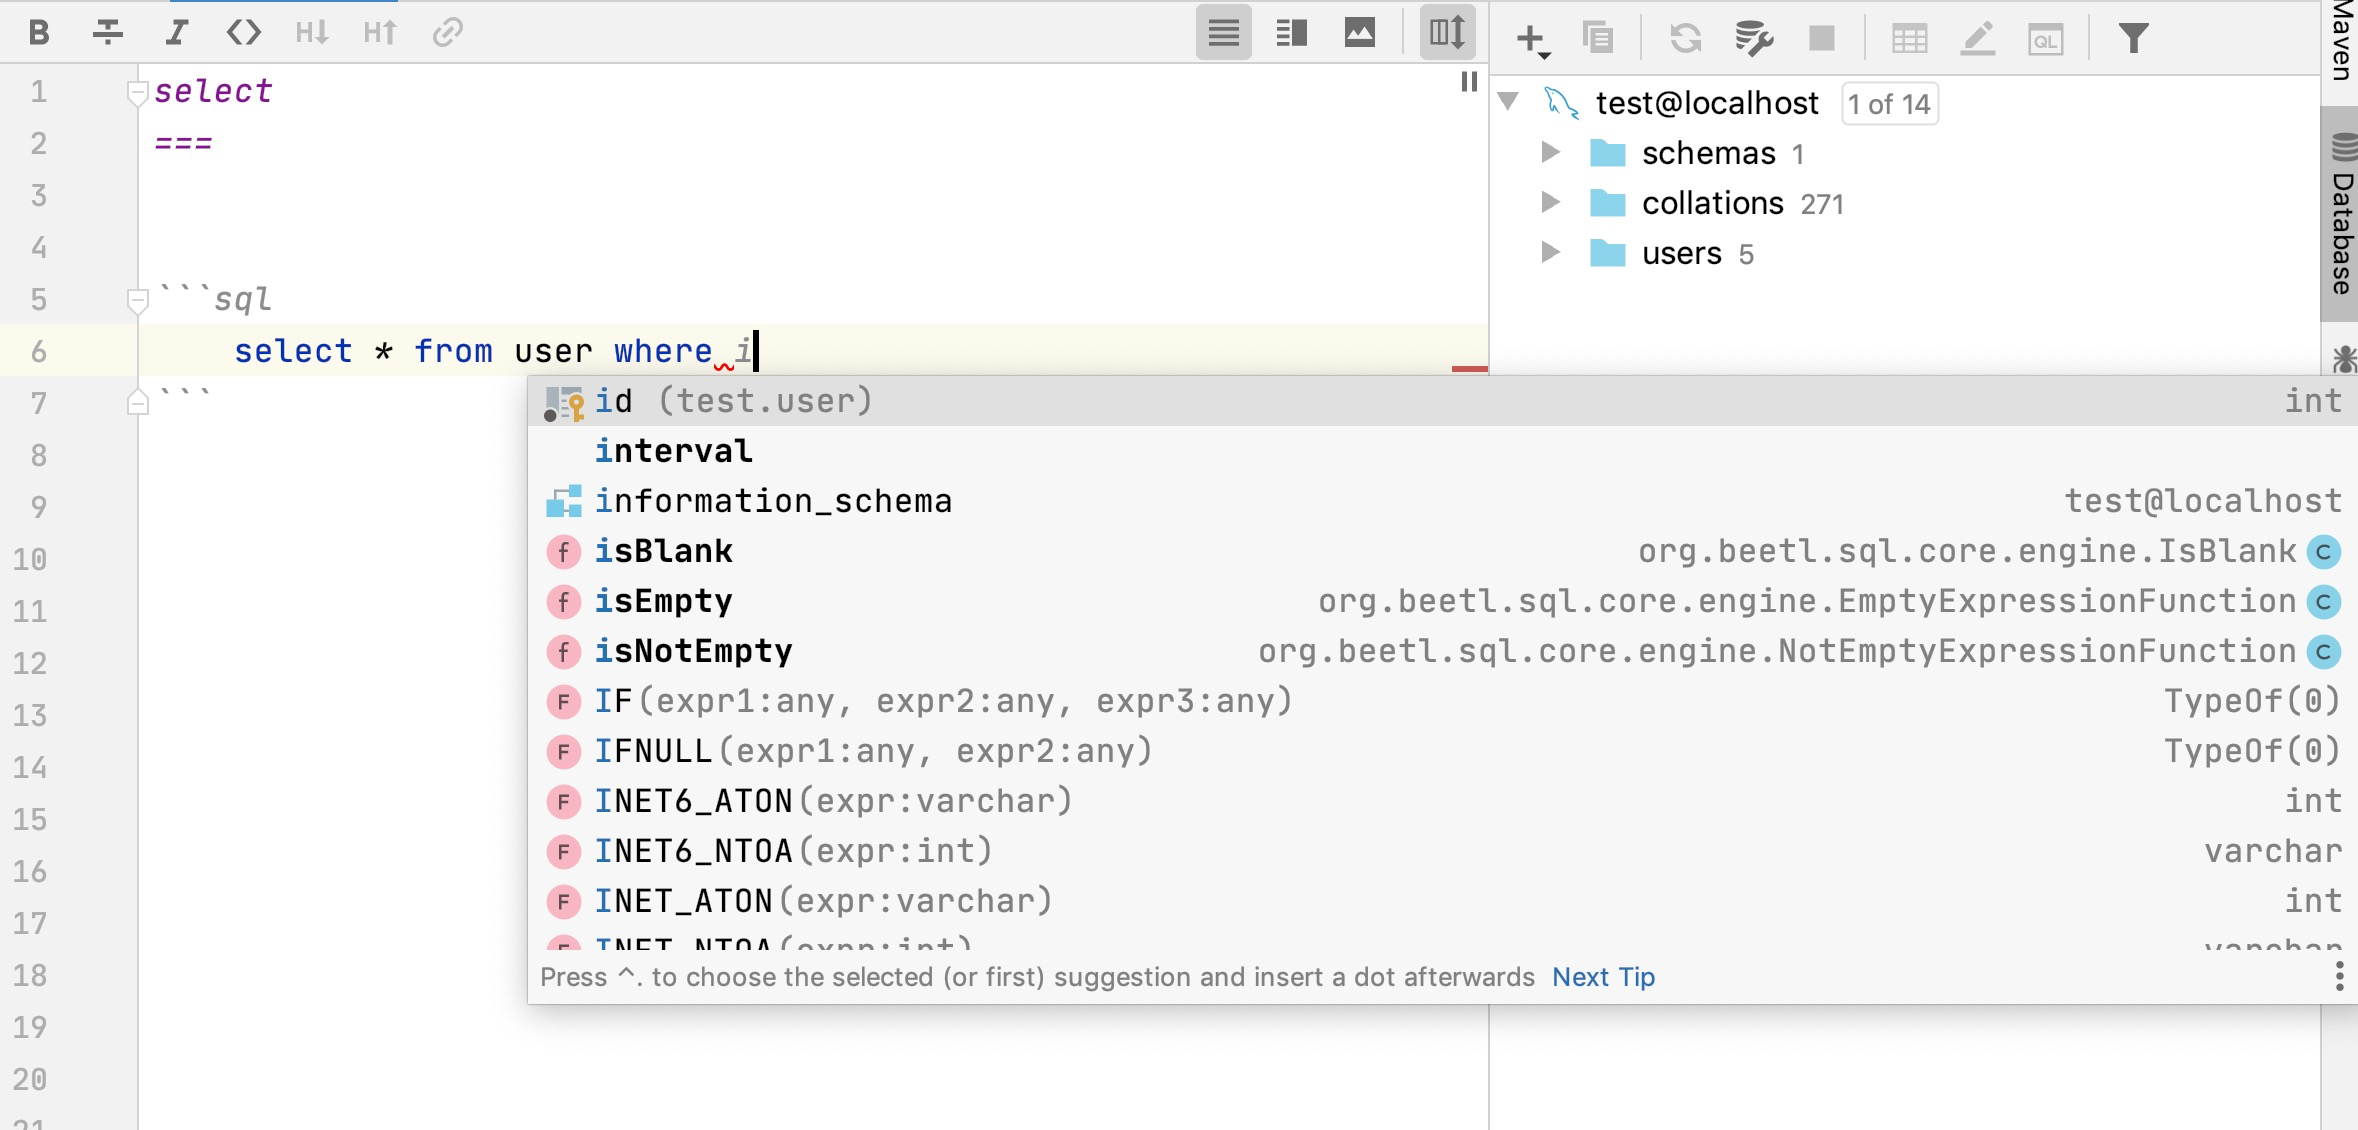
完善了Sql类型说明 修复Query类在使用无KeyHandler的时候的Bug 增强了Query类的page查询方法,允许使用PageRequest接口 <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.2.10-RELEASE</version> </dependency BeetlSQL 的目标是提供开发高效,维护高效,运行高效的数据库访问框架,以我20年在电信,金融以及互联网天天CRUD的经验总结得来的框架,适用范围广。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase BeetlSQL也支持IDEA插件,提供向导和自动提示

优秀的个人博客,低调大师

HanLP vs LTP 分词功能测试

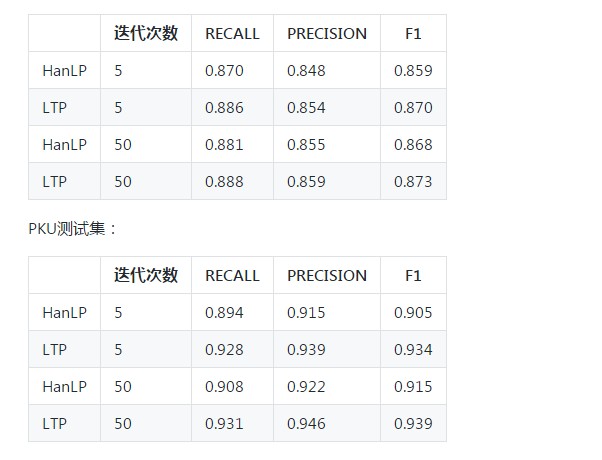
文章摘自github,本次测试选用 HanLP 1.6.0 , LTP 3.4.0 测试思路 使用同一份语料训练两个分词库,同一份测试数据测试两个分词库的性能。 语料库选取1998年01月的人民日报语料库。199801人民日报语料 该词库带有词性标注,为了遵循LTP的训练数据集格式,需要处理掉词性标注。 测试数据选择SIGHan2005提供的开放测试集。 SIGHan2005的使用可以参见其附带的readme。 HanLP java -cp libs/hanlp-1.6.0.jar com.hankcs.hanlp.model.perceptron.Main -task CWS -train -reference ../OpenCorpus/pku98/199801.txt -model cws.bin mkdir -p data/model/perceptron/pku199801 mv -f cws.bin data/model/perceptron/pku199801/cws.bin 默认情况下,训练的迭代次数为5。 修改 src/main/resouces 文件: root=../test-hanlp-ltp 打包命令: gradle clean build ​ SIGHan2005的MSR测试集 执行命令: java -cp build/libs/test-hanlp-ltp-1.0-SNAPSHOT.jar com.zongwu33.test.TestForSIGHan2005 ../NLP/icwb2-data/testing/msr_test.utf8 segment-msr-result.txt 将分词的结果生成到segment-msr-result.txt文件里。 利用SIGHan2005的脚本生成分数: perl ../NLP/icwb2-data/scripts/score ../NLP/icwb2-data/gold/msr_training_words.utf8 \ ../NLP/icwb2-data/gold/msr_test_gold.utf8 segment-msr-result.txt > score-msr.ut8 可以得到 HanLP在MSR数据集上的测试结果: === TOTAL TRUE WORDS RECALL: 0.870 === TOTAL TEST WORDS PRECISION: 0.848 === F MEASURE: 0.859 SIGHan2005的PKU测试集 java -cp build/libs/test-hanlp-ltp-1.0-SNAPSHOT.jar com.zongwu33.test.TestForSIGHan2005 ../NLP/icwb2-data/testing/pku_test.utf8 segment-pku-result.txt perl ../NLP/icwb2-data/scripts/score ../NLP/icwb2-data/gold/pku_training_words.utf8 ../NLP/icwb2-data/gold/pku_test_gold.utf8 segment-pku-result.txt > score-pku.utf8 结果: === TOTAL TRUE WORDS RECALL: 0.894 === TOTAL TEST WORDS PRECISION: 0.915 === F MEASURE: 0.905 Docker安装 LTP LTP 生成符合LTP训练格式的训练集文件: java -cp build/libs/test-hanlp-ltp-1.0-SNAPSHOT.jar com.zongwu33.test.CreateSimpleCorpus ../OpenCorpus/pku98/199801.txt simple-199801.txt simple-199801.txt 即为结果。 训练集 和开发集都指定为这个文件: ../LTP/ltp-3.4.0/tools/train/otcws learn --model model-test --reference simple-199801.txt --development simple-199801.txt --max-iter 5 SIGHan2005的MSR测试集 测试: ../LTP/ltp-3.4.0/tools/train/otcws test --model model-test --input /data/testLTP/icwb2-data/testing/msr_test.utf8 > msr_result.txt 利用SIGHan2005的脚本生成分数: perl icwb2-data/scripts/score icwb2-data/gold/msr_training_words.utf8 \ icwb2-data/gold/msr_test_gold.utf8 msr_result.txt > ltp-msr-score.utf8 查看ltp-msr-score.utf8 : === TOTAL TRUE WORDS RECALL: 0.886 === TOTAL TEST WORDS PRECISION: 0.854 === F MEASURE: 0.870 SIGHan2005的PKU测试集 ../LTP/ltp-3.4.0/tools/train/otcws test --model model-test --input /data/testLTP/icwb2-data/testing/pku_test.utf8 > pku_result.txt perl icwb2-data/scripts/score icwb2-data/gold/pku_training_words.utf8 \ icwb2-data/gold/pku_test_gold.utf8 pku_result.txt > ltp-pku-score.ut8 === TOTAL TRUE WORDS RECALL: 0.928 === TOTAL TEST WORDS PRECISION: 0.939 === F MEASURE: 0.934 对比 MSR测试集: 性能测试 阿里云ECS机器配置: 机器配置:Intel Xeon CPU *4 2.50GHz,内存16G 测试数据集 20M的网络小说,约140315句(不含空行)。 HanLP java -cp test-hanlp-ltp-1.0-SNAPSHOT.jar com.zongwu33.test.PerformanceTest ../NLP/strict-utf8-booken.txt init model: 313 ms total time:15677 ms total num:140315 需要15.677 s,可以计算得到处理速度 1375k/s 。 LTP ../LTP/ltp-3.4.0/tools/train/otcws test --model model-test --input strict-utf8-booken.txt > /dev/null [INFO] 2018-03-26 17:04:19 ||| ltp segmentor, testing ... [INFO] 2018-03-26 17:04:19 report: input file = strict-utf8-booken.txt [INFO] 2018-03-26 17:04:19 report: model file = model-test [INFO] 2018-03-26 17:04:19 report: evaluate = false [INFO] 2018-03-26 17:04:19 report: sequence probability = false [INFO] 2018-03-26 17:04:19 report: marginal probability = false [INFO] 2018-03-26 17:04:19 report: number of labels = 4 [INFO] 2018-03-26 17:04:19 report: number of features = 491820 [INFO] 2018-03-26 17:04:19 report: number of dimension = 1967296 [INFO] 2018-03-26 17:05:13 Elapsed time 53.680000 需要53s。处理速度389k/s。 对比 开源协议 Apache License Version 2.0

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册