首页 文章 精选 留言 我的

精选列表

搜索[运维安全中心(堡垒机)],共10000篇文章
优秀的个人博客,低调大师

9个SQL运维常遇到的问题

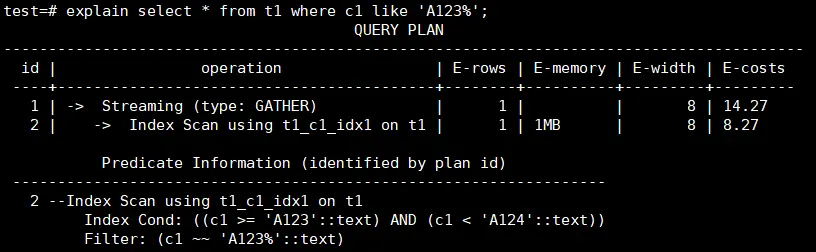
摘要:本文重点介绍单个SQL语句持续执行慢的场景。 本文分享自华为云社区《GaussDB(DWS) SQL性能问题案例集》,作者:黎明的风。 本文重点介绍单个SQL语句持续执行慢的场景。我们可以对执行慢的SQL进行单独分析,SELECT、INSERT、UPDATE等语句都可以使用explain verbose + SQL语句输出查询计划来进行分析,这样只输出查询计划,语句不会被实际的执行。 如果查询计划只出现__REMOTE_FQS_QUERY__或__REMOTE_LIGHT_QUERY__,看不到具体的计划,可以先执行set enable_fast_query_shipping to off; 然后再重新打印执行计划。 经常遇到的问题有以下几个: 【案例1】语句中包含不下推的函数 检查查询计划中是否包含_REMOTE_TABLE_QUERY_关键字, 如果有则表示语句没有下推,数据需要从DN上收取到CN上,然后语句在CN上执行。语句不下推原因,要从CN的日志中查找,搜索的关键字为:SQL can’t be shipped,以下为函数造成的不下推例子: LOG: SQL can't be shipped, reason: Function Fun1() can not be shipped 此外如果出现以下几种不下推的关键字:__REMOTE_GROUP_QUERY__、__REMOTE_LIMIT_QUERY__、 __REMOTE_SORT_QUERY__。这种需要检查enable_stream_operator参数是否处于关闭状态,一般来说打开STREAM开关后,语句就可以下推执行了。 如果出现以下两种关键字,表示语句可以下推执行: __REMOTE_FQS_QUERY__:表明语句走了Fast Query Shipping(FQS),SQL语句会下发到DN上执行,并且各DN之间没有数据交互,常见的场景有过滤条件为等值查询(where id = 1),或者关联的列是表的分布列的查询(where t1.id = t2.id)。 __REMOTE_LIGHT_QUERY__:表明语句走了Light Proxy(CN轻量化),将语句下发给了单个DN去处理,常见的场景过滤条件是分布列的等值查询(where id = 1),或者向一个DN插入数据的INSERT语句。 【案例2】表上有索引但没有走索引扫描,进行了全表扫描 从查询计划中可以看到Seq Scan或CStore Scan这样的关键字,如下所示: 对于行存表:-> Seq Scan on t1 对于列存表:-> CStore Scan on col_t1 出现这种问题通常有以下几种情况: 没有对所查询的表收集统计信息 如果表的实际行数很大,而估算行数很小,查询时可能会走全表顺序扫描,造成执行速度慢。此时通过analyze表更新统计信息,让优化器选择最佳的查询计划,一般就可以解决执行慢的问题。 【案例3】模糊匹配没有走索引 后模糊匹配查询可以通过建立一个BTREE索引来实现,需要根据数据类型设置索引的operator,对于text,varchar和char分别设置和text_pattern_ops,varchar_pattern_ops和bpchar_pattern_ops。 例如c1列的类型为text,创建索引时增加text_pattern_ops。 CREATE INDEX ON t1 (c1 text_pattern_ops); 创建索引后,可以看到语句执行时会使用到前面创建的索引,执行速度会变快。 【案例4】创建索引时所指定列的顺序问题 多列复合索引的组织结构与单列字段索引结构类似,按索引内表达式指定的顺序编排。当创建多列复合索引时,选择什么样的列的顺序,对查询性能会带来一定的影响。 例如按照c_date,c1和c2列的顺序建立检索,如果符合c_date条件的数据很多,通过这个索引扫描的数据就很会很多,造成执行时间长。 新建多列复合索引,将查询条件里的等值条件的列放到索引列的前面,先使用等值进行过滤,需要扫描的数据变少,查询变快。 【案例5】分区表没有分区剪枝进行了全表扫描 问题背景:XSYX局点使用MERGE INTO语句将每天的数据入库到表里,目标表为分区表,业务上线运行一段时间后发现MERGE INTO速度逐渐变慢。 原因分析:MERGE INTO语句的源表和目标表都是分区表,当前仅对源表增加了时间的过滤条件,可以进行分区剪枝。目标表由于没有指定时间过滤条件,进行的是全表扫描,随着每日的入库业务运行,目标表的数据量越来越大,造成执行速度越来越慢。 解决方案:由于源表的数据在MERGE INTO时会导入到目标表的对应分区里,可以对目标表增加时间的过滤条件进行分区剪枝。 业务修改前的查询计划: 对目标表增加了时间过滤条件后的计划显示可以走分区剪枝: 【案例6】表数据在DN节点上有存储倾斜 从查询计划中的A-time可以看到最长和最短的执行时间相差很大,说明在不同DN上扫描数据的时间不同。 在查询计划的DN信息中,通过rows可以看出在datanode1上扫描的数据量明显多于datanode2,说明有存储倾斜,这种情况建议对表进行合理的设计,选择合适的分布列,将数据均匀分布到所有的DN上。 【案例7】自定义函数引起执行慢 问题现象:查询语句比较简单,两个表做关联后输出了其中一列的值,在输出前增加了一个自定义函数对数据进行了处理。 原因分析:自定义函数里逻辑相对复杂,包含了对表的查询及数据计算逻辑,造成执行变慢。 解决方案;业务上对自定义函数进行性能优化。 【案例8】查询视图执行时间长 问题现象:某YD局点从C80版本迁移数据到8.1.1版本后,查询PG_STAT_USER_TABLES视图的时间由几分钟变成半个小时都不出结果。 原因分析:8.1.1版本中的PG_STAT_USER_TABLES视图在获取插入、更新、删除的行数的字段数值时,每一条记录都涉及到CN和DN的交互,在数据量和集群规模大的情况下耗时较多。 解决方案:建议根据应用的实际需要,将视图定义中不需要的函数注释掉以提升查询效率。 【案例9】关闭indexscan和bitmapscan后可以使用并行提升性能 问题现象: 查询计划中显示走了Index Scan,通过索引查询出的数据量比较大,速度慢。 原因分析:由于使用索引扫描时无法使用并行查询,当索引访问的数据量大时执行速度较慢。 解决方案:将enable_indexscan和enable_bitmapscan参数关闭,设置query_dop后走并行查询。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Kubernetes 4000节点运维经验分享

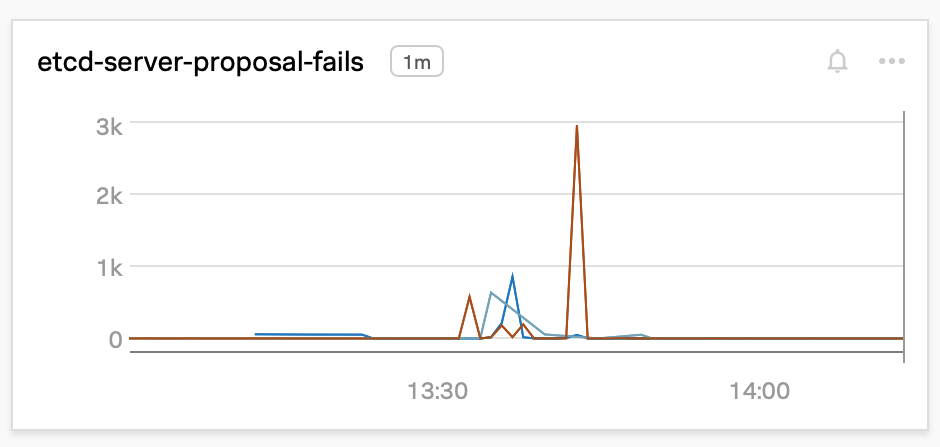
在 PayPal,我们最近开始试水 Kubernetes。我们大部分的工作负载都运行在 Apache Mesos 上,而作为迁移的一部分,我们需要从性能方面了解下运行 Kubernetes 集群以及 PayPal 特有的控制平面。其中最主要的是了解平台的可扩展性,以及通过调整集群找出可以改进的地方。 与 Apache Mesos 不同的是,前者无需任何修改即可扩展到 10,000 个节点,而扩展 Kubernetes 则非常具有挑战性。Kubernetes 的可扩展性不仅仅体现在节点和 Pod 的数量上,还有其他多个方面,如创建的资源数量、每个 Pod 的容器数量、服务总数和 Pod 部署的吞吐量。本文描述了我们在扩展过程中遇到的一些挑战,以及我们如何解决这些问题。 集群拓扑 我们的生产环境中有各种不同规模的集群,包含数千个节点。我们的设置包括三个主节点和一个外部的三节点 etcd 集群,所有这些都运行在谷歌云平台(GCP)上。控制平面前面有一个负载平衡器,所有数据节点都与控制平面属于相同的区域。 工作负载 为了进行性能测试,我们使用了一个开源的工作负载生成器 k-bench,并针对我们的场景做了修改。我们使用的资源对象是简单的 Pod 和部署。我们按不同的批次大小和部署间隔时间,分批次连续对它们进行部署。 扩展 开始时,Pod 和节点数量都比较少。通过压力测试,我们发现可以改进的地方,并继续扩大集群的规模,因为我们观察到性能有所改善。每个工作节点有四个 CPU 内核,最多可容纳 40 个 Pod。我们扩展到大约 4100 个节点。用于基准测试的应用程序是一个无状态的服务,运行在 100 个服务质量(QoS)有保证的毫核(millicores )上。 我们从 1000 个节点、2000 个 Pod 开始,接着是 16000 个 Pod,然后是 32000 个 Pod。之后,我们跃升到 4100 个节点、15 万个 Pod,接着是 20 万个 Pod。我们不得不增加每个节点的核数,以容纳更多的 Pod。 API 服务器 事实证明,API 服务器是一个瓶颈,有几个到 API 服务器的连接返回 504 网关超时,此外还有本地客户端限流(指数退避)。这些问题在扩展过程中 呈指数级 增长: I0504 17:54:55.731559 1 request.go:655] Throttling request took 1.005397106s, request: POST:https://<>:443/api/v1/namespaces/kbench-deployment-namespace-14/Pods.. I0504 17:55:05.741655 1 request.go:655] Throttling request took 7.38390786s, request: POST:https://<>:443/api/v1/namespaces/kbench-deployment-namespace-13/Pods.. I0504 17:55:15.749891 1 request.go:655] Throttling request took 13.522138087s, request: POST:https://<>:443/api/v1/namespaces/kbench-deployment-namespace-13/Pods.. I0504 17:55:25.759662 1 request.go:655] Throttling request took 19.202229311s, request: POST:https://<>:443/api/v1/namespaces/kbench-deployment-namespace-20/Pods.. I0504 17:55:35.760088 1 request.go:655] Throttling request took 25.409325008s, request: POST:https://<>:443/api/v1/namespaces/kbench-deployment-namespace-13/Pods.. I0504 17:55:45.769922 1 request.go:655] Throttling request took 31.613720059s, request: POST:https://<>:443/api/v1/namespaces/kbench-deployment-namespace-6/Pods.. API 服务器上限制速率的队列的大小是通过 max-mutating-requests-inflight 和 max-requests-inflight 更新的。1.20 版本中引入的 优先级和公平性 特性测试版,就是在 API 服务器上这两个标记的控制下将队列的总大小在不同的队列类别之间进行划分。例如,群首选举请求的优先级比 Pod 请求高。在每个优先级中,都有可配置队列的公平性。未来还可以通过 PriorityLevelConfiguration&FlowSchema API 对象做进一步调优。 控制器管理器 控制器管理器负责为副本集、命名空间等本地资源以及数量众多的部署(由副本集管理)提供控制器。控制器管理器与 API 服务器同步其状态的速度是有限的。有多个调节器用于调整这一行为: kube-api-qps -- 控制器管理器在一秒钟内可以向 API 服务器进行查询的次数。 kube-api-burst -- 控制器管理器突发流量峰值,是 kube-api-qps 之上另一个并发调用数。 concurrent-deployment-syncs -- 部署、复制集等对象同步调用的并发性。 调度器 当作为一个独立的组件单独测试时,调度器可以支持每秒 1000 个 Pod 的高吞吐率。然而,在将调度器部署到一个在线集群中时,我们注意到,实际的吞吐量有所降低。etcd 实例速度慢导致调度器的绑定延迟增加,使得待处理队列的大小增加到数千个 Pod 的程度。我们的想法是在测试运行期间将这个数值保持在 100 以下,因为数量比较大的话会影响 Pod 的启动延迟。此外,我们最后还调整了群首选举参数,以应对短暂的网络分区或网络拥堵引发的虚假重启。 etcd etcd 是 Kubernetes 集群中最关键的一部分。这一点从 etcd 在整个集群中引发的、以不同方式表现出来的大量问题可以看出来。经过非常仔细的研究,我们才找到根本原因,并扩展 etcd 以匹配我们预期的规模。 在扩展过程中,许多 Raft proposal 开始失败: 通过调查分析,我们发现,GCP 将 PD-SSD 磁盘的吞吐量限制在每秒 100MB 左右(如下图所示),我们的磁盘大小为 100G。GCP 没有提供增加吞吐量限制的方法——它只 随着磁盘的大小增加。尽管 etcd 节点只需要不到 10G 的空间,我们首先尝试了 1TB PD-SSD。然而,当所有 4k 个节点同时加入 Kubernetes 控制平面时,磁盘再大也会成为一个 瓶颈。我们决定使用本地 SSD,它的吞吐量非常高,代价是在出现故障时丢失数据的几率略高,因为它 不是持久化的。 在迁移到本地 SSD 后,我们并没有看到最快的 SSD 带来了预期的性能。我们用 FIO 直接在磁盘上做了一些基准测试,数值在意料之中。但是,对于所有成员的写入并发,etcd 基准测试讲述了一个不同的故事: Plain TextLOCAL SSDSummary: Total: 8.1841 secs. Slowest: 0.5171 secs. Fastest: 0.0332 secs. Average: 0.0815 secs. Stddev: 0.0259 secs. Requests/sec: 12218.8374 PD SSD Summary: Total: 4.6773 secs. Slowest: 0.3412 secs. Fastest: 0.0249 secs. Average: 0.0464 secs. Stddev: 0.0187 secs. Requests/sec: 21379.7235 本地 SSD 的表现更差!经过深入调查,这是由 ext4 文件系统的写屏障缓存提交导致的。由于 etcd 使用写前日志,并在每次提交到 Raft 日志时调用 fsync,所以可以禁用写屏障。此外,我们在文件系统级和应用程序级有 DB 备份作业,用于 DR。在这样修改之后,使用本地 SSD 的数值提高到了与 PD-SSD 相当的程度: Plain TextLOCAL SSDSummary: Total: 4.1823 secs. Slowest: 0.2182 secs. Fastest: 0.0266 secs. Average: 0.0416 secs. Stddev: 0.0153 secs. Requests/sec: 23910.3658 这一改进的效果在 etcd 的 WAL 同步持续时间和后端提交延迟上体现了出来,如下图所示,在 15:55 左右这个时间点上,WAL 同步持续时间和后端提交延迟降低了 90% 以上: etcd 中默认的 MVCC 数据库大小为 2GB。在 DB 空间不足的告警被触发时,这个大小最大会增加到 8GB。由于该数据库的 利用率约为 60%,所以我们能够扩展到 20 万个无状态 Pod。 经过上述这些优化,在预期的规模下,集群更加稳定了,然而,在 API 延迟方面,我们的 SLI 还差很多。 etcd 服务器还会偶尔重启,仅一次重启就会破坏基准测试结果,尤其是 P99 值。仔细观察发现,v1.20 版的 etcd YAML 中有一个存活探针 Bug。为了解决这个问题,我们采用了一个变通办法,即增加失败阈值的计数。 在用尽所有方法对 etcd 进行了垂直扩展之后,主要是在资源方面(CPU、内存、磁盘),我们发现,etcd 的性能受到范围查询的影响。当范围查询很多时,etcd 的表现并不好,对 Raft 日志的写入也受到影响,增加了集群的延迟。以下是一次测试运行中影响性能的每个 Kubernetes 资源的范围查询的数量: Plain Textetcd$ sudo grep -ir "events" 0.log.20210525-035918 | wc -l130830etcd$ sudo grep -ir "Pods" 0.log.20210525-035918 | wc -l107737etcd$ sudo grep -ir "configmap" 0.log.20210525-035918 | wc -l86274etcd$ sudo grep -ir "deployments" 0.log.20210525-035918 | wc -l6755etcd$ sudo grep -ir "leases" 0.log.20210525-035918 | wc -l4853etcd$ sudo grep -ir "nodes" 0.log.20210525-035918 | wc -l 由于这些查询很耗时,etcd 的后端延迟受到了很大的影响。在事件资源上对 etcd 服务器进行分片管理后,我们看到,在 Pod 高度竞争的情况下,集群的稳定性有所提高。将来,还可以进一步在 Pod 资源上对 etcd 集群进行分片。配置 API 服务器联系相关的 etcd 以与分片的资源进行交互很容易。 结果 在对 Kubernetes 的各种组件做完优化和调整后,我们观察到,延迟有大幅改善。下图展示了随着时间的推移,为满足 SLO 而实现的性能提升。其中,工作负载是 150k 个 Pod,每个部署 250 个副本,10 个并发工作进程。只要 Pod 启动的 P99 延迟在 5 秒之内,按照 Kubernetes SLO,我们就算是很好了。 下图显示了当集群有 20 万个 Pod 时,API 调用延迟完全符合 SLO。 _ 我们还实现了 20 万个 Pod P99 启动延迟为 5 秒左右,而 Pod 部署速率远远高于 K8s 针对 5k 节点测试时所声称的 3000 个 Pod/ 分钟。_ 总结 Kubernetes 是一个复杂的系统,必须深入了解控制平面,才能知道如何扩展每个组件。通过这次操练,我们学到了很多东西,并将继续优化我们的集群。

优秀的个人博客,低调大师

Linux运维笔记-日常操作命令总结(3)

使用"whois"命令可以查询到域名的注册信息 1)比如查询www.kevin.com、www.qq.com域名注册信息(使用whois命令查询时,需要去掉域名前面的www) [root@bastion~]#whoiskevin.com [root@bastion~]#whoisqq.com 2)查询ip注册信息 [root@bastion~]#whois112.110.116.15 "syntax error: unexpected end of file"一般从windows下的shell脚本传到Linux上可能会出现这样的问题,是因为Windows和Linux下的行末结束符是不一样的。即windoes下的dos格式文件传输到unix系统时,会在每行的结尾多一个^M,也就是说dos文件中的换行符"\r\n"会被转换为unix文件中的换行符"\n",而此文件若是一个可执行文件的话,会导致此文件不能被执行。 ======================================================================================================================= 案例一: 比如:我有一个test.sh脚本需要上传到centos系统中执行,但是传输到centos系统中,无法正常执行(前提脚本是完全可以执行的,没有错误)。可能原因是在windos系统上使用了类似notepad++的工具修改了可执行文件内容,导致在centos系统下无法正常执行。 案例二: 在本机(win10)测试正常的程序到了线上linux环境下就是跑步起来,tomcat总是卡在loadingconfig.properties这里,换了一个tomcat也是这种情况,以前是没有问题的。最后怀疑是config.properties文件的问题,然后通过vim查看config.properties文件的fileformat格式,命令":setfileformat",结果显示的是dos,最后通过命令修改为":setfileformat=unix" ======================================================================================================================= 这样先弄清楚一下"回车"和"换行符"的区别: 1)回车"\r" 本义是光标重新回到本行开头,r的英文return,控制字符可以写成CR,即CarriageReturn 2)换行"\n" 本义是光标往下一行(不一定到下一行行首),n的英文newline,控制字符可以写成LF,即LineFeed 解决办法: 1)使用vim打开file.sh脚本文件,进入编辑模式,修改如下: :setff=unix(或者:setfileformat=unix) :wq 2)如果以上步骤要求在一个shell批处理文件中完成,那么该怎么办?可以这样: vi+':w++ff=unix'+':q'${file} 这样一条命令就可以搞定了,但是要严格注意上面空格的位置,不能多不能少。 ================================================================================ 总结:在windows下新建的sh文件,copy到linux下有的会报错,一般是格式问题。 解决办法:使用vim编辑器进行一下文件格式fileformat转换可使用fileformat或简写ff。 在vim编辑可执行文件: setff或setff?#显示当前文件格式 setfileformat=unix或setff=unix#设置成unix格式 setff=dos#设置成dos格式 dos格式文件传输到unix系统时,会在每行的结尾多一个^M(/r) 删除^M的方法: :%s//r//g %s/\r//g sed文本操作命令使用 sed是一个很好的文件处理工具,本身是一个管道命令,主要是以行为单位进行处理,可以将数据行进行替换、删除、新增、选取等特定工作。 sed命令行格式为: sed[-nefri]‘command’输入文本 常用选项: -n∶使用安静(silent)模式。在一般sed的用法中,所有来自STDIN的资料一般都会被列出到萤幕上。但如果加上-n参数后,则只有经过sed特殊处理的那一行(或者动作)才会被列出来。 -e∶直接在指令列模式上进行sed的动作编辑; -f∶直接将sed的动作写在一个档案内,-ffilename则可以执行filename内的sed动作; -r∶sed的动作支援的是延伸型正规表示法的语法。(预设是基础正规表示法语法) -i∶直接修改读取的档案内容,而不是由萤幕输出。kevin.txt 常用命令: a∶新增,a的后面可以接字串,而这些字串会在新的一行出现(目前的下一行)~ c∶取代,c的后面可以接字串,这些字串可以取代n1,n2之间的行! d∶删除,因为是删除啊,所以d后面通常不接任何咚咚; i∶插入,i的后面可以接字串,而这些字串会在新的一行出现(目前的上一行); p∶列印,亦即将某个选择的资料印出。通常p会与参数sed-n一起运作~ s∶取代,可以直接进行取代的工作哩!通常这个s的动作可以搭配正规表示法!例如1,20s/old/new/g就是啦! 替换一行中的某部分。s后面的替换符号可以使用/,#,_三种符号 格式:sed's/要替换的字符串/新的字符串/g'(要替换的字符串可以用正则表达式) [root@kevin~]#sed-n'/ruby/p'kevin.txt|sed's/ruby/bird/g'#替换ruby为bird [root@kevin~]#sed-n'/ruby/p'kevin.txt|sed's#ruby#bird#g'#替换ruby为bird [root@kevin~]#sed-n'/ruby/p'kevin.txt|sed's_ruby_bird_g'#替换ruby为bird 定址 定址用于决定对哪些行进行编辑。地址的形式可以是数字、正则表达式、或二者的结合。 如果没有指定地址,sed将处理输入文件的所有行。 地址是一个数字,则表示行号;是“$"符号,则表示最后一行。例如: [root@kevin~]#sed-n'3p'datafile 只打印第三行 只显示指定行范围的文件内容,例如只查看文件的第100行到第200行 [root@kevin~]#sed-n'100,200p'mysql_slow_query.log 地址是逗号分隔的,那么需要处理的地址是这两行之间的范围(包括这两行在内)。范围可以用数字、正则表达式、或二者的组合表示。 [root@kevin~]#sed'2,5d'datafile 删除第二到第五行 [root@kevin~]#sed'/My/,/You/d'datafile 删除包含"My"的行到包含"You"的行之间的行 [root@kevin~]#sed'/My/,10d'datafile 删除包含"My"的行到第十行的内容 示例说明 kevin.txt删除某行 [root@kevin~]#sed'1d'kevin.txtkevin.txt#删除第一行 [root@kevin~]#sed'$d'kevin.txtkevin.txt#删除最后一行 [root@kevin~]#sed'1,2d'kevin.txt#删除第一行到第二行 [root@kevin~]#sed'2,$d'kevin.txt#删除第二行到最后一行 显示某行 [root@kevin~]#sed-n'1p'kevin.txt#显示第一行 [root@kevin~]#sed-n'$p'kevin.txt#显示最后一行 [root@kevin~]#sed-n'1,2p'kevin.txt#显示第一行到第二行 [root@kevin~]#sed-n'2,$p'kevin.txt#显示第二行到最后一行 使用模式进行查询 [root@kevin~]#sed-n'/ruby/p'kevin.txt#查询包括关键字ruby所在所有行 [root@kevin~]#sed-n'/\$/p'kevin.txt#查询包括关键字$所在所有行,使用反斜线\屏蔽特殊含义 增加一行或多行字符串 [root@kevin~]#catkevin.txt kevin.txtHello! kevin.txtrubyisme,welcometomyblog. kevin.txtend [root@kevin~]#sed'1adrinktea'kevin.txt#第一行后增加字符串"drinktea" kevin.txtHello! kevin.txtdrinktea kevin.txtrubyisme,welcometomyblog. kevin.txtend [root@kevin~]#sed'1,3adrinktea'kevin.txt#第一行到第三行后增加字符串"drinktea" kevin.txtHello! kevin.txtdrinktea kevin.txtrubyisme,welcometomyblog. kevin.txtdrinktea kevin.txtend kevin.txtdrinktea [root@kevin~]#sed'1adrinktea\norcoffee'kevin.txt#第一行后增加多行,使用换行符\n kevin.txtHello! kevin.txtdrinktea kevin.txtorcoffee kevin.txtrubyisme,welcometomyblog. kevin.txtend 代替一行或多行 [root@kevin~]#sed'1cHi'kevin.txt#第一行代替为Hi kevin.txtHi kevin.txtrubyisme,welcometomyblog. kevin.txtend [root@kevin~]#sed'1,2cHi'kevin.txtkevin.txt#第一行到第二行代替为Hi kevin.txtHi kevin.txtend 替换一行中的某部分 格式:sed's/要替换的字符串/新的字符串/g'(要替换的字符串可以用正则表达式) [root@kevin~]#sed-n'/ruby/p'kevin.txt|sed's/ruby/bird/g'#替换ruby为bird [root@kevin~]#sed-n'/ruby/p'kevin.txt|sed's/ruby//g'#删除ruby kevin.txt插入 [root@kevin~]#sed-i'$abye'kevin.txt#在文件kevin.txt中最后一行直接输入"bye" [root@kevin~]#catkevin.txt kevin.txtHello! kevin.txtrubyisme,welcometomyblog. kevin.txtend kevin.txtbye 替换: -e是编辑命令,用于sed执行多个编辑任务的情况下。在下一行开始编辑前,所有的编辑动作将应用到模式缓冲区中的行上。 [root@kevin~]#sed-e'1,10d'-e's/My/Your/g'datafile 选项-e用于进行多重编辑。 第一重编辑删除第1-3行。 第二重编辑将出现的所有My替换为Your。 因为是逐行进行这两项编辑(即这两个命令都在模式空间的当前行上执行),所以编辑命令的顺序会影响结果。 替换两个或多个空格为一个空格 [root@kevin~]#sed's/[][]*//g'file_name 替换两个或多个空格为分隔符: [root@kevin~]#sed's/[][]*/:/g'file_name 如果空格与tkevin.txt共存时用下面的命令进行替换 替换成空格 [root@kevin~]#sed's/[[:space:]][[:space:]]*//g'filename 替换成分隔符: [root@kevin~]#sed's/[[:space:]][[:space:]]*/:/g'filename ======================================= sed命令的调用: 在命令行键入命令;将sed命令插入脚本文件,然后调用sed;将sed命令插入脚本文件,并使sed脚本可执行 sed[option]sed命令输入文件在命令行使用sed命令,实际命令要加单引号 sed[option]-fsed脚本文件输入文件使用sed脚本文件 sed脚本文件[option]输入文件第一行具有sed命令解释器的sed脚本文件 option如下: n不打印;sed不写编辑行到标准输出,缺省为打印所有行(编辑和未编辑),p命令可以用来打印编辑行 c下一命令是编辑命令,使用多项编辑时加入此选项 f如果正在调用sed脚本文件,使用此选项,此选项通知sed一个脚本文件支持所用的sed命令,如 #sed-fmyscript.sedinput_file这里myscript.sed即为支持sed命令的文件 使用重定向文件即可保存sed的输出 使用sed在文本中定位文本的方式: xx为一行号,比如1 x,y表示行号范围从x到y,如2,5表示从第2行到第5行 /pattern/查询包含模式的行,如/disk/或/[a-z]/ /pattern/pattern/查询包含两个模式的行,如/disk/disks/ /pattern/,x在给定行号上查询包含模式的行,如/disk/,3 x,/pattern/通过行号和模式查询匹配行,如3,/disk/ x,y!查询不包含指定行号x和y的行 基本sed编辑命令: p打印匹配行c/用新文本替换定位文本 =显示文件行号s使用替换模式替换相应模式 a/在定位行号后附加新文本信息r从另一个文本中读文本 i/在定位行号后插入新文本信息w写文本到一个文件 d删除定位行q第一个模式匹配完成后退出或立即退出 l显示与八进制ASCII代码等价的控制字符y传送字符 n从另一个文本中读文本下一行,并附加在下一行{}在定位行执行的命令组 g将模式2粘贴到/patternn/ 基本sed编程举例: 使用p(rint)显示行:sed-n'2p'temp.txt只显示第2行,使用选项n 打印范围:sed-n'1,3p'temp.txt打印第1行到第3行 打印模式:sed-n'/movie/'ptemp.txt打印含movie的行 使用模式和行号查询:sed-n'3,/movie/'ptemp.txt只在第3行查找movie并打印 显示整个文件:sed-n'1,$'ptemp.txt$为最后一行 任意字符:sed-n'/.*ing/'ptemp.txt注意是.*ing,而不是*ing 打印行号:sed-e'/music/='temp.txt 附加文本:(创建sed脚本文件)chmodu+xscript.sed,运行时./script.sedtemp.txt #!/bin/sed-f /name1/a/#a/表示此处换行添加文本 HEREADDNEWLINE.#添加的文本内容 插入文本:/name1/a/改成4i/4表示行号,i插入 修改文本:/name1/a/改成/name1/c/将修改整行,c修改 删除文本:sed'1d'temp.txt或者sed'1,4d'temp.txt 替换文本:sed's/source/OKSTR/'temp.txt将source替换成OKSTR sed's//$//g'temp.txt将文本中所有的$符号全部删除 sed's/source/OKSTR/wtemp2.txt'temp.txt将替换后的记录写入文件temp2.txt 替换修改字符串:sed's/source/"ADDBEFORE"&/p'temp.txt 结果将在source字符串前面加上"ADDBEFORE",这里的&表示找到的source字符并保存 sed结果写入到文件:sed'1,2wtemp2.txt'temp.txt sed'/name/wtemp2.txt'temp.txt 从文件中读文本:sed'/name/rtemp2.txt'temp.txt 在每列最后加文本:sed's/[0-9]*/&Pass/g'temp.txt 从shell向sed传值:echo$NAME|sed"s/go/$REP/g"注意需要使用双引号 快速一行命令: 's//.$//g'删除以句点结尾行 '-e/abcd/d'删除包含abcd的行 's/[][][]*/[]/g'删除一个以上空格,用一个空格代替 's/^[][]*//g'删除行首空格 's//.[][]*/[]/g'删除句号后跟两个或更多的空格,用一个空格代替 '/^$/d'删除空行 's/^.//g'删除第一个字符,区别's//.//g'删除所有的句点 's/COL/(.../)//g'删除紧跟COL的后三个字母 's/^////g'删除路径中第一个/ ================================================= 1)使用句点匹配单字符 句点“.”可以匹配任意单字符。“.”可以匹配字符串头,也可以是中间任意字符。假定正在过滤一个文本文件,对于一个有10个字符的脚本集,要求前4个字符之后为XC,匹配操作如下:....XC.... 2)在行首以^匹配字符串或字符序列 ^只允许在一行的开始匹配字符或单词。在行首第4个字符为1,匹配操作表示为:^...1 3)在行尾以$匹配字符串或字符 可以说$与^正相反,它在行尾匹配字符串或字符,$符号放在匹配单词后。如果在行尾匹配单词jet01,操作如下:jet01$如果只返回包含一个字符的行,操作如下:^.$ 4)使用*匹配字符串中的单字符或其重复序列 使用此特殊字符匹配任意字符或字符串的重复多次表达式。 5)使用/屏蔽一个特殊字符的含义有 时需要查找一些字符或字符串,而它们包含了系统指定为特殊字符的一个字符。如果要在正则表达式中匹配以*.pas结尾的所有文件,可做如下操作:/*/.pas 6)使用[]匹配一个范围或集合 使用[]匹配特定字符串或字符串集,可以用逗号将括弧内要匹配的不同字符串分开,但并不强制要求这样做(一些系统提倡在复杂的表达式中使用逗号), 这样做可以增加模式的可读性。使用“-”表示一个字符串范围,表明字符串范围从“-”左边字符开始,到“-”右边字符结束。假定要匹配任意一个数字, 可以使用:[0123456789]要匹配任意字母,则使用:[A-Za-z]表明从A-Z、a-z的字母范围。 7)使用/{/}匹配模式结果出现的次数 使用*可匹配所有匹配结果任意次,但如果只要指定次数,就应使用/{/},此模式有三种形式,即: pattern/{n/}匹配模式出现n次。 pattern/{n,/}匹配模式出现最少n次。 pattern/{n,m}匹配模式出现n到m次之间,n,m为0-255中任意整数。 匹配字母A出现两次,并以B结尾,操作如下:A/{2/}B匹配值为AAB匹配A至少4次,使用:A/{4,/}B ====================== 替换单引号为空,可以这样写: sed's/'"'"'//g' sed's/'\''//g' seds/\'//g ===================== 在文件的第一行前面插入一行abc sed-i'1i\abc'urfile awk命令使用 awk是一个强大的文本分析工具,相对于grep的查找,sed的编辑,awk在其对数据分析并生成报告时,显得尤为强大。简单来说awk就是把文件逐行的读入, 以空格为默认分隔符将每行切片,切开的部分再进行各种分析处理。 awk有3个不同版本:awk、nawk和gawk,未作特别说明,一般指gawk,gawk是AWK的GNU版本。 awk其名称得自于它的创始人AlfredAho、PeterWeinberger和BrianKernighan姓氏的首个字母。实际上AWK的确拥有自己的语言: AWK程序设计语言,三位创建者已将它正式定义为“样式扫描和处理语言”。它允许您创建简短的程序,这些程序读取输入文件、为数据排序、处理数据、 对输入执行计算以及生成报表,还有无数其他的功能。 使用方法 awk'{pattern+action}'{filenames} 尽管操作可能会很复杂,但语法总是这样,其中pattern表示AWK在数据中查找的内容,而action是在找到匹配内容时所执行的一系列命令。 花括号({})不需要在程序中始终出现,但它们用于根据特定的模式对一系列指令进行分组。pattern就是要表示的正则表达式,用斜杠括起来。 awk语言的最基本功能是在文件或者字符串中基于指定规则浏览和抽取信息,awk抽取信息后,才能进行其他文本操作。完整的awk脚本通常用来格式化文本 文件中的信息。 通常,awk是以文件的一行为处理单位的。awk每接收文件的一行,然后执行相应的命令,来处理文本。 调用awk 有三种方式调用awk 1)命令行方式 awk[-Ffield-separator]'commands'input-file(s) 其中,commands是真正awk命令,[-F域分隔符]是可选的。input-file(s)是待处理的文件。 在awk中,文件的每一行中,由域分隔符分开的每一项称为一个域。通常,在不指名-F域分隔符的情况下,默认的域分隔符是空格。 2)shell脚本方式 将所有的awk命令插入一个文件,并使awk程序可执行,然后awk命令解释器作为脚本的首行,一遍通过键入脚本名称来调用。 相当于shell脚本首行的:#!/bin/sh 可以换成:#!/bin/awk 3)将所有的awk命令插入一个单独文件,然后调用: awk-fawk-script-fileinput-file(s) 其中,-f选项加载awk-script-file中的awk脚本,input-file(s)跟上面的是一样的。 假设last-n5的输出如下: [root@kevin~]#last-n5<==仅取出前五行 rootpts/1192.168.1.100TueFeb1011:21stillloggedin rootpts/1192.168.1.100TueFeb1000:46-02:28(01:41) rootpts/1192.168.1.100MonFeb911:41-18:30(06:48) dmtsaipts/1192.168.1.100MonFeb911:41-11:41(00:00) roottty1FriSep514:09-14:10(00:01) 如果只是显示最近登录的5个帐号 [root@kevin~]#last-n5|awk'{print$1}' root root root dmtsai root awk工作流程是这样的: 读入有'\n'换行符分割的一条记录,然后将记录按指定的域分隔符划分域,填充域,$0则表示所有域,$1表示第一个域,$n表示第n个域。 默认域分隔符是"空白键"或"[tab]键",所以$1表示登录用户,$3表示登录用户ip,以此类推。 如果只是显示/etc/passwd的账户 [root@kevin~]#cat/etc/passwd|awk-F':''{print$1}' root daemon bin sys 这种是awk+action的示例,每行都会执行action{print$1}。 -F指定域分隔符为':'。 如果只是显示/etc/passwd的账户和账户对应的shell,而账户与shell之间以tab键分割 [root@kevin~]#cat/etc/passwd|awk-F':''{print$1"\t"$7}' root/bin/bash daemon/bin/sh bin/bin/sh sys/bin/sh 如果只是显示/etc/passwd的账户和账户对应的shell,而账户与shell之间以逗号分割,而且在所有行添加列名name,shell,在最后一行添加"blue,/bin/nosh"。 [root@kevin~]#cat/etc/passwd|awk-F':''BEGIN{print"name,shell"}{print$1","$7}END{print"blue,/bin/nosh"}' name,shell root,/bin/bash daemon,/bin/sh bin,/bin/sh sys,/bin/sh .... blue,/bin/nosh awk工作流程是这样的: 先执行BEGING,然后读取文件,读入有/n换行符分割的一条记录,然后将记录按指定的域分隔符划分域,填充域,$0则表示所有域,$1表示第一个域, $n表示第n个域,随后开始执行模式所对应的动作action。接着开始读入第二条记录······直到所有的记录都读完,最后执行END操作。 搜索/etc/passwd有root关键字的所有行 [root@kevin~]#awk-F:'/root/'/etc/passwd root:x:0:0:root:/root:/bin/bash 这种是pattern的使用示例,匹配了pattern(这里是root)的行才会执行action(没有指定action,默认输出每行的内容)。 搜索支持正则,例如找root开头的:awk-F:'/^root/'/etc/passwd 搜索/etc/passwd有root关键字的所有行,并显示对应的shell [root@kevin~]#awk-F:'/root/{print$7}'/etc/passwd /bin/bash 这里指定了action{print$7} awk内置变量 awk有许多内置变量用来设置环境信息,这些变量可以被改变,下面给出了最常用的一些变量。 ARGC命令行参数个数 ARGV命令行参数排列 ENVIRON支持队列中系统环境变量的使用 FILENAMEawk浏览的文件名 FNR浏览文件的记录数 FS设置输入域分隔符,等价于命令行-F选项 NF浏览记录的域的个数 NR已读的记录数 OFS输出域分隔符 ORS输出记录分隔符 RS控制记录分隔符 此外,$0变量是指整条记录。$1表示当前行的第一个域,$2表示当前行的第二个域,......以此类推。 统计/etc/passwd:文件名,每行的行号,每行的列数,对应的完整行内容: [root@kevin~]#awk-F':''{print"filename:"FILENAME",linenumber:"NR",columns:"NF",linecontent:"$0}'/etc/passwd filename:/etc/passwd,linenumber:1,columns:7,linecontent:root:x:0:0:root:/root:/bin/bash filename:/etc/passwd,linenumber:2,columns:7,linecontent:daemon:x:1:1:daemon:/usr/sbin:/bin/sh filename:/etc/passwd,linenumber:3,columns:7,linecontent:bin:x:2:2:bin:/bin:/bin/sh filename:/etc/passwd,linenumber:4,columns:7,linecontent:sys:x:3:3:sys:/dev:/bin/sh 使用printf替代print,可以让代码更加简洁,易读 [root@kevin~]#awk-F':''{printf("filename:%10s,linenumber:%s,columns:%s,linecontent:%s\n",FILENAME,NR,NF,$0)}'/etc/passwd print和printf awk中同时提供了print和printf两种打印输出的函数。 其中print函数的参数可以是变量、数值或者字符串。字符串必须用双引号引用,参数用逗号分隔。如果没有逗号,参数就串联在一起而无法区分。 这里,逗号的作用与输出文件的分隔符的作用是一样的,只是后者是空格而已。 printf函数,其用法和c语言中printf基本相似,可以格式化字符串,输出复杂时,printf更加好用,代码更易懂。 awk编程:变量和赋值 除了awk的内置变量,awk还可以自定义变量。 下面统计/etc/passwd的账户人数 [root@kevin~]#awk'{count++;print$0;}END{print"usercountis",count}'/etc/passwd root:x:0:0:root:/root:/bin/bash ...... usercountis40 count是自定义变量。之前的action{}里都是只有一个print,其实print只是一个语句,而action{}可以有多个语句,以;号隔开。 这里没有初始化count,虽然默认是0,但是妥当的做法还是初始化为0: [root@kevin~]#awk'BEGIN{count=0;print"[start]usercountis",count}{count=count+1;print$0;}END{print"[end]usercountis",count}'/etc/passwd [start]usercountis0 root:x:0:0:root:/root:/bin/bash ... [end]usercountis40 统计某个文件夹下的文件占用的字节数 [root@kevin~]#ls-l|awk'BEGIN{size=0;}{size=size+$5;}END{print"[end]sizeis",size}' [end]sizeis8657198 如果以M为单位显示: [root@kevin~]#ls-l|awk'BEGIN{size=0;}{size=size+$5;}END{print"[end]sizeis",size/1024/1024,"M"}' [end]sizeis8.25889M 注意,统计不包括文件夹的子目录。 条件语句 awk中的条件语句是从C语言中借鉴来的,见如下声明方式: if(expression){ statement; statement; ...... } if(expression){ statement; }else{ statement2; } if(expression){ statement1; }elseif(expression1){ statement2; }else{ statement3; } 统计某个文件夹下的文件占用的字节数,过滤4096大小的文件(一般都是文件夹): [root@kevin~]#ls-l|awk'BEGIN{size=0;print"[start]sizeis",size}{if($5!=4096){size=size+$5;}}END{print"[end]sizeis",size/1024/1024,"M"}' [start]sizeis0 [end]sizeis0.0610514M 循环语句 awk中的循环语句同样借鉴于C语言,支持while、do/while、for、break、continue,这些关键字的语义和C语言中的语义完全相同。 数组 因为awk中数组的下标可以是数字和字母,数组的下标通常被称为关键字(key)。值和关键字都存储在内部的一张针对key/value应用hash的表格里。 由于hash不是顺序存储,因此在显示数组内容时会发现,它们并不是按照你预料的顺序显示出来的。数组和变量一样,都是在使用时自动创建的,awk 也同样会自动判断其存储的是数字还是字符串。一般而言,awk中的数组用来从记录中收集信息,可以用于计算总和、统计单词以及跟踪模板被匹配的次数等。 显示/etc/passwd的账户 [root@kevin~]#awk-F':''BEGIN{count=0;}{name[count]=$1;count++;};END{for(i=0;i<NR;i++)printi,name[i]}'/etc/passwd 0root 1daemon 2bin 3sys 4sync 5games ...... 这里使用for循环遍历数组 grep命令:从文件中查找匹配模式的行 1.作用 Linux系统中grep命令是一种强大的文本搜索工具,它能使用正则表达式搜索文本,并把匹配的行打印出来。grep全称是GlobalRegularExpressionPrint,表示全局正则表达式版本,它的使用权限是所有用户。 2.格式 grep[options] 3.主要参数 [options]主要参数: -c:只输出匹配行的计数。 -I:不区分大小写(只适用于单字符)。 -h:查询多文件时不显示文件名。 -l:查询多文件时只输出包含匹配字符的文件名。 -n:显示匹配行及行号。 -s:不显示不存在或无匹配文本的错误信息。 -v:显示不包含匹配文本的所有行。 pattern正则表达式主要参数: \:忽略正则表达式中特殊字符的原有含义。 ^:匹配正则表达式的开始行。 $:匹配正则表达式的结束行。 \<:从匹配正则表达式的行开始。 \>:到匹配正则表达式的行结束。 []:单个字符,如[A]即A符合要求。 [-]:范围,如[A-Z],即A、B、C一直到Z都符合要求。 。:所有的单个字符。 *:有字符,长度可以为0。 grep-v过滤 grep-c打印关键字符所在的行数 grep-An打印关键字符所在的行的后n行内容 grep-Bn打印关键字符所在的行的前n行内容 grep-Cn打印关键字符所在的行的前后各n行内容 catfilename|grep"abc" fgrep-R"abc"./* 4.grep命令使用简单实例 [root@kevin~]#grep‘test’d* 显示所有以d开头的文件中包含test的行。 [root@kevin~]#grep‘test’aabbcc 显示在aa,bb,cc文件中匹配test的行。 [root@kevin~]#grep‘[a-z]\{5\}’aa 显示所有包含每个字符串至少有5个连续小写字符的字符串的行。 [root@kevin~]#grep‘w\(es\)t.*\1′aa 如果west被匹配,则es就被存储到内存中,并标记为1,然后搜索任意个字符(.*),这些字符后面紧跟着另外一个es(\1),找到就显示该行。 如果用egrep或grep-E,就不用”\”号进行转义,直接写成’w(es)t.*\1′就可以了。 5.grep命令使用复杂实例 假设您正在’/usr/src/Linux/Doc’目录下搜索带字符串’magic’的文件: [root@kevin~]#grepmagic/usr/src/Linux/Doc/* sysrq.txt:*HowdoIenablethemagicSysRQkey? sysrq.txt:*HowdoIusethemagicSysRQkey? 其中文件’sysrp.txt’包含该字符串,讨论的是SysRQ的功能。 默认情况下,’grep’只搜索当前目录。如果此目录下有许多子目录,’grep’会以如下形式列出: grep:sound:Isadirectory 这可能会使’grep’的输出难于阅读。这里有两种解决的办法: 明确要求搜索子目录:grep-r 或忽略子目录:grep-dskip 如果有很多输出时,您可以通过管道将其转到’less’上阅读: [root@kevin~]#grepmagic/usr/src/Linux/Documentation/*|less 这样,您就可以更方便地阅读。 有一点要注意, 您必需提供一个文件过滤方式(搜索全部文件的话用*)。如果您忘了,’grep’会一直等着,直到该程序被中断。 如果您遇到了这样的情况,按<CTRLc>,然后再试。 下面还有一些有意思的命令行参数: grep-ipatternfiles:不区分大小写地搜索。默认情况区分大小写, grep-lpatternfiles:只列出匹配的文件名, grep-Lpatternfiles:列出不匹配的文件名, grep-wpatternfiles:只匹配整个单词,而不是字符串的一部分(如匹配’magic’,而不是’magical’), grep-Cnumberpatternfiles:匹配的上下文分别显示[number]行, greppattern1|pattern2files:显示匹配pattern1或pattern2的行, greppattern1files|greppattern2:显示既匹配pattern1又匹配pattern2的行。 grep-npatternfiles即可显示行号信息 grep-cpatternfiles即可查找总行数 这里还有些用于搜索的特殊符号: \<和\>分别标注单词的开始与结尾。 例如: grepman*会匹配‘Batman’、’manic’、’man’等, grep‘\<man’*匹配’manic’和’man’,但不是’Batman’, grep‘\<man\>’只匹配’man’,而不是’Batman’或’manic’等其他的字符串。 ‘^’:指匹配的字符串在行首, ‘$’:指匹配的字符串在行尾, ==============grep、fgrep、egrep的区别================= 者都是搜索工具,但功能上有区别。 1)首先,grep支持的是标准正则表达式。 2)fgrep,不支持正则表达式,只用于匹配固定字符串。 grep把模式当做正则表达式看,fgrep把模式当做固定字符串看,所以后者要比前者速度快,当然同时后者的搜索功能要弱于前者。 3)egrep:为grep的扩充版本,改良了许多传统grep不能或不便的操作.比如: -grep之下不支持?与+这两种modifier,但egrep则可。 -grep不支持a|b或(abc|xyz)这类"或一"比对,但egrep则可。 -grep在处理{n,m}时,需用\{与\}处理,但egrep则不需。 =========================================== 示例说明 [root@kevin~]#ps-ef|grepin.telnetd root19955181013:43:53?0:00in.telnetd [root@kevin~]#moresize.txtsize文件的内容 b124230 b034325 a081016 m7187998 m7282064 a022021 a061048 m9324822 b103303 a013386 b044525 m8987131 B081016 M45678 B103303 BADc2345 [root@kevin~]#moresize.txt|grep'[a-b]'范围;如[A-Z]即A,B,C一直到Z都符合要求 b124230 b034325 a081016 a022021 a061048 b103303 a013386 b044525 [root@kevin~]#moresize.txt|grep'[a-b]'* b124230 b034325 a081016 m7187998 m7282064 a022021 a061048 m9324822 b103303 a013386 b044525 m8987131 B081016 M45678 B103303 BADc2345 [root@kevin~]#moresize.txt|grep'b'#单个字符;如[b]即b符合要求 b124230 b034325 b103303 b044525 [root@kevin~]#moresize.txt|grep'[bB]'#b或者B b124230 b034325 b103303 b044525 B081016 B103303 BADc2345 [root@kevin~]#grep'root'/etc/group root::0:root bin::2:root,bin,daemon sys::3:root,bin,sys,adm adm::4:root,adm,daemon uucp::5:root,uucp mail::6:root tty::7:root,tty,adm lp::8:root,lp,adm nuucp::9:root,nuucp daemon::12:root,daemon [root@kevin~]#grep'^root'/etc/group#匹配正则表达式的开始行 root::0:root [root@kevin~]#grep'uucp'/etc/group uucp::5:root,uucp nuucp::9:root,nuucp [root@kevin~]#grep'\<uucp'/etc/group uucp::5:root,uucp [root@kevin~]#grep'root[root@kevin~]#'/etc/group#匹配正则表达式的结束行 root::0:root mail::6:root [root@kevin~]#moresize.txt|grep-i'b1..*3'#忽略大小写 b124230 b103303 B103303 [root@kevin~]#moresize.txt|grep-iv'b1..*3'#查找不包含匹配项的行 b034325 a081016 m7187998 m7282064 a022021 a061048 m9324822 a013386 b044525 m8987131 B081016 M45678 BADc2345 [root@kevin~]#moresize.txt|grep-in'b1..*3' 1:b124230 9:b103303 15:B103303 [root@kevin~]#grep'[root@kevin~]#'/etc/init.d/nfs.server|wc-l 128 [root@kevin~]#grep'\[root@kevin~]#'/etc/init.d/nfs.server|wc–l#忽略正则表达式中特殊字符的原有含义 15 [root@kevin~]#grep'\$'/etc/init.d/nfs.server case"$1"in >/tmp/sharetab.$$ ["x$fstype"!=xnfs]&& echo"$path\t$res\t$fstype\t$opts\t$desc" >>/tmp/sharetab.$$ /usr/bin/touch-r/etc/dfs/sharetab/tmp/sharetab.$$ /usr/bin/mv-f/tmp/sharetab.$$/etc/dfs/sharetab if[-f/etc/dfs/dfstab]&&/usr/bin/egrep-v'^[]*(#|$)' if[$startnfsd-eq0-a-f/etc/rmmount.conf]&& if[$startnfsd-ne0];then elif[!-n"$_INIT_RUN_LEVEL"];then while[$wtime-gt0];do wtime=`expr$wtime-1` if[$wtime-eq0];then echo"Usage:$0{start|stop}" [root@kevin~]#moresize.txt thetestfile theirarefiles Theend [root@kevin~]#grep'the'size.txt thetestfile theirarefiles [root@kevin~]#grep'\<the'size.txt thetestfile theirarefiles [root@kevin~]#grep'the\>'size.txt thetestfile [root@kevin~]#grep'\<the\>'size.txt thetestfile [root@kevin~]#grep'\<[Tt]he\>'size.txt thetestfile 多个文件查询 [root@kevin~]#grep"sort"*.txt#见文件名的匹配 行匹配:输出匹配行的计数 [root@kevin~]#grep-c"48"kevin.txt#输出文档中含有48字符的行数 显示匹配行和行数 [root@kevin~]#grep-n"48"kevin.txt#显示所有匹配48的行和行号 显示非匹配的行 [root@kevin~]#grep-vn"48"kevin.txt#输出所有不包含48的行 显示非匹配的行 [root@kevin~]#grep-vn"48"kevin.txt#输出所有不包含48的行 大小写敏感 [root@kevin~]#grep-i"ab"kevin.txt#输出所有含有ab或Ab的字符串的行 ==================================== 正则表达式的应用(注意:最好把正则表达式用单引号括起来) [root@kevin~]#grep'[239].'kevin.txt#输出所有含有以2,3或9开头的,并且是两个数字的行 不匹配测试 [root@kevin~]#grep'^[^48]'kevin.txt#不匹配行首是48的行 使用扩展模式匹配 [root@kevin~]#grep-E'219|216'kevin.txt 使用类名 可以使用国际模式匹配的类名: [[:upper:]][A-Z] [[:lower:]][a-z] [[:digit:]][0-9] [[:alnum:]][0-9a-zA-Z] [[:space:]]空格或tab [[:alpha:]][a-zA-Z] [root@kevin~]#grep'5[[:upper:]][[:upper:]]'kevin.txt#查询以5开头以两个大写字母结尾的行 cat、more、less、tail、head命令 cat是一个文本文件(查看)和(连接)工具,通常与more搭配使用,与more不同的是cat可以合并文件。查看一个文件的内容,用cat比较简单, 就是cat后面直接接文件名。 cat[选项][文件]... 选项 -A,--show-all等价于-vET -b,--number-nonblank对非空输出行编号 -e等价于-vE -E,--show-ends在每行结束处显示$ -n,--number对输出的所有行编号 -s,--squeeze-blank不输出多行空行 -t与-vT等价 -T,--show-tabs将跳格字符显示为^I -u(被忽略) -v,--show-nonprinting使用^和M-引用,除了LFD和TAB之外 --help显示此帮助信息并离开 cat查看文件内容实例: [root@kevin~]#cat/etc/profile//查看/etc/目录下的profile文件内容; [root@kevin~]#cat-b/etc/fstab//查看/etc/目录下的profile内容,并且对非空白行进行编号,行号从1开始; [root@kevin~]#cat-n/etc/profile//对/etc目录中的profile的所有的行(包括空白行)进行编号输出显示; [root@kevin~]#cat-E/etc/profile//查看/etc/下的profile内容,并且在每行的结尾处附加$符号; cat加参数-n和nl工具差不多,文件内容输出的同时,都会在每行前面加上行号; [root@kevin~]#cat-n/etc/profile [root@kevin~]#nl/etc/profile cat可以同时显示多个文件的内容,比如我们可以在一个cat命令上同时显示两个文件的内容; [root@kevin~]#cat/etc/fstab/etc/profile cat对于内容极大的文件来说,可以通过管道|传送到more工具,然后一页一页的查看; [root@kevin~]#cat/etc/fstab/etc/profile|more cat的创建、连接文件功能实例: cat有创建文件的功能,创建文件后,要以EOF或STOP结束; [root@kevin~]#cat>kevin.txt<<EOF >我来测试cat创建文件,并且为文件输入内容; >北京是个好地方; >EOF [root@kevin~]#catkevin.txt 我来测试cat创建文件,并且为文件输入内容; 北京是个好地方; cat还有向已存在的文件追加内容的功能; [root@kevin~]#catgrace.txt IamBeiNanNanBeiFromgrace.Org. 我正在为cat命令写文档 [root@kevin~]#cat>>grace.txt<<EOF >我来测试cat向文档追加内容的功能; >OK? >OK~ >北京你好 >EOF [root@kevin~]#catgrace.txt//查看文件内容,看是否追回成功。 IamBeiNanNanBeiFromgrace.Org. 我正在为cat命令写文档 我来测试cat向文档追加内容的功能; OK? OK~ 北京你好 cat连接多个文件的内容并且输出到一个新文件中; 假设我们有sir01.txt、sir02.tx和sir03.txt,并且内容如下; [root@kevin~]#catsir01.txt 123456 iamtesting [root@kevin~]#catsir02.txt 56789 BeiNanTested [root@kevin~]#catsir03.txt 09876 grace.orgtesting 我想通过cat把sir01.txt、sir02.txt及sir03.txt三个文件连接在一起(也就是说把这三个文件的内容都接在一起)并输出到一个新的文件sir04.txt中。 注意: 其原理是把三个文件的内容连接起来,然后创建sir04.txt文件,并且把几个文件的内容同时写入sir04.txt中。特别值得一提的是,如果您输入到一个已经 存在的sir04.txt文件,会把sir04.txt内容清空。 [root@kevin~]#catsir01.txtsir02.txtsir03.txt>sir04.txt [root@kevin~]#moresir04.txt 123456 iamtesting 56789 BeiNanTested 09876 grace.orgtesting cat把一个或多个已存在的文件内容,追加到一个已存在的文件中 [root@kevin~]#catsir00.txt grace.orgforever [root@kevin~]#catsir01.txtsir02.txtsir03.txt>>sir00.txt [root@kevin~]#catsir00.txt grace.orgforever 123456 iamtesting 56789 BeiNanTested 09876 grace.orgtesting ====================================================== more是我们最常用的工具之一,最常用的就是显示输出的内容,然后根据窗口的大小进行分页显示,然后还能提示文件的百分比; 参数如下: +num从第num行开始显示; -num定义屏幕大小,为num行; +/pattern从pattern前两行开始显示; -c从顶部清屏然后显示; -d提示Pressspacetocontinue,'q'toquit.(按空格键继续,按q键退出),禁用响铃功能; -l忽略Ctrl+l(换页)字符; -p通过清除窗口而不是滚屏来对文件进行换页。和-c参数有点相似; -s把连续的多个空行显示为一行; -u把文件内容中的下划线去掉退出more的动作指令是q more的参数应用举例: [root@kevin~]#more-dc/etc/profile//显示提示,并从终端或控制台顶部显示; [root@kevin~]#more+4/etc/profile//从profile的第4行开始显示; [root@kevin~]#more-4/etc/profile//每屏显示4行; [root@kevin~]#more+/MAIL/etc/profile//从profile中的第一个MAIL单词的前两行开始显示; more的动作指令: 我们查看一个内容较大的文件时,要用到more的动作指令,比如ctrl+f(或空格键)是向下显示一屏,ctrl+b是返回上一屏;Enter键可以向下滚动显示n行,要通过定,默认为1行; 我们只说几个常用的;自己尝试一下就知道了; Enter向下n行,需要定义,默认为1行; Ctrl+f向下滚动一屏; 空格键向下滚动一屏; Ctrl+b返回上一屏; =输出当前行的行号; :f输出文件名和当前行的行号; v调用vi编辑器; !命令调用Shell,并执行命令; q退出more当我们查看某一文件时,想调用vi来编辑它,不要忘记了v动作指令,这是比较方便的; 其它命令通过管道和more结合的运用例子: 比如我们列一个目录下的文件,由于内容太多,我们应该学会用more来分页显示。这得和管道|结合起来,比如: [root@kevin~]#ls-l/etc|more ======================================================= less查看文件内容工具 less工具也是对文件或其它输出进行分页显示的工具,应该说是linux正统查看文件内容的工具,功能极其强大;您是初学者,我建议您用less。 由于less的内容太多,我们把最常用的介绍一下; 常用参数 -c从顶部(从上到下)刷新屏幕,并显示文件内容。而不是通过底部滚动完成刷新; -f强制打开文件,二进制文件显示时,不提示警告; -i搜索时忽略大小写;除非搜索串中包含大写字母; -I搜索时忽略大小写,除非搜索串中包含小写字母; -m显示读取文件的百分比; -M显法读取文件的百分比、行号及总行数; -N在每行前输出行号; -ppattern搜索pattern;比如在/etc/profile搜索单词MAIL,就用less-pMAIL/etc/profile -s把连续多个空白行作为一个空白行显示; -Q在终端下不响铃; 比如:我们在显示/etc/profile的内容时,让其显示行号; [root@kevin~]#less-N/etc/profile less的动作命令: 进入less后,我们得学几个动作,这样更方便我们查阅文件内容;最应该记住的命令就是q,这个能让less终止查看文件退出; 动作: 回车键向下移动一行; y向上移动一行; 空格键向下滚动一屏; b向上滚动一屏; d向下滚动半屏; hless的帮助; u向上洋动半屏; w可以指定显示哪行开始显示,是从指定数字的下一行显示;比如指定的是6,那就从第7行显示; g跳到第一行; G跳到最后一行; pn%跳到n%,比如10%,也就是说比整个文件内容的10%处开始显示; /pattern搜索pattern,比如/MAIL表示在文件中搜索MAIL单词; v调用vi编辑器; q退出less !command调用SHELL,可以运行命令;比如!ls显示当前列当前目录下的所有文件; 就less的动作来说,内容太多了,用的时候查一查manless是最好的。在这里就不举例子了; ========================================================== head工具,显示文件内容的前几行 head是显示一个文件的内容的前多少行; 用法比较简单; head-n行数值文件名; 比如我们显示/etc/profile的前10行内容,应该是: [root@kevin~]#head-n10/etc/profile ========================================================= tail工具,显示文件内容的最后几行 tail是显示一个文件的内容的最后多少行; 用法比较简单; tail-n行数值文件名; 比如我们显示/etc/profile的最后5行内容,应该是: [root@kevin~]#tail-n5/etc/profile tail-f/var/log/syslog显示文件syslog的后十行内容并在文件内容增加后,且自动显示新增的文件内容。 cut命令:打印每行特定范围内内容 cut是一个选取命令,就是将一段数据经过分析,取出我们想要的。一般来说,选取信息通常是针对“行”来进行分析的,并不是整篇信息分析的。 其语法格式为: cut[-bn][file]或cut[-c][file]或cut[-df][file] 使用说明 cut命令从文件的每一行剪切字节、字符和字段并将这些字节、字符和字段写至标准输出。 如果不指定File参数,cut命令将读取标准输入。必须指定-b、-c或-f标志之一。 主要参数 -b:以字节为单位进行分割。这些字节位置将忽略多字节字符边界,除非也指定了-n标志。 -c:以字符为单位进行分割。 -d:自定义分隔符,默认为制表符。 -f:与-d一起使用,指定显示哪个区域。 -n:取消分割多字节字符。仅和-b标志一起使用。如果字符的最后一个字节落在由-b标志的List参数指示的<br/>范围之内,该字符将被写出;否则,该字符将被排除。 cut一般以什么为依据呢?也就是说,我怎么告诉cut我想定位到的剪切内容呢? cut命令主要是接受三个定位方法: 第一,字节(bytes),用选项-b 第二,字符(characters),用选项-c 第三,域(fields),用选项-f ========================================= cut在取列内容的时候和awk相识 awk-F""'{print$n}'以-F后的引号内的内容为列的分隔符,打印第n行 cut-d""-fn以-d后的引号内的内容为列的分隔符,打印第n行 比如打印a.txt文件中以空格为列的分隔符,打印第5行 awk-F""'{print$5}'a.txt当以空格为分隔符的时候,-F""可以省去 cut-d""-f5a.txt ========================================= 以“字节”定位 举个例子吧,当你执行ps命令时,会输出类似如下的内容: [root@kevin~]#who rocrocket:02009-01-0811:07 rocrocketpts/02009-01-0811:23(:0.0) rocrocketpts/12009-01-0814:15(:0.0) 如果我们想提取每一行的第3个字节,就这样: [root@kevin~]#who|cut-b3 c c c 如果“字节”定位中,我想提取第3,第4、第5和第8个字节,怎么办? -b支持形如3-5的写法,而且多个定位之间用逗号隔开就成了。看看例子吧: [root@kevin~]#who|cut-b3-5,8 croe croe croe 但有一点要注意,cut命令如果使用了-b选项,那么执行此命令时,cut会先把-b后面所有的定位进行从小到大排序,然后再提取。 可不能颠倒定位的顺序哦。这个例子就可以说明这个问题: [root@kevin~]#who|cut-b8,3-5 croe croe croe 还有哪些类似“3-5”这样的小技巧,列举一下吧! [root@kevin~]#who rocrocket:02009-01-0811:07 rocrocketpts/02009-01-0811:23(:0.0) rocrocketpts/12009-01-0814:15(:0.0) [root@kevin~]#who|cut-b-3 roc roc roc [root@kevin~]#who|cut-b3- crocket:02009-01-0811:07 crocketpts/02009-01-0811:23(:0.0) crocketpts/12009-01-0814:15(:0.0) -3表示从第一个字节到第三个字节,而3-表示从第三个字节到行尾。如果你细心,你可以看到这两种情况下,都包括了第三个字节“c”。 如果我执行who|cut-b-3,3-,你觉得会如何呢?答案是输出整行,不会出现连续两个重叠的c的。看: [root@kevin~]#who|cut-b-3,3- rocrocket:02009-01-0811:07 rocrocketpts/02009-01-0811:23(:0.0) rocrocketpts/12009-01-0814:15(:0.0) 给个以字符为定位标志的最简单的例子吧! 下面例子你似曾相识,提取第3,第4,第5和第8个字符: [root@kevin~]#who|cut-c3-5,8 croe croe croe 不过,看着怎么和-b没有什么区别啊?莫非-b和-c作用一样?其实不然,看似相同,只是因为这个例子举的不好,who输出的都是单字节字符, 所以用-b和-c没有区别,如果你提取中文,区别就看出来了,来,看看中文提取的情况: [root@kevin~]#catcut_ch.txt 星期一 星期二 星期三 星期四 [root@kevin~]#cut-b3cut_ch.txt � � � � [root@kevin~]#cut-c3cut_ch.txt 一 二 三 四 看到了吧,用-c则会以字符为单位,输出正常;而-b只会傻傻的以字节(8位二进制位)来计算,输出就是乱码。 既然提到了这个知识点,就再补充一句,如果你学有余力,就提高一下。 当遇到多字节字符时,可以使用-n选项,-n用于告诉cut不要将多字节字符拆开。例子如下: [root@kevin~]#catcut_ch.txt|cut-b2 � � � � [root@kevin~]#catcut_ch.txt|cut-nb2 [root@kevin~]#catcut_ch.txt|cut-nb1,2,3 星 星 星 星 域是怎么回事呢?解释解释:) 为什么会有“域”的提取呢,因为刚才提到的-b和-c只能在固定格式的文档中提取信息,而对于非固定格式的信息则束手无策。这时候“域”就派上用场了。 如果你观察过/etc/passwd文件,你会发现,它并不像who的输出信息那样具有固定格式,而是比较零散的排放。但是,冒号在这个文件的每一行中都 起到了非常重要的作用,冒号用来隔开每一个项。 cut命令提供了这样的提取方式,具体的说就是设置“间隔符”,再设置“提取第几个域”,就OK了! 以/etc/passwd的前五行内容为例: [root@kevin~]#cat/etc/passwd|head-n5 root:x:0:0:root:/root:/bin/bash bin:x:1:1:bin:/bin:/sbin/nologin daemon:x:2:2:daemon:/sbin:/sbin/nologin adm:x:3:4:adm:/var/adm:/sbin/nologin lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin [root@kevin~]#cat/etc/passwd|head-n5|cut-d:-f1 root bin daemon adm lp 用-d来设置间隔符为冒号,然后用-f来设置我要取的是第一个域,再按回车,所有的用户名就都列出来了! 当然,在设定-f时,也可以使用例如3-5或者4-类似的格式: [root@kevin~]#cat/etc/passwd|head-n5|cut-d:-f1,3-5 root:0:0:root bin:1:1:bin daemon:2:2:daemon adm:3:4:adm lp:4:7:lp [root@kevin~]#cat/etc/passwd|head-n5|cut-d:-f1,3-5,7 root:0:0:root:/bin/bash bin:1:1:bin:/sbin/nologin daemon:2:2:daemon:/sbin/nologin adm:3:4:adm:/sbin/nologin lp:4:7:lp:/sbin/nologin [root@kevin~]#cat/etc/passwd|head-n5|cut-d:-f-2 root:x bin:x daemon:x adm:x lp:x 如果遇到空格和制表符时,怎么分辨呢?我觉得有点乱,怎么办? 有时候制表符确实很难辨认,有一个方法可以看出一段空格到底是由若干个空格组成的还是由一个制表符组成的。 [root@kevin~]#cattab_space.txt thisistabfinish. thisisseveralspacefinish. [root@kevin~]#sed-nltab_space.txt thisistab\tfinish.$ thisisseveralspacefinish.$ 如果是制表符(TAB),那么会显示为\t符号,如果是空格,就会原样显示。 通过此方法即可以判断制表符和空格了。 注意,上面sed-n后面的字符是L的小写字母哦,不要看错。 我应该在cut-d中用什么符号来设定制表符或空格呢? 其实cut的-d选项的默认间隔符就是制表符,所以当你就是要使用制表符的时候,完全就可以省略-d选项,而直接用-f来取域就可以了。 如果你设定一个空格为间隔符,那么就这样: [root@kevin~]#cattab_space.txt|cut-d''-f1 this this 注意,两个单引号之间可确实要有一个空格哦,不能偷懒。 而且,你只能在-d后面设置一个空格,可不许设置多个空格,因为cut只允许间隔符是一个字符。 [root@kevin~]#cattab_space.txt|cut-d''-f1 cut:thedelimitermustbeasinglecharacter Try`cut--help'formoreinformation. cut有哪些缺陷和不足? 猜出来了吧?对,就是在处理多空格时。 如果文件里面的某些域是由若干个空格来间隔的,那么用cut就有点麻烦了,因为cut只擅长处理“以一个字符间隔”的文本内容。 tr命令:删除,去重,替换文本内容 可以把tr看作为一个简化的sed工具,tr表示为:translate。tr命令主要用于实现以下两个功能 替换操作的字符串转换。 删除操作的字符串转换,可以很容易的删除一些控制字符或者是空行。 tr命令能够实现的功能,都能够用sed命令来实现。但就具体的替换功能来说,tr用起来更容易,也比较简单。 一,命令格式 tr[option]["string1"]["string2"]<file 常用的选项有: 默认选项。就是没有任何选项的时候,tr默认为替换操作,就是将string1在文件中出现的字符替换为string2中的字符,这里要注意的是替换关系。 -c选项,用string1中字符的补集替换string1,这里的字符集为ASCII。 -d选项,删除文件中所有在string1中出现的字符。 -s选项,删除文件中重复并且在string1中出现的字符,只保留一个。 -c选项在使用时,只是将string1替换为现在的补集 [root@kevin~]#echo"helloworld,root,2012"|tr-c"0-9""*" *****************2012* 可以看出,我们使用0-9,添加-c选项后,会把0-9替换为其补集,这时补集自然不包含0-9,而包含很多其它的字符,接下来就把所有的其它字符都替换成*号, 但不包含数字。 如果只需要替换数字的话: [root@kevin~]#echo"helloworld,root,2012"|tr"0-9""*" helloworld,root,**** 二,字符串的取值范围 指定string或string2的内容时,只能使用单字符或字符串范围或列表。 [a-z]a-z内的字符组成的字符串。 [A-Z]A-Z内的字符组成的字符串。 [0-9]数字串。 \octal一个三位的八进制数,对应有效的ASCII字符。 [O*n]表示字符O重复出现指定次数n。因此[O*2]匹配OO的字符串。 三,控制字符的不同表达方式 速记符含义八进制方式 \aCtrl-G铃声\007 \bCtrl-H退格符\010 \fCtrl-L走行换页\014 \nCtrl-J新行\012 \rCtrl-M回车\015 \tCtrl-Itab键\011 \vCtrl-X\030注意这些控制字符,如果想在linux下输入,如我们可能需要输入^M这种字符,只需ctrl+V+M同时按下即可。 四,字符替换 这是tr的默认操作,先看下面的命令和输出 [root@kevin~]#echo"helloworld"|tr"a-z""A-Z" HELLOWORLD [root@kevin~]#echo"helloworld"|tr"a-l""A-Z" HELLoworLD [root@kevin~]#echo"helloworld"|tr"a-z""A-H" HEHHHHHHHD 第一行输出就是将小写换成大写。 第二行输出将小写中的a-l分别换成A-L,而将小写中的l以后的字符都不替换。 第三行输出将小写中的a-h换成A-H,而h以后的字符都换成H,因为后者的替换空间没有前面的字符空间大,所以就重复后面的H, 相当于后面的字符是A-HHH......HHHHH。 如果我们想要进行大小写转换,可以按下面的输入: tr"a-z""A-Z"<inputfile 五,去除重复字符 这个时候,所用的选项是-s选项,如: [root@kevin~]#echo"helloworld,root"|tr-s"ao" helloworld,rot [root@kevin~]#echo"helloworld,root"|tr-s"lo" heloworld,rot [root@kevin~]#echo"helloworld,root"|tr-s"a-z" heloworld,rot [root@kevin~]#echo"helloworld,root"|tr-s"0-9" helloworld,root 第一行表示将输入字符串中的包含在"ao"字符集中的重复字符去掉,只留一个。因为"helloworld,root",只有o满足条件,所以将root变成rot,把中间的两个o变成一个。 第二行将hello和root两个字符都压缩了。 第三行表示将a-z中的除复字符都去掉。 第三行表示将字符串中的重复的且重复字符在0-9字符集中的字符去掉,这里没有。 如果我们想要去掉空行,可以这样操作: tr-s"\n"<inputfile或者tr-s"\012"<inputfile//这两个是一样的。 就是将重复的换行符去掉,只留一个。 六,删除字符 -d选项和-s选项类似,只不过-d选项会删除所有出现的字符。 [root@kevin~]#echo"helloworld,root"|tr-d"a-h" lloworl,root [root@kevin~]#echo"helloworld,root,2012"|tr-d"a-z" ,,2012 [root@kevin~]#echo"helloworld,root,2012"|tr-d"0-9" sort/uniq/cut/wc命令 sort命令对File参数指定的文件中的行排序,并将结果写到标准输出。如果File参数指定多个文件,那么sort命令将这些文件连接起来,并当作一个文件进行排序。 sort语法 sort[-fbMnrtuk][fileorstdin] 选项与参数: -f:忽略大小写的差异,例如A与a视为编码相同; -b:忽略最前面的空格符部分; -M:以月份的名字来排序,例如JAN,DEC等等的排序方法; -n:使用『纯数字』进行排序(默认是以文字型态来排序的); -r:反向排序; -u:就是uniq,相同的数据中,仅出现一行代表; -t:分隔符,默认是用[tab]键来分隔; -k:以那个区间(field)来进行排序的意思 对/etc/passwd的账号进行排序 [root@kevin~]#cat/etc/passwd|sort adm:x:3:4:adm:/var/adm:/sbin/nologin apache:x:48:48:Apache:/var/www:/sbin/nologin bin:x:1:1:bin:/bin:/sbin/nologin daemon:x:2:2:daemon:/sbin:/sbin/nologin sort是默认以第一个数据来排序,而且默认是以字符串形式来排序,所以由字母a开始升序排序。 /etc/passwd内容是以:来分隔的,我想以第三栏来排序,该如何 [root@kevin~]#cat/etc/passwd|sort-t':'-k3 root:x:0:0:root:/root:/bin/bash uucp:x:10:14:uucp:/var/spool/uucp:/sbin/nologin operator:x:11:0:operator:/root:/sbin/nologin bin:x:1:1:bin:/bin:/sbin/nologin games:x:12:100:games:/usr/games:/sbin/nologin 默认是以字符串来排序的,如果想要使用数字排序: [root@kevin~]#cat/etc/passwd|sort-t':'-k3n root:x:0:0:root:/root:/bin/bash daemon:x:1:1:daemon:/usr/sbin:/bin/sh bin:x:2:2:bin:/bin:/bin/sh 默认是升序排序,如果要倒序排序,如下 [root@kevin~]#cat/etc/passwd|sort-t':'-k3nr nobody:x:65534:65534:nobody:/nonexistent:/bin/sh ntp:x:106:113::/home/ntp:/bin/false messagebus:x:105:109::/var/run/dbus:/bin/false sshd:x:104:65534::/var/run/sshd:/usr/sbin/nologin 如果要对/etc/passwd,先以第六个域的第2个字符到第4个字符进行正向排序,再基于第一个域进行反向排序。 [root@kevin~]#cat/etc/passwd|sort-t':'-k6.2,6.4-k1r sync:x:4:65534:sync:/bin:/bin/sync proxy:x:13:13:proxy:/bin:/bin/sh bin:x:2:2:bin:/bin:/bin/sh sys:x:3:3:sys:/dev:/bin/sh 查看/etc/passwd有多少个shell:对/etc/passwd的第七个域进行排序,然后去重: [root@kevin~]#cat/etc/passwd|sort-t':'-k7-u root:x:0:0:root:/root:/bin/bash syslog:x:101:102::/home/syslog:/bin/false daemon:x:1:1:daemon:/usr/sbin:/bin/sh sync:x:4:65534:sync:/bin:/bin/sync sshd:x:104:65534::/var/run/sshd:/usr/sbin/nologin ================================================================== uniq命令可以去除排序过的文件中的重复行,因此uniq经常和sort合用。也就是说,为了使uniq起作用,所有的重复行必须是相邻的。 uniq语法 uniq[-icu] 选项与参数: -i:忽略大小写字符的不同; -c:进行计数 -u:只显示唯一的行 [root@kevin~]#cattestfile hello world friend hello world hello 直接删除未经排序的文件,将会发现没有任何行被删除 [root@kevin~]#uniqtestfile hello world friend hello world hello 排序文件,默认是去重 [root@kevin~]#catwords|sort|uniq friend hello world 排序之后删除了重复行,同时在行首位置输出该行重复的次数 [root@kevin~]#sorttestfile|uniq-c 1friend 3hello 2world 仅显示存在重复的行,并在行首显示该行重复的次数 [root@kevin~]#sorttestfile|uniq-dc 3hello 2world 仅显示不重复的行 [root@kevin~]#sorttestfile|uniq-u friend =============================================== sort|uniq排序去重 sort|uniq-c|srot-rn排序去重,并降序 sort|uniq-c打印重复的行数 sort|uniq-d打印交集部分 sort|uniq-u打印交集以外的部分 ============================================== [root@kevin~]#cata.txt sdfsdf 123 123 1234 123 dasdfsd sdfsdf asfd34234 [root@kevin~]#cata.txt|sort|uniq 123 1234 asfd34234 dasdfsd sdfsdf [root@kevin~]#cata.txt|sort|uniq-c 3123 11234 1asfd34234 1dasdfsd 2sdfsdf [root@kevin~]#cata.txt|sort|uniq-d 123 sdfsdf [root@kevin~]#cata.txt|sort|uniq-u 1234 asfd34234 dasdfsd [root@kevin~]#cata.txt sdfsdf 123 123 1234 123 dasdfsd sdfsdf asfd34234 [root@kevin~]#catb.txt sdf 123 err 2345 123 gggg [root@kevin~]#cata.txtb.txt|sort|uniq 123 1234 2345 asfd34234 dasdfsd err gggg sdf sdfsdf [root@kevin~]#cata.txtb.txt|sort|uniq-c 5123 11234 12345 1asfd34234 1dasdfsd 1err 1gggg 1sdf 2sdfsdf [root@kevin~]#cata.txtb.txt|sort|uniq-d 123 sdfsdf [root@kevin~]#cata.txtb.txt|sort|uniq-u 1234 2345 asfd34234 dasdfsd err gggg sdf ======================================================= cut命令可以从一个文本文件或者文本流中提取文本列。 cut语法 cut-d'分隔字符'-ffields<==用于有特定分隔字符 cut-c字符区间<==用于排列整齐的信息 选项与参数: -d:后面接分隔字符。与-f一起使用; -f:依据-d的分隔字符将一段信息分割成为数段,用-f取出第几段的意思; -c:以字符(characters)的单位取出固定字符区间; PATH变量如下 [root@kevin~]#echo$PATH /bin:/usr/bin:/sbin:/usr/sbin:/usr/local/bin:/usr/X11R6/bin:/usr/games #1|2|3|4|5|6|7 将PATH变量取出,我要找出第五个路径。 [root@kevin~]#echo$PATH|cut-d':'-f5 /usr/local/bin 将PATH变量取出,我要找出第三和第五个路径。 [root@kevin~]#echo$PATH|cut-d':'-f3,5 /sbin:/usr/local/bin 将PATH变量取出,我要找出第三到最后一个路径。 [root@kevin~]#echo$PATH|cut-d':'-f3- /sbin:/usr/sbin:/usr/local/bin:/usr/X11R6/bin:/usr/games 将PATH变量取出,我要找出第一到第三个路径。 [root@kevin~]#echo$PATH|cut-d':'-f1-3 /bin:/usr/bin:/sbin: 将PATH变量取出,我要找出第一到第三,还有第五个路径。 [root@kevin~]#echo$PATH|cut-d':'-f1-3,5 /bin:/usr/bin:/sbin:/usr/local/bin 实用例子:只显示/etc/passwd的用户和shell [root@kevin~]#cat/etc/passwd|cut-d':'-f1,7 root:/bin/bash daemon:/bin/sh bin:/bin/sh ==================================================== wc 统计文件里面有多少单词,多少行,多少字符。 wc语法 [root@kevin~]#wc[-lwm] 选项与参数: -l:仅列出行; -w:仅列出多少字(英文单字); -m:多少字符; 默认使用wc统计/etc/passwd [root@kevin~]#wc/etc/passwd 40451719/etc/passwd 40是行数,45是单词数,1719是字节数 wc的命令比较简单使用,每个参数使用如下: [root@kevin~]#wc-l/etc/passwd#统计行数,在对记录数时,很常用 40/etc/passwd#表示系统有40个账户 [root@kevin~]#wc-w/etc/passwd#统计单词出现次数 45/etc/passwd [root@kevin~]#wc-m/etc/passwd#统计文件的字节数 1719 split命令:切分文件 split命令用于将一个文件分割成数个。 该指令将大文件分割成较小的文件,在默认情况下将按照每1000行切割成一个小文件。 语法 split[--help][--version][-<行数>][-b<字节>][-C<字节>][-l<行数>][要切割的文件][输出文件名] 参数说明: -<行数>:指定每多少行切成一个小文件.如split-3a.txt -b<字节>:指定每多少字节切成一个小文件 -l,--lines=NUMBER:对file进行切分,每个文件有NUMBER行。 --help:在线帮助 --version:显示版本信息 -C<字节>:与参数"-b"相似,但是在切割时将尽量维持每行的完整性 [输出文件名]:设置切割后文件的前置文件名,split会自动在前置文件名后再加上编号 示例1: 使用指令split将文件a.txt每3行切割成一个文件,输入如下命令: 注意:是按照a.txt文件中的行数进行分割的,每3行切分到一个文件中,切割成多个以"x"开头的小文件。直至所有行数被分完。 [root@kevin~]#cata.txt sdfsdf 123123123 sdfasdf2r345345 kljljkl sjkdfjsdofopf sadfsd2343 123123 asdf4555 66666 888888 [root@kevin~]#split-3a.txt [root@kevin~]#ls anaconda-ks.cfga.txtxaaxabxacxad [root@kevin~]#catxaa sdfsdf 123123123 sdfasdf2r345345 [root@kevin~]#catxab kljljkl sjkdfjsdofopf sadfsd2343 [root@kevin~]#catxac 123123 asdf4555 66666 [root@kevin~]#catxad 888888 示例2: 有个文件要处理,因为很大,所以想把它切成若干份,每份N行,以便并行处理。 参数说明: -b,--bytes=SIZE:对file进行切分,每个小文件大小为SIZE。可以指定单位b,k,m。 -l,--lines=NUMBER:对file进行切分,每个文件有NUMBER行。 prefix:分割后产生的文件名前缀。 示例: 假设要切分的文件为test.2012-08-16_17,大小1.2M,12081行。 1) [root@kevin~]#split-l5000test.2012-08-16_17 生成xaa,xab,xac三个文件。 [root@kevin~]#wc-l#看到三个文件行数如下: 5000xaa 5000xab 2081xac 12081总计 2) [root@kevin~]#split-b600ktest.2012-08-16_17 生成xaa,xab两个文件 [root@kevin~]#ls-lh#看到两个文件大小如下: 600Kxaa 554Kxab 3) [root@kevin~]#split-b500ktest.2012-08-16_17example 得到三个文件,文件名的前缀都是example [root@kevin~]#ls-lh#看到文件信息如下: 500Kexampleaa 500Kexampleab 154Kexampleac 示例3: 将一个大文件分成若干个小文件方法 例如将一个BLM.txt文件分成前缀为BLM_的1000个小文件,后缀为系数形式,且后缀为4位数字形式 [root@kevin~]#wc-lBLM.txt#读出BLM.txt文件一共有多少行 [root@kevin~]#split-l2482../BLM/BLM.txt-d-a4BLM_ 将文件BLM.txt分成若干个小文件,每个文件2482行(-l2482),文件前缀为BLM_,系数不是字母而是数字(-d),后缀系数为四位数(-a4) ===================================================== Linux下文件分割可以通过split命令来实现,可以指定按行数分割和安大小分割两种模式。Linux下文件合并可以通过cat命令来实现,非常简单。 在Linux下用split进行文件分割: 模式一:指定分割后文件行数 对与txt文本文件,可以通过指定分割后文件的行数来进行文件分割。 命令:split-l300large_file.txtnew_file_prefix 模式二:指定分割后文件大小 split-b10mserver.logwaynelog 对二进制文件我们同样也可以按文件大小来分隔。 在Linux下用cat进行文件合并: 命令:catsmall_files*>large_file 将a.txt的内容输入到b.txt的末尾 cata.txt>>b.txt comm命令:对于两个已排序文件,逐行比对 一、常用用法 commFILE1FILE2 二、含义与选项 2.1、含义 对于两个已排序的文件,逐行比对。 打印结果有3列:第1列,只属于“FILE1”的行;第2列,只属于“FILE2”的行;第3列,既属于“FILE1”,又属于“FILE2”的行。 2.2、选项表示的意思 “FILE1,FILE2”:指代已排序文件“FILE1”和“FILE2” 三、其他 3.1、“LC_COLLATE”等环境变量 由于涉及到两个字符串的比较等,故而程序实现中使用“LC_COLLATE”等环境变量,最终结果受到“LC_COLLATE”等环境变量的控制。 3.2、排序策略 comm命令实现设定的排序策略是“按照字典序排序”。两个已排序文件使用的排序策略组合共有3种情况。 3.2.1、情况1 一个排序文件按照字典序排序,另外一个排序文件按照非字典序(其他排序策略)排序。显而易见,在这种情况下,comm命令的执行结果会比较奇怪。 [root@localhost~]#cata.txt 001 02 3 10 [root@localhost~]#catb.txt 001 02 5 06 007 10 即已按照“数值大小”排序,执行“逐行比对”过程,我们的预期结果是:“3”只属于“c.txt”,“5,06,007”只属于“d.txt”,“001,02,10”共属于两个文件。 现在执行comma.txtb.txt命令,得到如图1所示结果,不能达到预期。 [root@localhost~]#comma.txtb.txt 001 02 3 comm:file1isnotinsortedorder 10 5 comm:file2isnotinsortedorder 06 007 10 执行comm--nocheck-ordera.txtb.txt命令,得到如图2所示结果,也不能达到预期。 [root@localhost~]#comm--nocheck-ordera.txtb.txt 001 02 3 10 5 06 007 10 两个文件都已按照字典序排序,这符合comm命令实现的设定,comm命令的执行结果能够达到预期。执行下述命令,得到如图3所示结果,结果符合预期。 [root@localhost~]#sorta.txt>aa.txt [root@localhost~]#sortb.txt>bb.txt [root@localhost~]#commaa.txtbb.txt 001 007 02 06 10 3 5 [root@localhost~]#cataa.txt 001 02 10 3 [root@localhost~]#catbb.txt 001 007 02 06 10 5 join命令:根据两行中具有相同值的两个字段,将该两行内容拼接成一行打印输出 一、常用用法 join[-tCHAR][-i][--header][-1FIELD][-2FIELD][-eSTR]FILE1FILE2 二、含义与选项 2.1、含义 存在两个已排序文件,假如文件1中的某条记录的某个字段值(默认是第一个字段,从1开始计数)与文件2中的某条记录的某个字段值 (默认是第一个字段,从1开始计数)一致,那么在最终打印结果中,将这两条记录拼接成一条记录。 2.2、选项表示的意思 “-tCHAR”:以“CHAR”字符作为记录内字段间的分隔符,默认的分隔符是“空格符” “-i”:两个字段值比较时,忽略大小写 “–header”:两个文件的第一行作为说明行,不参与比较 “-1FIELD”:FILE1中以第“FIELD”个字段作为比较字段 “-2FIELD”:FILE2中以第“FIELD”个字段作为比较字段 “-eSTR”:在最终的拼接记录中,如果某个字段的值为空,那么以“STR”替换 “FILE1”:文件1 “FILE2”:文件2 示例一 有文件“a.txt”和“b.txt”,内容分别如下: [root@localhost~]#cata.txt a1 b2 [root@localhost~]#catb.txt a3 b4 执行以下命令,得到如下结果: [root@localhost~]#joina.txtb.txt a13 b24 示例二 有文件“a.txt”和“b.txt”,内容分别如下: [root@localhost~]#cata.txt a;1 b;2 [root@localhost~]#catb.txt a;3 b;4 执行以下命令,得到如下结果: [root@localhost~]#join-t';'a.txtb.txt a;1;3 b;2;4 示例三 有文件“a.txt”和“b.txt”,内容分别如下: [root@localhost~]#cata.txt A1 b2 [root@localhost~]#catb.txt a3 b4 执行以下命令,得到如下结果: [root@localhost~]#join-ia.txtb.txt A13 b24 示例四 有文件“a.txt”和“b.txt”,内容分别如下: [root@localhost~]#cata.txt Col1Col2 a1 b2 [root@localhost~]#catb.txt Col3Col4 a3 b4 执行以下命令,得到如下结果: [root@localhost~]#join--headera.txtb.txt Col1Col2Col4 a13 b24 示例五 有文件“a.txt”和“b.txt”,内容分别如下: [root@localhost~]#cata.txt a1f b2g [root@localhost~]#catb.txt f35 g46 执行以下命令,得到如下结果: [root@localhost~]#join-13-21a.txtb.txt fa135 gb246 示例六 有文件“a.txt”和“b.txt”,内容分别如下: [root@localhost~]#cata.txt a b2 [root@localhost~]#catb.txt a3 b4 执行以下命令,得到如下结果: [root@localhost~]#join-e"helloworld"a.txtb.txt ahelloworld3 b24 四、其他 4.1、“LC_COLLATE”等环境变量 由于涉及到两个字符串的比较等,故而程序实现中使用“LC_COLLATE”等环境变量,最终结果受到“LC_COLLATE”等环境变量的控制。 4.2、排序策略 跟“comm”命令一样,join命令实现设定的排序策略是“按照字典序排序”。因而,两个文件“已排序”应该是按照字典序已排序,否则执行join命令得到的结果很有可能不能符合预期。

优秀的个人博客,低调大师

Nightingale 2.2.0 发布,滴滴开源运维监控系统

Nightingale从正式发布到今天5.21号,差不多两个月左右的时间,社区用户参与热情很高,发布了多个版本,最新版本已经到了2.2.0,这里罗列一下相关改进,供大家参考,欢迎大家参与到Nightingale的建设中来,我们希望与社区一起,把监控这个事情,做到极致。 进程采集不但支持采集进程数目,也支持采集进程cpu和mem占用 页面上支持了plugin的配置,可以给plugin脚本传参,通过配置也可以指定只启用部分节点下的plugin 服务端接收到监控数据之后,可以同时转发一份到OpenTSDB或者InfluxDB,转发到Thanos的支持也在开发中 客户端可以用更易用的方式来忽略某些分区的监控数据采集,对docker的/var/lib分区排除有帮助 数据缺失告警支持同时把tag报出来,便于了解具体是哪个指标有问题 看图增加了同环比看图能力,对于周期性的有规律的图形,可以很方便看出趋势 数据模型做了增强,支持了Extra字段,可以用来放置traceid或者日志,打开更多想象空间 客户端与服务端之间的通信从短连接改成长连接,提升性能 优化端口监控策略,先尝试连接127.0.0.1,如果无法连通再尝试连identity中配置的ip,适用面更广 支持了中英文两个语种的界面 在客户端支持了COUNTER类型的指标,这样Open-Falcon的绝大部分插件和采集器都可以复用 支持LDAP获取邮箱、手机号等信息,并回灌数据库 更多优化项就不罗列了,当然,也修复了一些bug,2.2.0这个版本是一个非常稳定的版本,推荐大家试用。

优秀的个人博客,低调大师

标记 (TAG) 您的运维编排(OOS)资源

标签的基本知识 标签是资源Meta信息,标签是一些充当元数据的词和短语,支持用户自定义和系统预制。每个标签都包含一个键(Key)和一个值(Value)。标签是一种资源的属性描述。 标签与资源是 多对多的关系。 标签可让您按各种标准(例如用途、所有者或环境)对 阿里云 资源进行分类。这在您具有相同类型的许多资源时会很有用,您可以根据分配给资源的标签快速识别特定资源。 标签对阿里云资源没有任何语义意义,应严格按字符串进行解析。同时,标签不会自动分配至您的资源。您可以修改标签的key和value,还可以随时删除资源的标签。您可以将标签的值设为空的字符串,但是不能将其设为空值。如果您添加的标签的值与该实例上现有标签的值相同,新的值就会覆盖旧值。如果删除资源,资源的所有标签也会被删除。 可以使用管理控制台 和 API 处理标签。 标签设计详情见最佳实践

优秀的个人博客,低调大师

运维编排场景系列-----如何使用jq

本文主要讲解在OOS如何对任务中的值进行筛选,任务中值的筛选主要依赖模版中两个常见字段,一个是ValueSelector,另一个是PropertySelector,且这两个字段必须配合jq表达式使用。那么接下来就分别讲下jq是什么,两个筛选字段何时需要定义、在哪定义和作用,以及各场景下jq表达式使用的分析。 jq介绍 jq是一个开源的数据处理工具,它可处理JSON格式的数据,比如按照您指定的jq表达式,筛选出JSON中你想要的部分。筛选时,jq把JSON格式的数据作为input,并根据指定的jq表达式进行筛选,然后返回一个output。jq有很多灵活的使用方法,详见后附的jq语法手册。 OOS中的筛选字段 先说下OOS任务中值的筛选目的,无非两种,一种是筛出期待的结果,并将其赋值给某个参数,供其他任务使用该参数;另一种则是筛选出期待的结果,在任务中将结果值与预先指定的值进行比较,用来检查某种条件。所以OOS中有两个用来筛选的字段,分别是ValueSelector和PropertySelector,前者用在给参数赋值前,后者用在检查某个条件前。 当任务有具体Outputs时,需要在Outputs中定义ValueSelector字段,该字段用来筛选任务动作返回的值,并且将筛选结果赋值给Outputs输出的参数。具体讲,如任务的动作为API类动作,则动作返回值即任务调用API后返回的JSON值;若任务的动作为事件触发器,则动作返回值为触发器监控事件发生的JSON消息通知体。筛选方式是jq把动作返回值作为输入参数,通过字段的jq表达式进行筛选,筛选结果作为任务的Outputs输出参数值。 当任务的动作为ACS::WaitFor或ACS::CheckFor时,需要在任务的Properties部分定义PropertySelector字段,该字段用来筛选任务调用API返回的JSON值,筛选方式是jq把API返回的JSON作为输入参数,并通过字段的jq表达式进行筛选,最后OOS将筛选结果与Properties中的DesiredValues或NotDesiredValues字段内包含的值进行比较,比较结果作为任务等待或判断的参考,进而执行后面的逻辑。 jq在OOS中的使用 下面带大家分析下一些公共模版中jq表达式的使用。 ValueSelector 场景1 FormatVersion: OOS-2019-06-01 Description: Adds backend servers by specifying tag. Parameters: loadBalancerId: Description: The ID of the SLB instance. Type: String AllowedPattern: lb-[A-Za-z0-9]* MaxLength: 30 MinLength: 1 tagKey: Description: The specific tag key. Type: String MinLength: 1 tagValue: Description: The specific tag value. Type: String MaxLength: 30 MinLength: 1 OOSAssumeRole: Description: The RAM role to be assumed by OOS. Type: String Default: OOSServiceRole RamRole: '{{ OOSAssumeRole }}' Tasks: - Name: describeRunningInstancesByTag Action: ACS::ExecuteApi Description: Views the ECS instances by specifying tag. Properties: Service: ECS API: DescribeInstances Parameters: Status: Running Tags: - Key: '{{ tagKey }}' Value: '{{ tagValue }}' Outputs: instanceIds: Type: List ValueSelector: .Instances.Instance[].InstanceId 我们来看下上面的模版,请直接看Tasks部分的describeRunningInstancesByTag任务,该任务是有具体Outputs的,其定义了输出名称为instanceIds的参数,参数Type为List,同时也定义了ValueSelector字段,并且该字段的jq表达式为.Instances.Instance[].InstanceId。就如Outputs中参数名 instanceIds字面意思,其表示输出API返回结果中所有ECS实例ID,那么该任务调用的API是DescribeInstances,API返回的JSON结果样例如下。结合此JSON样例,我们看下在.Instances.Instance[].InstanceId作用下,instanceIds最终返回值的获取过程。首先筛选出JSON中Key为Instances的结果,然后对结果继续筛选,获取Key为Instance的结果,该结果是一个数组,此时又对所得结果进行迭代,并将每个迭代结果中Key为InstanceId的值以List类型进行返回,于是得到最终返回值["id-001","id-002"],即'{{describeRunningInstancesByTag.instanceIds}}'的值为["id-001","id-002"]'。 API调用返回样例(JSON) { "PageNumber":"1", "TotalCount":"1", "PageSize":"10", "RequestId":"14A07460-EBE7-47CA-9757-12CC4761D47A", "Instances":{ "Instance":[ { "ImageId":"centos6u5_64_20G_aliaegis_20150130.vhd", "InnerIpAddress":{ "IpAddress":[ "10.170.XX.XXX" ] }, "InstanceId":"id-001", "EipAddress":{}, "InternetMaxBandwidthIn":"-1", "ZoneId":"cn-shenzhen-a", "InstanceNetworkType":"classic", "PublicIpAddress":{ "IpAddress":[ "120.25.XX.XXX" ] }, "InternetChargeType":"PayByTraffic", "HostName":"iZ94t3s0j***", "InstanceType":"ecs.s2.large", "SerialNumber":"51d1353b-22bf-4567-a176-8b3e12e43135", "IoOptimized":"false", "CreationTime":"2015-07-27T07:08Z", "Status":"Running", "VpcAttributes":{ "PrivateIpAddress":{ "IpAddress":[] } }, "InternetMaxBandwidthOut":"1", "SecurityGroupIds":{ "SecurityGroupId":[ "sg-94kd0c***" ] }, "RegionId":"cn-shenzhen", "OperationLocks":{ "LockReason":[] }, "InstanceChargeType":"PostPaid", "ExpiredTime":"2011-09-08T16:00Z", "InstanceName":"FinanceJoshua1" }, { "ImageId":"centos6u5_64_20G_aliaegis_20150130.vhd", "InnerIpAddress":{ "IpAddress":[ "10.170.XX.XXX" ] }, "InstanceId":"id-002", "EipAddress":{}, "InternetMaxBandwidthIn":"-1", "ZoneId":"cn-shenzhen-a", "InstanceNetworkType":"classic", "PublicIpAddress":{ "IpAddress":[ "120.25.XX.XXX" ] }, "InternetChargeType":"PayByTraffic", "HostName":"iZ94t3s0j***", "InstanceType":"ecs.s2.large", "SerialNumber":"51d1353b-22bf-4567-a176-8b3e12e43135", "IoOptimized":"false", "CreationTime":"2015-07-27T07:08Z", "Status":"Running", "VpcAttributes":{ "PrivateIpAddress":{ "IpAddress":[] } }, "InternetMaxBandwidthOut":"1", "SecurityGroupIds":{ "SecurityGroupId":[ "sg-94kd0c***" ] }, "RegionId":"cn-shenzhen", "OperationLocks":{ "LockReason":[] }, "InstanceChargeType":"PostPaid", "ExpiredTime":"2011-09-08T16:00Z", "InstanceName":"FinanceJoshua2" } ] } } 场景2 FormatVersion: OOS-2019-06-01 Description: Resets system disks to its initial state by specifying instance IDs. The specified ECS instances must be in stopped status. Parameters: instanceIds: Description: The ID list of the ECS instance. Type: List maxErrors: Description: The maximum number of errors allowed during task execution. Type: Number Default: 0 concurrency: Description: Concurrency ratio of task execution. Type: Number Default: 1 OOSAssumeRole: Description: The RAM role to be assumed by OOS. Type: String Default: OOSServiceRole RamRole: '{{ OOSAssumeRole }}' Tasks: - Name: checkInstanceReady Action: ACS::CheckFor Description: Checks ECS instances is in the stopped status. Properties: Service: ECS API: DescribeInstances Parameters: InstanceIds: - '{{ ACS::TaskLoopItem }}' DesiredValues: - Stopped PropertySelector: Instances.Instance[].Status Loop: MaxErrors: '{{ maxErrors }}' Concurrency: '{{ concurrency }}' Items: '{{ instanceIds }}' - Name: querySystemDisks Action: ACS::ExecuteAPI Description: Views system disk of the ECS instance. Properties: Service: ECS API: DescribeDisks Parameters: InstanceId: '{{ ACS::TaskLoopItem }}' DiskType: system Loop: Items: '{{ instanceIds }}' Outputs: diskIds: AggregateType: Fn::ListJoin AggregateField: diskId Outputs: diskId: Type: String ValueSelector: .Disks.Disk[].DiskId 我们来看下上面的模版,请直接看Tasks部分的querySystemDisks任务,该任务是有具体Outputs的,其定义了输出名称为 diskId的参数,参数Type为 String,同时也定义了ValueSelector字段,并且该字段的jq表达式为 .Disks.Disk[].DiskId。就如Outputs中参数名diskId字面意思,其表示输出API返回结果中的磁盘ID,那么该任务调用的API是DescribeDisks,API返回的JSON结果样例如下。结合此JSON样例,我们看下在 .Disks.Disk[].DiskId作用下,diskId最终返回值的获取过程。首先筛选出JSON中Key为Disks的结果,然后对结果继续筛选,获取Key为Disk的结果,该结果是一个数组,此时又对所得结果进行迭代,并将每个迭代结果中Key为DiskId的值以String类型进行返回,于是得到最终返回值 'd-28m5zb1sz',即'{{querySystemDisks.diskId}}'的值为'd-28m5zb1sz'。 上面可能有疑问,该场景的jq表达式和场景一的类似,且处理的数据结构也一样,为何此处最后只返回了一个String,而不像场景一返回了List。简单解释下,其实返回参数的Type是不同的,当Type为List时,OOS最后会把返回的一个或多个结果装到List中作为最终结果返回;当Type为String时,OOS最后会取返回的一个或多个结果中的第一个来作为最终结果。 API调用返回样例(JSON) { "PageNumber":1, "TotalCount":9, "PageSize":2, "RequestId":"ACD9BBB0-A9D1-46D7-9630-B7A69889E110", "Disks":{ "Disk":[ { "ImageId":"", "Description":"", "Device":"", "ProductCode":"", "Portable":true, "DetachedTime":"2014-07-23T08:28:48Z", "Type":"data", "InstanceId":"", "ZoneId":"cn-qingdao-b", "EnableAutoSnapshot":false, "DiskName":"", "AttachedTime":"2014-07-23T07:47:35Z", "SourceSnapshotId":"", "CreationTime":"2014-07-23T02:44:07Z", "Status":"Available", "DeleteAutoSnapshot":true, "Category":"cloud", "RegionId":"cn-qingdao", "DeleteWithInstance":false, "OperationLocks":{ "OperationLock":[] }, "DiskId":"d-28m5zb1sz", "Size":5 }, { "ImageId":"", "Description":"", "Device":"", "ProductCode":"", "Portable":true, "DetachedTime":"", "Type":"data", "InstanceId":"", "ZoneId":"cn-qingdao-b", "EnableAutoSnapshot":false, "DiskName":"", "AttachedTime":"", "SourceSnapshotId":"", "CreationTime":"2014-07-23T02:44:06Z", "Status":"Available", "DeleteAutoSnapshot":true, "Category":"cloud", "RegionId":"cn-qingdao", "DeleteWithInstance":false, "OperationLocks":{ "OperationLock":[] }, "DiskId":"d-28zfrmo13", "Size":5 } ] } } 场景3 --- FormatVersion: OOS-2019-06-01 Description: Start ECS instance when instance is stopped. Parameters: accessToken: Description: Dingtalk access_token to be notified. Type: String AllowedPattern: '[A-Za-z0-9]*' regionId: Description: The Region Id of SLB and Instance. Type: String MinLength: 1 MaxLength: 30 OOSAssumeRole: Description: The RAM role to be assumed by OOS. Type: String Default: OOSServiceRole loadBalancerId: Description: The ID of the SLB instance. Type: String AllowedPattern: lb-[A-Za-z0-9]* MaxLength: 30 MinLength: 1 RamRole: '{{OOSAssumeRole}}' Tasks: - Name: whenInstanceStopped Action: 'ACS::EventTrigger' Properties: Product: ECS Name: - 'Instance:StateChange' Level: - INFO Content: state: - Stopped Outputs: instanceId: ValueSelector: content.resourceId Type: String - Name: checkNeedRemoveOrNot Action: ACS::CheckFor Description: check the interrupted Instance is being added on SLB or Not. OnError: ACS::END OnSuccess: ACS::NEXT Properties: Service: SLB API: DescribeLoadBalancerAttribute Parameters: RegionId: '{{ regionId }}' LoadBalancerId: '{{ loadBalancerId }}' DesiredValues: - "{{whenInstanceStopped.instanceId}}" PropertySelector: 'BackendServers.BackendServer[].ServerId|select(.=="{{whenInstanceStopped.instanceId}}")' - Name: queryLoadBalancerAttribute Action: ACS::ExecuteApi Description: Views ECS instances to backend servers. Properties: Service: SLB API: DescribeLoadBalancerAttribute Parameters: RegionId: '{{ regionId }}' LoadBalancerId: '{{ loadBalancerId }}' Outputs: removeOrNot: Type: List ValueSelector: 'BackendServers.BackendServer[]|select(.ServerId=="{{whenInstanceStopped.instanceId}}")' backendServersToRemove: Type: List ValueSelector: 'BackendServers.BackendServer[]|select(.ServerId=="{{whenInstanceStopped.instanceId}}")|del(.Type)' 我们来看下上面的模版,先看Tasks部分的whenInstanceStopped任务,它会输出一个名为 instanceId的参数,关于这个任务知道这些就够了。然后看Tasks部分的 queryLoadBalancerAttribute任务,该任务是有具体Outputs的,比如其定义了输出名称为 backendServersToRemove的参数,参数Type为 List,同时也在参数中定义了ValueSelector字段,并且该字段的jq表达式为.BackendServers.BackendServer[]|select(.ServerId=="{{whenInstanceStopped.instanceId}}")|del(.Type),表达式好长,没关系,我们分析完,您就会发现它很简单。就如Outputs中参数名backendServersToRemove字面意思,其表示输出API返回结果中的后端服务器列表,那么该任务调用的API是DescribeLoadBalancerAttribute,API返回的JSON结果样例如下。结合此JSON样例,我们看下在这个很长的jq表达式作用下,backendServersToRemove最终返回值的获取过程。首先筛选出JSON中Key为BackendServers的结果,然后对结果继续筛选,获取Key为BackendServer的结果,该结果是一个数组,此时对所得结果进行迭代,然后我们看到的管道符 |,也就是把迭代获取的所有结果交到下一段操作,操作是,将每个迭代结果中Key为ServerId的值与whenInstanceStopped任务输出参数instanceId的值进行比较。如果比较结果是相等,则拿到该ServerId所在的这个Mapping,并将该Mapping中Key为的Type的key-val对剔除,再把该Mapping返回;如果比较结果为不相等,则忽略掉这个ServerId所在的Mapping。比较完后做下整理把所有返回的Mapping放在一个List中返回。假如whenInstanceStopped.instanceId值是"i-bp1234",得到最终返回值则为 [{"ServerId":"i-bp1234","Weight":100 }],即'{{queryLoadBalancerAttribute.backendServersToRemove}}'的值为[{"ServerId":"i-bp1234","Weight":100 }]。 API调用返回样例(JSON) { "CreateTimeStamp":1541679713000, "RegionIdAlias":"cn-hangzhou", "HasReservedInfo":"false", "BackendServers":{ "BackendServer":[ { "ServerId":"i-bpxccv123456jo7v", "Weight":100, "Type":"ecs" } ] }, "ListenerPorts":{ "ListenerPort":[] }, "VSwitchId":"vsw-bp1ccv123456jk9bmlj", "InternetChargeType":"paybytraffic", "VpcId":"vpc-bp1ccv123456j1qc5cm", "SlaveZoneId":"cn-hangzhou-d", "NetworkType":"vpc", "LoadBalancerSpec":"slb.s2.small", "ListenerPortsAndProtocol":{ "ListenerPortAndProtocol":[] }, "PayType":"PayOnDemand", "Bandwidth":5120, "LoadBalancerName":"abc1", "ResourceGroupId":"rg-acfmxazb4ph6aiy", "AddressIPVersion":"ipv4", "LoadBalancerId":"lb-bp23456jfuca5", "EndTimeStamp":32493801600000, "MasterZoneId":"cn-hangzhou-b", "ListenerPortsAndProtocal":{ "ListenerPortAndProtocal":[] }, "Address":"192.168.0.6", "RegionId":"cn-hangzhou", "RequestId":"35D745B3-1567-4855-9EF1-F5CED3C1670C", "CreateTime":"2018-11-08T12:21:53Z", "EndTime":"2999-09-08T16:00:00Z", "AddressType":"intranet", "LoadBalancerStatus":"active" } PropertySelector 场景1(CheckFor) FormatVersion: OOS-2019-06-01 Description: Creates a disk and attaches a data disk to an ECS instance. Parameters: diskName: Description: The name of the disk. Type: String zoneId: Description: The zone ID that is available in the specified region. Type: String diskCategory: Description: The category of the data disk. Type: String instanceId: Description: Creates a subscription disk and the system automatically attaches it to a subscription instance with the InstanceId you specified. Type: String AllowedPattern: i-[A-Za-z0-9]* MinLength: 1 MaxLength: 30 size: Description: The size of the disk. Type: String Tasks: - Name: checkInstanceReady Action: ACS::CheckFor Description: Checks whether the ECS instance status is running or stopped. Properties: Service: ECS API: DescribeInstances Parameters: InstanceIds: - '{{ instanceId }}' DesiredValues: - Running - Stopped PropertySelector: .Instances.Instance[].Status 我们来看下上面的模版,请直接看Tasks部分的checkInstanceReady任务,该任务的动作是 ACS::CheckFor,其Properties部分定义了DesiredValues的值为 ['Running','Stopped'],同时也定义了PropertySelector字段,并且该字段的jq表达式为 .Instances.Instance[].Status。该任务中,DesiredValues和PropertySelector两个字段会被联合起来,用来验证指定的条件即['Running','Stopped'],验证过程为先把API返回的JSON结果通过jq表达式筛选处理,再检查处理得到的筛选结果是否在DesiredValues字段的List中。如果在List中,则该任务执行结果为Success,否则该任务执行结果为Failed。那么该任务调用的API是DescribeInstances,API返回的JSON结果样例如下。结合此JSON样例,我们看下在 .Instances.Instance[].Status作用下,最终返回值的获取过程。首先筛选出JSON中Key为Instances的结果,然后对结果继续筛选,获取Key为Instance的结果,该结果是一个数组,此时对所得结果进行迭代,迭代获取数组中的第一个元素,并将该元素中Key为 Status的值作为与指定的条件比较的值,即检查'Running'是否在['Running','Stopped']中。 API调用返回样例(JSON) { "PageNumber":"1", "TotalCount":"1", "PageSize":"10", "RequestId":"14A07460-EBE7-47CA-9757-12CC4761D47A", "Instances":{ "Instance":[ { "ImageId":"centos6u5_64_20G_aliaegis_20150130.vhd", "InnerIpAddress":{ "IpAddress":[ "10.170.XX.XXX" ] }, "InstanceId":"id-001", "EipAddress":{}, "InternetMaxBandwidthIn":"-1", "ZoneId":"cn-shenzhen-a", "InstanceNetworkType":"classic", "PublicIpAddress":{ "IpAddress":[ "120.25.XX.XXX" ] }, "InternetChargeType":"PayByTraffic", "HostName":"iZ94t3s0j***", "InstanceType":"ecs.s2.large", "SerialNumber":"51d1353b-22bf-4567-a176-8b3e12e43135", "IoOptimized":"false", "CreationTime":"2015-07-27T07:08Z", "Status":"Running", "VpcAttributes":{ "PrivateIpAddress":{ "IpAddress":[] } }, "InternetMaxBandwidthOut":"1", "SecurityGroupIds":{ "SecurityGroupId":[ "sg-94kd0c***" ] }, "RegionId":"cn-shenzhen", "OperationLocks":{ "LockReason":[] }, "InstanceChargeType":"PostPaid", "ExpiredTime":"2011-09-08T16:00Z", "InstanceName":"FinanceJoshua1" }, { "ImageId":"centos6u5_64_20G_aliaegis_20150130.vhd", "InnerIpAddress":{ "IpAddress":[ "10.170.XX.XXX" ] }, "InstanceId":"id-002", "EipAddress":{}, "InternetMaxBandwidthIn":"-1", "ZoneId":"cn-shenzhen-a", "InstanceNetworkType":"classic", "PublicIpAddress":{ "IpAddress":[ "120.25.XX.XXX" ] }, "InternetChargeType":"PayByTraffic", "HostName":"iZ94t3s0j***", "InstanceType":"ecs.s2.large", "SerialNumber":"51d1353b-22bf-4567-a176-8b3e12e43135", "IoOptimized":"false", "CreationTime":"2015-07-27T07:08Z", "Status":"Running", "VpcAttributes":{ "PrivateIpAddress":{ "IpAddress":[] } }, "InternetMaxBandwidthOut":"1", "SecurityGroupIds":{ "SecurityGroupId":[ "sg-94kd0c***" ] }, "RegionId":"cn-shenzhen", "OperationLocks":{ "LockReason":[] }, "InstanceChargeType":"PostPaid", "ExpiredTime":"2011-09-08T16:00Z", "InstanceName":"FinanceJoshua2" } ] } } 场景2(WaitFor) FormatVersion: OOS-2019-06-01 Description: Creates a custom image. Parameters: imageName: Description: The image name. Type: String instanceId: Description: The ID of the instance. Type: String AllowedPattern: i-[A-Za-z0-9]* MinLength: 1 MaxLength: 30 Tasks: - Name: checkInstanceReady Action: ACS::CheckFor Description: Checks whether the ECS instance status is running or stopped. Properties: Service: ECS API: DescribeInstances Parameters: InstanceIds: - '{{ instanceId }}' DesiredValues: - Running - Stopped PropertySelector: Instances.Instance[].Status - Name: createImage Action: ACS::ExecuteAPI Description: Creates a custom image. Properties: Service: ECS API: CreateImage Parameters: ImageName: '{{ imageName }}' InstanceId: '{{ instanceId }}' Outputs: imageId: Type: String ValueSelector: ImageId - Name: untilImageReady Action: ACS::WaitFor Description: Waits for the image to be available. Properties: Service: ECS API: DescribeImages Parameters: ImageId: '{{ createImage.imageId }}' DesiredValues: - Available PropertySelector: .Images.Image[].Status 我们来看下上面的模版,请直接看Tasks部分的untilImageReady任务,该任务的动作是 ACS::WaitFor,其Properties部分定义了DesiredValues的值为 ['Available'],同时也定义了PropertySelector字段,并且该字段的jq表达式为 .Images.Image[].Status。该任务中,DesiredValues和PropertySelector两个字段会被联合起来,用来验证指定的条件即['Available'],验证过程为先把API返回的JSON结果通过jq表达式筛选处理,再检查处理得到的筛选结果是否在DesiredValues字段的List中。如果在List中,则该任务不再继续等待,并结束该任务向下执行;否则该任务会隔段时间再次调用API,并检查结果是否满足条件,直至条件满足或超出最大检查次数。那么该任务调用的API是DescribeImages,API返回的JSON结果样例如下。结合此JSON样例,我们看下在 .Images.Image[].Status作用下,最终返回值的获取过程。首先筛选出JSON中Key为Images的结果,然后对结果继续筛选,获取Key为Image的结果,该结果是一个数组,此时对所得结果进行迭代,迭代获取数组中的第一个元素,并将该元素中Key为 Status的值作为与指定的条件比较的值,即检查'Available'是否在['Available']中。 API调用返回样例(JSON) { "PageNumber":1, "TotalCount":24, "PageSize":1, "RequestId":"49CBCED4-C9B9-4851-BEB5-8FB5E5169E30", "RegionId":"cn-hangzhou", "Images":{ "Image":[ { "ImageId":"suse11sp3_64_20G_aliaegis_20150428.vhd", "OSType":"linux", "Architecture":"x86_64", "OSName":"SUSE Linux Enterprise Server 11 SP3 64位", "DiskDeviceMappings":{ "DiskDeviceMapping":[ { "Device":"/dev/xvda", "Size":"20" } ] }, "ImageOwnerAlias":"system", "Progress":"100%", "Usage":"instance", "CreationTime":"2015-05-06T09:01:32Z", "Status":"Available", "ImageVersion":"1", "ImageName":"suse11sp3_64_20G_aliaegis_20150428.vhd", "IsCopied":false, "IsSubscribed":false, "Platform":"SUSE", "Size":20 } ] } } jq语法手册 基础用法 通过Key筛选 jq表达式:".foo"input: {"foo": 42, "bar": "less interesting data"} output: 42 通过Index筛选 jq表达式:".[0]"input: [{"name":"JSON", "good":true}, {"name":"XML", "good":false}] output: { "name": "JSON", "good": true } 通过Iterator筛选 jq表达式:".[]"input: ["hello","world"] output: "hello" "world" jq表达式:".[]"input: [{"name":"JSON", "good":true}, {"name":"XML", "good":false}] output: { "name": "JSON", "good": true } { "name": "XML", "good": false } 通过Pipe("|")筛选 jq表达式:".[]|.name"input: [{"name":"JSON", "good":true}, {"name":"XML", "good":false}] output: "JSON" "XML" 构造Array jq表达式:"[.user, .projects[]]"input: {"user":"stedolan", "projects": ["jq", "wikiflow"]} output: [ "stedolan", "jq", "wikiflow" ] 构造Mapping jq表达式:"{user, title: .titles}"input: {"user":"stedolan","titles":["JQ Primer", "More JQ"]} output: { "user": "stedolan", "title": [ "JQ Primer", "More JQ" ] } jq表达式:"{(.user): .titles}"input: {"user":"stedolan","titles":["JQ Primer", "More JQ"]} output: { "stedolan": [ "JQ Primer", "More JQ" ] } 内建操作符和函数 Addition(+) jq表达式:".a + 1"input: {"a": 7} output: 8 jq表达式:".a + .b"input: {"a": [1,2], "b": [3,4]} output: [ 1, 2, 3, 4 ] Subtraction(-) jq表达式:". - ["xml", "yaml"]"input: ["xml", "yaml", "json"] output: [ "json" ] Length jq表达式:"[.[]| length]"input: [[1,2], "string", {"a":2}, null] output: [ 2, 6, 1, 0 ] Keys jq表达式:"keys"input: {"abc": 1, "abcd": 2, "Foo": 3} output: [ "Foo", "abc", "abcd" ] In jq表达式:'.[] | in({"foo": 42})'input: ["foo", "bar"] output: true false map jq表达式:"map(.+1)"input: [1,2,3] output: [ 2, 3, 4 ] map_values jq表达式:"map_values(.+1)"input: {"a": 1, "b": 2, "c": 3} output: { "a": 2, "b": 3, "c": 4 } del jq表达式:"del(.foo)"input: {"foo": 42, "bar": 9001, "baz": 42} output: { "bar": 9001, "baz": 42 } select jq表达式:'.[] | select(.id == "second")'input: [{"id": "first", "val": 1}, {"id": "second", "val": 2}] output: { "id": "second", "val": 2 } jq表达式:"map(select(. >= 2))"input: [1,5,3,0,7] output: [ 5, 3, 7 ] any jq表达式:"any"input: [true, false] output: true jq表达式:"any"input: [false, false] output: false all jq表达式:"all"input: [true, false] output: false jq表达式:"all"input: [true, true] output: true jq表达式:"all"input: [] output: true jq表达式:"all"input: [] output: true min、max jq表达式:"min"input: [5,4,2,7] output: 2 sort、sort_by jq表达式:"sort"input: [8,3,null,6] output: [ null, 3, 6, 8 ] jq表达式:"sort_by(.foo)"input: [{"foo":4, "bar":10}, {"foo":3, "bar":100}, {"foo":2, "bar":1}] output: [ { "foo": 2, "bar": 1 }, { "foo": 3, "bar": 100 }, { "foo": 4, "bar": 10 } ] index jq表达式:'index(", ")'input: "a,b, cd, efg, hijk" output: 3 split jq表达式:'split(", ")'input: "a, b,c,d, e, " output: [ "a", "b,c,d", "e", "" ] join jq表达式:'join(", ")'input: ["a","b,c,d","e"] output: "a, b,c,d, e" jq表达式:'join(" ")'input: ["a",1,2.3,true,null,false] output: "a 1 2.3 true false" 条件判断 if-then-else jq表达式: 'if . == 0 then "zero"elif . == 1 then "one"else "many"end' input: 2 output: "many" >, <,>=, <=,==,!= jq表达式: '.<5' input: 2 output: true jq表达式:'.==5' input: 2 output: false 高级用法 变量 jq表达式:".bar as $x | .foo | . + $x"input: {"foo":10, "bar":200} output: 210 jq表达式:". as $i|[(.*2|. as $i| $i), $i]"input: 5 output: [ 10, 5 ] 自定义函数 jq表达式:"def addvalue(f): . + [f]; map(addvalue(.[0]))"input: [[1,2],[10,20]] output: [ [ 1, 2, 1 ], [ 10, 20, 10 ] ] jq表达式:"def addvalue(f): f as $x | map(. + $x); addvalue(.[0])"input: [[1,2],[10,20]] output: [ [ 1, 2, 1, 2 ], [ 10, 20, 1, 2 ] ]

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册