首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10000篇文章
优秀的个人博客,低调大师

dubbo 入门

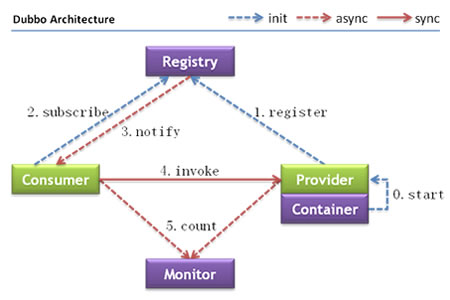
1 介绍 1.1 背景 随着互联网的发展,网站应用的规模不断扩大,常规的垂直应用架构已无法应对,分布式服务架构以及流动计算架构势在必行,亟需一个治理系统确保架构有条不紊的演进。 1.2 说明 DUBBO是一个分布式服务框架,致力于提供高性能和透明化的RPC远程服务调用方案,是阿里巴巴SOA服务化治理方案的核心框架。 1.3 功能 启动时检查、集群容错、负载均衡、线程模型、直连提供者、只订阅、只注册、静态服务、多协议、多注册中心、服务分组、多版本、分组聚合、参数验证、结果缓存、泛化引用、泛化实现、回声测试、上下文信息、隐式传参、异步调用、本地调用、参数回调、事件通知、本地存根、本地伪装、延迟暴露、并发控制、连接控制、延迟连接、粘滞连接、令牌验证、路由规则、配置规则、服务降级、优雅停机、主机绑定、日志适配、访问日志、服务容器、Reference Config缓存、分布式事务 1.4 支持的协议 dubbo rmi http webservice thrift memcached redis 2 环境准备 Java7、Java8 ZooKeeper Maven Tomcat7 Eclipse 3 架构图 节点角色说明及对应demo模块: Provider: 暴露服务的服务提供方。对应dubbo-demo-provider。 Consumer: 调用远程服务的服务消费方。对应dubbo-demo-consumer Registry: 服务注册与发现的注册中心。这个demo使用ZooKeeper,关于ZooKeeper的搭建可参考这篇文章。 Monitor: 统计服务的调用次调和调用时间的监控中心。需要搭建dubbo-admin,对应的war包可从这里下载,也可自行编译运行。 Container: 服务运行容器。使用Tomcat跟Jetty。 我的demo代码:https://github.com/JasperZXY/dubbo-demo 4 开始搭建项目 4.1 说明 下面的代码是在Java8下运行通过的。 4.2 创建maven项目 名称为dubbo-demo,加入需要的jar,这里把各个项目需要的jar包都放入了父pom中,实际项目最好做好分类,如下 <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <junit.version>4.12</junit.version> <spring.version>4.3.8.RELEASE</spring.version> <dubbo.version>2.5.3</dubbo.version> <zookeeper.version>3.4.10</zookeeper.version> <zkclient.version>0.10</zkclient.version> <jackson.version>2.7.4</jackson.version></properties><dependencies> <dependency> <groupId>junit</groupId> <artifactId>junit</artifactId> <version>${junit.version}</version> <scope>test</scope> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-webmvc</artifactId> <version>${spring.version}</version> </dependency> <!--SpringMVC集成slf4j-logback--> <dependency> <groupId>ch.qos.logback</groupId> <artifactId>logback-classic</artifactId> <version>1.1.3</version> </dependency> <dependency> <groupId>org.logback-extensions</groupId> <artifactId>logback-ext-spring</artifactId> <version>0.1.2</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>jcl-over-slf4j</artifactId> <version>1.7.12</version> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>dubbo</artifactId> <version>${dubbo.version}</version> <exclusions> <exclusion> <!--排除传递spring依赖,防止冲突--> <artifactId>spring</artifactId> <groupId>org.springframework</groupId> </exclusion> </exclusions> </dependency> <!--导入zookeeper依赖--> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>${zookeeper.version}</version> </dependency> <dependency> <groupId>com.github.sgroschupf</groupId> <artifactId>zkclient</artifactId> <version>0.1</version> </dependency> <dependency> <groupId>org.jboss.netty</groupId> <artifactId>netty</artifactId> <version>3.2.10.Final</version> </dependency> <dependency> <groupId>com.101tec</groupId> <artifactId>zkclient</artifactId> <version>${zkclient.version}</version> </dependency> <!--jackson--> <dependency> <groupId>com.fasterxml.jackson.core</groupId> <artifactId>jackson-databind</artifactId> <version>${jackson.version}</version> </dependency> <dependency> <groupId>com.fasterxml.jackson.core</groupId> <artifactId>jackson-core</artifactId> <version>${jackson.version}</version> </dependency> <dependency> <groupId>com.fasterxml.jackson.core</groupId> <artifactId>jackson-annotations</artifactId> <version>${jackson.version}</version> </dependency></dependencies> 4.3 dubbo-demo-api 这个模块用于定义接口以及交互的实体对象,创建一个User跟UserService publicclassUserimplementsjava.io.Serializable{privatestaticfinallongserialVersionUID=-2218791253527448503L;privateLongid;privateStringusername;privateStringpassword;privateIntegerage;//这里省略了getset方法 @Override publicStringtoString(){return"User[id="+id+",username="+username+",password="+password+",age="+age+"]"; } } publicinterfaceUserService{publicList<User>queryAll(); } 4.4 dubbo-demo-provider 这个模块用于提供服务,是使用main方法直接运行的。 1、需要添加dubbo-demo-api这个依赖,pom.xml如下 <dependency> <groupId>zxy.demo</groupId> <artifactId>dubbo-demo-api</artifactId> <version>${project.parent.version}</version></dependency> 2、UserService的实现 publicclassUserServiceImplimplementsUserService{/***这里通过模拟查询数据库返回用户信息*/ @Override publicList<User>queryAll(){ List<User>list=newArrayList<User>();for(inti=0;i<3;i++){ Randomrandom=newRandom(); Useruser=newUser(); user.setAge(random.nextInt(10)+18); user.setId(Long.valueOf(i+1)); user.setPassword("123456"); user.setUsername("name_"+i); list.add(user); }returnlist; } } 3、Spring配置 <beansxmlns="http://www.springframework.org/schema/beans"xmlns:context="http://www.springframework.org/schema/context"xmlns:p="http://www.springframework.org/schema/p"xmlns:aop="http://www.springframework.org/schema/aop"xmlns:tx="http://www.springframework.org/schema/tx"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xmlns:dubbo="http://code.alibabatech.com/schema/dubbo"xsi:schemaLocation="http://www.springframework.org/schema/beanshttp://www.springframework.org/schema/beans/spring-beans-4.0.xsdhttp://www.springframework.org/schema/contexthttp://www.springframework.org/schema/context/spring-context-4.0.xsdhttp://www.springframework.org/schema/aophttp://www.springframework.org/schema/aop/spring-aop-4.0.xsdhttp://www.springframework.org/schema/txhttp://www.springframework.org/schema/tx/spring-tx-4.0.xsdhttp://code.alibabatech.com/schema/dubbohttp://code.alibabatech.com/schema/dubbo/dubbo.xsd"> <!--提供方应用信息,用于计算依赖关系--> <dubbo:applicationname="dubbo-demo-provider"/> <!--这里使用的注册中心是zookeeper--> <dubbo:registryaddress="zookeeper://127.0.0.1:2181"client="zkclient"/> <!--用dubbo协议在20880端口暴露服务--> <dubbo:protocolname="dubbo"port="20880"/> <!--将该接口暴露到dubbo中--> <dubbo:serviceinterface="zxy.demo.dubbo.api.service.UserService"ref="userServiceImpl"/> <!--将具体的实现类加入到Spring容器中--> <beanid="userServiceImpl"class="zxy.demo.dubbo.provider.service.UserServiceImpl"/></beans> 注:如果<dubbo:标签有报错的,可下载一个dubbo.xsd文件(可从我的git上找到),在Eclipse上windows->preferrence->XML->XML Catalog->add->catalog entry->file system,选择刚刚下载的文件路径,修改key值(dubbo.xsd),保存。在xml文件右键validate即可解决。 4、编写启动方法 ublicclassApplication{@SuppressWarnings("resource")publicstaticvoidmain(String[]args)throwsException{ (newClassPathXmlApplicationContext(newString[]{"spring/provider.xml"})).start();//保持main方法不退出 CountDownLatchlatch=newCountDownLatch(1); latch.await(); } } 4.5 dubbo-demo-consumer 这个模块用于调用dubbo-demo-provider提供的服务,使用SpringMVC进行运行。 1、需要添加dubbo-demo-api这个依赖,pom.xml如下 <dependency> <groupId>zxy.demo</groupId> <artifactId>dubbo-demo-api</artifactId> <version>${project.parent.version}</version></dependency> 2、Spring的配置 appContext.xml,主配置文件 <context:component-scanbase-package="zxy.demo.dubbo.consumer"></context:component-scan><importresource="classpath*:spring/dubbo-*.xml"/><importresource="classpath*:spring/springmvc-servlet.xml"/> springmvc-servlet.xml <!--添加注解驱动--><mvc:annotation-driven/><!--返回json支持--><beanid="jsonConverter"class="org.springframework.http.converter.json.MappingJackson2HttpMessageConverter"> <propertyname="supportedMediaTypes"> <list> <value>text/html;charset=UTF-8</value> </list> </property></bean> dubbo-consumer.xml <!--提供方应用信息,用于计算依赖关系--><dubbo:applicationname="dubbo-demo-consumer"/><!--这里使用的注册中心是zookeeper--><dubbo:registryaddress="zookeeper://127.0.0.1:2181"client="zkclient"/><!--从注册中心中查找服务--><dubbo:referenceid="userService"interface="zxy.demo.dubbo.api.service.UserService"/> 3、web.xml <?xmlversion="1.0"encoding="UTF-8"?><web-appversion="3.0"xmlns="http://java.sun.com/xml/ns/javaee"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://java.sun.com/xml/ns/javaeehttp://java.sun.com/xml/ns/javaee/web-app_3_0.xsd"> <context-param> <param-name>contextConfigLocation</param-name> <param-value>classpath:spring/appContext.xml</param-value> </context-param> <listener> <listener-class>org.springframework.web.context.ContextLoaderListener</listener-class> </listener> <listener> <listener-class>ch.qos.logback.ext.spring.web.LogbackConfigListener</listener-class> </listener> <servlet> <servlet-name>springmvc</servlet-name> <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class> <init-param> <param-name>contextConfigLocation</param-name> <param-value></param-value> </init-param> <load-on-startup>1</load-on-startup> </servlet> <servlet-mapping> <servlet-name>springmvc</servlet-name> <url-pattern>/</url-pattern> </servlet-mapping> </web-app> 4、controller 调用远程服务并返回前端数据。 @Controller@RequestMapping("/user")publicclassUserController{@Autowired privateUserServiceuserService; @RequestMapping("/list")@ResponseBody publicObjectlistAll(){returnuserService.queryAll(); } } 4.6 运行 先启动ZooKeeper 启动dubbo-demo-provider 启动dubbo-demo-consumer,mvn jetty:run -Djetty.port=8083 访问http://127.0.0.1:8083/user/list获取数据 5 监控 自行编译运行dubbo-admin或从我的git上下载dubbo-admin-2.5.3.war,放入tomcat中运行。默认用的注册中心是zookeeper://127.0.0.1:2181,可修改,在WEB-INF/dubbo.properties中进行修改。 启动后访问http://127.0.0.1:8080/dubbo-admin-2.5.3,如果war包是改名为ROOT.war后运行的,则访问http://127.0.0.1:8080/,输入账号密码(root/root)。 注意,由于现在很多机器都安装了高版本的Java8,运行这个dubbo-admin将导致出错,报错信息为“Bean property 'URIType' is not writable or has an invalid setter method”,详见官方的issues。我自己的解决方法是下载一个低版本的Java,修改tomcat对应的Java版本,找到setclasspath.bat中的set _RUNJAVA,set _RUNJDB这两行,修改如下: set_RUNJAVA="C:\ProgramFiles\Java\jdk1.7.0_80\bin\java.exe"set_RUNJDB="C:\ProgramFiles\Java\jdk1.7.0_80\bin\jdb.exe" 本文转自帅气的头头博客51CTO博客,原文链接http://blog.51cto.com/12902932/1925692如需转载请自行联系原作者 sshpp
优秀的个人博客,低调大师

elasticsearch入门

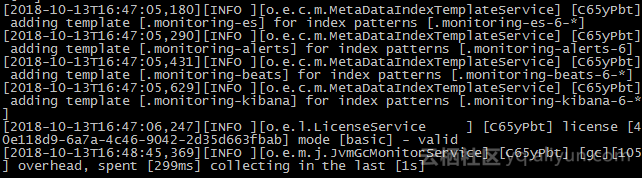
elasticsearch 本文基于elasticsearch-6.4.2版本 安装 1、安装JDK略2、安装es wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-6.4.2.tar.gz; tar -zxvf elasticsearch-6.4.2.tar.gz; mv elasticsearch-6.4.2 /usr/local; #创建用户elasticsearch 有elasticsearch 不能使用root账户运行,必须先创建用户 useradd elasticsearch; chown -R elasticsearch:elasticsearch /usr/local/elasticsearch-6.4.2/ ; #启动运行 su elasticsearch cd /usr/local/elasticsearch-6.4.2; sh ./bin/elasticsearch; 启动成功后,如下所示 3、安装head_plugin插件elasticsearch-6.x版本不支持使用elasticsearch-plugin install mobz/elasticsearch-head的方式安装。官方支持的plugin安装的方式的插件为 #安装head_plugin插件 wget https://github.com/mobz/elasticsearch-head/archive/master.zip yum install -y unzip; unzip master.zip; mv elasticsearch-head-master/ /usr/local/ #安装node wget https://npm.taobao.org/mirrors/node/v10.11.0/node-v10.11.0-linux-x64.tar.gz tar -zxvf node-v10.11.0-linux-x64.tar.gz mv node-v10.11.0-linux-x64 /usr/local/ vi /etc/profile #set node NODE_HOME=/usr/local/node-v10.11.0-linux-x64 export PATH=$PATH:$NODE_HOME/bin export NODE_PATH=$NODE_HOME/lib/node_modules "/etc/profile" 89L, 2079C written [root@k8s-master-101 ~]# source /etc/profile [root@k8s-master-101 ~]# node -v v10.11.0 #elasticsearch配置文件中授权 node.name: node-rcl-1 cluster.name: my-application-rcl network.host: 192.168.31.101 http.cors.enabled: true http.cors.allow-origin: "*" 启动过程中的几个问题: 1.max file descriptors [4096] for elasticsearch process is too low, increase to at least [65536] 2.max number of threads [1024] for user [lishang] likely too low, increase to at least [4096] 3.max virtual memory areas vm.max_map_count [65530] likely too low, increase to at least [262144] 分别修改 vi /etc/security/limits.conf elasticsearch hard nofile 65536 elasticsearch sorf nofile 65536 vi /etc/security/limits.d/20-nproc.conf * soft nproc 4096 * hard nproc 4096 elasticsearch soft nproc 4096 elasticsearch hard nproc 4096 #需要重启操作系统生效,使用ulimit -a 查看线程限制数 vi /etc/sysctl.conf vm.max_map_count=262144 4、启动ES、head-plugin #启动es cd /usr/local/elasticsearch-6.4.2 ./bin/elasticsearch -d #启动head-plugin cd /usr/local/elasticsearch-head-master npm run start 5、访问 ES的基本概念 群集 集群是一个或多个节点(服务器)的集合,它们共同保存您的整个数据,并提供跨所有节点的联合索引和搜索功能。群集由唯一名称标识,默认情况下为“elasticsearch”。此名称很重要,因为如果节点设置为按名称加入群集,则该节点只能是群集的一部分。 确保不要在不同的环境中重用相同的群集名称,否则最终会导致节点加入错误的群集。例如,您可以使用logging-dev,logging-stage以及logging-prod 用于开发,登台和生产集群。 请注意,如果群集中只有一个节点,那么它是完全正常的。此外,您还可以拥有多个独立的集群,每个集群都有自己唯一的集群名称。 节点 节点是作为群集一部分的单个服务器,存储数据并参与群集的索引和搜索功能。就像集群一样,节点由名称标识,默认情况下,该名称是在启动时分配给节点的随机通用唯一标识符(UUID)。如果不需要默认值,可以定义所需的任何节点名称。此名称对于管理目的非常重要,您可以在其中识别网络中哪些服务器与Elasticsearch集群中的哪些节点相对应。 可以将节点配置为按群集名称加入特定群集。默认情况下,每个节点都设置为加入一个名为cluster的集群elasticsearch,这意味着如果您在网络上启动了许多节点并且假设它们可以相互发现 - 它们将自动形成并加入一个名为的集群elasticsearch。 在单个群集中,您可以拥有任意数量的节点。此外,如果您的网络上当前没有其他Elasticsearch节点正在运行,则默认情况下启动单个节点将形成一个名为的新单节点集群elasticsearch。 索引 索引是具有某些类似特征的文档集合。例如,您可以拥有客户数据的索引,产品目录的另一个索引以及订单数据的另一个索引。索引由名称标识(必须全部小写),此名称用于在对其中的文档执行索引,搜索,更新和删除操作时引用索引。 在单个群集中,您可以根据需要定义任意数量的索引。 文档 文档是可以编制索引的基本信息单元。例如,您可以为单个客户提供文档,为单个产品提供另一个文档,为单个订单提供另一个文档。该文档以JSON(JavaScript Object Notation)表示,JSON是一种普遍存在的互联网数据交换格式。 在索引/类型中,您可以根据需要存储任意数量的文档。请注意,尽管文档实际上驻留在索引中,但实际上必须将文档编入索引/分配给索引中的类型。 碎片和副本 索引可能存储大量可能超过单个节点的硬件限制的数据。例如,占用1TB磁盘空间的十亿个文档的单个索引可能不适合单个节点的磁盘,或者可能太慢而无法单独从单个节点提供搜索请求。 为了解决这个问题,Elasticsearch提供了将索引细分为多个称为分片的功能。创建索引时,只需定义所需的分片数即可。每个分片本身都是一个功能齐全且独立的“索引”,可以托管在集群中的任何节点上。 分片很重要,主要有两个原因: 它允许您水平拆分/缩放内容量它允许您跨分片(可能在多个节点上)分布和并行化操作,从而提高性能/吞吐量分片的分布方式以及如何将其文档聚合回搜索请求的机制完全由Elasticsearch管理,对用户而言是透明的。 在可以随时发生故障的网络/云环境中,非常有用,强烈建议使用故障转移机制,以防分片/节点以某种方式脱机或因任何原因消失。为此,Elasticsearch允许您将索引的分片的一个或多个副本制作成所谓的副本分片或简称副本。 复制很重要,主要有两个原因: 它在碎片/节点发生故障时提供高可用性。因此,请务必注意,副本分片永远不会在与从中复制的原始/主分片相同的节点上分配。它允许您扩展搜索量/吞吐量,因为可以在所有副本上并行执行搜索。总而言之,每个索引可以拆分为多个分片。索引也可以复制为零(表示没有副本)或更多次。复制后,每个索引都将具有主分片(从中复制的原始分片)和副本分片(主分片的副本)。 可以在创建索引时为每个索引定义分片和副本的数量。创建索引后,您还可以随时动态更改副本数。您可以使用_shrink和_splitAPI 更改现有索引的分片数,但这不是一项简单的任务,并且预先计划正确数量的分片是最佳方法。 默认情况下,Elasticsearch中的每个索引都分配了5个主分片和1个副本,这意味着如果群集中至少有两个节点,则索引将包含5个主分片和另外5个副本分片(1个完整副本),总计为每个索引10个分片。 注意每个Elasticsearch分片都是Lucene索引。单个Lucene索引中可以包含最大数量的文档。截止LUCENE-5843,限制是2,147,483,519(= Integer.MAX_VALUE - 128)文档。您可以使用_cat/shardsAPI 监控分片大小。 参考:https://www.elastic.co/guide/en/elasticsearch/reference/current/_basic_concepts.html 索引管理 1、创建索引 PUT /index_name/ #参数配置 "settings": { "index": { "number_of_shards": "5", "number_of_replicas": "1" } } #number_of_shards为主分片数,默认为5;number_of_replicas为主分片对应的副本数,默认为1 2、mapping管理创建索引myindex4,并添加类型log、添加字段year(字段类型为整形) 向已经存在的索引myindex3添加类型log、字段year(字段类型为整形) 2、删除索引 DELETE /my_index DELETE /index_one,index_two DELETE /index_* DELETE /_all #禁止使用_all或者通配符*进行索引删除 action.destructive_requires_name: true 别名不能用于删除索引? 3、获取索引 GET /{myindex}/ 4、打开、关闭索引 POST /{indexname}/_open POST /{indexname}/_close #settingscluster.indices.close.enable: false 默认为开启 5、索引别名a、索引别名不能重复,也不能与索引名重复b、可以对一个或者多个索引指定一个别名(多个索引可以对应一个别名);一个索引也可以添加多个别名c、别名不能更新,只能删除后重建 GET /{myindex}/_alias/{alias} GET /{myindex}/_alias/{*} #添加索引 PUT /{myindex}/_alias/{myindexalias} #删除索引 DELETE /{myindex}/_alias/{alias} POST /_aliases/ { "actions": [ { "add": { "index": "myindex", "alias": "myindexalias" } }, { "add": { "index": "myindex", "alias": "myindexalias2" } }, { "add": { "index": "myindex2", "alias": "myindexalias" } }, { "remove": { "index": "myindex", "alias": "myindexalias" } } ] } 过滤索引别名 /* "filter": {"term": {"year": 2018}} #路由 "routing": "" 或者分开设置索引路由和查询路由 "index_routing": "2", "search_routing": "1,2" */ 6、获取、更新索引配置 GET /{index}/_settings/ #{index}的形式可以是:_all | *、xxx* | xxx,xxx,... 的形式 /**可以更新副本数量和添加分词(必须先关闭、添加、在打开索引)**/ PUT /{index}/_settings/ {"index": {"number_of_replicas": 4}} {"analysis":{"analyzer":{"content":{"type":"custom","tokenizer":"whitespace"}}}} 2、elastic操作2.1、集群状态监控 集群状态监控api如下所示 [root@localhost ~]# curl localhost:9200/_cat/ =^.^= /_cat/allocation /_cat/shards /_cat/shards/{index} /_cat/master /_cat/nodes /_cat/tasks /_cat/indices /_cat/indices/{index} /_cat/segments /_cat/segments/{index} /_cat/count /_cat/count/{index} /_cat/recovery /_cat/recovery/{index} /_cat/health /_cat/pending_tasks /_cat/aliases /_cat/aliases/{alias} /_cat/thread_pool /_cat/thread_pool/{thread_pools} /_cat/plugins /_cat/fielddata /_cat/fielddata/{fields} /_cat/nodeattrs /_cat/repositories /_cat/snapshots/{repository} /_cat/templates /_cat/health:集群状态/_cat/thread_pool:线程池状态/_cat/indices:索引状态/_cat/nodes:节点状态 2.2、索引创建索引 [root@localhost ~]# curl -XPUT localhost:9200/log?pretty { "acknowledged" : true, "shards_acknowledged" : true, "index" : "log" } 查询索引 curl localhost:9200/_cat/indices?v health status index uuid pri rep docs.count docs.deleted store.size pri.store.size yellow open log zm0ho3xFR1KaPFwHWfsX3Q 5 1 0 0 810b 810b yellow open customer lpfXum5qQoi3Mj9PJZB8Ug 5 1 1 0 4kb 4kb 关于重做索引、删除索引,索引之间如何平滑切换,后面详细讲解 2.3、文档创建文档 [root@localhost ~]# curl -XPUT localhost:9200/log/authlog/1?pretty -d '{"name":"rcl","detail":"blacklist"}' { "_index" : "log", "_type" : "authlog", "_id" : "1", "_version" : 1, "result" : "created", "_shards" : { "total" : 2, "successful" : 1, "failed" : 0 }, "created" : true } 更新文档 [root@localhost ~]# curl -XPUT localhost:9200/log/authlog/1?pretty -d '{"name":"amao","detail":"blacklist"}' { "_index" : "log", "_type" : "authlog", "_id" : "1", "_version" : 2, "result" : "updated", "_shards" : { "total" : 2, "successful" : 1, "failed" : 0 }, "created" : false } 查询文档 [root@localhost ~]# curl localhost:9200/log/authlog/1?pretty { "_index" : "log", "_type" : "authlog", "_id" : "1", "_version" : 2, "found" : true, "_source" : { "name" : "amao", "detail" : "blacklist" } } 此处name已被更新为amao,有此可见更新是有效的删除文档 [root@localhost ~]# curl -XDELETE localhost:9200/log/authlog/1?pretty { "found" : true, "_index" : "log", "_type" : "authlog", "_id" : "1", "_version" : 3, "result" : "deleted", "_shards" : { "total" : 2, "successful" : 1, "failed" : 0 } } [root@localhost ~]# curl localhost:9200/log/authlog/1?pretty { "_index" : "log", "_type" : "authlog", "_id" : "1", "found" : false } 2.4、DSL查询示例 [root@localhost ~]# curl -XPOST localhost:9200/log/_search -d '{"query":{"match":{"name":"amao"}}}' {"took":38,"timed_out":false,"_shards":{"total":5,"successful":5,"skipped":0,"failed":0},"hits":{"total":1,"max_score":0.2876821,"hits":[{"_index":"log","_type":"authlog","_id":"1","_score":0.2876821,"_source":{"name":"amao","detail":"blacklist"}}]}} kibana 1、安装 wget https://artifacts.elastic.co/downloads/kibana/kibana-6.4.2-linux-x86_64.tar.gz tar -zxvf kibana-6.4.2-linux-x86_64.tar.gz mv kibana-6.4.2-linux-x86_64 /usr/local cd /usr/local chown -R elasticsearch:elasticsearch kibana-6.4.2-linux-x86_64 ./bin/kibana Filebeat ./filebeat -e -c filebeat.yml filebeat.yml配置如下cat filebeat.yml | grep -v '#' | grep -v '^$' filebeat.inputs: - type: log enabled: true paths: - /usr/local/elastic-data/aaaaaa* fields: logtype: filelog logsource: log4j filebeat.config.modules: path: ${path.config}/modules.d/*.yml reload.enabled: false setup.template.settings: index.number_of_shards: 3 setup.kibana: output.logstash: hosts: ["192.168.31.101:5044"] Logstash 1、安装 wget https://artifacts.elastic.co/downloads/logstash/logstash-6.4.2.tar.gz tar -zxvf logstash-6.4.2.tar.gz mv logstash-6.4.2 /usr/local cd /usr/local chown -Relasticsearch:elasticsearch logstash-6.4.2 bin/logstash -f first-pipeline.conf --config.reload.automatic first-pipeline.conf在logstash home目录下新建first-pipeline.conf # comments to describe your configuration. input { beats { host => "192.168.31.101" port => "5044" } } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { elasticsearch { hosts => ["192.168.31.101:9200"] } }

优秀的个人博客,低调大师

Nginx入门

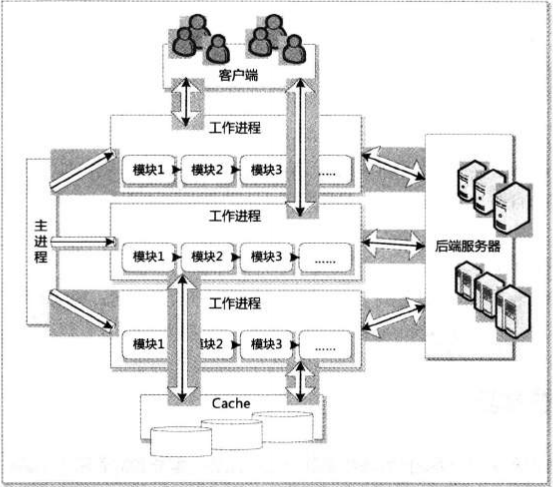
一、Nginx简介 1.1Nginx特性 模块化设计,较好的扩展性 高可靠性 支持热部署:不停机更新配置文件,升级版本,更换日志文件 低内存消耗:10000个keep-alive连接模式下的非活动连接,仅 需要2.5M内存event-driven,aio,mmap,sendfile 1.2Nginx的基本功能 静态资源的web服务器 http协议反向代理服务器 pop3/imap4协议反向代理服务器 FastCGI(lnmp),uWSGI(python)等协议 模块化(非DSO),如zip,SSL模块 1.3Nginx与web服务相关的功能 虚拟主机(server) 支持 keep-alive 和管道连接 访问日志(支持基于日志缓冲提高其性能) url rewirte 路径别名 基于IP及用户的访问控制 支持速率限制及并发数限制 重新配置和在线升级而无须中断客户的工作进程 Memcached 的 GET 接口 二、Nginx服务架构 master/worker结构 master进程:负责加载和分析配置文件、管理worker进程,平滑升级 worker进程:接收客户端请求、将请求一次送入各模块过滤、I/O调用、数据缓存、发送响应 cache相关进程:cache loader (缓存索引重建)与cache manager(缓存索引管理)组成 --Cache loader在Nginx服务启动后由主进程生成,根据本地磁盘上缓存建立索引元数据库后退出。 --Cache manager在元数据更新完成后,对元数据是否过期做出判断。 三、Nginx的配置文件结构 配置文件的组成部分 主配置文件:nginx.conf 子配置文件:include conf.d/*.conf fastcgi、uwsgi、scgi:等协议相关的配置文件。在根路径下 mime.types:支持的mime类型。在根路径下 四、基本配置实例讲解

优秀的个人博客,低调大师

SpringCloud入门

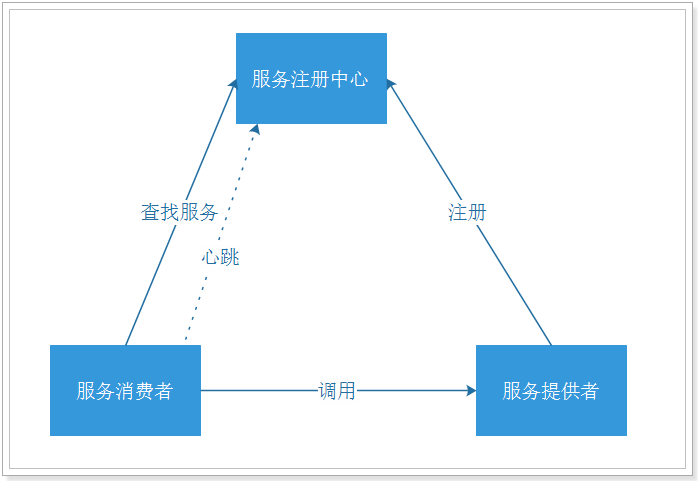
1.关于SpringCloud中各个微服务之间调用的URL硬编码问题 ----通过SpringCloud服务注册、发现的机制来完成 2.微服务调用的原理图 由上图可以看出: 1、 服务提供者将服务注册到注册中心 2、 服务消费者通过注册中心查找服务 3、 查找到服务后进行调用(这里就是无需硬编码url的解决方案) 4、 服务的消费者与服务注册中心保持心跳连接,一旦服务提供者的地址发生变更时,注册中心会通知服务消费者 3.注册中心Eureka SpringCloud提供了多种注册中心的支持,如:Eureka、ZooKeeper等。官方推荐使用Eureka。 原理: Eureka包含两个组件:Eureka Server和Eureka Client。 Eureka Server提供服务注册服务,各个节点启动后,会在Eureka Server中进行注册,这样EurekaServer中的服务注册表中将会存储所有可用服务节点的信息,服务节点的信息可以在界面中直观的看到。 Eureka Client是一个java客户端,用于简化与Eureka Server的交互,客户端同时也就别一个内置的、使用轮询(round-robin)负载算法的负载均衡器。 在应用启动后,将会向Eureka Server发送心跳,默认周期为30秒,如果Eureka Server在多个心跳周期内没有接收到某个节点的心跳,Eureka Server将会从服务注册表中把这个服务节点移除(默认90秒)。 Eureka Server之间通过复制的方式完成数据的同步,Eureka还提供了客户端缓存机制,即使所有的Eureka Server都挂掉,客户端依然可以利用缓存中的信息消费其他服务的API。综上,Eureka通过心跳检查、客户端缓存等机制,确保了系统的高可用性、灵活性和可伸缩性。

优秀的个人博客,低调大师

Hive 入门

官网:hive.apache.org 首先,Hive是数据仓库。可以用类SQL的语言来跑MR,可以理解为Hadoop的客户端。一方面Hive 数据都来自HDFS,另一方面Hive的代码需要提交到Hadoop中去执行,来跑MR。 HiveQL或者HQL,实际上是Hive将SQL提交,后翻译成MR,在HDFS上执行。所以Hive由解释器(解释成Java代码,提交到MR执行)、编译器、优化器等功能。 Hive在运行时元数据存储在关系型数据库中。不推荐默认的,可以使用mysql代替。具体的配置文件在conf/hive-site.xml里的ConnectionURL里面. hive的语法和sql很像,举例 CREATE TABLE t_person( id int, name string, hobby array<string>, character map<string, string>) ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' COLLECTION ITEMS TERMINATED BY '_' MAP KEYS TERMINATED BY ':'; 对应的example: 1, zhangsan, sports_books_TV, sex:man_color:red 另外,只有查所有数据的时候才不执行MR, 比如:select * from table 时 创建分区表,分区实际上是个文件夹,表名就是文件夹名。每一个分区,实际上就是这个文件夹下的不同文件。分区可以根据时间、区域等进行划分,如每天一个分区或者每个城市一个分区,只要写下 where pt=20170707这样的条件即可查询指定时间得到数据。 CREATE TABLE e_stu( id int, sname string, city string) PARTITIONED BY (ds string) ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' sTORED AS TEXTFILE; 导入数据(在hive中执行) LOAD DATA LOCAL INPATH '/home/zkpk/ecaoyng/input/estu.txt' OVERWRITE INTO TABLE e_stu PARTITION (ds='2017-07-07') LOAD DATA LOCAL INPATH '/home/zkpk/ecaoyng/input/estu2.txt' INTO TABLE e_stu PARTITION (ds='2017-07-08') hive> select * from e_stu; OK 1 young linyi 2017-07-07 2 jerry dalian 2017-07-07 3 ian dalian 2017-07-07 1 hello usa 2017-07-08 2 world France 2017-07-08 3 hadoop English 2017-07-08 4 hive spain 2017-07-08 Time taken: 0.087 seconds, Fetched: 7 row(s) hive> select * from e_stu where ds = '2017-07-07'; OK 1 young linyi 2017-07-07 2 jerry dalian 2017-07-07 3 ian dalian 2017-07-07 Time taken: 0.211 seconds, Fetched: 3 row(s) hive> hive> insert into table e_stu > partition (ds = '2017-09-10') > select id,sname,city from e_stu; hive> select * from e_stu where ds = '2017-09-10'; OK 1 young linyi 2017-09-10 2 jerry dalian 2017-09-10 3 ian dalian 2017-09-10 1 hello usa 2017-09-10 2 world France 2017-09-10 3 hadoop English 2017-09-10 4 hive spain 2017-09-10 那么hive的文件在哪里查看?从50070的页面中的browse directory 中的user目录下/user/hive/warehouse/day0525.db/e_stu 可以看到有两个文件夹 hive的四种数据导入方式,旧的版本不支持insert into values,但新版本已经支持。 http://blog.csdn.net/lifuxiangcaohui/article/details/40588929 因为mysql中存储元数据,所以启动hive的时候需要启动mysql。但启动是有时会遇到如下的提示: Another MySQL daemon already running with the same unix socket. 解决方案: find / -name mysql.sock 将mysql.sock(e.g. /var/lib/mysql/mysql.sock)删除,重启service即可 export将表中的数据导出到hdfs. 未完待续

优秀的个人博客,低调大师

HDFS 入门

注意secondaryname node 不是name node的备份,仅仅备份了一部分的元数据,不是实时备份。它的主要工作是帮助NN合并editslog,减少NN启动时间 比如删除元数据,不会立马删除,而是将操作信息写入日志edits log,在合并的时候(edits log和fsimage合并的时候)进行实际的删除。合并完成之后会得到一个新的fsimage再传送给NN,并替换原来的。 所以NN的主要做用是接受客户端的读写操作,而元数据的更新等需要大量IO操作的合并等由SNN来做。 SNN执行合并机制: 根据配置文件设置的时间间隔fs.checkpoint.period 默认为3600s 根据配置文件设置edits log大小 fs.checkpoint.size规定edits文件的最大默认为64M NameNode的$dfs.namenode.name.dir/current/文件夹的几个文件: current/ |– VERSION |– edits_* |– fsimage_0000000000008547077 |– fsimage_0000000000008547077.md5 `– seen_txid 其中存在大量的以edits开头的文件和少量的以fsimage开头的文件。那么这两种文件到底是什么,有什么用?下面对这两中类型的文件进行详解。在进入下面的主题之前先来搞清楚edits和fsimage文件的概念: (1)、fsimage文件其实是Hadoop文件系统元数据的一个永久性的检查点,其中包含Hadoop文件系统中的所有目录和文件idnode的序列化信息; (2)、edits文件存放的是Hadoop文件系统的所有更新操作的路径,文件系统客户端执行的所以写操作首先会被记录到edits文件中。 fsimage和edits文件都是经过序列化的,在NameNode启动的时候,它会将fsimage文件中的内容加载到内存中,之后再执行edits文件中的各项操作,使得内存中的元数据和实际的同步,存在内存中的元数据支持客户端的读操作。 NameNode起来之后,HDFS中的更新操作会重新写到edits文件中,因为fsimage文件一般都很大(GB级别的很常见),如果所有的更新操作都往fsimage文件中添加,这样会导致系统运行的十分缓慢,但是如果往edits文件里面写就不会这样,每次执行写操作之后,且在向客户端发送成功代码之前,edits文件都需要同步更新。如果一个文件比较大,使得写操作需要向多台机器进行操作,只有当所有的写操作都执行完成之后,写操作才会返回成功,这样的好处是任何的操作都不会因为机器的故障而导致元数据的不同步。 fsimage包含Hadoop文件系统中的所有目录和文件idnode的序列化信息;对于文件来说,包含的信息有修改时间、访问时间、块大小和组成一个文件块信息等;而对于目录来说,包含的信息主要有修改时间、访问控制权限等信息。fsimage并不包含DataNode的信息,而是包含DataNode上块的映射信息,并存放到内存中,当一个新的DataNode加入到集群中,DataNode都会向NameNode提供块的信息,而NameNode会定期的“索取”块的信息,以使得NameNode拥有最新的块映射。因为fsimage包含Hadoop文件系统中的所有目录和文件idnode的序列化信息,所以如果fsimage丢失或者损坏了,那么即使DataNode上有块的数据,但是我们没有文件到块的映射关系,我们也无法用DataNode上的数据!所以定期及时的备份fsimage和edits文件非常重要! 在前面我们也提到,文件系统客户端执行的所以写操作首先会被记录到edits文件中,那么久而久之,edits会非常的大,而NameNode在重启的时候需要执行edits文件中的各项操作,那么这样会导致NameNode启动的时候非常长!在下篇文章中我会谈到在Hadoop 1.x版本和Hadoop 2.x版本是怎么处理edits文件和fsimage文件的。 注意NN工作的数据都在内存中,会将用户操作都记录在edit 文件 HDFS读流程 其中Distributed FileSystem/FSDataInputStream是两个API,而且4,5是并发执行的,当读取所有的block在客户端合并成一个大文件。 HDFS写流程 注意当写dn的时候,仅仅是向一个dn上写block,其他副本由这个DN新起线程去完成。 HDFS文件权限 HDFS的HA,主要给NN做HA 用户连接的是ZK zk 必须是大于1的奇数(竞争锁的投票机制)) zkfc和nn的数量一致 JN也是奇数个 HDFS做HA,节点数量举例 MapReduce的HA,主要给Resource Manager做HA. 但是一般企业只对HDFS做HA

优秀的个人博客,低调大师

HBase入门

HBase 是hadoop的数据库(数据量大,实时),目标是存储并处理大型的数据,具体来讲是用普通的硬件资源,就能处理成千上万的行和列所组成的大型数据。它可以直接使用本地文件或者HDFS,因为稳定性的考虑,推荐使用HDFS。利用HDFS作为其文件存储系统,利用MR来处理Hbase中的海量数据,利用ZK来做HA(高可用)作为其分布式协同服务。 HBase的安装分为三种模式:单机、伪分布式安装、全分布模式安装。其中伪分布式模式是一个运行在单台机器上的分布式模式,此种模式性HBase所有的守护进程都运行在同一个节点。因为分布式模式依赖于HDFS,所有确认HDFS已成功安装并启动。另外,全分布模式需要zookeeper的配置。 HBase常用命令 HBase体系结构 HBase主从结构。HBase Master负责管理所有的HRegion服务器,而HBase所有的服务器都是通过Zookeeper来协调并处理HBase服务器可能遇到的错误。HBase Master本身并不存储HBase中的任何数据。Hbase逻辑上的表被划分为多个HRegion,然后存储到HRegion server 群中。 HRegion: HRegion服务器 所有的数据库文件一般保存在HDFS上,用户通过一些列的HRegion服务器获取这些数据,一台机器上面一般只运行一个HRegion服务器,且每一个区段的HRegion也智慧被一个HRegion服务器维护. HBase Master服务器 HBase 数据逻辑视图 每行列的个数可以不一样 HBase 数据物理视图 虽然从概念视图上每个表格有很多行组成,但是物理存储来看,它是按照列来保存的。 HBase体系结构 client请求zk(zk,用于HA,解决单点故障问题)。图中有一个错误,每一个HRegtionServer,只有一个Hlog,不应属于HRegion。 每一个store存在一个目录下,实际就是一个列族 MemStore,内存store,当数据刚写入时是放在内存中的,当溢写时写道StoreFile,而真正的数据是在HFile在HDSF上。StoreFile上有HFile上的元数据。在Region中不会真正的保存数据,真正的数据都在HDSF上面 HBase与RDBMS HBase常用命令 http://www.cnblogs.com/xiaolei2017/p/7245299.html http://blog.csdn.net/lifuxiangcaohui/article/details/40042117 启动Hbase 首先要确保zookeeper已经安装完成,可以用zkServer.sh 查看 start-hbase.sh. 可以通过jps查看hmaster和hregionserver是否启动。 另外可以通过网页:master:60010查看

优秀的个人博客,低调大师

入门预测

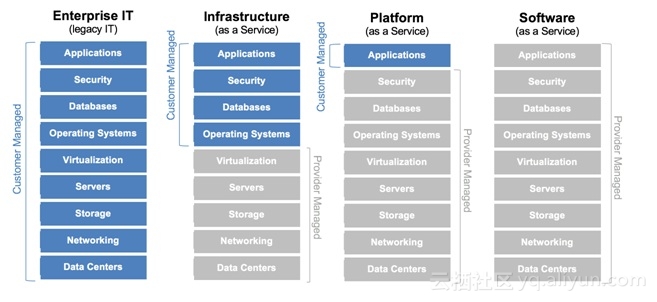
一句话理解云平台的运作模式,就是:在不同层级上、为不同规模的产业需求方提供不同形式上的互联网生态环境。 IaaS云服务的优势:省去了IT基础设施上的投资、建设工作量,研发人员可以直接获取虚拟化的基础设施资源来部署上层应用的搭建工作,客户消费的是云化资源类的服务。 PaaS云服务的优势:省去了IT应用平台上的投资、建设工作量,研发人员可以直接获取虚拟化的平台应用工具来部署上层应用的搭建工作,客户消费的是云化工具类的服务。 SaaS云服务的优势:省去了整个IT支撑上的所有工作,客户只需要根据自己的商业模式选择虚拟化的软件工作环境来部署上层应用即可,能以最快捷的方式投入商用运作、产生效益,客户消费的是云化软件类的服务。 下一步的演进方向应该是BaaS,即:客户可以自由地消费他/她所希望获取的某种商业模式,云服务商可以组合起互联网生态环境之外的其他社会生态环境(比如:物联网)的解决方案一并提供给客户。

优秀的个人博客,低调大师

以太坊开发入门,完整入门篇

一个适合区块链新手的以太坊DApp开发教程: http://xc.hubwiz.com/course/5a952991adb3847553d205d1 一个用区块链、星际文件系统(IPFS)、Node.js和MongoDB来构建电商平台: http://xc.hubwiz.com/course/5abbb7acc02e6b6a59171dd6 收集整理了一些免费区块链、以太坊技术开发相关的文件,有需要的可以下载,文件链接: web3.js API官方文档中文版:https://pan.baidu.com/s/1hOV9hEzi7hFxJCL4LTvC6g 以太坊官方文档中文版 :https://pan.baidu.com/s/1ktODJKLMBmkOsi8MPrpIJA 以太坊白皮书中文版 :https://pan.baidu.com/s/1bzAFnzJ35hlQxJ2J4Oj-Ow Solidity的官方文档中文版 :https://pan.baidu.com/s/18yp9XjEqAHpiFm2ZSCygHw Truffle的官方文档中文版 :https://pan.baidu.com/s/1y6SVd7lSLUHK21YF5FzIUQ C#区块链编程指南 :https://pan.baidu.com/s/1sJPLqp1eQqkG7jmxqwn3EA 区块链技术指南: :https://pan.baidu.com/s/13cJxAa80I6iMCczA04CZhg 精通比特币中文版: :https://pan.baidu.com/s/1lz6te3wcQuNJm28rFvBfxg Node.js区块链开发 :https://pan.baidu.com/s/1Ldpn0DvJ5LgLqwix6eWgyg geth使用指南文档中文版 :https://pan.baidu.com/s/1M0WxhmumF_fRqzt_cegnag 以太坊DApp开发环境搭建-Ubuntu : https://pan.baidu.com/s/10qL4q-uKooMehv9X2R1qSA 以太坊DApp开发环境搭建-windows :https://pan.baidu.com/s/1cyYkhIJIFuI2oyxM9Ut0eA 以太坊DApp开发私链搭建-Ubuntu : https://pan.baidu.com/s/1aBOFZT2bCjD2o0EILBWs-g 以太坊DApp开发私链搭建-windows :https://pan.baidu.com/s/10Y6F1cqUltZNN99aJv9kAA 以太坊ganache CLI命令行参数详解:https://pan.baidu.com/s/1lnknFkwenacaeM4asOcBdg 使用truflle和infura部署以太坊合约:https://pan.baidu.com/s/1PTxSVff2vHSVUihYczRRqw IPFS安装部署与开发环境搭建-windows:https://pan.baidu.com/s/1bnhDvqCoOgAqEBZXMtVbRg

优秀的个人博客,低调大师

入门 | egg.js 入门之egg-jwt

小小继续学习,这次学习的内容是egg-jwt 相关。 创建egg项目 这里创建一个egg新项目,这里使用的是ts模式。 npm init egg --type=ts npm install 安装相关的包 这里创建并安装完成以后,需要再次初始化俩包,分别为egg-cors与egg-jwt token 生成的验证包 npm install egg-cors egg-jwt --save 配置相关插件 这里配置相关的插件 import { EggPlugin } from 'egg'; const plugin: EggPlugin = { jwt: { enable: true, package: "egg-jwt" }, cors: { enable: true, package: 'egg-cors', } }; export default plugin; 配置默认配置文件 config.jwt = { secret: "123456"//自定义 token 的加密条件字符串 }; config.security = { csrf: { enable: false, ignoreJSON: true }, domainWhiteList: ['http://localhost:8080'],//允许访问接口的白名单 }; config.cors = { origin:'*', allowMethods: 'GET,HEAD,PUT,POST,DELETE,PATCH' }; 这里配置完成了相关的默认配置 在根目录声明any类型 这里需要在跟目录声明一个any类型,用于前后端发送相关的字符串参数。 import 'egg'; declare module 'egg' { interface Application { jwt: any; } } 配置相关路由 这里在app/router.ts 创建相关的路由 import { Application } from 'egg'; export default (app: Application) => { const { controller, router, jwt } = app; //正常路由 router.post('/admin/login', controller.admin.login); /* * 这里的第二个对象不再是控制器,而是 jwt 验证对象,第三个地方才是控制器 * 只有在需要验证 token 的路由才需要第二个 是 jwt 否则第二个对象为控制器 **/ router.post('/admin',jwt, controller.admin.index); }; 这里就配置完成了相关的路由。 编写路由对应的控制器 这里编写路由所对应的控制器这个控制器在app/controller/home.ts 目录下 import { Controller } from 'egg'; export default class AdminController extends Controller { // 验证登录并且生成 token public async login() { const { ctx ,app} = this; //获取用户端传递过来的参数 const data = ctx.request.body; // 进行验证 data 数据 登录是否成功 // ......... //成功过后进行一下操作 //生成 token 的方式 const token = app.jwt.sign({ username: data.username, //需要存储的 token 数据 //...... }, app.config.jwt.secret); // 生成的token = eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJmb28iOiJiYXIiLCJpYXQiOjE1NjAzNDY5MDN9.B95GqH-fdRpyZIE5g_T0l8RgzNyWOyXepkLiynWqrJg // 返回 token 到前端 ctx.body = token; }; //访问admin数据时进行验证token,并且解析 token 的数据 public async index() { const { ctx ,app} = this; console.log(ctx.state.user); /* * 打印内容为:{ username : 'admin', iat: 1560346903 } * iat 为过期时间,可以单独写中间件验证,这里不做细究 * 除了 iat 之后,其余的为当时存储的数据 **/ ctx.body = {code:0,msg:'验证成功'}; } } 前端请求相匹配 这里只需要在前端的authorization字段里,添加相关的配置信息即可。 axios({ method: 'post', url: 'http://127.0.0.1:7001/admin', data: { username: 'admin', lastName: '123456' }, headers:{ // 切记 token 不要直接发送,要在前面加上 Bearer 字符串和一个空格 'Authorization':`Bearer ${token}` } }).then(res=>{ console.log(res.data) }) 这里就完成了egg.js 结合jwt完成相关的验证 小tips 这里插曲一个小tips,这里使用的是jsonwebtoken。这里使用jsonwebtoken实现token相关认证机制。 安装 这里安装相关的依赖 npm install jsonwebtoken 编写中间件 在middleware文件下新建一个jwt.ts 文件 'use strict' const fs = require('fs') const path = require('path') const jwt = require('jsonwebtoken') //引入jsonwebtoken module.exports = (options, app) => { return async function userInterceptor(ctx, next) { let authToken = ctx.header.authorization // 获取header里的authorization if (authToken) { authToken = authToken.substring(7) const res = verifyToken(authToken) // 解密获取的Token if (res.corpid && res.userid) { // 如果需要限制单端登陆或者使用过程中废止某个token,或者更改token的权限。也就是说,一旦 JWT 签发了,在到期之前就会始终有效 // 此处使用redis进行保存 const redis_token = await app.redis.get('loginToken').get(res.corpid + res.userid) // 获取保存的token if (authToken === redis_token) { ctx.locals.corpid = res.corpid ctx.locals.userid = res.userid await next() } else { ctx.body = { code: 50012, msg: '您的账号已在其他地方登录' } } } else { ctx.body = { code: 50012, msg: '登录状态已过期' } } } else { ctx.body = { code: 50008, msg: '请登陆后再进行操作' } } } } // 解密,验证 function verifyToken(token) { const cert = fs.readFileSync(path.join(__dirname, '../public/rsa_public_key.pem')) // 公钥,看后面生成方法 let res = '' try { const result = jwt.verify(token, cert, { algorithms: [ 'RS256' ] }) || {} const { exp } = result, current = Math.floor(Date.now() / 1000) if (current <= exp) res = result.data || {} } catch (e) { console.log(e) } return res } 使用中间件 这里在config.default.js中加入如下的配置,实现中间件的开启和配置 // 方法一:在应用中使用中间件 config.middleware = [ 'jwt' ] config.jwt = { enable: true, ignore: [ '/api/v1/test/', '/public/' ], // 哪些请求不需要认证 } // 方法二:router中使用中间件 module.exports = app => { const jwt = app.middleware.jwt(); app.router.get('/api/v1/test/', jwt, app.controller.test.test); }; token生成 这里卸载文件里,用于调用,生成相关的token loginToken(data, expires = 7200) { const exp = Math.floor(Date.now() / 1000) + expires const cert = fs.readFileSync(path.join(__dirname, '../public/rsa_private_key.pem')) // 私钥,看后面生成方法 const token = jwt.sign({ data, exp }, cert, { algorithm: 'RS256' }) return token } 调用相关的生成方法 const token = ctx.helper.loginToken({ corpid: usersData.corpid, userid: usersData.userid }, 7200) // token生成 await app.redis.get('loginToken').set(usersData.corpid + usersData.userid, token, 'ex', 7200) // 保存到redis ctx.body = { data: { token, expires: this.config.login_token_time }, code: 1, msg: '登录成功' } // 返回前端 前端使用 这里前端使用headers,在后面加上相关的空格。 例:axios中 // request拦截器 service.interceptors.request.use(config => { if (store.getters.token) { config.headers['Authorization'] = `Bearer ${getToken()}` } return config }, error => { console.log(error) Promise.reject(error) }) 这里就完成了相关jwt的生成与使用。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册