首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4351篇文章
优秀的个人博客,低调大师

【征文】上传试卷、打Boss,玩游戏:我用WorkBuddy + TextIn xParse 做了一套“会解析试卷的刷题游戏“

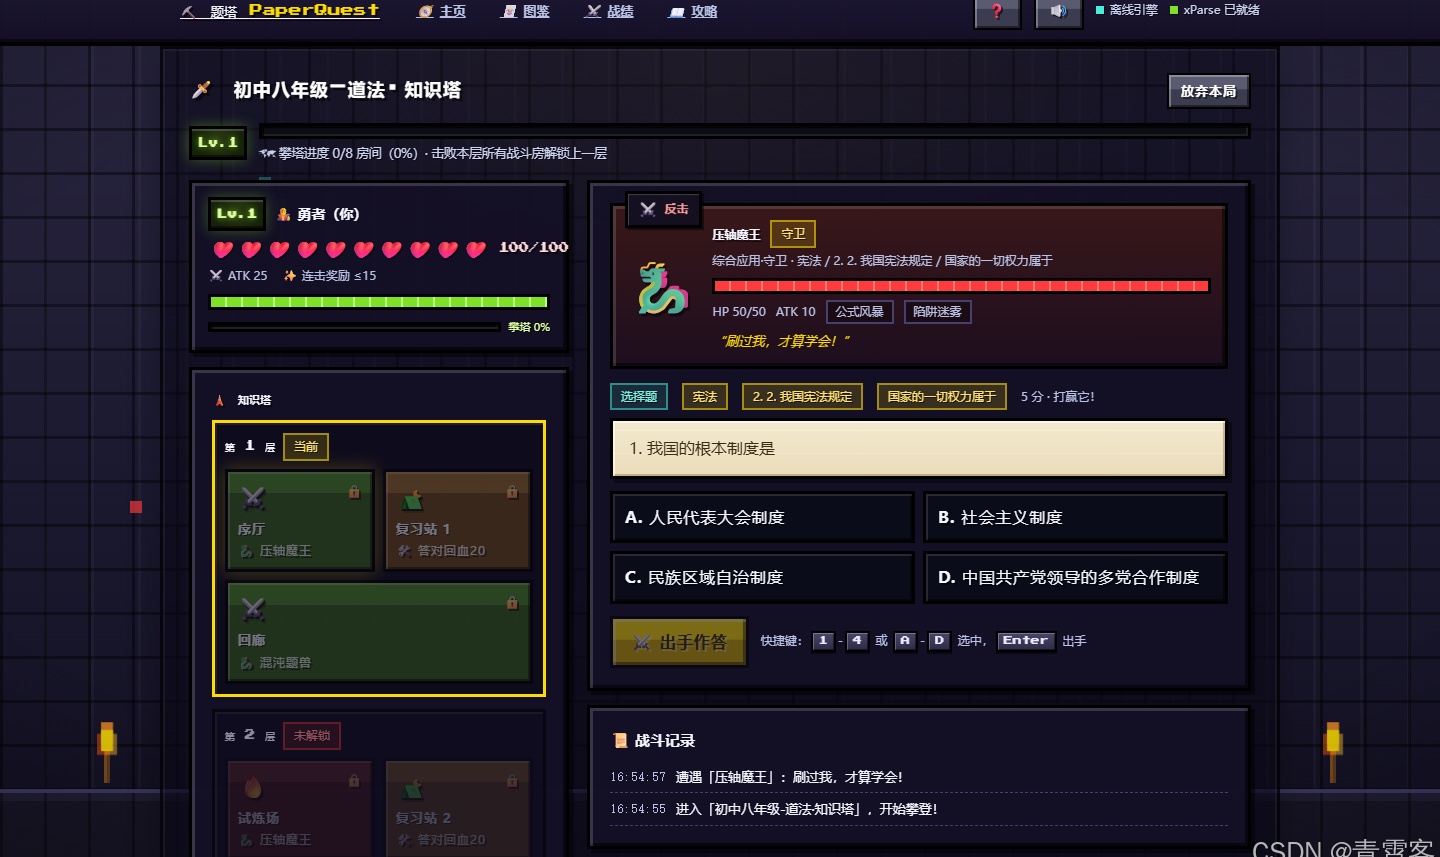
## 背景 刷题产品的题库成本卡在"把纸质试卷变成结构化题目"这一步:公式转 LaTeX、选项拆开、考点标注、答案核验。这套流程此前只有教育公司养团队才干得起。个人开发者写死几百道题的工具,题刷完就废了。 另一边,Roguelike"爬塔—掉卡—构筑"的玩法被验证能让人上瘾,但游戏化学习产品有个通病:demo 里题目是手写的,接真实试卷就死。解析、切题、判定三座大山任何一座塌了,"游戏化"就只是贴皮。 题塔 PaperQuest 要做的事: > 上传一份试卷 PDF,系统借 TextIn xParse 把它解析成带 LaTeX 公式的结构化 Markdown,切题、标注考点,再编译成一座三层的 Roguelike 知识塔。答对怪物掉血、连击暴击;答错怪物回血反击,掉一张错题卡进图鉴。通关后结算页给知识点雷达图和战绩海报。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/7b39ccdb076191780dacd369cba2bdc0.png) 到今天它跑着真实 xParse 解析,压着 5 份真实试卷、44 局真实对局数据,自动化测试 65 单测 + 65 接口 + 25 前端 + 83 E2E + 15 安全全绿,PC 和移动端真人走查 76 + 47 项逐项点过。 --- ## 第一道坎:让试卷"进得来" ### 端点踩坑史 接 TextIn xParse 时端点对齐遇到三个问题: 第一个端点 `https://api.textin.com/api/v1/xparse`,参赛指南页给的,在申报账号下直接网关 404。 换成 `https://api.textin.com/ai/service/v1/xparse`,返回 40007——机器人平台专用接口,不适用。 改用 multipart 表单上传文件,40303:文件类型无法识别。 翻到官方文档 `pdf_to_markdown` 一节才确认:协议要求 POST 原始二进制流,`Content-Type: application/octet-stream`,鉴权走请求头 `x-ti-app-id` / `x-ti-secret-code`,不是表单上传。改对之后一次通过。 ``` POST https://api.textin.com/ai/service/v1/pdf_to_markdown?markdown_details=1&parse_mode=auto x-ti-app-id: x-ti-secret-code: Content-Type: application/octet-stream body: 文件原始字节 ``` 下面这张图是这两天跑的一次真实调用响应,`x_request_id` 和耗时都在,不是演示数据: ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/6bafa59680c488af8f357cf1642b0c79.png) 重点看 `markdown_head` 那一行:`$1+1=\underline{}(5\text{fen})$`——印刷体公式被自动转写成了 LaTeX。这一行是整个项目的地基。有了它,题面可以原样进数据库、原样渲染到游戏界面,学生看到的题和卷子上长一个样。没有这一步,后面所有"把试卷变成游戏"都是空中楼阁。 ### 分层降级的解析管线 真实世界上传上来的东西很杂:PDF、图片、Word、txt,甚至还有 rtf 和 csv。管线按类型分层,任何一层掉链子都有下一层兜底: ``` 上传文件 ├─ .txt/.md/.markdown ────────→ 直通(plaintext,零解析成本) ├─ .rtf/.csv/.json/.tex ──────→ 本地提取(local-extract) └─ pdf/docx/html/图片/Office ──→ ① TextIn xParse(主力,含 xRequestId 留痕) ② 失败则降级本地提取(local-fallback) ③ 本地也失败才报错 ``` 解析成功后不是直接入库,还有两步:切题(`splitQuestions`)和补全(`enrichQuestions`:标注知识点、AI 补缺失答案)。产物在解析预览页一览无余: ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/411a75c8c534065c3cfd2b3daa632564.png) 解析报告里那个"请求 ID `fe9fe0ff...`、耗时 1.6 秒、解析出 668 字符"不是写死的文案,是每次真实调用后从 xParse 响应里带回来的。比赛要求"有效结果证明",可复现比截图重要,所以每条真实试卷入库都带 `parseMeta`,随时能拿请求 ID 回查。 --- ## 核心链路:从 Markdown 到一座"知识塔" 试卷进来了,接下来是最烧脑的一步:怎么把 7 道题编译成一座好玩的地下城? ### 编译器的不变量 编译结果的硬约束(`compiler.js`,20 个单测钉死): - 每座塔固定 3 层,每层至少 2 个房间; - 顶层必须是 Boss 房,首层必含 1 个"复习站"(商店房,答对回血 20); - 怪物 HP 由题目分值换算(分值×10,钳制上下限); - 非法题目的引用一律过滤——LLM 抽风也不能让塔里出现"幽灵怪"。 LLM 在真实模式下负责把题目按考点聚类、给房间起怪物名和嘲讽台词。同时实现了一套 mock 引擎:同样输入,两次编译结果完全一致。联调和 E2E 时测试不能被模型的随机性拖着走,mock 引擎是确定性测试替身。 ### 战斗引擎:纯函数,为可测性让路 战斗规则全部压在 `engine.js` 一个纯函数里,无 IO、无随机数,意图轮换是确定的(`attack→attack→heavy→heal` 四循环,玩家可以预判): - 答对:`伤害 = ATK25 + 连击奖励(min(连击×5, 15))`,连击 ≥3 触发暴击(+50% ATK); - 答错:没有免费回合——怪物先回血 tier 10%,再按意图反击(heavy 1.5 倍、heal 回 15% 上限再半力反击); - 玩家 HP≤0 阵亡,怪物 HP≤0 掉卡、清层、弹"三选一祝福"。 Roguelike 的心流循环是爬层→出题→构筑→清层。复习站是给受挫玩家的喘息窗口——纯击杀节奏下连错三题容易弃疗。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/b8e2fbe1fa66e83ffcf5b507e36d79ac.png) ### 判定器:本地快判 + LLM 精判 判分不能全甩给 LLM——每答一题一次网络请求,延迟和成本都吃不消。现在的分层是: 1. 选择题:本地精确比对,零延迟零成本; 2. 填空题:本地快判,归一化后严格等值,容忍"答案是25"这类前缀; 3. 解答题:一律走 LLM(真实模式)或 mock 引擎做语义精判; 4. LLM 挂了:降级启发式(数字重合度),至少不卡玩法。 这里有个真实的坑。第一版判题器为了"宽容",对填空用了"学生答案包含参考答案就判对"。测试期一个 case 把它打穿了:解答题答案 `a=-2`,学生提交 `我答a=-2X`——照样判对。抄了半句话的错题蒙混过关,直接污染正确率、伤害和通关判定。 修复方案是分区治理:解答题彻底不走本地字符串比对,填空收紧为严格等值。这个 bug 写进了回归测试(`bugfix.api.test.js`),现在是 9 条回归 case 之一。 ### 防作弊:答案一寸不漏 教育产品最怕"答案从接口漏出去"。铁律写在了 `runService` 注释里:任何出参不得包含 answer / answerAnalysis。实现上: - 出题接口下发的是 `sanitizeQuestion` 之后的题面(题号、题干、选项、分值、考点),没有答案字段; - 连"有没有答案"都只回一个布尔值 `hasAnswer`,解析预览页明示"答案已隐藏"; - E2E 和接口测试里各有一条断言,逐字段检查对局/战斗/挑战响应中不存在 `answer` 字样。 另外,变式题机制让"背答案"也失效:原题耗尽后,编译器从种子题生成结构相同、数值不同的变式,判定用新答案。 --- ## 答错之后:错题卡与图鉴系统 刷题产品只解决"爽"是不够的,还得解决"记住"。PaperQuest 的答案在答错那一刻就已写好:掉落错题卡。 每答错一题,系统把该题凝成一张卡(题干、考点、怪物出处),进图鉴。图鉴里可以对卡牌发起升级挑战:重新作答变式题,答对星级 +1,最高 3 星封顶。这本质上是一个游戏化的间隔重复系统(SRS)。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/c731c3c23055ef257b468ede042a053b.png) 结算页给出:答题数、正确率、伤害、掉落、知识点雷达图: ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/76971b0a841b5d63ed21c479322c6955.png) 雷达图的数据来自对局中按考点的累计统计。家长看雷达图三秒钟就知道:孩子"函数概念"塌陷,"几何证明"饱满——这比一句"考得不理想"有用得多。 --- ## 一个并发 bug 写真人走查脚本时,用并发请求压对战接口,抓到了一个竞态:两笔并发 answer,同一道题、同一个正确答案,一次判对一次判错,最终统计 `answered=2, correct=1, wrong=1`,还多掉了一张卡。 根因是 `answer()` 没有并发保护:请求 A 在 `await judge()` 期间,请求 B 拿到同一道题一起判;A 结算完把题换成了下一题,B 持旧引用继续结算,状态互相污染。真实 LLM 模式下判定耗时几百毫秒到几秒,这个窗口会被放大到必现。 修复很干脆:per-run 进程内锁,判定中的对局再来直接 409「正在判定中」。回归测试用 30ms 慢判复现窗口,断言只有一次结算、口径恒等。 这类 bug 单测摸不到,只在"像用户一样乱点"的走查里现形。这也是在单元测试之外坚持 5 层测试证据链的原因: | 层 | 内容 | 现状 | |---|---|---| | L1 | 单元(编译器/战斗引擎/判题/切题/工具) | 65/65 | | L2 | 接口(supertest 全 API,含防作弊/级联删除) | 65/65 | | L3 | 前端组件(渲染/Katex/成就系统/交互态) | 25/25 | | L4 | E2E(Playwright 全流程,含真实 xParse 上传) | 83 过 +1 跳过 | | L5 | 安全(CSP/限流/上传白名单/XSS/密钥泄漏) | 15/15 | 再加两条真人模拟走查:PC 端 76 项、移动端 47 项,逐一点、逐项断言 DOM。移动端两张实拍: ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/ac0a44a35fca1acd98ae7f78041224a6.png) ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-9681929/9d49900e8b921e22f4cf8001bfab9d69.png) L1-L4 全绿时以为项目稳了。真人走查第一轮还是抓出两个 bug:移动端抽屉遮罩拦点击、统计口径不恒等。测试的真正价值不在"证明它对",而在高效地发现它错。 --- ## 完整技术栈 - **运行时**:Node.js 22 + Express 4,单端口同服 API 与前端产物(`express.static` 托管 `web/dist`,SPA fallback 一条路由搞定); - **前端**:Vue 3 + Vite + Pinia + KaTeX,MC 像素风全部手写 CSS(`@fontsource/press-start-2p`),音频 WebAudio 合成; - **LLM 双引擎**:真实模式走 `DeepSeek-V4.1-Flash`(主)/`SenseNova-6.8-Flash-Lite`(备),超时/异常自动降级 mock 引擎,演示永远不翻车;mock 引擎同时是确定性测试替身; - **文档解析**:TextIn xParse `pdf_to_markdown`(raw body 协议),本地提取兜底 rtf/csv/json/tex 与降级场景; - **存储**:JSON 文件存储(`tmp+rename` 原子写,Windows EPERM 重试),损坏自动备份重建。零原生依赖,换 SQLite 只需替换一个文件; - **代码量**:server/src 49 文件 3568 行;web/src 43 文件 3870 行;测试层(单测+接口+E2E)合计约 4570 行——测试代码和业务代码接近 1:1.3,这是让它跑真实数据的底气。 工程上几条取舍: 第一,Mock 不是玩具,是基础设施。它让 E2E 在 CI 里 4 分钟跑完 83 个 case,让"两次编译结果一致"成为可断言的性质。 第二,答案只存在"判定那一刻"。从切题到入库,答案字段在详情接口就被剥掉,只在判定器和结算统计的闭环里出现。 第三,数据小到不需要数据库,但边界要留好。JSON 存储明说"单用户场景",并为换存储留了替换点。 --- ## 往前看 文档解析正在从"给人看"变成"给机器吃"。过去 OCR 的目标是识别文字;现在 xParse 这类服务输出的是带坐标、带层级、带 LaTeX 的结构化 Markdown——这是给后续系统消化的中间表示。意味着"一份 PDF 变成一个可交互应用"的成本,第一次降到了个人开发者的量级。 看到的方向至少有四个。一是个人题库即时化,任何人的讲义、培训材料、行业手册,都可以在分钟级变成刷题/闯关应用。二是错题的资产化,错题卡 + LLM 变式 + SRS 调度,三件事合起来就是自适应学习的引擎,当解析足够便宜,瓶颈从"内容数字化"转移到"学习科学本身"。三是过程性评价,游戏化对局天然积累过程数据:单题耗时、连击曲线、弃局率、意图预判准确率,这些比一张卷子更能刻画一个学习者的状态。四是内容合规与可信,解析层越强,伪造内容的风险也越高,解析结果的水印、出处回链(留 `x_request_id`)、以及 LLM 生成内容的显式标注,会从加分项变成必选项。 局限也要说清楚:判分对主观题仍然粗糙;xParse 对手写体、极端排版仍有错切;LLM 变式题需要防"变错"。这些是真实的工程债务,列在待办里。 --- ## 尾声 这个项目是一次完整的验证:一个国内的文档解析 API,足以让个人开发者把"纸质世界"改造成"数字玩法"。上传、解析、编译、爬塔、通关——链路每一环都有真实数据、真实测试、真实 bug 和真实修复。 ---

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册