首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4338篇文章
优秀的个人博客,低调大师

#WorkBuddy# 模型在加速退役、内存在加速涨价:把 AI 接进流程的人,最该攒的是「换掉它的成本」

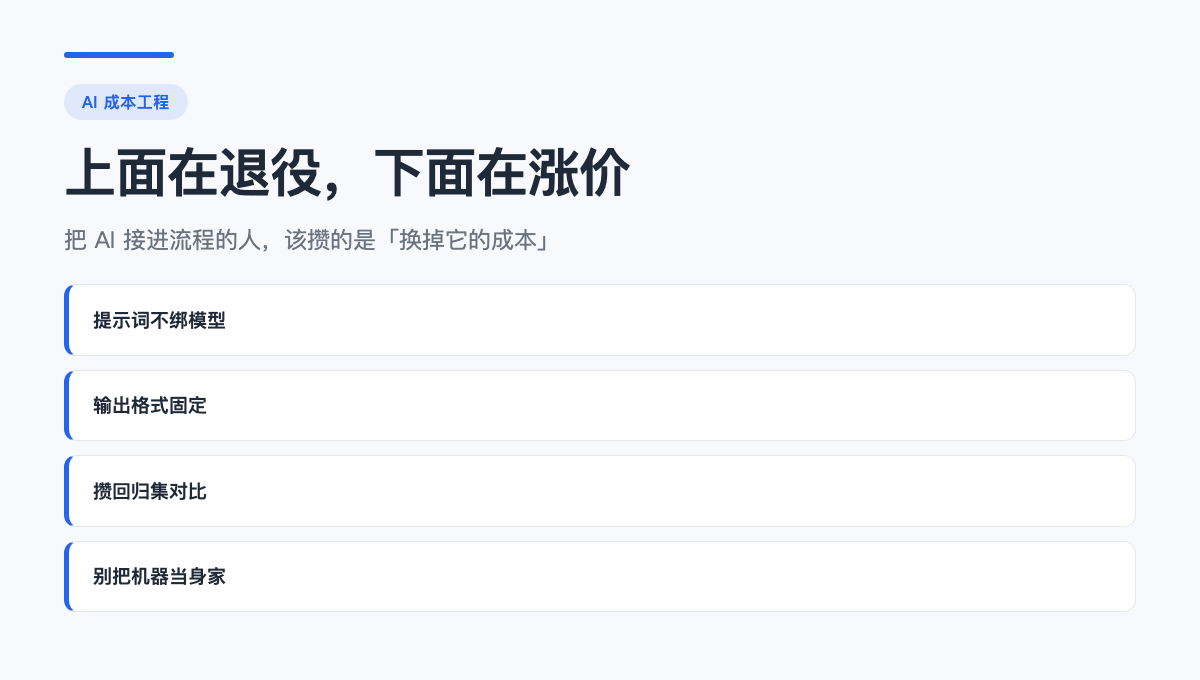
![](https://developer.qcloudimg.com/http-save/yehe-12690655/b842a2711cd4c1e21824e02b6dc86f5e.png) 9 月 18 日这一天有两件事挨在一起看,挺刺眼的:一边是 GPT-5.5 的退役日历开始提醒开发者提前迁移,模型迭代周期又被压缩了一轮;另一边是英特尔 CEO 出来预警,说内存价格已经涨到了原来的 5 到 7 倍,很多项目因为拿不到足够的内存被迫延期,中低价位的手机和笔记本尤其难。 上面在加速退役,下面在加速涨价。夹在中间的是什么人?是把 AI 真的接进自己流程里的人。 我为什么对这两条特别敏感——因为我吃过「绑死」的亏。 早先我调一套处理流程,是照着当时那个模型的手感一点点磨出来的:提示词里塞了几句针对它脾气的话,输出格式也默认它会乖乖照做。跑了几个月挺顺,直到那个模型下线(或者说,新版本一上,行为就变了)。那天我才发现,我以为我在维护一套流程,其实我维护的是一份「对这个模型的依赖」。提示词里那些精心调出来的怪招,是最脆的资产,模型一换全废。 后来我改了三个习惯,这条建议先收藏,凡是拿 AI 干正经活的人都用得上: **第一,提示词里不写「模型脾气」。** 不再靠「你要特别注意 XX」这种话去哄它,而是把要求写成明确规则,出格了就当它没做到,而不是回头再补一句咒语。 **第二,输出格式固定。** 我要的是结构化字段,不是「让它自由发挥后我再肉眼读」。格式一旦固定,换模型就是换个后端,下游那一整套解析逻辑不用动。 **第三,攒一个自己的回归集。** 这一步是我吃过亏才补上的:挑十几二十个自己业务里最典型的 case,换模型、换机器之后跑同一批,逐条对比。以前我判断「新模型行不行」全靠感觉,感觉经常骗人——有些原来能跑的长任务,新模型会悄悄丢中间步骤,你不拿同一批 case 对着看,根本发现不了。 至于硬件那条线更直白:想自己买机器跑模型的人,成本逻辑正在被内存改写。你算的是显卡,涨价的是内存。这不是短期波动,是这一轮基建投入传导下来的结果——大厂在抢产能,抢的东西最后会变成你的采购报价。 我的判断是:这轮迭代里,「选对模型」和「买对机器」的价值都在下降,真正拉开差距的是**换掉的成本**。谁的流程能在半天内换一个模型、换一台机器跑通同一批 case,谁就不怕这种新闻;谁把身家都压在某一个模型的手感上,那每一条发布新闻对他都是风险提示。 和我一样被模型下线、或者被硬件涨价打乱过计划的,评论区扣个 1,我想看看有多少人踩过这个坑——顺便说说你当时是怎么把流程捞回来的。

优秀的个人博客,低调大师

《6 个坑,我把 GPT-SoVITS 语音克隆跑通了:一份可直接复制的踩坑记录 #WorkBuddy#》

## 一、为什么要干这件事 我想要一个"本地、离线、专属"的语音合成环境——模型在自己硬盘上,文本不经过任何服务器。选 GPT-SoVITS 的理由很直接:社区模型多、支持微调、Windows 一键整合包开箱可用。 结果这条路比想象中曲折。整合包本身没问题,**坑全在"怎么把它跑起来"和"怎么把它打包好"上**。下面按踩坑顺序来。 --- ## 二、踩坑记录 ### 坑 1|用"后台任务"启动 WebUI,进程活着但不监听端口 **现象**:用 Agent 的后台执行方式拉起 `webui.py`,日志只打印到: 然后就没有然后了。进程在(`tasklist` 能看到 python.exe),但 `netstat` 里 9874 端口**从来没有 LISTEN**,`curl http://127.0.0.1:9874` 一直连不上。等了 10 分钟、20 分钟,一样。 **根因**:GPT-SoVITS 的 `webui.py`(Gradio)需要一个**真实的交互式终端**。后台/无终端方式启动时,它会在初始化流程里静默卡住,不报错、不退出、不监听——最难查的那种"假活"。 **解决**:不要用后台方式跑它,写一个用户双击的启动器,在真实 cmd 窗口里执行。 **教训**:**凡是交互式/带 UI 的本地服务,别用后台任务的方式托管**。判断一个服务是否"真的起来了",永远看端口监听,不看进程列表。 --- ### 坑 2|直接调 `go-webui.bat` 不灵,但换成 runtime 里的 python 就通了 整合包自带的 `go-webui.bat` 里做了环境变量拼接、目录切换等一堆事,在某些环境下会中途失败(尤其是从别的 shell 调用时)。 **更稳的写法**:跳过包装脚本,直接指定 runtime 里的解释器: `-I` 是隔离模式,避免当前机器的用户 site-packages 干扰整合包自带环境——这一步很重要,能挡掉一大类"在我机器上跑不通"的问题。 --- ### 坑 3|第一次启动要等 3–5 分钟,窗口一动不动,很容易误判为卡死 模型大约 1.5 GB,首次加载要往内存里搬。这期间: - 窗口没有新输出; - 没有任何进度条; - CPU/内存会有波动,但界面纹丝不动。 **判断标准只有一个**:等到出现 在此之前别关窗口、别重复启动(重复启动会抢端口)。超过 5 分钟仍无输出,才需要去看日志。 --- ### 坑 4|中文路径/中文输出乱码 两三行就能解决,但一旦漏了就很抓狂: 批处理文件本身也要存成 UTF-8,否则中文注释会直接把脚本解析炸掉。 --- ### 坑 5|创建桌面快捷方式被安全策略拦了 想用 PowerShell 的 `WScript.Shell` COM 创建 `.lnk`,结果 **COM 调用被安全策略直接拦下**(连 `Shell.Application` 也是),返回空或直接失败。 **退而求其次但完全够用的做法**:把 `.bat` 启动器**复制一份到桌面**。双击一样能用,图标丑一点,但零依赖零权限。 **教训**:被环境限制时,不要死磕"正规做法",**换一个能达到同样效果的土办法**往往更省时间。目标是"用户双击能用",不是"生成一个真正的 .lnk"。 --- ### 坑 6|打包含中文名的 zip,解压出来全是乱码(本篇最值得记的一条) 这条跟 GPT-SoVITS 无关,但同一次任务里踩到了,而且**极隐蔽**。 **现象**:用系统自带的 `Compress-Archive` 打包一个含中文文件名(如"工作区记忆")的目录,压缩过程一切正常、大小正常。但**解压后文件名变成 `ÕÀÑõ¢£Õî¦ޫ¦Õ+å` 这种鬼画符**,内容还在,名字全废。 **根因**:`Compress-Archive` 写 zip 时,中文文件名**没有按 UTF-8 写入、也没有设置 UTF-8 标志位**,解压端(尤其是非简体中文环境或某些解压工具)就按本地代码页猜,一猜就错。 **解决**:改用 7-Zip 打包,它写 zip 时中文文件名是标准 UTF-8: **关键动作——打完包必须"回读验证"**: 看解压出来的文件名是否完好,再抽查一两个文件的大小是否与原件一致。**"压缩成功" ≠ "能被正确解压"**,这一步不做,等于把坑留给未来的自己。 --- ## 三、最后交付的东西 一个复杂的 AI 工具,用户真正需要的不是"安装成功",而是**双击就开**。最后落地的产物是: |产物|作用| | --- | --- | |启动GPT-SoVITS.bat|双击启动,自动切 UTF-8、检查 runtime、启动服务、45 秒后自动开浏览器| |桌面同名副本|零权限依赖的入口| |使用指南(Markdown)|参数填写规则、可用音色清单、报错排查| 界面里几千个参数,用户真正要填的其实只有四个框:**参考音频路径、参考文本、语种、要合成的文本**。剩下全部保持默认。**把复杂度吃掉,是工具人的职责。** --- ## 四、给同路人的五条总结 1. **交互式服务别用后台任务托管**,判断存活看端口,不看进程; 1. **优先用 `runtime\python.exe -I` 直启**,绕开包装脚本和环境污染; 1. **首次启动慢是正常的**,认准 `Running on local URL` 这一行; 1. **中文名 zip 一律用 7-Zip 打包,并强制解包回读验证**; 1. **被安全策略拦住时,换土办法实现同等效果**,别跟环境较劲。

优秀的个人博客,低调大师

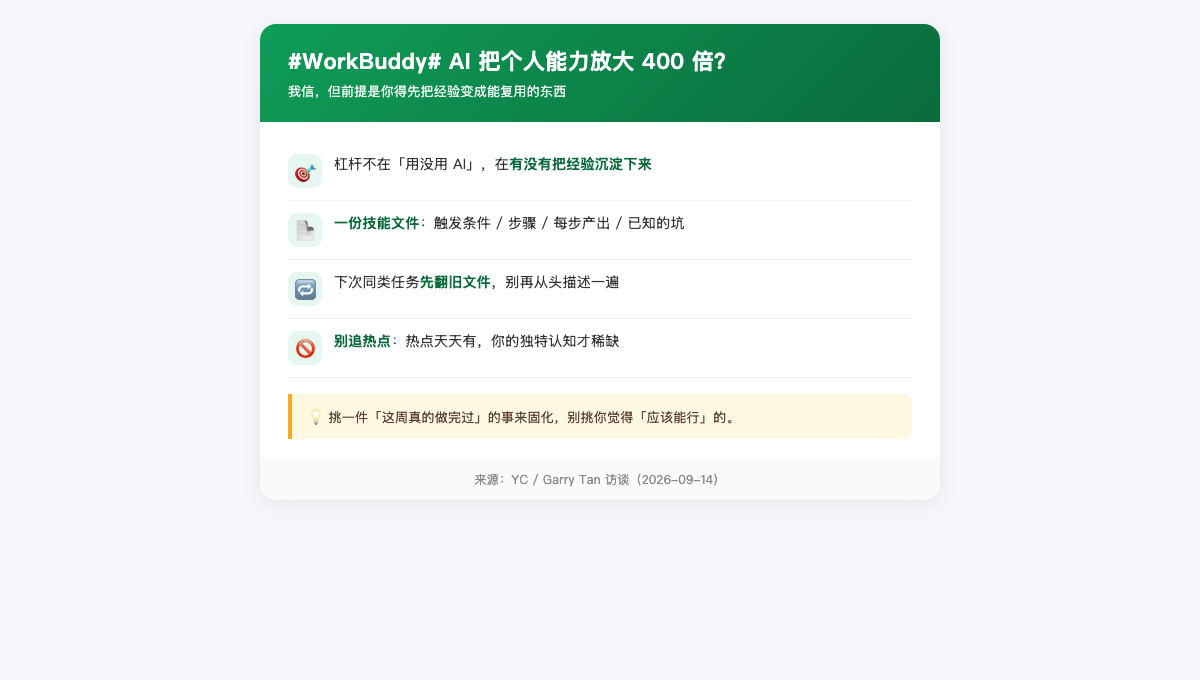
#WorkBuddy# AI 把个人能力放大 400 倍?我信,但前提是你得先把经验变成能复用的东西

![](https://developer.qcloudimg.com/http-save/yehe-12690655/64a5747258e7033398ca66521b8fc4b5.png) YC 的总裁 Garry Tan 最近说了句话,我盯着看了半天:靠 vibe coding 和 Agent 编程,今天一个人能顶九个月前的 400 个自己。 「400 倍」这种数字,听听就好,大概率是拿最猛的个例乘出来的。但他后面那句才是真东西—— 他说,创业者不该追热点,该追问的是:有什么是你独有、别人没有的认知?还有一句更狠:把一次成功的工作,沉淀成一份可复用的 Markdown 技能文件,让流程可重复、可修复。 前半句是鸡汤,后半句是方法。 我以前就是典型的反面教材:同一个流程,每次用时都重新跟 AI 描述一遍需求,改来改去,看着挺忙,其实每回都在从零开始。后来我把一个跑顺的流程写成了一份固定的说明——什么时候用它、分几步、每一步的输入输出是什么、哪个地方最容易踩坑——再遇到同样的活儿,直接调出来用。 省下的不是几分钟,是「重新想一遍」的那个脑子。 说白了,AI 的杠杆根本不在「你用了没有」,而在「你有没有把经验变成能重复调用的东西」。用得再多,每次都从头问,你还是那个你;把一次成功固化下来,你才有第二个你。 怎么固化,其实就三步。 第一,挑一件你这周真的做完过的事,别挑你觉得「应该能行」的。 第二,把它写成一段能照着做的话:触发条件、步骤、每步的产出、已知的坑。不用写漂亮,写清楚就行。 第三,下次遇到同类任务,先翻这份东西,别再重新描述。 这里我要站个队。Garry Tan 说「别追热点」,我完全同意,而且觉得这点比 400 倍更重要。热点每天都有,跟着跑很累,还攒不下东西;真正稀缺的是你对某个具体场景的理解——那个理解,才是能变成技能文件的原料。 (方法不复杂,建议先收藏,下次遇到重复活儿翻出来照着写第一份。) 最后抛个问题:你手上有没有一件「每个月都要重做一遍」的事?评论区说一件出来,我挑几个帮你拆成可以复用的流程——顺便看看大家重复劳动的重灾区到底在哪。

优秀的个人博客,低调大师

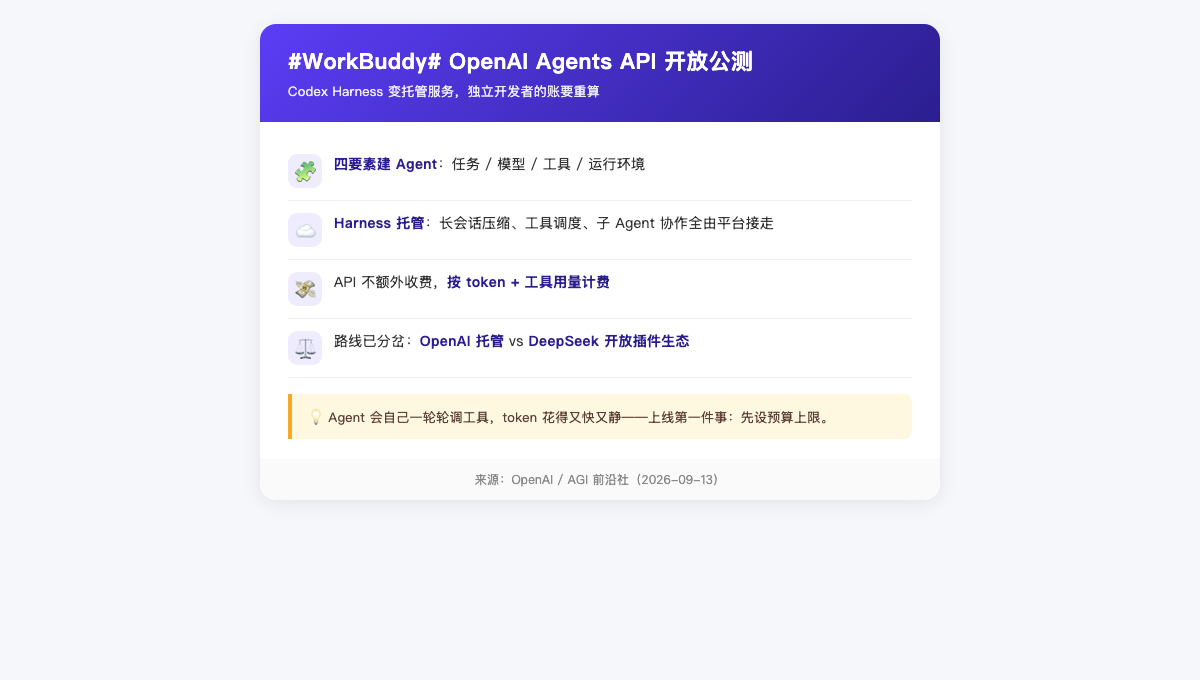
#WorkBuddy# 别再自己攒 Agent 框架了:OpenAI 把 Codex Harness 做成托管服务,独立开发者的账要重算

![](https://developer.qcloudimg.com/http-save/yehe-12690655/33c0a103034da643261967149b260bc7.png) 为了把一个天天重复的活儿交给 AI,我啃了两天 Agent 框架的文档。循环怎么写、工具调用失败怎么重试、上下文超了怎么截断——光这几件事,就够写满一整个文件,还没算调通。 结果昨天 OpenAI 直接把这活儿接走了。 9 月 13 日它一口气发了四条产品线,最值得盯的是 Agents API 开放公测。用法简单到有点不真实:你只要交代四件事——任务是什么、用哪个模型、有哪些工具、跑在什么环境——它就把 Agent 给你搭好。长会话怎么压缩、工具怎么调度、多个子 Agent 怎么分工,这些以前的脏活,现在由它自家的 Codex Harness 托管。而且 API 本身不另外收费,只按 token 和工具用量算钱。 听起来很香,但我想先泼一盆冷水。 自建和托管,其实是在两个东西之间做交易:一个是「控制权」,一个是「省事」。 自己攒框架,你能看到每一步、能改每一处、数据不出你的机器,代价是时间——大量的时间。 用托管,脏活不用干了、上线快了,代价是有一部分黑盒你碰不到。 我的判断很直接,分两种情况。 如果你在做原型、在验证一个想法、手上又没人——那就用托管的,别自建。省下来的时间够你试十个方向,哪个方向值得做,比「框架写得优雅」重要一万倍。 如果你对数据流向有要求、或者量已经大到成本敏感——这时再考虑自建。而且到了这个阶段,你已经清楚该自建哪几块了,不会白干。 有件事必须提前做:设预算上限。Agent 和普通聊天不一样,它会自己一轮轮调工具,token 花得又快又静。不设上限,一觉醒来账单能让你心跳加速。 还有个细节值得留意:这条路线其实已经分岔了。OpenAI 走托管,DeepSeek 那边走开放插件生态。选哪边,说到底是选「省事」还是选「可控」。 没有标准答案。但要有意识地选,别跟着默认值糊里糊涂走。 (这套「托管 vs 自建」的取舍挺绕,建议先收藏,后面我把成本对照算出来再补一篇。) 我押一个观点:现在 90% 的个人开发者根本不需要自建 Agent,自建纯属自我感动。你要是不服,评论区来辩——顺便说说你自己攒框架踩过最大的坑是什么。

优秀的个人博客,低调大师

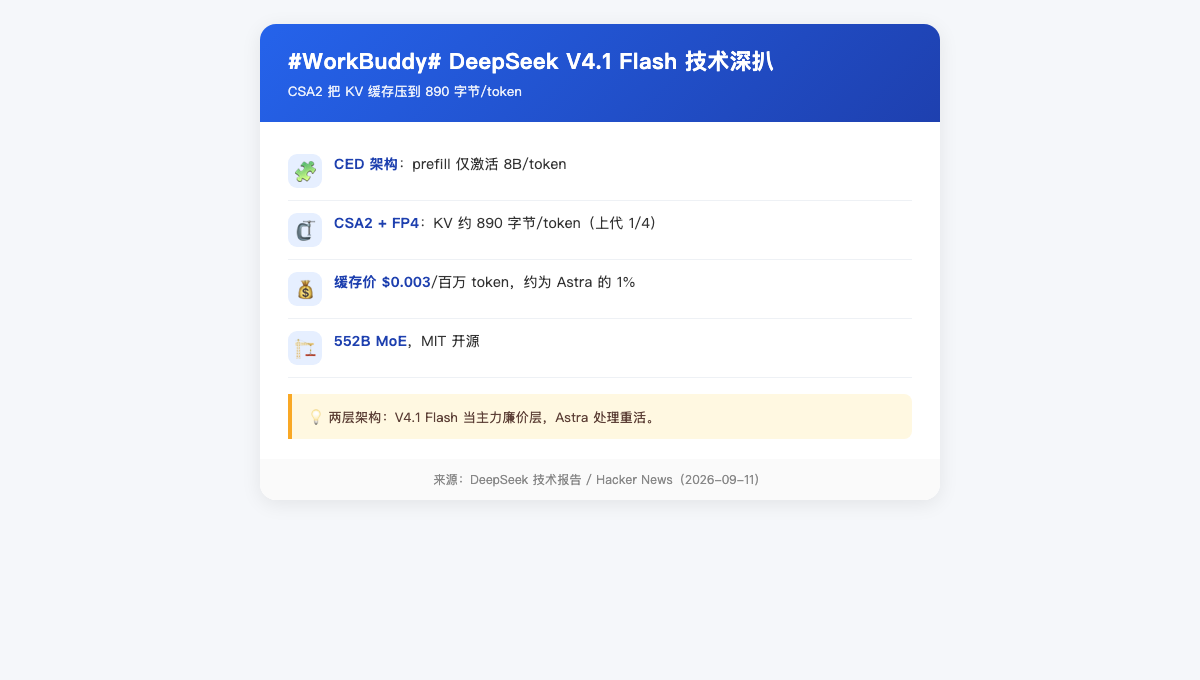
#WorkBuddy# DeepSeek V4.1 Flash 技术深扒:CSA2 把 KV 缓存压到 890 字节/token 意味着什么

![](https://developer.qcloudimg.com/http-save/yehe-12690655/f5b73da42e19c11aedb0f1198a5c8ac8.png) 几乎和 Astra 全量开放同一天,DeepSeek 放出了 V4.1 Flash 的详细技术报告,Hacker News 直接置顶。5520 亿参数(552B)的 MoE,却被他们玩成了"省显存王炸"——核心就是把 KV 缓存压到了约 890 字节/token。这篇不聊发布会,只拆架构,讲清楚它对你部署和成本到底意味着什么。 ## 一、先搞懂:KV 缓存为什么卡住推理成本 大模型推理分两步:prefill(一次性处理输入)和 decode(一个个吐 token)。decode 阶段每生成一个字,都要回头看之前所有字的 KV(Key/Value)向量,存在显存里。 所以: - 上下文越长,KV 占的显存越多 - 并发越高(很多人同时问),显存越爆 - KV 大小直接决定"一台机器能撑多少并发、多长上下文" 过去大家靠量化(INT8/INT4)压 KV,但 DeepSeek 这次上了新架构。 ## 二、CSA2 怎么把 KV 压到 890 字节 V4.1 Flash 用了两个关键设计: - CED 架构(Causal Encoder-Decoder):20 层因果 encoder 喂 20 层 decoder,prefill 只激活约 8B 参数/token,decode 16B/token——比很多小模型还省 - CSA2(Compressed Sparse Attention 2)+ FP4 KV 缓存:把 KV 做"压缩 + 稀疏 + 4 位存储",整体 KV 压到约 890 字节/token,约为上一代 V4-Flash 的四分之一 效果:缓存命中价低到 $0.003 / 百万 token,整体成本约为 Astra 的 1%。 ## 三、对你意味着什么 1. 长上下文更便宜:同样的钱,能喂更长的上下文、接更多并发 2. 部署门槛"显存侧"下降,但"参数侧"上升:KV 省了,可模型本体 552B 比上代 284B 大了一倍,消费级显卡反而更难本地跑——想本地部署得靠多卡或量化 3. 适合做"主力廉价层":把高频、对极致智能不敏感的任务全丢给它,把贵模型留给少数重活 ## 四、选型:Astra 还是 DeepSeek V4.1 Flash 一句话: - 要极致智能、长文档综合推理、会操作电脑 → Astra(但贵) - 要海量并发、低成本、长上下文通吃 → DeepSeek V4.1 Flash(成本约 1%) 很多团队的正确姿势是"两层架构":V4.1 Flash 当默认主力,Astra 只处理真正难的任务。 你更关心"怎么把推理成本压下来"还是"本地能不能跑起来"?评论区告诉我,下篇我直接上部署实测。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册