首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4351篇文章
优秀的个人博客,低调大师

用Workbuddy+腾讯云开发 CloudBase 搭建全球美食百科:风土食录从 0 到上线的实践复盘

做内容站的人大多卡在两件事上:一是技术门槛,二是冷启动没流量。我们最近上线的「风土食录」是一个以地理历史为主线的全球美食百科,从立项到上线用的全是腾讯云开发 CloudBase 这一套,一个人、零运维也能跑起来。这篇文章把我们的选型逻辑、内容架构和冷启动打法摊开讲一遍,供同样想做内容产品的朋友参考。

优秀的个人博客,低调大师

从一句话到一份能讲的 PPT:我的 AI 生成演示文稿全流程 #WorkBuddy#

以前做一份汇报用的 PPT,光是搭框架、找排版就要耗掉半天。最近我把这件事整个交给了 AI 助手,从一句话需求到一份能直接讲的演示文稿,全程十几分钟。把流程拆开分享一下。 ## 第一步:把需求说"完整" 我踩过的第一个坑是需求太笼统。只说"帮我做个产品介绍 PPT",出来的东西四平八稳没法用。后来我学会了在需求里带上三样东西:**给谁看、讲多久、想让他记住什么**。比如"给业务部门讲 10 分钟,重点让他们记住新流程比旧流程省三步",生成出来的结构和重点立刻不一样了。 ## 第二步:让 AI 先出大纲再动手 直接让它一口气生成全部页面,翻车率不低。我的固定流程是先要一份大纲:每页的标题、要点、放什么图。大纲确认无误后再生成完整版,返工率大幅下降。这跟人类协作一个道理——方向对了再抠细节。 ## 第三步:图表交给它,数据给足它 这类工具的图表能力其实相当强,柱状图、折线图、饼图都能直接生成,而且配色是配好的,不用我一个个调。关键是要把数据给足、给干净。有一次我随手贴了一坨没整理的数字,图做出来完全不是那个意思——垃圾进垃圾出,AI 也救不了没整理的数据。 ## 第四步:人工只做一件事——过一遍"讲故事"的顺序 AI 生成的页面单看都没问题,但页与页之间的叙事节奏还是需要人来顺一遍。哪页该留、哪页该合并、哪页需要一个过渡,这一步花不了十分钟,但决定了这份 PPT 是"信息的堆砌"还是"一个能讲的故事"。 ## 两个月用下来的感受 最大的变化是心理负担:以前想到"要做 PPT"就头大,现在它变成了一件"顺手的事"。我把常用的汇报结构存成了模板,每次生成完直接套,风格统一,同事还以为我请了设计。 工具不会替你想清楚"要讲什么",但它能把你想清楚的东西,又快又体面地呈现出来。这个分工,值得试试。 ![](https://developer.qcloudimg.com/http-save/yehe-12856501/4e58ab40d5ef1518993d7aa095ec6018.png) ![](https://developer.qcloudimg.com/http-save/yehe-12856501/245b5c5831b083533eea451bdced6761.png) ![](https://developer.qcloudimg.com/http-save/yehe-12856501/41665e5f96008595f13f3644074fb251.png)

优秀的个人博客,低调大师

用 WorkBuddy 从零打造一个「数字人」 一个文件,装下形象、对话、记忆和知识库

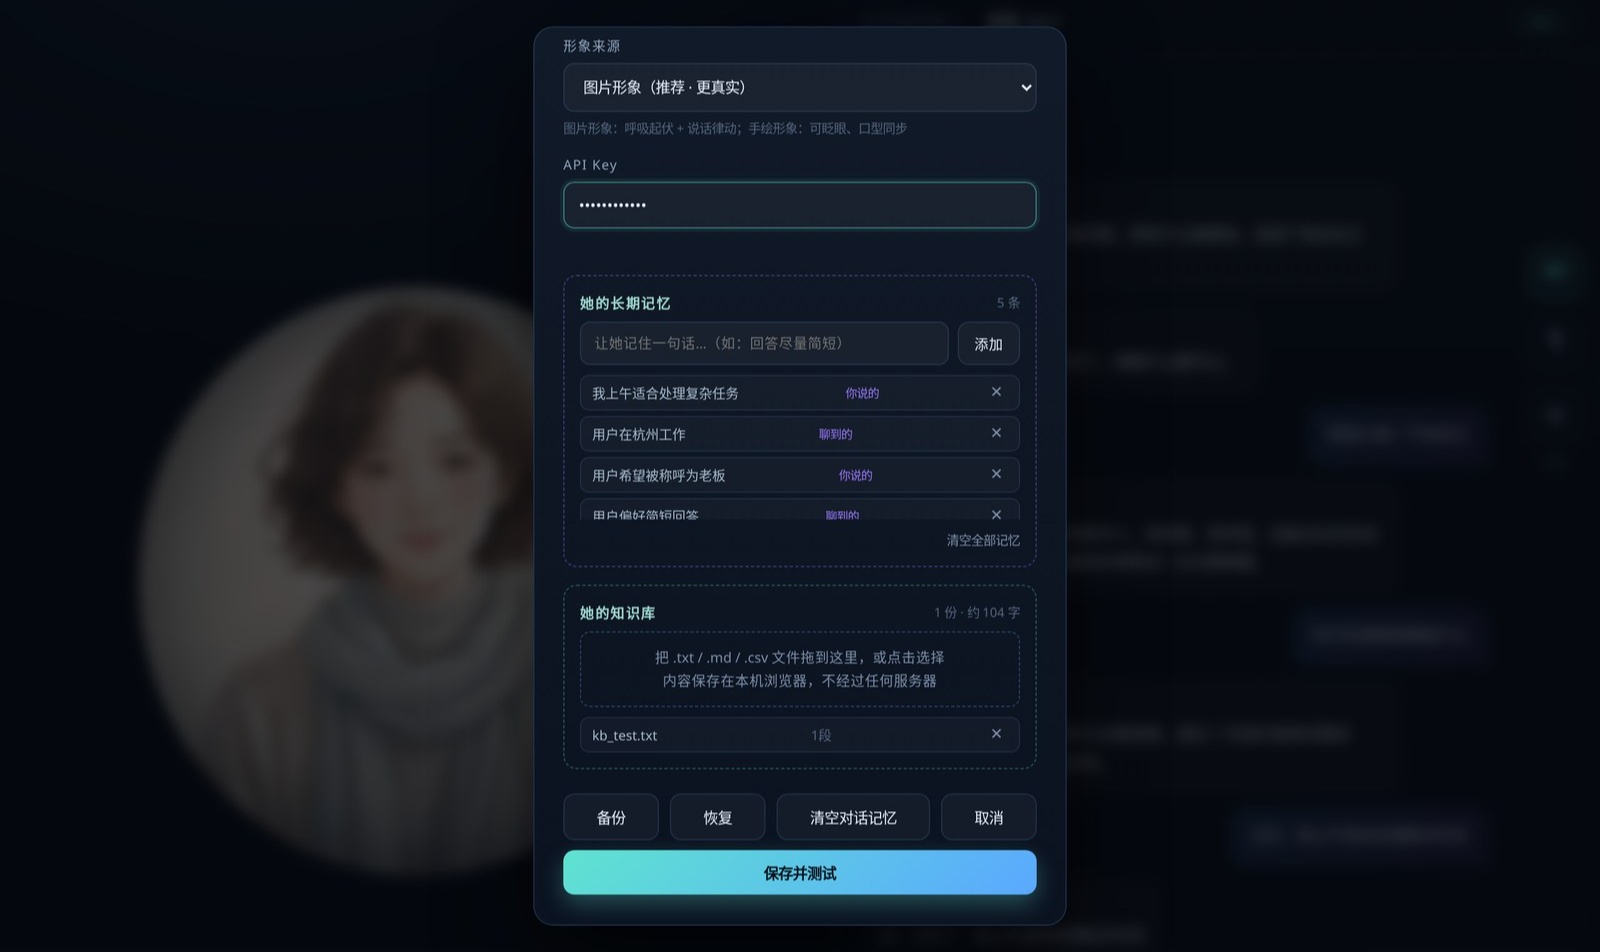
## 一、先说结果 最后得到的东西很简单:**一个 HTML 文件**。 打开它,屏幕上是一个有形象的女性数字人,能说话(合成语音)、能听懂你说的话、能记住你告诉过她的事、能回答你资料里的内容。没有服务器,没有数据库,没有部署流程。文件复制到哪台电脑,她就跟到哪台电脑。 技术上拆开看只有四层: |**层**|**实现**|**体积**| | --- | --- | --- | |形象|SVG 手绘 + AI 生图(可切换)|~110KB| |大脑|DeepSeek Chat API(OpenAI 兼容),流式输出|0(纯调用)| |声音|浏览器 Web Speech + 内嵌 MP3 开场音|~110KB| |记忆 / 知识库|localStorage + 关键词检索|0(本地)| 全部塞在一个 .html 里,不加载任何外部资源。 ![](https://developer.qcloudimg.com/http-save/audit-12854814/6d2745c3353cdedca258073882b761f6.jpg) 图 1:最终成品。左边是数字人形象,右边是对话区,最右侧三个按钮分别是语音播报、语音输入和设置。 ## 二、第一版:先让它「像个人」 最初的诉求很模糊——「打造一个数字人」。模糊需求最忌讳直接开工,先把它拆成可验证的形态问题: ● 是形象展示,还是能对话? ● 装在网页、微信、APP,还是线下大屏? ● 手上有没有素材,有没有预算? 问完这几个问题,方向就清楚了:**对话型 + 网页载体 + 从零开始**。于是第一版做了三件最基础的事: 1.  用 SVG 手绘一个人脸(当时是卡通风格),带呼吸、随机眨眼、视线微移 2.  用 edge-tts 生成几句开场语音,base64 内嵌进页面 3.  用规则引擎做对话(关键词匹配 10 来类问题) 这一版的价值不在好看,而在于**把骨架立起来了**:形象可以动、声音可以出、对话可以跑。后面所有升级都是替换零件,不用重写。 ## 三、接上真大脑:从「背台词」到「真的聊」 规则引擎撑不过三轮。用户第一句话问「你今天怎么样」,它就答不上来了。 换大模型时做了两个决策: **决策一:选哪家。**对比了当时的实时价格,DeepSeek 的空闲时段最便宜(每百万 tokens 输入 1.5 元、输出 4.5 元),一次普通对话约 500 tokens,算下来不到一分钱。中文表现也够用。 ![](https://developer.qcloudimg.com/http-save/audit-12854814/2e1e130db4540470b07f6dcf610948b6.jpg) 图 2:设置面板。填接口地址、模型名和 API Key,点「保存并测试」当场验证连通性;下方是知识库与记忆管理。 **决策二:key 放哪。**两个选项——前端直连,或者本地后端代理。选前端直连,理由是:单文件、双击可用、key 只存在用户自己的浏览器里,不经过任何第三方服务器。代价是 key 暴露在浏览器里,所以只适合「自己用」,不适合对外发布。 实现上最值得说的两点: **流式输出。**不用 await res.json(),而是读 res.body.getReader() 手动解析 SSE,边收边渲染。用户看到的文字是一个字一个字冒出来的,等待感消失了。 |const reader = res.body.getReader();const dec = new TextDecoder();let buf = '', full = '';while (true) { const { done, value } = await reader.read(); if (done) break; buf += dec.decode(value, { stream: true }); const lines = buf.split('\n'); buf = lines.pop(); for (const line of lines) { const s = line.trim(); if (!s.startsWith('data:')) continue; const data = s.slice(5).trim(); if (data === '[DONE]') continue; const d = JSON.parse(data).choices?.[0]?.delta?.content; if (d) { full += d; onDelta(d, full); } }}| | --- | 注意 buf = lines.pop() 这一行:**最后一个不完整的行必须留到下一轮**,否则中文多字节字符被切断会乱码。这个坑我调试了两轮。 **错误说人话。**401、402、429 这些状态码不能直接甩给用户。做一层映射:key 无效就说「这个 key 没通过验证」,余额不足就说「账户余额不足了,充一点就够用很久」,网络不通就说「连不上接口,检查一下网络」。 ## 四、声音:从两句固定音频到全量朗读 第一版只有 3 条内嵌 MP3,只能应付开场白。真实对话内容千变万化,不可能预生成。 分层方案: ● **固定短语**(问候、自我介绍)用内嵌 MP3,音质好 ● **其余所有回复**用浏览器 speechSynthesis,动态朗读 有个细节很关键:说话时要让形象「动嘴」。做法是 startTalking() / stopTalking() 两个函数,onstart 和 onend 各挂一次。这样即使语音是浏览器合成的,口型动画也能对上。 ## 五、长期记忆:这是「玩具」和「伙伴」的分界线 用户提了一个很准的需求: 他就记不住,没有长期记忆。我跟他聊的天儿他都能记住,我告诉他一些个事情,他能够记住改过来。 这句话点出了关键——**记忆不是存档,是改变行为**。所以设计成三条通道: **通道一:显式指令。**正则匹配「记住:xxx」,立刻入库,最高优先级,并且当场回一句「好,记住了:xxx」给用户确认。 |const m = text.match(/^(?:请\|帮我)?(?:记住\|记一下\|记着)[::,,]?\s*(.{2,160})$/);if (m) { addMem(m[1], 'user'); return '好,记住了:' + m[1]; }| | --- | **通道二:后台自动提取。**每轮对话结束后,再发一次很小的模型调用(max_tokens: 200),让它从这轮对话里提炼值得长期记住的信息,输出 JSON 数组。提示词要求它只提三类:用户告诉 AI 的事实、用户对说话方式的要求、用户的偏好习惯。 这次调用是异步的,不阻塞界面。失败了也不影响聊天——catch 里什么都不做。 **通道三:注入。**每次回答前,把最近的记忆条目拼进 system prompt: |【关于用户的长期记忆】这是你与用户长期相处积累的记忆,回答时自然运用(包括说话方式、偏好、事实),但不要逐条复述、不要说"根据我的记忆":- 用户希望被称呼为老板- 用户偏好简短回答- 用户住在杭州| | --- | 最后那句「不要逐条复述」很重要。不加的话,模型会机械地念「根据我的记忆,您住在杭州」,立刻出戏。 **成本控制**:记忆上限 80 条,注入时只取最近 24 条。既控制了 token,也符合「近的记忆更重要」的直觉。 ![](https://developer.qcloudimg.com/http-save/audit-12854814/bfa04c38708493b3db9c42d504c2c3de.jpg) 图 3:说一句「记住:我上午适合处理复杂任务」,她当场确认入库,之后每次回答都会带着这条记忆。 ![](https://developer.qcloudimg.com/http-save/audit-12854814/5fb415712b44597046497f44570688dd.jpg) 图 4:记忆可查看、可单条删除、可手动添加。标注了来源是「你说的」还是「聊到的」。 ## 六、形象:一次失败的判断,和一次有效的转向 这一节是整篇里我最想写的部分,因为我在这里判断错了。 ### 错误判断:以为「换更强的模型」能画得更好 初版形象是纯手写 SVG 贝塞尔曲线,效果一般。用户问:是不是换更强的模型会好一些? 答案是不行。**SVG 手绘的本质是用代码画插画**,上限卡在路径点的手工精度上——皮肤的通透感、头发的丝缕、光影的层次,靠手写路径几乎不可能达到照片级。这跟模型推理能力强不强没有关系。 这个判断很重要,因为它避免了一个常见的资源浪费:**用错工具,然后归因于模型不够强**。 ### 有效的做法:换画法,不换模型 正确路径是:用图像生成模型产出高质量半身像,再把图片嵌进页面做动态化。 实际跑了两轮,第一轮被否,理由很具体: 都不满意,年龄感有点儿太老了,配色有点儿太浓了,太发红黄了,表情也不自然。 第二轮针对性地改提示词: ● 年龄:从模糊描述改成明确「33–38 岁」「年轻清透肤质、淡妆」 ● 配色:从「彩色围巾」改成「低饱和、米白浅灰为主、淡雾蓝围巾,不要鲜艳的红黄橙」 ● 表情:从「微笑」改成「放松自然,嘴角轻轻上扬,眼神平静看着镜头,肩颈放松」 第二轮通过。 ### 图片形象的取舍 这里有一个必须诚实说明的限制:**静态图片做不到真眨眼和口型同步**。 能做的动效是:呼吸起伏(整体轻微缩放 + 位移,5 秒周期)、说话时律动加快、边缘柔光呼吸。看起来「活着」,但严格说没有表情驱动。 想要真口型,只有两条路:生成配套的眨眼帧/嘴型帧,或者接实时驱动服务。这是成本和技术栈的跃迁,不是调参数能解决的。 所以最终留了**双模式开关**:图片形象(更真实)/手绘形象(可眨眼、口型同步),用户自己选。这个设计比强行二选一要好——不同场景需求不同。 ![](https://developer.qcloudimg.com/http-save/audit-12854814/f785331ae52ed15f8faf7c8008ff3f45.png) 图 5:手机端的同一套界面。控制按钮改到人像右侧、与头部齐平,输入框固定在屏幕底部。 ## 七、踩过的坑(都是真踩的) **坑 1:移动端设置面板够不到底部按钮。**面板内容比屏幕高,父容器用 align-items: center 居中,导致上下溢出部分被裁掉且无法滚动。修复:max-height: 92vh; overflow-y: auto;。 这个 bug 很有代表性——**只在手机尺寸下出现,桌面完全正常**。如果只在桌面测试,永远发现不了。 **坑 2:重复的控制入口。**顶栏有一个齿轮,侧边控制栏又有一个。功能一样,纯冗余。删掉一个,界面立刻清爽。教训:**同一个功能不要给两个入口**,除非两个入口的使用场景明确不同。 **坑 3:布局改造留下的重复 ID。**把按钮从顶栏移到侧栏时,只替换了一部分 DOM,旧的按钮没删干净,导致页面里有两个 id="btnVoice"。表现是事件绑到了错误的元素上。教训:**改结构要用断言校验**,assert old in t 之后再替换,比肉眼检查可靠。 **坑 4:测试工具的假象。**用 Playwright 的手机模拟模式点击发送按钮,一直报「被其他元素遮挡」。查几何位置发现根本没有重叠——是模拟模式的坐标换算问题(innerHeight 953 > 视口 844)。换成窄视口但不启用 is_mobile 后,点击一次通过。 教训:**测试报错不等于产品有 bug**。要区分「测试环境问题」和「真实缺陷」,否则会为了修一个不存在的 bug 改坏正常代码。 **坑 5:pkill -f mock.py 把自己杀了。**命令行里包含 mock.py 这个字符串,pkill -f 匹配到自己的父进程,直接 SIGTERM。这个坑每次踩都很无语。 ![](https://developer.qcloudimg.com/http-save/audit-12854814/242b95832cbe6e0db7372deb58d7f3d4.jpg) 图 6:把一份资料喂进知识库后提问,她的回答来自资料本身,而不是凭空编。 ## 八、关于数据安全:什么都不在云上 这是刻意设计的。用户问过「这些喂的知识将来是存在云上了,还是存在哪里了」,答案是: |**内容**|**位置**| | --- | --- | |API Key|浏览器 localStorage| |对话记忆(近 12 轮)|浏览器 localStorage| |长期记忆(80 条)|浏览器 localStorage| |知识库文档|浏览器 localStorage| **知识跟着文件走**。文件复制到哪台电脑,她就带着记忆到哪台电脑;删了文件,记忆也没了。 代价是换设备要重来,所以做了「备份 / 恢复」:一键导出 key + 知识库 + 记忆为一个 json,换设备时导入即可。 这个取舍适合「个人使用」场景。要做多设备同步或团队共享,就必须上云——那时候成本和合规问题会一起出现,是另一个量级的工程。 ## 九、可复用的方法论 如果让我把这套东西抽象成几条可迁移的经验: **1. 用最小可运行骨架起步,然后逐层替换零件。**第一版的规则引擎很简陋,但它让「形象—声音—对话」这条链路先通了。后面换大模型、换记忆、换形象,都是替换单个零件,没有推倒重来。 **2. 单文件自包含,是个人工具的最优解。**零部署、零依赖、可离线、易备份、易分享。代价是体积大、无服务端能力。对于「自己用」的工具,这个代价完全值得。 **3. 记忆系统的核心是「注入」,不是「存储」。**存了不用等于没存。真正让用户感知到「她记得我」的,是每次回答前把记忆拼进提示词,并且明确要求模型自然运用而不是机械复述。 **4. 用错工具时,要敢于承认是工具的问题。**手写 SVG 画不出照片级人像,这不是模型能力问题,是画法问题。识别出这一点,比不断换模型试错省下的不只是积分。 **5. 每次改动都跑一遍端到端验证。**这套东西改到后面,一个 CSS 改动都可能影响按钮点击。所以每次改完都用无头浏览器跑一遍:加载、发消息、收回复、检查控制台报错。 ## 十、还没做完的部分 诚实地说,现在这版还是个「半成品」: ● **声音**是浏览器 TTS,音色一般,没有情感起伏。可以换成按回复动态生成的高质量语音,但每次都要调接口,延迟和成本都会上升。 ● **形象**是静态图,没有表情驱动。要做到真眨眼、真口型,需要接实时驱动服务。 ● **能力**只有聊天和查资料。还不能帮她干活——查天气、记事、读网页、订日程,这些都需要接工具。 但骨架是活的。加任何一层,都是往上装零件,不是重来。 ## 十一、最后 一开始的需求只有一句话:「帮我慢慢打造一个数智人」。 从这句话到一个能用的东西,中间经历了:形态追问 → 骨架搭建 → 接大脑 → 加声音 → 加记忆 → 换形象 → 反复修布局 → 清理产物。 有意思的是,**最有价值的几次推进都不是"加功能",而是"改判断"**: ● 意识到规则引擎撑不住,果断换大模型 ● 意识到手写 SVG 有上限,果断换画法 ● 意识到记忆不是存档而是注入,重新设计了整条链路 写这篇的时候我在想,工具的价值可能不在于它一次能给你多惊艳的结果,而在于它能不能陪你把一个模糊的想法,一层一层磨成具体的东西。 这个数字人现在还是半成品。但她有名字、有脸、有声音、记得住事。剩下的,慢慢来。    

优秀的个人博客,低调大师

一家 25 天刷出 17 万星:有人用纯 Rust 重写了整个创意软件全家桶 #WorkBuddy#

> 子杰线 · 腾讯云版|护城河 = 实测核实 + 诚实边界(不忽悠、不跟风、给真能走的路) --- 最近 GitHub 榜单炸了,一个叫 storytold 的新账号短短 25 天星标量冲破 17 万,霸榜趋势前所未有。作为只看实测不忽悠的博主,我按榜单去 GitHub 逐个核实了一遍数据,翻了仓库说明和工程结构。事实比传闻更硬核——这不是什么营销噱头,而是有人用纯 Rust,从零开始,一口气把 Adobe 全家桶、微软 Office 核心件和 AutoCAD 全复刻了。 下面是我的实测报告。 ## 0. 一句话结论 **这不只是"又一个开源替代",这是有人把"Adobe+Office+AutoCAD 三大收费堡垒"一次性用 Rust 复刻了一份,25 天拿 17 万星说明用户被订阅制憋太久了。** ## 1. 17 万星的数据拆解:三大堡垒的全面复制 2026-09-30 前后,GitHub 新账号 storytold 集中上架了 10 个"Craft"系列仓库。我于 2026-10-25 实时核实了星数,不到一个月的时间,合计星标达到了惊人的 173,620。明细如下: - **photocraft**:72,617 星(GitHub 新晋榜第一),对标 Photoshop,图片编辑器。 - **pdfcraft**:17,732 星,对标 Acrobat,PDF 阅读编辑器。 - **filmcraft**:16,196 星,对标 Premiere,非线性视频编辑器。 - **wordcraft**:15,969 星,对标微软 Word,干净室重实现。 - **lightcraft**:14,599 星,对标 Lightroom,非破坏性照片编辑。 - **vectorcraft**:10,646 星,对标 Illustrator,矢量绘图。 - **effectcraft**:7,871 星,对标 After Effects,动效合成。 - **cadcraft**:6,747 星,对标 AutoCAD,二维 CAD。 - **gridcraft**:6,474 星,对标 Excel,电子表格。 - **designcraft**:4,769 星,对标 InDesign,页面排版设计。 除了 storytold 的这 10 个库,同思路下还有 tangency-labs 出品的 **solidcraft**(10,102 星),对标参数化 3D CAD,且已支持 MCP(Model Context Protocol)自动化。 把这些领域摊开看,你就会倒吸一口凉气:**这恰好对应了过去二十年里三个最坚固的收费堡垒——Adobe 全家桶(Photoshop、Lightroom、Premiere、After Effects、Illustrator、InDesign)、Microsoft Office 核心生产力件(Word、Excel)、以及工程制造界的绝对霸主 AutoCAD。** 以往挑战这些堡垒的开源项目,通常是散兵游勇,做一个 PS 替代或者做一个 Word 替代,往往做到 30% 的功能就因为人力匮乏烂尾了。而 storytold 是一次性把十几个重度生产力工具全铺开了,且每个都拿到了万级甚至十万级的星标。这背后绝不是单纯的"开源社区又赢麻了"的套路,而是一场积怨已久的总爆发。25 天 17 万星,每一颗星都是用户对动辄几百上千元年费订阅制的一张反对票。 ## 2. 为什么是 Rust:从零写编辑器,2020 年前谁敢想? 如果这个故事发生在 2020 年以前,我肯定认为是骗子。从零手写一个 Photoshop 级别的图片编辑器,或者 Premiere 级别的视频编辑器,这在过去是不可想象的。C++ 写这些玩意儿,大厂得堆几百人干好几年,内存管理稍微不注意就是满屏段错误;小团队干?连门都摸不到。 所以过去十年,开源替代品基本只有一条路:**Electron 套壳**。用 Web 技术套个壳,底层调用开源库(比如 ImageMagick 或 FFmpeg)拼凑。结果呢?界面倒是做出来了,但稍微拖拽个大点的图片、或者时间线拉长一点,风扇就开始狂转,内存占用动辄 2GB 起步。**Electron 解决了小团队"写不出界面"的问题,但带来了"性能根本不能看"的灾难。**这就是为什么很多开源替代品永远只能做看图软件,做不了真正的生产力工具。 Rust 的出现改变了游戏规则。我翻了 photocraft 的仓库结构:整个项目是一个标准的 Rust workspace,拆出 `craft-ui`、`photocraft-geom`、`photocraft-color`、`photocraft-raster`、`photocraft-doc`、`photocraft-ops`、`photocraft-psd` 等十来个内部 crate——连 PSD 文件读取都是自己写的模块。**这是原生桌面软件的工程结构,不是网页套壳。**这类项目的渲染层普遍走 Rust 生态的 GPU 方案(如 wgpu/WebGPU 一族),直接把 GPU 渲染管线握在手里,跨平台自动映射 Vulkan/Metal/DX12。无论 photocraft 里的图层数百次叠加,还是 filmcraft 里的视频时间线实时预览,全走 GPU 硬件加速,这是 Electron 套壳根本不敢想的。 更致命的是 Rust 的**内存安全无 GC**。写复杂编辑器,最头疼的就是状态管理:撤销重做栈、非破坏性编辑节点图、多线程并行解码。C++ 写这些,多线程数据竞争能让人 debug 到抑郁;带 GC 的语言(Java/C#)写这些,GC 暂停能让你拖动滑块时感受到明显的卡顿。Rust 没有运行时 GC,所有权模型在编译期就把数据竞争消灭了,二进制文件又极小。这让三五人的小团队,拥有了写出桌面级原生性能软件的底气。**不是大厂写不出,是大厂用 C++ 写的成本太高;现在小团队用 Rust,成本降下来了,性能还不打折。** ## 3. clean-room 重实现:不抄代码,直接抽干护城河 只看结果,很多人会质疑:一个月出十几个重器,是不是抄了原厂代码?或者封装了现有开源库? 从仓库自述和工程结构看,结论很明确:**这批项目全部主打 clean-room(干净室)重实现,从零手写,不依赖现有同类软件的代码。**(photocraft 甚至把 PSD 解析都拆成自己的 crate 重写,而不是拿现成解析库凑数。) clean-room 在软件工程里是个极度硬核的词,意思是:开发者只根据软件的公开行为(功能、输入输出、UI 交互逻辑)来重新设计代码实现,绝对不看、也不引用原软件(比如 Photoshop、Word)的源代码,甚至连原厂开源过的协议代码都不沾。 这意味着什么?**意味着彻底摆脱了原厂的协议和法律约束,真正可以商用分发。** 回想一下以往开源替代品的窘境。LibreOffice 为什么界面老旧、架构臃肿难以重构?因为它身上背着 OpenOffice 时代三十年的历史债务,大量底层逻辑是为了兼容各种稀奇古怪的旧格式硬生生堆出来的,不敢删,一删就崩。更别提很多开源项目用了 GPL 协议的底层库,商业公司想用都得退避三舍。 clean-room 重实现斩断了这一切。storytold 的代码全是当代 Rust 风格,没有历史包袱,架构干净得令人发指。因为没有依赖那些协议复杂的遗留代码库,它们可以采用最宽松的商用协议发布。企业拿过去,二次开发也好,内部部署也好,没有后顾之忧。**这不只是技术上重写,这是在法律层面上把闭源大厂的护城河给抽干了。** 只要功能做到 80% 的可用度,加上免费和可商用这两把尖刀,足以对原厂的定价权造成毁灭性打击。 ## 4. 冷静面(诚实边界):星数 ≠ 可用性,硬骨头还没啃下来 作为实测博主,我必须泼冷水:**星数绝不等于可用性。** 17 万星代表的是情绪价值,是大家的期盼,不是软件已经成熟到可以干掉原厂了。 从项目当前完成度和社区反馈看,距离真正替代成熟商业软件,还有几块极硬的骨头: 1. **非破坏性编辑的深度验证**:photocraft 和 lightcraft 目前实现了图层和基本参数的非破坏性调整,但 Photoshop 那种几十个调整图层、智能对象嵌套、跨文档引用的复杂状态树,一旦遇到极高强度的操作,早期实现大概率会状态崩塌。没有几年用户 bug 报喂,这块的鲁棒性根本起不来。 1. **复杂文档兼容性**:wordcraft 做基础排版很漂亮,但如果你拿一个带几十个宏、嵌套复杂表格和修订记录的真实企业级 .docx 文件喂给它,解析崩溃或格式错乱的概率极高。微软的格式兼容壁垒是几十亿条文档堆出来的,重实现只是写了格式解析器,没经过海量语料训练。 1. **视频与动效的编码生态**:filmcraft 和 effectcraft 能跑通时间线,但遇到各种奇形怪状的摄像机直出编码、复杂的三方插件特效,立刻抓瞎。Premiere 和 AE 的护城河一大半在媒体编解码器和插件生态上,Rust 再强,也绕不过漫长的时间积累。 1. **订阅制软件的迁移成本**:哪怕功能做到了 100%,操作习惯、快捷键、工作流也是巨大的迁移门槛。专业用户的手指肌肉记忆比大脑更难改变。 **给你一个诚实的判断标准:别看了 17 万星就热血上头卸载原版。** 先去试 photocraft(目前 72,617 星,社区最活跃,功能最完善),如果它当前的图层逻辑和画笔体验能满足你 80% 的日常需求,再去考虑要不要慢慢把 pdfcraft 和 lightcraft 融入工作流。至于 filmcraft 和 effectcraft,专业影视从业者现阶段当个玩具看就行,别拿项目去赌。 ## 5. 落地建议:怎么找,怎么用,以及怎么抄作业 对于想尝鲜的国内用户,落地路径很简单: - **怎么找**:直接去 GitHub 搜 `storytold`,主账号下就是这 10 个 Craft 仓库。搜 `solidcraft` 则在 `tangency-labs` 账号下。 - **先跑哪个**:`photocraft` 和 `pdfcraft`。这两个是最贴近大众高频需求的,且目前的完成度最接近可用。如果你是轻量级办公需求,`wordcraft` 和 `gridcraft` 也可以拉下来编译玩一下,界面现代感确实秒杀 LibreOffice。 - **关注什么**:重点关注他们的 `wgpu` 渲染架构和节点图实现,这是所有 Craft 项目的底层核心,也是 Rust GUI 生态的目前最高水平实战。 **但对开发者来说,这里藏着一个更重要的启示——"用 Rust 复刻一个垂直领域收费软件",是当前 GitHub 涨星最快的模式之一,没有比这更性感的赛道了。** 过去做开源,大家喜欢做基础设施,做个数据库、做个 Web 框架,卷得要死还难出圈。现在 storytold 指了一条明路:别做底层了,**拿着 Rust 这把快刀,直接去刺向那些收着高昂订阅费、用户怨声载道、但产品本身技术护城河并没有想象中那么深的桌面软件。** AutoCAD 一年授权费好几万,核心不就是几何约束求解器和渲染引擎吗?用 Rust 搞个 clean-room 实现加上 MCP 自动化(参考 solidcraft),立刻 10 万星。微软 Office 核心不就是文档对象模型和排版引擎吗?用 Rust 重写,哪怕只支持 30% 的常用功能,加上导出 PDF 足够轻量级用户用了。 **痛点越痛,订阅越贵,Rust 复刻的涨星速度就越疯。** 这是技术对商业霸权的一次反攻,而且是一次成本极低的反攻。 --- ## 给三类人的话 **给普通用户**:这 17 万星是替你们举的牌。软件世界不该只有"交钱免灾"这一种选择。但现阶段请把它们当作希望的火种,而不是立刻能替你干活的骡子。先试 photocraft,给项目提 bug,这才是帮它们长大的正确姿势。 **给开发者**:别再卷 Web 框架了。看看你电脑里那些每年收你几千块订阅费、还经常卡死的工具软件,选一个你最熟悉的领域,用 Rust 做 clean-room 重实现。这是当前个人开发者和小团队破局出圈的最短路径,没有之一。 **给关注订阅制的人**:Adobe、微软、Autodesk 的高管们应该看看这 17 万星。这叫风箱里的老鼠——两头受气。一头是用户对订阅制的怒火,另一头是 Rust 等新技术把重写门槛拉低的现实。护城河不再是代码量大,而是时间。如果你们还不改变榨干用户的定价策略,下一波 17 万星出现的时间,只会更短。

优秀的个人博客,低调大师

拆穿"国内用 Muse"骗局:那个 2 万 Star 的 Molly 根本不是解锁器,真正能落地的是它 #WorkBuddy#

> 子杰线 · 腾讯云版|护城河 = 实测核实 + 诚实边界(不忽悠、不跟风、给真能走的路) --- ## 0. 一句话结论 有人拍视频说:国内想用 Meta 的 Muse 个人智能体?登录一个叫 **Molly** 的 GitHub 项目(据说 2 万 Star,云端环境),就能进 Muse 云端、再用 OpenMuse 跑个 Chrome 把环境搭起来,回去 Muse 就能登录了。 我按视频去 GitHub 把这几个项目全核实了一遍,结论很直接: - **视频说的因果链不成立。** "Molly" 真身是 `lexmount/moli`(实测 20,299 Star,Apache-2.0,Rust 写的无头浏览器引擎),它是**给 AI agent 用的浏览器**,跟"解锁 Meta Muse"没有任何关系。 - **Meta Muse 的地区锁是账号级,不是 IP 级。** 云端环境/VPN 改了 IP,绕不过账号地区校验;Meta 官方自己都发过话:这么干会冒封号风险,而且就算进去了,付款走的是美国银行体系,国内根本用不了。 - **真正能落地、无地区锁的"个人智能体"是 `CopilotKit/openmuse**`(实测 5,475 Star,MIT,开源自托管)。想体验 Muse 那种"替你跑腿"的能力,走它才是正路。 这篇把核实过程、三个真项目的实测数据、以及为什么视频那套是坑,全摊开给你。 --- ## 1. 先认清楚:Meta Muse 到底是个啥 Meta 在 2026-09-08 发布了 **Muse**,一个"个人 AI 智能体":它不像 ChatGPT 那样一问一答,而是**有自己的云端虚拟机(Muse Secure VM)**,能替你开浏览器、读邮件、订行程、填表单、比价购物,关掉 App 任务还在后台跑。同一台机器上还有个叫 **Sentinel** 的审批 Agent,Muse 想往外发任何东西都得它点头。 听起来很香,但两个硬限制: 1. **只对美国、加拿大 18+ 开放。** 官网写得很清楚,没有等待名单、没有国家清单可查。 1. **地区锁是账号级,不是 IP 级。** 这不是"挂个代理就能进"。Meta 的校验在登录时看的是你 **Meta 账号的地区**、应用商店地区、甚至支付卡。Meta 官方的 @meta.ai 账号在 Threads 上被问到时直接回过:*"你可能靠美区 VPN 过了注册,但你是在绕过地域限制,会冒封号风险。"* 更现实的是:Muse 付款走 **Stripe Link + Plaid**(仅对接美国 1.2 万家银行),购物、比价、退款这些它最主打的能力,**强依赖美国本地金融基础设施**。就算你真绕进去了,也是一个"没有美国银行卡、没有美国购物生态"的空壳智能体——核心功能全用不了。 **所以"国内用 Muse"在 Meta 官方产品上,当前无解。** 任何说"用 XX 就能进"的,先问一句:它改得了你的账号地区吗?改不了,就是忽悠。 --- ## 2. 视频里的"Molly"是啥?实测:是个浏览器引擎,不是解锁器 我按视频说的 "Molly / 2 万 Star / 云端环境部署" 去 GitHub 搜,结果只有两个相关信息: - **`lexmount/moli**`:实测 **20,299 Star / 542 fork / Apache-2.0 / Rust**,描述是 *"Best headless browser for AI agents. Lite, Fast, High-Compatibility."*(给 AI agent 最好的无头浏览器:轻量、快、高兼容)。 - 各类云浏览器榜单里,moli 和 browser-use(118.9k)、stagehand(25.8k) 排在一起,定位是**给 Agent 跑网页自动化的底层浏览器引擎**。 它确实火、确实有用——Rust 从零写内核,把"看页面"拆成"读结构"和"出图",默认只做结构抽取,内存压到 Chrome 的约 1/8(92MiB vs 697MiB),对 Agent 抓取、RAG 前置、低内存 CI 是真香。 **但它和"解锁 Muse"八竿子打不着。** moli 是给开发者用的浏览器内核,你要接个 Agent 让它抓网页才用得上。视频把它包装成"进 Muse 的云端环境钥匙",属于把两个不相关的事硬拼因果。这种"一听很神、一核实就露馅"的推荐,最该警惕。 --- ## 3. 那 Meta Muse 的"开源平替"在不在?在,叫 OpenMuse 如果你就是想要 Muse 那种"个人智能体"体验,而且**不想被地区锁、不想把数据交给 Meta**,真有一个干净的路: **`CopilotKit/openmuse**`(实测 5,475 Star / 775 fork / MIT / TypeScript)。 它是 Meta 发布 Muse 两周后,做 AG-UI 协议的 CopilotKit 团队开源的**自托管个人智能体**。能力对照 Muse 几乎照做了一套: - 持久化的 **Chromium 浏览器**(Agent computer),加一个可选的 **Linux 容器**当终端; - **后台持续跑的任务 worker**:你派个活,它后台一直干,卡住或要你拍板时停下来等你; - **Goals & Tracking**:提个长期目标,它帮你拆、追踪、复盘; - **Gmail & Calendar** 接入(发邮件、改日程都要单独审批); - 一套 React Native 代码同时出 **iOS / Android / Web**; - **MIT 协议、数据存在你自己机器上**(默认 `.openmuse/`),接 Claude Code / Codex / 任意 backend。 换句话说:**Muse 是 Meta 闭源云上跑、数据在它那;OpenMuse 是你自己部署、数据在你这。** 想要"个人智能体",这是当前最正、最没有地区锁、最符合"自己掌控"的路。 ### 诚实边界(必须说清楚) - OpenMuse 还是 **alpha**,单所有者项目,别接生产关键链路(和我们用 AgentReach 的纪律一致)。 - 前置需要:**Node 24 LTS + pnpm 11.19 + 一个 CopilotKit Intelligence 项目 key**(第三方 SaaS,得自己开账号)。这一步我们本地暂无 key,所以**我只核实了仓库与架构,没假跑**——有 key 才能真部署。 - 它现在**没有**健康/银行/社交连接器,自动下单付款也在路线图里没落地。别指望它现在就能"替你花钱"。 --- ## 4. 为什么这种"国内解锁"视频最容易坑人 回到我反复强调的那条铁律:**"凡普通人用 ChatGPT 一天就能复制操作的,基本就是蠢事、最赚不到钱。"** 这条放到"信息甄别"上也成立—— - 一个"挂个云端就能用上海外锁区服务"的故事,**传播力极强、复制极简单**,所以满天飞; - 但它在工程事实和平台规则上站不住(账号级锁 + 风控 + 本地金融依赖); - 真去照做的人,要么卡在登录界面(和 VPN 一个下场),要么冒封号风险,要么进去了也是个空壳。 **我们不做比他们更蠢的事。** 正确动作永远是:视频推荐的每一个项目,先去 GitHub API 拉 stars + 描述 + license 核实真身,再决定装不装、写不写。本案核实后真相清楚:Molly=moli 浏览器引擎(真有用,但非解锁器);真正该写、该用的是 OpenMuse 自托管。 --- ## 5. 给想动手的人:OpenMuse 自托管最小路径(文档级) ``` # 前置(需自备 CopilotKit Intelligence key) # Node 24 LTS + pnpm 11.19 nvm install 24 && nvm use 24 npm i -g pnpm@11.19 # 克隆并安装 git clone https://github.com/CopilotKit/openmuse.git cd openmuse && pnpm install # 配置:填 COPILOTKIT_INTELLIGENCE_KEY 等环境变量(见仓库 .env.example) # 本地起(先接演示数据,再接真实 Gmail/Calendar) pnpm dev ``` > 注:以上为仓库 README 文档级路径,需第三方 key,我们本地未跑通(无 key),不实装。等 CopilotKit 账号开好我们再实跑验证。 --- ## 6. 小结 |项目|实测星数|它到底是什么|国内能不能"用 Muse"| | --- | --- | --- | --- | |Meta Muse(本体)|热榜级|Meta 闭源个人智能体,美/加专属|❌ 账号级锁,无解| |lexmount/moli(视频的"Molly")|20,299|Rust 无头浏览器引擎,给 Agent 用|❌ 跟解锁无关| |CopilotKit/openmuse|5,475|开源自托管个人智能体,MIT|✅ 真正能落地、无地区锁| **一句话送你**:别信"云端一键解锁 Muse"的神话。真想要个人智能体,自己部署 OpenMuse——数据是你的,地区锁管不着你,这才叫"自己的 AI 员工"。 --- *实测锚定日期:2026-10-24|数据来源:GitHub API(stars/license/desc)、Meta 官方 Muse 可用性说明、CopilotKit/openmuse README。边界已声明,不实装未验证部分已标注。*

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册