首页 文章 精选 留言 我的

精选列表

搜索[HTTP/2],共10000篇文章
优秀的个人博客,低调大师

《Hadoop实战第2版》——3.1节为什么要用MapReduce

3.1 为什么要用MapReduceMapReduce的流行是有理由的。它非常简单、易于实现且扩展性强。大家可以通过它轻易地编写出同时在多台主机上运行的程序,也可以使用Ruby、Python、PHP和C++等非Java类语言编写Map或Reduce程序,还可以在任何安装Hadoop的集群中运行同样的程序,不论这个集群有多少台主机。MapReduce适合处理海量数据,因为它会被多台主机同时处理,这样通常会有较快的速度。下面来看一个例子。引文分析是评价论文好坏的一个非常重要的方面,本例只对其中最简单的一部分,即论文的被引用次数进行了统计。假设有很多篇论文(百万级),且每篇论文的引文形式如下所示:ReferencesDavid M. Blei, Andrew Y. Ng, and Michael I. Jordan. Latent dir

优秀的个人博客,低调大师

《Hadoop实战第2版》——3.3节MapReduce任务的优化

3.3 MapReduce任务的优化相信每个程序员在编程时都会问自己两个问题“我如何完成这个任务”,以及“怎么能让程序运行得更快”。同样,MapReduce计算模型的多次优化也是为了更好地解答这两个问题。MapReduce计算模型的优化涉及了方方面面的内容,但是主要集中在两个方面:一是计算性能方面的优化;二是I/O操作方面的优化。这其中,又包含六个方面的内容。 任务调度任务调度是Hadoop中非常重要的一环,这个优化又涉及两个方面的内容。计算方面:Hadoop总会优先将任务分配给空闲的机器,使所有的任务能公平地分享系统资源。I/O方面:Hadoop会尽量将Map任务分配给InputSplit所在的机器,以减少网络I/O的消耗。 数据预处理与InputSplit的大小MapReduce任务擅长处理少量的大数据,而在处理大量的小数据时,M

优秀的个人博客,低调大师

《Hadoop实战第2版》——1.3节Hadoop体系结构

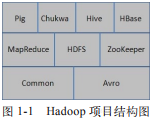
1.3 Hadoop体系结构如上文所说,HDFS和MapReduce是Hadoop的两大核心。而整个Hadoop的体系结构主要是通过HDFS来实现分布式存储的底层支持的,并且它会通过MapReduce来实现分布式并行任务处理的程序支持。下面首先介绍HDFS的体系结构。HDFS采用了主从(Master/Slave)结构模型,一个HDFS集群是由一个NameNode和若干个DataNode组成的。其中NameNode作为主服务器,管理文件系统的命名空间和客户端对文件的访问操作;集群中的DataNode管理存储的数据。HDFS允许用户以文件的形式存储数据。从内部来看,文件被分成若干个数据块,而且这若干个数据块存放在一组DataNode上。NameNode执行文件系统的命名空间操作,比如打开、关闭、重命名文件或目录等,它也负责数据块到具体

优秀的个人博客,低调大师

《Hadoop实战第2版》——1.6节Hadoop数据管理

1.6 Hadoop数据管理前面重点介绍了Hadoop及其体系结构与计算模型MapReduce,现在开始介绍Hadoop的数据管理,主要包括Hadoop的分布式文件系统HDFS、分布式数据库HBase和数据仓库工具Hive。 1.6.1 HDFS的数据管理HDFS是分布式计算的存储基石,Hadoop分布式文件系统和其他分布式文件系统有很多类似的特性: 对于整个集群有单一的命名空间; 具有数据一致性,都适合一次写入多次读取的模型,客户端在文件没有被成功创建之前是无法看到文件存在的; 文件会被分割成多个文件块,每个文件块被分配存储到数据节点上,而且会根据配置由复制文件块来保证数据的安全性。通过前面的介绍和图1-3可以看出,HDFS通过三个重要的角色来进行文件系统的管理:NameNode、DataNode和Client。NameNode可

优秀的个人博客,低调大师

《Hadoop实战第2版》——1.5节Hadoop计算模型—MapReduce

1.5 Hadoop计算模型—MapReduceMapReduce是Google公司的核心计算模型,它将运行于大规模集群上的复杂的并行计算过程高度地抽象为两个函数:Map和Reduce。Hadoop是Doug Cutting受到Google发表的关于MapReduce的论文启发而开发出来的。Hadoop中的MapReduce是一个使用简易的软件框架,基于它写出来的应用程序能够运行在由上千台商用机器组成的大型集群上,并以一种可靠容错的方式并行处理上T级别的数据集,实现了Hadoop在集群上的数据和任务的并行计算与处理。一个Map/Reduce作业(Job)通常会把输入的数据集切分为若干独立的数据块,由Map任务(Task)以完全并行的方式处理它们。框架会先对Map的输出进行排序,然后把结果输入给Reduce任务。通常作业的输入和输出

优秀的个人博客,低调大师

《软件需求工程(第2版)》一1.5 需求工程定义

1.5 需求工程定义 需求工程是指应用工程化的方法、技术和规格来开发和管理软件的需求。需求工程的目标就是要获取高质量的软件需求。与软件工程中传统的需求分析概念相比,需求工程突出了工程化的原则,强调以系统化、条理化、可重复化的方法和技术进行与软件需求相关的活动,从而有利于提高所有与软件需求相关的活动及其过程的可管理性,降低需求开发和管理的难度和成本。由于需求工程诞生的时间相对短暂,或者说它还是一个新兴的子学科,因此,对于需求工程来说,并不存在一个得到普遍承认的精确定义。许多不同的研究人员和组织依据各自的研究目的,分别从不同的侧面提出了各不相同但本质上近似的定义。例如Davis AM[13]把需求工程定义为“直到(但不包括)把软件分解为实际架构组建之前的所有活动”,即软件设计之前的一切活动。该定义虽然没有详细说明需求工程是什么,但给

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册