首页 文章 精选 留言 我的

精选列表

搜索[招聘下降],共10000篇文章
优秀的个人博客,低调大师

实习生招聘中 | Greptime & 开源之夏完美收官-感谢三位优秀学生!

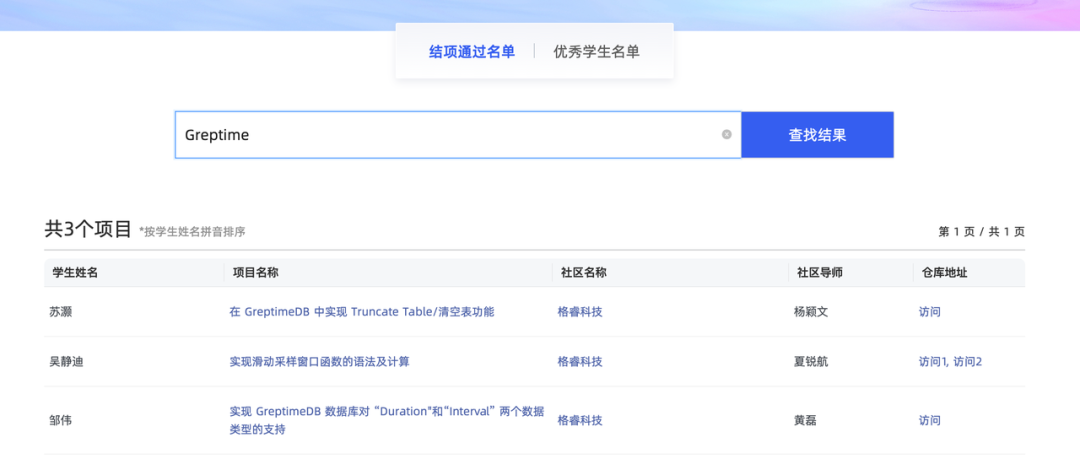
概述 “开源之夏”,是由 「中科院软件所」 “开源软件供应链点亮计划”发起并长期支持的一项暑期开源活动,一个专为在校学生量身打造的开源试炼盛宴。这一活动不仅激发了学生对开源项目的热爱,更培育了无数技术新星,为开源社区注入了活力。通过实践,参与者得以熟练掌握开源软件开发与维护的技术技巧,提前感受书面代码跳跃在生活中的感觉,切实体会代码实现的乐趣。 GreptimeDB 是一款用 Rust 编写的云原生、分布式、融合存储和分析的开源时序数据库,开发人员曾与诸如 OpenDAL、Apache Arrow 和 DataFusion 等优秀开源项目并肩作战,共同构建了一个坚实的技术栈,丰富了生态的同时,我们也希望回馈开源社区,开源之夏就是我们的启程之始。 项目介绍 GreptimeDB 选取了三个充满挑战的项目参与本年度的开源之夏,期待能和同学们碰撞出技术的火花。令人惊喜的是,同学们的热情和持之以恒让三个项目均圆满收官,也展示了大家作为未来技术新星的潜力和能力。 (开源之夏 & Greptime 项目展示) 项目一:实现 GreptimeDB 数据库对 Duration 和 Interval 两个数据类型的支持 🙇 描述:Duration 数据类型是度量特定类型的时间,可以用秒、毫秒、微秒或纳秒表示。Interval 数据类型通过计算两个时间点之间的天数来表示时间差异。这些数据类型在表示和建模真实世界的时序场景中非常有用。 🎓 认领同学:邹伟 📚 相关 Issue: https://github.com/GreptimeTeam/greptimedb/issues/1886 💡 相关 Pr: https://github.com/GreptimeTeam/greptimedb/pull/2265 https://github.com/GreptimeTeam/greptimedb/pull/2180 https://github.com/GreptimeTeam/greptimedb/pull/2146 https://github.com/GreptimeTeam/greptimedb/pull/2064 https://github.com/GreptimeTeam/greptimedb/pull/2117 https://github.com/GreptimeTeam/greptimedb/pull/1952 🌟 导师评价: 黄磊 邹伟同学在在开源之夏活动中为 Greptime 实现了 Interval 和 Duration 的数据类型,并编写了相关的运算函数。他的贡献极大地丰富了 GreptimeDB 的功能,使得它更加适用于时间数据的存储和处理,提升了用户的使用体验和数据处理的效率。尽管他之前缺乏开源项目的参与经验,但通过实现 Interval 和 Duration 数据类型及相关运算功能,展现了其快速学习和适应的能力,也证明了他在开源社区和软件开发方面的潜力和热情。 除了功能性的相关贡献,邹伟同学对于软件质量和可靠性的提升也做出了积极的努力。通过为 GreptimeDB 的 Interval 和 Duration 数据类型增加大量的测试用例,他进一步确保了新功能的稳定性,发现了不少历史遗留的 bug,也为未来可能出现的问题提供了回归测试的保障。这些贡献展现了他对于软件工程实践的深刻理解,特别是单元测试和代码维护性方面。 短短几个月,邹伟为 GreptimeDB 贡献的 PR 达 26 个,不仅完成了开源之夏的课题,也开始涉及到存储引擎等数据库内核模块,成长为 GreptimeDB 的核心开发者之一。 项目二:实现滑动采样窗口函数的语法及计算 🙇 描述:查询并聚合一个给定长度的时间范围的数据是时序数据常见的一种查询模式,例如 PromQL 中的 Range Selector,而 GreptimeDB 计划在 SQL 界面中实现类似的能力。与 WINDOW 语法不同,滑动采样窗口函数会按固定的步长及范围进行计算,例如:查询每日气温的周平均值;该查询的步长是一天(每日气温),每一次计算都使用过去一周的数据求平均。该项目需要从拓展 SQL Parser 开始,定义并实现滑动采样窗口函数的语法,并拓展逻辑计划器来实现相关语句的计划生成,最后实现对常见聚合算子的支持。 🎓认领同学:吴静迪 📚 相关 Issue: https://github.com/GreptimeTeam/greptimedb/issues/1662 💡 相关 Pr: https://github.com/GreptimeTeam/greptimedb/pull/2138 https://github.com/GreptimeTeam/greptimedb/pull/2229 https://github.com/GreptimeTeam/greptimedb/pull/2557 https://github.com/GreptimeTeam/greptimedb/pull/2664 https://github.com/GreptimeTeam/greptimedb/pull/2697 https://github.com/GreptimeTeam/greptimedb/pull/2770 https://github.com/GreptimeTeam/docs/pull/618 🌟 导师评价: 夏锐航 吴静迪同学在工作中完成了多项关键任务,给 GreptimeDB 的功能做出了重要贡献。在参与 Range 查询项目时,成功完成了从 parser 到算子的实现工作。也因为其在项目中的优秀表现,成为了 GreptimeDB 团队的实习生,在系统的自身可观测方面完成了大量工作,为 GreptimeDB 的稳定性和可靠性提供了保障。 项目三:在 GreptimeDB 中执行 TRUNCATE TABLE /清除表功能 🙇 描述:实现 GreptimeDB 的 TRUNCATE TABLE 功能;TRUNCATE TABLE从表中删除所有行。它类似于没有 WHERE 子句的 DELETE 语句,但比逐行删除更快。通过该功能的实现,提升 GreptimeDB 的性能。 🎓认领同学:苏灏 💡 相关 Pr: https://github.com/GreptimeTeam/greptimedb/pull/1932 https://github.com/GreptimeTeam/greptimedb/pull/2002 https://github.com/GreptimeTeam/greptimedb/pull/2090 https://github.com/GreptimeTeam/greptimedb/pull/2097 https://github.com/GreptimeTeam/greptimedb/pull/2335 https://github.com/GreptimeTeam/greptimedb/pull/2414 🌟 导师评价: 杨颖文 苏灏同学为 GreptimeDB 实现了 TRUNCATE TABLE 的功能。他的代码质量过关,可读性良好,符合社区规范。实现相关功能时也都编写了单元测试和 SQL 集成测试来保证代码的可靠性。期间,社区正在进行大规模重构和新存储引擎的开发,他也积极帮助社区将该功能移植到了新的引擎上,为社区分担了大量的工作。 总结 GreptimeDB 作为开源之夏的首次参与者,收获颇丰,我们的三个项目均圆满结项。每一个项目不仅是技术的挑战,更是团队合作与个人成长的见证。项目中的参与者逐渐作为实习生转化为团队的新鲜血液,我们希望通过开源之夏&Greptime 的项目平台帮助同学完成从校园理论到社会实践的平稳过渡,希望他们不仅学习开源文化,还能了解开源社区的运作方式。 一段代码,一次提交,一次测试,每一步都是成长的脚印。从功能实现到问题排查,每一个贡献都是价值的体现。在这个过程中,同学们不仅为 GreptimeDB 带来了新的功能,还提升了现有系统的稳定性与性能。他们的工作不仅限于解决眼前的问题,对未来挑战的预见也能做出同步的思考和准备。 不忘初心,方得始终。开源不仅是一门技术,更是一种精神。有人说,刷 LeetCode 可能是一种高效的面试准备,但参与到一个优秀的开源项目中,将你的代码贡献给全世界,无疑是更深层次的技术积累与职业磨练。 特别感谢开源之夏的组织方,感谢他们不仅为我们搭建了一个展示才华的舞台,更为开源社区注入了新的活力。 我们期待着在未来的日子里,能够继续与更多的优秀学生相遇。 期待明年的开源之夏,再次相会在代码的海洋。🌊 💃 我们招实习生啦!🏃 工作职责: 参与 GreptimeDB 设计和研发,包括但不限于存储引擎、查询引擎、分布式系统等; 负责相应模块的文档编写和维护; 其他研发和支持工作。 工作要求: 全日制本科及以上学历; 牢固掌握操作系统、数据结构和编译原理等计算机基础课程; 至少掌握和熟练使用一门编程语言,如 C/C++/Golang etc.; 有过数据库研发、 Rust 语言的学习和使用经验者优先; 参与过开源项目贡献者优先; 能实习三个月以上,每个月全职投入 15 天以上。 我们能提供: 有竞争力的实习待遇; 每月异地租房补贴(可 base 北京或杭州); 优秀同学可远程; 优秀的导师和自由开放的环境。 联系方式: xzhuang@greptime.com 关于 Greptime 的小知识: Greptime 格睿科技于 2022 年创立,目前正在完善和打造时序数据库 GreptimeDB,格睿云 GreptimeCloud 和可观测工具 GreptimeAI 这三款产品。 GreptimeDB 是一款用 Rust 语言编写的时序数据库,具有分布式、开源、云原生和兼容性强等特点,帮助企业实时读写、处理和分析时序数据的同时降低长期存储成本;GreptimeCloud 可以为用户提供全托管的 DBaaS 服务,能够与可观测性、物联网等领域高度结合;GreptimeAI 为 LLM 量身打造,提供成本、性能和生成过程的全链路监控。 GreptimeCloud 已正式公测,欢迎关注公众号或官网了解最新动态! 官网:https://greptime.cn/ GitHub: https://github.com/GreptimeTeam/greptimedb 文档:https://docs.greptime.cn/ Twitter: https://twitter.com/Greptime Slack: https://greptime.com/slack LinkedIn: https://www.linkedin.com/company/greptime/

优秀的个人博客,低调大师

阿里开发者招聘节 | 阿里巴巴数据技术及产品部诚招技术人才啦!

团队承担了阿里巴巴集团内的数据中台建设任务,现将多年实战积累下的经验通过云上环境对外输出至更多的政企业。2017年,出版的《大数据之路:阿里巴巴大数据实践》,书中总结了阿里巴巴数据中台多年的技术经验,为广大数据领域从业者提供了重要的实践指导。 2018年,我们又推出了智能数据构建与管理平台Dataphin —— 从数据接入到数据消费全链路,提供一站式的大数据能力,助力企业打造标准统一、融会贯通、资产化、服务化、闭环自优化的智能数据体系。 云上数据中台,未来无限可能,我们需要以下岗位: 实时大数据研发工程师• 职位描述:基于flink开源大数据计算平台,在阿里集团整体业务场景下 研发实时流计算数据研发平台,支持包括核心电商、云计算、大文娱、创新业务在内的等各个综合业务板块务 研发实时OLAP(ElasticSearch,Druid)赋能

优秀的个人博客,低调大师

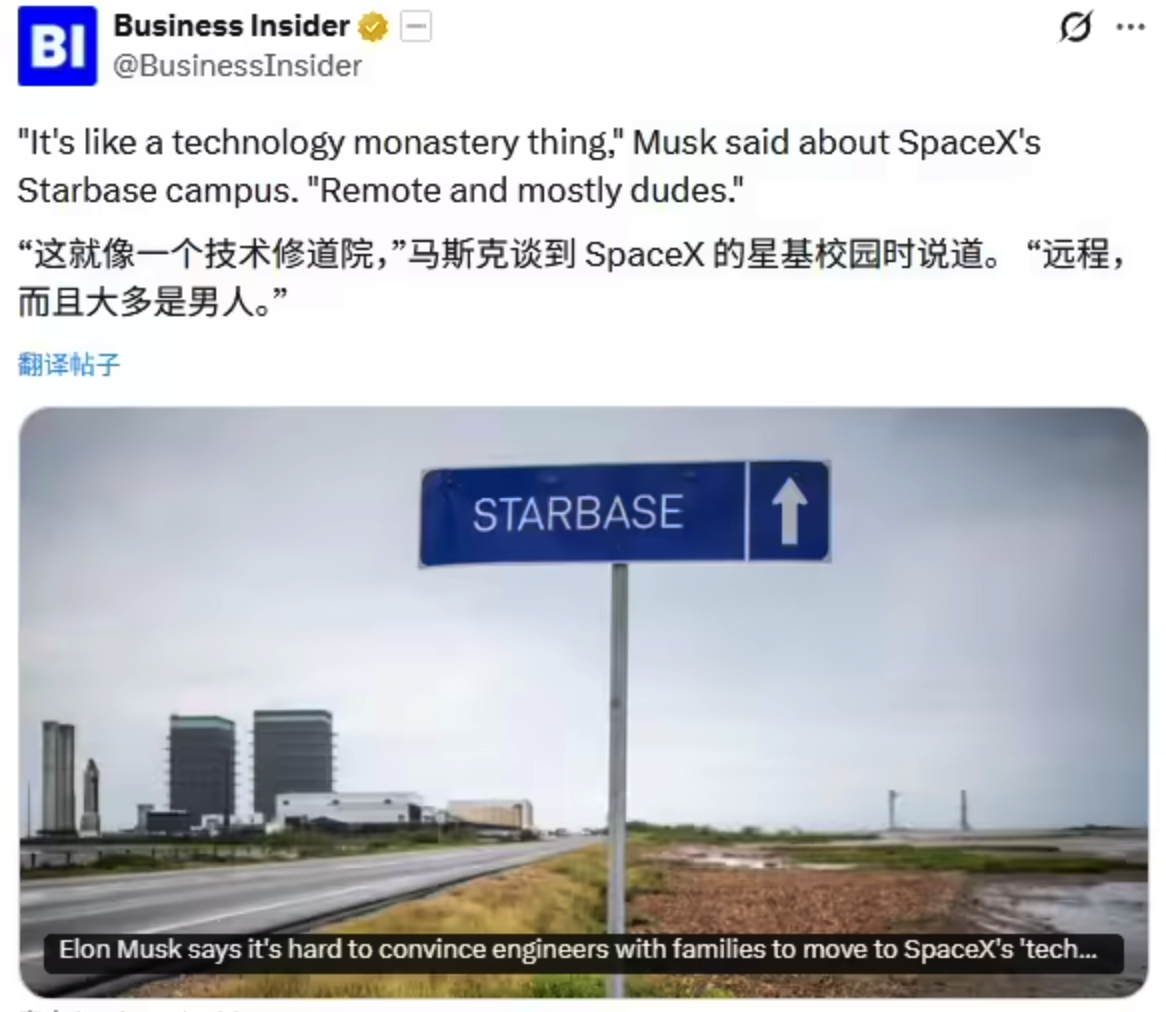
马斯克:SpaceX 招聘遇到挑战,吸引工程师搬迁至“技术修道院”不容易

SpaceX 创始人兼 CEO 马斯克最近表示,将公司的总部和主要研发力量从加利福尼亚迁往德州南部的 Starbase(太空港)后,吸引工程师及技术人员搬迁成为难题。他在访谈中将这种工作环境形象地描述为“技术修道院”。 据了解,Starbase 位于美墨边境附近、靠近 Brownsville 的南德州地区,与加州相比属于人口稀少区,附近非 SpaceX 的工作机会极少。马斯克称,这导致一些有家庭的工程师很难说服配偶一起搬家。 马斯克将这个现象称作“另一半问题”(significant other problem):很多技术人才不愿意搬到不会为其伴侣提供职业发展的地方。 虽然马斯克同样提到特斯拉在搬迁总部至奥斯汀后也面临类似挑战,但相比之下特斯拉在奥斯汀的环境更成熟、更有就业机会,因此招募难度没有 SpaceX 那么大。 特斯拉得州超级工厂距离奥斯汀市中心约 30 分钟车程,而奥斯汀人口接近 100 万。此外,尽管特斯拉高管大多已搬到得州,但公司仍在加州保留多个机器人、能源和制造业务部门。 马斯克表示,由于特斯拉的工程团队仍主要在硅谷,员工的生活变化相对较小,“通勤也差不多”,并称特斯拉工程团队多数仍在加州。 值得一提的是,马斯克曾预测奥斯汀将成为“美国 50 年来最大的繁荣城镇”。同时,他也在推动扩展公司园区建设,包括在 The Boring Company 与 SpaceX 附近规划名为“Snailbrook”的公司小镇。

优秀的个人博客,低调大师

阿里开发者招聘节 | 蚂蚁金服平台前端技术部诚招技术人才啦!

蚂蚁金服平台前端技术部,隶属于蚂蚁金服 CTO 线 - 平台数据技术事业群 - 体验技术部,是蚂蚁金服乃至阿里经济体内最专业的前端团队之一,大部门由前端大神玉伯 带领,而团队则是由可视化领域专家林峰 负责。 不同于一般的技术团队,平台前端技术部是一支基础技术与业务支持并重的团队,既有扎实过硬的技术底盘,又服务于蚂蚁金服多个核心、拳头业务。对外,我们 owner 了 Ant Design、AntV、UmiJS 等多个重量级的开源框架;对内,我们直接承担了蚂蚁金融科技大部分核心产品的前端研发工作,从分布式关系数据库、中间件、图计算到商业智能、机器学习和区块链应用等等,产品覆盖底层基础核心技术产品、金融核心应用到前沿科技探索,背后关系着未来全球 20 亿用户的金融、民生应用能力与体验。 目前平台前端技术部大部队集中在杭州,上海、成都、北京也

优秀的个人博客,低调大师

阿里开发者招聘节 | 2019阿里巴巴技术面试题集锦!参考答案已公布!

为帮助开发者们提升面试技能、有机会入职阿里,云栖社区特别制作了这个专辑——阿里巴巴资深技术专家们结合多年的工作、面试经验总结提炼而成的面试真题这一次整体放出。并通过这些笔试真题开放阿里巴巴工作机会,让更多的开发者加入到阿里这个大平台。 面试题官方参考答案统一汇总分享,点此进入下载查看参考答案! 这一次,不仅是知识的收获,还将间接地与技术大牛们做了直观的沟通,了解他们的出题思路与考察要点,并加以消化吸收,这对自己技术能力本身就是一种极大的提升。走上编程之路,不断丰富自己方能与世接轨,努力做最优秀的自己。 28.请评估一下程序的执行结果? public class SynchronousQueueQuiz { public static void main(String[] args) throws Exception {

优秀的个人博客,低调大师

消防隐患同比下降约60%,基于物联网大数据的智慧消防水系统远程监测方案

近十年全国共发生高层建筑火灾3.1万起,死亡474人,直接财产损失15.6亿元。其中,特别重大火灾3起、重大火灾4起、较大火灾24起,形势非常严峻。消防给水系统完善与否直接影响火灾扑救的效果,据火灾统计,在扑救成功的火灾案例中,93%的火场消防给水条件较好,水量、水压有保障;而在扑救失利的火灾案例中,81.5%的火场消防供水不足。许多大火失去控制,造成严重后果,大多与消防给水系统不完善、火场缺水有密切关系。国家层面正在全面推进“智慧消防”建设的指导意见公消〔2017〕297号建设城市物联网消防远程监控系统,打造城市消防远程监控系统“升级版”, 监测室内消火栓和自动喷淋系统水压、高位消防水箱和消防水池水位等也说明了城市消防栓智能化监管的迫切需求。 基于此背景,陕西拓普索尔电子科技有限责任公司研发的基于物联网大数据的智慧消防水系统远程监

优秀的个人博客,低调大师

用Python爬取了拉勾网的招聘信息+详细教程+趣味学习+快速爬虫入门+学习交流+大神+爬虫入门

关于 一直埋头学习,不知当前趋势,这是学习一门技术过程中最大的忌讳。刚好利用python爬虫,抓取一下拉勾网关于python职位的一些基本要求,不仅能知道岗位的基本技能要求,还能锻炼一下代码能力,学以致用,一举两得。 准备 工具 :python 2.7,PyCharm 类库:urllib2、BeautifulSoup、time、re、sys、json、collections、xlsxwriter 分析及代码实现 进入拉勾网进行分析,要想获取每个岗位的关键词,首先要知道每个岗位详情页面的url,通过对比我们发现,https://www.lagou.com/jobs/4289433.html中,只有4289433这一串数字是不同的,那么就可以知道我们只要获取到每个岗位的这一串数字,我们就可以爬取每个岗位详情页面。 通过F12查看,我们可以看到xhr请求中https://www.lagou.com/jobs/positionAjax.json?px=default&city=%E5%8C%97%E4%BA%AC&needAddtionalResult=false的响应消息里的参数positionId的值为详情页面url的那串数字,如下图 ,那么接下来我们就爬取这个请求来获取所有的positionId。 首先我们通过分析可以看到这是个post请求且form的参数为first、pn、kd,通过不同岗位列表页面的请求,我们可以看到first的取值逻辑是pn为1的时候,first为true,当pn不为1的时候,first的取值为false(其中pn为岗位列表的页数),还有kd为一个固定值(这里是python) def get_positionId(pn): positionId_list = [] url = 'https://www.lagou.com/jobs/positionAjax.json?px=default&city=%E5%8C%97%E4%BA%AC&needAddtionalResult=false' headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.115 Safari/537.36', 'Referer': 'https://www.lagou.com/jobs/list_Python?px=default&city=%E5%8C%97%E4%BA%AC' } if pn == 1: first = 'true' else: first = 'false' data = {'first': first, 'pn': pn, 'kd':kd #这里取变量值,可以获取不同岗位的关键词 } page = get_page(url, headers, data) if page == None: return None max_pageNum = get_pageSize(page) result = page['content']['positionResult']['result'] for num in range(0, max_pageNum): positionId = result[num]['positionId'] positionId_list.append(positionId) return positionId_list #该函数返回一个列表页的所有岗位的positionId 在获取到每个岗位的positionId后,我们就可以根据获取到的positionId进行拼接得到每个岗位详情页面的url,然后爬取这些url,来获取每个岗位的关键词(这里还有一个比较坑人的地方就是通过爬取来的网页内容和通过定位得到的内容竟然是不一样的,害的我纠结了好久),分析该网页如下图: 具体的实现如下: #获取每个岗位的职位要求def get_content(positionId): url = 'https://www.lagou.com/jobs/%s.html' %(positionId) headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.115 Safari/537.36', 'Referer': 'https://www.lagou.com/jobs/list_Python?px=default&city=%E5%8C%97%E4%BA%AC' } page = get_page(url,headers,data=0) soup = Bs(page, 'html.parser') content = soup.find('dd', class_='job_bt').get_text() return content 接下来就是对获取到的岗位描述进行过滤处理,来获取英文关键词,实现如下: #对获取的关键词列表进行过滤去重,获取top50的关键词#处理岗位描述,获取英文关键词def get_keyword(content): pattern = re.compile('[a-zA-Z]+') keyword = pattern.findall(content) return keyword 然后,在通过collections中的Counter模块获取到这些英文关键词中的top50,实现如下: #对获取的关键词列表进行过滤去重,获取top50的关键词def parser_keyword(keyword_list): for i in range(len(keyword_list)): keyword_list[i] = keyword_list[i].lower() keyword_top = Counter(keyword_list).most_common(50) return keyword_top 最后把top50的关键词保存到Excel中,并且生成分析图,实现如下: #数据保存到Excel中,并且生成报表。def save_excel(keyword_top): row = 1 col = 0 workbook = xlsxwriter.Workbook('lagou.xlsx') worksheet = workbook.add_worksheet('lagou') worksheet.write(0, col, u'关键词') worksheet.write(0, col+1, u'频次') for name, num in keyword_top: worksheet.write(row, col, name) worksheet.write(row, col+1, num) row += 1 chart = workbook.add_chart({'type': 'area'}) chart.add_series({ 'categories': 'lagou!$A$2:$A$51', 'values': 'lagou!$B$2:$B$51' }) chart.set_title({'name': u'关键词排名'}) chart.set_x_axis({'name': u'关键词'}) chart.set_y_axis({'name': u'频次(/次)'}) worksheet.insert_chart('C2', chart, {'x_offset':15, 'y_offset':10}) workbook.close() 结果 具体生成的分析图如下: image.png 如果对您有点帮助的话,麻烦您给点个赞,谢谢。 最后附上全部的代码: 大家如果有问题都可以评论区留言,另外如果需要一个学习交流的平台可以加小编的群:719+139+688,群里面有很多学习资料还有大神的直播分享,希望对大家有所帮助,另外在这个上面我回复可能稍微慢一点,但是你们有问题在评论区留言我都会帮你们解决的。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册