首页 文章 精选 留言 我的

精选列表

搜索[性能改进],共10000篇文章
优秀的个人博客,低调大师

微软解释机器学习如何改进 Windows 10 更新体验

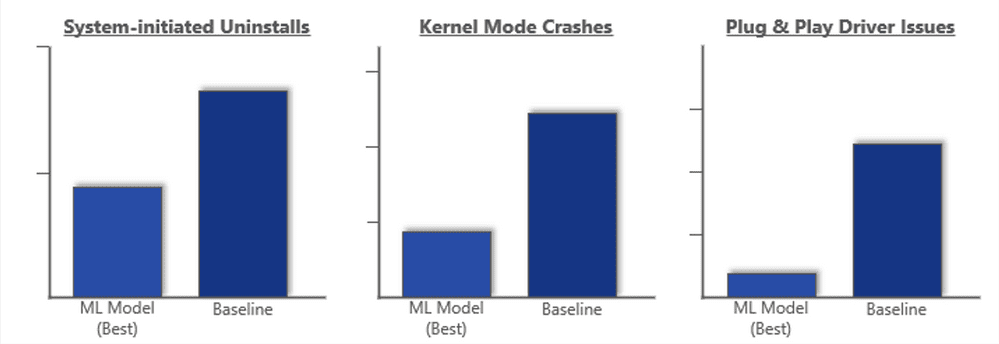
微软在 2018年 4月Windows更新时第一次大规模使用机器学习(ML),ML 通过监测PC运行状况的六个核心领域(例如总体可靠性),以确定功能更新过程是否顺利进行。而在 2019 年 5 月发布的更新推送中,这是微软使用 ML 的第三次迭代,可评估的领域增加到了 35 个,微软计划在未来的更新中进一步扩大覆盖范围。 微软表示,使用 ML 来部署更新拥有更好的更新体验,例如下图,通过 ML 更新后系统启动的卸载数量不到一半、内核崩溃的数量减少一半,以及更新后的驱动程序问题的数量减少了五倍。 微软是如何设计和构建支持 Windows 10 更新的机器学习模型 最近,微软发布博文介绍了这一技术信息。微软使用的是一个经过动态训练的模型,它通过在最新更新的 PC机上训练,有区分好的和坏的更新体验的能力。下图是一个详尽的机器学习图,展示了机器学习算法的整体框架。 每个 Windows 10 更新版本都先推给早期使用者(比如 Windows 内部人员和主动寻求更新的人)。有了这些体验者,微软开发人员就可以通过诊断数据(例如内核模式崩溃、异常关闭和驱动程序问题)来监控他们的更新体验。 机器学习在其中提供了两个关键功能: 它确定了一些有安全隐患的问题,从而可以及时采取措施保护尚未更新的 PC,以便 Windows 开发人员能够及时调查和解决这些问题 它预测和发现那些可以顺利进行更新的PC,从而提供更新 每天都重复这样一个过程,使模型不断地从最近更新的 PC 机中获得学习。然后随着时间的推移和不断解决问题,相比之下,过去那些更新了的 PC就又有了缺陷,而现在学习到的更好的经验就会重新对他们进行更新。 微软使用Azure Databricks构建 ML 模型,评估那些准备升级的 PC(准备数据,创建单个模型,并计算出分数): 微软表示,ML 驱动的推出过程中,一个关键因素就是具有能够及早发现兼容性问题的能力,使他们能够建立保护措施,以保护其他的PC不进行本次的更新。而以往来说,兼容性问题是通过实验室艰苦测试、反馈和其他渠道检测到的。虽然这些手段仍在使用,但在微软复杂的生态系统中,将 ML 应用到PC 的诊断数据,将使微软能够更快识别与任何更新相关的兼容性信息,如硬件特性、驱动程序、应用程序等方面。 为了发现兼容性问题,他们使用异常检测,以发现某些特征或模式在什么时候导致的故障率会比整体的预期高。通过使用 Azure Databricks,就可以快速扩展到数百万台 PC,并建立保护措施,以防止 PC 被更新相关的潜在问题干扰。下图显示了某个功能或模式的失败率为 82%,而基准失败率约为 3%。从而确定需要保护的位置,以防止其他 PC 遇到类似问题: 微软表示,目前的机器学习方案还不够完善,接下来会进一步发展 ML,以确保 ML 是全面的、更自动化的和灵活的,能够在几秒钟内而不是几个小时内解决问题。 参考:https://www.ithome.com/0/447/862.htm

优秀的个人博客,低调大师

深度剖析阿里巴巴对Apache Flink的优化与改进

本文主要从两个层面深度剖析:阿里巴巴对Flink究竟做了哪些优化? 取之开源,用之开源 一、SQL层 为了能够真正做到用户根据自己的业务逻辑开发一套代码,能够同时运行在多种不同的场景,Flink首先需要给用户提供一个统一的API。在经过一番调研之后,阿里巴巴实时计算认为SQL是一个非常适合的选择。在批处理领域,SQL已经经历了几十年的考验,是公认的经典。在流计算领域,近年来也不断有流表二象性、流是表的ChangeLog等理论出现。在这些理论基础之上,阿里巴巴提出了动态表的概念,使得流计算也可以像批处理一样使用SQL来描述,并且逻辑等价。这样一来,用户就可以使用SQL来描述自己的业务逻辑,相同的查询语句在执行时可以是一个批处理任务,也可以是一个高吞吐低延迟的流计算任务,甚至是先使用批处理技术进行历史数据的计算,然后自动的转成流计算任务处理

优秀的个人博客,低调大师

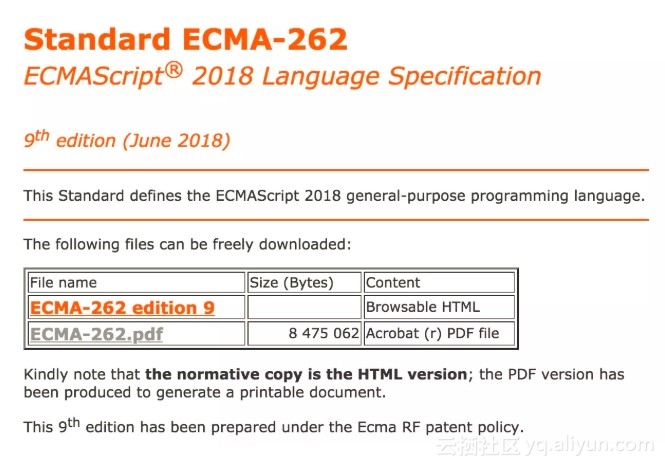
ECMAScript 2018 语言规范正式发布,改进正则表达式

ECMAScript 2018(第九版 JS)已于 6 月底正式发布,带来了许多新特性。ECMAScript 2018于今年2月出炉草案,TC39技术委员会每两个月开会一次,讨论当前草案的现状。 ECMAScript 2018 主要包含内容: 异步迭代器:原生支持在 JavaScript 中对异步获取的数据做迭代。 ObjectRest/Spread Properties Promise.prototype.finally Template Literal(模板字面量):取消Escape-Sequenzen 限制 正则表达式: 支持s (dotAll)模式 Unicode 属性转义(Property Escape) 支持后行断言(Lookbehind Assertions) 命名捕获组(named capture group) ECMAScript 2018 规范 PDF 地址: www.ecma-international.org/publication… 原文发布时间为:2018年07月03日 原文作者: 掘金 本文来源: 掘金 如需转载请联系原作者

优秀的个人博客,低调大师

Hadoop WordCount改进实现正确识别单词以及词频降序排序

0.参考资料: http://radarradar.javaeye.com/blog/289257 http://blog.chinaunix.net/u3/99156/showart_2157576.html 1.思路: 1.1过滤 MapReduce的第一操作就是要读取文件,不过我们经常会发现一个文本中会有一些我们不需要的字符,比如特殊字符。一般需要进行词频统计的都是单词或者是数字,所以那些非0-9,a-z,A-Z的字符基本都是垃圾字符,我们需要进行统计,这是我们可以通过一个正则表达式来进行过滤,当每次多去一行文字的时候,我们将所有非0-9,a-z,A-Z的垃圾字符都替换为空格,这样就清楚了垃圾字符。在我们最后的词频统计结果中,就不会出现这些特殊字符了。 1.2降序 定义一个用户排序比较的静态内部类,通过这个类来控制词频统计最后的排序结果。我们这里所使用的静态内部类是IntWritableDecreasingComparator。需要注意的是必须在main函数中主动声明使用这个比较器。 2.代码实例 package org.apache.hadoop.examples; import java.io.IOException; import java.util.Random; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.io.WritableComparable; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.input.SequenceFileInputFormat; import org.apache.hadoop.mapreduce.lib.map.InverseMapper; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.mapreduce.lib.output.SequenceFileOutputFormat; import org.apache.hadoop.util.GenericOptionsParser; public class WordCount2 { public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable> { private final static IntWritable one = new IntWritable(1); private Text word = new Text(); private String pattern = "[^//w]"; // 正则表达式,代表不是0-9, a-z, A-Z的所有其它字符,其中还有下划线 public void map(Object key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString().toLowerCase(); // 全部转为小写字母 line = line.replaceAll(pattern, " "); // 将非0-9, a-z, A-Z的字符替换为空格 StringTokenizer itr = new StringTokenizer(line); while (itr.hasMoreTokens()) { word.set(itr.nextToken()); context.write(word, one); } } } public static class IntSumReducer extends Reducer<Text, IntWritable, Text, IntWritable> { private IntWritable result = new IntWritable(); public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException { int sum = 0; for (IntWritable val : values) { sum += val.get(); } result.set(sum); context.write(key, result); } } private static class IntWritableDecreasingComparator extends IntWritable.Comparator { public int compare(WritableComparable a, WritableComparable b) { return -super.compare(a, b); } public int compare(byte[] b1, int s1, int l1, byte[] b2, int s2, int l2) { return -super.compare(b1, s1, l1, b2, s2, l2); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); String[] otherArgs = new GenericOptionsParser(conf, args) .getRemainingArgs(); if (otherArgs.length != 2) { System.err.println("Usage: wordcount <in> <out>"); System.exit(2); } Path tempDir = new Path("wordcount-temp-" + Integer.toString( new Random().nextInt(Integer.MAX_VALUE))); //定义一个临时目录 Job job = new Job(conf, "word count"); job.setJarByClass(WordCount2.class); try{ job.setMapperClass(TokenizerMapper.class); job.setCombinerClass(IntSumReducer.class); job.setReducerClass(IntSumReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(IntWritable.class); FileInputFormat.addInputPath(job, new Path(otherArgs[0])); FileOutputFormat.setOutputPath(job, tempDir);//先将词频统计任务的输出结果写到临时目 //录中, 下一个排序任务以临时目录为输入目录。 job.setOutputFormatClass(SequenceFileOutputFormat.class); if(job.waitForCompletion(true)) { Job sortJob = new Job(conf, "sort"); sortJob.setJarByClass(WordCount2.class); FileInputFormat.addInputPath(sortJob, tempDir); sortJob.setInputFormatClass(SequenceFileInputFormat.class); /*InverseMapper由hadoop库提供,作用是实现map()之后的数据对的key和value交换*/ sortJob.setMapperClass(InverseMapper.class); /*将 Reducer 的个数限定为1, 最终输出的结果文件就是一个。*/ sortJob.setNumReduceTasks(1); FileOutputFormat.setOutputPath(sortJob, new Path(otherArgs[1])); sortJob.setOutputKeyClass(IntWritable.class); sortJob.setOutputValueClass(Text.class); /*Hadoop 默认对 IntWritable 按升序排序,而我们需要的是按降序排列。 * 因此我们实现了一个 IntWritableDecreasingComparator 类, * 并指定使用这个自定义的 Comparator 类对输出结果中的 key (词频)进行排序*/ sortJob.setSortComparatorClass(IntWritableDecreasingComparator.class); System.exit(sortJob.waitForCompletion(true) ? 0 : 1); } }finally{ FileSystem.get(conf).deleteOnExit(tempDir); } } } 本文转自xwdreamer博客园博客,原文链接:http://www.cnblogs.com/xwdreamer/archive/2011/01/07/2297044.html,如需转载请自行联系原作者
优秀的个人博客,低调大师

谷歌收购深度搜索引擎Kifi 改进群聊应用Spaces

谷歌群聊应用Spaces 北京时间7月13日消息,据科技博客TechCrunch报道,谷歌实施了一笔小型收购交易,继续加大在社交应用领域的努力。 谷歌已经收购了创业公司Kifi背后的团队,后者开发扩展程序来收集和搜索社交应用中的链接,并进一步推荐链接,例如推文链接保存工具Kifi for Twitter。 这笔收购交易的财务条款并未披露,但是谷歌工程总监爱德·凯斯勒(Eddie Kessler)表示,Kifi团队将加入谷歌,开发群聊应用Spaces。谷歌拒绝披露到底有多少Kifi员工加入公司。 Spaces似乎确实需要Kifi的帮助。该应用在今年初推出,但是目前为止市场反应平平。应用分析公司App Annie的统计数据显示,Spaces目前在美国iOS应用商店的排名约为577位,在Android应用商店的排名为284位。 这实际上是一笔人才收购交易。Kifi称,其应用不会归属于谷歌,但只会继续运营几周时间,在这之后为用户提供几周时间导出数据。 目前为止,谷歌披露的收购交易接近200笔,其中为了增加社交和应用人才储备收购的公司包括新加坡职场聊天应用Pie、巴黎图像识别公司Moodstocks。 Kifi已经完成了逾1100万美元融资,投资者包括风投公司Wicklow Capital、SGVC等。 ====================================分割线================================ 本文转自d1net(转载)

优秀的个人博客,低调大师

Java性能调优:利用VisualVM进行性能分析

来源:https://www.cnblogs.com/xifengxiaoma/p/9402497.html作者:朝雨忆轻尘 ❞ JVisualVM 简介 VisualVM 是Netbeans的profile子项目,已在JDK6.0 update 7 中自带,能够监控线程,内存情况,查看方法的CPU时间和内存中的对 象,已被GC的对象,反向查看分配的堆栈(如100个String对象分别由哪几个对象分配出来的)。在JDK_HOME/bin(默认是C:\Program Files\Java\jdk1.6.0_13\bin)目录下面,有一个jvisualvm.exe文件,双击打开,从UI上来看,这个软件是基于NetBeans开发的了。 VisualVM 提供了一个可视界面,用于查看 Java 虚拟机 (Java Virtual Machine, JVM) 上运行的基于 Java 技术的应用程序的详细信息。VisualVM 对 Java Development Kit (JDK) 工具所检索的 JVM 软件相关数据进行组织,并通过一种使您可以快速查看有关多个 Java 应用程序的数据的方式提供该信息。您可以查看本地应用程序或远程主机上运行的应用程序的相关数据。此外,还可以捕获有关 JVM 软件实例的数据,并将该数据保存到本地系统,以供后期查看或与其他用户共享。 双击启动 jvisualvm.exe,启动起来后和jconsole 一样同样可以选择本地和远程,如果需要监控远程同样需要配置相关参数。 主界面如下: VisualVM可以根据需要安装不同的插件,每个插件的关注点都不同,有的主要监控GC,有的主要监控内存,有的监控线程等。 如何安装: 从主菜单中选择“工具”>“插件”。 在“可用插件”标签中,选中该插件的“安装”复选框。单击“安装”。 逐步完成插件安装程序。 我这里以 Eclipse(pid 22296)为例,双击后直接展开,主界面展示了系统和jvm两大块内容,点击右下方jvm参数和系统属性可以参考详细的参数信息. 因为VisualVM的插件太多,我这里主要介绍三个我主要使用几个:监控、线程、Visual GC 监控的主页其实也就是,cpu、内存、类、线程的图表 线程和jconsole功能没有太大的区别 Visual GC 是常常使用的一个功能,可以明显的看到年轻代、老年代的内存变化,以及gc频率、gc的时间等。 以上的功能其实jconsole几乎也有,VisualVM更全面更直观一些,另外VisualVM非常多的其它功能,可以分析dump的内存快照,dump出来的线程快照并且进行分析等,还有其它很多的插件大家可以去探索 案例分析 准备模拟内存泄漏样例 定义静态变量HashMap 分段循环创建对象,并加入HashMap importjava.util.HashMap;importjava.util.Map;publicclassCyclicDependencies{//声明缓存对象privatestaticfinalMapmap=newHashMap();publicstaticvoidmain(Stringargs[]){try{Thread.sleep(10000);//给打开visualvm时间}catch(InterruptedExceptione){e.printStackTrace();}//循环添加对象到缓存for(inti=0;i<1000000;i++){TestMemoryt=newTestMemory();map.put("key"+i,t);}System.out.println("first");//为dump出堆提供时间try{Thread.sleep(10000);}catch(InterruptedExceptione){e.printStackTrace();}for(inti=0;i<1000000;i++){TestMemoryt=newTestMemory();map.put("key"+i,t);}System.out.println("second");try{Thread.sleep(10000);}catch(InterruptedExceptione){e.printStackTrace();}for(inti=0;i<3000000;i++){TestMemoryt=newTestMemory();map.put("key"+i,t);}System.out.println("third");try{Thread.sleep(10000);}catch(InterruptedExceptione){e.printStackTrace();}for(inti=0;i<4000000;i++){TestMemoryt=newTestMemory();map.put("key"+i,t);}System.out.println("forth");try{Thread.sleep(Integer.MAX_VALUE);}catch(InterruptedExceptione){e.printStackTrace();}System.out.println("qqqq");}} 配置jvm参数如下: -Xms512m -Xmx512m -XX:-UseGCOverheadLimit -XX:MaxPermSize=50m 运行程序并打卡visualvm监控 使用JVisualVM分析内存泄漏 查看Visual GC标签,内容如下,这是输出first的截图 这是输出forth的截图: 通过2张图对比发现: 老生代一直在gc,当程序继续运行可以发现老生代gc还在继续: 增加到了7次,但是老生代的内存并没有减少。说明存在无法被回收的对象,可能是内存泄漏了。 如何分析是那个对象泄漏了呢? 打开抽样器标签:点击后如下图: 按照程序输出进行堆dump,当输出second时,dump一次,当输出forth时dump一次。 进入最后dump出来的堆标签,点击类: 比较结果如下: 可以看出在两次间隔时间内TestMemory对象实例一直在增加并且多了,说明该对象引用的方法可能存在内存泄漏。 如何查看对象引用关系呢? 右键选择类TestMemory,选择“在实例视图中显示”,如下所示: 左侧是创建的实例总数,右侧上部为该实例的结构,下面为引用说明,从图中可以看出在类CyclicDependencies里面被引用了,并且被HashMap引用。 如此可以确定泄漏的位置,进而根据实际情况进行分析解决。 JVisualVM 远程监控 Tomcat 修改远程tomcat的catalina.sh配置文件,在其中增加: JAVA_OPTS="$JAVA_OPTS-Djava.rmi.server.hostname=192.168.122.128-Dcom.sun.management.jmxremote.port=18999-Dcom.sun.management.jmxremote.ssl=false-Dcom.sun.management.jmxremote.authenticate=false" 打开jvisualvm,右键远程,选择添加远程主机: 输入主机的名称,直接写ip,如下: 右键新建的主机,选择添加JMX连接,输入在tomcat中配置的端口即可。 双击打开。完毕! 参考资料 https://blog.csdn.net/kl28978113/article/details/53817827 https://www.cnblogs.com/ityouknow/p/6437037.html 如果本文对你有帮助, 别忘记给我个三连: 点赞,转发,评论 。 咱们下期见! 收藏等于白嫖,点赞才是真情! End 干货分享 这里为大家准备了一份小小的礼物,关注公众号,输入如下代码,即可获得百度网盘地址,无套路领取!001:《程序员必读书籍》002:《从无到有搭建中小型互联网公司后台服务架构与运维架构》003:《互联网企业高并发解决方案》004:《互联网架构教学视频》006:《SpringBoot实现点餐系统》007:《SpringSecurity实战视频》008:《Hadoop实战教学视频》009:《腾讯2019Techo开发者大会PPT》 010:微信交流群 近期热文top 1、关于JWT Token 自动续期的解决方案 2、还不了解ETL,看看这篇文章? 3、为什么微服务需要api网关 4、架构师之路-微服务技术选型 5、RocketMQ进阶-事务消息 我就知道你“在看” 本文分享自微信公众号 - JAVA日知录(javadaily)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册