首页 文章 精选 留言 我的

精选列表

搜索[python],共10000篇文章
优秀的个人博客,低调大师

基于bs4+requests的python爬虫伪装

要导入fake-useragent库,需要先用pip安装,安装命令:pip install fake-useragentparams是爬虫伪装的参数,数据类型为字典dict,里面有2个键值对,2个键:headers、proxies。headers的数据类型是字典,里面有1个键值对,键User-Agent对应的值数据类型为字符串,User-Agent中文翻译是用户代理。proxies的数据类型是字典,里面有1个键值对,键http对应的值数据类型为字符串,是代理服务器的url。 匿名ip主要是从66ip.cn网站获取。 import requests from bs4 import BeautifulSoup as bs from fake_useragent import UserAgent import random def getSoup(url,encoding="utf-8",**params): print(params) reponse = requests.get(url,**params) reponse.encoding = encoding soup = bs(reponse.text,'lxml') return soup def cssFind(movie,cssSelector,nth=1): if len(movie.select(cssSelector)) >= nth: return movie.select(cssSelector)[nth-1].text.strip() else: return '' def getProxyList(): proxies_url_before = "http://www.66ip.cn/areaindex_2/{}.html" proxies_url = proxies_url_before.format(random.randint(1,10)) soup = getSoup(proxies_url) item_list = soup.select("table tr")[2:] proxies_list = [] for item in item_list: ipAddress = cssFind(item, "td") ipPort = cssFind(item, "td", 2) proxies_list.append("http://{}:{}".format(ipAddress, ipPort)) return proxies_list def getParams(): ua = UserAgent() ip_list = getProxyList() params = dict( headers = {'User-Agent': ua.random}, proxies = {'http': random.choice(ip_list)} ) return params if __name__ == "__main__": params = getParams() soup = getSoup("https://movie.douban.com/top250?start=50",**params)

优秀的个人博客,低调大师

Python-网页转义字符及正则全文匹配

前言 大部分情况下,通过request去请求网页,response.text返回来的都是正常值,但是有一些反爬虫比较严重的网站(比如知乎)就不会是这样。知乎会返回转义字符,例如: header = { "User-Agent":"Mozilla/5.0 (X11; Linux x86_64; rv:57.0) Gecko/20100101 Firefox/57.0", "HOST":"www.zhihu.com", "Referer":"https://www.zhihu.com/signup?next=%2F", } def rget(): response = session.get("https://www.zhihu.com/signup?next=%2F", headers=header) target_str = response.text print(target_str) rget() 在给知乎的登录页面发请求后,打印返回结果(内容太多,只返回一小部分): &quot;token&quot;:{&quot;xsrf&quot;:&quot;9b6c6406-db1b-45fa-8626-296c037cfc00&quot;,&quot;xUDID&quot;:&quot;ANBsasFlAg2PTgaqB1CHBtsWMijmJ20s89E=&quot;},&quot;account&quot;:{&quot;lockLevel&quot;:{} 发现有很多字符是转义的,登录需要用到的xsrf字段也在这里面,这样做正则匹配就很麻烦。 解决的办法是将html进行转义: import html target_str = html.unescape(response.text) 就能够得到正常的返回信息了: "token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="}, 正则匹配 匹配xsrf的值 (为了方便测试,只将一小部分值提取出来做匹配): tokens = '"token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="},:' matchs = re.search(r'xsrf[:"\w-]+', tokens) if matchs: print(matchs.group(0)) else: print("未匹配") 得到输出结果为: xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920" 然后再借用replace将引号替换,然后用split将值用冒号分开: import re tokens = '"token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="},:' matchs = re.search(r'xsrf[:"\w-]+', tokens) nstr = matchs.group(0).replace("\"", "").split(":") finall = nstr[1] print(finall) 就得到了我需要的xsrf: 9febf0fd-7c47-4695-93b6-f670e518d920 xUDID的提取也是如此,这两个值在知乎登录的时候是需要携带的,所以要提取: import re tokens = '"token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="},:' matchs = re.search(r'xUDID[:"\w-]+=', tokens) nstr = matchs.group(0).replace("\"", "").split(":") finall = nstr[1] print(finall) ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc= re正则匹配html的坑 上面的正则可以匹配到字符串了,如果正常登录的话要将请求返回的内容文本进行匹配的,也就是匹配response.text,代码是否就是 matchs = re.search(r'xUDID[:"\w-]+=', response.text) 坑就在这里! re默认匹配的是单行字符串,而response.text的返回值虽然是一个html页面的构成,但是它是分行的,第一行是html头<! DOCUMENT html>不是我想要的整个文本进行匹配。 re是支持整个文本匹配的,需要在正则代码加上参数re.DOTALL即可: matchs = re.search(r'xUDID[:"\w-]+=', response.text, re.DOTALL) 就可以对整个返回的文本进行匹配了

优秀的个人博客,低调大师

Python抓取分析“创造101 ”菊姐微博

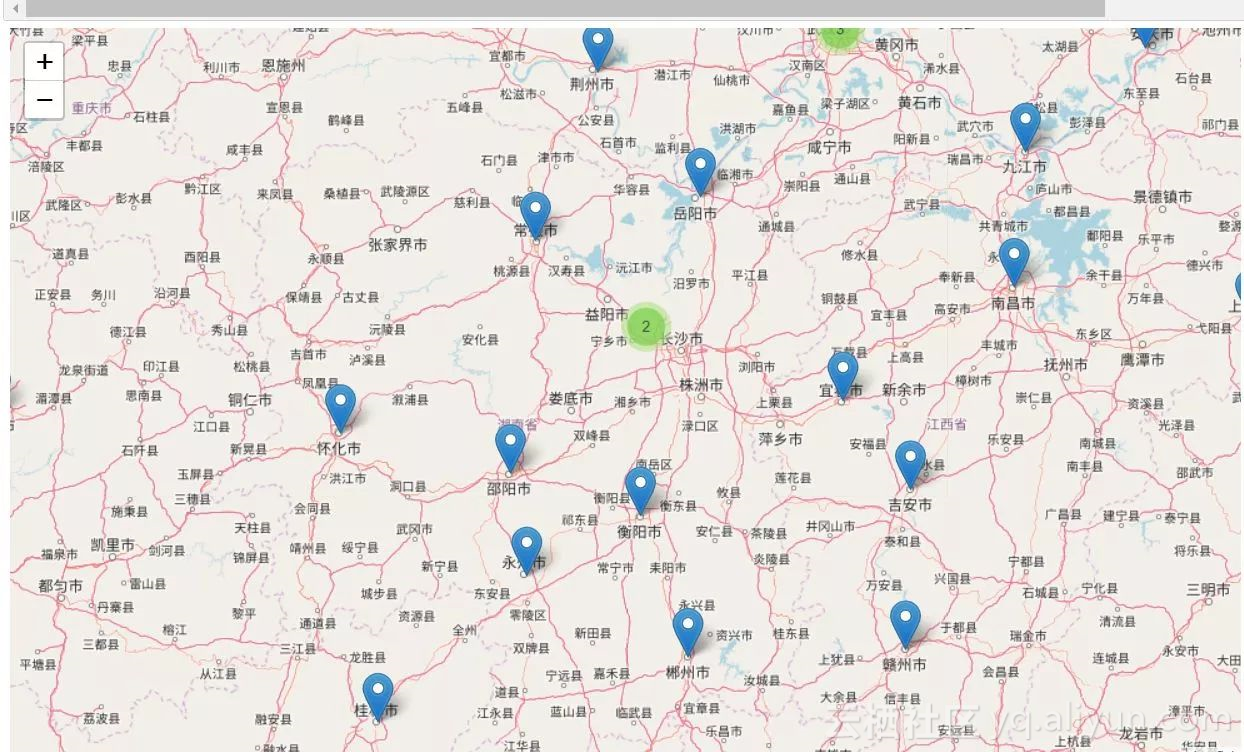
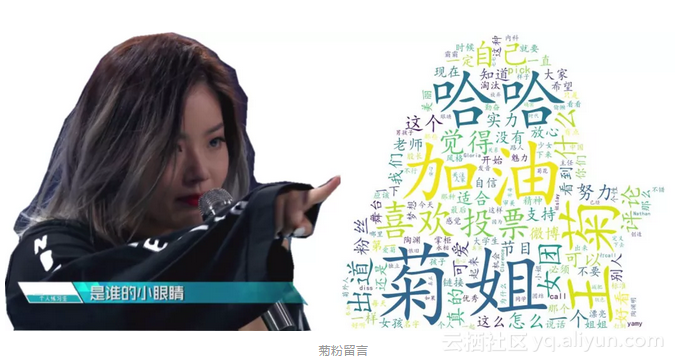
前一段时间,创造101很火,这个火是可以理解的,毕竟中国首部女团节目。但是还有一个人不知道为啥突然也火了,那就是我们的菊姐。关于菊姐为什么火,网上已经有很多发文了,这里就不再赘述了。我们抓取了菊姐的最新微博评论,将评论分词以后制作成如下词云图。 这里的海外指大陆+港澳台以外的其他所有地方。除海外用户以外就北上广的用户最多了,这些地方的互联网用户基数本来就大。 因为北京上海比较特殊,北京上海的一些区相当于北京上海这两个省下面的市区,所以你会看到一些北京上海的区域也进入了榜单,比如说朝阳群众。 但是大家都很爱学习,都想要代码学习学习,所以今天就专门来一篇讲讲代码。 在开始具体的代码讲解之前,我需要说明一下关于菊粉人数中摩羯座人数最多这个结论的一些争议,有人评论说微博用户如果不设置年龄的话,默认就是1月1,也就是摩羯座,所以摩羯座人数比较多。先

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册