首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

Python基础 | pandas.dataframe 专题使用指南

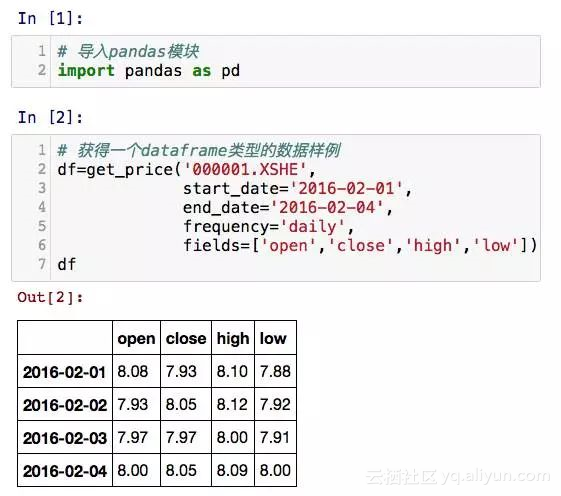
1.选取行名、列名、值 2.以标签(行、列的名字)为索引选择数据—— x.loc[行标签,列标签] 3.以位置(第几行、第几列)为索引选择数据—— x.iloc[行位置,列位置] 4.同时根据标签和位置选择数据——x.ix[行,列] 5.选择连续的多行多列——切片起点索引:终点索引 这种用法叫做一个切片,指从起点索引到终点索引。看实际用法就懂了。如果起点索引省略代表从头开始,终点索引省略代表直到最后,都省略就代表全部了。切片在.loc、.iloc、.ix三种方法中都可以应用 由上例可见,当以位置为索引时,切片是不包括终点的,是左闭右开的。即第1列到第3列不是写作0:2而是0:3。 6.选择不连续的某几行或某几列 备注:当以标签名选取不连续的某几行的时候在这个例子中如df.loc['2016-02-02','2016-02-04',:]这样写会出

优秀的个人博客,低调大师

基于bs4+requests的python爬虫伪装

要导入fake-useragent库,需要先用pip安装,安装命令:pip install fake-useragentparams是爬虫伪装的参数,数据类型为字典dict,里面有2个键值对,2个键:headers、proxies。headers的数据类型是字典,里面有1个键值对,键User-Agent对应的值数据类型为字符串,User-Agent中文翻译是用户代理。proxies的数据类型是字典,里面有1个键值对,键http对应的值数据类型为字符串,是代理服务器的url。 匿名ip主要是从66ip.cn网站获取。 import requests from bs4 import BeautifulSoup as bs from fake_useragent import UserAgent import random def getSoup(url,encoding="utf-8",**params): print(params) reponse = requests.get(url,**params) reponse.encoding = encoding soup = bs(reponse.text,'lxml') return soup def cssFind(movie,cssSelector,nth=1): if len(movie.select(cssSelector)) >= nth: return movie.select(cssSelector)[nth-1].text.strip() else: return '' def getProxyList(): proxies_url_before = "http://www.66ip.cn/areaindex_2/{}.html" proxies_url = proxies_url_before.format(random.randint(1,10)) soup = getSoup(proxies_url) item_list = soup.select("table tr")[2:] proxies_list = [] for item in item_list: ipAddress = cssFind(item, "td") ipPort = cssFind(item, "td", 2) proxies_list.append("http://{}:{}".format(ipAddress, ipPort)) return proxies_list def getParams(): ua = UserAgent() ip_list = getProxyList() params = dict( headers = {'User-Agent': ua.random}, proxies = {'http': random.choice(ip_list)} ) return params if __name__ == "__main__": params = getParams() soup = getSoup("https://movie.douban.com/top250?start=50",**params)

优秀的个人博客,低调大师

Python-网页转义字符及正则全文匹配

前言 大部分情况下,通过request去请求网页,response.text返回来的都是正常值,但是有一些反爬虫比较严重的网站(比如知乎)就不会是这样。知乎会返回转义字符,例如: header = { "User-Agent":"Mozilla/5.0 (X11; Linux x86_64; rv:57.0) Gecko/20100101 Firefox/57.0", "HOST":"www.zhihu.com", "Referer":"https://www.zhihu.com/signup?next=%2F", } def rget(): response = session.get("https://www.zhihu.com/signup?next=%2F", headers=header) target_str = response.text print(target_str) rget() 在给知乎的登录页面发请求后,打印返回结果(内容太多,只返回一小部分): &quot;token&quot;:{&quot;xsrf&quot;:&quot;9b6c6406-db1b-45fa-8626-296c037cfc00&quot;,&quot;xUDID&quot;:&quot;ANBsasFlAg2PTgaqB1CHBtsWMijmJ20s89E=&quot;},&quot;account&quot;:{&quot;lockLevel&quot;:{} 发现有很多字符是转义的,登录需要用到的xsrf字段也在这里面,这样做正则匹配就很麻烦。 解决的办法是将html进行转义: import html target_str = html.unescape(response.text) 就能够得到正常的返回信息了: "token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="}, 正则匹配 匹配xsrf的值 (为了方便测试,只将一小部分值提取出来做匹配): tokens = '"token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="},:' matchs = re.search(r'xsrf[:"\w-]+', tokens) if matchs: print(matchs.group(0)) else: print("未匹配") 得到输出结果为: xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920" 然后再借用replace将引号替换,然后用split将值用冒号分开: import re tokens = '"token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="},:' matchs = re.search(r'xsrf[:"\w-]+', tokens) nstr = matchs.group(0).replace("\"", "").split(":") finall = nstr[1] print(finall) 就得到了我需要的xsrf: 9febf0fd-7c47-4695-93b6-f670e518d920 xUDID的提取也是如此,这两个值在知乎登录的时候是需要携带的,所以要提取: import re tokens = '"token":{"xsrf":"9febf0fd-7c47-4695-93b6-f670e518d920","xUDID":"ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc="},:' matchs = re.search(r'xUDID[:"\w-]+=', tokens) nstr = matchs.group(0).replace("\"", "").split(":") finall = nstr[1] print(finall) ACDsF5lmAg2PTi2GMwQTl0Cwh88G51BOgzc= re正则匹配html的坑 上面的正则可以匹配到字符串了,如果正常登录的话要将请求返回的内容文本进行匹配的,也就是匹配response.text,代码是否就是 matchs = re.search(r'xUDID[:"\w-]+=', response.text) 坑就在这里! re默认匹配的是单行字符串,而response.text的返回值虽然是一个html页面的构成,但是它是分行的,第一行是html头<! DOCUMENT html>不是我想要的整个文本进行匹配。 re是支持整个文本匹配的,需要在正则代码加上参数re.DOTALL即可: matchs = re.search(r'xUDID[:"\w-]+=', response.text, re.DOTALL) 就可以对整个返回的文本进行匹配了


资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册